足球防守的价值,藏在没发生的进攻里
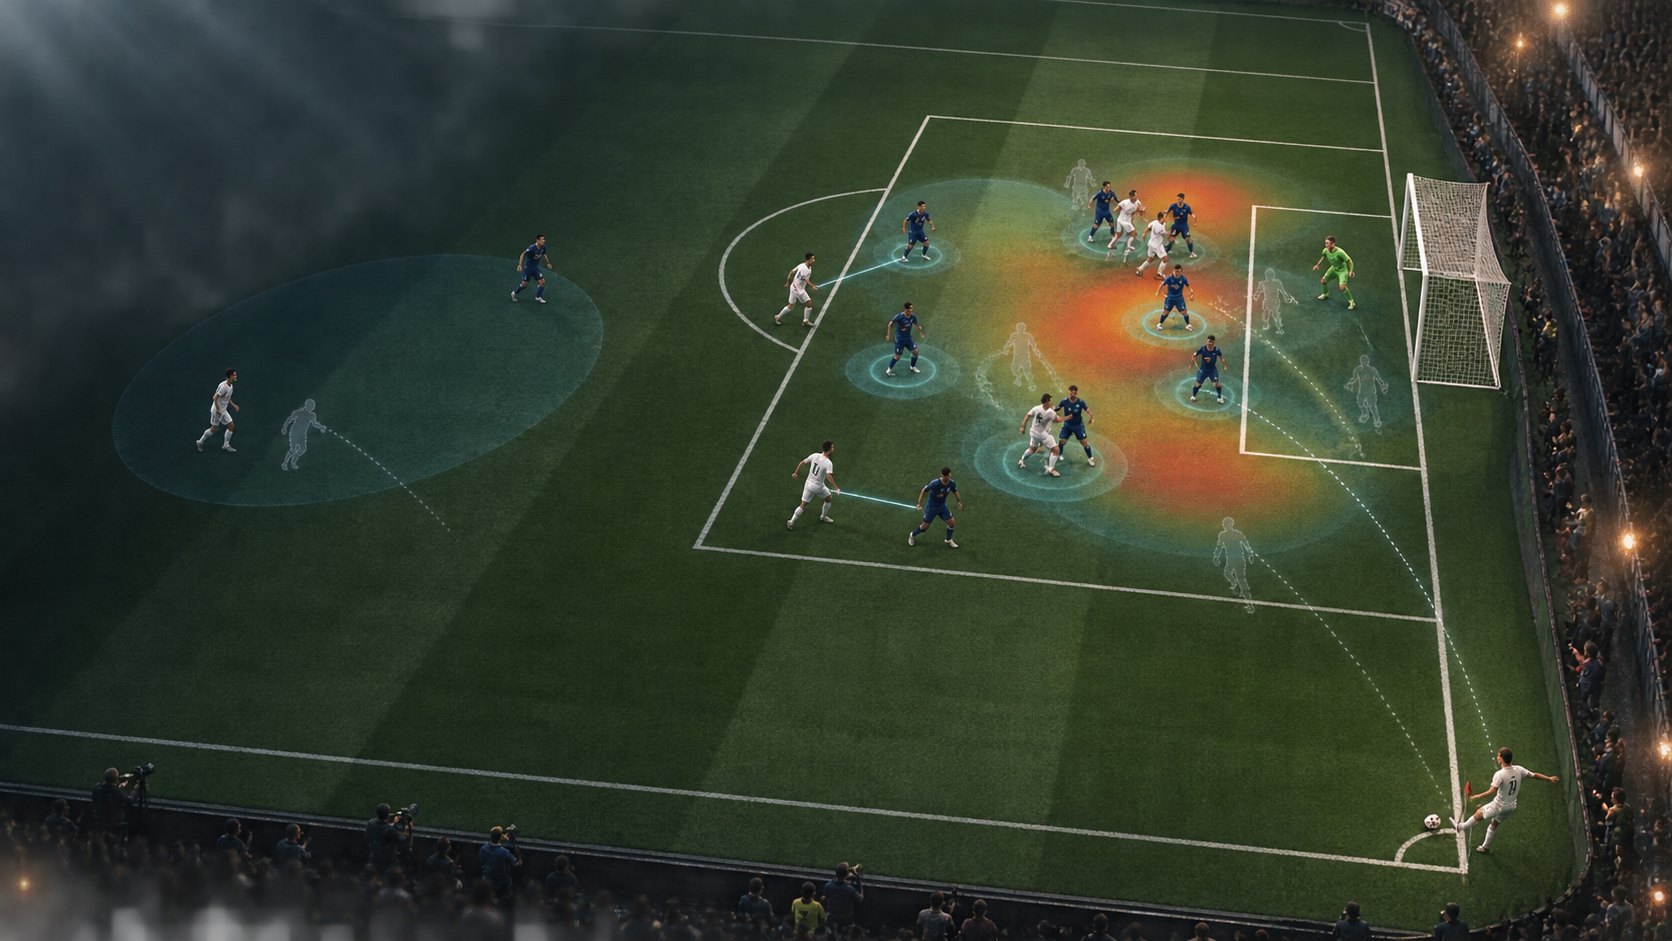
看足球比赛时,我们很容易记录进球、射门、抢断,却很难给一个"什么都没发生"的防守动作记分。一个后卫提前半步站位,可能让对手根本接不到球;一次协防让传球线路消失,也不会出现在传统事件表里。
我觉得,角球正好把这个问题放大了:战术结构清晰、动作时间短、人员角色相对稳定,却仍然很难判断一个防守者到底贡献了多少。新的分析框架让我看到,机器学习可以先推断防守角色,再用符合战术语境的反事实去评价站位。
一,先弄清楚:他当时在防谁、守哪里
这套方法使用协变量相关的隐马尔可夫模型,从球员追踪数据中无标签地推断两类角色:盯人防守,或守住固定区域。模型还加入了教练和分析师能理解的约束,例如区域发射分布固定、盯人状态如何随相对位置变化。
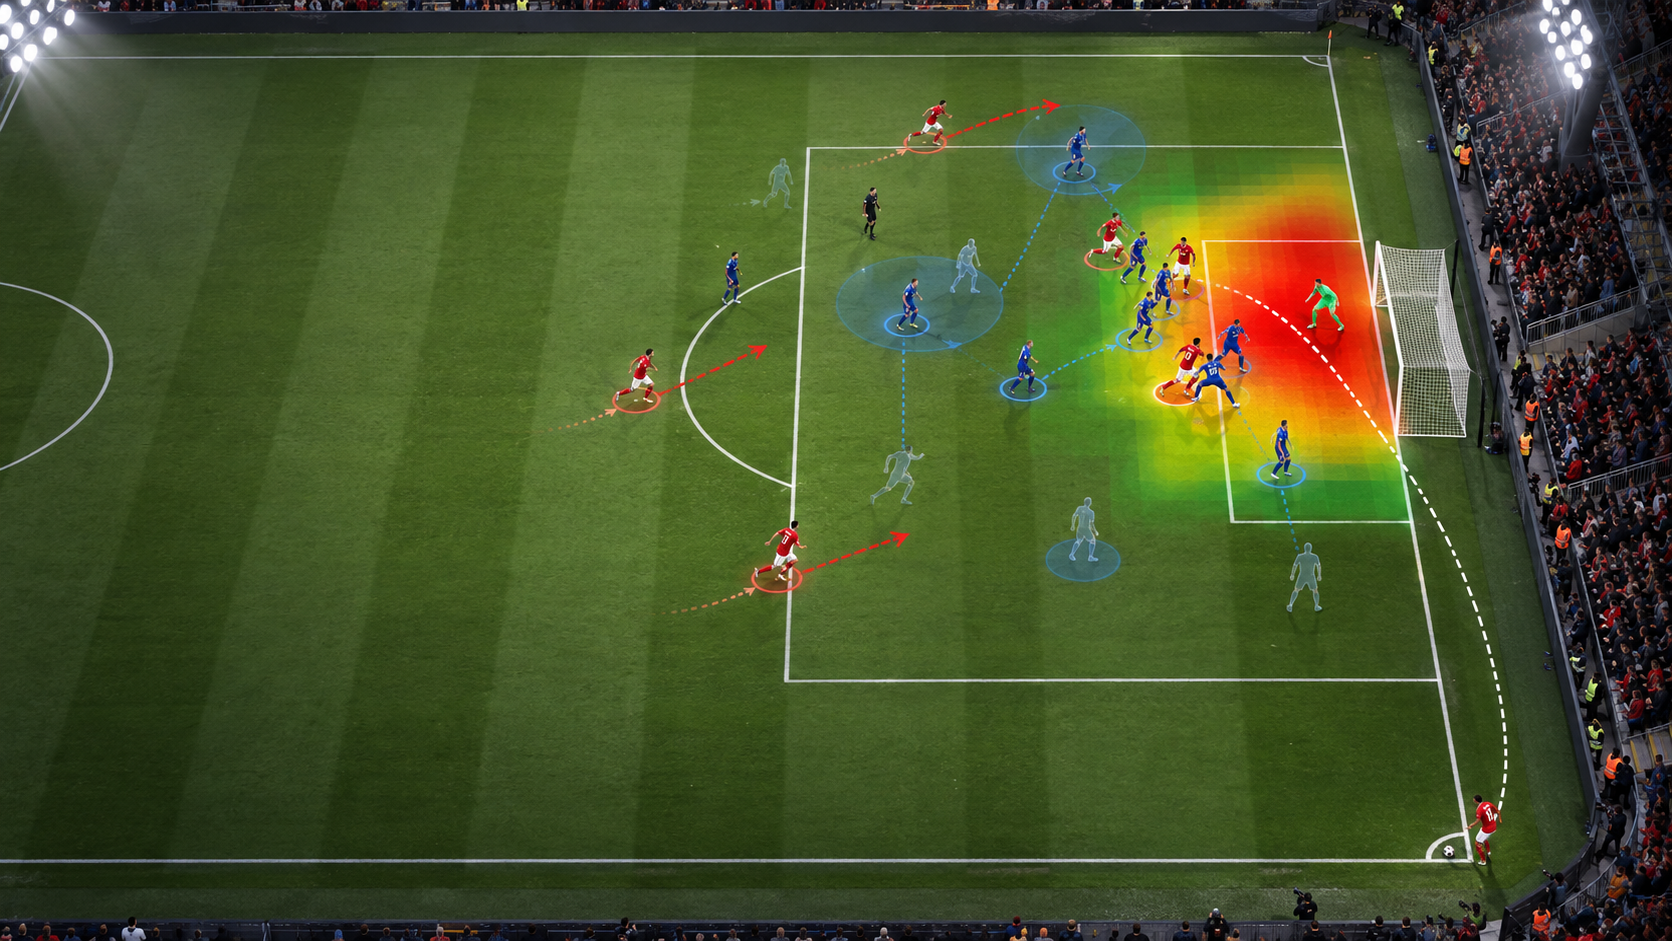
这样得到的不是一串难以解释的聚类编号,而是"这个防守者在盯谁""他在覆盖哪个区域""他何时改变任务"。对角球这种几秒内快速切换的场景,时间分辨率比一张静态站位图更有价值。
二,不用"平均后卫",而是生成有战术背景的幽灵
常见 ghosting 方法会模拟一个平均行为,再观察换成平均后卫后风险如何变化。但平均值可能没有战术意义:盯人球员被替换成守区球员,比较就不公平了。
这里的做法是生成角色条件化的反事实"幽灵":保留当时的战术角色、位置环境和传球情境,只替换成其他背景下同类角色的平均表现。随后把这些反事实放进接球或射门风险模型,定义 Group Coverage Advantage(GCA),比较一组防守者相对于角色匹配基线的覆盖优势。
我喜欢这个指标的原因,是它把"站得好"翻译成"如果换成相近角色,进攻成功概率会怎样变化",更接近教练真正关心的问题。
三,13,000 多个角球告诉了什么?
分析覆盖 2020/21 到 2023/24 四个完整英超赛季,清洗后包含超过 13,000 个角球。平均防守质量不太受传中轨迹影响,inswing 和 outswing 的平均差异很小(Cohen's d < 0.11);但 outswing 传中带来的结果波动显著更大(p < 10^-40)。
这两个结果放在一起很有意思:平均水平可能差不多,风险分布却不一样。于是教练不只要问"哪种传中更容易丢球",还要问"哪种传中让防守表现更不稳定,哪些角色在波动中最脆弱"。
模型还显示,inswing 的区域通常更靠近球门,outswing 的覆盖范围更分散;不同传中类型下,球队的区域布置与盯人切换也会变化。这些是传统总量统计很难直接看到的细节。
四,谨慎使用"防守贡献"
这个框架仍有几个重要边界。角色状态里暂时没有单独的"未参与"类别,模型可能被迫把无关动作归到盯人或区域状态;角色推断主要依靠战术合理性和模型诊断,没有公开的人工真值标签;GCA 也依赖下游接球风险模型,风险模型本身的偏差会传递到防守评价。
另外,角球是相对结构化的场景,不能直接把结论推广到开放比赛中的连续防守。不同球队的战术约束、球员能力和传中质量,也需要在更细的层级上拆开分析。
五,结论
我认为,防守分析最有潜力的方向,是把"阻止对手行动"也变成可比较的证据。先识别角色,再构造符合角色的反事实,最后把站位放进真实风险模型里,才能让无球跑动获得它应有的解释空间。
好的防守数据不只是告诉我们谁碰到了球,也要告诉我们谁让球根本没有机会被碰到。
参考资料:Groom, S., Belo, F., Rice, A. et al. A machine learning framework for off-ball defensive evaluation applied to corner kicks. npj Artif. Intell. (2026).