混合检索为什么有效:RRF 改变了哪些排名?------SciFact 开发集冻结排名实验
一、复现价值:平均更弱的一路,还有用吗?
冻结的 MiniLM 稠密检索平均低于 BM25,却在一些查询上获胜。这给出一个自然问题:能否把两路优势合起来?BM25 依赖词项匹配,稠密检索将文本编码为向量,再比较向量相似度。两者有不同的失误模式,但"不同"并不自动等于"互补有效"。
本篇只新增融合变量:语料、查询、标注、预处理、模型及其输出均冻结。我们要复现的不是一个漂亮总分,而是一条可审计证据链:相关文档原来在哪一路、融合后到了哪里、收益来自候选变多还是排序规则。SciFact 在这里是相关文献检索任务,检索分数不能解释成科学事实判断能力。SciFact 原论文
二、核心思想:把分数改成名次贡献
倒数排名融合(Reciprocal Rank Fusion,RRF)不直接相加 BM25 与向量相似度,而对每一路的名次取倒数后相加:
s ( q , d ) = ∑ j ∈ { B , D } 1 d ∈ L j ( m ) ( q ) k + r j ( q , d ) . s(q,d)=\sum_{j\in\{B,D\}}\frac{\mathbf 1d\\in L_j\^{(m)}(q)}{k+r_j(q,d)}. s(q,d)=∑j∈{B,D}k+rj(q,d)1d∈Lj(m)(q).
其中,查询为 (q),文档为 (d),两路分别用 (B,D) 表示;(L_j^{(m)}) 是每路保留的前 (m) 个候选,(r_j) 从一开始计数,未入榜的贡献为零。(k) 控制头部名次优势衰减的速度,不是保留候选的数量。本文主配置固定 (k=60,m=100),融合后再取前一百个文档。
**论文报告:**Cormack、Clarke 与 Buettcher 在 2009 年提出并评估 RRF,论文用先导实验确定常数六十;报告的优势来自其特定实验集合,不能当成任意检索器组合的保证。原论文
**作者推断:**两路都能找到的文档可获得两份贡献,因此融合偏好共识;这也可能压低只在一路排名很高的正确答案。这个解释必须回到逐候选记录验证,不能仅凭公式给所有失败编故事。
三、官方代码阅读路线:计分之外还有协议
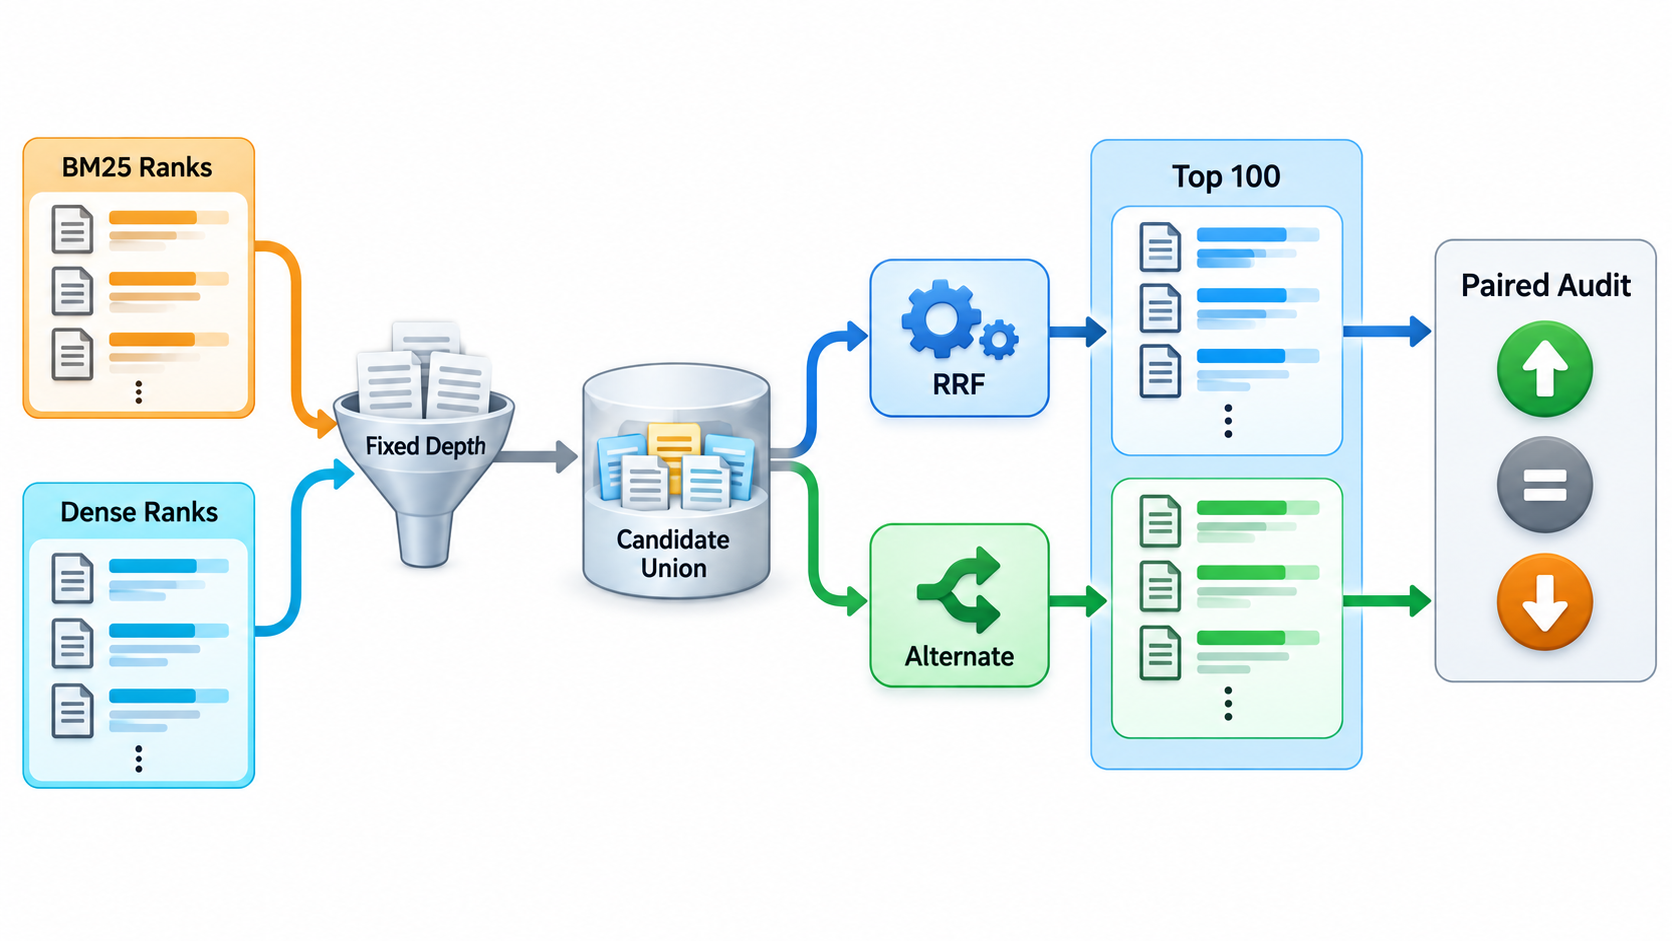
我们实际核验并运行 Castorini 官方 Pyserini 的固定提交 527c917120ff154f84b09ff2b69dc8946085aae4。先读 reciprocal_rank_fusion,再追到 TrecRun.rescore,最后读 TrecRun.merge:入口克隆输入,逐路按排名重计分,截断候选,按查询与文档编号求和。具体文件和行号见文末源码地图。
这里运行的是两份原样保存的官方模块,不是论文作者代码,也没有启动整套 Pyserini 搜索服务。输入是六列记录:查询编号、占位列、文档编号、名次、原分数、运行标签;两路分别有 80827 与 80900 行。一条 BM25 查询不足一百项,因此不能假定矩阵总是整齐的"查询数乘一百"。
官方默认同分时按文档编号升序。为延续前篇评测协议,适配层先取完整融合并集,再统一按分数降序、字符串编号降序排列和截断。我们明确保留这项改动,并另外测量升序的影响。只固定公式、不固定同分规则,仍可能得到不同结果。官方实现
四、最小实验:先冻结选择规则,再运行
本次使用 BEIR 的 SciFact train 划分作为开发集,809 条查询全部进入评测;300 条 test 查询继续封存。沿用前篇完整语料检索产生的两份前百排名和相关性标注,三份输入均锁定字节哈希与公开提交。MiniLM 与 tokenizer 的 revision 均为 1110a243fdf4706b3f48f1d95db1a4f5529b4d41,来源编码采用标题加空格加摘要、最大长度 256、384 维向量。原始数据包没有不可变 revision,使用已保存的 SHA-256 标识,详见资源锁。BEIR、模型卡
运行前写下 PROTOCOL.md:主指标为 nDCG@10,即对前十位相关文档按位置折扣并归一化;辅助指标为 Recall@100,即前百覆盖的相关文档比例,以及 MRR@10,即首个相关结果名次的倒数。常数六十事先固定,十与一百只做开发敏感性分析;不因本次结果更好就替换主配置。种子为八十四,但融合本身是确定性计算。
最小入口取五条真实开发查询,仍使用完整语料检索留下的排名。全量运行保存八套输出、逐查询指标、136650 行候选贡献、最大收益与损失各三例,以及阶段状态、退出码、环境和耗时。输入准备为验哈希,推理阶段为复用已有真实结果,融合和评测则本次实际执行;这些状态不能合写成"重新跑完所有模型"。
五、受控评测:候选覆盖与排序要分开
主实验每路一百项,并集平均约 168.9 项,最终输出一百项。它与单路一百项的比较同时改变了候选来源和候选数量,不能把提升全部归因于 RRF。
因此加入简单交替合并:按两路名次轮流取文档,BM25 先取,重复项跳过,最后保留一百项。先取哪一路也是冻结的规则。它与 RRF 读取相同并集,却采用不同排序规则。再加每路五十项的对照:去重并集至多一百项,两种规则保留完全相同的文档集合,更适合隔离前十排序差异。这个预算控制指的是保留的排名条目数,并不代表上游检索计算量相等。
| 方法 | 每路输入深度 | nDCG@10 | Recall@100 |
|---|---|---|---|
| BM25 | 100 | 0.69427 | 0.93506 |
| MiniLM | 100 | 0.66020 | 0.93243 |
| RRF,主配置 | 100+100 | 0.71222 | 0.95035 |
| 交替合并 | 100+100 | 0.71311 | 0.94850 |
| RRF,同集合对照 | 50+50 | 0.71294 | 0.94413 |
| 交替合并,同集合对照 | 50+50 | 0.71311 | 0.94413 |
**本次实际验证:**RRF 主配置比 BM25 提高约 0.01795,却比交替合并低约 0.00089。同集合对照也没有显示 RRF 的前十排序优势。因而本次支持"两路结合可以改善平均检索表现",暂不支持"RRF 公式优于简单合并"。差值很小,本文没有宣称统计显著或跨领域成立。
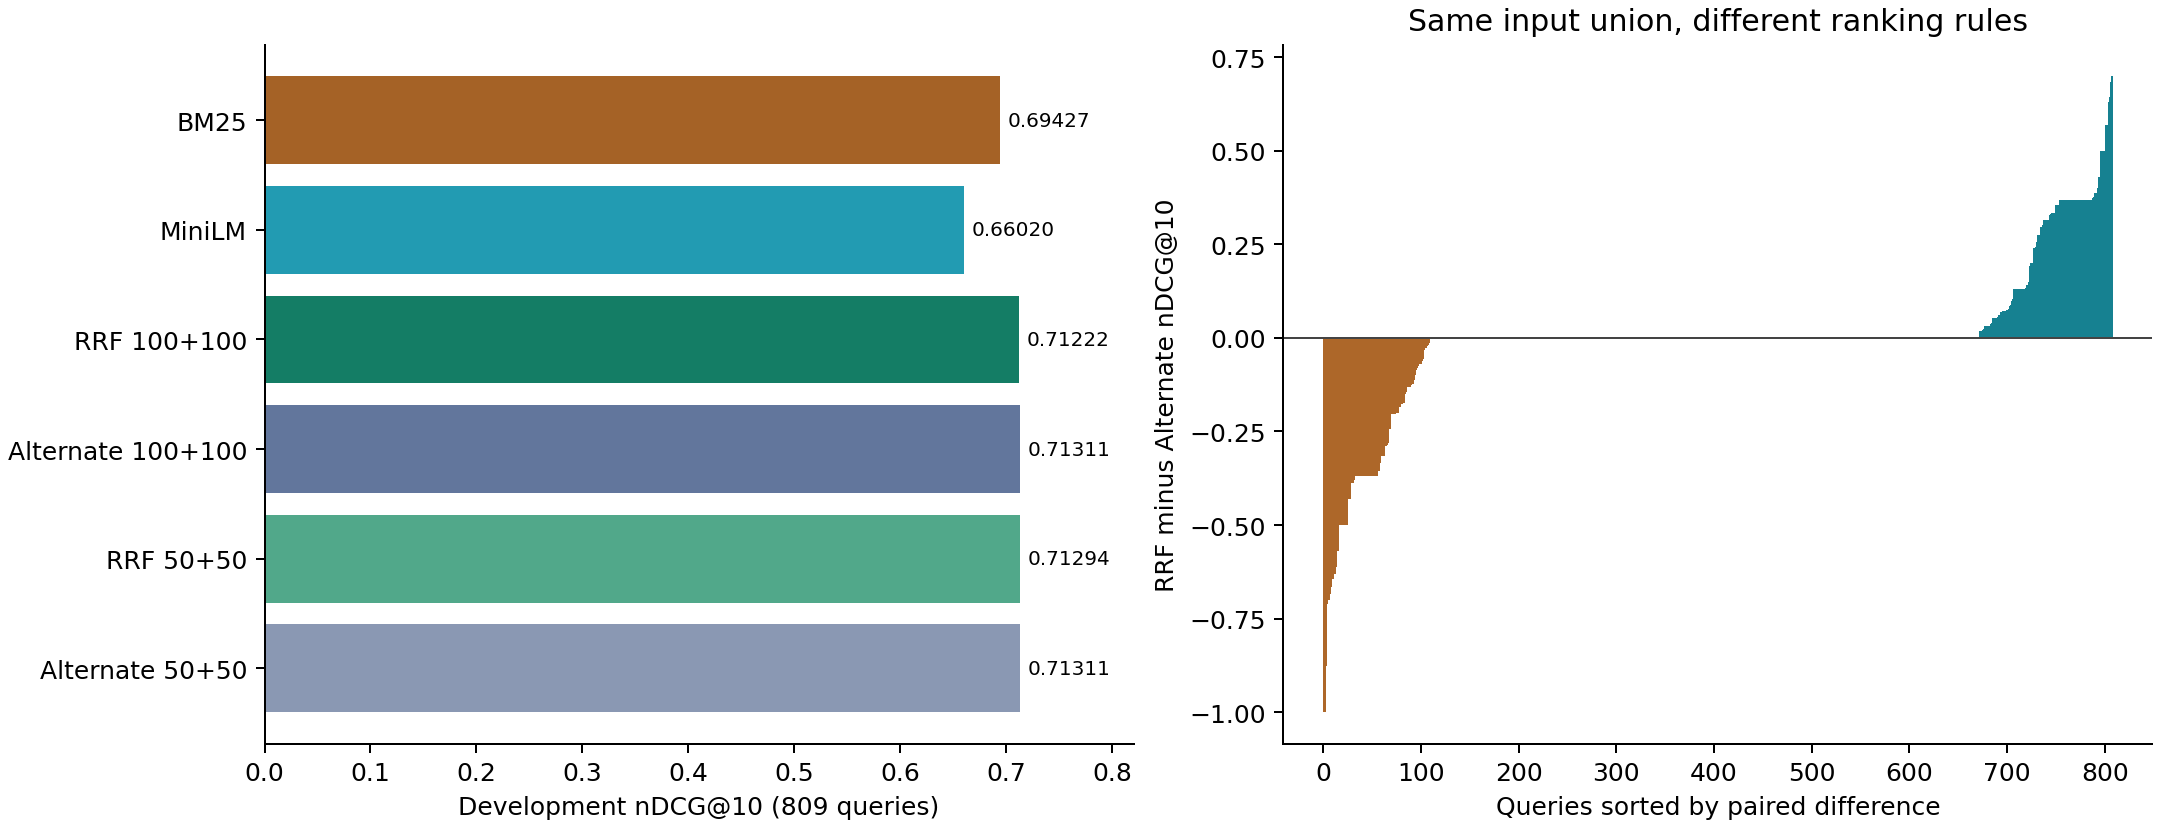
上图由 plot.py 读取保存的汇总与逐查询 JSON 生成,右侧按差值排序展示全部查询,没有挑选可视化子集。常数十的开发分数为 0.72098,高于六十;这一观察保留为后续假设,不能回头把主配置改称事先选定的赢家。
六、失败分析:到底改变了哪些名次?
相对 BM25,主配置在 162 条查询上提高、546 条持平、101 条下降;相对交替合并则是 137 胜、562 平、110 负。后者胜的查询更多,平均分却更低,因为提升幅度与损失幅度不对称。胜负数量不能替代逐查询差值之和。
按预先规定的极值选择规则,查询 618 的相关文档 6836086 从 BM25 第二十五、稠密第三,上升到融合第一。查询 317 的相关文档 4506414 则从 BM25 第一、稠密第五十二,下降到融合第十一,跌出主指标窗口。查询 1307 的相关文档只出现在 BM25 一路,同样从第一跌到第十一。它们说明共识偏好有代价,但尚不能证明某个语言现象是原因。
贡献表还显示:融合前十中的查询---文档对,7935 对被两路共同召回,仅 155 对来自单路。相对 BM25,有 44 个相关对进入前十,23 个离开。这是重复计入不同查询的"对",不是独立文档数。极值案例中还存在不同查询共享同一相关文档的情况;我们没有捏造人工语义分类,也没有假定这些查询完全独立。
完整并集的平均召回为 0.97054,仍有 22 条查询完全没有相关候选;截断为融合前百又丢掉了 18 个已召回相关对。这分别对应"没有候选可排"和"有候选但被排出",正是下一篇重排实验需要拆开的两类上限。
七、失败排查与可信边界
首先查编号、名次起点和去重,再查同分。只将编号规则改回升序,主配置 nDCG@10 就变成 0.71025,60 条查询的指标发生变化;这个变动甚至大于 RRF 与交替合并的均值差距。本文保留降序协议,不借此挑分。
其次查数值与程序不变量。独立审计用有理数重算融合贡献,检查 310733 个保存分数,最大误差约为 (2.78\times10^{-17});七个配置---查询组合存在有理数与浮点排序差异,但三项指标均未改变。另行逐行核对全部贡献记录,验证八套指标、原输入未变,以及复制同一路不会改变原排名。
最终全量运行在 macOS arm64、Python 3.12.14、CPU 上完成,耗时 4.86 秒,进程峰值常驻内存约 377.7 MiB;主配置融合约 0.37 秒。它们不包含前篇模型编码和检索成本。一次复核因错误地解析虚拟环境解释器软链接而缺少评测依赖,失败日志保留,改用环境内入口后通过;缺依赖时的环境记录也已修复。
还要检查实验身份。缓存键包含两份输入及标注的哈希、模型与分词器版本、配置、依赖和所有自写脚本的哈希;本实验没有提示词与解码,记录为明确的空值。即使融合不加载模型,也不能丢掉上游身份,否则后续换了编码长度或模型权重,旧排名仍可能被误当成同一次实验。
对刚接触复现的读者,最实用的阅读顺序是先看一条失败查询的贡献行,再回到汇总表。不要先靠总分猜机制:同一个召回比例可能来自不同文档集合,同一个前十指标也可能掩盖十名之后的大量交换。工程读者应让这些核验成为入口的一部分;研究生则需要进一步问,当前证据究竟区分了哪两个竞争解释。
八、把观察变成可检验的研究问题
第一个假设是:单路强命中、另一路缺失的查询,是共识融合的系统性弱点。下一步应在开发集预先定义"单路前位、另一路未召回"的分组,统计组内退化,并冻结一个简单保护规则;最终确认集只用于一次比较。若退化不集中在该组,假设就被削弱。
第二个假设是:重排收益主要受候选覆盖限制,而不是融合常数限制。下一篇保持相同候选集合,引入真实交叉编码器,分别报告已召回相关文档的排序改善与无相关候选的查询比例,同时测量推理成本。不能用更多候选换取提升后仍称其为纯排序改进。
九、源码与复现入口
公开固定版本:源码目录、README、SOURCE_MAP。依赖、配置、输入哈希、许可证、完整日志与逐查询结果均在该版本内,不需要访问作者机器。
安装 README 中的固定依赖后,最小命令为 python run.py --out results/my_smoke --smoke,预期生成五条真实查询的排名、指标、阶段状态与身份记录。完整复现去掉 --smoke,再运行 python audit.py --out results/my_run;输出路径需与运行命令一致。本次实际完成全部 809 条开发查询,本地归档解压与公开提交导出副本均已重跑全量实验,关键结果文件逐字节一致。
十、总结
混合检索的价值不只是把两份榜单相加,而是提供一个可以逐项追责的干预:哪些候选增加了,哪些相关结果上升了,哪些被共识压下去了。本次 RRF 改善了单路均值,却没有战胜简单交替规则。把这个负结果、协议细节和候选上限一起留下,比提前宣布一种融合方法获胜,更能支撑下一轮科研问题。
参考资料
检索与实际访问日期:2026-09-27。固定源码链接与许可证核验详见 SOURCE_MAP。
- Cormack, Clarke, Buettcher. Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods , SIGIR 2009:论文、出版信息。
- Castorini. Pyserini ,本文固定提交:融合源码、排名工具。
- Wadden et al. Fact or Fiction: Verifying Scientific Claims , EMNLP 2020:ACL 页面。
- Thakur et al. BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models , 2021,本文引用 arXiv v4:论文。
- Sentence Transformers. all-MiniLM-L6-v2 :官方模型卡。