让 AI 写出一篇"看起来像论文"的文章,和让 AI 真正完成一项研究,中间隔着的不是排版,而是一整套证据。
方法为什么有效?换个数据集还成立吗?提升到底来自新设计,还是调参碰巧调对了?审稿人指出问题后,是修改措辞,还是回到代码里补实验?这些问题,才是判断研究是否站得住脚的关键。
Google Cloud AI Research 与滑铁卢大学的研究者提出了 ScientistTwo。它试图自动完成的不只是"提出想法---写代码---生成论文",而是把实验、消融、模拟审稿和方法修改连成一个可以反复运行的科研过程。
论文标题: ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI
中文译名: ScientistTwo:利用自主 AI 开拓人类知识前沿
一、研究背景:AI 能写论文,不等于 AI 会做研究
真正的任务,是在已有研究上找到可验证的突破
这篇论文讨论的是"问题驱动的自主科研":人类给出一个研究问题,系统自行识别现有方法的不足、提出假设、编写代码、完成实验,最终交付论文和可复现的代码。原文将这个任务写成:
(P+,C+)=A(G),A={A1,A2,...,ANa}.(1) (\mathcal{P}^{+},\mathcal{C}^{+})=\mathcal{A}(\mathcal{G}),\qquad \mathcal{A}= \{\mathcal{A}1,\mathcal{A}2,\ldots,\mathcal{A}{N{\mathrm a}}\}. \tag{1} (P+,C+)=A(G),A={A1,A2,...,ANa}.(1)
这里,G\mathcal{G}G 是研究问题,A\mathcal{A}A 是由多个专业 Agent 组成的系统,P+\mathcal{P}^{+}P+ 和 C+\mathcal{C}^{+}C+ 分别是新论文与配套代码。换句话说,输出不能只有一段听起来不错的论述,还需要能够运行、能够核验,并且确实解决了某个已有瓶颈的实现。
不过,论文里的评测不是给 AI 一句任意领域的问题,就让它凭空发现新科学。作者选取了 ICLR、ICML、NeurIPS 已接收论文所对应的研究问题,并以这些工作的任务规格、已有方法和代码库作为研究起点;因此,更准确的理解是:在已有前沿工作的基础上,让 AI 自主寻找下一步改进,而不是从零替代所有科学研究。
为什么仅仅"自动跑实验"还不够?
作者认为,以往部分科研自动化系统更接近指标优化器:给定一个数据集和一个目标分数,系统尝试修改代码,直到分数变高。但一项研究是否成立,往往不能用单个分数回答------它还需要跨数据集验证、合理的对照、组件贡献分析,以及对失败场景的解释。
ScientistTwo 因而把重点放在三个相互关联的能力上:用多数据集、多指标判断方法是否真的有效,用消融结果反过来修改方法,再把模拟审稿意见转化为可执行的补充实验。这里的贡献不在于第一次让 AI 写论文,而在于让科研流程后半段产生的证据,能够持续反馈到前半段的假设与设计中。
二、相关工作:从"会用工具",走到"能推进研究"
这条路线的基础,是让大模型不再只输出文本,而是能够采取行动。ReAct 将推理与工具行动连接起来,AutoGen 等框架支持多个角色协作,SWE-agent 则围绕代码环境中的操作与执行反馈解决软件问题;它们提供了规划、调用工具、调试和协作的基础能力,但完成一个软件任务,并不天然等于完成一项科研贡献。
再往前一步,是自动机器学习与数据科学系统。论文列举的 AIDE、MLE-STAR,以及 Data Interpreter、DS-STAR 等工作,开始围绕建模流程、数据处理和结果验证组织任务,使系统能够执行并改进一条实验管线;这解决了"能不能把实验跑起来"的问题,但研究还要进一步回答:为什么选择这个方向,改动有什么新意,收益能否被解释,以及结论能否经受不同条件下的检验。
与 ScientistTwo 更直接相关的是端到端科研 Agent。AI Scientist 已经探索从想法、实验到论文写作的自动化,AI Scientist-v2 进一步采用最佳优先树搜索来组织实验分支,因此不能把"自动做实验、自动写论文"说成 ScientistTwo 首次提出;ScientistOne 则更强调研究产物的可验证性,包括实验分数、任务规则、参考文献与方法实现的一致性。ScientistTwo 要继续补上的,是核验之外的主动改进:发现证据不足后,不只指出问题,还能设计下一轮实验、修改核心方法。
此外,PaperOrchestra 和 ScholarPeer 分别对应科研流程中的写作与评审环节:前者把想法和实验记录整理为 LaTeX 论文,后者模拟多角色同行评审。ScientistTwo 在框架中引入这些能力,并把它们与实验执行连接起来;因此,它不是简单堆叠几个会聊天的角色,而是尝试让写作、审稿和代码执行真正影响彼此的下一步动作。
三、核心方法:不是一条流水线,而是多层反馈循环
ScientistTwo 是一个科研工作流框架,而不是一个同名的新基座模型。理解它的关键,是看每个阶段如何产生候选结果、由谁检查结果,以及检查不通过后系统返回哪里:有的问题只需要修代码,有的问题需要补实验,还有的问题必须重新设计方法。
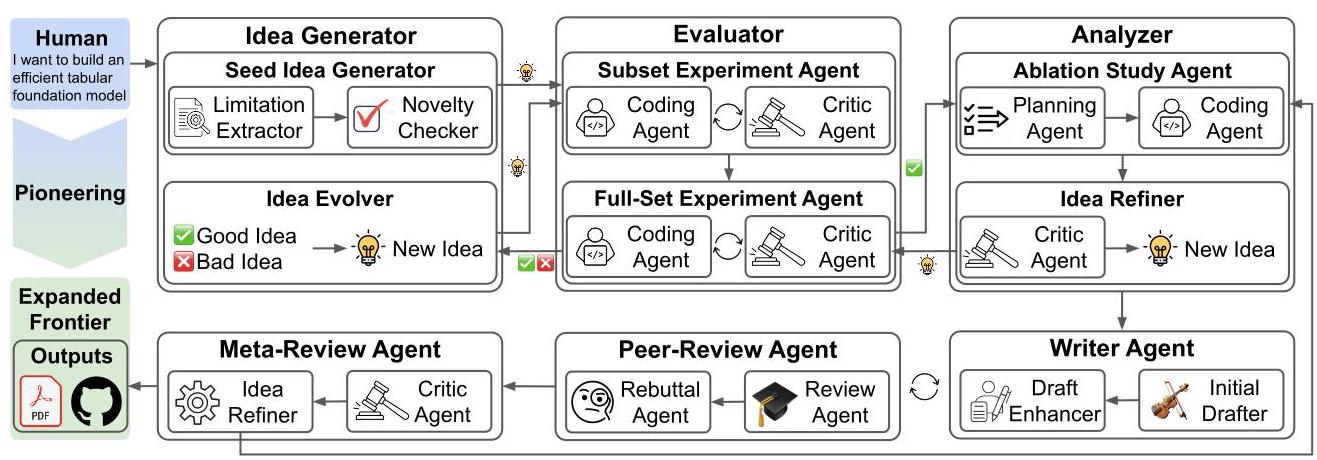
3.1 先找现有方法的瓶颈,再生成研究想法
系统首先通过 Limitation Extractor 提取现有方法的局限,再交给 Limitation Verifier 检查:这些局限是否足够具体,能不能引导出有意义的新方法;如果不够,系统继续补充,而不是立即进入写代码阶段。随后,Idea Generator 围绕这些问题生成候选想法,Novelty Checker 对其新颖性进行评分,形成种子集合 H0={h0,...,hNseed−1}\mathcal{H}0=\{h_0,\ldots,h{N_{\mathrm{seed}}-1}\}H0={h0,...,hNseed−1},并优先尝试评分较高的方向。
这一步的设计意图,是把"头脑风暴"变成有明确对象的研究:不是泛泛地说"加一个模块可能更好",而是先说明现有方法在哪里失效,再提出可能解决该失效的机制。需要区分的是,新颖性评分在这里是候选筛选信号,不是对"世界上从未有人做过"的严格证明。
3.2 先做小规模筛选,再决定是否投入完整实验
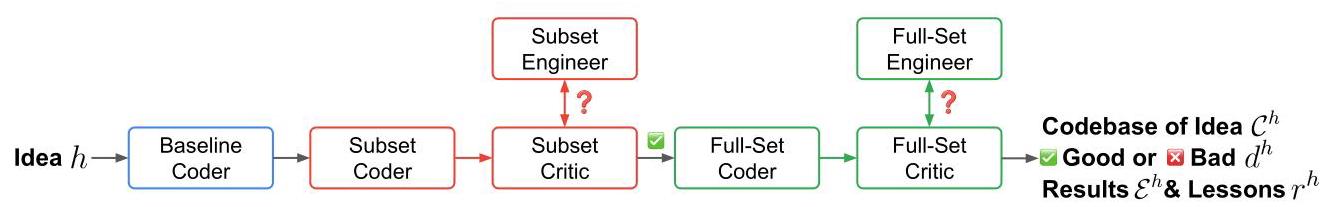
一个看起来合理的想法,未必值得立即投入完整算力。ScientistTwo 先在基准子集上复现原方法,得到基线结果 Ebase\mathcal{E}{\mathrm{base}}Ebase 和代码 Cbase\mathcal{C}{\mathrm{base}}Cbase,再修改这份代码实现候选想法,让新旧方法在相应的子集设置下进行比较。
评估 Agent 给出的不是简单的"通过或失败",而是 Bad、Good、Engineer 三种判断:明显不如基线的方向被放弃,稳定优于基线的方向进入完整评测,还有潜力但实现或参数尚未调整好的方向,交给工程 Agent 继续修改;修改次数有预算上限,避免系统在一个不理想的方向上无限消耗资源。\^experiment
通过筛选后,系统将实验扩展到完整基准套件,结合多个数据集和评价指标,检查改进是否仍然成立。论文把这整套过程封装成统一接口:
h,Eh,Ch,dh,rh=ACoder(G,h).(2) h,\mathcal{E}^{h},\mathcal{C}^{h},d^{h},r^{h}= \mathcal{A}_{\mathrm{Coder}}(\mathcal{G},h). \tag{2} h,Eh,Ch,dh,rh=ACoder(G,h).(2)
其中,Eh\mathcal{E}^{h}Eh 是实验结果,Ch\mathcal{C}^{h}Ch 是实现代码,dhd^{h}dh 是评估结论,rhr^{h}rh 是诊断反馈。系统保存的不是一个孤立分数,而是"想法---代码---结果---判断---反馈"这一整条记录,这也是下一轮改进能够利用实验经验的基础。\^experiment
3.3 成功结果和失败日志,都要进入下一轮研究
每轮实验完成后,ScientistTwo 不会把失败的方向直接从记忆里删除。它将式(2)的执行结果组织为轨迹集合;沿用原文式(3)的含义,可简洁写为:
Rk={(h,Eh,Ch,dh,rh) | h∈Hk}.(3) \mathcal{R}_k= \left\{ \left(h,\mathcal{E}^{h},\mathcal{C}^{h},d^{h},r^{h}\right) \;\middle|\; h\in\mathcal{H}_k \right\}. \tag{3} Rk={(h,Eh,Ch,dh,rh) h∈Hk}.(3)
Idea Evolver 会分析历轮记录 R<k=⋃i=0k−1Ri\mathbf{R}{<k}=\bigcup{i=0}^{k-1}\mathcal{R}_iR<k=⋃i=0k−1Ri,既利用成功方案中的有效设计,也利用失败日志中暴露的问题,生成下一轮改进想法。不过,系统不会只围着早期方案反复修补,还会加入尚未尝试的新颖种子;于是,第 kkk 轮候选池由"根据实验进化出的想法"和"尚未测试的种子想法"共同组成,即 Hk=Ik∪H0(k)\mathcal{H}_k=\mathcal{I}_k\cup\mathcal{H}_0^{(k)}Hk=Ik∪H0(k)。
这里对应的是一个很实际的研究取舍:一边沿着有希望的方向继续深挖,一边保留尝试新方向的机会。如果达到预算上限仍然没有成功方案,流程会终止,而不是无论实验是否成功都强行写出一篇论文;只要已有通过完整评测的候选,Selector Agent 就可以从中选择进入消融分析的最佳方案:
hbest,Ebest,Cbest=ASelector(G,{(h,Eh,Ch) | dh=Good}).(4) \begin{aligned} &h_{\mathrm{best}},\mathcal{E}{\mathrm{best}},\mathcal{C}{\mathrm{best}}\\ &\quad= \mathcal{A}_{\mathrm{Selector}}\left( \mathcal{G}, \left\{ (h,\mathcal{E}^{h},\mathcal{C}^{h}) \;\middle|\; d^{h}=\mathrm{Good} \right\} \right). \end{aligned} \tag{4} hbest,Ebest,Cbest=ASelector(G,{(h,Eh,Ch) dh=Good}).(4)
这里的"最佳"是系统结合候选的评价指标与执行记录作出的选择,并不意味着得到了数学意义上的全局最优解。
3.4 消融实验不是凑表格,而是允许推翻自己的设计
确定当前最佳方案后,Ablation Planner 会生成组件级消融计划,再由 Ablation Coding Agent 修改代码并执行,得到消融结果 Eabl={c1,...,cNp}\mathcal{E}{\mathrm{abl}}=\{c_1,\ldots,c{N_p}\}Eabl={c1,...,cNp}。关键在于,后面的 Ablation Critic 不只是把这些结果整理成论文表格,还要判断:哪些组件确实提供了收益,哪些组件可能冗余,当前方法是否还需要重构。
举个帮助理解的例子:一个候选方法包含 A、B、C 三个模块,消融后发现去掉 B 反而更好。系统不应该继续把 B 包装成贡献,而应该尝试删掉它,再重新验证简化后的方法;这对应论文强调的"用消融指导假设改进",而不是先把方案定死,再找几组结果为它背书。
为了避免"改得更多却变得更差",系统只在结果比较 Agent 判定新方案优于当前最佳方案时,才更新研究状态:
(hbest,Ebest,Cbest)←(hnew,Enew,Cnew). (h_{\mathrm{best}},\mathcal{E}{\mathrm{best}},\mathcal{C}{\mathrm{best}}) \leftarrow (h_{\mathrm{new}},\mathcal{E}{\mathrm{new}},\mathcal{C}{\mathrm{new}}). (hbest,Ebest,Cbest)←(hnew,Enew,Cnew).
更新后,新方案还要重新接受消融分析。因此,消融在这里既是解释工具,也是推动方法变化的工具;但组件贡献的实验分析,仍不应被直接等同于对所有因果机制的严格证明。
3.5 审稿意见不只是修改建议,而是下一轮实验任务
实验与消融完成后,写作 Agent 借助 PaperOrchestra 整合方法、结果和分析,生成初稿;随后,ScholarPeer 作为模拟审稿器给出优点、不足、问题和评分,若未达到设定门槛,就进入自动 rebuttal 流程。原文以 1---10 分制下的 8 分作为示例门槛,并为循环设置最大轮数。
最值得关注的是 Rebuttal Agent 的动作:它不是只生成一封"感谢审稿人建议"的回复,而是先把评论拆解成补充实验任务,再修改代码、执行实验,最后把新增证据写回论文。例如,审稿人质疑某项结论缺乏实验支持时,系统的目标应当是补齐相应证据,而不是仅把结论写得更有说服力;这是对该闭环工作方式的直观理解。
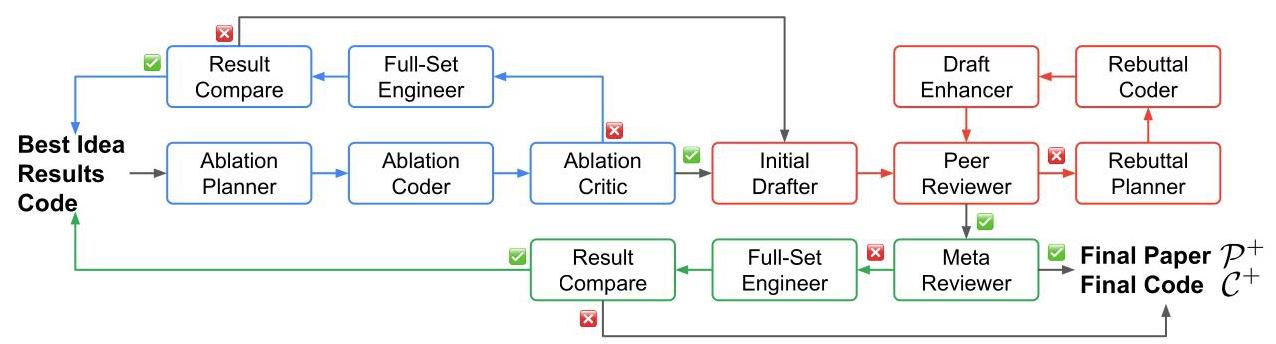
之后还有一层 Meta-Review Agent,即元审稿角色。它结合修改后的论文与审稿反馈作出 Accept 或 Refine 判断:如果发现的是方法本身或实验设计的关键缺陷,就把反馈送回完整实验阶段,推动新一轮方法修改;只有新方案被判定更优时,才更新当前最佳状态,并重新进行消融、写作和审稿,否则保留此前产物并结束相应流程。所以,系统导出最终论文,不自动意味着论文已经通过其内部接收门槛,更不意味着真实会议录用。
论文还用实验检查了这套反馈是否有效:在 49 个 ICML 来源任务上,ScholarPeer 评分随两轮审稿从 5.2 提高到 6.9、7.6,但未参与内部优化的 Stanford Agentic Reviewer 评分是 5.6、5.8、5.7。这个差异很重要------补实验与修改有收益,却不是审稿轮数越多,所有评审器都会持续给出更高评价;尤其 ScholarPeer 本身就在优化循环中,其分数上涨不能单独充当独立验证。
此外,系统设置了研究产物核验:重新执行代码核对报告分数,检查是否违反任务规则,验证参考文献是否真实,并核对论文方法与实际代码是否一致。例如,论文写了一个创新模块,代码却没有真正使用它,这种不一致也需要被发现并修正;在报告的 49 项最终审计样本中,系统通过了相应检查,但这仍是该评测范围内的核验结果,不是对任意输出的可靠性保证。
3.6 一个具体例子:检索到历史序列,不代表应该照单全收
论文展示了 ScientistTwo 生成的 DynaSpec-RAG,用于零样本时间序列预测。这个案例里的问题很直观:借助相似历史轨迹修正预测时,如果把检索结果当成不可拆分的整体,可能出现预测接缝处不连续、长期趋势与短期波动混在一起,以及无关历史反而干扰预测等问题。
ScientistTwo 给出的方案,不是继续增加检索数量,而是改变检索信息的使用方式:先对齐历史片段与当前观测的边界,再用频域分解区分趋势和细节,通过门控控制检索信息对预测的影响,并根据验证表现设置安全回退------当检索修正没有带来收益时,可以关闭它,退回基础预测。这里的"安全"指基于验证结果设置的回退机制,不是对所有未来数据都不会退化的理论保证。
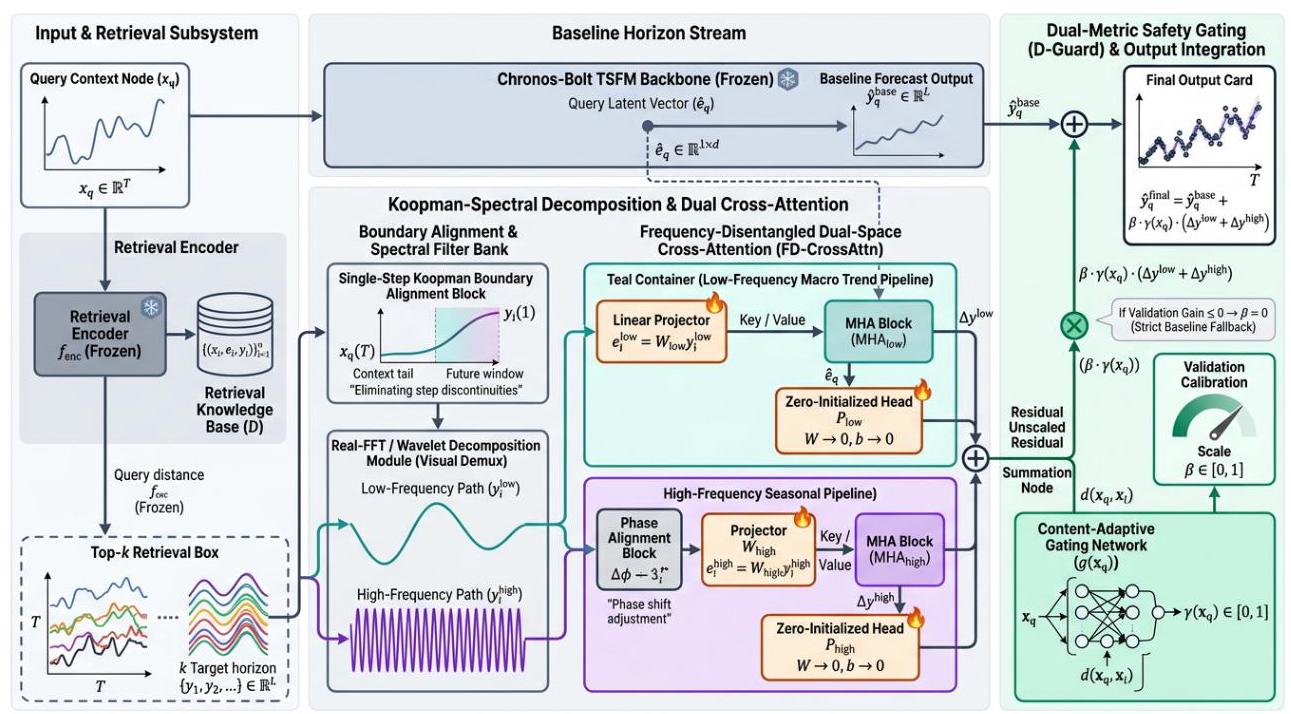
这套方法作用于冻结的时间序列基础模型输出侧,新增约 0.27M,也就是 27 万个可训练参数,不需要重新训练主干模型,但不代表新增模块完全不用训练;论文表 11 中,其平均 MSE 从 TS-RAG 的 0.1940 降至 0.1892,不过并非每个数据集、每项指标都胜出。这个案例展示的科研逻辑是:识别具体失效模式,设计针对性的机制,再通过实验检验,而不只是给现有代码换几组参数。
四、实验效果:有明确进展,也要看清评估边界
在 107 个来自顶会论文的研究问题上,ScientistTwo 成功改进了 86 个,成功率 80.4% ;按论文统计,成功案例的平均相对增益为 25.2% 、中位数为 7.7% ,二者的差距也提示收益并不均匀。
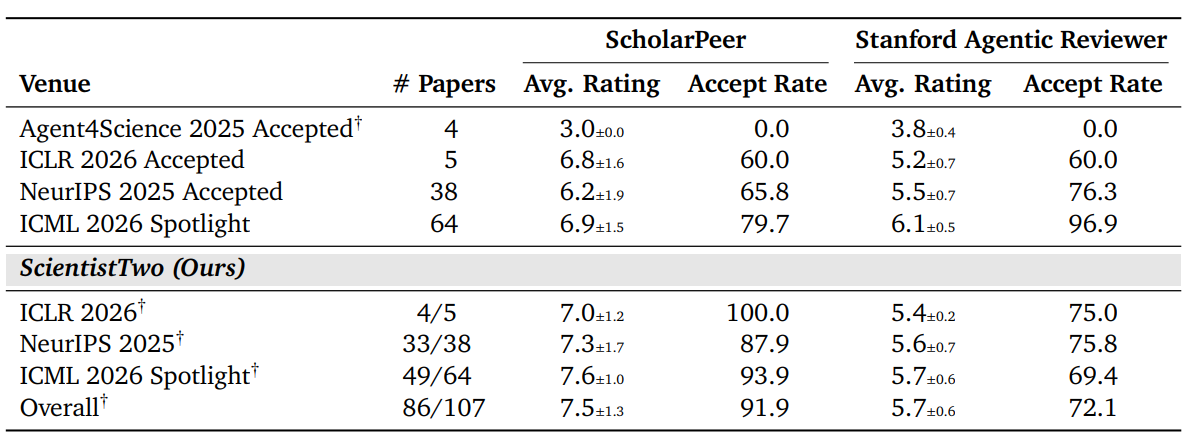
这 86 篇产出在 ScholarPeer 和 Stanford Agentic Reviewer 下的模拟接收率 分别为 91.9% 和 72.1%,另有 9 名专家对 33 篇产出进行评审,整体比较结果与人类论文相当,但这些评测都不等于真实顶会录用。
在 33 个 NeurIPS 来源任务的成本统计中,每项研究平均约需 2.5 天、3,765 美元,包含 token 与虚拟机费用,因此当前更适合看作高预算的自主科研探索,而不是低成本、无限批量的论文生产工具。
五、论文总结
ScientistTwo 的核心 insight 是:科研 AI 不应该只把想法写成论文,更应该让实验、消融和审稿反馈反过来改变想法。 它展示的是一种能够自主试错、补证据、改方法的研究闭环,而不是"只要生成足够多文字,就完成了科学发现"。