✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
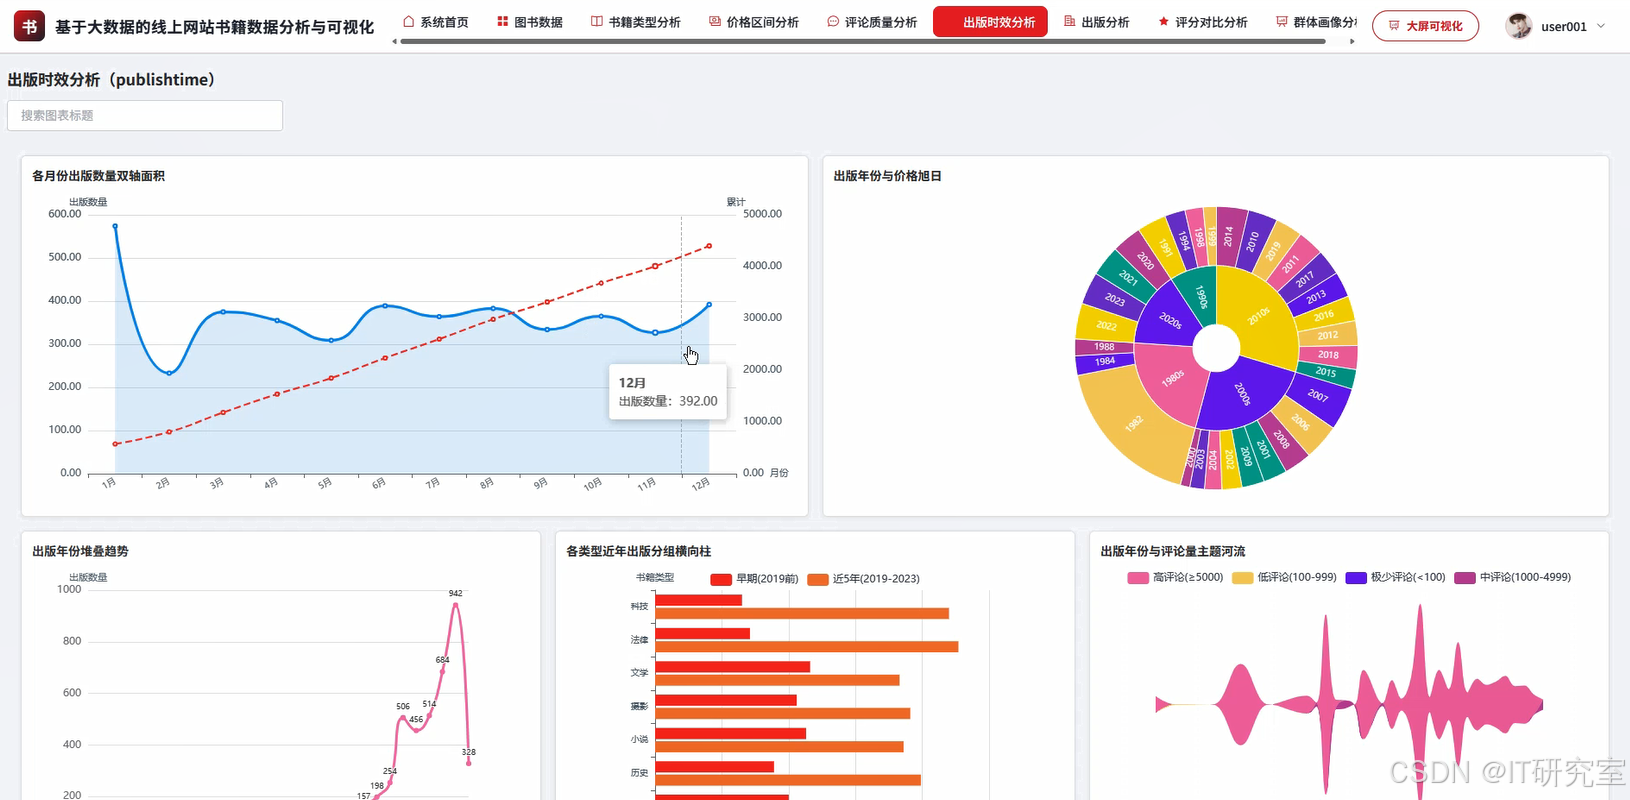
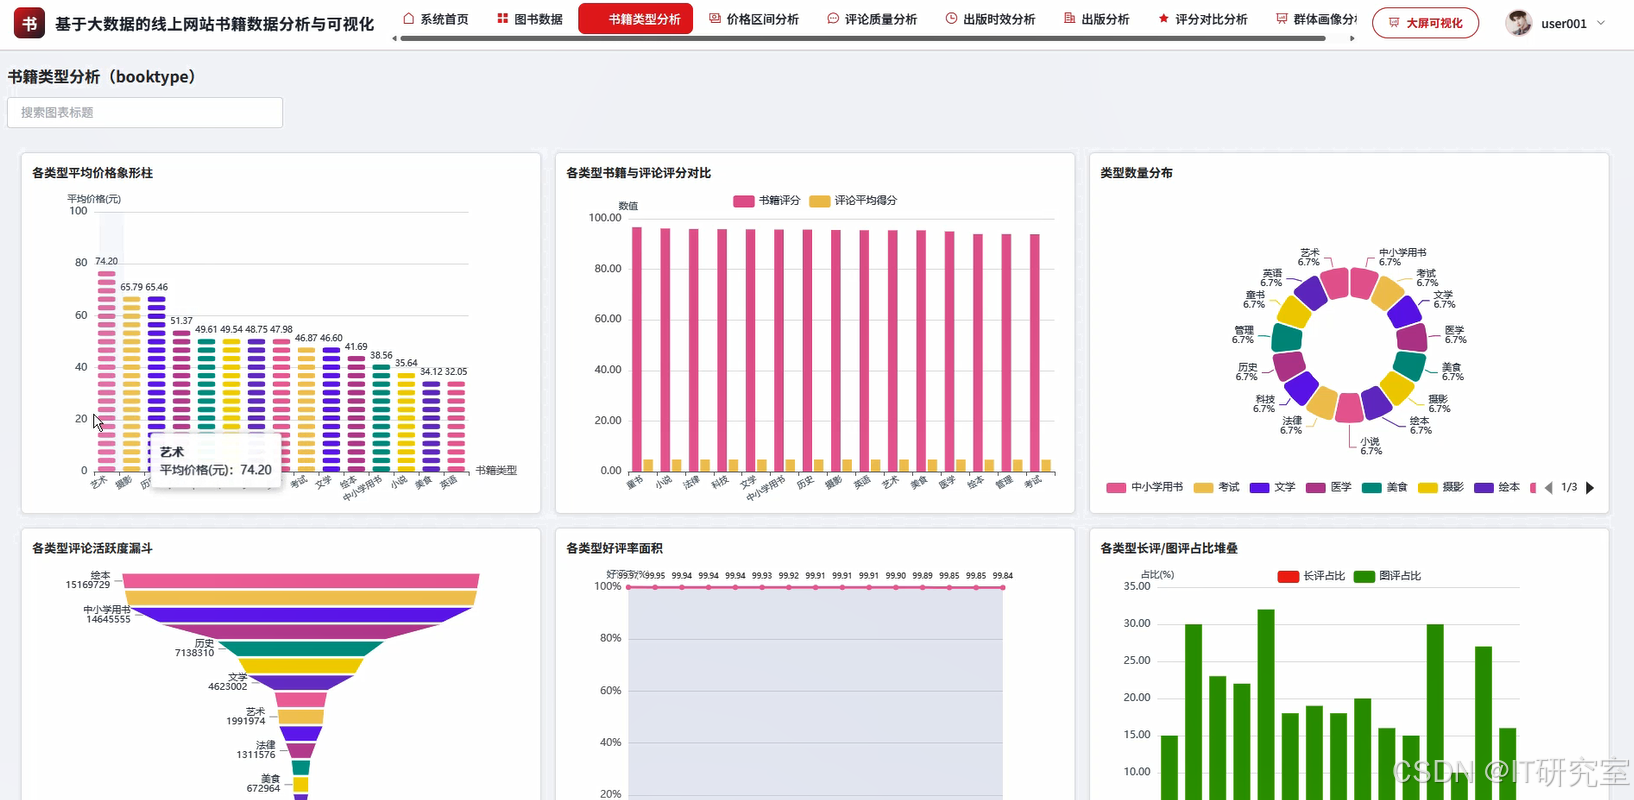
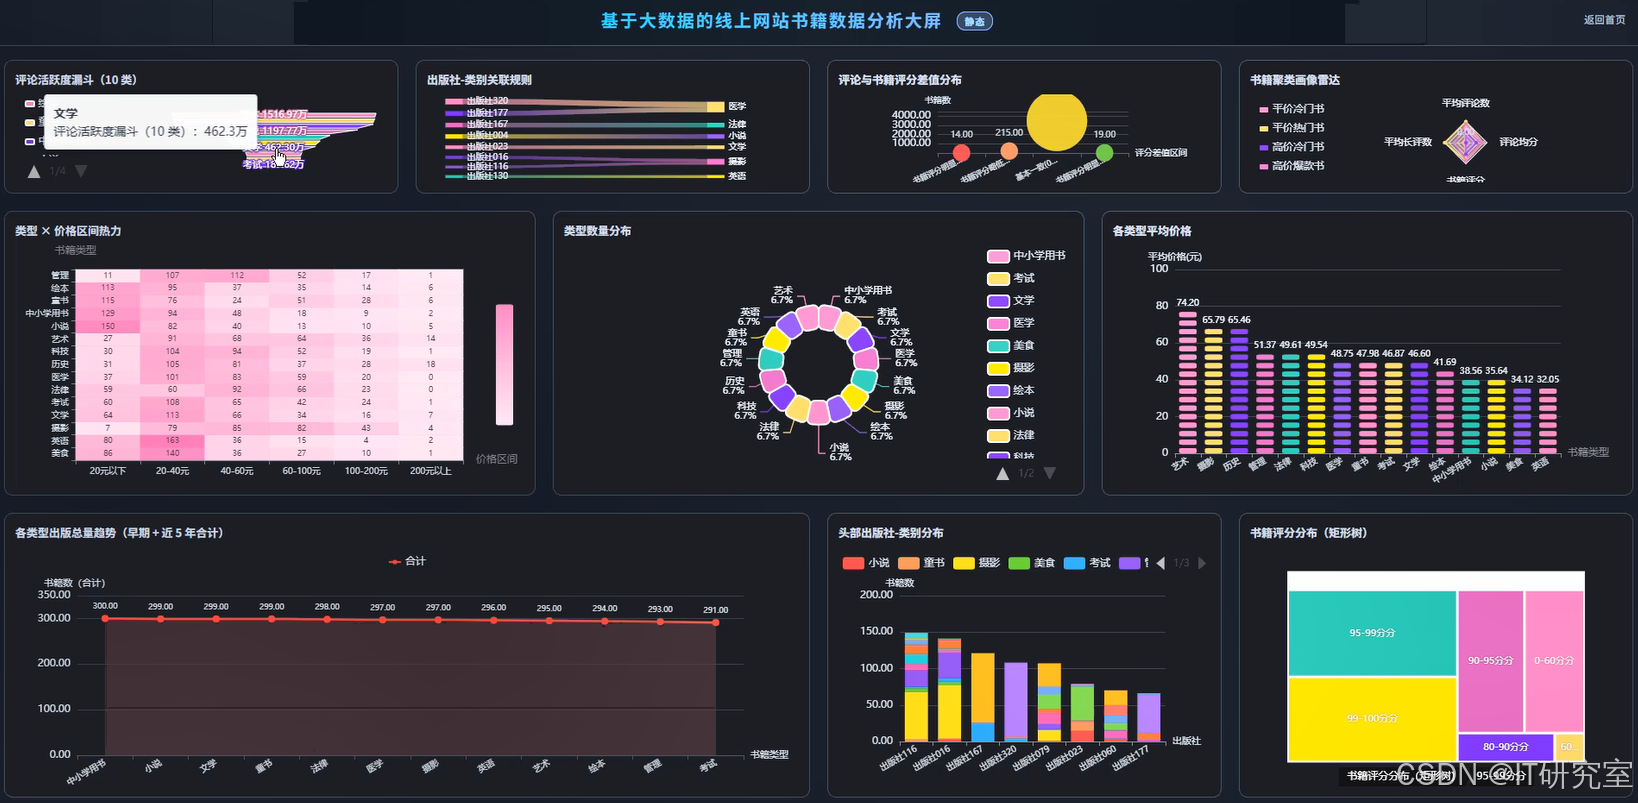
本系统名为《基于大数据的线上网站书籍数据分析与可视化》,是一个面向线上图书网站场景的数据分析类毕业设计系统。系统以Hadoop与Spark作为大数据处理核心,通过HDFS完成书籍原始数据的存储,借助Spark SQL与Pandas、NumPy完成数据清洗、统计与指标计算,后端采用Python+Django进行接口开发与业务调度,前端使用Vue配合ElementUI、Echarts以及HTML、CSS、JavaScript、jQuery完成可视化呈现,数据库使用MySQL保存分析结果与基础配置信息。系统围绕线上网站书籍数据设置了系统首页、图书数据、书籍类型分析、价格区间分析、评论质量分析、出版时效分析、出版分析、评分对比分析以及群体画像分析等功能模块。用户进入系统后可以查看图书整体数据概况,也可以按书籍类型、价格区间、评论质量、出版时效、出版信息、评分对比和群体画像等维度查看分析结果,并通过图表形式直观了解书籍数据在类型分布、价格结构、评论水平、出版节奏、评分差异和用户群体特征等方面的表现。系统希望把相对分散的书籍数据整理成可查看、可对比、可理解的分析结果,为书籍数据观察提供一个较为清晰的可视化入口。
选题背景
线上图书网站越来越多,书籍信息也随之变得庞杂,一本书往往同时包含类型、价格、评论、出版时间、出版社、评分以及购买或评价人群等多方面信息。这些数据单独看并不复杂,可一旦积累到一定数量,靠人工翻看或者简单表格统计就很难看出其中的规律。计算机专业毕业设计里,图书管理类系统并不少见,但多数停留在增删改查和基础展示层面,对数据本身的分析相对有限。Hadoop与Spark这类大数据技术正好适合处理这种数据量较大、维度较多的场景,通过HDFS存储原始数据,再借助Spark SQL完成统计与计算,可以把书籍数据中隐藏的类型分布、价格区间、评论质量、出版时效和评分差异等内容整理出来。基于这样的考虑,本课题选择以线上网站书籍数据为对象,结合Python+Django与Vue、Echarts等技术,构建一个基于大数据的书籍数据分析与可视化系统,让书籍数据不再只是静态记录,而是能够被观察和对比的分析对象。
选题意义
从实际作用来看,这个系统算不上复杂,更多是作为一次完整的毕业设计实践。它把Hadoop、Spark、Spark SQL、HDFS、Pandas、NumPy、Django、Vue、Echarts和MySQL等技术串在一起,让我在真实课题里走了一遍数据存储、数据处理、接口开发和可视化展示的流程,对大数据相关技术的理解不再停留在概念上。对线上图书网站来说,这类分析结果可以在一定程度上帮助观察书籍类型分布、价格结构、评论质量和出版节奏,为书籍展示和内容整理提供一点参考。对计算机专业学生而言,这个课题也提供了一个可以继续扩展的思路,后续如果想加入更多分析维度或者调整数据处理方式,都可以在现有框架上继续做。整体来说,它的意义更多体现在学习与实践层面,是一个相对踏实、可以落地的毕业设计题目。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
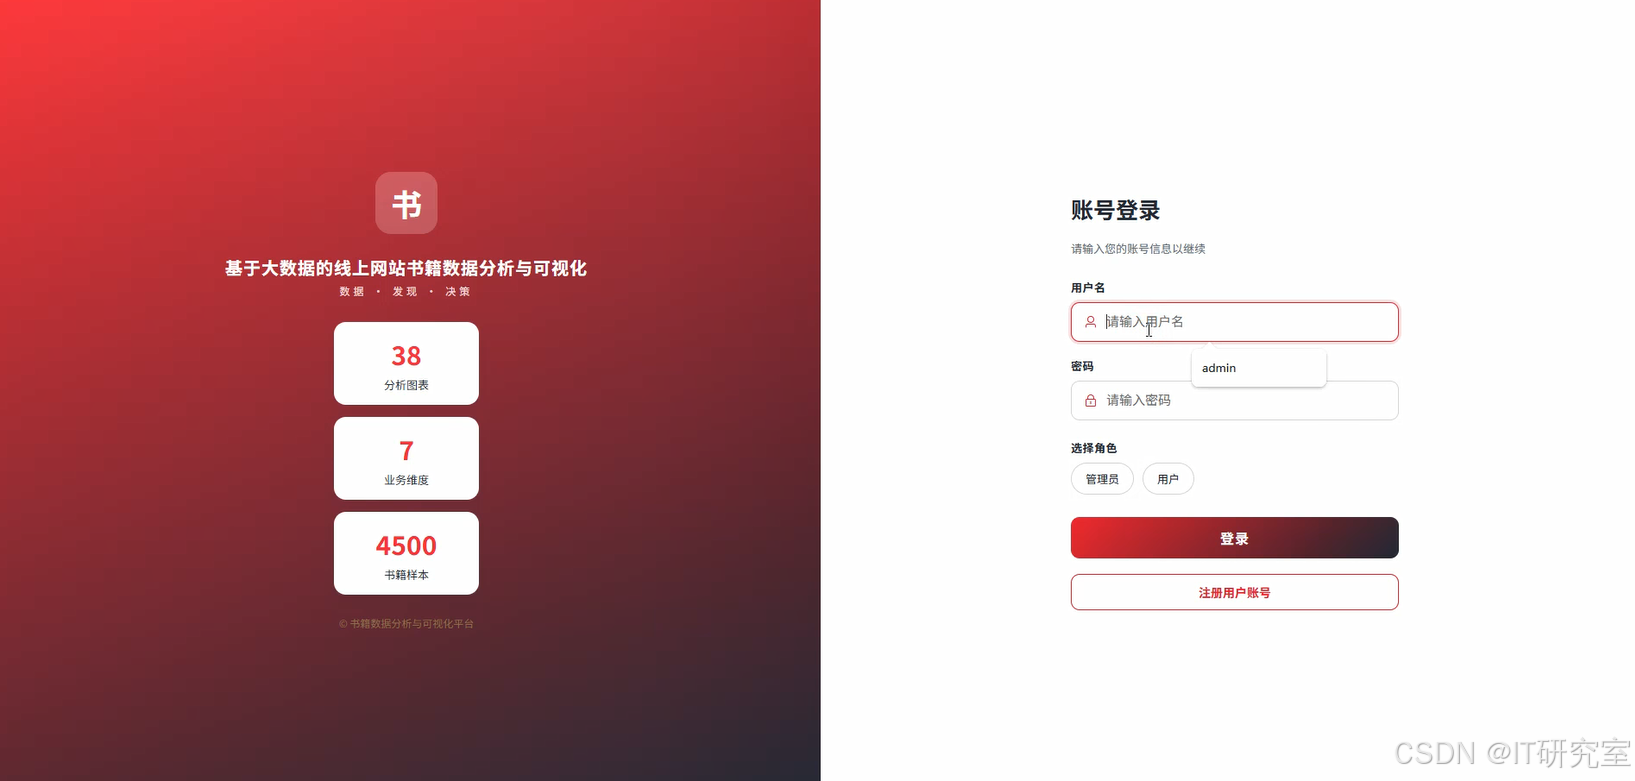
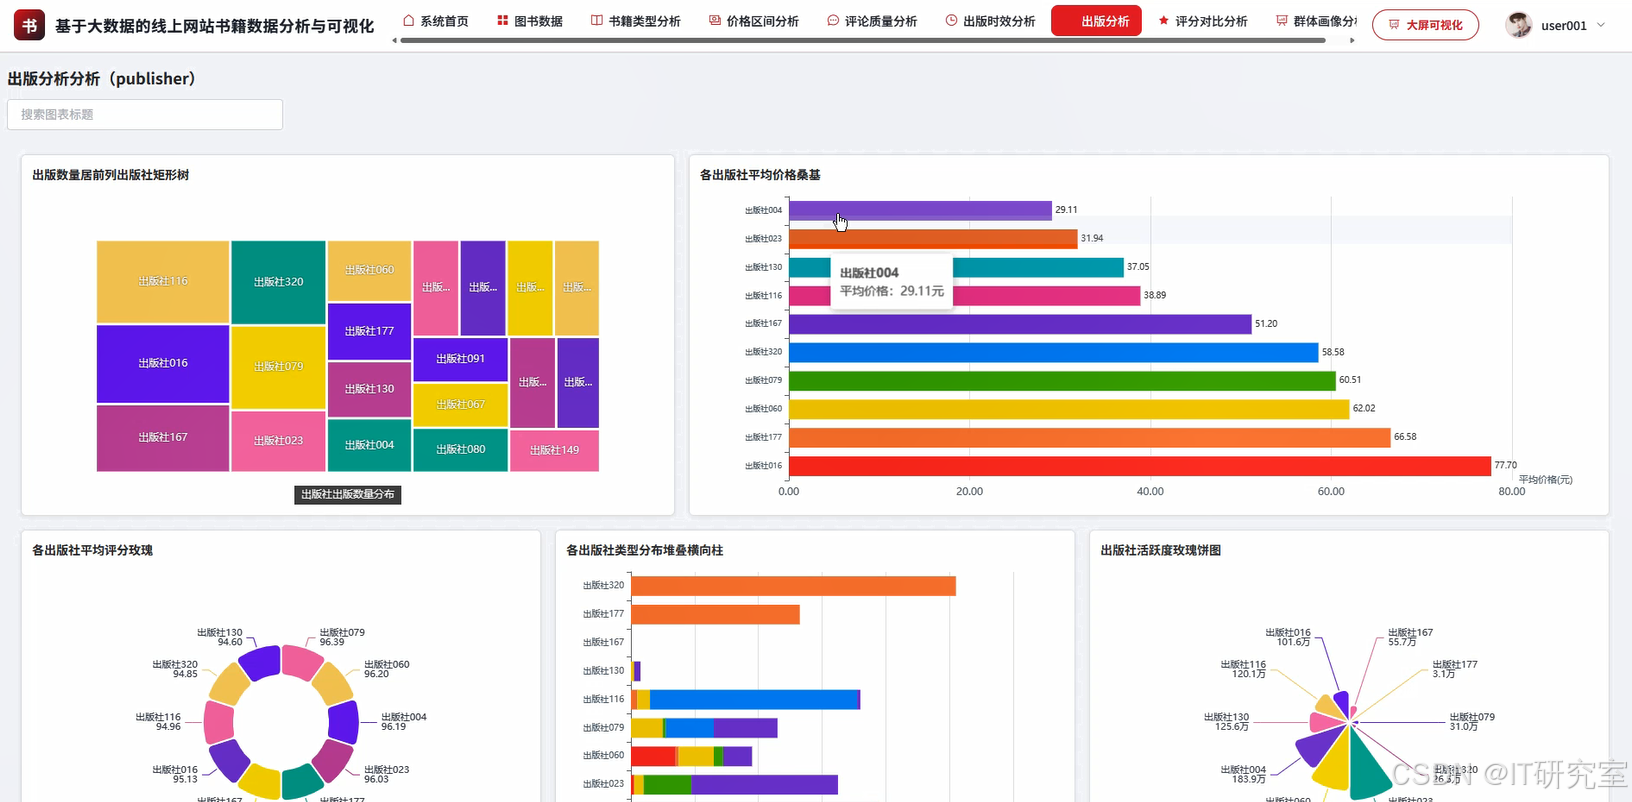
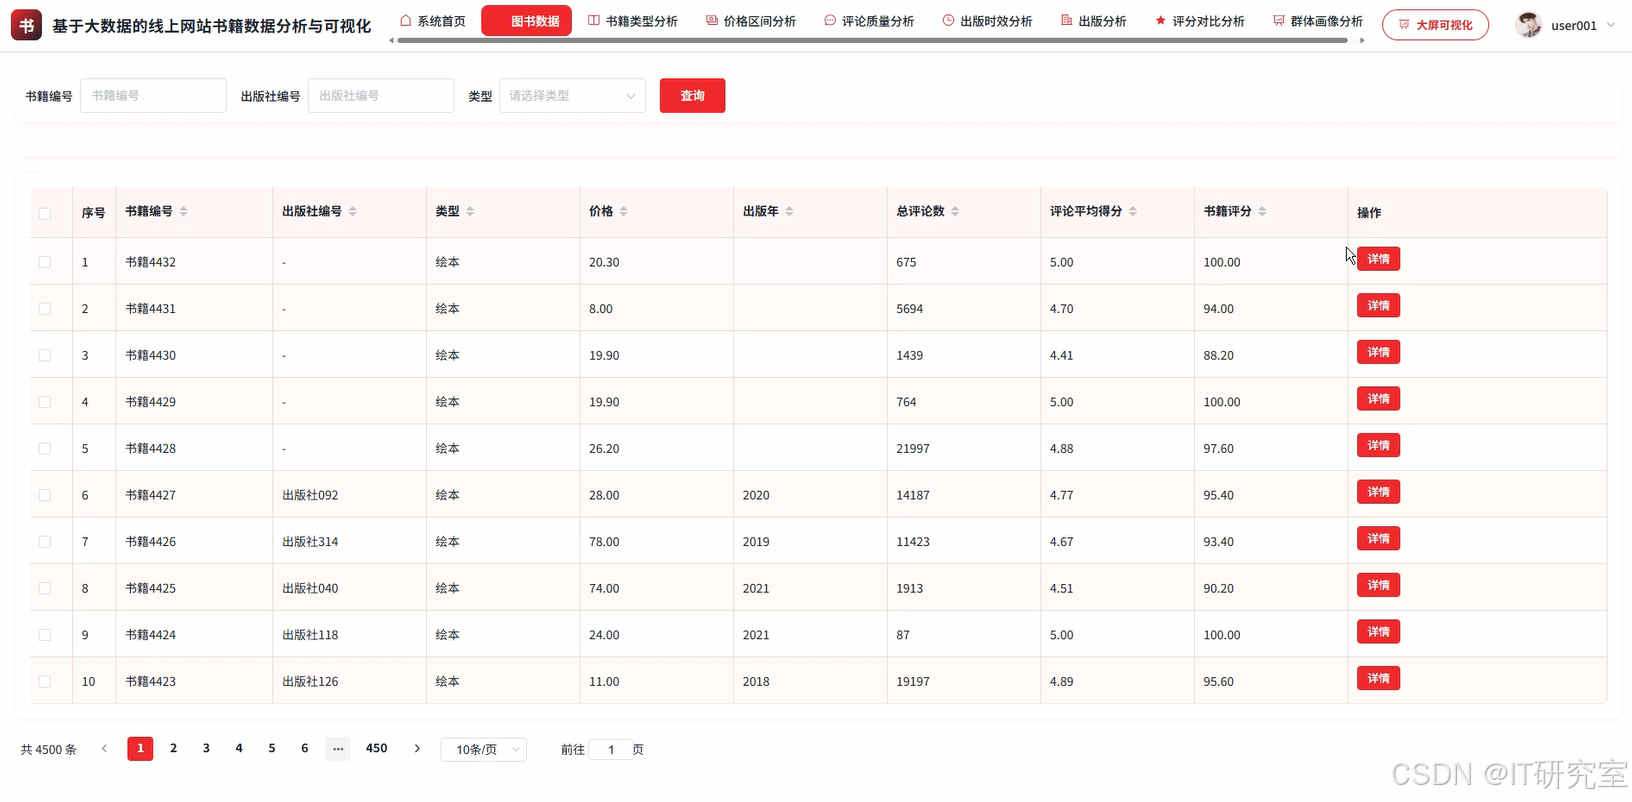
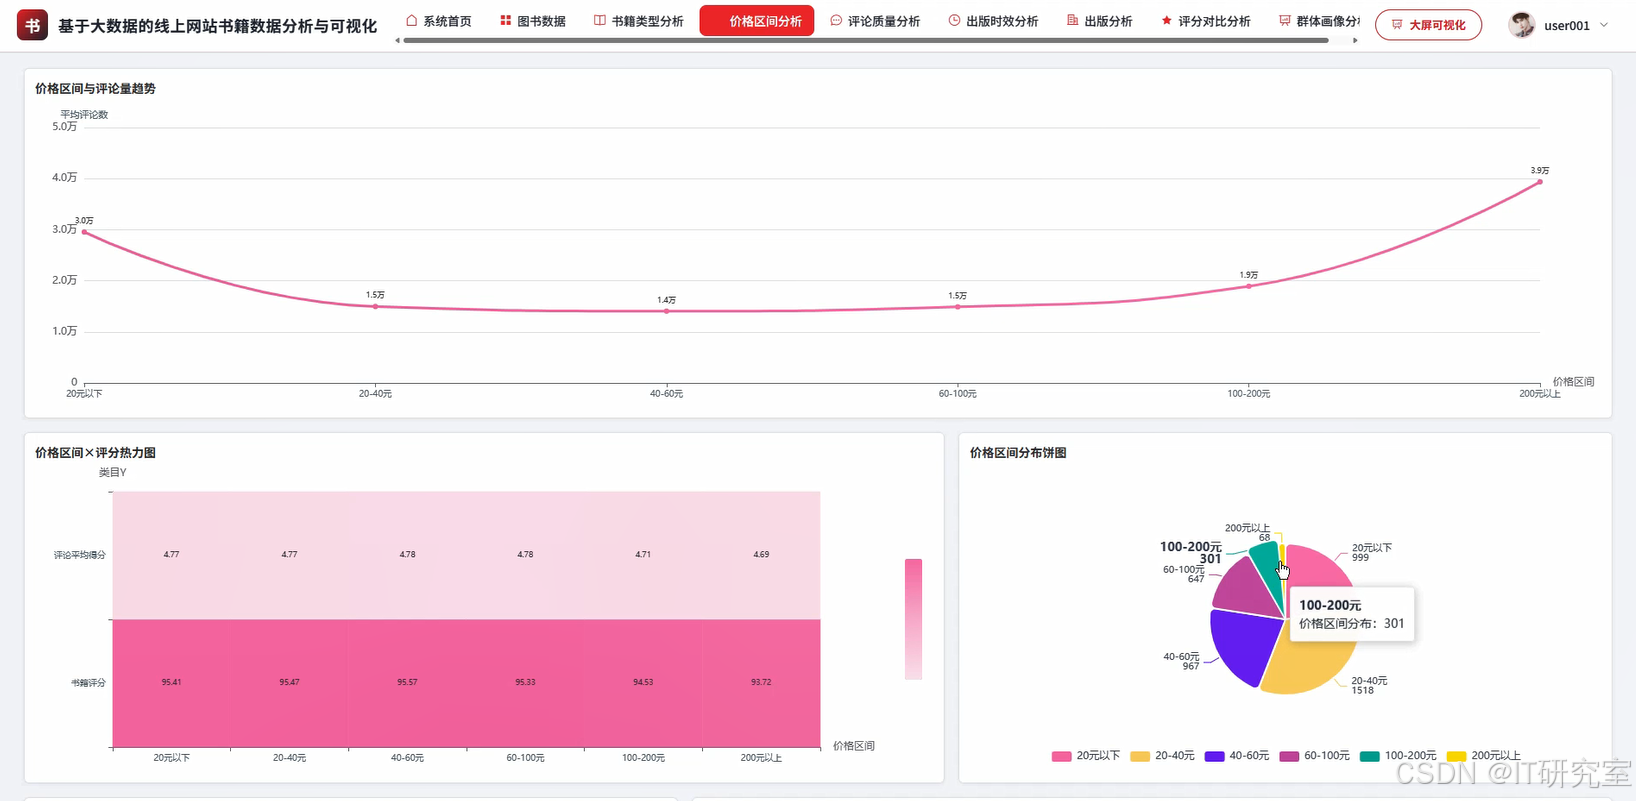
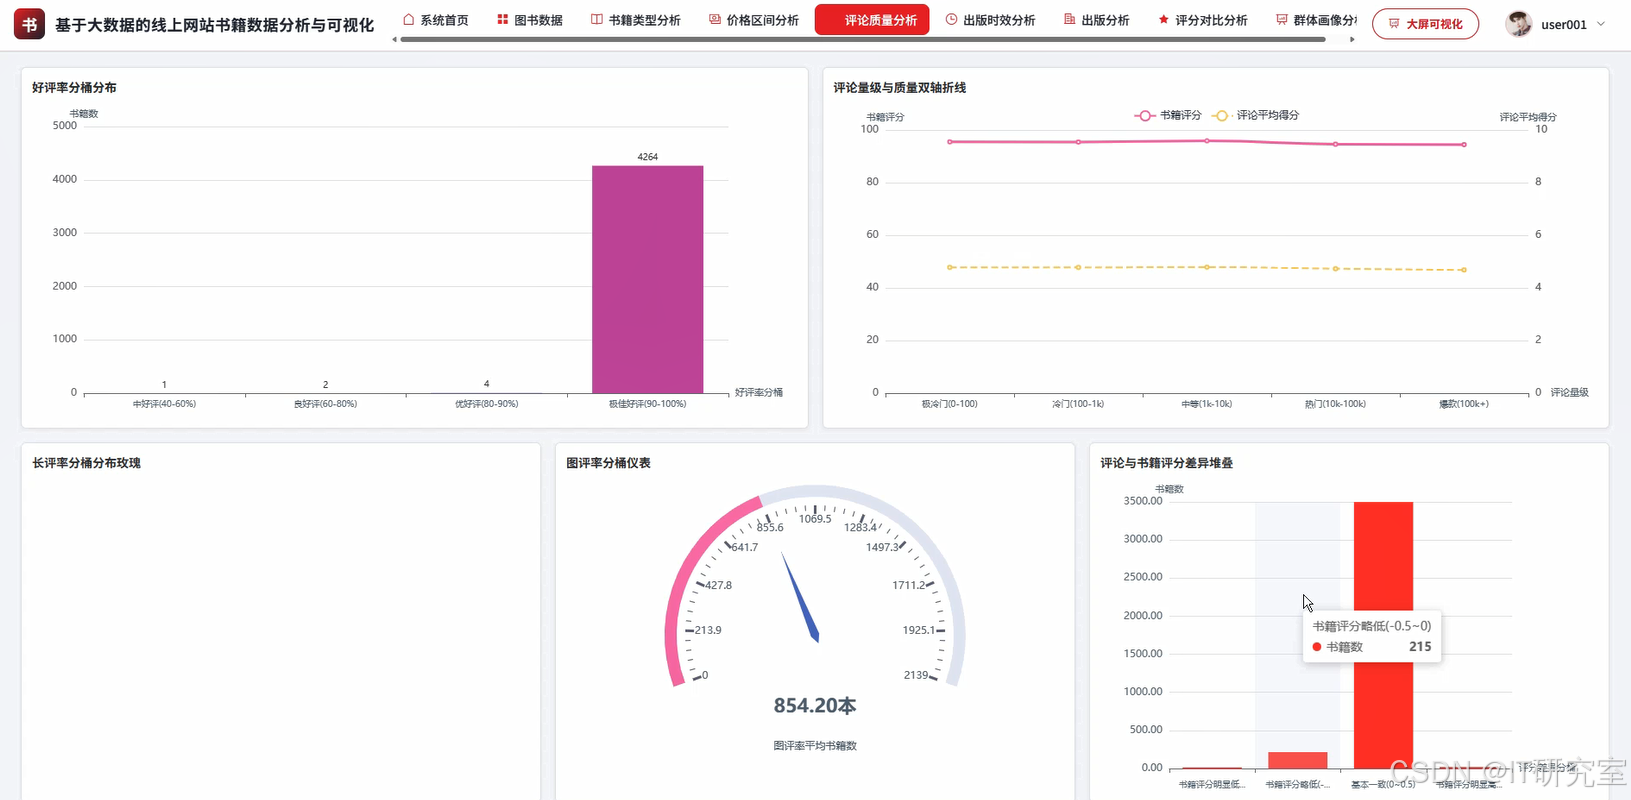
- 基于大数据的线上网站书籍数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, when, desc
from django.http import JsonResponse
from django.views.decorators.http import require_GET
from book.models import BookTypeResult, PriceRangeResult, CommentQualityResult
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("BookDataAnalysis").master("local[*]").config("spark.sql.warehouse.dir", "/user/hive/warehouse").enableHiveSupport().getOrCreate()

@require_GET
def book_type_analysis(request):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/book/data/book_info.csv")
    df_type = df.groupBy("book_type").agg(count("book_id").alias("type_count"), avg("book_price").alias("avg_price"), avg("book_score").alias("avg_score"))
    df_type = df_type.withColumn("type_ratio", col("type_count") / df_type.agg({"type_count": "sum"}).collect()[0][0])
    df_type = df_type.orderBy(desc("type_count"))
    pdf = df_type.toPandas()
    pdf["avg_price"] = pdf["avg_price"].round(2)
    pdf["avg_score"] = pdf["avg_score"].round(2)
    pdf["type_ratio"] = pdf["type_ratio"].round(4)
    BookTypeResult.objects.all().delete()
    for row in pdf.itertuples():
        BookTypeResult.objects.create(book_type=row.book_type, type_count=int(row.type_count), avg_price=float(row.avg_price), avg_score=float(row.avg_score), type_ratio=float(row.type_ratio))
    result = pdf.to_dict(orient="records")
    return JsonResponse({"code": 200, "msg": "书籍类型分析完成", "data": result})

@require_GET
def price_range_analysis(request):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/book/data/book_info.csv")
    df_price = df.withColumn("price_range", when(col("book_price") < 20, "20元以下").when((col("book_price") >= 20) & (col("book_price") < 40), "20-40元").when((col("book_price") >= 40) & (col("book_price") < 60), "40-60元").when((col("book_price") >= 60) & (col("book_price") < 80), "60-80元").otherwise("80元以上"))
    df_price = df_price.groupBy("price_range").agg(count("book_id").alias("book_count"), avg("book_score").alias("avg_score"), avg("comment_count").alias("avg_comment"))
    df_price = df_price.orderBy("price_range")
    pdf = df_price.toPandas()
    pdf["avg_score"] = pdf["avg_score"].round(2)
    pdf["avg_comment"] = pdf["avg_comment"].round(2)
    pdf["book_ratio"] = (pdf["book_count"] / pdf["book_count"].sum()).round(4)
    PriceRangeResult.objects.all().delete()
    for row in pdf.itertuples():
        PriceRangeResult.objects.create(price_range=row.price_range, book_count=int(row.book_count), avg_score=float(row.avg_score), avg_comment=float(row.avg_comment), book_ratio=float(row.book_ratio))
    result = pdf.to_dict(orient="records")
    return JsonResponse({"code": 200, "msg": "价格区间分析完成", "data": result})

@require_GET
def comment_quality_analysis(request):
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/book/data/book_comment.csv")
    df_comment = df.withColumn("quality_level", when(col("comment_length") < 10, "短评").when((col("comment_length") >= 10) & (col("comment_length") < 50), "中评").otherwise("长评"))
    df_comment = df_comment.withColumn("has_content", when(col("comment_content").isNotNull() & (col("comment_content") != ""), 1).otherwise(0))
    df_comment = df_comment.groupBy("quality_level").agg(count("comment_id").alias("comment_count"), avg("comment_length").alias("avg_length"), avg("has_content").alias("content_rate"), avg("comment_like").alias("avg_like"))
    df_comment = df_comment.orderBy(desc("comment_count"))
    pdf = df_comment.toPandas()
    pdf["avg_length"] = pdf["avg_length"].round(2)
    pdf["content_rate"] = pdf["content_rate"].round(4)
    pdf["avg_like"] = pdf["avg_like"].round(2)
    pdf["comment_ratio"] = (pdf["comment_count"] / pdf["comment_count"].sum()).round(4)
    CommentQualityResult.objects.all().delete()
    for row in pdf.itertuples():
        CommentQualityResult.objects.create(quality_level=row.quality_level, comment_count=int(row.comment_count), avg_length=float(row.avg_length), content_rate=float(row.content_rate), avg_like=float(row.avg_like), comment_ratio=float(row.comment_ratio))
    result = pdf.to_dict(orient="records")
    return JsonResponse({"code": 200, "msg": "评论质量分析完成", "data": result})
五、系统视频
基于大数据的线上网站书籍数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的线上网站书籍数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇