1 前提概要
使用requests爬虫时经常碰到cloudflare防护的网站,即使从浏览器中复制包含cookie在内的所有请求参数扔到requests的headers中,返回的仍然是"Just a moment..."对你发出无情的嘲讽,这是因为CF还要验证浏览器指纹,这不是简单地加个UA参数就能解决的。

2 思路
既然CF必须真实地浏览器才能验证通过,那我们就用真实的浏览器去爬取就行了。与正常访问网站不同的是,我们不需要浏览器渲染网页,不需要访问dom中的资源文件,只需要借助浏览器的网络访问能力,可以把浏览器当成我们爬虫的代理网关。
控制浏览器访问指定网页需要用到浏览器的CDP(Chrome DevTools Protocol)功能,可以通过指定端口,控制浏览器的行为。python中可以通过playwright去操控浏览器。
正常通过playwright操控时,经常用到的是
python
resp = page.goto('https://www.baidu.com')
print(resp.text()) # 原始html
print(page.content()) # 选然后的html
上述方式相当于在浏览器地址栏内输入了指定网址然后回车,在代码执行期间,我们能看到浏览器加载网页的情况。浏览器加载网页耗费了大量的性能与时间,但我们不需要渲染网页,不导航 Page、不执行网页、不加载图片/CSS/JS,而是让已经连接的 Chrome 通过 CDP 网络层直接 GET URL,再从 IO.read 读取响应体。CDP 本身提供了 Network.loadNetworkResource,并支持 includeCredentials;Playwright 也支持通过 new_cdp_session() 直接发送原始 CDP 命令。
相当于劫持了浏览器的网络层。
参考:CDP Network
3 部署CDP
不建议使用真实浏览器去开启CDP。我的做法是启用Windows沙盒,使用沙盒内的浏览器启用CDP。或者可以使用虚拟机也行。Windows沙盒其实就是Windows自带的能够快速部署的虚拟机。
3.1 启用Windows沙盒
使用真实浏览器或了解Windows沙盒的可以跳过这一节。
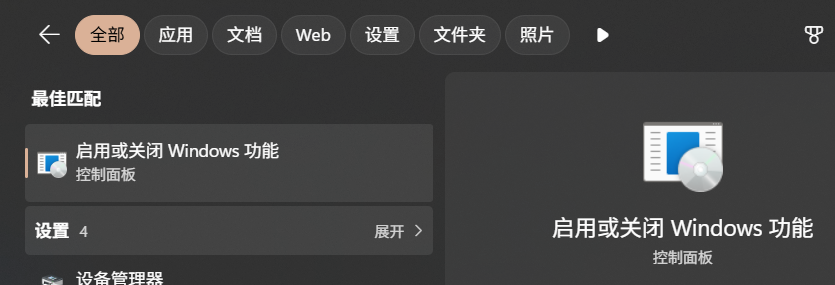
在Windows搜索栏内搜索"启用或关闭Windows功能"
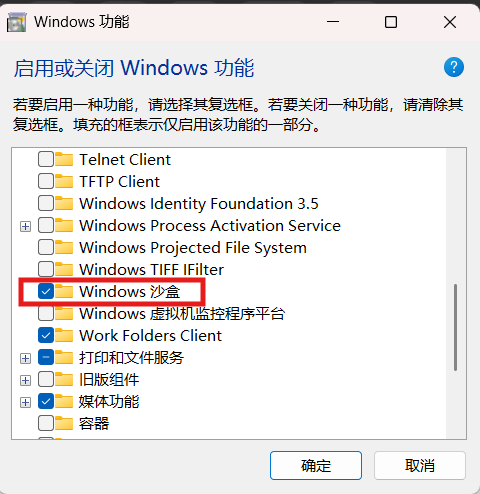
勾选Windows沙盒
确认后等待重启,重启后能够搜到windows sandbox的程序,直接使用就行。
3.2 启用CDP
在沙盒内的edge浏览器所在目录执行以下命令:
bash
.\msedge.exe --remote-debugging-port=9222 --user-data-dir="C:\Users\WDAGUtilityAccount\Documents\edgedata"这两个参数是必须的,端口与数据目录都能自己指定。
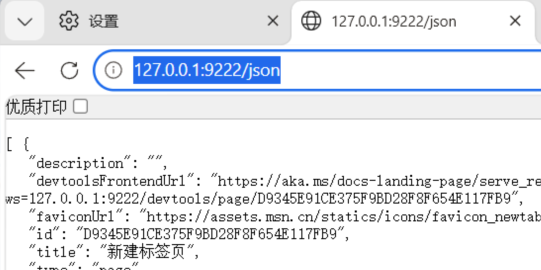
测试一下CDP是否正常,在浏览器内输入以下url:
bash
http://127.0.0.1:9222/json有内容输出就说明CDP正常启用
3.3 端口转发
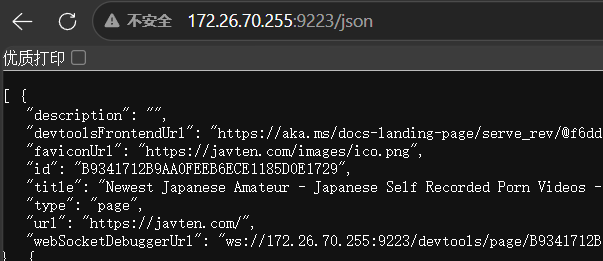
CDP仅绑定在127.0.0.1这个IP上,外部无法访问。比如物理机启用的CDP,能在本机通过127.0.0.1访问CDP,但是无法通过物理机的IP(比如192.168.1.2)访问。
需要利用另外一个端口(例如9223),将这个端口的流量转发到9222上。
bash
netsh interface portproxy add v4tov4 listenaddress=0.0.0.0 listenport=9223 connectaddress=127.0.0.1 connectport=9222此时仍然无法远程访问CDP,因为中间还拦着一道Windows防火墙。需要添加防火墙规则,放行9223端口的流量。
bash
netsh advfirewall firewall add rule name="CDP 9223" dir=in action=allow protocol=TCP localport=9223此时,可以在宿主机上访问沙盒内的CDP。
参考:端口转发
4 代码
平时爬虫时经常使用到多线程加速,CDP中我们可以启用多个异步IO的任务达到同样加速的效果,架构如下
bash
一个 Python 进程
    │
    ├── 一个 async_playwright
    │
    ├── 一个 CDP Chrome connection
    │
    ├── 一个 CDP Session
    │
    └── 8 个 asyncio Task
            ├── Task 0 → Network.loadNetworkResource
            ├── Task 1 → Network.loadNetworkResource
            ├── Task 2 → Network.loadNetworkResource
            ...
            └── Task 7 → Network.loadNetworkResource

async_playwright
      ↓
async CDP session
      ↓
asyncio Task 0 ─┐
asyncio Task 1 ─┤
asyncio Task 2 ─┤
...             ├── await cdp.send()
asyncio Task 7 ─┘
python
import asyncio
import base64
import os

from playwright.async_api import async_playwright

CDP_URL = "http://172.26.70.255:9223"
INPUT_FILE = "detail_page_urls.txt"
OUTPUT_DIR = r"Y:\detail_pages"
WORKER_COUNT = 8
MIN_SIZE = 10 * 1024


# 读取任务
def load_tasks():
    tasks = []
    with open(INPUT_FILE, "r", encoding="utf-8") as f:
        for line_no, line in enumerate(f, 1):
            line = line.strip()
            if not line:
                continue
            parts = line.split(None, 1)
            if len(parts) != 2:
                print(f"[跳过] 第 {line_no} 行格式错误:{line}")
                continue
            file_name, url = parts
            tasks.append((file_name, url))
    return tasks


# 均匀分成 count 份
def split_tasks(tasks, count):
    result = []
    total = len(tasks)
    base = total // count
    remainder = total % count
    start = 0
    for i in range(count):
        size = base
        if i < remainder:
            size += 1
        end = start + size
        result.append(tasks[start:end])
        start = end
    return result


# 读取 CDP Stream
async def read_stream(cdp, handle):
    chunks = []
    try:
        while True:
            result = await cdp.send(
                "IO.read",
                {
                    "handle": handle,
                    "size": 1024 * 1024,
                }
            )

            data = result.get("data", "")
            if data:
                if result.get("base64Encoded", False):
                    chunks.append(base64.b64decode(data))
                else:
                    chunks.append(data.encode("utf-8"))
            if result.get("eof", False):
                break
    finally:
        try:
            await cdp.send(
                "IO.close",
                {
                    "handle": handle
                }
            )

        except Exception:
            pass
    return b"".join(chunks)


# 通过 CDP Network 下载一个 URL
async def download_one(cdp, frame_id, file_name, url, worker_id):
    html_file = os.path.join(OUTPUT_DIR, file_name)

    # 已经存在
    if os.path.exists(html_file):
        print(f"[Worker {worker_id}] {file_name} 已存在,跳过")
        return "exists"
    try:
        # ----------------------------------------------------
        # 核心:
        #
        # 不 page.goto()
        # 不 view-source:
        #
        # 直接使用 Chrome Network 层请求
        # ----------------------------------------------------
        result = await cdp.send(
            "Network.loadNetworkResource",
            {
                "frameId": frame_id,
                "url": url,
                "options": {
                    "disableCache": False,
                    # 使用浏览器 credentials
                    "includeCredentials": True,
                },
            }
        )

        resource = result.get(
            "resource",
            {}
        )

        # 网络请求失败
        if not resource.get("success", False):
            error_name = resource.get("netErrorName", "")
            error_code = resource.get("netError", "")

            print(
                f"[Worker {worker_id}] "
                f"{file_name} 下载异常:"
                f"Network error "
                f"{error_name} "
                f"({error_code})"
            )
            return "stop"
        status_code = int(resource.get("httpStatusCode", 0))

        # 获取 stream
        stream = resource.get("stream")

        if not stream:
            print(
                f"[Worker {worker_id}] "
                f"{file_name} 下载异常:"
                f"Chrome 没有返回 stream"
            )
            return "error"

        # 读取 response body
        body = await read_stream(cdp, stream)
        size = len(body)

        # 异常文件处理
        # 小于 10KB
        if size < MIN_SIZE:
            html = body.decode("utf-8", errors="ignore")

            # -----------------------------------------------
            # Server Error:
            # 虽然小于 10KB,但是保存
            # -----------------------------------------------
            if "OK" in html:
                with open(html_file, "wb") as f:
                    f.write(body)
                print(
                    f"[Worker {worker_id}] "
                    f"{file_name} size Error,"
                    f"按规则保存,"
                    f"{size / 1024:.2f} KB"
                )
                return "ok"

            # -----------------------------------------------
            # 其他小文件:
            # 不保存,停止当前 worker
            # -----------------------------------------------
            print(
                f"[Worker {worker_id}] "
                f"{file_name} 下载异常:"
                f"{size / 1024:.2f} KB,"
                f"不是 Server Error,"
                f"停止当前 Worker"
            )
            return "stop"

        # 正常保存
        with open(html_file, "wb") as f:
            f.write(body)

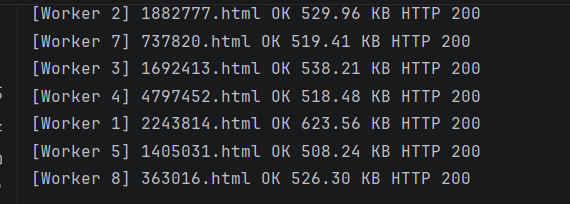
        print(
            f"[Worker {worker_id}] "
            f"{file_name} OK "
            f"{size / 1024:.2f} KB "
            f"HTTP {status_code}"
        )
        return "success"


    except Exception as e:
        print(
            f"[Worker {worker_id}] "
            f"{file_name} 下载异常:"
            f"{repr(e)}"
        )
        return "error"


# Worker
async def worker(worker_id, tasks, cdp, frame_id):
    print(f"[Worker {worker_id}] 开始,任务数:{len(tasks)}")
    for file_name, url in tasks:
        result = await download_one(cdp, frame_id, file_name, url, worker_id)

        # ----------------------------------------------------
        # 遇到小于 10KB 且无OK
        # 停止当前 Worker
        # ----------------------------------------------------
        if result == "stop":
            break
    print(f"[Worker {worker_id}] 结束")


# 主程序
async def main():
    os.makedirs(OUTPUT_DIR, exist_ok=True)

    # 读取全部任务
    tasks = load_tasks()
    print(f"总任务数:{len(tasks)}")

    # 分成 WORKER_COUNT 份
    batches = split_tasks(tasks, WORKER_COUNT)
    for i, batch in enumerate(batches):
        print(f"Worker {i}: {len(batch)} 个任务")

    # 连接已有 Chrome
    async with async_playwright() as p:
        print(f"连接 CDP:{CDP_URL}")
        browser = await p.chromium.connect_over_cdp(CDP_URL, timeout=30_000)
        print("Chrome connected:", browser.is_connected())

        # 获取现有 BrowserContext
        if not browser.contexts:
            raise RuntimeError("CDP Chrome 没有 BrowserContext")
        context = browser.contexts[0]

        # 获取当前 Page
        pages = context.pages
        if not pages:
            raise RuntimeError("CDP Chrome 当前没有 Page")
        page = pages[0]
        print("当前 Page:", page.url)

        # ----------------------------------------------------
        # 建立 CDP Session
        #
        # 注意:
        # 这里整个程序只创建一个 session
        # 所有 asyncio worker 共用
        #
        # 不存在 Python Thread
        # 所以不会出现 greenlet 跨线程
        # ----------------------------------------------------
        cdp = await context.new_cdp_session(page)

        # 获取当前 frame ID
        frame_tree = await cdp.send("Page.getFrameTree")
        frame_id = (frame_tree["frameTree"]["frame"]["id"])

        print("Frame ID:", frame_id)

        # 创建 WORKER_COUNT 个 asyncio Worker
        workers = []
        for worker_id in range(WORKER_COUNT):
            task = asyncio.create_task(
                worker(worker_id, batches[worker_id], cdp, frame_id)
            )
            workers.append(task)

        # 等待 所有 Worker
        await asyncio.gather(*workers)
        print("\n全部 Worker 执行完成")

        # 只断开 CDP Session,不关闭 Chrome
        try:
            await cdp.detach()
        except Exception:
            pass


# Windows
if __name__ == "__main__":
    asyncio.run(main())
代码解释:
我将所有的爬虫任务收集到一个文件中,即代码中的INPUT_FILE变量,这个文件有多行,每行2列,用空格隔开,第一列是爬取后的结果保存到的文件名,文件保存到OUTPUT_DIR目录下,第二列是url。
代码中我定义了8个worker,每个worker负责INPUT_FILE中任务的1/8,当网络请求失败时,停止当前worker,其他worker不受影响。当所有worker异常停止或任务完成后,整个python进程结束。
代码中我还定义了一些异常处理,比如下载的文件小于10KB,需要检查其内容后再判断是否需要保存为文件。
5 执行爬虫
使用上述方法并不能完全避免CF的防护,因为浏览器指纹、cookie会过期,无人干预的情况下,某个时间点之后,所有的任务都会失败。
使用之前需要我们打开目标网站,手动过一遍CF的验证,注意这个标签页不能关闭。
6 扩展骚操作
在浏览器指纹、cookie过期后,爬虫脚本就空转或结束了,在CF拦截导致任务停止后,手动刷新目标网页能让爬虫重新工作,但我不可能盯着爬虫。通过CDP去刷新网页是过不了CF验证的。
我想到了自动化操作。
思路其实很简单,写一个脚本,操纵键鼠,让他能够刷新网页。再另起一个脚本,调用执行爬虫脚本与自动化脚本,在这两个任务中循环。
自动化脚本示例:
python
from time import sleep
import pyautogui

if __name__ == "__main__":
    # 点击任务栏
    pyautogui.moveTo(1400, 1060, duration=0.5)
    pyautogui.click()
    # 点击沙盒
    pyautogui.moveTo(975, 1051, duration=0.5)
    pyautogui.click()
    # 新建标签页
    pyautogui.moveTo(1011, 165, duration=0.5)
    pyautogui.click()
    # 输入目标网址
    pyautogui.write("https://target.com")
    pyautogui.press("enter")
    sleep(10)
    # 鼠标滑动,模拟真人
    pyautogui.moveTo(1000, 440, duration=0.5)
    sleep(10)
    # 关闭标签页
    pyautogui.hotkey("ctrl", "w")
循环脚本示例
python
import subprocess
import time

while True:
    print("开始执行 爬虫")
    subprocess.run(["python", "tasks.py"], check=True)

    print("爬虫 执行完成,开始执行 自动化")
    subprocess.run(["python", "refresh.py"], check=True)

    print("自动化 执行完成,重新执行 爬虫")