文章目录
-
- [一、实验设计:20 次真实调用,每一条都记账](#一、实验设计:20 次真实调用,每一条都记账)
- [二、四种「没拿到数据」,状态码一律 200](#二、四种「没拿到数据」,状态码一律 200)
- 三、三档判据,检出能力差一个数量级
- [四、trace 的真正价值:能说出「哪个参数错了」](#四、trace 的真正价值:能说出「哪个参数错了」)
- [五、成本:每条 331 字节,占响应体的 0.12%](#五、成本:每条 331 字节,占响应体的 0.12%)
- 六、两个实现层的坑
- 七、结论
- 八、边界与声明
- 参考链接
给 Claude 接工具,最烦的不是报错,是「没拿到数据」------返回是空的,任务卡住,你却说不清是接口坏了、参数写错了,还是真的没数据。
我把 8 个香港官方数据接口跑了一遍真实调用:20 次请求里 8 次「没拿到数据」,其中 7 次的 HTTP 状态码都是 200 。更坑的是,有一次返回的是合法 JSON、信封里还写着 success------但它是失败的。这篇文章用真实数据把「空」拆开,量化三档判据各能抓到多少,最后给出一条每条只要 331 字节的记账格式。
一、实验设计:20 次真实调用,每一条都记账
我对 8 个香港开放数据接口(天文台 4 个口径、金管局、统计处、运输署、入境处、环保署、1823)发起 20 次真实请求:12 次正常取数,8 次故意带上各种问题------参数拼错、参数不存在、分页越界、表号不存在。这些错误参数全部来自接口规范的真实边界 (不存在的 dataType、越界的 offset、不存在的表号),不是凭空编的。
每次调用记一条 trace,字段只有七个:
python
def run_case(tag: str, tool: str, url: str, expect: str) -> dict:
    t0 = time.time()
    r = subprocess.run(["curl", "-sL", "-m", "60", "-w", "\n%{http_code}", url],
                       capture_output=True)
    out = r.stdout.decode("utf-8", "replace")
    body, _, code = out.rpartition("\n")
    raw = body.encode("utf-8")
    shape = shape_of(raw)                      # 响应长什么样(见第三节)
    err_code = status_name = None
    if shape == "json_envelope":               # 信封结构里挖状态字段
        d = json.loads(raw.decode("utf-8-sig", "replace"))
        h = d.get("header") or {}
        err_code = h.get("err_code")
        st = h.get("status") or {}
        status_name = st.get("name") if isinstance(st, dict) else st
    return {"tag": tag, "tool": tool, "url": url, "http": code.strip(),
            "bytes": len(raw), "ms": int((time.time() - t0) * 1000),
            "shape": shape, "err_code": err_code, "status_name": status_name,
            "arg_fp": hashlib.sha256(url.encode()).hexdigest()[:8],
            "resp_fp": hashlib.sha256(raw).hexdigest()[:16]}
注意最后两个字段:请求参数的指纹和响应内容的指纹。后面会用到。
二、四种「没拿到数据」,状态码一律 200
8 次异常调用,返回长这样:
| 调用 | 状态码 | 字节 | 返回长什么样 | 真实成因 |
|---|---|---|---|---|
hko_swt |
200 | 10 B | {"swt":[]} |
真没数据(特别提示通道当时为空) |
hko_typo |
200 | 726 B | 纯文本的参数说明 | dataType=warnsm 拼错 |
hko_badlang |
200 | 726 B | 纯文本的参数说明 | lang=xx 不存在 |
hkma_over |
200 | 110 B | JSON,"success":true,err_code:"1001" |
分页越界 |
csd_bad |
200 | 550 B | 合法 JSON 信封,status.name:"Fail" |
表号 999-99999 不存在 |
td_bad |
404 | 1,097 B | HTML 错误页 | 文件路径不存在 |
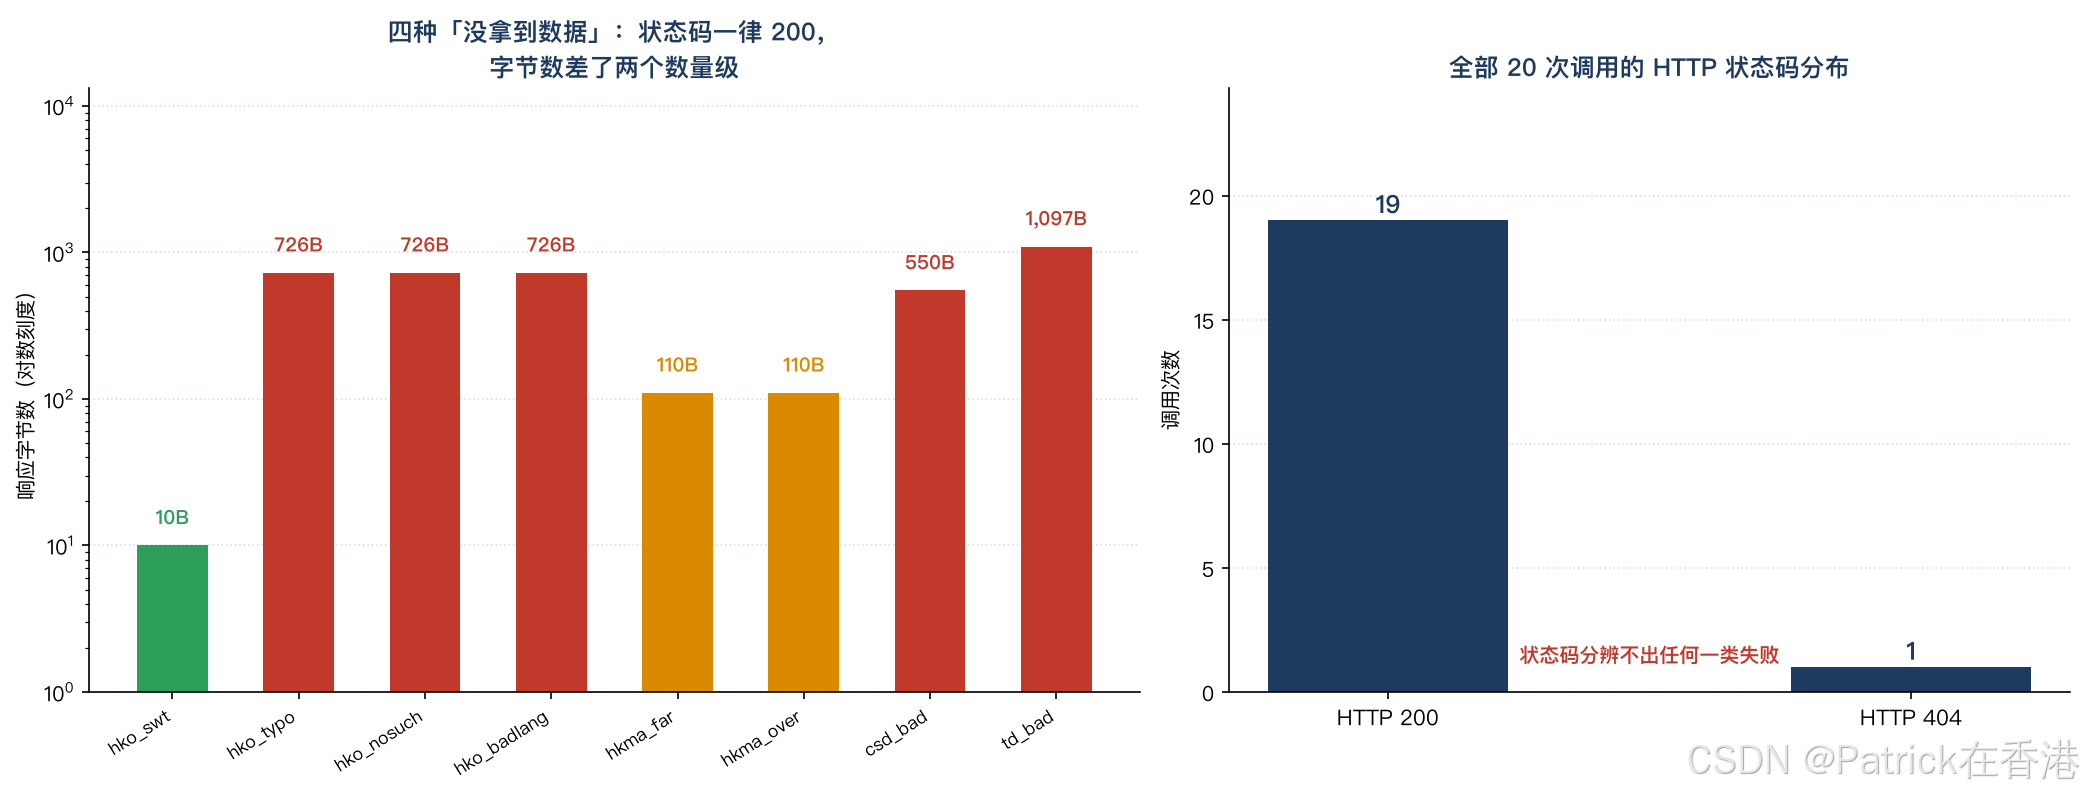
这张形态表建议收藏------四种失败的字节数差了两个数量级,长度本身就是第一条线索。
三次震惊,一次比一次深:
- 参数写错,接口返回 HTTP 200,还附了 726 字节的参数说明文档------天文台把这个当正常响应处理。
- 金管局分页越界,返回里写着
"success": true,错误藏在err_code: "1001"里。拿success字段当判据的代码会直接放行。 - 统计处的返回是完全合法的 JSON 信封 ,但错误藏在
header.status.name里------和金管局用的字段都不一样。
20 次调用里状态码的分布:19 次 200,1 次 404。也就是说,如果你只盯着状态码,8 次异常里你只能发现 1 次。
三、三档判据,检出能力差一个数量级
我用三档判据对同样的 8 次异常各判一遍:
python
def detect_by_http(tr: dict) -> bool:
    """最朴素的判据:状态码不是 200 就算失败。"""
    return tr["http"] != "200"


def detect_by_shape_generic(tr: dict) -> bool:
    """通用形态判据:空容器 / 不是 JSON / err_code 不为 0000 / 非 200,
    不读任何源特有的状态字段。"""
    if tr["http"] != "200":
        return True
    if tr["shape"] == "plain_text":
        return True
    if tr["shape"] in ("json_empty_container", "json_empty_array"):
        return True
    if tr["shape"] == "json_envelope" and tr["err_code"] not in (None, "0000"):
        return True
return False| 判据 | 检出 | 漏掉 |
|---|---|---|
| 只看 HTTP 状态码 | 1/8 | 其余 7 次 |
| 通用形态判据 | 7/8 | 统计处那条(它的失败不在通用字段里) |
| trace + 按源适配 | 8/8 | --- |
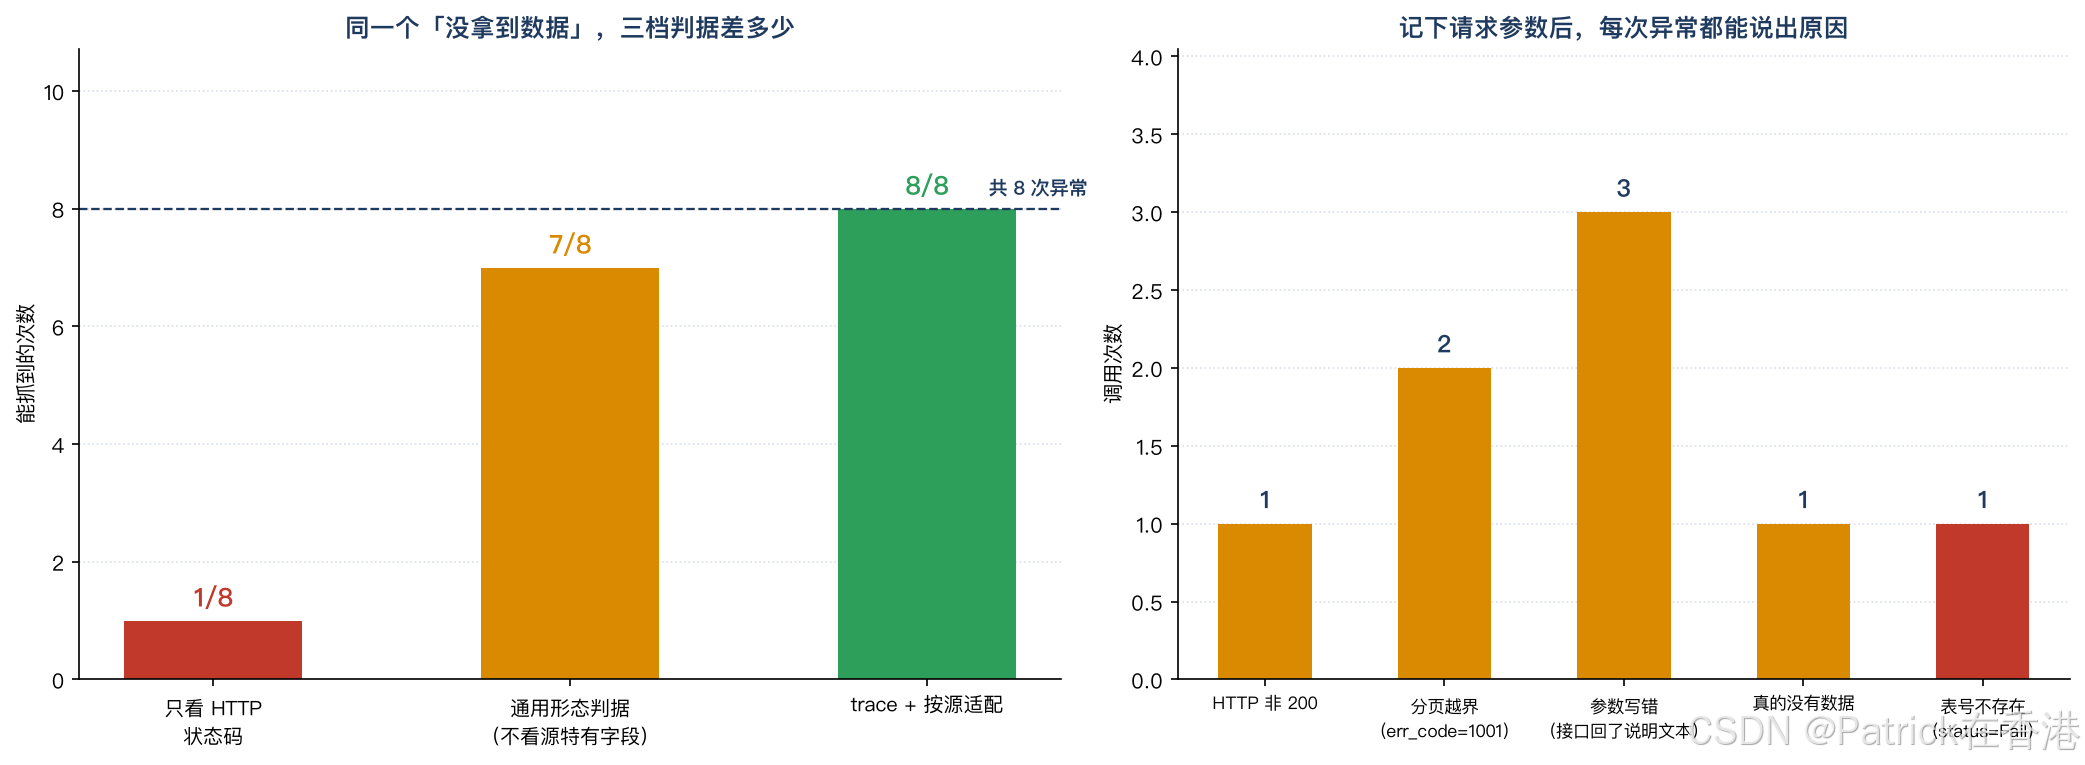
通用判据漏掉的那一次,恰好说明**「成功标识」在香港官方接口里没有统一约定**:金管局用 err_code,统计处用 status.name,天文台直接换返回类型,运输署靠 404。一套判据打天下,一定会漏。
四、trace 的真正价值:能说出「哪个参数错了」
判出「有问题」只是第一步。trace 里记了完整请求 URL,所以每次异常都能定位:
hko_typo     → 请求参数 dataType=warnsm&lang=tc
hko_badlang  → 请求参数 dataType=rhrread&lang=xx
hkma_over    → offset=99999
csd_bad      → id=999-99999(表号不存在)
td_bad       → 路径 no_such_file 不存在
hko_swt      → 无参数问题(该通道当时确实没有数据)
注意 hko_swt 那条------trace 帮你排除了参数问题,确认那次空是接口的真实状态。
这五条定位记录值得收藏照抄------排查 Agent「拿不到数据」时,第一件事就是把请求参数原样打出来。**「没数据」和「查错了东西」在返回值上几乎一样,在 trace 上截然相反。**这正是 Agent 排障时最需要的一条分界线。
五、成本:每条 331 字节,占响应体的 0.12%
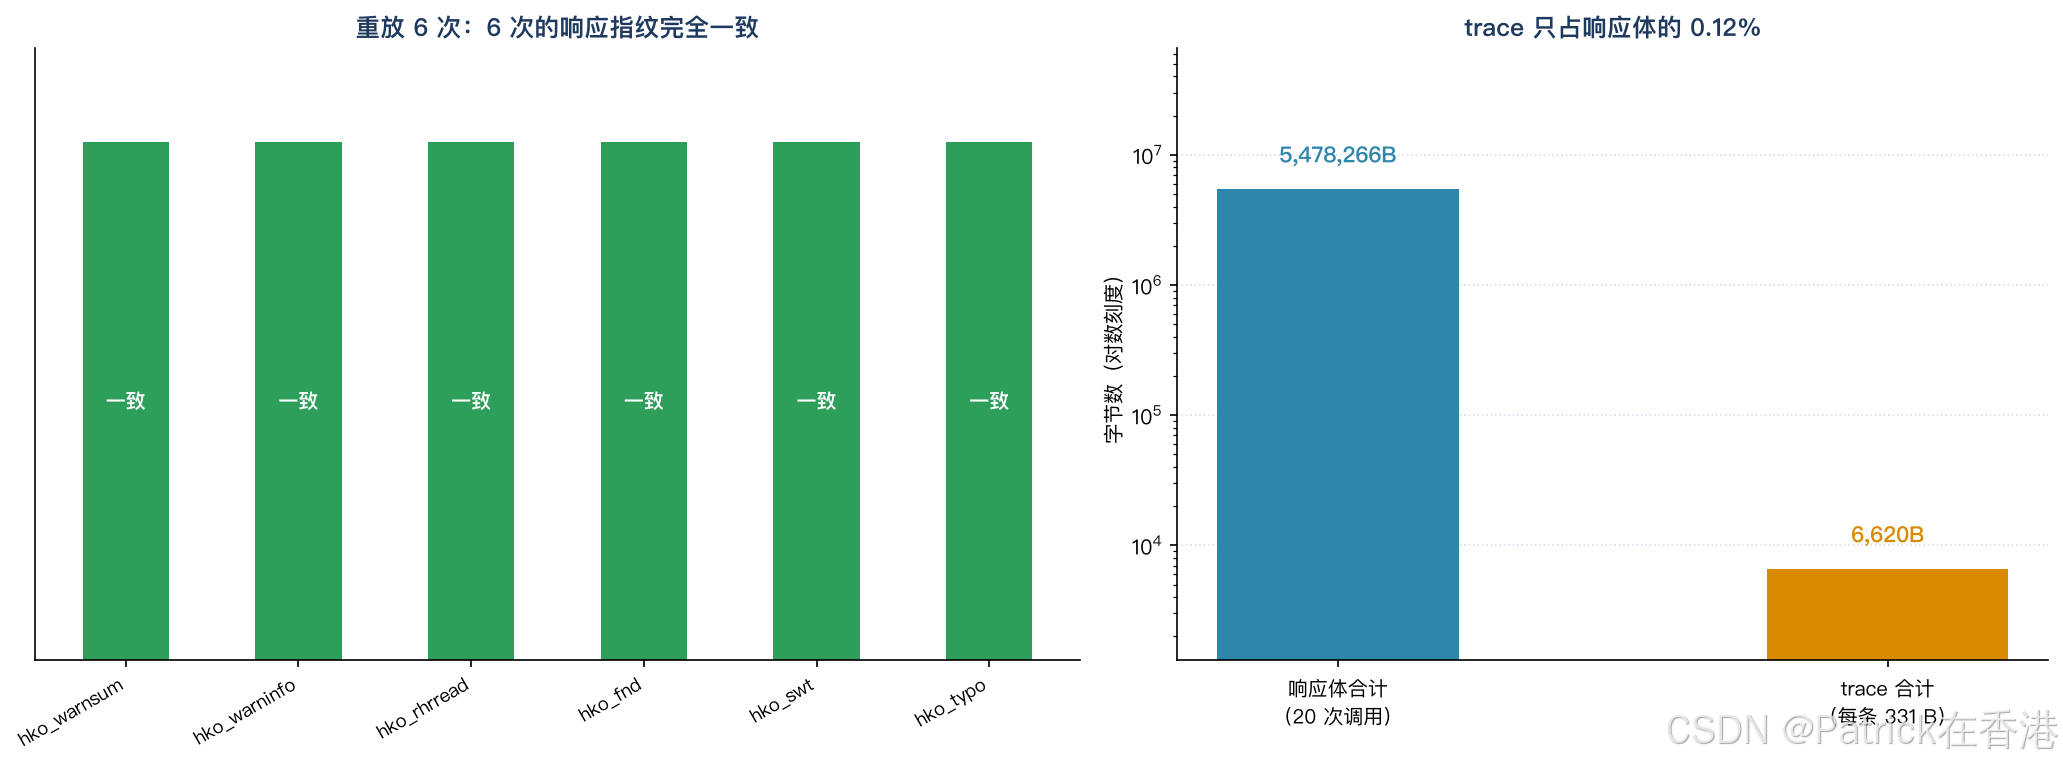
20 次调用的响应体合计 5,478,266 字节,20 条 trace 合计只有 6,620 字节------0.12%。记账的成本可以忽略不计。
我还把其中 6 次调用原样重放了一遍:6 次的响应 SHA-256 指纹全部一致 。这意味着这一批 trace 是可复现的------拿着旧 trace 能重建当时的现场。代价是耗时波动很大:同一个接口两次请求,一次 1,366 ms、一次 3,207 ms,差了两倍多。所以 trace 里必须记耗时------只记结果的账本,解释不了为什么慢;而「慢」在多步任务里会沿着调用链累积,最后变成用户看到的那次超时。
六、两个实现层的坑
UTF-8 BOM 会把 JSON 判成纯文本。 运输署、入境处、1823 的响应都带 BOM,我的第一版形态判定把这三个 JSON 数据源全判成了纯文本。用 utf-8-sig 解码后再判定才对。
别用「有没有逗号」判 CSV。 天文台的英文错误说明里也有逗号,会把 726 字节的错误文本判成 CSV。要求首行至少两个逗号才可靠。
七、结论
| 问题 | 实测结果 |
|---|---|
| 「没拿到数据」有几种 | 4 种形态:空容器 / 纯文本 / 信封错误(两种字段)/ 404 |
| 状态码能抓到几成 | 1/8(12.5%) |
| 通用形态判据呢 | 7/8,漏掉 status.name 那条 |
| trace 呢 | 8/8 检出 + 8/8 定位到参数,成本 0.12% |
三条:
- HTTP 200 和
success:true都不是「没出错」的证据。 在多源数据接入里,它们只是「没按错误方式出错」。 - trace 至少要记三样:完整请求参数、响应形态签名、内容指纹。 前两个用来定位,最后一个用来重放。
- 每个源的成功标识字段都要单独适配------这一步没有通用解,只有「逐个看过返回」这一条笨路。而 trace 就是把这条笨路固化下来,让下一次不用重走。
这套 trace 记法建议直接收藏 :字段就七个,任何 Agent 项目把 run_case 换成自己的调用函数就能用,先把账记起来,出了事才有得查。
八、边界与声明
- 错误参数来自接口规范的真实边界(不存在的
dataType、越界offset、不存在的表号),用于验证判据,不代表接口的常规错误率; - 本文只讨论工具调用层的可观测性,不涉及模型侧的行为;
- 数据均为香港政府公开接口,2026-09-20 当天实抓,trace 与原始响应全部落盘,脚本可原样复跑。
参考链接
- https://data.weather.gov.hk/weatherAPI/opendata/weather.php?dataType=warnsum\&lang=tc
- https://api.hkma.gov.hk/public/market-data-and-statistics/daily-monetary-statistics/daily-figures-interbank-liquidity
- https://www.censtatd.gov.hk/tc/web_table.html?id=650-80001
原创声明:本文全部数据来自 2026-09-20 当天对香港官方接口的真实调用(20 次 + 6 次重放),trace 与原始响应已落盘。觉得有用点个关注不迷路,下一篇拆一个新数据源。