本文是「Agent 基本概念」系列第一篇,本系列将带你了解agen的基本概念。
系列规划:① 什么是 AI Agent → ② 核心组件 → ③ 决策与规划 → ④ 记忆与工具 → ⑤ 架构与落地。
前言:你有了 ChatGPT,为什么还想要一个 Agent?
过去几年,大模型(LLM)彻底改变了我们与软件交互的方式。
你问它问题,它给你答案;你让它写代码,它给你代码;你让它总结文章,它给你摘要。
但你会发现一个尴尬的事实:
它很会说,但不会做。
在没有工具接入的情况下,它不能直接帮你查今天的航班,不能帮你把代码提交到 Git,不能帮你打开浏览器填表单,不能根据中间结果自动调整策略。
你只能:
- 自己把问题拆成步骤;
- 自己复制粘贴到不同工具;
- 自己判断下一步做什么;
- 自己把结果拼起来。
你成了那个"人肉 Agent"。
于是,AI Agent 出现了。
它的目标不是让模型"更会聊天",而是让模型能感知环境、在给定权限和约束下自主决策、调用工具、执行动作,并根据反馈持续迭代,最终完成一个目标。
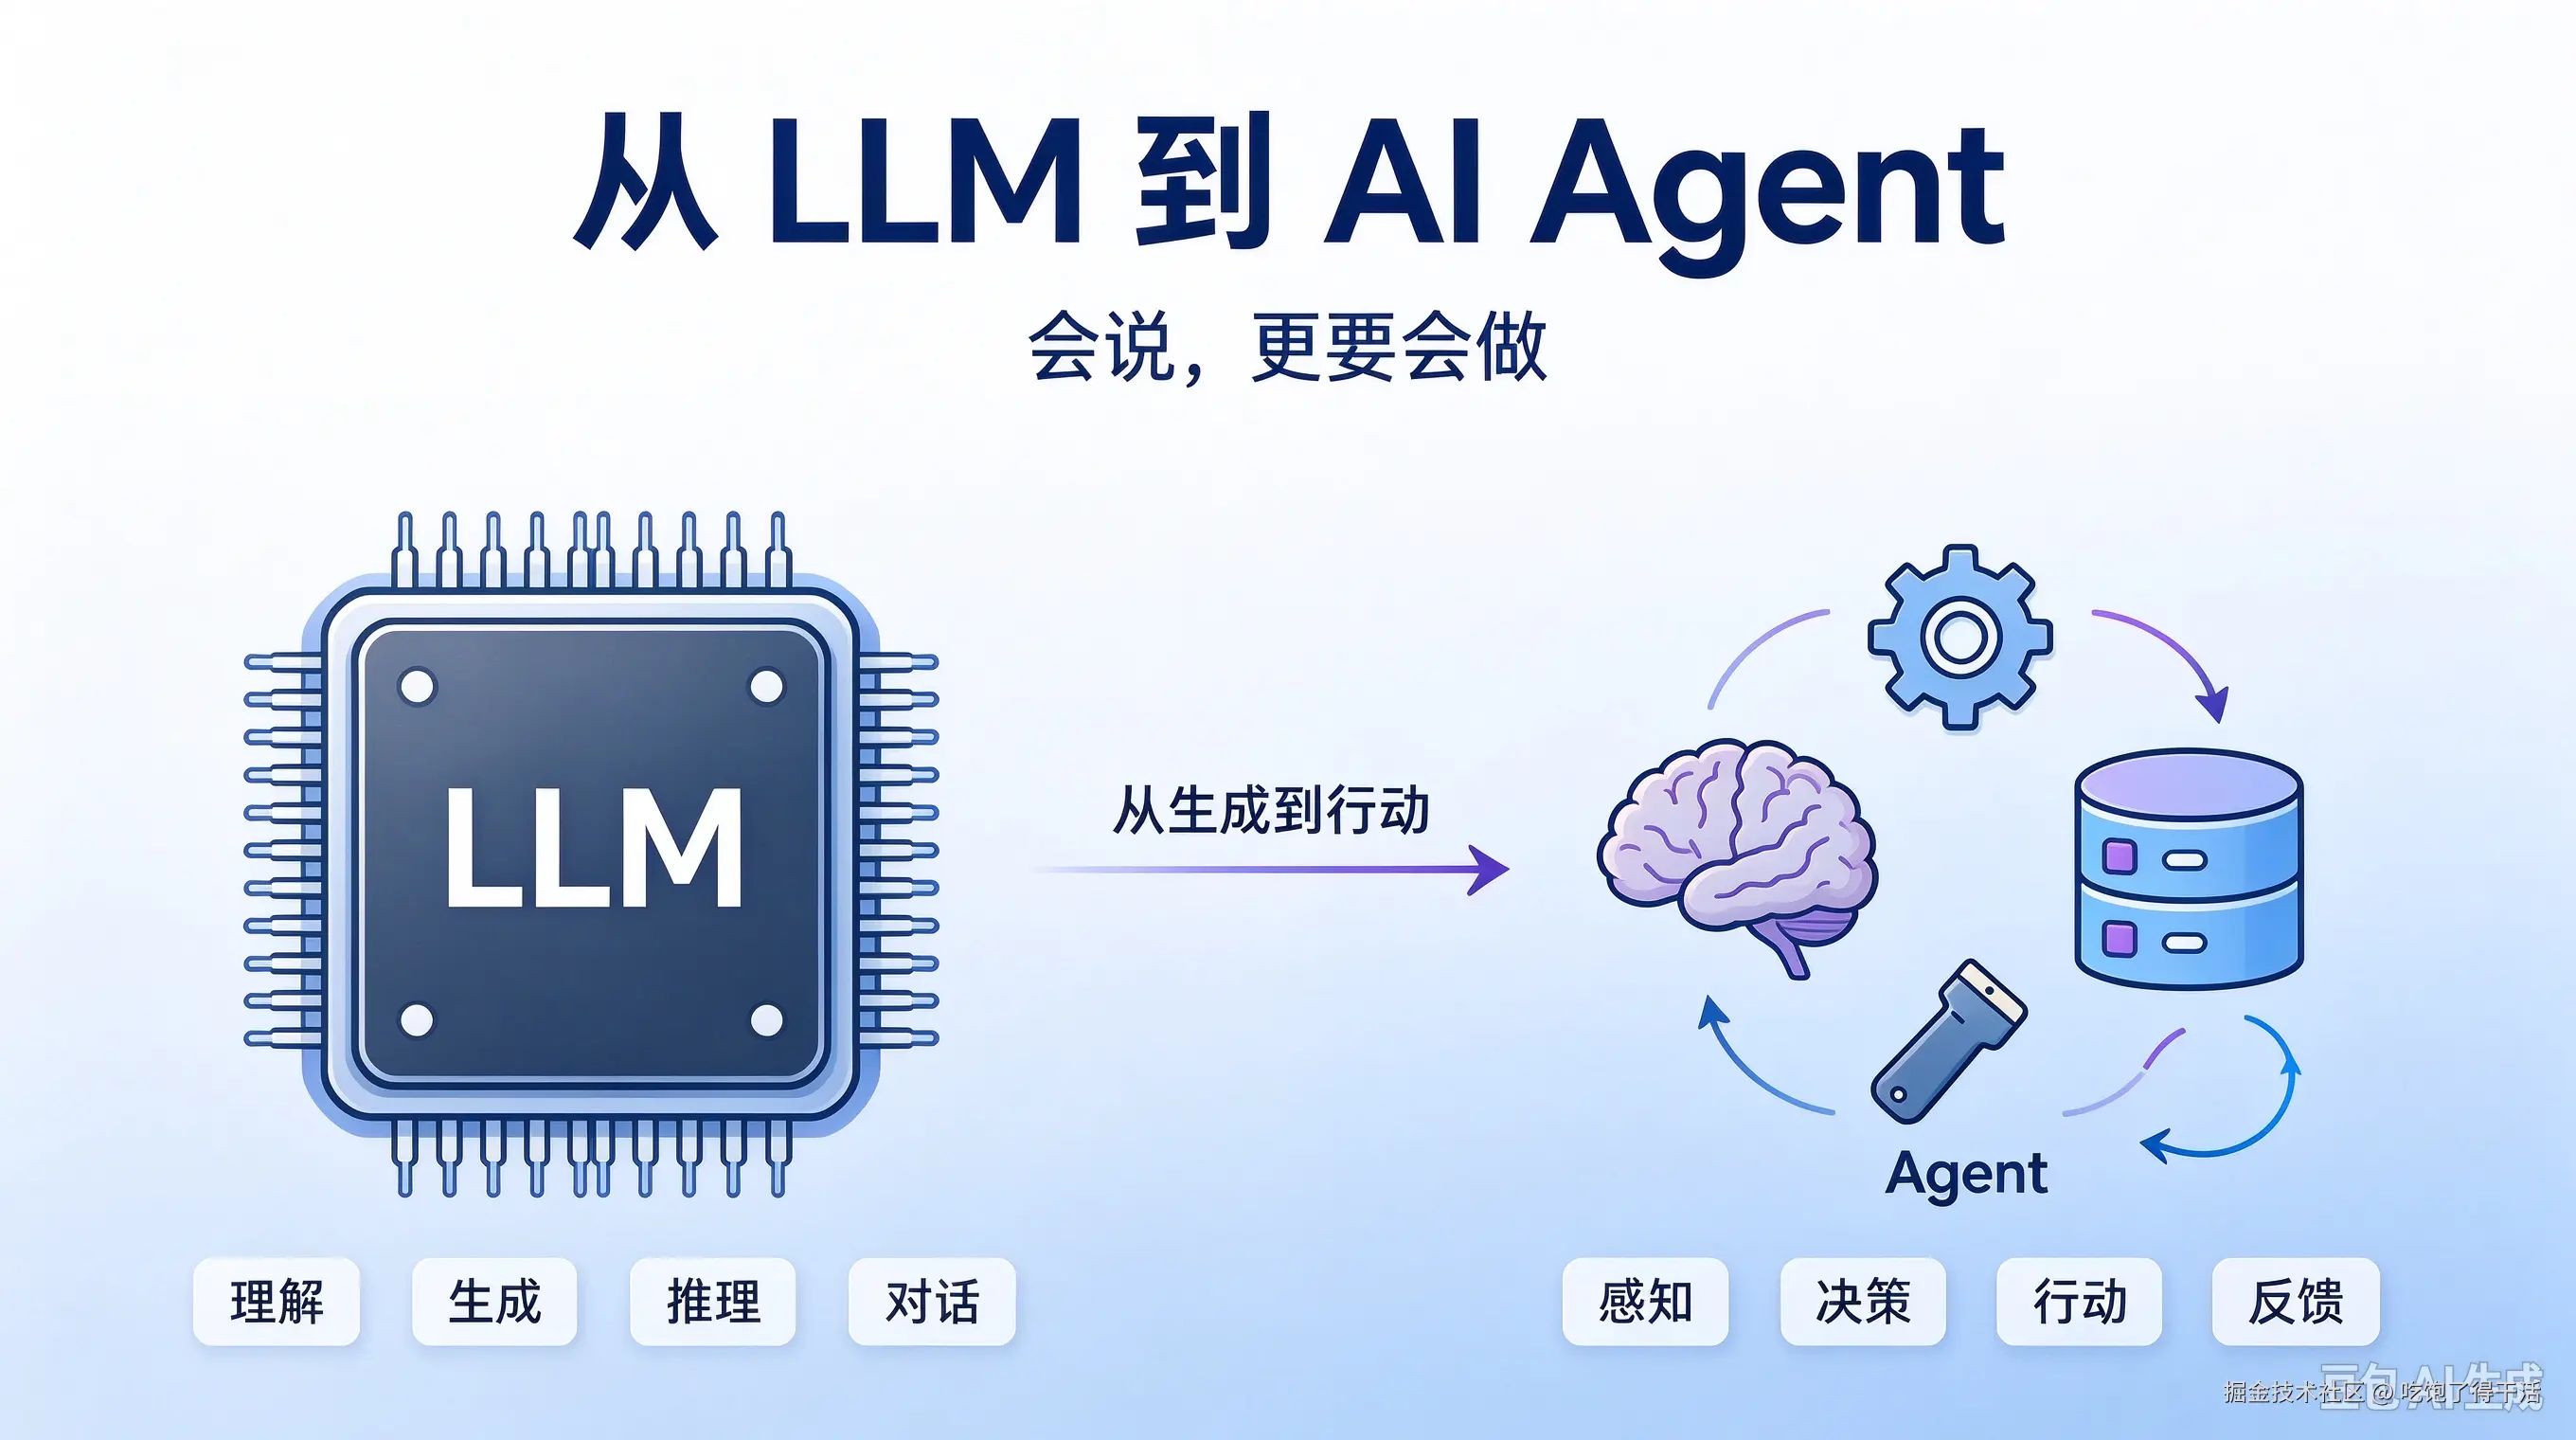
这篇文章会沿着一条主线讲清楚:
从"生成"到"行动",LLM 如何进化成 Agent。
我们会层层递进:先看 LLM 的能力边界,再看 Agent 的定义,然后拆解核心公式,对比常见概念,最后用一个完整例子把逻辑串起来。
一、LLM 的能力边界:会生成,不会行动
要理解 Agent,必须先理解 LLM 到底能做什么、不能做什么。
1.1 LLM 的本质:一个条件概率生成器
从建模角度看,自回归语言模型的核心目标可以抽象为:
P(tokent∣token1,token2,...,tokent−1)P(tokent∣token1,token2,...,tokent−1)
给定前面的 token,预测下一个 token。
它擅长的是:
- 语言理解与生成
- 知识问答
- 代码生成
- 推理(在某种程度上)
- 多轮对话
但它有几个根本限制:
| 限制 | 说明 |
|---|---|
| 模型本身无状态 | 模型本身不保存对话状态;对话状态由应用层通过上下文窗口、外部记忆等管理。默认不会跨会话记住信息。 |
| 无直接行动能力 | 不能直接操作外部世界,不能发 HTTP 请求、读文件、点按钮;需要外部工具或运行时代执行。 |
| 无实时信息 | 知识有截止时间,无法知道今天的天气、股价、航班,除非接入搜索或实时数据。 |
| 无长期记忆 | 不能持续积累用户偏好、任务历史,除非外部记忆系统支持。 |
| 无运行时反馈闭环 | 生成完就结束,不能根据执行结果自动修正,除非外部编排循环。 |
| 容易幻觉 | 会一本正经地胡说八道。 |
所以,LLM 是一个强大的推理与生成引擎,但它不是一个完整的系统。
1.2 把 LLM 包一层,就能变成 Agent 吗?
很多人第一反应是:
"那我给它加个搜索 API,不就能查实时信息了吗?"
没错,这是第一步。
但仅仅加一个工具调用,还远远不够。
因为真实任务往往需要:
- 多步决策:先查航班,再比价,再选座,再支付;
- 状态管理:记住用户偏好、当前进度、已选航班;
- 异常处理:航班售罄怎么办?支付失败怎么办?
- 动态规划:根据中间结果决定下一步。
这些不是一次函数调用能解决的。
你需要一个循环,一个能持续观察、思考、行动的系统。
这就是 Agent。
二、从"对话"到"做事":Agent 的定义
2.1 一句话定义
Agent 是一个能感知环境、在给定权限和约束下自主决策、调用工具、执行动作,并根据反馈迭代以达成目标的系统。
注意几个关键词:
- 感知:接收用户输入、API 返回、文件内容、网页状态;
- 自主决策:在权限和约束内,自己决定下一步做什么,而不是人预先写死;
- 调用工具:使用外部能力扩展自身边界;
- 执行动作:真正改变环境或产出结果;
- 反馈迭代:根据结果调整策略,直到完成或失败。
2.2 核心公式
我习惯用一个公式来概括:
Agent = LLM(或策略)+ 规划 + 记忆 + 工具 + 执行循环
这个公式是本文的主线。
后面我们会逐项拆解,但先记住:
- LLM(或策略) :大脑,负责推理和决策;
- 规划:把大目标拆成小步骤;
- 记忆:保存上下文、状态、经验;
- 工具:与外部世界交互的手脚;
- 执行循环:观察 → 思考 → 行动 → 观察 → ... → 完成。
缺少任何一项,Agent 的能力都会大打折扣。
2.3 一个更直观的循环图
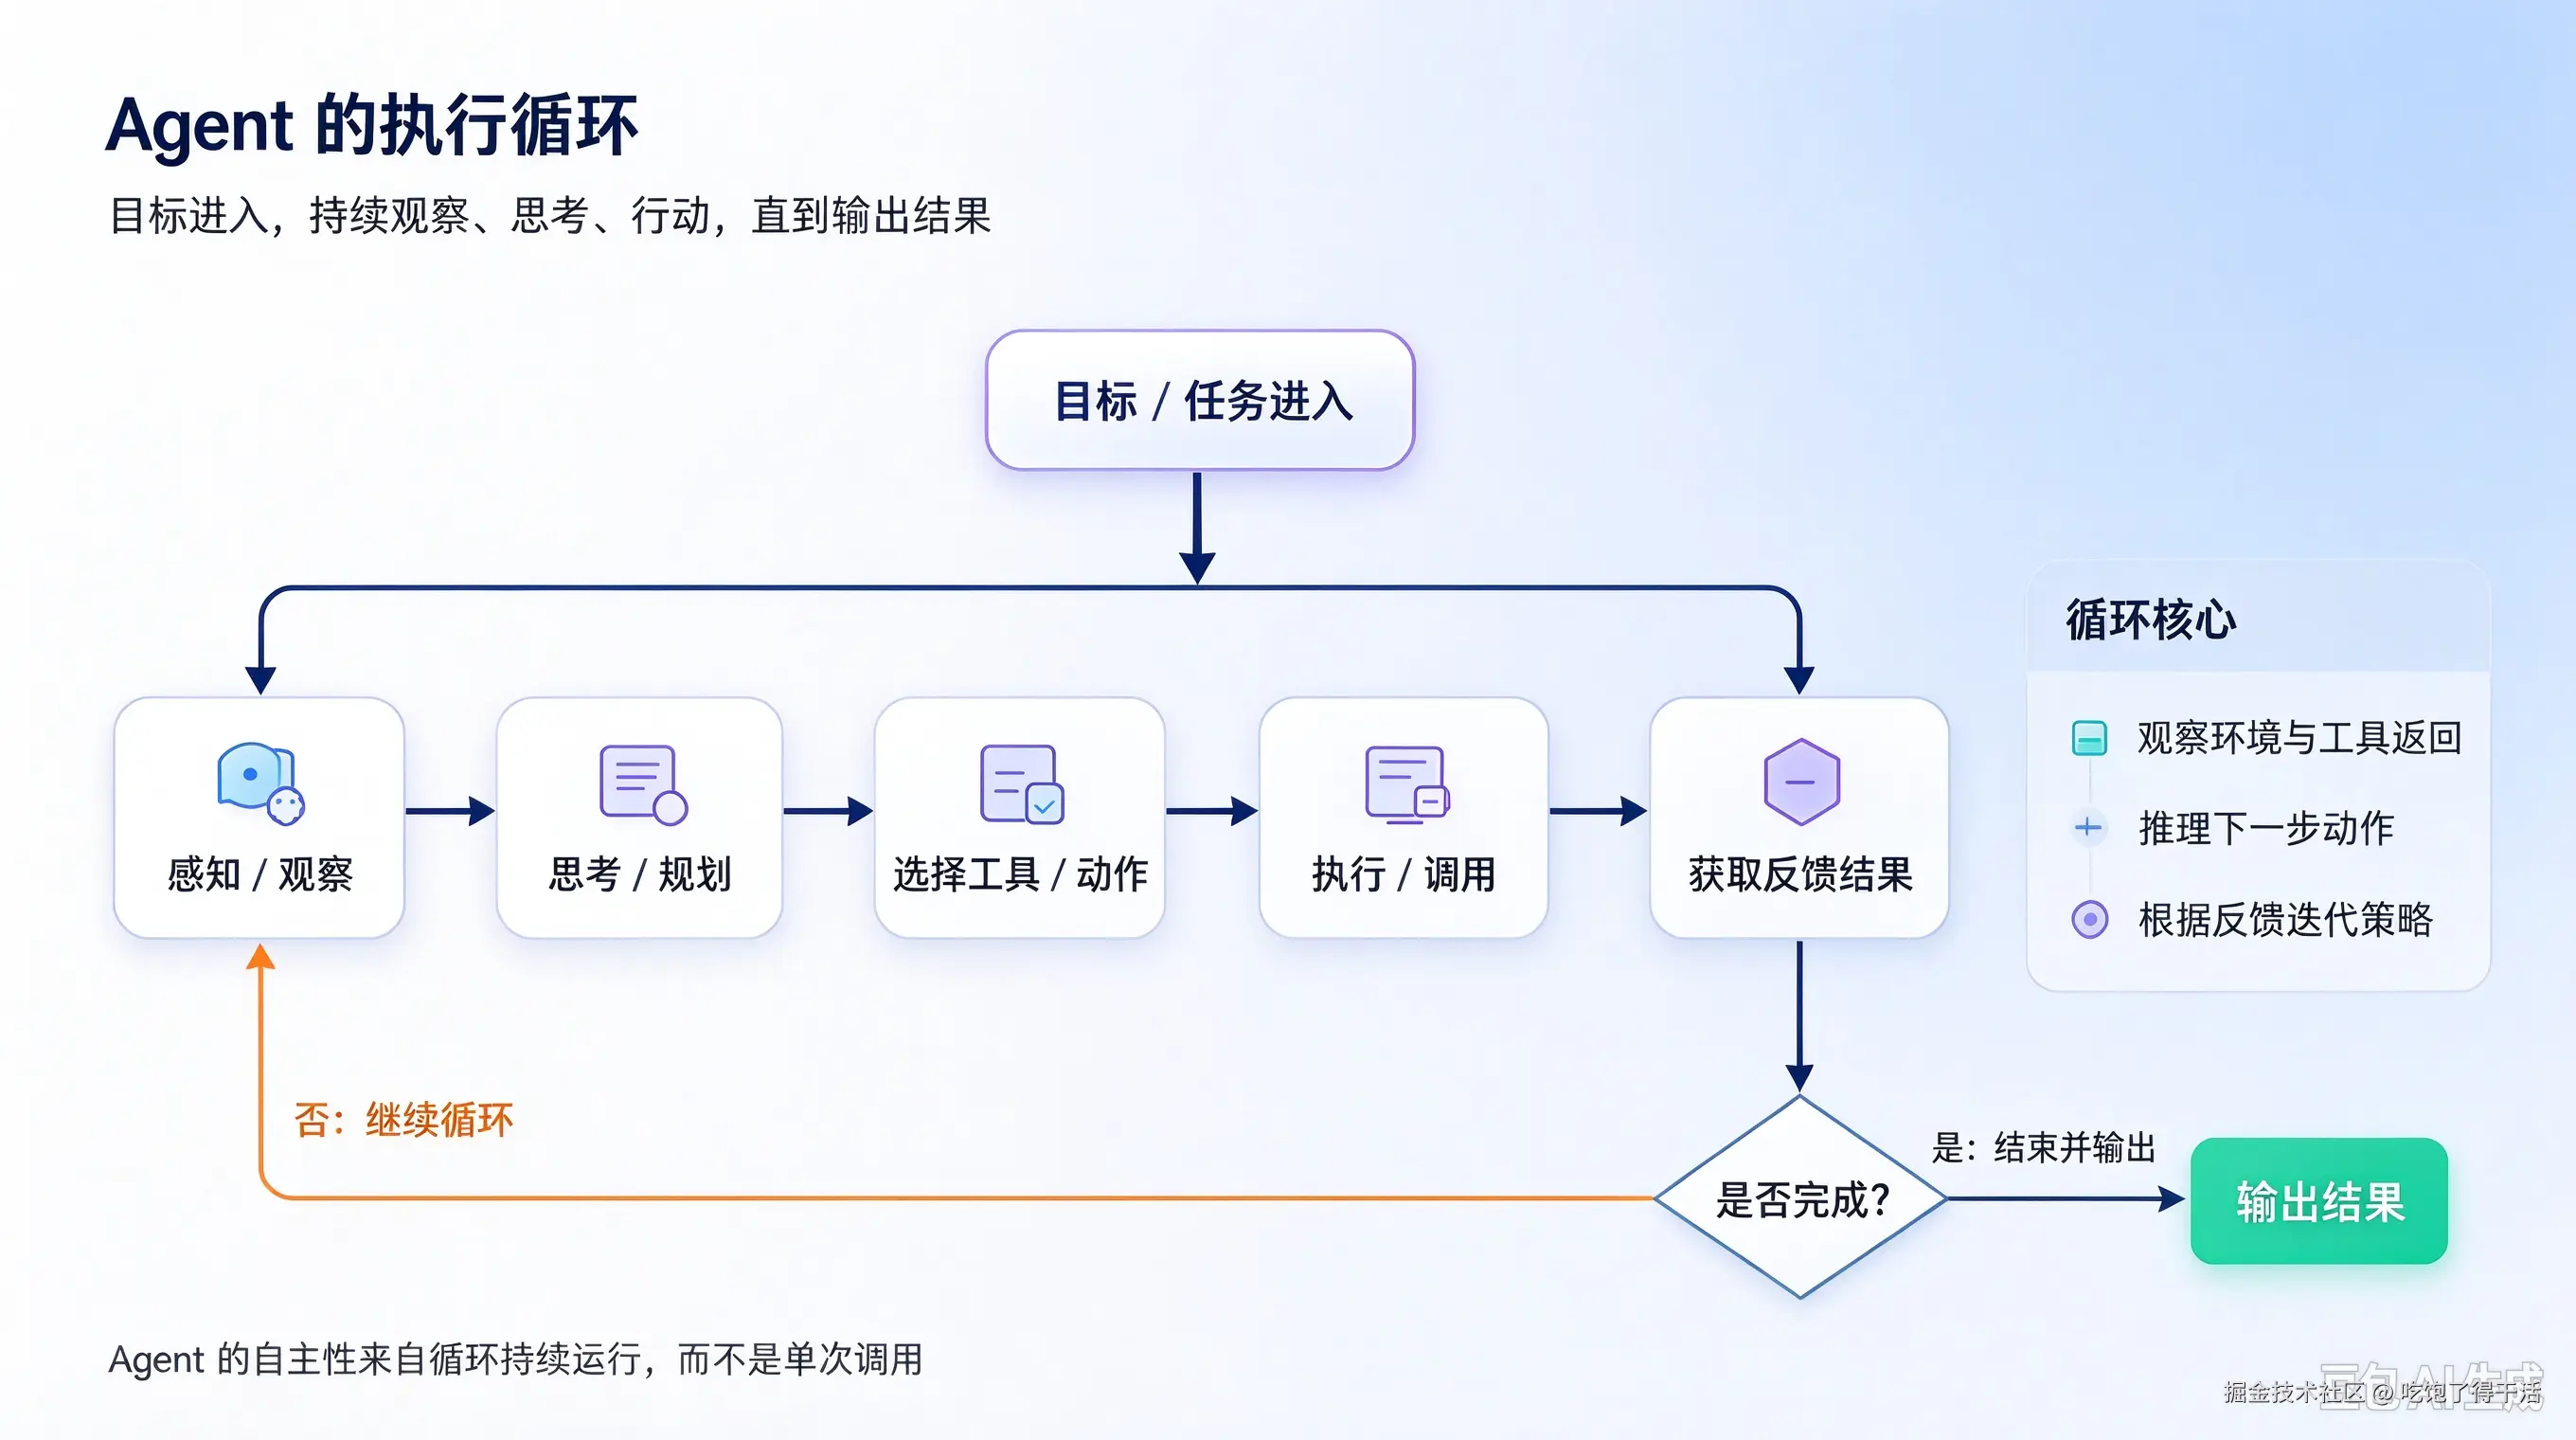
这个循环,就是 Agent 的心跳。
三、逐项拆解:Agent 的五个核心部件
3.1 LLM(或策略):Agent 的大脑
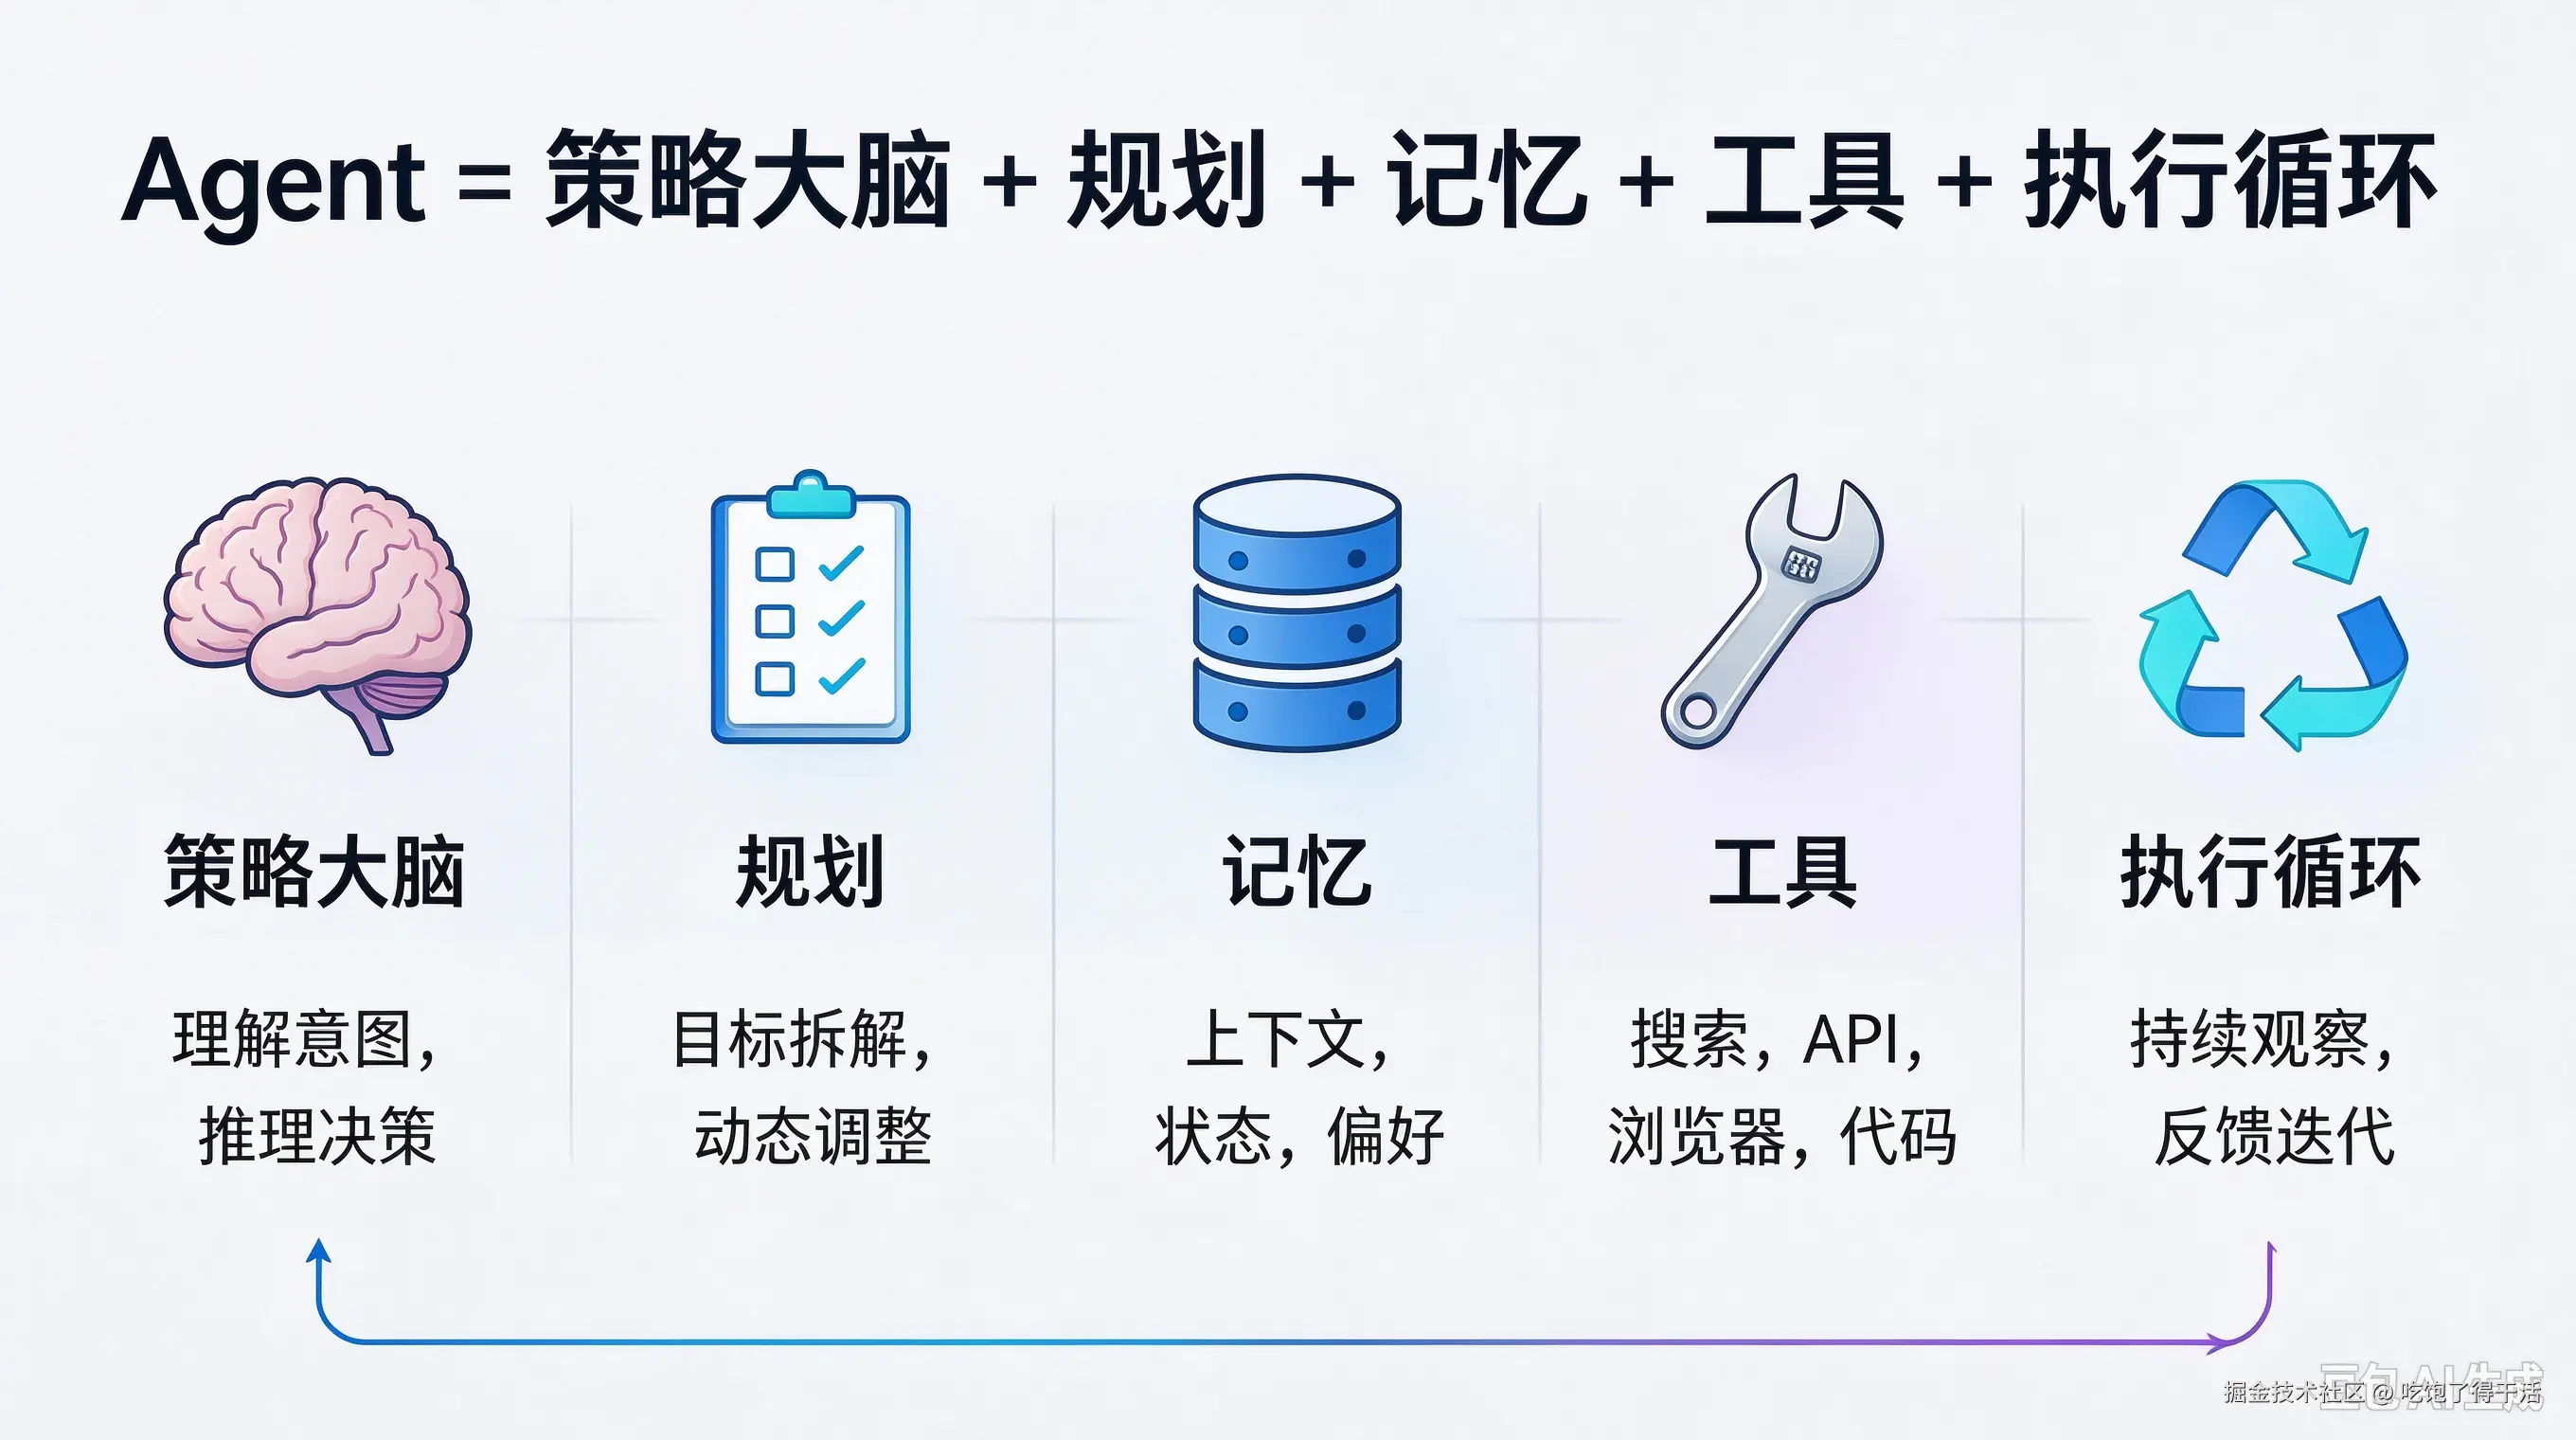
LLM 是 Agent 的推理核心。
它负责:
- 理解用户意图;
- 分析当前状态;
- 决定下一步动作;
- 生成工具调用参数;
- 总结结果并输出。
但 LLM 不是唯一策略。
在传统强化学习中,策略可以是一个神经网络;在简单规则系统中,策略可以是 if-else。
但在现代 AI Agent 语境下,LLM 通常扮演策略网络 + 推理引擎的双重角色。
3.2 规划:把"大目标"拆成"小步骤"
规划解决的是:
"我要完成 X,应该先做什么,再做什么?"
常见规划方式:
- 任务分解:把"订机票"拆成"查日期 → 搜航班 → 比价 → 选座 → 支付";
- 优先级排序:先查天气再决定带不带伞;
- 路径选择:如果 A 方案失败,走 B 方案;
- 反思与重规划:执行后发现不对,重新调整。
没有规划,Agent 就会像无头苍蝇,每一步都从零开始。
3.3 记忆:让 Agent 不再"金鱼脑"
记忆分三层:
| 类型 | 作用 | 例子 |
|---|---|---|
| 短期记忆 | 当前对话上下文 | 用户刚说的"不要转机" |
| 工作记忆 | 当前任务状态 | 已选航班、支付进度 |
| 长期记忆 | 跨会话知识与偏好 | 用户常坐靠窗、喜欢早班机 |
记忆的操作包括:写入、检索、压缩、更新、遗忘。
没有记忆,Agent 每次都要重新问一遍用户,体验极差。
3.4 工具:Agent 的手脚
工具是 Agent 与外部世界交互的接口。
常见工具类型:
- Function Calling:调用预定义函数;
- HTTP API:访问外部服务;
- 浏览器:打开网页、点击、填表单;
- 代码解释器:执行 Python、计算、绘图;
- 数据库:查询、写入;
- 文件系统:读写文件;
- 通过 MCP 接入外部工具:MCP(Model Context Protocol)是标准化模型与工具/上下文连接的协议。
工具让 Agent 从"会说"变成"会做"。
3.5 执行循环:Agent 的心跳
执行循环是 Agent 最核心的运行时结构。
一个典型的循环:
- 观察:读取当前状态(用户输入、工具返回、环境变化);
- 思考:LLM 推理下一步;
- 行动:调用工具或输出内容;
- 观察:获取行动结果;
- 判断:是否完成?未完成则回到第 1 步或第 2 步。
这个循环可以运行一次,也可以运行几十次。
Agent 的自主性,就体现在这个循环能自己转起来。
四、Agent 与普通程序、工作流、LLM 的区别
很多人容易混淆这几个概念。我们用一张表说清楚:
| 维度 | 普通程序 | 工作流 | LLM | Agent |
|---|---|---|---|---|
| 控制流 | 人写死 | 人预先编排 | 无自主控制流 | 在约束下自主决策 |
| 输入 | 可固定也可动态 | 固定/半固定 | 自然语言/多模态 | 自然语言 + 环境 |
| 输出 | 固定或按逻辑产出 | 固定/半固定 | 文本/多模态 | 动作 + 文本/多模态 |
| 工具使用 | 硬编码 | 节点调用 | 可生成工具调用请求,但不执行 | 动态选择并调用(由运行时执行) |
| 记忆 | 变量/数据库 | 有限状态 | 上下文窗口 | 短期 + 长期 |
| 异常处理 | 异常捕获 | 有限分支 | 无运行时异常捕获,依赖外部编排 | 反思重试 |
| 适用场景 | 确定性任务 | 流程明确任务 | 生成/问答 | 不确定环境任务 |
关键区别:
- 工作流:步骤是人定的,Agent 只是执行者;
- Agent:步骤是 Agent 自己定的,人只给目标。
所以,Agent 不是"更复杂的工作流",而是把决策权交给模型的系统。
五、一个完整例子:订机票 Agent
假设用户说:
"帮我订一张明天去北京的最早航班,要靠窗。"
一个完整的 Agent 会怎么做?
5.1 感知
- 解析用户意图:目的地北京、时间明天、偏好最早、靠窗。
- 检查记忆:用户是否存过身份证、常旅客号?
5.2 规划
- 步骤 1:获取明天日期;
- 步骤 2:搜索明天飞北京的航班;
- 步骤 3:按起飞时间排序,选最早;
- 步骤 4:检查靠窗座位;
- 步骤 5:确认价格和退改签政策;
- 步骤 6:调用订票 API;
- 步骤 7:返回订单号。
5.3 行动与循环
- 调用日历工具,得到明天日期;
- 调用航班搜索 API,返回 10 个航班;
- 调用排序工具,选出最早 3 个;
- 发现最早航班没有靠窗座位;
- 此时出现偏好冲突:最早 vs 靠窗;
- Agent 反思:是换下一个有靠窗的航班,还是问用户是否接受非靠窗?
- 根据策略,决定询问用户。
Agent:
最早航班 XX 没有靠窗座位。您是要"最早优先,接受非靠窗",还是"靠窗优先,选下一个有靠窗的航班"?
用户:
最早优先,接受非靠窗。
Agent:
- 继续调用订票 API;
- 完成支付;
- 返回订单号。
5.4 这个例子体现了什么?
- 自主决策:没有靠窗时,Agent 自己决定询问用户;
- 工具调用:日历、搜索、排序、订票 API;
- 记忆:用户偏好、身份证信息;
- 循环:多次观察-思考-行动;
- 反馈:根据 API 返回调整策略。
这就是 Agent 和"一次 LLM 调用"的本质区别。
六、常见误解:Agent 不是万能聊天机器人
误解 1:Agent 就是更聪明的 ChatGPT
不对。
ChatGPT 是对话界面,Agent 是执行系统。
Agent 可能用 ChatGPT 作为大脑,但还需要工具、记忆、循环。
误解 2:Agent 一定要多智能体
不对。
单 Agent 也能完成很多任务。多智能体是架构选择,不是必要条件。
误解 3:Agent 越自主越好
不对。
自主性越高,风险越大。
订机票可以自主,转账付款必须人工确认。
权限最小化、关键动作人工确认,是落地铁律。
误解 4:Agent 会取代工作流
不对。
确定性任务用工作流更稳、更便宜。
Agent 适合不确定环境、需要动态决策 的任务。
很多时候,最佳方案是 工作流 + Agent 节点。
七、总结:Agent 的本质是"在不确定环境中持续决策并执行"
回到主线:
LLM 解决了"生成",Agent 解决了"行动"。
Agent 的核心公式:
Agent = LLM(或策略)+ 规划 + 记忆 + 工具 + 执行循环
它不是一个更花哨的聊天机器人,而是一个能感知、会思考、能行动、可迭代的系统。
如果你要构建 Agent,记住三句话:
- 从工作流开始,逐步增加自主性。
- 先做可观测性,再做自动化。
- 能不用多智能体,就不用多智能体。
下一篇,我们会深入拆解 Agent 的核心组件:感知、规划、记忆、工具、行动、循环,看看每个部分如何设计,以及常见的工程坑。
本文是「Agent 基本概念」系列第 1 篇。
如果你觉得有帮助,欢迎点赞、收藏、关注。