✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
本系统名为《基于大数据的生活指数分析与可视化》,主要围绕生活指数相关数据展开分析与展示。系统采用 Hadoop 与 Spark 作为大数据处理核心,利用 HDFS 进行数据存储,通过 Spark SQL、Pandas、NumPy 完成数据清洗、统计计算与指标分析,后端提供 Python+Django 与 Java+Spring Boot 两个版本,前端使用 Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery 完成页面交互与图表展示,数据库采用 MySQL。系统功能包括系统首页、指数结构分析、等级态势分析、时效特征分析、时序演变分析、提示语义分析、交叉对比分析、风险洞察分析以及生活信息等模块。整体上,系统希望把原本分散、复杂的生活指数数据,通过大数据处理流程转化为较直观的分析结果和可视化图表,让用户能够从结构、等级、时间、语义、对比和风险等多个角度了解生活指数的变化情况,也为计算机专业毕业设计提供一个相对完整、可落地的大数据项目参考。
选题背景
生活指数这类数据在日常生活中并不少见,比如空气质量、舒适度、出行条件、消费水平等,都会在不同时间、不同区域产生变化。过去很多系统只是把数据简单存起来,或者做一点基础查询,面对数据量变大、维度变多的情况,处理起来就比较吃力。Hadoop 和 Spark 的出现,让大批量数据的存储和计算有了更合适的方式,也让生活指数这类带有时间、等级、区域、语义特征的数据可以被进一步分析。本课题选择基于大数据的生活指数分析与可视化,主要是想把课堂里学到的大数据技术与一个具体场景结合起来。系统并不追求特别复杂的业务,而是希望借助 Hadoop、HDFS、Spark、Spark SQL 等技术,把生活指数数据从采集后的原始状态,逐步处理成可以分析、可以展示、可以对比的结果。对于大四计算机专业学生来说,这样的题目既有一定技术含量,也方便围绕功能模块展开设计与实现,不会显得太空。
选题意义
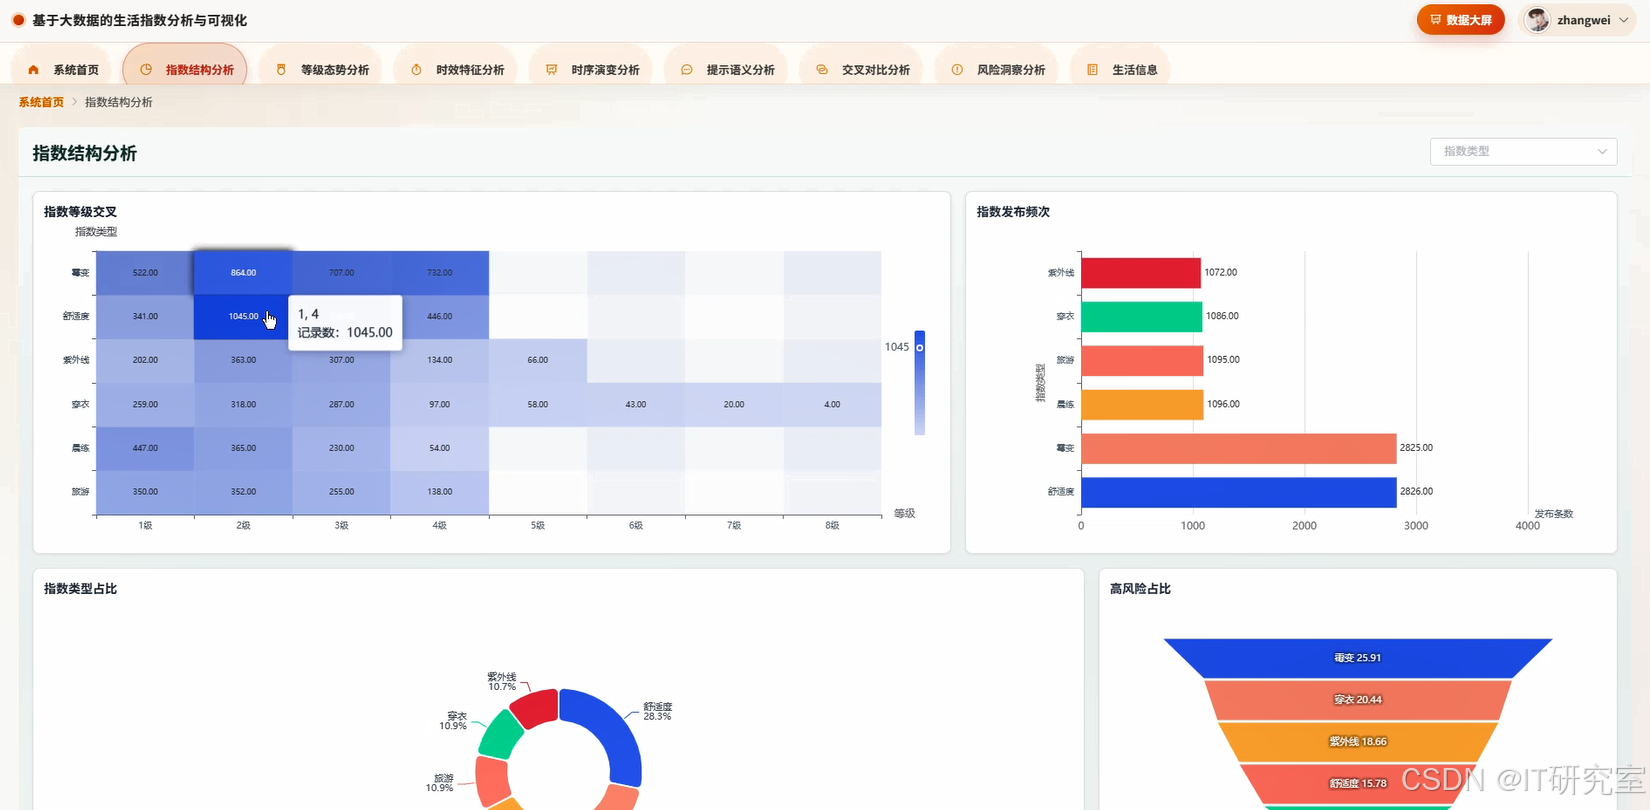
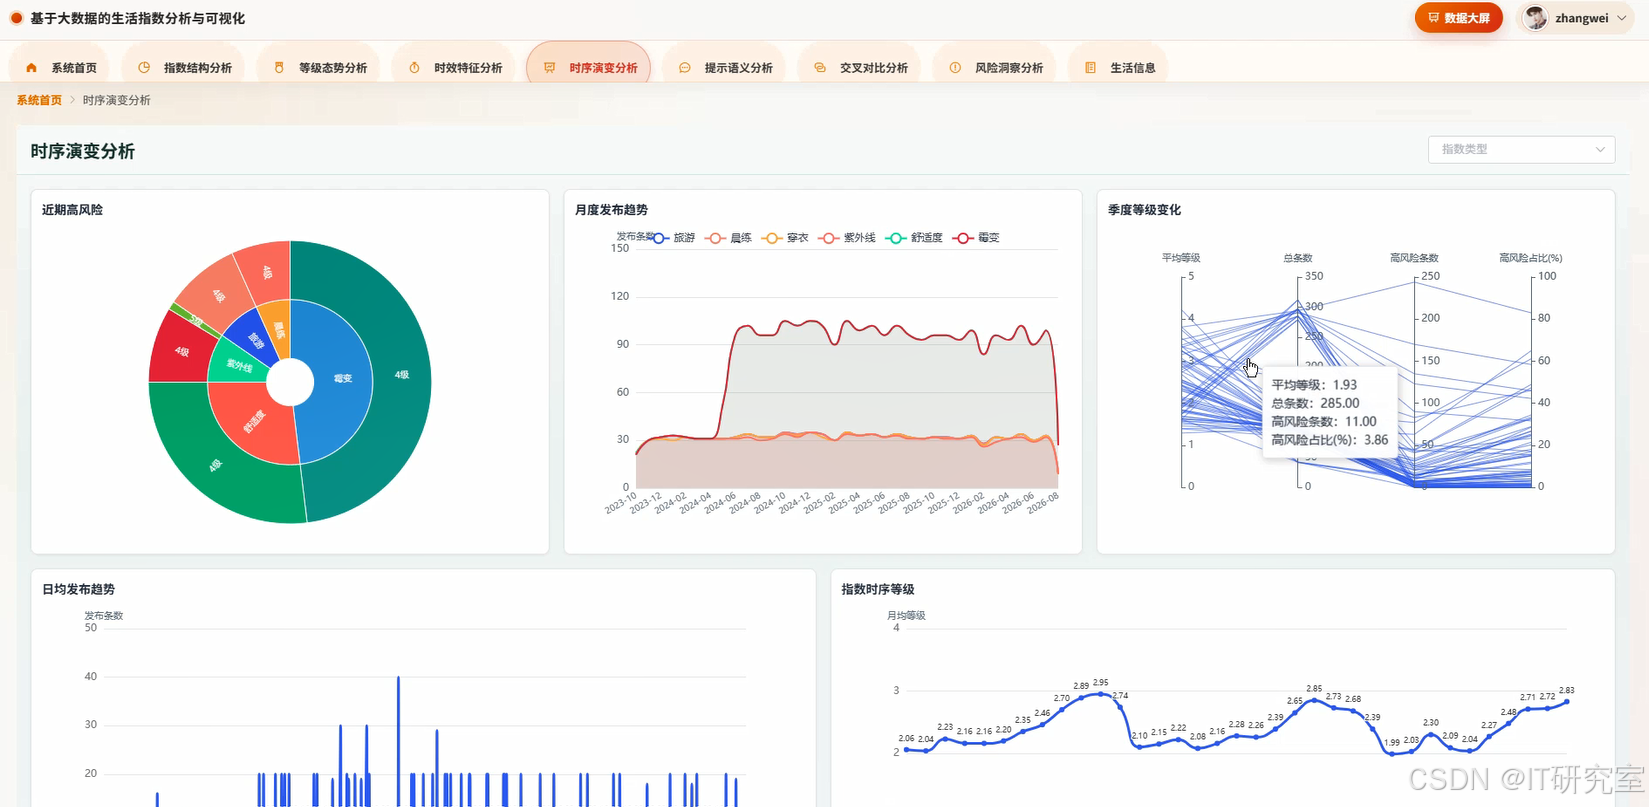
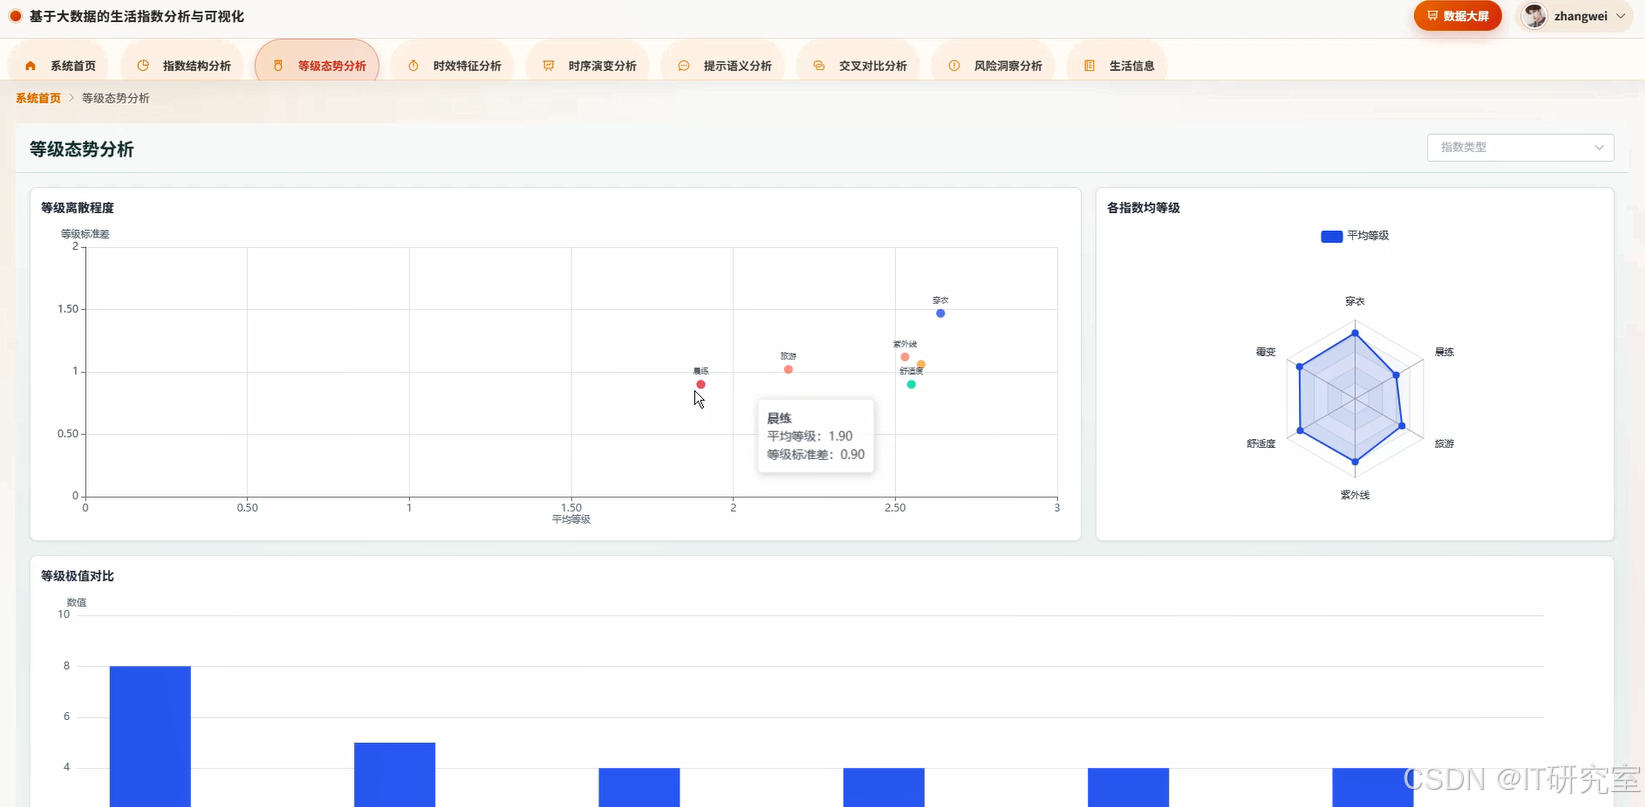
从实际意义上看,这个课题可以帮助使用者更直观地看到生活指数在不同维度下的变化。比如指数结构分析能看出各类指标占比,等级态势分析能看出不同等级分布,时序演变分析能看出一段时间内的波动趋势,交叉对比分析还能把不同对象放在一起观察。对于普通用户来说,这些图表比单纯看表格更容易理解;对于计算机专业学生来说,完成这样一个系统,可以把大数据处理、后端接口、数据库设计和前端可视化串起来,对个人综合能力是一次比较实在的锻炼。它的意义不需要被说得太大,毕竟它只是一个毕业设计,更多是起到练习和展示的作用。通过这个课题,可以熟悉 Hadoop 与 Spark 的基本使用方式,理解数据从存储、计算到展示的流程,也能为后续做类似的数据分析项目积累一点经验。整体来说,这个选题的价值在于技术路线相对清晰,功能模块比较完整,适合作为本科阶段的一次综合实践。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
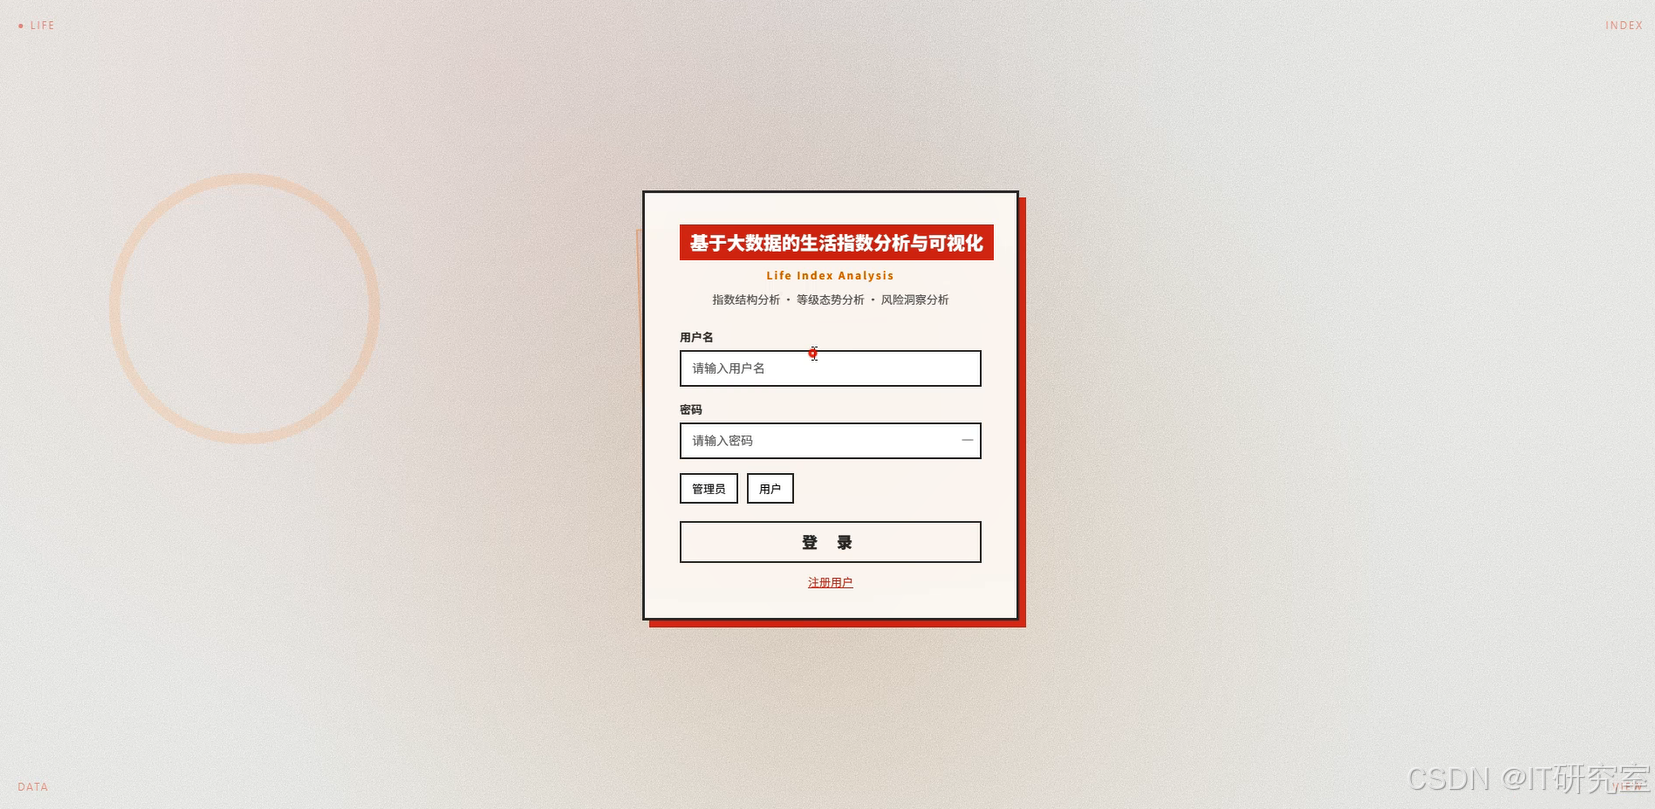
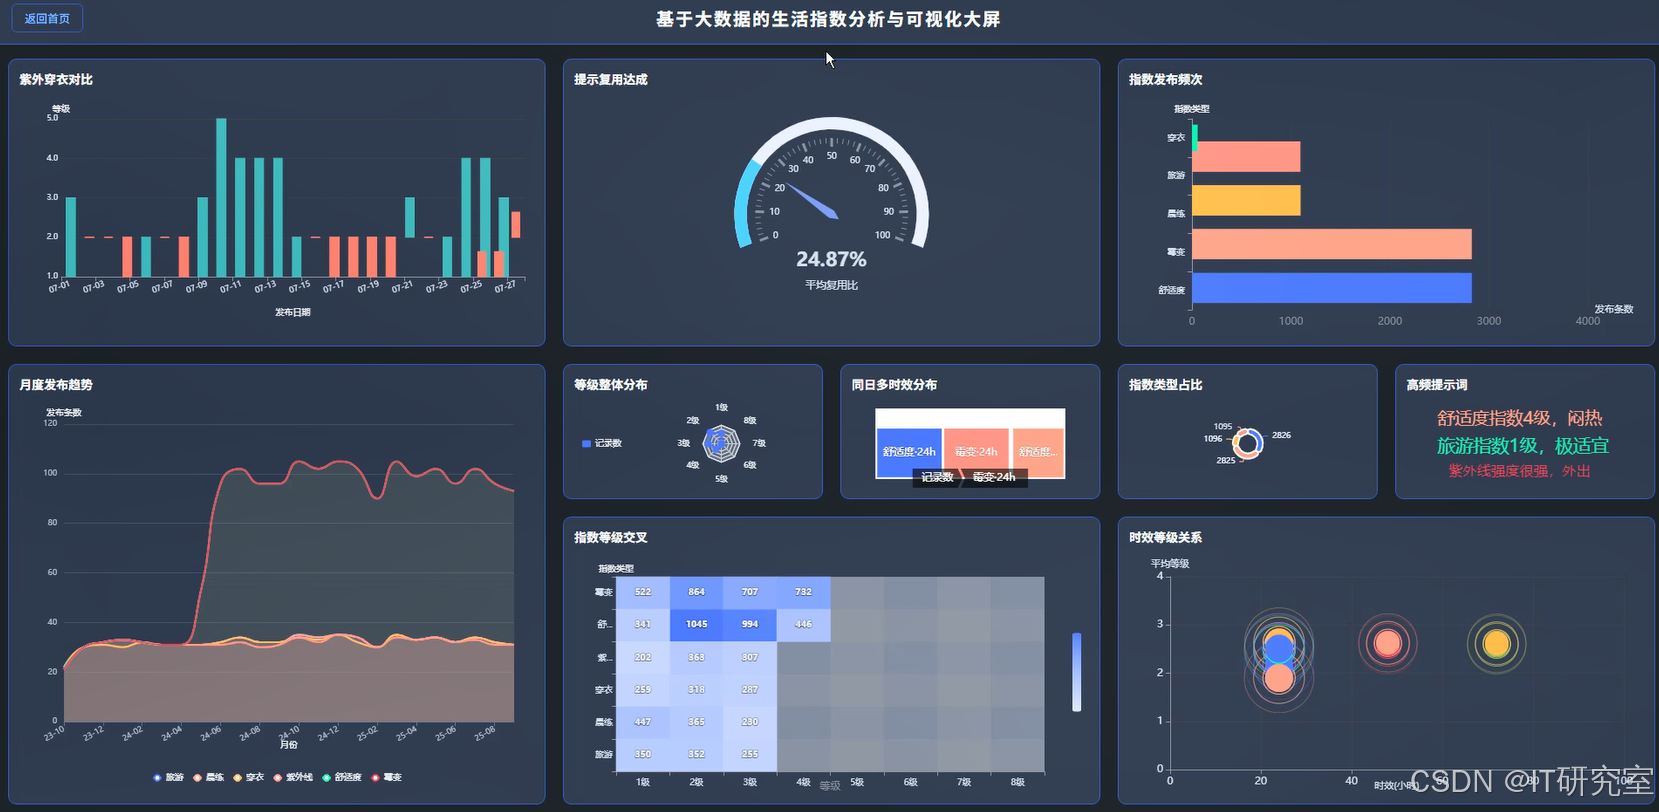
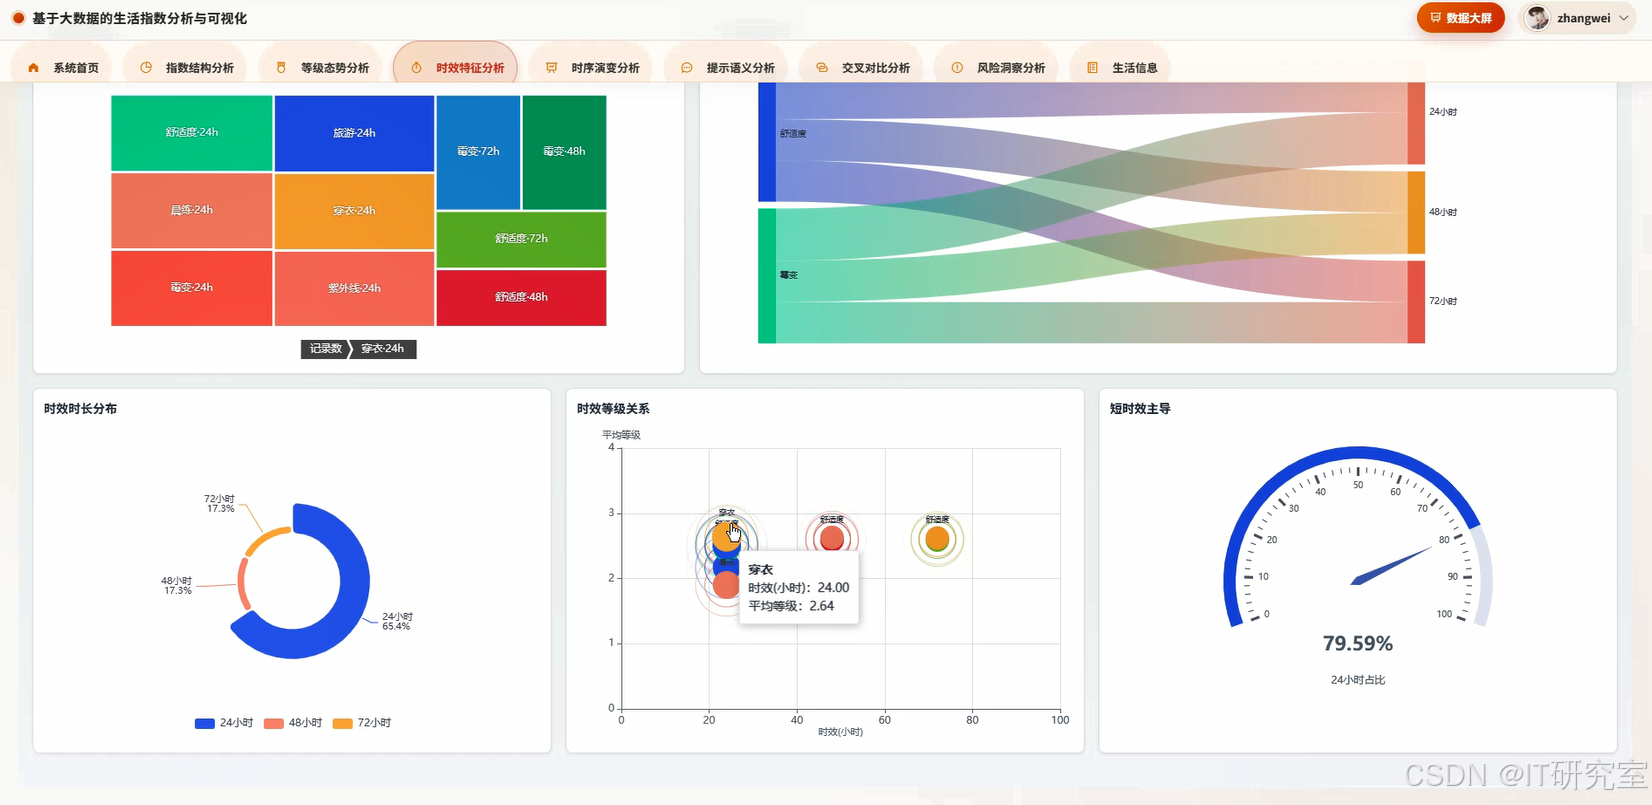
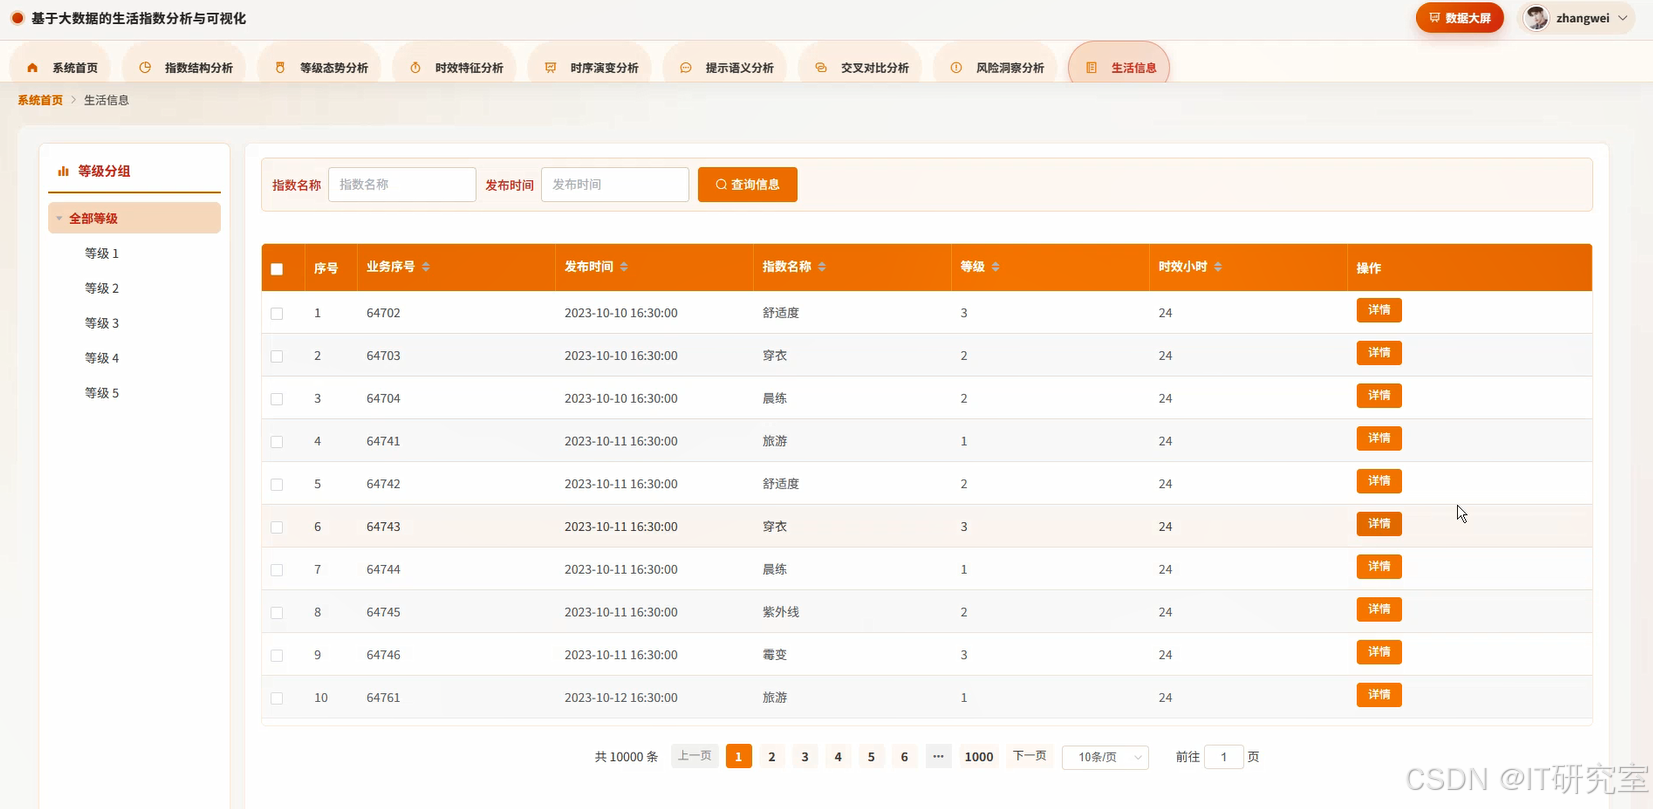
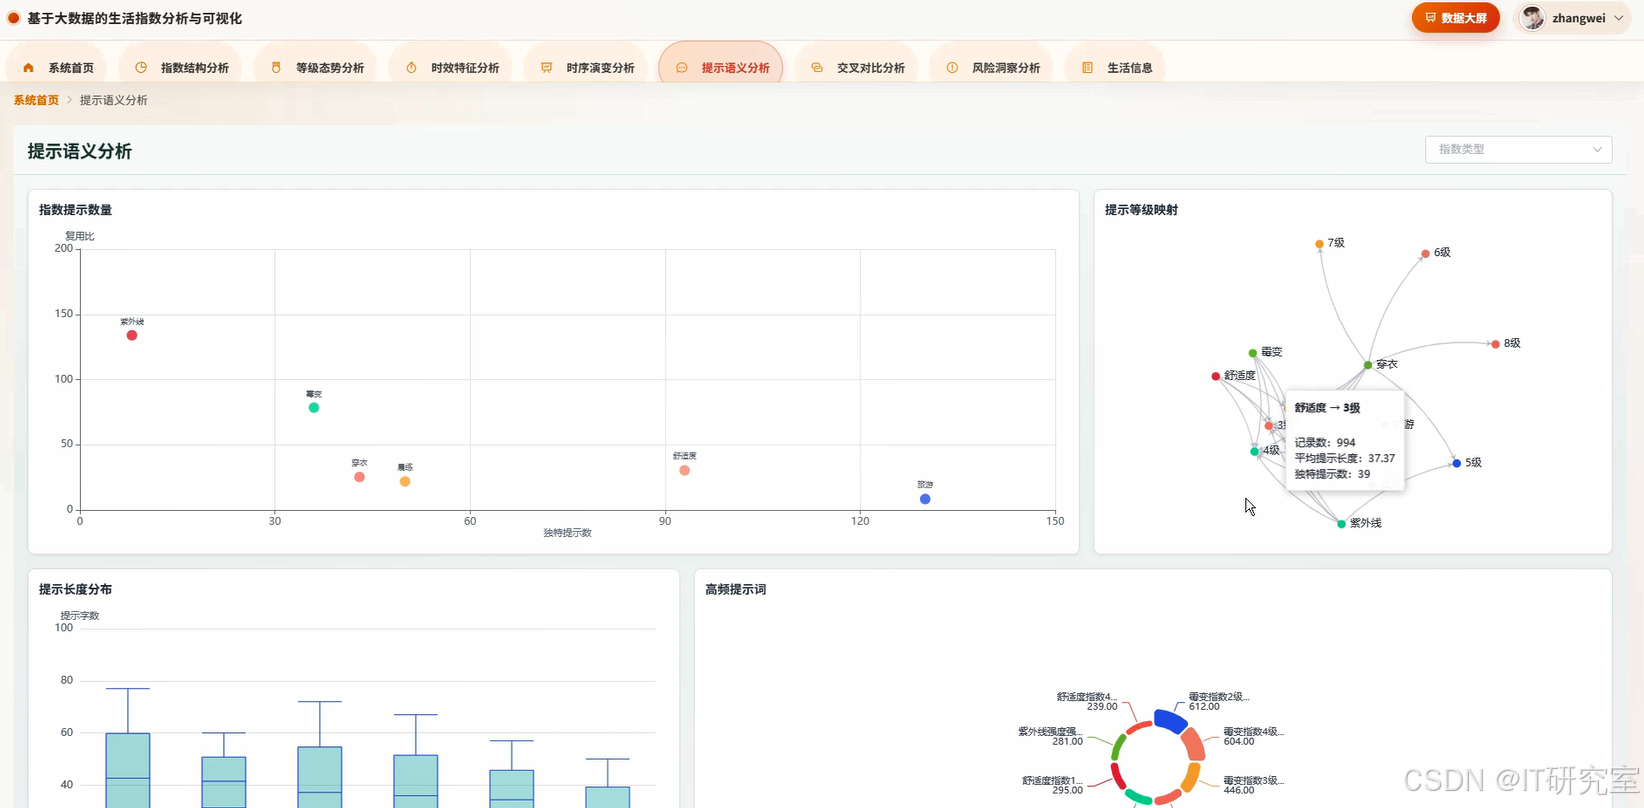
- 基于大数据的生活指数分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, when, avg, sum as spark_sum, date_format, to_date, desc, row_number
from pyspark.sql.window import Window
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from .models import LifeIndexData, LifeIndexResult
import pandas as pd
import numpy as np
import json
spark = SparkSession.builder.appName("LifeIndexAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def index_structure_analysis(request):
    if request.method != "POST":
        return JsonResponse({"code": 405, "msg": "请求方式不正确"})
    try:
        params = json.loads(request.body)
        start_date = params.get("startDate")
        end_date = params.get("endDate")
        region_code = params.get("regionCode")
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/life_index_db").option("dbtable", "life_index_data").option("user", "root").option("password", "123456").load()
        if start_date and end_date:
            df = df.filter((col("stat_date") >= start_date) & (col("stat_date") <= end_date))
        if region_code:
            df = df.filter(col("region_code") == region_code)
        total_count = df.count()
        if total_count == 0:
            return JsonResponse({"code": 200, "data": [], "msg": "暂无符合条件的数据"})
        structure_df = df.groupBy("index_type").agg(count("id").alias("type_count"), avg("index_value").alias("avg_value"), spark_sum("index_value").alias("sum_value"))
        structure_df = structure_df.withColumn("ratio", col("type_count") / total_count)
        structure_df = structure_df.orderBy(desc("type_count"))
        result_list = structure_df.collect()
        data = []
        for row in result_list:
            data.append({"indexType": row["index_type"], "typeCount": row["type_count"], "avgValue": round(float(row["avg_value"]), 2), "sumValue": round(float(row["sum_value"]), 2), "ratio": round(float(row["ratio"]) * 100, 2)})
        LifeIndexResult.objects.filter(result_type="index_structure").delete()
        for item in data:
            LifeIndexResult.objects.create(result_type="index_structure", result_key=item["indexType"], result_value=json.dumps(item, ensure_ascii=False))
        return JsonResponse({"code": 200, "data": data, "msg": "指数结构分析完成"})
    except Exception as e:
        return JsonResponse({"code": 500, "msg": "指数结构分析失败:" + str(e)})
def time_series_evolution_analysis(request):
    if request.method != "POST":
        return JsonResponse({"code": 405, "msg": "请求方式不正确"})
    try:
        params = json.loads(request.body)
        index_type = params.get("indexType")
        region_code = params.get("regionCode")
        start_date = params.get("startDate")
        end_date = params.get("endDate")
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/life_index_db").option("dbtable", "life_index_data").option("user", "root").option("password", "123456").load()
        if index_type:
            df = df.filter(col("index_type") == index_type)
        if region_code:
            df = df.filter(col("region_code") == region_code)
        if start_date and end_date:
            df = df.filter((col("stat_date") >= start_date) & (col("stat_date") <= end_date))
        df = df.withColumn("stat_day", to_date(col("stat_date"), "yyyy-MM-dd"))
        time_df = df.groupBy("stat_day", "index_type").agg(avg("index_value").alias("avg_value"), count("id").alias("data_count"))
        window_spec = Window.partitionBy("index_type").orderBy("stat_day")
        time_df = time_df.withColumn("prev_value", lag("avg_value", 1).over(window_spec))
        time_df = time_df.withColumn("change_rate", when(col("prev_value").isNull(), 0).otherwise((col("avg_value") - col("prev_value")) / col("prev_value")))
        time_df = time_df.orderBy("stat_day", "index_type")
        result_list = time_df.collect()
        data = []
        for row in result_list:
            data.append({"statDate": str(row["stat_day"]), "indexType": row["index_type"], "avgValue": round(float(row["avg_value"]), 2), "dataCount": row["data_count"], "changeRate": round(float(row["change_rate"]) * 100, 2) if row["change_rate"] is not None else 0})
        return JsonResponse({"code": 200, "data": data, "msg": "时序演变分析完成"})
    except Exception as e:
        return JsonResponse({"code": 500, "msg": "时序演变分析失败:" + str(e)})
def risk_insight_analysis(request):
    if request.method != "POST":
        return JsonResponse({"code": 405, "msg": "请求方式不正确"})
    try:
        params = json.loads(request.body)
        threshold = params.get("threshold", 80)
        region_code = params.get("regionCode")
        index_type = params.get("indexType")
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/life_index_db").option("dbtable", "life_index_data").option("user", "root").option("password", "123456").load()
        if region_code:
            df = df.filter(col("region_code") == region_code)
        if index_type:
            df = df.filter(col("index_type") == index_type)
        risk_df = df.withColumn("risk_level", when(col("index_value") >= threshold, "高风险").when((col("index_value") >= threshold * 0.7) & (col("index_value") < threshold), "中风险").otherwise("低风险"))
        risk_count_df = risk_df.groupBy("region_code", "index_type", "risk_level").agg(count("id").alias("risk_count"), avg("index_value").alias("avg_risk_value"))
        risk_count_df = risk_count_df.orderBy(desc("risk_count"))
        high_risk_df = risk_df.filter(col("risk_level") == "高风险").groupBy("region_code").agg(count("id").alias("high_count"), avg("index_value").alias("high_avg_value"))
        high_risk_list = high_risk_df.collect()
        risk_list = risk_count_df.collect()
        data = {"riskDistribution": [], "highRiskRegion": []}
        for row in risk_list:
            data["riskDistribution"].append({"regionCode": row["region_code"], "indexType": row["index_type"], "riskLevel": row["risk_level"], "riskCount": row["risk_count"], "avgRiskValue": round(float(row["avg_risk_value"]), 2)})
        for row in high_risk_list:
            data["highRiskRegion"].append({"regionCode": row["region_code"], "highCount": row["high_count"], "highAvgValue": round(float(row["high_avg_value"]), 2)})
        return JsonResponse({"code": 200, "data": data, "msg": "风险洞察分析完成"})
    except Exception as e:
        return JsonResponse({"code": 500, "msg": "风险洞察分析失败:" + str(e)})
五、系统视频
基于大数据的生活指数分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的生活指数分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇