Agent 洗冤集录:前缀缓存 ------ MCP 排序问题,如何影响模型调用的延迟与成本
系列引言
《洗冤集录》是南宋宋慈汇集前人验尸经验,并结合自身刑狱实践写成的法医学著作。
"告状切不可信,须是详细检验,务要从实。"
书中还反复强调亲自检验、多方求证:
"不可避臭恶......须是躬亲诣尸首地头......须是多方体访,务令参会归一,切不可凭一、二人口说,便以为信。"
「Agent 洗冤集录」取名于此,借的是这份重检验、重实据的态度,也提醒自己:少些浮躁,把事情查清楚再下结论。
作为 Agent Harness 的开发/维护者,我们收到的用户反馈,往往可以归结为两个字:慢(性能问题)、笨(能力问题)。而在我们的排查经验中,这些问题的原因,多数落在 Harness 的设计或实现 bug 上。
- 上下文遗漏、工具结果传递错误、状态流转异常,都可能表现为 Agent 的"笨";
- 重复执行、缓存失效、轮次设计不合理,则可能表现为"慢"。
很多时候,改善 Agent 的能力与性能,做的其实是修复这些具体的 bug。
用户的感受是排查的起点,原因则需要逐项检验:模型实际收到了什么,工具究竟返回了什么,系统又如何处理这些结果。
这个系列记录这些排查与修复,从原始请求、日志和代码出发,用实验验证推断。借用"洗冤"之名,就是希望对 Agent 的每一次归因,都能拿出可复查的证据,也能说清背后的原理。
从 MCP 排序开始
Agent 一慢,我们很容易先怀疑模型:是不是推理太重、上下文太长?再看不断累积的输入 tokens,似乎"又慢又贵"就是复杂任务的必然代价。
但有时,让 Agent 多花时间、多算一遍旧内容的,只是一段不起眼的拼接代码。
我们就遇到了这样一个 bug:接入 MCP 后,运行框架从 Go map 中取出服务说明,拼进 system prompt。说明一字没改,排列顺序却可能每次都变。 对人来说,这几段话先读哪段都差不多;对依赖相同前缀的提示缓存来说,这次重排却会影响后面整段历史的复用。
在一个真实续跑样本的六组配对测量中,我们对照了两种请求:保留原有重排,以及固定服务说明顺序。与保留重排相比,固定顺序时的缓存命中率从 39.01% 升到 99.15% ,单次模型调用的平均耗时从 7.31 秒降到 4.24 秒,减少约 42%。总输入 tokens 保持不变,更多旧内容得以直接复用计算;在缓存读取更便宜的计费方式下,这也意味着降低输入费用的机会。实际账单与完整任务耗时,还需要另行验证。
本篇从这个 MCP 排序问题出发,讨论前缀缓存如何影响模型调用的延迟与成本。排查始于一个很容易漏掉的问题:那些没有变化的内容,每次发给模型时,真的保持原样了吗?
为什么顺序会影响速度
Agent 通常需要多次调用模型才能完成任务。每次工具执行结束,运行框架会把结果追加到对话历史,再发送给模型。随着任务推进,请求中重复出现的内容也越来越多。
提示缓存可以复用这些重复内容的计算。OpenAI 的文档说明,这种复用要求提示具有完全一致的前缀。因此,固定指令适合放在前面,新消息追加在后面。
先看请求是怎样增长的。一轮用户对话可能包含多次模型调用:模型先要求读取文件,工具返回结果后,模型再继续回答;用户追问才开启下一轮对话。
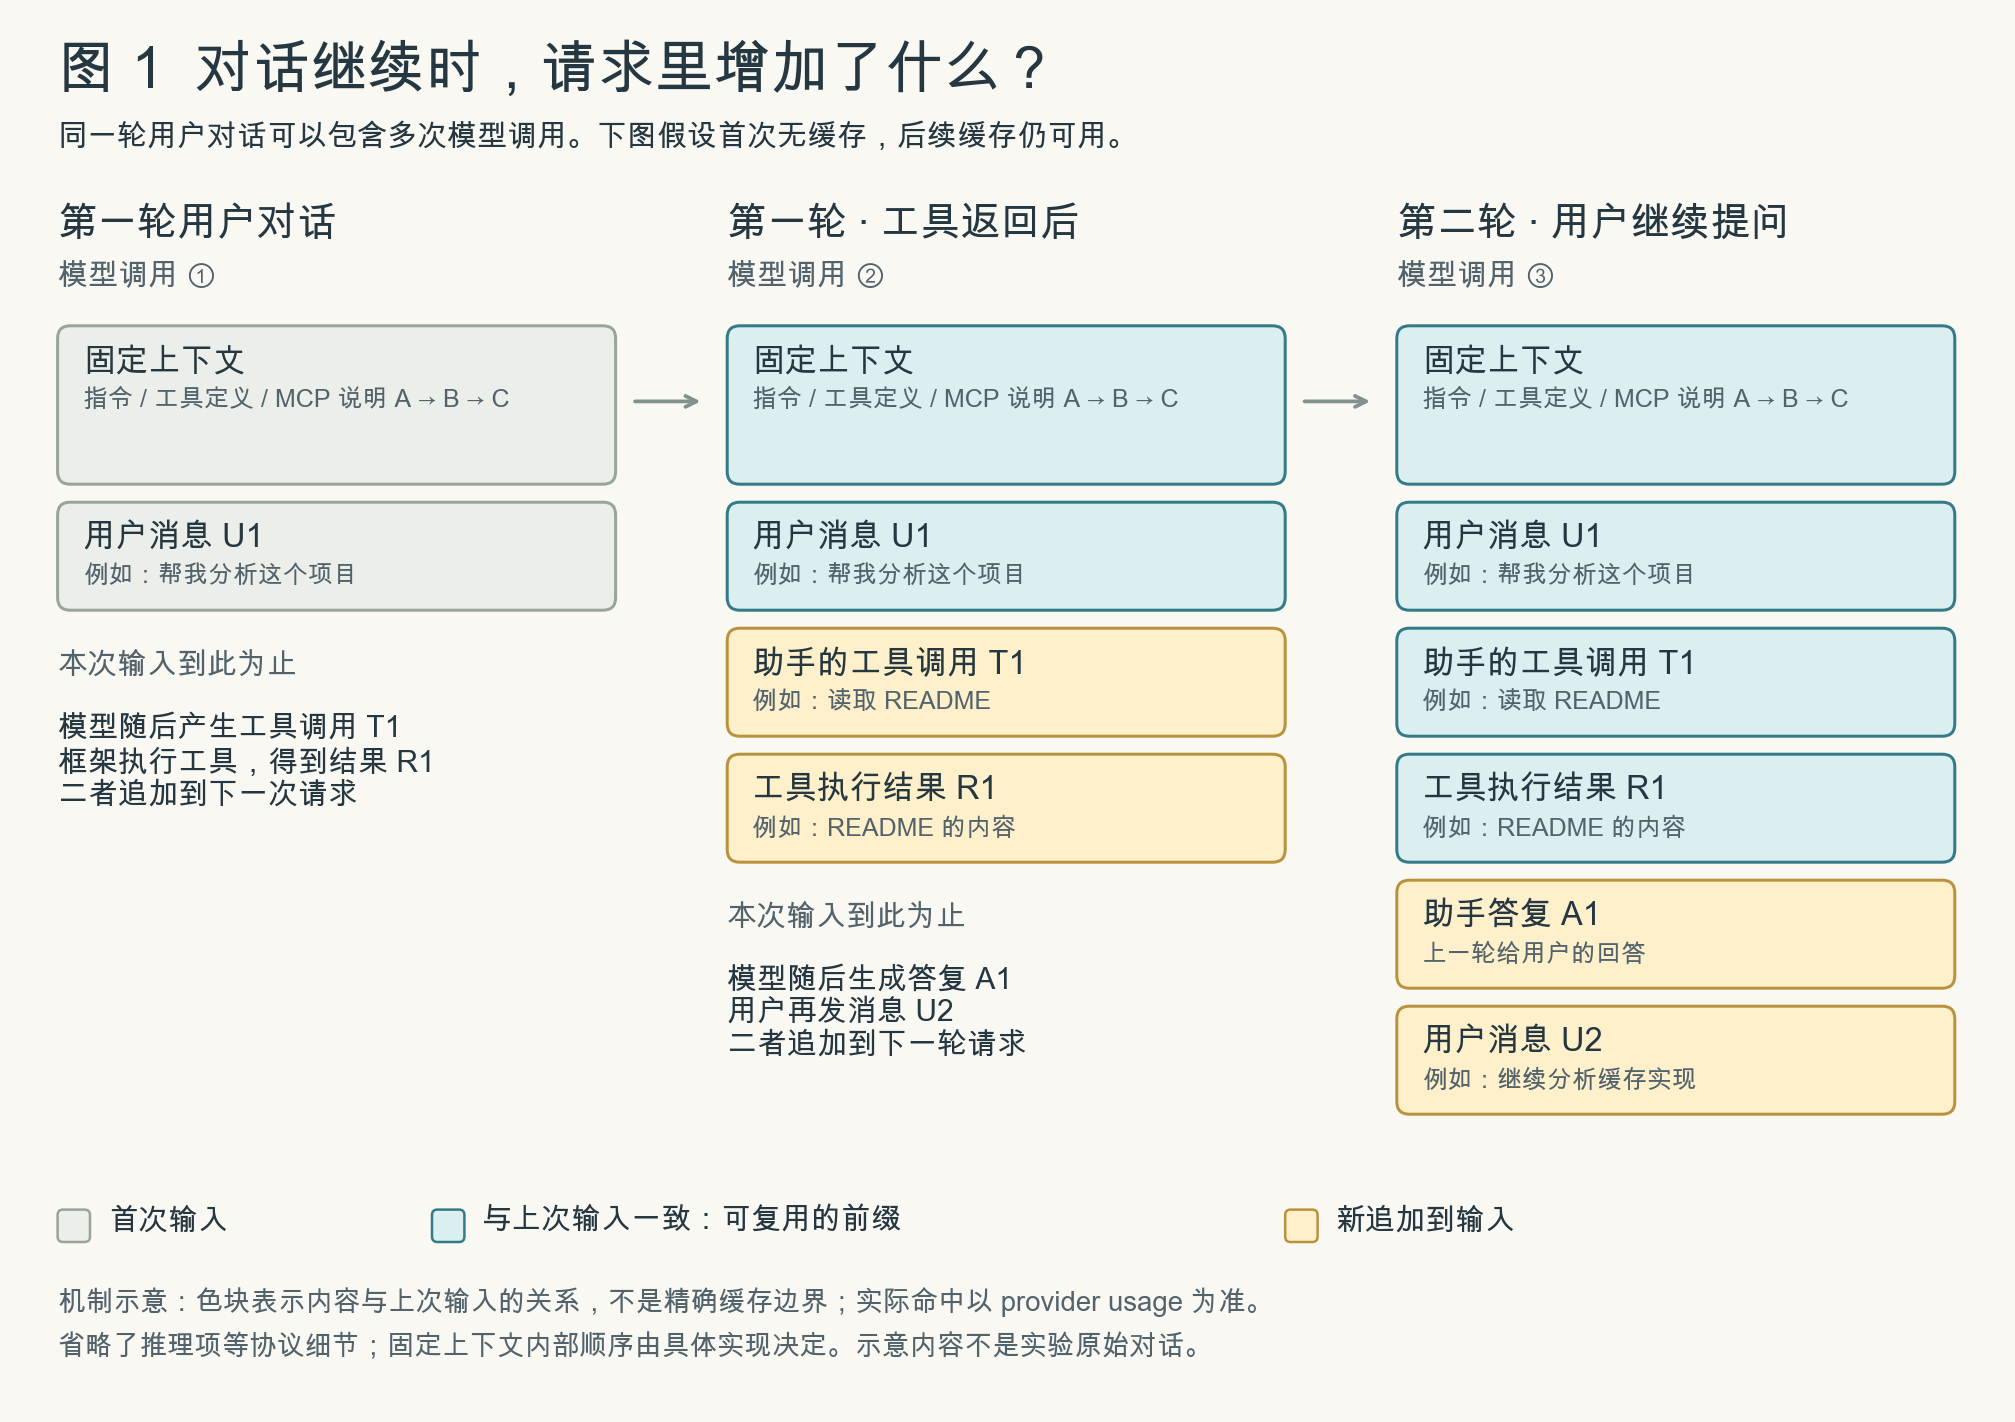
| 请求里的内容 | 第一轮:首次调用 | 第一轮:工具返回后 | 第二轮:用户追问 |
|---|---|---|---|
| 固定指令、工具定义、MCP 说明 | 首次带入 | 原样保留 | 原样保留 |
| 用户消息 U1 | 首次带入 | 原样保留 | 原样保留 |
| 助手工具调用 T1、工具结果 R1 | 尚未产生 | 追加到输入 | 原样保留 |
| 助手答复 A1、用户追问 U2 | 尚未产生 | 尚未产生 | 追加到输入 |
| 与上次请求的关系 | 假设尚无可用缓存 | 旧输入是新输入的前缀 | 旧输入仍是新输入的前缀 |
图中蓝色表示与上次输入一致的前缀,黄色表示新追加到输入的内容。它说明了缓存可以复用的原因;具体命中多少,还取决于缓存有效期、服务端处理等条件,需要读取实际 usage。图中是教学示例,省略了推理项等细节,并非下文实验的原始对话。
我们的排查受到《深入解析 Codex 智能体循环》的启发。文章提到,MCP 工具顺序不稳定曾导致缓存未命中。我们检查了自己的请求,发现了类似问题:MCP 服务说明的拼接顺序不稳定。
有意思的是,连 Codex 的开发者,也曾踩过同样的坑。相关修复 PR #2611 于 2025 年 8 月 25 日合并,到我们排查这个问题时,已过去一年多。那篇博客我其实很早就读过,却没能在自己的开发过程中认出这个问题------前人踩过的坑,看过了,也未必就能避开。把这次排查写下来,也是希望给后来者多留一个提醒:能少踩一个坑,就少踩一个,尽量不要让"后人复哀后人"。
用三个匿名服务表示,对比正常追加和顺序变化:
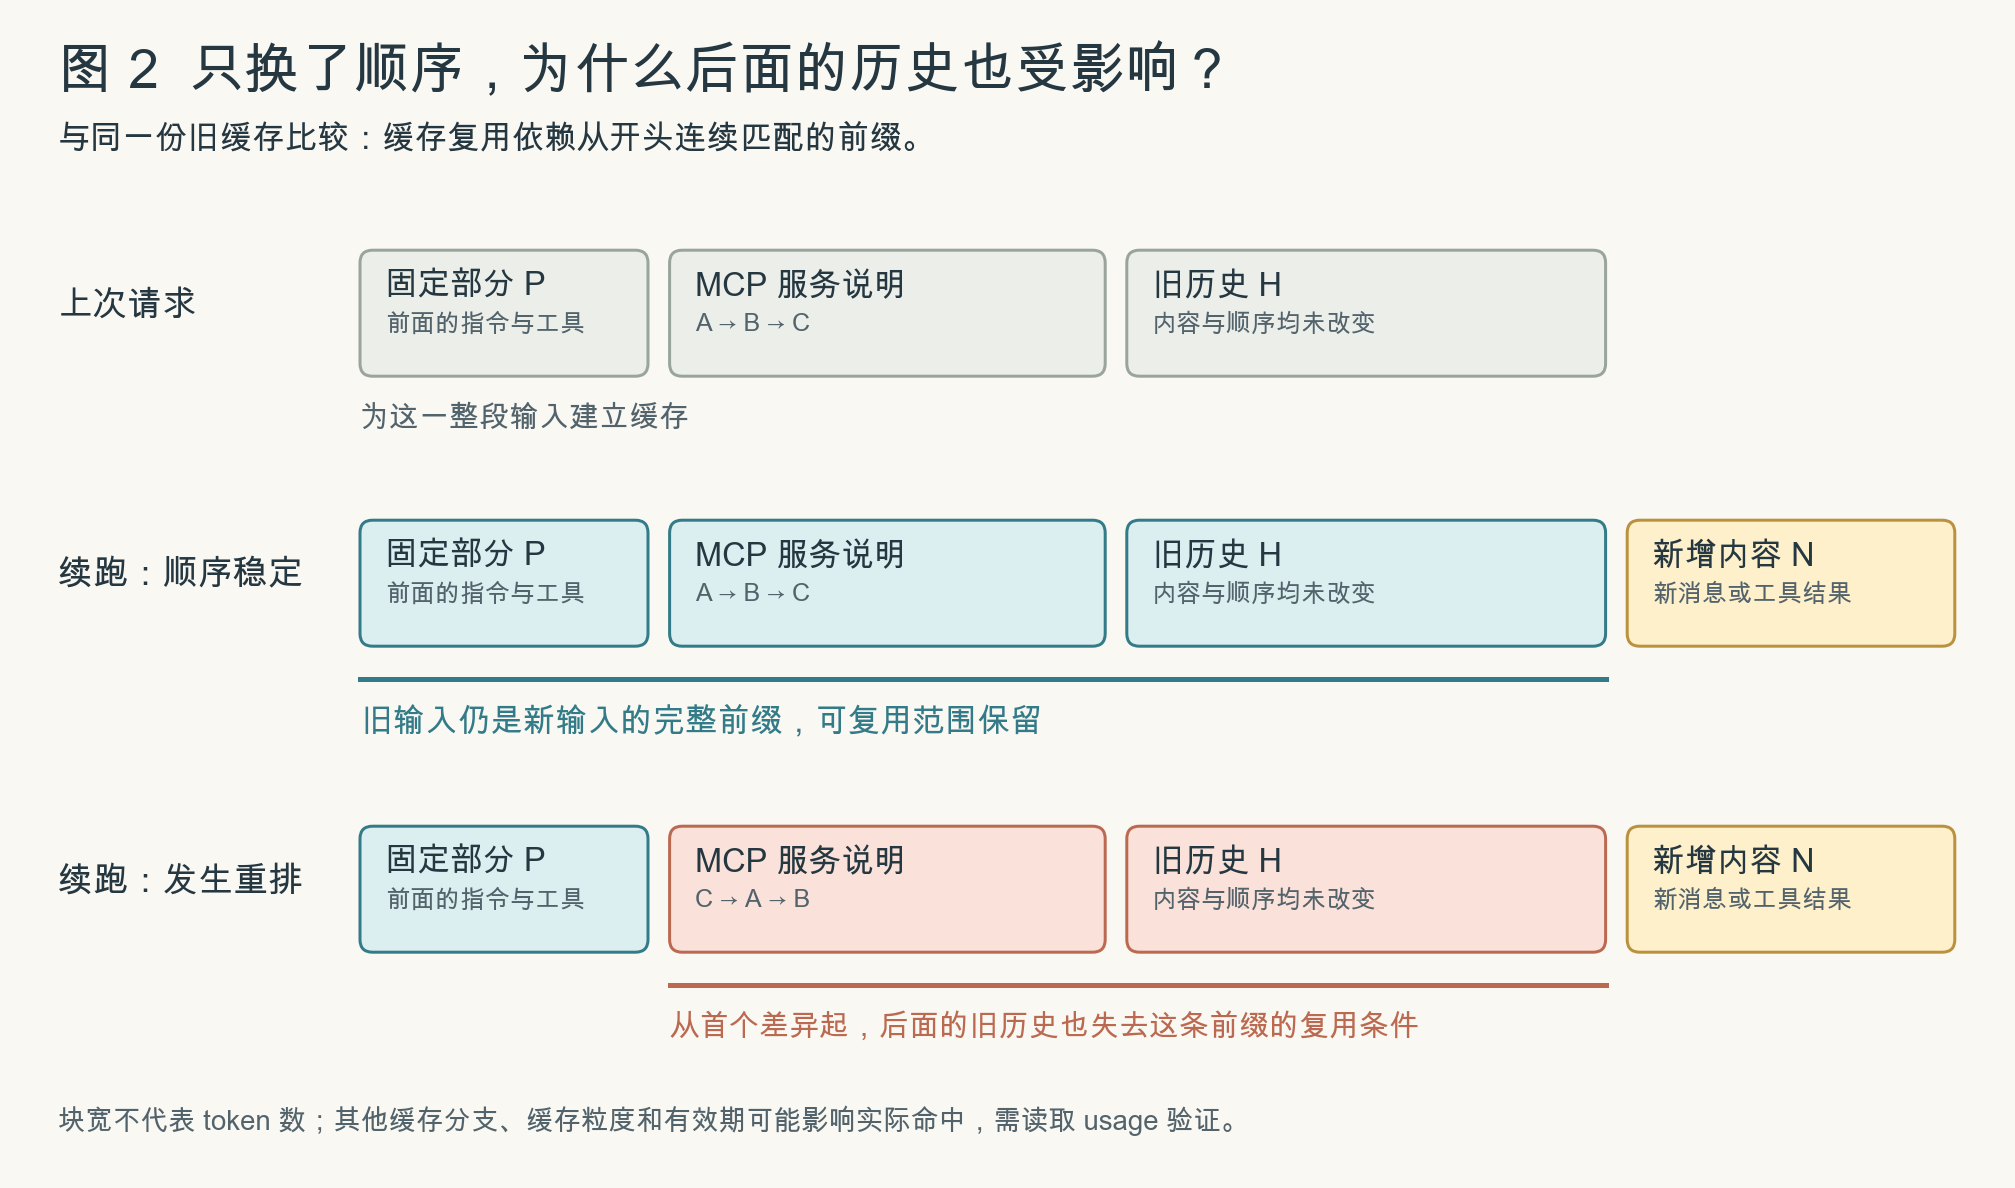
服务说明的内容没有变化,但它位于对话历史之前。这里一旦发生重排,后面的历史就不再拥有与上次相同的完整前缀。前面仍可能命中缓存,后面的复用却受到影响。
代码中的原因很简单:我们从 Go map 读取服务说明,然后直接拼接。map 的遍历顺序不固定,拼接函数也没有排序。
修复放在公共拼接入口:先复制有效的服务说明,再按服务名称排序。初始化和续跑都经过这个入口,因此同一组说明会生成相同文本。说明内容和工具权限保持原样。
这里也需要区分协议和实现。MCP 的 tools/list返回的是数组;原文提到的 Codex bug 发生在 Rust 实现中,修复是将内部 HashMap 收集的工具转成列表,再按完整工具名排序,见PR #2611。TypeScript 的原生 Map 则按插入顺序遍历,但不会自动按名称排序:如果每次按不同的异步完成顺序插入,最终顺序仍可能变化。需要保证的是相同内容形成相同序列。
用真实请求验证
在一份包含 99 次请求的会话日志中,我们发现了 32 次这样的纯顺序变化。随后选择其中一次续跑做实验:工具始终是 41 个,历史从 76 条追加到 79 条,变化的是一段 276 字符的 MCP 服务说明。
实验使用 qwen3.8-max 和现有网关,比较"保留重排"与"固定顺序"两组。除顺序和用于隔离两组缓存的标记外,工具、历史和模型参数保持一致。
我们交替运行了 6 组配对实验,共 24 次真实调用:12 次预热、12 次测量。每组先发送前一轮输入建立缓存,再测量续跑请求。输出上限统一为 64 tokens,业务工具没有实际执行。
下表只统计测量调用,每种方案各 6 次,数值为每次调用的平均值:
| 指标 | 顺序变化 | 固定顺序 | 变化 |
|---|---|---|---|
| 总输入 tokens | 62,998 | 62,998 | 不变 |
| 缓存读取 tokens | 24,576 | 62,464 | 增加 37,888 |
| 未缓存输入 tokens | 38,422 | 534 | 减少 98.61% |
| 缓存命中比例 | 39.01% | 99.15% | 增加 60.14 个百分点 |
| 平均首个推理片段时间 | 5.896 秒 | 2.769 秒 | 减少 53.03% |
| 平均模型调用耗时 | 7.311 秒 | 4.241 秒 | 减少 41.99% |
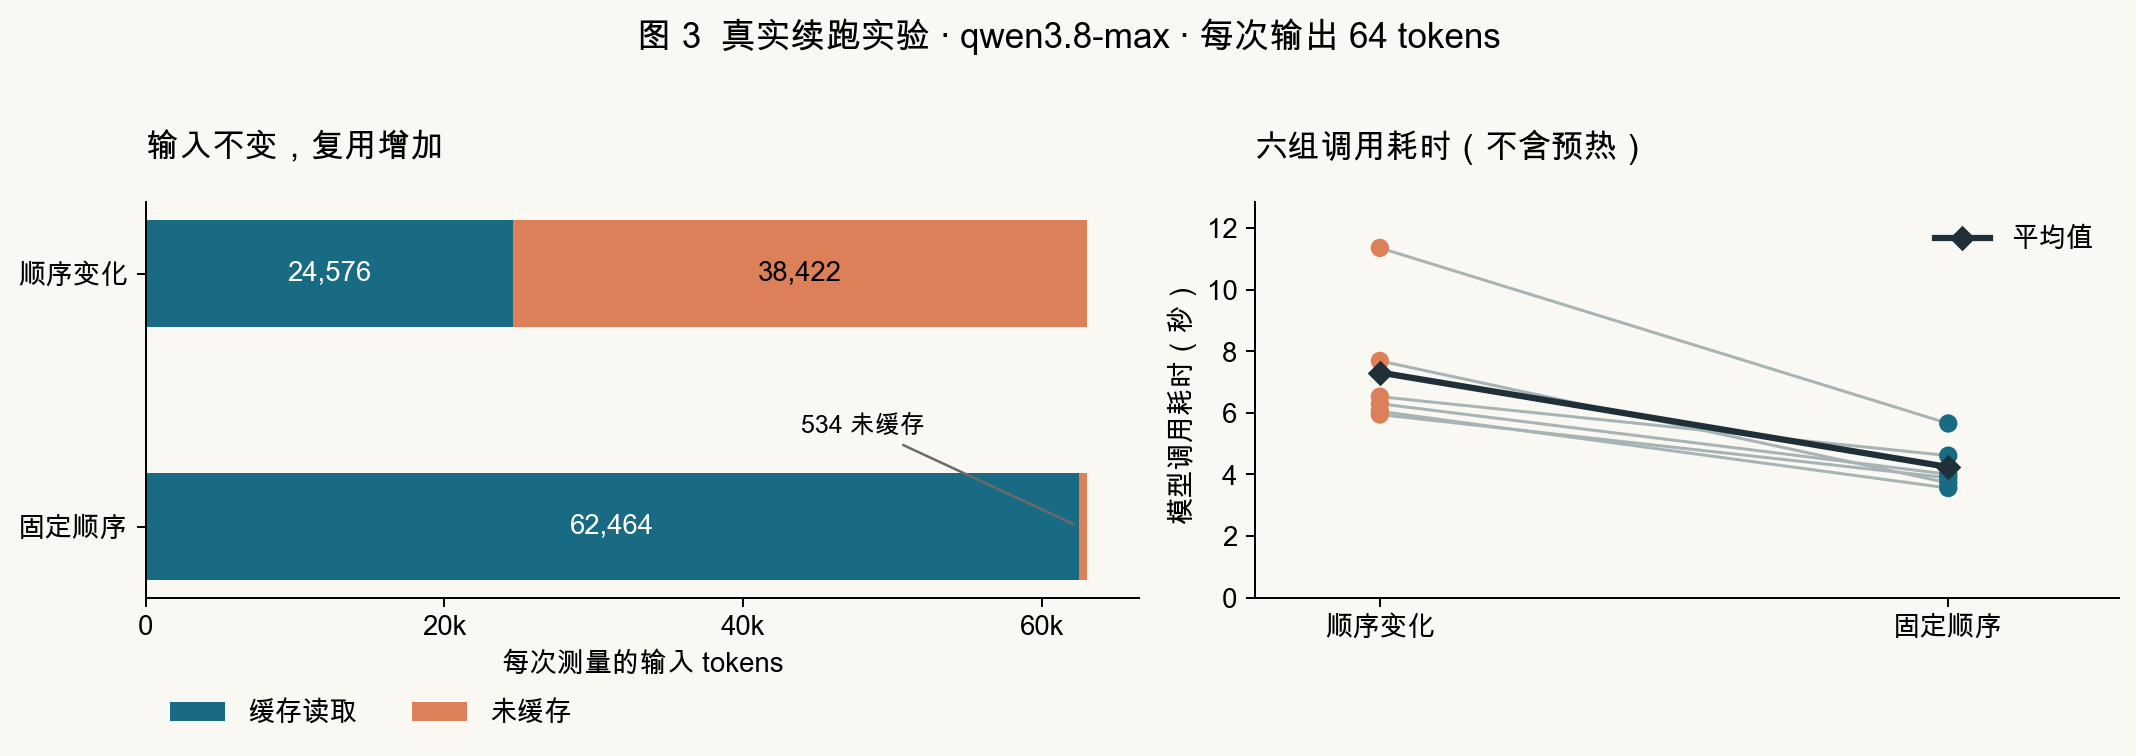
六组实验中,固定顺序后的调用耗时都更短,平均减少 3.07 秒。
这里需要区分两个数字:总输入没有减少;每次少了 37,888 个未缓存输入 tokens。 请求仍然包含完整历史,只是更多内容可以复用已有计算。
表中的"首个推理片段"是模型返回的 thinking_delta,不等于用户看到第一段正文的时间。耗时结果也只覆盖这次长历史、短输出的模型调用,不能直接推导为完整任务或所有用户都快 42%。
缓存命中的输入也更便宜
缓存还会影响输入费用。下面以 2026-09-29 核验的部分 GPT、Claude 型号为例,并列出本次 Eval 使用的 Qwen 型号。单位为美元 / 百万输入 tokens:
| 模型 | 普通输入 | 缓存读取 | 命中部分单价降低 |
|---|---|---|---|
| Qwen3.8-Max(本次 Eval) | $2.00 | $0.25 | 87.5% |
| GPT-6 Astra | $10.00 | $1.00 | 90% |
| GPT-6 Sol | $2.00 | $0.20 | 90% |
| Claude Fable 5.1 | $10.00 | $0.25 | 97.5% |
| Claude Opus 5.5 | $4.00 | $0.20 | 95% |
| Claude Sonnet 5 | $2.00 | $0.20 | 90% |
报价口径:Qwen取新加坡国际部署的隐式缓存价;GPT取 Standard 短上下文档;Claude取默认全球路由标准价。不含 Batch、加速或地域附加费。
读取便宜,写入也要算:GPT-6 的缓存写入按普通输入单价的 1.25 倍 计费;Claude的 5 分钟缓存写入为 1.25 倍 ,1 小时为 2 倍。这是写入 tokens 的适用单价,不是在普通输入费用上再加同额费用。
这也解释了为什么总输入 tokens 不变,费用仍可能下降:更多输入按缓存价格计费。但上表是命中部分的输入单价降幅,整个请求还要算未缓存输入、缓存写入及输出费用。本次实验经过内部网关,公开报价不代表该网关的实际账单;GPT、Claude 也未参与上面的速度实验。
对 Agent 开发的启示
提示缓存是否有效,部分取决于运行框架如何组织输入。一个对人来说无关紧要的顺序变化,放在长历史之前,就可能让大量内容失去复用机会。
这次我们修复了 MCP 服务说明的排序,并用回归测试检查:不同排列生成相同文本,真实内容变化仍能反映到提示中。接下来,线上验证还需要覆盖工具执行、长输出和多轮任务,观察用户实际等待时间。
反求诸己。 把原因归到模型上,很容易让排查止于"这是模型的问题,Agent 开发者控制不了"。但看似模型的性能或能力不足,也可能是 Agent 自身的 bug:上下文组织不当、工具结果传递错误、执行流程反复,都在开发者能检查、能修复的范围内。这次的缓存失效就是一例。先核对实际请求、工具结果和执行链路,再判断哪些是实现缺陷,哪些才是模型的边界。
我们增强了 Cache Token Trace 的实现,也把这次的两点收获写进了仓库的 AGENTS.md,作为后续开发约定。
修改 system prompt 时,同时考虑缓存影响。 除了判断内容是否必要,还要检查它是否经常变化、是否会改变已有前缀。同一内容应保持稳定顺序,动态信息在语义和权限允许时追加。需要更新的约束仍应正常更新,缓存不能优先于正确性。
把输入缓存作为 Agent 的重要性能指标。 评测时同时记录总输入、cached input tokens、未缓存输入,以及缓存命中率(缓存读取 tokens / 总输入 tokens),再结合响应耗时判断收益。这样才能区分"输入变少了"和"相同输入复用了更多计算",也能更早发现前缀变化造成的性能退化。
实验说明:2026-09-17,单一真实续跑样本;先做 2 组试验,再扩至 6 组。平均调用耗时减少量的配对 bootstrap 95% 区间为 2.136--4.247 秒。tokens 取自网关原始 usage,24 次调用的请求、输出与耗时均已留存并校验。前期 mock 只用于筛查问题,未用于上表。代码修复与这组上线前实验分别记录,线上效果尚待验证。
参考:OpenAI《深入解析 Codex 智能体循环》;OpenAI Prompt caching。文中性能数据来自我们的 Qwen 链路实测。