PCIe Switch Fabric
- [1. 引言:为什么需要 Fabric](#1. 引言:为什么需要 Fabric)
- [2. 核心概念:NT2.0 与 NTB 的关系](#2. 核心概念:NT2.0 与 NTB 的关系)
-
- [2.1 NTB(Non-Transparent Bridging)基础](#2.1 NTB(Non-Transparent Bridging)基础)
- [2.2 NT2.0:第二代非透明桥接](#2.2 NT2.0:第二代非透明桥接)
- [3. 三层地址空间模型:物理域、全局域与本地域](#3. 三层地址空间模型:物理域、全局域与本地域)
-
- [3.1 物理域(Physical Domain)](#3.1 物理域(Physical Domain))
- [3.2 全局域(Global Domain)](#3.2 全局域(Global Domain))
- [3.3 本地域(Local Domain)](#3.3 本地域(Local Domain))
- [3.4 三层模型的协同](#3.4 三层模型的协同)
- [4. Fabric 数据通路详解:Address Trap 与 DLUT 机制](#4. Fabric 数据通路详解:Address Trap 与 DLUT 机制)
-
- [4.1 Address Trap](#4.1 Address Trap)
- [4.2 DLUT(Domain Lookup Table,域查找表)](#4.2 DLUT(Domain Lookup Table,域查找表))
- [4.3 Hardware Traps:地址转换的执行者](#4.3 Hardware Traps:地址转换的执行者)
- [5. 跨域数据包生命周期:一次完整的 P2P 传输](#5. 跨域数据包生命周期:一次完整的 P2P 传输)
-
- [5.1 传输前准备(控制面)](#5.1 传输前准备(控制面))
- [5.2 数据面传输流程](#5.2 数据面传输流程)
- [5.3 关键路径总结](#5.3 关键路径总结)
- [6. 管理与控制:SM API 与硬件协同](#6. 管理与控制:SM API 与硬件协同)
- [7. 技术边界与限制](#7. 技术边界与限制)
-
- [7.1 错误报告缺失](#7.1 错误报告缺失)
- [7.2 配置一致性要求](#7.2 配置一致性要求)
- [7.3 并发安全限制](#7.3 并发安全限制)
- [8. 总结](#8. 总结)
1. 引言:为什么需要 Fabric
在传统的 PCIe 架构中,系统被限制为单一的树状拓扑(Root Complex → Switch → Endpoint)。这种结构存在根本性局限:
- 单主机限制:一个 PCIe 树只能有一个 Root Complex(Host),无法实现多主机对等通信
- 地址空间冲突:两个独立 Host各自枚举设备时,可能分配相同的地址或 BDF,导致冲突
- P2P 壁垒:不同子树间的 Endpoint(EP)无法直接通信,必须经过Host 中转,造成延迟和带宽浪费
Atlas2 Fabric 是 Broadcom 提出的解决方案:通过将多个物理上独立的 Atlas2 交换机互联,形成一个可编程的 PCIe 交换网络。这不仅支持传统的主机-设备通信,更实现了两大突破:
NT2.0 over Fabric: 不同 Host 之间的直接通信(Host-to-Host)
Peer-to-Peer overFabric: 跨交换机的 EP 直接数据交换(如 GPU 间 DMA)
2. 核心概念:NT2.0 与 NTB 的关系
2.1 NTB(Non-Transparent Bridging)基础
NTB 是 PCIe 标准中的一种桥接技术,用于解决多主机互连的根本问题。
在透明桥(Transparent Bridge)中,Host 可以枚举并访问下游所有设备;但在多主机场景下,如果两个 Host 通过透明桥相连,它们会同时尝试枚举对方,导致地址冲突和系统崩溃。
NTB 通过非透明方式解决此问题:
每个 Host 将对方视为一个Endpoint 设备,而非可枚举的桥
每个 Host 拥有独立的地址空间(LocalDomain),彼此隔离
通过特殊的 BAR(Base Address Register)映射和 Doorbell 机制实现受控的数据交换
2.2 NT2.0:第二代非透明桥接
NT2.0 是 Broadcom 在 NTB 基础上的第二代实现,深度集成于 Atlas2 芯片中。与传统 NTB 相比,NT2.0 实现了三大演进:
| 特性 | 传统 NTB | NT2.0 |
|---|---|---|
| 拓扑支持 | 点对点或简单级联 | 支持多交换机 Fabric 拓扑(Mesh、Dual Tree) |
| 管理接口 | 简单的寄存器读写 | 完整的 SM API(System Management API),支持动态配置 |
| 功能范围 | 仅 Host-to-Host | 同时支持 Host-to-Host 和跨域 P2P 管理 |
关键区别:NT2.0 不仅是数据通道,更是管理面代理。在 Atlas2 架构中,NT EP(Non-Transparent Endpoint)是 Host 访问芯片管理功能的入口,Host 通过 NT Driver 发送 SM API 来配置 Fabric 路由(详见第 6 节)。
3. 三层地址空间模型:物理域、全局域与本地域
理解 Atlas2 Fabric 的关键在于其三层的地址空间抽象。这解决了多主机环境下的寻址冲突问题。
3.1 物理域(Physical Domain)
定义: 单个 Atlas2 switch及其直连设备构成的硬件边界。
每个物理域拥有唯一的 Domain ID(如 Domain 1、Domain 2)
对应一个独立的 PCIe 子树,包含 Host Port、Fabric Port 和 Downstream Port
物理上通过 Fabric Link(通常为 Slimline线缆)与其他物理域互联
类比: 物理域如同一座拥有独立行政系统的城市,通过高速公路(Fabric Link)与其他城市相连。
3.2 全局域(Global Domain)
定义: 由 Atlas2 内部 ARM 处理器统一枚举和维护的 跨物理域统一地址空间。
形成过程(Synthetic Mode):
Atlas2 内部 ARM(mCPU)首先枚举所有下游设备,包括其他switch后的设备
ARM 为每个设备分配全局地址(如3400_0000h)和全局 BDF(如 16:0.0)
构建覆盖所有物理域的合成树(Synthetic Tree),即全局域
关键特性:
**跨域唯一性:**无论设备连接到哪个物理域,其全局地址和 ID 在整个 Fabric 中唯一
P2P 通信基准: EP 间直接通信使用全局地址作为目标
对 Host 透明: Host 操作系统 unaware of 全局域的存在
类比: 全局域如同世界地图,为每个城市(物理域)中的建筑(EP)分配全球唯一的 GPS 坐标。
3.3 本地域(Local Domain)
定义: 单个 Host 操作系统看到的地址空间,是 Host 标准 PCIe 枚举的结果。
形成过程:
- ARM 完成全局枚举后,将合成树呈现给 Host
- Host 进行标准的系统枚举,形成自己的内存映射
- 分配本地地址(如 8400_0000h)和本地 BDF(如 3B:00.0)
关键特性:
域内有效:本地地址仅在当前 Host 的地址空间内有效
Host 视角:Host A 认为 GPU1 在 8400_0000h,Host B 认为 GPU2 在 CF00_0000h
边界清晰:Host Port(HP)是本地域与全局域的分界线
**类比:**本地域如同你手机中的城市地图,只显示本地街道,不包含其他城市的地理信息。
3.4 三层模型的协同
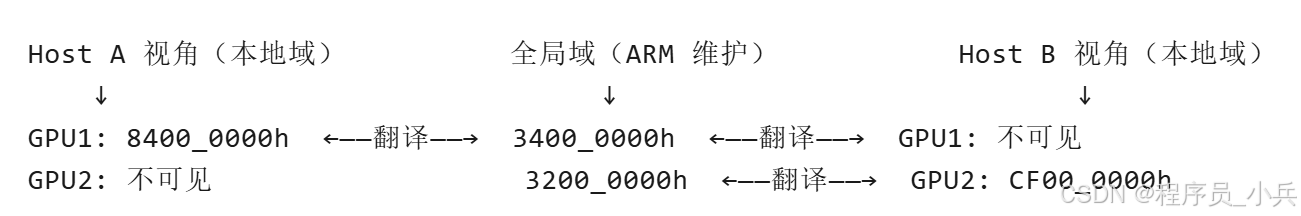
转换机制: 当数据包穿越 Host Port(HP)边界时,Atlas2 内部的Hardware Traps自动完成地址和 ID 的翻译。这个过程对软件完全透明,确保 Host 无需修改操作系统即可工作。
4. Fabric 数据通路详解:Address Trap 与 DLUT 机制
在 Fabric 中,跨域数据包的路由依赖两大硬件表项的协同工作。这是实现 P2P over Fabric 的核心。
4.1 Address Trap
功能定位:P2P 路由的开关, 决定数据包是否允许绕过 Host 直接跨域传输。
技术背景: PCIe 标准定义了 ACS(Access Control Service),默认情况下禁止下游端口(DSP)间的 P2P 路由,强制所有流量经过 Root Complex(Host)。这是为了安全性和一致性考虑,但阻碍了高性能 P2P 应用。
工作机制:
- 表项结构:每个 DSP 端口维护一组 Address Trap 表项,记录允许 P2P 的地址范围
- 匹配动作:当 DSP 收到数据包时,检查目标地址是否命中 Trap 表项
- 命中:数据包被重定向到 Fabric Port,绕过 Host
- 未命中:按默认路径发往 Host(或根据 ACS 规则丢弃)
配置特性 (通过 SM API):
Station/Index 定位:每个 Trap 通过"站点(端口号)+ 索引"唯一标识
重叠检测:添加时硬件检查地址范围是否重叠,防止路由歧义
权限控制:只有用户添加的 Trap 可删除,系统默认 Trap 不可修改
关键限制: 没有 Address Trap,P2P 路由永远被禁用。
4.2 DLUT(Domain Lookup Table,域查找表)
功能定位:跨域路由的地图, 决定数据包应该通过哪个 Fabric Port 发送到目标 Domain。
工作机制:
- 查询逻辑:当数据包需要跨域时,DLUT 根据目标 Domain ID 查询对应的出口 Fabric Port 编号
- 与 Choice 寄存器配合:每个 Station(端口)的 Choice 寄存器选择该端口关联的 Fabric Port,实现灵活的路径选择
4.3 Hardware Traps:地址转换的执行者
功能定位:在 Host Port 边界执行地址和 ID 的自动翻译。
转换内容:
地址转换:Local Address ↔ Global Address(如 8400_0000h ↔ 3400_0000h)
ID转换:Local BDF ↔ Global BDF(如 3B:00.0 ↔ 16:0.0)
执行时机:
数据包从 Host 进入 Fabric(Local → Global)
数据包从 Fabric 到达 Host(Global → Local)
纯 P2P 流量(EP 到 EP)通常只需 ID 转换,地址保持全局一致
5. 跨域数据包生命周期:一次完整的 P2P 传输
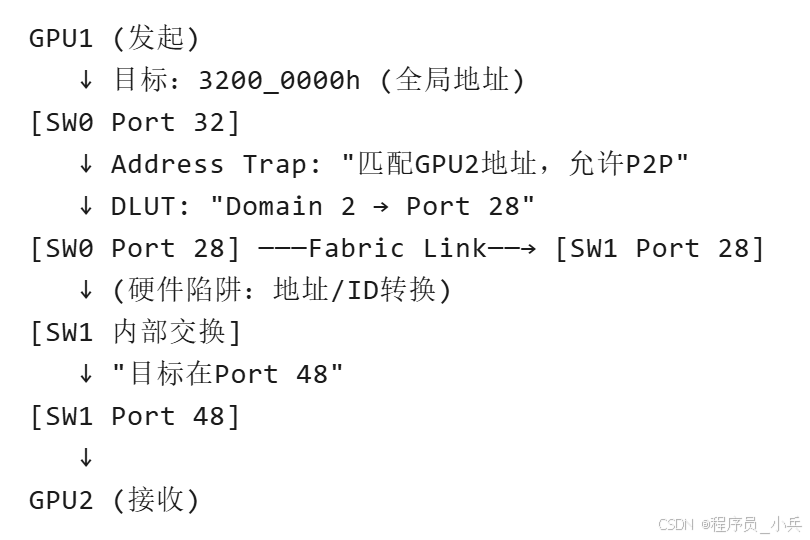
以 GPU1(Domain 1, Port 32)向 GPU2(Domain 2, Port 48)发起 DMA 写操作为例,详解数据包的完整旅程。
5.1 传输前准备(控制面)
Host 通过 SM API 完成以下配置:
- 配置 Address Trap:在 SW0 的 Port 32 上添加表项,允许目标地址 3200_0000h(GPU2 的 BAR0)的 P2P 流量
- 配置 DLUT:在 SW0 上设置 Domain 2 → Port 28 的映射;在 SW1 上设置 Domain 1 → Port 28 的映射(双向)
5.2 数据面传输流程
第一步:发起与入口检查
GPU1 生成 TLP 包,目标地址为全局地址 3200_0000h
数据包进入 SW0 的 Port 32(DSP)
Address Trap 检查:命中 GPU2 地址范围 → 触发 P2P 路由,绕过 Host A
第二步:路由决策
SW0 查询 DLUT:目标 Domain 2 → 出口为 Port 28(Fabric Port)
数据包被导向 Fabric Port,准备跨域
第三步:跨域传输与地址转换
数据包通过 Slimline 线缆到达 SW1 的 Port 28
硬件陷阱转换:在边界处完成必要的地址/ID 翻译(确保 Host B 的地址空间一致性)
第四步:出口投递
SW1 识别目标地址 3200_0000h 属于本地 Domain 2
内部交换矩阵将数据包导向 Port 48
数据包到达 GPU2,完成传输
全程无需 Host 介入: Host A 和 Host B 的 CPU 不参与数据搬运,实现了真正的硬件级 P2P。
5.3 关键路径总结
6. 管理与控制:SM API 与硬件协同
管理架构
Fabric 的可编程性通过 SM API(System Management API) 实现,提供 Inband 和 OOB 两种管理通道。
Inband 路径:
Host 上的客户应用通过 NT Driver 发送 SM API
NT Driver 提供透传机制,不解析 API 内容
数据包通过 NT EP 到达 Atlas2 内部的 SM API Handler
最终由硬件写入 Address Trap 和 DLUT 表项
OOB 路径:
BMC 通过 I2C 连接 Atlas2
使用 Scrutinylib(SL API)封装 SM API
适合带外管理,无需 Host操作系统参与
7. 技术边界与限制
7.1 错误报告缺失
Link Up/Down 事件:Fabric Link 的状态变化不会上报给 Host
AER(Advanced Error Reporting):跨域传输中的 PCIe 错误无法透传,排障困难
7.2 配置一致性要求
资源变更需重配:如果系统重新分配了 GPU 的 BAR 地址,必须重新编程对应的 Address Trap 和 DLUT
无自动发现:Atlas2 无法自动检测对端 Domain 的 Bus 号配置,必须由软件确保输入参数正确
7.3 并发安全限制
内存请求在途风险:添加/删除 Address Trap 时,如果目标地址范围内有未完成的内存请求,可能导致乱序执行或数据不一致
操作原子性:必须确保配置时目标地址范围无活动流量
8. 总结
Atlas2 Fabric 通过三层抽象(物理域/全局域/本地域)和两大机制(Address Trap/DLUT),将传统的 PCIe 树状结构扩展为可编程的多主机交换网络。
核心价值:
- NT2.0 解决了多主机互连的地址隔离问题,实现了 Host-to-Host 通信
- P2P over Fabric 打破了子树边界,使 GPU 等高性能设备能够跨交换机直接 DMA,绕过了 Host 瓶颈
- SM API 提供了灵活的控制面,支持动态配置路由规则
技术本质: 这是在 PCIe 物理层之上叠加了网络层路由功能(类似以太网的 VLAN 和路由表),通过硬件加速的地址转换(Hardware Traps)实现高效转发。虽然引入了网络的概念(Domain、路由表、拓扑),但底层传输仍是标准的 PCIe TLP,保留了 PCIe 的可靠性和性能特征。
这种架构特别适合 GPU 集群、分布式存储等需要大规模 P2P 通信的场景,在保持 PCIe 生态兼容的同时,实现了类似 InfiniBand 的交换能力。