摘要
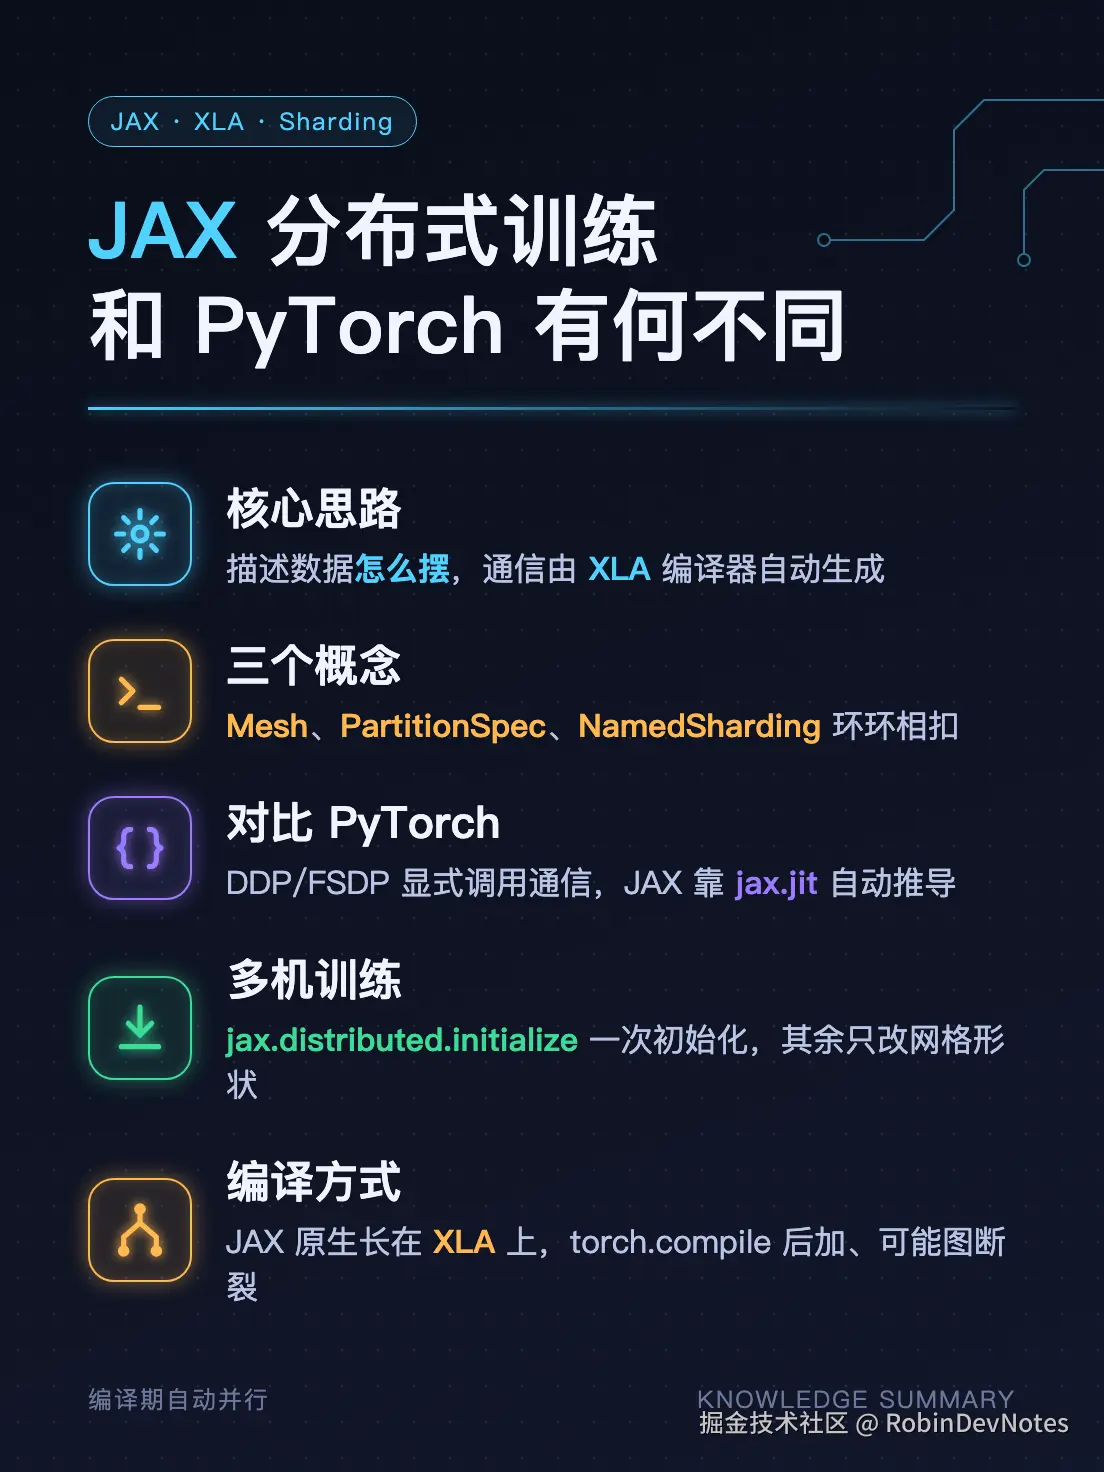
同样是"模型太大装不下、数据太多算不完",PyTorch 靠 DDP 和 FSDP 这两套显式的分布式 API 来解决,JAX 走的是另一条路:你只管把数据"该怎么摆"描述清楚,剩下的通信全部交给编译器 XLA 自动生成。这篇文章从 JAX 分布式训练最核心的几个概念讲起,边讲边对照 PyTorch 的思路,帮你搞清楚两者到底差在哪、什么时候该选哪个。
背景与问题
同一个问题,两种解法
无论用哪个框架,分布式训练要解决的问题都一样:要么数据太多,一张卡算得太慢;要么模型太大,一张卡的显存根本装不下参数、梯度和优化器状态。
PyTorch 的答案是两套边界清晰的工具:DDP 负责"数据并行"------每张卡存一份完整模型,各自算各自的数据,反向传播后把梯度加起来求平均;FSDP 负责"参数分片"------把参数、梯度、优化器状态切成小块分给各卡,要用到哪一层才临时拼回完整的那一层。这两套工具分别对应两个具体的 Python 类/函数,你要在代码里显式选择用哪一个、怎么包裹你的模型。
JAX 的答案不是"再造一套类似的 API",而是换了一个更底层的抽象。
JAX 为什么能换一条路走
这背后是两个框架编程模型的根本差异。
PyTorch 是命令式的:你一行行地写"算这个、更新那个",程序按你写的顺序执行。要并行,就需要显式地告诉框架"这一步要不要同步梯度""这一层要不要临时收集参数",DDP 和 FSDP 本质上就是把这些同步逻辑封装成了容易调用的接口。
JAX 是函数式的:训练的每一步被写成一个普通的纯函数(给定输入,必定产出相同输出,不依赖外部状态),再用装饰器 jax.jit 把它交给 XLA 编译器编译成设备可执行的程序。既然整个计算过程都会被完整编译,那"该在哪里插入通信"这件事,编译器完全可以自己算出来------你只需要告诉它"这份数据是怎么分布在各个设备上的",其余的推导和通信生成都是编译器的活。
这就是这篇文章要讲的核心:JAX 用"描述数据的摆放方式"取代了"显式调用并行 API"。
核心思路与优势
三个概念:Mesh、PartitionSpec、NamedSharding
理解 JAX 的分布式,先搞懂三个名词,它们环环相扣:
- Mesh(网格) :把一组物理设备组织成一个带名字的多维网格。比如 8 张卡,可以摆成一个 4×2 的网格,两个轴分别取名
'X'和'Y'。 - PartitionSpec(切分说明,简写
jax.P) :描述一个数组的每个维度,对应挂到 Mesh 的哪个轴上。None表示这个维度不切;没被提到的 Mesh 轴上,数据在各卡之间是完整复制的。 - NamedSharding(命名分片):把 Mesh 和 PartitionSpec 绑在一起,就是"这份数据具体怎么摆到设备上"的完整说明。
写成代码是这样:
python
import jax
import jax.numpy as jnp
import numpy as np

# 8 张卡摆成 4x2 的网格,两个轴分别叫 X 和 Y
mesh = jax.make_mesh((4, 2), ('X', 'Y'))
jax.set_mesh(mesh)

# 造一个数组,按 X 轴切第一维,按 Y 轴切第二维
x = jnp.arange(32.).reshape(8, 4)
x_sharded = jax.device_put(x, jax.P('X', 'Y'))

print(x_sharded.sharding)
# NamedSharding(mesh=Mesh('X': 4, 'Y': 2, axis_types=(Explicit, Explicit)), spec=P('X', 'Y'), memory_kind=device)
注意 jax.set_mesh(mesh) 这一句:设好"当前网格"之后,才能像上面这样直接把 jax.P(...) 传给 jax.device_put;不设的话,就得写完整的 jax.NamedSharding(mesh, jax.P('X', 'Y'))。
对比一下 PyTorch:DDP 不需要你描述数据怎么摆,因为它的规则是固定的------每卡一份完整模型;FSDP 也不需要你逐个数组指定切分方式,它内部按统一的规则(沿第 0 维切)自动处理。JAX 反过来,把"怎么摆"这件事完全交给你显式声明,好处是灵活------数据并行、模型并行、两者混合,都是同一套 API,换个 PartitionSpec 就行,不需要在"用 DDP 的接口"还是"用 FSDP 的接口"之间做选择。
jax.jit:自动生成通信,不用手写 all-reduce
这是 JAX 分布式设计里最有意思的一点:只要输入数组是分片好的,普通函数加一个 @jax.jit,JAX 就会顺着输入的分片推出中间结果和输出该怎么分片,编译器再据此在需要的地方自动插入通信,完全不需要你手写 all-reduce 或 all-gather。
python
@jax.jit
def add_arrays(a, b):
    return a + b

a = jax.device_put(jnp.arange(4).reshape(4, 1), jax.P('X', None))
b = jax.device_put(jnp.arange(8).reshape(1, 8), jax.P(None, 'Y'))
result = add_arrays(a, b)
# 结果自动是 P('X', 'Y') 的分片数组
这和 PyTorch 形成了鲜明对比。DDP 的梯度同步、FSDP 的 all-gather/reduce-scatter,都是运行时显式发生的通信操作,工程上非常成熟,但通信时机和方式是由框架按固定规则决定的。JAX 的通信是编译期根据你给的分片方式推导出来的------同一份训练代码,换一种切分方式,编译器就能生成出截然不同的并行策略,不用改训练逻辑本身。
这里有个新版 JAX 的细节值得知道:现在 jax.make_mesh 默认建出来的是"显式(Explicit)"模式的网格,分片信息直接写进数组的类型里,每种运算按简单规则推导输出的分片。遇到有歧义的情况,比如矩阵乘法两边被"约掉"的那个维度都被切开了,结果到底该 all-reduce 成完整的,还是 reduce-scatter 成分片的,JAX 不会替你瞎猜,而是直接报错,让你用 out_sharding 参数说清楚。如果你更希望编译器全权决定中间结果怎么切,可以在建网格时把轴设成 Auto 模式。两种模式下,通信代码都不用你写。
如果想更精细地控制,也可以显式声明输入输出的分片:
python
def matmul(x, y):
    return x @ y

fn = jax.jit(
    matmul,
    in_shardings=(jax.P('X', None), jax.P(None, 'Y')),
    out_shardings=jax.P('X', 'Y'),
)
少数需要手写集合通信的场景(比如某些自定义的高性能算子、流水线并行),JAX 还提供了更底层的 jax.shard_map,可以在函数体内部直接操作每张卡上的那一份数据,自己调用 jax.lax.psum 这类集合通信,感觉上类似 PyTorch 里直接调用 torch.distributed 的通信原语。不过这属于进阶用法,入门阶段的训练代码基本用不到。
XLA 编译:天生长在一起,还是后来接上去的
JAX 从设计第一天起就是为 XLA 编译而生的,jax.jit 装饰的函数能得到一份完整的编译期计算图。PyTorch 的 torch.compile 是后来加上去的能力,遇到不可追踪的控制流(比如依赖张量取值的 if 分支)时会发生"图断裂"(graph break),拿到的不一定是一整张完整的图,而是被拆成好几段分别优化,中间那部分退回普通 Python 执行。JAX 的做法正好相反:jax.jit 里不允许依赖张量取值的 Python if,这类分支必须改写成 jax.lax.cond 之类的函数,换来的是每次都能拿到一整张图。这是两边在"写起来自由"和"编译得彻底"之间做的不同取舍。
这也解释了为什么 JAX 在 TPU 上格外顺手------TPU 本身就是围绕 XLA 设计的,JAX 到 XLA 是原生路径。PyTorch 在 GPU 生态上更成熟,社区和周边工具也远比 JAX 庞大,这是两边各自的强项。
多机训练:思路相似,但统一到了同一套抽象里
单机多卡之外,两个框架都需要"手动在每台机器上把进程跑起来"------没有框架会替你自动登录到别的机器上启动程序。
PyTorch 常用 torchrun 启动,JAX 则是在程序里调用 jax.distributed.initialize(),必须在访问任何设备之前完成:
python
import jax

jax.distributed.initialize(
    coordinator_address="192.168.0.1:8000",
    num_processes=4,
    process_id=0,  # 每台机器上填自己的编号
)
在 Slurm、Kubernetes、Cloud TPU 这类环境里,甚至可以不传参数,直接调用 jax.distributed.initialize(),JAX 会自动从环境变量里识别出协调地址、进程数和自己的编号。
有两个概念要分清:jax.local_devices() 是当前进程直接挂载的物理设备,jax.devices() 是初始化完成后,整个集群里所有进程加起来的全部设备。一块卡只能属于一个进程,但一个进程可以管好几块卡。这里和 PyTorch 的习惯不太一样:torchrun 通常是一张 GPU 起一个进程(一个 rank 对应一张卡),而 JAX 常见的做法是每台机器只起一个进程,由它管理本机的全部卡。
两边扩展到多机时,要改的主要都是启动方式:PyTorch 是给 torchrun 加上 --nnodes、--node_rank 这类参数,JAX 是在每台机器上调用 jax.distributed.initialize()。区别在于初始化之后:JAX 里要不要跨机器切分数据,纯粹是 Mesh 该怎么摆的问题,训练步骤本身几乎不需要为"这是单机还是多机"做区分。
效果怎么看
用 jax.debug.visualize_array_sharding 能在终端里直接打印出一个数组具体分布在哪些设备上,调试切分策略时很有用(这个函数依赖 rich 包画表格,没装的话先 pip install rich):
python
x = jax.device_put(jnp.arange(8.), jax.P('X'))
jax.debug.visualize_array_sharding(x)
面向人群
- 已经熟悉 PyTorch DDP/FSDP,想弄清楚 JAX 的分布式训练"到底在做什么不一样的事"的工程师
- 在 TPU 上做研究或训练,绕不开 JAX 生态的算法研究者
- 想理解"编译期自动并行"和"运行时显式通信"这两种设计哲学差异的学习者
- 需要为团队评估训练框架、权衡灵活性和工程成熟度的技术负责人
实践步骤
下面用一个最小例子,把 JAX 里"数据并行"和"参数按列切分"同时走一遍,方便和 PyTorch 那边的 DDP/FSDP 直接对照。
第一步:搭好 Mesh
先看当前有几张设备,摆成一个网格。单机多卡的情况下,这一步不需要任何额外的初始化:
python
import jax
import jax.numpy as jnp

print(jax.devices())  # 看看有几张卡

# 假设有 4 张卡,摆成 (2, 2) 的网格
mesh = jax.make_mesh((2, 2), ('batch', 'model'))
jax.set_mesh(mesh)
这里特意把两个轴分别取名 'batch' 和 'model'------对应 PyTorch 里"数据并行"和"模型(参数)并行"这两个维度,JAX 用同一个 Mesh 把它们放在了一起。
第二步:把数据和参数分别摆好
数据按 'batch' 轴切(每张卡吃一部分样本),参数按 'model' 轴切(每张卡存一部分参数列):
python
batch = jax.device_put(jnp.ones((8, 4)), jax.P('batch', None))
params = jax.device_put(jnp.ones((4, 2)), jax.P(None, 'model'))
这一步就是 JAX 版本的"选择并行策略":数据在 batch 维度上是数据并行(类似 DDP 的思路,每卡吃不同的数据),参数在 model 维度上按列切开,每张卡只存、也只用自己那几列参数去计算,这更接近张量并行的思路。如果想要 FSDP 那种"平时分片存、计算前临时拼回完整参数"的效果,同样只是换一个 PartitionSpec 的事,比如把参数也沿 'batch' 轴切开,编译器会在用到时自动插入 all-gather。区别在于,这里不需要调用任何专门的并行类,就是普通的数组和普通的切分说明。
第三步:写一个普通的训练步骤函数
不用考虑任何并行细节,就当成单卡程序来写:
python
def loss_fn(params, batch):
    logits = jnp.dot(batch, params)
    return jnp.mean(logits ** 2)

@jax.jit
def train_step(params, batch):
    grads = jax.grad(loss_fn)(params, batch)
    new_params = params - 0.01 * grads
    return new_params
jax.grad 自动求梯度,@jax.jit 负责编译。因为传进来的 params 和 batch 已经是分片数组,梯度该怎么分片、中间要不要插入通信都会被自动推导出来。比如每张卡只看到了一部分样本,算出来的梯度需要沿 batch 轴加起来,编译器就会自动插入一次 all-reduce,这对应的正是 PyTorch 里 DDP 的梯度 allreduce,只是在这里完全看不到任何通信相关的代码。
第四步:跑起来,看效果
python
updated_params = train_step(params, batch)
print(updated_params.sharding)  # 确认更新后的参数分片方式没有变
如果想直观看到数据具体摆在哪些设备上,随时可以:
python
jax.debug.visualize_array_sharding(params)第五步:换成多机
单机例子理解了之后,多机只是多一步初始化。每台机器上跑同一份代码,只是 process_id 不同:
python
import jax

jax.distributed.initialize(
    coordinator_address="192.168.0.1:8000",
    num_processes=2,      # 假设用 2 台机器,每台 4 张卡
    process_id=0,         # 这台机器填 0,另一台填 1
)

# 初始化完成之后,jax.devices() 就能看到两台机器上全部 8 张卡了
mesh = jax.make_mesh((4, 2), ('batch', 'model'))
jax.set_mesh(mesh)
第三步的 train_step 一行都不用改,变的只是网格的形状。唯一需要多留意的是数据加载:多机时通常不会让每台机器都加载完整的一批数据,而是每台只读自己那一份,再用 jax.make_array_from_process_local_data 拼成一个跨机器的全局数组。这正是前面强调的重点:数据并行和模型并行、单机和多机,在 JAX 里都是同一套 Mesh/Sharding 抽象,不需要像 PyTorch 那样在 DDP、FSDP、torchrun 参数之间切换心智模型。
第六步:了解一下 Shardy(选读)
JAX 背后真正做切分传播和通信生成的,是 XLA 编译栈里的一套切分系统。早年的主力是 GSPMD,后来 Google DeepMind 和 XLA 团队合作推出了新一代的 Shardy,作为 GSPMD 的继任者,目标是让切分标注更易读、传播过程更可控。从 JAX 0.7(2025 年 7 月)开始,Shardy 已经是默认的切分系统,官方的迁移计划是让它最终完全取代 GSPMD。这部分是编译器内部的实现细节,日常写训练代码基本不需要关心;只有在排查某些奇怪的切分问题、或者读到老教程里的 jax_use_shardy_partitioner 开关时,知道它的来龙去脉就够了。
我的看法
DDP、FSDP 和 JAX 的 Mesh/Sharding,解决的是同一类问题,但选择了两种截然不同的抽象层级。PyTorch 把"数据并行"和"参数分片"做成了两个边界清晰、工程成熟的独立工具,学习成本低,出问题也容易定位到具体是哪一层的责任;JAX 把"怎么并行"变成了"数据怎么摆"这一个更底层、更统一的问题,代价是要先理解函数式编程和编译期推导这套思维方式,换回来的好处是数据并行、模型并行、多机训练用的是同一套代码骨架,不需要来回切换心智模型。
如果你的团队本来就在 GPU 上用 PyTorch,工程链路已经很成熟,DDP/FSDP 依然是最稳妥的选择;如果你在 TPU 上做研究,或者想要一套更统一、更贴近编译器自动优化的并行方式,JAX 值得花时间跨过最初的函数式门槛。两边并不是谁取代谁的关系,更像是两条路都能到山顶,只是沿途的风景和难度不一样。