一篇讲透图像分割的硬核长文。从阈值、边缘、分水岭,到聚类、图割,再到 U-Net 与 SAM,每种方法都配有数学原理 + Python 代码 + MATLAB 代码。读完这篇,你不仅能看懂每一行分割代码,还能根据场景选对算法。
目录
- 什么是图像分割?为什么它如此重要
- 图像分割的数学本质与分类体系
- [方法一:基于阈值------Otsu 大津法](#方法一:基于阈值——Otsu 大津法)
- [方法二:基于边缘------Canny 边缘检测分割](#方法二:基于边缘——Canny 边缘检测分割)
- 方法三:基于区域------分水岭算法
- [方法四:基于聚类------K-Means 分割](#方法四:基于聚类——K-Means 分割)
- [方法五:基于图论------GrabCut 交互式分割](#方法五:基于图论——GrabCut 交互式分割)
- [方法六:基于深度学习------U-Net 语义分割](#方法六:基于深度学习——U-Net 语义分割)
- [进阶前沿:Segment Anything (SAM) 与分割大模型](#进阶前沿:Segment Anything (SAM) 与分割大模型)
- 六大算法横向对比与选型指南
- 实战踩坑与工程经验
- 总结与展望
1. 什么是图像分割?为什么它如此重要
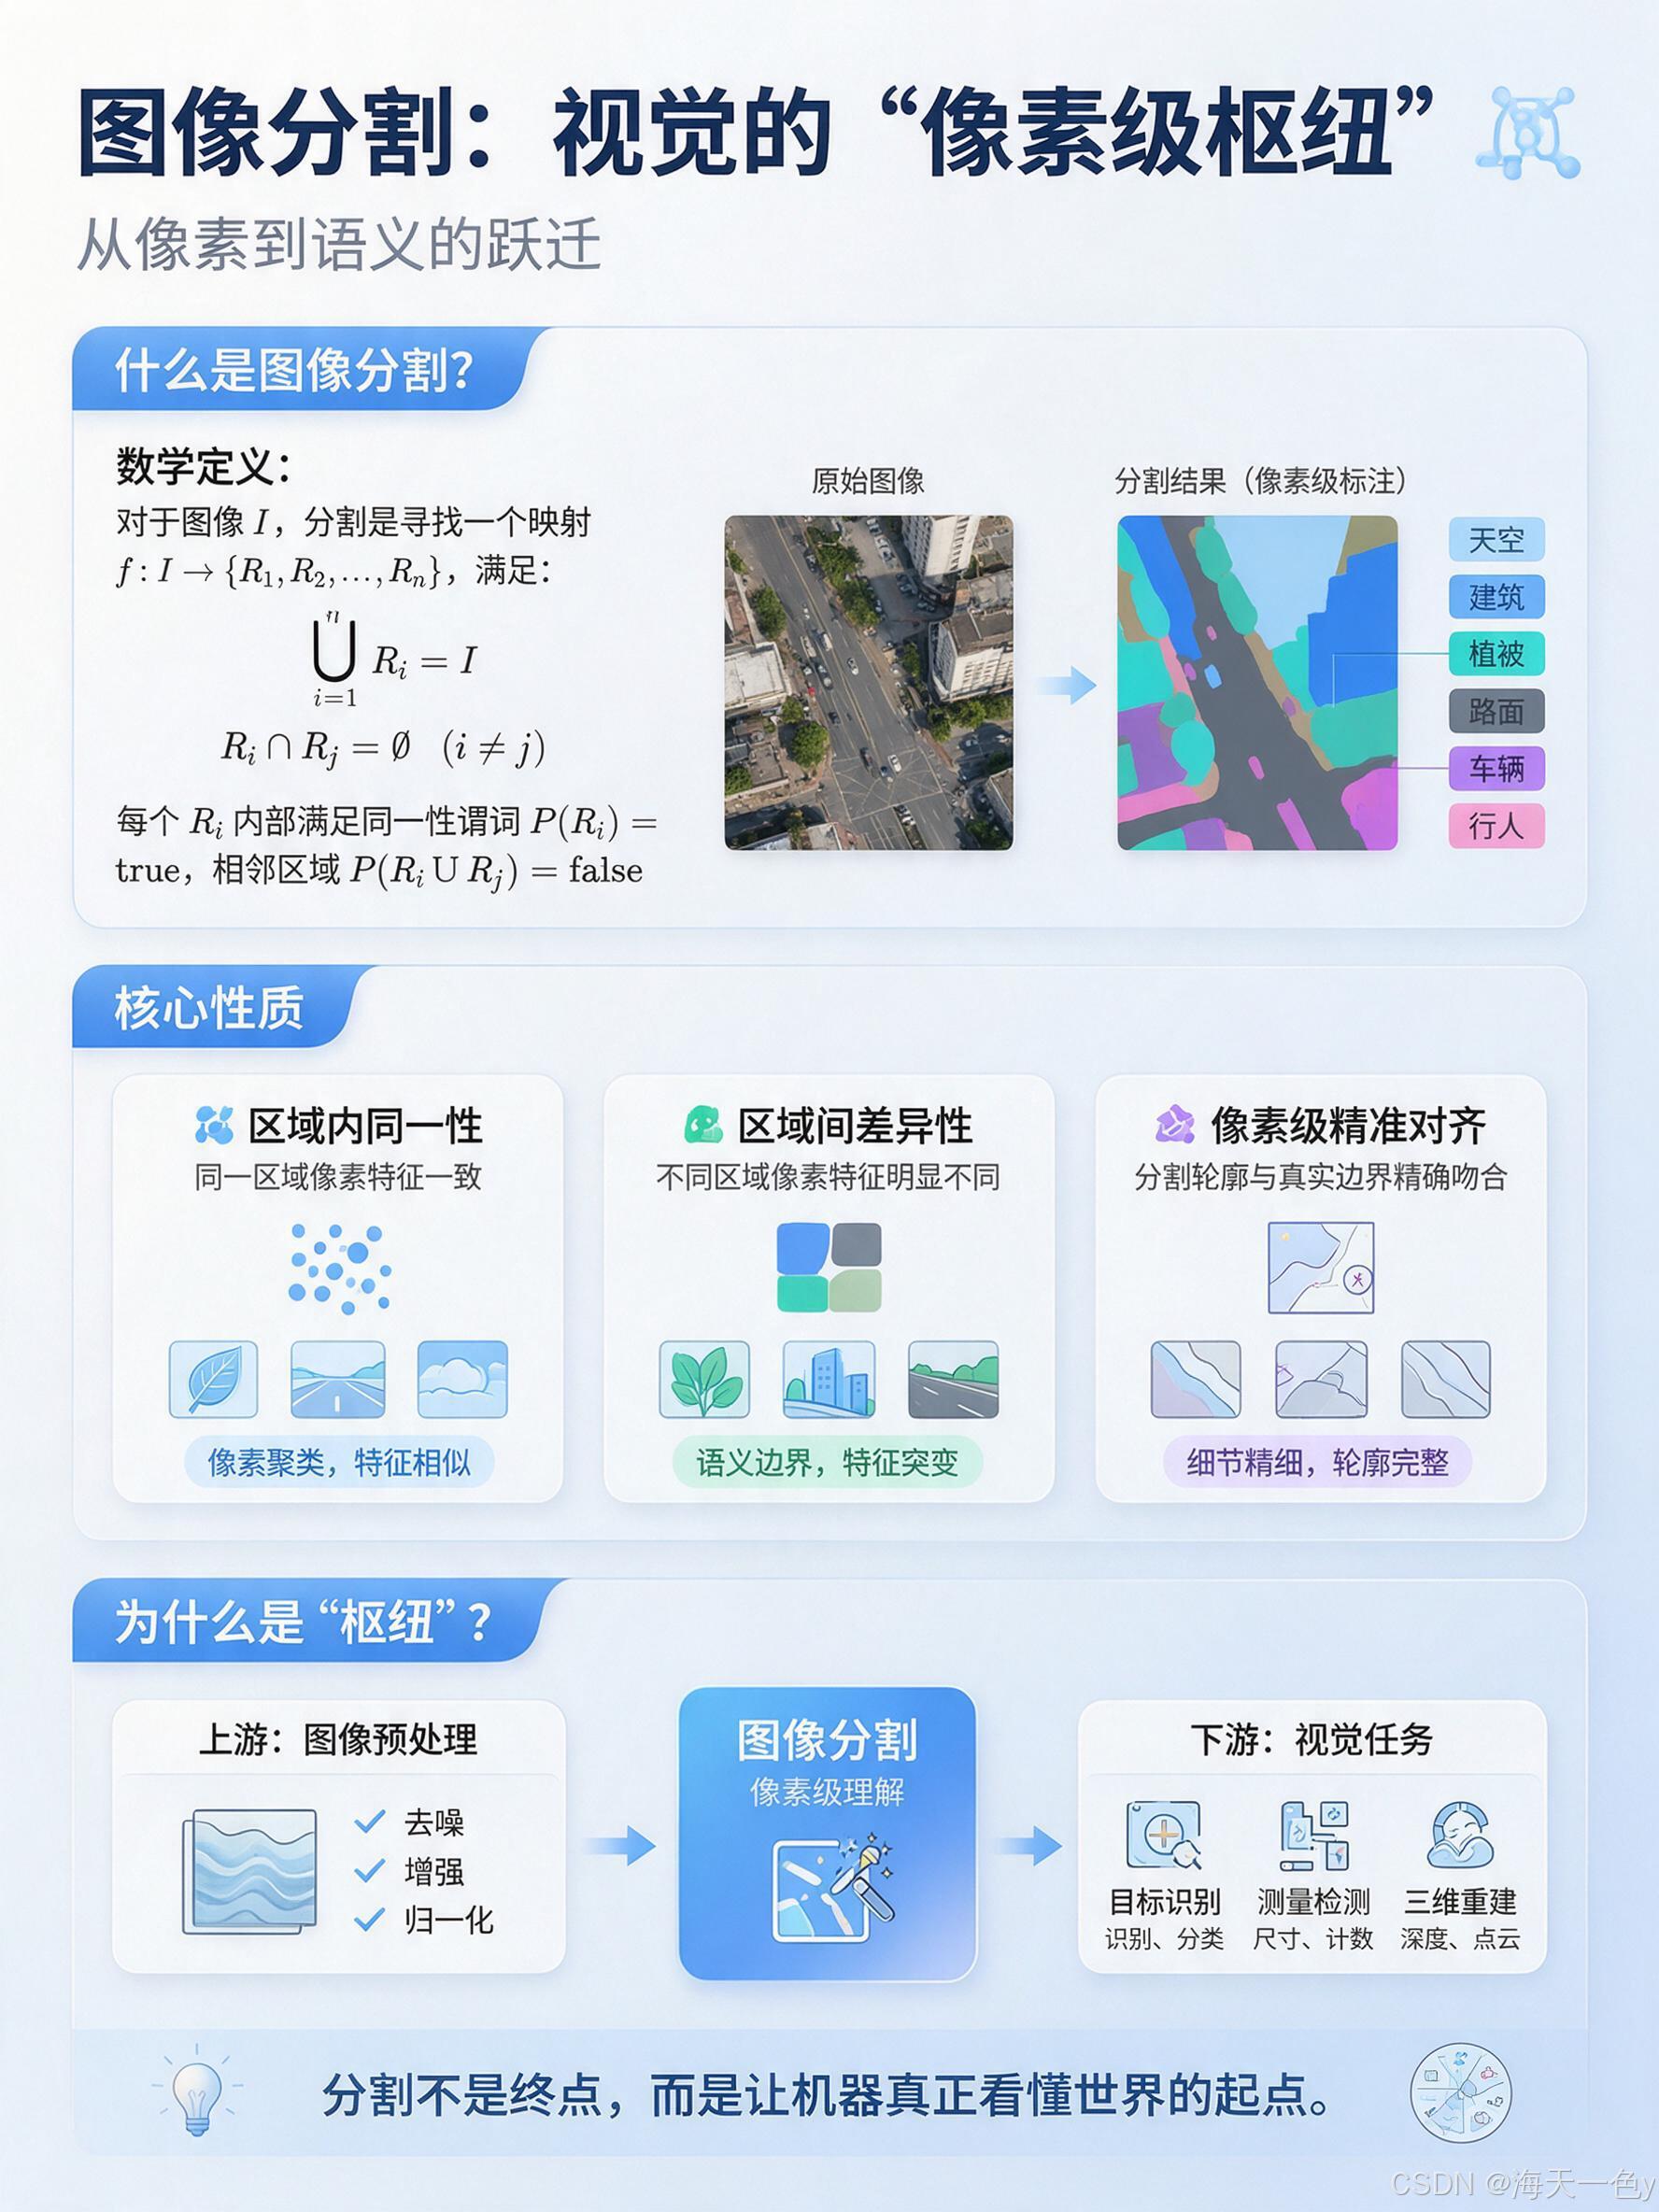
图像分割(Image Segmentation) 是指将一幅图像划分为若干个具有特定含义、互不重叠的区域,使得同一区域内像素具有一致性(如颜色、纹理、灰度相似),而不同区域之间存在明显差异的过程。
用数学语言描述:对于图像 I I I,分割是寻找一个映射 f : I → { R 1 , R 2 , ... , R n } f: I \to \{R_1, R_2, \dots, R_n\} f:I→{R1,R2,...,Rn},满足:
⋃ i = 1 n R i = I , R i ∩ R j = ∅ ( i ≠ j ) \bigcup_{i=1}^{n} R_i = I, \quad R_i \cap R_j = \emptyset \ (i \neq j) i=1⋃nRi=I,Ri∩Rj=∅ (i=j)
且每个 R i R_i Ri 内部满足同一性谓词(uniformity predicate) P ( R i ) = true P(R_i) = \text{true} P(Ri)=true,相邻区域 P ( R i ∪ R j ) = false P(R_i \cup R_j) = \text{false} P(Ri∪Rj)=false。
它为什么重要?
图像分割是计算机视觉的"承上启下"枢纽:
- 上:承接图像预处理(去噪、增强),是理解图像内容的起点;
- 下 :为后续的目标识别、测量、三维重建提供"像素级"的精准边界。
典型应用场景:
| 领域 | 应用 |
|---|---|
| 医疗影像 | CT/MRI 中肿瘤分割、器官勾画、细胞计数 |
| 自动驾驶 | 车道线、行人、可行驶区域分割 |
| 工业检测 | 缺陷检测、尺寸测量 |
| 遥感影像 | 建筑物提取、农作物分类、变化检测 |
| 农业 | 果实识别与计数、病虫害检测 |
💡 一句话理解:图像分类告诉你"图里有什么",目标检测告诉你"东西在哪个框里",而图像分割精确到"每一个像素属于什么"。
2. 图像分割的数学本质与分类体系
纵观所有分割算法,本质上都在做一件事:定义"相似性",然后据此把像素分到不同的组。差异只在于"相似性"的定义和分组的策略。
主流分类
图像分割算法
├── 基于阈值 (Threshold)
│   ├── 全局阈值 / 自适应阈值
│   └── Otsu 大津法
├── 基于边缘 (Edge-based)
│   ├── Sobel / Prewitt / Roberts
│   └── Canny
├── 基于区域 (Region-based)
│   ├── 区域生长 / 区域分裂合并
│   └── 分水岭 (Watershed)
├── 基于聚类 (Clustering)
│   ├── K-Means
│   └── 模糊 C 均值 (FCM)
├── 基于图论 (Graph-based)
│   ├── Graph Cut
│   └── GrabCut
└── 基于深度学习 (Deep Learning)
    ├── 语义分割:FCN / U-Net / DeepLab
    ├── 实例分割:Mask R-CNN
    └── 万能分割:SAM / SAM 2
下面我们逐一深入,每种方法都遵循 【原理 → 数学 → Python → MATLAB】 的四段式讲解。
3. 方法一:基于阈值------Otsu 大津法
3.1 原理
阈值法是最简单也最经典的分割思路:选一个灰度阈值 T T T,大于 T T T 的归为前景,小于 T T T 的归为背景。
g ( x , y ) = { 1 , f ( x , y ) > T 0 , f ( x , y ) ≤ T g(x,y) = \begin{cases} 1, & f(x,y) > T \\ 0, & f(x,y) \leq T \end{cases} g(x,y)={1,0,f(x,y)>Tf(x,y)≤T
难点在于 T T T 怎么选 。人工试显然不现实,Otsu(大津法) 给出了一种自动、最优的方案:让前景和背景的类间方差(between-class variance) 最大化。
3.2 数学推导
设图像灰度级为 L L L,灰度值 i i i 的像素数为 n i n_i ni,总像素数 N = ∑ n i N = \sum n_i N=∑ni,概率 p i = n i / N p_i = n_i / N pi=ni/N。
以阈值 k k k 将像素分为前景 C 0 = { 0 , ... , k } C_0 = \{0, \dots, k\} C0={0,...,k} 和背景 C 1 = { k + 1 , ... , L − 1 } C_1 = \{k+1, \dots, L-1\} C1={k+1,...,L−1},两类的概率与均值:
ω 0 = ∑ i = 0 k p i , ω 1 = 1 − ω 0 \omega_0 = \sum_{i=0}^{k} p_i, \quad \omega_1 = 1 - \omega_0 ω0=i=0∑kpi,ω1=1−ω0
μ 0 = ∑ i = 0 k i ⋅ p i ω 0 , μ 1 = ∑ i = k + 1 L − 1 i ⋅ p i ω 1 \mu_0 = \frac{\sum_{i=0}^{k} i \cdot p_i}{\omega_0}, \quad \mu_1 = \frac{\sum_{i=k+1}^{L-1} i \cdot p_i}{\omega_1} μ0=ω0∑i=0ki⋅pi,μ1=ω1∑i=k+1L−1i⋅pi
类间方差定义为:
σ B 2 ( k ) = ω 0 ω 1 ( μ 0 − μ 1 ) 2 \sigma_B^2(k) = \omega_0 \omega_1 (\mu_0 - \mu_1)^2 σB2(k)=ω0ω1(μ0−μ1)2
遍历所有 k k k,使 σ B 2 ( k ) \sigma_B^2(k) σB2(k) 最大的 k ∗ k^* k∗ 即为最优阈值:
k ∗ = arg max k σ B 2 ( k ) k^* = \arg\max_{k} \sigma_B^2(k) k∗=argkmaxσB2(k)
3.3 Python 实现
python
import cv2
import numpy as np
import matplotlib.pyplot as plt

# 读取图像并转灰度
img = cv2.imread('cell.png', cv2.IMREAD_GRAYSCALE)

# 高斯模糊去噪,避免噪声干扰阈值选择
blur = cv2.GaussianBlur(img, (5, 5), 0)

# Otsu 自动阈值分割
# cv2.THRESH_OTSU 让 OpenCV 自动计算最优阈值并返回
ret, binary = cv2.threshold(
    blur, 0, 255,
    cv2.THRESH_BINARY + cv2.THRESH_OTSU
)

print(f"Otsu 自动选择的阈值: {ret:.2f}")

# 可视化
plt.figure(figsize=(12, 4))
plt.subplot(131); plt.imshow(img, cmap='gray');    plt.title('原图')
plt.subplot(132); plt.hist(blur.ravel(), 256);     plt.title(f'直方图 (阈值={ret:.0f})')
plt.axvline(ret, color='r', linestyle='--')
plt.subplot(133); plt.imshow(binary, cmap='gray'); plt.title('Otsu 分割结果')
plt.tight_layout(); plt.savefig('otsu_result.png', dpi=150); plt.show()
如果想从零手写 Otsu,核心循环如下:
python
def otsu_threshold(hist):
    """从灰度直方图手算 Otsu 最优阈值"""
    total = sum(hist)
    sum_total = sum(i * hist[i] for i in range(256))
    sumB, wB, max_var, threshold = 0, 0, 0, 0

    for i in range(256):
        wB += hist[i]                          # 前景像素数
        if wB == 0: continue
        wF = total - wB                        # 背景像素数
        if wF == 0: break
        sumB += i * hist[i]
        mB = sumB / wB                         # 前景均值
        mF = (sum_total - sumB) / wF           # 背景均值
        var_between = wB * wF * (mB - mF) ** 2 # 类间方差
        if var_between > max_var:
            max_var = var_between
            threshold = i
    return threshold
3.4 MATLAB 实现
matlab
%% Otsu 大津法图像分割
clear; clc; close all;

img = imread('cell.png');
if size(img, 3) == 3
    img = rgb2gray(img);
end

% graythresh 返回 [0,1] 归一化阈值,内部即 Otsu
level = graythresh(img);
fprintf('Otsu 自动选择的阈值: %.4f\n', level);

% imbinarize 二值化
binary = imbinarize(img, level);

% 从零手算 Otsu(理解原理)
hist_counts = imhist(img);
total = sum(hist_counts);
sum_total = sum((0:255)' .* hist_counts);
sumB = 0; wB = 0; max_var = 0; thr = 0;
for i = 0:255
    wB = wB + hist_counts(i+1);
    if wB == 0, continue; end
    wF = total - wB;
    if wF == 0, break; end
    sumB = sumB + i * hist_counts(i+1);
    mB = sumB / wB;
    mF = (sum_total - sumB) / wF;
    var_between = wB * wF * (mB - mF)^2;
    if var_between > max_var
        max_var = var_between;
        thr = i;
    end
end
fprintf('手算 Otsu 阈值: %d\n', thr);

%% 可视化
figure('Position', [100 100 1200 400]);
subplot(1,3,1); imshow(img);     title('原图');
subplot(1,3,2); imhist(img); hold on;
ax = gca; ax.YLim(2) = ax.YLim(2)*0.1;
plot([1 1]*level*255, ax.YLim, 'r--', 'LineWidth', 2);
title(sprintf('直方图 (阈值=%.0f)', level*255));
subplot(1,3,3); imshow(binary); title('Otsu 分割结果');
✅ 适用场景:前景背景灰度差异明显、光照较均匀的场景。对光照不均、纹理复杂的图像效果差------这是后续算法要解决的问题。
4. 方法二:基于边缘------Canny 边缘检测分割
4.1 原理
物体与背景之间通常存在灰度突变,边缘 就是灰度变化最剧烈的地方。边缘检测利用梯度算子捕捉这种突变,再连接成闭合边界完成分割。
Canny 边缘检测 被誉为"最优边缘检测器",它把好的边缘检测归结为三个标准:低错误率、高定位精度、单像素响应,并设计了五步流程实现。
4.2 Canny 五步流程与数学
-
高斯平滑 :用高斯核卷积去噪,避免梯度对噪声敏感。
G ( x , y ) = 1 2 π σ 2 e − x 2 + y 2 2 σ 2 G(x,y) = \frac{1}{2\pi\sigma^2} e^{-\frac{x^2+y^2}{2\sigma^2}} G(x,y)=2πσ21e−2σ2x2+y2
-
计算梯度幅值与方向 :用 Sobel 算子求 G x , G y G_x, G_y Gx,Gy:
∣ ∇ I ∣ = G x 2 + G y 2 , θ = arctan ( G y / G x ) |\nabla I| = \sqrt{G_x^2 + G_y^2}, \quad \theta = \arctan(G_y / G_x) ∣∇I∣=Gx2+Gy2 ,θ=arctan(Gy/Gx)
-
非极大值抑制(NMS):沿梯度方向,只保留局部最大像素,把粗边缘细化成单像素宽。
-
双阈值检测 :设高阈值 T H T_H TH、低阈值 T L T_L TL。高于 T H T_H TH 为强边缘,低于 T L T_L TL 抛弃,中间为弱边缘。
-
滞后连接(Hysteresis):弱边缘只有与强边缘相连才保留,从而既去噪又保连续。
4.3 Python 实现
python
import cv2
import numpy as np
import matplotlib.pyplot as plt

img = cv2.imread('coins.jpg', cv2.IMREAD_GRAYSCALE)
blur = cv2.GaussianBlur(img, (5, 5), 0)

# Canny 边缘检测:低阈值 50,高阈值 150(推荐比例 1:2 或 1:3)
edges = cv2.Canny(blur, 50, 150)

# 进阶:用边缘闭合区域做分割
# 先轮廓填充,再提取连通域
contours, _ = cv2.findContours(edges, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
mask = np.zeros_like(img)
cv2.drawContours(mask, contours, -1, 255, thickness=cv2.FILLED)
# 过滤过小区域
mask = cv2.morphologyEx(mask, cv2.MORPH_OPEN,
                        cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (5, 5)))

plt.figure(figsize=(12, 4))
plt.subplot(131); plt.imshow(img, cmap='gray');    plt.title('原图')
plt.subplot(132); plt.imshow(edges, cmap='gray'); plt.title('Canny 边缘')
plt.subplot(133); plt.imshow(mask, cmap='gray');  plt.title('边缘闭合分割')
plt.tight_layout(); plt.savefig('canny_result.png', dpi=150); plt.show()
4.4 MATLAB 实现
matlab
%% Canny 边缘检测分割
clear; clc; close all;

img = imread('coins.jpg');
if size(img, 3) == 3, img = rgb2gray(img); end

% edge 函数内置 Canny,参数为 [低阈值 高阈值]
edges = edge(img, 'canny', [0.05 0.15]);

% 形态学闭操作让边缘闭合,再填洞做分割
se = strel('disk', 2);
closed = imclose(edges, se);
filled = imfill(closed, 'holes');

% 提取连通域,过滤小区域
cc = bwconncomp(filled);
stats = regionprops(cc, 'Area');
areas = [stats.Area];
keep = areas > 100;                    % 面积阈值
mask = ismember(labelmatrix(cc), find(keep));

figure('Position', [100 100 1200 400]);
subplot(1,3,1); imshow(img);     title('原图');
subplot(1,3,2); imshow(edges);   title('Canny 边缘');
subplot(1,3,3); imshow(mask);    title('边缘闭合分割');
⚠️ 局限 :边缘法对边缘不连续很敏感,常出现"断边"导致区域泄漏。实际中多与分水岭、形态学配合使用。
5. 方法三:基于区域------分水岭算法
5.1 原理
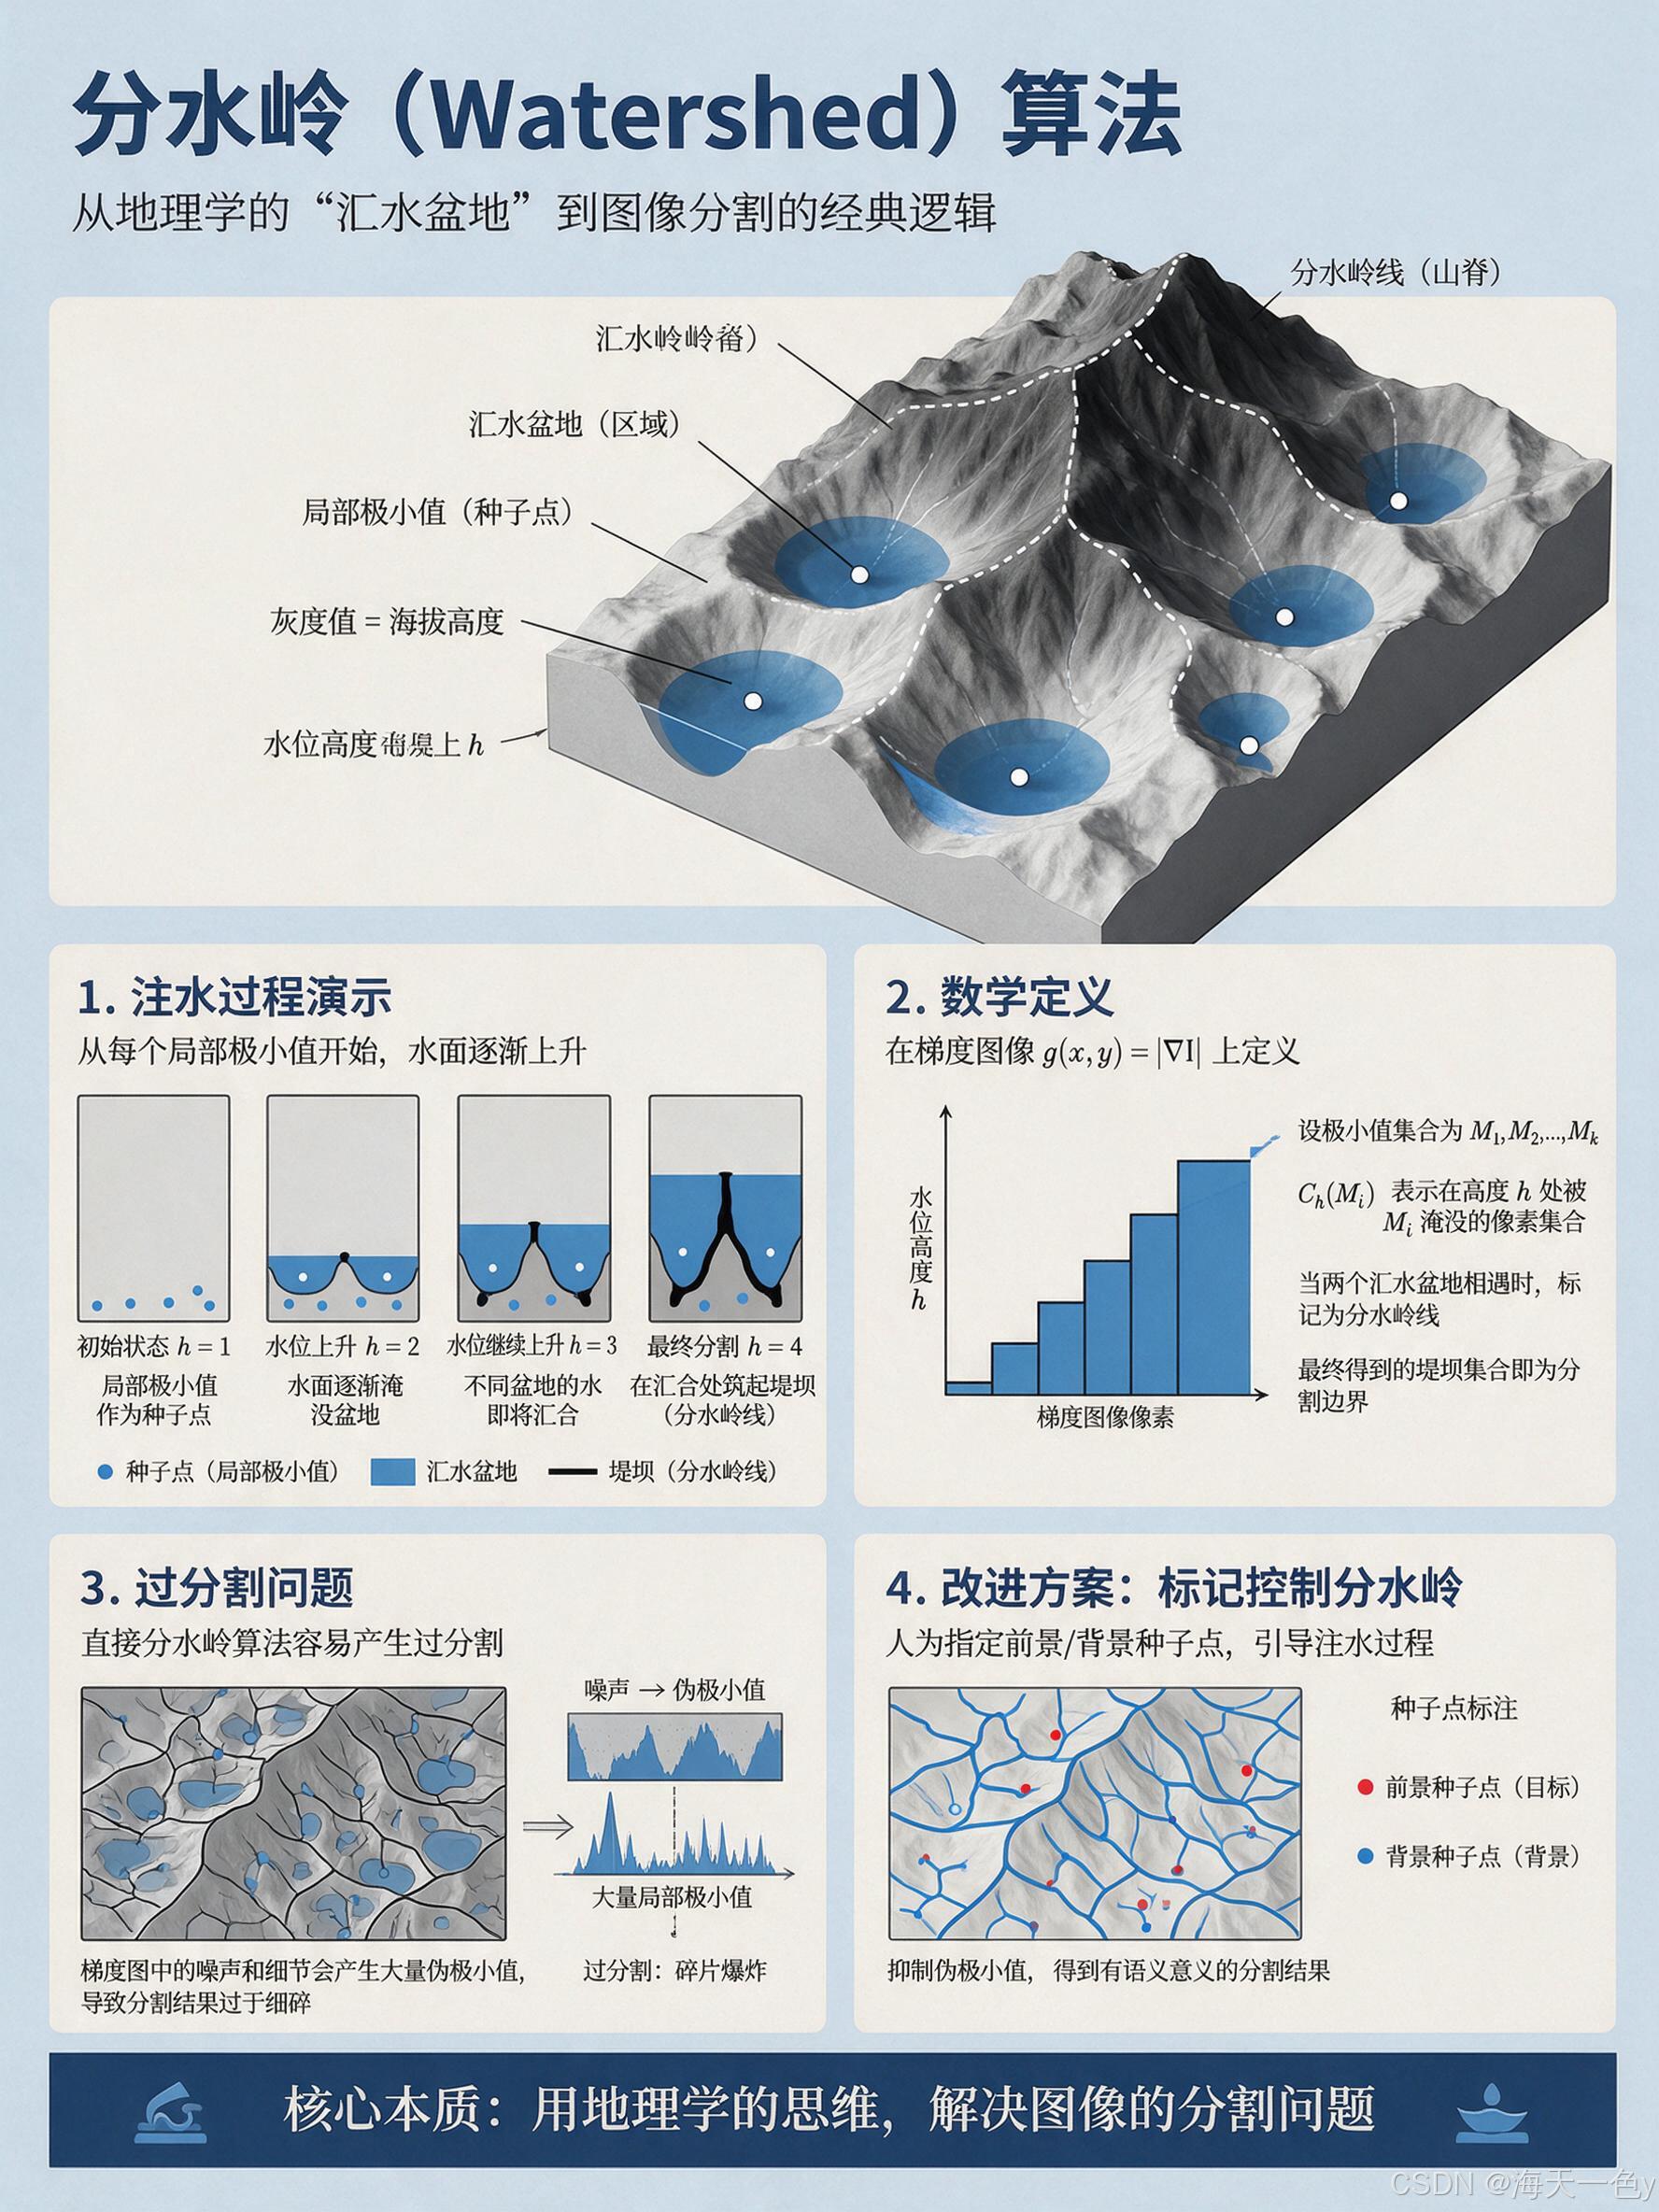
分水岭(Watershed) 算法借用地理学中的"汇水盆地"比喻:把图像看作地形表面,灰度值代表海拔,梯度大的地方是山脊(分水岭线),梯度小的地方是盆地(区域)。
想象从每个局部极小值开始"注水",水面逐渐上升;当两个不同盆地的水即将汇合时,就在交界处筑起"堤坝"------这些堤坝就是分割边界。
5.2 数学描述
分水岭在梯度图像 g ( x , y ) = ∣ ∇ I ∣ g(x,y) = |\nabla I| g(x,y)=∣∇I∣ 上定义。设极小值集合为 M 1 , ... , M k M_1, \dots, M_k M1,...,Mk,递增阈值 h h h 从最小灰度逐步扫描:
- 在高度 h h h 处,每个 M i M_i Mi 被淹没的像素集合记 C h ( M i ) C_h(M_i) Ch(Mi);
- 当两个汇水盆地相遇时标记为分水岭线。
最终得到的堤坝集合即为分割边界。
经典问题 :直接分水岭会过分割(over-segmentation) ------因为梯度图中的噪声和细节会产生大量伪极小值。解决方案:标记控制分水岭(Marker-controlled Watershed) ,人为指定前景/背景种子点。
5.3 Python 实现(标记控制分水岭)
python
import cv2
import numpy as np
import matplotlib.pyplot as plt
from scipy import ndimage

img = cv2.imread('coins.jpg')
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)

# 1. Otsu 二值化
ret, thresh = cv2.threshold(gray, 0, 255,
                             cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU)

# 2. 形态学开运算去噪
kernel = np.ones((3, 3), np.uint8)
opening = cv2.morphologyEx(thresh, cv2.MORPH_OPEN, kernel, iterations=2)

# 3. 确定背景:膨胀得到"肯定不是硬币"的区域
sure_bg = cv2.dilate(opening, kernel, iterations=3)

# 4. 确定前景:距离变换 + 阈值得到"肯定是硬币"的种子
dist_transform = cv2.distanceTransform(opening, cv2.DIST_L2, 5)
ret, sure_fg = cv2.threshold(dist_transform, 0.5 * dist_transform.max(), 255, 0)
sure_fg = np.uint8(sure_fg)

# 5. 未知区域 = 背景 - 前景
unknown = cv2.subtract(sure_bg, sure_fg)

# 6. 连通域标记,给每个种子打标签(背景必须为1,未知为0)
ret, markers = cv2.connectedComponents(sure_fg)
markers = markers + 1
markers[unknown == 255] = 0

# 7. 分水岭!
markers = cv2.watershed(img, markers)
img[markers == -1] = [255, 0, 0]  # 边界标红

plt.figure(figsize=(14, 4))
plt.subplot(141); plt.imshow(dist_transform, cmap='gray'); plt.title('距离变换')
plt.subplot(142); plt.imshow(sure_fg, cmap='gray');     plt.title('前景种子')
plt.subplot(143); plt.imshow(markers, cmap='jet');      plt.title('标记图')
plt.subplot(144); plt.imshow(cv2.cvtColor(img, cv2.COLOR_BGR2RGB)); plt.title('分割结果')
plt.tight_layout(); plt.savefig('watershed_result.png', dpi=150); plt.show()
5.4 MATLAB 实现
matlab
%% 标记控制分水岭分割
clear; clc; close all;

img = imread('coins.png');
I = rgb2gray(img);

% 1. 计算梯度(Sobel)
hy = fspecial('sobel');
hx = hy';
grad = imadd(imfilter(I, hy), imfilter(I, hx));

% 2. 用形态学重建确定前景/背景标记
se = strel('disk', 10);
Io = imopen(I, se);                 % 开运算去背景
Ie = imerode(I, se);                % 腐蚀,得到"肯定前景"
Iobr = imreconstruct(Ie, I);        % 形态学重建
Ioc = imclose(Iobr, se);            % 闭运算填小洞
Iobrd = imdilate(Ioc, se);          % 膨胀
Iobrcbr = imreconstruct(imcomplement(Iobrd), imcomplement(Ioc));
Iobrcbr = imcomplement(Iobrcbr);    % 重建后的清理图像

fgm = imregionalmax(Iobrcbr);       % 局部极大值作为前景标记
% 标记过多时进行合并
se2 = strel('disk', 5);
fgm2 = imclose(fgm, se2);
fgm3 = imerode(fgm, se2);
fgm4 = bwareaopen(fgm3, 20);        % 去小区域

% 3. 计算背景标记
bw = imbinarize(Iobrcbr);
D = bwdist(bw);
D = -D;
D(~bw) = -Inf;
L = watershed(D);
bgm = L == 0;

% 4. 组合标记并执行分水岭
markers = imdilate(fgm4, ones(3,3)) | bgm;
markers = bwlabel(markers);
gradmag = imgradient(I);
L = watershed(gradmag, markers);

% 5. 可视化
figure('Position', [100 100 1200 400]);
subplot(1,3,1); imshow(I);          title('原图');
subplot(1,3,2); imshow(gradmag,[]); title('梯度幅值');
rgb = label2rgb(L, 'jet', 'w', 'shuffle');
subplot(1,3,3); imshow(rgb);        title('分水岭分割结果');
💡 关键技巧 :分水岭的核心不在算法本身,而在如何设计好种子点。距离变换 + 形态学重建是构造种子的两大法宝。
6. 方法四:基于聚类------K-Means 分割
6.1 原理
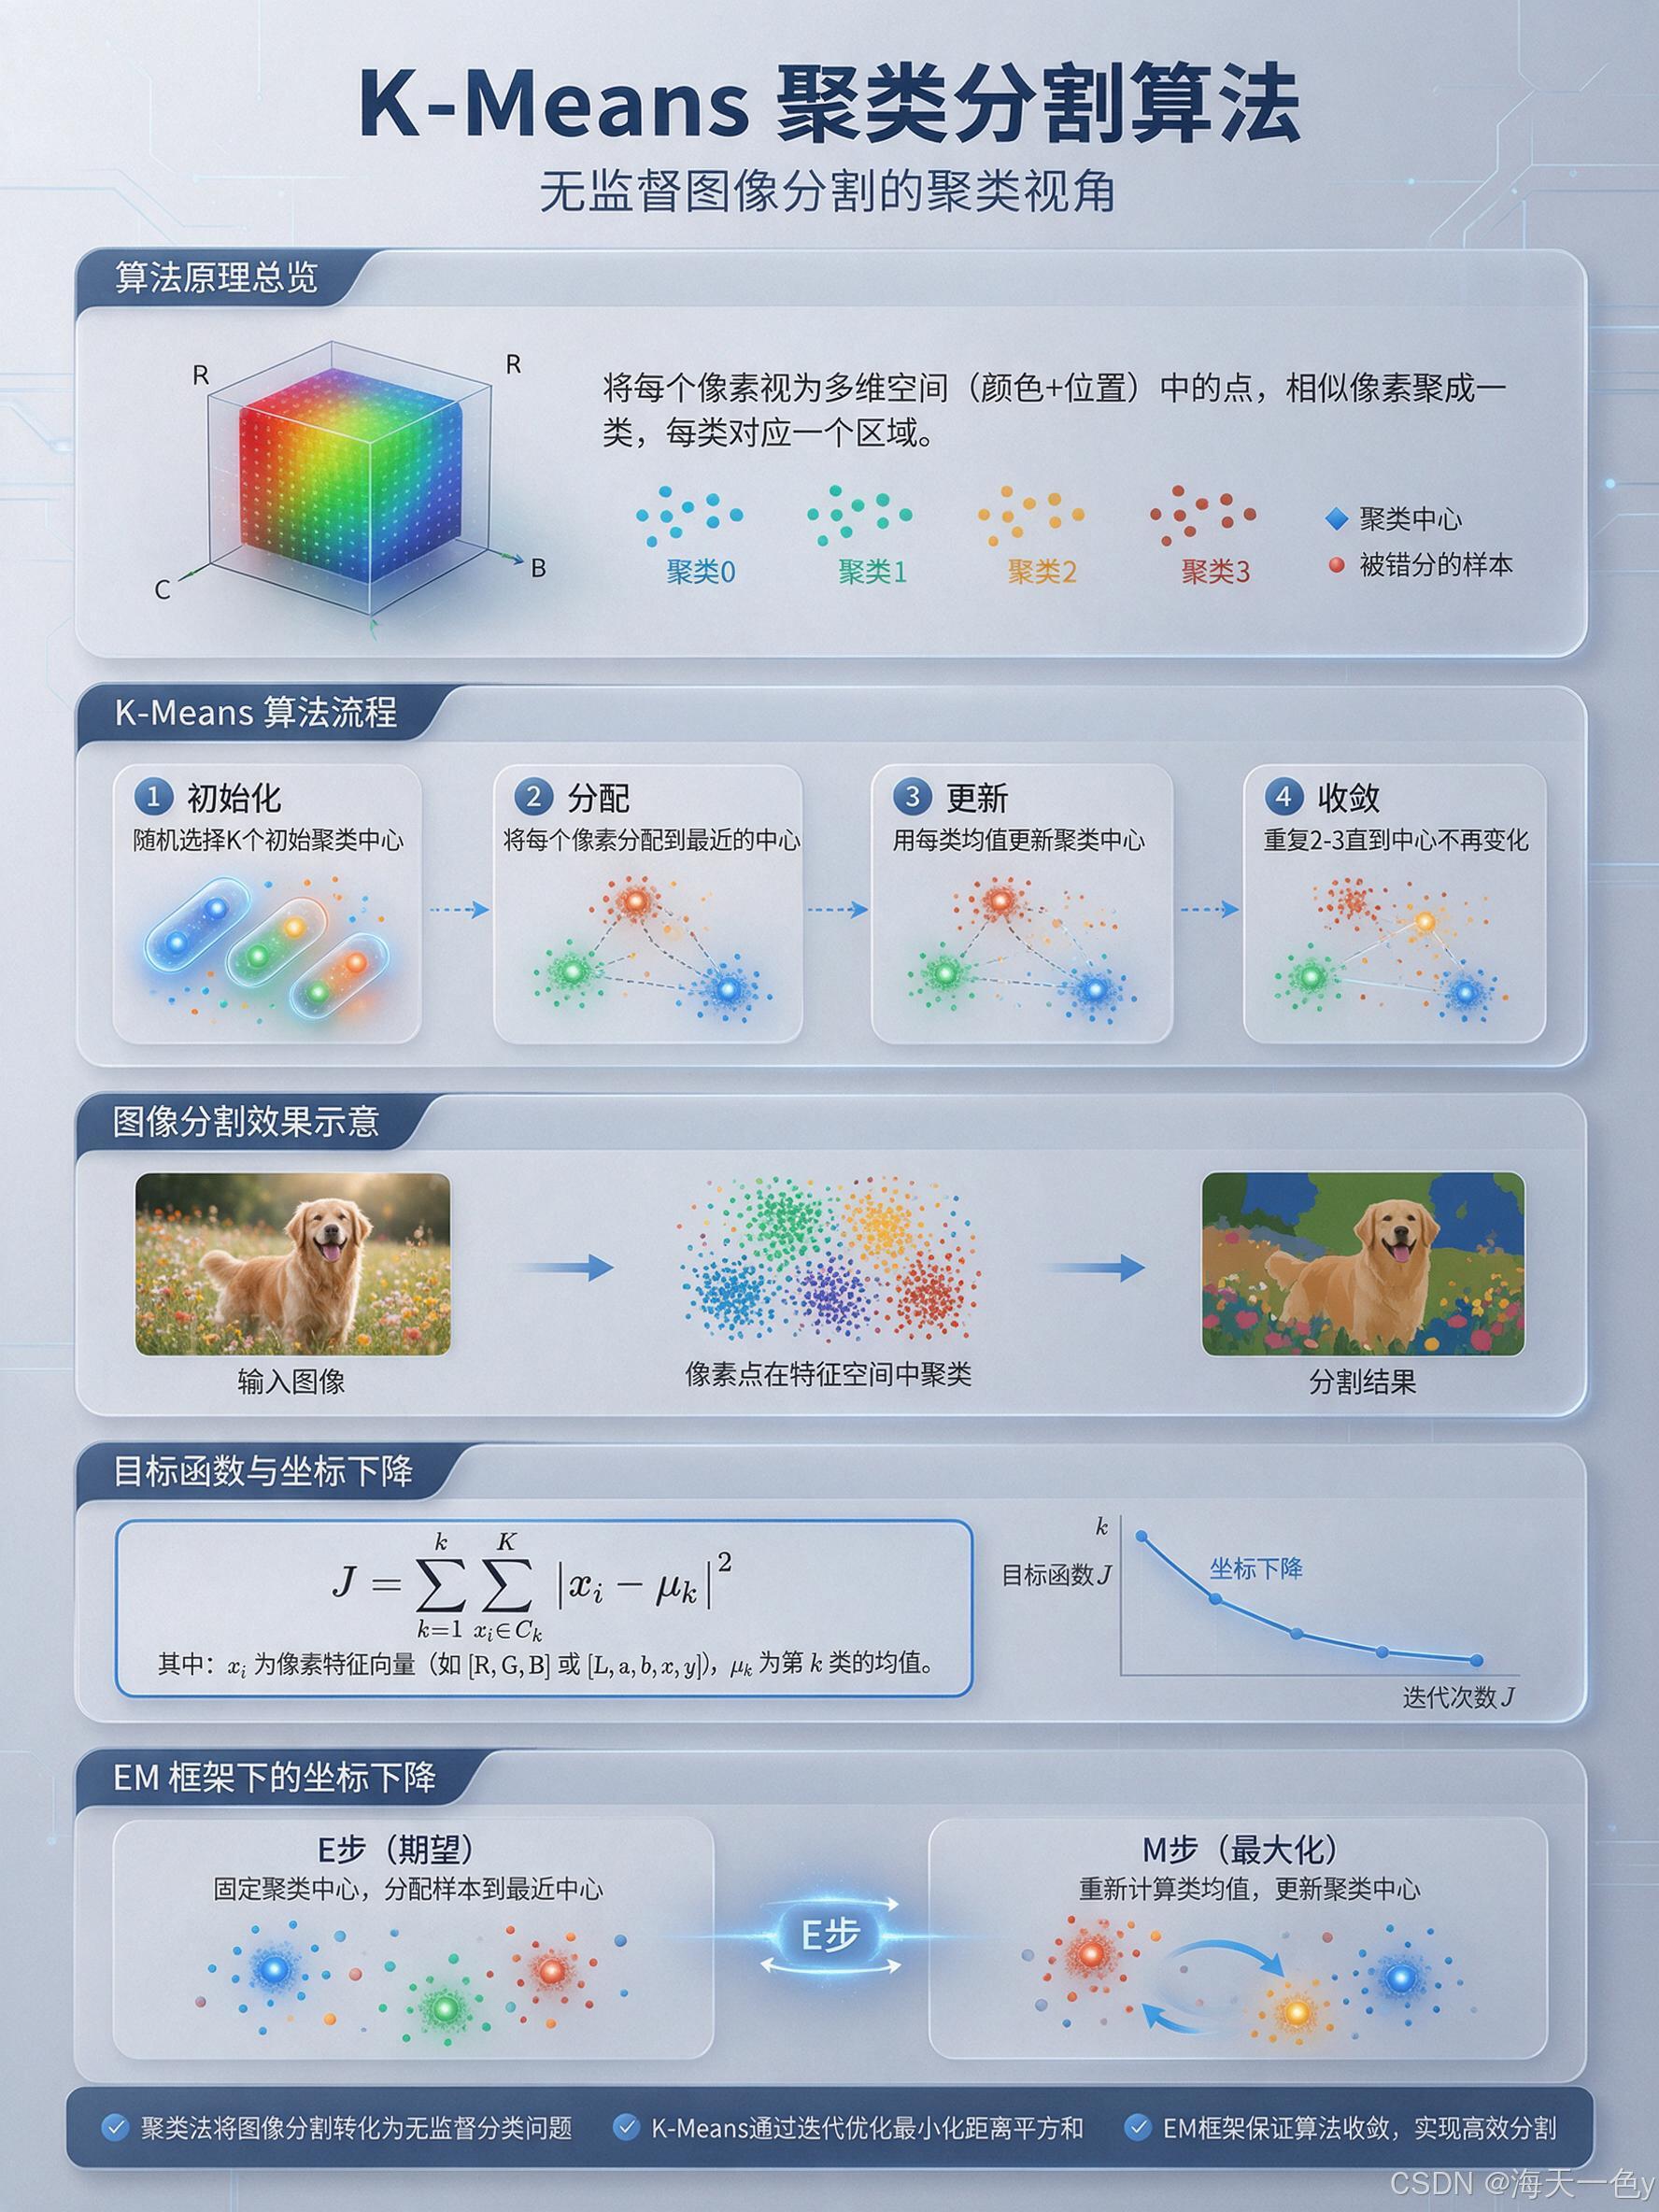
聚类法把图像分割视为无监督分类问题:把每个像素看作多维空间(颜色 + 位置)中的一个点,相似像素聚成一类,每类即为一个区域。
K-Means 思想极简:
- 随机选 K K K 个初始聚类中心;
- 把每个像素分配到最近的中心;
- 用每类像素的均值更新中心;
- 重复 2-3 直到收敛。
6.2 数学描述
目标是最小化所有像素到其所属中心的距离平方和:
J = ∑ k = 1 K ∑ x i ∈ C k ∥ x i − μ k ∥ 2 J = \sum_{k=1}^{K} \sum_{x_i \in C_k} \| x_i - \mu_k \|^2 J=k=1∑Kxi∈Ck∑∥xi−μk∥2
其中 x i x_i xi 为像素特征向量(如 R , G , B R, G, B R,G,B 或 L , a , b , x , y L, a, b, x, y L,a,b,x,y), μ k \mu_k μk 为第 k k k 类的均值。迭代过程即 EM 框架下的坐标下降。
6.3 Python 实现
python
import cv2
import numpy as np
import matplotlib.pyplot as plt

img = cv2.imread('fruit.jpg')
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
img = cv2.GaussianBlur(img, (5, 5), 0)

# 把每个像素 reshape 为 [N, 5]:颜色 L*a*b* + 坐标
Z = img.reshape((-1, 3))
Z = np.float32(Z)

# K-Means 参数:K=4,终止条件,最多迭代 10 次
K = 4
criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 10, 1.0)
ret, label, center = cv2.kmeans(Z, K, None, criteria, 10, cv2.KMEANS_PP_CENTERS)

# 把中心转回颜色并重建图像
center = np.uint8(center)
segmented = center[label.flatten()].reshape(img.shape)

# 不同簇单独显示
fig, axes = plt.subplots(1, K + 1, figsize=(4 * (K + 1), 4))
axes[0].imshow(img); axes[0].set_title('原图')
for k in range(K):
    mask = (label.flatten() == k).reshape(img.shape[:2])
    region = img.copy(); region[~mask] = 0
    axes[k + 1].imshow(region); axes[k + 1].set_title(f'簇 {k} ({center[k]})')
plt.tight_layout(); plt.savefig('kmeans_result.png', dpi=150); plt.show()
6.4 MATLAB 实现
matlab
%% K-Means 彩色图像分割
clear; clc; close all;

img = imread('fruit.jpg');
img = imfilter(img, fspecial('gaussian', [5 5], 0), 'replicate');

% 构造特征:颜色(RGB) + 空间坐标,增加空间一致性
[rows, cols, ~] = size(img);
[X, Y] = meshgrid(1:cols, 1:rows);
% 特征向量:[R G B x y],归一化坐标,平衡颜色与空间权重
features = [reshape(double(img(:,:,1)),[],1)/255, ...
            reshape(double(img(:,:,2)),[],1)/255, ...
            reshape(double(img(:,:,3)),[],1)/1, ...
            reshape(X, [], 1)/max(cols(:)), ...
            reshape(Y, [], 1)/max(rows(:))];

K = 4;
[idx, C] = kmeans(features, K, 'Replicates', 3, 'Distance', 'sqEuclidean');

% 重建分割图
label_img = reshape(idx, rows, cols);
rgb_label = label2rgb(label_img, 'jet', 'k', 'shuffle');

figure('Position', [100 100 900 400]);
subplot(1,2,1); imshow(img);       title('原图');
subplot(1,2,2); imshow(rgb_label); title(sprintf('K-Means 分割 (K=%d)', K));
📌 技巧 :把像素坐标也加入特征,可以让相邻的相似像素被分到一起,避免"椒盐式"碎块。颜色空间用 L*a*b*(欧氏距离符合人眼感知)比 RGB 效果更好。
7. 方法五:基于图论------GrabCut 交互式分割
7.1 原理
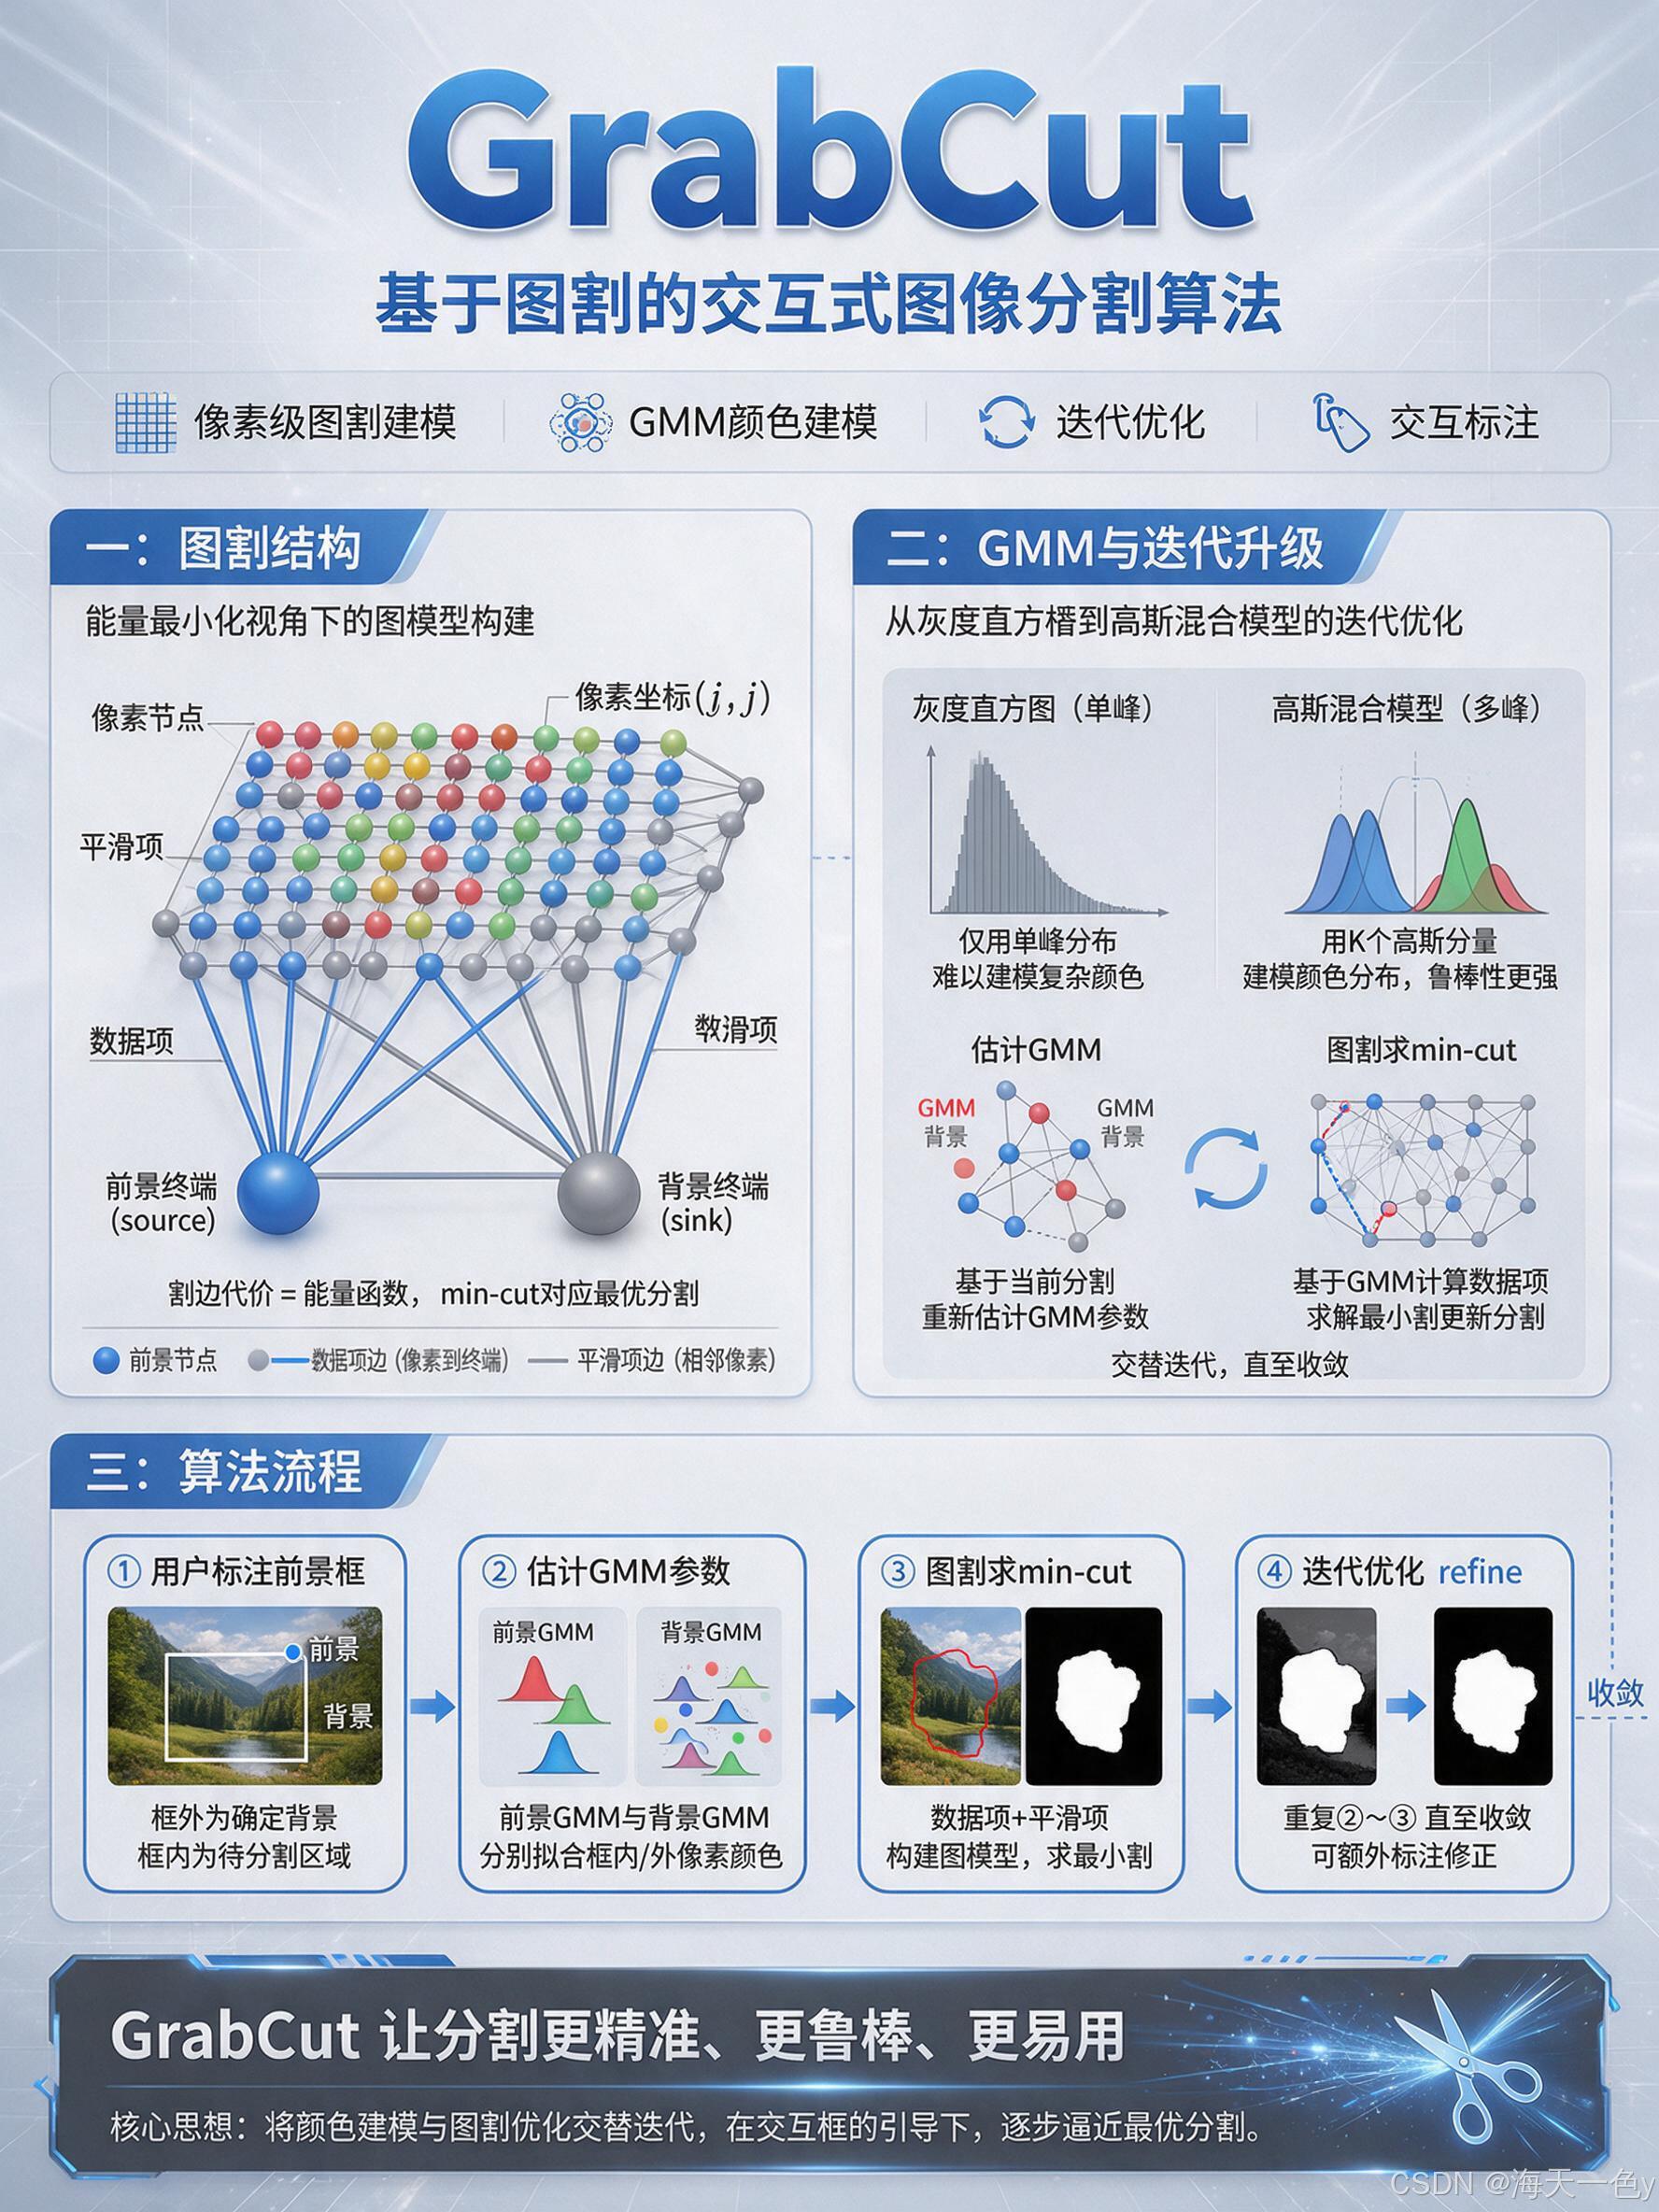
GrabCut 把分割建模为能量最小化的图割(Graph Cut)问题:每个像素是图中一个节点,相邻像素之间有"平滑项"边,像素与"前景/背景终端节点"之间有"数据项"边。割断这些边的代价就是能量函数:
E ( L ) = ∑ p D p ( L p ) ⏟ 数据项 + λ ∑ ( p , q ) ∈ N V p , q ( L p , L q ) ⏟ 平滑项 E(L) = \underbrace{\sum_{p} D_p(L_p)}{\text{数据项}} + \lambda \underbrace{\sum{(p,q)\in N} V_{p,q}(L_p, L_q)}_{\text{平滑项}} E(L)=数据项 p∑Dp(Lp)+λ平滑项 (p,q)∈N∑Vp,q(Lp,Lq)
GrabCut 的两大升级:
- 用 GMM(高斯混合模型) 代替灰度直方图建模颜色分布,鲁棒性更强;
- 采用迭代优化:先估计 GMM,再优化图割,交替进行,用户只需画一个前景框即可启动。
7.2 交互流程
- 用户框选前景区域,框外肯定为背景;
- 用框外像素训练背景 GMM,框内训练前景 GMM;
- 通过 min-cut 求最优分割;
- 重复 2-3 至收敛,用户可进一步标注 refine。
7.3 Python 实现
python
import cv2
import numpy as np
import matplotlib.pyplot as plt

img = cv2.imread('portrait.jpg')
img_rgb = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)

# 初始化 mask:0=明确背景, 1=前景, 2=可能背景, 3=可能前景
mask = np.zeros(img.shape[:2], np.uint8)

bgd_model = np.zeros((1, 65), np.float64)  # 背景 GMM
fgd_model = np.zeros((1, 65), np.float64)  # 前景 GMM

# 用户框选前景区域 [x, y, w, h]
rect = (50, 30, img.shape[1] - 100, img.shape[0] - 60)

# 第一次 GrabCut:用矩形初始化,迭代 5 次
cv2.grabCut(img, mask, rect, bgd_model, fgd_model, 5, cv2.GC_INIT_WITH_RECT)

# 把"可能前景"和"前景"都当前景
mask2 = np.where((mask == 1) | (mask == 3), 255, 0).astype('uint8')

# 可选:手动 refine(在可能错误处画线纠正)
# mask[y1:y2, x1:x2] = cv2.GC_FGD / cv2.GC_BGD
# cv2.grabCut(img, mask, None, bgd_model, fgd_model, 5, cv2.GC_INIT_WITH_MASK)

# 提取前景并叠加蒙版
result = cv2.bitwise_and(img_rgb, img_rgb, mask=mask2)

plt.figure(figsize=(12, 4))
plt.subplot(131); plt.imshow(img_rgb); plt.title('原图 + 框选')
plt.gca().add_patch(plt.Rectangle((rect[0], rect[1]), rect[2], rect[3],
                                  fill=False, edgecolor='red', linewidth=2))
plt.subplot(132); plt.imshow(mask2, cmap='gray'); plt.title('分割掩码')
plt.subplot(133); plt.imshow(result); plt.title('抠图结果')
plt.tight_layout(); plt.savefig('grabcut_result.png', dpi=150); plt.show()
7.4 MATLAB 实现
MATLAB 没有内置 grabcut,但 Image Processing Toolbox 提供 imsegfmm(基于测地距离的交互分割)可实现类似交互式抠图,也可调用 OpenCV 的 mex 接口。下面用 GraphCut / 测地距离 给出等价方案:
matlab
%% 交互式图割分割(GrabCut 思路)
clear; clc; close all;

img = imread('portrait.jpg');
figure; imshow(img); title('请用 roipoly 圈选前景');
% 交互:用户用鼠标绘制前景区域
bw = roipoly;
close;

% 基于前景/背景颜色直方图构建图割
% 这里用 grabcut 等价的测地线活动轮廓(GAC)近似
% 用前景种子做测地距离分割
seeds = bw;
% 计算图像梯度作为权重
G = imgradient(rgb2gray(img));
G = 1 ./ (G + eps);                  % 梯度小处代价低,易通过
L = imsegfmm(double(G), seeds, 0);   % 0-背景 1-前景
bw_segment = L == 1;

% 精化:结合颜色聚类 refine(GMM 思路)
cform = makecform('srgb2lab');
lab = applycform(img, cform);
features = reshape(double(lab), [], 3);
[idx, C] = kmeans(features, 5, 'Replicates', 3);
fg_idx = mode(idx(bw_segment(:)));   % 前景对应的主簇
refined = reshape(idx, size(img,1), size(img,2)) == fg_idx;

figure('Position', [100 100 1200 400]);
subplot(1,3,1); imshow(img);          title('原图');
subplot(1,3,2); imshow(refined);      title('分割掩码');
out = img; out(repmat(~refined,[1 1 3])) = 0;
subplot(1,3,3); imshow(out);          title('抠图结果');
🎯 适用场景:医学影像交互勾画、PS 抠图、证件照换背景。仅需一个矩形框即可获得像素级精度,是"人机协同"的经典范式。
8. 方法六:基于深度学习------U-Net 语义分割
8.1 原理
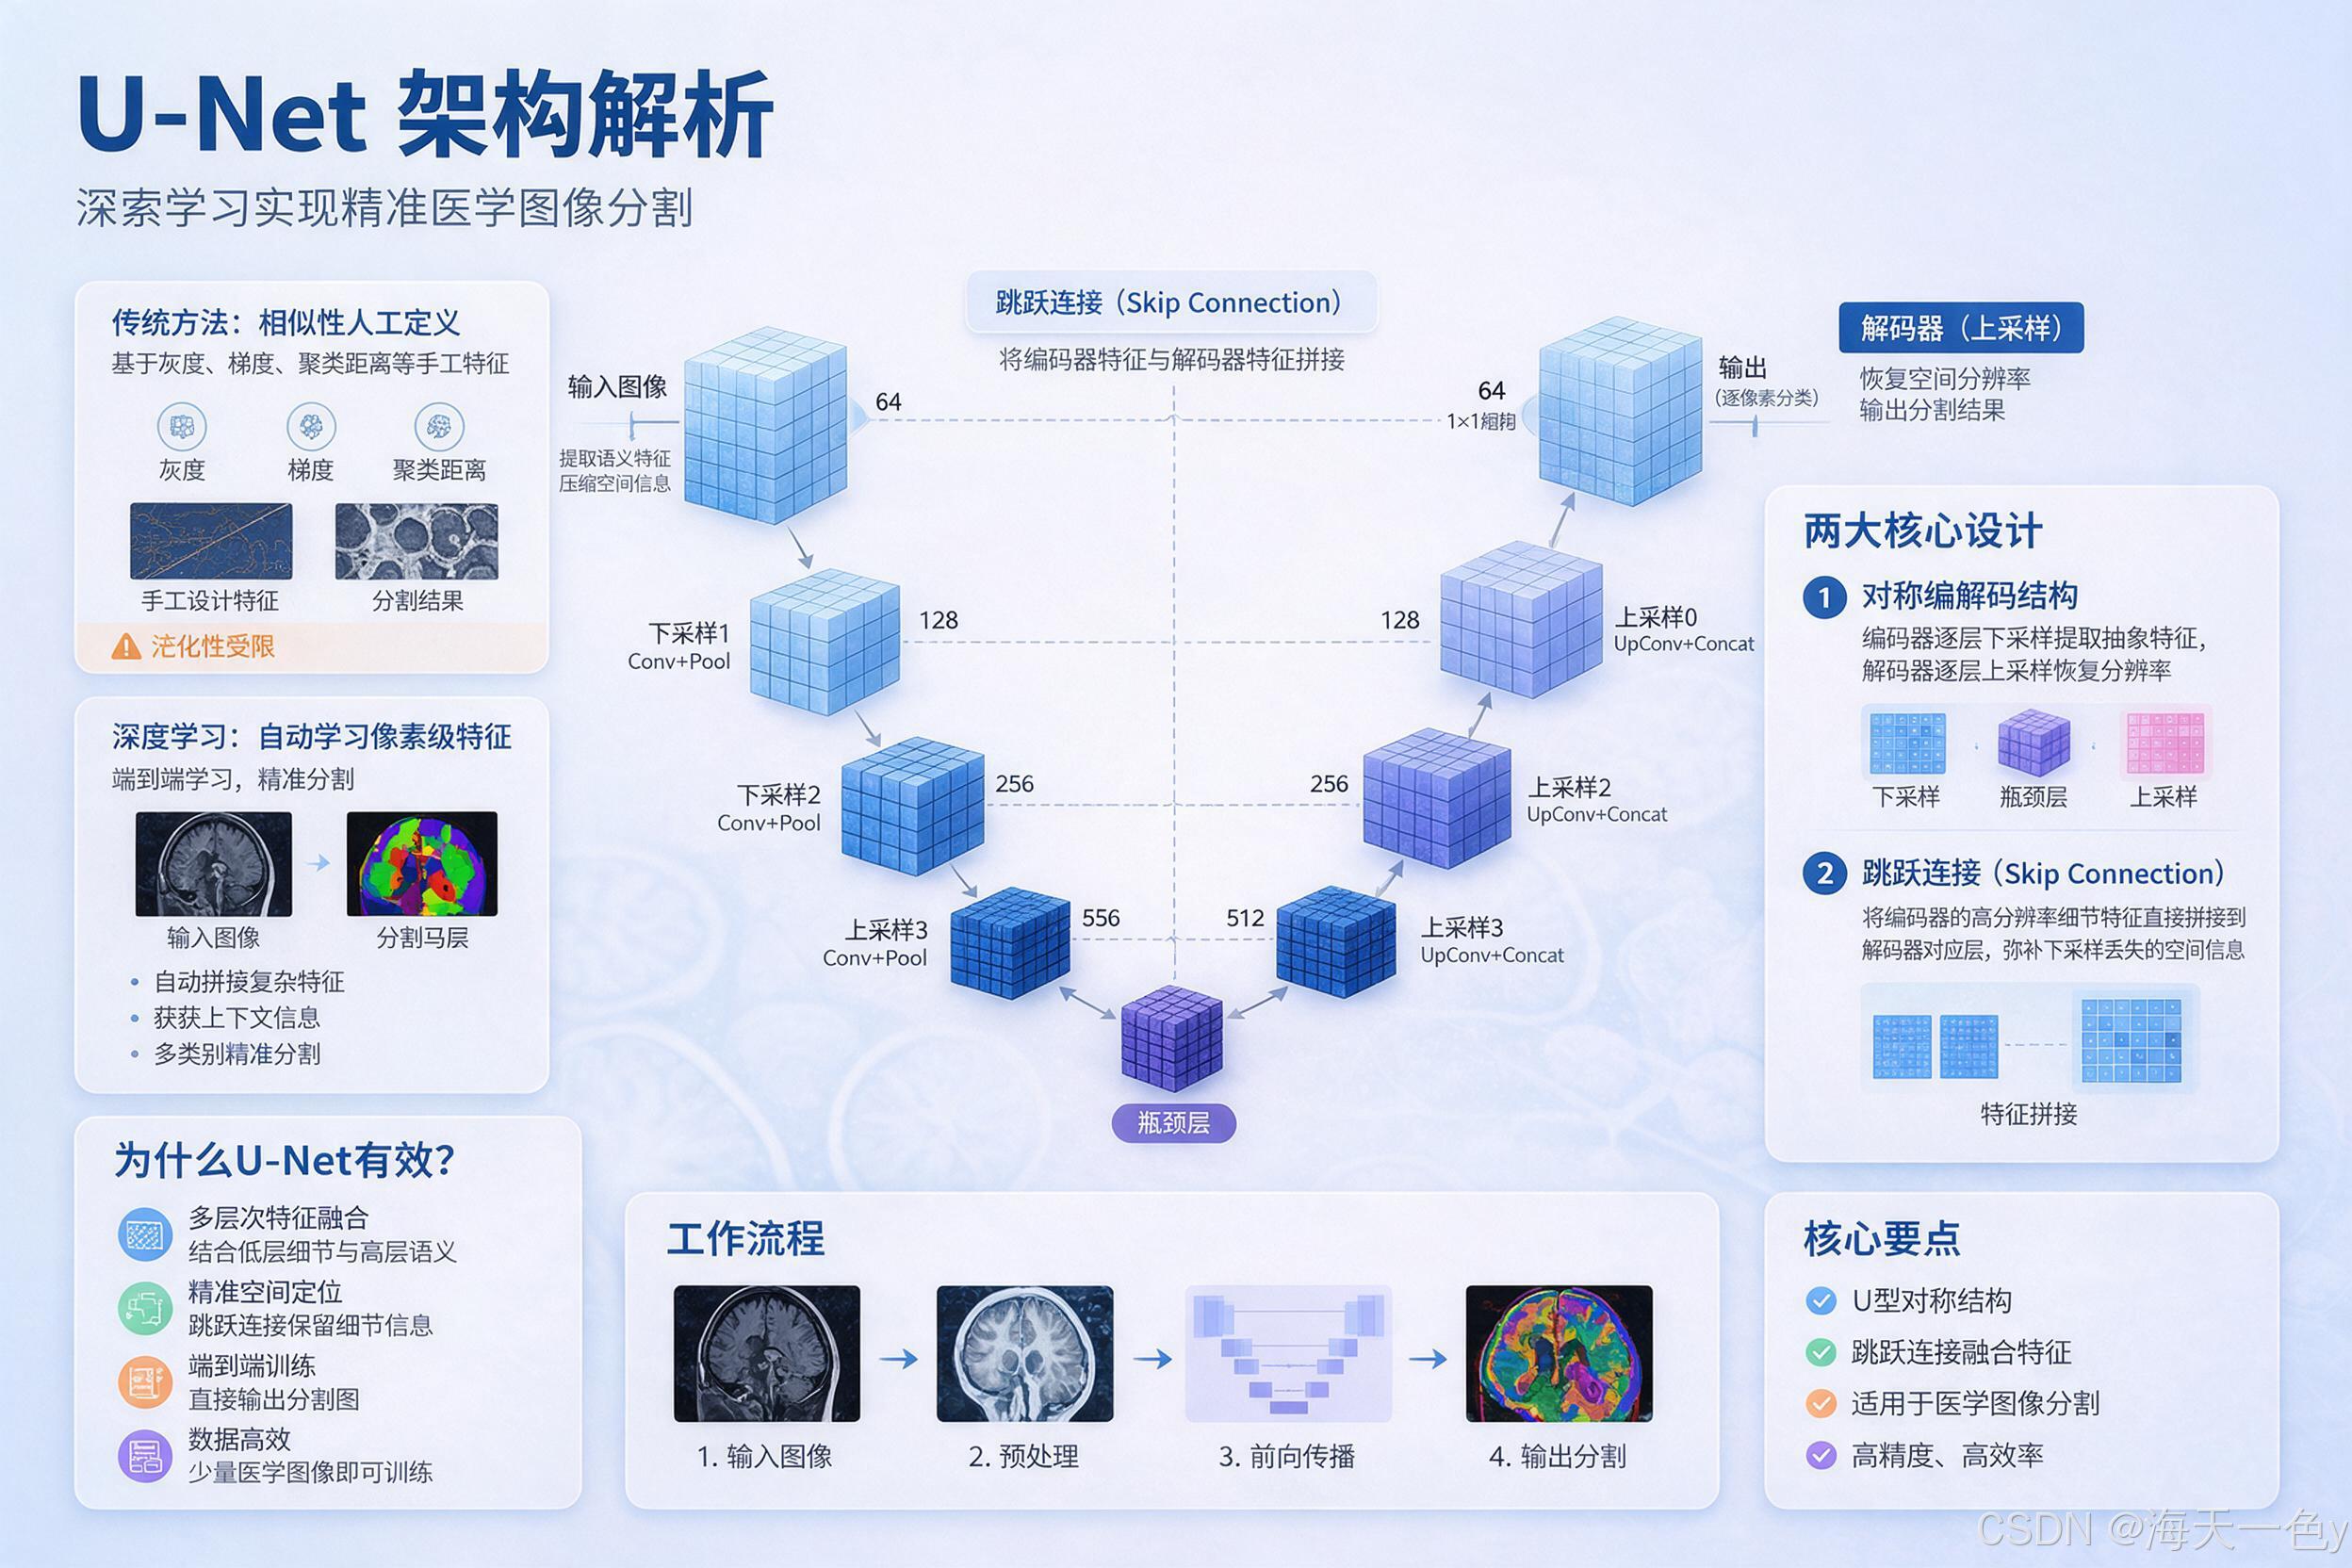
传统方法的"相似性"是人工定义的(灰度、梯度、聚类距离),泛化性受限。深度学习让网络从数据中自动学习像素级特征,分割精度实现了质的飞跃。
U-Net 因其结构形似字母 U 而得名,是医学图像分割的里程碑网络:
输入
  │
  ▼
[Conv-Conv-Pool] ──┐ 编码器(下采样):提取高层语义
[Conv-Conv-Pool] ──┤
[Conv-Conv-Pool] ──┤
[Conv-Conv] ───────┘ 瓶颈层
[UpConv-Conv] ──┐
[UpConv-Conv] ──┤ 解码器(上采样):恢复空间分辨率
[UpConv-Conv] ──┤   ↓ skip connection 跳跃连接
  ▼               将编码器特征与解码器特征拼接
输出(逐像素分类)两大核心设计:
- 对称编解码结构:编码器逐层下采样提取抽象特征,解码器逐层上采样恢复分辨率;
- 跳跃连接(Skip Connection) :把编码器的高分辨率细节特征直接拼接到解码器对应层,弥补下采样丢失的空间信息------这对医学影像等需要精确定位的任务至关重要。
损失函数 常用 Dice Loss(应对类别不平衡,如小病灶):
L D i c e = 1 − 2 ∑ i p i g i ∑ i p i + ∑ i g i \mathcal{L}_{Dice} = 1 - \frac{2 \sum_i p_i g_i}{\sum_i p_i + \sum_i g_i} LDice=1−∑ipi+∑igi2∑ipigi
其中 p i p_i pi 为预测概率, g i g_i gi 为真值。
8.2 Python 实现(PyTorch)
python
import torch
import torch.nn as nn
import torch.nn.functional as F

class DoubleConv(nn.Module):
    """(Conv -> BN -> ReLU) * 2"""
    def __init__(self, in_ch, out_ch):
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(in_ch, out_ch, 3, padding=1, bias=False),
            nn.BatchNorm2d(out_ch),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_ch, out_ch, 3, padding=1, bias=False),
            nn.BatchNorm2d(out_ch),
            nn.ReLU(inplace=True),
        )
    def forward(self, x):
        return self.block(x)

class UNet(nn.Module):
    def __init__(self, in_ch=1, num_classes=1):
        super().__init__()
        # 编码器(下采样)
        self.down1 = DoubleConv(in_ch, 64)
        self.down2 = DoubleConv(64, 128)
        self.down3 = DoubleConv(128, 256)
        self.down4 = DoubleConv(256, 512)
        self.pool  = nn.MaxPool2d(2)
        # 瓶颈层
        self.bottleneck = DoubleConv(512, 1024)
        # 解码器(上采样 + 跳跃连接)
        self.up4 = nn.ConvTranspose2d(1024, 512, 2, stride=2)
        self.up3 = nn.ConvTranspose2d(512, 256, 2, stride=2)
        self.up2 = nn.ConvTranspose2d(256, 128, 2, stride=2)
        self.up1 = nn.ConvTranspose2d(128, 64, 2, stride=2)
        self.dec4 = DoubleConv(1024, 512)
        self.dec3 = DoubleConv(512, 256)
        self.dec2 = DoubleConv(256, 128)
        self.dec1 = DoubleConv(128, 64)
        self.out_conv = nn.Conv2d(64, num_classes, 1)

    def forward(self, x):
        # 编码
        c1 = self.down1(x);          p1 = self.pool(c1)
        c2 = self.down2(p1);          p2 = self.pool(c2)
        c3 = self.down3(p2);          p3 = self.pool(c3)
        c4 = self.down4(p3);          p4 = self.pool(c4)
        # 瓶颈
        b  = self.bottleneck(p4)
        # 解码 + 跳跃连接(注意尺寸对齐)
        u4 = self.up4(b);  u4 = torch.cat([c4, u4], dim=1); d4 = self.dec4(u4)
        u3 = self.up3(d4); u3 = torch.cat([c3, u3], dim=1); d3 = self.dec3(u3)
        u2 = self.up2(d3); u2 = torch.cat([c2, u2], dim=1); d2 = self.dec2(u2)
        u1 = self.up1(d2); u1 = torch.cat([c1, u1], dim=1); d1 = self.dec1(u1)
        return self.out_conv(d1)


# ---------- 损失函数:Dice + BCE ----------
class DiceBCELoss(nn.Module):
    def __init__(self, smooth=1.0):
        super().__init__(); self.smooth = smooth
    def forward(self, logits, targets):
        probs = torch.sigmoid(logits)
        inter = (probs * targets).sum()
        dice  = 1 - (2 * inter + self.smooth) / (probs.sum() + targets.sum() + self.smooth)
        bce   = F.binary_cross_entropy_with_logits(logits, targets)
        return dice + bce


# ---------- 训练循环骨架 ----------
def train_unet(model, loader, epochs=50, lr=1e-4, device='cuda'):
    model = model.to(device)
    opt   = torch.optim.Adam(model.parameters(), lr=lr)
    loss_fn = DiceBCELoss()
    for epoch in range(epochs):
        model.train(); ep_loss = 0
        for imgs, masks in loader:
            imgs, masks = imgs.to(device), masks.to(device).float()
            logits = model(imgs)
            loss = loss_fn(logits, masks.unsqueeze(1))
            opt.zero_grad(); loss.backward(); opt.step()
            ep_loss += loss.item()
        print(f"Epoch {epoch+1}/{epochs}  Loss={ep_loss/len(loader):.4f}")
    return model


# ---------- 推理 ----------
@torch.no_grad()
def predict(model, img_tensor, device='cuda', thr=0.5):
    model.eval()
    logits = model(img_tensor.unsqueeze(0).to(device))
    prob = torch.sigmoid(logits)[0, 0].cpu().numpy()
    return (prob > thr).astype('uint8')
8.3 MATLAB 实现
MATLAB 的 Deep Learning Toolbox 内置了分割网络构建与训练,调用简洁:
matlab
%% U-Net 语义分割训练与推理
clear; clc; close all;

% 1. 准备数据:imds 存图像,pxds 存像素标签
imageDir = 'data/images/';
labelDir = 'data/labels/';
imds = imageDatastore(imageDir);
classNames = {'background', 'tumor'};
pxds = pixelLabelDatastore(labelDir, classNames, ...
        {0 1});   % 0->背景 1->肿瘤

% 2. 划分训练/验证
[imdsTrain, imdsVal, pxdsTrain, pxdsVal] = partitionData(imds, pxds, 0.8);

% 3. 构建 U-Net(内置 unetLayers)
imageSize = [256 256 1];
numClasses = numel(classNames);
lgraph = unetLayers(imageSize, numClasses);   % 一行建好 U-Net

% 4. 数据增强(随机翻转/平移)
augmenter = imageDataAugmenter( ...
    'RandXReflection', true, 'RandYReflection', true, ...
    'RandXTranslation', [-10 10], 'RandYTranslation', [-10 10]);
pxdsTrainAug = pixelLabelImageDatastore(imdsTrain, pxdsTrain, ...
    'DataAugmentation', augmenter);

% 5. 训练选项
options = trainingOptions('adam', ...
    'MaxEpochs', 50, 'MiniBatchSize', 8, ...
    'InitialLearnRate', 1e-3, 'Shuffle', 'every-epoch', ...
    'ValidationData', {readimage(imdsVal), read(pxdsVal)}, ...
    'Plots', 'training-progress');

% 6. 训练(Dice + 交叉熵,内置)
net = trainNetwork(pxdsTrainAug, lgraph, options);

% 7. 推理与可视化
testImg = imread('test.png');
pred = semanticseg(testImg, net);
overlay = labeloverlay(testImg, pred, 'Transparency', 0.5);

figure('Position', [100 100 1000 400]);
subplot(1,3,1); imshow(testImg); title('原图');
subplot(1,3,2); imshow(pred);    title('分割结果');
subplot(1,3,3); imshow(overlay); title('叠加显示');
🏥 U-Net 为何在医学领域封神:医学图像数据量小、目标边界要求像素级精确、类别极度不平衡,U-Net 的对称结构 + 跳跃连接完美匹配这些需求,仅用几十张标注图即可训练出可用模型。
9. 进阶前沿:Segment Anything (SAM) 与分割大模型
9.1 SAM 的革命性意义
2023 年 Meta 发布的 Segment Anything Model (SAM) 开创了"分割大模型"时代。它在 11 亿张图、11 亿个 mask 上训练,实现了零样本泛化(zero-shot):训练时没见过的物体、场景,也能精准分割。
SAM 的三组件架构:
┌─────────────┐     ┌──────────────┐     ┌──────────────┐
│ Image       │     │ Prompt       │     │ Mask        │
│ Encoder     │     │ Encoder      │     │ Decoder     │
│ (ViT-H)     │     │ (点/框/文本) │     │ (轻量解码)  │
└──────┬──────┘     └──────┬───────┘     └──────▲──────┘
       │                   │                    │
       └───────────┬───────┴────────────────────┘
                   ▼
图像嵌入 (一次编码,多次复用)- Image Encoder:用 ViT-H 把图像编码为特征嵌入,一张图只算一次;
- Prompt Encoder:编码用户的点、框、文本提示;
- Mask Decoder:结合图像嵌入和提示,毫秒级输出 mask。
9.2 SAM 零样本分割(Python)
python
# pip install segment-anything torch torchvision
import cv2
import numpy as np
import torch
from segment_anything import sam_model_registry, SamPredictor
import matplotlib.pyplot as plt

# 加载 SAM(下载权重 sam_vit_h_4b8939.pth)
sam = sam_model_registry["vit_h"](checkpoint="sam_vit_h_4b8939.pth")
sam.to("cuda")
predictor = SamPredictor(sam)

img = cv2.imread('dog.jpg')
img_rgb = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
predictor.set_image(img_rgb)              # 一次编码

# 模式一:点击分割(给一个前景点)
point_coords = np.array([[320, 240]])     # [x, y]
point_labels = np.array([1])             # 1=前景, 0=背景
masks, scores, _ = predictor.predict(
    point_coords=point_coords,
    point_labels=point_labels,
    multimask_output=True,               # 输出3个候选mask
)
best = masks[scores.argmax()]            # 取置信度最高的

# 模式二:自动分割整图所有物体
from segment_anything import SamAutomaticMaskGenerator
mask_gen = SamAutomaticMaskGenerator(sam)
all_masks = mask_gen.generate(img_rgb)

plt.figure(figsize=(12, 4))
plt.subplot(131); plt.imshow(img_rgb)
plt.scatter(*point_coords[0], c='red', s=100); plt.title('点提示')
plt.subplot(132); plt.imshow(np.where(best[...,None], img_rgb, 0)); plt.title('单点分割')
plt.subplot(133)
for m in all_masks:
    plt.imshow(m['segmentation'], alpha=0.3)
plt.title(f'自动分割 ({len(all_masks)} 个物体)')
plt.tight_layout(); plt.savefig('sam_result.png', dpi=150); plt.show()
9.3 SAM 2 与最新趋势
2024 年 Meta 发布 SAM 2 ,将能力从图像扩展到视频分割:
- 引入流记忆机制(Streaming Memory),可在视频序列中持续跟踪目标;
- 支持点击式交互视频分割,标记首帧即可全程追踪;
- 在视频分割基准 DAVIS、MOSE 上大幅超越此前所有方法。
此外,Grounding DINO + SAM 组合实现了"说一句话就分割"(文本驱动分割),Med-SAM 把大模型迁移到医学领域。分割正从"专用算法"走向"通用基础设施"。
10. 六大算法横向对比与选型指南
| 方法 | 原理 | 优点 | 缺点 | Python 关键 API | 适用场景 |
|---|---|---|---|---|---|
| Otsu 阈值 | 最大化类间方差 | 极快、无参数、易实现 | 仅适用双峰直方图 | cv2.threshold(.., THRESH_OTSU) |
文档二值化、简单前景背景 |
| Canny 边缘 | 梯度+NMS+双阈值 | 边缘精细、定位准 | 断边、需后处理闭合 | cv2.Canny() |
目标轮廓提取 |
| 分水岭 | 梯度地形注水 | 边界贴合、可处理粘连 | 易过分割、需标记 | cv2.watershed() |
细胞/颗粒计数 |
| K-Means | 像素聚类 | 无监督、彩色图友好 | 需指定 K、对噪声敏感 | cv2.kmeans() |
场景分层、颜色量化 |
| GrabCut | 图割+GMM | 像素级精确、交互友好 | 需交互、慢 | cv2.grabCut() |
抠图、医学勾画 |
| U-Net | 深度编解码 | 精度高、泛化强 | 需标注数据、需 GPU | PyTorch 自定义 | 医疗、自动驾驶 |
| SAM | 分割大模型 | 零样本、全场景 | 资源消耗大 | SamPredictor |
通用分割、标注辅助 |
选型决策树
有大量标注数据吗?
├── 是 → U-Net / SAM(精度最高)
└── 否
    ├── 能交互(画框/点)?
    │   ├── 是 → GrabCut(像素级精度)
    │   └── 否
    │       ├── 前景背景灰度差异大?
    │       │   ├── 是 → Otsu(最快)
    │       │   └── 否 → 分水岭 / K-Means
    │       └── 多目标粘连?→ 分水岭(标记控制)
11. 实战踩坑与工程经验
11.1 预处理决定上限
80% 的分割效果提升来自预处理,而非换算法。
- 去噪:高斯/中值/双边滤波,先去噪再分割;
- 光照校正:直方图均衡化(CLAHE)、Retinex;
- 颜色空间:肤色检测用 HSV/YCrCb,自然场景用 L*a*b*。
11.2 后处理决定下限
- 形态学开闭运算:去除小噪点、填小洞、平滑边界;
- 连通域过滤 :用
bwareaopen/cv2.connectedComponentsWithStats去除过小区域; - 边缘平滑 :对分割边界做
active contour(活动轮廓)精修。
11.3 评价指标别只看 Accuracy
类别不平衡时 Accuracy 会骗人,推荐:
IoU = ∣ A ∩ B ∣ ∣ A ∪ B ∣ , Dice = 2 ∣ A ∩ B ∣ ∣ A ∣ + ∣ B ∣ , mIoU = 1 C ∑ c = 1 C IoU c \text{IoU} = \frac{|A \cap B|}{|A \cup B|}, \quad \text{Dice} = \frac{2|A \cap B|}{|A| + |B|}, \quad \text{mIoU} = \frac{1}{C}\sum_{c=1}^{C} \text{IoU}_c IoU=∣A∪B∣∣A∩B∣,Dice=∣A∣+∣B∣2∣A∩B∣,mIoU=C1c=1∑CIoUc
Python 评估代码:
python
def iou_dice(pred, gt, smooth=1e-6):
    pred = pred.astype(bool); gt = gt.astype(bool)
    inter = (pred & gt).sum()
    union = (pred | gt).sum()
    return (inter + smooth) / (union + smooth), \
           (2 * inter + smooth) / (pred.sum() + gt.sum() + smooth)
11.4 跨语言协作建议
- 研究/原型:Python(生态丰富,PyTorch/TF 一站式);
- 工业部署/MATLAB 用户:MATLAB 调试直观、矩阵运算天然,适合算法验证和教学;
- 混合方案 :用 Python 训练模型 →
ONNX导出 → MATLABimportONNXNetwork部署,或反向用 MATLAB 训练 → ONNX → Python 推理。
12. 总结与展望
我们从经典 走到前沿:
- 阈值法(Otsu)让我们理解了"什么是最优分界";
- 边缘法(Canny)教会我们捕捉灰度突变;
- 分水岭把图像看作地形,用"注水筑坝"的几何直觉解决粘连目标;
- 聚类(K-Means)把分割归约为无监督分类;
- 图割(GrabCut)用能量最小化统一了数据项与平滑项;
- U-Net 让网络自动学习特征,突破了人工设计的瓶颈;
- SAM 用大模型实现了零样本通用分割,重写了行业范式。
未来趋势
- 统一大模型:SAM 2 等向"图像+视频+3D"统一分割演进;
- 多模态融合:文本、点云、RGB-D 联合驱动分割;
- 轻量化部署:蒸馏、量化让大模型跑在端侧;
- 自监督/弱监督:减少对精细标注的依赖;
- 分割即标注:SAM 反过来加速医学/遥感数据标注,形成飞轮。
给读者的建议
🚀 不要做算法收藏家,要做问题解决者。 没有最强的算法,只有最合适的算法。先用最简单的方法(Otsu/K-Means)跑通基线,定位瓶颈,再针对性地升级。深度学习不是万能药,传统方法的可解释性和效率在很多工业场景依然不可替代。
📎 附录:运行环境与数据集
Python 依赖:
bash
pip install opencv-python scikit-image scipy numpy matplotlib \
            torch torchvision segment-anything
MATLAB 工具箱: Image Processing Toolbox、Deep Learning Toolbox、Computer Vision Toolbox(SAM 接口)
公开数据集推荐:
| 数据集 | 类型 | 用途 |
|---|---|---|
| BSDS500 | 自然图像 | 经典分割基准 |
| COCO | 通用 | 实例分割 |
| Cityscapes | 街景 | 自动驾驶语义分割 |
| ISIC | 皮肤镜 | 医学病灶分割 |
| DAVIS | 视频 | 视频目标分割 |
如果这篇内容对你有帮助,欢迎 点赞、收藏、关注,我会持续分享计算机视觉与深度学习的硬核干货。你的关注是我持续创作的最大动力! 🌟