先看一个很常见的现象:表单里批量校验手机号,一列号码格式明明都对,却总有几个被判成不合法,而且是隔一个错一个。
原因往往只有一个字符:正则后面多了个 g。
这类问题的共同点是,正则本身写得没错,错的是 JavaScript 里正则对象和字符串方法之间的那些「约定」。下面整理六个高频的坑,每个都附了能直接在 Node 里跑的代码和实际输出(Node 25.8 实测)。
一、带 g 的正则反复 test(),结果一真一假
先复现开头那个问题:
js
const re = /\d+/g;
console.log(['a1', 'b2', 'c3', 'd4'].map(s => re.test(s)));
// [ true, false, true, false ]

const isNum = /^\d+$/g;
console.log(['123', '456', '789'].filter(s => isNum.test(s)));
// [ '123', '789' ]   ← 456 被丢了
原因是带 g(或 y)的正则对象有个可写的 lastIndex 属性。test() 和 exec() 每次都从 lastIndex 开始找 ,找到了就把 lastIndex 设成匹配结束的位置,找不到才重置为 0。
走一遍第二个例子:
| 调用 | 开始位置 | 结果 | 调用后 lastIndex |
|---|---|---|---|
| test('123') | 0 | true | 3 |
| test('456') | 3 | false(从第 3 位往后已经没东西了) | 0 |
| test('789') | 0 | true | 3 |
所以「隔一个错一个」。
修法很简单:做校验的正则不要加 g 。g 的意思是「在一个字符串里找所有匹配」,校验「整个字符串是否合法」根本用不到它。如果这个正则是别处传进来的、改不了,就在每次用之前 re.lastIndex = 0。
这个坑还有个更隐蔽的版本:把正则定义在模块顶层当常量复用,平时单次调用没事,一到循环或者 filter 里就出问题。
二、exec 循环遇到空匹配,直接死循环
老写法里,找所有匹配常用 while + exec:
js
const re = /x*/g;
let m, k = 0;
while ((m = re.exec('ab')) !== null && k < 5) { k++; }
console.log(re.lastIndex); // 0
我加了 k < 5 的保护,去掉它这段代码就卡死了。x* 可以匹配空字符串,在位置 0 匹配到一个长度为 0 的结果,lastIndex 被设成 0 + 0 = 0,下一次还从 0 开始,永远出不来。
*、?、{0,n} 开头的模式,以及 ^、\b 这类零宽断言,都可能产生空匹配。用户在页面上输入正则的场景尤其要防。
两种修法:
js
// 修法 1:手动推进
while ((m = re.exec(str)) !== null) {
  if (m.index === re.lastIndex) re.lastIndex++;
  // ...
}

// 修法 2:直接用 matchAll,引擎替你处理
console.log([...'axb'.matchAll(/x*/g)].map(m => [m.index, m[0]]));
// [ [ 0, '' ], [ 1, 'x' ], [ 2, '' ], [ 3, '' ] ]
能用 matchAll 就用 matchAll,它要求正则必须带 g(不带会直接抛 TypeError),而且每次调用内部会复制一份正则,不会改动你传进去那个对象的 lastIndex,顺带把第一个坑也躲开了。
三、replace 传字符串只换第一个
js
console.log('2026-09-29'.replace('-', '/'));
// 2026/09-29
很多从 Python、Java 转过来的同学会默认 replace 是全部替换,其实第一个参数是字符串时只换第一处。要全换有两种写法:replace(/-/g, '/') 或者 replaceAll('-', '/')。
注意 replaceAll 如果传正则,必须带 g,否则直接报错:
js
'2026-09-29'.replaceAll(/-/, '/');
// TypeError: String.prototype.replaceAll called with a non-global RegExp argument
这个报错反而是好事,至少不会静默出错。
四、替换内容里的 $ 会被解释
做模板替换时很容易遇到:
js
const tpl = '价格:{price}';
const price = '$&100';
console.log(tpl.replace('{price}', price));
// 价格:{price}100
replace 的第二个参数如果是字符串,里面的 $&(整个匹配)、$1(第 1 个分组)、`````、`'、$$都有特殊含义。上面$&被替换成了匹配到的{price}` 本身,于是输出了一个很诡异的结果。
替换内容来自用户输入、数据库、接口返回时,用函数形式:
js
console.log(tpl.replace('{price}', () => price));
// 价格:$&100
函数的返回值会原样插入,不做任何 $ 解析。另外如果你确实想插入一个 $,字符串形式要写 $$:'a.b'.replace('.', '$$') 得到 a$b。
五、用户输入直接拼进 new RegExp
做搜索高亮时很常见:
js
new RegExp('c++');
// SyntaxError: Invalid regular expression: /c++/: Nothing to repeat

new RegExp('a.b').test('axb');
// true   ← 用户搜 a.b,结果 axb 也被高亮了
前者直接崩,后者是静默的错误匹配,更难发现。要把用户输入当作字面量,先转义:
js
const esc = s => s.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
console.log(new RegExp(esc('c++')).test('I love c++'), new RegExp(esc('a.b')).test('axb'));
// true false
这里的 '\\$&' 正好用上了第四个坑里的 $&:把每个特殊字符替换成「反斜杠 + 它自己」。
好消息是 ES2025 加了 RegExp.escape,Node 25 里已经能用:
js
RegExp.escape('c++'); // '\\x63\\+\\+'开头的 c 被转成了 \x63,这是为了防止转义结果拼到别的正则后面时和前面的内容粘在一起(比如接在 \ 后面)。看着怪,但结果是对的。需要兼容老浏览器的项目,先用上面那个 esc 函数。
六、emoji 和生僻字:不加 u 就按「半个字」算
js
console.log('😀'.length);          // 2
console.log(/^.$/.test('😀'));     // false
console.log(/^.$/u.test('😀'));    // true
console.log(/^[😀]$/.test('😀'));  // false
console.log(/^[😀]$/u.test('😀')); // true
JavaScript 字符串是 UTF-16,基本平面以外的字符(emoji、一部分生僻字)占两个码元。不加 u 标志,. 和字符类 [...] 都按码元算,一个 emoji 会被当成两个「字符」。昵称长度校验、限制输入 N 个字这类需求,不加 u 就会算错。
还有更麻烦的情况:
js
console.log('👨👩👧'.length, [...'👨👩👧'].length); // 8 5这个「一家三口」看起来是一个字,实际是 3 个 emoji 用零宽连接符拼起来的,u 标志下按码点算也是 5 个。要按「用户看到的字」计数,得用 Intl.Segmenter,正则解决不了。这是正则能力的边界,不是写法问题。
调试时的一个习惯
上面这些坑,有一半是「我以为匹配到了 A,其实匹配到了 B」。所以我写完正则会先拿几条真实样本跑一遍,看它到底匹配了哪几段、在什么位置。
我平时用的是 福兮的正则测试工具,下面这张是拿秋招日程文本测日期正则的实际结果:
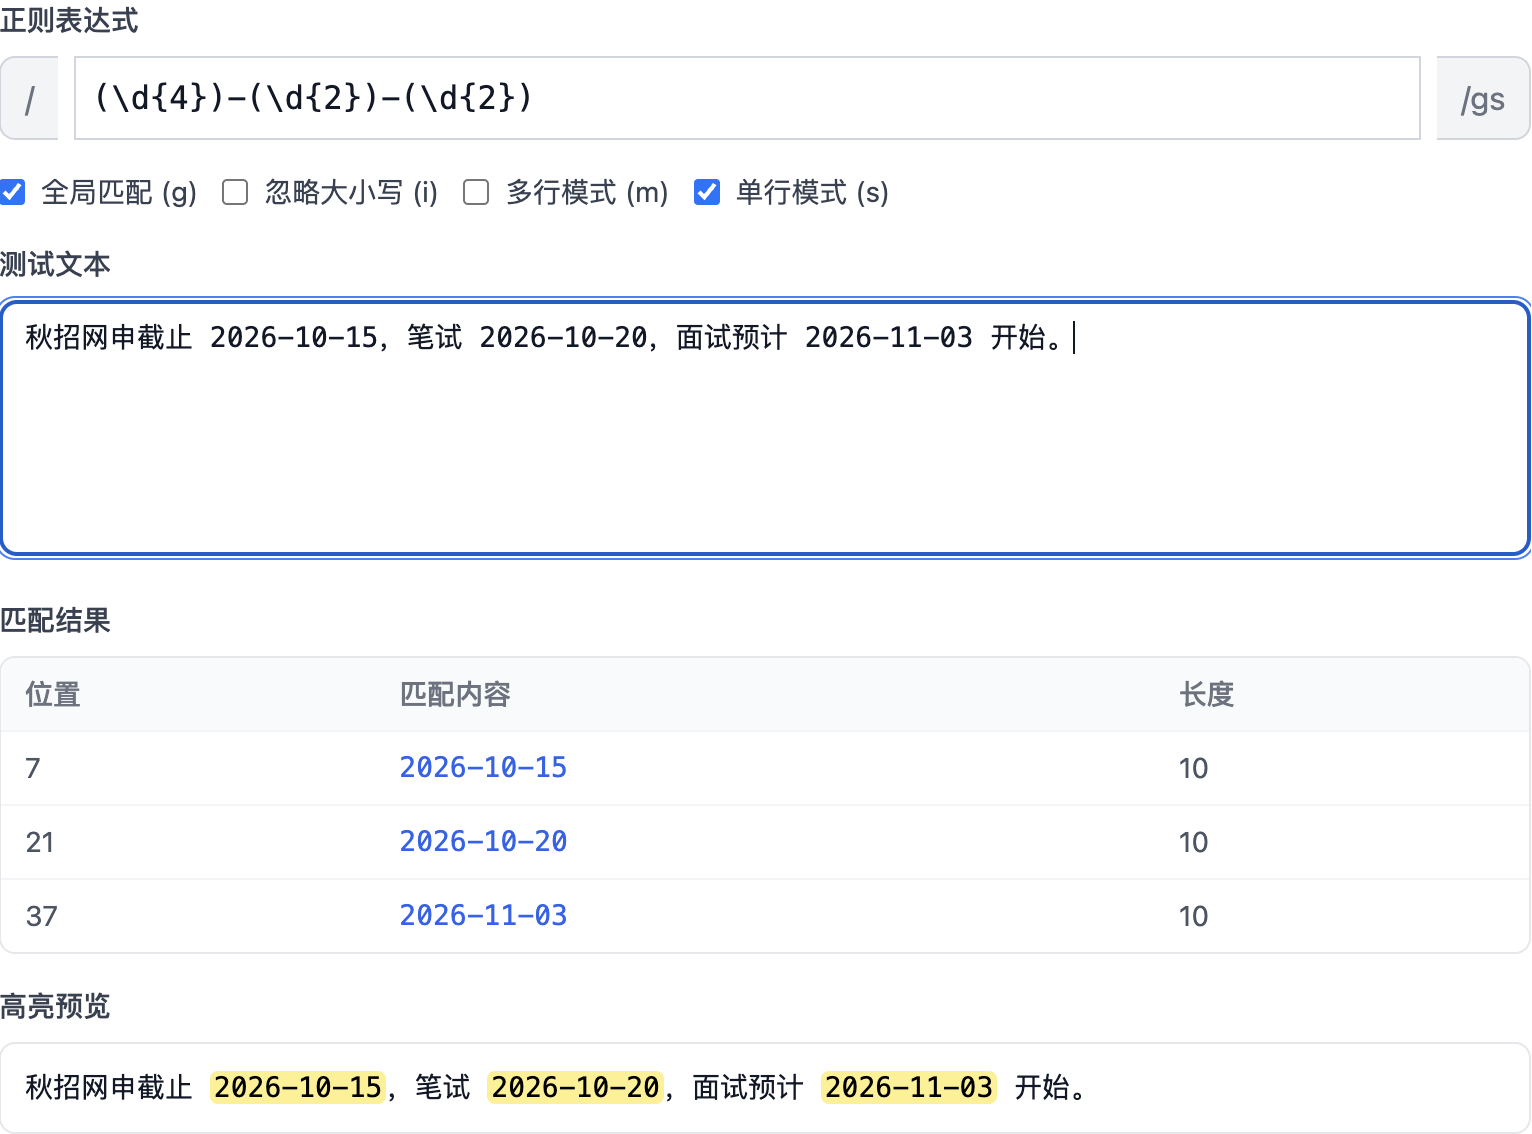
它会列出每个匹配的起始位置、内容和长度,下面有高亮预览,g / i / m / s 四个标志可以勾选,在浏览器本地算,不用登录。说两个局限:结果表只列整段匹配,不单独展开捕获组,想看 $1、$2 各是什么还得自己在控制台 exec 一下;零长度的匹配不会列在表里,所以第二个坑那种空匹配问题,用它是看不出来的。
小结
| 坑 | 一句话修法 |
|---|---|
| g + test() 一真一假 | 校验用的正则不加 g,或每次前重置 lastIndex |
| exec 空匹配死循环 | 改用 matchAll,或 index 等于 lastIndex 时手动加一 |
| replace 只换第一个 | 用 /x/g 或 replaceAll |
| 替换内容里的 $ | 替换值不可控时用函数形式 |
| 用户输入拼正则 | 先转义,新环境用 RegExp.escape |
| emoji 被当两个字 | 加 u;按可见字计数用 Intl.Segmenter |
回头看开头那个手机号校验,改法就是删掉一个 g。难的不是改,是想到「正则对象是有状态的」这个方向。