上一篇,我们把线程的基本概念,以及它和进程之间的那层关系,里里外外捋了一遍。今天,正式进入Linux多线程编程的实战环节。
这次我们要拿下的,是pthread线程库提供的那套核心控制接口,线程怎么创建、怎么等待、怎么退出、怎么取消,还有线程分离。把这些接口一个个摸透,线程从出生到消亡的完整生命周期,以及背后那套系统机制,也就跟着浮出水面了。
目录
[一、认识 pthread------Linux线程的用户层接口](#一、认识 pthread——Linux线程的用户层接口)
[1.1 为什么需要 pthread 线程库](#1.1 为什么需要 pthread 线程库)
[1.2 从系统调用到pthread------多线程的层层封装](#1.2 从系统调用到pthread——多线程的层层封装)
[1.2.1 从底层实现到用户接口------完整调用链路](#1.2.1 从底层实现到用户接口——完整调用链路)
[1.2.2 C++11等高级语言如何实现跨平台线程](#1.2.2 C++11等高级语言如何实现跨平台线程)
二、pthread线程控制------创建、等待与获取线程ID
[2.1 线程创建与线程等待](#2.1 线程创建与线程等待)
[2.1.1 pthread_create:创建一个新线程](#2.1.1 pthread_create:创建一个新线程)
[2.1.2 pthread_join:等待线程结束并回收资源](#2.1.2 pthread_join:等待线程结束并回收资源)
[2.1.3 pthread_self:获取当前线程ID](#2.1.3 pthread_self:获取当前线程ID)
[2.1.4 用Demo理解线程创建与等待](#2.1.4 用Demo理解线程创建与等待)
[2.1.5 让线程真正执行一个任务](#2.1.5 让线程真正执行一个任务)
[2.2 线程终止与线程取消](#2.2 线程终止与线程取消)
[2.2.1 线程有哪些终止方式](#2.2.1 线程有哪些终止方式)
[2.2.2 pthread_cancel:如何取消一个线程](#2.2.2 pthread_cancel:如何取消一个线程)
[2.3 线程分离:不再等待线程退出](#2.3 线程分离:不再等待线程退出)
[2.3.1 为什么需要线程分离](#2.3.1 为什么需要线程分离)
[2.3.2 pthread_detach:设置线程分离状态](#2.3.2 pthread_detach:设置线程分离状态)
[2.4 几个容易忽略的线程问题](#2.4 几个容易忽略的线程问题)
[2.4.1 新线程能不能继续创建线程](#2.4.1 新线程能不能继续创建线程)
[2.4.2 新线程能不能取消主线程](#2.4.2 新线程能不能取消主线程)
[2.5 线程终止与分离------完整Demo验证](#2.5 线程终止与分离——完整Demo验证)
[2.5.1 pthread_detach线程分离Demo](#2.5.1 pthread_detach线程分离Demo)
[2.5.2 线程终止Demo](#2.5.2 线程终止Demo)
一、认识 pthread------Linux线程的用户层接口
1.1 为什么需要 pthread 线程库
在操作系统层面,Linux压根没有传统意义上那种独立、纯粹的"线程"概念。内核眼里只有轻量级进程(LWP,Light Weight Process),真正干活的,是clone、vfork这类系统调用,靠它们创建出共享地址空间的进程。可对用户来说,谁管你底层是进程还是LWP?开发者只关心"线程"这个抽象概念,关心怎么创建、怎么同步、怎么退出。需求在用户层,实现却在内核层,中间隔着一道鸿沟。
为了把这道沟填上,Linux掏出了pthread库,也就是POSIX线程库,江湖人称"原生线程库"。它干的事很纯粹:**把底层那些轻量级进程的系统调用封装起来,向上层暴露一套标准的线程创建与控制接口。**内核负责实现,pthread负责翻译,用户只管调用。
1.2 从系统调用到pthread------多线程的层层封装
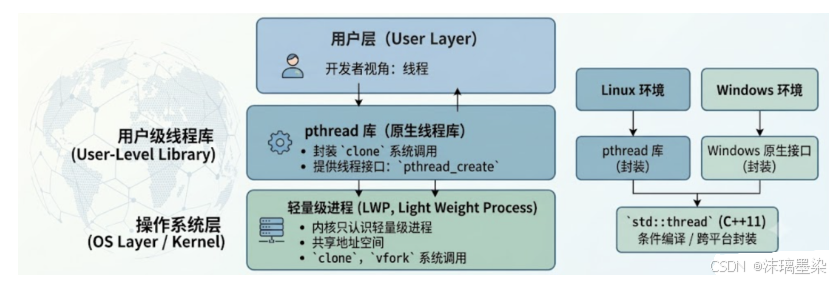
Linux 的线程实现,归根结底是搭在用户层的。用户不需要操心底下LWP那套细节,整套结构,是一层套一层垒起来的。
1.2.1 从底层实现到用户接口------完整调用链路
-
用户层:不同语言各自封装了不同的线程库。比如C++11的并发支持库,让你写多线程不用碰pthread的原生接口。
-
原生线程库层(pthread):对底层接口再做一层封装,把系统调用包装成标准、好用的线程控制接口。
-
操作系统层(OS):内核提供clone等系统调用,创建出与父进程共享地址空间的轻量级进程。这一层,才是真正动手干活的地方。
从内核的clone,到pthread的封装,再到各语言线程库的二次包装,一层叠一层,越往上越好用,越往下越接近真相。用户站在最顶端,看到的只有"线程"两个字,至于底下是怎么折腾的,全被封装挡得严严实实。
1.2.2 C++11等高级语言如何实现跨平台线程
像C++11里的std::thread,为什么能跨平台到处跑?秘密就藏在条件编译里。它自己并不直接跟操作系统打交道,而是根据不同平台,做一层二次封装:
- Linux环境下:std::thread本质上就是对pthread库的进一步包装。
- Windows环境下:它则转去封装Windows系统原生的创建线程接口。
一套代码,两种底层。你写的是std::thread,编译器在背后替你选了对应的那套实现。
看个例子:
cpp
// C++11 的并发支持库
void hello() {
    while (true)
        std::cout << "新线程: hello world" << std::endl;
}

int main() {
    std::thread t(hello);
    while (true)
        std::cout << "我是主线程..." << ", pid: " << getpid() << std::endl;
    t.join();
    return 0;
}
主线程和新线程各跑各的,谁也不碍谁。std::thread把pthread那一堆原生接口全挡在了后面,你只管建线程、等线程,平台差异一概不用操心。这就是封装的威力,底下的脏活累活,交给库去扛。
二、pthread线程控制------创建、等待与获取线程ID
2.1 线程创建与线程等待
pthread这一套函数,名字几乎清一色以pthread_打头,一眼扫过去,就知道它们是同一个家族的。要用它们,得先引入头文件<pthread.h>。
编译链接的时候,别忘了带上-lpthread选项,否则链接器找不到这些函数的实现,直接报错。
2.1.1 pthread_create:创建一个新线程
函数原型:
cpp
int pthread_create(pthread_t *thread, const pthread_attr_t *attr,
                   void *(*start_routine)(void *), void *arg);
参数逐个拆:
- thread:输出型参数,用来带回创建成功的线程ID,也就是tid。注意,这个tid是pthread库自己维护的概念,别直接跟内核里的LWP混为一谈。一个在用户层,一个在内核层,层次不同。
- attr:线程属性。平时直接传nullptr,用默认属性就行,省事。
- start_routine:函数指针,新线程要跑的入口函数。
- arg:传给start_routine的参数。
返回值:
成功返回0;失败返回错误码,而且此时*thread里的内容是未定义的,别去碰。
这里有个地方容易搞混,得说清楚:
main函数一结束,代表主线程结束,通常也代表整个进程结束。而新线程的入口函数跑完,只代表当前这条线程运行结束,进程还在不在,得看别的线程。另外,pthread函数的报错方式,跟传统函数不太一样。传统函数往往是成功返回0、失败返回-1,再顺手给全局变量errno赋个值。但 pthreads函数不设errno,它把错误码直接通过返回值交给你。
当然,pthreads也提供了线程内的errno变量,好让那些依赖errno的代码能正常跑。但判断 pthreads 函数的错误,还是建议看返回值,读返回值,比读线程内的errno开销更小,也更直接。
2.1.2 pthread_join:等待线程结束并回收资源
新线程创建出来之后,必须有人等它。主线程也好,其他线程也罢,总得有个"收尸"的。没人等,它退出了就会变成类似僵尸进程的东西,资源收不回来,内存跟着漏。
函数原型:
cpp
int pthread_join(pthread_t thread, void **retval);参数和作用:
- thread:要等待的目标线程ID,也就是pthread_create拿到的那一个。
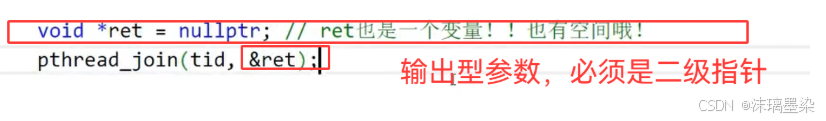
- retval:输出型参数,用来接收目标线程退出时的返回值。
为什么 join 的参数里,没有异常相关的字段?
因为等待的目标线程一旦发生异常,整个进程都会跟着崩溃退出,主线程也跑不掉。这种情况下,再想在join里捕获异常,已经没有任何意义了。join这套接口,设计时针对的就是线程正常跑完的场景。异常信号那是进程层面的事,轮不到join来操心。
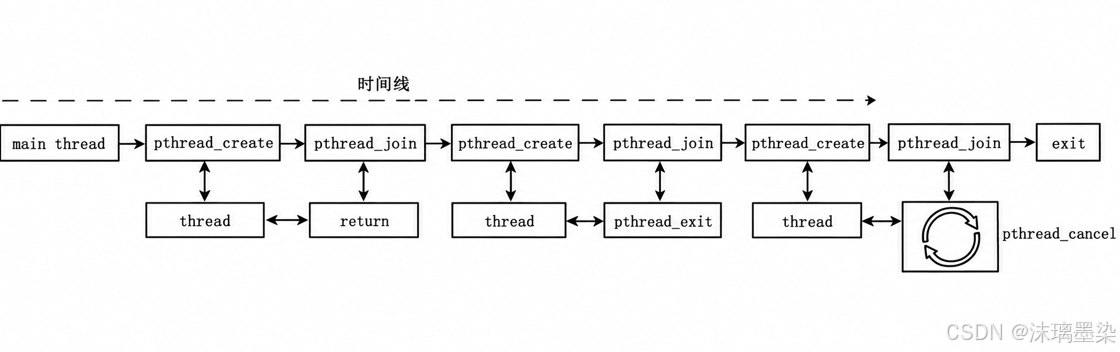
调用pthread_join的线程会挂起等待,直到ID为thread的那条线程终止。目标线程以不同的方式结束,join拿到的终止状态也不一样:
- 如果线程通过return返回,retval指向的单元里,放的是线程函数的返回值。
- 如果线程被其他线程调用pthread_cancel异常终止,retval指向的单元里,放的是常量PTHREAD_CANCELED。
- 如果线程自己调用pthread_exit终止,retval指向的单元里,放的是传给pthread_exit的参数。
- 如果对目标线程的终止状态压根不感兴趣,retval直接传NULL就行。
2.1.3 pthread_self:获取当前线程ID
函数原型:
cpp
pthread_t pthread_self(void);作用很简单:返回调用线程自己的线程ID,也就是tid。
Tips:关于线程ID的几个误区
很多人对线程ID有误解。我们打印一个出来看看,它其实不是LWP。
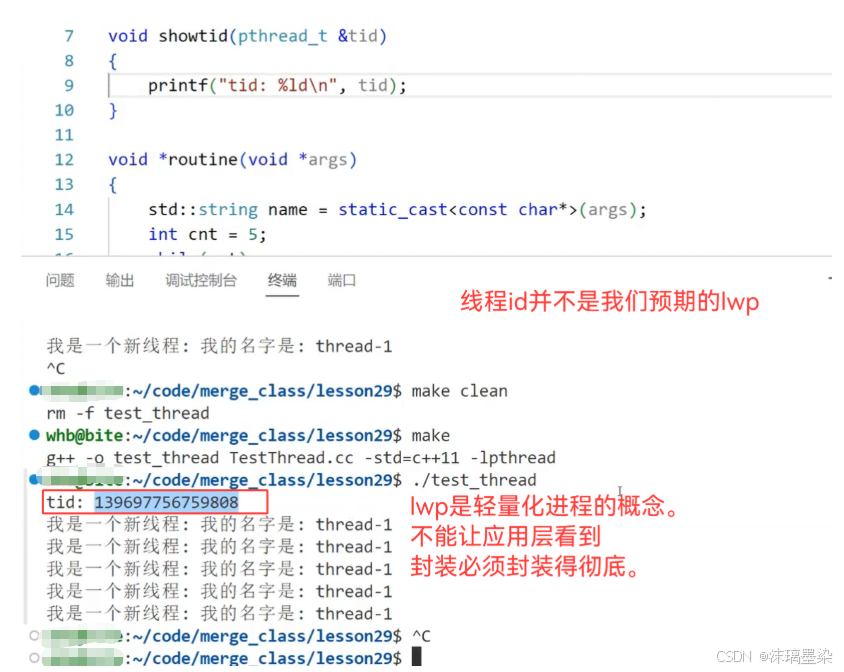
打印出来的tid,是一个pthread_t类型的变量,代表调用pthread_self的那条线程的"ID"。怎么理解这个"ID"?它是pthread库给每个线程定义的进程内唯一标识,是pthread库自己维护的。
由于每个进程都有自己独立的内存空间,这个"ID"的作用域是进程级的,不是系统级,内核根本不认识它。
pthread库当然也是靠内核提供的系统调用(比如clone)来创建线程的。内核会给每个线程分配一个系统全局唯一的ID,用来唯一标识这个线程。那个,才是LWP。
LWP 是什么?
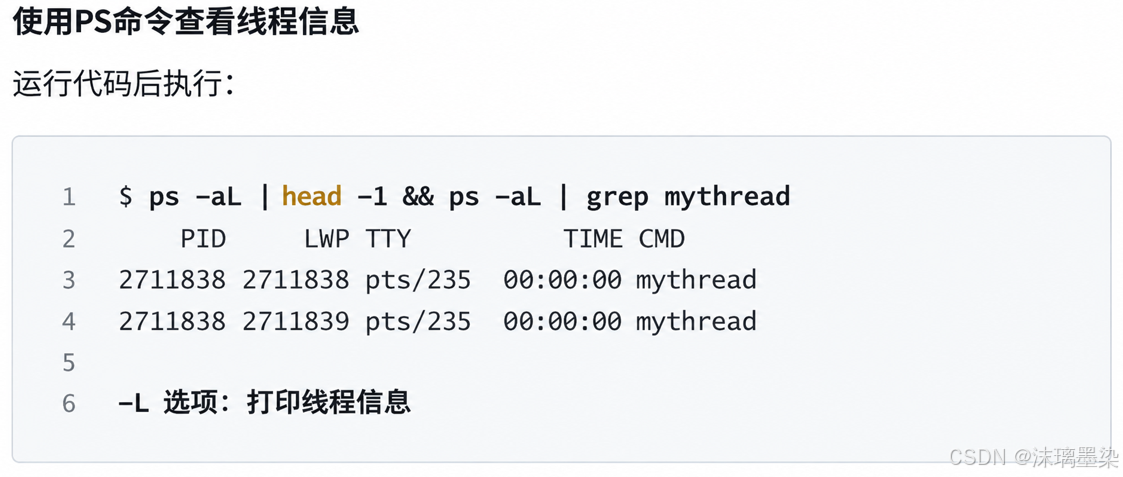
LWP拿到的才是真正的线程ID 。而pthread_self返回的那个数,实际上是一个地址,虚拟地址空间上的一个地址。通过这个地址,可以找到关于这条线程的基本信息,包括线程ID、线程栈、寄存器等等。
在ps -aL里看到的线程ID,有一个和进程ID相同,那条就是主线程。主线程的栈,就在虚拟地址空间的栈区上。其他线程的栈呢?它们待在共享区,也就是堆和栈之间那块地方。原因很简单:pthread 系列函数都是pthread库提供的,而pthread库本身就在共享区。所以,除了主线程之外,其他线程的栈,全都落在共享区里。这块内容现在先提一嘴,具体细节,后面再展开讲。
2.1.4 用Demo理解线程创建与等待
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>

void* thread_run(void* arg) {
    const char* name = (const char*)arg;
    for (int i = 0; i < 3; i++) {
        std::cout << name << " running, tid: " << pthread_self() << std::endl;
        sleep(1);
    }
    return (void*)100;
}

int main() {
    pthread_t tid;
    pthread_create(&tid, nullptr, thread_run, (void*)"thread 1");

    void* ret = nullptr;
    pthread_join(tid, &ret);

    std::cout << "thread exit code: " << (long long)ret << std::endl;
    return 0;
}
这段代码把创建和等待串成了一条完整的线:pthread_create把新线程拉起来,thread_run在里面跑三轮,每轮打印自己的名字和tid,然后睡一秒;跑完返回100。主线程这边,pthread_join一直等着,等到了就把返回值取出来,打印收工。
给**线程传的参数和返回值,可以是任意类型,既然任意类型都行,那自然也可以是一个对象。**指针一递一收,什么都能塞进去。
2.1.5 让线程真正执行一个任务
先看代码,再说几个关键点。
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <string>
#include <vector>
#include <functional>

using Task = std::function<void(void)>;

class TaskManager {
private:
    std::vector<Task> Taskv;
public:
    TaskManager() {};
    ~TaskManager() {};

    void Addtask(const std::function<void(void)>& task) {
        Taskv.push_back(task);
    }

    Task Gettask(int i) {
        return Taskv[i];
    }
};

void *Routine(void *args) {
    Task* task = (Task*)args;
    (*task)();
    delete task;
    return (void *)100;
}

void func_1() { std::cout << "线程 [" << pthread_self() << "] 正在执行:网络任务" << std::endl; }
void func_2() { std::cout << "线程 [" << pthread_self() << "] 正在执行:数据库任务" << std::endl; }
void func_3() { std::cout << "线程 [" << pthread_self() << "] 正在执行:系统任务" << std::endl; }
void func_4() { std::cout << "线程 [" << pthread_self() << "] 正在执行:重要任务" << std::endl; }
void func_5() { std::cout << "线程 [" << pthread_self() << "] 正在执行:关键任务" << std::endl; }

int main() {
    TaskManager taskmag;
    taskmag.Addtask(func_1);
    taskmag.Addtask(func_2);
    taskmag.Addtask(func_3);
    taskmag.Addtask(func_4);
    taskmag.Addtask(func_5);

    std::vector<pthread_t> pvtion = {0};
    for (int i = 0; i < 5; i++) {
        Task* task = new Task(taskmag.Gettask(i));
        int n = pthread_create(&pvtion[i], NULL, Routine, task);
        if (n != 0)
            std::cerr << "pthread_create error" << std::endl;
    }

    for (int i = 0; i < 5; i++) {
        void *ret = 0;
        pthread_join(pvtion[i], &ret);
        std::cout << (long)ret << std::endl;
    }

    return 0;
}
这段代码的设计思路很清晰:用std::function<void(void)>把任务抽象出来,TaskManager负责攒任务,主线程一口气拉起5条线程,每条线程从任务列表里领一个任务去干。Routine是线程入口,把Task从void*里还原出来,调一下,然后delete掉,动态分配的对象,谁领的谁负责回收。干完统一 pthread_join,收尸等结果。
2.2 线程终止与线程取消
2.2.1 线程有哪些终止方式
如果只想干掉某一条线程,又不想把整个进程拖下水,有三种办法:
- 入口函数return:线程入口函数跑完,返回了,这条线程就结束了。注意,千万别在线程里用 exit(),那是终止整个进程的家伙,一按下去,所有线程全得陪葬。
- 调用pthread_exit:终止调用它的那条线程本身。想退的是谁,就谁退,不影响别人。
- 被其他线程取消:靠pthread_cancel出手,把目标线程叫停。
pthread_exit的函数原型:
cpp
#include <pthread.h>

void pthread_exit(void *retval);
retval是线程退出的返回值,跟return retval; 一个意思,会被pthread_join收走。
这里有个坑必须拎出来说清楚:pthread_exit或者return返回的那个指针,它指向的内存,必须是全局的,或者是用malloc分配的,绝不能是在线程函数栈上分配的。 为什么?因为等别的线程拿到这个返回指针的时候,线程函数早就退出了,栈都销毁了。你给出去的是一个悬空指针,指向一块已经不属于你的内存。用了它,就是踩雷。
2.2.2 pthread_cancel:如何取消一个线程
函数原型先摆出来:
cpp
#include <pthread.h>

int pthread_cancel(pthread_t thread);
参数和细节,拆开看:
- **thread:**要取消的目标线程ID。指哪打哪,目标就是它。
- **取消前提:**动手之前,得确保目标线程已经启动、正在跑。还没跑起来就喊取消,等于对着空气挥拳,没意义。
- **返回值:**被取消的线程如果后来被pthread_join收了尸,它带回来的退出结果就是PTHREAD_CANCELED,本质上就是(void*)-1。
2.3 线程分离:不再等待线程退出
2.3.1 为什么需要线程分离
线程默认是可等待的,也就是joinable。主线程得对它调用pthread_join,把它那点残留下来的资源收走。不join?那就等着资源泄漏。
可有时候,主线程压根不关心新线程的返回值,也不打算等它。它只是想让新线程自己跑,跑完自己收拾干净,悄悄退场。这时候,就得把线程设成分离状态,也就是detached。
分离之后,线程依然待在进程的地址空间里,进程的资源它照样共享。唯一的区别是:主线程不用再join它了,也不允许join它。它退出了,资源自动释放,主线程该干嘛干嘛,两不相欠。
2.3.2 pthread_detach:设置线程分离状态
函数原型:
cpp
#include <pthread.h>
int pthread_detach(pthread_t thread);
这个函数,主线程能调,新线程自己也能调。主线程调pthread_detach(tid),等于把某个新线程"推开",从此不再等它。新线程在内部调pthread_detach(pthread_self()),则是自己把自己分离出去,和主线程之间的等待关系一刀两断。
但有一条得记住:线程一旦被分离,就再也join不了了。 你要是再对它调pthread_join,函数直接报错返回,一点情面不留。
2.4 几个容易忽略的线程问题
2.4.1 新线程能不能继续创建线程
可以。在POSIX线程模型里,所有线程,不管是主线程还是新创建的子线程,在权限和地位上都是平等的。谁都可以创建新线程,只要它具备执行条件,调pthread_create就行。线程生线程,天经地义。
2.4.2 新线程能不能取消主线程
技术接口层面可以,但逻辑上极不推荐。
- **技术可行性:**任何线程,只要拿到了主线程的线程ID,比如主线程把自己的pthread_self()当参数传给子线程,就能对主线程调pthread_cancel。
- **实际影响:**主线程被取消之后,它会退出运行。但只要进程里还有别的子线程没退出、没分离,整个进程就不会立刻终止。得等所有线程都退出了,进程才真正结束。这种做法,极容易把资源回收的逻辑搅成一锅粥,正常的生命周期管理全被它破坏。能干,不代表该干。
2.5 线程终止与分离------完整Demo验证
2.5.1 pthread_detach线程分离Demo
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <cstring>

void* thread_detach_demo(void* arg) {
    pthread_detach(pthread_self()); // 自我分离
    std::cout << "detached thread running..." << std::endl;
    sleep(1);
    return nullptr;
}

int main() {
    pthread_t tid;
    pthread_create(&tid, nullptr, thread_detach_demo, nullptr);

    sleep(2); // 确保子线程运行完成

    // 尝试 join 已分离的线程
    int ret = pthread_join(tid, nullptr);
    if (ret != 0) {
        std::cout << "pthread_join failed: " << strerror(ret) << std::endl;
    }

    return 0;
}
这段代码演示的是:子线程一跑起来,第一件事就是把自己分离出去,pthread_detach(pthread_self()),干净利落。分离之后,它和主线程之间的等待关系就断了。主线程睡够两秒,试着去join它,结果碰了一鼻子灰,pthread_join直接返回错误码。strerror一翻译,错误原因明明白白地打出来。这就是分离线程的规矩:一旦分离,概不join。
2.5.2 线程终止Demo
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <cstring>

void* thread_exit_demo(void* arg) {
    std::cout << "new thread running..." << std::endl;
    sleep(1);
    pthread_exit((void*)200); // 终止自身并返回 200
}

int main() {
    pthread_t tid;
    pthread_create(&tid, nullptr, thread_exit_demo, nullptr);

    void* ret = nullptr;
    pthread_join(tid, &ret);
    std::cout << "thread exit code: " << (long long)ret << std::endl;

    return 0;
}
这个例子,展示的是pthread_exit的用法。子线程跑了一会儿,睡了一秒,然后调pthread_exit((void*)200),主动结束自己,顺手把200这个值当作"遗言"带出去。主线程这边,pthread_join一直候着,等它退场,把返回值取出来,转成long long打印。200稳稳地出现在屏幕上,线程的退出,干净利落。
如果这个系列对你有帮助,别忘了点个赞、点个收藏、点个关注。你的每一次反馈,都是我继续硬核输出的最大动力。