哈喽,大家好~
之前我们聊过知识图谱是什么、能干什么,可能你还是觉得离日常工作有点远。
但在真实场景里,还有一类更普遍的需求:手上有一堆用例、接口、字段、bug,它们之间是怎么关联的,全都记忆和经验。
每次来个需求改动,都要靠回忆和经验去拼:这个字段谁在用?改了要跑哪些用例?以前这儿出过事没有?想全了靠经验,想漏了就漏了。
那么,能不能把「谁和谁有关系」这件事,从脑子里搬到一个能查的地方?
一、图谱能干什么:把关系从脑子里搬进一张表
不用图数据库,就一张三列的表,就能回答三个最实际的问题:
- ✅ 查影响面:改一个字段,要回归哪些用例、哪些脚本
- ✅ 查覆盖缺口:哪个需求一条用例都没覆盖
- ✅ 查缺陷热点:哪条链路上历史 bug 最多
二、方案介绍
整套东西只有两个文件:
data/triples.csv   每行一个三元组:头实体,关系,尾实体
query.py 读这张表,回答问题图谱里的最小单位叫三元组(Triple),就是把「谁和谁有什么关系」写成一行:
csv
TC-201,调用,API-301从左往右读就是一句话:TC-201 这条用例,调用了 API-301 这个接口。
没有嵌套、没有结构,就三段。头实体、关系、尾实体。
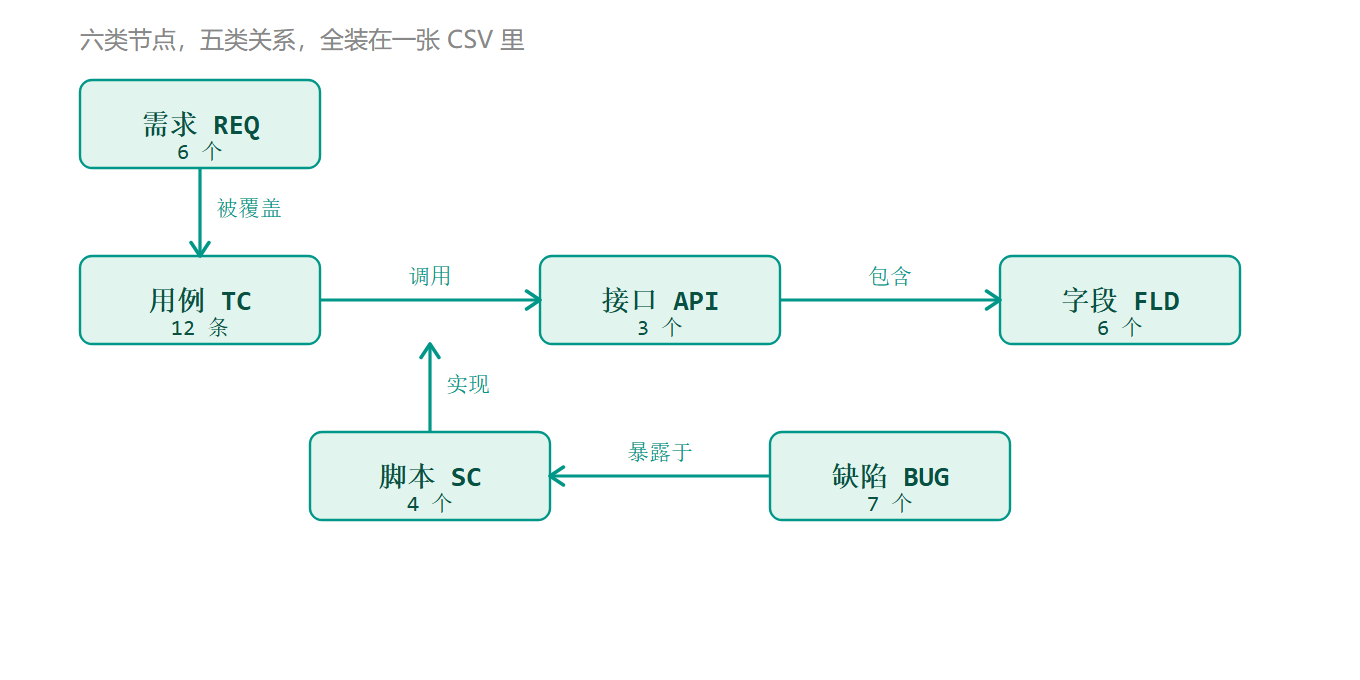
整个下单模块的图谱,就是五种关系加两类属性。每种抽一行出来看看:
csv
REQ-101,被覆盖,TC-201        # 需求-用例:这条需求由这条用例覆盖
TC-201,调用,API-301          # 用例-接口:这条用例会打到这个接口
API-301,包含,FLD-401         # 接口-字段:接口报文里含这个字段
SC-501,实现,TC-201           # 脚本-用例:这条用例已有自动化脚本
BUG-601,暴露于,TC-204        # 缺陷-用例:这个 bug 是这条用例暴露的
TC-204,标题,订单状态-待付款转已付款     # 属性:给节点挂个名字
BUG-601,严重度,高            # 属性:给缺陷标个严重度
都是最普通的行,没有任何黑魔法。整个下单模块的数据连起来长这样:
需求 REQ ──被覆盖──> 用例 TC ──调用──> 接口 API ──包含──> 字段 FLD
                       ↑
                    实现│
                    脚本 SC            缺陷 BUG ──暴露于──> 用例
6 个需求、12 条用例、3 个接口、6 个字段、4 个脚本、7 个缺陷,一共 39 个节点、86 条关系。全部在一张 CSV 里。
表有了,怎么查?query.py 的核心就这几行------把三列表读成两张邻接表,正向反向各存一份:
python
adj = defaultdict(lambda: defaultdict(list))   # 正向:头 -> 关系 -> [尾]
rev = defaultdict(lambda: defaultdict(list))   # 反向:尾 -> 关系 -> [头]

for h, r, t in rows:          # 每行一个三元组,比如 TC-201,调用,API-301
    adj[h][r].append(t)       # 正向存一份:API-301 能查到它包含哪些字段
    rev[t][r].append(h)       # 反向也存一份:FLD-403 能查到谁包含它

def inn(node, rel):           # 反向查「谁指向我」,整篇文章的主角
return rev.get(node, {}).get(rel, [])真实脚本里还有一些容错和按名字搜索的辅助函数,但骨架就这些。所谓多跳查询,就是顺着这两个字典多走几步。
三、案例实践:一次真实的字段变更
1、先看数据长什么样
拿最小的一个切口来看。接口和字段的关系,就三行:
csv
API-301,包含,FLD-401
API-301,包含,FLD-402
API-301,包含,FLD-403
读作:创建订单接口的报文里,有商品ID、购买数量、订单状态码这三个字段。
用例和接口的关系,也是几行:
csv
TC-201,调用,API-301
TC-202,调用,API-301
TC-203,调用,API-301注意:这里没有一条「用例-字段」的记录。 用例和字段的关联,是后面算出来的。
2、然后来了一个改动
产品找过来:「订单状态码(FLD-403)的取值范围要改,从 5 个扩到 8 个。」
要回答的问题是:这次改动,要回归多少东西?
3、顺着链路反向找
先找哪些接口包含这个字段。注意方向------表里写的是「接口包含字段」,而我们现在站在字段这一头,所以要逆着箭头找:
csv
API-301,包含,FLD-403
API-302,包含,FLD-403
API-303,包含,FLD-403
一次捞回 3 个接口。
再找哪些用例调用了这 3 个接口。同样是逆着找------表里是「用例调用接口」,我们从接口找回用例:
csv
TC-201,调用,API-301
TC-204,调用,API-302
TC-207,调用,API-303
...
12 条用例。
再往下还能找脚本、找历史缺陷。整个影响面分析,核心代码就一个函数:
python
def impact(field):
    apis = inn(field, "包含")             # 第 1 跳:字段 <-包含- 接口
    tcases = []
    for a in apis:
        tcases += inn(a, "调用")          # 第 2 跳:接口 <-调用- 用例
    tcases = list(dict.fromkeys(tcases))  # 去重、保序

    scripts = []
    for t in tcases:
        scripts += inn(t, "实现")         # 第 3 跳:用例 <-实现- 脚本

    bugs = []
    for t in tcases:
        bugs += inn(t, "暴露于")          # 历史缺陷:这条链路踩过的坑
没有递归、没有图算法,就是三层循环顺着字典走。跑出来的链路长这样:
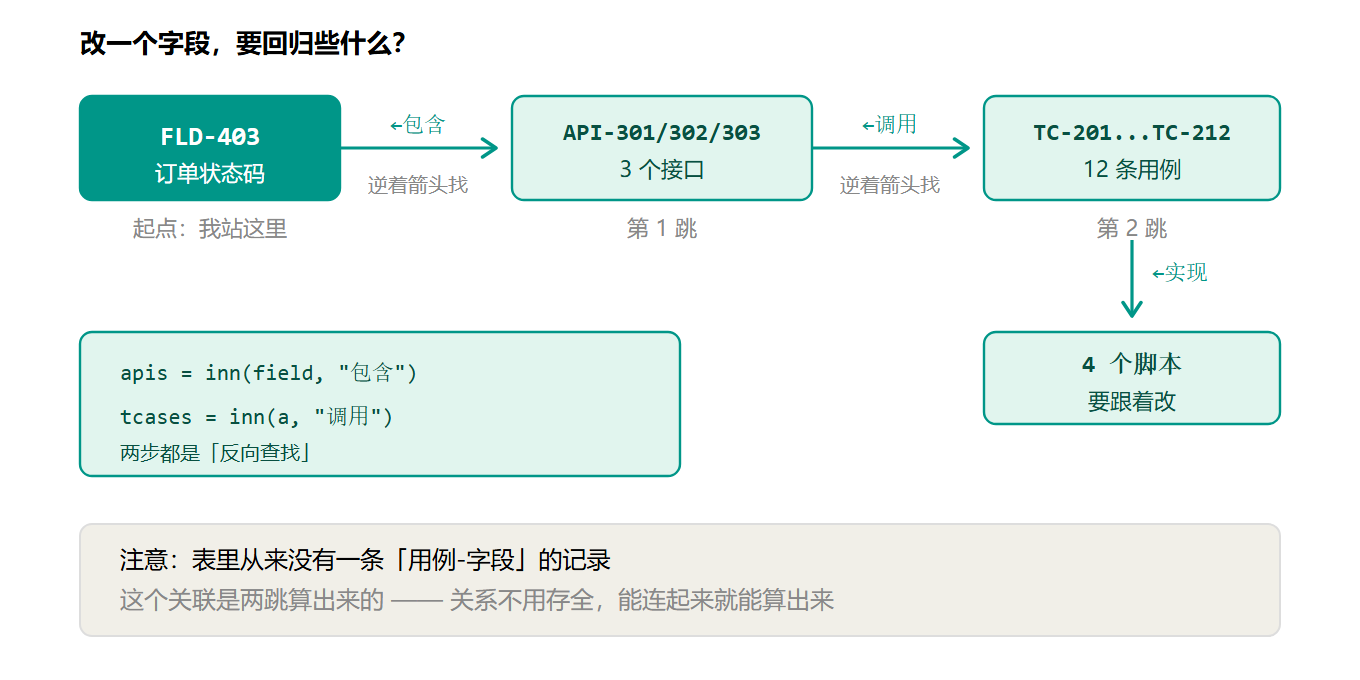
**这一步的作用:**整个方法的核心就是「反向查找」。人的直觉是顺藤摸瓜往前找,但这里要逆着箭头走------写的时候是接口指向字段,查的时候是从字段找回接口。
4、跑出来的结果
一条命令:
bash
python query.py impact FLD-403输出:
变更字段:FLD-403(订单状态码)

第 1 跳  受影响接口(3 个)
   - API-301  POST /v1/order/create
   - API-302  POST /v1/order/status/update
   - API-303  POST /v1/order/refund

第 2 跳  受影响用例(12 条)
   - TC-201  下单-正常流程
   - TC-204  订单状态-待付款转已付款
   ...

第 3 跳  受影响脚本(4 个)
   - SC-501  test_create_order.py
   ...

关联历史缺陷(7 个,反映该链路的风险)
   - BUG-601  严重度 高

结论:改 FLD-403 需要回归 12 条用例、4 个自动化脚本。这个结果直接回答了老板会问的三件事:要测多少、要动哪些脚本、以前这儿出过多少事。
而且第三点是它比人厉害的地方------「这个字段历史上爆过 7 个 bug,其中 4 个是高严重度」,这个信息只有顺着链路自动翻出来才拿得到,人脑记不住。
5、同样的数据,表格为什么不行
有人会问:这不就是个查表吗,我用 Excel 不行?
可以,但你要维护两张表:一张「用例→接口」,一张「接口→字段」。查的时候手工串两遍 VLOOKUP:先在第二张表找哪些接口含这个字段,再回第一张表找哪些用例调了这些接口。
能查,但每加一跳就得多套一层,还得保证两张表都跟代码同步。
而图谱里,4 跳就是同一张表里的 4 行:
csv
API-301,包含,FLD-403
TC-201,调用,API-301
SC-501,实现,TC-201
表结构从头到尾没变过,还是三列。加一跳就加一行,不用改结构、不用写公式。
差别在这:表格里「关系」是列,多一种关系就要加一列;图谱里「关系」是行,多几种都是加行。