▒ 目录 ▒
-
- [🛫 导读](#🛫 导读)
- [1️⃣ 常用设计模式](#1️⃣ 常用设计模式)
- [2️⃣ 工厂方法模式](#2️⃣ 工厂方法模式)
- [3️⃣ 单例模式](#3️⃣ 单例模式)
- [4️⃣ 策略模式](#4️⃣ 策略模式)
- [5️⃣ 装饰模式](#5️⃣ 装饰模式)
- [6️⃣ 迭代器模式](#6️⃣ 迭代器模式)
- [7️⃣ 观察者模式](#7️⃣ 观察者模式)
- [8️⃣ 学习模式的正确顺序](#8️⃣ 学习模式的正确顺序)
- [🛬 文章小结](#🛬 文章小结)
🛫 导读
设计模式不是固定模板,而是给常见设计问题一套便于交流的名字和解法。
本篇介绍设计模式的分类,并详细保留工厂方法、单例、策略、装饰器、迭代器和观察者六种模式的原文分析。阅读时建议先识别问题,再看结构和实现,最后比较优缺点;不要看到相似代码就急着套用模式。
本篇知识路线
text
创建型:对象怎样创建 ──► 工厂、单例
结构型:对象怎样组合 ──► 装饰
行为型:对象怎样协作 ──► 策略、迭代器、观察者
1️⃣ 常用设计模式
到目前为止,我们已经学完了 Python 语言的语法以及如何使用 Python,从本章开始,我们进入 Python 学习的高阶阶段。
本章我们来学习常用的设计模式。如果大家想全面学习所有的设计模式,请参考设计模式教程。
为什么要学习设计模式
了解设计模式能帮助你轻松应对面试和考核:几乎所有关于编程的工作面试和考核中都会有关于模式的问题。了解这些知识能够帮助你发现更广泛的工作机会,或者实现升职加薪的工作目标。
了解设计模式可扩展你的编程工具箱:模式能让你对已有的解决方案进行自定义,而不用完全自行开发。代码中的错误将更少,因为你使用的是经过证明的标准解决方案,它考虑了所有隐藏的问题。
了解设计模式让你能够更好地与同事沟通:你只需将模式的名称告诉给程序员,而不需要长篇累牍地解释自己那绝妙的设计思想以及其中各个类的作用。不费吹灰之力就能搞定同事之间的沟通。
设计模式的产生背景
"设计模式"这个术语最初并不是出现在软件设计中,而是被用于建筑领域的设计中。
1977 年,美国著名建筑大师、加利福尼亚大学伯克利分校环境结构中心主任克里斯托夫·亚历山大(Christopher Alexander)在他的著作《建筑模式语言:城镇、建筑、构造(A Pattern Language: Towns Building Construction)中描述了一些常见的建筑设计问题,并提出了 253 种关于对城镇、邻里、住宅、花园和房间等进行设计的基本模式。
1979 年他的另一部经典著作《建筑的永恒之道》(The Timeless Way of Building)进一步强化了设计模式的思想,为后来的建筑设计指明了方向。
1987 年,肯特·贝克(Kent Beck)和沃德·坎宁安(Ward Cunningham)首先将克里斯托夫·亚历山大的模式思想应用在 Smalltalk 中的图形用户接口的生成中,但没有引起软件界的关注。
直到 1990 年,软件工程界才开始研讨设计模式的话题,后来召开了多次关于设计模式的研讨会。
1995 年,艾瑞克·伽马(ErichGamma)、理査德·海尔姆(Richard Helm)、拉尔夫·约翰森(Ralph Johnson)、约翰·威利斯迪斯(John Vlissides)等 4 位作者合作出版了《设计模式:可复用面向对象软件的基础》(Design Patterns: Elements of Reusable Object-Oriented Software)一书,在本教程中收录了 23 个设计模式,这是设计模式领域里程碑的事件,导致了软件设计模式的突破。这 4 位作者在软件开发领域里也以他们的"四人组"(Gang of Four,GoF)匿名著称。
直到今天,狭义的设计模式还是 23 种经典设计模式。
GoF的23种设计模式的功能
GoF 的 23 种设计模式的分类,现在对各个模式的功能进行介绍。
-
单例(Singleton)模式:某个类只能生成一个实例,该类提供了一个全局访问点供外部获取该实例,其拓展是有限多例模式。
-
原型(Prototype)模式:将一个对象作为原型,通过对其进行复制而克隆出多个和原型类似的新实例。
-
工厂方法(Factory Method)模式:定义一个用于创建产品的接口,由子类决定生产什么产品。
-
抽象工厂(AbstractFactory)模式:提供一个创建产品族的接口,其每个子类可以生产一系列相关的产品。
-
建造者(Builder)模式:将一个复杂对象分解成多个相对简单的部分,然后根据不同需要分别创建它们,最后构建成该复杂对象。
-
代理(Proxy)模式:为某对象提供一种代理以控制对该对象的访问。即客户端通过代理间接地访问该对象,从而限制、增强或修改该对象的一些特性。
-
适配器(Adapter)模式:将一个类的接口转换成客户希望的另外一个接口,使得原本由于接口不兼容而不能一起工作的那些类能一起工作。
-
桥接(Bridge)模式:将抽象与实现分离,使它们可以独立变化。它是用组合关系代替继承关系来实现,从而降低了抽象和实现这两个可变维度的耦合度。
-
装饰(Decorator)模式:动态的给对象增加一些职责,即增加其额外的功能。
-
外观(Facade)模式:为多个复杂的子系统提供一个一致的接口,使这些子系统更加容易被访问。
-
享元(Flyweight)模式:运用共享技术来有效地支持大量细粒度对象的复用。
-
组合(Composite)模式:将对象组合成树状层次结构,使用户对单个对象和组合对象具有一致的访问性。
-
模板方法(TemplateMethod)模式:定义一个操作中的算法骨架,而将算法的一些步骤延迟到子类中,使得子类可以不改变该算法结构的情况下重定义该算法的某些特定步骤。
-
策略(Strategy)模式:定义了一系列算法,并将每个算法封装起来,使它们可以相互替换,且算法的改变不会影响使用算法的客户。
-
命令(Command)模式:将一个请求封装为一个对象,使发出请求的责任和执行请求的责任分割开。
-
职责链(Chain of Responsibipty)模式:把请求从链中的一个对象传到下一个对象,直到请求被响应为止。通过这种方式去除对象之间的耦合。
-
状态(State)模式:允许一个对象在其内部状态发生改变时改变其行为能力。
-
观察者(Observer)模式:多个对象间存在一对多关系,当一个对象发生改变时,把这种改变通知给其他多个对象,从而影响其他对象的行为。
-
中介者(Mediator)模式:定义一个中介对象来简化原有对象之间的交互关系,降低系统中对象间的耦合度,使原有对象之间不必相互了解。
-
迭代器(Iterator)模式:提供一种方法来顺序访问聚合对象中的一系列数据,而不暴露聚合对象的内部表示。
-
访问者(Visitor)模式:在不改变集合元素的前提下,为一个集合中的每个元素提供多种访问方式,即每个元素有多个访问者对象访问。
-
备忘录(Memento)模式:在不破坏封装性的前提下,获取并保存一个对象的内部状态,以便以后恢复它。
-
解释器(Interpreter)模式:提供如何定义语言的文法,以及对语言句子的解释方法,即解释器。
2️⃣ 工厂方法模式
工厂方法是一种创建型设计模式,解决了在不指定具体类的情况下创建产品对象的问题。
工厂方法定义了一个方法,且必须使用该方法代替通过直接调用构造函数来创建对象(new 操作符)的方式。子类可重写该方法来更改将被创建的对象所属类。
工厂方法亦称:虚拟构造函数、Virtual Constructor、Factory Method。
问题
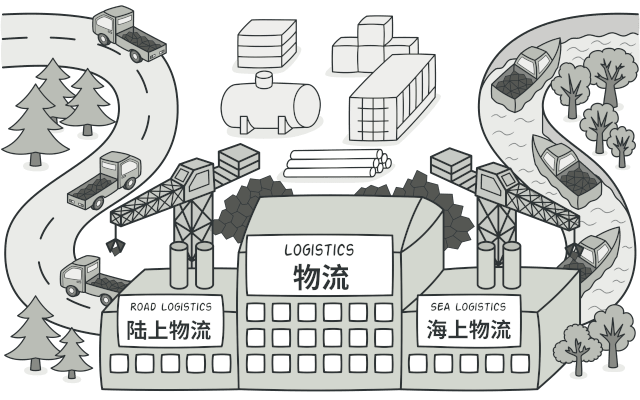
假设你正在开发一款物流管理应用。 最初版本只能处理卡车运输, 因此大部分代码都在位于名为 卡车的类中。
一段时间后, 这款应用变得极受欢迎。 你每天都能收到十几次来自海运公司的请求, 希望应用能够支持海上物流功能。
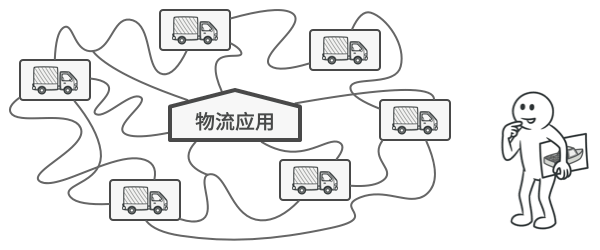
如果代码其余部分与现有类已经存在耦合关系, 那么向程序中添加新类其实并没有那么容易。
这可是个好消息。 但是代码问题该如何处理呢? 目前, 大部分代码都与 卡车类相关。 在程序中添加 轮船类需要修改全部代码。 更糟糕的是, 如果你以后需要在程序中支持另外一种运输方式, 很可能需要再次对这些代码进行大幅修改。
最后, 你将不得不编写繁复的代码, 根据不同的运输对象类, 在应用中进行不同的处理。
解决方案
工厂方法模式建议使用特殊的 工厂 方法代替对于对象构造函数的直接调用 (即使用 new运算符)。 不用担心, 对象仍将通过 new运算符创建, 只是该运算符改在工厂方法中调用罢了。 工厂方法返回的对象通常被称作 "产品"。
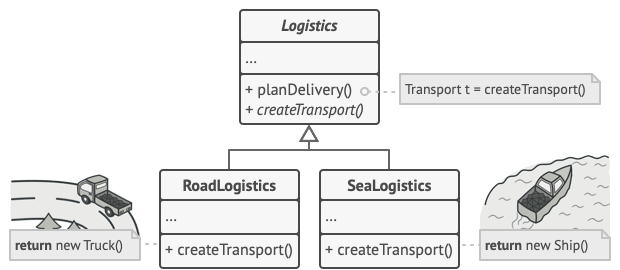
子类可以修改工厂方法返回的对象类型。
乍看之下, 这种更改可能毫无意义: 我们只是改变了程序中调用构造函数的位置而已。 但是, 仔细想一下, 现在你可以在子类中重写工厂方法, 从而改变其创建产品的类型。
但有一点需要注意:仅当这些产品具有共同的基类或者接口时, 子类才能返回不同类型的产品, 同时基类中的工厂方法还应将其返回类型声明为这一共有接口。
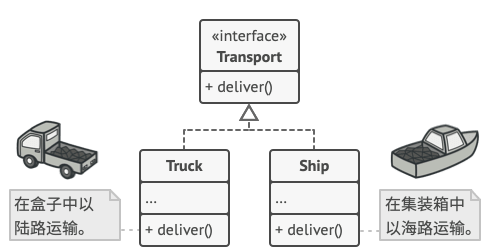
所有产品都必须使用同一接口。
举例来说, 卡车Truck和 轮船Ship类都必须实现 运输Transport接口, 该接口声明了一个名为 deliver交付的方法。 每个类都将以不同的方式实现该方法: 卡车走陆路交付货物, 轮船走海路交付货物。 陆路运输RoadLogistics类中的工厂方法返回卡车对象, 而 海路运输SeaLogistics类则返回轮船对象。
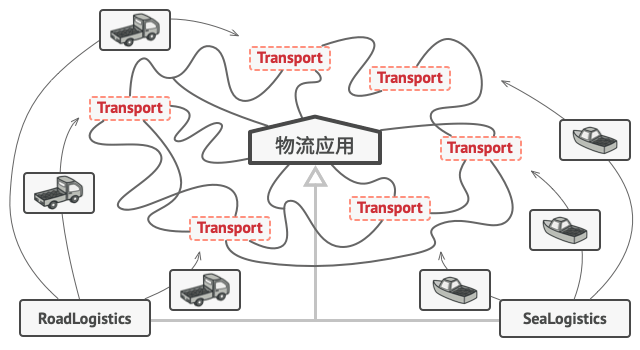
只要产品类实现一个共同的接口, 你就可以将其对象传递给客户代码, 而无需提供额外数据。
调用工厂方法的代码 (通常被称为 客户端 代码) 无需了解不同子类返回实际对象之间的差别。 客户端将所有产品视为抽象的 运输 。 客户端知道所有运输对象都提供 交付方法, 但是并不关心其具体实现方式。
工厂方法模式结构
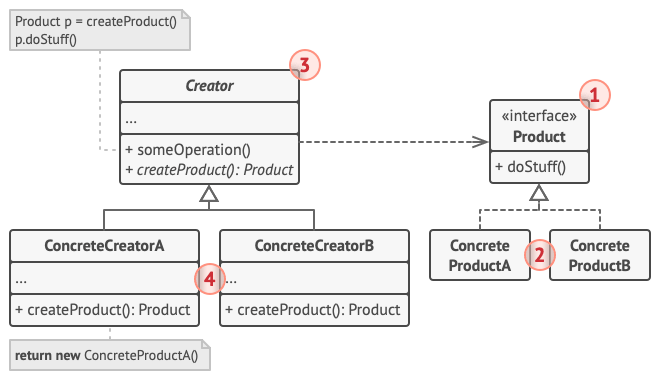
1:产品 (Product) 将会对接口进行声明。 对于所有由创建者及其子类构建的对象, 这些接口都是通用的。
2:具体产品 (Concrete Products) 是产品接口的不同实现。
3:创建者 (Creator) 类声明返回产品对象的工厂方法。 该方法的返回对象类型必须与产品接口相匹配。
你可以将工厂方法声明为抽象方法, 强制要求每个子类以不同方式实现该方法。 或者, 你也可以在基础工厂方法中返回默认产品类型。
注意, 尽管它的名字是创建者, 但他最主要的职责并不是 创建产品。 一般来说, 创建者类包含一些与产品相关的核心业务逻辑。 工厂方法将这些逻辑处理从具体产品类中分离出来。 打个比方, 大型软件开发公司拥有程序员培训部门。 但是, 这些公司的主要工作还是编写代码, 而非生产程序员。
4:具体创建者 (Concrete Creators) 将会重写基础工厂方法, 使其返回不同类型的产品。
注意, 并不一定每次调用工厂方法都会创建 新的实例。 工厂方法也可以返回缓存、 对象池或其他来源的已有对象。
工厂方法模式代码实现
工厂方法模式在 Python 代码中得到了广泛使用。当你需要在代码中提供高层次的灵活性时,该模式会非常实用。
工厂方法可通过构建方法来识别,它会创建具体类的对象,但以抽象类型或接口的形式返回这些对象。
本例说明了工厂方法设计模式的结构并重点回答了下面的问题:它由哪些类组成?这些类扮演了哪些角色?模式中的各个元素会以何种方式相互关联?
python
from __future__ import annotations
from abc import ABC, abstractmethod

class Creator(ABC):
    """
    The Creator class declares the factory method that is supposed to return an
    object of a Product class. The Creator's subclasses usually provide the
    implementation of this method.
    """

    @abstractmethod
    def factory_method(self):
        """
        Note that the Creator may also provide some default implementation of
        the factory method.
        """
        pass

    def some_operation(self) -> str:
        """
        Also note that, despite its name, the Creator's primary responsibility
        is not creating products. Usually, it contains some core business logic
        that relies on Product objects, returned by the factory method.
        Subclasses can indirectly change that business logic by overriding the
        factory method and returning a different type of product from it.
        """

        # Call the factory method to create a Product object.
        product = self.factory_method()

        # Now, use the product.
        result = f"Creator: The same creator's code has just worked with {product.operation()}"

        return result

"""
Concrete Creators override the factory method in order to change the resulting
product's type.
"""

class ConcreteCreator1(Creator):
    """
    Note that the signature of the method still uses the abstract product type,
    even though the concrete product is actually returned from the method. This
    way the Creator can stay independent of concrete product classes.
    """

    def factory_method(self) -> ConcreteProduct1:
        return ConcreteProduct1()

class ConcreteCreator2(Creator):
    def factory_method(self) -> ConcreteProduct2:
        return ConcreteProduct2()

class Product(ABC):
    """
    The Product interface declares the operations that all concrete products
    must implement.
    """

    @abstractmethod
    def operation(self) -> str:
        pass

"""
Concrete Products provide various implementations of the Product interface.
"""

class ConcreteProduct1(Product):
    def operation(self) -> str:
        return "{Result of the ConcreteProduct1}"

class ConcreteProduct2(Product):
    def operation(self) -> str:
        return "{Result of the ConcreteProduct2}"

def client_code(creator: Creator) -> None:
    """
    The client code works with an instance of a concrete creator, albeit through
    its base interface. As long as the client keeps working with the creator via
    the base interface, you can pass it any creator's subclass.
    """

    print(f"Client: I'm not aware of the creator's class, but it still works.\n"
          f"{creator.some_operation()}", end="")

if __name__ == "__main__":
    print("App: Launched with the ConcreteCreator1.")
    client_code(ConcreteCreator1())
    print("\n")

    print("App: Launched with the ConcreteCreator2.")
    client_code(ConcreteCreator2())
执行结果
text
Client: Testing client code with the first factory type:
The result of the product B1.
The result of the B1 collaborating with the (The result of the product A1.)

Client: Testing the same client code with the second factory type:
The result of the product B2.
The result of the B2 collaborating with the (The result of the product A2.)
项目案例和伪代码
以下示例演示了如何使用工厂方法 开发跨平台 UI (用户界面) 组件, 并同时避免客户代码与具体 UI 类之间的耦合。
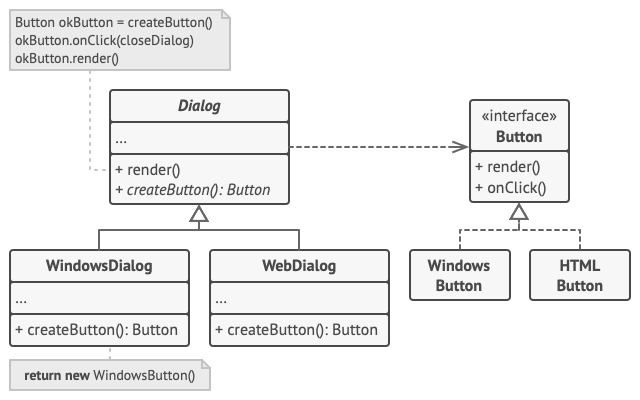
跨平台对话框示例。
基础对话框类使用不同的 UI 组件渲染窗口。 在不同的操作系统下, 这些组件外观或许略有不同, 但其功能保持一致。 Windows 系统中的按钮在 Linux 系统中仍然是按钮。
如果使用工厂方法, 就不需要为每种操作系统重写对话框逻辑。 如果我们声明了一个在基本对话框类中生成按钮的工厂方法, 那么我们就可以创建一个对话框子类, 并使其通过工厂方法返回 Windows 样式按钮。 子类将继承对话框基础类的大部分代码, 同时在屏幕上根据 Windows 样式渲染按钮。
如需该模式正常工作, 基础对话框类必须使用抽象按钮 (例如基类或接口), 以便将其扩展为具体按钮。 这样一来, 无论对话框中使用何种类型的按钮, 其代码都可以正常工作。
你可以使用此方法开发其他 UI 组件。 不过, 每向对话框中添加一个新的工厂方法, 你就离抽象工厂模式更近一步。 我们将在稍后谈到这个模式。
python
// 创建者类声明的工厂方法必须返回一个产品类的对象。创建者的子类通常会提供
// 该方法的实现。
class Dialog is
    // 创建者还可提供一些工厂方法的默认实现。
    abstract method createButton():Button

    // 请注意,创建者的主要职责并非是创建产品。其中通常会包含一些核心业务
    // 逻辑,这些逻辑依赖于由工厂方法返回的产品对象。子类可通过重写工厂方
    // 法并使其返回不同类型的产品来间接修改业务逻辑。
    method render() is
        // 调用工厂方法创建一个产品对象。
        Button okButton = createButton()
        // 现在使用产品。
        okButton.onClick(closeDialog)
        okButton.render()

// 具体创建者将重写工厂方法以改变其所返回的产品类型。
class WindowsDialog extends Dialog is
    method createButton():Button is
        return new WindowsButton()

class WebDialog extends Dialog is
    method createButton():Button is
        return new HTMLButton()

// 产品接口中将声明所有具体产品都必须实现的操作。
interface Button is
    method render()
    method onClick(f)

// 具体产品需提供产品接口的各种实现。
class WindowsButton implements Button is
    method render(a, b) is
        // 根据 Windows 样式渲染按钮。
    method onClick(f) is
        // 绑定本地操作系统点击事件。

class HTMLButton implements Button is
    method render(a, b) is
        // 返回一个按钮的 HTML 表述。
    method onClick(f) is
        // 绑定网络浏览器的点击事件。

class Application is
    field dialog: Dialog

    // 程序根据当前配置或环境设定选择创建者的类型。
    method initialize() is
        config = readApplicationConfigFile()

        if (config.OS == "Windows") then
            dialog = new WindowsDialog()
        else if (config.OS == "Web") then
            dialog = new WebDialog()
        else
            throw new Exception("错误!未知的操作系统。")

    // 当前客户端代码会与具体创建者的实例进行交互,但是必须通过其基本接口
    // 进行。只要客户端通过基本接口与创建者进行交互,你就可将任何创建者子
    // 类传递给客户端。
    method main() is
        this.initialize()
        dialog.render()
工厂方法模式适合应用场景
当你在编写代码的过程中 , 如果无法预知对象确切类别及其依赖关系时, 可使用工厂方法。
工厂方法将创建产品的代码与实际使用产品的代码分离 , 从而能在不影响其他代码的情况下扩展产品创建部分代码。
例如, 如果需要向应用中添加一种新产品, 你只需要开发新的创建者子类, 然后重写其工厂方法即可。
如果你希望用户能扩展你软件库或框架的内部组件 , 可使用工厂方法。
继承可能是扩展软件库或框架默认行为的最简单方法 。 但是当你使用子类替代标准组件时, 框架如何辨识出该子类?
解决方案是将各框架中构造组件的代码集中到单个工厂方法中, 并在继承该组件之外允许任何人对该方法进行重写。
让我们看看具体是如何实现的。 假设你使用开源 UI 框架编写自己的应用。 你希望在应用中使用圆形按钮, 但是原框架仅支持矩形按钮。 你可以使用 圆形按钮RoundButton子类来继承标准的 按钮Button类。 但是, 你需要告诉 UI框架UIFramework类使用新的子类按钮代替默认按钮。
为了实现这个功能, 你可以根据基础框架类开发子类 圆形按钮 UIUIWithRoundButtons , 并且重写其 createButton创建按钮方法。 基类中的该方法返回 按钮对象, 而你开发的子类返回 圆形按钮对象。 现在, 你就可以使用 圆形按钮 UI类代替 UI框架类。 就是这么简单!
如果你希望复用现有对象来节省系统资源 , 而不是每次都重新创建对象, 可使用工厂方法。
在处理大型资源密集型对象 (比如数据库连接、 文件系统和网络资源) 时, 你会经常碰到这种资源需求。
让我们思考复用现有对象的方法:
- 首先, 你需要创建存储空间来存放所有已经创建的对象。
- 当他人请求一个对象时, 程序将在对象池中搜索可用对象。
- ...然后将其返回给客户端代码。
- 如果没有可用对象, 程序则创建一个新对象 (并将其添加到对象池中)。
这些代码可不少! 而且它们必须位于同一处, 这样才能确保重复代码不会污染程序。
可能最显而易见, 也是最方便的方式, 就是将这些代码放置在我们试图重用的对象类的构造函数中。 但是从定义上来讲, 构造函数始终返回的是新对象 , 其无法返回现有实例。
因此, 你需要有一个既能够创建新对象, 又可以重用现有对象的普通方法。 这听上去和工厂方法非常相像。
实现方式
-
让所有产品都遵循同一接口。 该接口必须声明对所有产品都有意义的方法。
-
在创建类中添加一个空的工厂方法。 该方法的返回类型必须遵循通用的产品接口。
-
在创建者代码中找到对于产品构造函数的所有引用。 将它们依次替换为对于工厂方法的调用, 同时将创建产品的代码移入工厂方法。 你可能需要在工厂方法中添加临时参数来控制返回的产品类型。
工厂方法的代码看上去可能非常糟糕。 其中可能会有复杂的 switch分支运算符, 用于选择各种需要实例化的产品类。 但是不要担心, 我们很快就会修复这个问题。
-
现在, 为工厂方法中的每种产品编写一个创建者子类, 然后在子类中重写工厂方法, 并将基本方法中的相关创建代码移动到工厂方法中。
-
如果应用中的产品类型太多, 那么为每个产品创建子类并无太大必要, 这时你也可以在子类中复用基类中的控制参数。
例如, 设想你有以下一些层次结构的类。 基类 邮件及其子类 航空邮件和 陆路邮件 ; 运输及其子类 飞机, 卡车和 火车 。 航空邮件仅使用 飞机对象, 而 陆路邮件则会同时使用 卡车和 火车对象。 你可以编写一个新的子类 (例如 火车邮件 ) 来处理这两种情况, 但是还有其他可选的方案。 客户端代码可以给 陆路邮件类传递一个参数, 用于控制其希望获得的产品。
- 如果代码经过上述移动后, 基础工厂方法中已经没有任何代码, 你可以将其转变为抽象类。 如果基础工厂方法中还有其他语句, 你可以将其设置为该方法的默认行为。
工厂方法模式优缺点
-
你可以避免创建者和具体产品之间的紧密耦合 。
-
单一职责原则 。 你可以将产品创建代码放在程序的单一位置, 从而使得代码更容易维护。
-
开闭原则 。 无需更改现有客户端代码, 你就可以在程序中引入新的产品类型。
-
应用工厂方法模式需要引入许多新的子类 , 代码可能会因此变得更复杂。 最好的情况是将该模式引入创建者类的现有层次结构中。
与其他模式的关系
-
在许多设计工作的初期都会使用工厂方法模式 (较为简单, 而且可以更方便地通过子类进行定制), 随后演化为使用抽象工厂模式、 原型模式或生成器模式 (更灵活但更加复杂)。
-
原型并不基于继承, 因此没有继承的缺点。 另一方面, 原型 需要对被复制对象进行复杂的初始化。 工厂方法基于继承, 但是它不需要初始化步骤。
3️⃣ 单例模式
单例是一种创建型设计模式,让你能够保证一个类只有一个实例,并提供一个访问该实例的全局节点。
单例拥有与全局变量相同的优缺点。尽管它们非常有用,但却会破坏代码的模块化特性。
在某些其他上下文中,你不能使用依赖于单例的类。你也将必须使用单例类。绝大多数情况下,该限制会在创建单元测试时出现。
单例模式亦称:单件模式、Singleton。
问题
单例模式同时解决了两个问题, 所以违反了_单一职责原则_:
- 保证一个类只有一个实例 。 为什么会有人想要控制一个类所拥有的实例数量? 最常见的原因是控制某些共享资源 (例如数据库或文件) 的访问权限。
它的运作方式是这样的: 如果你创建了一个对象, 同时过一会儿后你决定再创建一个新对象, 此时你会获得之前已创建的对象, 而不是一个新对象。
注意, 普通构造函数无法实现上述行为, 因为构造函数的设计决定了它必须 总是返回一个新对象。
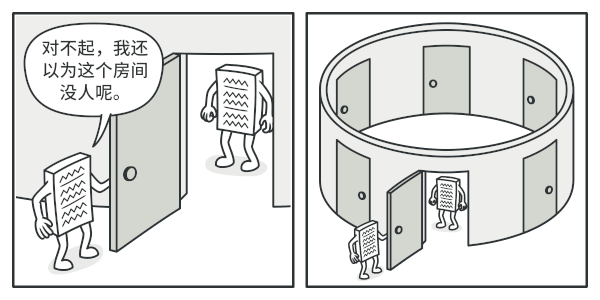
客户端甚至可能没有意识到它们一直都在使用同一个对象。
- 为该实例提供一个全局访问节点 。 还记得你 (好吧, 其实是我自己) 用过的那些存储重要对象的全局变量吗? 它们在使用上十分方便, 但同时也非常不安全, 因为任何代码都有可能覆盖掉那些变量的内容, 从而引发程序崩溃。
和全局变量一样, 单例模式也允许在程序的任何地方访问特定对象。 但是它可以保护该实例不被其他代码覆盖。
还有一点: 你不会希望解决同一个问题的代码分散在程序各处的。 因此更好的方式是将其放在同一个类中, 特别是当其他代码已经依赖这个类时更应该如此。
如今, 单例模式已经变得非常流行, 以至于人们会将只解决上文描述中任意一个问题的东西称为 单例 。
解决方案
所有单例的实现都包含以下两个相同的步骤:
- 将默认构造函数设为私有, 防止其他对象使用单例类的
new运算符。 - 新建一个静态构建方法作为构造函数。 该函数会 "偷偷" 调用私有构造函数来创建对象, 并将其保存在一个静态成员变量中。 此后所有对于该函数的调用都将返回这一缓存对象。
如果你的代码能够访问单例类, 那它就能调用单例类的静态方法。 无论何时调用该方法, 它总是会返回相同的对象。
真实世界类比
政府是单例模式的一个很好的示例。 一个国家只有一个官方政府。 不管组成政府的每个人的身份是什么, "某政府" 这一称谓总是鉴别那些掌权者的全局访问节点。
单例模式结构
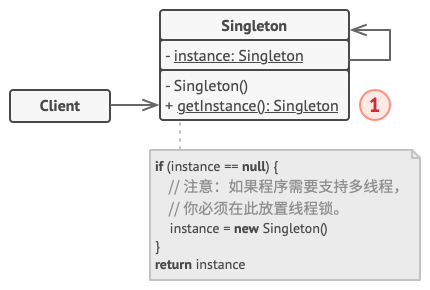
- 单例 (Singleton) 类声明了一个名为
getInstance获取实例的静态方法来返回其所属类的一个相同实例。
单例的构造函数必须对客户端 (Client) 代码隐藏。 调用 获取实例方法必须是获取单例对象的唯一方式。
单例模式代码实现
许多开发者将单例模式视为一种反模式。因此它在 Python 代码中的使用频率正在逐步减少。
识别方法:单例可以通过返回相同缓存对象的静态构建方法来识别。
实现一个粗糙的单例非常简单。你仅需隐藏构造函数并实现一个静态的构建方法即可。下面的代码是实现基础单例。
python
class SingletonMeta(type):
    """
    The Singleton class can be implemented in different ways in Python. Some
    possible methods include: base class, decorator, metaclass. We will use the
    metaclass because it is best suited for this purpose.
    """

    _instances = {}

    def __call__(cls, *args, **kwargs):
        """
        Possible changes to the value of the `__init__` argument do not affect
        the returned instance.
        """
        if cls not in cls._instances:
            instance = super().__call__(*args, **kwargs)
            cls._instances[cls] = instance
        return cls._instances[cls]

class Singleton(metaclass=SingletonMeta):
    def some_business_logic(self):
        """
        Finally, any singleton should define some business logic, which can be
        executed on its instance.
        """

        # ...

if __name__ == "__main__":
    # The client code.

    s1 = Singleton()
    s2 = Singleton()

    if id(s1) == id(s2):
        print("Singleton works, both variables contain the same instance.")
    else:
        print("Singleton failed, variables contain different instances.")
执行结果
text
Singleton works, both variables contain the same instance.相同的类在多线程环境中会出错。多线程可能会同时调用构建方法并获取多个单例类的实例。
为了解决这个问题,你必须在创建首个单例对象时对线程进行同步。
python
from threading import Lock, Thread

class SingletonMeta(type):
    """
    This is a thread-safe implementation of Singleton.
    """

    _instances = {}

    _lock: Lock = Lock()
    """
    We now have a lock object that will be used to synchronize threads during
    first access to the Singleton.
    """

    def __call__(cls, *args, **kwargs):
        """
        Possible changes to the value of the `__init__` argument do not affect
        the returned instance.
        """
        # Now, imagine that the program has just been launched. Since there's no
        # Singleton instance yet, multiple threads can simultaneously pass the
        # previous conditional and reach this point almost at the same time. The
        # first of them will acquire lock and will proceed further, while the
        # rest will wait here.
        with cls._lock:
            # The first thread to acquire the lock, reaches this conditional,
            # goes inside and creates the Singleton instance. Once it leaves the
            # lock block, a thread that might have been waiting for the lock
            # release may then enter this section. But since the Singleton field
            # is already initialized, the thread won't create a new object.
            if cls not in cls._instances:
                instance = super().__call__(*args, **kwargs)
                cls._instances[cls] = instance
        return cls._instances[cls]

class Singleton(metaclass=SingletonMeta):
    value: str = None
    """
    We'll use this property to prove that our Singleton really works.
    """

    def __init__(self, value: str) -> None:
        self.value = value

    def some_business_logic(self):
        """
        Finally, any singleton should define some business logic, which can be
        executed on its instance.
        """

def test_singleton(value: str) -> None:
    singleton = Singleton(value)
    print(singleton.value)

if __name__ == "__main__":
    # The client code.

    print("If you see the same value, then singleton was reused (yay!)\n"
          "If you see different values, "
          "then 2 singletons were created (booo!!)\n\n"
          "RESULT:\n")

    process1 = Thread(target=test_singleton, args=("FOO",))
    process2 = Thread(target=test_singleton, args=("BAR",))
    process1.start()
    process2.start()
执行结果
text
If you see the same value, then singleton was reused (yay!)
If you see different values, then 2 singletons were created (booo!!)

RESULT:

FOO
FOO
项目案例和伪代码
在本例中, 数据库连接类即是一个单例 。
该类不提供公有构造函数, 因此获取该对象的唯一方式是调用 获取实例方法。 该方法将缓存首次生成的对象, 并为所有后续调用返回该对象。
python
// 数据库类会对`getInstance(获取实例)`方法进行定义以让客户端在程序各处
// 都能访问相同的数据库连接实例。
class Database is
    // 保存单例实例的成员变量必须被声明为静态类型。
    private static field instance: Database

    // 单例的构造函数必须永远是私有类型,以防止使用`new`运算符直接调用构
    // 造方法。
    private constructor Database() is
        // 部分初始化代码(例如到数据库服务器的实际连接)。
        // ...

    // 用于控制对单例实例的访问权限的静态方法。
    public static method getInstance() is
        if (Database.instance == null) then
            acquireThreadLock() and then
                // 确保在该线程等待解锁时,其他线程没有初始化该实例。
                if (Database.instance == null) then
                    Database.instance = new Database()
        return Database.instance

    // 最后,任何单例都必须定义一些可在其实例上执行的业务逻辑。
    public method query(sql) is
        // 比如应用的所有数据库查询请求都需要通过该方法进行。因此,你可以
        // 在这里添加限流或缓冲逻辑。
        // ...

class Application is
    method main() is
        Database foo = Database.getInstance()
        foo.query("SELECT ...")
        // ...
        Database bar = Database.getInstance()
        bar.query("SELECT ...")
        // 变量 `bar` 和 `foo` 中将包含同一个对象。
单例模式适合应用场景
如果程序中的某个类对于所有客户端只有一个可用的实例 , 可以使用单例模式。
单例模式禁止通过除特殊构建方法以外的任何方式来创建自身类的对象 。 该方法可以创建一个新对象, 但如果该对象已经被创建, 则返回已有的对象。
如果你需要更加严格地控制全局变量 , 可以使用单例模式。
单例模式与全局变量不同 , 它保证类只存在一个实例。 除了单例类自己以外, 无法通过任何方式替换缓存的实例。
请注意, 你可以随时调整限制并设定生成单例实例的数量, 只需修改 获取实例方法, 即 getInstance 中的代码即可实现。
实现方式
-
在类中添加一个私有静态成员变量用于保存单例实例。
-
声明一个公有静态构建方法用于获取单例实例。
-
在静态方法中实现"延迟初始化"。 该方法会在首次被调用时创建一个新对象, 并将其存储在静态成员变量中。 此后该方法每次被调用时都返回该实例。
-
将类的构造函数设为私有。 类的静态方法仍能调用构造函数, 但是其他对象不能调用。
-
检查客户端代码, 将对单例的构造函数的调用替换为对其静态构建方法的调用。
单例模式优缺点
-
你可以保证一个类只有一个实例 。
-
你获得了一个指向该实例的全局访问节点 。
-
仅在首次请求单例对象时对其进行初始化 。
-
违反了_单一职责原则_ 。 该模式同时解决了两个问题。
-
单例模式可能掩盖不良设计 , 比如程序各组件之间相互了解过多等。
-
该模式在多线程环境下需要进行特殊处理 , 避免多个线程多次创建单例对象。
-
单例的客户端代码单元测试可能会比较困难 , 因为许多测试框架以基于继承的方式创建模拟对象。 由于单例类的构造函数是私有的, 而且绝大部分语言无法重写静态方法, 所以你需要想出仔细考虑模拟单例的方法。 要么干脆不编写测试代码, 或者不使用单例模式。
与其他模式的关系
-
如果你能将对象的所有共享状态简化为一个享元对象, 那么享元模式就和单例类似了。 但这两个模式有两个根本性的不同。
- 只会有一个单例实体, 但是 享元 类可以有多个实体, 各实体的内在状态也可以不同。
- 单例 对象可以是可变的。 享元对象是不可变的。
4️⃣ 策略模式
策略是一种行为设计模式,它将一组行为转换为对象,并使其在原始上下文对象内部能够相互替换。
原始对象被称为上下文,它包含指向策略对象的引用并将执行行为的任务分派给策略对象。为了改变上下文完成其工作的方式,其他对象可以使用另一个对象来替换当前链接的策略对象。
策略模式亦称:Strategy。
问题
一天, 你打算为游客们创建一款导游程序。 该程序的核心功能是提供美观的地图, 以帮助用户在任何城市中快速定位。
用户期待的程序新功能是自动路线规划: 他们希望输入地址后就能在地图上看到前往目的地的最快路线。
程序的首个版本只能规划公路路线。 驾车旅行的人们对此非常满意。 但很显然, 并非所有人都会在度假时开车。 因此你在下次更新时添加了规划步行路线的功能。 此后, 你又添加了规划公共交通路线的功能。
而这只是个开始。 不久后, 你又要为骑行者规划路线。 又过了一段时间, 你又要为游览城市中的所有景点规划路线。
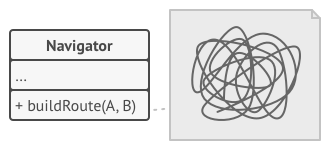
导游代码将变得非常臃肿。
尽管从商业角度来看, 这款应用非常成功, 但其技术部分却让你非常头疼: 每次添加新的路线规划算法后, 导游应用中主要类的体积就会增加一倍。 终于在某个时候, 你觉得自己没法继续维护这堆代码了。
无论是修复简单缺陷还是微调街道权重, 对某个算法进行任何修改都会影响整个类, 从而增加在已有正常运行代码中引入错误的风险。
此外, 团队合作将变得低效。 如果你在应用成功发布后招募了团队成员, 他们会抱怨在合并冲突的工作上花费了太多时间。 在实现新功能的过程中, 你的团队需要修改同一个巨大的类, 这样他们所编写的代码相互之间就可能会出现冲突。
解决方案
策略模式建议找出负责用许多不同方式完成特定任务的类, 然后将其中的算法抽取到一组被称为 策略 的独立类中。
名为 上下文 的原始类必须包含一个成员变量来存储对于每种策略的引用。 上下文并不执行任务, 而是将工作委派给已连接的策略对象。
上下文不负责选择符合任务需要的算法------客户端会将所需策略传递给上下文。 实际上, 上下文并不十分了解策略, 它会通过同样的通用接口与所有策略进行交互, 而该接口只需暴露一个方法来触发所选策略中封装的算法即可。
因此, 上下文可独立于具体策略。 这样你就可在不修改上下文代码或其他策略的情况下添加新算法或修改已有算法了。
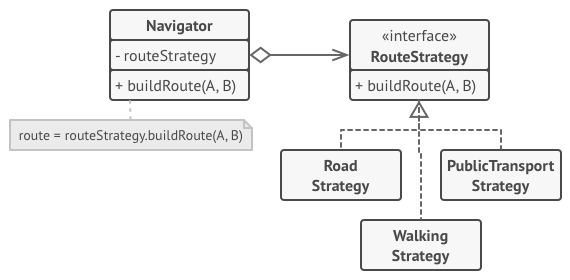
路线规划策略。
在导游应用中, 每个路线规划算法都可被抽取到只有一个 buildRoute生成路线方法的独立类中。 该方法接收起点和终点作为参数, 并返回路线中途点的集合。
即使传递给每个路径规划类的参数一模一样, 其所创建的路线也可能完全不同。 主要导游类的主要工作是在地图上渲染一系列中途点, 不会在意如何选择算法。 该类中还有一个用于切换当前路径规划策略的方法, 因此客户端 (例如用户界面中的按钮) 可用其他策略替换当前选择的路径规划行为。
真实世界类比
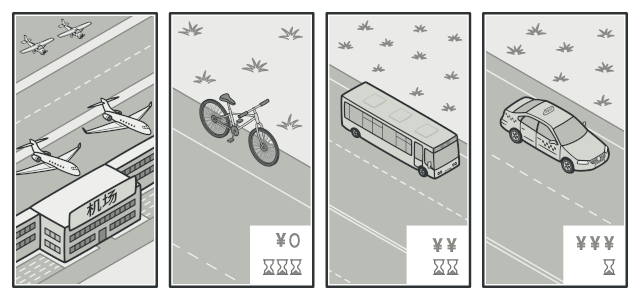
各种前往机场的出行策略
假如你需要前往机场。 你可以选择乘坐公共汽车、 预约出租车或骑自行车。 这些就是你的出行策略。 你可以根据预算或时间等因素来选择其中一种策略。
策略模式结构
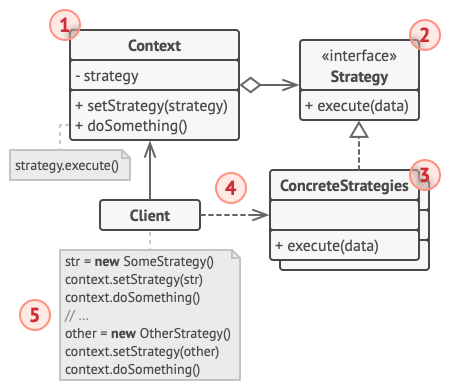
-
上下文 (Context) 维护指向具体策略的引用, 且仅通过策略接口与该对象进行交流。
-
策略 (Strategy) 接口是所有具体策略的通用接口, 它声明了一个上下文用于执行策略的方法。
-
具体策略 (Concrete Strategies) 实现了上下文所用算法的各种不同变体。
-
当上下文需要运行算法时, 它会在其已连接的策略对象上调用执行方法。 上下文不清楚其所涉及的策略类型与算法的执行方式。
-
客户端 (Client) 会创建一个特定策略对象并将其传递给上下文。 上下文则会提供一个设置器以便客户端在运行时替换相关联的策略。
策略模式代码实现
策略模式在 Python 代码中很常见。 它经常在各种框架中使用, 能在不扩展类的情况下向用户提供改变其行为的方式。
策略模式可以通过允许嵌套对象完成实际工作的方法以及允许将该对象替换为不同对象的设置器来识别。
本例说明了策略设计模式的结构并重点回答了下面的问题:它由哪些类组成?这些类扮演了哪些角色?模式中的各个元素会以何种方式相互关联?
python
from __future__ import annotations
from abc import ABC, abstractmethod
from typing import List

class Context():
    """
    The Context defines the interface of interest to clients.
    """

    def __init__(self, strategy: Strategy) -> None:
        """
        Usually, the Context accepts a strategy through the constructor, but
        also provides a setter to change it at runtime.
        """

        self._strategy = strategy

    @property
    def strategy(self) -> Strategy:
        """
        The Context maintains a reference to one of the Strategy objects. The
        Context does not know the concrete class of a strategy. It should work
        with all strategies via the Strategy interface.
        """

        return self._strategy

    @strategy.setter
    def strategy(self, strategy: Strategy) -> None:
        """
        Usually, the Context allows replacing a Strategy object at runtime.
        """

        self._strategy = strategy

    def do_some_business_logic(self) -> None:
        """
        The Context delegates some work to the Strategy object instead of
        implementing multiple versions of the algorithm on its own.
        """

        # ...

        print("Context: Sorting data using the strategy (not sure how it'll do it)")
        result = self._strategy.do_algorithm(["a", "b", "c", "d", "e"])
        print(",".join(result))

        # ...

class Strategy(ABC):
    """
    The Strategy interface declares operations common to all supported versions
    of some algorithm.

    The Context uses this interface to call the algorithm defined by Concrete
    Strategies.
    """

    @abstractmethod
    def do_algorithm(self, data: List):
        pass

"""
Concrete Strategies implement the algorithm while following the base Strategy
interface. The interface makes them interchangeable in the Context.
"""

class ConcreteStrategyA(Strategy):
    def do_algorithm(self, data: List) -> List:
        return sorted(data)

class ConcreteStrategyB(Strategy):
    def do_algorithm(self, data: List) -> List:
        return reversed(sorted(data))

if __name__ == "__main__":
    # The client code picks a concrete strategy and passes it to the context.
    # The client should be aware of the differences between strategies in order
    # to make the right choice.

    context = Context(ConcreteStrategyA())
    print("Client: Strategy is set to normal sorting.")
    context.do_some_business_logic()
    print()

    print("Client: Strategy is set to reverse sorting.")
    context.strategy = ConcreteStrategyB()
    context.do_some_business_logic()
执行结果
text
Client: Strategy is set to normal sorting.
Context: Sorting data using the strategy (not sure how it'll do it)
a,b,c,d,e

Client: Strategy is set to reverse sorting.
Context: Sorting data using the strategy (not sure how it'll do it)
e,d,c,b,a
项目案例和伪代码
在本例中, 上下文使用了多个策略 来执行不同的计算操作。
python
// 策略接口声明了某个算法各个不同版本间所共有的操作。上下文会使用该接口来
// 调用有具体策略定义的算法。
interface Strategy is
    method execute(a, b)

// 具体策略会在遵循策略基础接口的情况下实现算法。该接口实现了它们在上下文
// 中的互换性。
class ConcreteStrategyAdd implements Strategy is
    method execute(a, b) is
        return a + b

class ConcreteStrategySubtract implements Strategy is
    method execute(a, b) is
        return a - b

class ConcreteStrategyMultiply implements Strategy is
    method execute(a, b) is
        return a * b

// 上下文定义了客户端关注的接口。
class Context is
    // 上下文会维护指向某个策略对象的引用。上下文不知晓策略的具体类。上下
    // 文必须通过策略接口来与所有策略进行交互。
    private strategy: Strategy

    // 上下文通常会通过构造函数来接收策略对象,同时还提供设置器以便在运行
    // 时切换策略。
    method setStrategy(Strategy strategy) is
        this.strategy = strategy

    // 上下文会将一些工作委派给策略对象,而不是自行实现不同版本的算法。
    method executeStrategy(int a, int b) is
        return strategy.execute(a, b)

// 客户端代码会选择具体策略并将其传递给上下文。客户端必须知晓策略之间的差
// 异,才能做出正确的选择。
class ExampleApplication is
    method main() is

        创建上下文对象。

        读取第一个数。
        读取最后一个数。
        从用户输入中读取期望进行的行为。

        if (action == addition) then
            context.setStrategy(new ConcreteStrategyAdd())

        if (action == subtraction) then
            context.setStrategy(new ConcreteStrategySubtract())

        if (action == multiplication) then
            context.setStrategy(new ConcreteStrategyMultiply())

        result = context.executeStrategy(First number, Second number)

        打印结果。
策略模式适合应用场景
当你想使用对象中各种不同的算法变体 , 并希望能在运行时切换算法时, 可使用策略模式。
策略模式让你能够将对象关联至可以不同方式执行特定子任务的不同子对象 , 从而以间接方式在运行时更改对象行为。
当你有许多仅在执行某些行为时略有不同的相似类时 , 可使用策略模式。
策略模式让你能将不同行为抽取到一个独立类层次结构中 , 并将原始类组合成同一个, 从而减少重复代码。
如果算法在上下文的逻辑中不是特别重要 , 使用该模式能将类的业务逻辑与其算法实现细节隔离开来。
策略模式让你能将各种算法的代码 、 内部数据和依赖关系与其他代码隔离开来。 不同客户端可通过一个简单接口执行算法, 并能在运行时进行切换。
当类中使用了复杂条件运算符以在同一算法的不同变体中切换时 , 可使用该模式。
策略模式将所有继承自同样接口的算法抽取到独立类中 , 因此不再需要条件语句。 原始对象并不实现所有算法的变体, 而是将执行工作委派给其中的一个独立算法对象。
实现方式
-
从上下文类中找出修改频率较高的算法 (也可能是用于在运行时选择某个算法变体的复杂条件运算符)。
-
声明该算法所有变体的通用策略接口。
-
将算法逐一抽取到各自的类中, 它们都必须实现策略接口。
-
在上下文类中添加一个成员变量用于保存对于策略对象的引用。 然后提供设置器以修改该成员变量。 上下文仅可通过策略接口同策略对象进行交互, 如有需要还可定义一个接口来让策略访问其数据。
-
客户端必须将上下文类与相应策略进行关联, 使上下文可以预期的方式完成其主要工作。
策略模式优缺点
-
你可以在运行时切换对象内的算法 。
-
你可以将算法的实现和使用算法的代码隔离开来 。
-
你可以使用组合来代替继承 。
-
开闭原则 。 你无需对上下文进行修改就能够引入新的策略。
-
如果你的算法极少发生改变 , 那么没有任何理由引入新的类和接口。 使用该模式只会让程序过于复杂。
-
客户端必须知晓策略间的不同 ------它需要选择合适的策略。
-
许多现代编程语言支持函数类型功能 , 允许你在一组匿名函数中实现不同版本的算法。 这样, 你使用这些函数的方式就和使用策略对象时完全相同, 无需借助额外的类和接口来保持代码简洁。
与其他模式的关系
-
桥接模式、 状态模式和策略模式 (在某种程度上包括适配器模式) 模式的接口非常相似。 实际上, 它们都基于组合模式------即将工作委派给其他对象, 不过也各自解决了不同的问题。 模式并不只是以特定方式组织代码的配方, 你还可以使用它们来和其他开发者讨论模式所解决的问题。
-
命令模式和策略看上去很像, 因为两者都能通过某些行为来参数化对象。 但是, 它们的意图有非常大的不同。
-
你可以使用 命令 来将任何操作转换为对象。 操作的参数将成为对象的成员变量。 你可以通过转换来延迟操作的执行、 将操作放入队列、 保存历史命令或者向远程服务发送命令等。
-
另一方面, 策略 通常可用于描述完成某件事的不同方式, 让你能够在同一个上下文类中切换算法。
-
-
模板方法模式基于继承机制: 它允许你通过扩展子类中的部分内容来改变部分算法。 策略基于组合机制: 你可以通过对相应行为提供不同的策略来改变对象的部分行为。 模板方法 在类层次上运作, 因此它是静态的。 策略 在对象层次上运作, 因此允许在运行时切换行为。
-
状态可被视为策略的扩展。 两者都基于组合机制: 它们都通过将部分工作委派给 "帮手" 对象来改变其在不同情景下的行为。 策略 使得这些对象相互之间完全独立, 它们不知道其他对象的存在。 但 状态 模式没有限制具体状态之间的依赖, 且允许它们自行改变在不同情景下的状态。
5️⃣ 装饰模式
装饰是一种概念设计模式,允许你通过将对象放入特殊封装对象中来为原对象增加新的行为。
由于目标对象和装饰器遵循同一接口,因此你可用装饰来对对象进行无限次的封装。结果对象将获得所有封装器叠加而来的行为。
装饰模式亦称:装饰者模式、装饰器模式、Wrapper、Decorator。
问题
假设你正在开发一个提供通知功能的库, 其他程序可使用它向用户发送关于重要事件的通知。
库的最初版本基于 通知器Notifier类, 其中只有很少的几个成员变量, 一个构造函数和一个 send发送方法。 该方法可以接收来自客户端的消息参数, 并将该消息发送给一系列的邮箱, 邮箱列表则是通过构造函数传递给通知器的。 作为客户端的第三方程序仅会创建和配置通知器对象一次, 然后在有重要事件发生时对其进行调用。
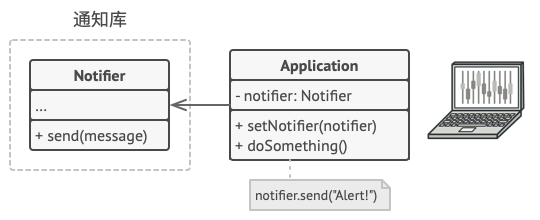
程序可以使用通知器类向预定义的邮箱发送重要事件通知。
此后某个时刻, 你会发现库的用户希望使用除邮件通知之外的功能。 许多用户会希望接收关于紧急事件的手机短信, 还有些用户希望在微信上接收消息, 而公司用户则希望在 QQ 上接收消息。
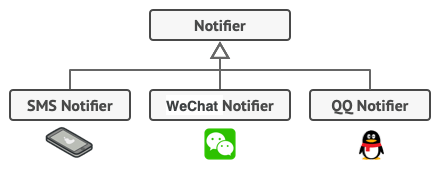
每种通知类型都将作为通知器的一个子类得以实现。
这有什么难的呢? 首先扩展 通知器类, 然后在新的子类中加入额外的通知方法。 现在客户端要对所需通知形式的对应类进行初始化, 然后使用该类发送后续所有的通知消息。
但是很快有人会问: "为什么不同时使用多种通知形式呢? 如果房子着火了, 你大概会想在所有渠道中都收到相同的消息吧。"
你可以尝试创建一个特殊子类来将多种通知方法组合在一起以解决该问题。 但这种方式会使得代码量迅速膨胀, 不仅仅是程序库代码, 客户端代码也会如此。
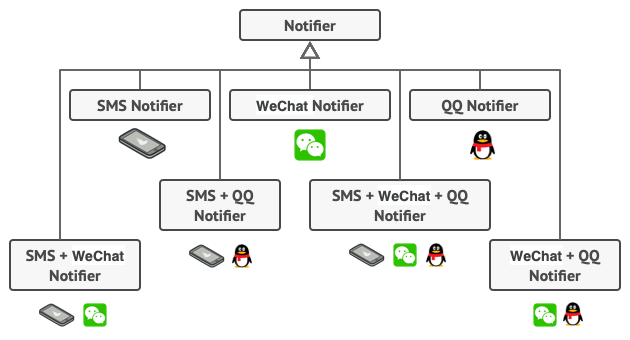
子类组合数量爆炸。
你必须找到其他方法来规划通知类的结构, 否则它们的数量会在不经意之间打破吉尼斯纪录。
解决方案
当你需要更改一个对象的行为时, 第一个跳入脑海的想法就是扩展它所属的类。 但是, 你不能忽视继承可能引发的几个严重问题。
-
继承是静态的。 你无法在运行时更改已有对象的行为, 只能使用由不同子类创建的对象来替代当前的整个对象。
-
子类只能有一个父类。 大部分编程语言不允许一个类同时继承多个类的行为。
其中一种方法是用 聚合 或 组合 聚合 : 对象 A 包含对象 B; B 可以独立于 A 存在。
组合 : 对象 A 由对象 B 构成; A 负责管理 B 的生命周期。 B 无法独立于 A 存在。 , 而不是 继承 。 两者的工作方式几乎一模一样: 一个对象 包含 指向另一个对象的引用, 并将部分工作委派给引用对象; 继承中的对象则继承了父类的行为, 它们自己 能够 完成这些工作。
你可以使用这个新方法来轻松替换各种连接的 "小帮手" 对象, 从而能在运行时改变容器的行为。 一个对象可以使用多个类的行为, 包含多个指向其他对象的引用, 并将各种工作委派给引用对象。
聚合 (或组合) 组合是许多设计模式背后的关键原则 (包括装饰在内)。 记住这一点后, 让我们继续关于模式的讨论。
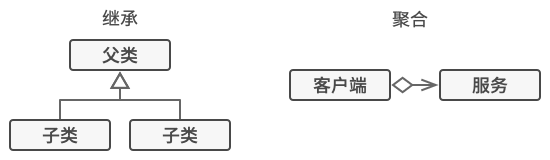
继承与聚合的对比
封装器 是装饰模式的别称, 这个称谓明确地表达了该模式的主要思想。 "封装器" 是一个能与其他 "目标" 对象连接的对象。 封装器包含与目标对象相同的一系列方法, 它会将所有接收到的请求委派给目标对象。 但是, 封装器可以在将请求委派给目标前后对其进行处理, 所以可能会改变最终结果。
那么什么时候一个简单的封装器可以被称为是真正的装饰呢? 正如之前提到的, 封装器实现了与其封装对象相同的接口。 因此从客户端的角度来看, 这些对象是完全一样的。 封装器中的引用成员变量可以是遵循相同接口的任意对象。 这使得你可以将一个对象放入多个封装器中, 并在对象中添加所有这些封装器的组合行为。
比如在消息通知示例中, 我们可以将简单邮件通知行为放在基类 通知器中, 但将所有其他通知方法放入装饰中。
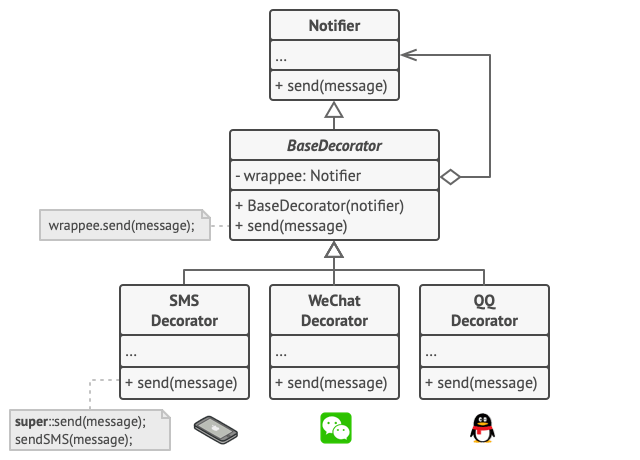
将各种通知方法放入装饰。
客户端代码必须将基础通知器放入一系列自己所需的装饰中。 因此最后的对象将形成一个栈结构。
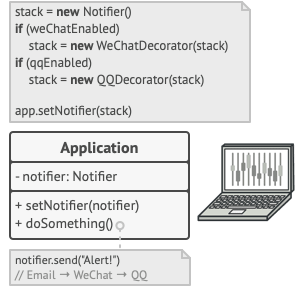
程序可以配置由通知装饰构成的复杂栈。
实际与客户端进行交互的对象将是最后一个进入栈中的装饰对象。 由于所有的装饰都实现了与通知基类相同的接口, 客户端的其他代码并不在意自己到底是与 "纯粹" 的通知器对象, 还是与装饰后的通知器对象进行交互。
我们可以使用相同方法来完成其他行为 (例如设置消息格式或者创建接收人列表)。 只要所有装饰都遵循相同的接口, 客户端就可以使用任意自定义的装饰来装饰对象。
真实世界类比
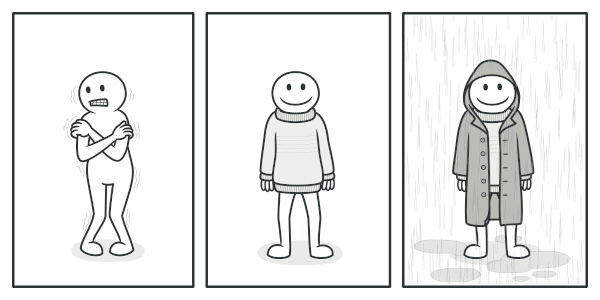
穿上多件衣服将获得组合性的效果。
穿衣服是使用装饰的一个例子。 觉得冷时, 你可以穿一件毛衣。 如果穿毛衣还觉得冷, 你可以再套上一件夹克。 如果遇到下雨, 你还可以再穿一件雨衣。 所有这些衣物都 "扩展" 了你的基本行为, 但它们并不是你的一部分, 如果你不再需要某件衣物, 可以方便地随时脱掉。
装饰模式结构
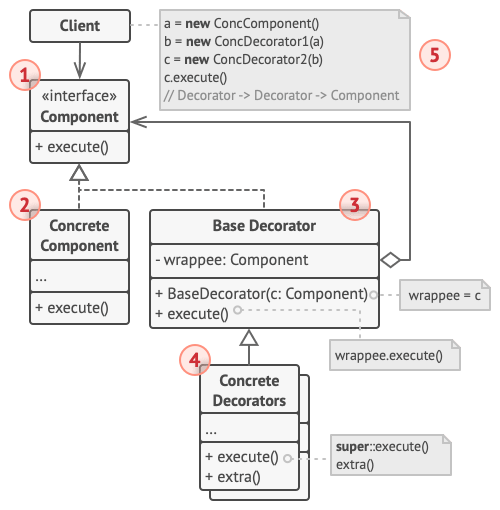
-
部件 (Component) 声明封装器和被封装对象的公用接口。
-
具体部件 (Concrete Component) 类是被封装对象所属的类。 它定义了基础行为, 但装饰类可以改变这些行为。
-
基础装饰 (Base Decorator) 类拥有一个指向被封装对象的引用成员变量。 该变量的类型应当被声明为通用部件接口, 这样它就可以引用具体的部件和装饰。 装饰基类会将所有操作委派给被封装的对象。
-
具体装饰类 (Concrete Decorators) 定义了可动态添加到部件的额外行为。 具体装饰类会重写装饰基类的方法, 并在调用父类方法之前或之后进行额外的行为。
-
客户端 (Client) 可以使用多层装饰来封装部件, 只要它能使用通用接口与所有对象互动即可。
装饰模式代码实现
使用示例:装饰在 Python 代码中可谓是标准配置,尤其是在与流式加载相关的代码中。
装饰可通过以当前类或对象为参数的创建方法或构造函数来识别。
本例说明了装饰设计模式的结构并重点回答了下面的问题:它由哪些类组成?这些类扮演了哪些角色?模式中的各个元素会以何种方式相互关联?
python
class Component():
    """
    The base Component interface defines operations that can be altered by
    decorators.
    """

    def operation(self) -> str:
        pass

class ConcreteComponent(Component):
    """
    Concrete Components provide default implementations of the operations. There
    might be several variations of these classes.
    """

    def operation(self) -> str:
        return "ConcreteComponent"

class Decorator(Component):
    """
    The base Decorator class follows the same interface as the other components.
    The primary purpose of this class is to define the wrapping interface for
    all concrete decorators. The default implementation of the wrapping code
    might include a field for storing a wrapped component and the means to
    initialize it.
    """

    _component: Component = None

    def __init__(self, component: Component) -> None:
        self._component = component

    @property
    def component(self) -> str:
        """
        The Decorator delegates all work to the wrapped component.
        """

        return self._component

    def operation(self) -> str:
        return self._component.operation()

class ConcreteDecoratorA(Decorator):
    """
    Concrete Decorators call the wrapped object and alter its result in some
    way.
    """

    def operation(self) -> str:
        """
        Decorators may call parent implementation of the operation, instead of
        calling the wrapped object directly. This approach simplifies extension
        of decorator classes.
        """
        return f"ConcreteDecoratorA({self.component.operation()})"

class ConcreteDecoratorB(Decorator):
    """
    Decorators can execute their behavior either before or after the call to a
    wrapped object.
    """

    def operation(self) -> str:
        return f"ConcreteDecoratorB({self.component.operation()})"

def client_code(component: Component) -> None:
    """
    The client code works with all objects using the Component interface. This
    way it can stay independent of the concrete classes of components it works
    with.
    """

    # ...

    print(f"RESULT: {component.operation()}", end="")

    # ...

if __name__ == "__main__":
    # This way the client code can support both simple components...
    simple = ConcreteComponent()
    print("Client: I've got a simple component:")
    client_code(simple)
    print("\n")

    # ...as well as decorated ones.
    #
    # Note how decorators can wrap not only simple components but the other
    # decorators as well.
    decorator1 = ConcreteDecoratorA(simple)
    decorator2 = ConcreteDecoratorB(decorator1)
    print("Client: Now I've got a decorated component:")
    client_code(decorator2)
执行结果
text
Client: I've got a simple component:
RESULT: ConcreteComponent

Client: Now I've got a decorated component:
RESULT: ConcreteDecoratorB(ConcreteDecoratorA(ConcreteComponent))
项目案例和伪代码
在本例中, 装饰模式能够对敏感数据进行压缩和加密, 从而将数据从使用数据的代码中独立出来。
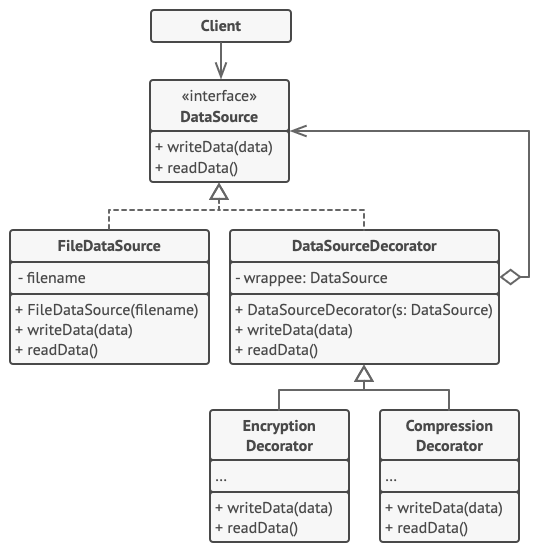
加密和压缩装饰的示例。
程序使用一对装饰来封装数据源对象。 这两个封装器都改变了从磁盘读写数据的方式:
-
当数据即将被写入磁盘 前, 装饰对数据进行加密和压缩。 在原始类对改变毫无察觉的情况下, 将加密后的受保护数据写入文件。
-
当数据刚从磁盘读出 后, 同样通过装饰对数据进行解压和解密。 装饰和数据源类实现同一接口, 从而能在客户端代码中相互替换。
python
// 装饰可以改变组件接口所定义的操作。
interface DataSource is
    method writeData(data)
    method readData():data

// 具体组件提供操作的默认实现。这些类在程序中可能会有几个变体。
class FileDataSource implements DataSource is
    constructor FileDataSource(filename) { ... }

    method writeData(data) is
        // 将数据写入文件。

    method readData():data is
        // 从文件读取数据。

// 装饰基类和其他组件遵循相同的接口。该类的主要任务是定义所有具体装饰的封
// 装接口。封装的默认实现代码中可能会包含一个保存被封装组件的成员变量,并
// 且负责对其进行初始化。
class DataSourceDecorator implements DataSource is
    protected field wrappee: DataSource

    constructor DataSourceDecorator(source: DataSource) is
        wrappee = source

    // 装饰基类会直接将所有工作分派给被封装组件。具体装饰中则可以新增一些
    // 额外的行为。
    method writeData(data) is
        wrappee.writeData(data)

    // 具体装饰可调用其父类的操作实现,而不是直接调用被封装对象。这种方式
    // 可简化装饰类的扩展工作。
    method readData():data is
        return wrappee.readData()

// 具体装饰必须在被封装对象上调用方法,不过也可以自行在结果中添加一些内容。
// 装饰必须在调用封装对象之前或之后执行额外的行为。
class EncryptionDecorator extends DataSourceDecorator is
    method writeData(data) is
        // 1. 对传递数据进行加密。
        // 2. 将加密后数据传递给被封装对象 writeData(写入数据)方法。

    method readData():data is
        // 1. 通过被封装对象的 readData(读取数据)方法获取数据。
        // 2. 如果数据被加密就尝试解密。
        // 3. 返回结果。

// 你可以将对象封装在多层装饰中。
class CompressionDecorator extends DataSourceDecorator is
    method writeData(data) is
        // 1. 压缩传递数据。
        // 2. 将压缩后数据传递给被封装对象 writeData(写入数据)方法。

    method readData():data is
        // 1. 通过被封装对象的 readData(读取数据)方法获取数据。
        // 2. 如果数据被压缩就尝试解压。
        // 3. 返回结果。

// 选项 1:装饰组件的简单示例
class Application is
    method dumbUsageExample() is
        source = new FileDataSource("somefile.dat")
        source.writeData(salaryRecords)
        // 已将明码数据写入目标文件。

        source = new CompressionDecorator(source)
        source.writeData(salaryRecords)
        // 已将压缩数据写入目标文件。

        source = new EncryptionDecorator(source)
        // 源变量中现在包含:
        // Encryption > Compression > FileDataSource
        source.writeData(salaryRecords)
        // 已将压缩且加密的数据写入目标文件。

// 选项 2:客户端使用外部数据源。SalaryManager(工资管理器)对象并不关心
// 数据如何存储。它们会与提前配置好的数据源进行交互,数据源则是通过程序配
// 置器获取的。
class SalaryManager is
    field source: DataSource

    constructor SalaryManager(source: DataSource) { ... }

    method load() is
        return source.readData()

    method save() is
        source.writeData(salaryRecords)
    // ...其他有用的方法...

// 程序可在运行时根据配置或环境组装不同的装饰堆桟。
class ApplicationConfigurator is
    method configurationExample() is
        source = new FileDataSource("salary.dat")
        if (enabledEncryption)
            source = new EncryptionDecorator(source)
        if (enabledCompression)
            source = new CompressionDecorator(source)

        logger = new SalaryManager(source)
        salary = logger.load()
    // ...
装饰模式适合应用场景
如果你希望在无需修改代码的情况下即可使用对象 , 且希望在运行时为对象新增额外的行为, 可以使用装饰模式。
装饰能将业务逻辑组织为层次结构 , 你可为各层创建一个装饰, 在运行时将各种不同逻辑组合成对象。 由于这些对象都遵循通用接口, 客户端代码能以相同的方式使用这些对象。
如果用继承来扩展对象行为的方案难以实现或者根本不可行 , 你可以使用该模式。
许多编程语言使用 final最终关键字来限制对某个类的进一步扩展。 复用最终类已有行为的唯一方法是使用装饰模式: 用封装器对其进行封装。
实现方式
-
确保业务逻辑可用一个基本组件及多个额外可选层次表示。
-
找出基本组件和可选层次的通用方法。 创建一个组件接口并在其中声明这些方法。
-
创建一个具体组件类, 并定义其基础行为。
-
创建装饰基类, 使用一个成员变量存储指向被封装对象的引用。 该成员变量必须被声明为组件接口类型, 从而能在运行时连接具体组件和装饰。 装饰基类必须将所有工作委派给被封装的对象。
-
确保所有类实现组件接口。
-
将装饰基类扩展为具体装饰。 具体装饰必须在调用父类方法 (总是委派给被封装对象) 之前或之后执行自身的行为。
-
客户端代码负责创建装饰并将其组合成客户端所需的形式。
装饰模式优缺点
-
你无需创建新子类即可扩展对象的行为 。
-
你可以在运行时添加或删除对象的功能 。
-
你可以用多个装饰封装对象来组合几种行为 。
-
单一职责原则 。 你可以将实现了许多不同行为的一个大类拆分为多个较小的类。
-
在封装器栈中删除特定封装器比较困难 。
-
实现行为不受装饰栈顺序影响的装饰比较困难 。
-
各层的初始化配置代码看上去可能会很糟糕 。
与其他模式的关系
-
适配器模式可以对已有对象的接口进行修改, 装饰模式则能在不改变对象接口的前提下强化对象功能。 此外, 装饰 还支持递归组合, 适配器 则无法实现。
-
责任链模式和装饰模式的类结构非常相似。 两者都依赖递归组合将需要执行的操作传递给一系列对象。 但是, 两者有几点重要的不同之处。
责任链的管理者可以相互独立地执行一切操作, 还可以随时停止传递请求。 另一方面, 各种 装饰 可以在遵循基本接口的情况下扩展对象的行为。 此外, 装饰无法中断请求的传递。
装饰 类似于 组合 , 但其只有一个子组件。 此外还有一个明显不同: 装饰 为被封装对象添加了额外的职责, 组合 仅对其子节点的结果进行了 "求和"。
但是, 模式也可以相互合作: 你可以使用 装饰 来扩展 组合 树中特定对象的行为。
-
装饰和代理有着相似的结构, 但是其意图却非常不同。 这两个模式的构建都基于组合原则, 也就是说一个对象应该将部分工作委派给另一个对象。 两者之间的不同之处在于 代理 通常自行管理其服务对象的生命周期, 而 装饰 的生成则总是由客户端进行控制。
6️⃣ 迭代器模式
迭代器是一种行为设计模式,让你能在不暴露复杂数据结构内部细节的情况下遍历其中所有的元素。
在迭代器的帮助下,客户端可以用一个迭代器接口以相似的方式遍历不同集合中的元素。
迭代器模式亦称:Iterator。
问题
集合是编程中最常使用的数据类型之一。 尽管如此, 集合只是一组对象的容器而已。
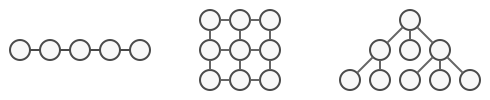
各种类型的集合。
大部分集合使用简单列表存储元素。 但有些集合还会使用栈、 树、 图和其他复杂的数据结构。
无论集合的构成方式如何, 它都必须提供某种访问元素的方式, 便于其他代码使用其中的元素。 集合应提供一种能够遍历元素的方式, 且保证它不会周而复始地访问同一个元素。
如果你的集合基于列表, 那么这项工作听上去仿佛很简单。 但如何遍历复杂数据结构 (例如树) 中的元素呢? 例如, 今天你需要使用深度优先算法来遍历树结构, 明天可能会需要广度优先算法; 下周则可能会需要其他方式 (比如随机存取树中的元素)。
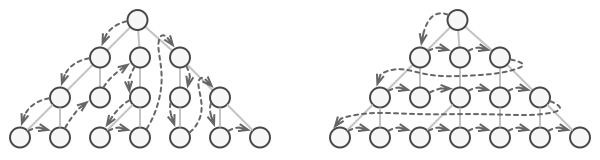
可通过不同的方式遍历相同的集合。
不断向集合中添加遍历算法会模糊其 "高效存储数据" 的主要职责。 此外, 有些算法可能是根据特定应用订制的, 将其加入泛型集合类中会显得非常奇怪。
另一方面, 使用多种集合的客户端代码可能并不关心存储数据的方式。 不过由于集合提供不同的元素访问方式, 你的代码将不得不与特定集合类进行耦合。
解决方案
迭代器模式的主要思想是将集合的遍历行为抽取为单独的 迭代器 对象。
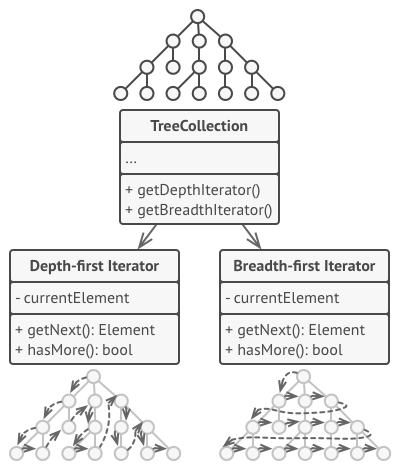
迭代器可实现多种遍历算法。 多个迭代器对象可同时遍历同一个集合。
除实现自身算法外, 迭代器还封装了遍历操作的所有细节, 例如当前位置和末尾剩余元素的数量。 因此, 多个迭代器可以在相互独立的情况下同时访问集合。
迭代器通常会提供一个获取集合元素的基本方法。 客户端可不断调用该方法直至它不返回任何内容, 这意味着迭代器已经遍历了所有元素。
所有迭代器必须实现相同的接口。 这样一来, 只要有合适的迭代器, 客户端代码就能兼容任何类型的集合或遍历算法。 如果你需要采用特殊方式来遍历集合, 只需创建一个新的迭代器类即可, 无需对集合或客户端进行修改。
真实世界类比
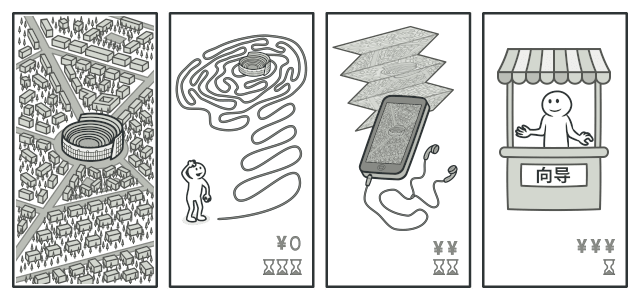
漫步罗马的不同方式。
你计划在罗马游览数天, 参观所有主要的旅游景点。 但在到达目的地后, 你可能会浪费很多时间绕圈子, 甚至找不到罗马斗兽场在哪里。
或者你可以购买一款智能手机上的虚拟导游程序。 这款程序非常智能而且价格不贵, 你想在景点待多久都可以。
第三种选择是用部分旅行预算雇佣一位对城市了如指掌的当地向导。 向导能根据你的喜好来安排行程, 为你介绍每个景点并讲述许多激动人心的故事。 这样的旅行可能会更有趣, 但所需费用也会更高。
所有这些选择(自由漫步、 智能手机导航或真人向导)都是这个由众多罗马景点组成的集合的迭代器。
迭代器模式结构
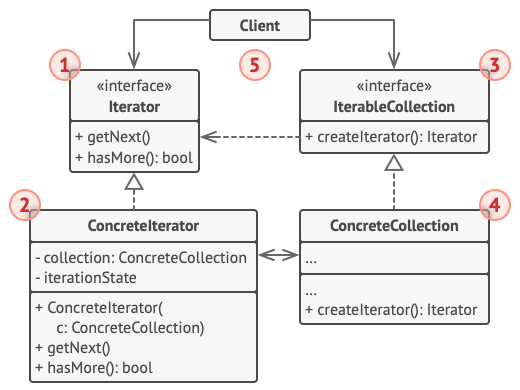
-
迭代器 (Iterator) 接口声明了遍历集合所需的操作: 获取下一个元素、 获取当前位置和重新开始迭代等。
-
具体迭代器 (Concrete Iterators) 实现遍历集合的一种特定算法。 迭代器对象必须跟踪自身遍历的进度。 这使得多个迭代器可以相互独立地遍历同一集合。
-
集合 (Collection) 接口声明一个或多个方法来获取与集合兼容的迭代器。 请注意, 返回方法的类型必须被声明为迭代器接口, 因此具体集合可以返回各种不同种类的迭代器。
-
具体集合 (Concrete Collections) 会在客户端请求迭代器时返回一个特定的具体迭代器类实体。 你可能会琢磨, 剩下的集合代码在什么地方呢? 不用担心, 它也会在同一个类中。 只是这些细节对于实际模式来说并不重要, 所以我们将其省略了而已。
-
客户端 (Client) 通过集合和迭代器的接口与两者进行交互。 这样一来客户端无需与具体类进行耦合, 允许同一客户端代码使用各种不同的集合和迭代器。
客户端通常不会自行创建迭代器, 而是会从集合中获取。 但在特定情况下, 客户端可以直接创建一个迭代器 (例如当客户端需要自定义特殊迭代器时)。
迭代器模式代码实现
python
from __future__ import annotations
from collections.abc import Iterable, Iterator
from typing import Any, List

"""
To create an iterator in Python, there are two abstract classes from the built-
in `collections` module - Iterable,Iterator. We need to implement the
`__iter__()` method in the iterated object (collection), and the `__next__ ()`
method in theiterator.
"""

class AlphabeticalOrderIterator(Iterator):
    """
    Concrete Iterators implement various traversal algorithms. These classes
    store the current traversal position at all times.
    """

    """
    `_position` attribute stores the current traversal position. An iterator may
    have a lot of other fields for storing iteration state, especially when it
    is supposed to work with a particular kind of collection.
    """
    _position: int = None

    """
    This attribute indicates the traversal direction.
    """
    _reverse: bool = False

    def __init__(self, collection: WordsCollection, reverse: bool = False) -> None:
        self._collection = collection
        self._reverse = reverse
        self._position = -1 if reverse else 0

    def __next__(self):
        """
        The __next__() method must return the next item in the sequence. On
        reaching the end, and in subsequent calls, it must raise StopIteration.
        """
        try:
            value = self._collection[self._position]
            self._position += -1 if self._reverse else 1
        except IndexError:
            raise StopIteration()

        return value

class WordsCollection(Iterable):
    """
    Concrete Collections provide one or several methods for retrieving fresh
    iterator instances, compatible with the collection class.
    """

    def __init__(self, collection: List[Any] = []) -> None:
        self._collection = collection

    def __iter__(self) -> AlphabeticalOrderIterator:
        """
        The __iter__() method returns the iterator object itself, by default we
        return the iterator in ascending order.
        """
        return AlphabeticalOrderIterator(self._collection)

    def get_reverse_iterator(self) -> AlphabeticalOrderIterator:
        return AlphabeticalOrderIterator(self._collection, True)

    def add_item(self, item: Any):
        self._collection.append(item)

if __name__ == "__main__":
    # The client code may or may not know about the Concrete Iterator or
    # Collection classes, depending on the level of indirection you want to keep
    # in your program.
    collection = WordsCollection()
    collection.add_item("First")
    collection.add_item("Second")
    collection.add_item("Third")

    print("Straight traversal:")
    print("\n".join(collection))
    print("")

    print("Reverse traversal:")
    print("\n".join(collection.get_reverse_iterator()), end="")
项目案例和伪代码
在本例中, 迭代器 模式用于遍历一个封装了访问微信好友关系功能的特殊集合。 该集合提供使用不同方式遍历档案资料的多个迭代器。
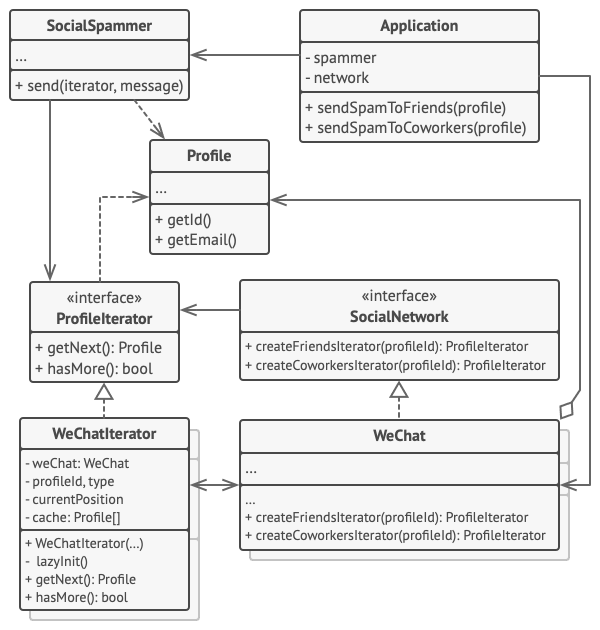
遍历社交档案的示例
"好友 (friends)" 迭代器可用于遍历指定档案的好友。 "同事 (colleagues)" 迭代器也提供同样的功能, 但仅包括与目标用户在同一家公司工作的好友。 这两个迭代器都实现了同一个通用接口, 客户端能在不了解认证和发送 REST 请求等实现细节的情况下获取档案。
客户端仅通过接口与集合和迭代器交互, 也就不会同具体类耦合。 如果你决定将应用连接到全新的社交网络, 只需提供新的集合和迭代器类即可, 无需修改现有代码。
python
// 集合接口必须声明一个用于生成迭代器的工厂方法。如果程序中有不同类型的迭
// 代器,你也可以声明多个方法。
interface SocialNetwork is
    method createFriendsIterator(profileId):ProfileIterator
    method createCoworkersIterator(profileId):ProfileIterator

// 每个具体集合都与其返回的一组具体迭代器相耦合。但客户并不是这样的,因为
// 这些方法的签名将会返回迭代器接口。
class WeChat implements SocialNetwork is
    // ...大量的集合代码应该放在这里...

    // 迭代器创建代码。
    method createFriendsIterator(profileId) is
        return new WeChatIterator(this, profileId, "friends")
    method createCoworkersIterator(profileId) is
        return new WeChatIterator(this, profileId, "coworkers")

// 所有迭代器的通用接口。
interface ProfileIterator is
    method getNext():Profile
    method hasMore():bool

// 具体迭代器类。
class WeChatIterator implements ProfileIterator is
    // 迭代器需要一个指向其遍历集合的引用。
    private field weChat: WeChat
    private field profileId, type: string

    // 迭代器对象会独立于其他迭代器来对集合进行遍历。因此它必须保存迭代器
    // 的状态。
    private field currentPosition
    private field cache: array of Profile

    constructor WeChatIterator(weChat, profileId, type) is
        this.weChat = weChat
        this.profileId = profileId
        this.type = type

    private method lazyInit() is
        if (cache == null)
            cache = weChat.socialGraphRequest(profileId, type)

    // 每个具体迭代器类都会自行实现通用迭代器接口。
    method getNext() is
        if (hasMore())
            currentPosition++
            return cache[currentPosition]

    method hasMore() is
        lazyInit()
        return currentPosition < cache.length

// 这里还有一个有用的绝招:你可将迭代器传递给客户端类,无需让其拥有访问整
// 个集合的权限。这样一来,你就无需将集合暴露给客户端了。
//
// 还有另一个好处:你可在运行时将不同的迭代器传递给客户端,从而改变客户端
// 与集合互动的方式。这一方法可行的原因是客户端代码并没有和具体迭代器类相
// 耦合。
class SocialSpammer is
    method send(iterator: ProfileIterator, message: string) is
        while (iterator.hasMore())
            profile = iterator.getNext()
            System.sendEmail(profile.getEmail(), message)

// 应用程序(Application)类可对集合和迭代器进行配置,然后将其传递给客户
// 端代码。
class Application is
    field network: SocialNetwork
    field spammer: SocialSpammer

    method config() is
        if working with WeChat
            this.network = new WeChat()
        if working with LinkedIn
            this.network = new LinkedIn()
        this.spammer = new SocialSpammer()

    method sendSpamToFriends(profile) is
        iterator = network.createFriendsIterator(profile.getId())
        spammer.send(iterator, "非常重要的消息")

    method sendSpamToCoworkers(profile) is
        iterator = network.createCoworkersIterator(profile.getId())
        spammer.send(iterator, "非常重要的消息")
迭代器模式适合应用场景
当集合背后为复杂的数据结构 , 且你希望对客户端隐藏其复杂性时 (出于使用便利性或安全性的考虑), 可以使用迭代器模式。
迭代器封装了与复杂数据结构进行交互的细节 , 为客户端提供多个访问集合元素的简单方法。 这种方式不仅对客户端来说非常方便, 而且能避免客户端在直接与集合交互时执行错误或有害的操作, 从而起到保护集合的作用。
使用该模式可以减少程序中重复的遍历代码 。
重要迭代算法的代码往往体积非常庞大 。 当这些代码被放置在程序业务逻辑中时, 它会让原始代码的职责模糊不清, 降低其可维护性。 因此, 将遍历代码移到特定的迭代器中可使程序代码更加精炼和简洁。
如果你希望代码能够遍历不同的甚至是无法预知的数据结构 , 可以使用迭代器模式。
该模式为集合和迭代器提供了一些通用接口 。 如果你在代码中使用了这些接口, 那么将其他实现了这些接口的集合和迭代器传递给它时, 它仍将可以正常运行。
实现方式
-
声明迭代器接口。 该接口必须提供至少一个方法来获取集合中的下个元素。 但为了使用方便, 你还可以添加一些其他方法, 例如获取前一个元素、 记录当前位置和判断迭代是否已结束。
-
声明集合接口并描述一个获取迭代器的方法。 其返回值必须是迭代器接口。 如果你计划拥有多组不同的迭代器, 则可以声明多个类似的方法。
-
为希望使用迭代器进行遍历的集合实现具体迭代器类。 迭代器对象必须与单个集合实体链接。 链接关系通常通过迭代器的构造函数建立。
-
在你的集合类中实现集合接口。 其主要思想是针对特定集合为客户端代码提供创建迭代器的快捷方式。 集合对象必须将自身传递给迭代器的构造函数来创建两者之间的链接。
-
检查客户端代码, 使用迭代器替代所有集合遍历代码。 每当客户端需要遍历集合元素时都会获取一个新的迭代器。
迭代器模式优缺点
-
单一职责原则 。 通过将体积庞大的遍历算法代码抽取为独立的类, 你可对客户端代码和集合进行整理。
-
开闭原则 。 你可实现新型的集合和迭代器并将其传递给现有代码, 无需修改现有代码。
-
你可以并行遍历同一集合 , 因为每个迭代器对象都包含其自身的遍历状态。
-
相似的 , 你可以暂停遍历并在需要时继续。
-
如果你的程序只与简单的集合进行交互 , 应用该模式可能会矫枉过正。
-
对于某些特殊集合 , 使用迭代器可能比直接遍历的效率低。
与其他模式的关系
7️⃣ 观察者模式
观察者是一种行为设计模式,允许一个对象将其状态的改变通知其他对象
观察者模式提供了一种作用于任何实现了订阅者接口的对象的机制,可对其事件进行订阅和取消订阅。
备忘录模式亦称:事件订阅者、监听者、Event-Subscriber、Listener、Observer。
问题
假如你有两种类型的对象: 顾客和 商店 。 顾客对某个特定品牌的产品非常感兴趣 (例如最新型号的 iPhone 手机), 而该产品很快将会在商店里出售。
顾客可以每天来商店看看产品是否到货。 但如果商品尚未到货时, 绝大多数来到商店的顾客都会空手而归。
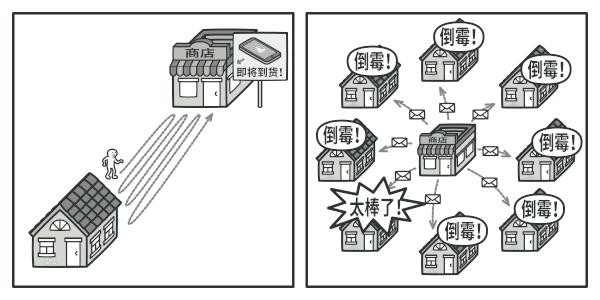
前往商店和发送垃圾邮件
另一方面, 每次新产品到货时, 商店可以向所有顾客发送邮件 (可能会被视为垃圾邮件)。 这样, 部分顾客就无需反复前往商店了, 但也可能会惹恼对新产品没有兴趣的其他顾客。
我们似乎遇到了一个矛盾: 要么让顾客浪费时间检查产品是否到货, 要么让商店浪费资源去通知没有需求的顾客。
解决方案
拥有一些值得关注的状态的对象通常被称为 目标 , 由于它要将自身的状态改变通知给其他对象, 我们也将其称为 发布者 (publisher)。 所有希望关注发布者状态变化的其他对象被称为 订阅者 (subscribers)。
观察者模式建议你为发布者类添加订阅机制, 让每个对象都能订阅或取消订阅发布者事件流。 不要害怕! 这并不像听上去那么复杂。 实际上, 该机制包括 1) 一个用于存储订阅者对象引用的列表成员变量; 2) 几个用于添加或删除该列表中订阅者的公有方法。
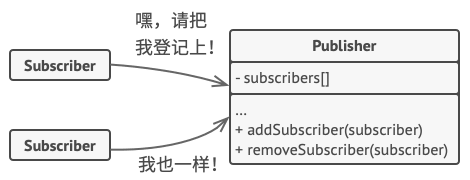
订阅机制允许对象订阅事件通知。
现在, 无论何时发生了重要的发布者事件, 它都要遍历订阅者并调用其对象的特定通知方法。
实际应用中可能会有十几个不同的订阅者类跟踪着同一个发布者类的事件, 你不会希望发布者与所有这些类相耦合的。 此外如果他人会使用发布者类, 那么你甚至可能会对其中的一些类一无所知。
因此, 所有订阅者都必须实现同样的接口, 发布者仅通过该接口与订阅者交互。 接口中必须声明通知方法及其参数, 这样发布者在发出通知时还能传递一些上下文数据。
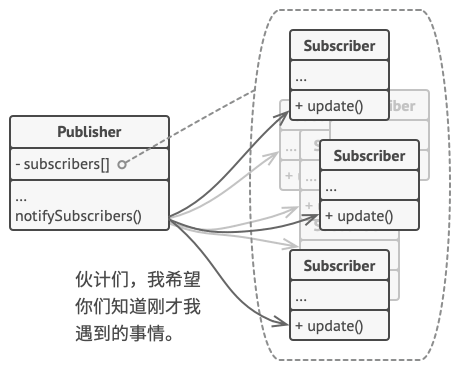
发布者调用订阅者对象中的特定通知方法来通知订阅者。
如果你的应用中有多个不同类型的发布者, 且希望订阅者可兼容所有发布者, 那么你甚至可以进一步让所有订阅者遵循同样的接口。 该接口仅需描述几个订阅方法即可。 这样订阅者就能在不与具体发布者类耦合的情况下通过接口观察发布者的状态。
真实世界类比
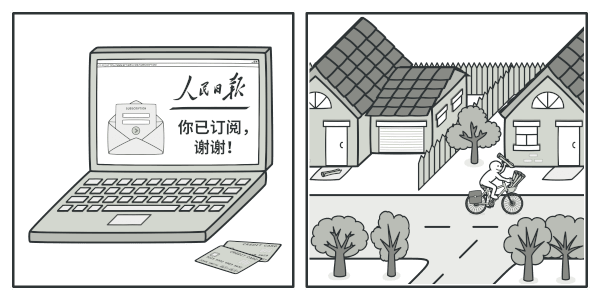
杂志和报纸订阅。
如果你订阅了一份杂志或报纸, 那就不需要再去报摊查询新出版的刊物了。 出版社 (即应用中的 "发布者") 会在刊物出版后 (甚至提前) 直接将最新一期寄送至你的邮箱中。
出版社负责维护订阅者列表, 了解订阅者对哪些刊物感兴趣。 当订阅者希望出版社停止寄送新一期的杂志时, 他们可随时从该列表中退出。
观察者模式结构
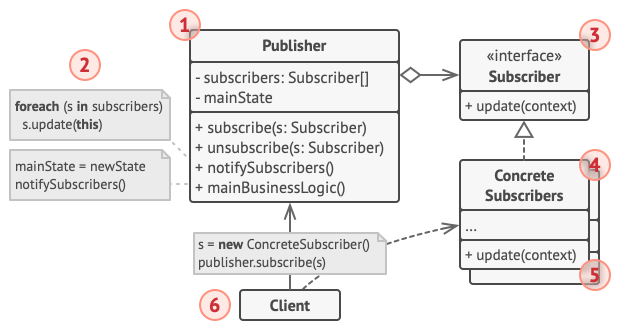
-
发布者 (Publisher) 会向其他对象发送值得关注的事件。 事件会在发布者自身状态改变或执行特定行为后发生。 发布者中包含一个允许新订阅者加入和当前订阅者离开列表的订阅构架。
-
当新事件发生时, 发送者会遍历订阅列表并调用每个订阅者对象的通知方法。 该方法是在订阅者接口中声明的。
-
订阅者 (Subscriber) 接口声明了通知接口。 在绝大多数情况下, 该接口仅包含一个
update更新方法。 该方法可以拥有多个参数, 使发布者能在更新时传递事件的详细信息。 -
具体订阅者 (Concrete Subscribers) 可以执行一些操作来回应发布者的通知。 所有具体订阅者类都实现了同样的接口, 因此发布者不需要与具体类相耦合。
-
订阅者通常需要一些上下文信息来正确地处理更新。 因此, 发布者通常会将一些上下文数据作为通知方法的参数进行传递。 发布者也可将自身作为参数进行传递, 使订阅者直接获取所需的数据。
-
客户端 (Client) 会分别创建发布者和订阅者对象, 然后为订阅者注册发布者更新。
观察者模式代码实现
观察者模式在 Python 代码中很常见,特别是在 GUI 组件中。它提供了在不与其他对象所属类耦合的情况下对其事件做出反应的方式。
该模式可以通过将对象存储在列表中的订阅方法, 和对于面向该列表中对象的更新方法的调用来识别。
本例说明了观察者设计模式的结构并重点回答了下面的问题:它由哪些类组成?这些类扮演了哪些角色?模式中的各个元素会以何种方式相互关联?
python
from __future__ import annotations
from abc import ABC, abstractmethod
from random import randrange
from typing import List

class Subject(ABC):
    """
    The Subject interface declares a set of methods for managing subscribers.
    """

    @abstractmethod
    def attach(self, observer: Observer) -> None:
        """
        Attach an observer to the subject.
        """
        pass

    @abstractmethod
    def detach(self, observer: Observer) -> None:
        """
        Detach an observer from the subject.
        """
        pass

    @abstractmethod
    def notify(self) -> None:
        """
        Notify all observers about an event.
        """
        pass

class ConcreteSubject(Subject):
    """
    The Subject owns some important state and notifies observers when the state
    changes.
    """

    _state: int = None
    """
    For the sake of simplicity, the Subject's state, essential to all
    subscribers, is stored in this variable.
    """

    _observers: List[Observer] = []
    """
    List of subscribers. In real life, the list of subscribers can be stored
    more comprehensively (categorized by event type, etc.).
    """

    def attach(self, observer: Observer) -> None:
        print("Subject: Attached an observer.")
        self._observers.append(observer)

    def detach(self, observer: Observer) -> None:
        self._observers.remove(observer)

    """
    The subscription management methods.
    """

    def notify(self) -> None:
        """
        Trigger an update in each subscriber.
        """

        print("Subject: Notifying observers...")
        for observer in self._observers:
            observer.update(self)

    def some_business_logic(self) -> None:
        """
        Usually, the subscription logic is only a fraction of what a Subject can
        really do. Subjects commonly hold some important business logic, that
        triggers a notification method whenever something important is about to
        happen (or after it).
        """

        print("\nSubject: I'm doing something important.")
        self._state = randrange(0, 10)

        print(f"Subject: My state has just changed to: {self._state}")
        self.notify()

class Observer(ABC):
    """
    The Observer interface declares the update method, used by subjects.
    """

    @abstractmethod
    def update(self, subject: Subject) -> None:
        """
        Receive update from subject.
        """
        pass

"""
Concrete Observers react to the updates issued by the Subject they had been
attached to.
"""

class ConcreteObserverA(Observer):
    def update(self, subject: Subject) -> None:
        if subject._state < 3:
            print("ConcreteObserverA: Reacted to the event")

class ConcreteObserverB(Observer):
    def update(self, subject: Subject) -> None:
        if subject._state == 0 or subject._state >= 2:
            print("ConcreteObserverB: Reacted to the event")

if __name__ == "__main__":
    # The client code.

    subject = ConcreteSubject()

    observer_a = ConcreteObserverA()
    subject.attach(observer_a)

    observer_b = ConcreteObserverB()
    subject.attach(observer_b)

    subject.some_business_logic()
    subject.some_business_logic()

    subject.detach(observer_a)

    subject.some_business_logic()
执行结果
text
Subject: Attached an observer.
Subject: Attached an observer.

Subject: I'm doing something important.
Subject: My state has just changed to: 0
Subject: Notifying observers...
ConcreteObserverA: Reacted to the event
ConcreteObserverB: Reacted to the event

Subject: I'm doing something important.
Subject: My state has just changed to: 5
Subject: Notifying observers...
ConcreteObserverB: Reacted to the event

Subject: I'm doing something important.
Subject: My state has just changed to: 0
Subject: Notifying observers...
ConcreteObserverB: Reacted to the event
项目案例和伪代码
在本例中, 观察者 模式允许文本编辑器对象将自身的状态改变通知给其他服务对象。
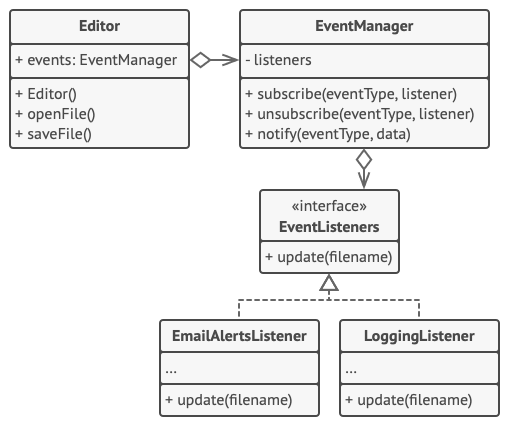
将对象中发生的事件通知给其他对象。
订阅者列表是动态生成的: 对象可在运行时根据程序需要开始或停止监听通知。
在本实现中, 编辑器类自身并不维护订阅列表。 它将工作委派给专门从事此工作的一个特殊帮手对象。 你还可将该对象升级为中心化的事件分发器, 允许任何对象成为发布者。
只要发布者通过同样的接口与所有订阅者进行交互, 那么在程序中新增订阅者时就无需修改已有发布者类的代码。
python
// 发布者基类包含订阅管理代码和通知方法。
class EventManager is
    private field listeners: hash map of event types and listeners

    method subscribe(eventType, listener) is
        listeners.add(eventType, listener)

    method unsubscribe(eventType, listener) is
        listeners.remove(eventType, listener)

    method notify(eventType, data) is
        foreach (listener in listeners.of(eventType)) do
            listener.update(data)

// 具体发布者包含一些订阅者感兴趣的实际业务逻辑。我们可以从发布者基类中扩
// 展出该类,但在实际情况下并不总能做到,因为具体发布者可能已经是子类了。
// 在这种情况下,你可用组合来修补订阅逻辑,就像我们在这里做的一样。
class Editor is
    public field events: EventManager
    private field file: File

    constructor Editor() is
        events = new EventManager()

    // 业务逻辑的方法可将变化通知给订阅者。
    method openFile(path) is
        this.file = new File(path)
        events.notify("open", file.name)

    method saveFile() is
        file.write()
        events.notify("save", file.name)

    // ...

// 这里是订阅者接口。如果你的编程语言支持函数类型,则可用一组函数来代替整
// 个订阅者的层次结构。
interface EventListener is
    method update(filename)

// 具体订阅者会对其注册的发布者所发出的更新消息做出响应。
class LoggingListener implements EventListener is
    private field log: File
    private field message

    constructor LoggingListener(log_filename, message) is
        this.log = new File(log_filename)
        this.message = message

    method update(filename) is
        log.write(replace('%s',filename,message))

class EmailAlertsListener implements EventListener is
    private field email: string

    constructor EmailAlertsListener(email, message) is
        this.email = email
        this.message = message

    method update(filename) is
        system.email(email, replace('%s',filename,message))

// 应用程序可在运行时配置发布者和订阅者。
class Application is
    method config() is
        editor = new TextEditor()

        logger = new LoggingListener(
            "/path/to/log.txt",
            "有人打开了文件:%s");
        editor.events.subscribe("open", logger)

        emailAlerts = new EmailAlertsListener(
            "admin@example.com",
            "有人更改了文件:%s")
        editor.events.subscribe("save", emailAlerts)
观察者模式适合应用场景
当一个对象状态的改变需要改变其他对象 , 或实际对象是事先未知的或动态变化的时, 可使用观察者模式。
当你使用图形用户界面类时通常会遇到一个问题 。 比如, 你创建了自定义按钮类并允许客户端在按钮中注入自定义代码, 这样当用户按下按钮时就会触发这些代码。
观察者模式允许任何实现了订阅者接口的对象订阅发布者对象的事件通知。 你可在按钮中添加订阅机制, 允许客户端通过自定义订阅类注入自定义代码。
当应用中的一些对象必须观察其他对象时 , 可使用该模式。 但仅能在有限时间内或特定情况下使用。
订阅列表是动态的 , 因此订阅者可随时加入或离开该列表。
实现方式
-
仔细检查你的业务逻辑, 试着将其拆分为两个部分: 独立于其他代码的核心功能将作为发布者; 其他代码则将转化为一组订阅类。
-
声明订阅者接口。 该接口至少应声明一个
update方法。 -
声明发布者接口并定义一些接口来在列表中添加和删除订阅对象。 记住发布者必须仅通过订阅者接口与它们进行交互。
-
确定存放实际订阅列表的位置并实现订阅方法。 通常所有类型的发布者代码看上去都一样, 因此将列表放置在直接扩展自发布者接口的抽象类中是显而易见的。 具体发布者会扩展该类从而继承所有的订阅行为。
但是, 如果你需要在现有的类层次结构中应用该模式, 则可以考虑使用组合的方式: 将订阅逻辑放入一个独立的对象, 然后让所有实际订阅者使用该对象。
-
创建具体发布者类。 每次发布者发生了重要事件时都必须通知所有的订阅者。
-
在具体订阅者类中实现通知更新的方法。 绝大部分订阅者需要一些与事件相关的上下文数据。 这些数据可作为通知方法的参数来传递。
但还有另一种选择。 订阅者接收到通知后直接从通知中获取所有数据。 在这种情况下, 发布者必须通过更新方法将自身传递出去。 另一种不太灵活的方式是通过构造函数将发布者与订阅者永久性地连接起来。
- 客户端必须生成所需的全部订阅者, 并在相应的发布者处完成注册工作。
观察者模式优缺点
-
开闭原则 。 你无需修改发布者代码就能引入新的订阅者类 (如果是发布者接口则可轻松引入发布者类)。
-
你可以在运行时建立对象之间的联系 。
-
订阅者的通知顺序是随机的 。
与其他模式的关系
-
责任链模式、 命令模式、 中介者模式和观察者模式用于处理请求发送者和接收者之间的不同连接方式:
- 责任链 按照顺序将请求动态传递给一系列的潜在接收者, 直至其中一名接收者对请求进行处理。
- 命令 在发送者和请求者之间建立单向连接。
- 中介者 清除了发送者和请求者之间的直接连接, 强制它们通过一个中介对象进行间接沟通。
- 观察者 允许接收者动态地订阅或取消接收请求。
-
中介者和观察者之间的区别往往很难记住。 在大部分情况下, 你可以使用其中一种模式, 而有时可以同时使用。 让我们来看看如何做到这一点。
中介者 的主要目标是消除一系列系统组件之间的相互依赖。 这些组件将依赖于同一个中介者对象。 观察者 的目标是在对象之间建立动态的单向连接, 使得部分对象可作为其他对象的附属发挥作用。
有一种流行的中介者模式实现方式依赖于 观察者 。 中介者对象担当发布者的角色, 其他组件则作为订阅者, 可以订阅中介者的事件或取消订阅。 当 中介者 以这种方式实现时, 它可能看上去与 观察者 非常相似。
当你感到疑惑时, 记住可以采用其他方式来实现中介者。 例如, 你可永久性地将所有组件链接到同一个中介者对象。 这种实现方式和 观察者 并不相同, 但这仍是一种中介者模式。
假设有一个程序, 其所有的组件都变成了发布者, 它们之间可以相互建立动态连接。 这样程序中就没有中心化的中介者对象, 而只有一些分布式的观察者。
8️⃣ 学习模式的正确顺序
每种模式都可以按同一顺序学习:先明确它解决的变化点,再找参与对象及其关系,然后阅读代码实现,最后判断引入模式后的成本。Python 自身已经通过函数、迭代协议和模块机制简化了不少模式,实现时可以写得更符合 Python 习惯,不必机械复制其他语言的类结构。
🛬 文章小结
- 设计模式归纳常见问题的解法,可按创建、结构和行为三类理解。
- 比较各模式的意图、适用场景和维护成本,先明确实际问题,再决定是否需要引入模式。
- 读完示例后,可尝试用简单实现解决同一问题,并说明引入模式后哪些变化更容易处理。