文章目录
- Ceph分布式存储集群配置与池管理:从配置优先级到PG、复本池与纠删码池
-
- 前言
- 一、集群配置:来源、优先级与配置文件
-
- [1.1 配置选项的命名规则](#1.1 配置选项的命名规则)
- [1.2 六个配置来源与覆盖原则](#1.2 六个配置来源与覆盖原则)
- [1.3 集群配置文件 ceph.conf 的查找顺序](#1.3 集群配置文件 ceph.conf 的查找顺序)
- [1.4 配置部分与实例设置](#1.4 配置部分与实例设置)
- [1.5 元变量:让配置文件少写一堆硬编码](#1.5 元变量:让配置文件少写一堆硬编码)
- [二、集中配置数据库:ceph config 命令族](#二、集中配置数据库:ceph config 命令族)
-
- [2.1 数据库在哪、能干什么](#2.1 数据库在哪、能干什么)
- [2.2 六个查询命令,各查什么](#2.2 六个查询命令,各查什么)
- [2.3 改配置:set / rm / log / reset](#2.3 改配置:set / rm / log / reset)
- [三、运行时覆盖:ceph tell、ceph daemon 与 Dashboard](#三、运行时覆盖:ceph tell、ceph daemon 与 Dashboard)
-
- [3.1 为什么需要"临时改配置"](#3.1 为什么需要"临时改配置")
- [3.2 ceph tell:向守护进程"发消息"](#3.2 ceph tell:向守护进程"发消息")
- [3.3 ceph config set 与 ceph tell 怎么选](#3.3 ceph config set 与 ceph tell 怎么选)
- [3.4 ceph daemon:不需要 MON 的本地覆盖](#3.4 ceph daemon:不需要 MON 的本地覆盖)
- [3.5 顺手用 Dashboard 改](#3.5 顺手用 Dashboard 改)
- 四、监控器(MON)配置与仲裁
-
- [4.1 MON 为什么这么关键](#4.1 MON 为什么这么关键)
- [4.2 mon_host 与"别改 MON 的 IP"](#4.2 mon_host 与"别改 MON 的 IP")
- [4.3 查看仲裁状态与 MON 映射](#4.3 查看仲裁状态与 MON 映射)
- [4.4 集中配置数据库的容量治理](#4.4 集中配置数据库的容量治理)
- [4.5 顺带看一眼集群认证开关](#4.5 顺带看一眼集群认证开关)
- 五、公共网络、集群网络与端口安全
-
- [5.1 public 网络与 cluster 网络的职责划分](#5.1 public 网络与 cluster 网络的职责划分)
- [5.2 把守护进程约束到特定子网](#5.2 把守护进程约束到特定子网)
- [5.3 IPv6 与巨型帧](#5.3 IPv6 与巨型帧)
- [5.4 为什么值得单独划一张 cluster 网络](#5.4 为什么值得单独划一张 cluster 网络)
- [5.5 端口清单与防火墙规则](#5.5 端口清单与防火墙规则)
- [六、池与放置组(PG):对象怎么落到 OSD](#六、池与放置组(PG):对象怎么落到 OSD)
-
- [6.1 池与 PG 的关系](#6.1 池与 PG 的关系)
- [6.2 PG 数量为什么不能拍脑袋](#6.2 PG 数量为什么不能拍脑袋)
- [6.3 对象 → PG → OSD:四步定位](#6.3 对象 → PG → OSD:四步定位)
- [6.4 读流程与写流程](#6.4 读流程与写流程)
- 七、复本池与纠删码池:用多少空间换多少可靠
-
- [7.1 两种数据保护方式](#7.1 两种数据保护方式)
- [7.2 复本池:主 OSD 负责找齐"副本队友"](#7.2 复本池:主 OSD 负责找齐"副本队友")
- [7.3 纠删码池:k+m 块与"用 1.5 倍空间换 3 副本的可靠"](#7.3 纠删码池:k+m 块与"用 1.5 倍空间换 3 副本的可靠")
- [7.4 纠删代码配置文件:参数与不可修改的铁律](#7.4 纠删代码配置文件:参数与不可修改的铁律)
- [八、池的日常管理:查看、配额、复本数与 PG 数](#八、池的日常管理:查看、配额、复本数与 PG 数)
-
- [8.1 查看池状态与容量](#8.1 查看池状态与容量)
- [8.2 池的应用类型(application)](#8.2 池的应用类型(application))
- [8.3 池配额:按对象数或字节数封顶](#8.3 池配额:按对象数或字节数封顶)
- [8.4 池配置与 nodelete 保护](#8.4 池配置与 nodelete 保护)
- [8.5 复本数与 min_size](#8.5 复本数与 min_size)
- [8.6 PG 数与自动扩展](#8.6 PG 数与自动扩展)
- [8.7 为新池预置默认标志](#8.7 为新池预置默认标志)
- [九、池中对象操作:rados 命令与池快照](#九、池中对象操作:rados 命令与池快照)
-
- [9.1 rados:直接操作池中对象](#9.1 rados:直接操作池中对象)
- [9.2 上传、查看与定位一个对象](#9.2 上传、查看与定位一个对象)
- [9.3 检索、追加与删除对象](#9.3 检索、追加与删除对象)
- [9.4 池快照:给整个池按一次"快门"](#9.4 池快照:给整个池按一次"快门")
- 十、命名空间、重命名与删除池
-
- [10.1 为什么需要命名空间](#10.1 为什么需要命名空间)
- [10.2 命名空间实操](#10.2 命名空间实操)
- [10.3 重命名池](#10.3 重命名池)
- [10.4 删除池:动手前先做两件事](#10.4 删除池:动手前先做两件事)
- 十一、验证测试、排障指南与最佳实践
-
- [11.1 实验环境与前置条件](#11.1 实验环境与前置条件)
- [11.2 验证测试](#11.2 验证测试)
- [11.3 排障指南](#11.3 排障指南)
- [11.4 最佳实践](#11.4 最佳实践)
- 写在最后
Ceph分布式存储集群配置与池管理:从配置优先级到PG、复本池与纠删码池
集群搭好只是开始------把配置管明白、把池和 PG 算对,才是 Ceph 能不能长期稳定跑下去的分水岭。
前言
Ceph 集群部署完成的那一刻,很多人的第一反应是"终于搞定了"。但真正在生产里待过一段时间就会明白:部署只是一次性动作,配置与池管理才是每天都要面对的事 。一个 mon_allow_pool_delete 没开,你可能连一个测试池都删不掉;一次 pg_num 拍脑袋设错,集群可能在半夜自己掀起一轮全量数据重平衡,把本该给业务的 IOPS 全吃掉;而如果你用复本池去存冷数据、用纠删码池去跑数据库,那就是在容量和性能两头都做了错误的选择。
现实中的痛点基本集中在四件事上:配置散落在多处 ------命令行参数、环境变量、本地 ceph.conf、MON 上的集中配置数据库,谁覆盖谁常常说不清;改了不生效、重启就丢 ------用 ceph tell 改完看着生效了,守护进程一重启又回到旧值;池参数靠猜 ------复本数、放置组(Placement Group,PG)数量、纠删码的 k+m 到底怎么定;池操作高风险------删除池会连同池里所有数据一起消失,不可逆转。
本文接续前两篇(第 1、2 章讲清了 RADOS 架构与 cephadm 部署),正式进入第 3、4 章:先讲透 集群配置的来源与生效优先级 、ceph config 命令族、运行时覆盖与 Dashboard 改配置、监控器(Monitor,MON)仲裁与网络端口,再深入 池与放置组原理 、复本池与纠删码池的取舍,最后落到池的日常管理、实验环境规划、验证测试与排障指南。读完你应该能回答一个很实在的问题:这条配置到底该写在哪、怎么让它既生效又持久。
一、集群配置:来源、优先级与配置文件
1.1 配置选项的命名规则
Ceph 的每一个配置选项都有一个唯一名称 ,名称由小写字符加下划线组成。少数历史选项里还带着短划线(中横杠)或空格,但推荐做法是统一使用下划线------因为在命令行里传递带短划线或空格的选项,最容易在不同 shell 和不同工具间出现转义问题。
1.2 六个配置来源与覆盖原则
Ceph 守护进程会从以下来源获取配置,从"最早"到"最新"依次是:
| 配置来源 | 说明 | 是否持久 |
|---|---|---|
| 编译中的默认值 | 代码里写死的默认值,是所有配置的兜底 | --- |
| 集中配置数据库 | MON 节点集中管理,ceph config set 写入的位置 |
✅ 持久 |
| 本地主机上的配置文件 | 每个节点上的 /etc/ceph/ceph.conf |
✅ 持久(但只在本机) |
| 环境变量 | 进程启动时从环境读取 | ❌ 随进程 |
| 命令行参数 | 启动命令里显式传入的选项 | ❌ 单次启动 |
| 运行时覆盖 | 守护进程运行期间临时注入 | ❌ 重启即失效 |
当存在多个设置源时,配置生效原则:
- 较新的设置会覆盖较早设置源中的设置------命令行参数比配置文件"新",配置文件比编译默认值"新";
- 配置文件会在启动时配置守护进程;
- 配置文件设置会覆盖存储在集中数据库中的设置;
- MON 节点管理集中配置数据库。
实际的生效过程分两步:
- 启动时,Ceph 守护进程解析命令行选项、环境变量和本地集群配置文件提供的配置选项;
- 然后,守护进程联系 MON 集群,检索存储在集中配置数据库中的配置选项。
⚠️ 重要 :讲义里同时强调了"Ceph 存储优先使用集中配置数据库中配置,弃用 ceph.conf 集群配置文件"。这两句话看似矛盾,其实对应的是 Ceph 配置体系的演进方向:
ceph.conf属于传统方式,新版本推荐把集群级配置集中写进 MON 的配置数据库 。实践中的稳妥结论是------集群级、需要所有匹配守护进程统一生效的配置,用ceph config set写进数据库;只跟本机环境强相关的(比如守护进程数据目录)才留在ceph.conf。
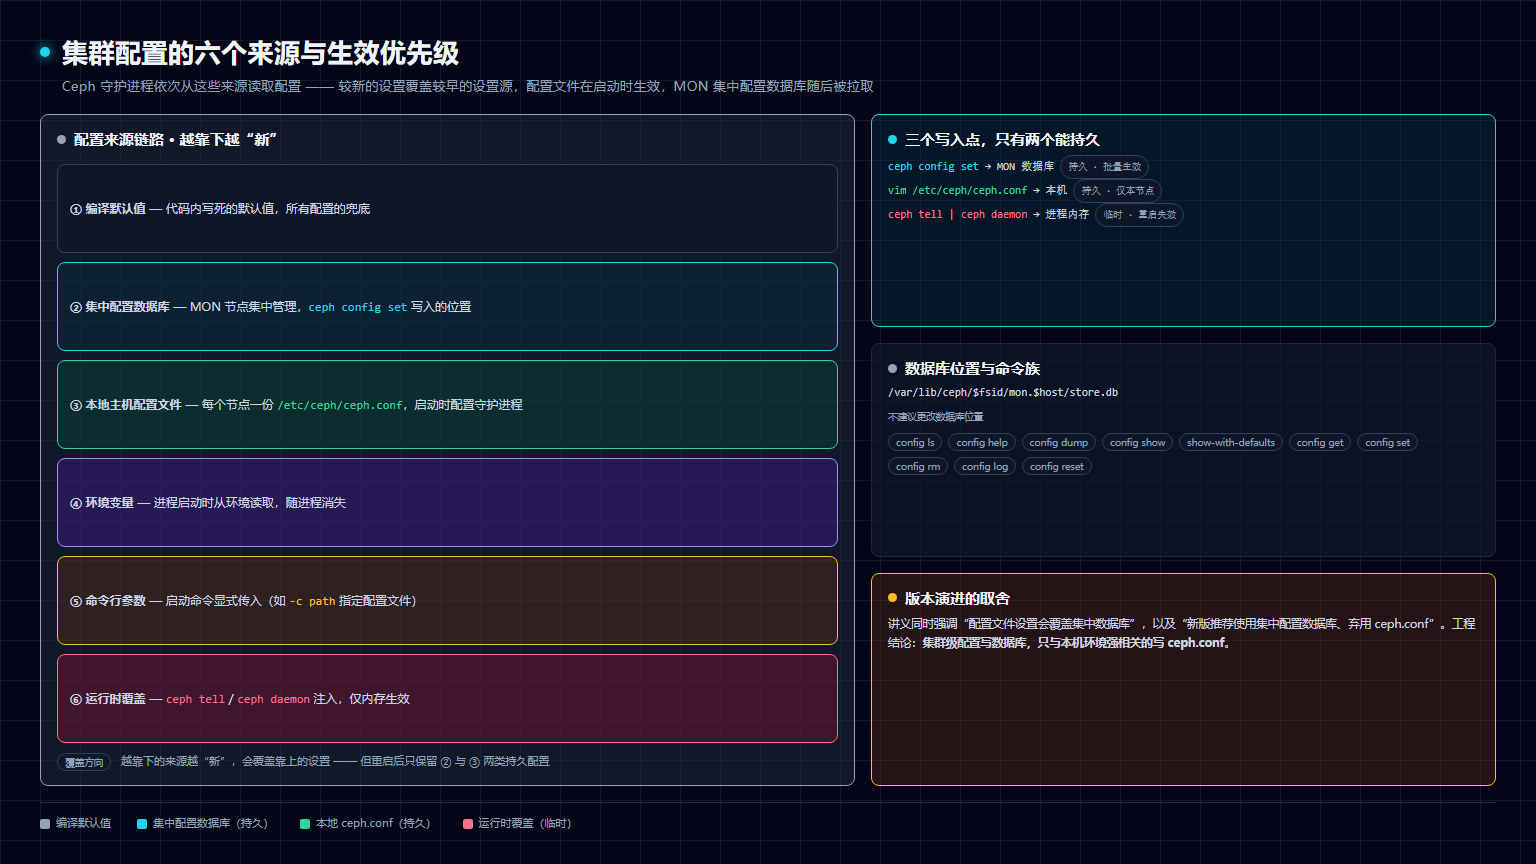
图 1 | 集群配置的六个来源与生效优先级 ------ 越靠下的来源越"新",会覆盖靠上的设置;但重启后只保留集中配置数据库与本地 ceph.conf 两类持久配置
1.3 集群配置文件 ceph.conf 的查找顺序
Ceph 会按下面的顺序查找集群相关配置文件,先找到先用:
| 顺序 | 位置 | 说明 |
|---|---|---|
| 1 | CEPH_CONF 环境变量中包含的路径 |
显式指定,优先级最高 |
| 2 | -c path/path |
由命令行参数 -c 指定的路径 |
| 3 | ./$cluster.conf |
当前目录下的集群同名文件 |
| 4 | ~/.ceph/$cluster.conf |
当前用户家目录 |
| 5 | /etc/ceph/$cluster.conf |
默认位置 |
每个 Ceph 节点都会存一份本地 配置文件,默认就是 /etc/ceph/ceph.conf。cephadm 在部署时用最小选项集创建初始配置文件,不会把一堆参数都塞进去。
配置文件采用 INI 文件格式 ,同时承载守护进程和客户端的配置。每个部分用 [name] 标头定义名称,下面是若干键值对;用井号 # 或分号 ; 可以禁用某个设置或写注释。
text
[global]
parameter1 = value1
parameter2 = value2
引导集群时也可以借助集群配置文件来自定义引导过程:
bash
# cephadm bootstrap --config ceph-config.yaml💡 提示 :找现成的配置范例,直接看
/usr/share/doc/ceph/sample.ceph.conf,它由ceph-common软件包提供,注释极其详尽。
1.4 配置部分与实例设置
Ceph 用"所应用的守护进程或客户端"来分组配置选项,并据此决定它是存在配置文件里还是写进配置数据库:
| 配置部分 | 存储内容 |
|---|---|
[global] |
所有守护进程(包括客户端)共有的一般配置 |
[mon] |
监控器(MON)的配置 |
[osd] |
OSD 守护进程的配置 |
[mgr] |
管理器(MGR)的配置 |
[mds] |
元数据服务器(MDS)的配置 |
[client] |
应用到所有 Ceph 客户端的配置 |
[global] 是兜底:可以为单个守护进程或客户端 创建调用部分来覆盖 [global] 里的参数。
实例设置 适用于特定守护进程,名称格式是 [daemon-type.instance-ID],同样的写法对 [osd]、[mgr]、[mds] 和 [client] 都适用:
- OSD 守护进程的实例 ID 始终为数字 ,例如
[osd.0]; - 客户端的实例 ID 是有效的用户名 ,例如
[client.operator3]。
1.5 元变量:让配置文件少写一堆硬编码
元变量(metavariable)由 Ceph 定义,用户可以用它们简化配置,避免把集群名、主机名写死:
| 元变量 | 展开为 | 说明 |
|---|---|---|
$cluster |
集群名称 | Ceph 存储集群的名字,默认 ceph |
$type |
守护进程类型 | mon、osd、mds、mgr、client |
$id |
守护进程实例 ID | ceph1 上监控器为 ceph1;osd.1 为 1;客户端为用户名 |
$name |
守护进程名称 | $type.$id 的简写 |
$host |
运行守护进程的主机名 | 如 ceph1 |
bash
[mon]
# Settings for all mon daemons
[mon.ceph1]
# Settings that apply to the specific MON daemon running on ceph1
## Metavariables
# $cluster    ; Expands to the Ceph Storage Cluster name. Useful
#             ; when running multiple Ceph Storage Clusters
#             ; on the same hardware.
#             ; Example: /etc/ceph/$cluster.keyring
#             ; (Default: ceph)
# $name       ; Expands to $type.$id.
#             ; Example: /var/run/ceph/$cluster-$name.asok
二、集中配置数据库:ceph config 命令族
2.1 数据库在哪、能干什么
集群配置数据库由 MON 节点集中管理,它能做到三件本地配置文件做不到的事:
- 在守护进程启动之前,暂时更改设置;
- 在守护进程运行时,更改大部分设置;
- 将永久设置存储在数据库中------重启也不会丢。
数据库默认落在 MON 节点上:
text
/var/lib/ceph/$fsid/mon.$host/store.db⚠️ 注意:不建议更改数据库的位置。它会不断增大,后续的压缩与告警阈值设定都依赖默认路径的可用空间判断。
查询和修改集中配置数据库统一用 ceph config 命令。
2.2 六个查询命令,各查什么
这一组命令最容易混,关键在于**"是否包含默认值"和"是看配置还是看历史"**:
| 命令 | 作用 | 看的是 |
|---|---|---|
ceph config ls |
列出集群数据库中所有配置条目名 | 有哪些可配置项 |
ceph config help <key> |
查看某个配置项的帮助信息 | 类型、默认值、能否运行时改、适用服务 |
ceph config dump |
显示被显式设置过 的配置项(含旧版 ceph.conf 加载的项) |
当前生效的"非默认"配置 |
ceph config show $type.$id [<key>] |
查看该守护进程被显式设置过的配置项 | "我到底自定义了哪些" |
ceph config show-with-defaults $type.$id |
显示所有配置项及当前值(含默认值) | 完整运行时配置,排错/审计 |
ceph config get $type.$id [<key>] |
从数据库精准点查某项配置 | 单点取值 |
bash
[root@ceph1 ~] ceph config ls
host
fsid
public_addr
public_addrv
public_bind_addr
cluster_addr
public_network
public_network_interface
cluster_network
cluster_network_interface
......

[root@ceph1 ~] ceph config help host
host - local hostname
  (str, basic)
  Default:
  Can update at runtime: false
  Services: [common]
  Tags: [network]
if blank, ceph assumes the short hostname (hostname -s)

[root@ceph1 ~] ceph config help fsid
fsid - cluster fsid (uuid)
  (uuid, basic)
  Default: 00000000-0000-0000-0000-000000000000
  Can update at runtime: false
  Services: [common]
ceph config help 里那两个字段特别有用:Can update at runtime 告诉你这个参数能不能在线改(false 就必须重启对应守护进程),Services 告诉你会影响哪些守护进程。
bash
# 只看"被显式设置过"的项
[root@ceph1 ~] ceph config show mon.ceph1.laogao.cloud
[root@ceph1 ~] ceph config show mon.ceph1.laogao.cloud public_network
192.168.108.0/24

# 看完整运行时配置(含默认值),排错时用
[root@ceph1 ~] ceph config show-with-defaults mon.ceph1.laogao.cloud
NAME                                                        VALUE
admin_socket
 $run_dir/$cluster-$name.asok
💡 提示 :
ceph config dump与ceph config show $type.$id都不显示纯默认值 ------从没被设置过的项不会出现。想审计"这个集群到底被改过什么",用这两条;想知道"某个参数此刻到底是什么值",用show-with-defaults。
2.3 改配置:set / rm / log / reset
bash
# 精准点查
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud
WHO     MASK  LEVEL     OPTION                                  VALUE
                                                        RO
mon           advanced  auth_allow_insecure_global_id_reclaim  false
global        basic     container_image                         quay.io/ceph/ceph@sha256:6ba107eb55617994a9e6ed49fb938828c2ed3121aa19ceeffbf8e28608535d94  *
mon           advanced  public_network                          192.168.108.0/24

[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud public_network
192.168.108.0/24
ceph config set 的作用范围是它的精髓------同一组参数,写到什么粒度就影响什么粒度:
bash
# 设置"特定类型的所有实例":影响所有 mon
[root@ceph1 ~] ceph config set mon mon_allow_pool_delete false

# 设置"特定类型的特定实例":只影响 ceph1 上这个 mon
[root@ceph1 ~] ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true
ceph config set 的工作原理值得记住:
- 修改的是 Monitor 维护的集中式配置数据库;
- 所有符合条件的 daemon(如所有 OSD)会自动拉取新配置并应用------不需要你挨个节点改文件;
- 配置持久存储在 Monitor 的 KV store 中。
删除与回滚:
bash
# 删除该参数 = 还原默认配置
[root@ceph1 ~] ceph config rm mon.ceph1.laogao.cloud mon_allow_pool_delete
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false

# 查看配置历史(类似 Linux 的 history),默认显示 10 条
[root@ceph1 ~] ceph config log
--- 16 --- 2025-08-19T08:08:00.450868+0000 ---
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
--- 15 --- 2025-08-19T08:07:01.547157+0000 ---
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
--- 14 --- 2025-08-19T08:05:20.097053+0000 ---
+ mon/mon_allow_pool_delete = false
......

# 只看最近两条
[root@ceph1 ~] ceph config log 2
ceph config log 的每一行都带 + / - 前缀,表示这次操作新增 还是移除了 该设置;前面的序号就是版本号,ceph config reset <num> 可以回滚到指定历史版本:
bash
# 制造两条新的历史记录
[root@ceph1 ~] ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true
   #产生log 20记录
[root@ceph1 ~] ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete false
   #产生log 21记录
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false               #此刻为false

# 回滚到 log 20 的版本
[root@ceph1 ~] ceph config reset 20
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true                #验证回到 log 20 的 true
[root@ceph1 ~] ceph config log 1
--- 22 --- 2025-08-19T08:25:27.045753+0000 --- reset to 20 ---      #从22回滚到20
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
三、运行时覆盖:ceph tell、ceph daemon 与 Dashboard
3.1 为什么需要"临时改配置"
生产上最常见的场景是紧急排错:某个 OSD 行为异常,你想临时把它的日志级别拉到 debug 级别,看几十秒输出,然后恢复。这时候往配置数据库里写一条永久配置是错的------改完忘了删,就是个埋在系统里的雷。
Ceph 提供了两条临时覆盖的路子:ceph tell 和 ceph daemon。
3.2 ceph tell:向守护进程"发消息"
ceph tell 的本质是直接与指定的运行中 daemon 通信 (通过 admin socket 或网络),常用于执行管理命令(如 compact leveldb、flush cache)。要用它改配置,底层是通过 injectargs 模拟"启动参数"。
bash
# 获取守护进程的所有运行时设置
ceph tell $type.$id config show

# 获取/设置守护进程的特定运行时设置
ceph tell $type.$id config get <key>
ceph tell $type.$id config set <key> <value>
它要求所配置的 MON 和守护进程都在运行。完整实验走一遍:
bash
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "true"
}

# 临时改掉
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{
    "success": "mon_allow_pool_delete = 'false' "
}

# 临时值已生效
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "false"
}

# 但集群数据库中的值仍然是 true!
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true

# 重启守护进程后,生效值恢复为数据库中设置的值
[root@ceph1 ~] ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "true"
}
ceph tell $type.$id config 还接受通配符,可以一次拿到同一类型所有守护进程的值:
bash
[root@ceph1 ~] ceph tell mon.* config get mon_allow_pool_delete
mon.ceph1.laogao.cloud: {
    "mon_allow_pool_delete": "true"
}
mon.ceph2: {
    "mon_allow_pool_delete": "false"
}
mon.ceph3: {
    "mon_allow_pool_delete": "false"
}
3.3 ceph config set 与 ceph tell 怎么选
这是本章最该背下来的一张表:
| 特性 | ceph config set |
ceph tell ... injectargs |
|---|---|---|
| 配置存储位置 | Monitor 配置数据库 | 仅内存(daemon 进程内) |
| 是否持久 | ✅ 是 | ❌ 否,重启恢复原始设置 |
| 是否批量生效 | ✅(如 osd 影响所有 osd) |
❌(必须指定具体实例,如 osd.0) |
| 能否用于非配置操作 | ❌ 仅配置 | ✅(如 compact、flush) |
是否被 ceph config get 识别 |
✅ 是 | ❌ 否 |
| 适用场景 | 长期配置、运维策略 | 紧急排错、临时调试 |
使用建议:
- 日常调优、生产配置 → 用
ceph config set; - 紧急排查、临时抓日志 → 用
ceph tell osd.0 injectargs --debug_xxx=20; - 执行管理动作(不是配置) → 必须用
ceph tell,例如ceph tell mon.ceph1.laogao.cloud compact。
3.4 ceph daemon:不需要 MON 的本地覆盖
Ceph 还支持在集群特定节点上 用 ceph daemon $type.$id config 临时覆盖配置。它和 ceph tell 最大的区别是:不需要连接 MON ------只要对应的守护进程在运行即可。所以即使 MON 未运行,这条命令依然能发挥作用,对故障排除价值极大。
bash
# 在 ceph1 上只能查看和设置 ceph1 上运行的相关进程设置
[root@ceph1 ~] cephadm shell
[ceph: root@ceph1 /] ceph daemon mon.ceph1.laogao.cloud config show
{
    "name": "mon.ceph1.laogao.cloud",
    "cluster": "ceph",
    "admin_socket": "/var/run/ceph/ceph-mon.ceph1.laogao.cloud.asok",
    "admin_socket_mode": "",
    "auth_client_required": "cephx, none",
    "auth_cluster_required": "cephx",
    "auth_mon_ticket_ttl": "259200.000000",
......

[ceph: root@ceph1 /] ceph daemon mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{
    "success": "mon_allow_pool_delete = 'false' "
}
[ceph: root@ceph1 /] ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "false"
}
⚠️ 注意 :同样地,用
ceph daemon更改的设置在守护进程重启后会恢复为原始设置。这三条命令的"持久性"记住一句话就够了------只有ceph config set是持久的,ceph tell和ceph daemon都是临时的。
3.5 顺手用 Dashboard 改
不想记命令的时候,Web 控制台也能改:
- 打开浏览器访问
https://ceph1.laogao.cloud:8443,必要时接受证书警告,用admin/laogao@123登录; - 单击 Cluster > Configuration 进入 Configuration Settings 页面;
- 从 advanced 菜单中选择 advanced 选项查看高级配置项,在搜索框输入
mon_allow_pool_delete定位; - 单击
mon_allow_pool_delete,然后单击 Edit; - 将 global 值设为
true,单击 Update; - 控制面板会显示一条消息确认新设置已生效。
💡 提示 :Dashboard 改的其实是同一个集中配置数据库,效果和
ceph config set等价(持久)。区别只在于它不给你"改错回滚"的后悔药------真要精细操作,还是命令行配合ceph config log/ceph config reset更稳。
四、监控器(MON)配置与仲裁
4.1 MON 为什么这么关键
Ceph 监控器(MON)存储和维护着客户端用于查找 MON 和 OSD 节点的集群映射。客户端必须先连上 MON 拿到集群映射,之后才能读写任何数据。所以"正确配置集群 MON"不是可选项,而是前提。
MON 采用一种 Paxos 变体算法来选举领导者,在分布式计算机集之间达成一致。每个 MON 分别处于以下角色之一:
| 角色 | 含义 |
|---|---|
| Leader | 第一个获得集群映射最新版本的 MON |
| Provider | 拥有最新版本的集群映射、但不是 Leader 的 MON |
| Requester | 没有最新版本的集群映射,必须先与 Provider 同步,才能重新加入仲裁 |
一旦有新的 MON 加入集群,便会进行同步。每个 MON 都会定期检查相邻监控器是否已有更新版本的集群映射,如果相邻 MON 的映射更新,就必须同步并获取。
仲裁(quorum)的硬规则 :集群中大多数 MON 必须处于运行状态 才能建立仲裁。例如部署了五个 MON,必须运行三个才能建立仲裁;在生产的 Ceph 集群中至少部署三个 MON 节点以确保高可用。Ceph 支持在运行中的集群里添加或删除 MON。
4.2 mon_host 与"别改 MON 的 IP"
集群配置文件的 [mon] 块里,mon_host 定义 MON 主机的 IP 地址(或 DNS 名称)和端口。这里有个容易踩的坑:cephadm 工具不会自动更新集群配置文件 ,所以多节点之间的 ceph.conf 需要你自己想办法保持一致(例如用 rsync 之类的第三方工具同步)。
text
[global]
        fsid = 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
        mon_host = [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0]
[v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0]
[v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]
注意上面每个 MON 都同时有 **v2(3300 端口)和 v1(6789 端口)**两条地址------这是 Ceph 新老协议并存的表现。
⚠️ 重要 :在集群部署和运行期间,建议不要更改 MON 节点的 IP 地址。集群映射里记的就是这些地址,改了 IP 等于把地图和工作中的道路对不上。
4.3 查看仲裁状态与 MON 映射
bash
# 三种查看方式
[root@ceph1 ~] ceph status | grep mon
    mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 11m)

[root@ceph1 ceph] ceph mon stat
e3: 3 mons at {ceph1.laogao.cloud=
[v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0],
ceph2=[v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0],
ceph3=[v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]} removed_ranks: {},
election epoch 16,
leader 0 ceph1.laogao.cloud, quorum 0,1,2 ceph1.laogao.cloud,ceph2,ceph3

# 友好的 json 输出,脚本里最好用
[root@ceph1 ~] ceph quorum_status -f json-pretty
{
    "election_epoch": 16,
    "quorum": [0, 1, 2],
    "quorum_names": ["ceph1.laogao.cloud", "ceph2", "ceph3"],
    "quorum_leader_name": "ceph1.laogao.cloud",
    "quorum_age": 869,
    "monmap": {
        "epoch": 3,
        "fsid": "2faf683a-7cbf-11f0-b5ba-000c29e0ad0e",
        "modified": "2025-08-19T05:51:46.573105Z",
        "created": "2025-08-19T05:41:50.650957Z",
        "min_mon_release": 16,
        ...
    }
}
**MON 映射(monitor map)**里装的是三样东西:
- 集群 fsid(文件系统 ID)------一种自动生成的唯一标识符(UUID),用于标识 Ceph 集群;
- 各个 MON 节点通信的名称、IP 地址和网络端口;
- 映射版本信息,如 epoch 和最近一次更改时间------MON 节点通过同步更改并就当前版本达成一致来维护映射。
bash
[root@ceph1 ~] ceph mon dump
epoch 3
fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e            #集群fsid
last_changed 2025-08-19T05:51:46.573105+0000
created 2025-08-19T05:41:50.650957+0000
min_mon_release 16 (pacific)
election_strategy: 1
0: [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0] mon.ceph1.laogao.cloud
1: [v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0] mon.ceph2
2: [v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0] mon.ceph3
dumped monmap epoch 3
💡 提示 :Ceph 的集群映射是五张映射的统称------MON 映射、OSD 映射、PG 映射、MDS 映射、CRUSH 映射 ,分别用
ceph mon dump、ceph osd dump、ceph pg dump、ceph fs dump、ceph osd crush dump查看。Dashboard 里也可以单击 Cluster > Monitor 看 MON 状态。
4.4 集中配置数据库的容量治理
数据库文件会不断增大,讲义给了几条改进措施:
bash
# 整合数据库以提高性能
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud compact

# 每次守护进程启动时自动压缩
[root@ceph1 ~] ceph config set mon mon_compact_on_start true| 配置项 | 触发条件 | 默认值 | 后果 |
|---|---|---|---|
mon_data_size_warn |
数据库文件超过该值 | 15 (GB) | 集群健康变为 HEALTH_WARN |
mon_data_avail_warn |
数据库所在文件系统剩余容量 ≤ 该百分比 | 30 (%) | 集群健康变为 HEALTH_WARN |
mon_data_avail_crit |
数据库所在文件系统剩余容量 ≤ 该百分比 | 5 (%) | 集群健康变为 HEALTH_ERR |
这三个阈值是生产巡检的重点:MON 的 store.db 一涨到 15 GB 就会告警,而它所在分区剩余空间跌破 30% / 5% 会分别触发 WARN 和 ERR。
4.5 顺带看一眼集群认证开关
Ceph 默认使用 Cephx 协议 进行加密身份验证,同时使用共享密钥进行身份验证;默认情况下 Cephx 是开启的。如有必要可以禁用它,但不建议这样做,因为那会直接削弱集群安全性。
| 参数 | 作用 | 可用值 |
|---|---|---|
auth_service_required |
客户端与 Ceph services 之间通信认证 | cephx / none |
auth_cluster_required |
Ceph 集群守护进程之间通信认证(mon/osd/mds/mgr) | cephx / none |
auth_client_required |
客户端与 Ceph 集群之间通信认证 | cephx / none |
bash
[root@ceph1 ~] ceph config get mon auth_service_required
cephx
[root@ceph1 ~] ceph config get mon auth_cluster_required
cephx
[root@ceph1 ~] ceph config get mon auth_client_required
cephx, none
📌 官方原话:If this configuration setting is enabled, then Ceph clients can access Ceph services only if those clients authenticate with the Ceph Storage Cluster.
cephadm 工具会创建 client.admin 用户,让你能运行管理命令并创建其他 Ceph 客户端用户帐户,用户密钥环存储在 /etc/ceph 目录中:
bash
[root@ceph1 ~] ls /etc/ceph
ceph.client.admin.keyring  ceph.conf  ceph.pub  rbdmap

# MON 的密钥环文件位于守护进程数据目录
[root@ceph1 ~] ls /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring
/var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring

# 用 ceph-authtool 手工创建密钥环文件(MON 示例)
[root@ceph1 ~] ceph-authtool --create-keyring /tmp/ceph.mon.keyring --gen-key -n mon. --cap mon 'allow *'
creating /tmp/ceph.mon.keyring
拆开看这条命令:
--create-keyring /tmp/ceph.mon.keyring:创建一个新的密钥环文件;--gen-key -n mon.:生成新密钥,-n mon.指定密钥关联的实体名称 (实体名通常以守护进程类型开头,如mon.、osd.,后接节点标识符);--cap mon 'allow *':为该密钥分配权限(Capabilities) ,mon表示权限作用于 Monitor 服务,'allow *'授予所有 Monitor 操作的完全权限。
⚠️ 重要 :密钥环文件以纯文本形式存储机密密钥,务必用合适的 Linux 文件权限保护它们。用户账户与权限的完整内容会在下一篇(第 5 章)展开。
五、公共网络、集群网络与端口安全
5.1 public 网络与 cluster 网络的职责划分
public 网络是所有 Ceph 集群通信的默认网络 。cephadm 工具会假定第一个 MON 守护进程 IP 地址所在的网络就是 public 网络;新的 MON 守护进程也部署在 public 网络中,除非你明确指定了不同的网络。
数据流向上有三条规则:
- Ceph 客户端通过 public 网络直接向 OSD 发送请求;
- OSD 的复制和恢复流量默认也走 public 网络------除非你为此配置了单独的 cluster 网络;
- 配置独立的 cluster 网络可以减少 public 网络的流量负载,把后端 OSD 运维流量与客户端流量分流,从而提高集群性能。
| 网络 | 承载流量 | 默认行为 |
|---|---|---|
| public 网络 | 客户端 ↔ MON / OSD;MON 之间通信 | 必选,cephadm 按第一个 MON 推断 |
| cluster 网络 | OSD 之间的复制、恢复、心跳 | 可选,不配就走 public |
配置独立 cluster 网络的步骤:
- 在每个集群节点上配置一个额外的网络接口;
- 在每个节点的新接口上配置适当的 cluster 网络 IP 地址;
cephadm bootstrap命令使用--cluster-network选项,在集群引导时定义 cluster 网络。
Ceph 支持用集群配置文件设置 public 与 cluster 网络,也可以为每个网络配置多个子网 (逗号分隔),使用 CIDR 表示法 ,例如 172.25.250.0/24。
text
[global]
public_network = 192.168.108.0/24,192.168.109.0/24
cluster_network = 192.168.101.0/24
⚠️ 重要 :如果为一个网络配置多个子网,这些子网必须能够互相路由。
同样可以用 ceph config set 设置:
bash
# ceph config set mon public_network 192.168.108.0/24
text
[mon]
public_network = 192.168.108.0/24
5.2 把守护进程约束到特定子网
MON 守护进程必须绑定到特定的 IP 地址 ,而 MGR、OSD 和 MDS 守护进程可以绑定到任何可用的 IP 地址 。cephadm 使用 public 网络执行大部分服务,所以要控制新守护进程的落点,就得先定义服务要使用的特定子网------只有同一子网中有 IP 地址的主机,才可用于部署该服务。
bash
# 手动把 MON 部署到特定子网或 IP
# ceph orch daemon add mon cluster-host02:192.168.108.0/24
💡 提示 :讲义明确建议使用服务规范文件(service spec)来管理 Ceph 集群,不建议使用运行时的
ceph orch daemon命令更改配置。前者声明式、可复现;后者改完就散在集群里,难以审计。
5.3 IPv6 与巨型帧
默认情况下,ms_bind_ipv4 的值是 TRUE,ms_bind_ipv6 的值是 FALSE。要绑定 IPv6:
- 将
ms_bind_ipv6设置为TRUE; - 将
ms_bind_ipv4设置为FALSE; - 同时把
public_network和cluster_network都改为 IPv6 网络。
bash
# ceph config get mon.ceph1.laogao.cloud ms_bind_ipv4
true
# ceph config get mon.ceph1.laogao.cloud ms_bind_ipv6
false
text
[global]
public_network = <IPv6 public-network/netmask>
cluster_network = <IPv6 cluster-network/netmask>存储网络里另一个推荐做法是启用巨型帧 :在 cluster 网络接口上把 MTU 配成 9000,可以提升性能。
⚠️ 重要 :通信路径中的所有节点和网络设备必须具有相同的 MTU 值。如果是绑定(bond)网络接口,要在绑定接口上设置 MTU 值,基础接口会继承相同的 MTU。
5.4 为什么值得单独划一张 cluster 网络
配置独立的 cluster 网络不只是性能问题,它同时提高集群的安全性和可用性:
- 防止数据在 public 网络上泄露;
- 减少 public 网络上的攻击面;
- 防止针对集群某些类型的拒绝服务(DoS)攻击;
- 防止 OSD 之间的流量中断------一旦 OSD 之间的流量中断,客户端就无法读写数据;
- 确保流量不在 cluster 和 public 网络之间路由,从而保护后端 cluster 网络。
5.5 端口清单与防火墙规则
Ceph OSD 和 MDS 守护进程默认绑定 6800 到 7300 之间的 TCP 端口 ;若要改用其他范围,修改 ms_bind_port_min 和 ms_bind_port_max。
| 服务 | 端口 | 用途 |
|---|---|---|
| MON | 6789、3300 | 集群内部通信(v1 / v2) |
| OSD、MDS | 6800-7300 | 每个 OSD 占用四个端口:public 网络与客户端和 MON 通信、cluster/public 网络与其他 OSD 数据通信、心跳包交换(其中一个需两个端口) |
| MGR | 8443 | 以 SSL 方式登录 Ceph 图形化页面 |
| Prometheus | 9283 | Prometheus 插件通信 |
| Grafana | 3000 | Grafana 服务 |
| RGW | 80 | RADOSGW 通信(client.rgw 配置为空时 cephadm 用默认 80) |
💡 提示 :以上端口全部是 TCP 协议。
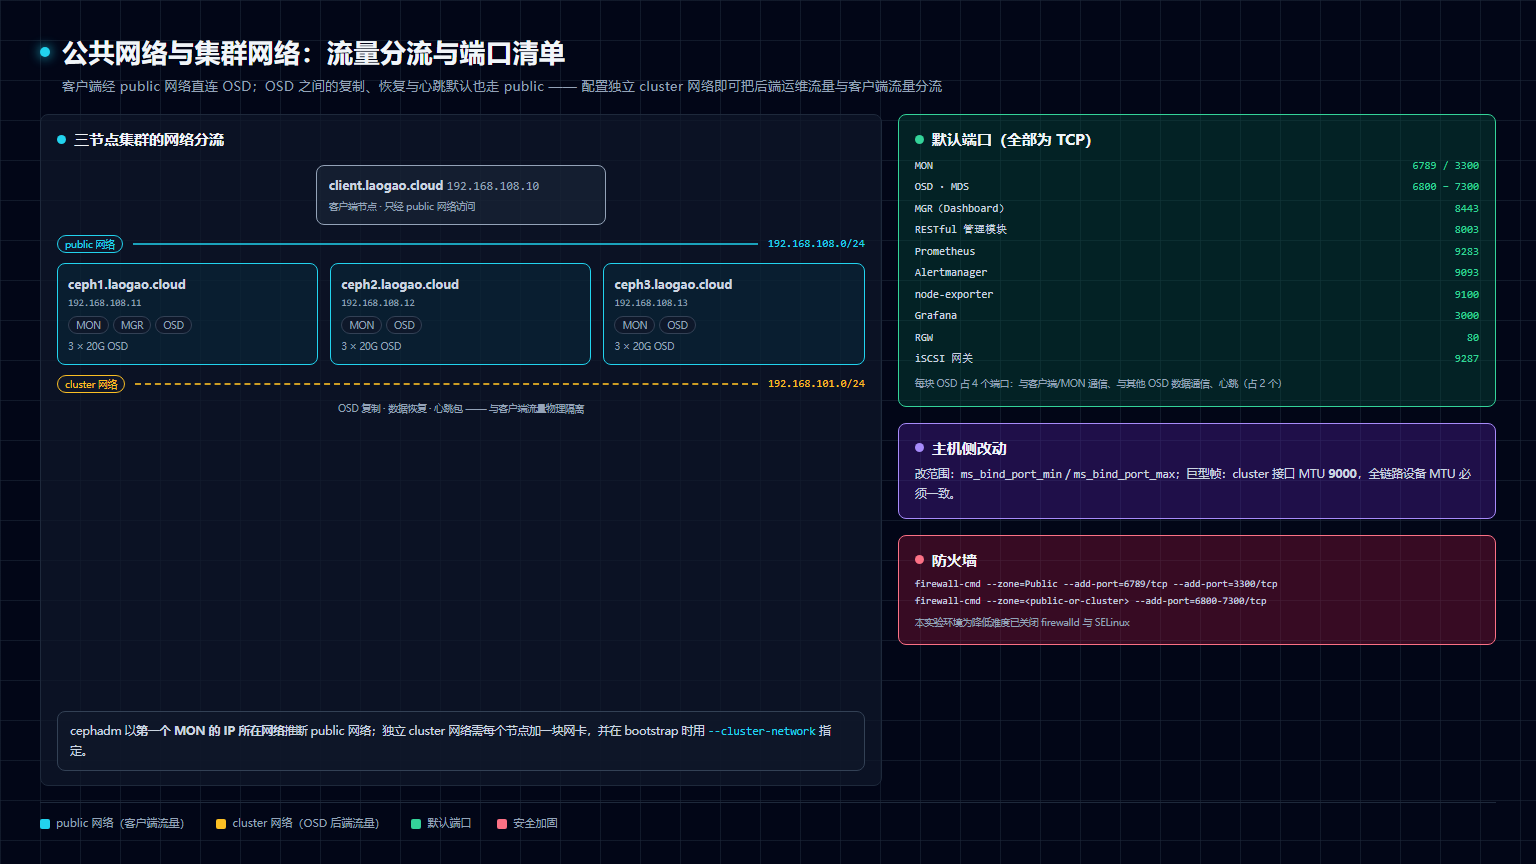
图 2 | 公共网络与集群网络的流量分流与端口清单 ------ 客户端只走 public 网络,OSD 之间的复制、恢复与心跳在独立 cluster 网络上完成
用防火墙保护 MON 节点(需用 Public 接口和 Public 网络 IP 地址来配置规则):
bash
firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp
firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp --permanent
# 也可直接放行服务
firewall-cmd --zone=Public --add-service=ceph-mon
firewall-cmd --zone=Public --add-service=ceph-mon --permanent
保护 OSD 节点(配置 cluster 网络时,防火墙需要同时放行 public 和 cluster 两个网络的规则;客户端通过 public 网络连接 OSD,OSD 之间通过 cluster 网络通信):
bash
firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp
firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp --permanent
firewall-cmd --zone=<public-or-cluster> --add-service=ceph
firewall-cmd --zone=<public-or-cluster> --add-service=ceph --permanent
⚠️ 注意 :本套实验环境为了降低安装难度直接关闭了 firewalld 及 SELinux。上面的规则是生产环境的做法,实验里不用执行------但面试和实际运维里必须知道怎么开。
六、池与放置组(PG):对象怎么落到 OSD
6.1 池与 PG 的关系
池(Pool)是 Ceph 存储集群的逻辑分区 ,用于在通用名称标签下存储对象。Ceph 为每个池分配特定数量的放置组(Placement Group,PG),用于对对象进行分组以便存储。
每个池都有以下可调整属性:
| 属性 | 说明 |
|---|---|
| 池 ID、池名称 | 唯一标识与人类可读的名字 |
| PG 数量 | 该池划分为多少个放置组 |
| CRUSH 规则 | 用于确定此池的 PG 到 OSD 的映射 |
| 保护类型 | 复本(replicated)或纠删码(erasure code) |
| 与保护类型相关的参数 | 如复本数、k+m 数值 |
| 各种标志 | 影响集群行为,如 nodelete、nopgchange |
PG(Placement Group)是构成 pool 的子集,也是一系列对象的集合 。一个 PG 仅能属于一个 Pool 。Ceph 将每个 PG 映射到一组 OSD ;属于同一个 PG 的所有对象都返回相同的哈希结果。
用一个类比理解:对象是散落的文件,池是"按用途分好的柜子区域",PG 是柜子里的格子------先按哈希把文件放进某个格子,再由 CRUSH 决定这个格子放在哪几个仓库(OSD)里。
6.2 PG 数量为什么不能拍脑袋
PG 数量直接影响集群性能,两头都会出事:
- PG 数量过多 :数据移动时每个 PG 维护的数据量过少,Ceph 要占用大量 CPU 和内存做计算,影响集群正常客户端使用;
- PG 数量过少 :单个 PG 存储的数据就越多,移动 PG 会占用大量带宽,同样影响客户端。
旧版本的 PG 计算公式:
text
Ceph集群PG 总数 = (OSD 数 * 100) / 最大副本数
单个资源池PG总数 = (OSD 数 * 100) / 最大副本数 / 池数
⚠️ 重要 :以上公式计算出的结果必须舍入到最接近 2 的 N 次幂的值(2^n),否则 CRUSH 分布会不均匀。
一般情况下 PG 数量的设置原则:
| OSD 数量 | PG 数量 |
|---|---|
| 少于 5 个 | 128 |
| 大于 5 小于 10 | 512 |
| 大于 10 小于 50 | 4096 |
| 大于 50 | 借助官方工具计算,参考 https://old.ceph.com/pgcalc/ |
💡 提示 :新版 Ceph 推荐用
pg_autoscaler自动调 PG 数(ceph osd pool set <pool> pg_autoscale_mode on),比手工套公式更省心。但在实验和考试环境里,上面的经验值仍然是最常被问到的答案。
6.3 对象 → PG → OSD:四步定位
客户端在读写数据时,只需要向 Ceph 提供资源池(pool)的名称和对象 ID 。一个完整的对象由三部分组成:对象 ID、二进制数据、对象元数据。
定位过程分四步:
- Ceph 客户端从 MON 获取最新的集群映射复本 。集群映射会告诉客户端所有 MON、OSD 和 MDS 的信息,但不提供对象的位置;
- 计算 PG ID,公式为:
text
PG ID = hash(Object ID) % (PG number)为了计算 PG ID,Ceph 需要知道对象所属池的名称 和对象 ID:根据池名取得池的 PG 数量,然后对对象 ID 做 hash 运算,最终得到 PG ID;
- Ceph 使用 CRUSH 算法确定这个 PG 由哪些 OSD 负责(Acting Set) 。Acting Set 中的 OSD 必须在 Up Set 中;Up Set 中的第一个 OSD 就是该 PG 的主 OSD(primary) ,其余是辅助/次要 OSD;
- 客户端直接与主 OSD 通信完成对象读写。
客户端访问 Ceph 的完整流程:
text
┌─────────────┐         ┌──────────────────┐
│  Ceph 客户端 │ ──────▶ │   MON 集群        │
└─────────────┘  ①连接    └──────────────────┘
      │                  ② 索引 cluster map
      │                     (拿到 MON/OSD/MDS 信息,但拿不到对象位置)
      ▼
 ③ 客户端自己用 CRUSH 算出 PG 和 OSD
      │
      ▼
┌─────────────────────┐
│  主 OSD(primary)   │ ◀── ④ 直接通信,完成对象读写
└─────────────────────┘
      │
      │ 复制
      ▼
┌──────────┐ ┌──────────┐
│ 次 OSD 1 │ │ 次 OSD 2 │
└──────────┘ └──────────┘
💡 提示 :在 Ceph 中,客户端自行计算对象存储位置的速度要比和 Ceph 组件交互查询快得多,所以读写数据时都是客户端根据 CRUSH 完成位置计算------这也是 Ceph 去中心化设计的核心收益。
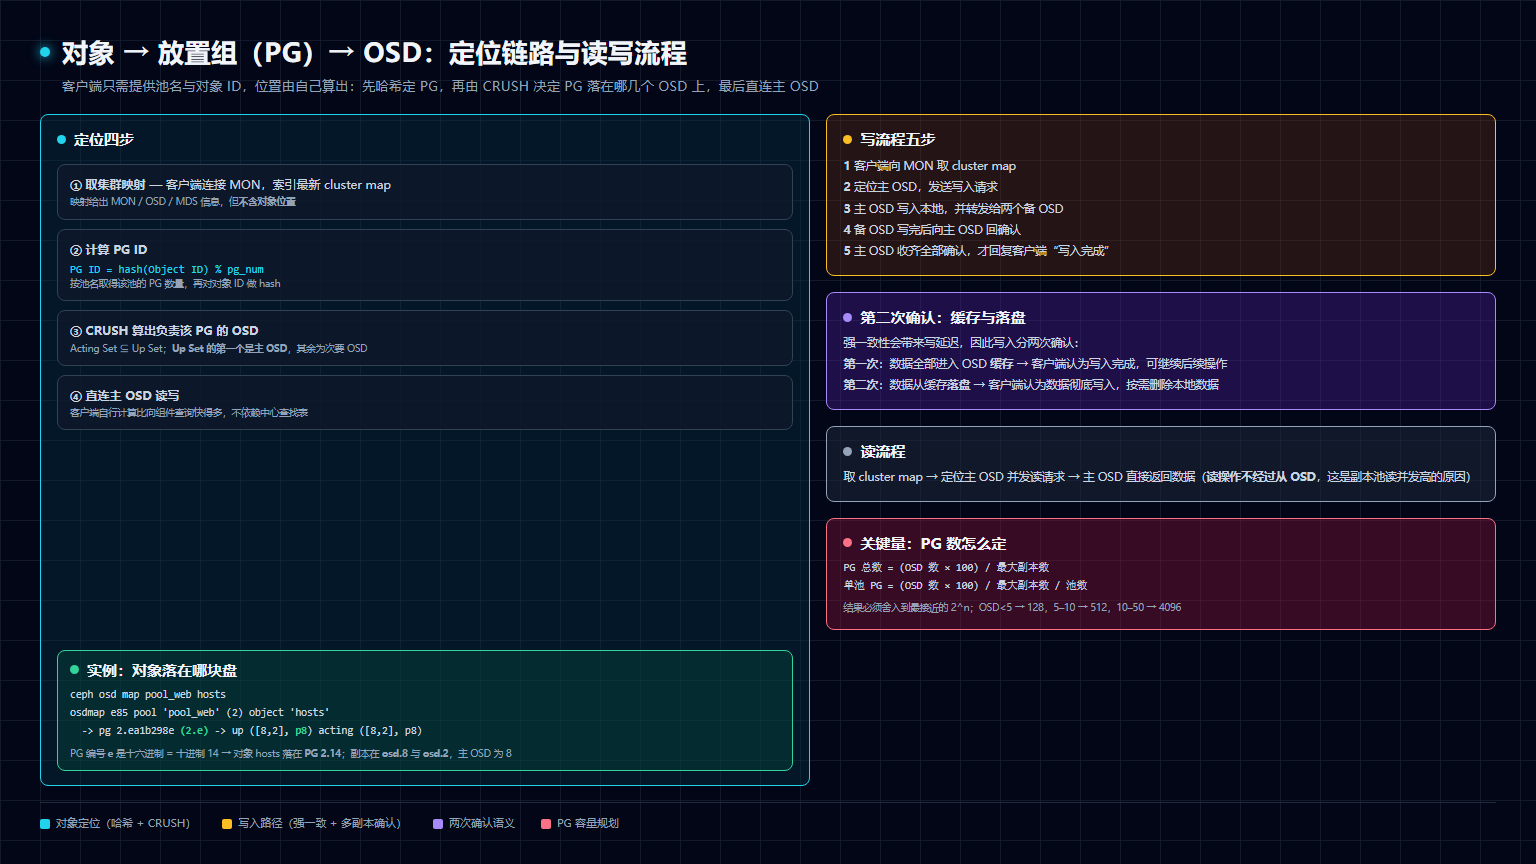
图 3 | 对象 → PG → OSD 的定位链路与读写流程 ------ PG ID = hash(对象 ID) % pg_num,再由 CRUSH 决定 PG 落在哪几个 OSD;写操作要等全部副本确认才回复客户端
6.4 读流程与写流程
读流程只需三步:
- 客户端通过 MON 获取 cluster map;
- 客户端通过 cluster map 获取主 OSD 节点信息,并向其发送读取请求;
- 主 OSD 将客户端请求的数据返回给客户端。
写流程是五步,且体现了 Ceph 的强一致设计:
- 客户端通过 MON 获取 cluster map;
- 客户端通过 cluster map 获取主 OSD 节点信息,并向其发送写入请求;
- 主 OSD 收到写入请求后先写入自己,并向两个备 OSD 发起数据写入指令;
- 两个备 OSD 写入完成后返回确认给主 OSD;
- 主 OSD 收到所有备 OSD 的写入确认后,才向客户端返回写入完成。
text
                 ① 取 cluster map
   客户端 ─────────────────────────▶ MON
      │
      │ ② 写请求
      ▼
 ┌──────────────┐  ③ 转发写指令   ┌────────────┐
 │  主 OSD       │ ──────────────▶ │  备 OSD 1  │
 │ (primary)     │ ──────────────▶ │  备 OSD 2  │
 └──────────────┘                 └────────────┘
      │  ④ 备 OSD 回确认
      │
      ▼  ⑤ 全部确认后,才回复"写入完成"
   客户端
Ceph 采用数据强一致性 来保证数据的同步。但强一致性会让写入有较大延迟,所以 Ceph 做了优化------把写入分成两次确认:
- 第一次 :当所有数据都写入 OSD 节点的缓存后,向 client 发送一次确认,client 认为数据写入完成,可以继续后面的操作;
- 第二次 :当所有数据都从缓存写入磁盘后,再向 client 发送一次确认,client 认为数据彻底写入,从而可以根据需要删除对应的本地数据。
⚠️ 注意 :这个"两次确认"的机制,正是 OSD 日志(journal)存在的意义。它让写入的响应延迟取决于"落缓存"而不是"落盘",但客户端必须知道第一次确认不等于数据已持久化------真正的持久化要等第二次确认。
七、复本池与纠删码池:用多少空间换多少可靠
7.1 两种数据保护方式
Ceph 存储支持两种池类型:
| 池类型 | 工作方式 | 优点 | 代价 |
|---|---|---|---|
| 复本池(replicated pool) | 把各个对象的完整复本复制到多个 OSD | 通过冗余提高读取可用性,读写延迟低 | 需要较多存储空间 |
| 纠删码池(erasure code pool) | 把对象切成数据块并计算编码块分散存放 | 需要较少的存储空间和网络带宽 | 要做奇偶校验计算,占用较多 CPU 处理时间 |
⚠️ 注意 :池一旦创建完成,池的类型便无法更改。 选错了只能新建池再迁数据------这是本章最"昂贵"的一条限制。
池类型怎么选:
- 数据不需要频繁访问、不需要低延迟 → 推荐纠删码池(归档、备份、冷数据);
- 数据需要频繁访问、要快速读取性能 → 推荐复本池(数据库、虚拟机磁盘、活跃业务数据)。
7.2 复本池:主 OSD 负责找齐"副本队友"
Ceph 为每个对象创建多个复本来保护复本池中的数据。具体流程是:Ceph 使用 CRUSH 故障域 确定存储数据的操作集的主要 OSD ,然后主要 OSD 会查找池的当前复本数量,并计算要写入对象的次要 OSD。在主要 OSD 收到写入确认并完成数据写入后,才向客户端确认写入成功。如果有一个或多个 OSD 出现故障,这一过程仍然能保护对象中的数据。
创建复本池语法:
bash
ceph osd pool create pool-name pg-num pgp-num replicated crush-rule-name| 参数 | 含义 |
|---|---|
pool_name |
指定新池的名称 |
pg_num |
指定池的放置组(PG)总数 |
pgp_num |
指定池的有效 放置组数量,应设置为与 pg_num 相等(可省略) |
replicated |
指定池的类型为复本池;命令中未包含此参数时这是默认值 |
crush-rule-name |
指定池使用的 CRUSH 规则集名称,默认值由 osd_pool_default_crush_replicated_ruleset 配置参数设置 |
bash
[root@ceph1 ~] ceph osd pool create pool_web 32 32 replicated
pool 'pool_web' created
[root@ceph1 ~] ceph osd pool ls
device_health_metrics
pool_web
7.3 纠删码池:k+m 块与"用 1.5 倍空间换 3 副本的可靠"
纠删码池在存储对象时,把对象分割为多个数据区块 ,这些数据区块存储在不同的 OSD 中;编码块的数量是根据数据块计算出来的 ,同样存储在不同的 OSD 中。当 OSD 出现故障时,可以利用编码块重构对象数据。
工作方式:
- 每个对象的数据分割为 k 个数据区块 ,计算出 m 个编码区块;
- 对象存储在总共 k + m 个 OSD 中;
- 编码区块大小与数据区块大小相同;
- 主 OSD 接收写入操作,然后把载荷编码为 K+M 块,发给纠删码池中的次要 OSD。
存储效率对比------这是纠删码最大的价值:
| 保护方式 | 存储开销 | 举例 |
|---|---|---|
| 复本池(3 复本) | 3 倍(300%) | 存 100 GB 数据占用 300 GB |
| 纠删码池 k=4, m=2 | 1.5 倍(150%) | 存 100 GB 数据占用 150 GB |
支持的 k+m 值及其对应的可用与原始比:
| k+m | 比率 |
|---|---|
| 4+2 | 1 : 1.5 |
| 8+3 | 1 : 1.375 |
| 8+4 | 1 : 1.5 |
纠删码池有效容量百分比 的计算公式是 k / (k+m)。讲义给的例子很值得自己算一遍:如果有 64 个 OSD(每个 4 TB,总计 256 TB),并且 k=8、m=4,那么
text
8 / (8+4) * 64 * 4 = 170.67 (TB)
256 TB / 170.67 TB = 1.5 #即开销比为 1.5创建纠删码池语法:
bash
ceph osd pool create pool-name pg-num pgp-num erasure erasure-code-profile crush-rule-name| 参数 | 含义 |
|---|---|
pool-name |
新池的名称 |
pg-num / pgp-num |
池的 PG 总数 / 有效 PG 数(通常两者相等) |
erasure |
指定池的类型是纠删代码池 |
erasure-code-profile |
池使用的纠删代码配置文件名称,默认用 default |
crush-rule-name |
该池使用的 CRUSH 规则集名称;不设置时 Ceph 会用纠删代码池配置文件中定义的规则集 |
⚠️ 注意 :纠删代码池无法使用对象映射(object-map)功能。对象映射是对象的一个索引,用于跟踪 rbd 对象的块被分配到哪,可提高大小调整、导出、扁平化等操作的性能------这是选择纠删码时要接受的代价之一。
bash
[root@ceph1 ~] ceph osd pool create pool_era 32 32 erasure
pool 'pool_era' created
[root@ceph1 ~] ceph osd pool ls
device_health_metrics
pool_web
pool_era

# 查看默认纠删代码配置
[root@ceph1 ~] ceph osd erasure-code-profile ls
default
[root@ceph1 ~] ceph osd erasure-code-profile get default
k=2
m=2
plugin=jerasure
technique=reed_sol_van
7.4 纠删代码配置文件:参数与不可修改的铁律
纠删代码配置文件决定池用多少个数据区块和编码区块,以及用哪个插件和算法:
bash
ceph osd erasure-code-profile set profile-name arguments| 参数 | 说明 | 默认值 |
|---|---|---|
k |
在不同 OSD 之间拆分的数据区块数量 | 2 |
m |
数据变得不可用之前可以出现故障的 OSD 数量 | 1 |
directory |
插件库的位置(可选) | /usr/lib64/ceph/erasure-code |
plugin |
使用的纠删代码算法(可选) | --- |
technique |
插件提供的具体技术/算法实现 | --- |
crush-failure-domain |
CRUSH 故障域,控制区块放置 | host |
crush-device-class |
只把该类设备(hdd/ssd/nvme)的 OSD 用于池 |
--- |
crush-root |
CRUSH 规则集的根节点 | --- |
key=value |
插件独有的键值参数 | --- |
crush-failure-domain 值得多说一句:默认设置为 host,确保对象的区块放置到不同主机的 OSD 上 ;如果设为 osd,区块就可能落在同一主机的多个 OSD 上------一旦主机故障,这台主机上所有 OSD 一起挂,数据就危险了。故障域同样可用于把区块放到不同机架甚至不同数据中心。
实操:创建、查看、删除配置文件
bash
# 创建一个 k=4 m=2 的配置文件
[root@ceph1 ~] ceph osd erasure-code-profile set ceph k=4 m=2
[root@ceph1 ~] ceph osd erasure-code-profile ls
ceph
default
[root@ceph1 ~] ceph osd erasure-code-profile get ceph
crush-device-class=
crush-failure-domain=host
crush-root=default
jerasure-per-chunk-alignment=false
k=4
m=2
plugin=jerasure
technique=reed_sol_van
w=8

# 删除
[root@ceph1 ~] ceph osd erasure-code-profile rm ceph
[root@ceph1 ~] ceph osd erasure-code-profile ls
default
⚠️ 重要 :现有纠删代码配置文件无法修改或更改,只能创建新的配置文件。 与"池类型不能改"一样,这属于创建前必须想清楚的事。默认的
default配置文件已配置为把对象分割为 2 个数据区块和 2 个编码区块。
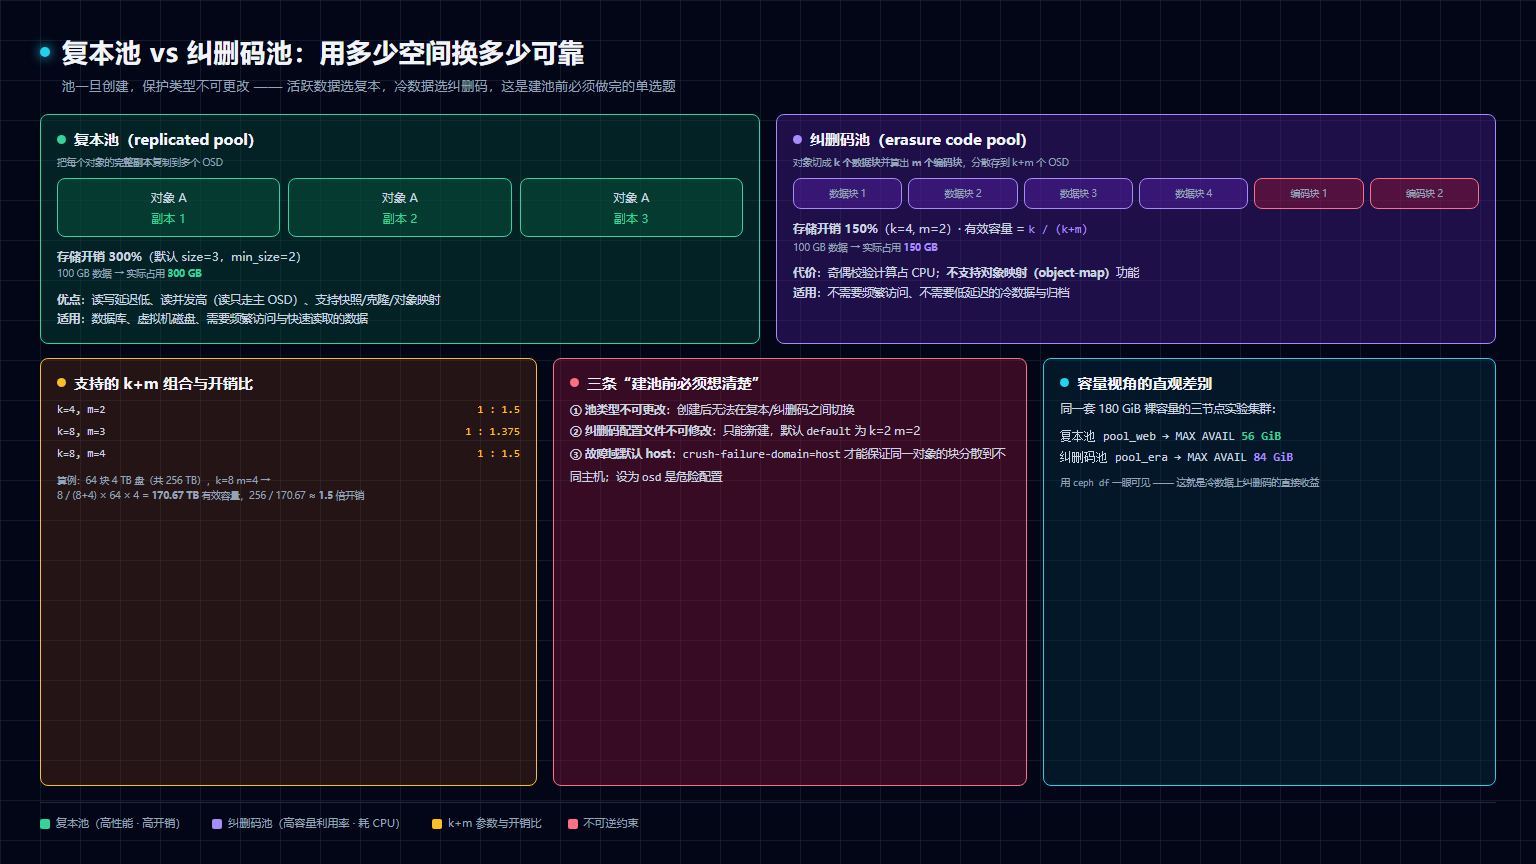
图 4 | 复本池与纠删码池的存储开销对比 ------ 3 副本占 300% 空间,k=4/m=2 的纠删码池只要 150%;池类型与纠删码配置文件一旦创建都无法更改
八、池的日常管理:查看、配额、复本数与 PG 数
8.1 查看池状态与容量
bash
# 列出池清单
[root@ceph1 ~] ceph osd pool ls
device_health_metrics
pool_web
pool_era

# 列出池清单 + 详细配置(最常用)
[root@ceph1 ~] ceph osd pool ls detail
pool 1 'device_health_metrics' replicated size 3 min_size 2 crush_rule 0
object_hash rjenkins pg_num 1 pgp_num 1 autoscale_mode on last_change 31 flags
hashpspool stripe_width 0 pg_num_max 32 pg_num_min 1 application mgr_devicehealth
pool 2 'pool_web' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins
pg_num 32 pgp_num 32 autoscale_mode on last_change 34 flags hashpspool
stripe_width 0
pool 3 'pool_era' erasure profile default size 4 min_size 3 crush_rule 1
object_hash rjenkins pg_num 32 pgp_num 32 autoscale_mode on last_change 41 flags
hashpspool stripe_width 8192

# 另一条列出池清单的命令
[root@ceph1 ~] ceph osd lspools
1 device_health_metrics
2 pool_web
3 pool_era

# 池状态信息、被哪些客户端使用
[root@ceph1 ~] ceph osd pool stats
pool device_health_metrics id 1
  nothing is going on
pool pool_web id 2
  nothing is going on
pool pool_era id 3
  nothing is going on

# 容量使用信息
[root@ceph1 ~] ceph df
--- RAW STORAGE ---
CLASS     SIZE    AVAIL     USED  RAW USED  %RAW USED
hdd    180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
TOTAL  180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
--- POOLS ---
POOL                   ID  PGS  STORED  OBJECTS  USED  %USED  MAX AVAIL
device_health_metrics   1    1     0 B        0   0 B      0     56 GiB
pool_web                2   32     0 B        0   0 B      0     56 GiB
pool_era                3   32     0 B        0   0 B      0     84 GiB
注意 pool_era(纠删码池)的 MAX AVAIL 是 84 GiB ,而复本池 pool_web 只有 56 GiB ------同样 180 GiB 裸容量,纠删码池的可用容量明显更大,这就是 1.5 倍开销和 3 倍开销的直观差别。
8.2 池的应用类型(application)
应用类型有 cephfs (Ceph 文件系统)、rbd (Ceph 块设备)和 rgw(RADOS 网关)。给池打上正确的应用类型,是让 Ceph 按预期管理它的前提。
bash
# 子命令
[root@ceph1 ~] ceph osd pool application <tab><tab>
disable  enable   get      rm       set

# 启用池的应用类型为 rbd
[root@ceph1 ~] ceph osd pool application enable pool_web rbd
enabled application 'rbd' on pool 'pool_web'
[root@ceph1 ~] ceph osd pool ls detail | grep pool_web
pool 2 'pool_web' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins
pg_num 32 pgp_num 32 autoscale_mode on last_change 44 flags hashpspool
stripe_width 0 `application rbd`  <------ #看这的变化

# set 子命令:设置应用类型的详细配置
[root@ceph1 ~] ceph osd pool application set pool_web rbd app1 apache
set application 'rbd' key 'app1' to 'apache' on pool 'pool_web'

# get 子命令:查看应用类型详细配置
[root@ceph1 ~] ceph osd pool application get pool_web
{
    "rbd": {
        "app1": "apache"
    }
}

# rm 子命令:删除应用类型详细配置
[root@ceph1 ~] ceph osd pool application rm pool_web rbd app1
removed application 'rbd' key 'app1' on pool 'pool_web'

# 禁用池的类型
[root@ceph1 ~] ceph osd pool application disable pool_web rbd --yes-i-really-mean-it
disable application 'rbd' on pool 'pool_web'
💡 提示 :
disable这类破坏性操作需要额外带上--yes-i-really-mean-it确认参数------Ceph 的这套"真的确定吗"机制在删除池、清空池等危险操作上普遍存在,看到它就该停一秒。
8.3 池配额:按对象数或字节数封顶
ceph osd pool get-quota 获取配额信息(池中能存储的最大字节数或最大对象数量),ceph osd pool set-quota 设置配额。
- 当存储对象达到限额时,整个池会无法使用;
- 当池使用量达到池配额时,操作将被阻止;
- 用户可通过将该值设置为 0 来删除配额。
bash
[root@ceph1 ~] ceph osd pool get-quota pool_web
quotas for pool 'pool_web':
  max objects: N/A
  max bytes  : N/A

[root@ceph1 ~] ceph osd pool set-quota pool_web max_objects 100000
set-quota max_objects = 100000 for pool pool_web
[root@ceph1 ~] ceph osd pool set-quota pool_web max_bytes 10G
set-quota max_bytes = 10737418240 for pool pool_web

[root@ceph1 ~] ceph osd pool get-quota pool_web
quotas for pool 'pool_web':
  max objects: 100k objects  (current num objects: 0 objects)
  max bytes  : 10 GiB  (current num bytes: 0 bytes)

# 设为 0 即取消配额
[root@ceph1 ~] ceph osd pool set-quota pool_web max_objects 0
[root@ceph1 ~] ceph osd pool set-quota pool_web max_bytes 0
[root@ceph1 ~] ceph osd pool get-quota pool_web
quotas for pool 'pool_web':
  max objects: N/A
  max bytes  : N/A
8.4 池配置与 nodelete 保护
bash
# 查看池所有配置
[root@ceph1 ~] ceph osd pool get pool_web all
size: 3                              #副本数3
min_size: 2
pg_num: 32
pgp_num: 32
crush_rule: replicated_rule
hashpspool: true
nodelete: false
nopgchange: false
nosizechange: false
write_fadvise_dontneed: false
noscrub: false
nodeep-scrub: false
use_gmt_hitset: 1
fast_read: 0
pg_autoscale_mode: on
bulk: false

# 查看特定配置
[root@ceph1 ~] ceph osd pool get pool_web nodelete
nodelete: false

# 备用命令(过滤出来看)
[root@ceph1 ~] ceph osd pool get pool_web all | grep nodelete
nodelete: false给池加上防误删保护------这一步在生产环境几乎必做:
bash
# 设置池不可删除
[root@ceph1 ~] ceph osd pool set pool_web nodelete true
set pool 2 nodelete to true
[root@ceph1 ~] ceph osd pool get pool_web nodelete
nodelete: true

# 将 nodelete 重新设置为 FALSE,即可允许删除池
[root@ceph1 ~] ceph osd pool set pool_web nodelete false
set pool 2 nodelete to false
💡 提示 :
nodelete、nopgchange、nosizechange这三个标志是池的"安全锁":分别禁止删除池、禁止改pg_num/pgp_num、禁止改池大小。生产环境建议至少打开nodelete。
8.5 复本数与 min_size
池的默认复本数量由 osd_pool_default_size 配置参数定义,默认值为 3。
bash
[root@ceph1 ~] ceph osd pool set pool_web size 2
set pool 2 size to 2
[root@ceph1 ~] ceph osd pool get pool_web all
size: 2                    #这里确实从之前的3变成了2
min_size: 1
pg_num: 32
...

# 查看/修改新建池的默认复本数
[root@ceph1 ~] ceph config get mon osd_pool_default_size
3
[root@ceph1 ~] ceph config set mon osd_pool_default_size 2
[root@ceph1 ~] ceph config get mon osd_pool_default_size
2
osd_pool_default_min_size 参数定义集群必须提供多少个对象复本才能接受 I/O 请求:复本数为 3 的池,该值为 2;复本数为 2 的池,该值为 1。
bash
[root@ceph1 ~] ceph config get mon osd_pool_default_min_size
0
💡 提示 :参数值为
0是特殊设置 ,意味着集群将自动使用存储池的 size 值计算最小副本数 。举例:如果某存储池size=3,那么min_size会自动设为 2(即size/2+1取整)。也就是说,3 副本池至少要有 2 个副本在线才接受写入------这解释了为什么"3 个 OSD 挂掉 2 个"时集群会停止服务而不是硬扛。
8.6 PG 数与自动扩展
bash
[root@ceph1 ~] ceph osd pool set pool_web pg_num 64         #思考PG设置多少合适???
set pool 2 pg_num to 64
[root@ceph1 ~] ceph osd pool get pool_web all
size: 2
min_size: 1
pg_num: 64                                            #确实PG变为了64
pgp_num: 64
...
Ceph 存储默认在池上配置放置组自动扩展 :集群会自行计算 PG 数量并自动选择合适的 pg_num 值。每个池都有一个 pg_autoscale_mode 选项,取值可以是 on、off 或 warn:
| 取值 | 含义 |
|---|---|
on |
启用自动调整池的 PG 数 |
off |
禁用池的 PG 自动扩展 |
warn |
PG 数需要调整时引发运行状况警报,把集群状态变为 HEALTH_WARN |
要让集群自动扩展 PG,需要在 Ceph MGR 节点上启用 pg_autoscaler 模块 ,并把池的自动扩展模式设为 on:
bash
[root@ceph1 ~] ceph mgr module enable pg_autoscaler
module 'pg_autoscaler' is already enabled (always-on)
[root@ceph1 ~] ceph osd pool set pool_web pg_autoscale_mode off
set pool 2 pg_autoscale_mode to off

[root@ceph1 ~] ceph osd pool autoscale-status
POOL                     SIZE  TARGET SIZE  RATE  RAW CAPACITY   RATIO
device_health_metrics      0                 3.0        179.9G  0.0000
pool_web                   0                 2.0        179.9G  0.0000
pool_era                   0                 2.0        179.9G  0.0000
ceph osd pool autoscale-status 的 AUTOSCALE 列会显示每个池当前是 on 还是 off,NEW PG_NUM 列则会给出建议的新 PG 数------调优时直接看这一列就行。
8.7 为新池预置默认标志
可以在集群级别为新创建的池设置默认值,避免每个池都手工加锁:
| 配置参数 | 作用 |
|---|---|
osd_pool_default_flag_nodelete |
池 nodelete 标志的默认值,设为 TRUE 防止删除池 |
osd_pool_default_flag_nopgchange |
池 nopgchange 标志的默认值,设为 TRUE 防止更改 pg_num 和 pgp_num |
osd_pool_default_flag_nosizechange |
池 nosizechange 标志的默认值,设为 TRUE 防止更改池大小 |
⚠️ 注意 :以上这些参数需要配置在集群配置文件
ceph.conf的[global]块中------这也回答了第 1 节留下的问题:"哪些配置该写文件、哪些该写数据库"。
九、池中对象操作:rados 命令与池快照
9.1 rados:直接操作池中对象
Ceph 使用 rados 命令管理池的对象。它的子命令按用途分成几大类:
| 命令组 | 常用子命令 | 作用 |
|---|---|---|
| POOL COMMANDS | lspools、cppool、purge、df、ls |
列池、复制池内容、清空池内容、容量、列对象 |
| POOL SNAP COMMANDS | lssnap、mksnap、rmsnap |
列出/创建/删除池快照 |
| OBJECT COMMANDS | get、put、append、truncate、create、rm、cp、stat、touch、rollback |
对象的增删改查与回滚 |
| SCRUB AND REPAIR | list-inconsistent-pg、list-inconsistent-obj |
列出不一致的 PG / 对象 |
| IMPORT AND EXPORT | export、import |
把池内容序列化到文件或从文件导入 |
⚠️ 注意 :
purge会清空池中所有对象(--yes-i-really-really-mean-it),rm支持--force-full用于集群满时强制删除对象。这两个都是高危操作,生产环境慎用。
9.2 上传、查看与定位一个对象
bash
# 造一个测试文件并上传到池中,对象命名为 hosts
[root@ceph1 ~] echo laogao1 > hosts1
[root@ceph1 ~] rados -p pool_web put hosts hosts1

# 列出池中对象
[root@ceph1 ~] rados -p pool_web ls
hosts

# 查看对象状态(大小、修改时间)
[root@ceph1 ~] rados -p pool_web stat hosts
pool_web/hosts mtime 2025-08-21T09:52:43.000000+0800, size 8"这个对象到底存在哪块盘上"------这是排障和验证 CRUSH 是否按预期工作最有用的一个问题:
bash
[root@ceph1 ~] ceph osd map pool_web hosts
osdmap e85 pool 'pool_web' (2) object 'hosts' -> pg 2.ea1b298e (2.e) -> up ([8,2], p8) acting ([8,2], p8)
这行输出信息量极大,逐段拆开看:
| 片段 | 含义 |
|---|---|
osdmap e85 |
当前 OSD 映射表是第 85 版(epoch)。每次加盘、删盘、故障、重启,版本号都会涨 |
pool 'pool_web' (2) |
池名 pool_web,池 ID 2 |
object 'hosts' |
要查询的对象名 |
-> pg 2.ea1b298e (2.e) |
对象先映射到 PG。2 是池 ID,ea1b298e 是对象名 hash 出的十六进制值,(2.e) 是简化写法 = 池 2 + PG 编号 e |
(2.e) → PG 14 |
PG 编号 e 是十六进制 ,等于十进制 14 ,即对象被放进 PG 2.14 |
up ([8,2], p8) |
当前活着、可用的 OSD 列表 ------ 两个副本分别在 osd.8 和 osd.2 ;p8 表示 primary(主)OSD 是 8,读写优先走主 OSD |
acting ([8,2], p8) |
实际负责这个 PG 的 OSD。正常情况下 up 和 acting 完全一样;如果在恢复、迁移、故障中,两者会不一致 |
顺着这条链再往下钻,就能确认落盘设备:
bash
[root@ceph1 ~] ceph osd metadata 8 | grep devices
    "bluestore_bdev_devices": "sdd",
    "devices": "sdd",
    "objectstore_numa_unknown_devices": "sdd",
"osdspec_affinity": "all-available-devices",最终结论(最关键)------这个对象在 Ceph 里的完整位置是:
text
pool_web (pool-2)
  → 对象 hosts
    → 哈希到 PG 2.e (PG 14)
      → 主 OSD:osd.8
      → 副本 OSD:osd.2
数据存在 osd.8 和 osd.2 两块盘上
💡 提示 :
ceph osd map <pool> <object>是验证 PG 数量调整是否生效、复本数是否按预期分布的最快手段。改完pg_num后对象落到新 PG,用这条命令一眼就能看出来。
另有 ceph pg dump pgs_brief 可以从 PG 视角批量查看状态。
9.3 检索、追加与删除对象
bash
# 检索对象到本地
[root@ceph1 ~] rados -p pool_web get hosts newhosts
[root@ceph1 ~] cat newhosts
laogao1

# 追加内容(注意语法:rados append -p <pool> <对象名> <本地文件>)
[root@ceph1 ~] echo laogao2 >> hosts2
[root@ceph1 ~] rados append -p pool_web hosts hosts2
[root@ceph1 ~] rados get hosts newhosts -p pool_web
[root@ceph1 ~] cat newhosts
laogao1
laogao2

# 上传系统文件 / 删除对象
[root@ceph1 ~] rados put passwd /etc/passwd -p pool_web
[root@ceph1 ~] rados ls -p pool_web
passwd
hosts
[root@ceph1 ~] rados rm passwd -p pool_web
[root@ceph1 ~] rados ls -p pool_web
hosts
⚠️ 注意 :
rados put/append/get的参数顺序容易写错------put是rados put <对象名> <本地文件> -p <池>,而append是rados append -p <池> <对象名> <本地文件>。写反了会报文件不存在,别以为是集群出问题。
9.4 池快照:给整个池按一次"快门"
bash
# 创建池快照
[root@ceph1 ~] ceph osd pool mksnap pool_web snap1
created pool pool_web snap snap1

# 池详情里会多出快照记录
[root@ceph1 ~] ceph osd pool ls detail
pool 2 'pool_web' replicated size 2 min_size 1 crush_rule 0 object_hash rjenkins
pg_num 64 pgp_num 64 autoscale_mode off last_change 68 lfor 0/0/60 flags
hashpspool,pool_snaps stripe_width 0
        snap 1 'snap1' 2025-08-21T02:05:02.662386+0000                 #多了snap1

# 用 rados 查看池快照
[root@ceph1 ~] rados -p pool_web lssnap
1       snap1   2025.09.29 14:38:50
1 snaps

# 删除池快照
[root@ceph1 ~] ceph osd pool rmsnap pool_web snap1
removed pool pool_web snap snap1
[root@ceph1 ~] rados -p pool_web lssnap
0 snaps
快照里的对象是只读的 ------这是理解快照机制的关键。配合 -s 选项就能对某个快照中的对象做操作:
bash
# 重新拍一个快照,然后查看对象在快照中的信息
[root@ceph1 ~] ceph osd pool mksnap pool_web snap1
created pool pool_web snap snap1
[root@ceph1 ~] rados -p pool_web listsnaps hosts
hosts:
cloneid snaps   size    overlap
head    -       16

# 拍摄快照后,上传新的内容到 hosts 中
[root@ceph1 ~] echo laogao3 > hosts3
[root@ceph1 ~] rados -p pool_web put hosts hosts3
[root@ceph1 ~] rados -p pool_web get hosts newhosts
[root@ceph1 ~] cat newhosts
laogao3

# 列出快照中的对象
[root@ceph1 ~] rados ls -p pool_web -s snap1
selected snap 3 'snap1'
hosts

# 从快照取回对象:即使 hosts 在快照后被改过,取出来的仍是快照时刻的内容
[root@ceph1 ~] rados -p pool_web -s snap1 get hosts hosts-from-snap1
selected snap 3 'snap1'
[root@ceph1 ~] cat hosts-from-snap1
laogao1
laogao2把对象内容回滚到快照时刻:
bash
[root@ceph1 ~] rados -p pool_web rollback hosts snap1
rolled back pool pool_web to snapshot snap1
[root@ceph1 ~] rados -p pool_web get hosts newhosts
[root@ceph1 ~] cat newhosts
laogao1
laogao2快照是只读的,往里写或删都会被拒绝:
bash
[root@ceph1 ~] rados put -p pool_web -s snap1 passwd /etc/passwd
selected snap 3 'snap1'
error putting pool_web/passwd: (30) Read-only file system

[root@ceph1 ~] rados rm -p pool_web -s snap1 hosts
selected snap 3 'snap1'
error removing pool_web>hosts: (30) Read-only file system
💡 提示 :
(30) Read-only file system就是"快照是只读的"最直接的证据。记住这个错误码:在排查用户反馈"往快照里写不进去"时,它能让你立刻定位到原因------用户对快照的理解错了,不是集群坏了。
十、命名空间、重命名与删除池
10.1 为什么需要命名空间
Ceph 可以把整个池提供给特定应用,但应用一多,池的数量就会增加。这里有个容易被忽略的连锁反应:
- 建议每个 OSD 关联的 PG 数量为 100-200;
- 集群中 OSD 数量是有限的,所以 PG 的数量也是有限的;
- 创建的池越多,每个池能分配到的 PG 就越少 ,每个 PG 要为更多的对象映射到 OSD 磁盘,导致每个 PG 的计算开销更高(负载更重) ,从而降低 OSD 性能。
命名空间(namespace) 就是解这个矛盾的工具:它可以把池中对象做逻辑分组 ,还能限制用户只能存储或检索池中特定命名空间 内的对象。借助命名空间,可以让多个应用共用同一个池,不必为每个应用单独划一个池,从而确保池的数量不会太多。
⚠️ 重要 :命名空间目前仅支持直接使用 librados 的应用 ------RBD 和 Ceph 对象网关(RGW)客户端目前不支持此功能。这是一个明确的适用边界。
默认情况下,每个池都包含一个具有空名称的命名空间 ,称为默认命名空间 。要在命名空间内存储对象,客户端应用必须同时提供池名 和命名空间名。
10.2 命名空间实操
bash
# 把 /etc/hostname 上传到池 pool_web 的 myns1 命名空间
[root@ceph1 ~] rados put -p pool_web -N myns1 hostname1 /etc/hostname

# 默认命名空间里看不到它
[root@ceph1 ~] rados ls -p pool_web
hosts

# 指定命名空间才看得到
[root@ceph1 ~] rados ls -p pool_web -N myns1
hostname1

# 再建一个命名空间
[root@ceph1 ~] rados put -p pool_web -N myns2 hostname2 /etc/hostname
[root@ceph1 ~] rados ls -p pool_web -N myns2
hostname2

# 一次列出所有命名空间的对象(--all)
[root@ceph1 ~] rados ls -p pool_web --all
myns1   hostname1
        hosts
myns2   hostname2

# 也可以要 json 格式,方便脚本处理
[root@ceph1 ~] rados ls -p pool_web --all --format=json-pretty
[
    {
        "namespace": "myns1",
        "name": "hostname1"
    },
    {
        "namespace": "",
        "name": "hosts"
    },
    {
        "namespace": "myns2",
        "name": "hostname2"
    }
]
注意 --all 输出里 hosts 那一行的命名空间是空字符串 ------它就是默认命名空间 。另外 -N/--namespace 指定要使用的命名空间,--all 与 --default 是配合 ls 使用的过滤开关(--default 的优先级高于 --all)。
💡 提示 :把
--all放进CEPH_ARGS环境变量可以让它成为默认行为;但记得--default会覆盖--all------两个都设的时候,看的是--default。
10.3 重命名池
bash
[root@ceph1 ~] ceph osd pool rename pool_web pool_apache
pool 'pool_web' renamed to 'pool_apache'重命名池不会影响池中存储的数据,但有一条必须记住的副作用:
⚠️ 重要 :如果用户重命名池,池级别的用户权限会受影响,必须用新的池名称来更新该用户的能力(caps)。也就是说,如果一个受限用户的能力里写死了旧池名,重命名之后这个用户就会立刻失去访问权限------这类"改名后业务断了"的故障,根因往往就在权限的 caps 里。
10.4 删除池:动手前先做两件事
使用 ceph osd pool delete 命令删除池。但在敲这条命令之前,有一道默认关闭的开关必须先打开:
bash
# 集群级别必须先允许删除池
[root@ceph1 ~] ceph config set mon mon_allow_pool_delete true
⚠️ 重要 :删除池会删除池中的所有数据,而且不可逆转。 这也解释了前面反复出现的两个设置为什么存在:
mon_allow_pool_delete(默认false)------ 集群级的"总闸",不打开谁都删不了池;- 池级
nodelete标志(可设为true)------ 单个池的"安全锁",加锁的池即使总闸开了也删不掉。
推荐的删池顺序 :先确认池内数据已备份或确认可丢 → 池级 nodelete 设为 false → 集群级 mon_allow_pool_delete 设为 true → 执行删除 → 立刻把 mon_allow_pool_delete 改回 false。
bash
# 完整流程示意
[root@ceph1 ~] ceph osd pool set pool_apache nodelete false     # 解锁池
[root@ceph1 ~] ceph config set mon mon_allow_pool_delete true   # 打开总闸
[root@ceph1 ~] ceph osd pool delete pool_apache pool_apache --yes-i-really-really-mean-it
[root@ceph1 ~] ceph config set mon mon_allow_pool_delete false  # 立刻关回总闸
这也是本篇开头那个实验环境清理场景的延续------第 3 章开篇时清理 ceph2 节点的残留数据,用的就是这类"先放开权限、再动手、最后恢复"的套路:
bash
# 清理磁盘数据、移除主机(第 3 章开篇的环境恢复)
[root@ceph1 ~] ceph orch device zap ceph2.laogao.cloud /dev/sdb --force
[root@ceph1 ~] ceph orch device zap ceph2.laogao.cloud /dev/sdc --force
[root@ceph1 ~] ceph orch device zap ceph2.laogao.cloud /dev/sdd --force
[root@ceph1 ~] ceph orch host rm ceph2
[root@ceph1 ~] ceph orch host ls             #查看现象ceph2被移除
HOST                ADDR           LABELS  STATUS
ceph1.laogao.cloud  192.168.108.11  _admin
ceph3.laogao.cloud  192.168.108.13  _admin
2 hosts in cluster
[root@ceph2 ~] rm -rf /var/lib/ceph
[root@ceph2 ~] rm -rf /etc/ceph /etc/systemd/system/ceph*
[root@ceph2 ~] rm -rf /var/log/ceph
💡 提示 :"先把权限放够、做完危险动作、立刻把权限收回去" 是所有 Ceph 破坏性操作的通用节奏。怕忘记收回去,就把这三条命令写成一个脚本一次性执行。
十一、验证测试、排障指南与最佳实践
11.1 实验环境与前置条件
本篇的实验承接前两篇搭好的三节点集群:
| 主机名 | IP 地址 | 角色 |
|---|---|---|
| client.laogao.cloud | 192.168.108.10 | 客户端节点 |
| ceph1.laogao.cloud | 192.168.108.11 | 主集群 MON / MGR / OSD |
| ceph2.laogao.cloud | 192.168.108.12 | 主集群 ceph 节点 |
| ceph3.laogao.cloud | 192.168.108.13 | 主集群 ceph 节点 |
| 项目 | 配置 |
|---|---|
| 集群 fsid | 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e |
| Ceph 版本 | 16.2.15(pacific) |
| 每节点数据盘 | 3 × 20G(1 磁盘 = 1 OSD,XFS / BlueStore) |
| Dashboard | https://ceph1.laogao.cloud:8443,admin / laogao@123 |
前置条件:集群 ceph status 为 HEALTH_OK;ceph -s 中 mon 有 3 个 daemon 并处于 quorum;ceph orch host ls 能看到三台主机。后续所有 ceph 命令都在 ceph1 上执行(或先 cephadm shell 进入容器化 shell)。
11.2 验证测试
测试1:配置是否真的写进了数据库、并且不随重启丢失
bash
# 写入一条配置并确认
[root@ceph1 ~] ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true

# 重启 MON,配置依然是 true(因为它在数据库里)
[root@ceph1 ~] ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true
测试2:临时覆盖与持久配置的差别(故障注入式的对照实验)
bash
# 用 ceph tell 临时把值改成 false
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{ "success": "mon_allow_pool_delete = 'false' " }

# 运行时看是 false
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{ "mon_allow_pool_delete": "false" }

# 数据库里依然是 true ------ 这就是"临时覆盖不影响持久配置"的证据
[root@ceph1 ~] ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true

# 重启后临时值消失,回到数据库里的 true
[root@ceph1 ~] ceph orch daemon restart mon.ceph1.laogao.cloud
[root@ceph1 ~] ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{ "mon_allow_pool_delete": "true" }
测试3:对象确实落到了预期的 PG 与 OSD 上
bash
[root@ceph1 ~] echo laogao1 > hosts1
[root@ceph1 ~] rados -p pool_web put hosts hosts1
[root@ceph1 ~] ceph osd map pool_web hosts
osdmap e85 pool 'pool_web' (2) object 'hosts' -> pg 2.ea1b298e (2.e) -> up ([8,2], p8) acting ([8,2], p8)判定标准:up 与 acting 两个列表完全一致 (说明没有处于恢复/迁移状态),且列表长度等于池的 size(复本数)。如果长度不一致,先查 ceph -s 里的 pgs 状态和 ceph health detail。
测试4:池配额生效与解除
bash
[root@ceph1 ~] ceph osd pool set-quota pool_web max_objects 100000
[root@ceph1 ~] ceph osd pool get-quota pool_web
quotas for pool 'pool_web':
  max objects: 100k objects  (current num objects: 0 objects)
  max bytes  : 10 GiB  (current num bytes: 0 bytes)
# 置 0 即取消配额
[root@ceph1 ~] ceph osd pool set-quota pool_web max_objects 0
测试5:快照只读性的验证(预期"失败"的测试)
bash
[root@ceph1 ~] rados put -p pool_web -s snap1 passwd /etc/passwd
error putting pool_web/passwd: (30) Read-only file system
[root@ceph1 ~] rados rm -p pool_web -s snap1 hosts
error removing pool_web>hosts: (30) Read-only file system这条测试必须报错才算通过 ------拿到 Read-only file system 说明快照的只读语义是生效的。
11.3 排障指南
| 故障现象 | 排查方向 |
|---|---|
| 改了配置但没生效 | 先 ceph config get <who> <key> 确认数据库里的值;再确认改的粒度对不对(mon vs mon.ceph1.laogao.cloud);检查 ceph config help <key> 里 Can update at runtime 是否为 false(需重启守护进程) |
| 配置重启后回退 | 你用的是 ceph tell 或 ceph daemon(临时覆盖,仅在内存中)。要持久必须用 ceph config set |
ceph config get 查不到刚改的值 |
用 ceph tell / ceph daemon 改的值不会被 ceph config get 识别,这是设计如此 |
| MON 无法建立仲裁 | 用 ceph status / ceph mon stat / ceph quorum_status -f json-pretty 看 quorum 成员数;确认超过一半的 MON 在运行;检查 MON 之间 6789/3300 端口与时钟同步 |
HEALTH_WARN 与 mon 数据库有关 |
查 mon_data_size_warn(默认 15 GB)与 mon_data_avail_warn(30%)阈值;执行 ceph tell mon.$id compact 压缩数据库,或设置 mon_compact_on_start true |
| 删不掉池 | 池级:ceph osd pool get <pool> nodelete 若为 true 先置 false;集群级:mon_allow_pool_delete 必须为 true |
| 重命名池后用户访问失败 | 池级权限的 caps 里写的是旧池名,必须用新池名更新该用户的能力 |
| 集群性能下降、IO 抖动 | 看 ceph osd pool autoscale-status 的 NEW PG_NUM 列是否有明显偏差;PG 数过多会吃 CPU/内存,过少会让移动 PG 占满带宽 |
往对象写数据报 Read-only file system |
你带上了 -s <snap>,正在往快照里写------快照只读,这是预期行为 |
| 客户端读写报错、OSD 之间通信异常 | 检查 cluster 网络与 public 网络的连通性、MTU 是否一致、防火墙是否放行 6800-7300/tcp |
| 对象位置与预期不符 | ceph osd map <pool> <object> 对比 PG 与 OSD;确认 CRUSH 规则与故障域(crush-failure-domain)设置是否符合预期 |
11.4 最佳实践
- 集群级配置写数据库,本机相关配置写文件 :
- 需要所有匹配守护进程统一生效、且要持久的 →
ceph config set; - 只跟本机环境强相关的(数据目录、
osd_pool_default_flag_*这类 global 块参数) →ceph.conf的[global]。
- 需要所有匹配守护进程统一生效、且要持久的 →
- 临时调试用 tell/daemon,用完立刻回滚 :
- 紧急抓日志
ceph tell osd.0 injectargs --debug_xxx=20,事后重启或反向设置恢复; - 把"临时改动清单"写进变更记录,避免以 为已经改回来。
- 紧急抓日志
- 改配置前先看历史,改完留好回滚点 :
ceph config log看近期变更;- 关键改动前后各记一次
ceph config get <who> <key>,出问题用ceph config reset <num>回滚。
- 池的"三把锁"该上就上 :新池默认打开
nodelete;对 PG 已调优稳定的池打开nopgchange、nosizechange。 - 池类型是创建时的单选题 :活跃数据用复本池,冷数据/归档用纠删码池;池类型与纠删码配置文件都不可事后修改,宁可多评估一天。
- PG 数优先交给 autoscaler :
pg_autoscale_mode on配合pg_autoscaler模块,用ceph osd pool autoscale-status复核;旧公式只能当兜底经验值。 - 容量规划时把纠删码算进去:同样 180 GiB 裸容量,复本池可用约 56 GiB 而 k+m 纠删码池可达 84 GiB------这是"要不要为冷数据上纠删码"最直观的决策依据。
- 危险操作前先备份、后动手、再收权 :删除池、
device zap、purge一律遵循"放开权限 → 执行 → 立刻收回"的节奏。 - 保护密钥环与 MON 数据 :密钥环是纯文本,注意文件权限;MON 的
store.db所在分区要留足空间(30% / 5% 两个阈值会直接触发 WARN / ERR)。 - 不要改 MON 的 IP:集群映射里记的就是这些地址,改 IP 会让集群"找不到路"。
写在最后
本文从 集群配置的来源与优先级 一路走到 池的日常管理,把 Ceph 第 3、4 章的核心内容串成了一条线------配置该写在哪、怎么改才持久、池该怎么建、PG 该给多少、复本和纠删码怎么选:
| 章节 | 核心内容 | 应用场景 / 解决的问题 |
|---|---|---|
| 一、集群配置来源 | 六大配置来源、覆盖原则、ceph.conf 查找顺序、配置部分与元变量 |
搞不清"参数写在哪、谁覆盖谁" |
| 二、集中配置数据库 | ceph config ls/help/dump/show/get/set/rm/log/reset |
统一管理集群配置、审计与回滚 |
| 三、运行时覆盖 | ceph tell、ceph daemon、Dashboard 改配置 |
紧急排错、临时抓日志 |
| 四、MON 配置与仲裁 | Paxos 角色、quorum、mon_host、mon map、数据库容量治理 |
保证集群可读可写、避免脑裂 |
| 五、网络与端口 | public / cluster 网络分流、CIDR 多子网、IPv6、MTU 9000、防火墙规则 | 性能隔离与安全加固 |
| 六、池与 PG 原理 | 池属性、PG 计算与设置原则、对象→PG→OSD 四步定位、读写流程 | 让数据分布均匀、读写延迟可控 |
| 七、复本池 vs 纠删码池 | 3 副本 300% 开销 vs k+m 150%、纠删码配置文件 | 用最少的空间换到足够的可靠 |
| 八~十、池的日常管理 | 应用类型、配额、复本数、min_size、PG 数、对象操作、快照、命名空间、重命名与删除 | 从建池到删池的全生命周期运维 |
| 十一、验证与排障 | 5 组验证测试、10 类故障排查方向、10 条最佳实践 | 出事能定位、上线有规范 |
核心价值:
✅ 可用性 :MON 奇数部署保证 quorum、min_size 兜住写入一致性、nodelete 防误删池,把"人为事故"和"硬件故障"两类风险一起压住。
✅ 性能 :PG 数按 OSD 规模取值(128 / 512 / 4096)或交给 pg_autoscaler,配合 public/cluster 网络分流与 MTU 9000,避免"调参调出性能事故"。
✅ 成本 :冷数据用 k+m 纠删码池把存储开销从 300% 压到 150%,同样硬件多存一倍数据。
✅ 运维效率 :配置分四类来源但写入点只有两个(数据库 / ceph.conf),一套 ceph config 命令族搞定查询、修改、历史与回滚。
📌 核心命令速查
bash
# 配置查询与修改(写数据库 = 持久)
ceph config ls                       # 列出所有配置条目
ceph config help <key>               # 看参数类型、默认值、能否运行时改
ceph config dump                     # 只看被显式设置过的项
ceph config show <who> [<key>]       # 某个守护进程显式设置过的项
ceph config show-with-defaults <who> # 完整运行时配置(含默认值)
ceph config get <who> <key>          # 精准点查
ceph config set <who> <key> <value>  # 写入集中配置数据库(持久、批量生效)
ceph config rm <who> <key>           # 删除 = 还原默认
ceph config log [n] / reset <n>      # 看历史 / 回滚到第 n 版

# 临时覆盖(重启即失效)
ceph tell <type>.<id> config show|get|set    # 需要 MON 在运行,支持 mon.* 通配
ceph daemon <type>.<id> config show|get|set  # 不需要 MON,本机守护进程即可

# MON 与仲裁
ceph status | grep mon               # 快速看 quorum
ceph mon stat                        # MON 位置、leader、quorum
ceph quorum_status -f json-pretty    # 机器可读的仲裁状态
ceph mon dump                        # MON 映射
ceph tell mon.<id> compact           # 压缩 MON 配置数据库
ceph config set mon mon_compact_on_start true

# 网络与端口
ceph config set mon public_network 192.168.108.0/24
ceph config get mon.ceph1.laogao.cloud ms_bind_ipv4
ceph orch daemon add mon cluster-host02:192.168.108.0/24
# firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp

# 池的查看与创建
ceph osd pool ls / ls detail / lspools / stats / df
ceph osd pool create pool_web 32 32 replicated          # 复本池
ceph osd pool create pool_era 32 32 erasure             # 纠删码池
ceph osd erasure-code-profile ls|get|set|rm             # 纠删码配置文件

# 池的属性与保护
ceph osd pool get <pool> all                            # 看全部池配置
ceph osd pool set <pool> size 2                         # 改复本数
ceph osd pool set <pool> nodelete true                  # 防误删
ceph osd pool set <pool> pg_num 64                      # 改 PG 数
ceph osd pool set <pool> pg_autoscale_mode on           # PG 自动扩展
ceph osd pool autoscale-status                          # 看建议 PG 数
ceph osd pool set-quota <pool> max_bytes 10G            # 池配额
ceph osd pool get-quota <pool>
ceph osd pool application enable <pool> rbd             # 池应用类型

# 池中对象与快照
rados -p <pool> put <obj> <file> / get / append / rm / ls / stat
ceph osd map <pool> <obj>                               # 对象落在哪个 PG / 哪个 OSD
rados -p <pool> -N <ns> put ...                         # 命名空间
rados -p <pool> --all ls                                # 列出所有命名空间
ceph osd pool mksnap <pool> <snap> / rmsnap             # 池快照
rados -p <pool> -s <snap> get <obj> <file>              # 从快照取对象
rados -p <pool> rollback <obj> <snap>                   # 回滚对象

# 重命名与删除池
ceph osd pool rename <old> <new>                        # 记得同步更新用户 caps
ceph config set mon mon_allow_pool_delete true          # 删池总闸(默认 false)
ceph osd pool delete <pool> <pool> --yes-i-really-really-mean-it
📝 本文首发于个人技术博客,欢迎交流讨论。如有错误,恳请指正。
下篇预告 :配置管住了、池建好了,下一步就是让客户端真正用起来。下一篇进入------认证和授权管理 + 块存储管理:从 cephx 密钥环与用户 caps 权限讲起,一路打通 RBD 镜像的映射、快照、克隆,以及跨集群的 RBD Mirrors 单向/双向池模式同步。