第 4 章 矩阵:数据的仓库与批量计算的引擎
4.1 矩阵是什么:一张数字表格
坦白一件让我丢了面子的事:曾经一个模型,代码逻辑全对,训练却怎么都不动。我调了两天------换学习率、换初始化、甚至怀疑框架有 bug。最后发现是 (100, 1) 和 (100,) 的区别:一维数组在某个环节被悄悄当成了行向量,整个梯度算出来形状不对,广播机制又把它"善意地"算成了另一个数。两天,就毁在一个 shape 上。所以本章我会不厌其烦地写形状、盯形状、把形状当动词来说------这不是强迫症,是伤疤。
上一章我们把一个 样本变成了向量。但数据集从来不是一个样本------鸢尾花数据集有 150 朵花,每朵 4 个指标。把 150 个向量排成一张表,就是矩阵:
            花瓣长   花瓣宽   萼片长   萼片宽
样本1        1.4     0.2     5.1     3.5
样本2        1.4     0.2     4.9     3.0
 ...
样本150      5.1     1.8     6.7     3.0
矩阵 = 表格 = 向量的堆叠。机器学习里数据集的标准形态。记号:
X=1.40.25.13.51.40.24.93.0⋮⋮5.11.86.73.0X = \begin{bmatrix} 1.4 & 0.2 & 5.1 & 3.5 \\ 1.4 & 0.2 & 4.9 & 3.0 \\ \vdots & & & \vdots \\ 5.1 & 1.8 & 6.7 & 3.0 \end{bmatrix}X= 1.41.4⋮5.10.20.21.85.14.96.73.53.0⋮3.0
- 矩阵用大写粗体字母;
- 形状(shape)记作 行数 × 列数 :上面是 150×4150 \times 4150×4(150 行 4 列);
- 元素记 XijX_{ij}Xij 或 xijx_{ij}xij:第 i 行第 j 列 的数。X1,2=0.2X_{1,2} = 0.2X1,2=0.2(第 1 行第 2 列)。
铁律(刻在脑子里) :数据矩阵一行一个样本,一列一个特征。所以"150×4"读作"150 个样本、每个 4 个特征"。
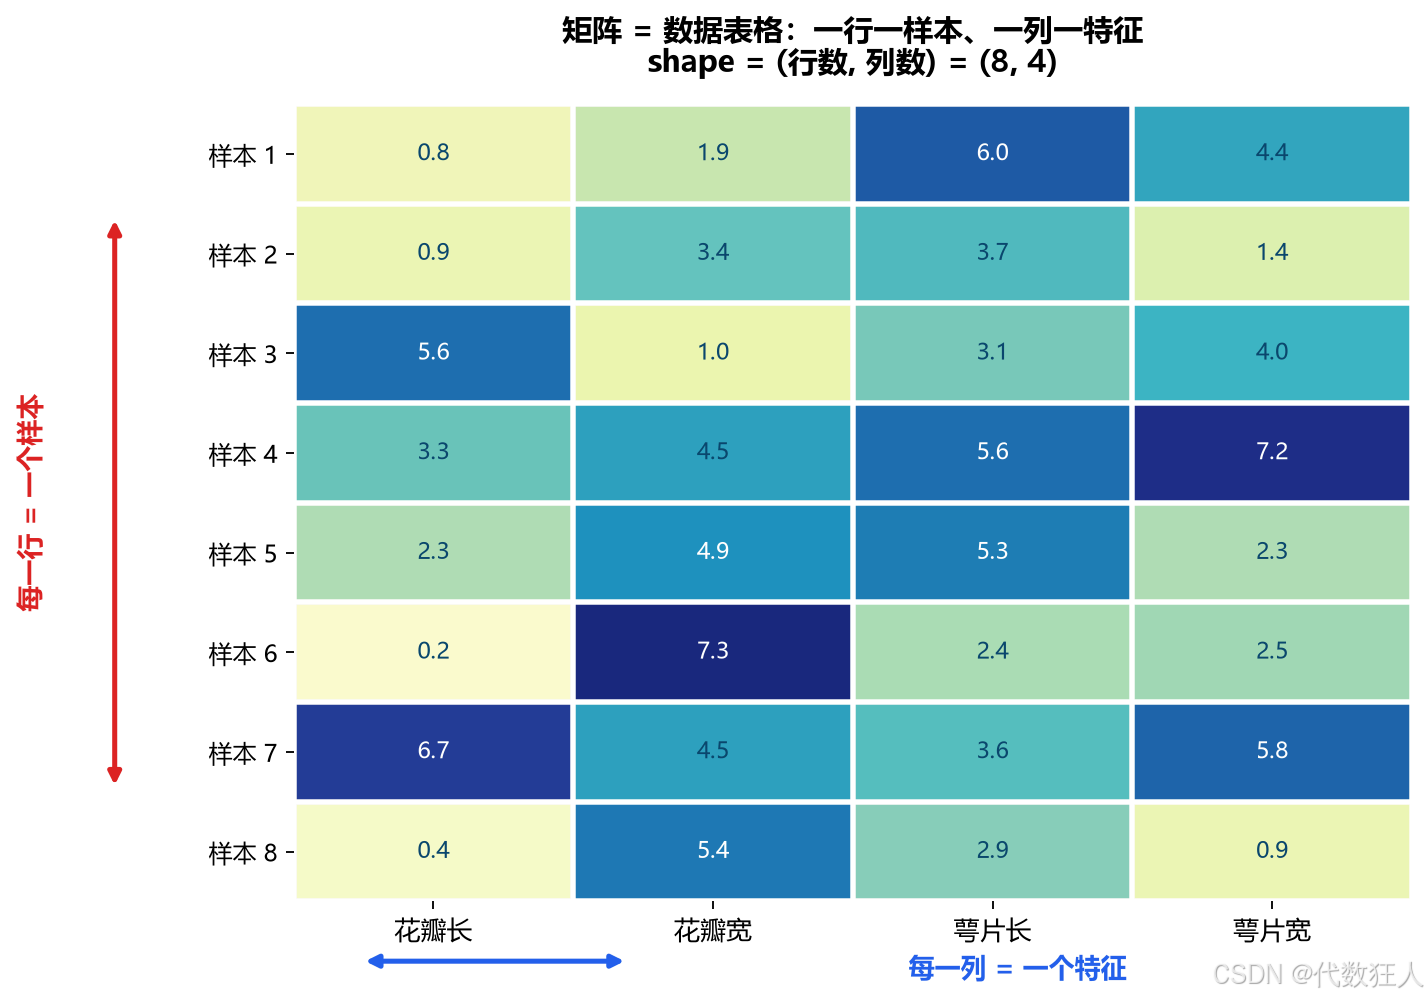
图 4-1:矩阵 = 数据表格------一行一个样本、一列一个特征
坑 :行列顺序说反是初学者第一大混乱源。记法只有一个:先横着数行,再竖着数列,"(行, 列)"和坐标 (x, y) 一样"先行后列"。NumPy 里 X.shape 返回 (150, 4),顺序相同。
4.2 特殊矩阵速览
- 向量 = 只有一列(或一行)的矩阵 :3×13 \times 13×1 矩阵就是三维列向量。矩阵是向量的一般化,向量是矩阵的特例;
- 零矩阵:全是 0;
- 单位矩阵 I :方阵(行=列),对角线全是 1、其余是 0。3×33\times 33×3 的 I:
I=100010001I = \begin{bmatrix} 1 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & 0 & 1 \end{bmatrix}I= 100010001
单位矩阵 III 是矩阵乘法的单位元------正如数字 1 是数字乘法的单位元:任何矩阵乘 III 都保持不变(IX=XIX = XIX=X,且 XI=XXI = XXI=X),所以它相当于"乘法世界的 1"。
注意两点:① III 不是唯一的,每个尺寸各有一个(I2I_2I2、I3I_3I3...),长方阵左乘、右乘用的 III 尺寸可以不同;② 类比仅限"单位元"------数字里除 0 外都有倒数,但矩阵只有可逆方阵才有逆,不可逆矩阵没有 X−1X^{-1}X−1。
4.3 矩阵加法与数乘
和向量完全同款,逐元素进行(形状必须相同):
1234\]+\[10203040\]=\[11223344\],2×\[1234\]=\[2468\]\\begin{bmatrix} 1 \& 2 \\\\ 3 \& 4 \\end{bmatrix} + \\begin{bmatrix} 10 \& 20 \\\\ 30 \& 40 \\end{bmatrix} = \\begin{bmatrix} 11 \& 22 \\\\ 33 \& 44 \\end{bmatrix}, \\qquad 2 \\times \\begin{bmatrix} 1 \& 2 \\\\ 3 \& 4 \\end{bmatrix} = \\begin{bmatrix} 2 \& 4 \\\\ 6 \& 8 \\end{bmatrix}\[1324\]+\[10302040\]=\[11332244\],2×\[1324\]=\[2648
4.4 矩阵 × 向量:批量预测(本章第一主角)
4.4.1 规则
AAA(形状 m×nm \times nm×n)乘列向量 xxx(形状 nnn)得到 mmm 维向量。规则:结果的第 i 个分量 = A 的第 i 行和 x 的内积。
手算(本章最重要的一张演算,务必拿笔走一遍):
A=123456,x=21A = \begin{bmatrix} 1 & 2 \\ 3 & 4 \\ 5 & 6 \end{bmatrix}, \quad x = \begin{bmatrix} 2 \\ 1 \end{bmatrix}A= 135246 ,x=21
- 结果第 1 分量:1,2⋅2,1=2+2=41, 2 \cdot 2, 1 = 2 + 2 = 41,2⋅2,1=2+2=4
- 结果第 2 分量:3,4⋅2,1=6+4=103, 4 \cdot 2, 1 = 6 + 4 = 103,4⋅2,1=6+4=10
- 结果第 3 分量:5,6⋅2,1=10+6=165, 6 \cdot 2, 1 = 10 + 6 = 165,6⋅2,1=10+6=16
Ax=41016Ax = \begin{bmatrix} 4 \\ 10 \\ 16 \end{bmatrix}Ax= 41016
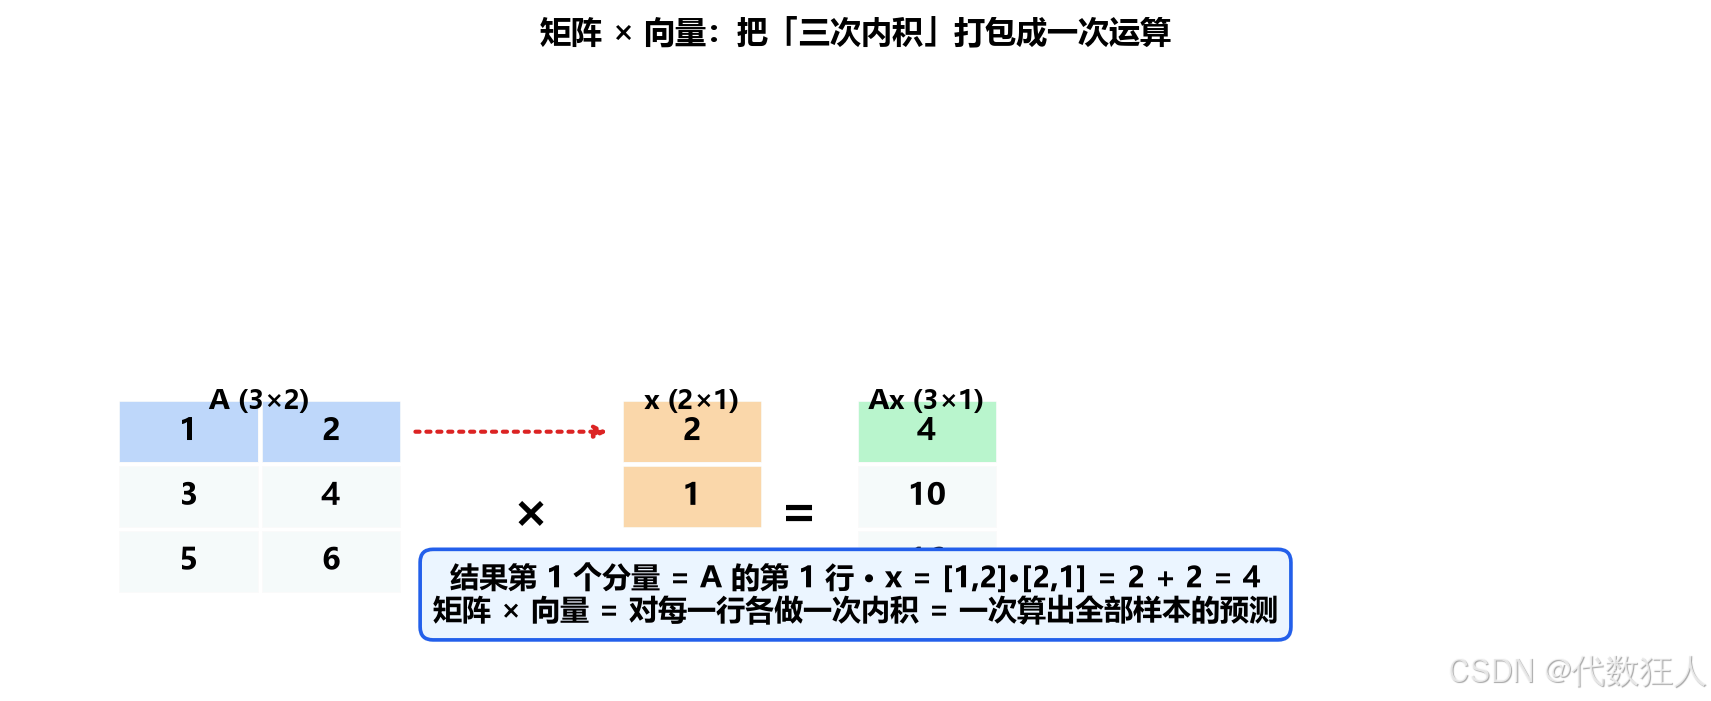
图 4-2:矩阵 × 向量------对每一行各做一次内积,一次算出全部预测
矩阵乘向量 = 对每一行做一次内积 = 三次乘加打包成一次书写。仅此而已,没有任何新运算。
4.4.2 形状规则(背下来)
(m×n)⏟A×(n×1)⏟x=(m×1)\underbrace{(m \times n)}{A} \times \underbrace{(n \times 1)}{x} = (m \times 1)A (m×n)×x (n×1)=(m×1)
中间的两个 n 必须相等 (A 的列数 = x 的行数),这叫"维度相容"。外层的 m 和 1 是结果的形状。NumPy 报错 matmul: Input operand 1 has a mismatch... 就是这条被违反了。调试神经网络时 80% 的 shape 错误,把各层形状按这个格式写成一串(如 150×4→4×8→8×1150\times4 \to 4\times8 \to 8\times1150×4→4×8→8×1)就能立刻看出哪一环断了。
4.4.3 这就是批量预测
线性模型对一个样本的预测是内积 w⋅xw \cdot xw⋅x(上一章)。现在有 3 个样本、每个 2 个特征,权重 w=2,1w = 2, 1w=2,1:
X=123456,Xw=41016X = \begin{bmatrix} 1 & 2 \\ 3 & 4 \\ 5 & 6 \end{bmatrix}, \quad Xw = \begin{bmatrix} 4 \\ 10 \\ 16 \end{bmatrix}X= 135246 ,Xw= 41016
一次矩阵乘法 = 三个样本同时预测完 。150 个样本就是一次 150×4150\times4150×4 乘 4×14\times14×1。你在《机器学习实战》这本书里到处看到的model.predict(X),底层就是这行数学。这就是第 3 章说的"内积 = 模型预测"的批量版。
4.5 矩阵 × 矩阵:批量预测的批量版
形状 (m×n)(m \times n)(m×n) 乘 (n×p)(n \times p)(n×p) 得 (m×p)(m \times p)(m×p)。规则:结果的第 (i,j) 元 = 第一个矩阵第 i 行 · 第二个矩阵第 j 列的内积。
手算小例子:
1234\]\[5678\]=\[1×5+2×71×6+2×83×5+4×73×6+4×8\]=\[19224350\]\\begin{bmatrix} 1 \& 2 \\\\ 3 \& 4 \\end{bmatrix} \\begin{bmatrix} 5 \& 6 \\\\ 7 \& 8 \\end{bmatrix} = \\begin{bmatrix} 1\\times5+2\\times7 \& 1\\times6+2\\times8 \\\\ 3\\times5+4\\times7 \& 3\\times6+4\\times8 \\end{bmatrix} = \\begin{bmatrix} 19 \& 22 \\\\ 43 \& 50 \\end{bmatrix}\[1324\]\[5768\]=\[1×5+2×73×5+4×71×6+2×83×6+4×8\]=\[19432250
什么时候需要?当右边的"向量"扩成好几个并排的向量时。深度学习每一层就是矩阵×矩阵:输入 XXX(m×nm \times nm×n)乘权重 WWW(n×kn \times kn×k)------一次运算同时完成"m 个样本、每个乘出 k 个新特征"。反向传播里梯度也是靠矩阵乘法一层层回传(第 11 章)。
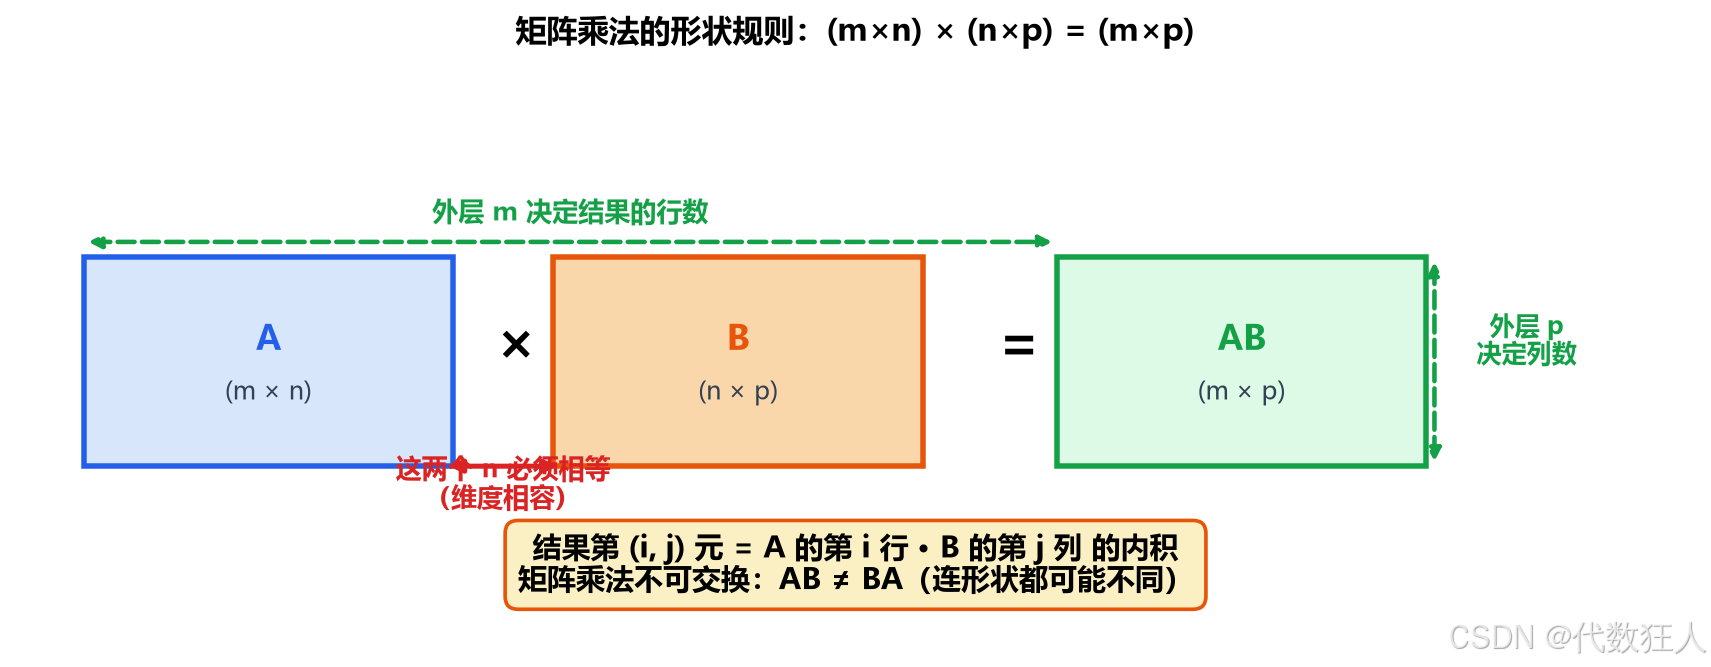
图 4-3:矩阵乘法的形状规则------中间维度必须相等,外层决定结果形状
坑(高频) :矩阵乘法不满足交换律 。ABABAB 通常 ≠ BABABA(甚至形状都不同)。"(行,列)内积"这个规则决定了谁在左谁在右很重要------第 11 章推导中每个 WTW^TWT 的位置都是有原因的,不是装饰。
4.6 转置:行列互换
把行变成列:
A=123456,AT=142536A = \begin{bmatrix} 1 & 2 & 3 \\ 4 & 5 & 6 \end{bmatrix}, \qquad A^T = \begin{bmatrix} 1 & 4 \\ 2 & 5 \\ 3 & 6 \end{bmatrix}A=142536,AT= 123456
2×32\times32×3 转完变 3×23\times23×2。性质(用了就回来查):
- (AT)T=A(A^T)^T = A(AT)T=A
- (AB)T=BTAT(AB)^T = B^T A^T(AB)T=BTAT(顺序翻转!第 11 章反向传播推导的绊脚石,先在此立牌)
转置最重要的用途------解释 xTyx^T yxTy 记号 :列向量 xxx(n×1n\times1n×1)转置成行向量 xTx^TxT(1×n1\times n1×n),于是 xTyx^T yxTy 是 (1×n)(n×1)=1×1(1\times n)(n \times 1) = 1\times1(1×n)(n×1)=1×1------结果是"一行一列的矩阵",按惯例就当一个数,正是内积。机器学习书爱写 wTxw^T xwTx(权重转置乘样本),你现在知道它和 w⋅xw \cdot xw⋅x 是同一个东西。
4.7 逆矩阵:解方程的另一把钥匙
数字世界里 ax=bax = bax=b 的解是 x=ba=a−1bx = \frac{b}{a} = a^{-1}bx=ab=a−1b。矩阵世界有对应物:若存在 A−1A^{-1}A−1 使 AA−1=IA A^{-1} = IAA−1=I(单位矩阵),则 Ax=bAx = bAx=b 的解是:
x=A−1bx = A^{-1} bx=A−1b
直觉 :AAA 是把 x 变成 b 的变换,A−1A^{-1}A−1 是把 b 变回 x 的逆变换(矩阵 A 是一个"变换机器",A−1A^{-1}A−1 是它的"撤销键")。"正规方程" θ^=(XTX)−1XTy\hat{\theta} = (X^T X)^{-1} X^T yθ^=(XTX)−1XTy(《机器学习实战》第 4 章的宠儿)就是把线性回归写成矩阵方程后直接"解"出来的公式------不用一步步迭代梯度下降,一步到位算出最优参数。
但有三件重要的事:
- 只有方阵才可能可逆;
- 可逆不是必然的:XTXX^TXXTX 在特征线性相关(比如"厘米身高"和"米身高"两列)时不可逆 ,正规方程直接失效------这正是岭回归在 XTXX^TXXTX 上加一个 λI\lambda IλI(让它"永远可逆")的历史动机;
- 实践中数值稳定性差、样本大时慢,梯度下降往往更受青睐------但理解逆矩阵让你知道"一步解"和"迭代解"是同一道题的两种解法。
4.8 特征值与特征向量:只建立直觉
对方阵 A,如果存在非零向量 v 使 Av=λvAv = \lambda vAv=λv(λ 是数),就称 v 是 A 的特征向量 、λ 是对应的特征值。
"v 被 A 变换后(左边),等于把 v 单纯伸缩 λ 倍(右边)" → 方向不变
直觉:矩阵是"对空间的一次变换"。大多数箭头被变换后又转又拉;但少数方向特殊的箭头只被拉长/压扁、方向不动------它们就是特征向量,被伸缩的倍数就是特征值。
为什么你现在就该知道这个词:PCA(主成分分析) 找"数据散得最开的方向",数学上正是对数据的协方差矩阵求特征向量------方差最大的几个方向 = 最大的几个特征值对应的方向。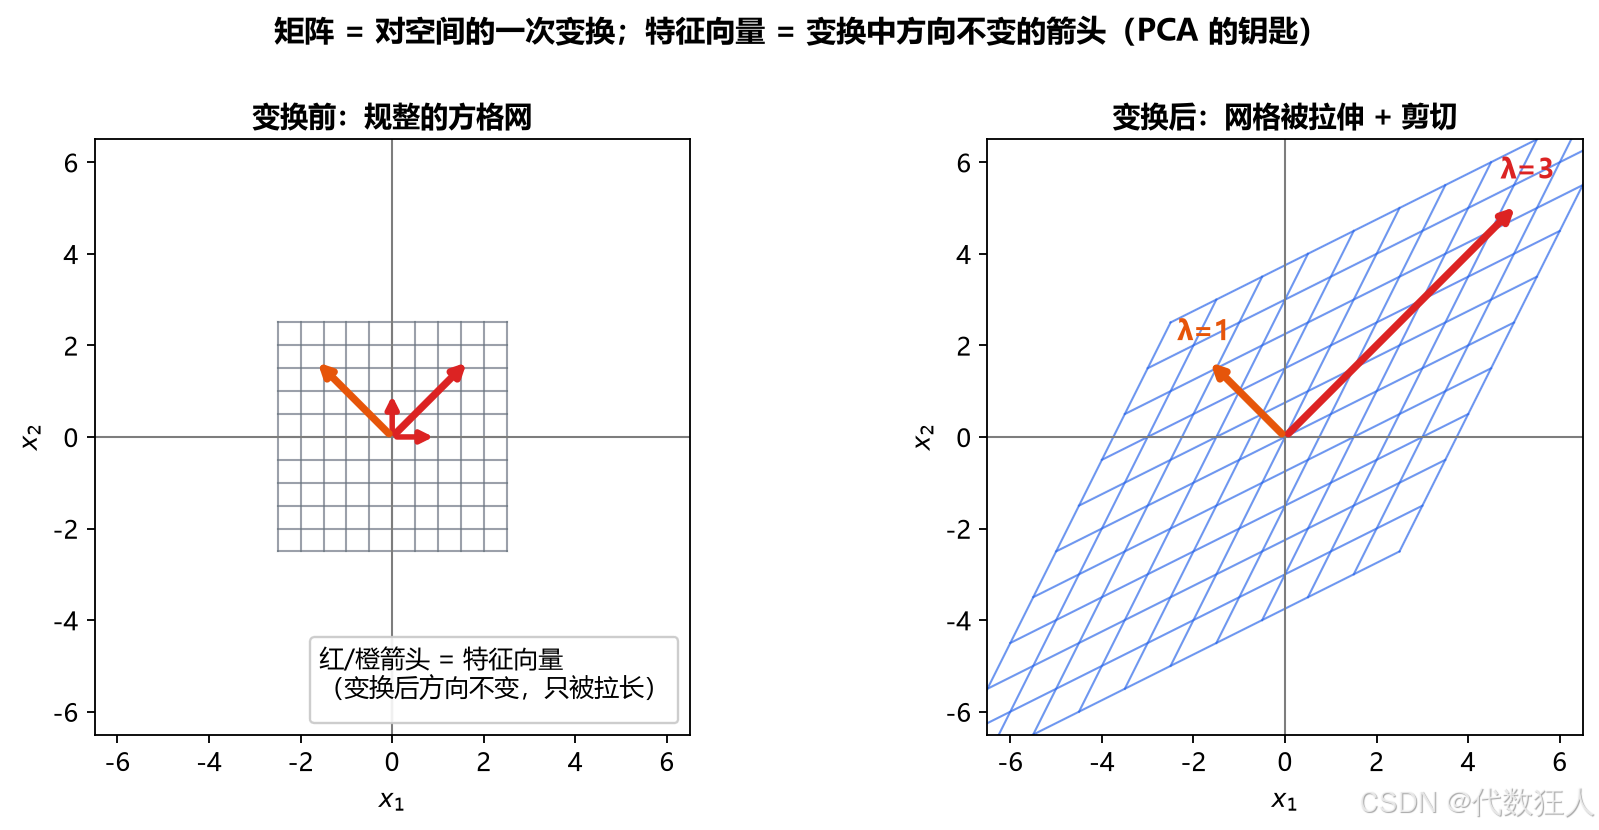
图 4-4:矩阵 = 对空间的一次变换------特征向量是变换中方向不变的箭头
本书不推导 PCA,但带着这个直觉去读,很多公式会突然变得眉清目秀。
4.9 NumPy 实操(必跑)
python
import numpy as np

A = np.array([[1, 2],
              [3, 4],
              [5, 6]])      # shape (3, 2)
x = np.array([2, 1])        # shape (2,)

print(A.shape, x.shape)     # (3, 2) (2,)

# 矩阵乘向量:结果 shape (3,)
print(A @ x)                # [ 4 10 16]   <- 和 4.4.1 手算完全一致!

W = np.array([[2.0, 1.0]])  # 把权重摆成矩阵
print(np.dot(x, x))         # 5   内积

# 转置
print(A.T.shape)            # (2, 3)

# 列向量(注意和一维数组的区别)
xc = x.reshape(2, 1)
print(xc.T @ xc)            # [[5]]  <- 这就是 x·x = 5,"一行一列矩阵当数用"

# 一个小数据集的"批量预测"
X = np.array([[1.0, 2.0],
              [3.0, 4.0],
              [5.0, 6.0]])
w = np.array([0.5, 0.1])
print(X @ w)                # [0.7 1.9 3.1]  三个样本的预测一次完成
新手三大 shape 坑(这三个坑我每个都亲身交过学费,其中第一个让我搭进去整整两天):
- 一维数组没有转置的概念:x.T 对 np.array(1,2) 无效果。需要列向量就 reshape(-1, 1);
- A @ x 里 A 是 (m,n)(m, n)(m,n)、x 是一维 n 个数 → 结果一维 m 个数(NumPy 的友好特例);但 x 若是 (n,1)(n, 1)(n,1) 二维 → 结果 (m,1)(m, 1)(m,1) 二维。混用会得到诡异的 (3,1) 广播错误;
- (AB)T= BT AT 顺序会翻------手推反向传播时 90% 的"推导不对"都是这个原因。
4.10 本章小结
- 矩阵 = 表格;数据矩阵一行一样本、一列一特征;shape 先行后列
- 矩阵×向量 = 每行做一次内积 = 批量预测;中间维度必须相等
- 矩阵×矩阵 = 结果元 = 行·列内积;不可交换 ;(AB)T=BTAT(AB)^T = B^T A^T(AB)T=BTAT
- wTxw^T xwTx 就是内积的矩阵记号;单位矩阵是"乘法的 1";逆矩阵给出一部解方程法(正规方程),特征相关性会让它失效
- 特征向量 = 变换中方向不变的箭头 = PCA 的钥匙
4.11 练习(答案在本章末尾)
- A=1023A = \begin{bmatrix} 1 & 0 \\ 2 & 3 \end{bmatrix}A=1203,B=4102B = \begin{bmatrix} 4 & 1 \\ 0 & 2 \end{bmatrix}B=4012。手算 ABABAB 和 BABABA,验证两者不等。
- XXX 形状 100×8100 \times 8100×8(100 个样本、8 个特征),www 形状 8×18 \times 18×1。XwXwXw 的形状是什么?含义是什么?
- v=34v = \begin{bmatrix} 3 \\ 4 \end{bmatrix}v=34。计算 IvIvIv(I 是 2×22\times22×2 单位矩阵)和 vTvv^T vvTv。
- AAA 是 2×32 \times 32×3,BBB 是 3×43 \times 43×4。ABABAB 形状?BABABA 呢?
- 用形状规则解释:为什么 XTXX^T XXTX 一定是方阵?若 X 是 m×nm \times nm×n,XTXX^T XXTX 是几乘几?它和"每个特征的统计量"有什么关系(提示:对角线元素 = 每列的平方和)?
- (预习式思考)线性回归写成 y^=Xw\hat{y} = Xwy^=Xw。如果 m 个样本的真实值是向量 y,用第 3 章练习 7 的 MSE 定义写出它的矩阵形式。
练习答案
- AB=1×4+0×01×1+0×22×4+3×02×1+3×2=4188AB = \begin{bmatrix} 1\times4+0\times0 & 1\times1+0\times2 \\ 2\times4+3\times0 & 2\times1+3\times2 \end{bmatrix} = \begin{bmatrix} 4 & 1 \\ 8 & 8 \end{bmatrix}AB=1×4+0×02×4+3×01×1+0×22×1+3×2=4818;BA=1×4+1×2⋯BA = \begin{bmatrix} 1\times4+1\times2\cdots \end{bmatrix}BA=1×4+1×2⋯ 逐步算得 6346\begin{bmatrix} 6 & 3 \\ 4 & 6 \end{bmatrix}6436。确实不等。
- 100×1100 \times 1100×1:100 个样本各自的预测值,一次算完。
- Iv=34=vIv = \begin{bmatrix} 3 \\ 4 \end{bmatrix} = vIv=34=v(乘 I 不变);vTv=9+16=25v^T v = 9 + 16 = 25vTv=9+16=25(内积 = L2 范数平方)。
- ABABAB:2×42\times42×4。BABABA:(3×4)(2×3)(3\times4)(2\times3)(3×4)(2×3) 中间是 4 和 2,不相等------不可乘(维度不相容)。
- (m×n)T=n×m(m\times n)^T = n\times m(m×n)T=n×m,再乘 (m×n)(m\times n)(m×n):中间两个 m 相等,结果是 n×nn\times nn×n 方阵。对角线第 j 个元素 =∑ixij2= \sum_i x_{ij}^2=∑ixij2 = 第 j 个特征的平方和(未中心化时含均值信息)------协方差矩阵的骨架。
- MSE(w)=1m(Xw−y)T(Xw−y)\text{MSE}(w) = \frac{1}{m} (Xw - y)^T (Xw - y)MSE(w)=m1(Xw−y)T(Xw−y)。展开(用 (AB)T=BTAT(AB)^T = B^T A^T(AB)T=BTAT):1m(wTXTXw−2wTXTy+yTy)\frac{1}{m}\left(w^T X^T X w - 2 w^T X^T y + y^T y\right)m1(wTXTXw−2wTXTy+yTy)。你刚刚独立走完了正规方程推导的一半,第 11 章剩另一半。