本文是「Spring Boot + AI 全栈后端」系列第 04 篇。第 03 篇解决了「贵的模型被便宜问题白烧」的成本问题,这一篇换个方向:模型明明读懂了,后端却还是用不了它返回的东西。示例基于 Spring AI 2.0 / Boot 4.1(全部已通过测试)。
一个让后端很憋屈的场景
V哥 带学员做招聘系统实训时,总会先让他们去看一眼 HR 的日常工作:收到一封简历(PDF、Word、甚至邮件正文),人工把姓名、手机号、学历、工作年限、技能关键词、最近职位一个一个敲进表单,再点保存。一份简历平均两三分钟,一天几十份,眼睛看花了就串行、漏字段,录进去的脏数据后面还要返工清洗。
你肯定第一时间想到:让 AI 来读。于是你按第 02 篇的方式接了个对话接口,把简历文本丢给模型,问它「请提取姓名、手机号、学历、工作年限、技能」。
模型回了一大段:
这位候选人叫张伟,联系电话是 13800138000,邮箱 zhangwei@example.com。
他本科学历,有 6 年左右的 Java 后端开发经验,比较熟悉的技术包括 Java、Spring Boot 和 MySQL......
最近一份工作是某电商公司的高级后端工程师。读得准不准?准。但这段东西后端根本没法直接入库------它是一段自然语言,不是一条记录。于是现实里通常出现三种土办法,每一种都埋雷:
- 写正则 / 字符串截取:从文本里抠「姓名:」后面的内容。模型今天写「姓名:张伟」,明天写「这位候选人叫张伟」,正则直接失效;
- 在提示词里喊「请返回 JSON」 :模型确实返回 JSON 了,但字段名一会儿
name、一会儿姓名,yearsOfExperience有时是数字 6、有时是字符串 "6 年",反序列化照样炸; - 让模型输出后再调一次模型「请把上面的内容转成 JSON」:多一轮调用,多一份钱,多一次出错机会。
问题到这里就清楚了:不是模型不会读简历,是它的输出没有「形状」约束,下游没法稳定消费。V哥 做后端二十多年,这条规律反复被验证:凡是靠「约定」而不是靠「约束」的接口,早晚要在脏数据上栽跟头。我们要解决的,就是「让模型的输出必须长成我定义的样子」这件事。
解决思路:给它一份 JSON Schema,让它照着填
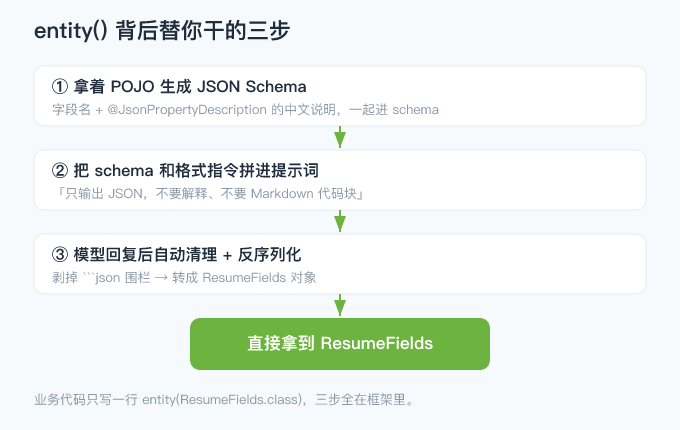
结构化输出(Structured Output)的思路很朴素:你先把想要的字段定义成一个 Java 类(POJO),框架拿着这个类自动生成一份 JSON Schema,把 schema 塞进提示词里告诉模型「你必须按这个格式输出」,拿到模型回复后再自动反序列化成 POJO。
对比一下就明白它好在哪:
| 做法 | 形状约束 | 字段类型 | 维护成本 |
|---|---|---|---|
| 提示词里喊「返回 JSON」 | 靠模型自觉 | 靠运气,数字可能变字符串 | 每次改字段都要改提示词 + 改解析 |
| 手写正则 | 无 | 全是字符串 | 模型换个说法就崩 |
| 结构化输出(schema 约束) | 框架强制 | 按 POJO 类型保证 | 只改 POJO,其它全自动化 |
Spring AI 里这件事只需要一个 .entity(ResumeFields.class)。下面按「定义字段 → 服务调用 → 脏数据防线 → 接口暴露」四步落地。
第一步:把字段定义成 POJO,注释写给模型看
先定义简历要抽哪些字段。这里最关键的一行不是字段本身,而是 @JsonPropertyDescription------它不是给程序员看的注释,是写给模型看的字段说明书 ,会被 Spring AI 的 JsonSchemaGenerator 读走,变成 JSON Schema 里的 description。
java
public record ResumeFields(

        @JsonPropertyDescription("候选人姓名,纯中文人名,不要带称谓")
        String name,

        @JsonPropertyDescription("手机号,11 位数字;没有就返回空字符串")
        String phone,

        @JsonPropertyDescription("邮箱地址;没有就返回空字符串")
        String email,

        @JsonPropertyDescription("最高学历,取值只能是:大专/本科/硕士/博士/其他")
        String education,

        @JsonPropertyDescription("工作年限,整数,不足一年按 0")
        Integer yearsOfExperience,

        @JsonPropertyDescription("技能关键词列表,最多 10 个,每个不超过 8 个字")
        List<String> skills,

        @JsonPropertyDescription("最近一段工作经历的职位名称")
        String latestTitle,

        @JsonPropertyDescription("一句话总结候选人,不超过 40 字")
        String summary) {

    /** 关键字段缺失时打人工复核标记,别让脏数据直接落库。 */
    public boolean needsReview() {
        return isBlank(name) || isBlank(latestTitle)
                || yearsOfExperience == null || yearsOfExperience < 0;
    }

    private static boolean isBlank(String s) {
        return s == null || s.trim().isEmpty();
    }
}
写这份 POJO 有三条经验,是 V哥 在项目里一条条试出来的:
- 取值要收敛:学历不要写「学历」,写「取值只能是:大专/本科/硕士/博士/其他」。模型的自由度给得越大,它给你的花样越多;
- 缺失要约定:找不到就「字符串填空串、数字填 0、列表填空数组」,不要让模型自己编------编出来的手机号比空值危险一百倍;
- 列表要给边界:「最多 10 个,每个不超过 8 个字」,否则技能列表能被它写成 30 个同义词。
本篇的测试里专门断言了 schema 的生成结果:converter.getFormat() 里既包含字段 yearsOfExperience,也包含我写的中文说明「工作年限」------说明这份说明书确实送到了模型面前。
第二步:服务里一行 entity(),三步活全包了
有了 POJO,服务层异常简单:
java
@Service
public class ResumeParserService {

    private static final String INSTRUCTION = """
            你是招聘系统的简历解析助手。请从下面的简历文本中抽取字段,严格按 JSON Schema 输出。
            规则:
            1. 只输出 JSON,不要任何解释、不要 Markdown 代码块;
            2. 文本里找不到的字段,字符串填空串、数字填 0、列表填空数组,不要自己编造;
            3. 工作年限按「截止到今天」折算成整数。

            简历文本:
            {resume}
            """;

    private final ChatClient chatClient;

    public ResumeParserService(ChatModel chatModel) {
        this.chatClient = ChatClient.create(chatModel);
    }

    public ResumeFields parse(String resumeText) {
        try {
            return chatClient.prompt()
                    .user(u -> u.text(INSTRUCTION).param("resume", resumeText))
                    .call()
                    .entity(ResumeFields.class);
        } catch (Exception ex) {
            throw new ResumeParseException("模型输出无法解析为简历字段,请转人工复核", ex);
        }
    }
}
别看只有一行 .entity(ResumeFields.class),它背后替你干了三步:
- 生成 schema :拿着
ResumeFields生成 JSON Schema(就是BeanOutputConverter干的事); - 注入提示词:把 schema 和一段格式指令拼到你的提示词后面。这段指令是框架内置的,大意是「只提供符合 RFC8259 的 JSON 响应、不要解释、不要 Markdown 代码块,输出必须遵循下面的 JSON Schema」;
- 反序列化 :模型返回文本后,自动剥掉可能的 Markdown 围栏、转成
ResumeFields对象。
想自己掌控这三步(比如想把 schema 打进日志排查、或是在流式场景里手动收尾),可以手动用 BeanOutputConverter:
java
BeanOutputConverter<ResumeFields> converter = new BeanOutputConverter<>(ResumeFields.class);
String format = converter.getFormat();   // 拿到带 schema 的格式指令,可注入任意提示词
ResumeFields fields = converter.convert(jsonText);  // 手动反序列化
日常用 entity(),需要定制提示词或排查 schema 时用 BeanOutputConverter------两者是同一套机制的两层封装,不是两套东西。
第三步:别信模型,留两道防线
结构化输出把「大概率对」变成了「基本可信」,但 AI 应用必须有兜底,这一节是本篇最该抄走的部分。
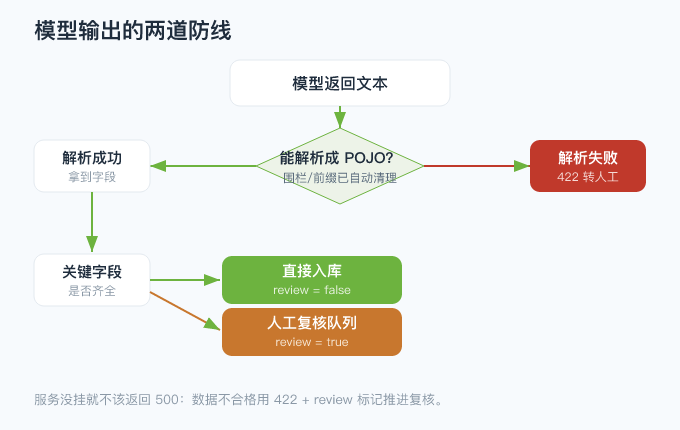
防线一:输出不干净也能救回来。 模型经常把 JSON 用 ```````json```` 代码块包起来,甚至带点「好的,以下是结果:」的前缀。Spring AI 内置了输出清理器,本篇测试专门模拟了这种情况------桩模型返回被 Markdown 围栏包裹的 JSON,entity() 照样解析出正确字段。所以别自己写正则去剥围栏,框架已经替你干了。
防线二:字段缺失要打复核标记,不要直接落库。 模型说「简历里没写手机号」时,正确做法不是把空值塞进数据库,而是标记这条数据需要人工看一眼:
java
public boolean needsReview() {
    return isBlank(name) || isBlank(latestTitle)
            || yearsOfExperience == null || yearsOfExperience < 0;
}
防线三:彻底解析不了要有明确出口。 模型偶尔会抽风返回「抱歉,我无法完成这个请求」。这时候不能让异常变成一堆堆栈甩给用户,包一层业务异常,再在全局异常处理器里转成能直接展示的响应:
java
/** 模型输出不合 schema:不是服务挂了,而是这条数据需要转人工,返回 422。 */
@ExceptionHandler(ResumeParseException.class)
public ResponseEntity<Map<String, String>> handleParseFailure(ResumeParseException ex) {
    return ResponseEntity.status(HttpStatus.UNPROCESSABLE_ENTITY)
            .body(Map.of("error", ex.getMessage(), "review", "true"));
}
注意这里返回的是 422(不可处理的实体)而不是 500 :服务没挂,是这条数据不合格。前端拿到 review = true,直接把这条简历推进「人工复核」队列,用户体验和反悔成本都最小。
第四步:接口暴露,控制器不碰模型
java
@RestController
@RequestMapping("/api/resume")
public class ResumeParseController {

    private final ResumeParserService parserService;

    public ResumeParseController(ResumeParserService parserService) {
        this.parserService = parserService;
    }

    @PostMapping("/parse")
    public ResponseEntity<ResumeParseResult> parse(@Valid @RequestBody ResumeParseRequest request) {
        ResumeFields fields = parserService.parse(request.resumeText());
        return ResponseEntity.ok(new ResumeParseResult(fields, fields.needsReview()));
    }
}
ResumeParseResult 只是把「结构化结果 + 是否要复核」打包出去:
java
public record ResumeParseResult(ResumeFields data, boolean review) {}控制器从头到尾没出现任何模型 API------模型在哪、用的哪档、schema 长什么样,它一概不知。这就是第 03 篇说的「业务只认抽象」在结构化场景里的延续。
怎么验证:离线也能跑通这套逻辑
外部 LLM 要密钥要联网,但要验证的是「schema 生成对不对、反序列化稳不稳、兜底逻辑好不好使」,用一个桩模型返回固定 JSON 就够了,重点验证这几件事:
| 测试 | 验证什么 |
|---|---|
parse_returnsStructuredFields |
发真实 HTTP,断言姓名/电话/学历/年限/技能/职位逐字段正确,review=false |
schemaIsGeneratedFromFieldDescriptions |
getFormat() 含「JSON Schema」、字段名和中文说明,证明说明书真的送到了模型 |
markdownWrappedJson_isStillParsed |
桩返回被 Markdown 围栏包裹的 JSON,照样解析成功 |
manualConverterMode_producesSameFields |
手动 BeanOutputConverter.convert() 与 entity() 结果一致 |
missingKeyFields_markedForManualReview |
关键字段为空 → needsReview() 为 true |
unparsableOutput_throwsResumeParseException |
模型返回非 JSON → 抛业务异常(→ 422) |
blankResumeText_returnsBadRequest |
简历文本为空 → 400 校验拦截 |
全程不需要任何真实密钥,也不依赖网络。
落地要点
- schema 别贪多:一次抽 20 个字段,模型的注意力被摊薄,每个字段的准确率都会掉。真要抽 20 个,拆成两次调用,一次抽「基本信息」、一次抽「项目经历」;
- 不确定就给「未知」:与其让模型猜,不如约定一个明确的兜底值,下游逻辑才好判断;
- schema 本身吃 token:字段越多、说明越长,每次调用都要多付这笔钱。说明写到「够约束」就停,别写小作文;
- 长简历先截断:超过模型上下文的简历要先切块或抽关键段落,别整本丢进去,否则又贵又慢;
- 合规要前置:简历是个人敏感信息,调用外部模型前确认对方的数据留存策略,必要时走私有化部署或脱敏(姓名、手机号先打码再解析)。V哥 给企业做方案时,这条永远是评审会上第一个要过的关。
最后一句:别再拿正则去抠模型说的话------把字段定义成 POJO,让 schema 逼着模型按你的形状输出,再留一道「解析不了就转人工」的出口,AI 才算真正接进了你的业务系统,而不是停在演示里。下一篇(05)V哥 带你解决更尴尬的一种情况:模型答不上实时数据,让它自己调你的 Java 方法去查订单和库存。