每个有一定年头的企业都有一两个"祖传系统":十年前的 SSH 或 ASP.NET 老项目,无文档、无测试、无源码注释,原班人马早已散伙。业务还在跑,需求还在提,但没人敢动代码------改一行,崩三处。推倒重建风险高、周期长、预算难批;继续维护等于持续失血。这一篇讲 geejing WebBuilder 快速开发平台为这类遗留系统提供的第三条路:渐进式接管。
一、为什么"推倒重建"大多失败
遗留系统的真实情况通常是:业务逻辑散落在几千个 JSP/代码文件、存储过程和没人记得的定时任务里;十年来打过的每一个补丁都是一次隐性需求,没有任何文档记录。推倒重建意味着要把这些隐性逻辑全部重新梳理------而梳理的成本往往超过新开发本身。更致命的是"平行运行期":新旧系统并行,数据双录,业务部门怨声载道,项目在上线前就被政治性地否决。
所以可行策略只有一个方向:让新系统长在老系统旁边,一个模块一个模块地接管,而不是一夜之间替换。这要求新平台具备两个能力:能直连老系统的数据库(共享数据资产),并且足够轻(每次只接管一个模块,投入可控)。geejing WebBuilder 快速开发平台两者兼备。
二、第一步:把老库登记进新平台
平台的元数据体系天然适配"接管"场景:老系统里的表不需要迁移,直接在平台的连接池里配上第二个数据源即可访问;表结构则在数据字典里登记一遍------而这一次登记,顺手就完成了十年来第一次系统性的数据字典梳理。
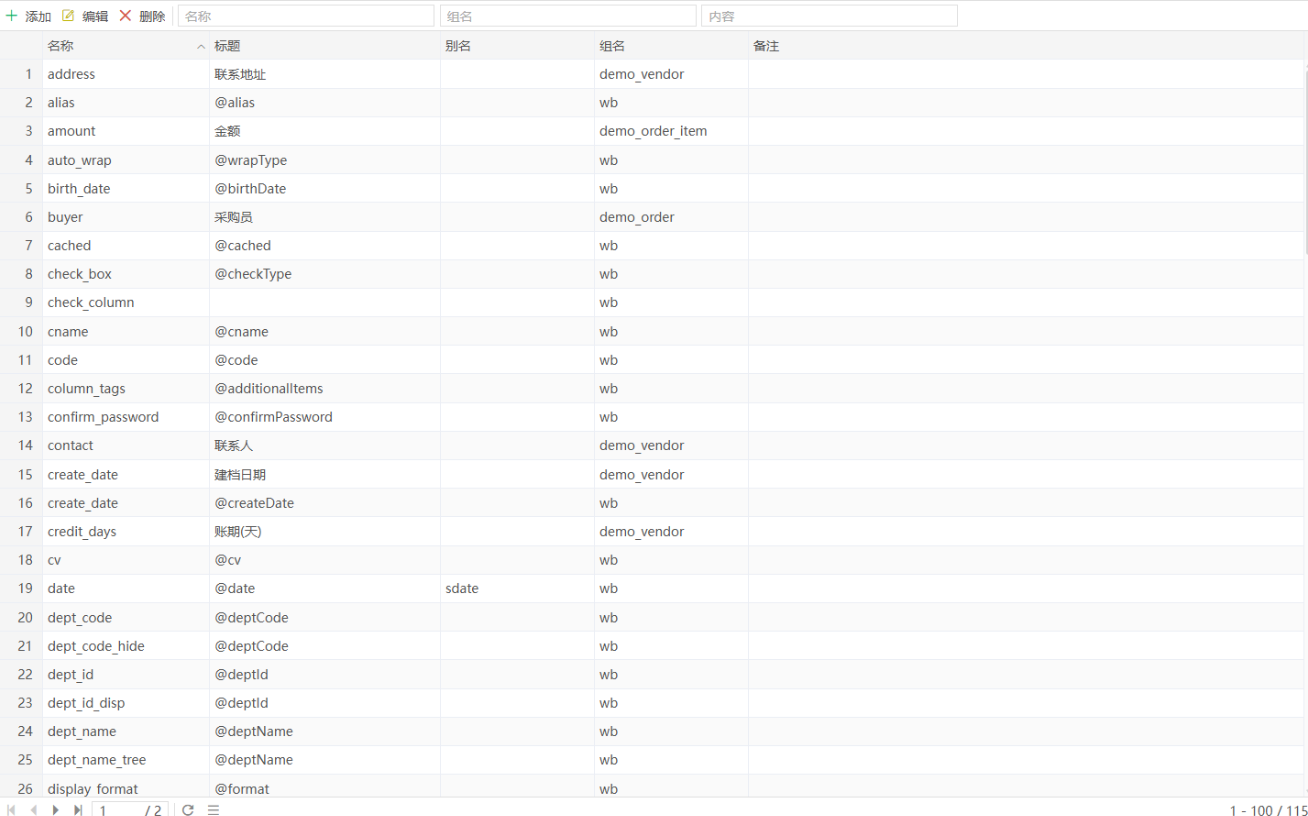
注意这个过程的双重价值:对业务侧,字典里每条 title、displayType、required 就是一份可读可评审的数据规格说明;对技术侧,keyName 关联的值字典把老库里那些含义不明的状态码(1、2、9)翻译成了人话。梳理字典的过程,就是把老系统隐性知识显性化的过程------这一步做完,即使后面不用新平台,企业也赚到了一份数据字典。
三、第二步:一个模块一个模块地接管
登记完字典,接管哪个模块、按什么顺序,可以完全按业务价值排优先级:先接报表(只读,零风险),再接录入(写老库,风险可控),最后接流程。只读报表的接管几乎是"零成本"的------平台支持字典驱动直接出页面,服务端一句 Wb.sendDict(sql, '老表名,分组,') 把元数据随数据下发,列表、表单、校验自动生成,页面里不需要写一行列定义:
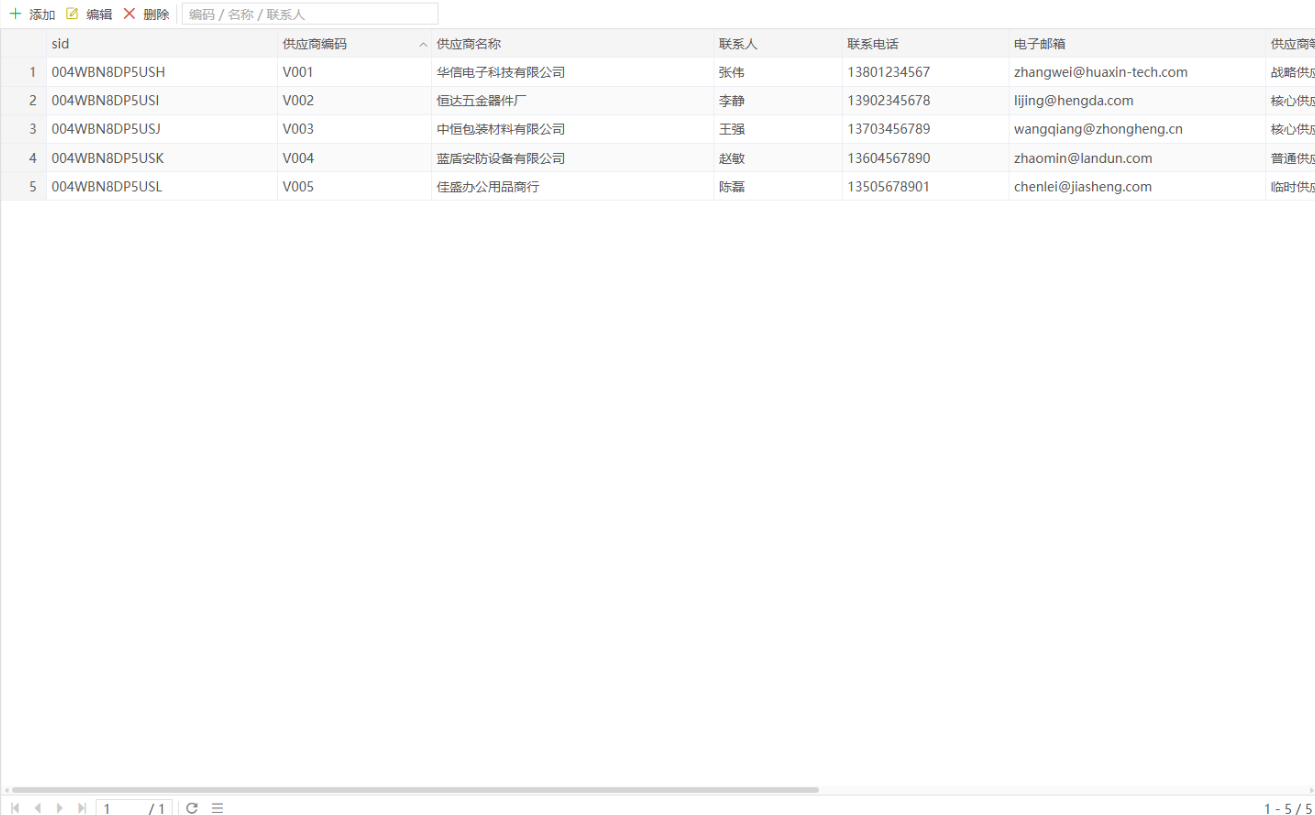
每次接管只上一个模块,业务部门平行验证一周,确认无误后老菜单下线。整个过程没有"大爆炸上线",没有双录期------因为新旧系统读写的是同一个数据库,数据天然一致。这在遗留系统改造里是决定性的优势:业务无感切换,回滚只是把菜单换回来。
四、第三步:新模块成为新的知识载体
接管的每个新模块,都是一个自解释的 .xwl 文件:组件树、属性、事件、服务端脚本全在明面上,能进版本库、能做 diff。老系统里"这个状态为什么置 9"的答案,可以写进模块的 remark 和字典的 groupTitle 里------新知识从第一天起就有宿主,不会再过十年又变成新的祖传黑盒。
对开发人员,平台的 IDE 提供了可视化的模块编辑与调试,读懂一个被接管模块的成本以分钟计。这在人员交接频繁的维护型团队里,价值不亚于开发效率本身。
五、给评估者的成本对照
把三条路线摆在同一张桌上比较:
|-------|-------------|--------------|-------|
| 路线 | 初期投入 | 风险 | 见效周期 |
| 推倒重建 | 最高(全量梳理+重建) | 极高(隐性逻辑遗失) | 以年计 |
| 原地修补 | 看似最低 | 持续累积(每改一次更脆) | 永远不到头 |
| 渐进式接管 | 按模块分摊 | 低(无并行期、可回滚) | 以周计 |
渐进式接管不是技术上的激进选择,而是组织上的稳妥选择:预算按模块立项,每一步都有独立可交付的成果,随时可以停在任意一个"够用"的状态。geejing WebBuilder 快速开发平台的多数据源接入、字典驱动页面、文件化模块,恰好是这条路线的全部技术前提。
六、一条可参考的接管时间线
把上面的策略落成时间表,一个中等复杂度的报表接管大致是这样推进的:
第 1 周:梳理与登记。 拉通老表的字段清单,和数据使用方逐字段确认含义(这一步常常惊心动魄------大量字段的业务含义连业务部门都说不清,只能靠翻历史数据反推),在平台字典里完成登记,同步补齐值字典把状态码翻译成人话。
第 2 周:页面与数据。 字典登记完成后,字典驱动的列表页面基本是"配置即所得";服务端补一段只读查询脚本对接老库,注意沿用老系统的过滤口径(老报表里的口径本身就是十年需求的化石层,照抄而不是"优化"------优化口径必须和业务方单独确认)。
第 3 周:平行核对与切换。 新老报表并行输出,逐行核对数字。对不上的每一处差额都是一个被发现的隐性逻辑,回到字典或脚本里修正。数字全对上的那一天,老菜单下线,接管完成。
三个模块的接管量,一个中级工程师一个月内可以完成------这还不算第 2 周顺手沉淀下来的数据字典文档的价值。风险最高的其实不是技术,而是"梳理含义"这一步对业务部门的占用时间,所以立项时要明确:业务部门的确认义务写进计划,而不是指望他们随叫随到。
七、什么时候不该选这条路
保持诚实:渐进式接管也不是万能的。三种情况下要慎重------
- 老库数据模型已经烂到根上:比如主键不唯一、大量冗余互不同步的重复表。这时接管的每一个新模块都在继承垃圾模型,应先做数据治理而不是直接上页面;
- 老系统厂商还在且收费维护:如果厂商合同还在、响应还行,接管的性价比要重新算------除非合同即将到期或厂商响应已经名存实亡;
- 业务方全程不参与:字典梳理需要业务部门投入确认时间,如果对方连字段含义都不肯确认,说明接管的政治条件还不成熟,硬推只会做出第二个没人认账的系统。
判断标准一句话:渐进式接管救的是"系统老但数据还好"的场景;数据本身坏了,先治病,后接管。
七、小结
遗留系统的出路不在"重建 vs 维修"的二选一里,而在"登记字典 → 按价值逐模块接管 → 新模块沉淀知识"的渐进路线里。平台的元数据体系在这条路线里身兼三职:页面生成器、数据字典文档、以及老系统隐性知识的显性化工具。下一篇转向企业 IT 团队自身的组织问题:全栈难招、人才单点,怎么破。