前言
- 最近在准备
VLA以及以图像作为输入的强化学习任务,其中反复出现的一个前置问题是:一张RGB(Red Green Blue,红绿蓝三通道)图像,究竟是如何被转换成网络可用的视觉特征的 - 本文从
ResNet18的结构出发,说明它如何把一张图像逐级转换为视觉特征(Visual Features),以及这些特征为什么可以作为下游任务的输入 - 为使整条链路可验证,本文会在
CIFAR-10上完整训练一次ResNet18,再用训练好的模型完成三个特征可视化任务:Feature Map可视化 、512 维特征展示 与Feature Space可视化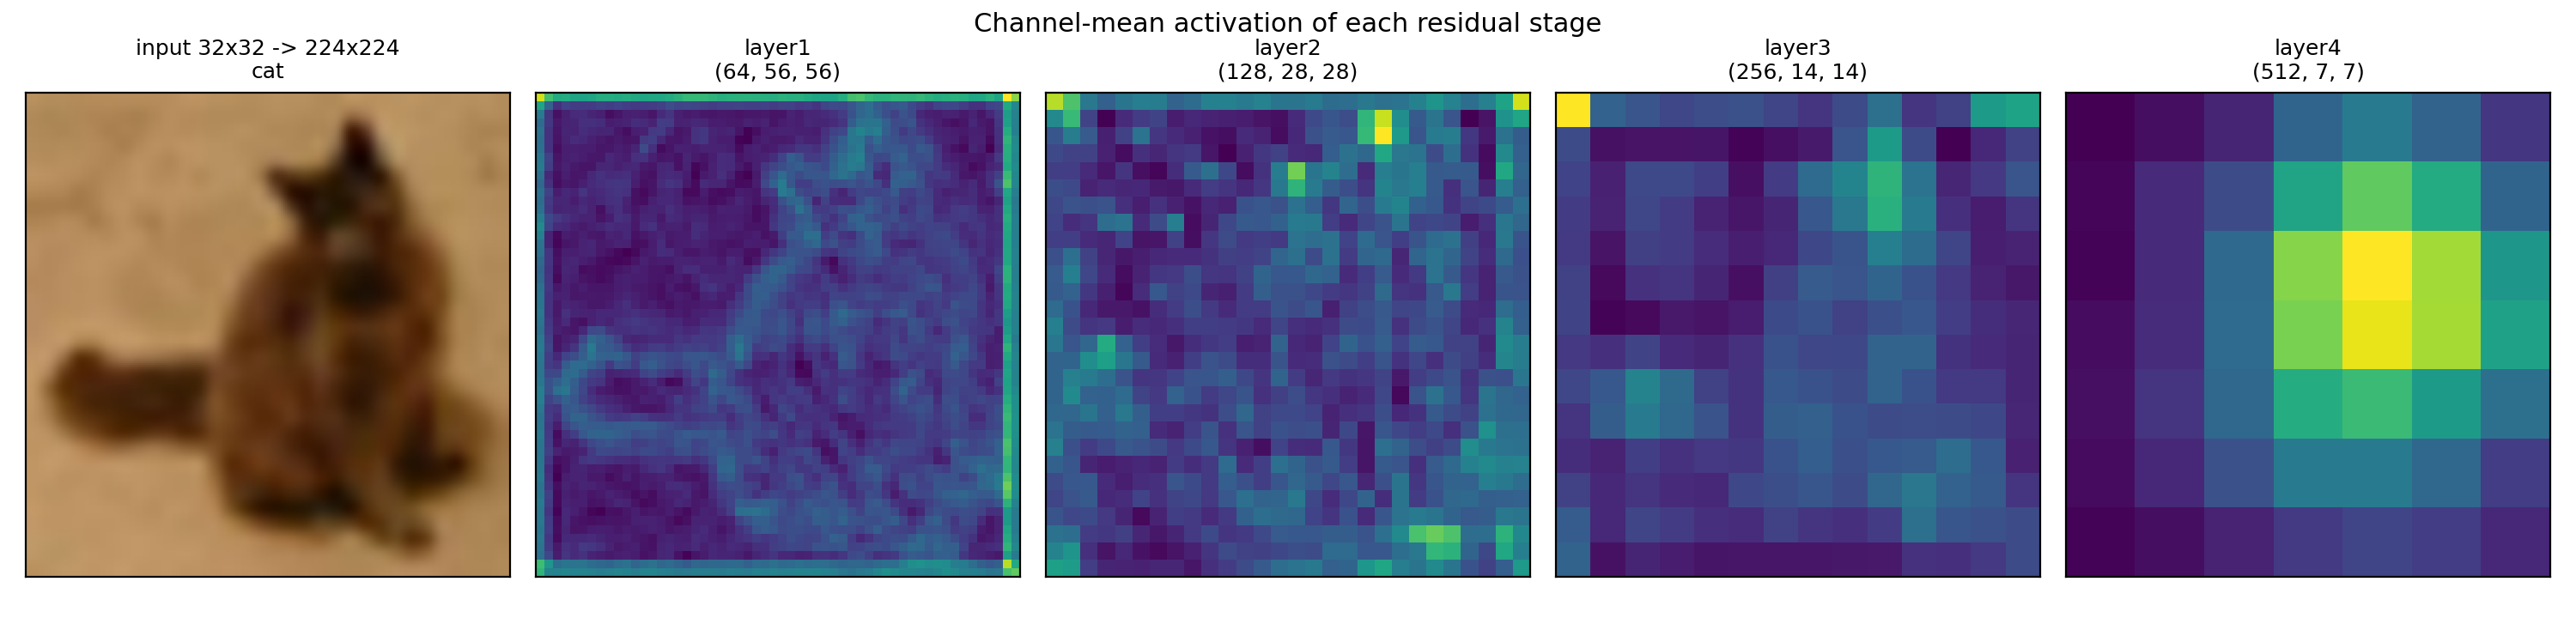
1 CNN的基础与困境
- 在进入
ResNet之前,先回顾卷积神经网络提取视觉特征的基本方式
1-1 CNN如何提取视觉特征
CNN(Convolutional Neural Network,卷积神经网络)最初被提出,主要是为了解决将图像直接输入全连接网络所带来的参数量过大、空间结构难以利用等问题。- 其核心是通过不断堆叠卷积层,并配合池化或步幅卷积,逐级降低特征图的空间分辨率、增加通道数,从而提取越来越抽象的视觉特征
#mermaid-svg-KAJa7dW79Mf0P0vP{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-KAJa7dW79Mf0P0vP .error-icon{fill:#552222;}#mermaid-svg-KAJa7dW79Mf0P0vP .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-KAJa7dW79Mf0P0vP .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-KAJa7dW79Mf0P0vP .marker{fill:#333333;stroke:#333333;}#mermaid-svg-KAJa7dW79Mf0P0vP .marker.cross{stroke:#333333;}#mermaid-svg-KAJa7dW79Mf0P0vP svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-KAJa7dW79Mf0P0vP p{margin:0;}#mermaid-svg-KAJa7dW79Mf0P0vP .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster-label text{fill:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster-label span{color:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster-label span p{background-color:transparent;}#mermaid-svg-KAJa7dW79Mf0P0vP .label text,#mermaid-svg-KAJa7dW79Mf0P0vP span{fill:#333;color:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP .node rect,#mermaid-svg-KAJa7dW79Mf0P0vP .node circle,#mermaid-svg-KAJa7dW79Mf0P0vP .node ellipse,#mermaid-svg-KAJa7dW79Mf0P0vP .node polygon,#mermaid-svg-KAJa7dW79Mf0P0vP .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-KAJa7dW79Mf0P0vP .rough-node .label text,#mermaid-svg-KAJa7dW79Mf0P0vP .node .label text,#mermaid-svg-KAJa7dW79Mf0P0vP .image-shape .label,#mermaid-svg-KAJa7dW79Mf0P0vP .icon-shape .label{text-anchor:middle;}#mermaid-svg-KAJa7dW79Mf0P0vP .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-KAJa7dW79Mf0P0vP .rough-node .label,#mermaid-svg-KAJa7dW79Mf0P0vP .node .label,#mermaid-svg-KAJa7dW79Mf0P0vP .image-shape .label,#mermaid-svg-KAJa7dW79Mf0P0vP .icon-shape .label{text-align:center;}#mermaid-svg-KAJa7dW79Mf0P0vP .node.clickable{cursor:pointer;}#mermaid-svg-KAJa7dW79Mf0P0vP .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-KAJa7dW79Mf0P0vP .arrowheadPath{fill:#333333;}#mermaid-svg-KAJa7dW79Mf0P0vP .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-KAJa7dW79Mf0P0vP .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-KAJa7dW79Mf0P0vP .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-KAJa7dW79Mf0P0vP .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-KAJa7dW79Mf0P0vP .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-KAJa7dW79Mf0P0vP .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster text{fill:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP .cluster span{color:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-KAJa7dW79Mf0P0vP .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-KAJa7dW79Mf0P0vP rect.text{fill:none;stroke-width:0;}#mermaid-svg-KAJa7dW79Mf0P0vP .icon-shape,#mermaid-svg-KAJa7dW79Mf0P0vP .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-KAJa7dW79Mf0P0vP .icon-shape p,#mermaid-svg-KAJa7dW79Mf0P0vP .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-KAJa7dW79Mf0P0vP .icon-shape .label rect,#mermaid-svg-KAJa7dW79Mf0P0vP .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-KAJa7dW79Mf0P0vP .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-KAJa7dW79Mf0P0vP .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-KAJa7dW79Mf0P0vP :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Input 输入图像
Conv2d 卷积
Feature Map 特征图
Conv2d 卷积
Feature Map 特征图
Pooling / Stride 下采样
更小的 Spatial Resolution
更大的 Channel
更抽象的视觉特征
- 这条路径上存在一条稳定的规律:空间信息持续减少,通道信息持续增加
- 低层特征图分辨率高、通道数少,响应的是边缘、纹理、颜色等局部信息
- 高层特征图分辨率低、通道数多,响应的是部件、物体、语义等全局信息
说人话:卷积网络完成的工作,是把一张按像素排布的图像,逐步转换成一组按语义排布的向量
- 这个转换过程可以用一个最朴素的
CNN说明
python
import torch.nn as nn


class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()

        self.features = nn.Sequential(
            # stride=2 代替池化,每次把空间尺寸减半、通道数翻倍
            nn.Conv2d(3, 32, 3, stride=2, padding=1),
            nn.ReLU(),

            nn.Conv2d(32, 64, 3, stride=2, padding=1),
            nn.ReLU(),

            nn.Conv2d(64, 128, 3, stride=2, padding=1),
            nn.ReLU(),
        )

    def forward(self, x):
return self.features(x)- 其中:
3 到 32:卷积核数量是 32 个,因此输出 32 个特征通道3×3:每个卷积核观察局部3×3区域stride=2:卷积核每次移动 2 个像素,因此空间尺寸大约减半padding=1:在边缘补 1 圈像素,使尺寸计算比较规整
python
Conv2d(
    输入通道 = 3,
    输出通道 = 32,
    卷积核 = 3×3,
    stride = 2,
    padding = 1
)- 也就是输入一张
3 × 224 × 224的图像,经过三层CNN之后输出128 × 28 × 28- 空间尺寸由
224降至28,通道数由3升至128,与上面那条规律一致
- 空间尺寸由
- 也就是说,
CNN正是在空间信息压缩与通道信息扩展的交替过程中,逐级获得更高级的视觉表示
1-2 深层CNN的问题
- 随着 CNN 深度增加,特征图通常会"空间上越来越粗,语义上越来越深"。
- 既然加深网络能够提升表达能力,那么层数是否越多越好?
- 从理论上的表达能力来看,更深的网络并不会因为增加层数而变差。 但在实际训练中,网络加深后会出现明显的优化困难。
#mermaid-svg-97rKQayEyLEZDRMA{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-97rKQayEyLEZDRMA .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-97rKQayEyLEZDRMA .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-97rKQayEyLEZDRMA .error-icon{fill:#552222;}#mermaid-svg-97rKQayEyLEZDRMA .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-97rKQayEyLEZDRMA .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-97rKQayEyLEZDRMA .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-97rKQayEyLEZDRMA .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-97rKQayEyLEZDRMA .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-97rKQayEyLEZDRMA .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-97rKQayEyLEZDRMA .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-97rKQayEyLEZDRMA .marker{fill:#333333;stroke:#333333;}#mermaid-svg-97rKQayEyLEZDRMA .marker.cross{stroke:#333333;}#mermaid-svg-97rKQayEyLEZDRMA svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-97rKQayEyLEZDRMA p{margin:0;}#mermaid-svg-97rKQayEyLEZDRMA .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-97rKQayEyLEZDRMA .cluster-label text{fill:#333;}#mermaid-svg-97rKQayEyLEZDRMA .cluster-label span{color:#333;}#mermaid-svg-97rKQayEyLEZDRMA .cluster-label span p{background-color:transparent;}#mermaid-svg-97rKQayEyLEZDRMA .label text,#mermaid-svg-97rKQayEyLEZDRMA span{fill:#333;color:#333;}#mermaid-svg-97rKQayEyLEZDRMA .node rect,#mermaid-svg-97rKQayEyLEZDRMA .node circle,#mermaid-svg-97rKQayEyLEZDRMA .node ellipse,#mermaid-svg-97rKQayEyLEZDRMA .node polygon,#mermaid-svg-97rKQayEyLEZDRMA .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-97rKQayEyLEZDRMA .rough-node .label text,#mermaid-svg-97rKQayEyLEZDRMA .node .label text,#mermaid-svg-97rKQayEyLEZDRMA .image-shape .label,#mermaid-svg-97rKQayEyLEZDRMA .icon-shape .label{text-anchor:middle;}#mermaid-svg-97rKQayEyLEZDRMA .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-97rKQayEyLEZDRMA .rough-node .label,#mermaid-svg-97rKQayEyLEZDRMA .node .label,#mermaid-svg-97rKQayEyLEZDRMA .image-shape .label,#mermaid-svg-97rKQayEyLEZDRMA .icon-shape .label{text-align:center;}#mermaid-svg-97rKQayEyLEZDRMA .node.clickable{cursor:pointer;}#mermaid-svg-97rKQayEyLEZDRMA .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-97rKQayEyLEZDRMA .arrowheadPath{fill:#333333;}#mermaid-svg-97rKQayEyLEZDRMA .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-97rKQayEyLEZDRMA .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-97rKQayEyLEZDRMA .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-97rKQayEyLEZDRMA .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-97rKQayEyLEZDRMA .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-97rKQayEyLEZDRMA .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-97rKQayEyLEZDRMA .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-97rKQayEyLEZDRMA .cluster text{fill:#333;}#mermaid-svg-97rKQayEyLEZDRMA .cluster span{color:#333;}#mermaid-svg-97rKQayEyLEZDRMA div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-97rKQayEyLEZDRMA .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-97rKQayEyLEZDRMA rect.text{fill:none;stroke-width:0;}#mermaid-svg-97rKQayEyLEZDRMA .icon-shape,#mermaid-svg-97rKQayEyLEZDRMA .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-97rKQayEyLEZDRMA .icon-shape p,#mermaid-svg-97rKQayEyLEZDRMA .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-97rKQayEyLEZDRMA .icon-shape .label rect,#mermaid-svg-97rKQayEyLEZDRMA .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-97rKQayEyLEZDRMA .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-97rKQayEyLEZDRMA .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-97rKQayEyLEZDRMA :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 网络变深
理论上表达能力增强
但实际训练越来越困难
出现梯度传播、优化困难等问题
甚至更深的网络训练误差反而变高
ResNet
- ResNet 讨论的是一种假设场景 :假设某个网络层经过训练后,最理想的目标是让输入保持不变,也就是H(x)=xH(x)=xH(x)=x,其中的H(x)H(x)H(x)表示这一堆卷积层最终对输入xxx做出的完整变换
- 但是普通 CNN 要做到这一点,网络越深,需要共同协调的层越多,这个恒等映射就越难优化出来。
说人话:假设这一层其实什么都不用做,输入什么就输出什么。普通 CNN 得让里面好几层卷积"配合起来",最终做到 输入 xxx,输出仍是xxx。网络越深,需要配合的层越多,这件事就越难训练。
ResNet原论文重点讨论了这种现象,即退化问题(degradation problem) : 随着网络不断加深,训练误差反而可能上升 。例如原论文实验中,56 层网络的训练误差高于 20 层网络。- 退化的原因在于:网络层数增加后,优化问题变得更加困难,传统网络难以有效学习各层之间的映射关系,导致新增的网络层无法得到有效训练。
- 因此,虽然网络变深后表达能力更强,但实际训练出来的模型反而可能具有更高的训练误差。
- ResNet 针对这一问题,引入了残差连接(Residual Connection),让网络学习残差映射,而不是直接学习完整映射,从而降低深层网络的优化难度。
2 ResNet
2-1 ResNet介绍
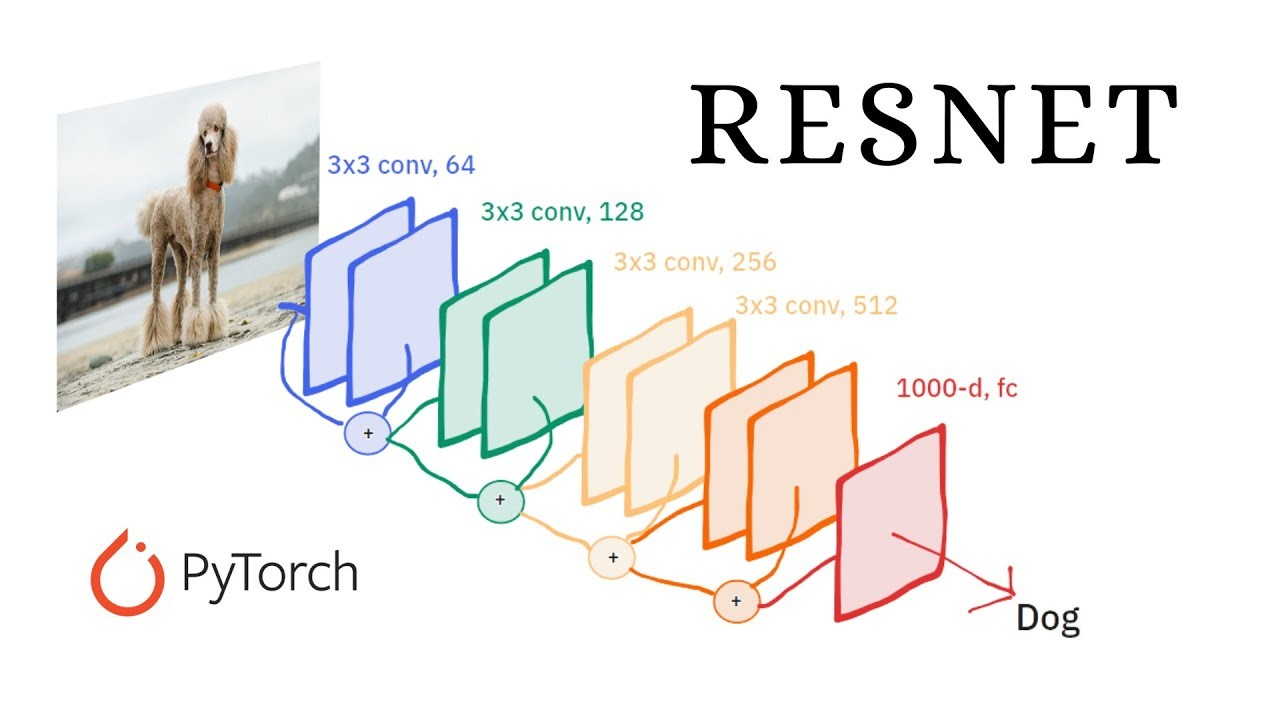
-
ResNet最初提出时,主要针对的正是深层CNN在图像识别任务中的训练困难 -
原始论文为 2015 年的 《Deep Residual Learning for Image Recognition》
-
其核心论点是:网络加深之后,性能不应仅仅因为层数增加而下降
-
为此作者提出残差学习(Residual Learning) ,把原先让网络直接拟合目标映射H(x)H(x)H(x)的做法,改为拟合残差:
y=F(x)+x\boxed{y=F(x)+x}y=F(x)+x
- 以防你忘记:
- xxx:该层的输入,即恒等映射(identity) 支路上的信号
- F(x)F(x)F(x):主干卷积支路学到的残差
- yyy:该层的输出
- 这样一来,网络不需要从零学出
H(x),只需要学出H(x) - x这一增量
说人话:让网络学习"需要改变多少",而不是学习"完整的结果是什么"。
- 若最优解本身就是恒等映射,只需把F(x)F(x)F(x)的权重压到 0 即可实现,这远比让多个非线性层拼出恒等映射容易
- 从优化的角度看,残差连接为输入提供了一条直接的 Shortcut 通路,使网络即使在新增层尚未学到有效残差时,也能够保留原有特征信息,从而显著降低深层网络的优化难度。
#mermaid-svg-aTKKoAavSZNDqeGU{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-aTKKoAavSZNDqeGU .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-aTKKoAavSZNDqeGU .error-icon{fill:#552222;}#mermaid-svg-aTKKoAavSZNDqeGU .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-aTKKoAavSZNDqeGU .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-aTKKoAavSZNDqeGU .marker{fill:#333333;stroke:#333333;}#mermaid-svg-aTKKoAavSZNDqeGU .marker.cross{stroke:#333333;}#mermaid-svg-aTKKoAavSZNDqeGU svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-aTKKoAavSZNDqeGU p{margin:0;}#mermaid-svg-aTKKoAavSZNDqeGU .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-aTKKoAavSZNDqeGU .cluster-label text{fill:#333;}#mermaid-svg-aTKKoAavSZNDqeGU .cluster-label span{color:#333;}#mermaid-svg-aTKKoAavSZNDqeGU .cluster-label span p{background-color:transparent;}#mermaid-svg-aTKKoAavSZNDqeGU .label text,#mermaid-svg-aTKKoAavSZNDqeGU span{fill:#333;color:#333;}#mermaid-svg-aTKKoAavSZNDqeGU .node rect,#mermaid-svg-aTKKoAavSZNDqeGU .node circle,#mermaid-svg-aTKKoAavSZNDqeGU .node ellipse,#mermaid-svg-aTKKoAavSZNDqeGU .node polygon,#mermaid-svg-aTKKoAavSZNDqeGU .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-aTKKoAavSZNDqeGU .rough-node .label text,#mermaid-svg-aTKKoAavSZNDqeGU .node .label text,#mermaid-svg-aTKKoAavSZNDqeGU .image-shape .label,#mermaid-svg-aTKKoAavSZNDqeGU .icon-shape .label{text-anchor:middle;}#mermaid-svg-aTKKoAavSZNDqeGU .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-aTKKoAavSZNDqeGU .rough-node .label,#mermaid-svg-aTKKoAavSZNDqeGU .node .label,#mermaid-svg-aTKKoAavSZNDqeGU .image-shape .label,#mermaid-svg-aTKKoAavSZNDqeGU .icon-shape .label{text-align:center;}#mermaid-svg-aTKKoAavSZNDqeGU .node.clickable{cursor:pointer;}#mermaid-svg-aTKKoAavSZNDqeGU .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-aTKKoAavSZNDqeGU .arrowheadPath{fill:#333333;}#mermaid-svg-aTKKoAavSZNDqeGU .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-aTKKoAavSZNDqeGU .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-aTKKoAavSZNDqeGU .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-aTKKoAavSZNDqeGU .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-aTKKoAavSZNDqeGU .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-aTKKoAavSZNDqeGU .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-aTKKoAavSZNDqeGU .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-aTKKoAavSZNDqeGU .cluster text{fill:#333;}#mermaid-svg-aTKKoAavSZNDqeGU .cluster span{color:#333;}#mermaid-svg-aTKKoAavSZNDqeGU div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-aTKKoAavSZNDqeGU .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-aTKKoAavSZNDqeGU rect.text{fill:none;stroke-width:0;}#mermaid-svg-aTKKoAavSZNDqeGU .icon-shape,#mermaid-svg-aTKKoAavSZNDqeGU .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-aTKKoAavSZNDqeGU .icon-shape p,#mermaid-svg-aTKKoAavSZNDqeGU .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-aTKKoAavSZNDqeGU .icon-shape .label rect,#mermaid-svg-aTKKoAavSZNDqeGU .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-aTKKoAavSZNDqeGU .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-aTKKoAavSZNDqeGU .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-aTKKoAavSZNDqeGU :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 输入 x
残差分支 F(x)
Shortcut
⊕
输出 y = F(x) + x
- 下图为最简形式的残差单元
#mermaid-svg-pR7kTReZdPQoQ5rX{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-pR7kTReZdPQoQ5rX .error-icon{fill:#552222;}#mermaid-svg-pR7kTReZdPQoQ5rX .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-pR7kTReZdPQoQ5rX .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-pR7kTReZdPQoQ5rX .marker{fill:#333333;stroke:#333333;}#mermaid-svg-pR7kTReZdPQoQ5rX .marker.cross{stroke:#333333;}#mermaid-svg-pR7kTReZdPQoQ5rX svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-pR7kTReZdPQoQ5rX p{margin:0;}#mermaid-svg-pR7kTReZdPQoQ5rX .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster-label text{fill:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster-label span{color:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster-label span p{background-color:transparent;}#mermaid-svg-pR7kTReZdPQoQ5rX .label text,#mermaid-svg-pR7kTReZdPQoQ5rX span{fill:#333;color:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX .node rect,#mermaid-svg-pR7kTReZdPQoQ5rX .node circle,#mermaid-svg-pR7kTReZdPQoQ5rX .node ellipse,#mermaid-svg-pR7kTReZdPQoQ5rX .node polygon,#mermaid-svg-pR7kTReZdPQoQ5rX .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-pR7kTReZdPQoQ5rX .rough-node .label text,#mermaid-svg-pR7kTReZdPQoQ5rX .node .label text,#mermaid-svg-pR7kTReZdPQoQ5rX .image-shape .label,#mermaid-svg-pR7kTReZdPQoQ5rX .icon-shape .label{text-anchor:middle;}#mermaid-svg-pR7kTReZdPQoQ5rX .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-pR7kTReZdPQoQ5rX .rough-node .label,#mermaid-svg-pR7kTReZdPQoQ5rX .node .label,#mermaid-svg-pR7kTReZdPQoQ5rX .image-shape .label,#mermaid-svg-pR7kTReZdPQoQ5rX .icon-shape .label{text-align:center;}#mermaid-svg-pR7kTReZdPQoQ5rX .node.clickable{cursor:pointer;}#mermaid-svg-pR7kTReZdPQoQ5rX .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-pR7kTReZdPQoQ5rX .arrowheadPath{fill:#333333;}#mermaid-svg-pR7kTReZdPQoQ5rX .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-pR7kTReZdPQoQ5rX .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-pR7kTReZdPQoQ5rX .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-pR7kTReZdPQoQ5rX .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-pR7kTReZdPQoQ5rX .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-pR7kTReZdPQoQ5rX .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster text{fill:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX .cluster span{color:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-pR7kTReZdPQoQ5rX .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-pR7kTReZdPQoQ5rX rect.text{fill:none;stroke-width:0;}#mermaid-svg-pR7kTReZdPQoQ5rX .icon-shape,#mermaid-svg-pR7kTReZdPQoQ5rX .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-pR7kTReZdPQoQ5rX .icon-shape p,#mermaid-svg-pR7kTReZdPQoQ5rX .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-pR7kTReZdPQoQ5rX .icon-shape .label rect,#mermaid-svg-pR7kTReZdPQoQ5rX .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-pR7kTReZdPQoQ5rX .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-pR7kTReZdPQoQ5rX .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-pR7kTReZdPQoQ5rX :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 输入 x
Conv 3x3
ReLU
Conv 3x3
逐元素相加 Add
F(x) + x
- 图中包含两条支路:主干卷积支路负责拟合F(x)F(x)F(x),恒等映射支路把xxx直接送至相加处
- 两条支路的输出在
Add节点逐元素相加后传给下一层
- 两条支路的输出在
- 需要注意的是,相加之后还需要一次
ReLU(Rectified Linear Unit,修正线性单元),完整的BasicBlock将在 3-4 节展开
2-2 ResNet整体架构
ResNet最初作为图像识别模型提出,但在实际应用中,其前部的特征提取部分常被用作Backbone,向下游任务提供视觉特征- 因此可以把
ResNet划分成两段来理解
#mermaid-svg-t6RWsVJiMygol1OZ{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-t6RWsVJiMygol1OZ .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-t6RWsVJiMygol1OZ .error-icon{fill:#552222;}#mermaid-svg-t6RWsVJiMygol1OZ .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-t6RWsVJiMygol1OZ .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-t6RWsVJiMygol1OZ .marker{fill:#333333;stroke:#333333;}#mermaid-svg-t6RWsVJiMygol1OZ .marker.cross{stroke:#333333;}#mermaid-svg-t6RWsVJiMygol1OZ svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-t6RWsVJiMygol1OZ p{margin:0;}#mermaid-svg-t6RWsVJiMygol1OZ .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-t6RWsVJiMygol1OZ .cluster-label text{fill:#333;}#mermaid-svg-t6RWsVJiMygol1OZ .cluster-label span{color:#333;}#mermaid-svg-t6RWsVJiMygol1OZ .cluster-label span p{background-color:transparent;}#mermaid-svg-t6RWsVJiMygol1OZ .label text,#mermaid-svg-t6RWsVJiMygol1OZ span{fill:#333;color:#333;}#mermaid-svg-t6RWsVJiMygol1OZ .node rect,#mermaid-svg-t6RWsVJiMygol1OZ .node circle,#mermaid-svg-t6RWsVJiMygol1OZ .node ellipse,#mermaid-svg-t6RWsVJiMygol1OZ .node polygon,#mermaid-svg-t6RWsVJiMygol1OZ .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-t6RWsVJiMygol1OZ .rough-node .label text,#mermaid-svg-t6RWsVJiMygol1OZ .node .label text,#mermaid-svg-t6RWsVJiMygol1OZ .image-shape .label,#mermaid-svg-t6RWsVJiMygol1OZ .icon-shape .label{text-anchor:middle;}#mermaid-svg-t6RWsVJiMygol1OZ .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-t6RWsVJiMygol1OZ .rough-node .label,#mermaid-svg-t6RWsVJiMygol1OZ .node .label,#mermaid-svg-t6RWsVJiMygol1OZ .image-shape .label,#mermaid-svg-t6RWsVJiMygol1OZ .icon-shape .label{text-align:center;}#mermaid-svg-t6RWsVJiMygol1OZ .node.clickable{cursor:pointer;}#mermaid-svg-t6RWsVJiMygol1OZ .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-t6RWsVJiMygol1OZ .arrowheadPath{fill:#333333;}#mermaid-svg-t6RWsVJiMygol1OZ .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-t6RWsVJiMygol1OZ .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-t6RWsVJiMygol1OZ .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-t6RWsVJiMygol1OZ .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-t6RWsVJiMygol1OZ .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-t6RWsVJiMygol1OZ .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-t6RWsVJiMygol1OZ .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-t6RWsVJiMygol1OZ .cluster text{fill:#333;}#mermaid-svg-t6RWsVJiMygol1OZ .cluster span{color:#333;}#mermaid-svg-t6RWsVJiMygol1OZ div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-t6RWsVJiMygol1OZ .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-t6RWsVJiMygol1OZ rect.text{fill:none;stroke-width:0;}#mermaid-svg-t6RWsVJiMygol1OZ .icon-shape,#mermaid-svg-t6RWsVJiMygol1OZ .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-t6RWsVJiMygol1OZ .icon-shape p,#mermaid-svg-t6RWsVJiMygol1OZ .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-t6RWsVJiMygol1OZ .icon-shape .label rect,#mermaid-svg-t6RWsVJiMygol1OZ .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-t6RWsVJiMygol1OZ .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-t6RWsVJiMygol1OZ .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-t6RWsVJiMygol1OZ :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} ResNet
Backbone 主干
分类头
视觉特征 Feature
Linear 全连接
类别
可以拿给其他任务
- 上半段的
Backbone输出视觉特征,下半段的分类头把特征映射为类别- 本文后续工作的本质,就是只保留
Backbone并舍弃分类头
- 本文后续工作的本质,就是只保留
- 在
PyTorch中这两段的划分十分明确:Backbone是fc之前的全部层,分类头即最后一个nn.Linear
python
from torchvision.models import resnet18

model = resnet18(weights=None)

# 分类头就是最后这个全连接层
print(model.fc)          # Linear(in_features=512, out_features=1000, bias=True)

# 主干输出的特征维度,就是 fc 的输入维度
print(model.fc.in_features) # 512- 这里出现的
512并非任意取值,它由ResNet18的结构决定,3-6 节将给出完整推导
2-3 ResNet的实际用途
ResNet并不一定直接输出最终任务结果- 在很多任务中,只使用其
Backbone部分,把输出的视觉特征交给后续网络
| 方向 | ResNet 用途 |
|---|---|
| VLA(Vision-Language-Action,视觉语言动作模型) | 作为Vision Encoder或Backbone |
| 视觉强化学习 | 图像经CNN或ResNet送入Policy与Value网络 |
| 机器人抓取 | RGB或RGB-D输入得到视觉特征 |
| 目标检测 | 作为检测器的Backbone |
| 语义与实例分割 | 作为分割头的Backbone |
| 多模态 | 作为Image Encoder |
- 这些任务的上游输入形态差异很大,但它们对
Backbone的要求是一致的:把图像压缩成一组稠密且带有语义的向量 - 这正是本文后三章要定量验证的性质
2-4 ResNet家族
ResNet并非单一网络,而是一个网络家族
#mermaid-svg-suARcX7bYwRu5Vxg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-suARcX7bYwRu5Vxg .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-suARcX7bYwRu5Vxg .error-icon{fill:#552222;}#mermaid-svg-suARcX7bYwRu5Vxg .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-suARcX7bYwRu5Vxg .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-suARcX7bYwRu5Vxg .marker{fill:#333333;stroke:#333333;}#mermaid-svg-suARcX7bYwRu5Vxg .marker.cross{stroke:#333333;}#mermaid-svg-suARcX7bYwRu5Vxg svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-suARcX7bYwRu5Vxg p{margin:0;}#mermaid-svg-suARcX7bYwRu5Vxg .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-suARcX7bYwRu5Vxg .cluster-label text{fill:#333;}#mermaid-svg-suARcX7bYwRu5Vxg .cluster-label span{color:#333;}#mermaid-svg-suARcX7bYwRu5Vxg .cluster-label span p{background-color:transparent;}#mermaid-svg-suARcX7bYwRu5Vxg .label text,#mermaid-svg-suARcX7bYwRu5Vxg span{fill:#333;color:#333;}#mermaid-svg-suARcX7bYwRu5Vxg .node rect,#mermaid-svg-suARcX7bYwRu5Vxg .node circle,#mermaid-svg-suARcX7bYwRu5Vxg .node ellipse,#mermaid-svg-suARcX7bYwRu5Vxg .node polygon,#mermaid-svg-suARcX7bYwRu5Vxg .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-suARcX7bYwRu5Vxg .rough-node .label text,#mermaid-svg-suARcX7bYwRu5Vxg .node .label text,#mermaid-svg-suARcX7bYwRu5Vxg .image-shape .label,#mermaid-svg-suARcX7bYwRu5Vxg .icon-shape .label{text-anchor:middle;}#mermaid-svg-suARcX7bYwRu5Vxg .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-suARcX7bYwRu5Vxg .rough-node .label,#mermaid-svg-suARcX7bYwRu5Vxg .node .label,#mermaid-svg-suARcX7bYwRu5Vxg .image-shape .label,#mermaid-svg-suARcX7bYwRu5Vxg .icon-shape .label{text-align:center;}#mermaid-svg-suARcX7bYwRu5Vxg .node.clickable{cursor:pointer;}#mermaid-svg-suARcX7bYwRu5Vxg .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-suARcX7bYwRu5Vxg .arrowheadPath{fill:#333333;}#mermaid-svg-suARcX7bYwRu5Vxg .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-suARcX7bYwRu5Vxg .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-suARcX7bYwRu5Vxg .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-suARcX7bYwRu5Vxg .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-suARcX7bYwRu5Vxg .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-suARcX7bYwRu5Vxg .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-suARcX7bYwRu5Vxg .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-suARcX7bYwRu5Vxg .cluster text{fill:#333;}#mermaid-svg-suARcX7bYwRu5Vxg .cluster span{color:#333;}#mermaid-svg-suARcX7bYwRu5Vxg div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-suARcX7bYwRu5Vxg .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-suARcX7bYwRu5Vxg rect.text{fill:none;stroke-width:0;}#mermaid-svg-suARcX7bYwRu5Vxg .icon-shape,#mermaid-svg-suARcX7bYwRu5Vxg .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-suARcX7bYwRu5Vxg .icon-shape p,#mermaid-svg-suARcX7bYwRu5Vxg .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-suARcX7bYwRu5Vxg .icon-shape .label rect,#mermaid-svg-suARcX7bYwRu5Vxg .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-suARcX7bYwRu5Vxg .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-suARcX7bYwRu5Vxg .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-suARcX7bYwRu5Vxg :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} ResNet
ResNet18
ResNet34
ResNet50
ResNet101
ResNet152
BasicBlock
Bottleneck
- 名称中的数字代表网络规模,也就是层数的差异
- 更关键的是结构上的分界:
ResNet18与ResNet34使用BasicBlock,而ResNet50、ResNet101、ResNet152使用Bottleneck
- 更关键的是结构上的分界:
BasicBlock由两层3×3卷积构成,Bottleneck则是1×1降维、3×3卷积、1×1升维的三层结构- 后者以更少的计算量支撑更深的网络,这一设计从 50 层开始引入
- 在
PyTorch中切换该家族只需更换构造函数
python
import torchvision.models as models

# 18 层与 34 层使用 BasicBlock
resnet18 = models.resnet18()
resnet34 = models.resnet34()

# 50 层以上使用 Bottleneck
resnet50 = models.resnet50()
resnet101 = models.resnet101()
resnet152 = models.resnet152()- 本文选用
ResNet18,原因在于其规模小、训练快,且BasicBlock中的残差逻辑最为简洁,便于把原理讲透
3 ResNet18网络结构解析
3-1 输入与输出
- 标准的
ResNet18输入是一张 RGB 图像:3×224×2243\times224\times2243×224×224,也就是:3:RGB 三个颜色通道224 × 224:图像空间尺寸
- 经过
ResNet-18的特征提取和分类头后,输出维度为1000,也就是 1000 个类别的分类 logits,对应 ImageNet 的 1000 个类别
3-2 整体结构
- 先从顶层观察
ResNet18的整体结构 - 下图按数据流经的顺序给出各阶段的组成,并在每一步标注张量形状
#mermaid-svg-XBsYY6C9Kq3BDg6Z{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .error-icon{fill:#552222;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .marker{fill:#333333;stroke:#333333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .marker.cross{stroke:#333333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z p{margin:0;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster-label text{fill:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster-label span{color:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster-label span p{background-color:transparent;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .label text,#mermaid-svg-XBsYY6C9Kq3BDg6Z span{fill:#333;color:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .node rect,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node circle,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node ellipse,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node polygon,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .rough-node .label text,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node .label text,#mermaid-svg-XBsYY6C9Kq3BDg6Z .image-shape .label,#mermaid-svg-XBsYY6C9Kq3BDg6Z .icon-shape .label{text-anchor:middle;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .rough-node .label,#mermaid-svg-XBsYY6C9Kq3BDg6Z .node .label,#mermaid-svg-XBsYY6C9Kq3BDg6Z .image-shape .label,#mermaid-svg-XBsYY6C9Kq3BDg6Z .icon-shape .label{text-align:center;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .node.clickable{cursor:pointer;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .arrowheadPath{fill:#333333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-XBsYY6C9Kq3BDg6Z .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-XBsYY6C9Kq3BDg6Z .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster text{fill:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .cluster span{color:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-XBsYY6C9Kq3BDg6Z rect.text{fill:none;stroke-width:0;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .icon-shape,#mermaid-svg-XBsYY6C9Kq3BDg6Z .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .icon-shape p,#mermaid-svg-XBsYY6C9Kq3BDg6Z .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .icon-shape .label rect,#mermaid-svg-XBsYY6C9Kq3BDg6Z .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-XBsYY6C9Kq3BDg6Z .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-XBsYY6C9Kq3BDg6Z .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-XBsYY6C9Kq3BDg6Z :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 输入
3×224×224
Conv1
64×112×112
MaxPool
64×56×56
Layer1
64×56×56
Layer2
128×28×28
Layer3
256×14×14
Layer4
512×7×7
AvgPool
512
FC
1000
- 图中已经显现出两条贯穿始终的规律:空间尺寸逐级收缩,通道数逐级扩张
- 上述结构可以直接在代码中打印核对
python
from torchvision.models import resnet18

model = resnet18(weights=None)

# 顶层子模块,其中 layer1 到 layer4 确实是四个 Sequential
for name, module in model.named_children():
print(name, module.__class__.__name__)- 输出结果如下,
layer1到layer4确实是四个Sequential,每个内部包含两个BasicBlock
bash
conv1 Conv2d
bn1 BatchNorm2d
relu ReLU
maxpool MaxPool2d
layer1 Sequential
layer2 Sequential
layer3 Sequential
layer4 Sequential
avgpool AdaptiveAvgPool2d
fc Linear- 下面我们详细看每一个模块的实现
3-3 逐模块解析
- 张量形状的总变化已在 3-2 节的图中给出,这一段逐个模块说明它们各自做了什么
| 阶段 | 操作 | 输出尺寸 |
|---|---|---|
| 输入 | RGB 图像 | 3×224×224 |
| Conv1 | 7×7, 64, stride=2 |
64×112×112 |
| MaxPool | 3×3, stride=2 |
64×56×56 |
| Layer1 | BasicBlock ×2 | 64×56×56 |
| Layer2 | BasicBlock ×2 | 128×28×28 |
| Layer3 | BasicBlock ×2 | 256×14×14 |
| Layer4 | BasicBlock ×2 | 512×7×7 |
| AvgPool | Global Average Pooling | 512 |
| FC | 全连接层(Fully Connected) | 1000 |
3-3-1 主干入口
Conv1是第一个卷积层,作用是从原始图像中提取边缘、纹理这类初级视觉特征- 输入为
3×224×224,经过Conv1后变为64×112×112
- 输入为
- 它的配置为
7×7卷积核、输出 64 个通道、步长为 2,三个参数各自的含义如下
| 参数 | 取值 | 作用 |
|---|---|---|
| 卷积核大小 | 7×7 |
决定单个输出位置所覆盖的输入范围 |
| 输出通道数 | 64 | 该层并行学习 64 种初级特征 |
| 步长 | 2 | 空间尺寸减半 |
说人话:用 64 个卷积核提取不同的视觉特征,同时通过步长为 2 的卷积把图像尺寸缩小一半。
-
MaxPool是最大池化层,在3×3的窗口内取最大值,步长为 2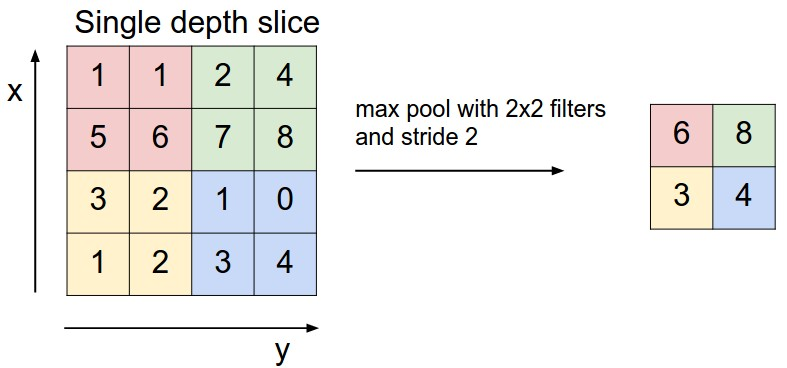
- 它的作用是继续降低空间分辨率,同时保留窗口内最显著的响应。虽然这样会导致一些细粒度位置信息丢失,但是整体空间布局仍然保留
-
经过
MaxPool后,张量由64×112×112变为64×56×56- 至此空间尺寸已由
224降到56,累计下采样 4 倍,后续四个阶段从这里接续
- 至此空间尺寸已由
说人话:这一步相当于把特征图缩小一半,让后面的网络在更小的尺寸上计算,代价是位置精度下降
3-3-2 四个残差阶段
Layer1到Layer4的结构相同,都由两个BasicBlock串联而成,区别只在于通道数与空间尺寸
| 阶段 | 输入形状 | 输出形状 | 空间尺寸 | 通道数 |
|---|---|---|---|---|
Layer1 |
64×56×56 |
64×56×56 |
不变 | 不变 |
Layer2 |
64×56×56 |
128×28×28 |
减半 | 翻倍 |
Layer3 |
128×28×28 |
256×14×14 |
减半 | 翻倍 |
Layer4 |
256×14×14 |
512×7×7 |
减半 | 翻倍 |
Layer1是唯一不改变形状的阶段,两个BasicBlock都在原尺寸上继续提取特征Layer2到Layer4的规律一致:空间尺寸减半,通道数翻倍- 下采样由每个阶段的第一个
BasicBlock完成,其主干卷积的步长设为 2,捷径分支同步做一次1×1卷积以对齐形状
- 下采样由每个阶段的第一个
- 这正是
ResNet的核心结构第一次出现,BasicBlock与捷径分支共同构成残差学习,其内部细节在 3-4 节展开
上述规律的含义是:每个输出位置所覆盖的输入范围不断扩大,可供组合的特征种类不断增多,网络因此得以从边缘、纹理逐步过渡到部件与物体
Layer4的输出为512×7×7,可以看作ResNet18最后的空间视觉特征,它在本文中的用途见 3-6 节与第五章
3-3-3 池化与分类头
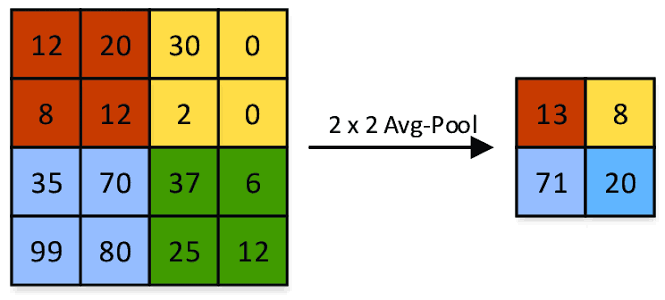
AvgPool是全局平均池化,它并不消除通道,而是对每一个通道的7×7特征图分别求平均- 512 个
7×7特征图各得到一个平均值,拼成 512 维向量
- 512 个
- 这一操作把
7×7的空间维度压缩掉,得到一个更加关注 "有没有某种特征" 、而不是 "特征具体位于哪里" 的全局描述。- 这也带来了一个重要性质:一定程度的平移不变性(translation invariance)。
- 例如,同一个物体在特征图中发生一定程度的位置移动,只要整体激活模式没有发生太大变化,经过全局平均后得到的特征可能仍然比较接近。
- 因此,对于图像分类而言,即使目标在图像中的位置发生一定变化,模型仍然可以较稳定地判断"图像中有什么"。
说人话:全局平均池化会使图像丢失空间信息,但是换来的是更强的平移不变性,让模型更关注"有什么",而不是"在哪里"。
- 这里可以对比一下前面的
MaxPool
| 操作 | 空间信息 | 主要作用 |
|---|---|---|
| MaxPool | 部分保留 | 下采样,同时保留局部最强响应 |
| Global AvgPool | 大幅压缩 | 把整个空间区域汇总成一个数 |
-
经过全局平均池化后,我们就得到了一个 512 维向量,对于分类任务,后面紧接着就是
FC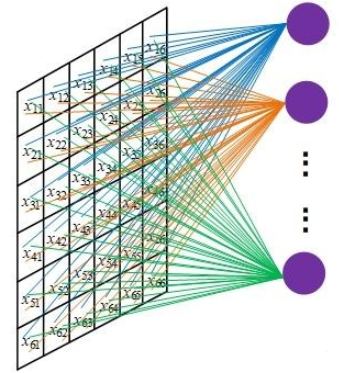
-
FC是全连接层,把 512 维向量映射为 1000 个类别的分数- 标准
ImageNet版本的ResNet18输出 1000 维,与 3-1 节给出的输出形状一致
- 标准
-
本文在
CIFAR-10上训练时,这一层会被替换为输出 10 类的全连接层,具体做法见 4-2 节
3-4 BasicBlock
3-4-1 完整结构
- 2-1 节给出的是最简形式的残差单元,真实的
BasicBlock还需要补上批归一化与捷径分支的对齐
#mermaid-svg-jeNf22spymNazk4Z{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-jeNf22spymNazk4Z .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-jeNf22spymNazk4Z .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-jeNf22spymNazk4Z .error-icon{fill:#552222;}#mermaid-svg-jeNf22spymNazk4Z .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-jeNf22spymNazk4Z .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-jeNf22spymNazk4Z .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-jeNf22spymNazk4Z .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-jeNf22spymNazk4Z .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-jeNf22spymNazk4Z .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-jeNf22spymNazk4Z .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-jeNf22spymNazk4Z .marker{fill:#333333;stroke:#333333;}#mermaid-svg-jeNf22spymNazk4Z .marker.cross{stroke:#333333;}#mermaid-svg-jeNf22spymNazk4Z svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-jeNf22spymNazk4Z p{margin:0;}#mermaid-svg-jeNf22spymNazk4Z .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-jeNf22spymNazk4Z .cluster-label text{fill:#333;}#mermaid-svg-jeNf22spymNazk4Z .cluster-label span{color:#333;}#mermaid-svg-jeNf22spymNazk4Z .cluster-label span p{background-color:transparent;}#mermaid-svg-jeNf22spymNazk4Z .label text,#mermaid-svg-jeNf22spymNazk4Z span{fill:#333;color:#333;}#mermaid-svg-jeNf22spymNazk4Z .node rect,#mermaid-svg-jeNf22spymNazk4Z .node circle,#mermaid-svg-jeNf22spymNazk4Z .node ellipse,#mermaid-svg-jeNf22spymNazk4Z .node polygon,#mermaid-svg-jeNf22spymNazk4Z .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-jeNf22spymNazk4Z .rough-node .label text,#mermaid-svg-jeNf22spymNazk4Z .node .label text,#mermaid-svg-jeNf22spymNazk4Z .image-shape .label,#mermaid-svg-jeNf22spymNazk4Z .icon-shape .label{text-anchor:middle;}#mermaid-svg-jeNf22spymNazk4Z .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-jeNf22spymNazk4Z .rough-node .label,#mermaid-svg-jeNf22spymNazk4Z .node .label,#mermaid-svg-jeNf22spymNazk4Z .image-shape .label,#mermaid-svg-jeNf22spymNazk4Z .icon-shape .label{text-align:center;}#mermaid-svg-jeNf22spymNazk4Z .node.clickable{cursor:pointer;}#mermaid-svg-jeNf22spymNazk4Z .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-jeNf22spymNazk4Z .arrowheadPath{fill:#333333;}#mermaid-svg-jeNf22spymNazk4Z .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-jeNf22spymNazk4Z .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-jeNf22spymNazk4Z .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-jeNf22spymNazk4Z .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-jeNf22spymNazk4Z .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-jeNf22spymNazk4Z .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-jeNf22spymNazk4Z .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-jeNf22spymNazk4Z .cluster text{fill:#333;}#mermaid-svg-jeNf22spymNazk4Z .cluster span{color:#333;}#mermaid-svg-jeNf22spymNazk4Z div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-jeNf22spymNazk4Z .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-jeNf22spymNazk4Z rect.text{fill:none;stroke-width:0;}#mermaid-svg-jeNf22spymNazk4Z .icon-shape,#mermaid-svg-jeNf22spymNazk4Z .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-jeNf22spymNazk4Z .icon-shape p,#mermaid-svg-jeNf22spymNazk4Z .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-jeNf22spymNazk4Z .icon-shape .label rect,#mermaid-svg-jeNf22spymNazk4Z .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-jeNf22spymNazk4Z .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-jeNf22spymNazk4Z .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-jeNf22spymNazk4Z :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 输入 x
Conv 3x3
BatchNorm
ReLU
Conv 3x3
BatchNorm
逐元素相加 Add
Downsample 1x1 卷积
ReLU
输出
- 其数学形式为:
y=ReLU(F(x)+Wsx)y = \mathrm{ReLU}\big(F(x) + W_s x\big)y=ReLU(F(x)+Wsx)
- 以防你忘记:
- F(x)F(x)F(x):主干支路,即两层
3×3卷积加批归一化 - WsW_sWs:捷径分支上的
1×1卷积,实现中称为downsample - ReLU\mathrm{ReLU}ReLU:相加之后还有一次激活
- F(x)F(x)F(x):主干支路,即两层
3-4-2 BatchNorm 与卷积偏置
BatchNorm(Batch Normalization,批归一化)用于对卷积输出进行归一化,并配合可学习的缩放与平移参数,帮助网络更加稳定地训练。- 因此,ResNet 的卷积层通常设置为
bias=False:- 因为卷积后紧接着就是
BatchNorm,卷积的偏置会在 BatchNorm 的归一化过程中被抵消。 - 因此保留卷积偏置通常没有必要,还会增加少量冗余参数。
- 因为卷积后紧接着就是
3-4-3 捷径分支的形状对齐
- 这里有一个关键细节:捷径分支并不总是恒等映射
- 当该层的输入输出通道数不一致,或空间尺寸需要下采样 2 倍时,xxx与F(x)F(x)F(x)的形状无法对齐,不能直接相加
- 此时捷径分支上会挂一个
1×1、步长为 2 的卷积WsW_sWs,把xxx投影到与F(x)F(x)F(x)相同的形状
- 例如:
text
64 × 56 × 56
		↓ 1×1 Conv, stride=2
128 × 28 × 28- 因此:
- 如果形状一致,Shortcut 直接传递
x - 如果形状不一致,Shortcut 使用
1×1卷积进行投影
- 如果形状一致,Shortcut 直接传递
- 实现中这个操作被称为
downsample。 - 也就是说,捷径分支在形状一致时执行恒等传递,在形状不一致时执行一次线性投影
3-4-4 ReLU 的位置
- 另一处细节是
ReLU的位置:它位于残差相加之后 ,且相加前只有一次,即y=ReLU(F(x)+Wsx)y=\mathrm{ReLU}(F(x)+W_sx)y=ReLU(F(x)+Wsx),这样残差支路可以学习正负方向的变化,而不是在相加之前就被ReLU截断
3-4-5 代码实现
BasicBlock的官方实现如下,残差相加对应其中的out += identity
python
class BasicBlock(nn.Module):
    expansion = 1

    def __init__(self, inplanes, planes, stride=1, downsample=None):
        super().__init__()
        # 第一个卷积负责改变通道数和空间尺寸
        self.conv1 = nn.Conv2d(inplanes, planes, kernel_size=3,
                               stride=stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(planes)
        self.relu = nn.ReLU(inplace=True)
        # 第二个卷积保持形状不变
        self.conv2 = nn.Conv2d(planes, planes, kernel_size=3,
                               stride=1, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(planes)
        # 形状对不上时用来对齐捷径分支,形状对得上时为 None
        self.downsample = downsample

    def forward(self, x):
        identity = x

        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)

        out = self.conv2(out)
        out = self.bn2(out)

        # 只有需要改变形状时,捷径分支才做一次 1x1 卷积
        if self.downsample is not None:
            identity = self.downsample(x)

        out += identity          # 对应公式里的 F(x) + x
        out = self.relu(out)     # 加法之后再做一次激活

        return out
3-5 Feature Map
3-5-1 定义
- Feature Map(特征图) 可以理解成 CNN 经过卷积后得到的"特征地图"。
- 对于一层卷积来说,每一个输出通道都对应一张 Feature Map 。因此,如果某一层输出形状为
64×112×112,就可以理解为:- 一共有 64 张 Feature Map;
- 每张 Feature Map 的空间尺寸为
112×112。
- 这 64 张 Feature Map 并不是 64 张原始图像,而是卷积核对输入图像进行特征提取后得到的 64 个不同的特征响应结果。
可以理解为:不同卷积核负责关注不同类型的视觉模式,例如边缘、纹理、局部形状等,而对应的 Feature Map 则记录了这些模式在图像不同位置上的响应强弱。
3-5-2 关于Feature Map训练
- 需要注意的是,Feature Map 本身并不是一个需要单独训练的模型,而是 CNN 在进行前向传播时产生的中间结果。
- 一个卷积层可以简单表示为Y=Conv(X;W)Y = \mathrm{Conv}(X; W)Y=Conv(X;W),其中:
X:输入特征;W:卷积核的参数;Y:卷积计算得到的输出,也就是 Feature Map。
- 真正需要通过训练学习的是卷积核中的参数 。在训练 CNN 的过程中,网络通过反向传播不断调整这些参数,使卷积核逐渐学会提取对任务有用的视觉特征。
- 例如,在训练好的 CNN 中,浅层卷积核可能对边缘、纹理等基础视觉模式产生较强响应,而更深层的卷积核则可能逐渐学习到更加复杂的形状和语义特征。
- 因此可以区分两个概念:
- 训练 CNN: 学习卷积核等网络参数;
- 得到 Feature Map: 将图像输入已经训练好的 CNN,通过前向传播计算得到 Feature Map。
说人话:Feature Map 不是"训练出来的东西",而是 CNN 用已经训练好的卷积核处理图像后"算出来的东西"。
3-5-3 Feature Map 表示什么
- 在网络较浅的阶段,Feature Map 通常会对一些比较基础的视觉模式产生响应,例如:
- 边缘
- 颜色变化
- 简单纹理
- 局部轮廓
- 随着网络不断加深,Feature Map 表示的内容会逐渐变得更加抽象,例如:
- 局部形状
- 物体部件
- 更复杂的结构
- 与具体目标类别相关的高级语义特征
- 5-4 节的特征图可视化会进一步直观展示不同网络阶段 Feature Map 的空间尺寸变化,以及网络逐渐提取高级视觉特征的过程。
3-5-4 Feature Map 的数量
- 如上面所述,Feature Map 的数量由卷积层的输出通道数决定。
- 以 ResNet18 为例:
| 网络阶段 | 输出形状 | Feature Map 数量 | 每张 Feature Map 尺寸 |
|---|---|---|---|
| Conv1 | 64×112×112 |
64 | 112×112 |
| Layer1 | 64×56×56 |
64 | 56×56 |
| Layer2 | 128×28×28 |
128 | 28×28 |
| Layer3 | 256×14×14 |
256 | 14×14 |
| Layer4 | 512×7×7 |
512 | 7×7 |
- 可以发现,随着网络不断加深,Feature Map 呈现出两个明显的变化:
- 空间尺寸逐渐减小 :
112、56、28、14、7 - Feature Map 数量逐渐增加 :
64、128、256、512
- 空间尺寸逐渐减小 :
- 这也是 CNN 中常见的设计规律:空间信息越来越粗,但特征表示越来越丰富。
3-5-5 Feature Map 能做什么
- Feature Map 保留了空间维度 ,因此不仅包含"检测到了什么特征",还保留了这些特征在图像中的大致空间分布。
- 这使得 Feature Map 可以作为很多视觉任务的基础特征,例如:
- 图像分类:进一步聚合 Feature Map,判断整张图像属于什么类别;
- 目标检测:利用空间特征判断目标是什么以及目标在哪里;
- 语义分割:利用空间特征对不同像素或区域进行分类;
- 视觉控制:利用特征及其空间分布,为机器人提供视觉决策所需的信息;
- 视觉 Transformer / VLA:将空间 Feature Map 进一步转换成视觉 Token,交给 Transformer 进行后续处理。
- 因此,在很多视觉任务中,并不一定要把 Feature Map 直接压缩成一个全局向量,而是会根据任务需求保留空间特征。
说人话:Feature Map 不只是"中间结果",它本身就是视觉网络提取出来的一种有空间结构的特征表示,可以继续交给后面的网络完成分类、检测、分割、控制等任务。
3-6 ResNet18输出
- 前文反复出现的
512,现在可以完整推导:- 3-2 节已经给出了以
ImageNet常用的224×224图像为输入时,各阶段的特征图形状,这里补充这些形状的来源。 Conv1使用7×7、步长为2的卷积,输出边长为: ⌊(224+2×3−7)/2⌋+1=112\lfloor (224 + 2 \times 3 - 7)/2 \rfloor + 1 = 112⌊(224+2×3−7)/2⌋+1=112MaxPool使用3×3、步长为2的池化,边长变为56。- 之后
Layer2、Layer3、Layer4各执行一次步长为2的下采样,边长依次变为28、14、7。 - 通道数则按照
64、128、256、512逐层增加。 - 因此,
Layer4的输出为512×7×7。随后经过 Global Average Pooling,仅在空间维度上进行平均,将其压缩为512维特征向量。
- 3-2 节已经给出了以
- 由此可见,在
Layer4的512×7×7Feature Map 中,512 指的是特征通道数,而不是空间尺寸 ;经过 Global Average Pooling 后,每个通道的7×7特征图被压缩为一个数,最终得到512维特征向量。 - 这也解释了为什么该特征能够直接用于图像分类等下游任务:
- 经过全局平均池化后,
7×7的空间特征被压缩为512维向量,不再显式保留物体在图像中的具体空间位置。
- 经过全局平均池化后,
说人话:512 维特征更像是在回答"图像里有什么",而不是"它具体在哪里"。
4 ResNet18 + CIFAR-10
- 虽然本文最终关注的是
Visual Feature Extraction,但仍需先通过一个监督学习任务训练ResNet18,使网络学到具有区分性的视觉表示- 也就是说,特征提取器是分类任务的产物,而不是独立训练的模块
4-1 CIFAR-10介绍
4-1-1 数据集构成
CIFAR-10是一个 10 分类彩色图像数据集- 图像尺寸为
32×32,共 60000 张,官方划分为 50000 张训练集与 10000 张测试集,每个类别各 6000 张 - 十个类别分别为
airplane、automobile、bird、cat、deer、dog、frog、horse、ship、truck - 数据集规模较小,完整压缩包约 160 MB,适合用于验证性实验
- 图像尺寸为
- 每个类别各取一张原始图像,按 2 行 5 列排列如下

- 在
torchvision中加载该数据集只需几行代码
python
from torchvision.datasets import CIFAR10

# download=True 会在本地缺失时自动下载并校验,已有则直接读取
train_set = CIFAR10(root="./data", train=True, download=True)
test_set = CIFAR10(root="./data", train=False, download=True)

print(len(train_set), len(test_set))    # 50000 10000
print(train_set.classes) # 十个类别名- 需要注意,此处读到的图像默认为
PIL图像对象,真正的预处理要交给后续的transform完成
4-1-2 输入尺寸的选择
- 这里存在一个必须在训练前确定的问题:
ResNet18是为224×224设计的,而CIFAR-10的图像只有32×32- 若直接把
32×32输入网络,结果将如何 - 3-6 节已经算过,
ResNet18的总下采样倍率为 32,由conv1的步长 2、maxpool的步长 2,以及layer2到layer4各一次步长 2 累乘得到 - 于是32÷32=132 \div 32 = 132÷32=1,
layer4的输出会退化成一个1×1的空间尺寸 - 此时
AvgPool不再具有任何作用,5-4 节要做的特征图可视化也无从谈起
- 若直接把
- 因此有两条可行路径
| 方案 | 做法 | 代价 |
|---|---|---|
| 放大输入 | 把32×32插值到224×224 |
图像变糊,细节由插值产生,并非真实信息 |
| 改网络 | conv1换成3×3步长 1,去掉maxpool |
不再是官方模型,结构被改动 |
-
表中"放大输入"这一行的代价可以直接看出来
-
左上角是原始
32×32,每个方块就是一个真实测量的像素,共 1024 个- 右上角是双三次插值到
224×224后的结果,也就是模型真正看到的输入 - 下排把同一小块区域放大对照:左侧是 64 个真实像素,右侧是插值出来的 3136 个
- 右上角是双三次插值到
-
两相对照可以看出,插值并没有增加任何信息,只是把 1024 个测量值摊开到 50176 个网格点上,多出来的部分是一步步平滑出来的
-
本文选择放大输入这一路径
- 理由在于本文的目的是理解
ResNet18本身,结构一字不改才能保证观察到的行为确实来自这个官方模型 - 代价是
32到224共 7 倍插值,输入图像明显变糊,这一点在后续特征图上可以直接观察到
- 理由在于本文的目的是理解
4-2 ImageNet介绍
-
在确定训练方案之前,还需要交代本文所用预训练权重的来源
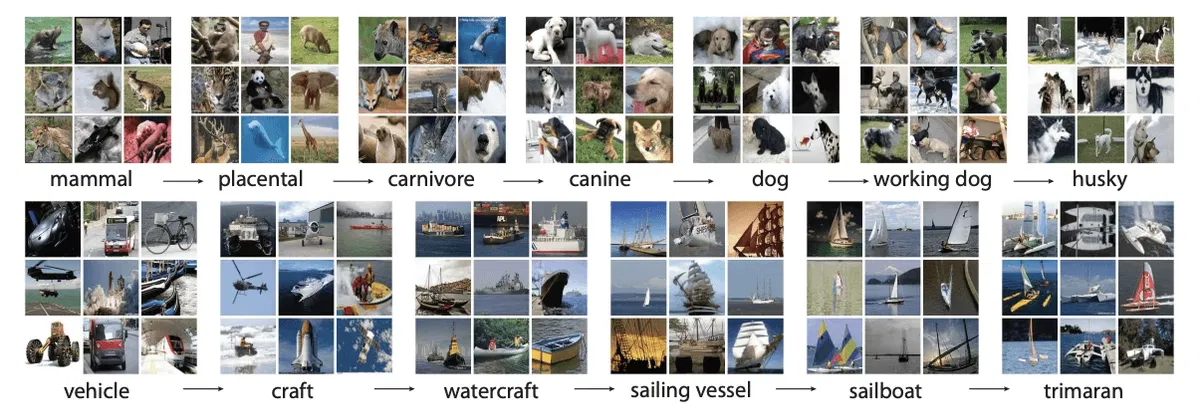
-
ImageNet是一个大规模图像分类数据集,其中用于图像分类竞赛的子集包含 1000 个类别、约 128 万张训练图像与 5 万张验证图像- 它与
CIFAR-10在规模、分辨率与类别粒度上都不在同一量级
- 它与
| 项目 | CIFAR-10 | ImageNet 分类子集 |
|---|---|---|
| 类别数 | 10 | 1000 |
| 训练图像数 | 50000 | 约 128 万 |
| 图像尺寸 | 32×32 |
原始尺寸不一,常缩放到224×224 |
| 类别粒度 | 粗粒度,如猫、狗 | 细粒度,含大量犬种与车型 |
- 表中与本文关系最直接的是图像尺寸一行:官方
ResNet18正是针对224×224设计的,4-1-2 节讨论的输入尺寸问题正源于此 - 另一处关键差异是类别粒度
ImageNet的 1000 个类别中包含大量细粒度区分,例如不同犬种、不同车型- 要在这 1000 类上取得可用的精度,网络必须学到相当通用的视觉表示,而不能只记住少数几个粗类别的模板
- 这一点决定了它的特征具备迁移价值
说人话:
ImageNet预训练相当于让主干先在一千类细粒度任务上练过一遍,再拿来分十类,起点远高于随机初始化
- 本文并不在
ImageNet上训练,而是直接使用官方提供的预训练权重- 具体做法是在构造模型时加载该权重,再替换分类头
python
import torch.nn as nn
from torchvision.models import resnet18, ResNet18_Weights

# 加载 ImageNet 预训练权重
model = resnet18(weights=ResNet18_Weights.DEFAULT)

# 分类头原本输出 1000 类,替换为 10 类以适配 CIFAR-10
model.fc = nn.Linear(model.fc.in_features, 10)- 主干中没有任何一层被改动,被替换的只有最后那个全连接层
- 这份权重对本文的影响落在三处:
- 其一,4-3-2 节的两段式微调之所以可行,正是因为主干特征已经可用,可以先冻结主干、只让新分类头追平其水平
- 其二,4-3-1 节数据管道中的标准化参数
IMAGENET_MEAN与IMAGENET_STD,取自ImageNet训练集的统计量 - 使用预训练权重时,输入必须按同一套均值与标准差归一化,否则输入分布与主干训练时所见的分布不一致,预训练权重的优势会被削弱
- 其三,第六章中作为对照的"未微调特征空间",使用的同样是这份预训练权重
- 设置这一对照的目的,是把
ImageNet本身就带来的语义结构与微调额外塑造的结构区分开
4-3 ResNet18训练
4-3-1 数据管道与增广
- 输入尺寸确定之后,接下来是预处理与增广策略
- 训练集与验证集使用的变换必须不同:训练阶段做随机增广,验证阶段只做确定性缩放
python
import torchvision.transforms as T

# ImageNet 预训练模型的标准化参数,微调时必须沿用
IMAGENET_MEAN = (0.485, 0.456, 0.406)
IMAGENET_STD = (0.229, 0.224, 0.225)

train_tf = T.Compose([
    # 先在 32x32 原图上裁出 25x25 到 32x32 的区域,再放大到 224
    T.RandomResizedCrop(224, scale=(0.6, 1.0),
                        interpolation=T.InterpolationMode.BICUBIC),
    T.RandomHorizontalFlip(),
    T.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    T.ToTensor(),
    T.Normalize(IMAGENET_MEAN, IMAGENET_STD),
])

eval_tf = T.Compose([
    # 验证集不做任何随机性,只做确定性缩放
    T.Resize(224, interpolation=T.InterpolationMode.BICUBIC),
    T.ToTensor(),
    T.Normalize(IMAGENET_MEAN, IMAGENET_STD),
])- 其中有两处需要展开说明
- 第一处是裁剪与放大的顺序:
RandomResizedCrop先在原始32×32上裁剪,再插值到224- 若反过来先放大到
224再裁剪,裁出的区域实际上是插值结果的子块,由于插值本身不产生新信息,样本多样性会随之下降
- 若反过来先放大到
- 第二处是增广强度的取舍:
scale取(0.6, 1.0),而非常用于ImageNet从头训练的(0.4, 1.0)- 原因是
(0.4, 1.0)对应的是数十个 epoch 的长时间训练,在短轮次微调中会明显延缓收敛
- 原因是
- 第一处是裁剪与放大的顺序:
- 增广的作用是抑制过拟合,但训练轮次本身有限时,过强的增广会使网络连必要的判别特征都未能充分学到
- 此外,验证集必须从训练集中划分,不能使用测试集充当验证集
- 本文的做法是从 50000 张训练图中划分 5000 张作为验证集,用固定随机种子打乱后取前 5000 张,保证结果可复现
- 那 10000 张测试集全程不参与训练与模型选择,只在最终评测时使用一次
- 本文的做法是从 50000 张训练图中划分 5000 张作为验证集,用固定随机种子打乱后取前 5000 张,保证结果可复现
4-3-2 两段式微调
- 训练分为两个阶段:前 2 个 epoch 冻结主干、只训练新的分类头,之后再解冻全量微调
- 这样安排的依据在于预训练权重的性质
- 从
ImageNet预训练权重出发时,主干输出的特征本身已具备良好的可用性,而新替换的分类头是随机初始化的 - 若一开始就全量反向传播,随机分类头产生的大梯度会沿网络回传,破坏预训练特征
- 先让分类头追平主干的水平,再以小学习率共同调整,是这类微调任务的标准做法
- 从
- 还有一处容易遗漏的细节:冻结主干时,
BatchNorm也必须切换到eval()
python
def set_backbone_frozen(model, frozen):
    # 只放开分类头,其余参数全部冻结
    for name, param in model.named_parameters():
        if not name.startswith("fc."):
            param.requires_grad = not frozen

    # 关键:主干冻结时 BN 也必须切到 eval
    # 否则主干权重虽然不更新,BN 的滑动均值仍会被新数据集的
    # batch 统计量悄悄覆盖,等于偷偷改动了主干
    for module in model.modules():
        if isinstance(module, nn.BatchNorm2d):
            module.eval() if frozen else module.train()


set_backbone_frozen(model, True)     # 第一阶段:冻结
# ... 训练若干 epoch ...
set_backbone_frozen(model, False) # 第二阶段:解冻- 之所以要单独处理
BatchNorm,是因为它包含两类状态- 一类是可经梯度更新的仿射参数γ\gammaγ与β\betaβ,另一类是不参与梯度、由滑动平均更新的
running_mean与running_var - 仅设置
requires_grad = False只会冻结前者,后者在前向传播时仍会被当前 batch 的统计量更新
- 一类是可经梯度更新的仿射参数γ\gammaγ与β\betaβ,另一类是不参与梯度、由滑动平均更新的
- 结果是主干的归一化基准被
CIFAR-10的数据分布改写
说人话:冻结要冻彻底,否则主干权重看似未动,其归一化层其实已经在新数据集上重新标定过
- 实测中解冻带来的提升是断层式的:验证精度在一个 epoch 内从
79.56%跃升至93.96% - 这一跃升也说明,在
ImageNet特征基础上做适配,其效率远高于从零训练
4-3-3 优化器与学习率调度
- 主干参数来自
ImageNet,分类头参数为随机初始化,两者不应共用同一学习率 - 因此优化器分为两组参数
python
backbone_params = [p for n, p in model.named_parameters()
                   if not n.startswith("fc.") and p.requires_grad]
head_params = [p for n, p in model.named_parameters()
               if n.startswith("fc.")]

optimizer = torch.optim.AdamW([
    # 主干用一个更小的学习率,避免把预训练特征冲坏
    {"params": backbone_params, "lr": lr * backbone_lr_mult},
    {"params": head_params, "lr": lr},
], weight_decay=1e-4)

# 余弦退火只在解冻之后启动,退火周期等于剩余轮数
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(
optimizer, T_max=epochs - freeze_epochs, eta_min=lr * 0.01)- 主干学习率取分类头的 0.1 倍,这正是
backbone_lr_mult系数的含义- 学习率调度上还有一处细节:
CosineAnnealingLR的周期T_max被设为剩余轮数,而非总轮数 - 因为调度器在解冻那一刻才创建,冻结阶段的 epoch 不应计入退火周期
- 若把冻结轮次算进去,解冻时学习率已经衰减了一部分,退火的行程被白白浪费
- 学习率调度上还有一处细节:
- 训练全程采用
AMP(Automatic Mixed Precision,自动混合精度),前向与反向在float16下计算,参数更新仍保持float32
python
with torch.autocast(device_type="cuda", enabled=use_amp):
    logits = model(images)
    loss = criterion(logits, targets)

scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()- 该做法同时降低了显存占用与计算开销,并且由于梯度缩放的存在,小梯度不会在
float16下被截断为 0
4-4 Loss与Accuracy
4-4-1 训练曲线
- 训练过程逐 epoch 记录了损失、精度与学习率
- 图中包含三条曲线,横轴上的竖虚线标出了主干解冻的位置
- 损失曲线上,解冻处出现明显台阶,验证损失由
1.02附近降至0.70以下 - 精度曲线同样如此,验证精度在解冻那一步的抬升最为显著
- 损失曲线上,解冻处出现明显台阶,验证损失由
- 到训练末期,训练精度达到
99.64%,验证精度停留在96.90%,两条曲线的间距在稳定扩大- 这一间距是过拟合的直接证据:模型已经充分拟合训练集,但泛化能力不再提升
- 从机制上看,解冻前是分类头在适应固定的主干特征,解冻后则是整个网络共同适应
CIFAR-10,后者带来的提升是数量级的,同时也伴随过拟合风险的上升 - 训练损失采用带标签平滑的交叉熵,因此即使模型完全自信,损失也不会降到 0,这是曲线停留在非零平台的原因之一
4-4-2 混淆矩阵与分类指标
- 在 10000 张从未参与训练与选型的测试集上,最终结果为:
top-196.46%,top-599.91% - 各类别的
top-1精度如下
| 类别 | 精度 | 类别 | 精度 |
|---|---|---|---|
| airplane | 97.90% | frog | 98.70% |
| automobile | 98.30% | horse | 97.50% |
| bird | 94.70% | ship | 98.10% |
| cat | 89.10% | truck | 97.20% |
| deer | 97.90% | dog | 95.20% |
- 仅凭类别精度无法看出误差的具体去向,因此还需要混淆矩阵
- 以防你不知道:混淆矩阵(Confusion Matrix) 是一种用于评估分类模型性能的表格,通过统计真实类别与预测类别之间的对应关系,直观展示模型哪些类别预测正确、哪些类别容易混淆。
- 这里有一个实现上的关键选择:混淆矩阵必须按行归一化
python
def plot_confusion(cm, class_names):
    # 按行归一化:每一行是"真实类别为 i 的样本被预测成了什么"的条件分布
    # 不做归一化的话,每个类别都是 1000 张,看不出任何差别
    cm_norm = cm / cm.sum(axis=1, keepdims=True)

    fig, ax = plt.subplots(figsize=(8, 7))
    im = ax.imshow(cm_norm, cmap="Blues", vmin=0, vmax=1)

    for i in range(len(class_names)):
        for j in range(len(class_names)):
            # 对角线就是召回率,非对角线就是误判去向
            ax.text(j, i, f"{cm_norm[i, j] * 100:.1f}",
                    ha="center", va="center",
                    color="white" if cm_norm[i, j] > 0.55 else "black")
return fig- 按行归一化后,每一行构成一个概率分布,对角线即该类别的召回率
- 若使用原始计数则不具备这一性质,因为每个类别均为 1000 张,各格子在数值上无从区分
- 从图中可以直接读出最典型的一对混淆:
cat所在行最显著的非对角格对应dog- 具体数值为
cat有 5.8% 的样本被误判为dog,这也是cat精度仅为 89.10% 的主要原因 - 这两个类别在
32×32分辨率下确实难以区分,毛色、体型与姿态的差异都被压缩掉了 - 与之对照的是
frog的 98.70%,蛙类的绿色与独特轮廓在小尺寸图像上反而更容易区分 top-1与top-5之间仅相差 3.45 个百分点,说明模型在判错时,正确答案仍基本位于前五位
- 具体数值为
说人话:模型判错时,正确答案基本仍然落在前五位
5 Visual Feature Extraction
- 至此分类任务已经完成,模型也已训练完毕
- 但本文真正关心的是:这个模型的主干究竟学到了什么样的视觉特征
- 接下来三章分别从中间特征图 、512 维全局特征 与特征空间分布三个角度展开观察
5-1 从分类模型到视觉特征提取器
- Visual Feature Extraction(视觉特征提取) 是指利用 CNN、Transformer 等模型,从原始图像中提取边缘、纹理、形状以及高级语义等特征 ,将图像转换为机器更容易处理的特征表示。
- 一个训练好的分类模型本身就是一个特征提取器
- 因为网络必须先把图像编码成具有区分度的向量,才可能完成正确的分类
- 所要做的,只是把这个编码过程截取出来
#mermaid-svg-lcDhnMUggz8AzQlA{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-lcDhnMUggz8AzQlA .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-lcDhnMUggz8AzQlA .error-icon{fill:#552222;}#mermaid-svg-lcDhnMUggz8AzQlA .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-lcDhnMUggz8AzQlA .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-lcDhnMUggz8AzQlA .marker{fill:#333333;stroke:#333333;}#mermaid-svg-lcDhnMUggz8AzQlA .marker.cross{stroke:#333333;}#mermaid-svg-lcDhnMUggz8AzQlA svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-lcDhnMUggz8AzQlA p{margin:0;}#mermaid-svg-lcDhnMUggz8AzQlA .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-lcDhnMUggz8AzQlA .cluster-label text{fill:#333;}#mermaid-svg-lcDhnMUggz8AzQlA .cluster-label span{color:#333;}#mermaid-svg-lcDhnMUggz8AzQlA .cluster-label span p{background-color:transparent;}#mermaid-svg-lcDhnMUggz8AzQlA .label text,#mermaid-svg-lcDhnMUggz8AzQlA span{fill:#333;color:#333;}#mermaid-svg-lcDhnMUggz8AzQlA .node rect,#mermaid-svg-lcDhnMUggz8AzQlA .node circle,#mermaid-svg-lcDhnMUggz8AzQlA .node ellipse,#mermaid-svg-lcDhnMUggz8AzQlA .node polygon,#mermaid-svg-lcDhnMUggz8AzQlA .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-lcDhnMUggz8AzQlA .rough-node .label text,#mermaid-svg-lcDhnMUggz8AzQlA .node .label text,#mermaid-svg-lcDhnMUggz8AzQlA .image-shape .label,#mermaid-svg-lcDhnMUggz8AzQlA .icon-shape .label{text-anchor:middle;}#mermaid-svg-lcDhnMUggz8AzQlA .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-lcDhnMUggz8AzQlA .rough-node .label,#mermaid-svg-lcDhnMUggz8AzQlA .node .label,#mermaid-svg-lcDhnMUggz8AzQlA .image-shape .label,#mermaid-svg-lcDhnMUggz8AzQlA .icon-shape .label{text-align:center;}#mermaid-svg-lcDhnMUggz8AzQlA .node.clickable{cursor:pointer;}#mermaid-svg-lcDhnMUggz8AzQlA .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-lcDhnMUggz8AzQlA .arrowheadPath{fill:#333333;}#mermaid-svg-lcDhnMUggz8AzQlA .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-lcDhnMUggz8AzQlA .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-lcDhnMUggz8AzQlA .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-lcDhnMUggz8AzQlA .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-lcDhnMUggz8AzQlA .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-lcDhnMUggz8AzQlA .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-lcDhnMUggz8AzQlA .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-lcDhnMUggz8AzQlA .cluster text{fill:#333;}#mermaid-svg-lcDhnMUggz8AzQlA .cluster span{color:#333;}#mermaid-svg-lcDhnMUggz8AzQlA div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-lcDhnMUggz8AzQlA .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-lcDhnMUggz8AzQlA rect.text{fill:none;stroke-width:0;}#mermaid-svg-lcDhnMUggz8AzQlA .icon-shape,#mermaid-svg-lcDhnMUggz8AzQlA .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-lcDhnMUggz8AzQlA .icon-shape p,#mermaid-svg-lcDhnMUggz8AzQlA .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-lcDhnMUggz8AzQlA .icon-shape .label rect,#mermaid-svg-lcDhnMUggz8AzQlA .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-lcDhnMUggz8AzQlA .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-lcDhnMUggz8AzQlA .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-lcDhnMUggz8AzQlA :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 训练好的 ResNet18
保留 Backbone
丢弃分类头 FC
中间层特征图 layer1 到 layer4
avgpool 之后的 512-D 全局特征
任务一:Feature Map 可视化
任务二:512-D Feature 展示
任务三:Feature Space 可视化
- 这里需要区分两类特征:
- 一类是中间特征图 ,即
layer1到layer4的输出,形状为C × H × W,仍保留空间结构 - 另一类是全局特征 ,即
avgpool之后的 512 维向量,空间结构已被平均掉
- 一类是中间特征图 ,即
前者适合观察网络关注的位置,后者适合直接输入下游网络
- 提取特征时还有一个必要前提:模型必须切换到
eval()并关闭梯度- 原因是若
BatchNorm停留在train()模式,它会使用当前 batch 的统计量做归一化,同一条数据在不同 batch 下会得到不同特征,结果不可复现 - 关闭梯度则因为此处只做前向计算,不需要保存中间激活,可以显著节省显存
- 原因是若
python
model.eval()

with torch.no_grad():
    features = extractor(images)
5-2 提取512-D Visual Feature
- 先明确 512 维这一数值的物理含义
layer4的输出为512 × 7 × 7,可以理解为 512 张7×7的语义响应地图avgpool在H与W两个维度上取平均,得到 512 个数值
- 于是第kkk个分量为:
zk=1H×W∑i=1H∑j=1WAk,i,jz_k = \frac{1}{H \times W}\sum_{i=1}^{H}\sum_{j=1}^{W} A_{k,i,j}zk=H×W1i=1∑Hj=1∑WAk,i,j
- 以防你忘记:
- Ak,i,jA_{k,i,j}Ak,i,j:
layer4输出中第kkk个通道在位置(i,j)(i,j)(i,j)处的激活值 - H=W=7H = W = 7H=W=7:该层的空间尺寸
- zkz_kzk:全局平均池化后第kkk维的取值
- Ak,i,jA_{k,i,j}Ak,i,j:
- 这一平均操作带来一个关键性质:平移不变性
- 物体在图像中平移若干像素,只会使Ak,i,jA_{k,i,j}Ak,i,j的分布整体移动,其平均值几乎不变
- 这正好符合分类任务的需求:关心的是图像中是否存在某类物体,而非该物体所处的位置
- 但这也是它作为下游任务输入时的局限:位置信息被完全丢弃
- 也就是说,
avgpool以牺牲位置信息为代价,换取了与位置无关的稳定性
- 也就是说,
- 实测这 512 维向量的统计特征如下
| 指标 | 数值 |
|---|---|
| 取值范围 | 0, 5.17 |
| 均值 | 0.83 |
| 标准差 | 0.76 |
| 接近零的维度占比 | 0.5% |
| L2 范数范围 | 20.2 到 35.2 |
- 把这 512 个数值直接画出来,可以更直观地看到它的形态
- 取十个类别各一张测试图像,把它们的特征向量按行排成矩阵,显示为热力图
- 图中每一行是一张图像,每一列对应一个特征维度
- 各行的强响应位置互不重合,也没有呈现出明显的分区结构,说明单个维度并不固定对应某一类语义
- 这与 6-2 节的结论一致:类别信息分散在整个 512 维空间中,而非集中在少数几个维度上
说人话:这 512 个数值中几乎每一个都在参与表达,只有极少数维度长期处于静默状态
5-3 PyTorch Feature Extraction
- 获取中间层输出最直接的办法是手写
register_forward_hook,但由此产生的代码较为零散 PyTorch官方torchvision提供了专门用于Visual Feature Extraction的接口,可直接按节点名取出输出
python
from torchvision.models.feature_extraction import create_feature_extractor

# 任务一:取四个 stage 的中间特征图
extractor = create_feature_extractor(model, return_nodes={
    "layer1": "feat1",
    "layer2": "feat2",
    "layer3": "feat3",
    "layer4": "feat4",
})

# 任务二、任务三:取 avgpool 之后的 512 维全局特征
extractor = create_feature_extractor(model, return_nodes={
    "avgpool": "feature",
})- 该接口的本质,是在模型的
forward计算图上按节点名挂钩子return_nodes的键是模型内部的模块名,值是自定义的别名- 一次前向即可取回所有需要的层输出,比逐个注册钩子简洁得多
python
model.eval()

with torch.no_grad():
    outputs = extractor(images)

    feat1 = outputs["feat1"]        # (B, 64, 56, 56)
    feat2 = outputs["feat2"]        # (B, 128, 28, 28)
    feat3 = outputs["feat3"]        # (B, 256, 14, 14)
    feat4 = outputs["feat4"]        # (B, 512, 7, 7)

    feature = outputs["feature"]    # (B, 512, 1, 1)
feature = torch.flatten(feature, 1) # (B, 512)- 需要注意,
avgpool的输出形状是(B, 512, 1, 1)而非(B, 512)- 因为
AdaptiveAvgPool2d属于池化层,会保留两个长度为 1 的空间维度,必须手动flatten才能得到真正的二维向量 - 若遗漏这一展平步骤,后续计算距离或执行
PCA时形状会持续出错
- 因为
- 另外,
feature的提取与feat1到feat4的提取可以放在同一个extractor中 ,只需把avgpool一并写入return_nodes- 此处分开书写,是为了让两段代码各自的意图更清晰
5-4 Feature Map可视化
- 接下来考察第一个问题:四个 stage 的特征图分别呈现出什么形态
- 为使观察对象具有代表性,这里取逐类
top-1精度最高与次高的两个类别各一张测试图像 - 按 4-4-2 节的统计,这两个类别是
frog(98.70%)与automobile(98.30%)
- 为使观察对象具有代表性,这里取逐类
- 前者的纹理与背景差异明显,后者轮廓规整,模型在这两类上都很少判错,其响应图也更干净,适合作为观察样本
- 把四个 stage 的通道平均响应放在一起对比
5-4-1 通道平均响应
- 每张图是把该 stage 所有通道的激活在通道维度上求平均后显示为热力图,标题标注了各自的张量形状
- 从中可以直接观察到三个现象:
- 其一,空间尺寸逐级收缩,依次为
56×56、28×28、14×14、7×7,位置信息被逐层丢弃 - 其二,图像四周存在一圈明显的亮边,这主要是卷积零填充产生的边界效应,并不代表真实的语义响应。
- 其三,从
layer1到layer4,响应分布逐渐集中layer1的响应较为弥散,几乎处处存在;layer4则收缩为若干明确的亮斑,这些亮斑对应图中主体所在的位置
- 其一,空间尺寸逐级收缩,依次为
- 我们可以一目了然的看到"低层看纹理、高层看物体"这一规律
5-4-2 单通道响应
- 通道平均会把所有通道的信息叠加在一起,无法看出单个通道的功能
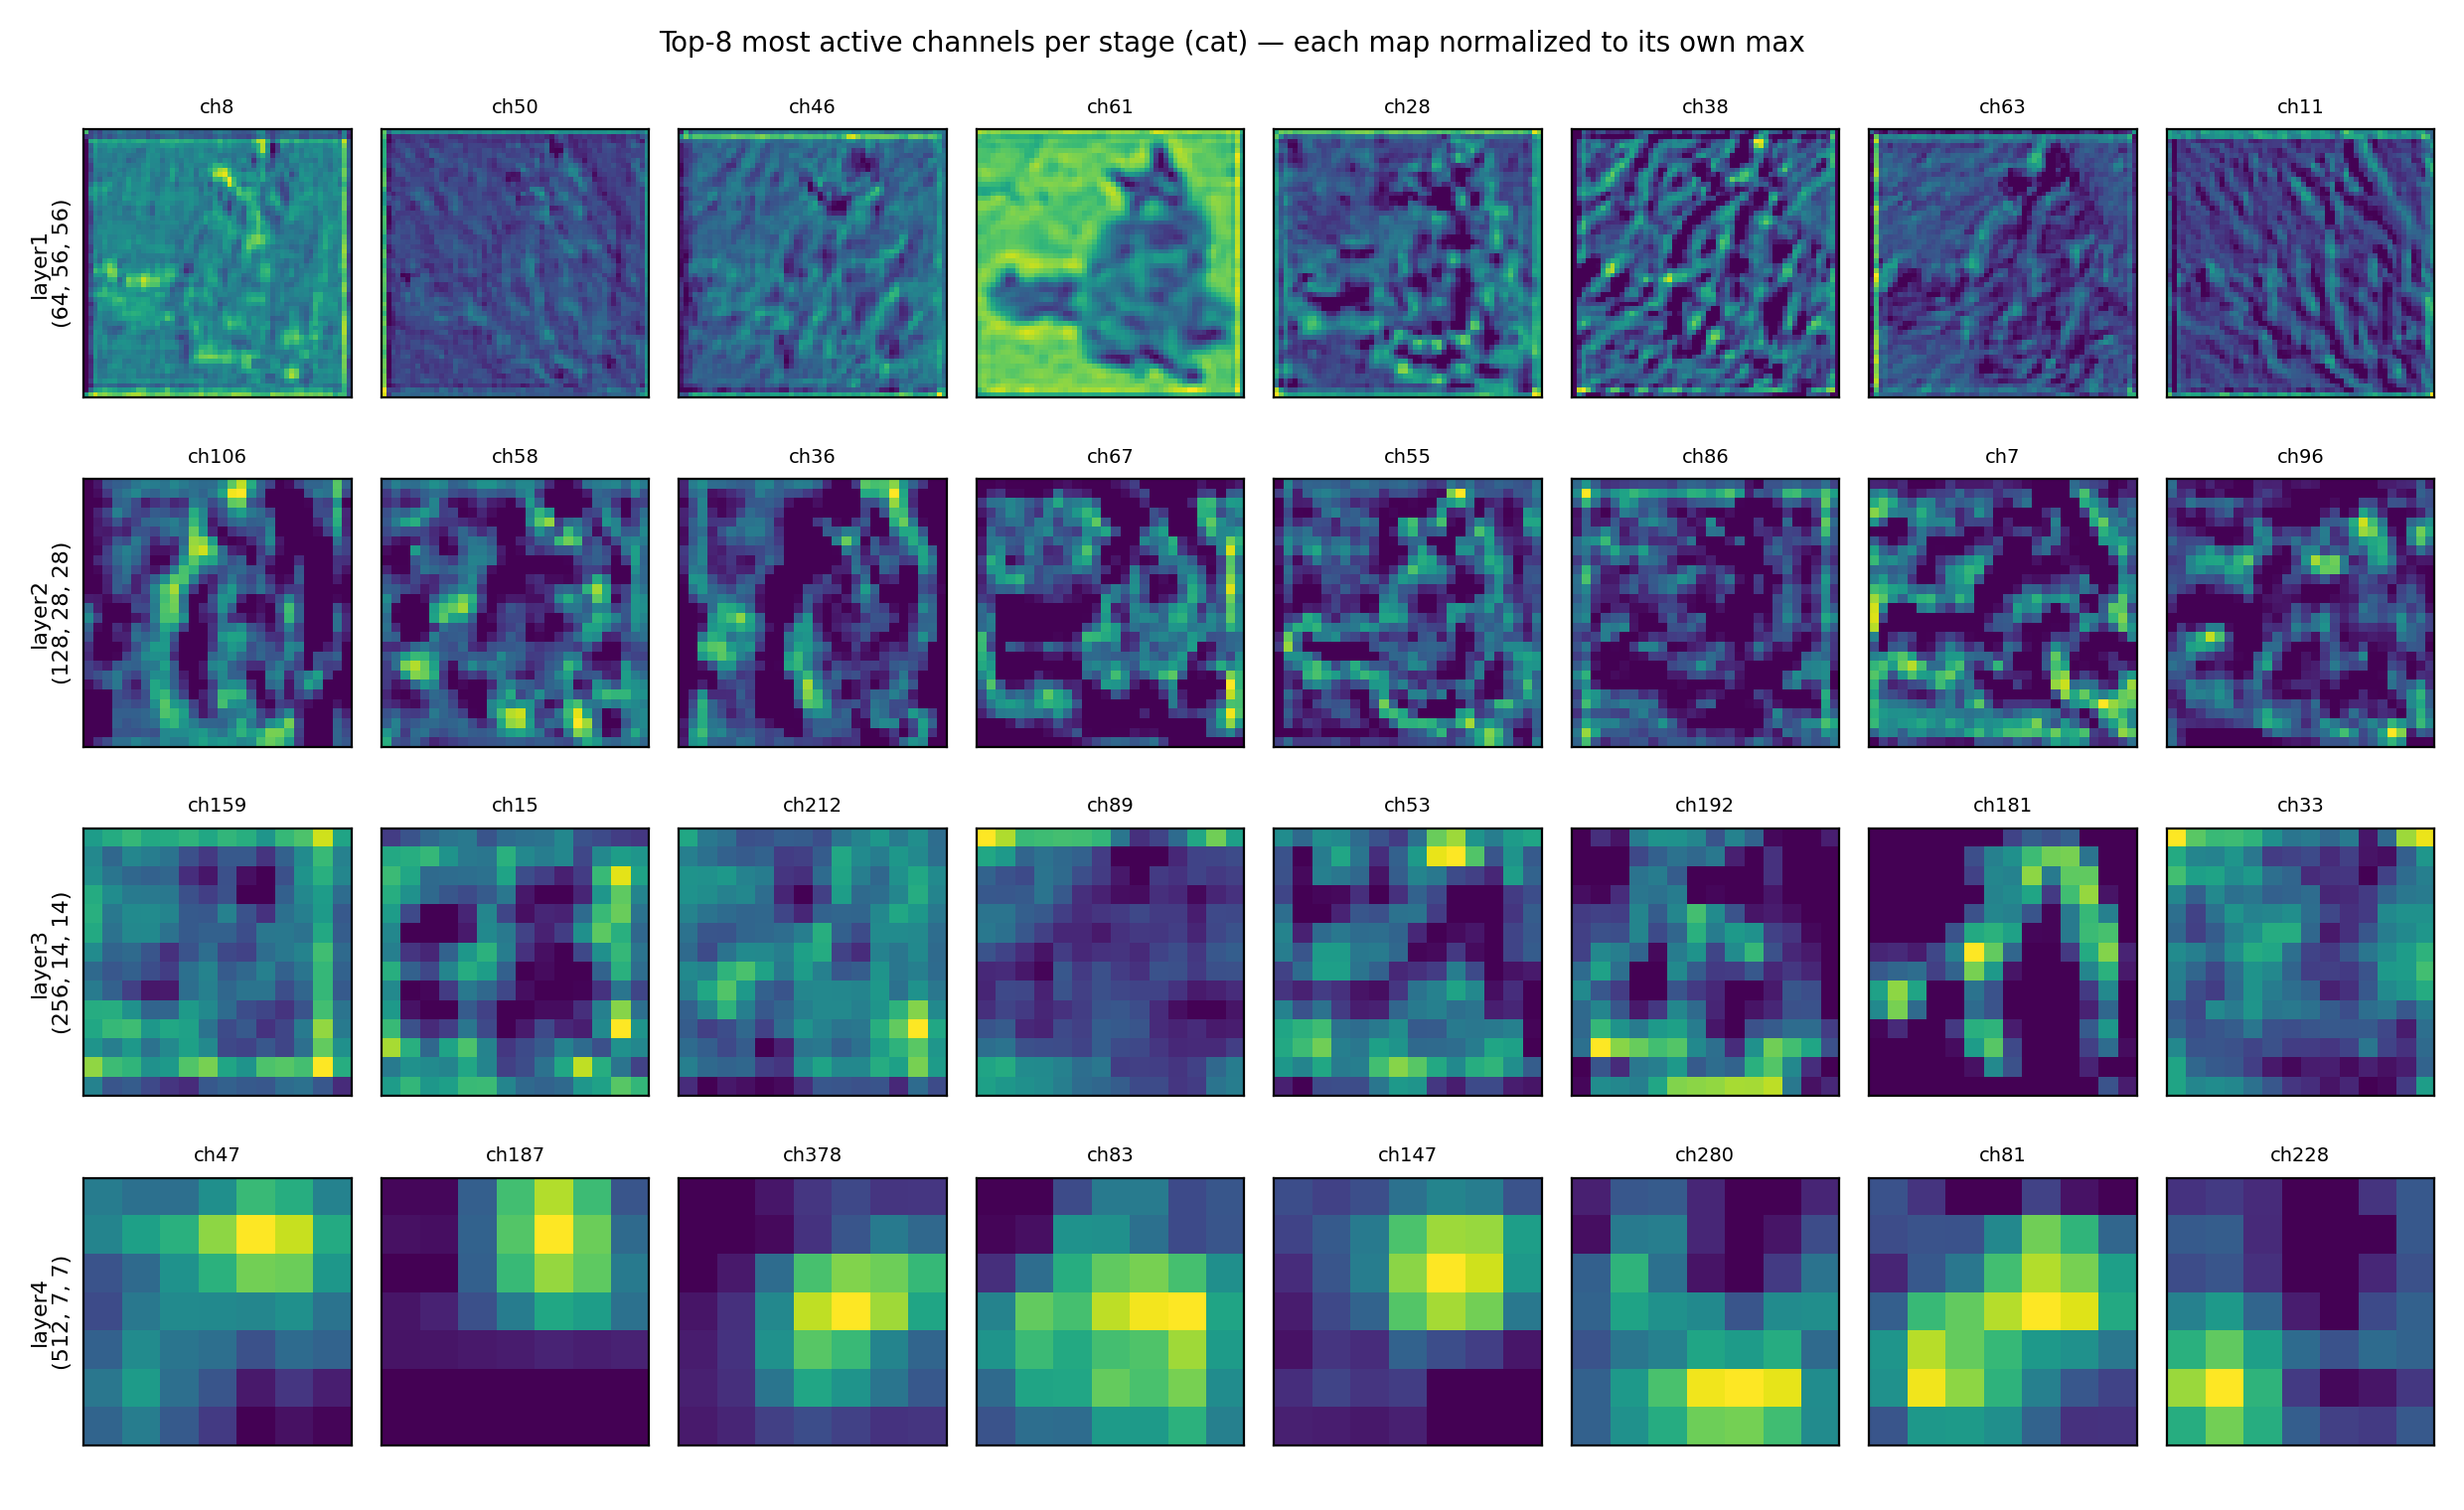
- 因此我们继续从所有 Feature Map(通道)里,挑出"响应值最大"的 8 个通道,然后把这 8 张 Feature Map 可视化出来。
- 通道的选取方式是按空间平均响应排序,取前 8 名
- 两张图使用同一套选取规则,可以在同一口径下对比
- 此处有一个必须注意的处理:每个通道都做了独立归一化
- 原因是通道之间的响应强度差异很大,若统一使用一个色标,弱响应通道会整片呈现为同一颜色,内部结构无法辨认
- 归一化的作用是让每个通道都能显示自身的图案,代价是不同通道之间的绝对强弱不再可直接比较
- 从图中可以看出清晰的功能分工
layer1的通道大多响应边缘与颜色块,通道之间的区别在于所响应的边缘方向layer2开始出现局部部件,例如圆弧与拐角这一类结构layer3的响应已经能体现物体的部件组合layer4的响应收缩为单个连通的亮斑,不再像低层那样铺满整幅图,通道之间的差别也退化为亮斑的形状与偏心方向
- 这一收缩过程也解释了
avgpool存在的必要性:到layer4时,空间上仅剩 49 个位置,任何依赖精确位置的下游任务都难以在此之上展开,不如直接平均得到一个稳定的全局描述子
6 Visual Feature Space
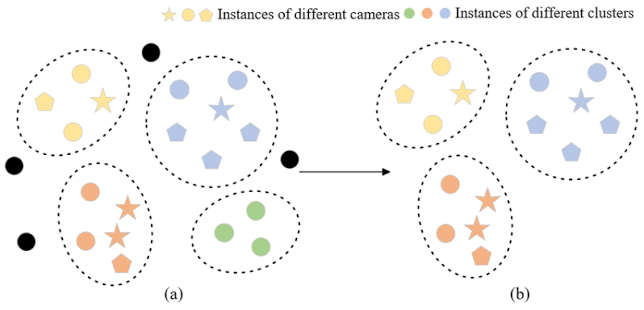
- 观察完单个 stage,再退一步看全局
- 前面得到的 512 维向量,如果把每张图像视为 512 维空间中的一个点,十类图像是否会自然聚成十团
- 这直接决定了这些特征能否被下游任务直接使用
- 但 512 维无法直接绘制,因此第一步需要降维
6-1 PCA降维
6-1-1 PCA的数学形式
PCA(Principal Component Analysis,主成分分析)的目标很明确:寻找若干方向,使数据投影到这些方向后方差最大- 之所以追求方差最大,是因为方差大意味着数据在这些方向上分布得更展开,保留的信息更多
- 假设数据中心化之后为矩阵X∈RN×DX \in \mathbb{R}^{N \times D}X∈RN×D,需要求一组投影方向v1,v2,...v_1, v_2, \dotsv1,v2,...
- 第一个主成分即在单位约束下最大化投影方差:
v1=argmax∥v∥=1∥Xv∥2v_1 = \arg\max_{\|v\|=1} \|Xv\|^2v1=arg∥v∥=1max∥Xv∥2
* 这等价于求协方差矩阵$C = \frac{1}{N-1}X^{\top}X$的最大特征值所对应的特征向量- 第二个主成分在与第一个正交的约束下重复同样的过程,依次类推每个主成分解释的方差占比为:
ratiok=λk∑jλj\text{ratio}k = \frac{\lambda_k}{\sum{j} \lambda_j}ratiok=∑jλjλk
- 以防你忘记:
- XXX:中心化后的特征矩阵,本文中为N×512N \times 512N×512
- vkv_kvk:第kkk个主成分方向
- λk\lambda_kλk:对应的特征值,正比于该方向上的方差
- ratiok\text{ratio}_kratiok:该主成分解释的方差占全部方差的比例
- 从几何上看,
PCA寻找的是数据分布最为分散的方向,并把数据投影到这些方向上,从而以尽可能少的维度保留尽可能多的差异
6-1-2 用SVD实现PCA
- 直接对512×512512 \times 512512×512的协方差矩阵做特征分解是可行的,但需要先构造协方差矩阵并做平方运算,条件数会被放大
- 本文的实现不求协方差矩阵,而是直接对中心化后的数据做奇异值分解
python
def pca(X, n_components=2, center=True):
    X = torch.as_tensor(X, dtype=torch.float32)

    if center:
        # PCA 的前提是数据中心化,否则第一主成分会被均值方向带偏
        X = X - X.mean(dim=0, keepdim=True)

    # 直接对中心化后的数据做 SVD,等价于对协方差矩阵做特征分解,
    # 且不放大条件数,数值上更稳
    _, singular, Vh = torch.linalg.svd(X, full_matrices=False)

    # 投影到前 n_components 个主成分上
    scores = X @ Vh[:n_components].T

    # 每个主成分的方差 = 奇异值平方 / (N - 1)
    variance = singular ** 2 / max(X.shape[0] - 1, 1)
    ratio = variance / variance.sum()

return scores.numpy(), ratio.numpy()- 该实现的关键,是把协方差矩阵的特征分解与数据矩阵的奇异值分解对应起来
- 因为C=1N−1X⊤XC = \frac{1}{N-1}X^{\top}XC=N−11X⊤X,而X=UΣV⊤X = U\Sigma V^{\top}X=UΣV⊤,所以C=VΣ2N−1V⊤C = V\frac{\Sigma^2}{N-1}V^{\top}C=VN−1Σ2V⊤
- 也就是说,VVV的列即主成分方向,Σ2/(N−1)\Sigma^2/(N-1)Σ2/(N−1)即对应的特征值
- 采用
SVD(Singular Value Decomposition,奇异值分解)的好处在于避免了显式构造协方差矩阵及其平方运算,条件数更小,数值稳定性更好- 该实现不依赖
scikit-learn,torch.linalg.svd已经足够
- 该实现不依赖
- 中心化这一步同样不可省略:若不减去均值,第一主成分会被数据的均值方向带偏,散点图通常表现为所有点挤向某一角落
6-2 Feature Space 可视化:512-D → 2-D
- Visual Feature Space(视觉特征空间) 是指模型将图像转换成特征向量或特征图后,这些视觉特征所构成的一个高维表示空间,在这个空间中,具有相似视觉特征的图像通常会具有更接近的表示
- 它与像素空间的区别在于按"内容是否相似"组织数据:两张汽车照片即使一左一右,在特征空间中也会彼此靠近
因此判断一份特征的质量,就看它在这个空间中的分布形态:同类是否聚拢,异类是否分开
- 绘图数据:从
CIFAR-10测试集按类别均匀取 2000 张(每类 200 张),经微调后的主干得到 512 维特征,再用 6-1 节的PCA压到二维;对照组换成未微调的预训练权重,其余完全相同
- 左上为微调后的特征空间,右上为预训练对照组,每个点是一张图像,颜色表示类别,黑色
×为类别质心 - 下方是解释方差曲线,柱形为单个主成分,折线为累计值
- 曲线显示,微调后前两个主成分只解释
20.4%的方差,前 50 个累计才到82.7%- 这说明 512 维中的信息高度分散,二维投影只是便于观察的窗口,不能用解释方差的高低来评判特征质量
- 两张散点图的差别完全体现在颜色的分布上
- 左图十种颜色各自成团,整体从左上到右下排列,只有
automobile与truck相互交叠 - 右图颜色彼此混杂,
cat、deer、dog三类的点云几乎完全重合,其前两个主成分只解释15.7%的方差;可见预训练特征虽语义能力强,服务的却是ImageNet的一千类,边界并不贴合CIFAR-10的十类
- 左图十种颜色各自成团,整体从左上到右下排列,只有
- 量化指标取类间方差占总方差的比例 ,对 512 维原空间与
PCA二维投影分别计算
| 指标 | ImageNet 预训练(微调前) | CIFAR-10 微调后 |
|---|---|---|
| 类间方差占比(512 维原空间) | 18.68% | 52.23% |
| 类间方差占比(PCA 二维投影) | 27.0% | 63.1% |
| PC1 与 PC2 解释方差 | 15.7% | 20.4% |
- 这张表是全文信息量最大的结果之一:512 维原空间中,微调把属于类别的方差由不足两成提升到过半
- 也就是说,方差的主要来源从同一类别内部的差异变成了类别之间的差异,与上面两张散点图一一对应
- 二维投影的占比(63.1%)高于原空间(52.23%)并不矛盾:
PCA本就按方差最大化选择方向,会优先保留类间差异这类大尺度结构 - 因此判断特征质量应以 512 维原空间的
52.23%为准,二维图只是择优投影后的观察窗口
- 经过微调的
ResNet18主干由此构成一个类别结构清晰 的特征空间,这正是它能作为ACT(Action Chunking Transformer,动作分块 Transformer)、VLA、视觉强化学习等任务输入的原因:下游任务不需要从像素开始学习"什么是物体"
6-3 Feature Space 代码实现
- 上表中的类间方差占比由下面这个函数算出,它接受特征矩阵与类别标签,返回该比值
python
def class_separability(features, labels):
    overall_mean = features.mean(dim=0, keepdim=True)

    # 类间方差:每个类别的质心偏离全局均值的程度,按样本数加权
    between = 0.0
    for c in labels.unique():
        group = features[labels == c]
        between += group.shape[0] * \
            ((group.mean(dim=0) - overall_mean) ** 2).sum()

    # 总方差:所有样本偏离全局均值的程度
    total = ((features - overall_mean) ** 2).sum()

return (between / total).item()- 实现只有三步:求全局均值、按类别累加类间平方和、除以总方差
- 类间项乘上
group.shape[0]不能省,否则样本数少的类别会被低估权重 - 分子与分母都在求平方和,因此把特征整体乘以 10,两者同步放大 100 倍,比值不变
- 这正是它能直接比较两份特征的原因:即使微调前后的特征幅度差异很大,数值仍落在同一量纲上
- 同一个函数既可作用于 512 维原空间,也可作用于
PCA之后的二维坐标- 6-2 节表中的类间方差占比都由它算出,解释方差那一行则来自 6-1 节
PCA的返回值
- 6-2 节表中的类间方差占比都由它算出,解释方差那一行则来自 6-1 节
- 整个实现不依赖
scikit-learn,几行张量运算即可
总结
- 本文从
CNN提取视觉特征的基本规律出发,经过ResNet的残差学习原理、ResNet18的结构解析、CIFAR-10上的完整训练,一直推进到三个特征可视化任务,把"一张图像如何转换为 512 维视觉特征"这条链路完整走了一遍 - 核心要点回顾:
- 残差学习的本质 :网络加深后训练误差反而升高,问题不在表达能力而在优化过程,
y = F(x) + x为网络保留了一条恒等映射通路 - 512 这一数值的来源 :
layer4输出512 × 7 × 7,avgpool只在空间维度取平均,得到 512 维全局描述子,其中 512 是通道数而非空间尺寸 - 两段式微调的必要性 :先冻结主干训练分类头,再解冻全量微调;解冻带来的提升是断层式的,验证精度在一个 epoch 内从
79.56%升至93.96% - 冻结必须彻底 :主干冻结时
BatchNorm也要切换到eval(),否则其滑动均值会被新数据集改写 - 特征提取使用官方接口 :
create_feature_extractor按节点名挂钩子,一次前向取回所有需要的层输出,其中avgpool的输出需要手动flatten - 微调确实重塑了特征空间 :512 维原空间中,类间方差占比从
18.68%提升到52.23%,特征由以类内差异为主转为以类间差异为主 - 二维投影不能替代定量指标 :
PCA会主动保留类间差异,二维图上的类间方差占比(63.1%)偏高,判断特征质量应以原空间数值为准
- 残差学习的本质 :网络加深后训练误差反而升高,问题不在表达能力而在优化过程,
- 如有错误,欢迎指出!
- 感谢观看!