目录
[2.1 C语言中的字符串](#2.1 C语言中的字符串)
[2.2 string到底是什么?](#2.2 string到底是什么?)
[3.1 string的构造](#3.1 string的构造)
[4.1 size()和length()](#4.1 size()和length())
[4.2 capacity()](#4.2 capacity())
[4.3 clear()](#4.3 clear())
[4.4 reserve()](#4.4 reserve())
[4.5 resize()](#4.5 resize())
[5.1 operator\[\](最常用)](#5.1 operator)
[5.2 迭代器遍历(范围for的底层封装也是迭代器哦)](#5.2 迭代器遍历(范围for的底层封装也是迭代器哦))
[5.4 范围for](#5.4 范围for)
[5.5 范围for的底层](#5.5 范围for的底层)
[6.1 push_back()](#6.1 push_back())
[6.2 append()](#6.2 append())
[6.3 operator+=](#6.3 operator+=)
[7.1 find和npos()](#7.1 find和npos())
[7.2 substr()](#7.2 substr())
[7.3 find + substr的经典组合](#7.3 find + substr的经典组合)
[11.3 String s2(s1)会发生什么?](#11.3 String s2(s1)会发生什么?)
[11.4.1 String的深拷贝实现](#11.4.1 String的深拷贝实现)
[12. 赋值运算符同样存在浅拷贝](#12. 赋值运算符同样存在浅拷贝)
[12.2 现代版写法:swap](#12.2 现代版写法:swap)
[13.1 为什么string一定要理解深浅拷贝?](#13.1 为什么string一定要理解深浅拷贝?)
15.string中的operator<<和operator>>
[1. size和capacity不要混](#1. size和capacity不要混)
[2. reserve不会改变size](#2. reserve不会改变size)
[3. resize会改变size](#3. resize会改变size)
[4. clear不会主动释放capacity](#4. clear不会主动释放capacity)
[5. string和C字符串不要完全等同](#5. string和C字符串不要完全等同)
[6. 动态资源类一定要想到深拷贝](#6. 动态资源类一定要想到深拷贝)
1.前言
学习了C++中的类和对象、构造函数、析构函数、拷贝构造以及运算符重载,又接触了模板。学到这里,其实会发现C++里面有一个常见的东西:
string平时写代码的时候,我们经常会这样:
cpp
string s1("hello");
string s2("hello world");
然后直接使用:
cpp
s1 += " world";
cout << s1 << endl;如果我们使用C语言来完成同样的事情,就需要自己维护字符数组,然后配合strcpy、strlen、s等函数来完成字符串的操作。所以:
C++中的string类到底是什么?为什么要使用string?string底层又是怎么实现的?这是核心问题
这篇文章主要分成下面几个部分:
-
为什么要学习string类
-
string类的基本使用
-
string常用接口
-
string的遍历、增删查改
-
string中的几个常见问题
-
string的模拟实现
-
重点:浅拷贝与深拷贝
-
传统深拷贝与现代写法
其中前面的接口部分大家主要做到会用即可。真正值得我们重点理解的是后面的:
为什么string需要自己实现拷贝构造?
什么是浅拷贝?
为什么浅拷贝会导致程序崩溃?
深拷贝到底解决了什么问题?
这个才是这篇文章真正的重点。
2.为什么要学习string类?
2.1 C语言中的字符串
我们之前学习C语言的时候就已经接触过字符串。C语言中没有专门的字符串类型,它是
以
\0结尾的一组字符。
例如:
char str[] = "hello";实际上在内存中可以理解成这样,编译器读取到\0就终止
h e l l o \0如果我们想获取字符串长度,复制,追加,比较可以使用以下函数
cpp
strlen(str);
strcpy(dest, str);
strcat(dest, str);
strcmp(str1, str2);
但是这些字符串本身和操作函数是分开的,函数只是工具。字符空间还需要开发者自行管理,容易发生访问越界、内存泄漏,操作起来也是相对麻烦。而C++是面向对象的语言,所以我们自然会想到:
能不能把字符串和操作字符串的方法封装到一个类里面?
于是就有了:
cpp
string2.2 string到底是什么?
C++标准库中的string就是一个专门用来处理字符串的类。使用时需要:
cpp
#include <string>
using namespace std;
然后就可以:
cpp
string s1;
string s2("hello");
string s3(s2);
甚至可以直接进行:
cpp
s1 += "world";
cout << s1 << endl;
这就是string最大的意义:
把字符串数据和字符串操作封装到了一起。
在实际开发以及OJ刷题中,字符串相关题目也基本都会直接使用string。
3.string类的常用接口
string的接口非常多。这里没有必要一个一个全部讲。因为真正写代码的时候,不可能把所有接口全部背下来。
我的建议是:
常用的记住,不常用的需要的时候查文档。
3.1 string的构造
最常见的几种构造方式:
|---------------------------------|-------------------------------------------|
| 函数名称 | 功能说明 |
| string()(重点) | 构造空的string类对象,即空字符串 |
| string(const char* s)(重点) | 用C-string来构造string类对象 |
| string(size_t n, char c) | string类对象中包含n个字符c |
| string(const string&s)(重点) | 拷贝构造函数 |
cpp
string s1;
string s2("hello");
string s3(10, '*');
string s4(s2);
分别对应:
cpp
s1:空字符串
s2:"hello"
s3:"**********"
s4:拷贝s2
代码:
cpp
#include <iostream>
#include <string>
using namespace std;
int main()
{
    string s1;
    string s2("hello");
    string s3(10, '*');
    string s4(s2);
    cout << s1 << endl;
    cout << s2 << endl;
    cout << s3 << endl;
    cout << s4 << endl;
    return 0;
}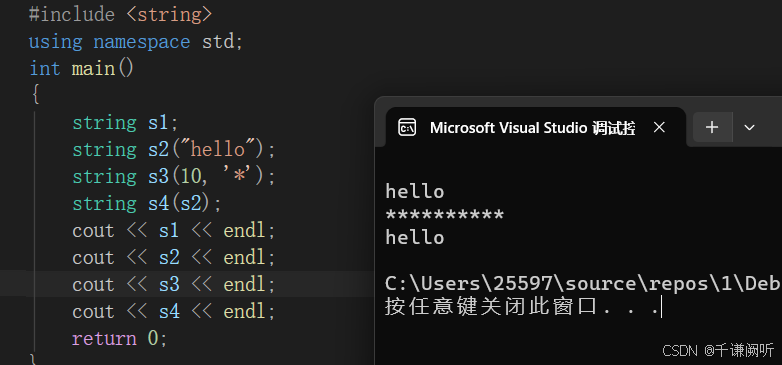
string s4(s2);这实际上就涉及到我们后面重点要讲的:拷贝构造函数。
4.string的容量操作
string里面有几个比较常用的容量相关接口。
| 函数 | 作用 |
|---|---|
| size() | 获取有效字符长度 |
| length() | 获取有效字符长度 |
| capacity() | 获取容量 |
| empty() | 判断是否为空 |
| clear() | 清空字符串 |
| reserve() | 预留空间 |
| resize() | 改变有效字符个数 |
4.1 size()和length()
两者作用相同,那么使用哪个?
cpp
string s("hello");
cout << s.size() << endl;
cout << s.length() << endl;结果都是:5。为什么要有两个?获取的都是字符串有效字符长度。之所以提供size(),主要是为了和其他容器保持统一的接口。所以平时用哪个多不用挑明了。
4.2 capacity()
capacity表示:
当前string底层空间能够容纳多少有效字符。
例如:
cpp
string s("hello");
cout << s.size() << endl;
cout << s.capacity() << endl;
这里:
size:5
capacity:可能大于5
结果演示:
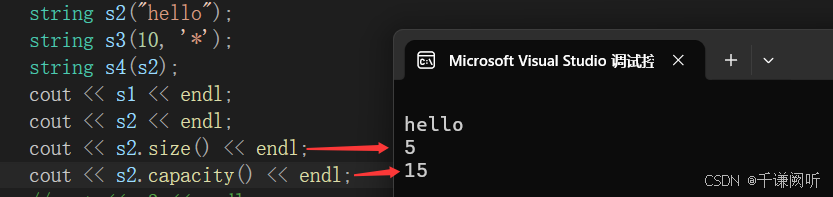
为什么capacity一般不等于size?因为string为了提高效率,通常会提前开辟一些空间。如果每增加一个字符都重新申请空间,那么效率也太低了。所以string会:
cpp
先申请一块比较大的空间
        ↓
不断添加字符
        ↓
空间不足
        ↓
再扩容
这和我们之前实现顺序表、栈的时候其实是一样的。
4.3 clear()
cpp
string s("hello world");
cout << s.size() << endl;
s.clear();
cout << s.size() << endl;
cout << s.capacity() << endl;
这里要注意:
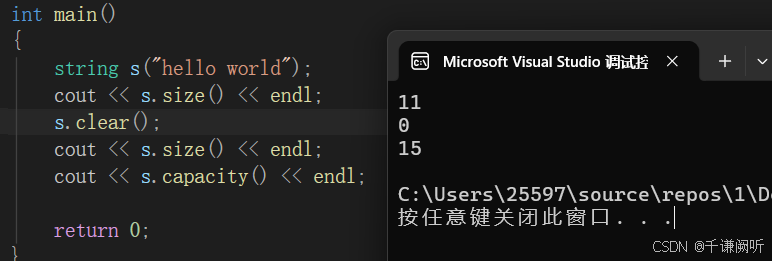
clear()只是把string中的有效字符清空,并不会主动把底层空间大小释放掉。
也就是说:
size ↓
capacity一般不变
这个地方很容易搞混,当然resize就不一样了,后面会介绍。
4.4 reserve()
reserve可以理解成:
提前给string预留空间。
cpp
string s;
s.reserve(100);
就是开了个100的空间,这样我们就提前让string准备一块能够容纳较多字符的空间。如果我们大概知道后面要存很多数据,可以使用reserve。
cpp
string s;
s.reserve(1000);
for(int i = 0; i < 1000; ++i)
{
    s += 'a';
}
这样可以减少频繁扩容,增加效率。
4.5 resize()
resize和reserve非常容易搞混。
大家记住:
reserve:只管空间,不管有效字符个数。
而:
resize:改变有效字符个数。
例如:
cpp
string s("hello world");
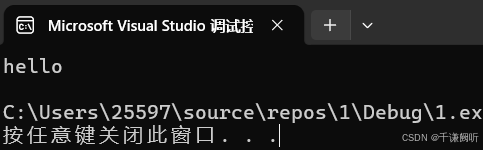
s.resize(5);
cout << s << endl;
结果:
如果扩大:
cpp
s.resize(10, 'x');那么多出来的部分会使用x进行填充。
5.string的访问和遍历
string本质上还是一个字符序列,所以我们可以像数组一样访问。
5.1 operator\[\](最常用)
cpp
string s("hello world");
cout << s[0] << endl;
cout << s[1] << endl;
非const string成员也可以进行修改,但是加了const的限定修饰就不行:
cpp
s[0] = 'H';5.2 迭代器遍历(范围for的底层封装也是迭代器哦)
string同样支持迭代器:
cpp
string s("hello world");
string::iterator it = s.begin();
while(it != s.end())
{
    cout << *it << " ";
    ++it;
}
begin()指向第一个字符,end()指向最后一个字符的下一个位置,也就是'\0',其实这个东西和vector、list的迭代器非常类似。也就是说:
STL容器的很多操作方式都是统一的。
5.4 范围for
C++11之后可以更加简单:
cpp
for(auto ch : s)
{
    cout << ch << " ";
}
如果想修改字符,就加上引用:
cpp
for(auto& ch : s)
{
    ch++;
}这里的auto&非常重要,前者是值拷贝,修改拷贝不会影响原来的字符串,后者是引用,修改后也改变了原来的值。
5.5 范围for的底层
范围for的本质上还是用的迭代器,可以说如果可以用迭代器,那就可以用范围for,如果不能用,那就意味着迭代器是被ban掉的。
6.string的修改操作
string除了可以访问,还可以进行各种修改。
6.1 push_back()
在末尾插一个字符(c):
cpp
string s("hello");
s.push_back('!');
cout << s << endl;
结果:
6.2 append()
尾部追加字符串(str):
cpp
string s("hello");
s.append(" world");
cout << s << endl;
结果:
6.3 operator+=
这个更常用
cpp
string s("hello");
s += "world";
cout << s << endl;
结果:
所以:
cpp
s.push_back('x');
s.append("xxx");
s += "xxx";都可以完成字符串追加。但是+=使用起来更加自然。
7.string的查找与截取
这个部分在OJ题里面非常常见。
7.1 find和npos()
例如:
cpp
string s("hello world");
size_t pos = s.find("world");
cout << pos << endl;
因为:
hello world
0123456789...所以可以找到world的位置。
如果没有找到:会返回:
cpp
string::npos所以一般写:
cpp
size_t pos = s.find("world");
if(pos != string::npos)
{
    cout << "找到了" << endl;
}
7.2 substr()
substr可以用来截取字符串。
cpp
string s("hello world");
string sub = s.substr(6, 5);
cout << sub << endl;
它的意思就是:从下标6开始,截取5个字符
7.3 find + substr的经典组合
例如一个URL:
cpp
string url = "ftp://www.baidu.com/?tn=65081411_1_oem_dg";我们可以把它拆成:协议,域名,资源
实现代码:
cpp
size_t pos1 = url.find("://");
if(pos1 != string::npos)
{
    string protocol = url.substr(0, pos1);

    cout << protocol << endl;
}

size_t pos2 = url.find('/', pos1 + 3);

if(pos2 != string::npos)
{
    string domain = url.substr(pos1 + 3,
                               pos2 - (pos1 + 3));

    string uri = url.substr(pos2 + 1);

    cout << domain << endl;
    cout << uri << endl;
}这个例子其实还蛮有意思的,因为我们学习一个接口最终还是为了使用。find()负责找位置substr()负责:截取。两个接口配合起来,就可以完成很多字符串处理。
8.string的删除操作
string还提供了erase。
cpp
string s("hello world");

s.erase(5, 1);

cout << s << endl;
删除从下标5开始的一个字符。也可以:
cpp
s.erase(5);表示从下标5开始一直删除到结尾。
9.string的比较
string支持:
<
>
<=
>=
==
!=
例如:
cpp
string s1("hello");
string s2("helloxxx");

cout << (s1 < s2) << endl;
cout << (s1 > s2) << endl;
cout << (s1 == s2) << endl;
string的比较本质上是按照字符的字典序进行比较。比如:
cpp
"hello"
"helloxxx"
前面的部分都相同。但是hello更短。所以:
cpp
"hello" < "helloxxx"10.string中的一个特殊问题:'\0'
这里有一个非常值得注意或者学习的地方。C中的字符串,是通过:
'\0'判断字符串结束的。但是string不一样。string内部有自己的:
size来记录有效字符个数。例如:
cpp
string s("hello world");
s += '\0';
s += "!!!!!!!!!!";
cout << s.c_str() << endl;
cout << s << endl;
这里就可以观察到一个很有意思的测试结果:
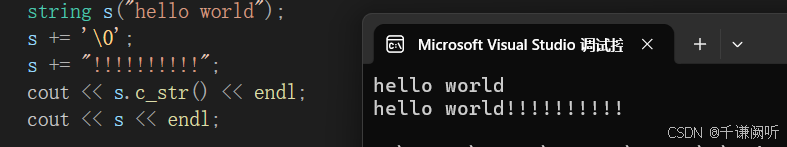
c_str()返回的是C风格字符串,适合需要和C接口的场景。而string自己内部记录的是:
sizeC字符串看
\0,string主要看自己的size。
这一点在string模拟实现的时候尤其重要。
11.string模拟实现
一直在使用string。那么问题来了:
string到底是怎么实现的?
当然不是把string标准的函数全部复现一遍,那就太老实了,也太耗费时间了我们这里主要是为了理解:
一个管理动态字符数组的类应该怎么设计。
所以我们自己简单实现一个:
class String就可以了。
11.1string模拟实现的基本结构
我们先思考一下。一个字符串至少需要管理什么?
例如:
String s("hello");底层肯定需要一块空间保存:
h e l l o \0所以我们至少需要字符串指针:
cpp
char* _str;如果还要支持扩容,就需要:
cpp
size_t _size;
size_t _capacity;
因此可以设计成:
cpp
class String
{
private:
    size_t _size;
    size_t _capacity;
    char* _str;
};
这个结构其实和我们之前实现顺序表、栈的时候非常类似。
11.2.构造函数和析构函数
构造函数:
cpp
String(const char* str )
	:_size(strlen(str))
	, _capacity(_size)
	, _str(new char[_capacity + 1])
{

	memcpy(_str, str, _size + 1);
}
这里多申请一个空间,是为了存斜杠0,不然会出现空间不足:
'\0'析构的时候:
cpp
~String()
{
    delete[] _str;
    _str = nullptr;
    _size = _capacity = 0;
}
到这里看起来似乎好像没有什么问题。
但是问题马上就来了。
11.3 String s2(s1)会发生什么?
假设:
cpp
String s1("hello");

String s2(s1);
我们没有写拷贝构造函数。那么编译器会自动生成一个默认拷贝构造。默认拷贝构造做的之前也是反复强调的浅拷贝:
编译器只是将对象中的值拷贝过来 。如果 对象中管理资源 ,最后就会 导致 多个对象共
享同一份资源 ,当一个对象销毁时就会将该资源释放掉,而此时另一些对象不知道该资源已经被释放,以为 还有效,所以当继续对资源操作时,就会发生了访问违规
按照成员变量进行逐字节拷贝。
我们的类里面有:
cpp
size_t _size;
size_t _capacity;
char* _str;
思路是:
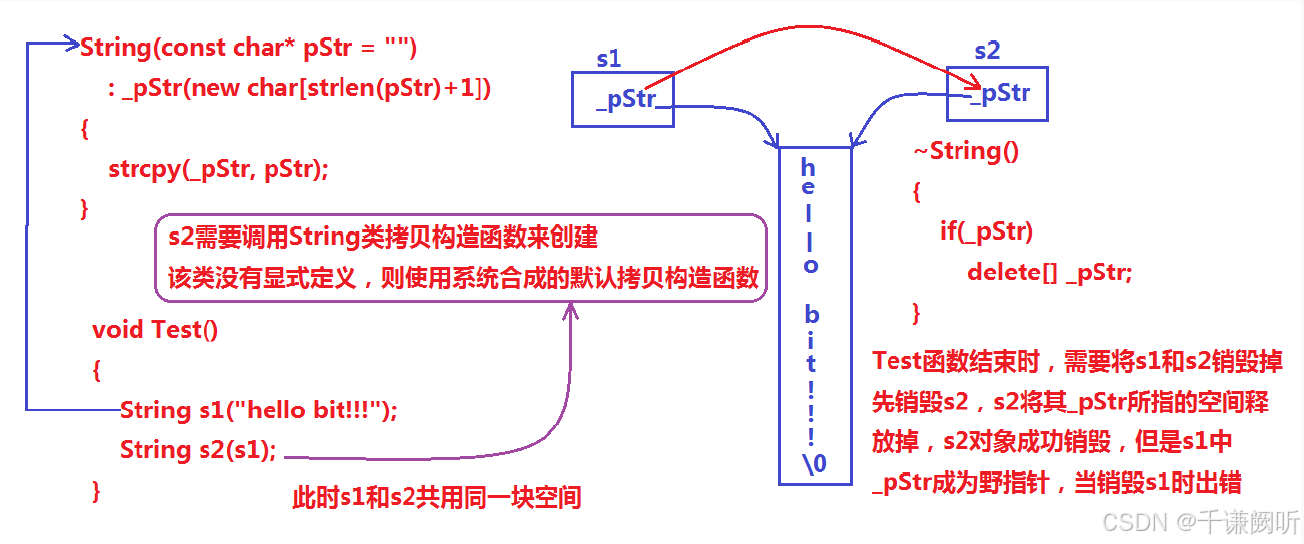
也就是说:
s1和s2的_str指向了同一块空间。
例如:
cpp
String s1("hello");

String s2(s1);
执行完之后:
cpp
s1
 └── _pstr ──────┐
                │
                ↓
             hello
                ↑
                │
 └── _pstr ──────┘
s2两个对象共用同一块空间。但是一旦对象销毁:问题就出现了。先析构s2:
s2析构
 ↓
delete[] _str
 ↓
hello这块空间被释放但是:s1._pstr仍然保存着原来的地址。此时s1以为这块空间还是我的。但其实实际上这块空间早已被释放了。当s1再次析构:同一块空间被释放两次。 这就是经典的:double free程序可能直接崩溃,就炸了。
11.4.深拷贝
既然浅拷贝有问题,那么怎么办?答案就是:
深拷贝。
深拷贝的核心思想其乃是:
每个对象拥有自己独立的空间资源。
上面的例子深拷贝之后应该是:
s1._str ─────→ "hello"

s2._str ─────→ "hello"
虽然两个字符串内容一样:
hello但是:
它们不是同一块空间。地址不一样。
所以:
s1销毁
 ↓
释放s1自己的空间

s2销毁
 ↓
释放s2自己的空间
互不影响。
这才是正确的资源管理。
11.4.1 String的深拷贝实现
那么拷贝构造就不能让编译器默认生成了。需要自己写:
cpp
String(const String& s)
{
    _str = new char[s._capacity + 1];
    memcpy(_str, s._str, s._size + 1);
    _size = s._size;
    _capacity = s._capacity;
}
这里最关键的是:重新申请了一块空间。
new char[...]然后:memcpy(...)把原来的字符串内容复制过来。这样两者彻底独立,每个人都有独立的空间。
12. 赋值运算符同样存在浅拷贝
解决了拷贝构造就结束了?还有一个非常重要的地方:
=例如:
cpp
String s1("hello");
String s2("world");
s1 = s2;
这时候是:
两个已经存在的对象进行赋值。
和:
String s1(s2);是不一样的。前者是:赋值运算符重载后者是:拷贝构造如果我们不写:operator=。编译器也会自动生成。默认情况下同样是逐字节拷贝:
s1._str ──→ hello
s2._str ──→ world

s1 = s2

s1._str ──┐
          ├──→ world
s2._str ──┘于是又出现了两个对象管理同一块资源的问题。还是浅拷贝
所以可以记住但凡是
涉及动态资源管理的类,一般都需要自己实现拷贝构造、赋值运算符以及析构函数。
这也是我们之前学习类和对象时反复强调的内容。
12.1.传统写法的赋值运算符
我们可以这样写,
cpp
String& operator=(const String& s)
{
    if(this != &s)
    {
        char* tmp = new char[s._capacity + 1];
        memcpy(tmp, s._str, s._size + 1);
        delete[] _str;
        _str = tmp;
        _size = s._size;
        _capacity = s._capacity;
    }

    return *this;
}
为新对象独立申请一个临时空间,把对象s的内存空间移植新空间tmp里,释放旧空间。然后将当前对象的指针指向新的空间。这里有一个非常重要的判断:
cpp
if(this != &s)这是为了防止:**自己给自己赋值。**如果不判断,可能把自己的资源先释放掉,然后再从已经释放的空间里复制数据。所以自赋值检查非常重要。
12.2 现代版写法:swap
其实上面的赋值运算符代码还是有一点长。我们可以使用:swap,就是pua人家,大忽悠
首先写一个swap:
cpp
void swap(String& s)
{
    std::swap(_str, s._str);
    std::swap(_size, s._size);
    std::swap(_capacity, s._capacity);
}
然后:
cpp
String& operator=(String s)
{
    swap(s);
    return *this;
}是不是一下简单了很多?但是为什么参数不是const String&,而是直接传值?因为进入函数之前已经用拷贝构造得到了一个副本,这个副本拥有自己的资源。然后直接把当前对象和这个临时副本的资源交换。函数结束以后:
临时对象s
 ↓
析构
 ↓
释放原来this的资源
整个过程就非常自然。
12.3为什么swap写法更加简洁?
s1 = s2;执行传统写法:
cpp
申请新空间
    ↓
复制数据
    ↓
释放旧空间
    ↓
修改指针指向新空间
而现代一点的写法:
cpp
String& operator=(String s)
{
    swap(s);
    return *this;
}
变成:
先构造一个副本
      ↓
swap交换资源
      ↓
临时对象析构
      ↓
释放旧资源
代码不仅短,而且:
异常安全性也更容易保证。
13.一个简化版String
为了不把模拟实现写得太复杂,这里我只保留最核心的部分。
cpp
class String
{
public:
    String(const char* str = "")
    {
        _size = strlen(str);
        _capacity = _size;
        _str = new char[_capacity + 1];
        memcpy(_str, str, _size + 1);
    }

    // 深拷贝
    String(const String& s)
    {
        _str = new char[s._capacity + 1];
        memcpy(_str, s._str, s._size + 1);
        _size = s._size;
        _capacity = s._capacity;
    }

    void swap(String& s)
    {
        std::swap(_str, s._str);
        std::swap(_size, s._size);
        std::swap(_capacity, s._capacity);
    }

    // 现代写法
    String& operator=(String s)
    {
        swap(s);

        return *this;
    }

    ~String()
    {
        delete[] _str;

        _str = nullptr;
        _size = _capacity = 0;
    }

private:
    char* _str;
    size_t _size;
    size_t _capacity;
};
13.1 为什么string一定要理解深浅拷贝?
这个问题其实非常重要。以后学习:
cpp
vector
string
list
stack
queue
以及自己写一些带动态资源的类时,都会遇到类似的问题。只要类里面出现:
new
malloc
文件句柄
资源指针那么就一定要想到:这个资源是谁申请的?谁负责释放?对象拷贝之后,资源应该共享还是独立?
如果直接使用默认拷贝,那么就可能出现浅拷贝问题,所以:
深浅拷贝本质上是一个资源管理问题。
14.写时拷贝:了解即可
除了深拷贝之外,还有一种比较经典的方式:
写时拷贝。
它的思想是:
多个对象可以先共享同一份资源,只有真正发生修改的时候,才进行拷贝。
这里就需要一个:引用计数
        ┌───────────┐
s1 ───→ │           │
s2 ───→ │ "hello"   │
s3 ───→ │ ref = 3   │
        └───────────┘
三个对象共同使用一份资源。如果只是读取:
cout << s1;
cout << s2;
大家可以一起用。如果:
s1[0] = 'H';s1要修改资源。那么s1就需要:重新申请一份空间,复制原来的内容,s1独立修改
s1 ───→ "Hello"

s2 ───→ "hello"
s3 ───→ "hello"
这就是写时拷贝的基本思想。
15.string中的operator<<和operator>>
我们平时可以直接:
cpp
string s;
cin >> s;
cout << s << endl;
是因为string重载了:operator>>,这其实和我们之前学习日期类时的流插入、流提取是一样的。
cpp
ostream& operator<<(ostream& out, const String& s)
{
    for(auto ch : s)
    {
        out << ch;
    }

    return out;
}
而输入则可以通过读取字符的方式实现。这一部分模拟实现了解原理即可,没有必要为了模拟标准库而写出非常复杂的输入代码。
16.string使用过程中几个容易踩的坑
最后再总结几个比较容易出错的地方。
- size和capacity不要混,size表示:有效字符数量。capacity表示:当前底层空间的容量。
- reserve不会改变size,只是预留空间。
- resize会改变size。s.resize(100),会改变有效字符数量。
- clear不会主动释放capacity。主要是清空有效字符。
- string和C字符串不要完全等同。C字符串:通过'\0'判断结束。string:内部维护size
- 动态资源类一定要想到深拷贝,否则非常容易出现浅拷贝问题。
17.写在最后
string这个东西刚开始接触的时候,可能会觉得:
不就是一个字符串吗?这么简单需要特意去学吗
实际上真正学习string,并不是为了记住这些接口,这些直接调用就可以,不会就看看文档
push_back()
append()
find()
substr()
erase()
真正重要的是:
通过string去理解一个类是如何管理资源的。
尤其是我们自己模拟实现string的时候:
char* _str;一旦出现了这个指针,事情就不简单了,笑容是会转移的!!!。
因为它已经不是简单的:
int
double
char
这种值类型数据。它背后管理的是一块动态申请的空间。所以当对象发生拷贝的时候,就必须考虑:是复制指针?还是复制资源?
如果只是复制指针:
s1 ──┐
     ├──→ 同一块空间
s2 ──┘
这就是**浅拷贝。**如果重新申请空间:
s1 ──→ 空间1

s2 ──→ 空间2
这就是:**深拷贝。**而深拷贝解决的核心问题就是:
让每个对象拥有自己独立的资源。
所以以后再看到这种代码:
class String
{
    char* _str;
};
一定要打起100分精神:
这里面有没有动态资源?
拷贝怎么办?
赋值怎么办?
析构怎么办?
这才是string这一章真正值得我们掌握的东西。
string只是一个开始。后面我们继续学习STL的时候,还会看到:
vector
list
stack
queue
map
set
这些容器背后其实都有很多类似的思想。把string这一关真正搞明白,后面的STL学习也会轻松很多。下篇可能会讲解string的力扣练习题。
感谢大家的观看阅读,如果这篇文章能够给你们带来哪怕一点点收获和解决困惑,那对我而言都是一种动力和成就感。如果文章对你有帮助,欢迎点赞 👍、收藏 ⭐、评论 💬 支持一下!