深入理解指针(五):回调函数、qsort 的使用与模拟实现
前言
在《深入理解指针(四)》中,我们系统梳理了字符指针、数组指针、二维数组传参、函数指针、函数指针数组以及转移表。这一篇,我们将深入探讨回调函数的本质,剖析标准库
qsort的设计哲学,并手把手带你从底层模拟实现一个属于自己的通用排序函数。
目录
一、本节目标
- 理解回调函数的概念,掌握用函数指针解耦代码的方法。
- 掌握标准库
qsort的使用,能对浮点数、字符串、结构体排序。 - 掌握通用选择排序的实现,明白
void *与字节操作的作用。---
二、回调函数是什么?
2.1 定义与本质
回调函数(callback function)本质上是一个通过函数指针间接调用的函数。它并不是一种特殊的语法,而是一种函数使用方式和设计思想。
具体来说:如果你把一个函数的指针作为参数传递给另一个函数,那么当这个指针在合适的时机被用来调用它所指向的函数时,被调用的那个函数就称为回调函数。也就是说,回调函数通常由使用者实现,但并不是由使用者直接调用,而是由接收函数指针的那一方,在特定事件发生或特定条件满足时"回头调用"。
可以概括为三个要点:
- 回调函数本身是一个函数;
- 它的地址通过函数指针作为参数传递出去;
- 它在另一个函数中被间接调用。
普通函数调用是"我知道你的名字,我现在直接调用你";回调则是"我把你的地址交给别人,别人在合适的时机再调用你"。因此,回调体现了一种控制反转:具体行为由调用者提供,但调用时机由框架或库决定。
在 C 语言中,回调通常依赖函数指针实现;在 C++ 中还可以使用函数对象、Lambda 表达式、std::function 等;例如 C 标准库中的 qsort,其比较函数就是一种典型回调。
2.2 从"通用数组遍历器"看回调函数
假设我们要对一个整型数组进行各种操作:打印、翻倍、取平方。如果不用回调函数,我们往往需要为每种操作写一个专用循环,代码高度重复。
改造前:每种操作写一个专用循环
c
#include <stdio.h>

// 打印数组
void print_array(int *arr, size_t count) {
    for (size_t i = 0; i < count; ++i) {
        printf("%d ", arr[i]);
    }
}

// 数组元素翻倍
void double_array(int *arr, size_t count) {
    for (size_t i = 0; i < count; ++i) {
        arr[i] *= 2;
    }
}

// 数组元素取平方
void square_array(int *arr, size_t count) {
    for (size_t i = 0; i < count; ++i) {
        arr[i] = arr[i] * arr[i];
    }
}

int main(void) {
    int data[] = { 1, 2, 3, 4, 5 };
    size_t n = sizeof(data) / sizeof(data[0]);

    printf("原始数据: ");
    print_array(data, n);

    double_array(data, n);
    printf("\n翻倍后: ");
    print_array(data, n);

    square_array(data, n);
    printf("\n平方后: ");
    print_array(data, n);

    printf("\n");
    return 0;
}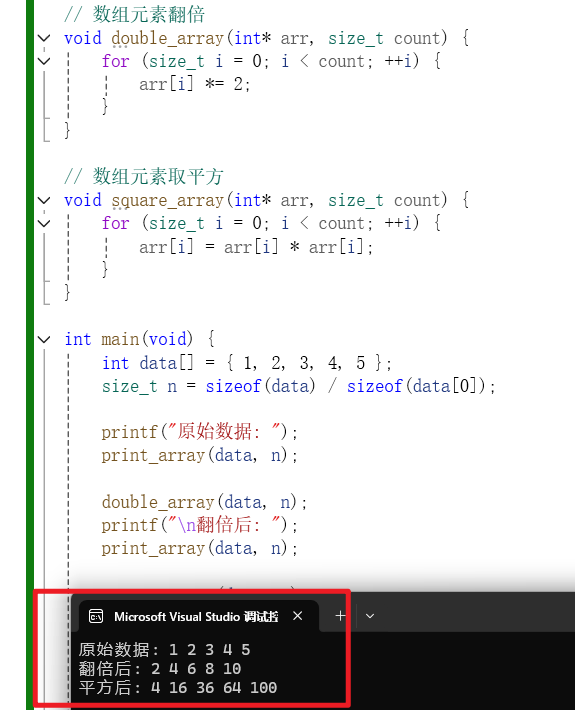
运行结果同样是:
text
原始数据: 1 2 3 4 5
翻倍后: 2 4 6 8 10
平方后: 4 16 36 64 100 可以看到,print_array、double_array、square_array 三个函数中,for 循环的结构完全一样:
c
for (size_t i = 0; i < count; ++i) {
    // 对 arr[i] 做点什么
}
变化的只是"对单个元素做什么":
- 打印:
printf("%d ", arr[i]); - 翻倍:
arr[i] *= 2; - 平方:
arr[i] = arr[i] * arr[i];
这三段循环逻辑重复了三遍。如果以后还要加"取相反数""加 1""清零"等操作,就要继续复制这个循环结构。代码量越来越大,维护成本也越来越高。一旦循环的写法需要调整,比如改成用指针遍历、增加边界检查、加入日志,就要同时修改多个函数,很容易漏改。
问题本质
专用循环的写法把两件本可以分开的事情绑死在一起:
- 遍历流程 :从第 0 个元素走到第
count - 1个元素; - 具体操作:对当前元素执行什么动作。
遍历流程是不变的,具体操作是变化的。把变化的部分抽离出来,通过函数指针传入,就得到了通用遍历框架。
改造后:通用遍历框架 + 回调函数
c
#include <stdio.h>

// 定义函数指针类型,指向"接收 int*,返回 void"的函数
typedef void (*ArrayAction)(int *);

// 具体的操作函数(回调函数)
static void print_element(int *elem) {
    printf("%d ", *elem);
}

static void double_element(int *elem) {
    *elem *= 2;
}

static void square_element(int *elem) {
    *elem = (*elem) * (*elem);
}

// 通用遍历框架
static void array_foreach(int *arr, size_t count, ArrayAction action) {
    if (arr == NULL || action == NULL) {
        return;
    }

    for (size_t i = 0; i < count; ++i) {
        action(&arr[i]);   // 通过函数指针调用回调函数
    }
}

int main(void) {
    int data[] = { 1, 2, 3, 4, 5 };
    size_t n = sizeof(data) / sizeof(data[0]);

    printf("原始数据: ");
    array_foreach(data, n, print_element);

    array_foreach(data, n, double_element);
    printf("\n翻倍后: ");
    array_foreach(data, n, print_element);

    array_foreach(data, n, square_element);
    printf("\n平方后: ");
    array_foreach(data, n, print_element);

    printf("\n");
    return 0;
}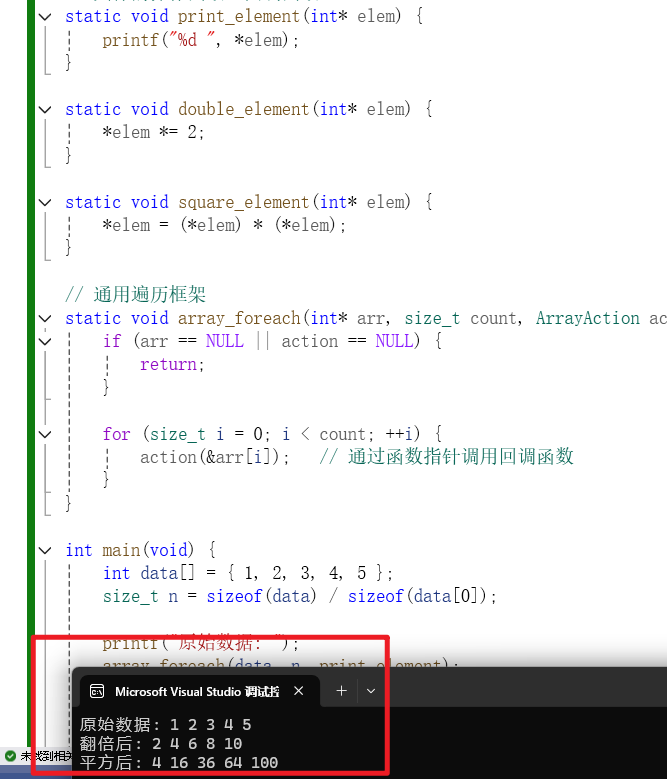
运行结果:
text
原始数据: 1 2 3 4 5
翻倍后: 2 4 6 8 10
平方后: 4 16 36 64 100
对比
| 对比项 | 改造前:专用循环 | 改造后:通用遍历框架(回调) |
|---|---|---|
| 循环代码 | 每个操作写一遍,重复三次 | 只写一次,放在 array_foreach 中 |
| 新增操作 | 需要再复制一个循环 | 只需新增一个处理单元素的函数 |
| 修改循环逻辑 | 要改多个函数 | 只改 array_foreach 一处 |
| 耦合度 | 遍历与操作强绑定 | 遍历与操作分离 |
| 扩展性 | 差 | 强 |
| 代码量 | 随操作数量线性增长 | 框架固定,操作按需增加 |
回调函数的价值:不是为了用函数指针而用函数指针,而是为了消除重复、降低耦合、提高扩展性。
2.3 使用回调时需要注意的问题
-
函数签名必须严格匹配
如果框架要求
void (*action)(int *),那么回调函数就必须是void 函数名(int *)。如果写成void print_element(int),参数类型不匹配,编译器会报错。 -
框架内部应检查空指针
arr或action可能为NULL,如果不检查就调用,会导致程序崩溃。因此框架中应加入:cif (arr == NULL || action == NULL) return; -
C 语言没有闭包,需要额外数据时可传上下文
如果回调函数需要访问外部数据,可以增加
void *context参数,例如:cvoid (*action)(int *elem, void *context)这样可以把上下文数据一并传入。
-
明确回调的调用时机和参数有效性
框架应该清楚地定义:回调会被调用多少次、按什么顺序调用、参数是否可以被修改、返回值如何处理等。
-
注意数据生命周期和线程安全
回调可能在未知时机被调用。如果回调访问共享数据,需要确保数据生命周期有效,并在多线程环境下考虑同步问题。
-
只读与可写接口可以区分
示例中为了统一签名,
print_element也接收int *,虽然它并不修改元素。工程中如果强调只读,可以设计const int *版本的遍历接口,但函数指针类型必须统一。
三、qsort 使用举例
3.1 认识 qsort
qsort 是 C 标准库 <stdlib.h> 中的通用排序函数。它的名字来源于快速排序(quick sort),但 C 标准并没有规定它必须用快速排序实现,只规定了它的排序行为和函数接口。
c
void qsort(void *base, size_t nmemb, size_t size,
           int (*compar)(const void *, const void *));
参数含义:
base:待排序数组的首元素地址。类型为void *,因此可以接收任意类型的数组。nmemb:数组中元素的个数。size:每个元素占用的字节数。compar:比较函数的函数指针,用来决定两个元素谁排在前面、谁排在后面。
比较函数 compar 的返回值含义:
- 返回值
< 0:p1指向的元素应排在p2指向的元素前面; - 返回值
== 0:两个元素等价; - 返回值
> 0:p1指向的元素应排在p2指向的元素后面。
qsort 只关心返回值的正负和是否为零,并不要求一定返回 -1、0、1。但为了清晰和一致,通常建议返回 -1、0、1。
另外,qsort 不保证稳定排序。如果两个元素比较相等,它们在排序后的相对顺序可能发生变化。如果需要稳定排序,应使用稳定排序算法,或在比较函数中加入次级比较条件。
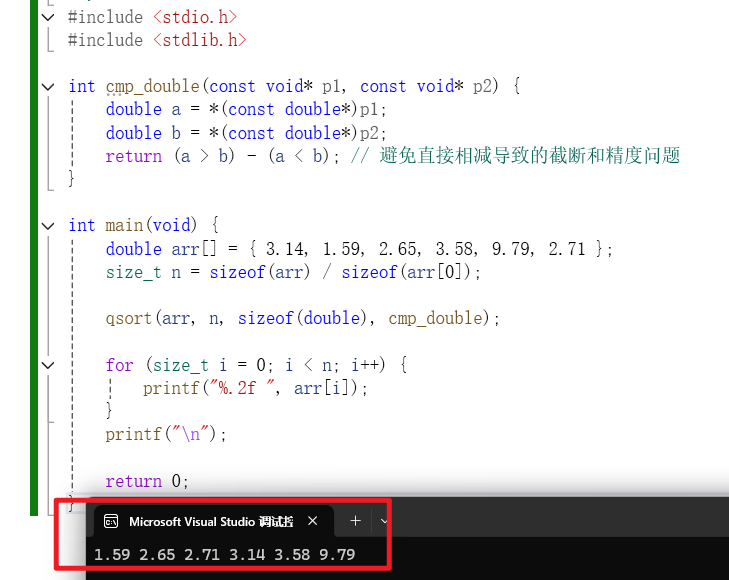
3.2 使用 qsort 排序浮点型数据
c
#include <stdio.h>
#include <stdlib.h>

int cmp_double(const void *p1, const void *p2) {
    double a = *(const double *)p1;
    double b = *(const double *)p2;
    return (a > b) - (a < b); // 避免直接相减导致的截断和精度问题
}

int main(void) {
    double arr[] = { 3.14, 1.59, 2.65, 3.58, 9.79, 2.71 };
    size_t n = sizeof(arr) / sizeof(arr[0]);

    qsort(arr, n, sizeof(double), cmp_double);

    for (size_t i = 0; i < n; i++) {
        printf("%.2f ", arr[i]);
    }
    printf("\n");

    return 0;
}
编写浮点型比较函数时,有一个关键点:浮点数比较不能像整型那样直接相减。如果写成:
c
return a - b;当 a 和 b 非常接近时,相减结果可能是一个很小的浮点数,但函数返回类型是 int,会被截断为 0,导致排序认为二者相等,结果不可靠。
因此推荐写成:
c
return (a > b) - (a < b);关系运算符的结果是 0 或 1,所以该表达式会返回 -1、0 或 1,语义清晰且安全。
同时不要忘记:p1 和 p2 是 const void *,必须先强转为 const double *,再解引用得到真正的 double 值。
如果数组中可能包含 NaN,还需要特殊处理。因为 NaN 与任何值比较都返回假,(a > b) - (a < b) 会返回 0,可能破坏排序的一致性。此时可以显式定义 NaN 的排序位置,例如把 NaN 统一放到最后。
3.3 使用 qsort 排序字符串数组
c
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

int cmp_string(const void *p1, const void *p2) {
    const char *s1 = *(const char * const *)p1;
    const char *s2 = *(const char * const *)p2;
    return strcmp(s1, s2);
}

int main(void) {
    const char *fruits[] = { "banana", "apple", "cherry", "date" };
    size_t n = sizeof(fruits) / sizeof(fruits[0]);

    qsort(fruits, n, sizeof(fruits[0]), cmp_string);

    for (size_t i = 0; i < n; i++) {
        printf("%s\n", fruits[i]);
    }

    return 0;
}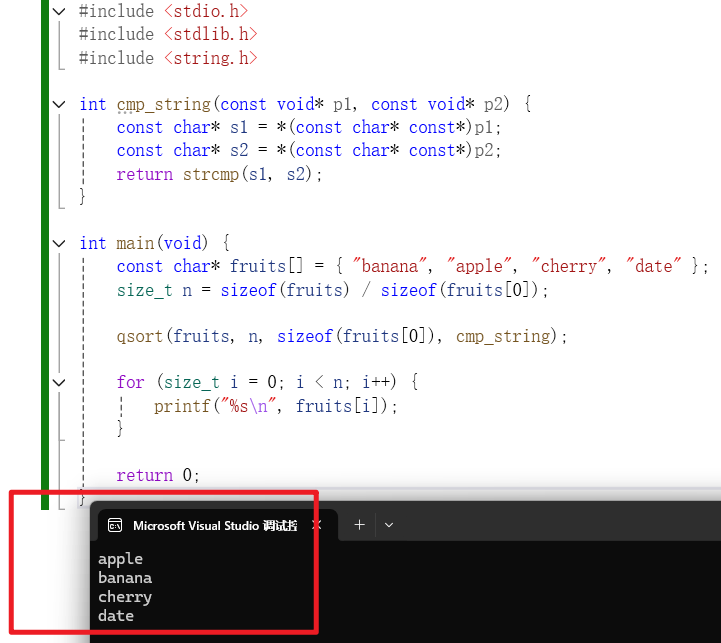
字符串数组比较有一个常见的陷阱:fruits 是一个数组,每个元素是 const char *。当数组名 fruits 传给 qsort 时,它退化为指向首元素的指针,类型可以理解为 const char **。因此,比较函数中的 p1 和 p2 实际上是指向字符串指针的指针。
所以必须先解开一层:
c
*(const char * const *)p1才能拿到真正的字符串地址,再交给 strcmp 比较。
如果直接写成:
c
strcmp((const char *)p1, (const char *)p2)那么传给 strcmp 的并不是字符串本身,而是存储字符串指针的地址,这通常会导致未定义行为,排序结果自然毫无规律。
此外,计算元素个数时应该写:
c
size_t n = sizeof(fruits) / sizeof(fruits[0]);也就是除以一个元素的大小,即 sizeof(const char *),而不是除以 sizeof(char)。
3.4 使用 qsort 排序结构体
c
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct {
    char title[50];
    double price;
} Book;

int cmp_book_by_price(const void *p1, const void *p2) {
    const Book *a = (const Book *)p1;
    const Book *b = (const Book *)p2;
    return (a->price > b->price) - (a->price < b->price);
}

int cmp_book_by_title(const void *p1, const void *p2) {
    const Book *a = (const Book *)p1;
    const Book *b = (const Book *)p2;
    return strcmp(a->title, b->title);
}

void print_books(const Book books[], size_t n) {
    for (size_t i = 0; i < n; i++) {
        printf("《%s》 %.2f元\n", books[i].title, books[i].price);
    }
    printf("---\n");
}

int main(void) {
    Book library[] = {
        {"C Programming", 45.50},
        {"Data Structures", 59.90},
        {"Algorithm Design", 72.00},
        {"Pointer Mastery", 38.80}
    };
    size_t n = sizeof(library) / sizeof(library[0]);

    printf("原始顺序:\n");
    print_books(library, n);

    qsort(library, n, sizeof(Book), cmp_book_by_price);
    printf("按价格排序:\n");
    print_books(library, n);

    qsort(library, n, sizeof(Book), cmp_book_by_title);
    printf("按书名排序:\n");
    print_books(library, n);

    return 0;
}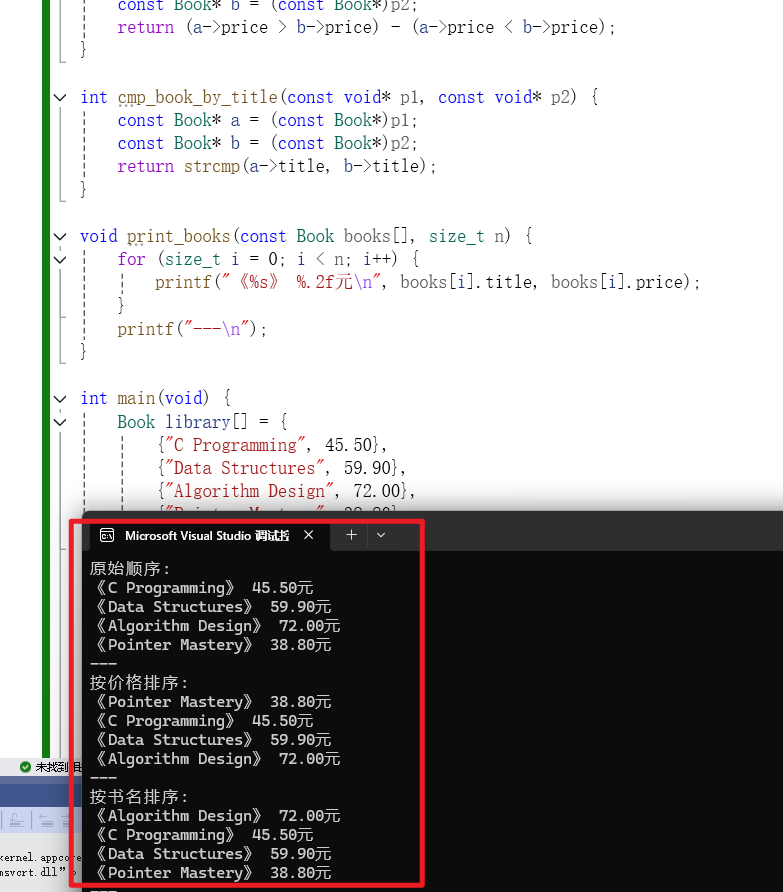
结构体排序的关键是:比较函数先通过 const void * 参数拿到结构体地址,再访问具体字段。
例如按价格排序:
c
const Book *a = (const Book *)p1;
const Book *b = (const Book *)p2;
return (a->price > b->price) - (a->price < b->price);
按书名排序:
c
return strcmp(a->title, b->title);如果希望多级排序,例如先按价格排序,价格相同再按书名排序,可以写成:
c
int cmp_book_price_title(const void *p1, const void *p2) {
    const Book *a = (const Book *)p1;
    const Book *b = (const Book *)p2;

    if (a->price < b->price) return -1;
    if (a->price > b->price) return 1;
    return strcmp(a->title, b->title);
}
这样可以在主排序字段相等时,用次级字段继续比较。
3.5 不同数据类型的比较函数写法
| 数据类型 | 比较函数核心代码 | 注意点 |
|---|---|---|
| 整型 | int a = *(const int*)p1; int b = *(const int*)p2; return (a > b) - (a < b); |
不要直接写 a - b,有符号整数相减可能溢出 |
| 浮点型 | double a = *(const double*)p1; double b = *(const double*)p2; return (a > b) - (a < b); |
不要直接相减后返回 int,避免截断和精度问题;NaN 需特殊处理 |
| 字符串 | const char *s1 = *(const char * const *)p1; const char *s2 = *(const char * const *)p2; return strcmp(s1, s2); |
必须双重解引用,得到真正的字符串地址;sizeof 要用元素大小 |
| 结构体 | const Book *a = (const Book*)p1; const Book *b = (const Book*)p2; 按字段比较 |
先强转再访问成员;可加入多级比较条件 |
3.6 常见错误与注意事项
-
比较函数签名不匹配
qsort要求比较函数必须是:cint cmp(const void *p1, const void *p2);如果写成
int cmp(int a, int b)或其他形式,编译器会报错。 -
忘记强转或双重解引用
对
void *不能直接解引用,必须先转换成具体类型指针。对字符串数组,还要再解开一层指针。
-
元素大小传错
qsort的第三个参数是单个元素的字节数。对
int数组是sizeof(int),对double数组是sizeof(double),对字符串指针数组是sizeof(char *)。 -
比较函数返回
a - b对整型可能溢出,对浮点型会截断。推荐使用:
creturn (a > b) - (a < b); -
认为
qsort是稳定排序qsort不保证稳定。如果两个元素相等,它们的相对顺序可能改变。 -
在比较函数中修改元素
比较函数参数是
const void *,通常应只读,不应修改待排序元素。 -
对非连续内存使用
qsortqsort要求待排序数据在内存中连续存放。链表、树等结构不能直接交给qsort。
四、qsort 函数的模拟实现
4.1 认识 void* 指针与字节操作
qsort 之所以能排序任意类型的数据,核心在于两个东西:
void*通用指针:它可以接收任意类型的地址;- 元素大小
size:它告诉函数每个元素占多少字节。
但 void* 有一个限制:不能直接解引用,也不能直接进行指针加减运算。因为编译器不知道它指向的数据到底是什么类型,也就不知道"加 1"应该跳过几个字节。
例如:
c
void *p = arr;
p + 1;      // 标准 C 中不允许
*p;         // 不允许,因为不知道类型
为了按字节操作内存,我们通常把 void* 强制转换为:
c
unsigned char *原因有三个:
sizeof(unsigned char) == 1,所以unsigned char*加 1 就是前进 1 字节;unsigned char可以按字节访问任意对象的内存表示;- 逐字节交换时,不需要知道原始数据类型。
因此,void* 和 unsigned char* 的分工非常明确:
| 类型 | 作用 |
|---|---|
void* |
作为通用接口,接收任意类型地址 |
unsigned char* |
作为底层操作指针,按字节偏移和交换 |
模拟 qsort 时,最重要的公式是:
c
第 i 个元素的地址 = (unsigned char *)base + i * size其中:
base是数组首元素地址;i是元素下标;size是单个元素的字节数。
只要知道首地址、元素个数和元素大小,就能定位任意元素,而不需要知道它具体是什么类型。
4.2 模拟实现(选择排序版)
下面用选择排序模拟 qsort 的行为。选择排序虽然不是标准库 qsort 的实际实现方式,但它逻辑简单,非常适合用来理解"泛型 + 回调 + 字节操作"的思想。
c
#include <stdio.h>
#include <stddef.h>

// 整型比较函数:返回负数表示 p1 应排在 p2 前,0 表示等价,正数表示 p1 应排在 p2 后
static int cmp_int(const void *p1, const void *p2) {
    int a = *(const int *)p1;
    int b = *(const int *)p2;
    return (a > b) - (a < b);   // 避免直接相减可能导致的溢出
}

// 内存交换函数:逐字节交换 a 和 b 指向的两块内存,共 size 字节
static void swap_memory(void *a, void *b, size_t size) {
    if (a == b || size == 0) {
        return;
    }

    unsigned char *p1 = (unsigned char *)a;
    unsigned char *p2 = (unsigned char *)b;

    for (size_t i = 0; i < size; ++i) {
        unsigned char temp = p1[i];
        p1[i] = p2[i];
        p2[i] = temp;
    }
}

// 通用排序:模拟 qsort 的接口和行为
static void generic_sort(void *base, size_t num, size_t size,
                         int (*cmp)(const void *, const void *)) {
    if (base == NULL || cmp == NULL || num < 2 || size == 0) {
        return;
    }

    unsigned char *start = (unsigned char *)base;

    for (size_t i = 0; i + 1 < num; ++i) {
        size_t min_idx = i;

        for (size_t j = i + 1; j < num; ++j) {
            void *elem_j   = start + j * size;
            void *elem_min = start + min_idx * size;

            if (cmp(elem_j, elem_min) < 0) {
                min_idx = j;
            }
        }

        if (min_idx != i) {
            swap_memory(start + i * size,
                        start + min_idx * size,
                        size);
        }
    }
}

int main(void) {
    int arr[] = { 42, 17, 93, 8, 56, 31, 74, 22 };
    size_t n = sizeof(arr) / sizeof(arr[0]);

    generic_sort(arr, n, sizeof(arr[0]), cmp_int);

    for (size_t i = 0; i < n; ++i) {
        printf("%d ", arr[i]);
    }
    printf("\n");

    return 0;
}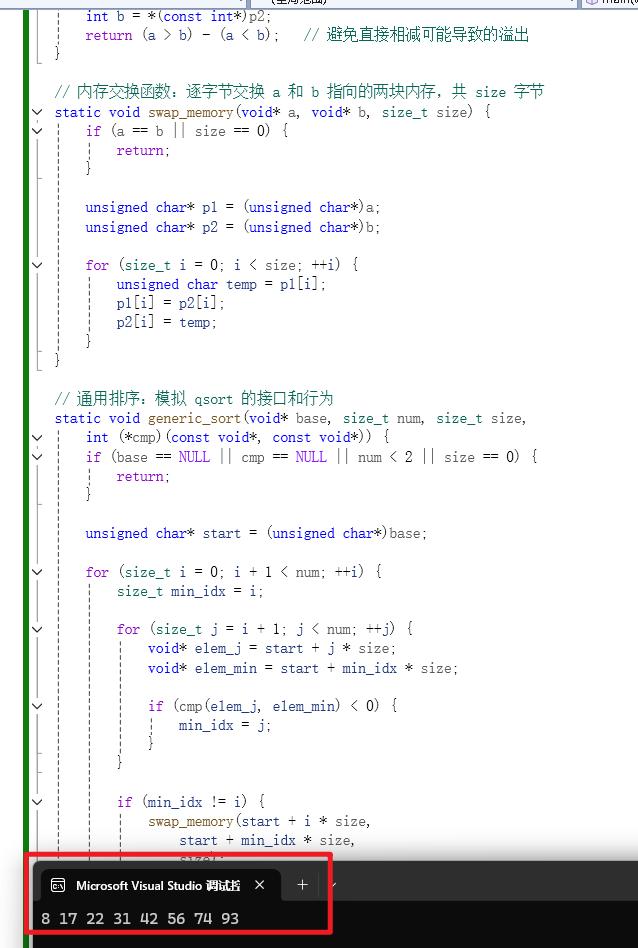
运行结果:
text
8 17 22 31 42 56 74 934.3 代码逐段解释
1. 比较函数 cmp_int
c
static int cmp_int(const void *p1, const void *p2) {
    int a = *(const int *)p1;
    int b = *(const int *)p2;
    return (a > b) - (a < b);
}
cmp_int 是回调函数。它接收两个 const void *,表示"指向两个待比较元素的指针"。
由于实际数据是 int,所以先强转为 const int *,再解引用得到两个整数。
返回值含义:
| 返回值 | 含义 |
|---|---|
< 0 |
p1 指向的元素应排在 p2 前面 |
== 0 |
两个元素等价 |
> 0 |
p1 指向的元素应排在 p2 后面 |
这里没有写成:
c
return a - b;因为两个 int 相减可能溢出。写成:
c
return (a > b) - (a < b);关系运算结果是 0 或 1,所以最终只会得到 -1、0、1,安全且清晰。
2. 内存交换函数 swap_memory
c
static void swap_memory(void *a, void *b, size_t size) {
    if (a == b || size == 0) {
        return;
    }

    unsigned char *p1 = (unsigned char *)a;
    unsigned char *p2 = (unsigned char *)b;

    for (size_t i = 0; i < size; ++i) {
        unsigned char temp = p1[i];
        p1[i] = p2[i];
        p2[i] = temp;
    }
}
排序过程中需要交换两个元素,但我们不知道它们是什么类型。可能是 int、double、结构体,甚至更大的对象。
因此不能写成:
c
int temp = *a;
*a = *b;
*b = temp;
因为 a 和 b 是 void*,而且元素类型未知。
正确做法是:把两个地址都看成字节数组,然后一个字节一个字节地交换,共交换 size 次。
这就是为什么 qsort 必须知道每个元素的大小 size。
3. 通用排序函数 generic_sort
c
static void generic_sort(void *base, size_t num, size_t size,
                         int (*cmp)(const void *, const void *)) {
    if (base == NULL || cmp == NULL || num < 2 || size == 0) {
        return;
    }

    unsigned char *start = (unsigned char *)base;

    for (size_t i = 0; i + 1 < num; ++i) {
        size_t min_idx = i;

        for (size_t j = i + 1; j < num; ++j) {
            void *elem_j   = start + j * size;
            void *elem_min = start + min_idx * size;

            if (cmp(elem_j, elem_min) < 0) {
                min_idx = j;
            }
        }

        if (min_idx != i) {
            swap_memory(start + i * size,
                        start + min_idx * size,
                        size);
        }
    }
}
参数解释:
| 参数 | 含义 |
|---|---|
base |
待排序数组首元素地址 |
num |
元素个数 |
size |
单个元素字节数 |
cmp |
比较函数指针 |
函数内部先把 base 转为 unsigned char *:
c
unsigned char *start = (unsigned char *)base;这样,第 j 个元素的地址就是:
c
start + j * size第 min_idx 个元素的地址就是:
c
start + min_idx * size选择排序的过程:
- 外层循环
i表示当前未排序区间的起点; - 假设
i位置就是最小元素,记录min_idx = i; - 内层循环从
i + 1到num - 1,逐个与当前最小元素比较; - 如果
cmp(elem_j, elem_min) < 0,说明j位置更小,更新min_idx; - 内层结束后,如果
min_idx != i,交换第i个和第min_idx个元素; - 交换时调用
swap_memory,按字节交换。
注意边界检查:
c
if (base == NULL || cmp == NULL || num < 2 || size == 0) {
    return;
}
这样可以避免:
- 空指针解引用;
- 元素个数为 0 或 1 时无意义排序;
size == 0时地址计算和交换没有意义;num - 1在num == 0时发生无符号下溢。
循环条件写成:
c
for (size_t i = 0; i + 1 < num; ++i)而不是:
c
for (size_t i = 0; i < num - 1; ++i)也是为了在 num == 0 时更安全。
4. main 函数调用
c
int arr[] = { 42, 17, 93, 8, 56, 31, 74, 22 };
size_t n = sizeof(arr) / sizeof(arr[0]);

generic_sort(arr, n, sizeof(arr[0]), cmp_int);
调用 generic_sort 时传入:
arr:数组首地址,自动转换为void*;n:元素个数;sizeof(arr[0]):每个int的字节数;cmp_int:整型比较函数,函数名自动转换为函数指针。
这四者配合起来,就让 generic_sort 能够排序任意类型的连续数组。
4.4 模拟实现中的关键点
-
void*负责泛型接口,unsigned char*负责字节操作void*接收任意地址,但不能直接运算和解引用;unsigned char*可以按字节偏移和读写。 -
元素地址必须用
base + i * size计算第
i个元素的地址是:c(unsigned char *)base + i * size如果直接用
base + i,编译器不知道步长,标准 C 也不允许。 -
比较逻辑由回调函数决定
generic_sort不知道元素是什么类型,也不决定谁大谁小。它只调用cmp,根据返回值判断是否需要更新最小值或交换。 -
交换必须按字节进行
因为不知道元素类型,所以只能逐字节交换
size个字节。如果只交换sizeof(int)字节,但实际元素是更大的结构体,就会导致数据错乱。 -
边界检查不能少
要检查
base、cmp是否为空,num是否小于 2,size是否为 0。否则可能出现空指针访问、无符号下溢或无效交换。 -
比较函数要满足严格弱序
比较函数必须保证:
cmp(a, a) == 0;cmp(a, b)与cmp(b, a)符号相反;相等关系可传递。否则排序结果不可靠。 -
size必须传对对
int数组传sizeof(int),对double数组传sizeof(double),对字符串指针数组传sizeof(char *)。传错会导致地址计算错误,甚至内存越界。 -
选择排序只是模拟,不是标准库实现
标准
qsort通常使用快速排序,平均时间复杂度为O(n log n);选择排序时间复杂度为O(n²)。模拟的目的是理解泛型机制,而不是追求性能。
4.5 与标准 qsort 的对比
| 对比项 | 标准 qsort |
模拟 generic_sort |
|---|---|---|
| 所在头文件 | <stdlib.h> |
自定义 |
| 排序算法 | 通常为快速排序 | 选择排序 |
| 时间复杂度 | 平均 O(n log n) |
O(n²) |
| 稳定性 | 不保证稳定 | 选择排序也不稳定 |
| 泛型方式 | void* + size + 回调 |
void* + size + 回调 |
| 参数顺序 | base, nmemb, size, cmp |
base, num, size, cmp |
| 实际用途 | 生产环境排序 | 理解原理、教学演示 |
五、总结
- 回调函数:通过函数指针调用函数,将"变化的行为"抽离出来,实现框架与逻辑解耦(策略模式)。
- qsort 原型 :
void qsort(void *base, size_t nmemb, size_t size, int (*compar)(const void *, const void *))。 - qsort 使用:传入首地址、元素个数、元素大小和比较函数,即可排序任意类型。
- 比较函数写法 :整型/浮点用
(a > b) - (a < b);字符串用strcmp(*(char**)p1, *(char**)p2)。 - 模拟实现核心 :用
void *接收任意类型,用unsigned char *做字节运算,用回调函数决定比较规则,用逐字节交换实现通用交换。 - 排序算法选择 :模拟实现时采用选择排序 ,避免与常规冒泡排序案例雷同,同时保证 O(n²) 的教学友好性。
- 易错点 :比较函数返回值语义;
void *不能直接解引用;字符串数组比较需双重解引用。---
留个关注支持一下吧!