Go slog 生产落地:结构化日志、LevelVar,以及和现有日志库共存
Go 1.21 起标准库自带 log/slog:前端是 Logger,后端是可替换的 Handler。生产侧要落地的其实就三件事:统一成可检索的结构化输出,运行中能改级别,老代码和 Zap 不必一夜清零。API 清单不用再背一遍。
一、生产为什么要结构化,别再拼字符串了
值班时最怕的是日志明明在,却搜不动。user=42 err=timeout 夹在自由文本里时,过滤、聚合、告警都靠正则碰运气;换成稳定的 key-value(或一行一条 JSON),采集链路才能按字段建索引。
官方博客 Structured Logging with slog 把动机写得很直接。服务端日志量大,快速搜索与过滤是刚需;生态里早就有多套结构化库,大程序常通过依赖间接带进好几套,主程序还得逐个配置才能格式一致。slog 进标准库,目标是提供可共享的前端 + Handler 后端 ,方便各库互通。它并不打算取代 Zap、logrus 等第三方库。
内置两条后端就够起步:
| Handler | 形态 | 典型用途 |
|---|---|---|
TextHandler |
空格分隔的 key=value |
本地开发、人眼扫一眼 |
JSONHandler |
一行一条 JSON | 生产采集、ELK / Loki 一类管道 |
默认最低级别是 Info:HandlerOptions.Level 为 nil 时按 LevelInfo 处理。Debug 默认不会刷屏,这是刻意的。
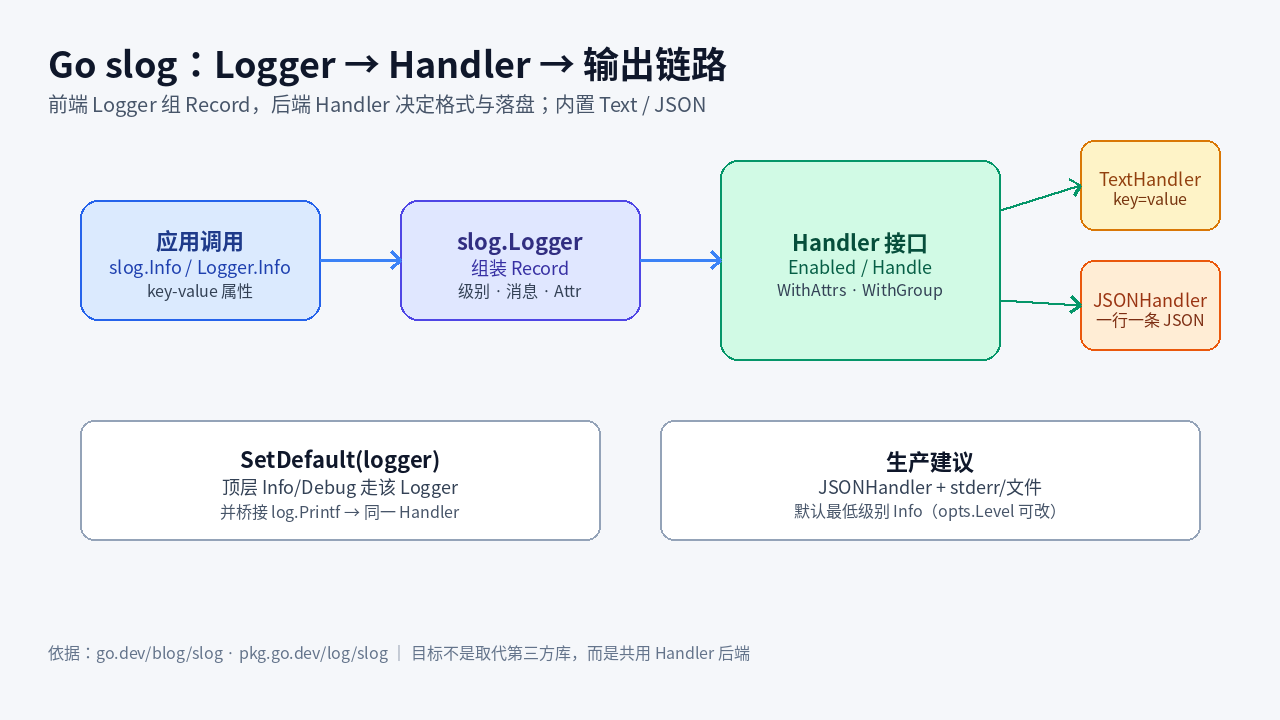
把「结构化」落到团队规范时,建议先统一三件小事,再谈换库:键名用稳定英文小写(用 request_id,别有时 reqId 有时 rid);错误用 err 键并传 error 值(内置 JSONHandler 会对 Attr 里的 error 调 Error() 打成字符串);请求维度字段(方法、路径、耗时)尽量进同一条记录,别拆成三行自由文本。这三件事不依赖 slog 特有 API,却决定采集后能不能做成看板。
也别把「结构化」当成「什么都往日志里塞」。卡片号、口令、Token 进日志就是事故,谈不上可观测性。需要脱敏时,可让类型实现 LogValuer,在 LogValue 里返回打码后的 Value。官方文档的 Secret 示例就是这条路。自定义 Handler 这里不展开,但上线前应把敏感字段清单和替换策略写进评审,别指望采集侧事后正则。
二、生产环境的推荐配置:JSONHandler + SetDefault
生产进程启动时,优先把默认 Logger 换成 JSON 出口,并让顶层 slog.Info / slog.Error 与历史 log.Printf 走同一条管道。文档对 SetDefault 的约定是:顶层函数改用该 Logger;同时 更新 log 包默认 Logger,使既有 log.Print 一类调用也进入这个 Handler,不必立刻改完所有调用点。
go
package main

import (
	"log"
	"log/slog"
	"os"
)

func main() {
	h := slog.NewJSONHandler(os.Stderr, nil)
	logger := slog.New(h)
	slog.SetDefault(logger)

	slog.Info("service started", "port", 8080)
	// SetDefault 之后,旧 log 输出也会进同一 Handler
	log.Printf("legacy printf still works")
}
几点落地注意:
- 写 stderr 还是文件:容器里常见是进程写 stderr,由运行时采集;若自己写文件,记得按采集规范做轮转,运维细节这里不展开。
- 一行一条 :
JSONHandler每次Handle产出一条完整 JSON 对象并换行,适合按行切割的采集器。 - 公共字段用
With:logger.With("service", "checkout")会得到带固定属性的子 Logger;内置 Handler 可在With时预格式化这些属性,热路径上比每行重复拼同样字段更划算。 - 有 context 就用
*Context:InfoContext/ErrorContext等把context.Context传给 Handler,便于将来从 context 取 trace id;取消 context 不会阻止写日志。
需要「旧 log.Logger API、新 Handler 后端」时,还有 slog.NewLogLogger(h, level):它返回 *log.Logger,Output 会派发成 slog 的 Record。
SetDefault 与 log 桥接的级别由 SetLogLoggerLevel 控制(Go 1.22+)。调用 SetDefault 之后 ,SetLogLoggerLevel 决定 log.Printf 落到 slog Handler 时使用的级别;调用 之前 ,它影响的是顶层 slog 函数通往默认 log.Logger 的最低级别。值班改级别时先分清「现在有没有 SetDefault」,避免拧反旋钮。
本地开发若嫌 JSON 难读,可以按环境变量切换 Handler:开发机用 TextHandler 打到 stdout,生产镜像固定 JSONHandler。切换时保持同一套 With 属性与级别策略,避免「开发时键齐、生产时键丢」。ReplaceAttr 能改内置键名或丢掉 time 字段,适合测试里做确定性断言;生产改键名前先和采集映射表对齐,否则仪表盘会集体空白。
内置 Handler 在写 io.Writer 前会加锁,保证一条 Record 完整落盘、不被别的 goroutine 撕成两截。你若自写 Handler 转发到网络或异步队列,并发与排序要自己负责。文档把这条责任划得很清楚。上线初期与其追求「零分配极致 Handler」,不如先保证 JSON 行完整、级别可控、旧 log 已桥接。
三、LevelVar:不用重启就能把 Debug 打开
固定写死 HandlerOptions{Level: slog.LevelInfo} 简单,但排障时常想「只对这一段开 Debug」。把 Level 设成 *LevelVar 即可:它实现 Leveler,Set / Level 并发安全,零值等于 LevelInfo。
go
package main

import (
	"log/slog"
	"os"
)

func main() {
	var programLevel = new(slog.LevelVar) // 零值 = LevelInfo
	h := slog.NewJSONHandler(os.Stderr, &slog.HandlerOptions{Level: programLevel})
	slog.SetDefault(slog.New(h))

	slog.Info("info visible")
	slog.Debug("debug hidden by default")

	// 例如管理接口、信号或远端配置回调里:
	programLevel.Set(slog.LevelDebug)
	slog.Debug("debug now visible", "reason", "level hot-switched")
}
实践建议:
- 全局一个
LevelVar:挂到 JSON Handler 上,再SetDefault;热改一处,全进程生效。 - 入口收敛 :用 HTTP 管理端口、
SIGUSR或配置中心回调调用Set,不要在业务 goroutine 里散落改级别。 - 改完记得收回:排障窗口结束把级别设回 Info / Warn,避免 Debug 把磁盘和采集费用打满。
- 参数仍会求值 :即便某条 Debug 被 Handler 丢掉,调用处的实参表达式仍会执行;昂贵计算用
LogValuer推迟,或先用logger.Enabled(ctx, level)判断再算。LogValuer是官方文档性能节里的建议。
级别本身是整数:LevelDebug=-4、Info=0、Warn=4、Error=8。需要介于 Info 与 Warn 之间的自定义档,直接用中间整数即可;自定义命名这里不展开,免得和内置四档搅在一起。
和「改配置文件再滚动发布」相比,LevelVar 的价值在于窗口很短的排障 :线上偶现、两个请求后就复现不了时,你往往等不起一轮发布。把 Set 挂到受鉴权保护的管理接口(或仅内网可达的 admin)后,可以在不重启、不换包的前提下抬高 verbosity,抓完立刻降回。记得鉴权与审计:谁在何时把级别改成了 Debug,本身就该留一条 Info。
若多实例部署,进程内 LevelVar 只影响当前实例。需要舰队级一致时,应通过配置中心或控制面下发,再在各进程回调里 Set;不要假设改了一个 Pod,同 Deployment 其它副本会跟着变。这和「日志库能不能热改」是两层问题:slog 解决进程内安全写级别,舰队同步仍归你的发布/配置体系管。
四、和 log、Zap 共存:靠桥接,别搞「大扫除」
官方设计从一开始就把 API 拆成 Logger 前端与 Handler 后端,并写明:已有生态库可以对接同一后端,不必重写所有调用方。生产迁移通常是渐进式的。
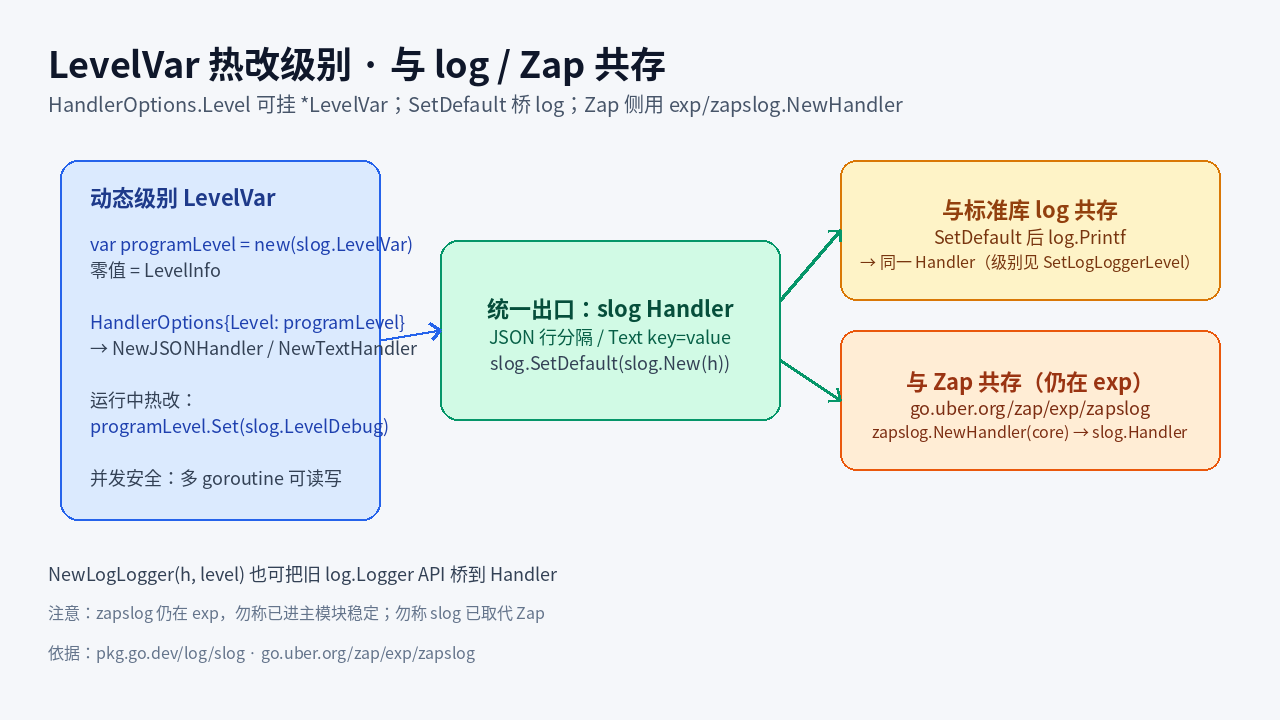
与标准库 log: 上一节的 SetDefault 已经覆盖大多数「老模块还在 log.Printf」的情况;需要显式拿到 *log.Logger 时用 NewLogLogger。
与 Zap: Uber 提供 go.uber.org/zap/exp/zapslog。核心 API 是 zapslog.NewHandler(core),得到实现了 slog.Handler 的值,从而把 slog 记录写进既有 zapcore.Core。zapslog 在独立模块 go.uber.org/zap/exp 里(包路径 go.uber.org/zap/exp/zapslog),需要单独 go get。注意两点边界:
- 路径里带
exp,说明仍在实验子模块,别写成「已稳定进 zap 主模块」; - 方向是 slog → Zap Core:新代码用 slog API,落盘仍走你已经配好的 Zap。这不代表「slog 官方宣布取代 Zap」。
go
package main

import (
	"log/slog"

	"go.uber.org/zap"
	"go.uber.org/zap/exp/zapslog"
)

func main() {
	zapL, err := zap.NewProduction()
	if err != nil {
		panic(err)
	}
	defer zapL.Sync()

	h := zapslog.NewHandler(zapL.Core())
	logger := slog.New(h)
	logger.Info("via slog into zap", "component", "api")
}
依赖上需拉取 go.uber.org/zap/exp(以及 zap 本身)。若团队短期仍以 Zap 为唯一出口,这种桥可以让新包先写 slog,旧包继续 zap.Logger,采集格式保持一致。
官方博客提到社区已有或在做对接 Zap、logr、hclog 等的 Handler;选型以各库文档为准,这里只演示可核对的 zapslog.NewHandler。
子系统键名冲突时,用 WithGroup:例如 logger.WithGroup("parser") 后,后续属性会带上分组前缀(Text 用点号,JSON 则嵌套对象),比靠约定「大家都别用 id 这个键」更稳。
迁移节奏上,常见三段都比「全仓替换 import」健康:
- 出口先统一:老 Zap / 新 slog 都进同一 JSON 或同一 Core,采集与告警规则不用改两套;
- 新代码写 slog :模块边界清晰的包优先
log/slog,用With/WithGroup带上服务与子系统前缀; - 旧调用点按需收 :
log.Printf可暂时靠SetDefault续命;Zap 热路径若已稳定,不必为了「纯度」强行重写。
Go 官方博客说得很克制:替换仍然工作的第三方日志代码,很少是好的时间用法。评审里若有人拿没有出处的 benchmark 或版本号主张「必须立刻弃用 Zap」,先请他给出可复现的数据。
五、上线与值班清单
- 语言版本 :使用
log/slog需 Go 1.21+;若用到SetLogLoggerLevel,按文档对应 Go 1.22+。 - 默认出口 :启动时
NewJSONHandler+SetDefault;确认采集侧按行解析 JSON。 - 级别 :生产默认 Info;排障用进程内
LevelVar.Set(LevelDebug),结束收回。 - 桥接清点 :全局搜
log.Print/log.Printf,确认SetDefault后级别符合预期(对照SetLogLoggerLevel)。 - Zap 共存 :仅通过
go.uber.org/zap/exp/zapslog的NewHandler;文档与评审里标注「仍在 exp」。 - 字段约定 :服务名、环境、请求 ID 用
With/WithGroup固定,避免每行手写不一致的键名。 - 别假迁移:不要为了「全面 slog」一次性删掉仍在工作的 Zap 配置;前端可以混用,后端先统一。
- 和
GOMAXPROCS那篇的分工 :《Go1.25容器感知GOMAXPROCS避限流》写的是 Go 1.25 容器感知GOMAXPROCS,这里讲日志管线。一层管 CPU 并行,一层管可观测输出,排障时别互相顶锅。
再补两条习惯,防止日志写多了反而看不清:热点路径优先 LogAttrs + 具体类型的 Attr 构造函数(如 slog.String、slog.Int),减少交替 key-value 的装箱;公共大对象(例如整份请求元数据)放到 With 里,别每条 Debug 重新塞一遍。文档的性能节还提醒:传 *url.URL 这类值让 Handler 在真正输出时再格式化,往往比先 String() 再传字符串更省。前提是你接受 JSON 里呈现为结构化对象,而非纯字符串。
最后再把责任边界说死:slog 负责结构化记录与 Handler 生态接口;采集、存储、索引、告警阈值是平台侧。把 JSON 行打稳、级别可调、旧 API 有桥,你就已经完成应用侧该做的大半;剩下的「要不要上 Zap 采样、要不要独立 error 索引」按团队现有可观测栈选,不必为了显得完整就强行上新依赖。
生产用 JSONHandler 做行分隔结构化输出,用 SetDefault 收编顶层 slog 与旧 log,用 LevelVar 热改级别,和 Zap 并存时走 exp/zapslog.NewHandler。目标是共用后端,并不宣布谁取代谁。