-
- [2. Distributed Training:分布式训练](#2. Distributed Training:分布式训练)
-
- [2.2 Data Parallelism:数据并行](#2.2 Data Parallelism:数据并行)
-
- [2.2.1 数据并行的基本思想](#2.2.1 数据并行的基本思想)
- [2.2.2 每张 GPU 如何完成一次训练](#2.2.2 每张 GPU 如何完成一次训练)
- [2.2.3 Gradient Synchronization 与 All-Reduce](#2.2.3 Gradient Synchronization 与 All-Reduce)
- [2.2.4 Data Parallelism 为什么能加速训练](#2.2.4 Data Parallelism 为什么能加速训练)
- [2.2.5 Data Parallelism 的局限](#2.2.5 Data Parallelism 的局限)
- [2.2.6 Data Parallelism 与 Model Parallelism](#2.2.6 Data Parallelism 与 Model Parallelism)
- [2.3 Pipeline Parallelism:流水线并行](#2.3 Pipeline Parallelism:流水线并行)
-
- [2.3.1 Pipeline Parallelism 的基本思想](#2.3.1 Pipeline Parallelism 的基本思想)
- [2.3.2 为什么需要 Pipeline Parallelism](#2.3.2 为什么需要 Pipeline Parallelism)
- [2.3.3 数据如何在不同 Stage 之间流动](#2.3.3 数据如何在不同 Stage 之间流动)
- [2.3.4 Micro-batch:让流水线真正并行起来](#2.3.4 Micro-batch:让流水线真正并行起来)
- [2.3.5 Pipeline Bubble:流水线气泡](#2.3.5 Pipeline Bubble:流水线气泡)
- [2.3.6 Stage Balance:阶段负载均衡](#2.3.6 Stage Balance:阶段负载均衡)
- [2.3.7 Pipeline Parallelism 的核心特点](#2.3.7 Pipeline Parallelism 的核心特点)
- [2.4 Tensor Parallelism:张量并行](#2.4 Tensor Parallelism:张量并行)
-
- [2.4.1 Tensor Parallelism 的基本思想](#2.4.1 Tensor Parallelism 的基本思想)
- [2.4.2 为什么需要 Tensor Parallelism](#2.4.2 为什么需要 Tensor Parallelism)
- [2.4.3 Column Parallel 与 Row Parallel](#2.4.3 Column Parallel 与 Row Parallel)
- [2.4.4 Transformer 中如何使用 Tensor Parallelism](#2.4.4 Transformer 中如何使用 Tensor Parallelism)
- [2.4.5 Tensor Parallelism 的通信开销](#2.4.5 Tensor Parallelism 的通信开销)
- [2.4.6 Tensor Parallelism 的核心特点](#2.4.6 Tensor Parallelism 的核心特点)
- [2.5 三种并行方式的区别](#2.5 三种并行方式的区别)
-
- [2.5.1 Data Parallelism:切数据](#2.5.1 Data Parallelism:切数据)
- [2.5.2 Pipeline Parallelism:切 Layer](#2.5.2 Pipeline Parallelism:切 Layer)
- [2.5.3 Tensor Parallelism:切矩阵](#2.5.3 Tensor Parallelism:切矩阵)
- [2.5.4 DP、PP、TP 对比](#2.5.4 DP、PP、TP 对比)
- [2.5.5 三种并行方式应该怎么理解](#2.5.5 三种并行方式应该怎么理解)
- [2.6 多种并行策略组合](#2.6 多种并行策略组合)
-
- [2.6.1 DP + TP:数据并行 + 张量并行](#2.6.1 DP + TP:数据并行 + 张量并行)
- [2.6.2 DP + PP:数据并行 + 流水线并行](#2.6.2 DP + PP:数据并行 + 流水线并行)
- [2.6.3 TP + PP:张量并行 + 流水线并行](#2.6.3 TP + PP:张量并行 + 流水线并行)
- [2.6.4 3D Parallelism:DP + PP + TP](#2.6.4 3D Parallelism:DP + PP + TP)
- [2.6.5 GPU 数量如何计算](#2.6.5 GPU 数量如何计算)
- [2.6.6 一个 32 GPU 的例子](#2.6.6 一个 32 GPU 的例子)
- [2.6.7 为什么需要组合并行](#2.6.7 为什么需要组合并行)
- [2.6.8 组合并行的代价](#2.6.8 组合并行的代价)
2. Distributed Training:分布式训练
2.2 Data Parallelism:数据并行
- 每张 GPU 保存一份完整模型
- 将不同 Batch 数据分配到不同 GPU
- 每张 GPU 独立完成 Forward 和 Backward
- 通过 All-Reduce 同步各 GPU 的 Gradient
- 典型实现:PyTorch DDP
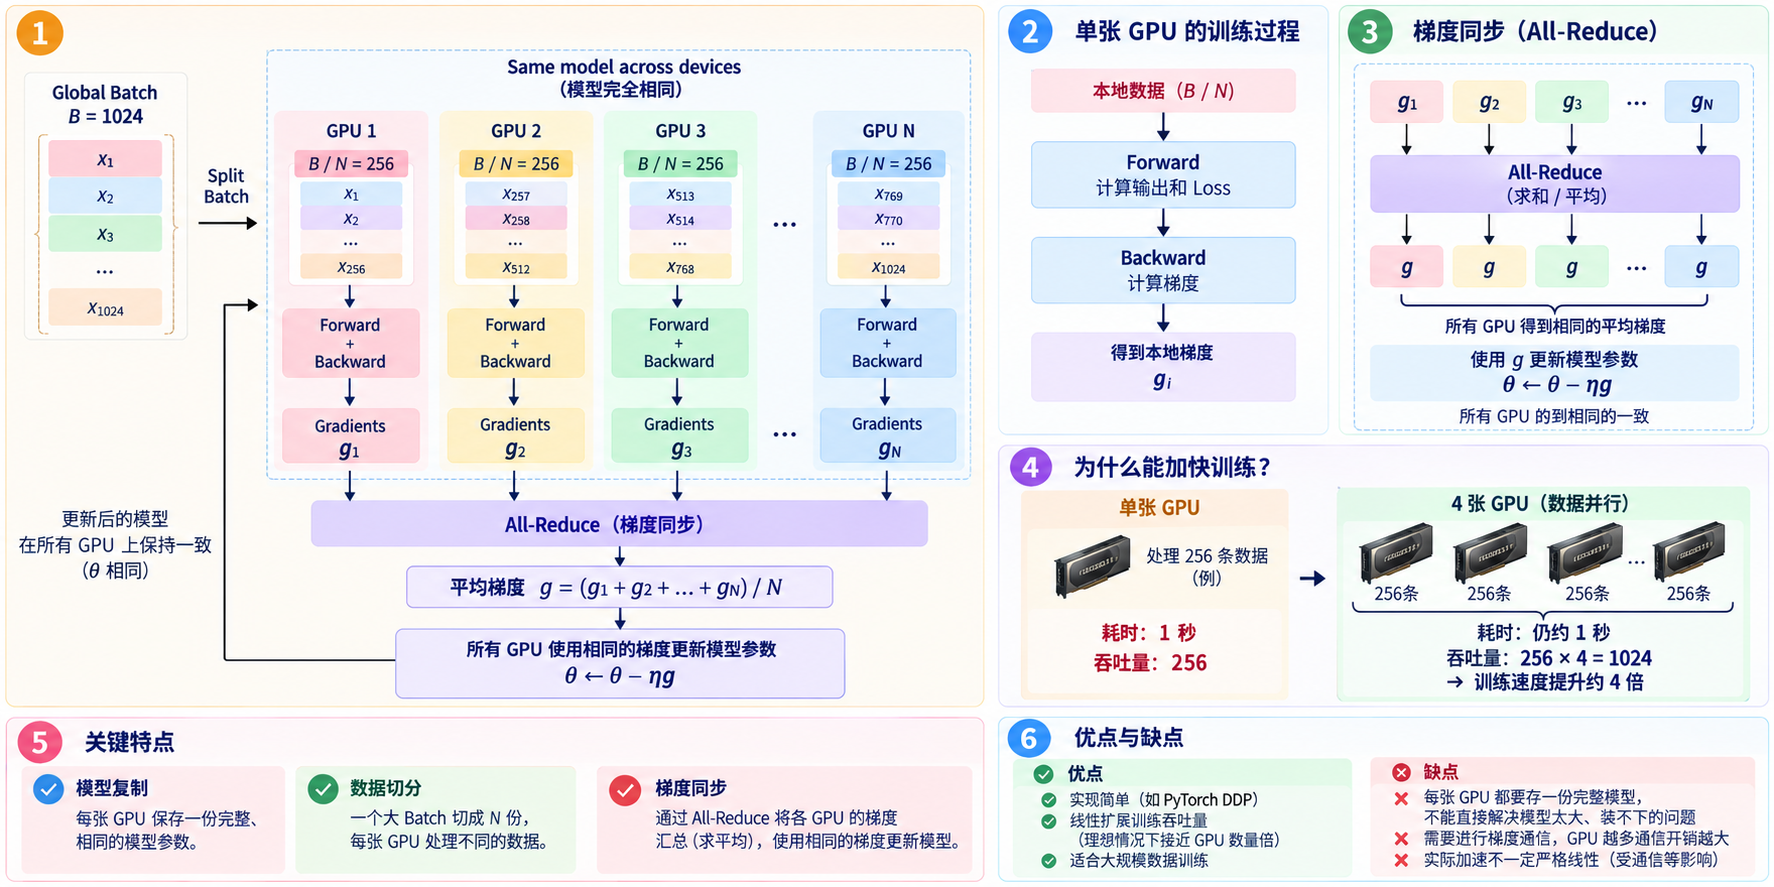
2.2.1 数据并行的基本思想
Data Parallelism 的核心是:
复制模型 + 切分数据
也就是:
- 每张 GPU 保存一份完整且相同的模型
- 一个 Global Batch 被切分到不同 GPU
- 每张 GPU 只处理自己分到的数据
- 多张 GPU 同时执行 Forward 和 Backward
例如:
Global Batch Size = 1024
使用 4 张 GPU:
每张 GPU 处理 256 条数据
因此:
模型相同,数据不同
这也是"Data Parallelism"这个名字的来源。
2.2.2 每张 GPU 如何完成一次训练
假设有两张 GPU:
GPU 1:模型 θ + 数据 A
GPU 2:模型 θ + 数据 B
两张 GPU 分别执行:
Forward → Loss → Backward
然后得到各自的梯度:
GPU 1 → g1
GPU 2 → g2
如果直接使用各自的梯度更新:
θ1 ← θ - ηg1
θ2 ← θ - ηg2
两张 GPU 上的模型参数就会逐渐不同。
因此 Data Parallelism 还必须进行:
Gradient Synchronization
也就是梯度同步。
2.2.3 Gradient Synchronization 与 All-Reduce
假设 4 张 GPU 得到:
g1、g2、g3、g4
可以计算平均梯度:
g = (g1 + g2 + g3 + g4) / 4
然后所有 GPU 都使用相同的 g 更新模型:
θ ← θ - ηg
这样下一次训练开始时:
GPU 1 参数 = GPU 2 参数 = ... = GPU N 参数
分布式训练中,这种梯度汇总通常通过:
All-Reduce
完成。
所以 Data Parallelism 的一次完整 Step 可以记成:
切分 Batch
↓
每张 GPU 独立 Forward
↓
每张 GPU 独立 Backward
↓
All-Reduce 同步 Gradient
↓
所有 GPU 同步更新参数
2.2.4 Data Parallelism 为什么能加速训练
假设一张 GPU 每秒可以处理:
256 samples
使用 4 张 GPU 后,每张仍然处理 256 条:
256 × 4 = 1024 samples/s
因此 Data Parallelism 提升的主要是:
Training Throughput
也就是单位时间能够处理更多训练数据。
它并不是让"单条数据"运行得明显更快,而是:
让更多数据同时被处理
2.2.5 Data Parallelism 的局限
Data Parallelism 的一个重要问题是:
每张 GPU 都必须保存完整模型。
例如模型本身需要:
40 GB
那么使用 4 张 GPU 时仍然是:
GPU 1:40 GB
GPU 2:40 GB
GPU 3:40 GB
GPU 4:40 GB
而不是:
40 GB / 4 = 10 GB
因此传统 Data Parallelism:
- 可以提高训练吞吐量
- 可以缩短训练时间
- 但不能直接解决"单张 GPU 装不下整个模型"的问题
这也是后面需要继续学习:
- Pipeline Parallelism
- Tensor Parallelism
- ZeRO
- FSDP
等技术的原因。
2.2.6 Data Parallelism 与 Model Parallelism
两者最简单的区别:
Data Parallelism = 切数据,复制模型
Model Parallelism = 切模型
Data Parallelism:
GPU 1:完整模型 + 数据 1
GPU 2:完整模型 + 数据 2
GPU 3:完整模型 + 数据 3
Model Parallelism:
GPU 1:模型的一部分
GPU 2:模型的一部分
GPU 3:模型的一部分
因此 Data Parallelism 最核心的两个关键词就是:
Replicate Model
2.3 Pipeline Parallelism:流水线并行
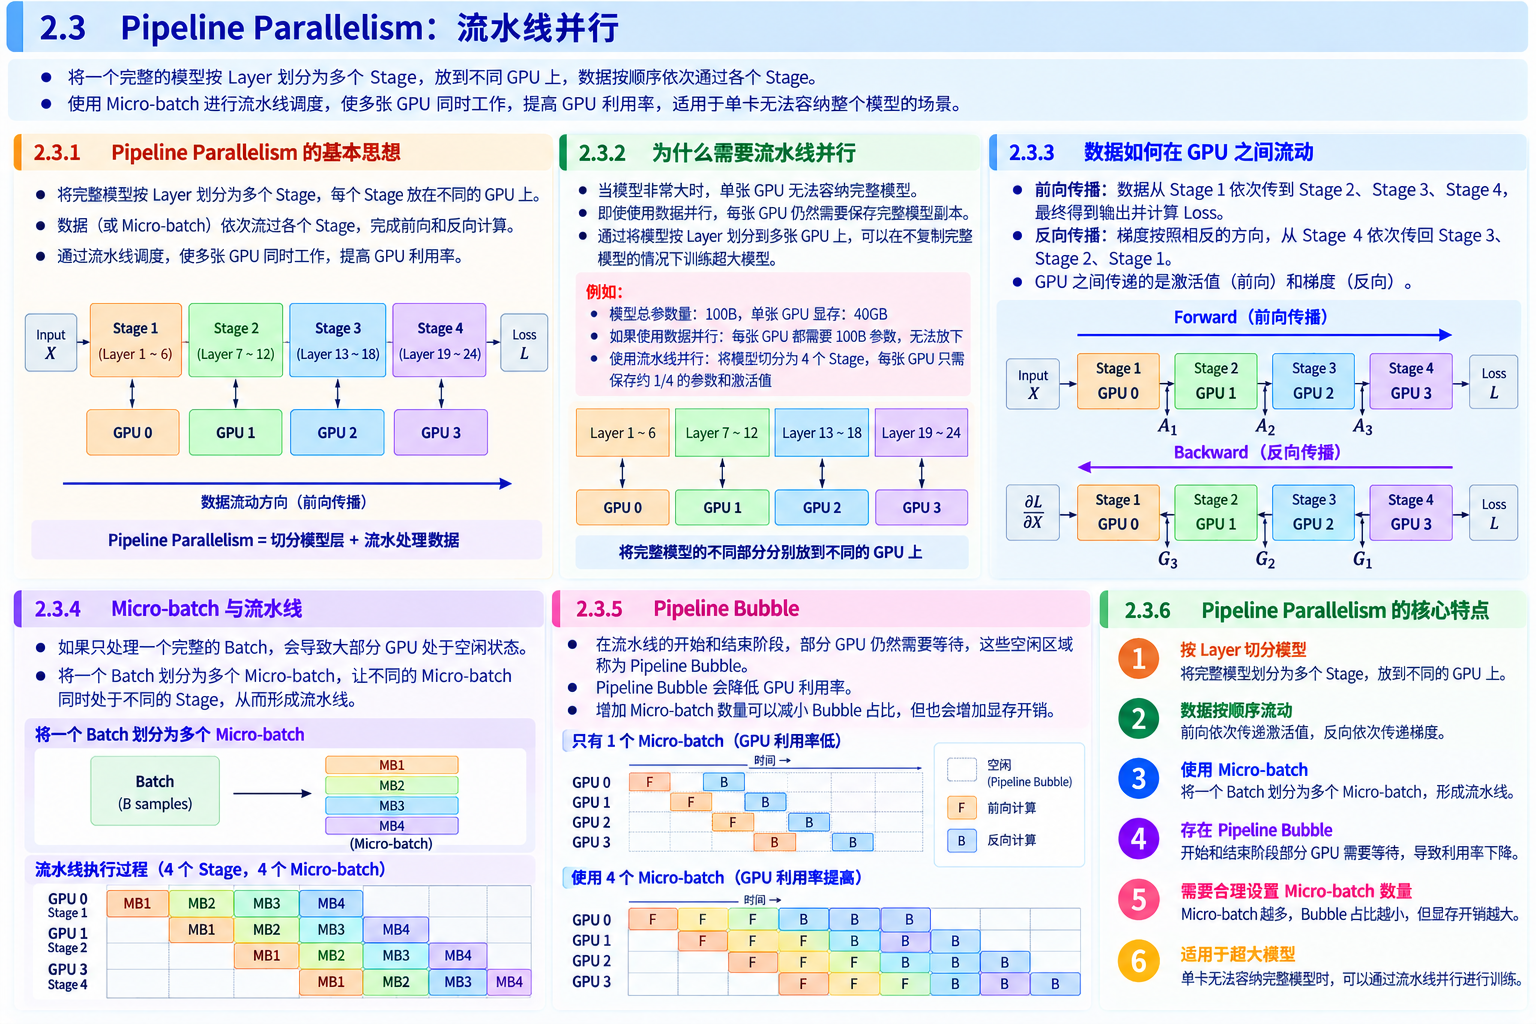
- 将完整模型按照 Layer 切分成多个 Pipeline Stage
- 不同 Stage 分别放到不同 GPU
- 数据按照顺序依次经过多个 Stage
- 使用 Micro-batch 提高多张 GPU 的并行利用率
- 主要问题:Pipeline Bubble、Stage 不均衡和 GPU 间通信
2.3.1 Pipeline Parallelism 的基本思想
Pipeline Parallelism 的核心是:
切分模型 + 流水处理数据
与 Data Parallelism 不同:
Data Parallelism = 模型复制,数据切分
而:
Pipeline Parallelism = 模型切分,数据依次流过
假设一个 Transformer 有 24 层,使用 4 张 GPU:
GPU0:Layer 1 ~ 6
GPU1:Layer 7 ~ 12
GPU2:Layer 13 ~ 18
GPU3:Layer 19 ~ 24
也就是:
完整模型 = Stage 0 + Stage 1 + Stage 2 + Stage 3
每张 GPU 只负责其中一个 Stage。
2.3.2 为什么需要 Pipeline Parallelism
Pipeline Parallelism 最直接解决的问题是:
模型太大,一张 GPU 无法保存完整模型。
例如:
模型大小 = 120 GB
而单张 GPU 显存只有:
40 GB
如果使用普通 Data Parallelism,每张 GPU 都要保存完整模型:
GPU0:120 GB ×
GPU1:120 GB ×
GPU2:120 GB ×
仍然无法训练。
而 Pipeline Parallelism 可以把模型拆成多个 Stage:
GPU0:Stage 0 ≈ 40 GB
GPU1:Stage 1 ≈ 40 GB
GPU2:Stage 2 ≈ 40 GB
这样每张 GPU 只保存模型的一部分。
因此:
DP = 每张 GPU 保存完整模型
PP = 每张 GPU 保存部分模型
2.3.3 数据如何在不同 Stage 之间流动
假设:
GPU0:Layer 1 ~ 6
GPU1:Layer 7 ~ 12
GPU2:Layer 13 ~ 18
GPU3:Layer 19 ~ 24
Forward 时:
Input
↓
GPU0:Stage 0
↓
Activation A0
↓
GPU1:Stage 1
↓
Activation A1
↓
GPU2:Stage 2
↓
Activation A2
↓
GPU3:Stage 3
↓
Loss
因此不同 GPU 之间主要传递的是:
Activation
训练时还需要 Backward:
Loss
↓
GPU3
↓
Gradient
↓
GPU2
↓
GPU1
↓
GPU0
所以可以简单记成:
Forward:Activation 从前往后传
Backward:Gradient 从后往前传
2.3.4 Micro-batch:让流水线真正并行起来
如果一次只送一个完整 Batch:
GPU0 工作
↓
GPU1 工作
↓
GPU2 工作
↓
GPU3 工作
那么大部分时间只有一张 GPU 在工作,其他 GPU 都在等待。
因此 Pipeline Parallelism 通常会把一个 Batch 再切成多个:
Micro-batch
例如:
Global Batch = 64
可以切成:
MB1 = 16
MB2 = 16
MB3 = 16
MB4 = 16
然后让不同 Micro-batch 同时位于不同 Stage:
GPU0:MB4
GPU1:MB3
GPU2:MB2
GPU3:MB1
这时多张 GPU 就可以同时工作。
可以理解成:
MB1 → Stage0 → Stage1 → Stage2 → Stage3
MB2 → Stage0 → Stage1 → Stage2 → Stage3
MB3 → Stage0 → Stage1 → Stage2 → Stage3
多个 Micro-batch 像工厂产品一样连续进入流水线。
2.3.5 Pipeline Bubble:流水线气泡
即使使用 Micro-batch,流水线开始和结束时仍然会出现空闲。
例如刚开始:
Time 1
GPU0:MB1
GPU1:Idle
GPU2:Idle
GPU3:Idle
下一时刻:
GPU0:MB2
GPU1:MB1
GPU2:Idle
GPU3:Idle
直到流水线被填满:
GPU0:MB4
GPU1:MB3
GPU2:MB2
GPU3:MB1
所有 GPU 才能同时工作。
这些等待区域称为:
Pipeline Bubble
通常:
Micro-batch 数量越多
↓
Bubble 占比越小
↓
GPU 利用率越高
但 Micro-batch 也不能无限增加,还要考虑:
- 显存
- 调度开销
- Batch Size
- 通信开销
2.3.6 Stage Balance:阶段负载均衡
Pipeline Parallelism 不仅要"平均分 Layer",更重要的是:
让每个 Stage 的计算时间尽量接近
例如:
Stage 0:10 ms
Stage 1:10 ms
Stage 2:40 ms
Stage 3:10 ms
那么 Stage 2 会成为整个 Pipeline 的:
Bottleneck
其他 GPU 即使已经计算完,也必须等待 Stage 2。
理想情况是:
T_stage0 ≈ T_stage1 ≈ T_stage2 ≈ T_stage3
因此实际划分模型时,不一定简单按照:
每张 GPU 相同 Layer 数
还要考虑:
- Attention / MLP 的计算量
- Embedding
- LM Head
- Activation 大小
- GPU 间通信
- 不同 Stage 的显存占用
2.3.7 Pipeline Parallelism 的核心特点
Pipeline Parallelism 可以总结为:
完整模型
↓
按 Layer 切成多个 Stage
↓
Stage 分配到不同 GPU
↓
Batch 再切成多个 Micro-batch
↓
不同 Micro-batch 同时位于不同 Stage
↓
形成流水线
它的优势是:
- 降低单张 GPU 保存模型参数的压力
- 可以训练单卡无法容纳的大模型
- 多个 Stage 可以同时计算不同 Micro-batch
主要问题是:
- Pipeline Bubble
- Stage Balance
- Activation / Gradient 通信
- 调度更加复杂
最后可以记成:
DP = 切数据
PP = 切 Layer
而下一节:
TP = 连一个 Layer 内部的大矩阵都切开
2.4 Tensor Parallelism:张量并行
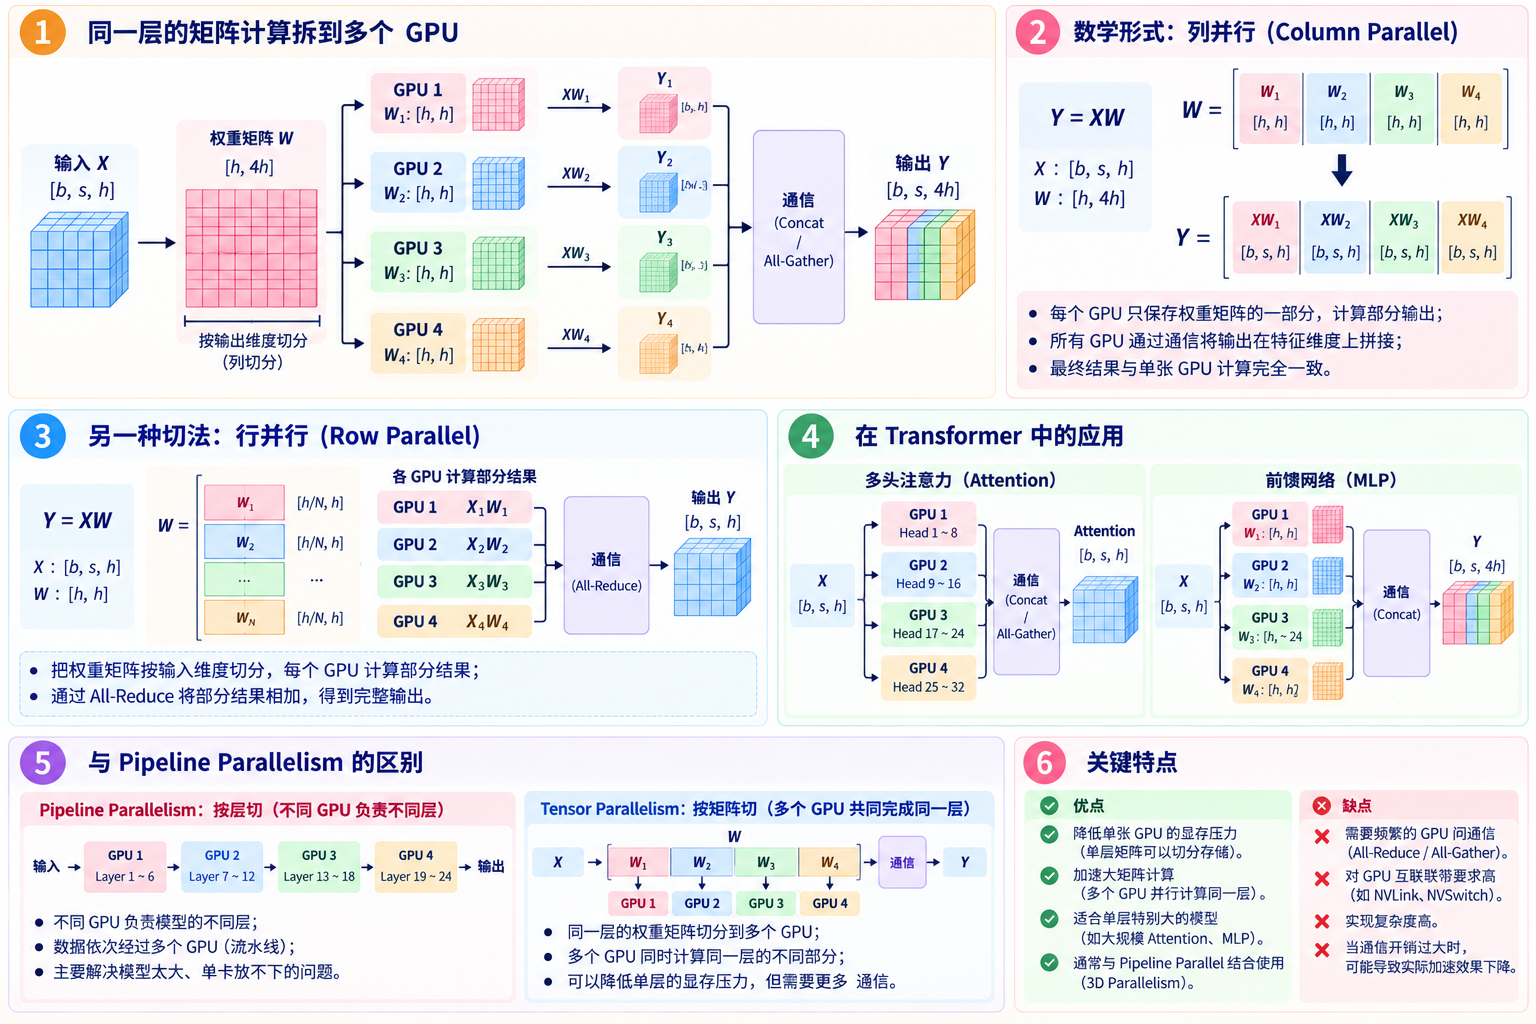
- 将同一个 Layer 内部的大矩阵切分到多张 GPU
- 多张 GPU 共同完成同一层的计算
- 常用于 Attention 和 MLP 的大矩阵乘法
- 可以降低单张 GPU 的参数与计算压力
- 代价是需要更频繁的 GPU 间通信
- 典型实现:Megatron-LM
2.4.1 Tensor Parallelism 的基本思想
Tensor Parallelism 的核心是:
同一层内部切分矩阵
假设一个线性层:
Y = XW
其中:
X:[b,s,h]
W:[h,4h]
如果权重矩阵 W 很大,可以把它拆成多个部分:
W = [W1 | W2 | ... | WN]
然后分别放到不同 GPU:
GPU0 → W1
GPU1 → W2
GPU2 → W3
...
所有 GPU 使用同一个输入 X,同时计算自己负责的矩阵部分。
所以:
Pipeline Parallelism = 不同 GPU 负责不同 Layer
而:
Tensor Parallelism = 多个 GPU 共同完成同一个 Layer
可以简单记成:
PP = 层与层之间切
TP = 一层内部切
2.4.2 为什么需要 Tensor Parallelism
Pipeline Parallelism 已经可以把不同 Layer 放到不同 GPU。
但是还可能出现一个问题:
单个 Transformer Layer 本身就很大,一张 GPU 仍然放不下。
例如 MLP 第一层:
W1:[h,4h]
当:
h = 8192
时:
W1:[8192,32768]
这个矩阵本身就包含大量参数。
Attention 中同样存在:
Wq
Wk
Wv
Wo
这些大型矩阵。
因此可以进一步:
把一个 Layer 内部的矩阵拆开
↓
多张 GPU 共同保存
↓
多张 GPU 同时计算
这就是 Tensor Parallelism。
所以它主要解决:
单层模型太大
和:
单层矩阵计算量太大
的问题。
2.4.3 Column Parallel 与 Row Parallel
Tensor Parallelism 最常见的矩阵切分方式可以先理解成:
Column Parallel
和:
Row Parallel
Column Parallel:按输出维度切分
假设:
Y = XW
其中:
W:[h,4h]
使用两张 GPU 时,可以把 W 按列切开:
W = [W1 | W2]
其中:
W1:[h,2h]
W2:[h,2h]
两张 GPU 同时计算:
GPU0:Y1 = XW1
GPU1:Y2 = XW2
最后:
Y = Concat(Y1,Y2)
因此 Column Parallel 可以理解成:
每张 GPU 负责一部分输出维度
Row Parallel:按输入维度切分
另外一种方式是把权重矩阵按照输入维度切开。
例如:
W = [W1 ; W2]
输入也对应拆开:
X = [X1 | X2]
两张 GPU 分别计算:
GPU0:Y1 = X1W1
GPU1:Y2 = X2W2
最后需要:
Y = Y1 + Y2
所以通常需要进行:
All-Reduce
或者类似的归约通信。
因此可以简单记成:
Column Parallel → 输出切开,最后 Concat
Row Parallel → 输入切开,最后 Sum / Reduce
这两种方式组合起来,就可以高效拆分 Transformer 中的大型线性层。
2.4.4 Transformer 中如何使用 Tensor Parallelism
Transformer 一层主要包含:
Self-Attention
和:
MLP
这两部分都有大量矩阵乘法,因此非常适合 Tensor Parallelism。
Attention 部分
Attention 中有:
Wq、Wk、Wv、Wo
还包含多个 Attention Head。
例如:
32 个 Attention Heads
使用 4 张 GPU:
GPU0:Head 1 ~ 8
GPU1:Head 9 ~ 16
GPU2:Head 17 ~ 24
GPU3:Head 25 ~ 32
每张 GPU 只负责自己的一部分 Attention Head。
因此:
同一层 Attention
↓
多张 GPU 同时计算
↓
再通过通信合并结果
MLP 部分
经典 MLP:
h → 4h → h
第一层:
W1:[h,4h]
可以使用 Column Parallel:
W1 → 按列切分
第二层:
W2:[4h,h]
可以使用 Row Parallel:
W2 → 按行切分
这样两层可以自然组合:
Column Parallel
↓
各 GPU 得到部分中间特征
↓
Row Parallel
↓
All-Reduce
↓
恢复完整输出
这也是 Megatron-LM 中非常经典的 Tensor Parallel 思路。
2.4.5 Tensor Parallelism 的通信开销
Tensor Parallelism 可以把参数和计算拆到多张 GPU,但代价是:
GPU 之间需要频繁通信
常见通信操作包括:
All-ReduceAll-GatherReduce-Scatter
例如 Row Parallel 中:
GPU0 → Y0
GPU1 → Y1
GPU2 → Y2
GPU3 → Y3
最终需要得到:
Y = Y0 + Y1 + Y2 + Y3
这就需要进行:
All-Reduce
所以 Tensor Parallelism 对 GPU 间互联速度非常敏感。
通常更加依赖:
NVLink
NVSwitch
等高速互联。
如果:
计算时间 < 通信时间
那么 GPU 大量时间都会花在等待通信上,并行收益就会明显下降。
2.4.6 Tensor Parallelism 的核心特点
Tensor Parallelism 可以总结成:
一个 Transformer Layer
↓
大型权重矩阵切分
↓
不同 GPU 保存不同矩阵分片
↓
所有 GPU 同时完成这一层的部分计算
↓
通过 All-Reduce / All-Gather 等方式交换结果
↓
得到完整 Layer 输出
它的主要优势是:
- 降低单张 GPU 保存单层参数的压力
- 分摊大型矩阵乘法的计算量
- 可以让多张 GPU 共同完成同一个 Transformer Layer
- 特别适合 Attention 和 MLP
主要问题是:
- GPU 间通信频繁
- 对 NVLink / NVSwitch 等高速互联依赖较强
- Tensor Parallel Degree 越大,通信成本通常越明显
最后可以把三种基本并行方式先记成:
DP = 切数据
PP = 切 Layer
TP = 切 Layer 内部的矩阵
2.5 三种并行方式的区别
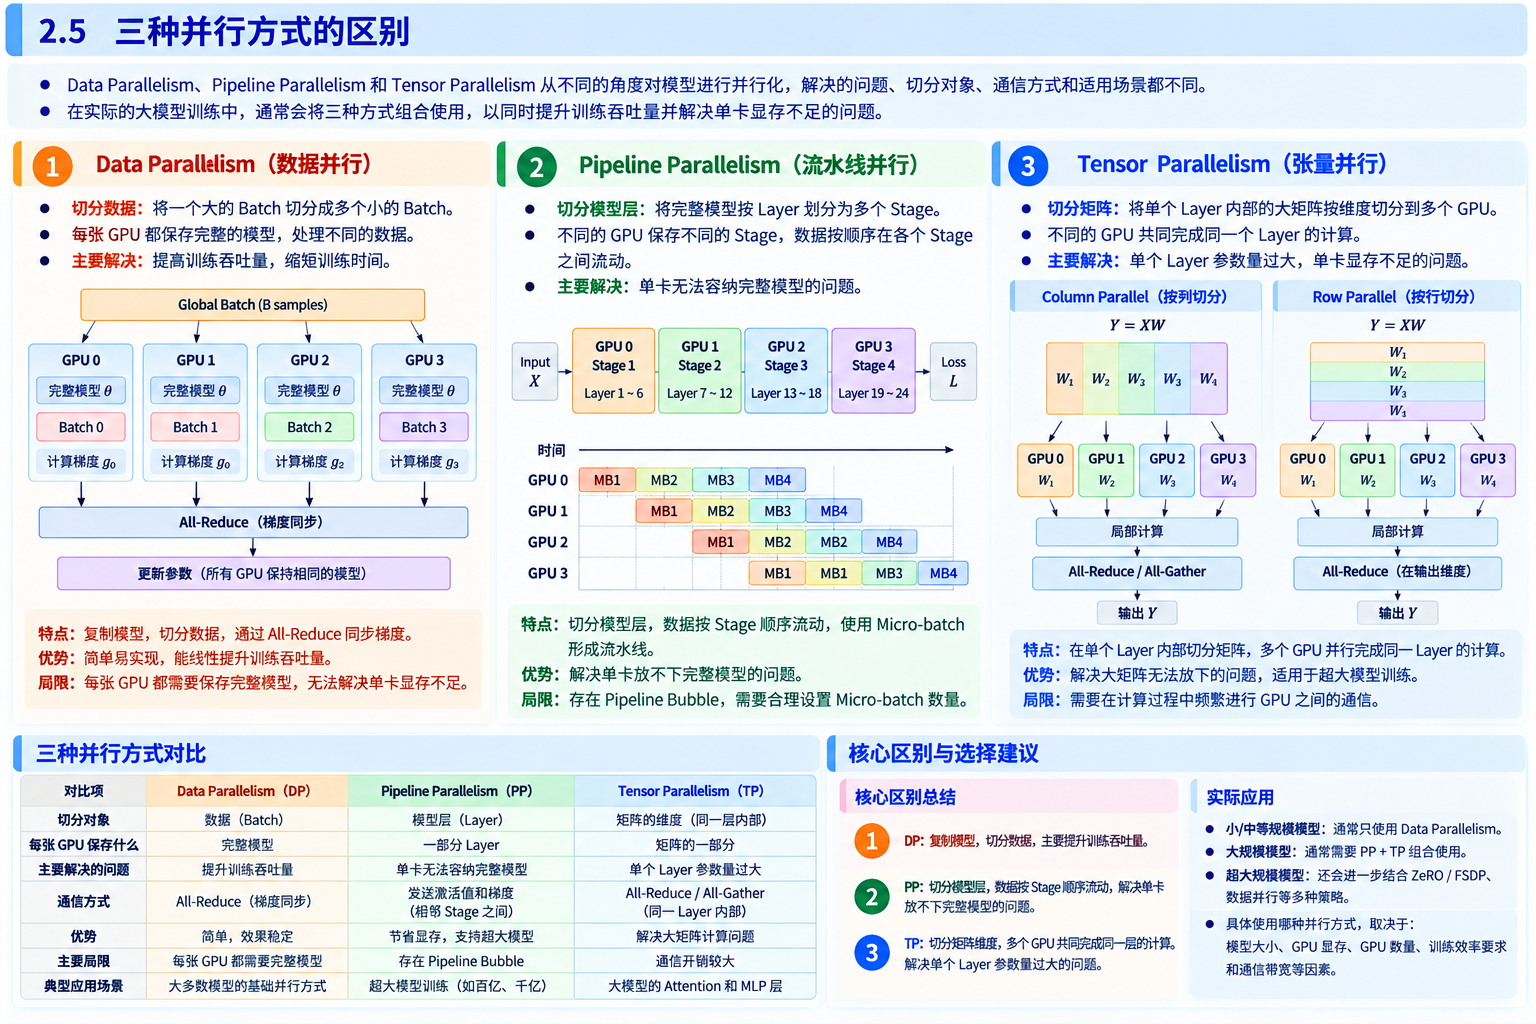
前面已经分别介绍了:
- Data Parallelism
- Pipeline Parallelism
- Tensor Parallelism
三种方法最大的区别就是:
DP = 切数据
PP = 切 Layer
TP = 切 Layer 内部的矩阵
它们解决的问题并不完全相同。
2.5.1 Data Parallelism:切数据
Data Parallelism 的核心是:
模型复制 + 数据切分
假设有 4 张 GPU:
GPU0:完整模型 + Data0
GPU1:完整模型 + Data1
GPU2:完整模型 + Data2
GPU3:完整模型 + Data3
每张 GPU 独立执行:
Forward → Backward
然后通过:
All-Reduce
同步梯度。
因此 DP 主要解决:
单张 GPU 计算速度有限,希望多张 GPU 同时处理更多数据。
它主要提升的是:
Training Throughput
但是缺点是:
每张 GPU 都要保存完整模型
所以如果模型本身单卡放不下,单纯使用 DP 仍然无法训练。
2.5.2 Pipeline Parallelism:切 Layer
Pipeline Parallelism 的核心是:
把模型按照 Layer / Stage 切开
例如:
GPU0:Layer 1 ~ 6
GPU1:Layer 7 ~ 12
GPU2:Layer 13 ~ 18
GPU3:Layer 19 ~ 24
同一份数据依次流过:
GPU0 → GPU1 → GPU2 → GPU3
因此 PP 主要解决:
完整模型太大,一张 GPU 无法容纳。
为了提高 GPU 利用率,还需要:
Micro-batch
让不同 Micro-batch 同时位于不同 Pipeline Stage。
主要问题是:
- Pipeline Bubble
- Stage Balance
- Activation / Gradient 通信
2.5.3 Tensor Parallelism:切矩阵
Tensor Parallelism 切得更细。
它不是把不同 Layer 分给不同 GPU,而是:
多个 GPU 共同完成同一个 Layer
例如线性层:
Y = XW
可以把:
W
切成:
W1、W2、W3、W4
然后:
GPU0 → W1
GPU1 → W2
GPU2 → W3
GPU3 → W4
多张 GPU 同时完成同一个矩阵乘法的一部分。
因此 TP 主要解决:
单个 Transformer Layer 或大型矩阵本身就太大。
它经常用于:
- Attention Heads
- Q / K / V / Wo
- MLP 大矩阵
主要问题是:
GPU 间通信非常频繁
因此通常需要:
NVLink / NVSwitch
等高速互联。
2.5.4 DP、PP、TP 对比
| 并行方式 | 切分对象 | 每张 GPU 保存什么 | 数据如何流动 | 主要解决的问题 | 主要代价 |
|---|---|---|---|---|---|
| Data Parallelism | 数据 | 完整模型 | 不同 GPU 处理不同 Batch | 提高训练吞吐量 | 梯度同步 |
| Pipeline Parallelism | Layer / Stage | 部分模型层 | 数据依次经过多个 Stage | 模型单卡放不下 | Pipeline Bubble |
| Tensor Parallelism | 单层内部矩阵 | 矩阵的一部分 | 多 GPU 同时算同一层 | 单层本身太大 | 高频 GPU 通信 |
可以简单记成:
DP:模型不切,数据切
PP:模型按层切
TP:一层内部继续切
2.5.5 三种并行方式应该怎么理解
如果模型能够完整放进一张 GPU,但训练太慢:
优先考虑 DP
如果整个模型太大,一张 GPU 放不下:
考虑 PP
如果连单个 Transformer Layer 都很大:
考虑 TP
但是超大模型训练中通常不会只选择一种。
例如:
DP + PP
DP + TP
PP + TP
甚至:
DP + PP + TP
一起使用。
因此三种并行方式更准确的关系不是:
谁替代谁
而是:
它们解决不同维度的问题,可以组合使用
这就自然进入下一节:
2.6 多种并行策略组合
也就是大模型训练中常说的:
3D Parallelism
2.6 多种并行策略组合
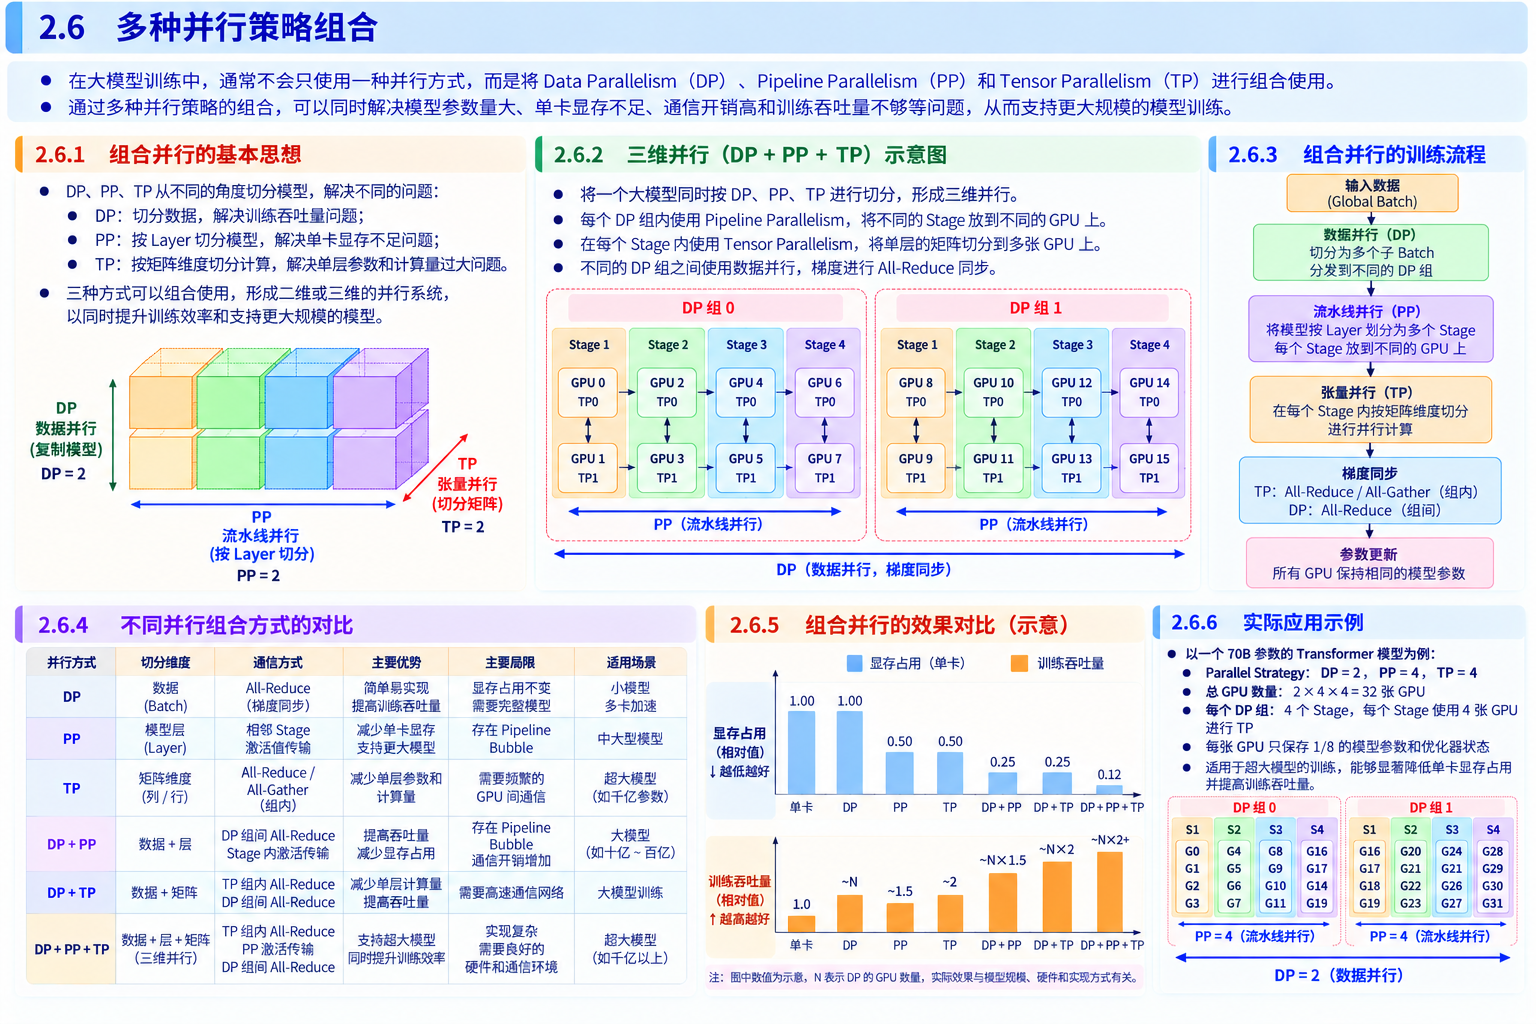
实际的大模型训练中,通常不会只使用一种并行方式。
因为:
DP、PP、TP
分别解决的是不同问题:
DP:切数据,提高训练吞吐量PP:切模型层,解决整个模型单卡放不下TP:切单层矩阵,解决单个 Layer 本身太大
因此实际训练中经常组合使用:
DP + TP
DP + PP
TP + PP
以及:
DP + PP + TP
其中:
DP + PP + TP
通常称为:
3D Parallelism
2.6.1 DP + TP:数据并行 + 张量并行
假设有 8 张 GPU。
可以划分成两个 Data Parallel Group:
DP Group 0:GPU0 ~ GPU3
DP Group 1:GPU4 ~ GPU7
每个 DP Group 内部再使用 Tensor Parallelism:
GPU0 ~ GPU3
共同完成一个模型副本中的矩阵计算。
而:
GPU4 ~ GPU7
共同完成另一份相同的模型副本。
两组处理不同的数据:
DP Group 0 → Data A
DP Group 1 → Data B
因此:
TP
负责:
把同一个 Layer 内部的大矩阵切开
而:
DP
负责:
复制多份 TP 模型,处理不同数据
这种组合适合:
模型单层较大,同时还希望通过多份模型副本提高训练吞吐量。
2.6.2 DP + PP:数据并行 + 流水线并行
假设一个模型被划分成 4 个 Pipeline Stage:
Stage 0
Stage 1
Stage 2
Stage 3
使用 4 张 GPU:
GPU0 → Stage 0
GPU1 → Stage 1
GPU2 → Stage 2
GPU3 → Stage 3
这 4 张 GPU 共同组成:
一个完整 Pipeline
如果还有另外 4 张 GPU:
GPU4 ~ GPU7
就可以再复制一套相同的 Pipeline。
于是:
Pipeline 0 → Data A
Pipeline 1 → Data B
两套 Pipeline 最后再进行梯度同步。
因此:
PP
负责:
把一个完整模型按 Layer 切开
而:
DP
负责:
复制多套完整 Pipeline
这种组合适合:
整个模型太大,同时还希望通过多份 Pipeline 提高整体训练吞吐量。
2.6.3 TP + PP:张量并行 + 流水线并行
如果模型继续增大,可能出现两个问题:
整个模型太大
同时:
单个 Layer 也很大
这时可以同时使用:
TP + PP
先使用 Pipeline Parallelism:
模型 → Stage 0 + Stage 1 + Stage 2 + Stage 3
再在每个 Stage 内部使用 Tensor Parallelism。
例如 8 张 GPU:
Stage 0 → GPU0 + GPU1
Stage 1 → GPU2 + GPU3
Stage 2 → GPU4 + GPU5
Stage 3 → GPU6 + GPU7
这里:
PP = 切不同 Layer
而:
TP = 切每个 Layer 内部的大矩阵
因此可以进一步降低:
单张 GPU 的模型参数和计算压力
2.6.4 3D Parallelism:DP + PP + TP
超大模型训练通常会同时使用:
Data Parallelism
Pipeline Parallelism
Tensor Parallelism
这就是:
3D Parallelism
三个维度分别负责:
DP → 数据维度
PP → Layer 维度
TP → 单层矩阵维度
可以把它理解成:
一个训练集群
↓
先划分多个:
Data Parallel Group
↓
每个 DP Group 内部划分:
Pipeline Stage
↓
每个 Pipeline Stage 内部继续划分:
Tensor Parallel Group
所以三种并行方式不是互相替代,而是在不同维度共同拆分训练任务。
2.6.5 GPU 数量如何计算
假设:
DP = 4
PP = 2
TP = 4
那么总 GPU 数量:
GPU Total = DP × PP × TP
也就是:
4 × 2 × 4 = 32
因此:
GPU 总数 = DP × PP × TP
这个公式非常重要。
其中:
TP = 4:一个 Layer 内部由 4 张 GPU 共同计算PP = 2:一个模型被切成 2 个 Pipeline StageDP = 4:完整模型结构一共复制 4 份
2.6.6 一个 32 GPU 的例子
假设:
GPU Total = 32
设置:
TP = 4
PP = 2
那么一份完整模型需要:
TP × PP
也就是:
4 × 2 = 8 张 GPU
32 张 GPU 一共可以组成:
32 / 8 = 4
份完整模型。
所以:
DP = 4
最终:
DP = 4
PP = 2
TP = 4
并满足:
32 = 4 × 2 × 4
可以理解成:
4 个 Data Parallel Group
每个 Group 内:
2 个 Pipeline Stage
每个 Stage 内:
4 张 GPU 做 Tensor Parallel
2.6.7 为什么需要组合并行
三种并行方式分别解决:
DP
↓
训练吞吐量不足
PP
↓
整个模型单卡放不下
TP
↓
单个 Layer 本身太大
因此实际大模型训练通常不是:
DP / PP / TP 三选一
而是:
根据模型大小和硬件条件进行组合
最终目标是同时解决:
模型放不下
训练速度太慢
GPU 利用率不高
的问题。
2.6.8 组合并行的代价
并行方式越多,系统也越复杂。
需要同时考虑:
- DP 的 Gradient Synchronization
- PP 的 Pipeline Bubble
- TP 的高频 GPU Communication
- Parallel Group 的划分
- GPU 间通信拓扑
- NVLink / NVSwitch / InfiniBand
- 显存分配
- 计算负载均衡
所以:
GPU 数量更多 ≠ 一定训练更快
真正需要平衡的是:
计算
显存
通信
并行效率
因此这一部分可以最终压缩成:
DP = 切数据
PP = 切 Layer
TP = 切矩阵
进一步:
DP + TP
DP + PP
TP + PP
DP + PP + TP = 3D Parallelism
并且:
GPU Total = DP × PP × TP
这也是后面继续学习:
DeepSpeed
和:
Megatron-LM
的重要基础。
Split Batch