一、先建立直觉:LLM 是什么
请先忘掉 "人工智能" 这个唬人的词,记住一个朴素画面:
给你出题:"青岛是山东的___"。你会填什么?------"省会"。
LLM 干的事就是这件事,只是规模大了几个数量级:它不是查字典,而是对词表里的每一个词打分 ,选出概率最高的那个。你问它任何问题,它都在做同一件事 ------续写一段最 "像样" 的文字。
关键认知(新手最容易误解的三点):
| 误解 | 真相 |
|---|---|
| LLM 是 "数据库 / 搜索引擎" | 不是。它的知识是 "压" 在参数里的统计关联,不是逐条存储 |
| LLM 知道 "答案对不对" | 不知道。它只知道 "这么说最像人话" |
| LLM 每句话都是查证过的 | 不是。它可能一本正经地编造(幻觉,后面细讲) |
为什么这反而很有用:语言是知识、逻辑、指令的载体。当一个模型 "极擅长续写人话" 时,续写 "请帮我写一封请假邮件:......" 就约等于 "执行指令"。这就是 LLM 能成为一切 AI 应用地基的原因。
二、语言的基本单位:Token
LLM 不按 "字" 或 "词" 处理语言,而是按 token(词元)。
示例 :"今天天气真好" 可能被切成 [今天] [天气] [真] [好] 4 个 token(也可能切成更细的子词,取决于分词器)。
- 分词器(Tokenizer) :主流用 BPE(字节对编码) ------ 高频词整体保留,低频词拆成常见子词。比如英文
unbelievable可能拆成un+believable,这样模型不需要为每个生僻词单独建槽位。 - 词汇表:常见模型几万到几十万个 token。模型输出层的 "打分",就是给这几十万个候选词逐个打分。
- 上下文窗口:模型一次能 "看" 的 token 上限(几千到上百万)。窗口是 LLM 记忆的物理边界 ------ 上一讲 Agent 的 "短期记忆" 就受它约束。
三、核心机制一:自回归 "预测下一个词"
这是 LLM 最重要的一张图。模型工作时,就是在 "输入序列 → 打分 → 采样 → 拼回输入 → 再来一轮" 的循环里转:
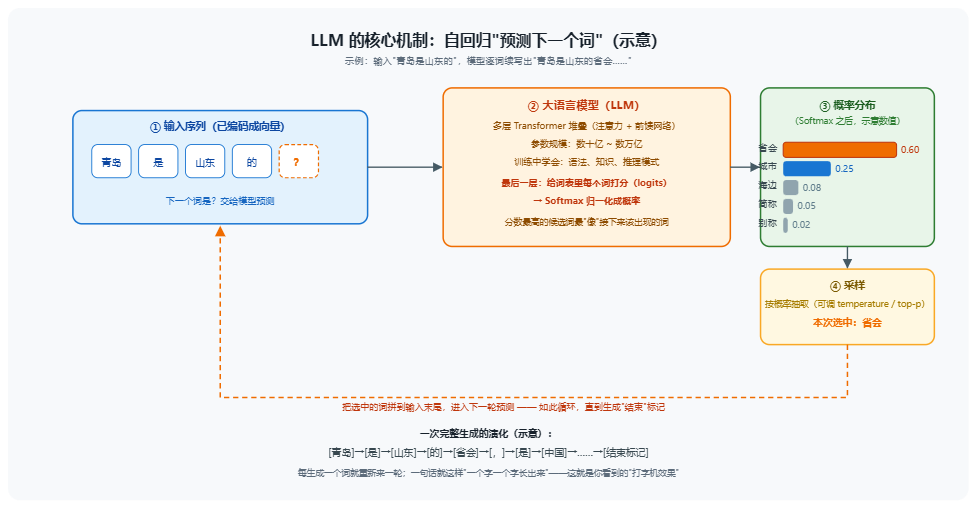
机制逐条解释:
- 打分:LLM 把输入序列编码成向量,经过几十上百层 Transformer 后,最后一层对词汇表里每个词输出一个分数(logits)。分数来自模型在训练中见过的统计模式 ------ 它见过大量 "青岛是山东的省会" 这类文本,所以 "省会" 这个位置的分数最高。
- Softmax:把原始分数转成概率分布(和为 1)。图中 "省会"0.60、"城市"0.25...... 这些是示意数值。
- 采样 :从分布里 "抽" 一个词。这一步有讲究:
- 贪心解码:永远选概率最高的("省会")→ 稳定但死板、容易重复;
- 温度(temperature):调节分布的 "陡峭程度"------ 温度低(如 0.1)几乎总是选最高分(适合写代码、算术);温度高(如 1.5)分布变平坦,敢选 "冷门词"(适合写诗、编故事);
- Top-p(核采样):只从累计概率达 p 的候选里抽,把 "明显离谱" 的词排除掉。
- 循环 :选中的词拼回输入,再预测下一个 ------ 直到模型输出专门的 "结束" 标记。这就是 "打字机效果" 的底层原因:不是 UI 在慢慢显示,而是模型真的在逐词生成。
实际价值 :理解了 "预测下一个词",你就理解了为什么 LLM 能写文章(续写)、能翻译(续写另一种语言)、能编程(续写代码)------所有任务都被统一成了 "续写" 这一个动作。
四、核心机制二:注意力与上下文
上一讲已经拆过 Transformer 注意力内部(Q/K/V),这里只看 LLM 特有的两个点:
- 上下文 = 模型 "看见" 的全部输入 。你的问题、历史对话、系统设定,全被拼成一段 token 序列一起喂给模型。模型没有 "读取记忆" 的能力 ------它只根据当前窗口里的内容回答。
- 窗口是硬边界。示例:你和它聊了 30 分钟、超出 128K 窗口后,最早的内容可能被截断或压缩,它就 "忘了"。这就是为什么长文档处理要用 "分块 + 检索"(上一讲的 RAG)而不是把所有内容硬塞进去。
五、核心机制三:涌现能力(不用训练就会的新本事)
LLM 最神奇的一点:训练时只学了 "预测下一个词",但到一定规模后,它 "无师自通" 了一些新能力 。这被称为涌现能力(Emergent Ability)------ 小模型没有、大模型突然出现的本领。
示例 1:上下文学习(In-Context Learning) 你不需要微调模型,只要在问题前给几个例子:
例子 1:句子 "天气很好" → 改写为感叹句 "天气真好啊!" 例子 2:句子 "他考了满分" → 改写为感叹句 "他居然考了满分!" 问题:句子 "晚饭真香" → 改写为感叹句
模型会照猫画虎输出 "晚饭真香啊!"。
机理解释:注意力机制让模型在上下文里 "现场找规律"------ 它发现 "句子 → 感叹句" 的模式,并把它套用到新输入上。参数一个没动,能力却 "现场长出来" 了。
示例 2:思维链(Chain-of-Thought, CoT) 问:"鸡和兔共 10 个头、28 只脚,各几只?" 直接答容易错。但如果让模型 "一步步想":
假设全是鸡:10 头 = 20 脚;实际 28 脚,多 8 脚;每把一只鸡换成兔多 2 脚;8 ÷ 2 = 4 → 4 只兔、6 只鸡。
机理解释:把推理过程拆成中间步骤写在输出里,每一步都是 "局部简单的预测",错误率远低于 "一步到位" 的跳跃式预测。这就是为什么现在的模型都默认 "先思考再回答"。
六、LLM 能做什么:能力谱系与示例
| 能力 | 示例 | 机理(一句话) |
|---|---|---|
| 续写 / 创作 | "写一首关于大海的短诗" | 续写训练时见过海量诗歌模式 |
| 翻译 | "猫坐在垫子上" → "The cat sat on the mat" | 预训练语料中中英文本交错出现,注意力把两种语言语义对齐 |
| 摘要 | 给一篇 5000 字新闻 → 100 字要点 | 注意力权重高的句子 / 关键信息被加权保留 |
| 问答 | "光合作用的原料是什么" | 参数中 "压" 着语料里的知识关联 |
| 代码生成 | "用 Python 写斐波那契函数" | 代码在语料中量大且规律极强,最容易 "续写" |
| 推理 | "三个苹果吃了两个还剩几个" | 语言模式 + 思维链机制 |
| 多模态 | 看图描述、听语音转文字 | 视觉 / 听觉先 "翻译" 成 token(上一讲已展开) |
示例展开 ------ 翻译的机理:模型在预训练时读了海量 "中英对照" 或 "双语混排" 的网页,注意力在训练中学会了 "中文 ' 猫' 的向量,和英文 'cat' 的向量,语义上指向同一概念"。翻译时它就是在 "用另一种语言续写同一个意思"。
七、LLM 是怎么训练出来的:三阶段
一个大模型要变成 "好用且安全" 的助手,要连续精调三遍:
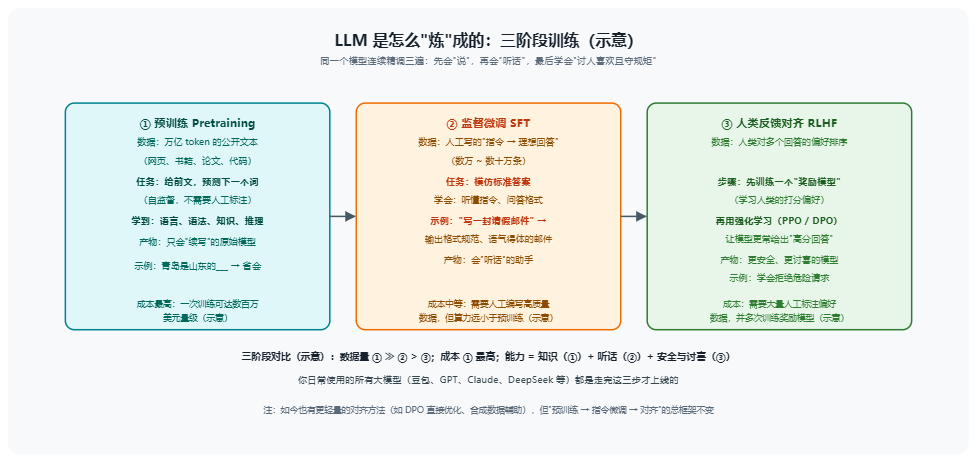
机制补充说明:
- 预训练为什么用 "预测下一个词":因为文本本身就是免费的标签 ------ 任何一个句子的 "后半句" 就是 "前半句" 的标准答案。这让模型可以从整个互联网的文本中自学,不需要人工标注,这是大模型能做大的根本原因。
- RLHF 具体怎么跑:让人对同一问题的多个回答排序("A 更安全、B 更有帮助")→ 训练一个 "奖励模型" 模仿人的打分 → 用强化学习(PPO)调整大模型,让它更倾向于输出高分回答。今天更流行的 DPO 则跳过奖励模型,直接根据偏好数据优化,更简单稳定。
- 对齐的价值 :模型 "拒绝危险请求"(如不提供自伤方法、不教违法犯罪)不是天生就会,而是对齐阶段被训练出来的行为。
八、LLM 的 "坏毛病":幻觉与局限(新手必看)
幻觉(Hallucination):模型一本正经地编造事实。
- 示例:问 "某本 2025 年出版的书讲了什么",模型可能煞有介事地编出一个书名和目录 ------ 因为它 "续写" 得很流畅,但没有任何事实核查。
- 机理解释 :模型的训练目标从来都是 "像 ",不是"对"。它只优化" 这句话在统计上像人类写的 ",没有" 去查证 "的通道。当某个问题超出它知识范围时,它不会说" 不知道 ",而是会" 编一个最像样的答案 "。
- 缓解手段 :RAG(检索增强,让它先查资料再回答)、工具调用(上一讲的 Agent 就是为此设计的)、人工审核。所以重要事实类问题,永远要以工具查证结果为准。
其他常见局限:
- 知识截止:训练数据有截止日期,之后的新事它不知道(需要联网工具补)。
- 上下文有限:窗口外的内容 "看不见"。
- 数学与计数弱:大数乘法、复杂计数容易错(所以要让它用代码计算器)。
- 立场与偏见:模型会放大训练数据中的偏见,这也是对齐阶段要持续治理的。
九、实践价值与学习路径
价值:LLM 是过去十年 AI 领域最大的 "平台级" 突破 ------ 一个模型统一了写作、翻译、问答、编程、多模态理解,再叠加 Agent 的记忆与工具,就能变成 "能办事的助理"(前两讲的完整链路)。
给新手的四步路径:
- 玩:多用几款大模型产品,观察它们在不同任务上的表现差异,建立手感。
- 懂:把本文的 "自回归循环 + 三阶段训练" 讲给朋友听(能讲清楚 = 真懂了)。
- 拆:用开源工具(Ollama 本地跑小模型)改 temperature/top-p,亲手看概率分布变化;用提示词实验 few-shot 和 CoT 的效果。
- 建:调一个开源小模型(LoRA 微调),或基于 API 做一个带 RAG 和工具的小应用,把前面所有概念串成实物。
一句话总结 :LLM = 在万亿文本上,用 "预测下一个词" 的方式训练出来的巨型概率模型 ;它靠自回归循环 生成内容、靠注意力 理解上下文、靠三阶段训练获得知识 / 听话 / 安全三种能力;它的强大来自规模,它的错误(幻觉)也来自 "只求像、不求对" 的本性。理解这四条,你就真正入门了大语言模型。