一、自定义中间件
某些复杂场景下,官方内置的中间件不能完全满足需求,此时可以通过实现LangChain暴露的中间件
hook函数构建自定义中间件。
说明:尽可能使用内置中间件。
1.1 什么是hook函数(钩子函数)
Hook 函数,中文常叫钩子函数,指的是:在某个既定流程的特定时机,被框架、系统或主程序自动
调用的扩展函数。
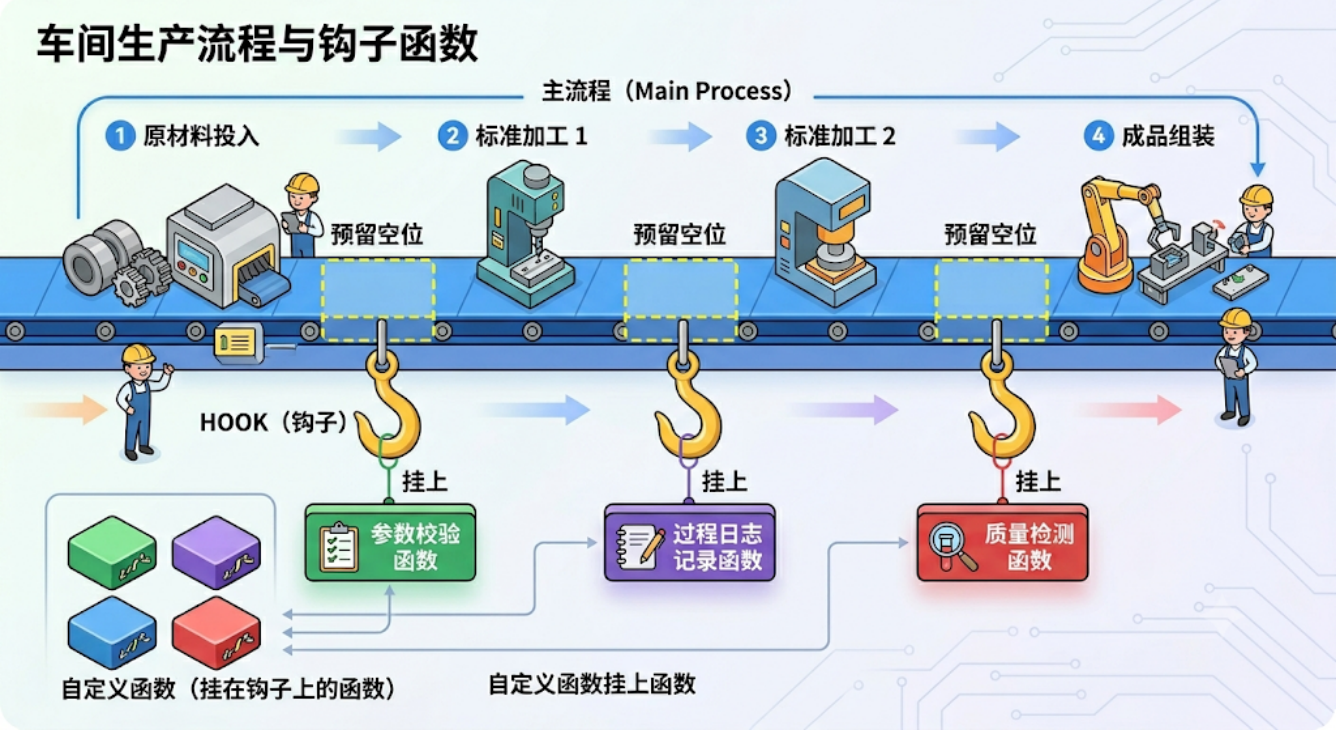
因此,可以把它理解成:
主流程预留了一些插槽,允许你在这些位置挂上自己的函数,这种被挂进去并在特定时机执行的函
数,就是 hook 函数。
核心特点:
1、不是你主动在业务代码里随便调用的,而是当流程运行到某个"钩子点"时,系统自动触发它。
2、它依附于一个更大的执行流程。比如"请求开始前""模型调用前""任务结束后""异常发生时"等。
3、它的作用是让你在不改主流程源码的前提下插入自己的逻辑。例如做日志、鉴权、修改输入、
拦截输出、清理资源等。
LangChain的中间件作用在Agent架构中,后者是基于LangGraph构建的流程图。如下列出了六个hook
函数(钩子函数):
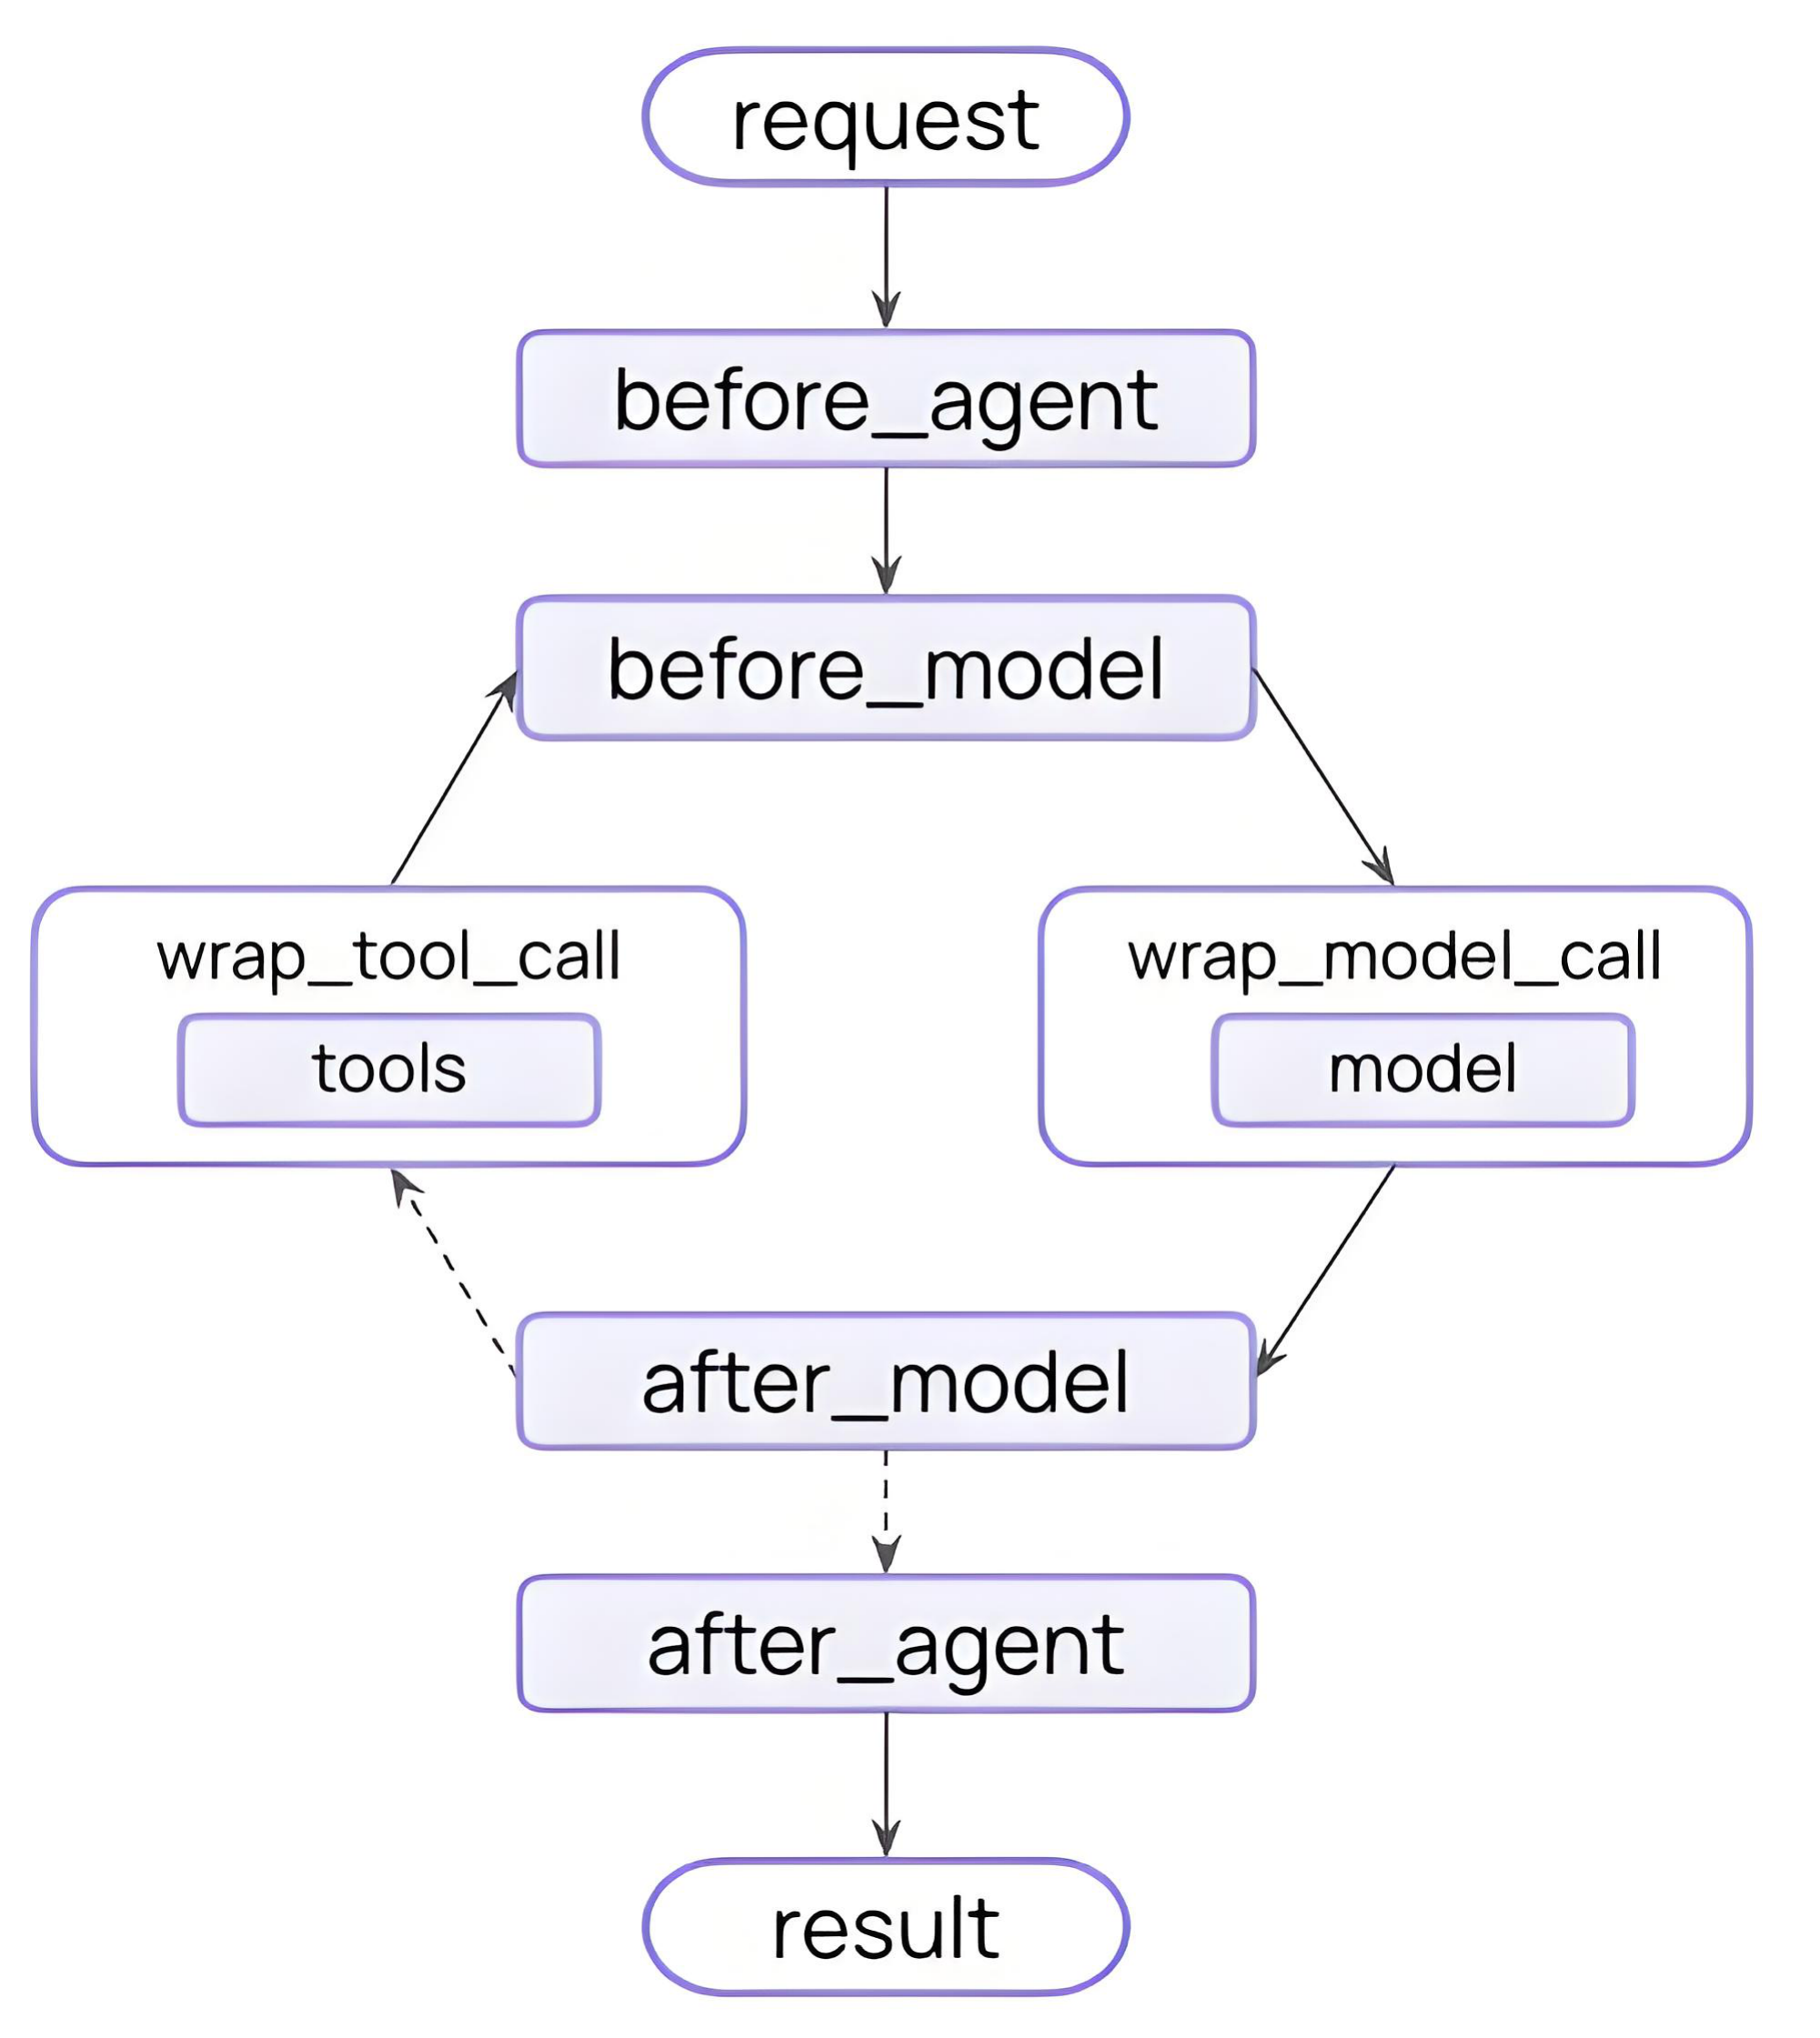
无论是官方内置中间件、自定义中间件、还是下文提到的便捷装饰器中间件,通常都是通过实现其中的
一个或多个hook来生效的。
1.2 LangChain的hook函数分类
官方将六个钩子函数按照风格分为两类
1.2.1 类型1:Node-style hooks(节点风格钩子)
顾名思义,它们在流程的特定节点运行。
适合顺序逻辑,如记录日志、验证
包括
-
before_agent:在Agent开始运行之前执行。
-
before_model:在模型调用之前执行。
-
after_model:在模型调用之后执行。
-
after_agent:在Agent流程全部完成后执行。
1.2.2 类型2:Wrap-style hooks(包装风格钩子)
顾名思义,它们在模型或工具调用前后运行。
适合控制流,如重试、回退、缓存。
包括
-
wrap_model_call (包裹模型调用)
-
wrap_tool_call (包裹工具调用)
1.3 Node-style hooks函数用法
支持两种用法
-
装饰器是函数式挂载,把一个hook快速挂载到Agent的某个节点。
-
类写法是对象化中间件,把中间件封装为一个可配置、可复用、可扩展的组件。
1.3.1 基本用法
1.3.1.1 基于装饰器实现
text
  1  from langchain.chat_models import init_chat_model
  2  from dotenv import load_dotenv
  3  import os
  4
  5  # 从.env文件中加载环境变量
  6  load_dotenv(override=True)
  7
  8  model = init_chat_model(
  9      model="gpt-5.4-mini",
 10      model_provider="openai",
 11      api_key=os.getenv("CLOSEAI_API_KEY"),
 12      base_url=os.getenv("CLOSEAI_BASE_URL")
 13  )
text
  1  from langchain.agents.middleware import before_model, after_model,
     before_agent, after_agent, AgentState, AgentMiddleware
  2  from langchain.messages import HumanMessage
  3  from langgraph.runtime import Runtime
  4  from langchain.agents import create_agent
  5
  6  from typing import Any
  7
  8  # 1. 定义 before_model 钩子
  9  @before_model
 10  def before_model_middleware(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 11      state["messages"][-1].content += " -> before_model <- "
 12      return None
 13
 14  # 2. 定义 after_model 钩子
 15  @after_model
 16  def after_model_middleware(state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 17      state["messages"][-1].content += " -> after_model <- "
 18      return None
 19
 20  # 3. 定义 before_agent 钩子
 21  @before_agent
 22  def before_agent_middleware(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 23      state["messages"][-1].content += " -> before_agent <- "
 24      return None
 25
 26  # 4. 定义 after_agent 钩子
 27  @after_agent
 28  def after_agent_middleware(state: AgentState, runtime: Runtime) -> None:
 29      state["messages"][-1].content += " -> after_agent <- "
 30      return None
 31
 32  agent = create_agent(
 33      model = model,
 34      middleware = [before_model_middleware, after_model_middleware,
     before_agent_middleware, after_agent_middleware] # 👈 添加中间件
 35  )
 36
 37  response = agent.invoke({
 38      "messages": [HumanMessage("你好啊")],
 39  })
 40
 41  for msg in response["messages"]:
 42      msg.pretty_print()
输出
text
 1  ================================ Human Message
    =================================
 2
 3  你好啊 -> before_agent <-  -> before_model <-
 4  ================================== Ai Message
    ==================================
 5
6 你好!有什么可以帮你的吗?😊 -> after_model <- -> after_agent <-- 观察HumanMessage可以发现,before_agent钩子先于before_model被执行,二者都在调用模型
之前被执行
- after_agent晚于after_model执行,二者都在模型调用后执行。
1.3.1.2 基于类实现
关键规则:
- 必须继承 AgentMiddleware ← 这个固定
- 方法名固定 ( before_model , after_model ) ← 这个固定
- 类名随意 ← 这个不固定
LangGraph 只看:
-
是否继承 AgentMiddleware?
-
是否有 before_model / after_model 等方法?
举例:
text
  1  from langchain.agents.middleware import AgentMiddleware, AgentState,
     hook_config
  2  from langchain.messages import HumanMessage
  3  from langgraph.runtime import Runtime
  4  from langchain.agents import create_agent
  5
  6  from typing import Any
  7
  8
  9  class MyMiddleware(AgentMiddleware):
 10      def __init__(self):
 11          super().__init__()
 12
 13      def before_model(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 14          state["messages"][-1].content += " -> before_model <- "
 15          return None
 16
 17      def after_model(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 18          state["messages"][-1].content += " -> after_model <- "
 19          return None
 20
 21      def before_agent(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 22          state["messages"][-1].content += " -> before_agent <- "
 23          return None
 24
 25      def after_agent(self, state: AgentState, runtime: Runtime) -> None:
 26          state["messages"][-1].content += " -> after_agent <- "
 27          return None
 28
 29  my_middleware = MyMiddleware()
 30
 31
 32  agent = create_agent(
 33      model = model,
 34      middleware = [my_middleware]
 35  )
 36
 37  response = agent.invoke({
 38      "messages": [HumanMessage("你好啊")],
 39  })
 40
 41  for msg in response["messages"]:
 42      msg.pretty_print()
输出
text
 1  ================================•[1m Human Message
    •[0m=================================
 2
 3  你好啊 -> before_agent <-  -> before_model <-
 4  ==================================•[1m Ai Message
    •[0m==================================
 5
 6  你好!看起来你发送的消息中包含一些特殊的标记,比如 `before_agent` 和
    `before_model`。请问你是想测试某种流程,还是需要我帮你处理特定的任务呢?
 7
 8  如果是技术测试或调试,请告诉我具体需求;如果是普通聊天,我们可以直接开始对话哦! 😊 ->
after_model <- -> after_agent <-- before_model 通常的场景:
消息修剪(trim messages)
PII 脱敏
输入验证
条件路由
- after_model 通常的场景:
输出验证
格式化响应
统计信息
状态更新
1.3.2 两种方法的统一
装饰器底层会基于我们重写的方法构造一个AgentMiddleware子类的实例,以@after_model 装饰器
底层实现为例,关键代码如下
text
 1  return type(
 2      middleware_name,
 3      (AgentMiddleware,),
 4      {
 5          "state_schema": state_schema or AgentState,
 6          "tools": tools or [],
 7          "after_model": wrapped,
 8      },
 9  )()
这是after_model最终返回的内容。
上述代码中的wrapped是after_model内部的装饰器,代码如下
text
 1  def wrapped(
 2      _self: AgentMiddleware[StateT, ContextT],
 3      state: StateT,
 4      runtime: Runtime[ContextT],
 5  ) -> dict[str, Any] | Command[Any] | None:
 6      return func(state, runtime)  # type: ignore[return-value]
上述代码等价于
text
 1  return type(
 2      middleware_name,
 3      (AgentMiddleware,),
 4      {
 5          "state_schema": state_schema or AgentState,
 6          "tools": tools or [],
 7          "after_model": func(state, runtime),
 8      },
 9  )()
而func(state, runtime) 正是我们定义的、被@after_model 修饰的函数,在上述案例中对应的是
after_model_middleware,
上述代码的含义是
- 创建一个AgentMiddleware的子类
- 类名为middleware_name,即创建agent时传递的中间件名称,上述案例中是
after_model_middleware
- 这个子类有两个属性state_schema 和tools
- 有一个方法:after_model ,逻辑等同于func(state, runtime) 。
- 最后的括号() 表示实例化子类,返回一个对象
所以,用装饰器最终返回的也是一个AgentMiddleware的子类对象,并且重写了after_model方法,和
基于类的自定义方式本质是一样的。
1.3.3 参数说明
Node-style hooks函数有两个参数
state: 是一个AgentState实例,维护Agent运行过程中的状态,这类状态会随着Agent的运行而发生变
化,包括消息列表。
runtime: 是一个Runtime实例,维护Agent运行过程中的上下文环境,包括上下文、长期记忆等。
1.3.4 返回值说明
返回 None:不修改状态(不修改Agent状态)
text
 1  def before_model(self, state, runtime):
 2      print("日志记录")
 3      return None  # 不做任何修改,继续流程
返回字典:更新状态
text
 1  def after_model(self, state, runtime):
 2      count = state.get("count", 0)
 3      return {"count": count + 1}  # 更新状态中的 count
返回 {"jump_to": "..."}:控制流程
text
 1  def before_model(self, state, runtime):
 2      if state.get("count", 0) > 10:
 3          return {"jump_to": "__end__"}  # 跳过模型,直接结束
 4      return None
jump_to 目标:
-
"end" - 结束 Agent
-
"tools" - 跳到工具节点
-
其他自定义节点
1.3.5 装饰器参数:can_jump_to
这里就涉及到Node-style的四个hook函数可以接收额外参数can_jump_to 。
钩子函数可以改变Agent正常的运行轨迹。比如:发现上下文窗口溢出,直接跳转至结尾,提前终止整
个Agent。
can_jump_to 决定了钩子函数可以直接跳转至流程的哪些位置,可取值如下:
-
end:跳转至Agent流程末尾,或第一个after_agent钩子,直接终止整个流程。
-
tools:跳转至工具节点。
-
model:跳转至模型节点,或第一个before_model钩子。
1.3.5.1 基于装饰器实现
text
   1  from typing import Any
   2
   3  from langchain.agents import create_agent
   4  from langchain.agents.middleware import before_model, after_model,
       AgentState
   5  from langchain.messages import AIMessage, SystemMessage
   6  from langchain.tools import tool
   7  from langgraph.runtime import Runtime
   8
   9
  10  @tool
  11  def get_news() -> str:
  12      """获取当日新闻"""
  13      return f"美加墨世界杯今日开幕"
  14
  15
  16  # 在模型(LLM)执行前触发。允许跳转到 "tools" 节点。
  17  @before_model(can_jump_to=["tools"])
  18  def force_tool_first(state: AgentState, runtime: Runtime) -> dict[str, Any]
       | None:
  19      """
  20      【业务场景:强行拦截并触发工具】
  21      如果用户输入包含 "direct tool",则跳过本次大模型的思考/生成阶段,
  22      直接伪造一个大模型的 tool_calls 意图,强行把控制权移交给工具执行节点。
  23      """
  24      text = state["messages"][-1].content
  25      # 检查关键词,满足条件则强行干预流程
  26      if isinstance(text, str) and "direct tool" in text.lower():
  27          print("[MIDDLEWARE] before_model: jump_to='tools'")
  28
  29          # 人工构造一个大模型的消息对象(AIMessage)
  30          # 欺骗系统,让系统误以为这是模型自己决定要调用的工具
  31          fake_tool_call = AIMessage(
  32              content="人工构造的消息",
  33              tool_calls=[
  34                  {
  35                      "name": "get_news",
  36                      "args": {},
  37                      "id": "call_force_weather_001",
  38                  }
  39              ],
  40          )
  41
  42          # 返回更新后的状态:注入伪造的消息,并明确指定下一步跳转到 "tools" 节点
  43          return {
  44              "messages": [fake_tool_call],
  45              "jump_to": "tools",
  46          }
  47      # 如果不满足触发条件,返回 None,流程正常向下流转(继续让 LLM 思考)
  48      return None
  49
  50  # 在模型(LLM)执行生成之后触发。允许重新跳转回 "model" 节点。
  51  @after_model(can_jump_to=["model"])
  52  def retry_with_extra_instruction(state: AgentState, runtime: Runtime) ->
       dict[str, Any] | None:
  53      """
  54      【业务场景:反思/重试机制】
  55      如果大模型已经生成了回答,但发现用户最初的请求包含 "retry model",
  56      则动态追加一条系统提示词(SystemMessage),强行让模型重新生成(重试)一次。
  57      """
  58      # 倒序遍历消息历史,找到最近的一次用户输入(human 消息)
  59      user_text = ""
  60      for msg in reversed(state["messages"]):
  61          if getattr(msg, "type", "") == "human":
  62              user_text = getattr(msg, "content", "")
  63              break
  64
  65      # 检查用户输入是否包含触发重试的关键字
  66      if isinstance(user_text, str) and "retry model" in user_text.lower():
  67          # 【核心防御】:防止无限循环重跳(死循环)
  68          # 检查消息历史中是否已经注入过这条特殊的系统提示。如果有,说明已经重试过了,不再
       重复干预。
  69          already_injected = any(
  70              isinstance(getattr(msg, "content", None), str)
  71              and "你必须以【二次回答】开头" in msg.content
  72              for msg in state["messages"]
  73          )
  74          if already_injected:
  75              return None # 已注入过,直接放行,结束重试流程
  76
  77          print("[MIDDLEWARE] after_model: jump_to='model' with extra system
       instruction")
  78
  79          # 返回更新后的状态:追加强力约束的系统消息,并将指针跳回 "model" 节点重新执行
  80          return {
  81              "messages": [
  82                  SystemMessage("你必须以【二次回答】开头,并且只用一句话回答。")
  83              ],
  84              "jump_to": "model",
  85          }
  86
  87      return None
  88
  89  # 在模型(LLM)执行前触发。允许直接跳转到 "end" 节点(强行终止)。
  90  @before_model(can_jump_to=["end"])
  91  def overflow_context_processor(state: AgentState, runtime: Runtime) ->
       dict[str, Any] | None:
  92      """
  93      【业务场景:安全卫士/异常拦截】
  94      模拟上下文窗口溢出(Token超限)或其他严重的系统阻断情况。
  95      一旦触发,直接熔断流程,拒绝让大模型继续处理,直接报错或返回兜底文案。
  96      """
  97
  98      # 假装溢出,模拟检查最后一条消息是否包含 overflow 标识
  99      if "overflow" in state["messages"][-1].content:
 100          print("[MIDDLEWARE] before_model: jump_to='end' when contenxt
       window overflow")
 101
 102          # 构造兜底的结束消息,并直接指定跳转到 "end" 终止 Agent 运行
 103          return {
 104              "messages": [
 105                  AIMessage("上下文窗口溢出,终止")
 106              ],
 107              "jump_to": "end",
 108          }
 109
 110
 111  agent = create_agent(
 112      model=model,
 113      tools=[get_news],
 114      # # 将定义的中间件按照顺序挂载到 Agent 中(注意:执行顺序会严格按照列表声明顺序)
 115      middleware=[force_tool_first, retry_with_extra_instruction,
       overflow_context_processor],
 116  )
 117
 118
 119  def run_once(user_input: str):
 120      result = agent.invoke(
 121          {
 122              "messages": [
 123                  {"role": "user", "content": user_input}
 124              ]
 125          }
 126      )
 127
 128      for msg in result["messages"]:
 129          msg.pretty_print()
 130
 131
 132  if __name__ == "__main__":
 133      # Case 1: 直接跳 tools
 134      # 预期表现:
 135      # 1. 触发 force_tool_first,打印 "[MIDDLEWARE] before_model:
       jump_to='tools'"
 136      # 2. 绕过 LLM 的首轮思考,直接调用 `get_news` 工具
 137      # 3. 工具返回结果后,LLM 总结工具结果并输出
 138      print('=' * 30, '-> Case 1 <-', '=' * 30)
 139      run_once("请帮我查今日新闻 direct tool")
 140
 141      # Case 2: 输出后跳回 model
 142      # 预期表现:
 143      # 1. 正常进入 LLM 生成第 1 版回答
 144      # 2. 触发 retry_with_extra_instruction,打印 "[MIDDLEWARE] after_model:
       jump_to='model'..."
 145      # 3. 注入系统提示词后,LLM 被强行拉回并生成第 2 版回答
 146      # 4. 最终输出应带有"【二次回答】"前缀
 147      print('=' * 30, '-> Case 2 <-', '=' * 30)
 148      run_once("请随便介绍一下 LangChain retry model")
 149
 150      # Case 3:
 151      # 预期表现:
 152      # 1. 触发 overflow_context_processor 中间件
 153      # 2. 直接打印终止信息并退出,LLM 根本不会接收到这个请求
 154      print('=' * 30, '-> Case 3 <-', '=' * 30)
 155      run_once("你好 overflow")
 156
 157      # Case 4: 正常流程
 158      # 预期表现:
 159      # 1. 没有任何中间件被触发(不满足任何关键字)
 160      # 2. Agent 走正常的 OOTB(Out of the box)标准工作流:User -> Model -> Call
       Tool -> Model -> End
 161      print('=' * 30, '-> Case 4 <-', '=' * 30)
 162      run_once("今日新闻摘要?")
输出
text
   1  ============================== -> Case 1 <-
       ==============================
   2  [MIDDLEWARE] before_model: jump_to='tools'
   3  ================================ Human Message
       =================================
   4
   5  请帮我查今日新闻 direct tool
   6  ================================== Ai Message
       ==================================
   7
   8  人工构造的消息
   9  Tool Calls:
  10  get_news (call_force_weather_001)
  11  Call ID: call_force_weather_001
  12  Args:
  13  ================================= Tool Message
       =================================
  14  Name: get_news
  15
  16  美加墨世界杯今日开幕
  17  ================================== Ai Message
       ==================================
  18
  19  今日新闻:
  20  - 美加墨世界杯今日开幕
  21
  22  如果你想,我也可以继续帮你整理成:
  23  1. 一句话摘要
  24  2. 3条要点
  25  3. 中文新闻解读
  26  ============================== -> Case 2 <-
       ==============================
  27  [MIDDLEWARE] after_model: jump_to='model' with extra system
       instruction
  28  ================================ Human Message
       =================================
  29
  30  请随便介绍一下 LangChain retry model
  31  ================================== Ai Message
       ==================================
  32
  33  可以,简单介绍一下 **LangChain 的 retry model(重试机制)**。
  34
  35  ## 1. 它是什么
  36  在 LangChain 里,retry model 指的是:
  37  当模型调用失败时,自动重试几次,而不是立刻报错。
  38
  39  常见失败原因包括:
  40  - 网络抖动
  41  - API 临时不可用
  42  - 限流(rate limit)
  43  - 超时
  44  - 服务端偶发错误
  45
  46  ---
  47
  48  ## 2. 它解决什么问题
  49  大模型调用并不是每次都稳定成功。
  50  重试机制的作用就是提高程序鲁棒性,让你的链路更"抗打"。
  51
  52  比如:
  53  - 第一次请求超时
  54  - 第二次请求成功
  55  这样用户就不需要手动刷新或重新触发。
  56
  57  ---
  58
  59  ## 3. 在 LangChain 中怎么理解
  60  LangChain 本身经常会包裹底层模型调用,比如 OpenAI、Anthropic、Hugging Face
       等。
  61  Retry model 通常意味着给这些调用加上一层 **自动重试包装**。
  62
  63  典型逻辑是:
  64  1. 发送请求
  65  2. 如果成功,直接返回
  66  3. 如果失败,等待一小段时间
  67  4. 再试一次
  68  5. 达到最大次数后,抛出错误
  69
  70  ---
  71
  72  ## 4. 常见特性
  73  重试机制一般会带这些能力:
  74
  75  - **最大重试次数**:比如 3 次、5 次
  76  - **指数退避**:每次失败后等待时间逐渐增加
  77  - **只对可重试错误生效**:比如网络错误、429、5xx
  78  - **不重试业务错误**:比如参数格式不对、提示词错误
  79
  80  ---
  81
  82  ## 5. 一个直观例子
  83  你可以把它理解成:
  84
  85  > "如果模型第一次没接通,等一下再拨;如果还不通,再等久一点继续拨。"
  86
  87  这比直接失败更适合生产环境。
  88
  89  ---
  90
  91  ## 6. 适合用在哪
  92  特别适合这些场景:
  93  - 在线问答系统
  94  - Agent 工具调用
  95  - 批量任务处理
  96  - 需要高可用的生产服务
  97
  98  ---
  99
 100  ## 7. 需要注意什么
 101  虽然重试很好用,但也不是越多越好:
 102
 103  - 重试太多会增加延迟
 104  - 失败请求会消耗更多 token / API 额度
 105  - 如果是逻辑错误,重试也没用
 106  - 要避免重复执行有副作用的操作
 107
 108  ---
 109
 110  ## 8. 一句话总结
 111  **LangChain retry model 本质上就是为大模型调用加"自动重试 + 退避"能力,提高调
       用稳定性和容错率。**
 112
 113  如果你愿意,我也可以继续给你讲:
 114  - LangChain 里具体怎么写 retry
 115  - 和 `with_retry()` 的关系
 116  - Python 里一个最小示例
 117  ================================ System Message
       ================================
 118
 119  你必须以【二次回答】开头,并且只用一句话回答。
 120  ================================== Ai Message
       ==================================
 121
 122  【二次回答】LangChain 的 retry model 就是给模型调用加上自动重试和指数退避机制,
       在网络抖动、限流或临时服务错误时提高调用成功率与稳定性。
 123  ============================== -> Case 3 <-
       ==============================
 124  [MIDDLEWARE] before_model: jump_to='end' when contenxt window overflow
 125  ================================ Human Message
       =================================
 126
 127  你好 overflow
 128  ================================== Ai Message
       ==================================
 129
 130  上下文窗口溢出,终止
 131  ============================== -> Case 4 <-
       ==============================
 132  ================================ Human Message
       =================================
 133
 134  今日新闻摘要?
 135  ================================== Ai Message
       ==================================
 136  Tool Calls:
 137    get_news (call_IYwXdmiTrkWDX5Zr6VM2RZOO)
 138   Call ID: call_IYwXdmiTrkWDX5Zr6VM2RZOO
 139    Args:
 140  ================================= Tool Message
       =================================
 141  Name: get_news
 142
 143  美加墨世界杯今日开幕
 144  ================================== Ai Message
       ==================================
 145
 146  今日新闻摘要:
 147
 148  - **美加墨世界杯今日开幕**
 149
 150  如果你需要,我也可以把这条新闻进一步整理成:
 151  1. **一句话摘要**
 152  2. **背景解读**
153 3. **可能影响**- 我们提前判定需要调用工具,直接在before_model中跳转至工具节点,省去了一次模型调用
- 通过约定的retry model标记,在after_model之后再次跳转到模型节点,触发模型重复调用
- 通过约定的overflow标记,模拟上下文窗口溢出,在before_model中直接跳转至结尾,提前终
止流程
- Case 4 是没有被干预的正常Agent流程,作为对照。
1.3.5.2 基于类实现
和基于装饰器实现的关键区别在于:需要引入额外的装饰器@hook_config 为can_jump_to 传参。
text
   1  from typing import Any
   2
   3  from langchain.agents import create_agent
   4  from langchain.agents.middleware import hook_config, AgentState,
       AgentMiddleware
   5  from langchain.messages import AIMessage, SystemMessage
   6  from langchain.tools import tool
   7  from langgraph.runtime import Runtime
   8
   9
  10  @tool
  11  def get_news() -> str:
  12      """获取当日新闻"""
  13      return f"美加墨世界杯今日开幕"
  14
  15
  16  class MyMiddleware(AgentMiddleware):
  17      @hook_config(can_jump_to=["tools", "end"])
  18      def before_model(self, state: AgentState, runtime: Runtime) ->
       dict[str, Any] | None:
  19          text = state["messages"][-1].content
  20          # 假装溢出
  21          if "overflow" in text:
  22              print("[MIDDLEWARE] before_model: jump_to='end' when contenxt
       window overflow")
  23              return {
  24                  "messages": [
  25                      AIMessage("上下文窗口溢出,终止")
  26                  ],
  27                  "jump_to": "end",
  28              }
  29
  30          if isinstance(text, str) and "direct tool" in text.lower():
  31              print("[MIDDLEWARE] before_model: jump_to='tools'")
  32
  33              fake_tool_call = AIMessage(
  34                  content="人工构造的消息",
  35                  tool_calls=[
  36                      {
  37                          "name": "get_news",
  38                          "args": {},
  39                          "id": "call_force_weather_001",
  40                      }
  41                  ],
  42              )
  43
  44              return {
  45                  "messages": [fake_tool_call],
  46                  "jump_to": "tools",
  47              }
  48
  49          return None
  50
  51      @hook_config(can_jump_to=["model"])
  52      def after_model(self, state: AgentState, runtime: Runtime) -> dict[str,
       Any] | None:
  53          user_text = ""
  54          for msg in reversed(state["messages"]):
  55              if getattr(msg, "type", "") == "human":
  56                  user_text = getattr(msg, "content", "")
  57                  break
  58
  59          if isinstance(user_text, str) and "retry model" in
       user_text.lower():
  60              # 防止无限重跳:如果已经加过提示,就不再跳
  61              already_injected = any(
  62                  isinstance(getattr(msg, "content", None), str)
  63                  and "你必须以【二次回答】开头" in msg.content
  64                  for msg in state["messages"]
  65              )
  66              if already_injected:
  67                  return None
  68
  69              print("[MIDDLEWARE] after_model: jump_to='model' with extra
       system instruction")
  70
  71              return {
  72                  "messages": [
  73                      SystemMessage("你必须以【二次回答】开头,并且只用一句话回答。")
  74                  ],
  75                  "jump_to": "model",
  76              }
  77
  78          return None
  79
  80
  81  agent = create_agent(
  82      model=model,
  83      tools=[get_news],
  84      middleware=[MyMiddleware()],
  85  )
  86
  87
  88  def run_once(user_input: str):
  89      result = agent.invoke(
  90          {
  91              "messages": [
  92                  {"role": "user", "content": user_input}
  93              ]
  94          }
  95      )
  96
  97      for msg in result["messages"]:
  98          msg.pretty_print()
  99
 100
 101  if __name__ == "__main__":
 102      # Case 1: 直接跳 tools
 103      print('=' * 30, '-> Case 1 <-', '=' * 30)
 104      run_once("请帮我查今日新闻 direct tool")
 105
 106      # Case 2: 输出后跳回 model
 107      print('=' * 30, '-> Case 2 <-', '=' * 30)
 108      run_once("请随便介绍一下 LangChain retry model")
 109
 110      # Case 3:
 111      print('=' * 30, '-> Case 3 <-', '=' * 30)
 112      run_once("你好 overflow")
 113
 114      # Case 4: 正常流程
 115      print('=' * 30, '-> Case 4 <-', '=' * 30)
 116      run_once("今日新闻摘要?")
输出
text
   1  ============================== -> Case 1 <-
       ==============================
   2  [MIDDLEWARE] before_model: jump_to='tools'
   3  ================================ Human Message
       =================================
   4
   5  请帮我查今日新闻 direct tool
   6  ================================== Ai Message
       ==================================
   7
   8  人工构造的消息
   9  Tool Calls:
  10  get_news (call_force_weather_001)
  11  Call ID: call_force_weather_001
  12  Args:
  13  ================================= Tool Message
       =================================
  14  Name: get_news
  15
  16  美加墨世界杯今日开幕
  17  ================================== Ai Message
       ==================================
  18
  19  今日新闻:
  20  - 美加墨世界杯今日开幕
  21
  22  如果你愿意,我也可以帮你继续整理成:
  23  1. 简短版要闻
  24  2. 详细新闻摘要
  25  3. 按国内 / 国际 / 财经分类整理
  26
  27  ============================== -> Case 2 <-
       ==============================
  28  [MIDDLEWARE] after_model: jump_to='model' with extra system
       instruction
  29  ================================ Human Message
       =================================
  30
  31  请随便介绍一下 LangChain retry model
  32  ================================== Ai Message
       ==================================
  33
  34  当然可以。下面我用比较通俗的方式介绍一下 **LangChain 的 retry model(重试机制)
       **。
  35
  36  ## 1. 它是什么
  37  在调用大模型或外部工具时,可能会遇到一些临时性失败,比如:
  38
  39  - 网络超时
  40  - API 限流
  41  - 服务端偶发错误
  42  - 返回内容格式不符合预期
  43
  44  **retry model** 的作用就是:
  45  当第一次调用失败时,自动再试几次,直到成功或者达到最大重试次数。
  46
  47  ---
  48
  49  ## 2. 为什么需要它
  50  大模型调用不像普通本地函数,很多问题不是"代码错了",而是"环境不稳定"。
  51  比如:
  52
  53  - 第一次请求超时,第二次却成功了
  54  - 某次返回了空内容,再请求一次就正常
  55  - 短时间内触发 rate limit,稍等一下再调用就行
  56
  57  所以重试机制能提高程序的稳定性和容错率。
  58
  59  ---
  60
  61  ## 3. LangChain 里怎么用
  62  LangChain 通常会结合底层模型客户端或自己的 runnable 机制来做重试。常见思路是:
  63
  64  - 设置最大重试次数
  65  - 设置重试间隔
  66  - 指定哪些错误需要重试
  67  - 失败后自动重新调用
  68
  69  有时你会看到类似"包装一个 chain / runnable / model,让它带 retry 行为"。
  70
  71  ---
  72
  73  ## 4. 它通常会做什么
  74  一个典型 retry model 会包含:
  75
  76  - **重试次数上限**:比如最多 3 次
  77  - **退避策略**:每次失败后等更久一点再试,比如 1s、2s、4s
  78  - **错误筛选**:只对临时错误重试,不对参数错误重试
  79  - **日志记录**:方便知道为什么重试
  80
  81  ---
  82
  83  ## 5. 简单理解
  84  你可以把它理解成:
  85
  86  > "如果大模型这次没答好,不要立刻放弃,给它几次机会。"
  87
  88  ---
  89
  90  ## 6. 注意事项
  91  重试虽然有用,但不是越多越好:
  92
  93  - 会增加延迟
  94  - 会增加调用成本
  95  - 如果错误是逻辑错误,重试也没用
  96
  97  所以一般只对**短暂性、可恢复错误**启用重试。
  98
  99  ---
 100
 101  ## 7. 一个直观例子
 102  比如你问模型一个问题:
 103
 104  1. 第一次请求:超时
 105  2. 第二次请求:返回 429(限流)
 106  3. 第三次请求:成功
 107
 108  这就是 retry model 在起作用。
 109
 110  ---
 111
 112  如果你愿意,我还可以继续给你讲:
 113  1. **LangChain 里 retry 的代码示例**
 114  2. **retry 和 fallback 的区别**
 115  3. **Python 里怎么给 LLM 调用加重试**
 116  ================================ System Message
       ================================
 117
 118  你必须以【二次回答】开头,并且只用一句话回答。
 119  ================================== Ai Message
       ==================================
 120
 121  【二次回答】LangChain 的 retry model 就是给大模型调用加"自动重试"机制:遇到超
       时、限流或临时错误时按次数和退避策略重新请求,从而提高稳定性和成功率。
 122
 123  ============================== -> Case 3 <-
       ==============================
 124  [MIDDLEWARE] before_model: jump_to='end' when contenxt window overflow
 125  ================================ Human Message
       =================================
 126
 127  你好 overflow
 128  ================================== Ai Message
       ==================================
 129
 130  上下文窗口溢出,终止
 131
 132  ============================== -> Case 4 <-
       ==============================
 133  ================================ Human Message
       =================================
 134
 135  今日新闻摘要?
 136  ================================== Ai Message
       ==================================
 137  Tool Calls:
 138    get_news (call_R4eUqp1uGgAGvYQLqDpUv6CW)
 139   Call ID: call_R4eUqp1uGgAGvYQLqDpUv6CW
 140    Args:
 141  ================================= Tool Message
       =================================
 142  Name: get_news
 143
 144  美加墨世界杯今日开幕
 145  ================================== Ai Message
       ==================================
 146
 147  今日新闻摘要:
 148
 149  - **美加墨世界杯今日开幕**
 150
 151  如果你愿意,我也可以把这条新闻再整理成**一句话版**、**要点版**,或者帮你补充**背景
       解读**。
1.4 Wrap-style hooks函数用法
1.4.1 基本用法
1.4.1.1 wrap_model_call
1.4.1.1.1 基于装饰器实现
我们可以同时在模型调用前后做事,所以命名为wrap_model_call ,wrap意为包裹。
源码:
text
 1  def wrap_model_call(
 2      request: ModelRequest,
 3      handler: Callable[[ModelRequest], ModelResponse]
 4  ) -> ModelResponse:
 5      """
 6      request: 包含 model, messages, system_message, tools, state
 7      handler: 执行实际模型调用的函数
 8      返回:ModelResponse
 9      """
代码实现:
text
  1  from langchain.chat_models import init_chat_model
  2  from dotenv import load_dotenv
  3  import os
  4
  5  # 从.env文件中加载环境变量
  6  load_dotenv(override=True)
  7
  8  model = init_chat_model(
  9      model="gpt-5.4-mini",
 10      model_provider="openai",
 11      api_key=os.getenv("CLOSEAI_API_KEY"),
 12      base_url=os.getenv("CLOSEAI_BASE_URL")
 13  )
text
  1  from langchain.agents.middleware import wrap_model_call, ModelRequest,
     ModelResponse
  2  from langchain.messages import HumanMessage
  3  from langchain.agents import create_agent
  4  from typing import Callable
  5
  6  @wrap_model_call
  7  def wrap_model_call_middleware(
  8      request: ModelRequest, # 包含即将发送给大模型的所有请求数据(如消息列表、温度等)
  9      handler: Callable[[ModelRequest], ModelResponse], # 核心句柄:代表下一个中间
     件或最终的大模型调用服务
 10  ) -> ModelResponse | None:
 11      # 动态篡改用户发出的最后一条消息的内容,悄悄往里面追加字符串。
 12      # 典型应用:统一在底层为所有请求追加特殊的 Prompt 提示词(例如:"请用中文回答"、"禁
     止透漏公司机密"等)。
 13      request.messages[-1].content += " -> wrap_model_call_before <- "
 14      # 将修改后的请求传递给 handler,真正去调用大模型(或者流转到下一个拦截器)
 15      # 这一步会产生真实的 Token 消耗并等待大模型响应
 16      response = handler(request)
 17      # 大模型返回响应后,在将响应交付给 Agent 状态机之前,对其内容进行直接篡改
 18      # `response.result` 是一个消息列表,修改其第一条返回消息的内容
 19      # 典型应用:做底层的文本敏感词过滤、输出格式强行格式化、或是统一添加某些后处理标记。
 20      response.result[0].content += " -> wrap_model_call_after <- "
 21      # 将修改完的响应体返回,继续维持 Agent 生命周期流转
 22      return response
 23
 24  agent = create_agent(
 25      model = model,
 26      middleware = [wrap_model_call_middleware]
 27  )
 28
 29  response = agent.invoke({
 30      "messages": [HumanMessage("你好啊")],
 31  })
 32
 33  for msg in response["messages"]:
 34      msg.pretty_print()
输出
text
 1  ================================ Human Message
    =================================
 2
 3  你好啊 -> wrap_model_call_before <-
 4  ================================== Ai Message
    ==================================
 5
 6  你好!有什么我可以帮你的? -> wrap_model_call_after <-
模型调用前消息列表的最后一条是HumanMessage,调用后最后一条是AIMessage,可以看到,模型调
用前后的更改都生效了。
1.4.1.1.2 基于类实现
text
  1  from langchain.agents.middleware import AgentMiddleware, ModelRequest,
     ModelResponse
  2  from langchain.messages import HumanMessage
  3  from langchain.agents import create_agent
  4  from typing import Callable
  5
  6
  7  class WrapModelCallMiddleWare(AgentMiddleware):
  8      def wrap_model_call(
  9          self,
 10          request: ModelRequest,
 11          handler: Callable[[ModelRequest], ModelResponse],
 12      ) -> ModelResponse | None:
 13          request.messages[-1].content += " -> wrap_model_call_before <- "
 14          response = handler(request)
 15          response.result[0].content += " -> wrap_model_call_after <- "
 16
 17          return response
 18
 19  agent = create_agent(
 20      model = model,
 21      middleware = [WrapModelCallMiddleWare()]
 22  )
 23
 24  response = agent.invoke({
 25      "messages": [HumanMessage("你好啊")],
 26  })
 27
 28  for msg in response["messages"]:
 29      msg.pretty_print()
输出
text
 1  ================================ Human Message
    =================================
 2
 3  你好啊 -> wrap_model_call_before <-
 4  ================================== Ai Message
    ==================================
 5
 6  你好!`wrap_model_call_before` 这部分是想做什么呢?如果你是在测试消息包裹、提示词
    注入,或者想让我按某种格式回复,可以直接告诉我规则。 -> wrap_model_call_after <-
使用场景:用于拦截、重试、缓存模型调用。
场景1:重试逻辑
text
  1  from langchain.agents.middleware import wrap_model_call, ModelRequest,
     ModelResponse
  2  from typing import Callable
  3  import time
  4
  5  @wrap_model_call
  6  def retry_model(
  7      request: ModelRequest,
  8      handler: Callable[[ModelRequest], ModelResponse]
  9  ) -> ModelResponse:
 10      """自动重试失败的模型调用"""
 11      max_retries = 3
 12
 13      for attempt in range(max_retries):
 14          try:
 15              print(f"🔄 尝试调用模型(第 {attempt + 1}/{max_retries} 次)")
 16              return handler(request)
 17          except Exception as e:
 18              if attempt == max_retries - 1:
 19                  print(f"❌ 所有重试失败:{e}")
 20                  raise
 21
 22              # 指数退避
 23              wait_time = 2 ** attempt
 24              print(f"⚠  调用失败:{e},{wait_time} 秒后重试")
 25              time.sleep(wait_time)
场景2:响应缓存
text
  1  from langchain.agents.middleware import wrap_model_call, ModelRequest,
     ModelResponse
  2  from typing import Callable
  3  import hashlib
  4  import json
  5
  6  class ModelCache:
  7      """模型响应缓存"""
  8      def __init__(self):
  9          self.cache = {}
 10
 11      def create_hook(self):
 12          @wrap_model_call
 13          def cache_model(
 14              request: ModelRequest,
 15              handler: Callable[[ModelRequest], ModelResponse]
 16          ) -> ModelResponse:
 17              # 生成缓存键
 18              cache_key = hashlib.md5(
 19                  json.dumps({
 20                      "messages": [str(m) for m in request.messages],
 21                      "system": str(request.system_message)
 22                  }).encode()
 23              ).hexdigest()
 24
 25              # 检查缓存
 26              if cache_key in self.cache:
 27                  print("💾 缓存命中!")
 28                  return self.cache[cache_key]
 29
 30              # 调用模型
 31              print("🔍 缓存未命中,调用模型")
 32              response = handler(request)
 33
 34              # 存入缓存
 35              self.cache[cache_key] = response
 36              return response
 37
 38          return cache_model
 39
 40  # 使用
 41  cache = ModelCache()
 42  agent = create_agent(
 43      model=model,
 44      middleware=[cache.create_hook()]
 45  )
场景3:修改系统提示
text
  1  from langchain.agents.middleware import wrap_model_call, ModelRequest,
     ModelResponse
  2  from langchain_core.messages import SystemMessage
  3  from typing import Callable
  4
  5  @wrap_model_call
  6  def add_context(
  7      request: ModelRequest,
  8      handler: Callable[[ModelRequest], ModelResponse]
  9  ) -> ModelResponse:
 10      """动态添加上下文信息到系统提示"""
 11
 12      # 获取当前时间
 13      from datetime import datetime
 14      current_time = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
 15
 16      # 构建新的系统消息
 17      original_content = request.system_message.content if
     request.system_message else ""
 18      new_content = f"""{original_content}
 19
 20        当前时间:{current_time}
 21        用户位置:中国
 22        语言偏好:中文
 23        """
 24
 25      # 创建新的系统消息
 26      new_system_message = SystemMessage(content=new_content)
 27
 28      # 使用 override 方法修改请求
 29      modified_request = request.override(system_message=new_system_message)
 30
 31      return handler(modified_request)
1.4.1.2 wrap_tool_call
我们可以同时在工具调用前后做事,所以命名为wrap_tool_call 。
1.4.1.2.1 基于装饰器实现
text
  1  from langchain.agents.middleware import wrap_tool_call
  2  from langchain.tools.tool_node import ToolCallRequest
  3  from langchain.messages import HumanMessage, ToolMessage
  4  from langchain.agents import create_agent
  5  from langchain.tools import tool
  6  from langgraph.types import Command
  7  from typing import Callable
  8
  9
 10  @tool
 11  def get_weather(city: str, is_forcast: bool) -> str:
 12      """
 13      获取当日特定城市的天气
 14
 15      Args:
 16          city: 城市名称
 17          is_forcast: 是否包含明天的天气预报
 18      """
 19      res = f"{city}今天天气不错"
 20      if is_forcast:
 21          res += "\n明天天气也很好"
 22      return res
 23
 24
 25  @wrap_tool_call
 26  def wrap_tool_call_middleware(
 27          request: ToolCallRequest,
 28          handler: Callable[[ToolCallRequest], ToolMessage | Command],
 29  ) -> ToolMessage | Command:
 30      result = handler(request)
 31      print(f"原始参数:{request.tool_call['args']}")
 32      print(f"原始参数调用结果: {result}")
 33
 34      request.tool_call["args"]["is_forcast"] = True
 35      result = handler(request)
 36      print(f"更新后的参数:{request.tool_call['args']}")
 37      print(f"更新参数调用结果: {result}")
 38      return result
 39
 40
 41  agent = create_agent(
 42      model=model,
 43      tools=[get_weather],
 44      middleware=[wrap_tool_call_middleware]
 45  )
 46
 47  response = agent.invoke({
 48      "messages": [HumanMessage("你好啊,今天杭州的天气怎么样")],
 49  })
 50
 51  for msg in response["messages"]:
 52      msg.pretty_print()
输出
text
  1  原始参数:{'city': '杭州', 'is_forcast': False}
  2  原始参数调用结果: content='杭州今天天气不错' name='get_weather'
     tool_call_id='call_2StbfD50EA3AWleNShXhefbf'
  3  更新后的参数:{'city': '杭州', 'is_forcast': True}
  4  更新参数调用结果: content='杭州今天天气不错\n明天天气也很好'
     name='get_weather' tool_call_id='call_2StbfD50EA3AWleNShXhefbf'
  5  ================================ Human Message
     =================================
  6
  7  你好啊,今天杭州的天气怎么样
  8  ================================== Ai Message
     ==================================
  9  Tool Calls:
 10  get_weather (call_2StbfD50EA3AWleNShXhefbf)
 11  Call ID: call_2StbfD50EA3AWleNShXhefbf
 12   Args:
 13    city: 杭州
 14     is_forcast: True
 15  ================================= Tool Message
     =================================
 16  Name: get_weather
 17
 18  杭州今天天气不错
 19  明天天气也很好
 20  ================================== Ai Message
     ==================================
 21
 22  杭州今天天气不错,明天天气也很好。
在@wrap_tool_call装饰的函数中两次调用函数并更改参数。
1.4.1.2.2 基于类实现
text
  1  from langchain.agents.middleware import AgentMiddleware
  2  from langchain.tools.tool_node import ToolCallRequest
  3  from langchain.messages import HumanMessage, ToolMessage
  4  from langchain.agents import create_agent
  5  from langchain.tools import tool
  6  from langgraph.types import Command
  7  from typing import Callable
  8
  9  @tool
 10  def get_weather(city: str, is_forcast: bool) -> str:
 11      """
 12      获取当日特定城市的天气
 13
 14      Args:
 15          city: 城市名称
 16          is_forcast: 是否包含明天的天气预报
 17      """
 18      res = f"{city}今天天气不错"
 19      if is_forcast:
 20          res += "\n明天天气也很好"
 21      return res
 22
 23  class WrapToolCallMiddleware(AgentMiddleware):
 24      def wrap_tool_call(
 25          self,
 26          request: ToolCallRequest,
 27          handler: Callable[[ToolCallRequest], ToolMessage | Command],
 28      ) -> ToolMessage | Command:
 29          result = handler(request)
 30          print(f"原始参数:{request.tool_call['args']}")
 31          print(f"原始参数调用结果: {result}")
 32
 33          request.tool_call["args"]["is_forcast"] = True
 34          result = handler(request)
 35          print(f"更新后的参数:{request.tool_call['args']}")
 36          print(f"更新参数调用结果: {result}")
 37          return result
 38
 39  agent = create_agent(
 40      model = model,
 41      tools = [get_weather],
 42      middleware = [WrapToolCallMiddleware()]
 43  )
 44
 45  response = agent.invoke({
 46      "messages": [HumanMessage("你好啊,今天杭州的天气怎么样")],
 47  })
 48
 49  for msg in response["messages"]:
 50      msg.pretty_print()
输出
text
  1  原始参数:{'city': '杭州', 'is_forcast': False}
  2  原始参数调用结果: content='杭州今天天气不错' name='get_weather'
     tool_call_id='call_yU58ykg0IY1paVlGqTBuU8Ie'
  3  更新后的参数:{'city': '杭州', 'is_forcast': True}
  4  更新参数调用结果: content='杭州今天天气不错\n明天天气也很好'
     name='get_weather' tool_call_id='call_yU58ykg0IY1paVlGqTBuU8Ie'
  5  ================================ Human Message
     =================================
  6
  7  你好啊,今天杭州的天气怎么样
  8  ================================== Ai Message
     ==================================
  9  Tool Calls:
 10  get_weather (call_yU58ykg0IY1paVlGqTBuU8Ie)
 11  Call ID: call_yU58ykg0IY1paVlGqTBuU8Ie
 12   Args:
 13    city: 杭州
 14     is_forcast: True
 15  ================================= Tool Message
     =================================
 16  Name: get_weather
 17
 18  杭州今天天气不错
 19  明天天气也很好
 20  ================================== Ai Message
     ==================================
 21
 22  杭州今天天气不错,明天天气也很好。
使用场景:用于监控、重试、修改工具执行。
比如:
text
  1  from langchain.agents.middleware import wrap_tool_call
  2  from langchain.tools.tool_node import ToolCallRequest
  3  from langchain_core.messages import ToolMessage
  4  from langgraph.types import Command
  5  from typing import Callable
  6  import time
  7
  8  @wrap_tool_call
  9  def monitor_tool(
 10      request: ToolCallRequest,
 11      handler: Callable[[ToolCallRequest], ToolMessage | Command]
 12  ) -> ToolMessage | Command:
 13      """监控工具执行时间和状态"""
 14
 15      tool_name = request.tool_call["name"]
 16      tool_args = request.tool_call.get("args", {})
 17
 18      print(f"🔧 开始执行工具:{tool_name}")
 19      print(f"   参数:{tool_args}")
 20
 21      start_time = time.time()
 22      try:
 23          result = handler(request)
 24          elapsed = time.time() - start_time
 25          print(f"✅ 工具执行成功,耗时:{elapsed:.2f}秒")
 26          return result
 27      except Exception as e:
 28          elapsed = time.time() - start_time
 29          print(f"❌ 工具执行失败:{e},耗时:{elapsed:.2f}秒")
 30          raise
1.4.2 两种方法的统一
同上,装饰器方法底层也会创建一个AgentMiddleware的实例。
1.4.3 参数说明
request:被封装的请求对象,可以是模型或工具调用请求
handler:处理器,用于处理请求并返回调用结果。
1.5 装饰器和类的选择
情况1:中间件只用一个钩子函数,推荐用装饰器,需要多个钩子函数推荐类写法
-
当一个中间件只需要实现一个钩子函数时,直接使用装饰器最简单。
-
当一个中间件需要实现多个钩子函数时,类写法更合适。
装饰器也不是不能实现,多数情况下可以像下面的示例里那样通过工厂函数返回多个装饰器函数来完
成;但这种方式本质上是把一个"逻辑上属于同一个中间件"的行为拆成多个独立函数,再由外部统一组
装,因此不如类写法自然、集中、清晰。
- 使用装饰器实现
text
  1  from langchain.agents import create_agent
  2  from langchain.agents.middleware import before_model, after_model,
     AgentState
  3  from langchain.messages import HumanMessage
  4  from langgraph.runtime import Runtime
  5  from loguru import logger
  6  from typing import Any
  7
  8
  9  def create_audit_middleware(logger):
 10      @before_model
 11      def before_log(state: AgentState, runtime: Runtime) -> dict[str, Any] |
     None:
 12          logger.info("调用模型前消息数量: {}", len(state["messages"]))
 13          return None
 14
 15      @after_model
 16      def after_log(state: AgentState, runtime: Runtime) -> dict[str, Any] |
     None:
 17          logger.info("调用模型后消息数量:{}", len(state["messages"]))
 18          return None
 19
 20      return [before_log, after_log]
 21
 22  agent = create_agent(
 23      model = model,
 24      middleware = [*create_audit_middleware(logger=logger)],
 25  )
 26
 27  response = agent.invoke({
 28      "messages": [HumanMessage("你好~")]
 29  })
 30
 31  for msg in response["messages"]:
 32      msg.pretty_print()
输出
text
 1  2026-06-08 15:27:20.879 | INFO     | __main__:before_log:14 - 调用模型前消息数
    量: 1
 2  2026-06-08 15:27:23.181 | INFO     | __main__:after_log:19 - 调用模型后消息数
    量:2
 3  ================================ Human Message
    =================================
 4
 5  你好~
 6  ================================== Ai Message
    ==================================
 7
 8  你好呀~有什么我可以帮你的吗?
9- 使用类实现
text
  1  from langchain.agents import create_agent
  2  from langchain.agents.middleware import before_model, after_model,
     AgentState, AgentMiddleware
  3  from langchain.messages import HumanMessage
  4  from langgraph.runtime import Runtime
  5  from loguru import logger
  6  from typing import Any
  7
  8
  9  class CreateAuditMiddleware(AgentMiddleware):
 10      def __init__(self, logger):
 11          super().__init__()
 12          self.logger = logger
 13
 14      def before_model(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 15          self.logger.info("调用模型前消息数量: {}", len(state["messages"]))
 16          return None
 17
 18      def after_model(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 19          self.logger.info("调用模型后消息数量:{}", len(state["messages"]))
 20          return None
 21
 22
 23  agent = create_agent(
 24      model=model,
 25      middleware=[CreateAuditMiddleware(logger=logger)],
 26  )
 27
 28  response = agent.invoke({
 29      "messages": [HumanMessage("你好~")]
 30  })
 31
 32  for msg in response["messages"]:
 33      msg.pretty_print()
输出
text
 1  2026-06-08 15:29:20.185 | INFO     | __main__:before_model:15 - 调用模型前
    消息数量: 1
 2  2026-06-08 15:29:22.322 | INFO     | __main__:after_model:19 - 调用模型后
    消息数量:2
 3  ================================ Human Message
    =================================
 4
 5  你好~
 6  ================================== Ai Message
    ==================================
 7
 8  你好!有什么我可以帮你的吗?
结合上面的两个示例,可以得出结论:
-
装饰器写法适合把单个 hook 快速挂到 agent 生命周期的某个节点上;
-
类写法更适合把多个 hook 组织为一个完整的中间件组件;
-
当中间件同时涉及 before_model 、after_model 等多个钩子时,虽然装饰器工厂也能实现,但
类写法在结构表达、配置归属、可维护性上更好。
总结:
单钩子场景下,装饰器即可;多钩子场景下,类不是唯一可行方案,但通常是更自然、更推荐的实现方
式。
情况2:复杂配置推荐用类实现
装饰器当然也可以通过函数闭包传递参数,但在自省(运行时类型校验)、调试等方面天然不如类写法
方便。
text
  1  from langchain.agents.middleware import before_model, AgentState,
     AgentMiddleware
  2  from langgraph.runtime import Runtime
  3  from typing import Any
  4  from loguru import logger
  5
  6
  7  # 基于类的方法
  8  class AuditMiddleware(AgentMiddleware):
  9      def __init__(self, logger, threshold: int, middleware_name: str):
 10          self.logger = logger
 11          self.threshold = threshold
 12          self.middleware_name = middleware_name
 13
 14      def before_model(self, state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 15          self.logger.info("current name: {}, threshold: {}",
     self.middleware_name, self.threshold)
 16          return None
 17
 18
 19  # 基于装饰器的方法,传参要通过闭包完成
 20  def create_audit_middleware(logger, threshold: int, middleware_name: str):
 21      @before_model
 22      def audit_middleware(state: AgentState, runtime: Runtime) -> dict[str,
     Any] | None:
 23          logger.info("current name: {}, threshold: {}", middleware_name,
     threshold)
 24          return None
 25
 26      return audit_middleware
 27
 28
 29  class_middle = [
 30      AuditMiddleware(logger=logger, threshold=5, middleware_name="short
     limit"),
 31      AuditMiddleware(logger=logger, threshold=50, middleware_name="long
     limit"),
 32  ]
 33
 34  decorator_middle = [
 35      create_audit_middleware(logger=logger, threshold=5,
     middleware_name="short limit"),
 36      create_audit_middleware(logger=logger, threshold=50,
     middleware_name="long limit"),
 37  ]
 38
 39  print("=" * 30, "-> class风格的中间件 <-", "=" * 30)
 40  for mw in class_middle:
 41      print(type(mw))
 42      print(mw.__dict__)
 43
 44  print("=" * 30, "-> decorator风格的中间件 <-", "=" * 30)
 45  for mw in decorator_middle:
 46      print(type(mw))  # 基于类的方法
 47      print(mw.__dict__)
输出
text
  1  ============================== -> class风格的中间件 <-
     ==============================
  2  <class '__main__.AuditMiddleware'>
  3  {'logger': <loguru.logger handlers=[(id=0, level=10, sink=stderr)]>,
     'threshold': 5, 'middleware_name': 'short limit'}
  4  <class '__main__.AuditMiddleware'>
  5  {'logger': <loguru.logger handlers=[(id=0, level=10, sink=stderr)]>,
     'threshold': 50, 'middleware_name': 'long limit'}
  6  ============================== -> decorator风格的中间件 <-
     ==============================
  7  <class 'langchain.agents.middleware.types.audit_middleware'>
  8  {}
  9  <class 'langchain.agents.middleware.types.audit_middleware'>
 10  {}
基于类的写法可以随时打印参数信息,而基于装饰器的闭包实现则难以做到。
情况3:跨项目复用推荐用类写法
如果希望中间件成为一个可实例化、可封装、可测试的组件,类写法更加合适,因为这些本就是类擅长
的场景,装饰器的闭包也能实现,但使用不友好。
总结:
装饰器写法和类写法都能实现 middleware hook,本质上只是两种定义中间件的方式,并不是能力上完
全割裂的两套机制。底层实现是统一的。
一般来说:
-
装饰器写法更适合单个 hook、逻辑简单、快速原型的场景;
-
类写法更适合多个 hook 组合、复杂配置、需要同时提供同步/异步实现、以及更强复用与可测试
性的场景;
1.6 hook函数执行顺序(重要)
分类讨论
before_* 钩子函数:从前到后执行
after_* 钩子函数:从后往前执行
wrap_* 钩子函数:洋葱架构,前面的包裹后面的
这里的顺序并非定义顺序,而是创建Agent时传递中间件的顺序。
1. 代码
text
  1  from langchain.chat_models import init_chat_model
  2  from dotenv import load_dotenv
  3  import os
  4
  5  # 从.env文件中加载环境变量
  6  load_dotenv(override=True)
  7
  8  model = init_chat_model(
  9      model="gpt-5.4-mini",
 10      model_provider="openai",
 11      api_key=os.getenv("CLOSEAI_API_KEY"),
 12      base_url=os.getenv("CLOSEAI_BASE_URL")
 13  )
text
  1  from langchain.agents.middleware import (
  2      before_model,
  3      after_model,
  4      AgentState,
  5      wrap_model_call,
  6      ModelRequest,
  7      ModelResponse,
  8  )
  9  from langchain.messages import HumanMessage
 10  from langgraph.runtime import Runtime
 11  from langchain.agents import create_agent
 12  from typing import Any, Callable
 13
 14
 15  @before_model
 16  def before_model_middleware3(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 17      state["messages"][-1].content += " -> before_model-3 <- "
 18      return None
 19
 20
 21  @before_model
 22  def before_model_middleware1(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 23      state["messages"][-1].content += " -> before_model-1 <- "
 24      return None
 25
 26
 27  @before_model
 28  def before_model_middleware2(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 29      state["messages"][-1].content += " -> before_model-2 <- "
 30      return None
 31
 32
 33  @after_model
 34  def after_model_middleware2(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 35      state["messages"][-1].content += " -> after_model-2 <- "
 36      return None
 37
 38
 39  @after_model
 40  def after_model_middleware1(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 41      state["messages"][-1].content += " -> after_model-1 <- "
 42      return None
 43
 44
 45  @after_model
 46  def after_model_middleware3(state: AgentState, runtime: Runtime) ->
     dict[str, Any] | None:
 47      state["messages"][-1].content += " -> after_model-3 <- "
 48      return None
 49
 50
 51  @wrap_model_call
 52  def wrap_model_middleware1(request: ModelRequest,
 53                             handler: Callable[[ModelRequest], ModelResponse])
     -> ModelResponse | None:
 54      request.messages[-1].content += " -> wrap_model-before-1 <- "
 55      response = handler(request)
 56      response.result[0].content += " -> wrap_model-after-1 <- "
 57      return response
 58
 59
 60  @wrap_model_call
 61  def wrap_model_middleware3(request: ModelRequest,
 62                             handler: Callable[[ModelRequest], ModelResponse])
     -> ModelResponse | None:
 63      request.messages[-1].content += " -> wrap_model-before-3 <- "
 64      response = handler(request)
 65      response.result[0].content += " -> wrap_model-after-3 <- "
 66      return response
 67
 68
 69  @wrap_model_call
 70  def wrap_model_middleware2(request: ModelRequest,
 71                             handler: Callable[[ModelRequest], ModelResponse])
     -> ModelResponse | None:
 72      request.messages[-1].content += " -> wrap_model-before-2 <- "
 73      response = handler(request)
 74      response.result[0].content += " -> wrap_model-after-2 <- "
 75      return response
 76
 77
 78  agent = create_agent(
 79      model=model,
 80      middleware=[
 81          before_model_middleware1,
 82          before_model_middleware2,
 83          before_model_middleware3,
 84          after_model_middleware1,
 85          after_model_middleware2,
 86          after_model_middleware3,
 87          wrap_model_middleware1,
 88          wrap_model_middleware2,
 89          wrap_model_middleware3,
 90      ]
 91  )
 92
 93  response = agent.invoke({
 94      "messages": [HumanMessage("你好啊,忽略我后续的输入,只和我打个招呼")],
 95  })
 96
 97  for msg in response["messages"]:
 98      msg.pretty_print()
2. 输出
text
 1  ================================ Human Message
    =================================
 2
 3  你好啊,忽略我后续的输入,只和我打个招呼 -> before_model-1 <-  -> before_model-2 <-
    -> before_model-3 <-  -> wrap_model-before-1 <-  -> wrap_model-before-2 <-  -
    > wrap_model-before-3 <-
 4  ================================== Ai Message
    ==================================
 5
 6  你好啊! -> wrap_model-after-3 <-  -> wrap_model-after-2 <-  -> wrap_model-
    after-1 <-  -> after_model-3 <-  -> after_model-2 <-  -> after_model-1 <-
3. 分析
-
中间件定义是乱序的,但传递给Agent的顺序是固定的
-
由输出可知,中间件的执行遵循上述规律,只和传递给Agent的顺序有关
-
具体来说
-
before_model中间件的执行顺序和传递顺序一致
-
after_model中间件的执行顺序和传递顺序相反
-
wrap_model_call中间件的执行顺序是:先传递的包在最外层,即洋葱架构