🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:
在Linux系统编程中,线程 是理解并发编程绕不开的一部分.相比进程,线程拥有更轻量的执行模型,同一进程中的多个线程可以共享大部分系统资源,因此非常适合处理高并发、异步任务以及需要提升程序响应速度的场景.不过,线程并不只是"创建一个执行流"这么简单.在线程真正应用到项目之前,还需要弄清楚几个核心问题:线程到底是什么?线程和进程有什么区别?线程如何创建、退出、等待和分离?多个线程之间为什么会出现数据竞争?又该如何通过同步与互斥保证线程安全? 本文将围绕 Linux 系统下线程的概念与控制 展开,从线程的基本原理入手,逐步介绍线程创建、线程终止、线程等待、线程分离等常见控制方式,并进一步梳理多线程编程中的资源共享、同步与互斥等关键知识.学完本文后,你不仅能够理解 Linux 线程的基本运行机制,还能够建立起较完整的多线程编程知识框架,为后续学习互斥锁、条件变量、线程池以及高并发服务器开发打下基础.
目录
- 1.Linux线程概念
- 2.Linux进程和线程---哪些资源共享、哪些独占?
- 3.Linux线程控制
- 4.线程ID及进程地址空间布局
- 5.线程封装
- 6.附录---源码阅读以及相关拓展
- 6.3⻚表和⻚表项
1.Linux线程概念
1.1什么是线程?
在Linux中,线程(Thread)是CPU调度执行的基本单位 .可以把它理解为:一个进程内部的一条执行路径.
一个进程可以只有一个线程,也可以同时拥有多个线程.多个线程通常会共享进程的大部分资源,但每个线程又有自己独立的执行状态.
举个例子
假设你运行一个浏览器程序:
text
浏览器进程
│
├── 线程1:处理用户界面
├── 线程2:加载网页
├── 线程3:播放视频
└── 线程4:处理网络请求
这些线程属于同一个进程,可以并发执行不同任务.
线程之间共享什么?
同一进程中的线程通常共享:
- 代码段
- 全局变量
- 堆内存 Heap
- 打开的文件
- 文件描述符
- 进程地址空间
但每个线程都有自己独立的:
- 栈 Stack
- CPU 寄存器
- 程序计数器 PC
- 线程 ID
- 调度状态
可以简单画成:
text
进程地址空间
┌─────────────────────┐
│        代码          │ ← 共享
├─────────────────────┤
│      全局变量        │ ← 共享
├─────────────────────┤
│        堆 Heap       │ ← 共享
├─────────────────────┤
│  Thread 1 Stack     │ ← 独立
├─────────────────────┤
│  Thread 2 Stack     │ ← 独立
├─────────────────────┤
│  Thread 3 Stack     │ ← 独立
└─────────────────────┘
线程和进程最大的区别
| 对比 | 进程 Process | 线程 Thread |
|---|---|---|
| 地址空间 | 通常独立 | 同进程线程共享 |
| 创建开销 | 较大 | 较小 |
| 上下文切换 | 相对较重 | 相对较轻 |
| 数据通信 | IPC 等方式 | 可以直接访问共享内存 |
| 相互影响 | 隔离性较强 | 一个线程出错可能影响整个进程 |
例如:
text
进程A                进程B
┌─────────┐         ┌─────────┐
│线程1     │         │线程1     │
│线程2     │         │线程2     │
│共享内存  │         │共享内存  │
└─────────┘         └─────────┘
   ↑                    ↑
地址空间不同          地址空间不同
Linux 内核对"线程"的实现比较特别:
Linux 内核本质上把线程看作一种共享资源的进程。
Linux 内核中通常使用 task_struct 描述一个可调度任务,不管它是我们平时说的"进程"还是"线程".
创建普通进程时,可以使用:
c
fork()创建线程底层则可以通过:
c
clone()例如让两个任务共享虚拟地址空间:
c
clone(..., CLONE_VM | CLONE_FILES | CLONE_SIGHAND | ...)用户程序里一般不会直接使用 clone(),而是使用 POSIX 线程库:
c
pthread_create()例如:
c
#include <pthread.h>

void *worker(void *arg)
{
    printf("hello thread\n");
    return NULL;
}

int main()
{
    pthread_t tid;

    pthread_create(&tid, NULL, worker, NULL);

    pthread_join(tid, NULL);

    return 0;
}
编译:
bash
gcc test.c -pthread记住的一句话
进程是资源分配和隔离的基本单位,线程是 CPU 调度和执行的基本单位。
而在 Linux 内核实现层面,进程和线程并没有一道绝对的分界线,本质上都是 task,只是共享资源的程度不同。
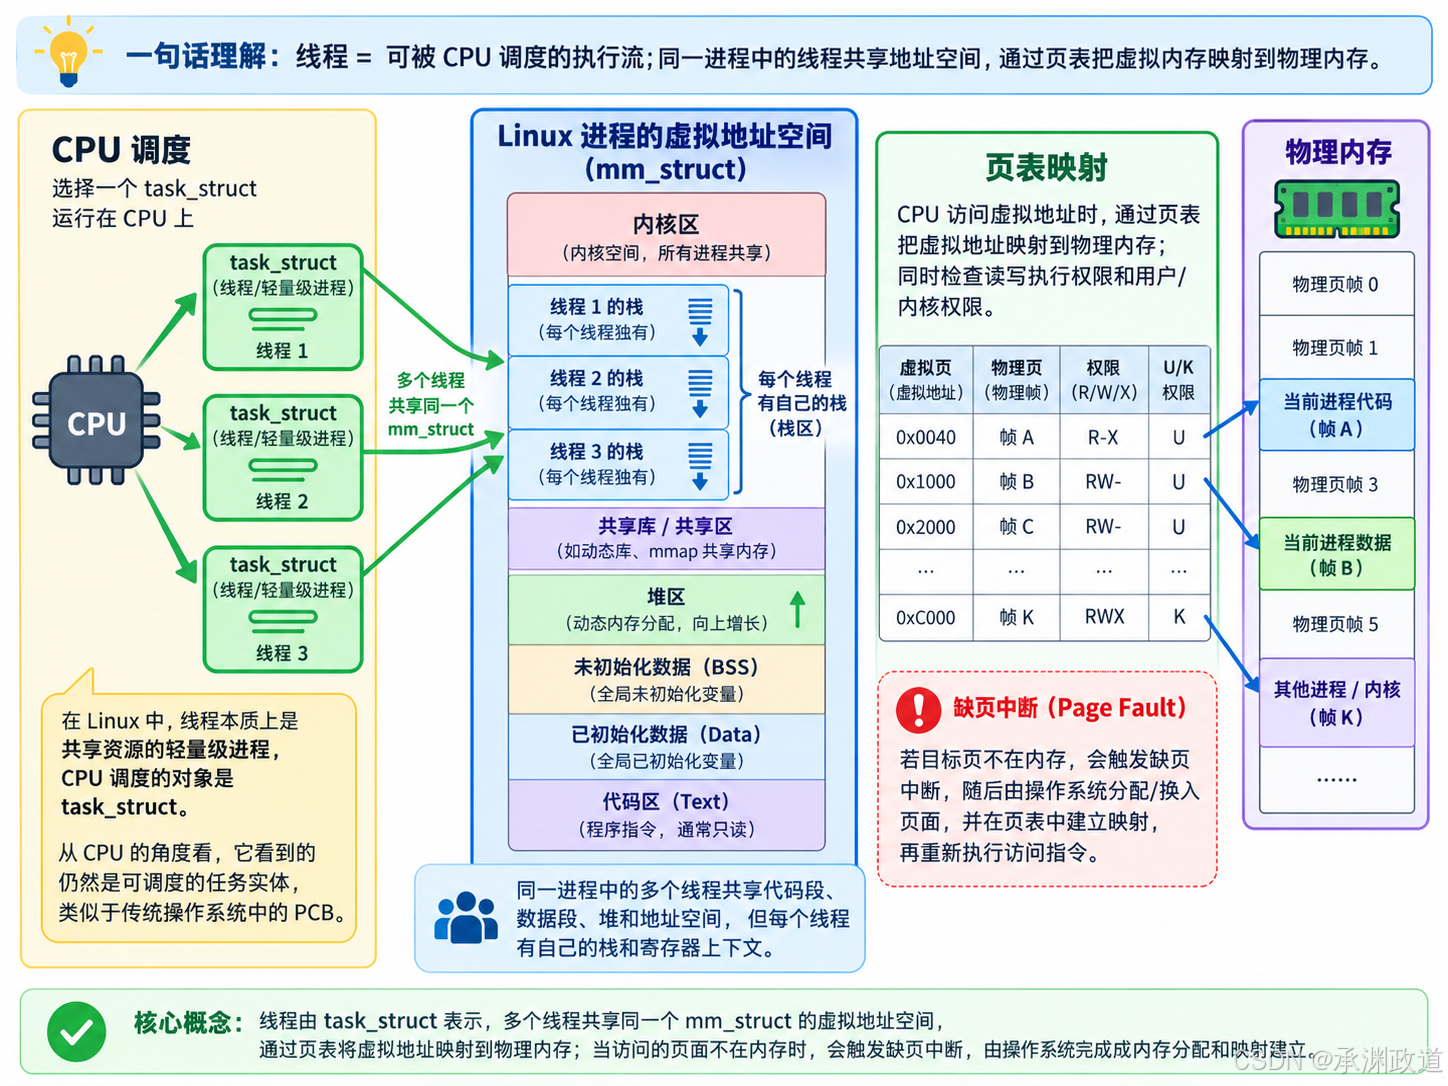
在⼀个程序⾥的⼀个执⾏路线就叫做线程(thread).更准确的定义是:线程是"⼀个进程内部
的控制序列";⼀切进程⾄少都有⼀个执⾏线程;线程在进程内部运⾏,本质是在进程地址空间内运⾏;在Linux系统中,在CPU眼中,看到的PCB都要⽐传统的进程更加轻量化;透过进程虚拟地址空间,可以看到进程的⼤部分资源,将进程资源合理分配给每个执⾏流,就形成了线程执⾏流.
1.2分⻚式存储管理
(1)虚拟地址和⻚表的由来
思考⼀下,如果在没有虚拟内存和分⻚机制的情况下,每⼀个⽤⼾程序在物理内存上所对应的空间必须是连续的,如下图:
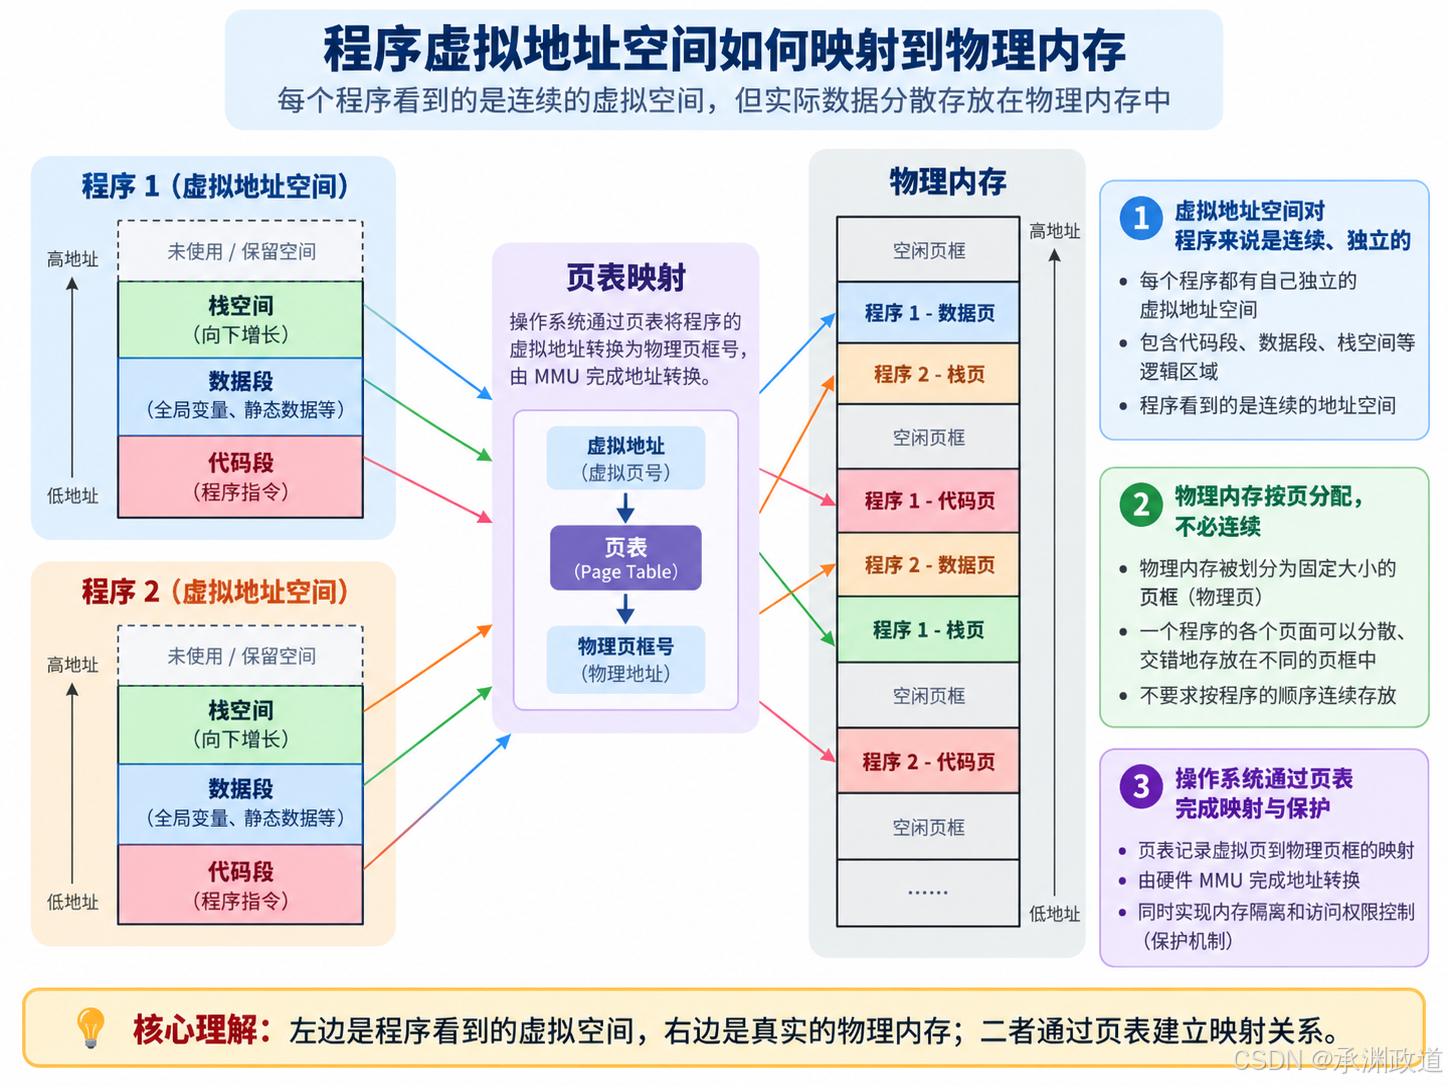
因为每⼀个程序的代码、数据⻓度都是不⼀样的,按照这样的映射⽅式,物理内存将会被分割成各种离散的、⼤⼩不同的块.经过⼀段运⾏时间之后,有些程序会退出,那么它们占据的物理内存空间可以被回收,导致这些物理内存都是以很多碎⽚的形式存在.
怎么办呢?我们希望操作系统提供给⽤户的空间必须是连续的,但是物理内存最好不要连续.此时虚拟内存和分⻚便出现了,如下图所示:
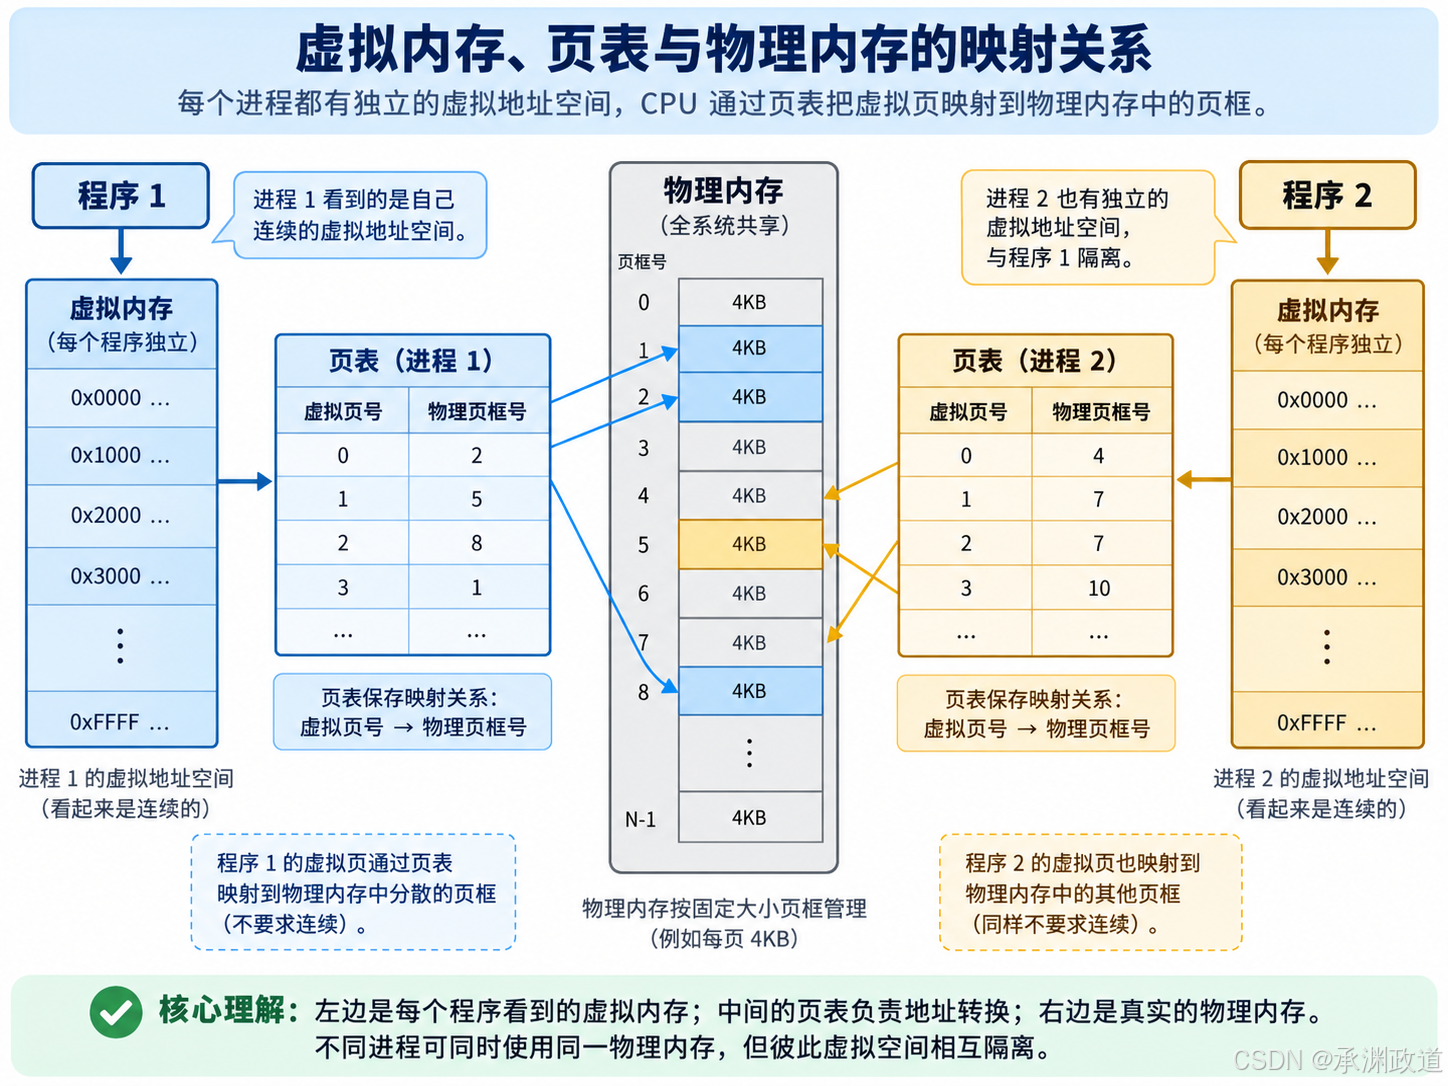
把物理内存按照⼀个固定的⻓度的⻚框进⾏分割,有时叫做物理⻚.每个⻚框包含⼀个物理⻚
(page).⼀个⻚的⼤⼩等于⻚框的⼤⼩.⼤多数32位体系结构⽀持4KB的⻚,⽽64位体系结构⼀般会⽀持8KB的⻚.区分⼀⻚和⼀个⻚框是很重要的:
• ⻚框是⼀个存储区域;
• ⻚是⼀个数据块,可以存放在任何⻚框或磁盘中.
有了这种机制,CPU便并⾮是直接访问物理内存地址,⽽是通过虚拟地址空间来间接的访问物理内存地址.所谓的虚拟地址空间,是操作系统为每⼀个正在执⾏的进程分配的⼀个逻辑地址,在32位机上,其范围从0 ~ 4G-1.
操作系统通过将虚拟地址空间和物理内存地址之间建⽴映射关系,也就是⻚表,这张表上记录了每⼀对⻚和⻚框的映射关系,能让CPU间接的访问物理内存地址.
总结⼀下,其思想是将虚拟内存下的逻辑地址空间分为若⼲⻚,将物理内存空间分为若⼲⻚框,通过⻚表便能把连续的虚拟内存,映射到若⼲个不连续的物理内存⻚.这样就解决了使⽤连续的物理内存造成的碎⽚问题.
(2)物理内存管理
可以把Linux的物理内存管理理解成一句话:操作系统把真实 RAM 划分成很多固定大小的页框,然后负责分配、回收、复用这些页框.在常见x86/Linux系统里,基本页大小通常是4KB.
假设⼀个可⽤的物理内存有4GB的空间.按照⼀个⻚框的⼤⼩4KB进⾏划分,4GB的空间就是4GB/4KB = 1048576个⻚框.有这么多的物理⻚,操作系统肯定是要将其管理起来的,操作系统
需要知道哪些⻚正在被使⽤,哪些⻚空闲等等.内核⽤struct page结构表⽰系统中的每个物理⻚,出于节省内存的考虑,struct page中使⽤了⼤量的联合体union.
cpp
struct page {
/* 原⼦标志,有些情况下会异步更新 */
unsigned long flags;
union {
struct {
/* 换出⻚列表,例如由zone->lru_lock保护的active_list */
struct list_head lru;
/* 如果最低为为0,则指向inode
* address_space,或为NULL
* 如果⻚映射为匿名内存,最低为置位
* ⽽且该指针指向anon_vma对象
*/
struct address_space* mapping;
/* 在映射内的偏移量 */
pgoff_t index;
/*
* 由映射私有,不透明数据
* 如果设置了PagePrivate,通常⽤于buffer_heads
* 如果设置了PageSwapCache,则⽤于swp_entry_t
* 如果设置了PG_buddy,则⽤于表⽰伙伴系统中的阶
*/
unsigned long private;
};
struct { /* slab, slob and slub */
union {
struct list_head slab_list; /* uses lru */
struct { /* Partial pages */
struct page* next;
#ifdef CONFIG_64BIT
int pages; /* Nr of pages left */
int pobjects; /* Approximate count */
#else
short int pages;
short int pobjects;
#endif
};
};
struct kmem_cache* slab_cache; /* not slob */
/* Double-word boundary */
void* freelist; /* first free object */
union {
void* s_mem; /* slab: first object */
unsigned long counters; /* SLUB */
struct { /* SLUB */
unsigned inuse : 16; /* ⽤于SLUB分配器:对象的数⽬ */
unsigned objects : 15;
unsigned frozen : 1;
};
};
};
...
};
union {
/* 内存管理⼦系统中映射的⻚表项计数,⽤于表⽰⻚是否已经映射,还⽤于限制逆向映射
搜索*/
atomic_t _mapcount;
unsigned int page_type;
unsigned int active; /* SLAB */
int units; /* SLOB */
};
...
#if defined(WANT_PAGE_VIRTUAL)
/* 内核虚拟地址(如果没有映射则为NULL,即⾼端内存) */
void* virtual;
#endif /* WANT_PAGE_VIRTUAL */
...
}
其中⽐较重要的⼏个参数:
-
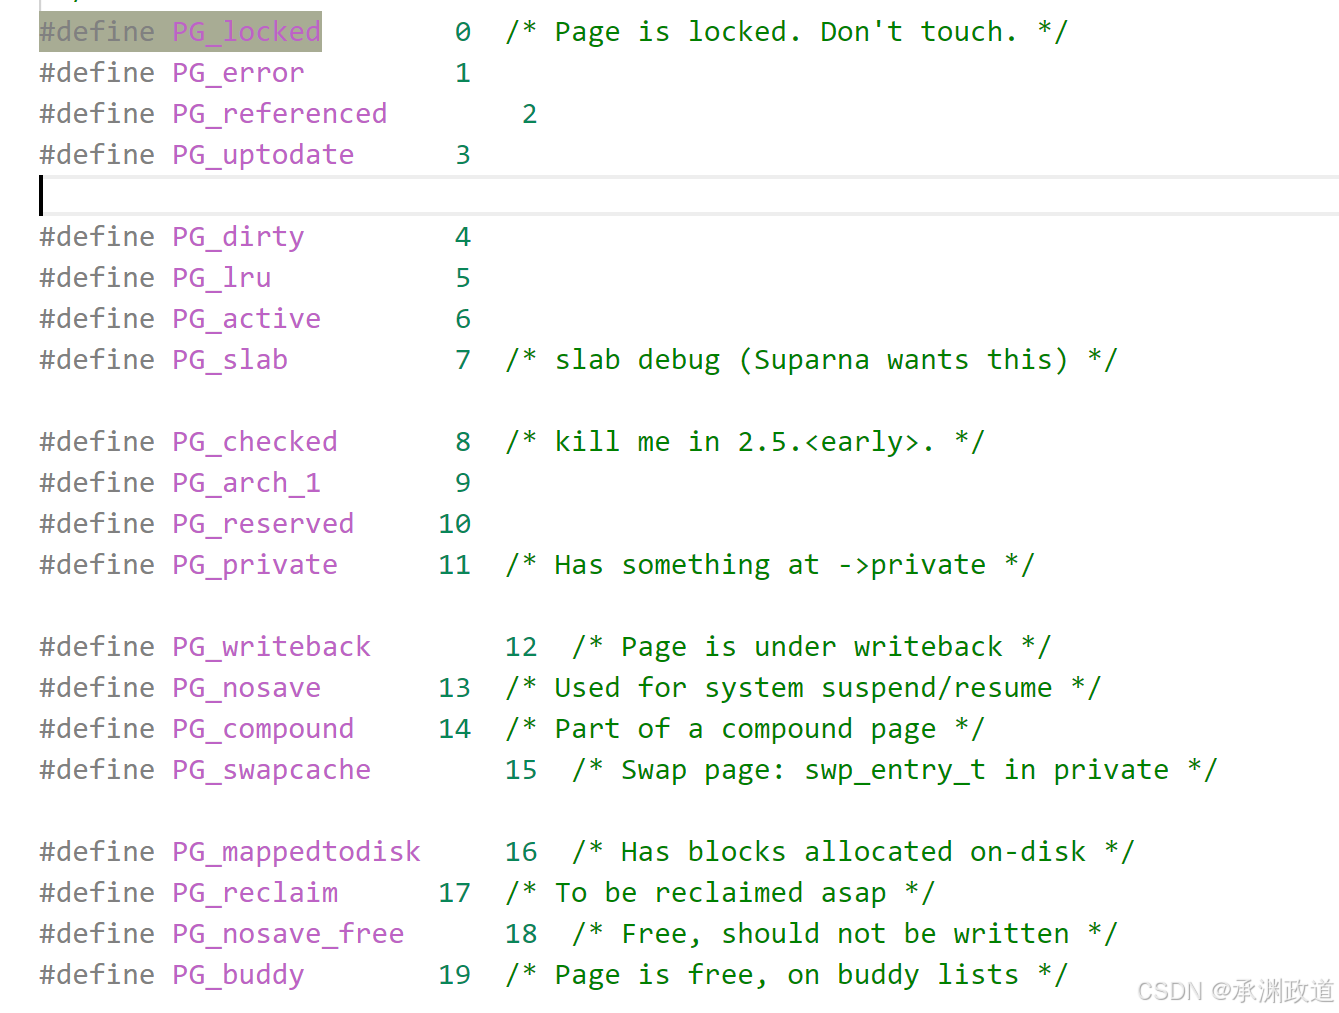
flags :⽤来存放⻚的状态.这些状态包括⻚是不是脏的,是不是被锁定在内存中等.flag的每⼀位单独表⽰⼀种状态,所以它⾄少可以同时表示出32种不同的状态.这些标志定义在<linux/page-flags.h>中.其中⼀些⽐特位⾮常重要,如PG_locked⽤于指定⻚是否锁定,PG_uptodate⽤于表示⻚的数据已经从块设备读取并且没有出现错误.
-
_mapcount :表示在⻚表中有多少项指向该⻚,也就是这⼀⻚被引⽤了多少次.当计数值变为-1时,就说明当前内核并没有引⽤这⼀⻚,于是在新的分配中就可以使⽤它.
-
virtual :是⻚的虚拟地址.通常情况下,它就是⻚在虚拟内存中的地址.有些内存(即所谓的⾼端内存)并不永久地映射到内核地址空间上.在这种情况下,这个域的值为NULL,需要的时候,必须动态地映射这些⻚.
要注意的是 struct page与物理⻚相关,⽽并⾮与虚拟⻚相关.⽽系统中的每个物理⻚都要分配⼀个这样的结构体,让我们来算算对所有这些⻚都这么做,到底要消耗掉多少内存.
算struct page占40个字节的内存吧,假定系统的物理⻚为4KB⼤⼩,系统有 4GB 物理内存.那么系统中共有⻚⾯1048576 个(1兆个),所以描述这么多⻚⾯的page结构体消耗的内存只不过40MB,相对系统4GB内存⽽⾔,仅是很⼩的⼀部分罢了.因此,要管理系统中这么多物理⻚⾯,这
个代价并不算太⼤.
要知道的是,⻚的⼤⼩对于内存利⽤和系统开销来说⾮常重要,⻚太⼤,⻚内必然会剩余较⼤不能利⽤的空间(⻚内碎⽚).⻚太⼩,虽然可以减⼩⻚内碎⽚的⼤⼩,但是⻚太多,会使得⻚表太⻓⽽占⽤内存,同时系统频繁地进⾏⻚转化,加重系统开销.因此,⻚的⼤⼩应该适中,通常为512B -
8KB ,windows/Linux系统的⻚框⼤⼩为4KB.
(3)页表
页表可以先记成一句话:页表就是"虚拟页号 → 物理页框号"的映射表.
程序访问的是虚拟地址,真正的数据在物理内存里.CPU/MMU需要通过页表,才能知道某个虚拟地址最终对应哪块物理内存.
⻚表中的每⼀个表项,指向⼀个物理⻚的开始地址.在32位系统中,虚拟内存的最⼤空间是4GB,这是每⼀个⽤户程序都拥有的虚拟内存空间.既然需要让4GB的虚拟内存全部可⽤,那么⻚表中就需要能够表示这所有的4GB空间,那么就⼀共需要4GB/4KB =1048576个表项.如下图所示:
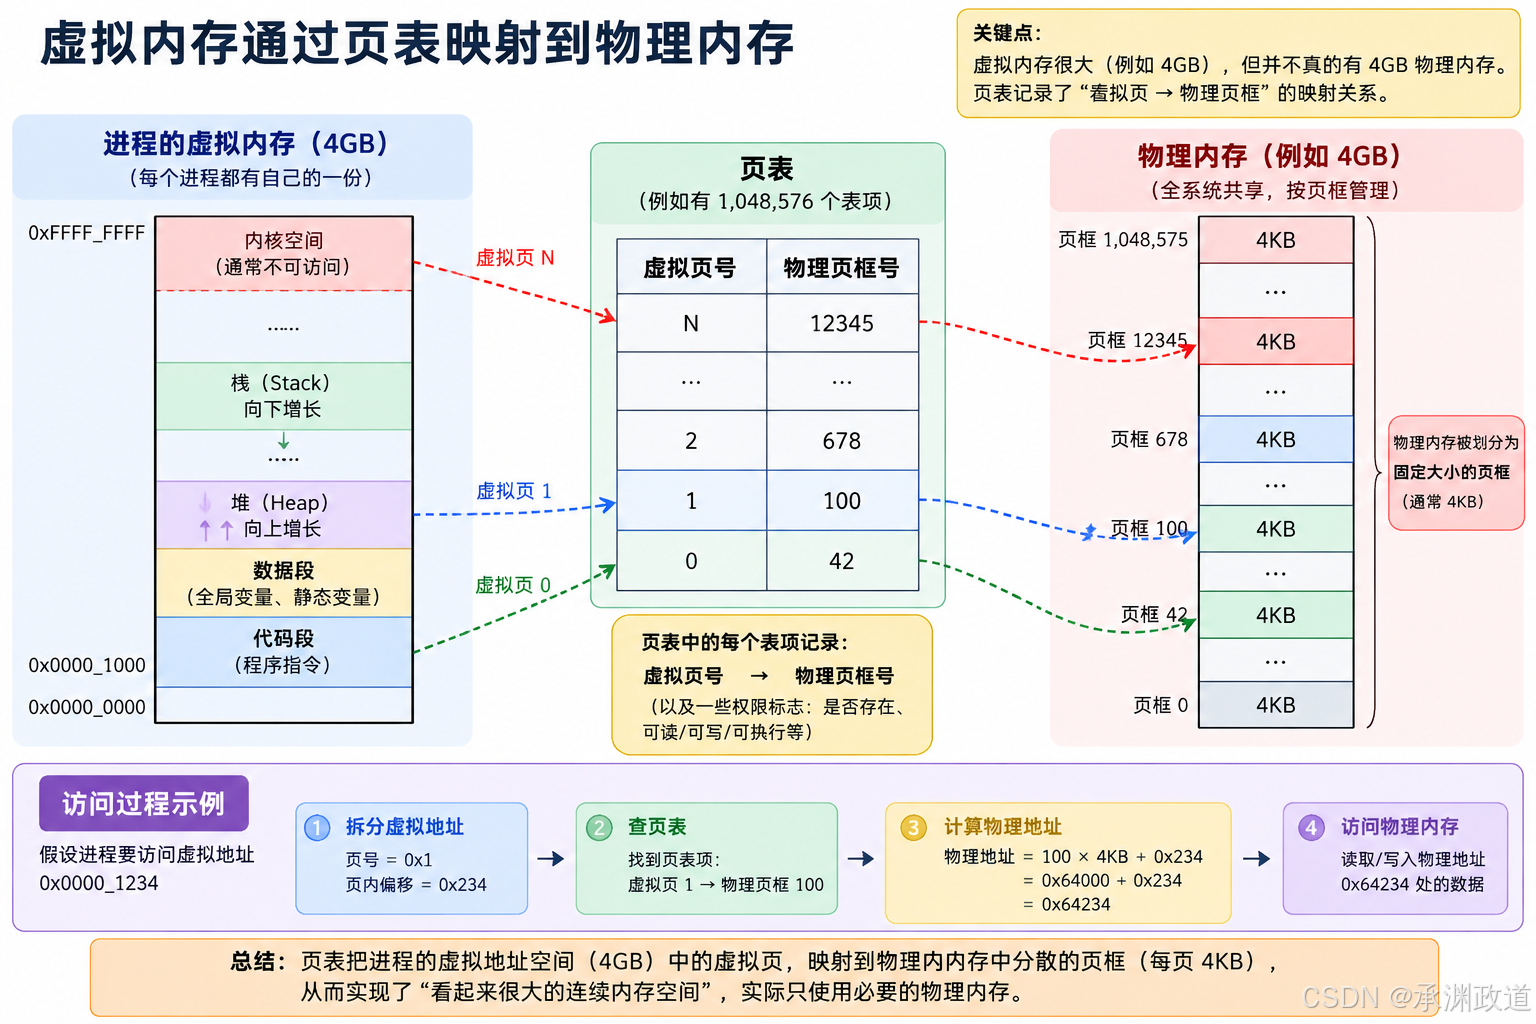
虚拟内存看上去被虚线"分割"成⼀个个单元,其实并不是真的分割,虚拟内存仍然是连续的.这个
虚线的单元仅仅表示它与⻚表中每⼀个表项的映射关系,并最终映射到相同⼤⼩的⼀个物理内存⻚上.
⻚表中的物理地址,与物理内存之间,是随机的映射关系,哪⾥可⽤就指向哪⾥(物理⻚).虽然最终使⽤的物理内存是离散的,但是与虚拟内存对应的线性地址是连续的.处理器在访问数据、获取指令时,使⽤的都是线性地址,只要它是连续的就可以了,最终都能够通过⻚表找到实际的物理地址.
假设,在32位系统中,地址的⻓度是4个字节,那么⻚表中的每⼀个表项就是占⽤4个字节.所以⻚表占据的总空间⼤⼩就是:1048576*4 = 4MB的⼤⼩.也就是说映射表⾃⼰本⾝,就要占⽤4MB/4KB=1024个物理⻚.
解决需要⼤容量⻚表的最好⽅法是:把⻚表看成普通的⽂件,对它进⾏离散分配,即对⻚表再分⻚,由此形成多级⻚表的思想.
为了解决这个问题,可以把这个单⼀⻚表拆分成1024个体积更⼩的映射表.如下图所示.这样⼀
来,1024(每个表中的表项个数)*1024(表的个数),仍然可以覆盖4GB的物理内存空间.
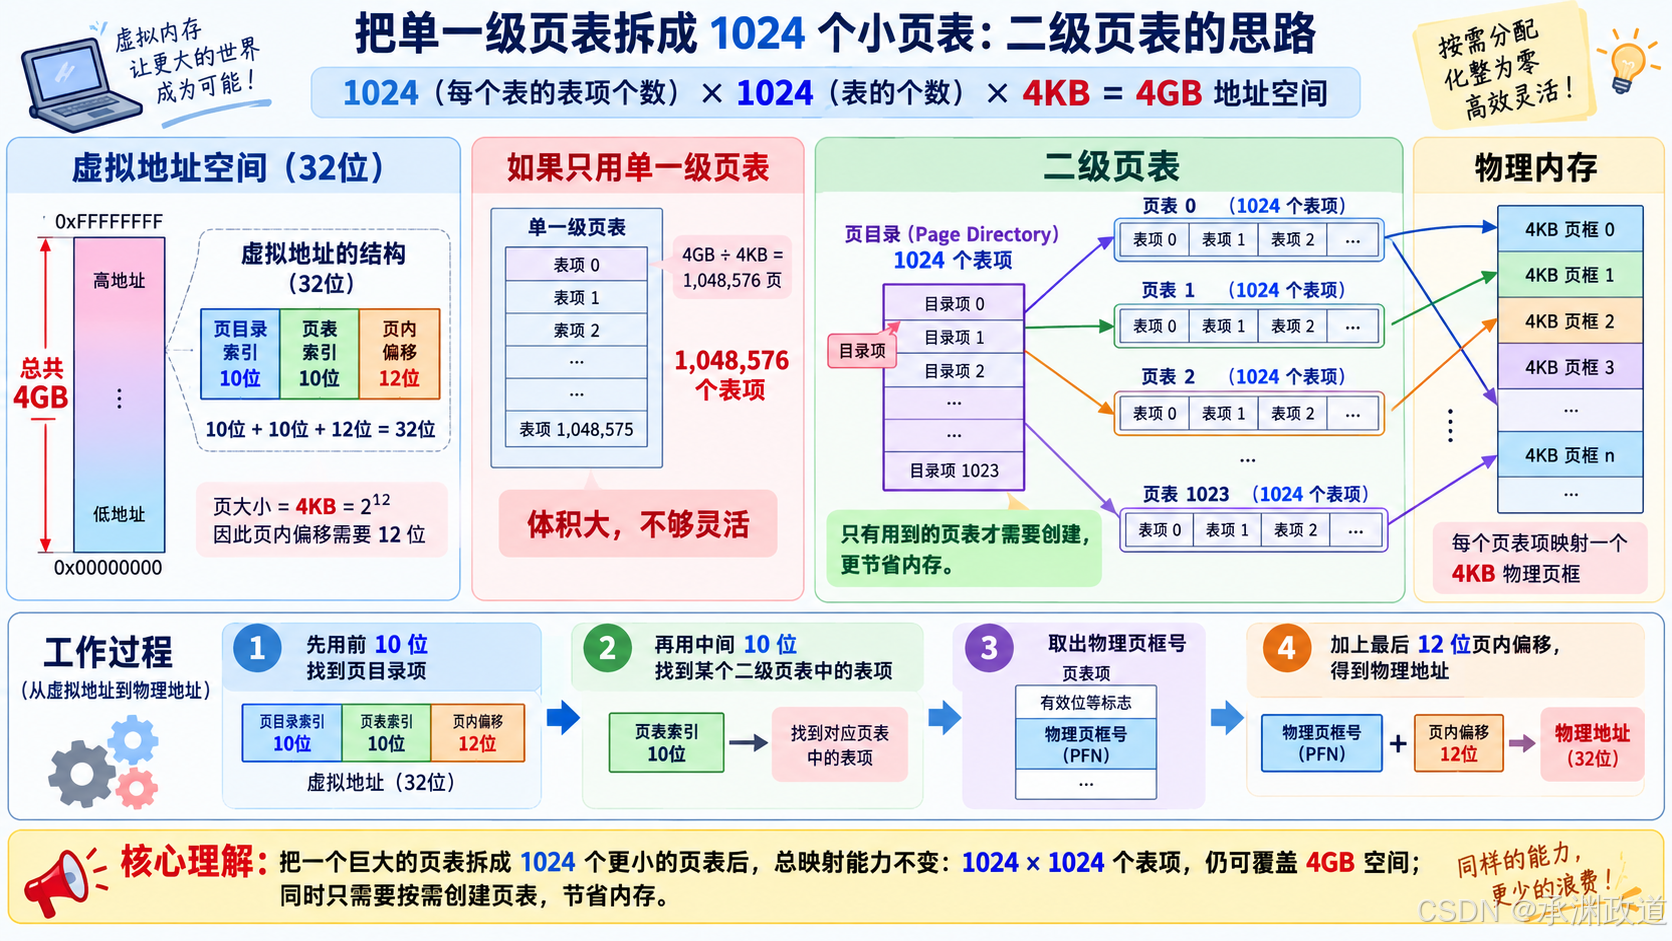
这⾥的每⼀个表,就是真正的⻚表,所以⼀共有1024个⻚表.⼀个⻚表⾃⾝占⽤4KB,那么1024 个⻚表⼀共就占⽤了4MB的物理内存空间,和之前没差别?
从总数上看是这样,但是⼀个应⽤程序是不可能完全使⽤全部的4GB空间的,也许只要⼏⼗个⻚表就可以了.例如:⼀个⽤户程序的代码段、数据段、栈段,⼀共就需要10MB的空间,那么使⽤3个⻚表就⾜够了.(计算过程:每⼀个⻚表项指向⼀个4KB的物理⻚,那么⼀个⻚表中1024个⻚表项,⼀共能覆盖4MB的物理内存;那么10MB的程序,向上对⻬取整之后(4MB的倍数,就是12MB),就需要3个⻚表就可以了.
(4)⻚⽬录结构
页目录(Page Directory)可以理解成二级页表里的"一级索引表".它本身不直接保存最终物理页地址,而是通常先找到页表(Page Table),再由页表找到物理页框.
以经典 32 位 x86、4KB 页、非 PAE 的二级页表为例,结构最清楚:
text
32 位虚拟地址
┌────────────┬────────────┬──────────────┐
│ 前 10 位   │ 中间 10 位 │ 后 12 位     │
│ 页目录索引 │ 页表索引   │ 页内偏移     │
└─────┬──────┴─────┬──────┴──────┬───────┘
      │            │             │
      ▼            ▼             │
   页目录         页表            │
      │            │             │
      ▼            ▼             │
   PDE          PTE              │
      │            │             │
      └──→ 页表 ───┘             │
                   │             │
                   ▼             │
                物理页框          │
                   │             │
                   └──── + 偏移 ─┘
                         ↓
                      物理地址
到⽬前为⽌,每⼀个⻚框都被⼀个⻚表中的⼀个表项来指向了,那么这1024个⻚表也需要被管理起来.管理⻚表的表称之为⻚⽬录表,形成⼆级⻚表.如下图所示:
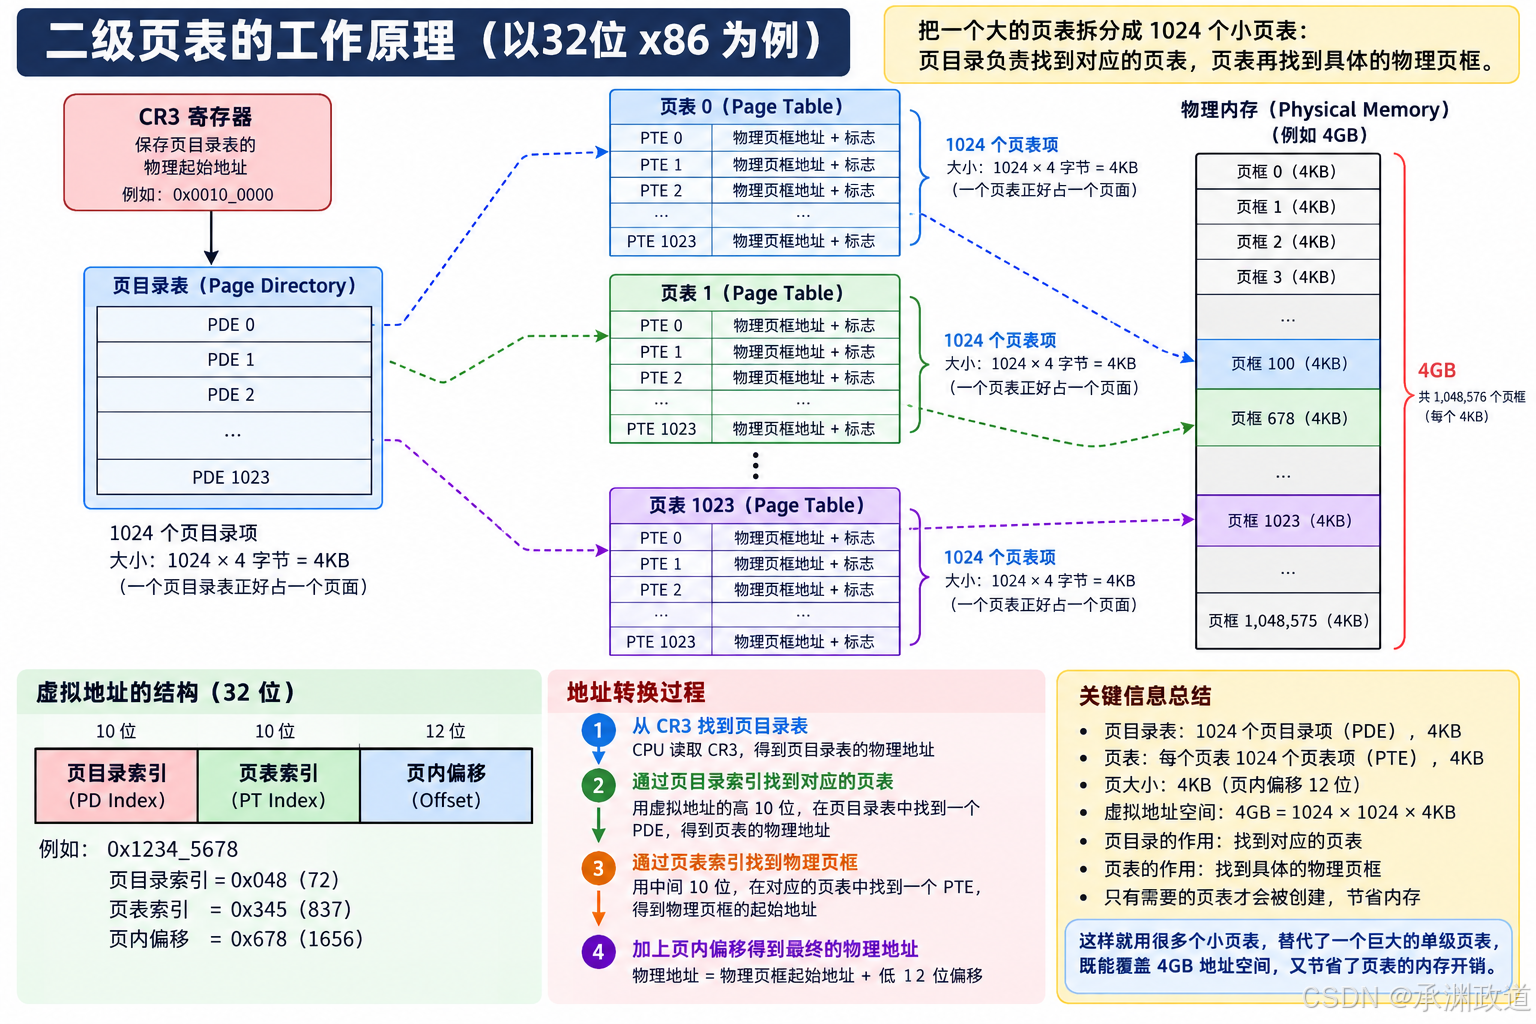
所有⻚表的物理地址被⻚⽬录表项指向;⻚⽬录的物理地址被CR3寄存器指向,这个寄存器中,保存了当前正在执⾏任务的⻚⽬录地址.所以操作系统在加载⽤⼾程序的时候,不仅仅需要为程序内容来分配物理内存,还需要为⽤来保存程序的⻚⽬录和⻚表分配物理内存.
(5)两级⻚表的地址转换
两级页表的地址转换可以直接记成这条链:
虚拟地址 → 页目录 → 页表 → 物理页框 → 物理地址
以经典 32 位 x86、4KB 页、非 PAE 二级页表为例,最核心的是把一个 32 位虚拟地址拆成:
text
31                22 21                12 11               0
┌──────────────────┬────────────────────┬───────────────────┐
│ 页目录索引 10 bit │ 页表索引 10 bit    │ 页内偏移 12 bit    │
└──────────────────┴────────────────────┴───────────────────┘
        ↓                   ↓                    ↓
    找哪个页表          找哪个物理页框          页内哪个字节
也就是:
text
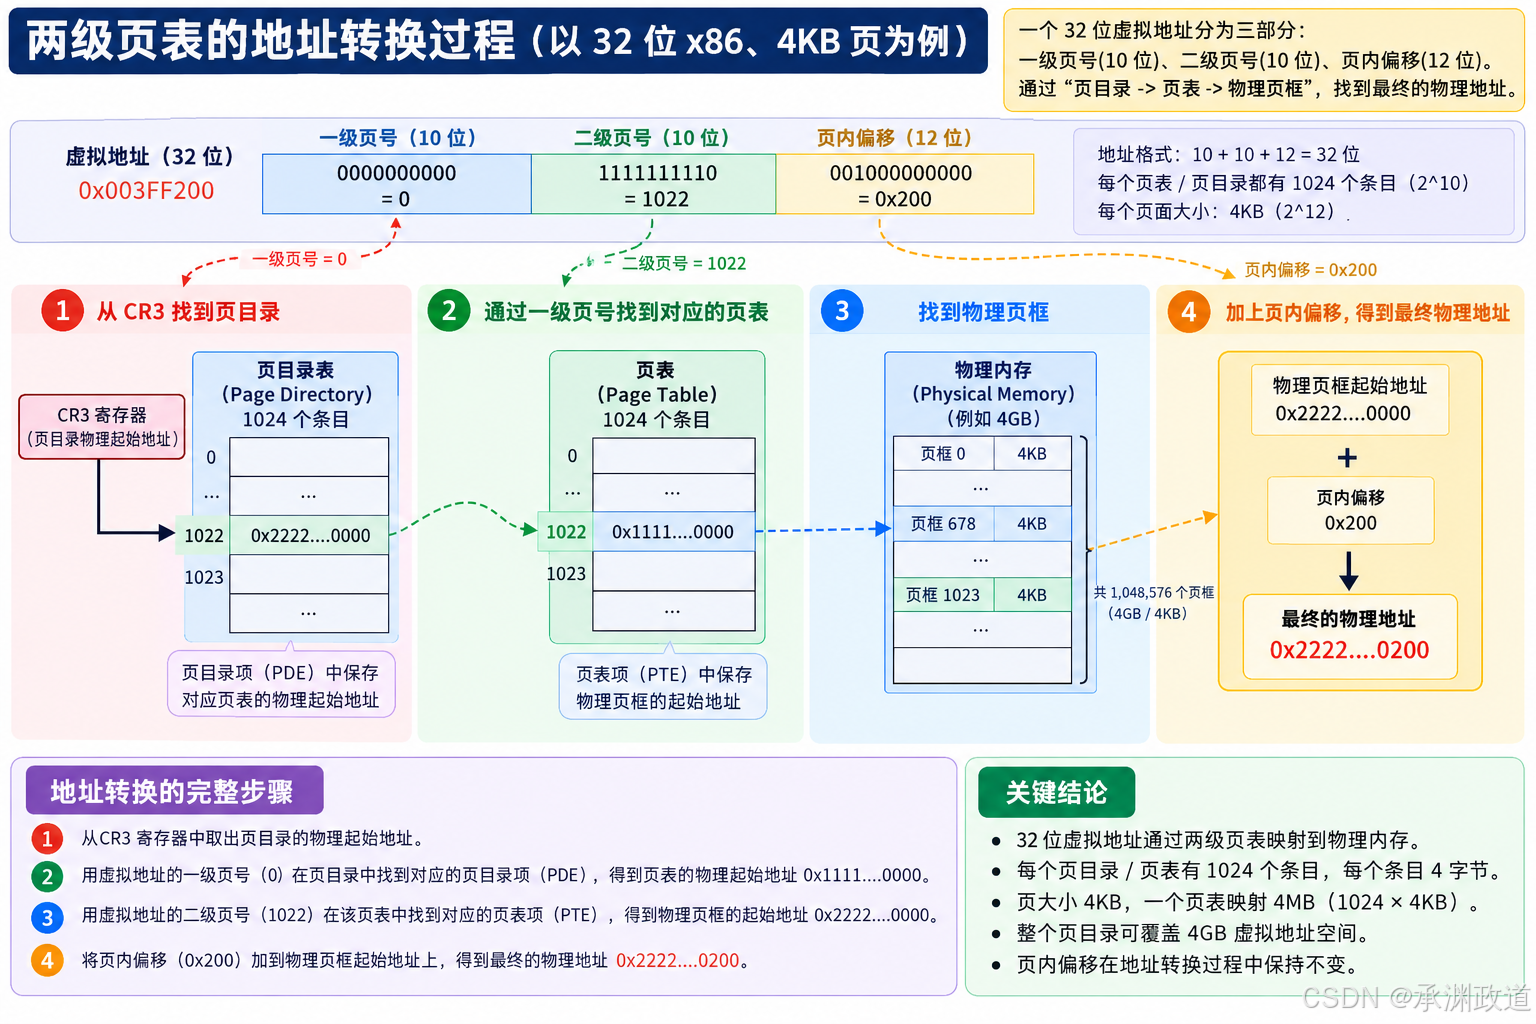
10 bit + 10 bit + 12 bit = 32 bit下⾯以⼀个逻辑地址为例.将逻辑地址(0000000000,0000000001,11111111111)转换为物理地址的过程:
- 在32位处理器中,采⽤4KB的⻚⼤⼩,则虚拟地址中低12位为⻚偏移,剩下⾼20位给⻚表,分成两级,每个级别占10个bit(10+10).
- CR3 寄存器读取⻚⽬录起始地址,再根据⼀级⻚号查⻚⽬录表,找到下⼀级⻚表在物理内存中存放位置.
- 根据⼆级⻚号查表,找到最终想要访问的内存块号.
- 结合⻚内偏移量得到物理地址.
- ⼀个物理⻚的地址⼀定是4KB对⻬的(最后的12位全部为0),所以其实只需要记录物理⻚地址的⾼20位即可.
- 以上其实就是MMU的⼯作流程.MMU(Memory Manage Unit)是⼀种硬件电路,其速度很快,主要⼯作是进⾏内存管理,地址转换只是它承接的业务之⼀.
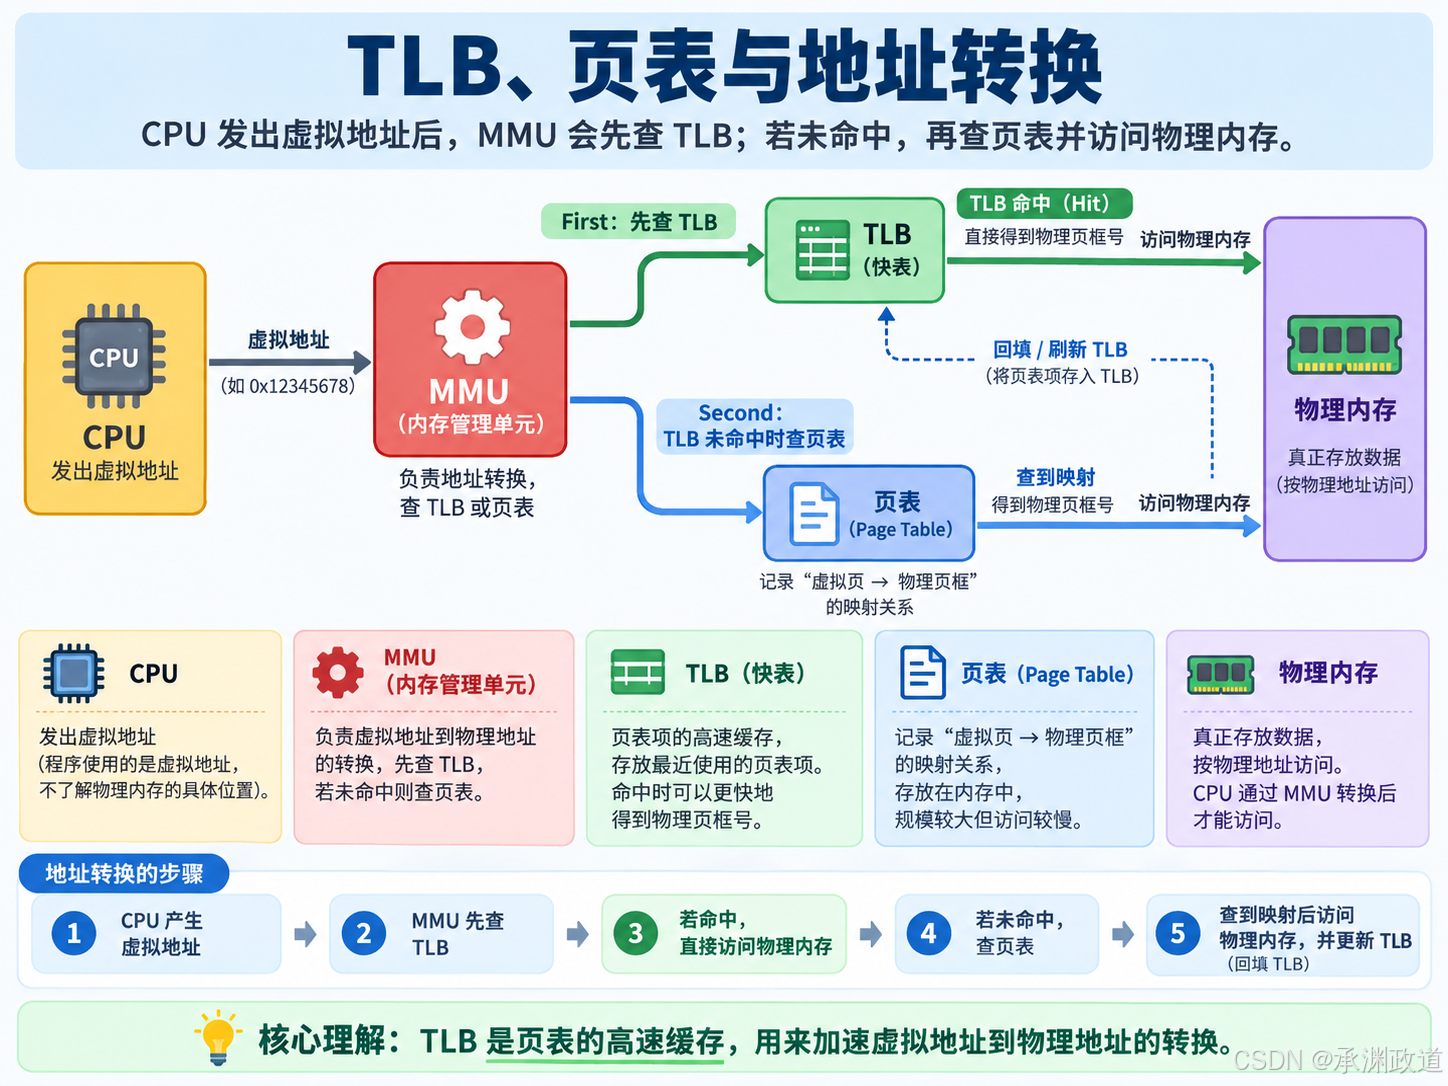
到这⾥其实还有个问题,MMU要先进⾏两次⻚表查询确定物理地址,在确认了权限等问题后,MMU再将这个物理地址发送到总线,内存收到之后开始读取对应地址的数据并返回.那么当⻚表变为N级时,就变成了N次检索+1次读写.可⻅,⻚表级数越多查询的步骤越多,对于CPU来说等待时间越⻓,效率越低.
让我们现在总结⼀下:单级⻚表对连续内存要求⾼,于是引⼊了多级⻚表,但是多级⻚表也是⼀把双刃剑,在减少连续存储要求且减少存储空间的同时降低了查询效率.
有没有提升效率的办法呢?计算机科学中的所有问题,都可以通过添加⼀个中间层来解决.MMU引⼊了新武器,江湖⼈称快表的TLB(其实,就是缓存,Translation Lookaside Buffer,学名转译后备缓冲器).当CPU给MMU传新虚拟地址之后,MMU先去问TLB那边有没有,如果有就直接拿到物理地址发到总线给内存,⻬活.但TLB容量⽐较⼩,难免发⽣Cache Miss,这时候MMU还有保底的⽼武器⻚表,在⻚表中找到之后MMU除了把地址发到总线传给内存,还把这条映射关系给到TLB,让它记录⼀下刷新缓存.
(6)缺⻚异常
缺页异常(Page Fault) 可以先记成一句话:CPU访问某个虚拟地址时,发现当前页表无法直接完成这次访问,于是陷入内核,由操作系统处理.它不等于"程序出错",很多时候是正常的内存管理机制.
设想,CPU给MMU的虚拟地址,在TLB和⻚表都没有找到对应的物理⻚,该怎么办呢?其实这就是缺⻚异常Page Fault,它是⼀个由硬件中断触发的可以由软件逻辑纠正的错误.假如⽬标内存⻚在物理内存中没有对应的物理⻚或者存在但⽆对应权限,CPU就⽆法获取数据,这种情况下CPU就会报告⼀个缺⻚错误.由于CPU没有数据就⽆法进⾏计算,CPU罢⼯了⽤户进程也就出现了缺⻚中断,进程会从⽤户态切换到内核态,并将缺⻚中断交给内核的Page Fault Handler处理.
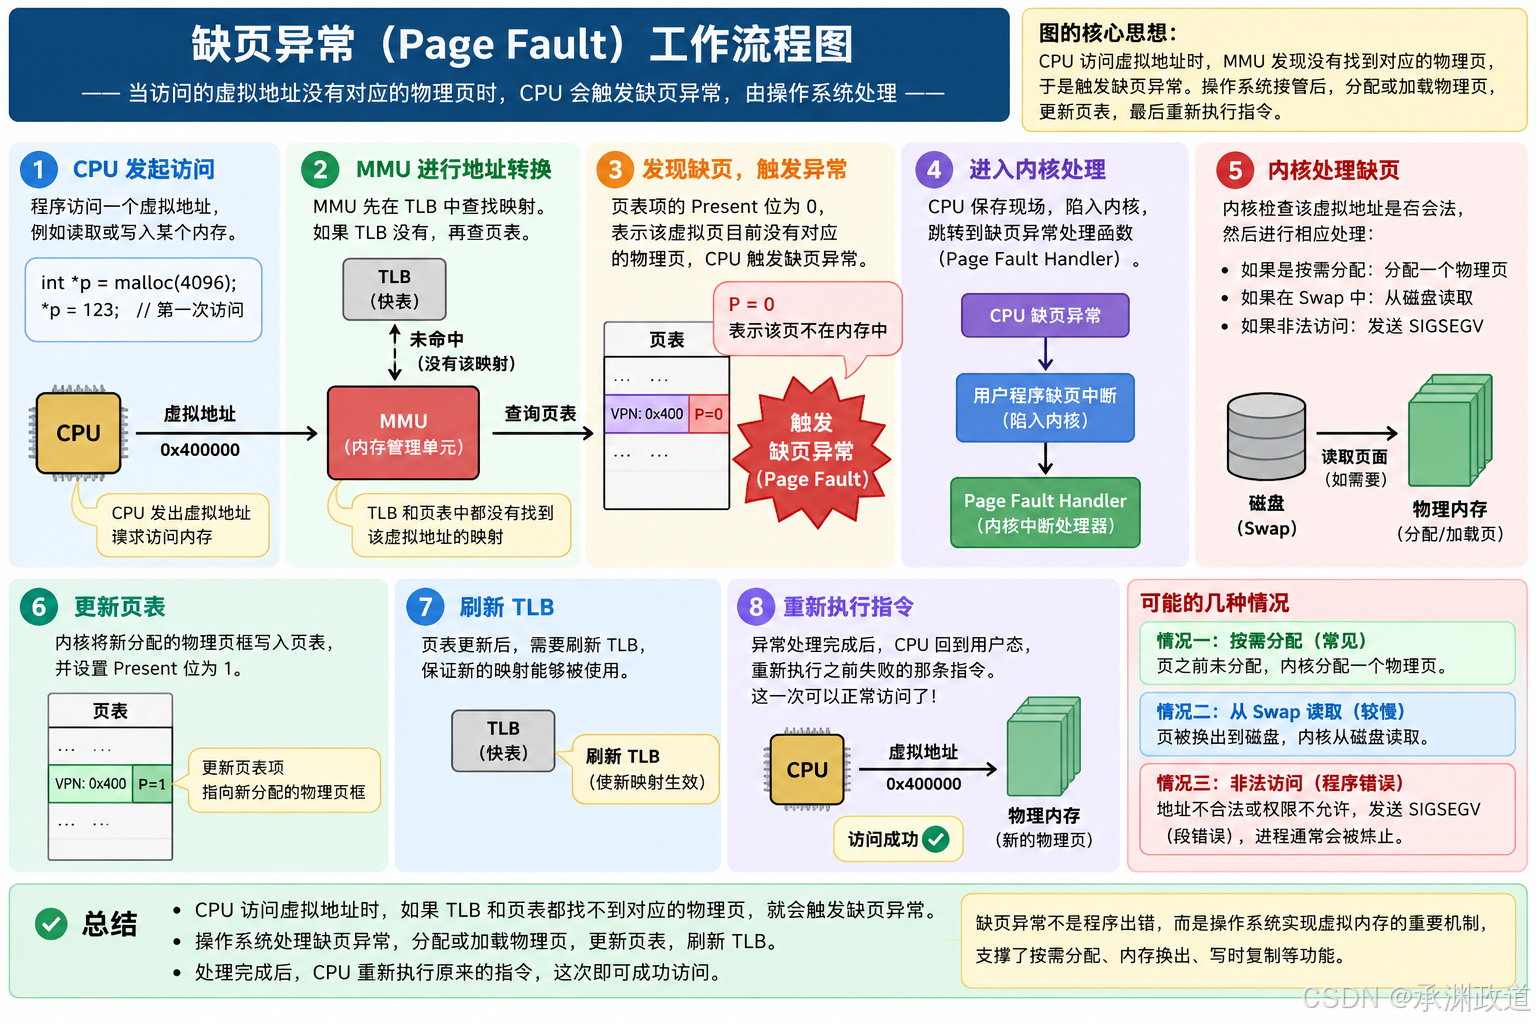
缺⻚中断会交给PageFaultHandler处理,其根据缺⻚中断的不同类型会进⾏不同的处理:
- Hard Page Fault也被称为Major Page Fault,翻译为硬缺⻚错误/主要缺⻚错误,这时物理内存中没有对应的物理⻚,需要CPU打开磁盘设备读取到物理内存中,再让MMU建⽴虚拟地址和物理地址的映射.
- Soft Page Fault也被称为Minor Page Fault,翻译为软缺⻚错误/次要缺⻚错误,这时物理内存中是存在对应物理⻚的,只不过可能是其他进程调⼊的,发出缺⻚异常的进程不知道⽽已,此时MMU只需要建⽴映射即可,⽆需从磁盘读取写⼊内存,⼀般出现在多进程共享内存区域.
- Invalid Page Fault 翻译为⽆效缺⻚错误,⽐如进程访问的内存地址越界访问,⼜⽐如对空指针解引⽤内核就会报 segment fault 错误中断进程直接挂掉.
📌注意:
- 如何理解我们之前的
new和malloc?
malloc和new的本质都是向程序申请一块可用内存,但它们首先获得的通常是虚拟地址空间 ,并不意味着对应的物理内存已经全部立即分配;真正的物理页往往在程序第一次访问这些地址时,通过缺页异常由操作系统按需分配.区别在于malloc只是分配一块原始内存,而 C++ 的new除了分配内存,还会调用对象的构造函数.- 如何理解我们之前学的写时拷贝(Copy-On-Write)?
写时拷贝的核心思想是"不写就不复制 ":例如fork()之后,父子进程最开始可以让自己的虚拟地址都映射到同一份物理内存,并暂时设置成只读;只要双方都只是读取,就一直共享,当其中一个进程真正尝试写入时,会触发缺页异常,内核这时才复制一个新的物理页,并修改该进程的页表,使父子进程从此使用各自独立的数据,从而避免不必要的内存复制.- 申请内存究竟是在干什么?
所谓申请内存,不能简单理解成"立刻从 RAM 中拿走一块空间",更准确地说,是先让操作系统或内存分配器为程序安排一段合法的虚拟地址范围,程序随后真正访问这些地址时,内核再根据需要分配物理页,并通过页表建立"虚拟页 → 物理页框"的映射,因此申请内存实际上涉及虚拟地址空间管理、物理内存分配和页表映射三个层次.- 如何区分是缺页了,还是真的越界了?
当CPU无法通过当前页表完成一次内存访问时,都会先触发 Page Fault ,然后 Linux 内核再判断原因:如果这个虚拟地址属于进程合法的内存区域,只是还没有分配物理页、页面在 Swap 中或属于写时拷贝,那么内核会修复映射后继续执行;如果地址根本不属于进程,或者访问权限不允许,就属于非法访问,通常会发送SIGSEGV.但需要注意,C/C++ 中的小范围数组越界可能仍然落在一个已经合法映射的内存页中,因此即使发生了越界,也不一定立刻触发缺页异常或段错误.- 越界了一定会报错吗?
不一定.C/C++ 中发生数组越界、指针越界后,程序只是进入了未定义行为 ,并不保证马上报错;如果越界后的地址仍然落在当前进程已经映射、并且具有相应读写权限的内存页中,CPU 和 MMU 可能认为这次访问完全合法,因此既不会触发Page Fault,也不会产生SIGSEGV,程序甚至可能继续运行,只是悄悄破坏了其他数据.只有当越界访问到了未映射地址、受保护区域或权限不允许的页面时,才更可能触发缺页异常,并最终由操作系统判断为非法访问而报段错误.
①⻚号合法性检查:操作系统在处理中断或异常时,⾸先检查触发事件的虚拟地址的⻚号是
否合法.如果⻚号合法但⻚⾯不在内存中,则为缺⻚中断;如果⻚号⾮法,则为越界访问.
②内存映射检查:操作系统还可以检查触发事件的虚拟地址是否在当前进程的内存映射范围
内.如果地址在映射范围内但⻚⾯不在内存中,则为缺⻚中断;如果地址不在映射范围内,则为越界访问.线程资源划分的真相:只要将虚拟地址空间进⾏划分,进程资源就天然被划分好了.
1.3线程的优缺点
线程的优点:
创建⼀个新线程的代价要⽐创建⼀个新进程⼩得多;与进程之间的切换相⽐,线程之间的切换需要操作系统做的⼯作要少很多.最主要的区别是线程的切换虚拟内存空间依然是相同的,但是进程切换是不同的.这两种上下⽂切换的处理都是通过操作系统内核来完成的.内核的这种切换过程伴随的最显著的性能损耗是将寄存器中的内容切换出.另外⼀个隐藏的损耗是上下⽂的切换会扰乱处理器的缓存机制.简单的说,⼀旦去切换上下⽂,处理器中所有已经缓存的内存地址⼀瞬间都作废了.还有⼀个显著的区别是当你改变虚拟内存空间的时候,处理的⻚表缓冲TLB(快表)会被全部刷新,这将导致内存的访问在⼀段时间内相当的低效.但是在线程的切换中,不会出现这个问题,当然还有硬件cache.线程占⽤的资源要⽐进程少.能充分利⽤多处理器的可并⾏数量.在等待慢速I/O操作结束的同时,程序可执⾏其他的计算任务计算密集型应⽤,为了能在多处理器系统上运⾏,将计算分解到多个线程中实现.I/O密集型应⽤,为了提⾼性能,将I/O操作重叠.线程可以同时等待不同的I/O操作.
一句话说:线程的优点是创建和切换开销通常比进程小,同一进程中的多个线程可以共享代码段、堆、全局变量和文件描述符,因此线程之间通信比较方便;同时,多线程可以充分利用多核 CPU,让多个任务并发或并行执行,提高程序的响应速度和吞吐量.
线程的缺点:
- 性能损失:⼀个很少被外部事件阻塞的计算密集型线程往往⽆法与其它线程共享同⼀个处理器.如果计算密集型线程的数量⽐可⽤的处理器多,那么可能会有较⼤的性能损失,这⾥的性能损失指的是增加了额外的同步和调度开销,⽽可⽤的资源不变.
- 健壮性降低:编写多线程需要更全⾯更深⼊的考虑,在⼀个多线程程序⾥,因时间分配上的细微偏差或者因共享了不该共享的变量⽽造成不良影响的可能性是很⼤的,换句话说线程之间是缺乏保护的.
- 缺乏访问控制:进程是访问控制的基本粒度,在⼀个线程中调⽤某些OS函数会对整个进程造成影响.
- 编程难度提⾼:编写与调试⼀个多线程程序⽐单线程程序困难得多.
一句话说:线程的缺点是因为多个线程共享同一份地址空间,一旦同时访问和修改共享数据,就容易产生竞态条件、死锁等并发问题,需要使用互斥锁、信号量等同步机制,程序设计和调试难度较大;另外线程之间隔离性较差,一个线程发生严重错误,例如非法访问内存,可能导致整个进程中的所有线程一起退出.
1.4线程异常
线程异常 可以理解为线程在运行过程中出现了无法正常继续执行的问题,例如访问非法内存、栈溢出、除零、死锁、竞争条件,或者C++中抛出的异常没有被线程内部捕获等.由于同一进程中的多个线程共享同一个地址空间和大部分资源,因此线程异常往往会影响整个进程,例如某个线程发生非法内存访问导致 SIGSEGV,Linux 通常会终止整个进程,而不只是终止这个线程;所以多线程程序中需要特别注意异常捕获、线程同步、共享数据保护和资源释放.
1.5线程⽤途
线程的用途主要是让一个进程能够同时处理多个任务,提高程序的并发能力、响应速度和多核 CPU 利用率.例如服务器可以用不同线程同时处理多个客户端请求,浏览器可以分别用线程处理界面、网络、渲染等任务,计算程序也可以把一个大任务拆成多个子任务交给不同线程并行执行;由于同一进程内的线程共享内存和资源,线程之间交换数据也比较方便,因此特别适合那些需要多个任务协同工作的程序.
2.Linux进程和线程---哪些资源共享、哪些独占?
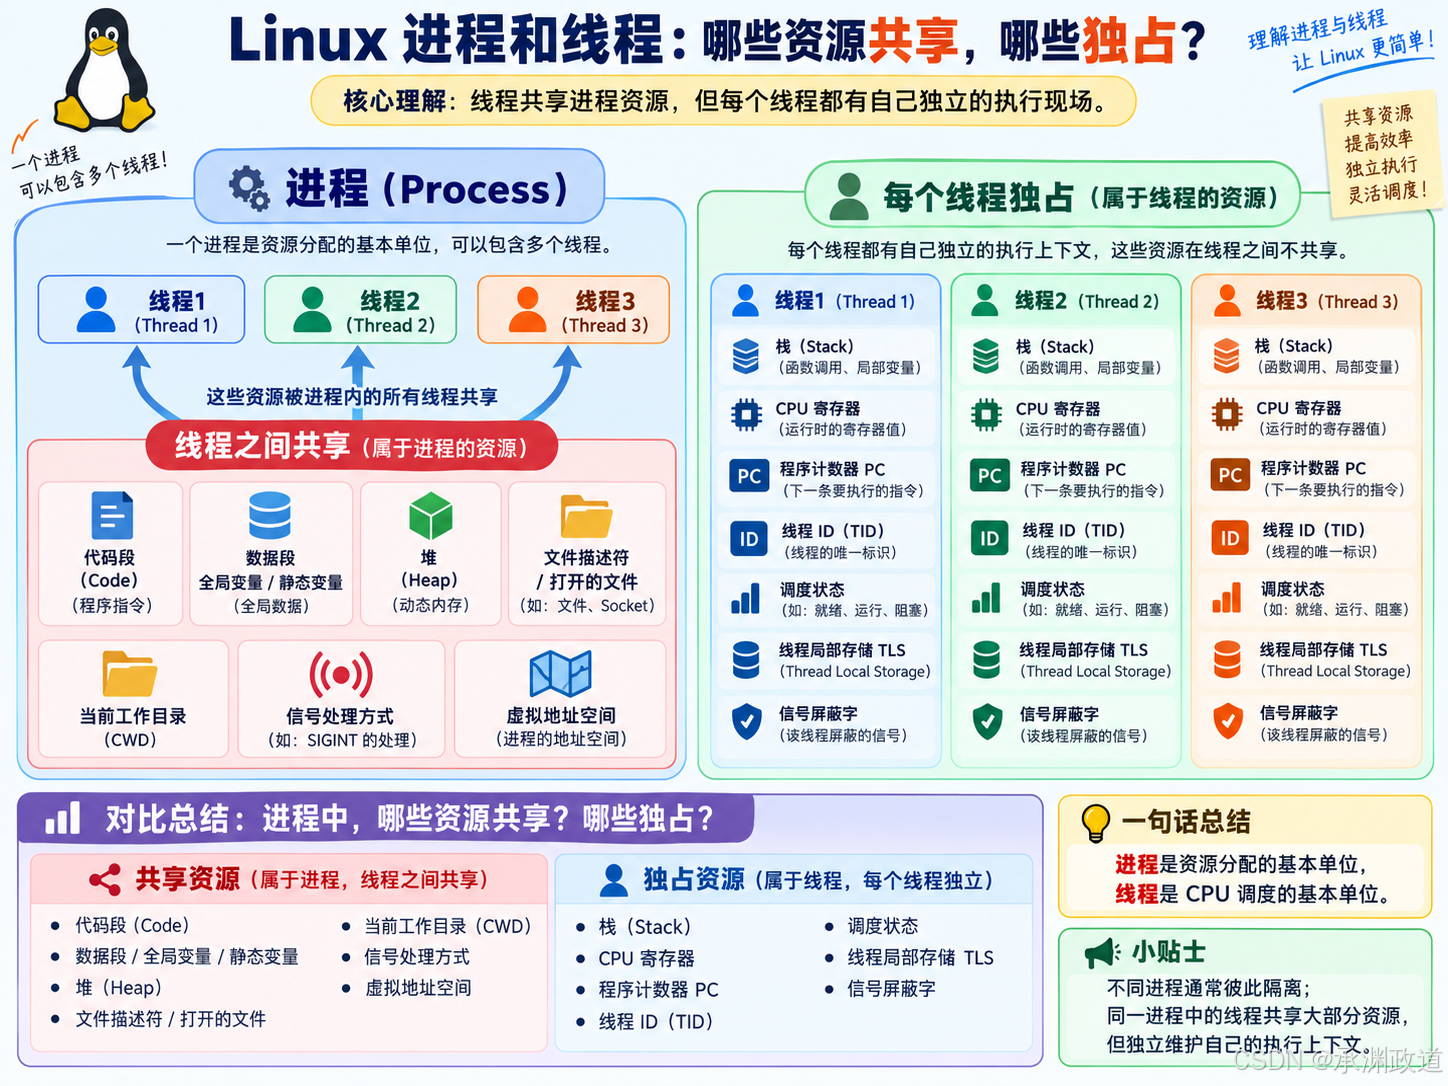
在Linux中,进程之间强调资源隔离,线程之间强调资源共享 。同一进程内的多个线程通常共享 :虚拟地址空间(代码段、数据段、堆)、全局变量、打开的文件/文件描述符、当前工作目录、信号处理方式等;而每个线程又有自己独立的:线程ID(TID)、栈、CPU 寄存器、程序计数器、调度状态、线程局部存储(TLS)、信号屏蔽字等.
| 资源 | 同一进程的线程之间 |
|---|---|
| 代码段 | ✅ 共享 |
| 全局变量/静态变量 | ✅ 共享 |
| 堆 Heap | ✅ 共享 |
| 虚拟地址空间 | ✅ 共享 |
| 文件描述符 | ✅ 共享 |
| 当前工作目录 | ✅ 共享 |
| 信号处理函数 | ✅ 共享 |
| 用户栈 Stack | ❌ 每个线程独立 |
| CPU 寄存器 | ❌ 独立 |
| 程序计数器 PC | ❌ 独立 |
| 线程 ID TID | ❌ 独立 |
| 调度状态 | ❌ 独立 |
| TLS 线程局部变量 | ❌ 独立 |
| 信号屏蔽字 | ❌ 独立 |
可以简单记成:
线程共享"进程的资源",但独占"自己的执行现场"。
而不同进程通常拥有各自独立的虚拟地址空间、页表和资源管理环境,即使 fork() 后最初通过写时拷贝共享物理页,从逻辑上看仍然是彼此独立的进程地址空间.
2.1进程的多个线程共享
一个进程中的多个线程通常会共享该进程的大部分资源 ,主要包括:虚拟地址空间、代码段、数据段、堆、全局变量和静态变量、打开的文件及文件描述符、当前工作目录、信号处理方式等 ;因此一个线程修改堆或全局变量后,其他线程通常也能看到.与此同时,每个线程又有自己独立的线程栈、CPU 寄存器、程序计数器、线程 ID、调度状态、线程局部存储(TLS)和信号屏蔽字 .可以简单记成:线程共享进程资源,但每个线程独占自己的执行现场.
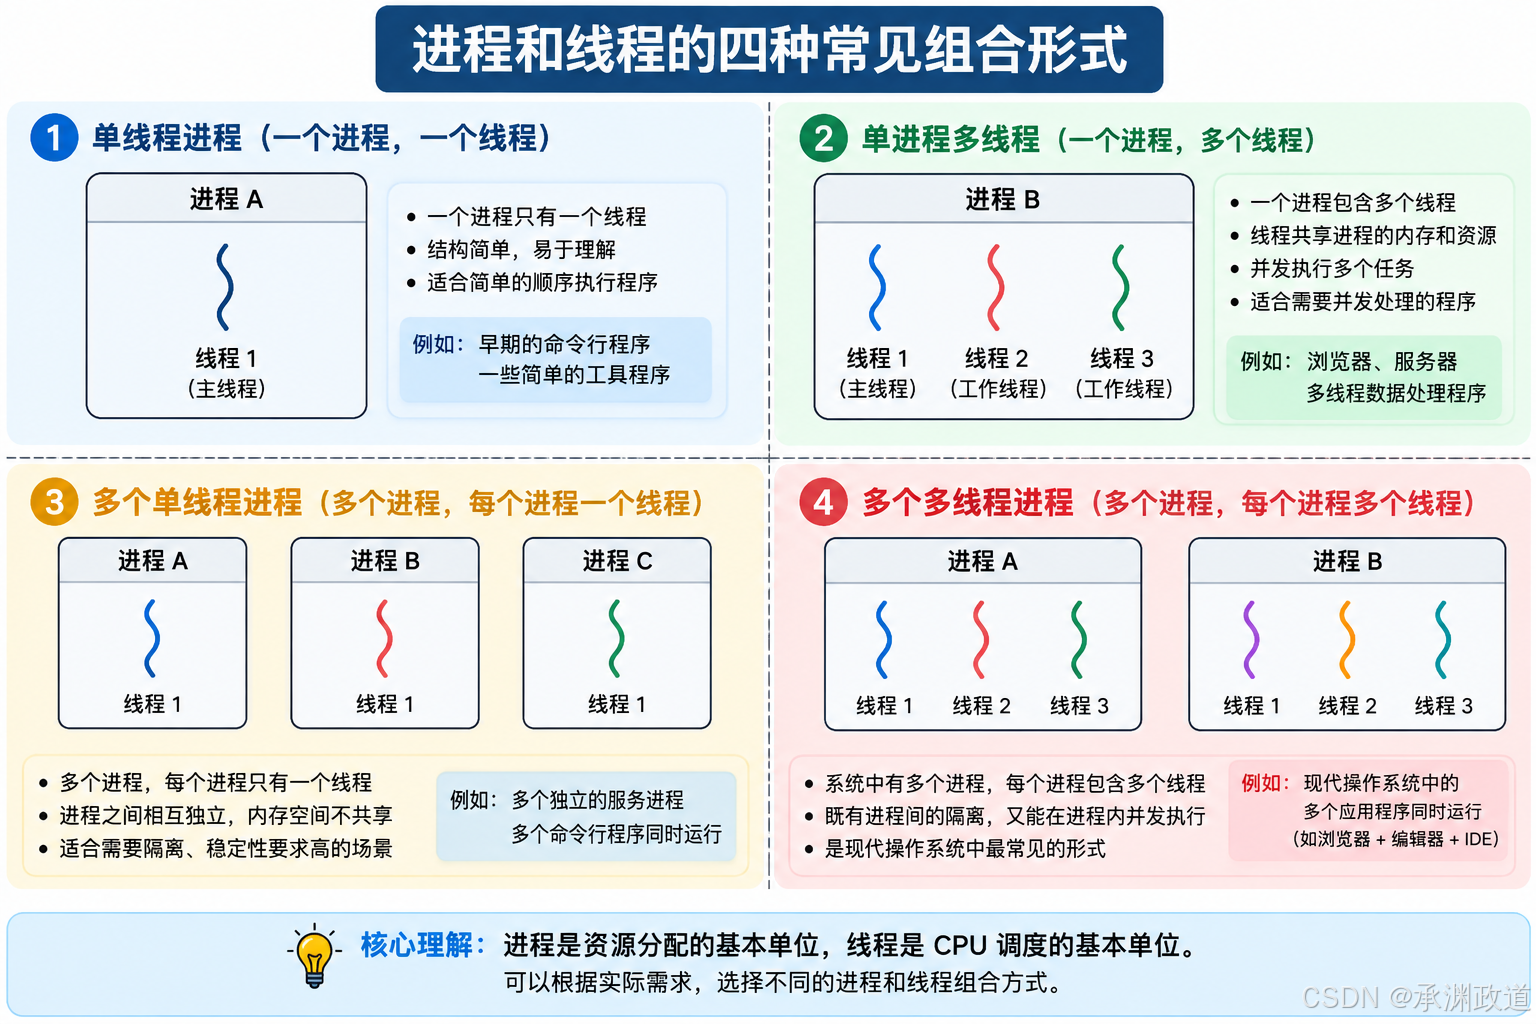
2.2如何看待单进程具有⼀个线程执⾏流的进程?
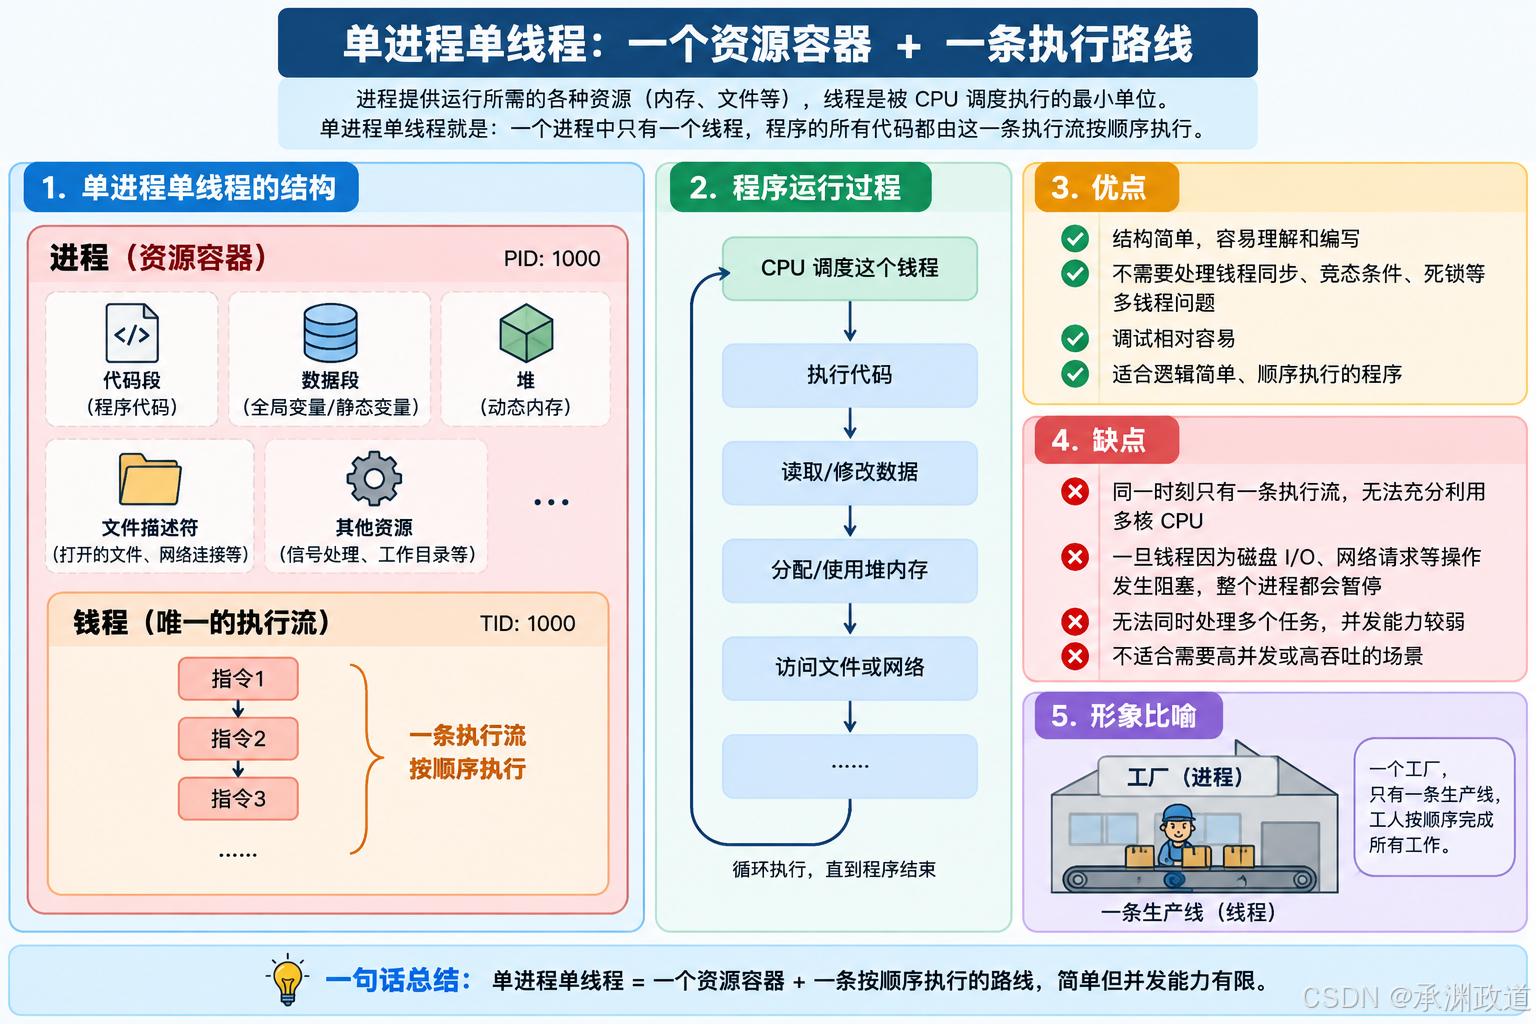
单进程、单线程执行流 可以理解为:一个进程中只有一个线程,程序的所有代码都由这一条执行流按顺序执行,也就是说进程负责提供独立的地址空间、堆、代码段、文件描述符等资源,而唯一的线程负责真正被 CPU 调度执行.它的优点是结构简单,不存在线程同步、竞态条件、死锁等多线程问题,程序比较容易编写和调试;缺点是同一时刻只有一条执行流,无法充分利用多核CPU,而且一旦线程因为磁盘I/O、网络请求等操作发生阻塞,整个进程的执行都会暂停.可以简单记成:进程是资源容器,单线程进程就是"一个资源容器 + 一条执行路线".
3.Linux线程控制
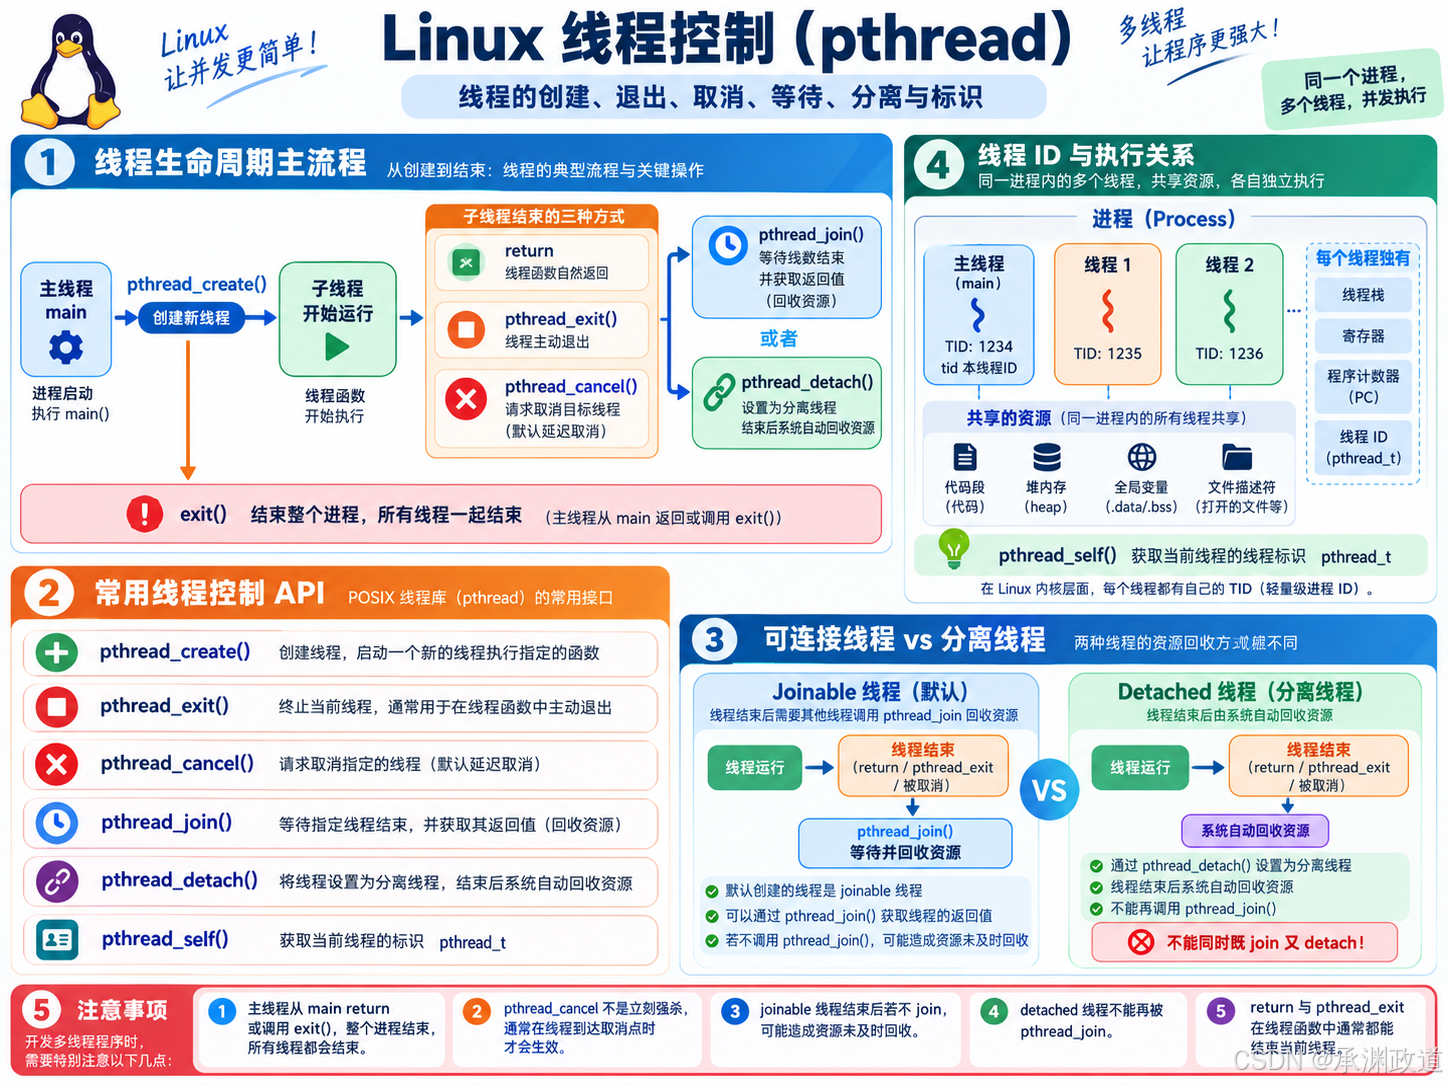
3.1POSIX线程库
POSIX 线程库(POSIX Threads,简称pthread) 是 Unix/Linux 系统中一套标准的多线程编程接口,它规定了线程创建、退出、等待、同步等操作的API.在Linux中,我们通常通过pthread_create() 创建线程、pthread_join() 等待线程结束、pthread_exit() 退出线程,并使用 pthread_mutex_*、pthread_cond_* 等接口实现互斥和线程同步;这些线程属于同一个进程,因此共享虚拟地址空间、堆、全局变量和文件描述符,但每个线程拥有独立的栈、寄存器、程序计数器和线程ID.Linux目前通常由glibc的 NPTL 实现pthread,底层最终依赖Linux的线程机制(如 clone()、futex).编译 pthread 程序时一般使用:
bash
gcc test.c -pthread

与线程有关的函数构成了⼀个完整的系列,绝⼤多数函数的名字都是以"pthread_"打头的
要使⽤这些函数库,要通过引⼊头⽂ <pthread.h>
链接这些线程函数库时要使⽤编译器命令的"-lpthread"选项可以简单记成:pthread是Linux/C程序进行多线程编程最常用的一套标准接口.
3.2创建线程
在Linux中,创建线程通常使用POSIX线程库提供的 pthread_create() 函数,它会在当前进程中创建一条新的执行流,新线程与主线程共享进程的虚拟地址空间、堆、全局变量和文件描述符,但拥有自己独立的栈、寄存器和线程ID.函数原型是:
c
功能:创建⼀个新的线程
原型:int pthread_create(
    pthread_t *thread,
    const pthread_attr_t *attr,
    void *(*start_routine)(void *),
    void *arg
);

参数:
thread:返回线程ID
attr:设置线程的属性,attr为NULL表⽰使⽤默认属性
start_routine:是个函数地址,线程启动后要执⾏的函数
arg:传给线程启动函数的参数
返回值:成功返回0;失败返回错误码
最常见的写法:
c
#include <stdio.h>
#include <pthread.h>

void *worker(void *arg)
{
    printf("子线程正在运行\n");
    return NULL;
}

int main()
{
    pthread_t tid;

    // 创建线程
    pthread_create(&tid, NULL, worker, NULL);

    // 等待子线程结束
    pthread_join(tid, NULL);

    printf("主线程结束\n");

    return 0;
}
编译时使用:
bash
gcc test.c -pthread -o test执行过程可以理解为:
text
进程启动
   ↓
主线程 main
   ↓
pthread_create()
   ↓
┌──────────────┬──────────────┐
│ 主线程       │ 新线程        │
│ 继续执行     │ worker()     │
└──────────────┴──────────────┘
        ↓
pthread_join()
        ↓
等待子线程结束
        ↓
进程结束
其中 pthread_create() 成功返回 0,失败返回错误码 .可以简单记成:pthread_create() 负责创建线程并指定线程从哪个函数开始执行,pthread_join() 负责等待线程结束.
错误检查:
①传统的⼀些函数是,成功返回0,失败返回-1,并且对全局变量errno赋值以指示错误.
②pthreads函数出错时不会设置全局变量errno(⽽⼤部分其他POSIX函数会这样做).⽽是将错误代码通过返回值返回.
③pthreads同样也提供了线程内的errno变量,以⽀持其它使⽤errno的代码.对于pthreads函数的错误,建议通过返回值业判定,因为读取返回值要⽐读取线程内的errno变量的开销更⼩.
cpp
#include <unistd.h>
#include <stdlib.h>
#include <stdio.h>
#include <string.h>
#include <pthread.h>

void *rout(void *arg)
{
    int i;
    for (;;)
    {
        printf("I'am thread 1\n");
        sleep(1);
    }
}
int main(void)
{
    pthread_t tid;
    int ret;
    if ((ret = pthread_create(&tid, NULL, rout, NULL)) != 0)
    {
        fprintf(stderr, "pthread_create : %s\n", strerror(ret));
        exit(EXIT_FAILURE);
    }
    int i;
    for (;;)
    {
        printf("I'am main thread\n");
        sleep(1);
    }
}
打印出来的tid是通过pthread库中有函数pthread_self得到的,它返回⼀个 pthread_t 类型的变量,指代的是调⽤pthread_self 函数的线程的"ID".怎么理解这个"ID"呢?这个"ID"是 pthread 库给每个线程定义的进程内唯⼀标识,是pthread库维持的.
由于每个进程有⾃⼰独⽴的内存空间,故此"ID"的作⽤域是进程级⽽⾮系统级(内核不认识).其实pthread库也是通过内核提供的系统调⽤(例如clone)来创建线程的,⽽内核会为每个线程创建系统全局唯⼀的"ID"来唯⼀标识这个线程.使⽤PS命令查看线程信息运⾏代码后执⾏:

LWP是什么呢?LWP得到的是真正的线程ID.之前使⽤ pthread_self 得到的这个数实际上是⼀
个地址,在虚拟地址空间上的⼀个地址,通过这个地址,可以找到关于这个线程的基本信息,包括线程ID,线程栈,寄存器等属性.在ps-aL得到的线程ID,有⼀个线程ID和进程ID相同,这个线程就是主线程,主线程的栈在虚拟地址空间的栈上,⽽其他线程的栈在是在共享区(堆栈之间),因为pthread系列函数都是pthread库提供给我们的.⽽pthread库是在共享区的.所以除了主线程之外的其他线程的栈都在共享区.
3.3线程终⽌
线程终止 是指某个线程结束自己的执行.在POSIX线程中,常见方式有:线程函数执行完毕并 return,或者在线程内部调用 pthread_exit() 主动退出;其他线程也可以通过 pthread_cancel() 请求取消目标线程,但是否立即终止取决于线程的取消状态和取消点.需要特别注意的是,线程终止和进程终止不是一回事 :普通工作线程结束通常不会影响同一进程中的其他线程,但如果调用 exit()、_exit(),或者主线程从 main() 中 return,会导致整个进程结束,所有线程都会一起终止.一个可连接线程结束后,其部分资源不会立即完全回收,通常需要其他线程调用 pthread_join() 等待并回收;如果线程被设置为detached状态,则终止后资源会由系统自动回收.
pthread_exit() 用于结束当前线程本身,而不是结束整个进程.它的函数原型是:
c
功能:线程终⽌
原型:void pthread_exit(void *retval);
参数:value_ptr:value_ptr 不要指向⼀个局部变量。
返回值:⽆返回值,跟进程⼀样,线程结束的时候⽆法返回到它的调⽤者(⾃⾝)

需要注意,pthread_exit或者return返回的指针所指向的内存单元必须是全局的或者是⽤malloc分配的,
不能在线程函数的栈上分配,因为当其它线程得到这个返回指针时线程函数已经退出了。其中retval是线程退出时返回给其他线程的结果,其他线程可以通过pthread_join()获取:
c
void *rout(void *arg)
{
    printf("thread running\n");

    pthread_exit((void *)123);

    // 不会执行到这里
}
等待线程:
c
pthread_t tid;
void *ret = NULL;

pthread_create(&tid, NULL, rout, NULL);

pthread_join(tid, &ret);

printf("thread return: %ld\n", (long)ret);
在线程函数中:
c
return value;和:
c
pthread_exit(value);效果通常类似,都会结束当前线程并返回结果.
但有一个很重要的场景:如果主线程执行:
c
return 0;或者:
c
exit(0);会导致整个进程结束,其他线程也全部结束;而主线程执行:
c
pthread_exit(NULL);只会结束主线程,其他工作线程仍然可以继续运行.
可以简单记成:
pthread_exit()= 当前线程主动退出;exit()= 整个进程退出.
另外,pthread_exit()返回的指针不要指向线程自己的局部变量,例如:
c
void *rout(void *arg)
{
    int a = 100;
    pthread_exit(&a);   // 不推荐
}因为线程退出后,它自己的栈会失效,&a 也就不能再安全使用.
pthread_cancel() 用于向指定线程发送"取消请求" ,请求它结束执行.注意它不是像 kill -9 那样立刻强制杀死线程,目标线程是否以及何时退出,取决于它自己的取消状态和取消类型.
函数原型:
c
功能:取消⼀个执⾏中的线程
原型:int pthread_cancel(pthread_t thread);
参数:thread:线程ID
返回值:成功返回0;失败返回错误码
例如:
c
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

void *worker(void *arg)
{
    while (1)
    {
        printf("worker running...\n");
        sleep(1);
    }

    return NULL;
}

int main()
{
    pthread_t tid;

    pthread_create(&tid, NULL, worker, NULL);

    sleep(3);

    // 请求取消子线程
    pthread_cancel(tid);

    // 等待线程真正退出并回收资源
    pthread_join(tid, NULL);

    printf("worker stopped\n");

    return 0;
}
执行过程可以理解为:
text
主线程
   ↓
pthread_cancel(tid)
   ↓
发送取消请求
   ↓
目标线程运行到"取消点"
   ↓
线程终止
   ↓
pthread_join()
   ↓
回收线程资源
默认情况下,POSIX 线程采用延迟取消:
text
PTHREAD_CANCEL_DEFERRED也就是说:
收到取消请求后,不一定马上结束,而是运行到某个"取消点"才退出.
常见取消点包括:
c
sleep()
read()
write()
accept()
pthread_cond_wait()
例如:
c
while (1)
{
    printf("running\n");
    sleep(1);   // 这里通常是取消点
}
所以执行:
c
pthread_cancel(tid);后,线程通常会在 sleep() 等取消点响应取消.
线程也可以关闭取消功能:
c
pthread_setcancelstate(PTHREAD_CANCEL_DISABLE, NULL);重新开启:
c
pthread_setcancelstate(PTHREAD_CANCEL_ENABLE, NULL);还可以设置取消类型:
c
pthread_setcanceltype(PTHREAD_CANCEL_DEFERRED, NULL);表示延迟取消;或者:
c
pthread_setcanceltype(PTHREAD_CANCEL_ASYNCHRONOUS, NULL);表示异步取消,理论上线程可能在任意位置被取消,但这种方式风险很大,因为线程可能正持有锁或正在修改共享数据,因此一般不推荐.
如果线程因为 pthread_cancel() 被成功取消,pthread_join() 可以获取:
c
PTHREAD_CANCELED例如:
c
void *ret;

pthread_cancel(tid);
pthread_join(tid, &ret);

if (ret == PTHREAD_CANCELED)
{
    printf("thread was canceled\n");
}
可以简单记成:
pthread_cancel()= 请求目标线程退出;默认要等线程运行到取消点后才真正终止.
而:
text
pthread_exit()是线程自己主动退出,
text
pthread_cancel()是别的线程请求它退出.
3.4线程等待
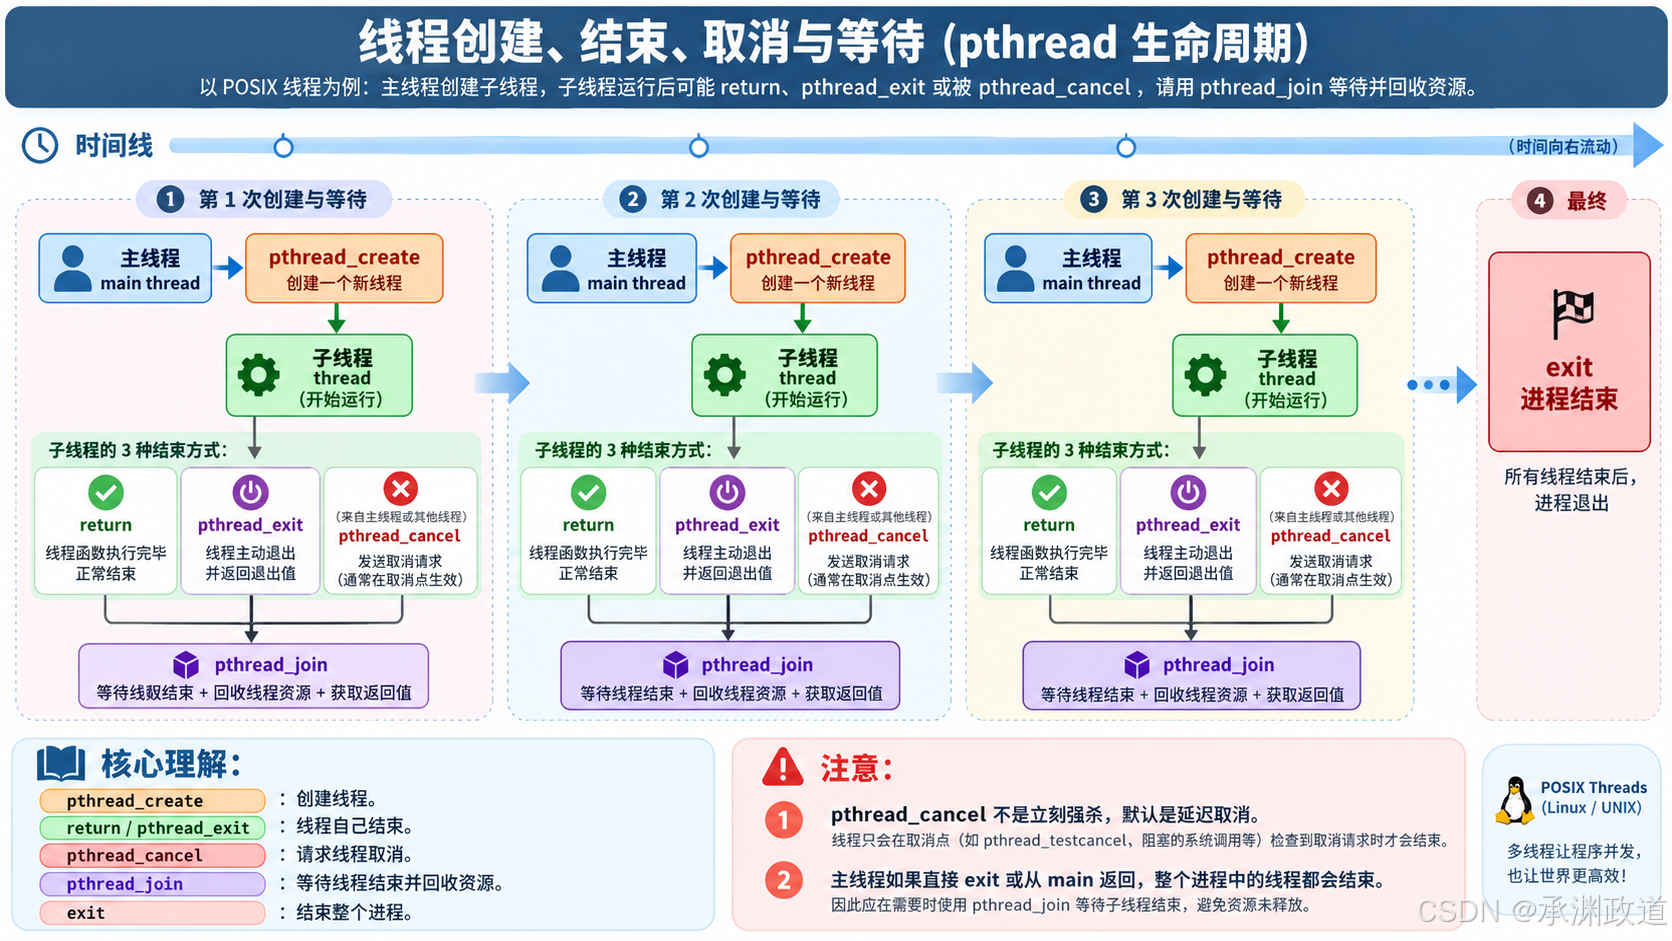
线程等待 通常指一个线程等待另一个线程结束,在 POSIX 线程中主要使用 pthread_join().它的作用有两个:一是让当前线程阻塞,直到目标线程退出;二是回收目标线程的相关资源,并且可以获取目标线程的返回值.函数原型是:
c
功能:等待线程结束
原型:int pthread_join(pthread_t thread, void **retval);
参数:thread:线程ID
     value_ptr:它指向⼀个指针,后者指向线程的返回值
返回值:成功返回0;失败返回错误码
调⽤该函数的线程将挂起等待,直到id为thread的线程终⽌.thread线程以不同的⽅法终⽌,通过
pthread_join得到的终⽌状态是不同的,总结如下:
- 如果thread线程通过return返回,value_ ptr所指向的单元⾥存放的是thread线程函数的返回值.
- 如果thread线程被别的线程调⽤pthread_ cancel异常终掉,value_ ptr所指向的单元⾥存放的是常数PTHREAD_ CANCELED.
- 如果thread线程是⾃⼰调⽤pthread_exit终⽌的,value_ptr所指向的单元存放的是传给pthread_exit的参数.
- 如果对thread线程的终⽌状态不感兴趣,可以传NULL给value_ ptr参数.
例如:
c
#include <stdio.h>
#include <pthread.h>

void *worker(void *arg)
{
    printf("子线程执行中...\n");
    return (void *)123;
}

int main()
{
    pthread_t tid;
    void *ret = NULL;

    pthread_create(&tid, NULL, worker, NULL);

    // 等待子线程结束
    pthread_join(tid, &ret);

    printf("子线程结束,返回值 = %ld\n", (long)ret);

    return 0;
}
执行过程可以理解为:
text
主线程
  ↓
pthread_create()
  ↓
子线程运行
  ↓
pthread_join(tid)
  ↓
主线程阻塞等待
  ↓
子线程结束
  ↓
主线程被唤醒
  ↓
回收子线程资源
  ↓
继续执行
需要注意,默认创建的线程是 joinable(可等待) 的.如果线程结束后一直没有被 pthread_join(),它的一部分资源会暂时保留;如果不打算等待线程,可以把线程设置为 detached(分离状态),这样线程结束后资源会自动回收.
可以简单记成:
pthread_join()= 等线程结束 + 获取返回值 + 回收线程资源.
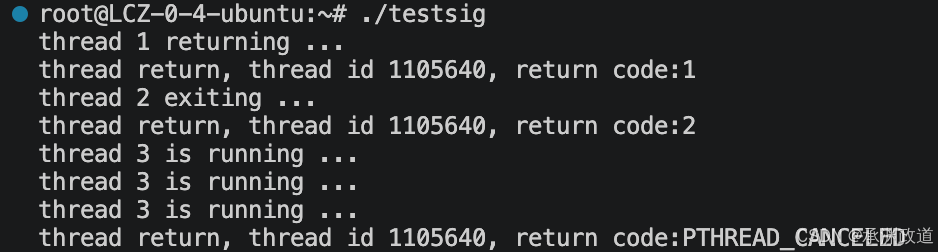
样例代码:
cpp
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
void *thread1(void *arg)
{
    printf("thread 1 returning ... \n");
    int *p = (int *)malloc(sizeof(int));
    *p = 1;
    return (void *)p;
}
void *thread2(void *arg)
{
    printf("thread 2 exiting ...\n");
    int *p = (int *)malloc(sizeof(int));
    *p = 2;
    pthread_exit((void *)p);
}
void *thread3(void *arg)
{
    while (1)
    { //
        printf("thread 3 is running ...\n");
        sleep(1);
    }
    return NULL;
}
int main(void)
{
    pthread_t tid;
    void *ret;
    // thread 1 return
    pthread_create(&tid, NULL, thread1, NULL);
    pthread_join(tid, &ret);
    printf("thread return, thread id %X, return code:%d\n", tid, *(int *)ret);
    free(ret);
    // thread 2 exit
    pthread_create(&tid, NULL, thread2, NULL);
    pthread_join(tid, &ret);
    printf("thread return, thread id %X, return code:%d\n", tid, *(int *)ret);
    free(ret);
    // thread 3 cancel by other
    pthread_create(&tid, NULL, thread3, NULL);
    sleep(3);
    pthread_cancel(tid);
    pthread_join(tid, &ret);
    if (ret == PTHREAD_CANCELED)
        printf("thread return, thread id %X, return code:PTHREAD_CANCELED\n",
               tid);
    else
        printf("thread return, thread id %X, return code:NULL\n", tid);
}
3.5分离线程
分离线程(Detached Thread) 是指线程创建后不再需要其他线程通过 pthread_join() 等待和回收它;线程一旦执行结束,系统会自动回收它的线程资源.默认情况下,pthread_create() 创建的是 joinable(可连接)线程 ,结束后通常需要 pthread_join() 回收;而分离线程可以通过 pthread_detach(tid) 设置:
c
pthread_t tid;

pthread_create(&tid, NULL, worker, NULL);
pthread_detach(tid);
线程也可以自己分离:
c
pthread_detach(pthread_self());之后线程正常执行:
c
void *worker(void *arg)
{
    printf("thread running\n");
    return NULL;    // 结束后资源自动回收
}需要注意,分离线程不能再被 pthread_join() 等待,否则会失败.因此可以简单记成:
普通线程:结束 →
pthread_join()→ 回收资源;分离线程:结束 → 系统自动回收资源。
分离线程比较适合"创建后独立完成任务,不关心返回值"的场景,例如服务器中处理一次请求的工作线程.
joinable和分离是冲突的,⼀个线程不能既是joinable⼜是分离的.
cpp
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <pthread.h>
void *thread_run(void *arg)
{
    pthread_detach(pthread_self());
    printf("%s\n", (char *)arg);
    return NULL;
}
int main(void)
{
    pthread_t tid;
    if (pthread_create(&tid, NULL, thread_run, "thread1 run...") != 0)
    {
        printf("create thread error\n");
        return 1;
    }
    int ret = 0;
    sleep(1); // 很重要,要让线程先分离,再等待
    if (pthread_join(tid, NULL) == 0)
    {
        printf("pthread wait success\n");
        ret = 0;
    }
    else
    {
        printf("pthread wait failed\n");
        ret = 1;
    }
    return ret;
}
4.线程ID及进程地址空间布局
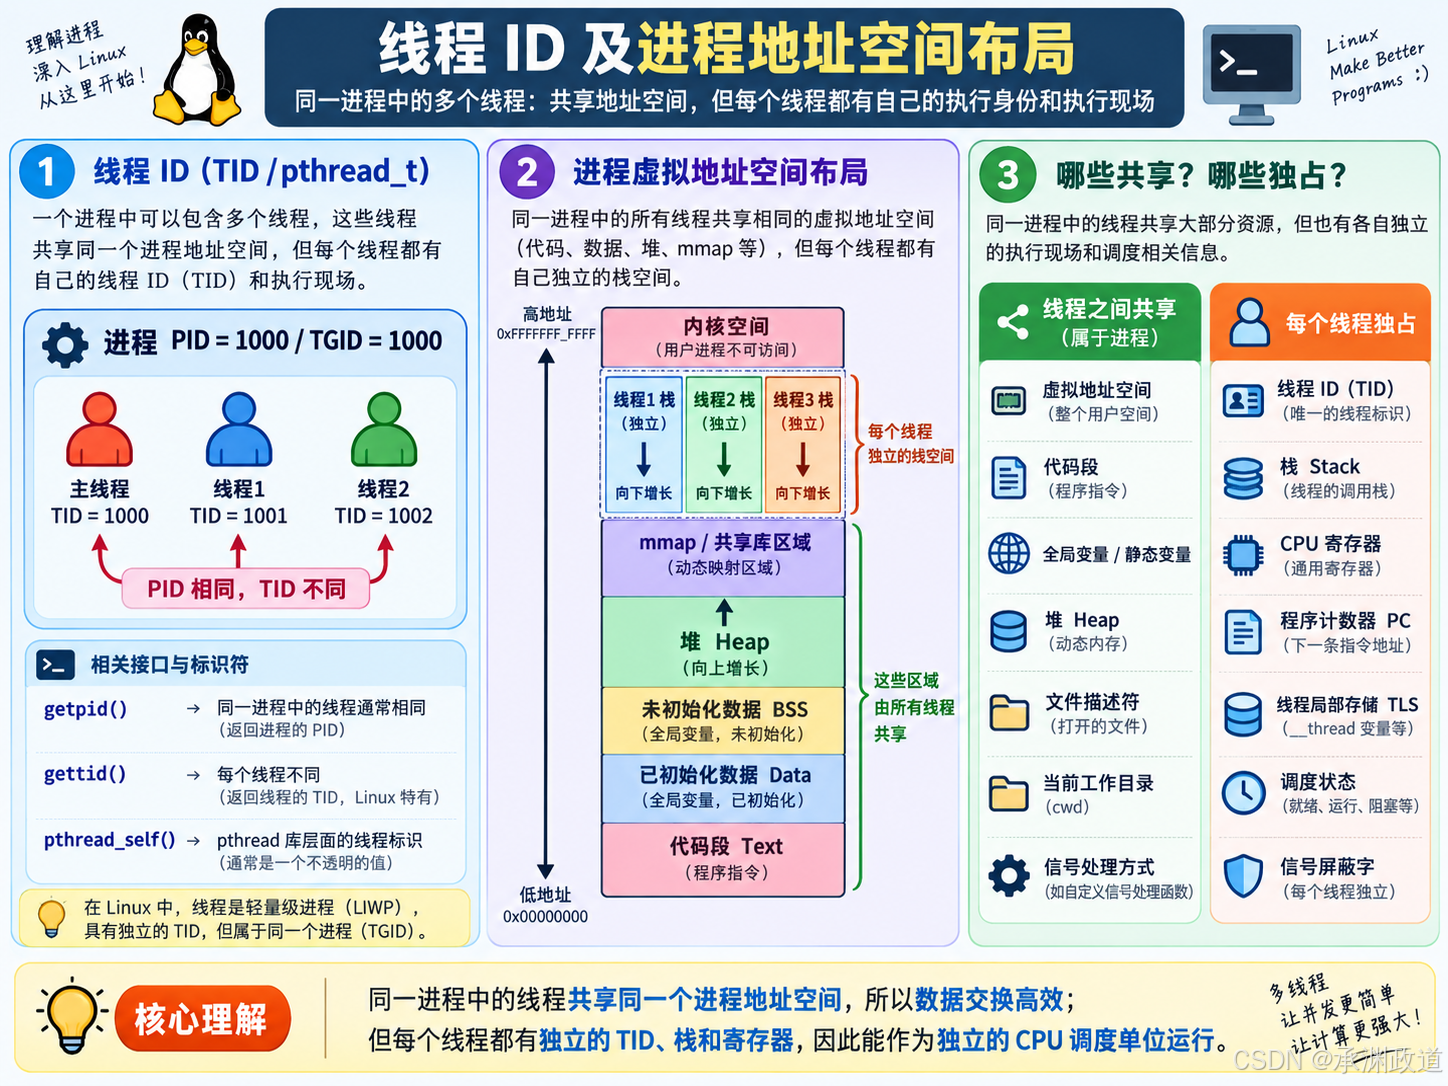
线程ID和进程地址空间布局 可以一起理解:同一进程中的多个线程共享同一个虚拟地址空间,但每个线程都有自己独立的执行身份和执行现场.
1.Linux中的线程ID
在Linux内核看来,每个线程都是一个独立的 task_struct,因此每个线程都有自己的 TID.
text
一个进程
PID/TGID = 1000

├── 主线程  TID = 1000
├── 线程1   TID = 1001
├── 线程2   TID = 1002
└── 线程3   TID = 1003
几个常见接口要区分:
c
getpid();        // 同一进程所有线程通常得到相同的进程ID
gettid();        // 每个线程不同的内核TID
pthread_self();  // POSIX线程库使用的线程标识
其中:
pthread_t/pthread_self()是POSIX层面的线程标识,不能简单等同于 Linux 内核的 TID.
在Linux中,主线程通常满足:
text
PID == 主线程 TID其他线程:
text
PID相同,TID不同2.一个多线程进程的地址空间
例如一个进程有三个线程:
text
高地址
┌─────────────────────────────┐
│        内核空间              │
├─────────────────────────────┤
│  Thread 1 Stack             │ ← 线程1独立
├─────────────────────────────┤
│  Thread 2 Stack             │ ← 线程2独立
├─────────────────────────────┤
│  Thread 3 Stack             │ ← 线程3独立
├─────────────────────────────┤
│        mmap 映射区           │ ← 共享
│  动态库 / mmap / 共享内存    │
├─────────────────────────────┤
│                             │
│          Heap 堆            │ ← 共享
│             ↑               │
├─────────────────────────────┤
│          BSS                │ ← 共享
│   未初始化全局/静态变量      │
├─────────────────────────────┤
│          Data               │ ← 共享
│   已初始化全局/静态变量      │
├─────────────────────────────┤
│          Text               │ ← 共享
│          代码段              │
└─────────────────────────────┘
低地址
所以多个线程:
共享:
- 代码段
- 数据段
- BSS
- Heap
- mmap 映射区域
- 全局变量、静态变量
- 文件描述符
- 整个进程虚拟地址空间
但是每个线程都有自己的:
- 用户栈
- CPU 寄存器
- 程序计数器 PC
- TID
- TLS(Thread Local Storage)
- 调度状态
- 信号屏蔽字
3.为什么线程的栈独立,但还说共享地址空间?
这是一个很容易混淆的地方.
三个线程的栈其实都存在于同一个进程虚拟地址空间中:
text
同一个虚拟地址空间

┌──────────────────┐
│ Thread 1 Stack   │
├──────────────────┤
│ Thread 2 Stack   │
├──────────────────┤
│ Thread 3 Stack   │
├──────────────────┤
│ Heap             │
├──────────────────┤
│ Data             │
├──────────────────┤
│ Code             │
└──────────────────┘
只是操作系统为每个线程划出不同的区域作为它自己的栈.
所以从地址空间角度:
栈区域仍属于同一个进程地址空间。
从线程使用角度:
每个线程只使用自己的栈。
4.为什么每个线程必须有独立的栈?
因为不同线程可能同时调用同一个函数:
c
void func()
{
    int a = 10;
    int b = 20;
}
线程1:
text
Thread 1 Stack

a = 10
b = 20
返回地址
线程2:
text
Thread 2 Stack

a = 10
b = 20
返回地址
如果栈也共享,它们的局部变量、函数调用和返回地址就会互相覆盖.
因此:
线程共享数据,但必须有各自独立的函数调用栈。
5.pthread_self() 看什么?
例如:
c
#include <stdio.h>
#include <pthread.h>

void *worker(void *arg)
{
    printf("pthread id = %lu\n",
           (unsigned long)pthread_self());

    return NULL;
}
它得到:
text
pthread_t这是 pthread 库识别线程使用的标识.
如果想看Linux内核的TID,可以使用:
c
#include <unistd.h>
#include <sys/syscall.h>

pid_t tid = syscall(SYS_gettid);
然后:
c
printf("PID = %d\n", getpid());
printf("TID = %d\n", tid);
两个线程可能输出:
text
线程1:
PID = 1000
TID = 1001

线程2:
PID = 1000
TID = 1002
这就非常直观:
text
同一个 PID
    ↓
同一个进程
    ↓
共享地址空间

不同 TID
    ↓
不同线程
    ↓
CPU可以分别调度
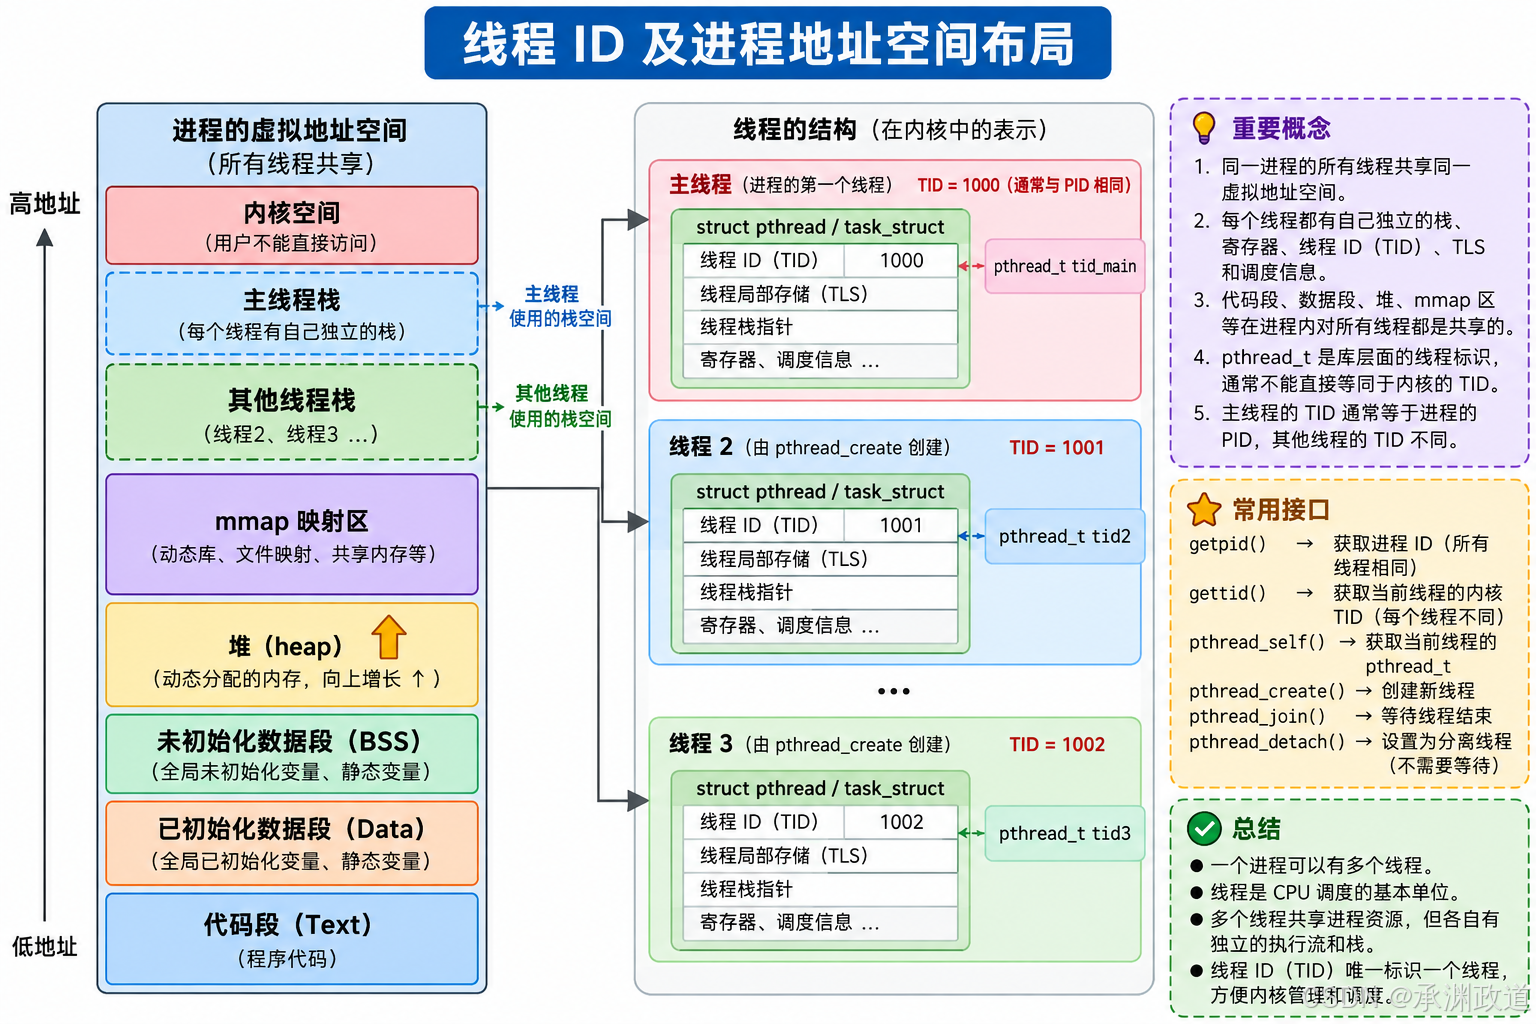
• pthread_ create函数会产⽣⼀个线程ID,存放在第⼀个参数指向的地址中.该线程ID和前⾯说的线程ID不是⼀回事.
• 前⾯讲的线程ID属于进程调度的范畴.因为线程是轻量级进程,是操作系统调度器的最⼩单位,所以需要⼀个数值来唯⼀表示该线程.
• pthread_ create函数第⼀个参数指向⼀个虚拟内存单元,该内存单元的地址即为新创建线程的线程ID,属于NPTL线程库的范畴.线程库的后续操作,就是根据该线程ID来操作线程的.
• 线程库NPTL提供了pthread_ self函数,可以获得线程⾃⾝的ID:pthread_t pthread_self(void);
pthread_t 到底是什么类型呢?取决于实现.对于Linux⽬前实现的NPTL实现⽽⾔,pthread_t类
型的线程ID,本质就是⼀个进程地址空间上的⼀个地址.
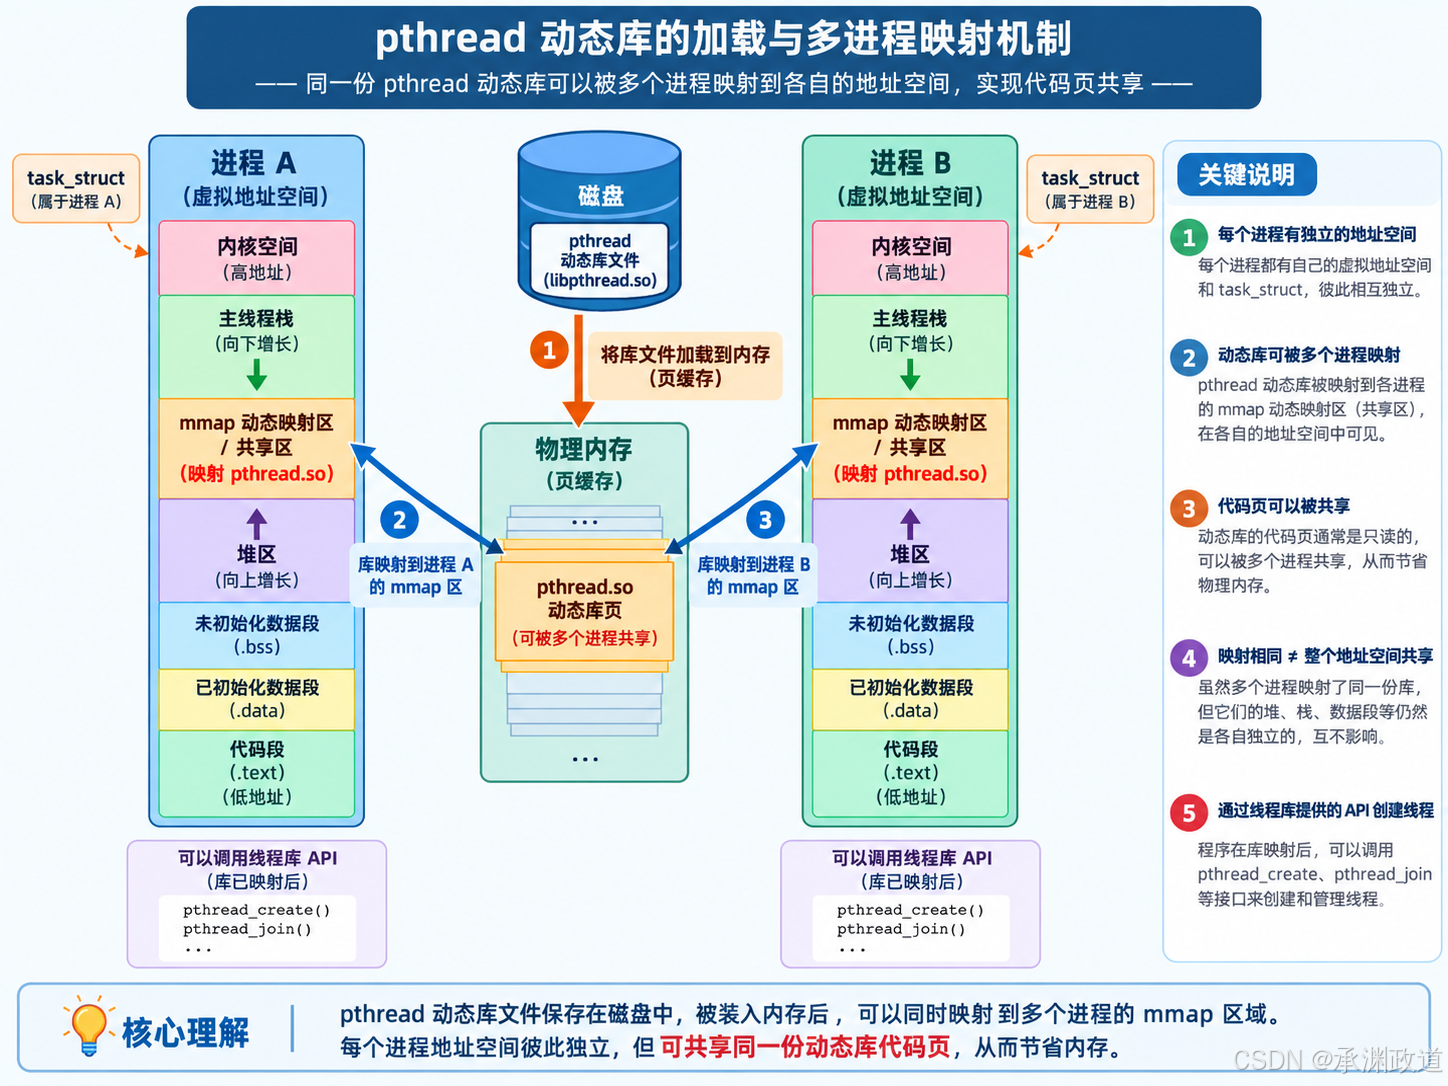
一句话总结
Linux中,同一进程的多个线程拥有不同的TID、栈、寄存器和执行上下文,但共享同一个进程的虚拟地址空间、代码段、数据段和堆;因此线程既能高效共享数据,又能作为独立的CPU调度单位运行.
5.线程封装
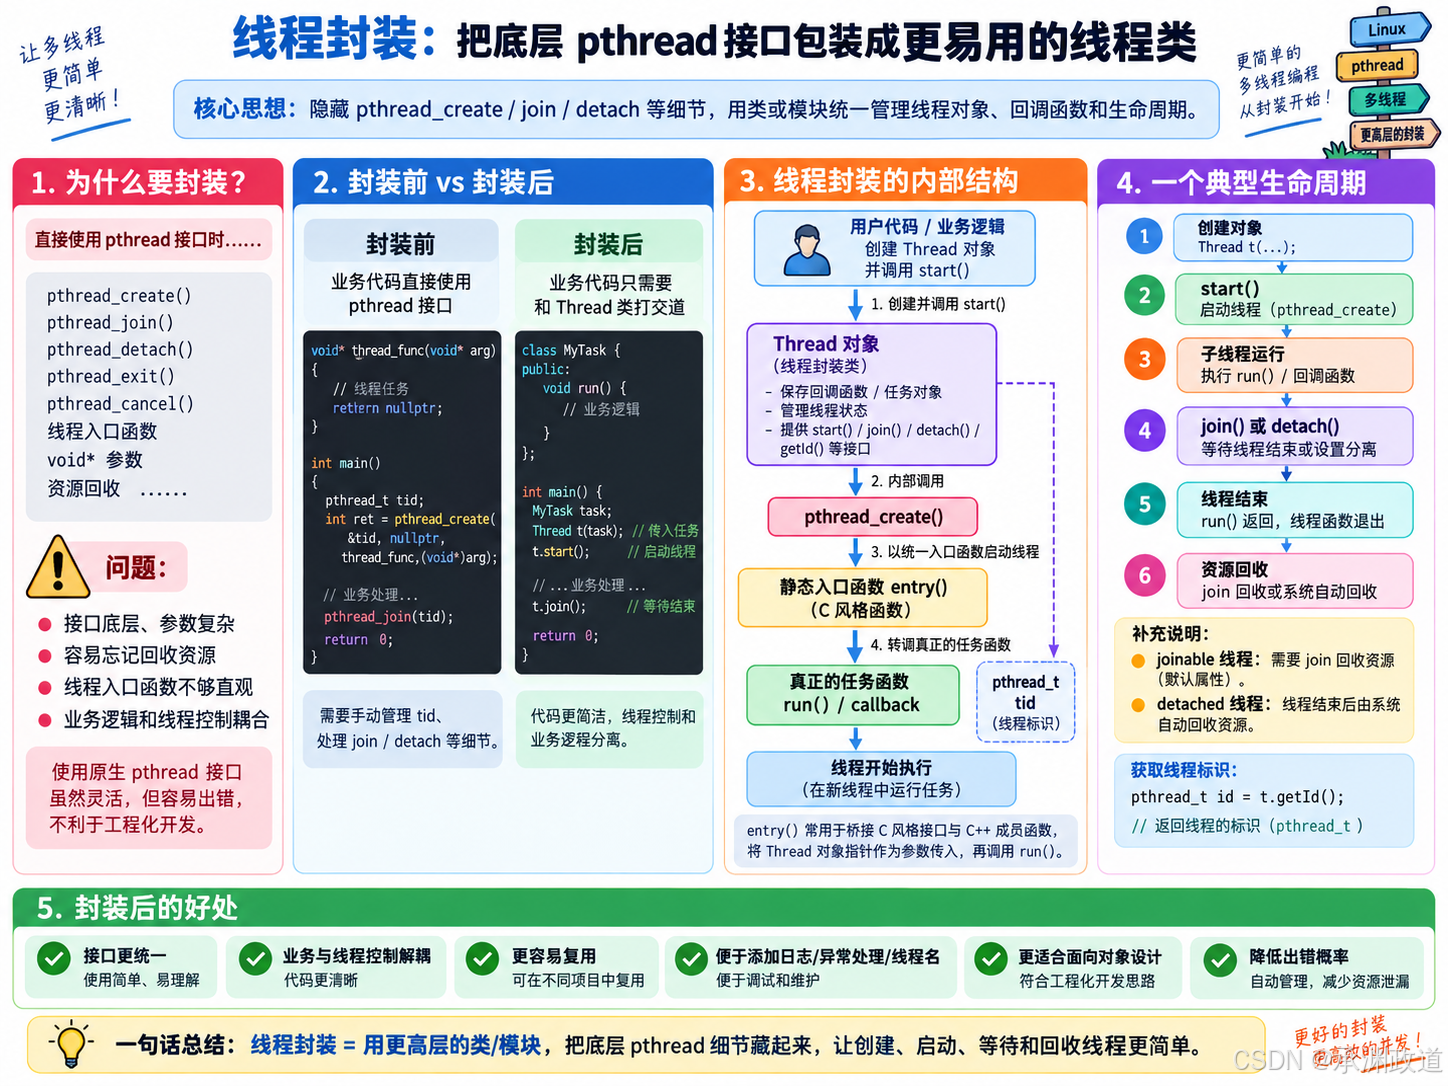
cpp
//Thread.hpp
#pragma once
#include <iostream>
#include <string>
#include <functional>
#include <pthread.h>
namespace ThreadModule
{
    // 原⼦计数器,⽅便形成线程名称
    std::uint32_t cnt = 0;
    // 线程要执⾏的外部⽅法,我们不考虑传参,后续有std::bind来进⾏类间耦合
    using threadfunc_t = std::function<void()>;
    // 线程状态
    enum class TSTATUS
    {
        THREAD_NEW,
        THREAD_RUNNING,
        THREAD_STOP
    };
    // 线程
    class Thread
    {
    private:
        static void *run(void *obj)
        {
            Thread *self = static_cast<Thread *>(obj);
            pthread_setname_np(pthread_self(), self->_name.c_str()); // 设置线
            程名称
            self->_status = TSTATUS::THREAD_RUNNING;
            if (!self->_joined)
            {
                pthread_detach(pthread_self());
            }
            self->_func();
            return nullptr;
        }
        void SetName()
        {
            // 后期加锁保护
            _name = "Thread-" + std::to_string(cnt++);
        }

    public:
        Thread(threadfunc_t func) : _status(TSTATUS::THREAD_NEW),
                                    _joined(true), _func(func)
        {
            SetName();
        }
        void EnableDetach()
        {
            if (_status == TSTATUS::THREAD_NEW)
                _joined = false;
        }
        void EnableJoined()
        {
            if (_status == TSTATUS::THREAD_NEW)
                _joined = true;
        }
        bool Start()
        {
            if (_status == TSTATUS::THREAD_RUNNING)
                return true;
            int n = ::pthread_create(&_id, nullptr, run, this);
            if (n != 0)
                return false;
            return true;
        }
        bool Join()
        {
            if (_joined)
            {
                int n = pthread_join(_id, nullptr);
                if (n != 0)
                    return false;
                return true;
            }
            return false;
        }
        ~Thread() {}

    private:
        std::string _name;
        pthread_t _id;
        TSTATUS _status;
        bool _joined;
        threadfunc_t _func;
    };
}
cpp
// main.cc
#include <iostream>
#include <unistd.h>
#include "Thread.hpp"
void hello1()
{
    char buffer[64];
    pthread_getname_np(pthread_self(), buffer, sizeof(buffer) - 1);
    while (true)
    {
        std::cout << "hello world, " << buffer << std::endl;
        sleep(1);
    }
}
void hello2()
{
    char buffer[64];
    pthread_getname_np(pthread_self(), buffer, sizeof(buffer) - 1);
    while (true)
    {
        std::cout << "hello world, " << buffer << std::endl;
        sleep(1);
    }
}
int main()
{
    pthread_setname_np(pthread_self(), "main");
    ThreadModule::Thread t1(hello1);
    t1.Start();
    ThreadModule::Thread t2(std::bind(&hello2));
    t2.Start();
    t1.Join();
    t2.Join();
    return 0;
}
pthread_setname_np和pthread_getname_np是两个⽤于设置和获取线程名称的⾮标准函数(_np 表示"non-portable",即⾮可移植的).它们通常在Linux和其他⼀些类Unix系统中可⽤,⽤于调试和多线程程序的管理线程名称⻓度限制:在Linux上,线程名称的最⼤⻓度为16个字符(包括结尾的\0).如果名称超过这个⻓度,会被截断.权限:通常,只有线程⾃⾝可以设置⾃⼰的名称.尝试设置其他线程的名称可能会导致错误.
6.附录---源码阅读以及相关拓展
6.1源码阅读---理解线程
cpp
int __pthread_create_2_1(newthread, attr, start_routine, arg)
pthread_t *newthread;
const pthread_attr_t *attr;
void *(*start_routine)(void *);
void *arg;
{
    STACK_VARIABLES;
    // 重点1: 线程属性,虽然我们不设置,但是不妨碍我们了解
    const struct pthread_attr *iattr = (struct pthread_attr *)attr;
    if (iattr == NULL)
        /* Is this the best idea? On NUMA machines this could mean
        accessing far-away memory. */
        iattr = &default_attr;
    // 重点2:传说中的原⽣线程库中的⽤来描述线程的tcb
    struct pthread *pd = NULL;
    // 重点3: ALLOCATE_STACK会在先申请struct pthread对象,当然其实是申请⼀⼤块空间,
    // struct pthread在空间的开头,⼀会追
    int err = ALLOCATE_STACK(iattr, &pd);
    if (__builtin_expect(err != 0, 0))
        /* Something went wrong. Maybe a parameter of the attributes is
        invalid or we could not allocate memory. */
        versioned_symbol return err;
/* Initialize the TCB. All initializations with zero should be
performed in 'get_cached_stack'. This way we avoid doing this if
the stack freshly allocated with 'mmap'. */
#ifdef TLS_TCB_AT_TP
    /* Reference to the TCB itself. */
    pd->header.self = pd;
    /* Self-reference for TLS. */
    pd->header.tcb = pd;
#endif
    /* Store the address of the start routine and the parameter. Since
    we do not start the function directly the stillborn thread will
    get the information from its thread descriptor. */
    // 重点4:向线程tcb中设置未来要执⾏的⽅法的地址和参数
    pd->start_routine = start_routine;
    pd->arg = arg;
    /* Copy the thread attribute flags. */
    struct pthread *self = THREAD_SELF;
    pd->flags = ((iattr->flags & ~(ATTR_FLAG_SCHED_SET | ATTR_FLAG_POLICY_SET)) | (self->flags & (ATTR_FLAG_SCHED_SET | ATTR_FLAG_POLICY_SET)));
    /* Initialize the field for the ID of the thread which is waiting
    for us. This is a self-reference in case the thread is created
    detached. */
    pd->joinid = iattr->flags & ATTR_FLAG_DETACHSTATE ? pd : NULL;
    /* The debug events are inherited from the parent. */
    pd->eventbuf = self->eventbuf;
    /* Copy the parent's scheduling parameters. The flags will say what
    is valid and what is not. */
    pd->schedpolicy = self->schedpolicy;
    pd->schedparam = self->schedparam;
/* Copy the stack guard canary. */
#ifdef THREAD_COPY_STACK_GUARD
    THREAD_COPY_STACK_GUARD(pd);
#endif
/* Copy the pointer guard value. */
#ifdef THREAD_COPY_POINTER_GUARD
    THREAD_COPY_POINTER_GUARD(pd);
#endif
    // ⼀堆参数设定,我们不关⼼
    /* Determine scheduling parameters for the thread. */
    if (attr != NULL && __builtin_expect((iattr->flags & ATTR_FLAG_NOTINHERITSCHED) != 0, 0) && (iattr->flags & (ATTR_FLAG_SCHED_SET | ATTR_FLAG_POLICY_SET)) != 0)
    {
        INTERNAL_SYSCALL_DECL(scerr);
        /* Use the scheduling parameters the user provided. */
        if (iattr->flags & ATTR_FLAG_POLICY_SET)
            pd->schedpolicy = iattr->schedpolicy;
        else if ((pd->flags & ATTR_FLAG_POLICY_SET) == 0)
        {
            pd->schedpolicy = INTERNAL_SYSCALL(sched_getscheduler, scerr, 1, 0);
            pd->flags |= ATTR_FLAG_POLICY_SET;
        }
        if (iattr->flags & ATTR_FLAG_SCHED_SET)
            memcpy(&pd->schedparam, &iattr->schedparam,
                   sizeof(struct sched_param));
        else if ((pd->flags & ATTR_FLAG_SCHED_SET) == 0)
        {
            INTERNAL_SYSCALL(sched_getparam, scerr, 2, 0, &pd->schedparam);
            pd->flags |= ATTR_FLAG_SCHED_SET;
        }
        /* Check for valid priorities. */
        int minprio = INTERNAL_SYSCALL(sched_get_priority_min, scerr, 1,
                                       iattr->schedpolicy);
        int maxprio = INTERNAL_SYSCALL(sched_get_priority_max, scerr, 1,
                                       iattr->schedpolicy);
        if (pd->schedparam.sched_priority < minprio || pd -
                                                           > schedparam.sched_priority > maxprio)
        {
            err = EINVAL;
            goto errout;
        }
    }
    /* Pass the descriptor to the caller. */
    // 重点5:把pd(就是线程控制块地址)作为ID,传递出去,所以上层拿到的就是⼀个虚拟地址
    *newthread = (pthread_t)pd;
    /* Remember whether the thread is detached or not. In case of an
    error we have to free the stacks of non-detached stillborn
    threads. */
    // 重点6: 检测线程属性是否分离,这个很好理解
    bool is_detached = IS_DETACHED(pd);
    /* Start the thread. */
    err = create_thread(pd, iattr, STACK_VARIABLES_ARGS); // 重点函数
    if (err != 0)
    {
        /* Something went wrong. Free the resources. */
        if (!is_detached)
        {
        errout:
            __deallocate_stack(pd);
        }
        return err;
    }
    return 0;
}
// 版本确认信息,意思就是如果⽤的库是GLIBC_2_1,pthread_create函数就是
__pthread_create_2_1
    versioned_symbol(libpthread, __pthread_create_2_1, pthread_create, GLIBC_2_1);
线程属性:
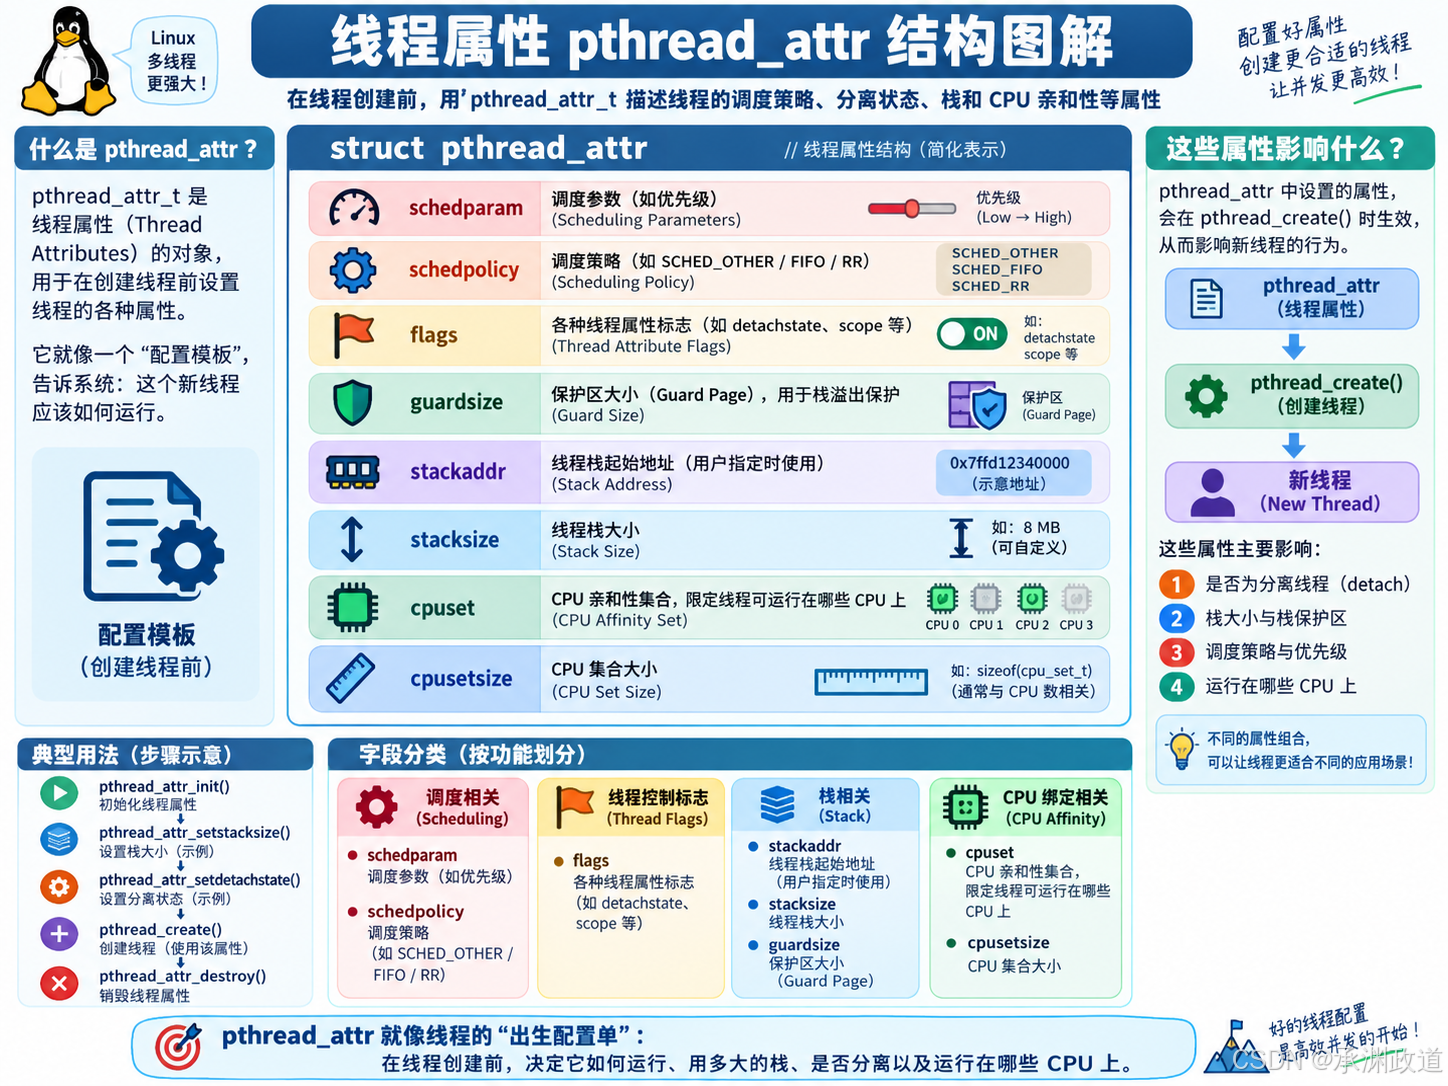
cpp
struct pthread_attr
{
    /* Scheduler parameters and priority. */
    struct sched_param schedparam;
    int schedpolicy;
    /* Various flags like detachstate, scope, etc. */
    int flags;
    /* Size of guard area. */
    size_t guardsize;
    /* Stack handling. */
    void *stackaddr;
    size_t stacksize;
    /* Affinity map. */
    cpu_set_t *cpuset;
    size_t cpusetsize;
};
线程tcb:
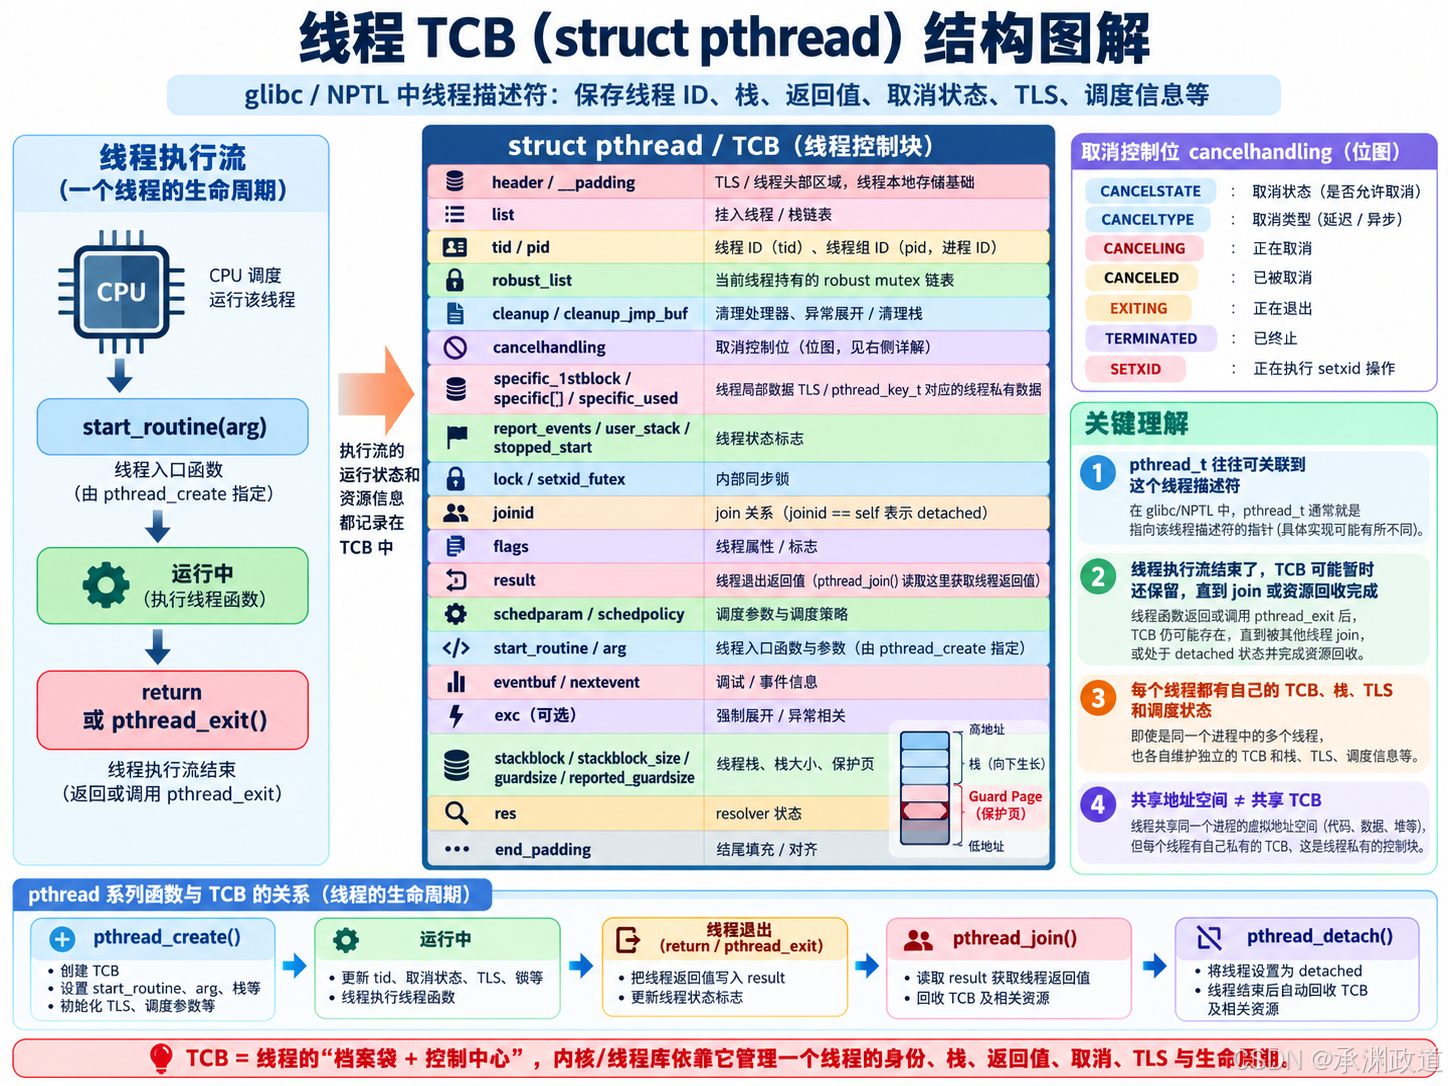
cpp
/* Thread descriptor data structure. */
struct pthread
{
    union
    {
#if !TLS_DTV_AT_TP
        /* This overlaps the TCB as used for TLS without threads (see tls.h). */
        tcbhead_t header;
#else
        struct
        {
            int multiple_threads;
        } header;
#endif
        /* This extra padding has no special purpose, and this structure layout
        is private and subject to change without affecting the official ABI.
        We just have it here in case it might be convenient for some
        implementation-specific instrumentation hack or suchlike. */
        void *__padding[16];
    };
    /* This descriptor's link on the `stack_used' or `__stack_user' list. */
    list_t list;
    /* Thread ID - which is also a 'is this thread descriptor (and
    therefore stack) used' flag. */
    pid_t tid;
    /* Process ID - thread group ID in kernel speak. */
    pid_t pid;
/* List of robust mutexes the thread is holding. */
#ifdef __PTHREAD_MUTEX_HAVE_PREV
    __pthread_list_t robust_list;
#define ENQUEUE_MUTEX(mutex) \
    do                       \
    {                        \
        __pthread_list_t *next = THREAD_GETMEM(THREAD_SELF, robust_list.__next);

    next->__prev = &mutex->__data.__list;
    mutex->__data.__list.__next = next;
    mutex->__data.__list.__prev = &THREAD_SELF->robust_list;
    THREAD_SETMEM(THREAD_SELF, robust_list.__next, &mutex->__data.__list);

} while (0)
#define DEQUEUE_MUTEX(mutex) \
    do                       \
    {                        \
        mutex->__data.__list.__next->__prev = mutex->__data.__list.__prev;

    mutex->__data.__list.__prev->__next = mutex->__data.__list.__next;

mutex->__data.__list.__prev = NULL;
mutex->__data.__list.__next = NULL;
}
while (0)
#else
    __pthread_slist_t robust_list;
#define ENQUEUE_MUTEX(mutex)                                                          \
    do                                                                                \
    {                                                                                 \
        mutex->__data.__list.__next = THREAD_GETMEM(THREAD_SELF, robust_list.__next); \
        THREAD_SETMEM(THREAD_SELF, robust_list.__next, &mutex->__data.__list);

} while (0)
#define DEQUEUE_MUTEX(mutex) \
    do                       \
    {                        \
__pthread_slist_t *runp = THREAD_GETMEM (THREAD_SELF,
robust_list.__next);
if (runp == &mutex->__data.__list)
    THREAD_SETMEM(THREAD_SELF, robust_list.__next, runp->__next);
else
{
    while (runp->__next != &mutex->__data.__list)
        runp = runp->__next;

    runp->__next = runp->__next->__next;
    mutex->__data.__list.__next = NULL;
}
}
while (0)
#endif
    /* List of cleanup buffers. */
    struct _pthread_cleanup_buffer *cleanup;
/* Unwind information. */
struct pthread_unwind_buf *cleanup_jmp_buf;
#define HAVE_CLEANUP_JMP_BUF
/* Flags determining processing of cancellation. */
int cancelhandling;
/* Bit set if cancellation is disabled. */
#define CANCELSTATE_BIT 0
#define CANCELSTATE_BITMASK 0x01
/* Bit set if asynchronous cancellation mode is selected. */
#define CANCELTYPE_BIT 1
#define CANCELTYPE_BITMASK 0x02
/* Bit set if canceling has been initiated. */
#define CANCELING_BIT 2
#define CANCELING_BITMASK 0x04
/* Bit set if canceled. */
#define CANCELED_BIT 3
#define CANCELED_BITMASK 0x08
/* Bit set if thread is exiting. */
#define EXITING_BIT 4
#define EXITING_BITMASK 0x10
/* Bit set if thread terminated and TCB is freed. */
#define TERMINATED_BIT 5
#define TERMINATED_BITMASK 0x20
/* Bit set if thread is supposed to change XID. */
#define SETXID_BIT 6
#define SETXID_BITMASK 0x40
/* Mask for the rest. Helps the compiler to optimize. */
#define CANCEL_RESTMASK 0xffffff80
#define CANCEL_ENABLED_AND_CANCELED(value) \
(((value) & (CANCELSTATE_BITMASK | CANCELED_BITMASK | EXITING_BITMASK

| CANCEL_RESTMASK | TERMINATED_BITMASK)) == CANCELED_BITMASK)
#define CANCEL_ENABLED_AND_CANCELED_AND_ASYNCHRONOUS(value) \
(((value) & (CANCELSTATE_BITMASK | CANCELTYPE_BITMASK | CANCELED_BITMASK
\
| EXITING_BITMASK | CANCEL_RESTMASK | TERMINATED_BITMASK)) \
== (CANCELTYPE_BITMASK | CANCELED_BITMASK))
/* We allocate one block of references here. This should be enough
to avoid allocating any memory dynamically for most applications. */
struct pthread_key_data
{
    /* Sequence number. We use uintptr_t to not require padding on
    32- and 64-bit machines. On 64-bit machines it helps to avoid
    wrapping, too. */
    uintptr_t seq;
    /* Data pointer. */
    void *data;
} specific_1stblock[PTHREAD_KEY_2NDLEVEL_SIZE];
/* Two-level array for the thread-specific data. */
struct pthread_key_data *specific[PTHREAD_KEY_1STLEVEL_SIZE];
/* Flag which is set when specific data is set. */
bool specific_used;
/* True if events must be reported. */
bool report_events;
/* True if the user provided the stack. */
bool user_stack;
/* True if thread must stop at startup time. */
bool stopped_start;
/* Lock to synchronize access to the descriptor. */
lll_lock_t lock;
/* Lock for synchronizing setxid calls. */
lll_lock_t setxid_futex;
#if HP_TIMING_AVAIL
/* Offset of the CPU clock at start thread start time. */
hp_timing_t cpuclock_offset;
#endif
/* If the thread waits to join another one the ID of the latter is
stored here.
In case a thread is detached this field contains a pointer of the
TCB if the thread itself. This is something which cannot happen
in normal operation. */
struct pthread *joinid;
/* Check whether a thread is detached. */
#define IS_DETACHED(pd) ((pd)->joinid == (pd))
/* Flags. Including those copied from the thread attribute. */
int flags;
/* The result of the thread function. */
// 线程运⾏完毕,返回值就是void*, 最后的返回值就放在tcb中的该变量⾥⾯
// 所以我们⽤pthread_join获取线程退出信息的时候,就是读取该结构体
// 另外,要能理解线程执⾏流可以退出,但是tcb可以暂时保留,这句话
void *result;
/* Scheduling parameters for the new thread. */
struct sched_param schedparam;
int schedpolicy;
/* Start position of the code to be executed and the argument passed
to the function. */
// ⽤⼾指定的⽅法和参数
void *(*start_routine)(void *);
void *arg;
/* Debug state. */
td_eventbuf_t eventbuf;
/* Next descriptor with a pending event. */
struct pthread *nextevent;
#ifdef HAVE_FORCED_UNWIND
/* Machine-specific unwind info. */
struct _Unwind_Exception exc;
#endif
/* If nonzero pointer to area allocated for the stack and its
size. */
// 线程⾃⼰的栈和⼤⼩
void *stackblock;
size_t stackblock_size;
/* Size of the included guard area. */
size_t guardsize;
/* This is what the user specified and what we will report. */
size_t reported_guardsize;
/* Resolver state. */
struct __res_state res;
/* This member must be last. */
char end_padding[];
#define PTHREAD_STRUCT_END_PADDING \
    (sizeof(struct pthread) - offsetof(struct pthread, end_padding))
}
__attribute((aligned(TCB_ALIGNMENT)));
创建线程:
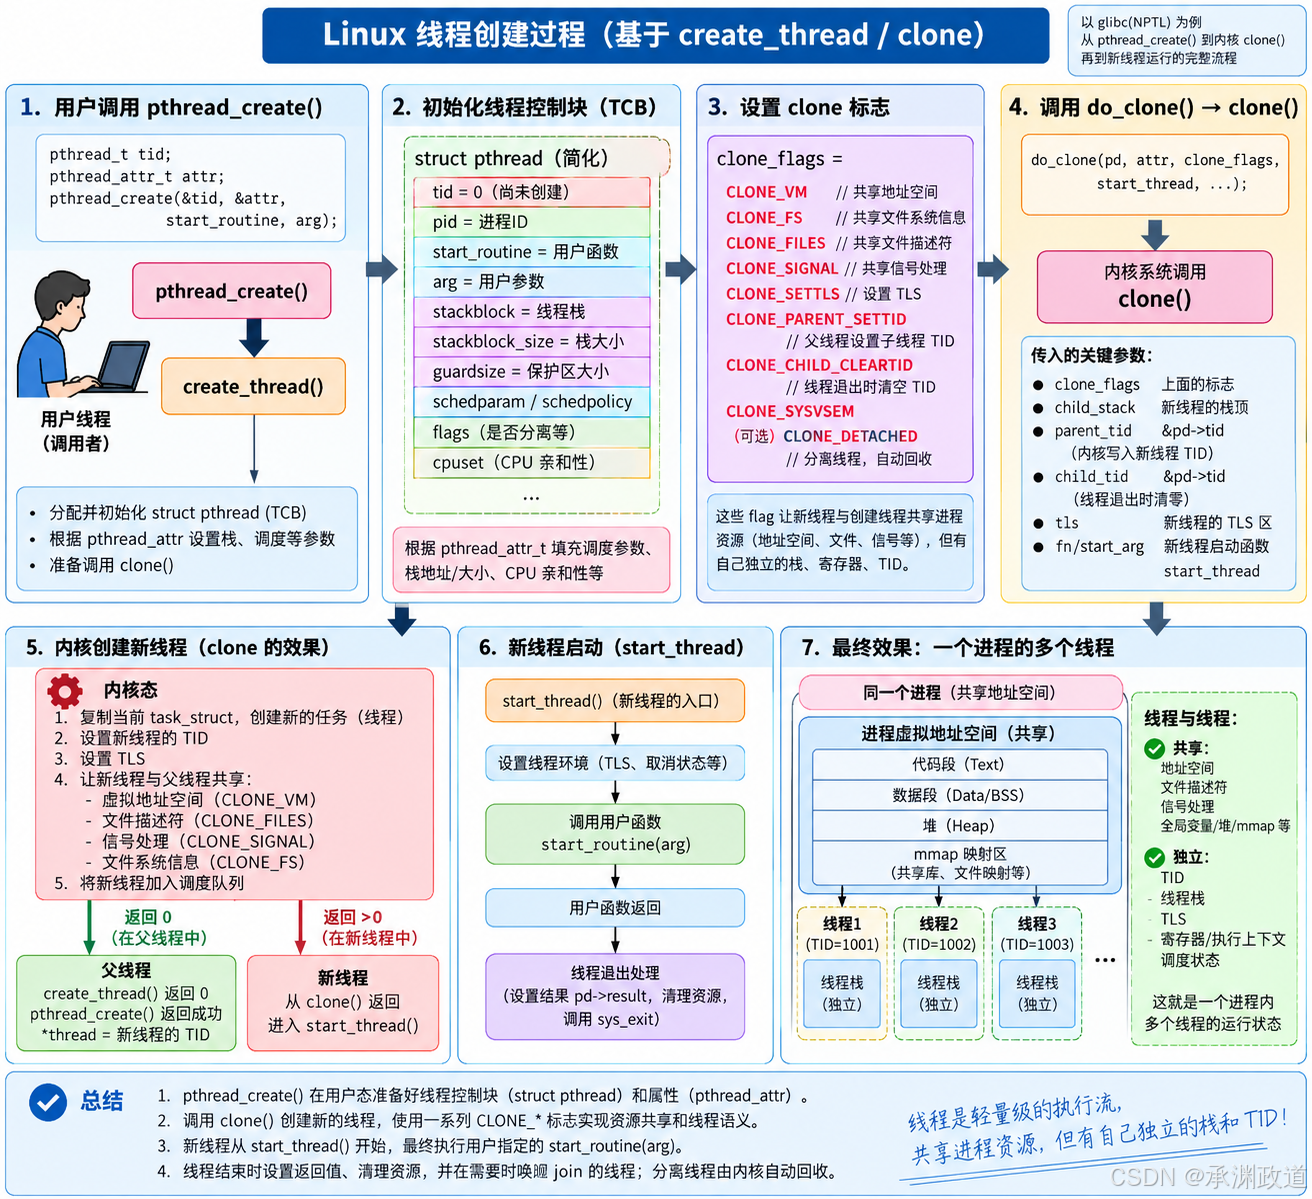
cpp
tatic int
create_thread(struct pthread *pd, const struct pthread_attr *attr,
              STACK_VARIABLES_PARMS)
{
#ifdef TLS_TCB_AT_TP
    assert(pd->header.tcb != NULL);
#endif
    /* We rely heavily on various flags the CLONE function understands:
    CLONE_VM, CLONE_FS, CLONE_FILES
    These flags select semantics with shared address space and
    file descriptors according to what POSIX requires.
    CLONE_SIGNAL
    This flag selects the POSIX signal semantics.
    CLONE_SETTLS
    The sixth parameter to CLONE determines the TLS area for the
    new thread.
    CLONE_PARENT_SETTID
    The kernels writes the thread ID of the newly created thread
    into the location pointed to by the fifth parameters to CLONE.
    Note that it would be semantically equivalent to use
    CLONE_CHILD_SETTID but it is be more expensive in the kernel.
    CLONE_CHILD_CLEARTID
    The kernels clears the thread ID of a thread that has called
    sys_exit() in the location pointed to by the seventh parameter
    to CLONE.
    CLONE_DETACHED
    No signal is generated if the thread exists and it is
    automatically reaped.
    The termination signal is chosen to be zero which means no signal
    is sent. */
    int clone_flags = (CLONE_VM | CLONE_FS | CLONE_FILES | CLONE_SIGNAL |
                       CLONE_SETTLS | CLONE_PARENT_SETTID | CLONE_CHILD_CLEARTID | CLONE_SYSVSEM
#if __ASSUME_NO_CLONE_DETACHED == 0
                       | CLONE_DETACHED
#endif
                       | 0);
    if (__builtin_expect(THREAD_GETMEM(THREAD_SELF, report_events), 0))
    {
        /* The parent thread is supposed to report events. Check whether
        the TD_CREATE event is needed, too. */
        const int _idx = __td_eventword(TD_CREATE);
        const uint32_t _mask = __td_eventmask(TD_CREATE);
        if ((_mask & (__nptl_threads_events.event_bits[_idx] | pd -
                                                                   > eventbuf.eventmask.event_bits[_idx])) != 0)
        {
            /* We always must have the thread start stopped. */
            pd->stopped_start = true;
            /* Create the thread. We always create the thread stopped
            so that it does not get far before we tell the debugger. */
            int res = do_clone(pd, attr, clone_flags, start_thread,
                               STACK_VARIABLES_ARGS, 1);
            if (res == 0)
            {
                /* Now fill in the information about the new thread in
                the newly created thread's data structure. We cannot let
                the new thread do this since we don't know whether it was
                already scheduled when we send the event. */
                pd->eventbuf.eventnum = TD_CREATE;
                pd->eventbuf.eventdata = pd;
                /* Enqueue the descriptor. */
                do
                    pd->nextevent = __nptl_last_event;
                while (atomic_compare_and_exchange_bool_acq(&__nptl_last_event,
                                                            pd, pd->nextevent) != 0);
                /* Now call the function which signals the event. */
                __nptl_create_event();
                /* And finally restart the new thread. */
                lll_unlock(pd->lock);
            }
            return res;
        }
    }
#ifdef NEED_DL_SYSINFO
    assert(THREAD_SELF_SYSINFO == THREAD_SYSINFO(pd));
#endif
    /* Determine whether the newly created threads has to be started
    stopped since we have to set the scheduling parameters or set the
    affinity. */
    bool stopped = false;
    if (attr != NULL && (attr->cpuset != NULL || (attr->flags &
                                                  ATTR_FLAG_NOTINHERITSCHED) != 0))
        stopped = true;
    pd->stopped_start = stopped;
    /* Actually create the thread. */
    int res = do_clone(pd, attr, clone_flags, start_thread,
                       STACK_VARIABLES_ARGS, stopped);
    if (res == 0 && stopped)
        /* And finally restart the new thread. */
        lll_unlock(pd->lock);
    return res;
}
执行克隆:
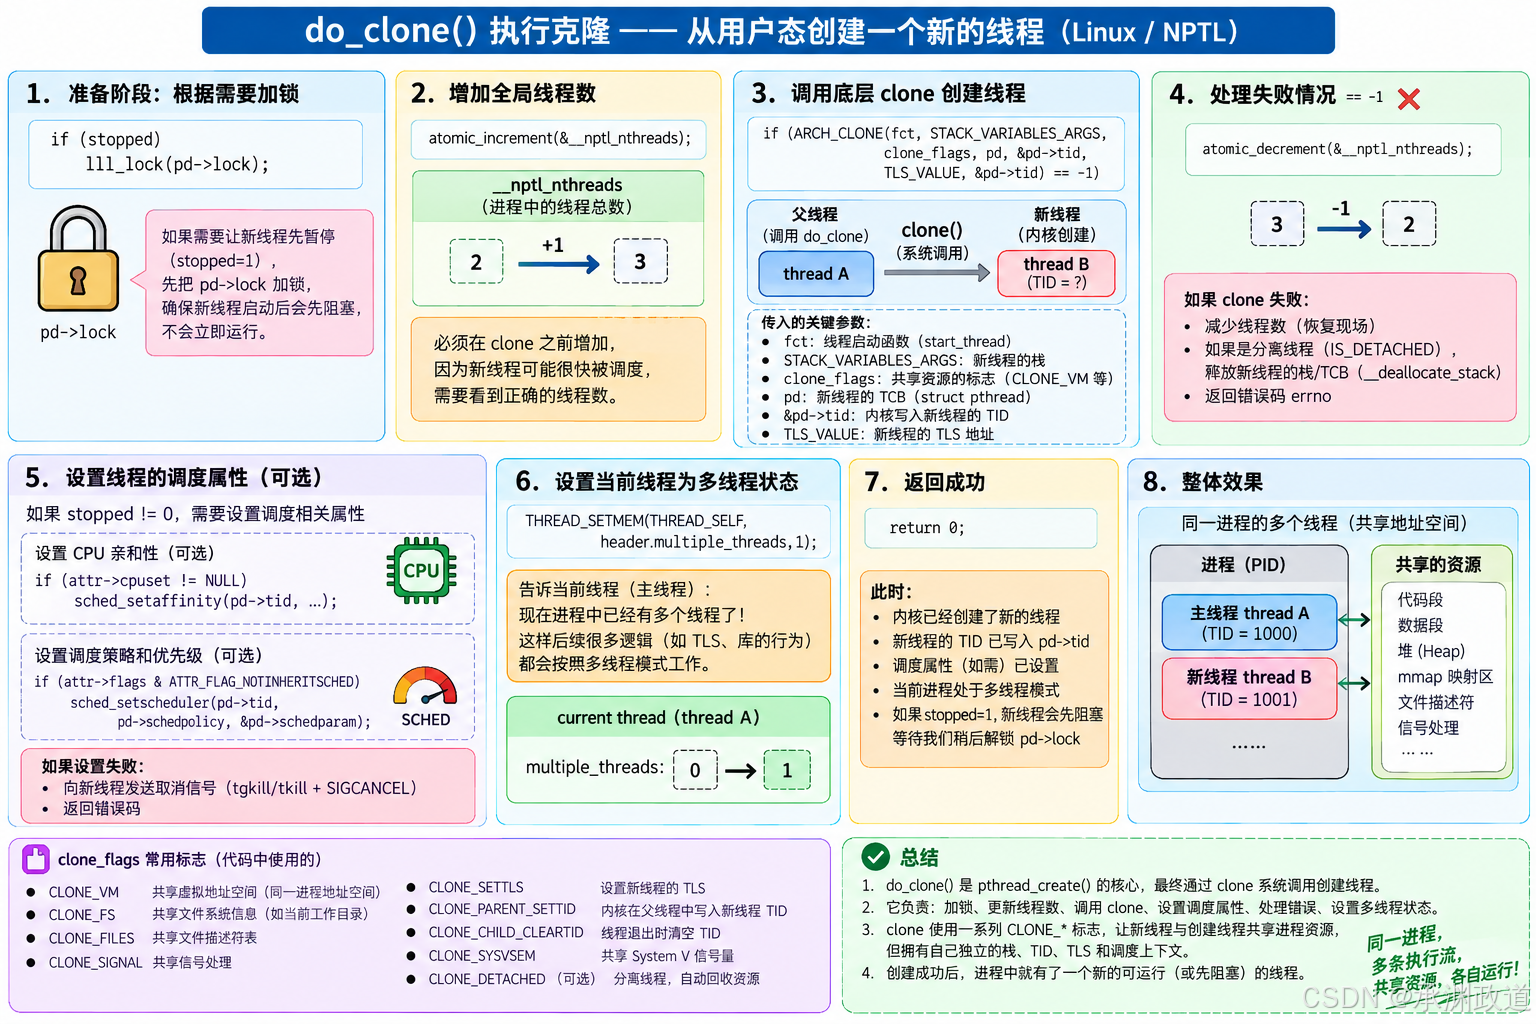
cpp
static int
do_clone(struct pthread *pd, const struct pthread_attr *attr,
         int clone_flags, int (*fct)(void *), STACK_VARIABLES_PARMS,
         int stopped)
{
#ifdef PREPARE_CREATE
    PREPARE_CREATE;
#endif
    if (stopped)
        /* We Make sure the thread does not run far by forcing it to get a
        lock. We lock it here too so that the new thread cannot continue
        until we tell it to. */
        lll_lock(pd->lock);
    /* One more thread. We cannot have the thread do this itself, since it
    might exist but not have been scheduled yet by the time we've returned
    and need to check the value to behave correctly. We must do it before
    creating the thread, in case it does get scheduled first and then
    might mistakenly think it was the only thread. In the failure case,
    we momentarily store a false value; this doesn't matter because there
    is no kosher thing a signal handler interrupting us right here can do
    that cares whether the thread count is correct. */
    atomic_increment(&__nptl_nthreads);
    // 执⾏特性体系结构下的clone函数
    if (ARCH_CLONE(fct, STACK_VARIABLES_ARGS, clone_flags,
                   pd, &pd->tid, TLS_VALUE, &pd->tid) == -1)
    {
        atomic_decrement(&__nptl_nthreads); /* Oops, we lied for a second. */
        /* Failed. If the thread is detached, remove the TCB here since
        the caller cannot do this. The caller remembered the thread
        as detached and cannot reverify that it is not since it must
        not access the thread descriptor again. */
        if (IS_DETACHED(pd))
            __deallocate_stack(pd);
        return errno;
    }
    /* Now we have the possibility to set scheduling parameters etc. */
    // 下⾯是调⽤相关系统调⽤,设置轻量级进程的调度参数和⼀些异常处理,不关⼼
    if (__builtin_expect(stopped != 0, 0))
    {
        INTERNAL_SYSCALL_DECL(err);
        int res = 0;
        /* Set the affinity mask if necessary. */
        if (attr->cpuset != NULL)
        {
            res = INTERNAL_SYSCALL(sched_setaffinity, err, 3, pd->tid,
                                   sizeof(cpu_set_t), attr->cpuset);
            if (__builtin_expect(INTERNAL_SYSCALL_ERROR_P(res, err), 0))
            {
                /* The operation failed. We have to kill the thread. First
                send it the cancellation signal. */
                INTERNAL_SYSCALL_DECL(err2);
            err_out:
#if __ASSUME_TGKILL
                (void)INTERNAL_SYSCALL(tgkill, err2, 3,
                                       THREAD_GETMEM(THREAD_SELF, pid),
                                       pd->tid, SIGCANCEL);
#else
                (void)INTERNAL_SYSCALL(tkill, err2, 2, pd->tid, SIGCANCEL);
#endif
                return (INTERNAL_SYSCALL_ERROR_P(res, err)
                            ? INTERNAL_SYSCALL_ERRNO(res, err)
                            : 0);
            }
        }
        /* Set the scheduling parameters. */
        if ((attr->flags & ATTR_FLAG_NOTINHERITSCHED) != 0)
        {
            res = INTERNAL_SYSCALL(sched_setscheduler, err, 3, pd->tid,
                                   pd->schedpolicy, &pd->schedparam);
            if (__builtin_expect(INTERNAL_SYSCALL_ERROR_P(res, err), 0))
                goto err_out;
        }
    }
    /* We now have for sure more than one thread. The main thread might
    not yet have the flag set. No need to set the global variable
    again if this is what we use. */
    THREAD_SETMEM(THREAD_SELF, header.multiple_threads, 1);
    return 0;
}
6.2线程栈
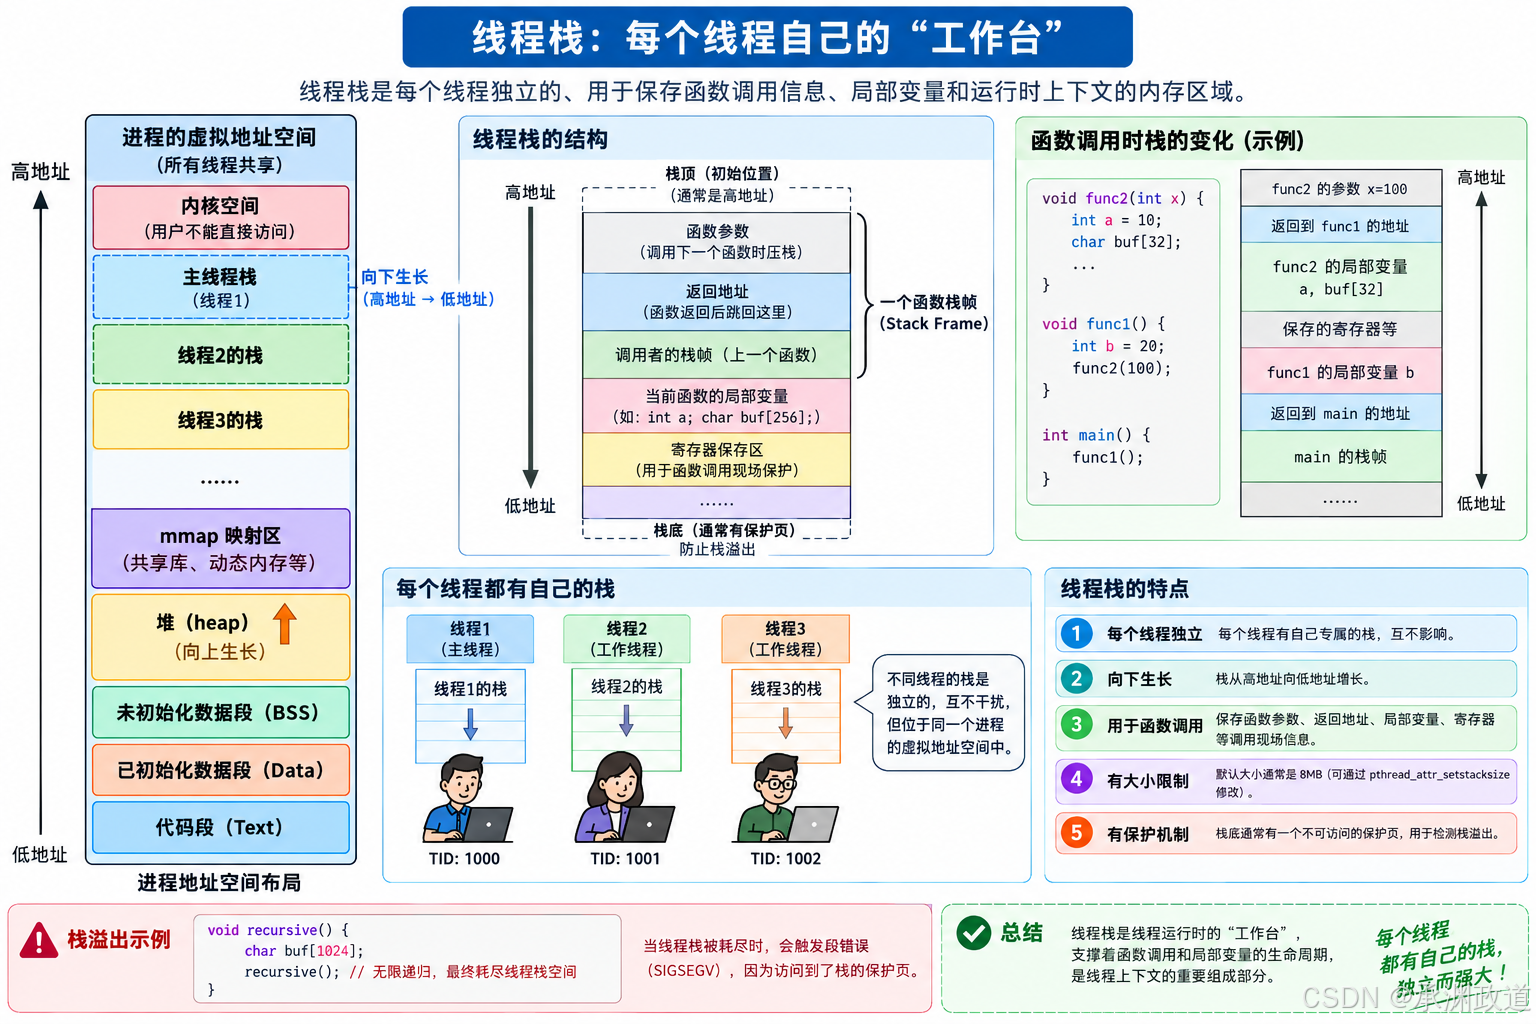
线程栈(Thread Stack)是每个线程用于保存自己函数调用现场的一块内存区域,主要存放函数栈帧、局部变量、返回地址、部分函数参数以及需要保存的寄存器状态 .同一个进程中的线程共享代码段、数据段、堆和整个虚拟地址空间,但每个线程都有自己独立使用的栈,所以多个线程即使同时执行同一个函数,它们的局部变量也不会因为使用同一个栈而相互覆盖.
text
同一个进程的虚拟地址空间

高地址
┌──────────────────────┐
│ 主线程栈             │  ← main线程使用
├──────────────────────┤
│ 线程1的栈            │  ← pthread线程1
├──────────────────────┤
│ 线程2的栈            │  ← pthread线程2
├──────────────────────┤
│ mmap / 动态库        │
├──────────────────────┤
│ Heap 堆              │  ← 所有线程共享
├──────────────────────┤
│ BSS / Data           │  ← 所有线程共享
├──────────────────────┤
│ Text 代码段          │  ← 所有线程共享
└──────────────────────┘
低地址
当线程执行:
c
void func()
{
    int a = 10;
    char buf[100];
}
它的栈中大致会形成:
text
线程栈
      ↓ 通常向低地址增长

┌──────────────────┐
│ 函数参数          │
├──────────────────┤
│ 返回地址          │
├──────────────────┤
│ 保存的寄存器      │
├──────────────────┤
│ int a             │
├──────────────────┤
│ char buf[100]     │
└──────────────────┘
对于 pthread_create() 创建的线程,glibc/NPTL 通常会为新线程准备独立的用户栈,栈大小可以通过:
c
pthread_attr_setstacksize()进行设置,并通常配置 Guard Page(保护页) 来帮助检测栈溢出.如果递归过深或者局部数组过大:
c
void func()
{
    char buf[1024 * 1024];
    func();
}
可能最终造成:
text
线程栈耗尽
   ↓
访问保护页/非法区域
   ↓
SIGSEGV需要特别注意:"线程栈独立"是指每个线程有自己专门使用的栈区域,并不代表其他线程从地址权限上绝对无法访问它;因为同一进程的线程共享虚拟地址空间,如果一个线程拿到了另一个线程栈上变量的地址,理论上也可以访问,因此仍然可能产生数据竞争.
虽然 Linux 将线程和进程不加区分的统⼀到了 task_struct ,但是对待其地址空间的 stack 还是
有些区别的.
- 对于 Linux 进程或者说主线程,简单理解就是main函数的栈空间,在fork的时候,实际上就是复制了⽗亲的 stack 空间地址,然后写时拷⻉(cow)以及动态增⻓.如果扩充超出该上限则栈溢出会报段错误(发送段错误信号给该进程).进程栈是唯⼀可以访问未映射⻚⽽不⼀定会发⽣段错误⸺超出扩充上限才报.
- 然⽽对于主线程⽣成的⼦线程⽽⾔,其stack将不再是向下⽣⻓的,⽽是事先固定下来的.线程栈⼀般是调⽤glibc/uclibc等的pthread 库接⼝pthread_create创建的线程,在⽂件映射区(或称之为共享区).其中使⽤mmap系统调⽤,这个可以从 glibc 的nptl/allocatestack.c 中的 allocate_stack 函数中看到:mem = mmap (NULL, size, prot,MAP_PRIVATE | MAP_ANONYMOUS | MAP_STACK, -1, 0);
此调⽤中的 size 参数的获取很是复杂,你可以⼿动传⼊stack的⼤⼩,也可以使⽤默认的,⼀般⽽
⾔就是默认的8M.这些都不重要,重要的是,这种stack不能动态增⻓,⼀旦⽤尽就没了,这是和⽣成进程的fork不同的地⽅.在glibc中通过mmap得到了stack之后,底层将调⽤sys_clone 系统调⽤:
cpp
int sys_clone(struct pt_regs *regs)
{
unsigned long clone_flags;
unsigned long newsp;
int __user *parent_tidptr, *child_tidptr;
clone_flags = regs->bx;
//获取了mmap得到的线程的stack指针
newsp = regs->cx;
parent_tidptr = (int __user *)regs->dx;
child_tidptr = (int __user *)regs->di;
if (!newsp)
newsp = regs->sp;
return do_fork(clone_flags, newsp, regs, 0, parent_tidptr,
child_tidptr);
}
因此,对于⼦线程的stack,它其实是在进程的地址空间中map出来的⼀块内存区域,原则上是线程私有的,但是同⼀个进程的所有线程⽣成的时候,是会浅拷⻉⽣成者的 task_struct 的很多字段,如果愿意,其它线程也还是可以访问到的,⼀定要注意.
一句话记忆:
线程栈就是每个线程自己的"函数调用工作区",保存局部变量和调用现场;线程之间共享进程资源,但各自维护自己的栈和执行上下文.
6.3⻚表和⻚表项
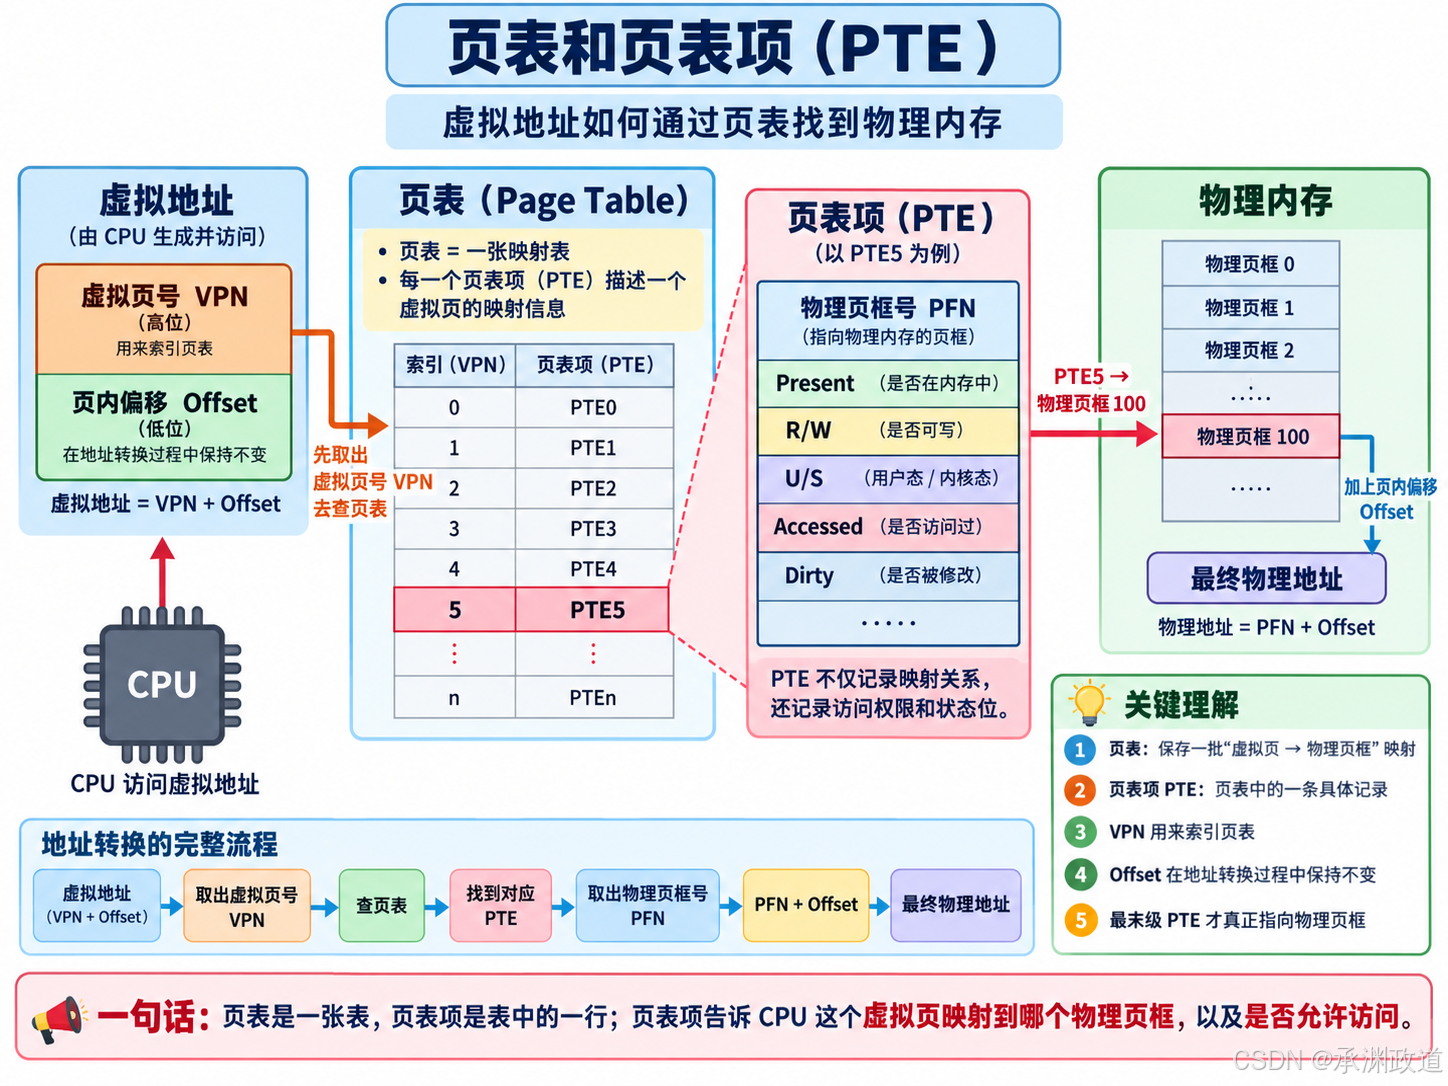
页表(Page Table) 是操作系统为进程维护的"虚拟地址 → 物理地址"的映射结构,而页表项(Page Table Entry,PTE) 就是页表中的一条具体记录.可以理解成:页表是一张表,页表项是表中的一行 .例如某个虚拟页号为5,页表中的第5个页表项可能记录它映射到物理页框 100,同时还保存Present、读写权限、用户/内核权限、是否访问过、是否被修改等状态位;CPU/MMU 在进行地址转换时,根据虚拟页号找到对应的页表项,从页表项中取得物理页框号,再加上页内偏移,得到最终物理地址.
text
虚拟地址
   │
   ├── 虚拟页号
   │       ↓
   │     页表
   │   ┌──────────────┐
   │   │ PTE 0        │
   │   ├──────────────┤
   │   │ PTE 1        │
   │   ├──────────────┤
   │   │ ...          │
   │   ├──────────────┤
   │   │ PTE 5        │ ──→ 物理页框 100
   │   └──────────────┘
   │
   └── 页内偏移
           ↓
物理页框 100 + 偏移
           ↓
        物理地址
其中一个典型页表项可以简单理解为:
text
PTE
┌──────────────────────┐
│ 物理页框号 PFN       │
├──────────────────────┤
│ Present              │ 是否存在
├──────────────────────┤
│ R/W                  │ 是否可写
├──────────────────────┤
│ U/S                  │ 用户/内核权限
├──────────────────────┤
│ Accessed             │ 是否访问过
├──────────────────────┤
│ Dirty                │ 是否被修改
└──────────────────────┘
在多级页表中还会出现 页目录项 PDE ,它负责指向下一级页表;而最末级的 PTE 才真正指向物理页框.
一句话记忆:页表负责管理一批映射,页表项负责描述某一个虚拟页具体映射到哪个物理页框以及它的访问权限.
6.4任意参数传递的线程封装demo
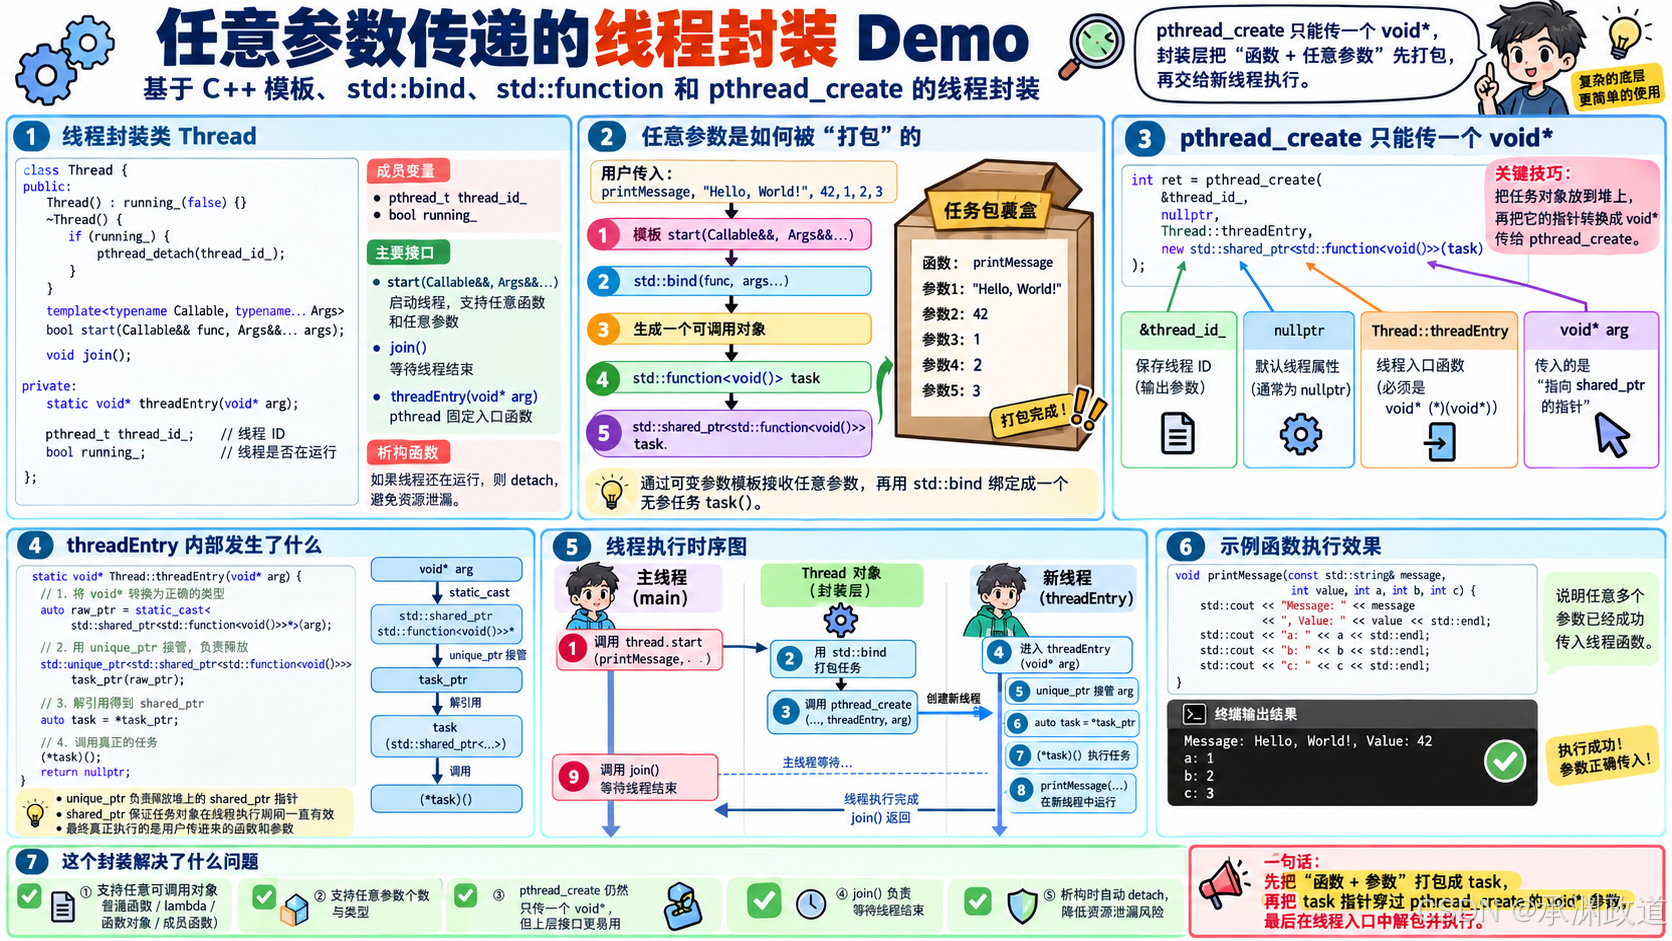
cpp
#include <iostream>
#include <functional> // ⽤于 std::function 和 std::bind
#include <memory>     // ⽤于 std::shared_ptr 和 std::unique_ptr
#include <pthread.h>  // POSIX 线程库
#include <unistd.h>
class Thread
{
public:
    // 构造函数
    Thread() : thread_id_(0), running_(false) {}
    // 析构函数
    ~Thread()
    {
        if (running_)
        {
            pthread_detach(thread_id_); // 分离线程,避免资源泄漏
        }
    }
    // 启动线程,接受任意可调⽤对象和参数
    template <typename Callable, typename... Args>
    bool start(Callable &&func, Args &&...args)
    {
        if (running_)
        {
            std::cerr << "Thread is already running!" << std::endl;
            return false;
        }
        // 将可调⽤对象和参数打包为⼀个 std::function<void()> 对象
        // 使⽤ std::bind 将函数和参数绑定在⼀起
        // std::forward ⽤于完美转发参数,保持参数的左值/右值属性
        auto task = std::make_shared<std::function<void()>>(
            std::bind(std::forward<Callable>(func), std::forward<Args>(args)...));
        // 将任务传递给线程⼊⼝函数
        // 使⽤ new 在堆上分配 std::shared_ptr,确保任务对象在线程执⾏期间有效
        if (pthread_create(&thread_id_, nullptr, &Thread::threadEntry, new std::shared_ptr<std::function<void()>>(task)) != 0)
        {
            std::cerr << "Failed to create thread!" << std::endl;
            return false;
        }
        running_ = true;
        return true;
    }
    // 等待线程结束
    void join()
    {
        if (running_)
        {
            pthread_join(thread_id_, nullptr);
            running_ = false;
        }
    }

private:
    pthread_t thread_id_; // 线程 ID
    bool running_;        // 线程是否在运⾏
    // 线程⼊⼝函数
    static void *threadEntry(void *arg)
    {
        // 从参数中提取任务并执⾏
        // 使⽤ std::unique_ptr 管理 std::shared_ptr 的指针,确保资源释放
        std::unique_ptr<std::shared_ptr<std::function<void()>>> task_ptr(
            static_cast<std::shared_ptr<std::function<void()>> *>(arg));
        auto task = *task_ptr; // 解引⽤获取任务对象
        (*task)();             // 执⾏任务
        return nullptr;
    }
};
// ⽰例:测试函数
void printMessage(const std::string &message, int value, int a, int b, int c)
{
    std::cout << "Message: " << message << ", Value: " << value << std::endl;
    std::cout << "a:" << a << std::endl;
    std::cout << "b:" << b << std::endl;
    std::cout << "c:" << c << std::endl;
    sleep(10);
}
int main()
{
    Thread thread;
    // 启动线程,传递任意函数和参数
    // 这⾥传递了⼀个普通函数 printMessage 和两个参数 "Hello, World!" 和 42
    thread.start(printMessage, "Hello, World!", 42, 1, 2, 3);
    // 等待线程结束
    thread.join();
    return 0;
}
6.5⾃⼰调⽤⼀下clone
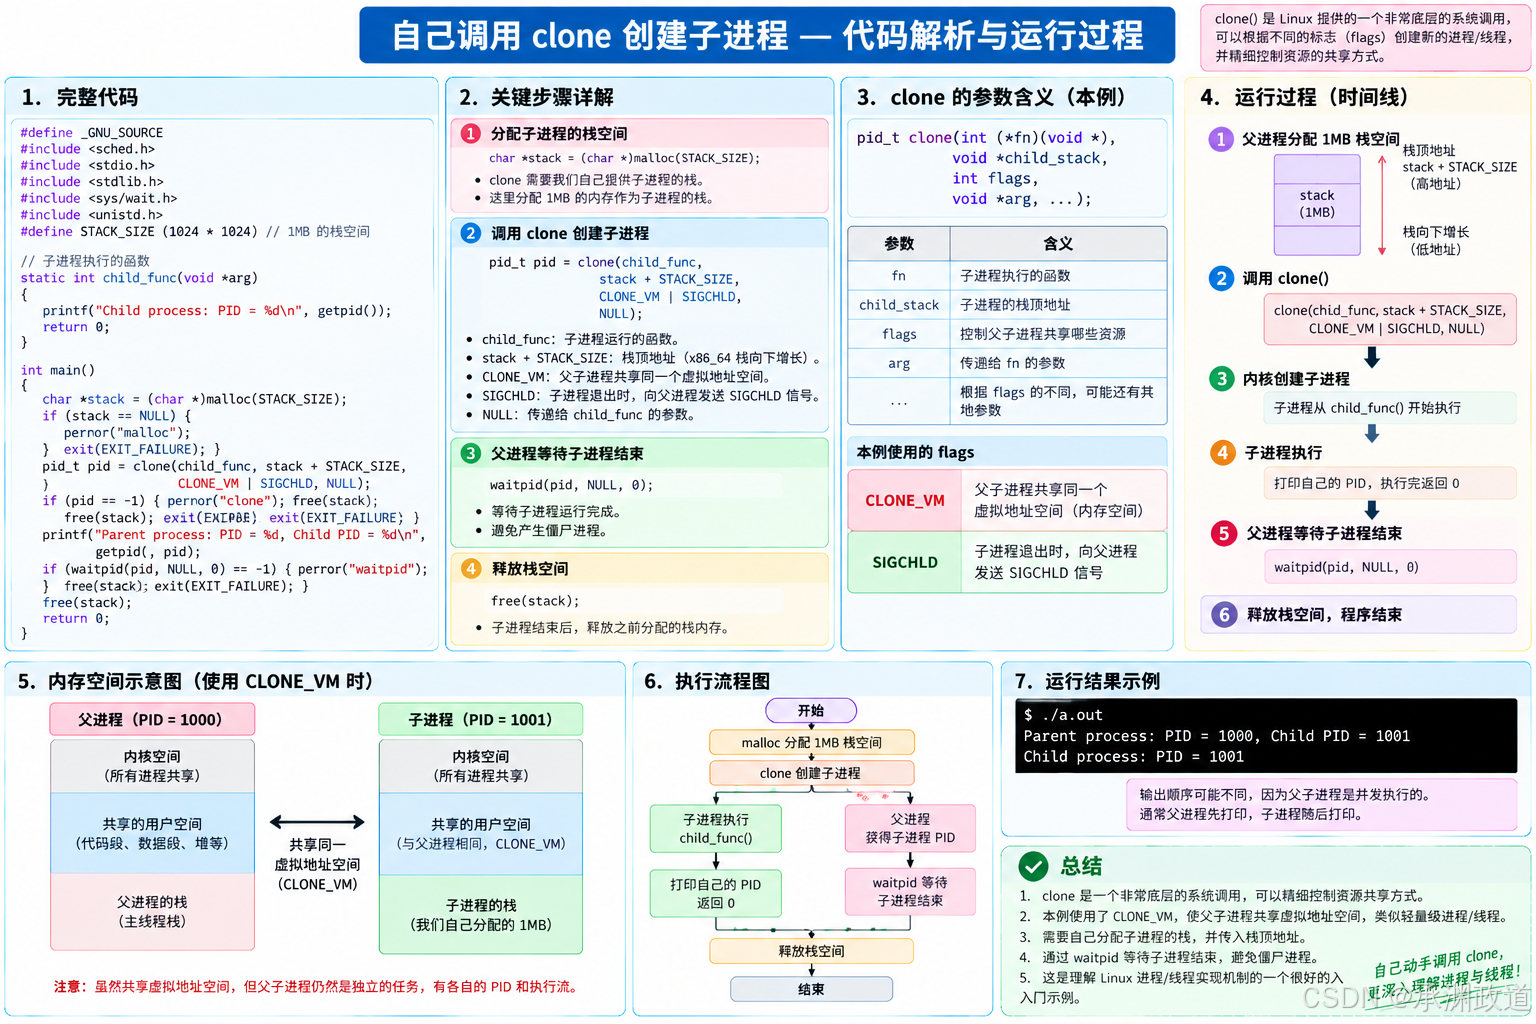
cpp
#define _GNU_SOURCE
#include <sched.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/wait.h>
#include <unistd.h>
#define STACK_SIZE (1024 * 1024) // 1MB 的栈空间
// ⼦进程执⾏的函数
static int child_func(void *arg)
{
    printf("Child process: PID = %d\n", getpid());
    return 0;
}
int main()
{
    char *stack = (char *)malloc(STACK_SIZE); // 为⼦进程分配栈空间
    if (stack == NULL)
    {
        perror("malloc");
        exit(EXIT_FAILURE);
    }
    // 使⽤ clone 创建⼦进程
    pid_t pid = clone(child_func, stack + STACK_SIZE, CLONE_VM | SIGCHLD,
                      NULL);
    if (pid == -1)
    {
        perror("clone");
        free(stack);
        exit(EXIT_FAILURE);
    }
    printf("Parent process: PID = %d, Child PID = %d\n", getpid(), pid);
    // 等待⼦进程结束
    if (waitpid(pid, NULL, 0) == -1)
    {
        perror("waitpid");
        free(stack);
        exit(EXIT_FAILURE);
    }
    free(stack);
    return 0;
}
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 真正成熟的共情,是有边界感!
很多人以为自己是"共情能力强",其实真正让自己反复被消耗的,往往不是共情,而是无法承受别人的痛苦、失望和愤怒.你看到别人难受,自己就产生内疚和焦虑,于是本能地让步、帮助、承担,最后把"理解别人"变成了"替别人负责".真正成熟的共情,不是感受更少,而是边界更清楚:我可以理解你的痛苦,但不必承担你的后果;我可以同情你,但不会因此牺牲自己的利益和原则.