把关键点连成图:CNS 用图神经网络做视觉伺服,精度 0.053°、0.3 mm
原文:CNS: Correspondence Encoded Neural Image Servo Policy
作者:Anzhe Chen、Hongxiang Yu、Yue Wang、Rong Xiong(浙江大学)
arXiv:arXiv:2309.09047v1 cs.RO(2023-09-16)
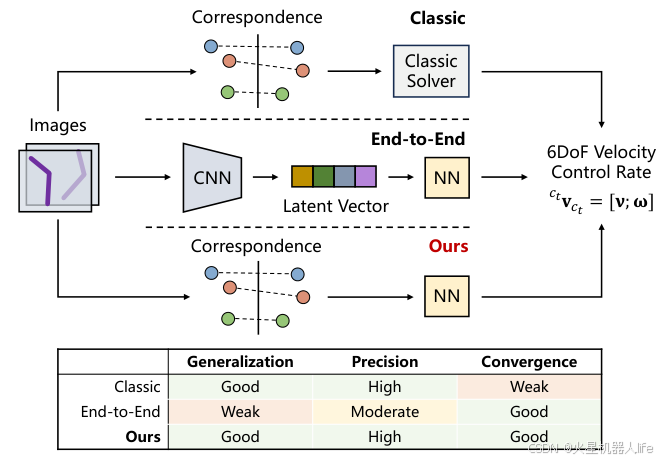
图注:这张开篇图把论文的定位讲得很清楚------经典方法把图像特征送进求解器(需要干净的关键点对应),端到端方法把图像整块塞进 CNN+NN(精度中等、换场景要重训),而 CNS 走中间路线:把关键点与它们的对应关系显式编码成图,再交给神经网络当策略,下面那张表就很直白地标出了"泛化性 / 精度 / 收敛性"三项的取舍。
如果把视觉伺服比作"蒙着眼睛靠相机把手指点到一个位置上",那么真正决定成败的不是控制器那几行公式,而是你用什么中间表示来描述"我看到什么、离目标还差多少"。浙江大学的 CNS 给出的答案是:把关键点和它们的对应关系画成一张图,让图神经网络来读这张图。
研究背景与现有方法不足
图像伺服(image servo / visual servoing)是机器人高精度定位的核心技术。论文把现有方法分成两支,并指出了各自迈不过去的坎:
- 经典方法(IBVS 等):依赖手工特征与干净的关键点对应,精度可以做到很高,但(a)需要先用 RANSAC 之类的机制把误匹配剔干净,一旦观测有噪声、有遮挡,性能会断崖式下跌;(b)收敛域(convergence basin)小,初始位姿偏差大就收敛不了;(c)对特征误差的鲁棒性弱。
- 学习类方法(端到端/implicit 模型) :收敛域大、在特定场景精度尚可,但(a)精度上限不高;(b)换一个新环境就要重新训练,泛化性差。
作者的核心观察是:这两类方法的差别实质上是"中间表示 "的差别。关键点对应是一种非常通用的表示(与场景无关),而神经网络的强项是建模能力。于是问题变成:能不能把关键点对应保留下来,但不要用它直接解算式,而是从中学习一个策略?
论文给出了一个佐证式实验:在实物场景 Scene-Easy 上,若把 RANSAC 去掉(即允许误匹配直接进入控制器),经典 IBVS 的成功率从 98.33% 掉到 8.33%------几乎全崩;这说明"精确对应"这个前提有多脆弱。
核心创新点
1)把关键点与对应关系编码成图(graph),用 GNN 当控制器。
- 节点 是当前帧与期望帧上的关键点,其中还包含一组"目标节点"(可理解为从期望位姿解析出的距离先验 dpriord_{prior}dprior 的载体);
- 边分两类 :E0E^0E0 刻画"当前点---目标点"的对应关系(跨平面连接),E1E^1E1 刻画时序/帧内的运动关系。这样一张图既表达了"哪个点对应哪个点",也表达了"它们彼此之间的几何结构"。
- 这种表示天然支持关键点数量变化与部分缺失,也天然继承了"泛化的中间表示"这一优势。
2)面向这张图的网络架构:PTConv + GConvGRU。
- PTConv(point-to-point 卷积):用距离先验把"位置"与"方向"解耦着处理,避免网络把尺度和朝向耦合在一起;
- GConvGRU :在图上做带门控的循环聚合,把每一帧的图特征在时间维度上平滑,输出速度指令。消融显示,与直接用 GGNN 相比,base 模型的精度提升 超过 50% ,在 ErenderE_{render}Erender 上成功率达到 100%(GGNN 为 97.33%);
- 其余模块还有 PERConv、AttPool 与 MLP 头(速度变换),输出含方向与幅值的速度指令。
3)三个提升效率/精度/泛化的"训练侧技巧"。
- 逼真数据生成(randomization):在仿真里生成带噪声、带扰动、带部分遮挡的数据;
- 特征聚类(feature clustering):把"这个点属于哪一类/哪个对应"变成分类问题,消融显示去掉聚类会带来巨大退化------收敛步数从 207.8 涨到 378.7,控制器单帧耗时从 11.5 ms 涨到 67.4 ms;
- 距离解耦(distance decoupling):让策略只在归一化空间里工作,额外估计一个标量距离先验,就能适配任意尺度的场景------这是它"纯仿真训练 + 实物零样本迁移"的关键。
4)初始旋转补偿。 对 0°/90°/180°/−90° 四个旋转假设分别做匹配并取最优,让方法能从一个"只露出一部分、且被大幅旋转"的初始视角收敛(论文的实物精细实验里最优假设就是 180°)。
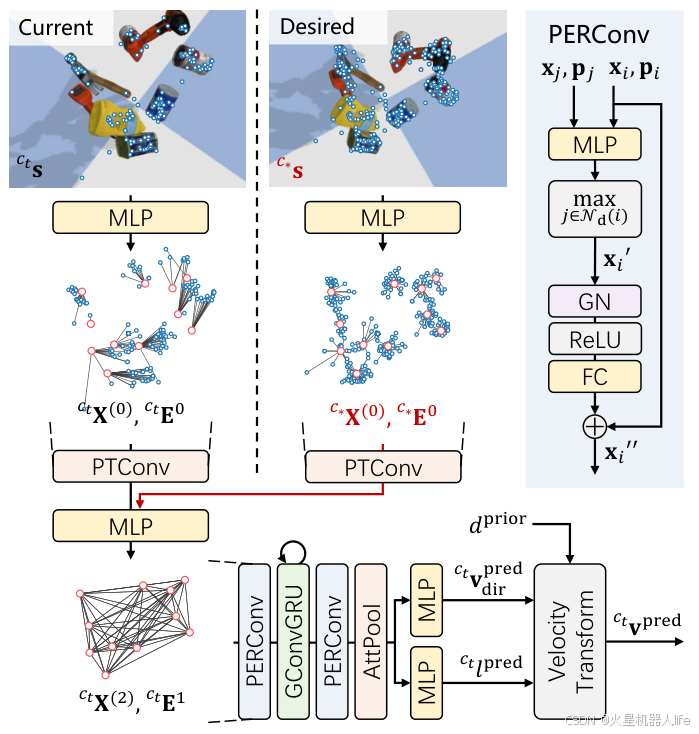
图注:这张架构图是全文信息密度最高的一张------左右两列分别处理"当前帧"和"期望帧"的点云与边结构,中间的 PTConv 负责点对点特征、GConvGRU 负责时序门控,最后经 AttPool 与 MLP 输出速度指令。看它就是看 CNS 到底"怎么想问题"。
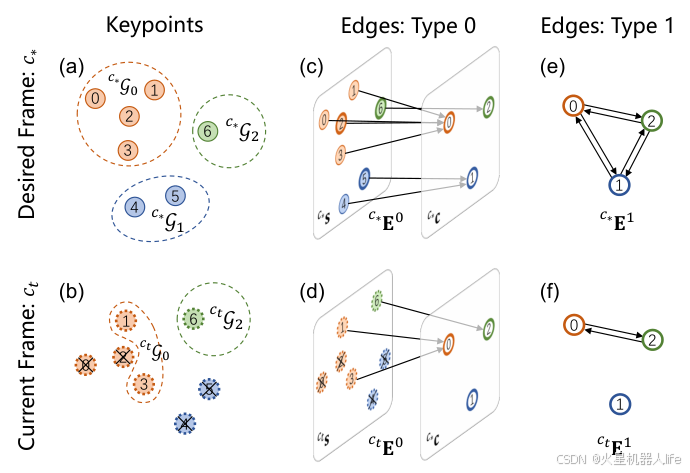
图注:用一个只有 7 个关键点的小例子讲清"图表示":(a)(b) 是期望帧/当前帧的关键点及其分组,中间两列是把两帧点连起来的 E0E^0E0 边(跨帧对应),右侧是 E1E^1E1 边(帧内/时序结构)。这是理解 CNS 与"直接回归位姿"的区别最直观的一张图。
实验平台
- 仿真环境一 ErenderE_{render}Erender: 用 PyBullet 渲染,场景里随机放置 8--12 个 YCB 数据集物体 ,共 150 个场景 ,每个场景随机采样初始位姿与期望位姿;成功判据为最终旋转误差 RE<3°RE < 3°RE<3° 且平移误差 TE<3 cmTE < 3\ \mathrm{cm}TE<3 cm。对比方法包括 RAFT+IBVS、AKAZE+IBVS 与本文 AKAZE+CNS,分"有/无 RANSAC"两组,并按初始旋转误差分成 S/M/L 三档(平均 24.06°、67.38°、136.46°)与全部场景(平均 75.96°、TE 247.9 mm)。
- 仿真环境二 EaffineE_{affine}Eaffine: 用 2D 图像做仿射变换构成场景(与对比方法 1113 保持一致),150 次运行,平均初始 RE 44.69°、TE 284.6 mm,成功判据为 RE<10°RE<10°RE<10°、TE<10 cmTE<10\ \mathrm{cm}TE<10 cm。
- 实物环境: 分 Scene-Easy 与 Scene-Hard 两个场景,每个统计量来自 60 次运行 ,平均初始 RE 86.56°、TE 148.8 mm ;IBVS 与 CNS 都使用 SIFT 作为观测器 以保证公平;成功判据为 RE<3°RE<3°RE<3°、TE<3 cmTE<3\ \mathrm{cm}TE<3 cm。论文补充材料里还验证了 ORB、SIFT、AKAZE、BRISK 等多种观测器。
- 评价指标: 成功率 SR(附 95% 置信区间)、收敛步数 TS(每一步 0.04 s)、旋转误差 RE、平移误差 TE、观测器单帧耗时 mOT、控制器单帧耗时 mCT、单帧总耗时 mTT。
- 训练与推理分工: 模型完全在仿真中训练,实物测试为零样本迁移 ;论文给出"最大 40 fps(含观测器)"的速度结论,即观测器与控制器加起来仍能跑到 40 帧/秒。
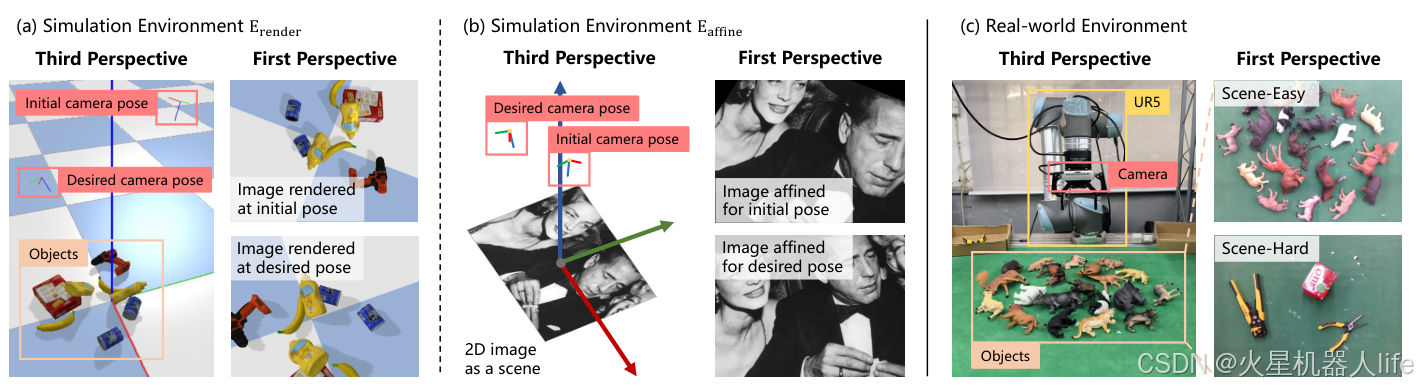
图注:从左到右分别是渲染仿真环境(随机摆放 YCB 物体、随机初始/期望相机位姿)、2D 仿射测试环境,以及实物台(UR 机械臂 + 相机 + 桌面物体,含 Scene-Easy 与 Scene-Hard 两种难度)。三种环境的复杂度递进,是"仿真训练、实物零样本"这条结论的证据链。
主要结果
实物对比(Table I,每格 60 次运行,平均初始 RE 86.56°、TE 148.8 mm):
| 场景 / 条件 | 指标 | IBVS | CNS(本文) |
|---|---|---|---|
| Scene-Easy,有 RANSAC | 成功率 | 98.33%(95.90--100) | 100% |
| RE / TE | 0.147° / 0.843 mm | 0.053° / 0.308 mm | |
| Scene-Easy,无 RANSAC | 成功率 | 8.33%(1.34--15.33) | 75.00%(64.04--85.96) |
| 收敛步数(0.04 s/步) | 358.8±65.1 | 136.6±49.4 | |
| TE | 8.256±2.657 mm | 0.385±0.156 mm | |
| Scene-Hard,有 RANSAC | 成功率 | 70.00% | 96.67% |
| RE / TE | 0.523° / 2.839 mm | 0.101° / 0.367 mm |
三条结论:精度上 ,CNS 在实物做到 <0.3°、亚毫米(0.053° / 0.308 mm) ;鲁棒性上 ,一旦剔除误匹配的"护栏"(去掉 RANSAC),IBVS 直接崩到 8.33%,CNS 仍有 75%;速度上,在无 RANSAC 的困难条件下,CNS 的收敛步数只有 IBVS 的约 38%(136.6 vs 358.8 步,即快了 2.6 倍)。
仿真结果: 在 ErenderE_{render}Erender 的完整消融基准上,base CNS 达到 100% 成功率、RE 0.12±0.11°、TE 1.39±1.40 mm、控制器单帧 11.5±1.65 ms ;在 S/M/L 三档初始误差(含 136.46° 的大偏差档)上均能保持高成功率,体现了"大收敛域"。与端到端学习类方法 1113 相比,在 EaffineE_{affine}Eaffine 上本文模型在同等高成功率下取得最好的伺服精度。
消融(Table II,ErenderE_{render}Erender,150 次):
| 配置 | SR | 收敛步数 | RE | TE | mCT |
|---|---|---|---|---|---|
| CNS(base) | 100% | 207.8±43.8 | 0.12±0.11° | 1.39±1.40 mm | 11.5±1.65 ms |
| 去掉聚类(-Cluster) | 99.33% | 378.7±183 | 0.72±0.62° | 9.29±9.18 mm | 67.4±40.6 ms |
| 去掉 GConvGRU | 99.33% | 218.6±62.0 | 0.23±0.29° | 2.92±3.60 mm | 10.1±1.40 ms |
| 换成 GGNN | 97.33% | 203.4±118 | 0.24±0.28° | 2.84±3.91 mm | 10.2±1.38 ms |
控制频率视角: 控制器单帧 11.5 ms(约 87 Hz 的理论上限),加上观测器后整体最高 40 fps ------也就是说在 CNS 这套设计里,瓶颈是观测器而不是网络。
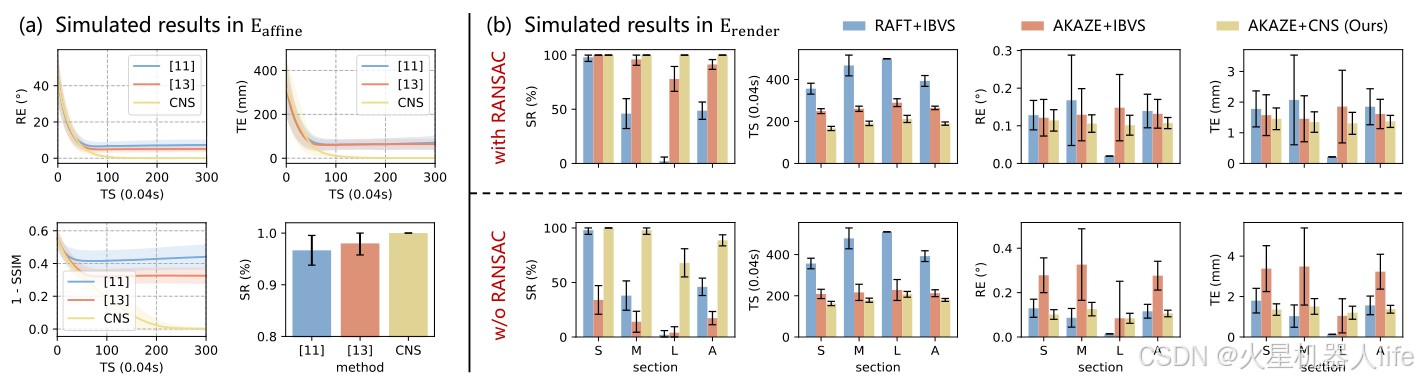
图注:左半部分是 EaffineE_{affine}Eaffine 上的收敛曲线与成功率柱状图(本文方法在同等成功率下误差更低),右半部分是 ErenderE_{render}Erender 的分档柱状图,可以清楚看到"无 RANSAC"和"大初始旋转(L 档)"这两个最难的条件下 CNS 与 IBVS 的差距被拉开。
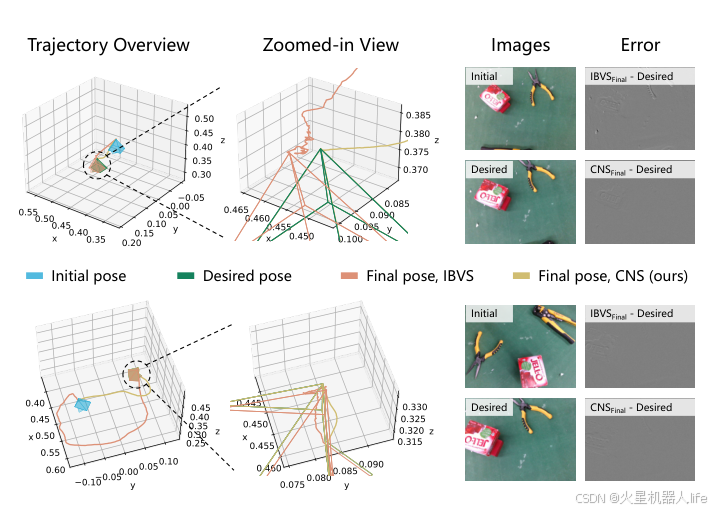
图注:每一行是一组实物试验:左侧是全局轨迹与局部放大(红/绿/黄分别代表初始位姿、IBVS 终态、CNS 终态),右侧是初始/期望图像以及终态图像与期望图像之差。最右侧的"误差图"是灰的说明对上了------CNS 那一列明显比 IBVS 更干净。
对机器人工程实践的启示
- 控制器与观测器解耦,是这套方案最工程化的一点。 CNS 只吃关键点与对应关系,因此可以用 SIFT、ORB、AKAZE、BRISK 中任意一种观测器,甚至可以在观测器退化时靠自身的鲁棒性撑住(无 RANSAC 场景 75% 成功率)。对企业来说,这意味着可以复用已有特征/跟踪模块,只替换控制器。
- 可以砍掉 RANSAC。 若你的流水线里为了剔除误匹配而挂着 RANSAC,CNS 提供了一条"用学习到的鲁棒性换掉外点剔除"的路径------省的不只是算力,还有调参成本。
- 算力分配要看清瓶颈。 控制器 11.5 ms/帧很轻,整体 40 fps 的上限主要来自观测器(mOT)。部署时应把优化重心放在特征提取/匹配侧,而不是继续瘦身网络。
- 训练成本可控:纯仿真训练 + 实物零样本迁移。 依靠数据随机化与"距离解耦"(只需额外估一个标量先验),模型能直接跨尺度使用,避免了为每个工位采数据的成本。
- 图表示对现场变化更友好。 关键点数量变化、部分遮挡、临时丢失几个点,都不会破坏输入结构------相比"固定维度的位姿回归",它更贴近真实感知的抖动。
主要局限 + 未来方向
- 精度受观测器与关键点分辨率限制。 亚毫米级精度是在"关键点可被稳定观测"的前提下取得的;纹理弱、反光、严重遮挡的目标上,观测器质量会直接决定上限。
- 单目尺度需要额外的距离先验。 论文用"距离解耦 + 估计一个标量"的方式绕开了尺度问题,但这本身也是一个误差源(补充材料用专门的实验分析其容差)。
- 验证范围有限。 仿真与实物都集中在桌面/抓取类场景,目标是静态的(没有移动目标的跟踪实验),也没有做到"手眼标定误差"这类系统级因素的分析。
- 补充材料承担了大量关键验证(不同观测器对比、数据生成技术、距离先验影响),正文的结论完整性依赖附录。
- 未来可做: 3D 关键点/多相机融合的图表示、动态目标与移动平台的视觉伺服、把观测器也纳入可学习/可联合优化的范围,以及向更多工业场景(装配、插接等亚毫米级需求)推进。
总结
CNS 的核心贡献可以浓缩成一句话:把"关键点 + 对应关系"这种通用但脆弱的中间表示,包进图神经网络的骨架里,从而同时拿到经典方法的高精度与学习方法的鲁棒性和大收敛域 。它用 PTConv + GConvGRU 处理图结构,用聚类、距离解耦与数据随机化解决训练与泛化,用初始旋转补偿解决"开局偏得太远"的问题。结果很有说服力:实物精度 0.053° / 0.308 mm,无 RANSAC 条件下成功率 8.33% → 75.00%,含观测器仍能跑到 40 fps,且模型是纯仿真训练、实物零样本迁移。对于正在做视觉引导抓取/装配的团队,它给出的启示非常具体------保留通用观测器、把鲁棒性放进策略、按瓶颈分配算力。