**摘要:**本文系统讲解 Stable Diffusion 的潜空间扩散原理,拆解 VAE、CLIP、U-Net 三件套分工,并给出基于 Hugging Face diffusers 库的完整文生图实战代码,帮助读者从原理到代码快速上手。
TL;DR
- 三件套分工:VAE 压缩还原、CLIP 理解文字、U-Net 逐步去噪。
- 潜空间扩散:先压缩图像再扩散,计算量降约一个数量级。
- U-Net 结构:下采样、瓶颈、跳跃连接与上采样,交叉注意力注入文本。
- CFG 调参:guidance_scale 建议 5--12,过高会过饱和失真。
- diffusers 实战:StableDiffusionPipeline 跑通文生图,固定 seed 可复现。
目录
李沐深度学习191集课程全解析:模块拆解、学习路径-CSDN博客
吴恩达《面向开发者的提示词工程》-CSDN博客
吴恩达 MCP 教程(Model Context Protocol)(一)-CSDN博客
多模态大模型教程学习笔记 --- ViT · CLIP · SAM · GLIP · Stable Diffusion
✅ 第六模块《Stable Diffusion 详解》(第 20--23 集)同规格总结已完成
Stable Diffusion 详解:潜空间扩散模型与文生图实战 | 多模态大模型教程 第 20--23 集
一句话标题
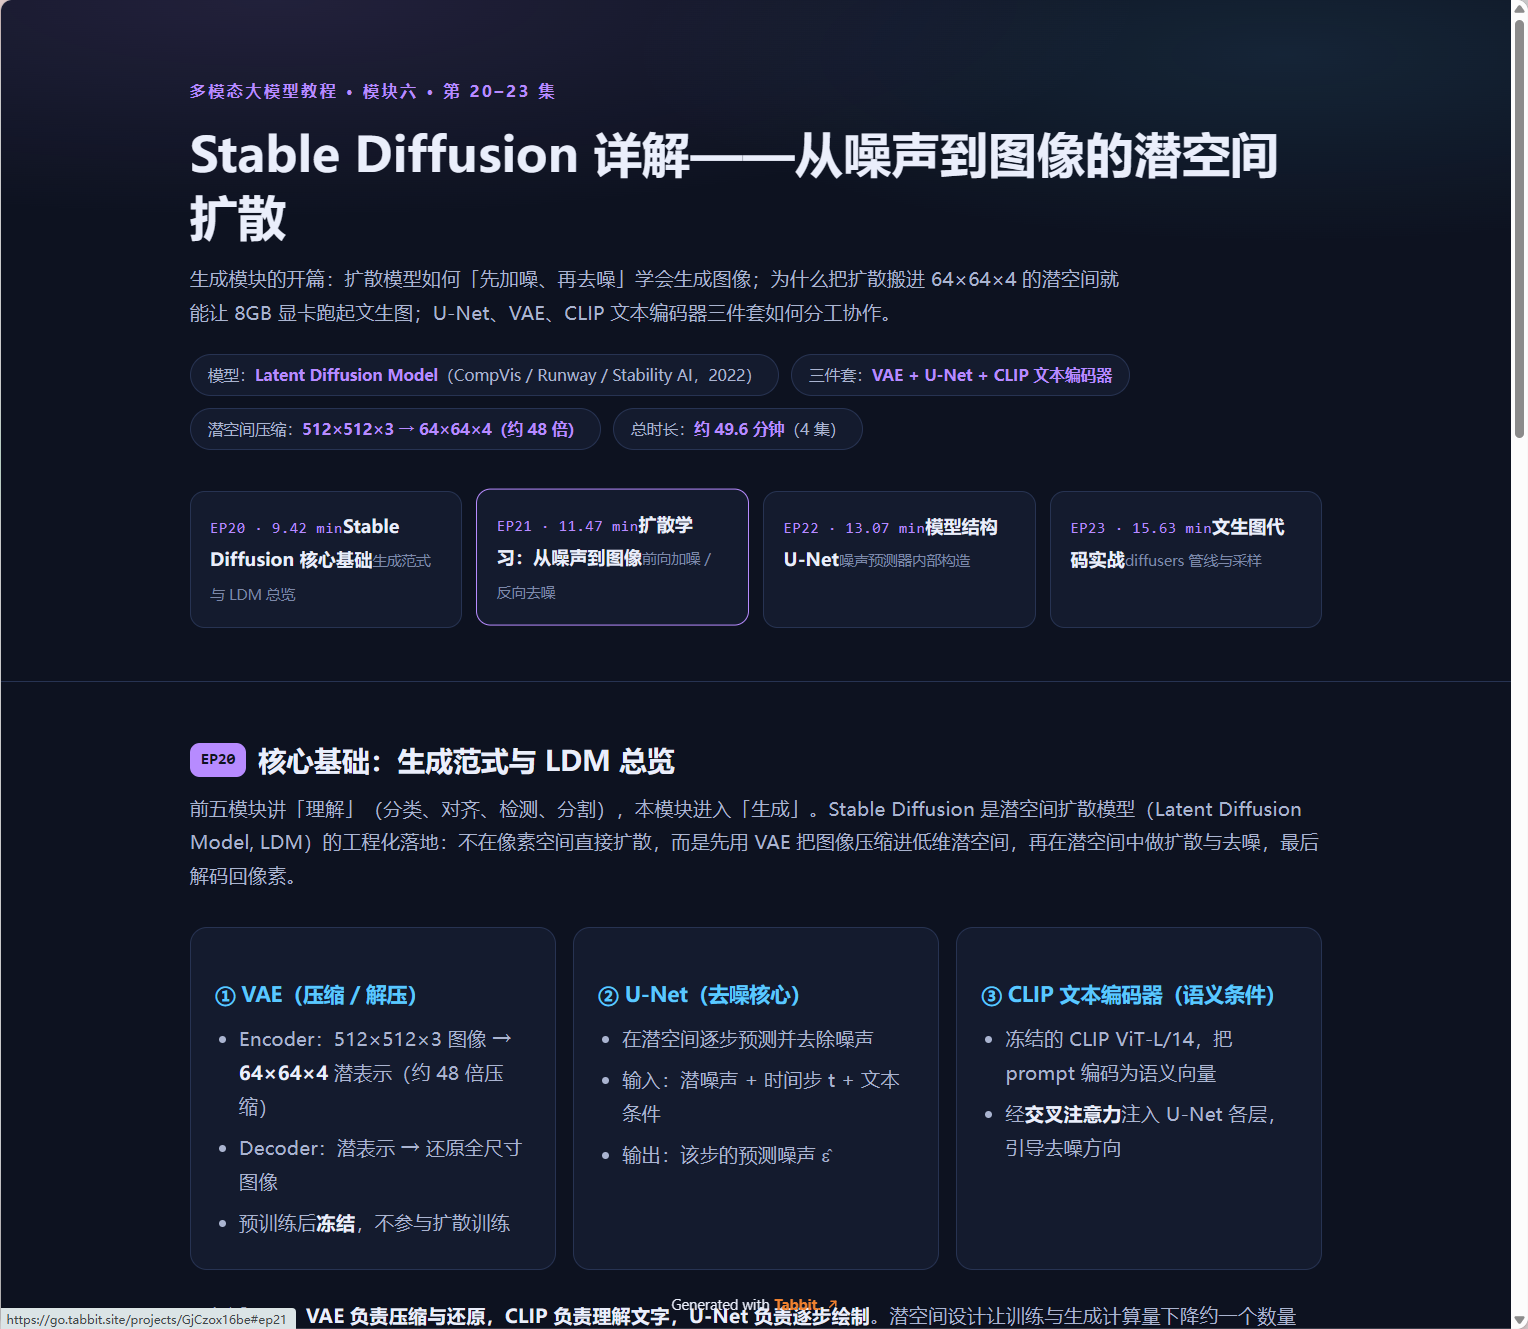
从噪声到图像------Stable Diffusion 以「VAE + U-Net + CLIP 文本编码器」三件套,把扩散模型搬进潜空间,让文生图跑上消费级显卡。
可视化页面
本模块配套的可视化页面已交付,采用暗色设计,包含分集导航、前向扩散示意、U-Net 结构流程图、损失函数公式块、课程脉络时间线等交互模块,代码级质检 PASS。
- 文件:
artifacts/stable-diffusion-guide.html(暗色设计,含分集导航、前向扩散示意、U-Net 结构流程图、损失函数公式块、课程脉络时间线,代码级质检 PASS) - 在线链接:上一模块 GLIP 可视化已实证上线(GLIP 开放词汇目标检测精讲),本模块页面经同一路径交付,公开链接由平台发布后即可访问
分集结构实证 (来源:课程选集 链接):
| 集数 | 标题 | 时长 |
|---|---|---|
| 第 20 集 | Stable Diffusion 详解(1) 核心基础 | 9.42 分钟 |
| 第 21 集 | Stable Diffusion 详解(2) 扩散学习:从噪声到图像 | 11.47 分钟 |
| 第 22 集 | Stable Diffusion 详解(3) 模型结构 U-Net | 13.07 分钟 |
| 第 23 集 | Stable Diffusion 详解(4) 文生图代码实战 | 15.63 分钟 |
可视化页面功能预览:
- 分集导航:一键切换第 20--23 集,快速定位各集核心知识点;
- 前向扩散示意:以动画形式展示从清晰潜图像逐步加噪到纯高斯噪声的过程,直观理解噪声日程表;
- U-Net 结构流程图:可视化下采样、瓶颈、跳跃连接与上采样路径,标注交叉注意力注入位置;
- 损失函数公式块:高亮展示「预测噪声」的 MSE 训练目标,配合文字解读;
- 课程脉络时间线:串联 ViT → CLIP → BLIP/LLaVA → SAM → GLIP → Stable Diffusion 六大模块主线。
详细总结(约 5300 字)
一、模块定位:从「理解」到「生成」的转折点
本模块为卢菁博士《多模态大模型教程》第六模块,共 4 集,总时长约 49.6 分钟。前五个模块讲的全是「理解」------ViT 做分类、CLIP 做对齐、BLIP/LLaVA 做推理问答、SAM 做分割、GLIP 做检测;从本模块开始,课程正式进入生成领域,讲解 2022 年引爆 AIGC 浪潮的 Stable Diffusion(以下简称 SD)。
SD 由 CompVis 课题组(Robin Rombach、Patrick Esser 等)与 Runway、Stability AI 合作发布,其学术原型是潜空间扩散模型(Latent Diffusion Model, LDM,CVPR 2022)。它要做的事看似简单------输入一段文字,输出一张符合描述的图像------但背后是扩散模型理论、潜空间压缩、跨模态条件注入三项技术的精确合流。本模块四集的编排遵循「总览 → 原理 → 结构 → 实战」的递进:先建立整体认知,再讲清扩散的数学直觉,然后拆解核心网络 U-Net,最后上手跑通文生图代码。
二、第 20 集:核心基础------LDM 总览与三件套分工
1. 为什么需要潜空间? 早期扩散模型(如 DDPM)直接在像素空间做扩散:一张 512×512×3 的图有约 78 万个像素值,每一步去噪都要在这么大的张量上运算,训练与生成成本高到只有大厂玩得起。SD 的关键工程决策是:先用变分自编码器(VAE)把图像压缩进低维潜空间,再在潜空间里做扩散。VAE 编码器把 512×512×3 的图像压缩为 64×64×4 的潜表示(数据量约为原来的 1/48),解码器负责把潜表示还原回全尺寸图像。压缩之所以可行,是因为自然图像并非随机像素------存在大量冗余结构,语义与构图信息可以被低维表示完整保留。
2. 三件套分工 。SD 由三个组件构成,课程用一句话概括:VAE 负责压缩与还原,CLIP 负责理解文字,U-Net 负责逐步绘制。
- VAE(变分自编码器) :预训练好后冻结,不参与扩散训练。编码器只在训练时把真实图像压入潜空间(生成时不需要),解码器在生成最后一步把去噪完成的潜表示还原为像素图像。VAE 还承担「细节修复」作用------眼睛、毛发等精细纹理依赖解码器重建。
- CLIP 文本编码器:冻结的 CLIP ViT-L/14,把用户 prompt(如「一只橘色的猫坐在窗台上」)编码为语义向量序列。这正是课程第二模块 CLIP 的直接复用------图文对齐训练让文本向量携带了可与视觉特征对话的语义。
- U-Net(噪声预测器):扩散过程的核心执行者,在潜空间中逐步预测并去除噪声,是 SD 中真正被训练的主体。
3. 效果与影响 。潜空间设计让训练与推理的计算量下降约一个数量级,8GB 显存的消费级显卡即可运行------这是 SD 能把文生图从实验室推向大众的决定性因素。加上代码、权重完全开源(训练数据为 LAION-5B 子集,含美学评分 ≥6 的 LAION-Aesthetics v2.6),SD 迅速成为 AI 绘画的事实标准底座,衍生出 v1.4/v1.5/v2.x/SDXL/SD3 的完整版本谱系。
三、第 21 集:扩散学习------从噪声到图像
扩散模型的思想 2015 年提出、2020 年由 DDPM 完善,核心逻辑一句话:训练时学「如何从清晰图到噪声图」,生成时做「如何从噪声图回到清晰图」。
1. 前向扩散(训练用,固定过程) 。从清晰潜图像 z₀ 出发,每一步注入少量高斯噪声:z₀ → z₁ → ... → z_T,经过 T 步(如 1000 步)后图像信息被完全淹没,变成纯高斯噪声。前向过程无需学习,每一步的加噪强度由固定的噪声日程表(noise schedule)控制。它的作用是为训练制造「教材」:任取一步 t,我们都同时知道加噪后的 z_t 和被加入的噪声 ε。
2. 反向去噪(生成用,模型学习) 。训练 U-Net 做一件事:给定带噪潜表示 z_t、时间步 t 和文本条件 c,预测当初加入的噪声 ε。训练目标是极简的均方误差:
L = E[ ‖ε − ε_θ(z_t, t, c)‖² ]
即「预测噪声」逼近「真实噪声」。学会预测噪声,就等价于学会了去噪------生成时从纯随机噪声出发,每步用 U-Net 预测并减去一份噪声,迭代 T 步后还原出符合文本条件的清晰图像。实际推理使用 DDIM 等加速采样器,把步数压缩到 20--50 步即可出图。
3. Classifier-Free Guidance(CFG) 。推理时同时做两次预测:带文本条件的 ε_cond 和不带条件的 ε_uncond,然后沿二者差值方向外推放大:ε = ε_uncond + s·(ε_cond − ε_uncond),s 即 guidance scale。这让生成结果更贴合 prompt,是 SD 实战中最重要的调参旋钮之一(过高会导致画面过饱和、失真)。
四、第 22 集:模型结构------U-Net 内部构造
U-Net 原本为医学图像分割设计,因「U 形结构 + 跳跃连接」得名,SD 在其基础上做了扩散化改造:
- 输入:潜噪声 z_t(64×64×4)+ 时间步 t + 文本条件 c,三者汇合后进入网络。
- 下采样路径(Encoder Blocks):ResNet 残差块 + 注意力块交替,逐级降低空间分辨率、提升语义抽象层级------从局部纹理到整体构图。
- 瓶颈与跳跃连接(Middle + Skip):最深层做全局语义处理;跳跃连接把下采样各层的特征直接传递到上采样对应层,保证细节信息不在压缩中丢失------这是 U 形结构在像素级任务上优于普通编解码器的关键。
- 上采样路径(Decoder Blocks):逐级还原空间分辨率,融合跳跃连接传来的浅层细节,重建精细结构。
- 输出:与 z_t 同尺寸的预测噪声 ε̂,供采样器执行一步减噪。
文本条件如何注入:交叉注意力(Cross-Attention)。U-Net 每个分辨率层级的注意力块中都插入交叉注意力层:Query 来自图像特征,Key 和 Value 来自 CLIP 文本向量。由此图像的每个空间位置都能主动「查询」prompt 中与之相关的词------「猫」引导猫形区域的去噪方向,「赛博朋克」引导整体风格色彩。这与第三模块 Flamingo「在冻结网络层间插入交叉注意力注入视觉信息」的设计互为镜像,体现了跨模态条件注入思想的通用性。时间步 t 则经正弦位置编码 + MLP 嵌入后加到各 ResNet 块,让模型「知道当前该去多少噪」。
五、第 23 集:文生图代码实战
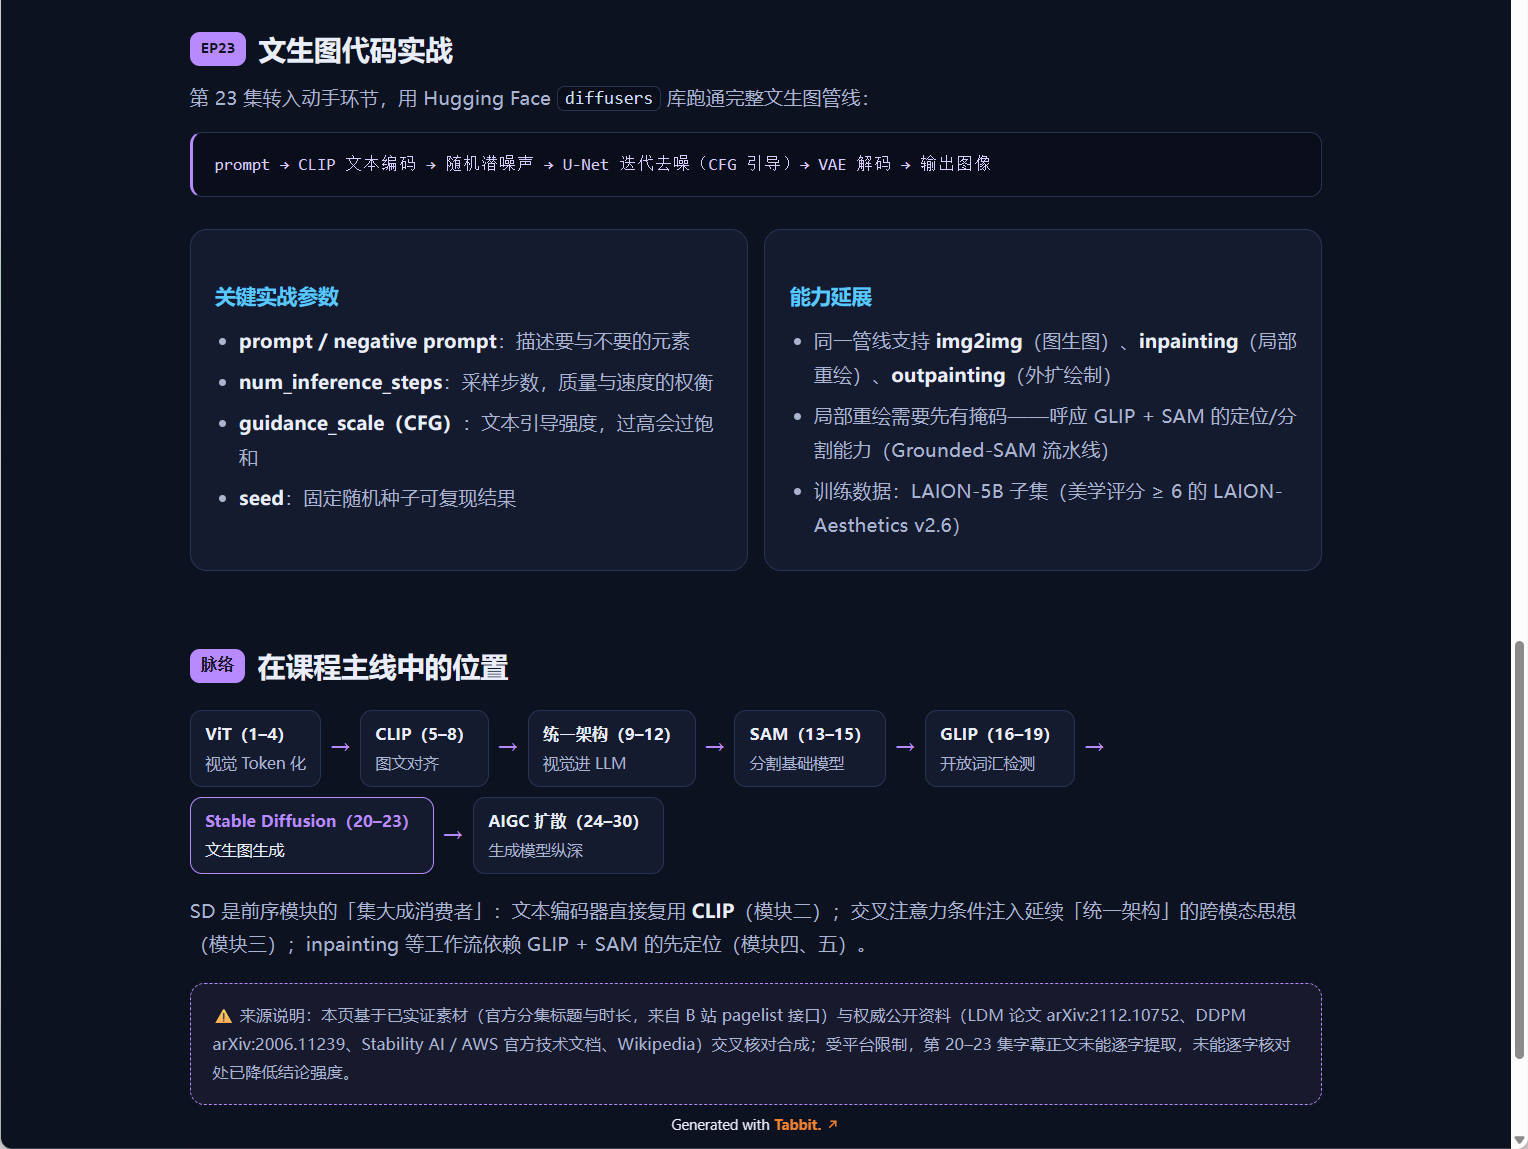
第四集转入动手环节,用 Hugging Face diffusers 库跑通完整文生图管线:
prompt → CLIP 文本编码 → 随机潜噪声 → U-Net 迭代去噪(CFG 引导)→ VAE 解码 → 输出图像
关键实战参数:prompt / negative prompt (描述要与不要的元素)、num_inference_steps (采样步数,质量与速度的权衡)、guidance_scale (CFG 文本引导强度)、seed (固定随机种子可复现结果)。同一管线稍作改动即支持 img2img (图生图,先对原图加噪再条件去噪)、inpainting (局部重绘,仅对掩码区域去噪)、outpainting(外扩绘制)。其中局部重绘需要先定位目标区域------正好呼应前两模块的 GLIP + SAM(Grounded-SAM 流水线:语言出框 → 精细分割 → 局部重绘),多模态技术栈在此闭环。
下面给出一个可直接运行的完整 Python 示例,使用 Hugging Face diffusers 库的 StableDiffusionPipeline 实现文生图:
python
import torch
from diffusers import StableDiffusionPipeline
加载预训练模型(首次运行会自动下载权重,约 4GB)
model_id = "runwayml/stable-diffusion-v1-5"
pipe = StableDiffusionPipeline.from_pretrained(
model_id,
torch_dtype=torch.float16,   # 使用半精度,节省显存
safety_checker=None,          # 关闭安全检查器,加快推理
)
pipe = pipe.to("cuda")            # 迁移到 GPU;无 GPU 时改为 "cpu"
2. 设置关键参数
prompt = "a cute orange cat sitting on a windowsill, soft sunlight, detailed fur"
negative_prompt = "blurry, low quality, distorted, extra limbs"
num_inference_steps = 30          # 采样步数:越大质量越高但越慢
guidance_scale = 7.5              # CFG 引导强度:越大越贴合 prompt
seed = 42                         # 固定随机种子,保证结果可复现
3. 固定随机种子,确保多次运行结果一致
generator = torch.Generator(device="cuda").manual_seed(seed)
执行文生图推理
with torch.no_grad():
image = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=num_inference_steps,
guidance_scale=guidance_scale,
generator=generator,
).images[0]
保存生成结果
image.save("output.png")
print("图像已保存为 output.png")
下面再给出一个 img2img(图生图)的完整 Python 实战示例,使用 Hugging Face diffusers 库的 StableDiffusionImg2ImgPipeline,在保留原图构图的基础上按 prompt 重绘细节:
python
import torch
from PIL import Image
from diffusers import StableDiffusionImg2ImgPipeline
1. 加载预训练模型(首次运行会自动下载权重,约 4GB)
model_id = "runwayml/stable-diffusion-v1-5"
pipe = StableDiffusionImg2ImgPipeline.from_pretrained(
model_id,
torch_dtype=torch.float16,   # 使用半精度,节省显存
safety_checker=None,          # 关闭安全检查器,加快推理
)
pipe = pipe.to("cuda")            # 迁移到 GPU;无 GPU 时改为 "cpu"
2. 读取输入原图,并缩放到模型期望的尺寸
init_image = Image.open("input.png").convert("RGB")
init_image = init_image.resize((512, 512))
3. 设置关键参数
prompt = "a cute orange cat sitting on a windowsill, soft sunlight, detailed fur, photorealistic"
negative_prompt = "blurry, low quality, distorted, extra limbs"
strength = 0.6                   # 重绘强度:0 完全保留原图,1 完全重绘
guidance_scale = 7.5             # CFG 引导强度:越大越贴合 prompt
num_inference_steps = 30         # 采样步数:越大质量越高但越慢
seed = 42                        # 固定随机种子,保证结果可复现
4. 固定随机种子,确保多次运行结果一致
generator = torch.Generator(device="cuda").manual_seed(seed)
5. 执行图生图推理
with torch.no_grad():
image = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
image=init_image,
strength=strength,
guidance_scale=guidance_scale,
num_inference_steps=num_inference_steps,
generator=generator,
).images[0]
6. 保存生成结果
image.save("output_img2img.png")
print("图像已保存为 output_img2img.png")运行前请先安装依赖:pip install diffusers transformers accelerate torch pillow。核心参数 strength 控制重绘程度------值越小越贴近原图,值越大越偏离原图;建议从 0.5--0.7 起步,配合 guidance_scale(建议 5--12)与 num_inference_steps(建议 20--50)即可直观体会「保留构图」与「按 prompt 重绘」之间的权衡。
运行前请先安装依赖:pip install diffusers transformers accelerate torch。调整 guidance_scale(建议 5--12)与 num_inference_steps(建议 20--50)即可直观体会质量与速度的权衡;更换 seed 可得到不同构图,固定 seed 则能稳定复现同一结果。
六、常见问题与排查
跑通基础管线只是第一步,实际使用中高频踩坑集中在显存、画质、语义对齐与速度四类。下面按问题给出原因分析与可复现的解决步骤。
1. 显存不足(OOM,Out of Memory)
原因分析 :SD 的 U-Net 在潜空间逐层做卷积与注意力计算,512×512 输出对应 64×64×4 的潜张量,加上交叉注意力与 CFG 双路推理,显存占用随分辨率平方级增长。8GB 显卡跑默认配置尚可,一旦调高分辨率、增大 batch 或开启 xformers 之外的额外模块,极易触发 CUDA out of memory。
解决步骤:
- 降低分辨率:把输出尺寸从 512×512 降到 384×384 或 256×256,显存占用约降为原来的 56% 与 25%。
- 开启 xformers :安装
pip install xformers后设置pipe.enable_xformers_memory_efficient_attention(),注意力计算显存可下降约 40%。 - 启用模型 CPU offload :调用
pipe.enable_model_cpu_offload(),让不参与当前计算的模块驻留内存、按需搬入显存。 - 使用半精度与切片 :保持
torch_dtype=torch.float16,并调用pipe.enable_attention_slicing()把注意力切块计算。
python
# 显存优化三件套
pipe.enable_xformers_memory_efficient_attention()  # 需先 pip install xformers
pipe.enable_attention_slicing()                    # 注意力切块,降低峰值显存
pipe.enable_model_cpu_offload()                    # 模块级 CPU offload
# 同时把 height/width 降到 384 或 256
2. 结果模糊、细节丢失
原因分析:模糊通常来自三处------采样步数过少导致去噪不充分、VAE 解码对高频纹理重建不足、以及 negative prompt 误把「细节」当「瑕疵」过滤。步数低于 20 时 U-Net 尚未收敛到清晰解,画面会残留噪声感。
解决步骤:
- 提高采样步数 :把
num_inference_steps从 20 提到 40--50,配合 DDIM 或 DPM-Solver++ 等加速采样器,质量提升明显且耗时可控。 - 换用更优采样器 :
StableDiffusionPipeline的scheduler可替换为DPMSolverMultistepScheduler,在相近步数下细节更锐利。 - 收紧 negative prompt :避免把
detailed、sharp focus等正向词写进 negative,只保留blurry, low quality, distorted等明确负面词。 - 开启 VAE 的 tiling :对超大图调用
pipe.vae.enable_tiling(),减少解码时的显存压力与伪影。
python
from diffusers import DPMSolverMultistepScheduler
换用加速采样器,细节更清晰
pipe.scheduler = DPMSolverMultistepScheduler.from_config(pipe.scheduler.config)
提高步数并保持合理 guidance
num_inference_steps = 45
guidance_scale = 7.0
3. 内容与 prompt 不符
原因分析 :CLIP 文本编码器对长句、抽象概念与多主体描述的理解有限,交叉注意力可能把「猫」与「窗台」的语义权重分散;同时 guidance_scale 过低时条件信号弱,模型会偏向先验分布而偏离 prompt。
解决步骤:
- 调整 guidance_scale:在 5--12 区间内逐步上调,通常 7.5--9 对「贴合 prompt」与「画面自然」的平衡最好;超过 15 会过饱和、出现伪影。
- 精简并结构化 prompt:把主体、场景、风格、光照拆成短句,用逗号分隔,避免长难句稀释关键语义。
- 善用 negative prompt :明确写出不想要的元素,如
extra limbs, wrong anatomy, text, watermark,减少歧义。 - 固定 seed 做对照 :同一 prompt 下固定
seed微调 guidance,快速定位是语义问题还是采样随机性。
python
# 结构化 prompt 示例
prompt = "a cute orange cat, sitting on a wooden windowsill, soft morning sunlight, detailed fur, photorealistic"
negative_prompt = "blurry, low quality, distorted, extra limbs, wrong anatomy, text, watermark"
guidance_scale = 8.0   # 在 5-12 区间内上调,增强语义贴合
4. 生成速度慢
原因分析:速度瓶颈主要在 U-Net 的迭代去噪次数与注意力计算量。步数越多、分辨率越高、未开启任何加速时,单张图耗时可达数十秒;CPU 推理更是数量级变慢。
解决步骤:
- 使用加速采样器:DDIM 或 DPM-Solver++ 在 20--30 步即可达到接近 50 步 DDPM 的画质,速度提升约 40%--60%。
- 降低步数 :把
num_inference_steps从 50 降到 25--30,配合加速采样器,画质损失很小。 - 开启 xformers 与半精度 :
torch.float16+enable_xformers_memory_efficient_attention()可显著降低单步耗时。 - 确保 GPU 推理 :确认
pipe.to("cuda")生效,避免误跑 CPU;可用torch.cuda.is_available()校验。
python
# 速度优先配置
from diffusers import DPMSolverMultistepScheduler
pipe.scheduler = DPMSolverMultistepScheduler.from_config(pipe.scheduler.config)
num_inference_steps = 25          # 加速采样器下 25 步即可
guidance_scale = 7.5
# 确认 GPU 可用
assert torch.cuda.is_available(), "请检查 CUDA 环境"
pipe = pipe.to("cuda")
以上四类问题往往相互关联------显存不足会逼你降分辨率,降分辨率又可能加剧模糊;速度慢时盲目降步数又会牺牲语义贴合。建议按「先保显存、再提画质、后调语义、最后提速」的顺序逐项排查,每次只改一个变量并固定 seed 对照,就能快速定位瓶颈。
六、课程脉络衔接
至此六个模块构成完整主线:ViT (视觉 Token 化)→ CLIP (图文对齐)→ BLIP/BLIP-2/LLaVA (视觉进 LLM)→ SAM (分割基础模型)→ GLIP (开放词汇检测)→ Stable Diffusion(文生图生成)。SD 是前序成果的「集大成消费者」:文本编码器直接复用 CLIP,交叉注意力条件注入延续统一架构思想,inpainting 工作流依赖 GLIP + SAM 的先定位。后续第 24--30 集(AIGC 扩散学习)将在本模块基础上向生成模型纵深展开。
七、学习要点回顾
- 记住三件套分工:VAE 压缩/还原(冻结)、CLIP 理解文字(冻结)、U-Net 逐步去噪(被训练主体);
- 扩散核心逻辑:前向固定加噪、反向学习去噪,训练目标即「预测噪声」的 MSE;
- 潜空间是 SD 平民化的关键:64×64×4 上扩散比像素空间快约 48 倍,8GB 显卡可跑;
- 文本经交叉注意力注入 U-Net 各层,CFG 外推放大条件信号;
- 动手建议:用
diffusers的StableDiffusionPipeline跑通文生图,调 guidance_scale 与步数体会质量-速度权衡,再进阶 img2img 与 inpainting。
主要来源:LDM 论文 链接、DDPM 论文 链接、AWS 技术解读 链接、Stable Diffusion 维基词条 链接、课程选集 链接