第二章:大语言模型(LLM)基础
构建 AI Agent,大语言模型(LLM)是最核心的基础设施。Agent 的推理、工具调用、记忆能力,都依赖底层模型质量。理解 LLM 的内部机制,才能在工程中做出正确的架构决策。
本章从 Transformer 架构出发,逐步深入到 Tokenization、上下文窗口、采样策略、幻觉问题、Function Calling、主流模型对比以及 Embedding 与 MCP 协议,覆盖 Agent 开发者需要掌握的 LLM 基础知识。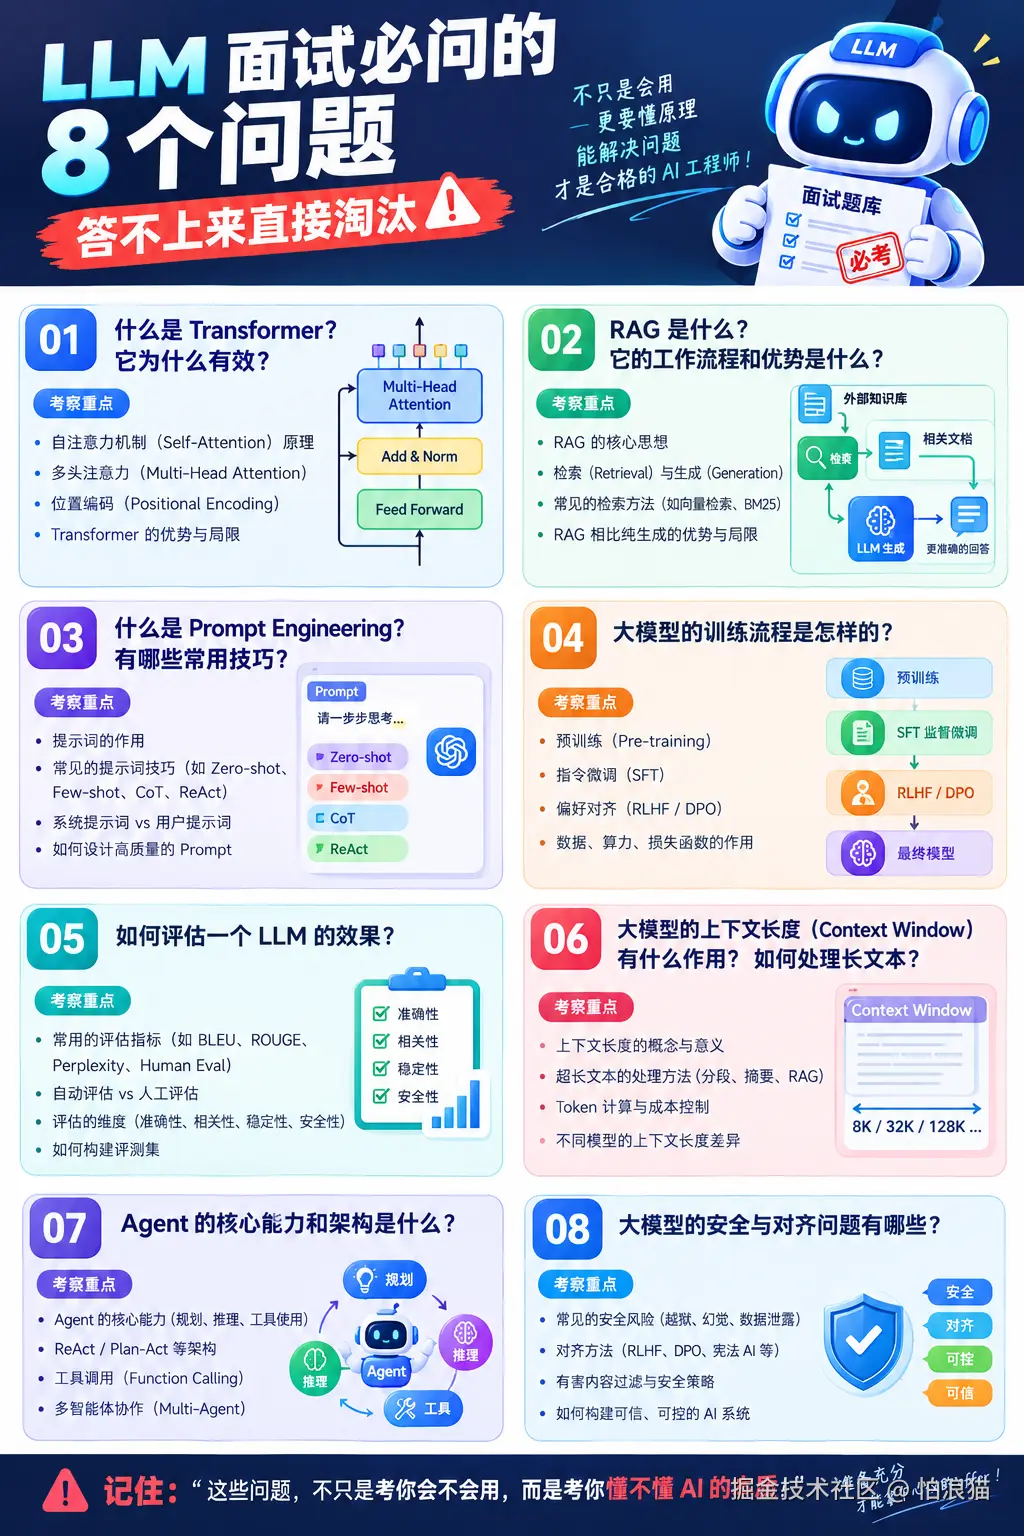
2.1 Transformer 架构核心:Self-Attention 与位置编码
2.1.1 Transformer 的诞生与核心思想
2017 年 Google 发表《Attention Is All You Need》,提出 Transformer。此前 NLP 主要依赖 RNN 和 LSTM 处理序列数据,但它们必须按时间步顺序计算,无法并行化,长距离依赖效果也差。
Transformer 完全摒弃循环结构,仅依赖注意力机制建模序列中任意两个位置的依赖关系,实现全并行训练,并通过 Multi-Head Attention 捕捉不同维度的语义关系。
2.1.2 Self-Attention 的数学原理
Self-Attention 是 Transformer 的灵魂。对输入序列中的每个位置,计算它与所有其他位置的相关性权重,然后对所有位置的值向量加权求和。
给定输入矩阵 X(n × d,n 为序列长度,d 为模型维度),通过三个可学习的权重矩阵 W_Q、W_K、W_V 将其投影为 Query、Key、Value 三个矩阵:
bash
Q = X * W_Q    (n x d_k)
K = X * W_K    (n x d_k)
V = X * W_V    (n x d_v)
注意力权重的计算公式为:
bash
Attention(Q, K, V) = softmax(Q * K^T / sqrt(d_k)) * V其中 sqrt(d_k) 是缩放因子,防止点积结果过大导致 softmax 梯度消失。d_k 是 Key 向量维度。
直觉上,Q 和 K 的点积衡量两个位置的"匹配度",softmax 归一化为概率分布,再用这个分布对 V 加权求和。
2.1.3 Multi-Head Attention
单个 Attention 函数只学一种关注模式。Multi-Head Attention 将 Q、K、V 分别投影到 h 个子空间,分别做 Attention 后拼接,让模型同时从多个角度理解序列:
python
import torch
import torch.nn.functional as F
import math

class MultiHeadAttention(torch.nn.Module):
    def __init__(self, d_model=512, num_heads=8):
        super().__init__()
        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads
        self.W_q = torch.nn.Linear(d_model, d_model)
        self.W_k = torch.nn.Linear(d_model, d_model)
        self.W_v = torch.nn.Linear(d_model, d_model)
        self.W_o = torch.nn.Linear(d_model, d_model)

    def forward(self, x):
        batch_size, seq_len, _ = x.shape
        Q = self.W_q(x).view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
        K = self.W_k(x).view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
        V = self.W_v(x).view(batch_size, seq_len, self.num_heads, self.d_k).transpose(1, 2)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
        attn = F.softmax(scores, dim=-1)
        out = torch.matmul(attn, V)
        out = out.transpose(1, 2).contiguous().view(batch_size, seq_len, self.d_model)
        return self.W_o(out)
每个头可以学到不同的关注模式------语法依赖、语义相似性、位置相近词等。
2.1.4 位置编码:让模型理解顺序
Self-Attention 本身是排列不变的------打乱输入顺序得到相同结果,模型无法区分"猫追狗"和"狗追猫"。位置编码(Positional Encoding)就是用来把顺序信息注入输入向量。
原始论文使用的是正弦余弦位置编码:
bash
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
这种编码的优势在于:不同位置的编码唯一,且相对位置可通过线性函数表示,模型能学到相对位置关系。
现代 LLM 中位置编码已有多种变体:
| 位置编码类型 | 代表模型 | 特点 |
|---|---|---|
| Sinusoidal | 原始 Transformer | 固定编码,不可学习 |
| Learned PE | GPT-2, BERT | 可学习参数,但长度固定 |
| RoPE (Rotary Position Embedding) | LLaMA, GLM | 旋转位置编码,支持长度外推 |
| ALiBi | BLOOM | 通过注意力偏置实现,无需额外参数 |
对 Agent 开发者来说,位置编码的意义在于:不同模型的上下文长度外推能力不同。RoPE 和 ALiBi 支持 NTK-aware scaling 等技术在训练长度之外推理,直接影响 Agent 能处理的上下文范围。
2.1.5 对 Agent 设计的影响
Transformer 的架构特性决定了 LLM 的几个基本约束。计算复杂度 O(n² × d),序列长度翻倍意味着计算量四倍增长。KV Cache 在推理时缓存已计算的 K 和 V,避免重复计算,是推理加速的关键。FFN 层占模型参数量约 2/3,是知识存储的主要位置。
这些底层特性直接影响 Agent 设计:为什么上下文窗口有上限、为什么长对话会变慢、为什么 Function Calling 需要结构化输出。理解这些,才能在工程中做出合理权衡。
2.2 Token 与 Tokenization:对 Agent 设计的深层影响
2.2.1 什么是 Token
Token 是 LLM 处理文本的最小单位。英文中一个 Token 可能是一个单词(如"hello"),也可能是词的一部分(如"unbelievable"拆为"un""believ""able")。中文中一个汉字通常对应 1-2 个 Token,取决于 Tokenizer。
Tokenization(分词)将原始文本切分为 Token 序列。这不是简单空格切分,而是基于统计学习算法在大量语料上训练出来的子词(subword)切分策略。
2.2.2 主流 Tokenization 算法
当前主流 Tokenization 方法有三种:
BPE (Byte Pair Encoding, 字节对编码):从字符级别开始,迭代地合并最高频的字符对。GPT-2、GPT-3 使用这种方案。例如,训练语料中"the"出现频率极高,BPE 会将"t""h""e"合并为一个 Token。
WordPiece:与 BPE 类似,但选择合并的依据不是频率最高,而是最大化语言模型的似然。BERT 使用这种方案。
SentencePiece:直接在 Unicode 字符上操作,不依赖空格预分词,因此特别适合中日韩等非空格分隔语言。LLaMA、GLM 系列使用这种方案。
| 算法 | 代表模型 | 语言支持 | 中文效率 |
|---|---|---|---|
| BPE | GPT-4, GPT-3.5 | 英文优 | 一般 |
| WordPiece | BERT, ELECTRA | 多语言 | 较好 |
| SentencePiece | LLaMA, GLM, T5 | 多语言 | 优秀 |
2.2.3 Token 对成本的直接影响
LLM 定价以 Token 为单位。同样一段中文文本,不同模型的 Token 消耗差异可能达 2-3 倍,直接影响 Agent 运行成本。
以"我是一个AI Agent开发者"为例(约12个汉字),不同模型的 Token 消耗大致如下:
bash
GPT-4 (tiktoken):    约 12-15 tokens
Claude:               约 10-12 tokens
GLM-4:                约 6-8 tokens
LLaMA 3 (SentencePiece): 约 8-10 tokens
国产模型(如 GLM)在中文 Tokenization 效率上有明显优势,中文场景下可以用相同上下文窗口塞入更多内容,同时降低 API 成本。
2.2.4 Tokenization 对 Agent 的深层影响
对 Agent 开发者来说,Tokenization 的影响远不止成本:
Prompt 工程精度。Agent 的 System Prompt 包含工具描述、行为规范等关键指令。如果 Tokenizer 将关键指令切到不同 Token 中,模型对这些指令的注意力可能被分散。理解目标模型的 Tokenization 行为,能更精准地控制模型行为。
上下文窗口有效容量。128K Token 的上下文窗口,英文约 96,000 词,中文可能只有 50,000-60,000 字。设计 Agent 记忆系统时,必须基于实际 Token 消耗而非字符数规划。
工具调用参数对齐。Function Calling 参数序列化为 JSON 后送入模型,JSON 结构化字符(括号、引号、冒号)也消耗 Token。复杂嵌套结构可能致 Token 消耗激增,多工具场景尤其要注意。
Token 边界对输出的影响。某些模型在 Token 边界处可能出现截断效应,导致 JSON 输出不完整。Agent 框架解析模型输出时需做好容错,比如自动补全缺失括号。
2.2.5 实用工具与最佳实践
实际开发中可以用以下工具预估 Token 消耗:
python
import tiktoken

# GPT-4 的 tokenizer
enc = tiktoken.encoding_for_model("gpt-4")
text = "这是一个Agent开发示例"
tokens = enc.encode(text)
print(f"Token 数量: {len(tokens)}")
print(f"Token 列表: {tokens}")
# Token 数量: 9
# Token 列表: [57460, 57668, 9554, 44093, 10459, 370]
建议在 Agent 开发中建立 Token 预算管理:为 System Prompt、对话历史、工具调用结果、模型输出分别设 Token 上限,避免单次请求超出上下文窗口或产生过高成本。
2.3 上下文窗口:Agent 的记忆容量边界
2.3.1 上下文窗口的定义
上下文窗口(Context Window)是模型一次推理能处理的最大 Token 数量,需要容纳所有输入:System Prompt、对话历史、工具描述、用户输入,以及模型输出的 Token。
可以类比为模型的"工作记忆"------LLM 一次推理中能"关注"的信息量有上限。
2.3.2 主流模型的上下文窗口对比
| 模型 | 上下文窗口 | 约等于中文 | 约等于英文 |
|---|---|---|---|
| GPT-4 Turbo | 128K | 约 6 万字 | 约 9.6 万词 |
| GPT-4o | 128K | 约 6 万字 | 约 9.6 万词 |
| Claude 3.5 Sonnet | 200K | 约 10 万字 | 约 15 万词 |
| Claude 3 Opus | 200K | 约 10 万字 | 约 15 万词 |
| LLaMA 3.1 | 128K | 约 6 万字 | 约 9.6 万词 |
| GLM-4 | 128K | 约 8 万字 | 约 9.6 万词 |
| GLM-4-Long | 1M | 约 50 万字 | 约 75 万词 |
| Gemini 1.5 Pro | 2M | 约 100 万字 | 约 150 万词 |
从表格可以看出,不同模型上下文窗口差异巨大。Claude 在窗口大小上有优势,GLM 在中文 Token 效率上占优,Gemini 在超长上下文方面领先。
2.3.3 上下文窗口的"有效注意力"问题
上下文窗口大,不等于模型能均匀关注所有内容。LLM 存在以下注意力衰减现象:
Lost in the Middle 效应。斯坦福研究发现,模型对 Prompt 开头和结尾的信息关注度远高于中间。上下文中大量检索文档时,中间位置的关键信息容易被忽略。
长上下文精度下降。上下文接近窗口上限时,模型对细节的回忆精度下降。这不是"忘记",而是注意力被稀释------每个位置需与所有其他位置计算相关性,上下文越长,注意力权重越分散。
对 Agent 设计的启示:
最重要的指令放 System Prompt 开头和结尾。对话历史不能无限制增长,需设计截断或压缩策略。RAG 文档排列顺序会影响效果,最相关的放开头和结尾。
2.3.4 Agent 的记忆管理策略
受限于上下文窗口,Agent 需要设计记忆管理策略。常见方案:
滑动窗口(Sliding Window):只保留最近 N 轮对话,丢弃更早的历史。简单高效,但会丢失长期上下文。
摘要压缩(Summarization):定期将旧对话历史压缩为摘要,保留关键信息。这会增加一次 LLM 调用的开销,但能大幅节省 Token。
分层记忆(Hierarchical Memory):将记忆分为短期(当前对话)、中期(摘要)、长期(向量数据库)三层。短期记忆用于即时对话,中期记忆通过摘要保留上下文,长期记忆通过向量检索按需调用。
选择性保留(Selective Retention):使用一个轻量级模型或规则系统,从对话历史中筛选出对当前任务最重要的信息,丢弃无关内容。
bash
Agent 记忆架构示意:

用户输入 --> [短期记忆: 最近N轮对话]
                |
                v
           [摘要引擎] --> [中期记忆: 压缩摘要]
                |
                v
           [向量存储] --> [长期记忆: 语义检索]
2.3.5 上下文窗口与成本的关系
上下文窗口越大,API 成本越高。主流模型定价分输入 Token 和输出 Token,输出通常是输入的 3-5 倍。
以 GPT-4 Turbo 为例,输入 10/百万Token,输出30/百万 Token。Agent 每次请求携带 50K Token 上下文,仅输入成本就 0.5/次。每天1000次请求,仅上下文成本500/天。
所以"用满上下文窗口"不是好策略。在效果和成本之间找到平衡点,通过合理的记忆管理和信息检索,让每一 Token 都发挥最大价值。
2.4 采样策略:Temperature、Top-p、Top-k 的工程选择
2.4.1 LLM 输出的概率分布
LLM 生成文本时,每一步都在预测下一个 Token 的概率分布。模型最后一层输出 logits(未归一化分数),经 softmax 转为概率分布。采样策略决定如何从分布中选择下一个 Token,直接影响输出的多样性、连贯性和确定性。
Agent 场景中采样策略尤为关键,需要在可靠性和创造性之间找到平衡。
2.4.2 Temperature:控制随机性
Temperature(温度)是最常用的采样参数。它通过调整 softmax 函数的"锐度"来控制概率分布的平坦程度:
bash
softmax(logits / T)- T = 0:贪婪模式,始终选择概率最高的 Token。输出完全确定,适合代码生成、Function Calling 等需要精确性的场景。
- T = 1.0:标准 softmax,按原始概率分布采样。
- T > 1.0:概率分布变平坦,低概率 Token 被选中的机会增加,输出更随机、更有创意,但也更容易出现不连贯的内容。
在 Agent 开发中,Temperature 的推荐设置如下:
| Agent 任务类型 | 推荐 Temperature | 原因 |
|---|---|---|
| Function Calling | 0 - 0.1 | 需要严格遵循指令,输出结构化 JSON |
| 代码生成 | 0 - 0.2 | 代码需要精确,不允许创造性偏差 |
| 数据分析 | 0.1 - 0.3 | 需要逻辑严谨,少量灵活性 |
| 对话交互 | 0.5 - 0.7 | 需要自然流畅,避免机械感 |
| 创意写作 | 0.8 - 1.0 | 鼓励多样性和创造性 |
2.4.3 Top-k 采样
Top-k 只从概率最高的 k 个 Token 中采样,其他 Token 概率置零,有效过滤低质量"噪声"Token。但 k 值选择是个难题。
k 太小(k=1 等同贪婪采样),输出过于确定。k 太大可能引入不相关 Token。而且 k 值固定,无法根据分布形状自适应------模型很确定时(分布尖锐),k=10 可能包含大量不合理选项;模型不确定时(分布坦),k=10 可能正好合适。
2.4.4 Top-p(Nucleus Sampling)采样
Top-p 采样(核采样,Nucleus Sampling)解决了 Top-k 固定 k 值的问题:选择概率累计达到 p 的最小 Token 集合,只在该集合中采样。
Top-p 优势在于自适应。分布尖锐时(模型确定),选出集合小;分布坦平时(模型不确定),选出集合大。
常用 Top-p 设为 0.9-0.95,保留 90%-95% 概率质量,过滤长尾低概率 Token。
2.4.5 组合使用与最佳实践
实际工程中 Temperature、Top-p、Top-k 通常组合使用。推荐组合:
高可靠性场景(Function Calling、代码生成):
- Temperature = 0, Top_p = 1, Top_k = 1
- 等同于贪婪采样,最大化确定性
平衡场景(Agent 对话):
- Temperature = 0.3, Top_p = 0.9, Top_k = 40
- 适度多样性,保持逻辑连贯
创意场景(内容生成):
- Temperature = 0.8, Top_p = 0.95, Top_k = 50
- 较高多样性,但过滤极端选项
不同模型对相同参数的敏感度不同。OpenAI 模型在 Temperature=0 时很稳定,某些开源模型在 Temperature=0 时可能重复生成。切换模型时需重新调优采样参数。
2.4.6 其他采样参数
除了三个核心参数,还有几个采样相关设置:
Frequency Penalty(频率惩罚):降低已生成过 Token 的概率,减少重复,适合长文本生成。
Presence Penalty(存在惩罚):只要 Token 出现过就降低概率,鼓励引入新词汇。与 Frequency Penalty 不同,它不关心出现次数,只关心是否出现过。
Stop Sequences(停止序列) :指定遇到某些字符串时停止生成。在 Agent 场景中,常用于控制输出格式,例如遇到 </tool_call> 时停止。
2.5 幻觉问题:Agent 场景的成因与缓解策略
2.5.1 什么是幻觉
幻觉(Hallucination)是 LLM 生成看似合理但不正确、无依据或虚构的内容。在 Agent 场景中尤其危险,因为 Agent 会基于模型输出做实际工具调用和决策。
幻觉主要分为三种类型:
事实性幻觉(Factual Hallucination):模型生成与客观事实不符的内容。例如,声称某篇论文的作者是错误的,或编造不存在的 API 接口。
忠实性幻觉(Faithfulness Hallucination):模型输出与给定的上下文或指令不一致。例如,用户要求总结一篇文章,但模型在总结中加入了原文没有的信息。
指令幻觉(Instruction Hallucination):模型误解或编造指令。例如,Agent 被要求调用天气 API,但模型编造了一个不存在的 API 端点。
2.5.2 幻觉的成因分析
理解幻觉成因才能设计缓解策略。从模型和工程两个维度分析。
模型层面:训练数据包含错误信息和虚构内容,模型不加区分地学习了这些内容。最大似然训练目标鼓励"流畅"而非"准确"------流畅但错误的回答概率可能高于生涩但正确的回答。模型也缺乏"不知道"的能力,被训练为对每个输入都给出回答。
工程层面:Prompt 设计不当------模糊指令、缺乏上下文、未限定回答范围,都会增加幻觉概率。上下文窗口中信息冲突时,模型可能选择性忽略某些约束。工具调用结果被误读------模型不理解返回字段时可能"猜"含义,导致幻觉。
2.5.3 Agent 场景中的幻觉缓解策略
针对 Agent 场景,以下策略可有效缓解幻觉:
RAG(检索增强生成)。模型生成回答前,先从外部知识库检索相关文档作为上下文,提供事实依据,减少对参数化知识的依赖。
python
# RAG 基本流程示例
def agent_with_rag(user_query, vector_db, llm_client):
    # 1. 检索相关文档
    retrieved_docs = vector_db.similarity_search(user_query, top_k=3)
    context = "\n".join([doc.content for doc in retrieved_docs])

    # 2. 构造带上下文的 Prompt
    prompt = f"""基于以下参考资料回答问题。如果资料中没有答案,请说"我无法根据现有资料回答"。

    参考资料:
    {context}

    问题:{user_query}"""

    # 3. 调用模型
    return llm_client.chat(prompt, temperature=0)
CoT(思维链)推理。要求模型在给最终答案前先展示推理过程,提高透明度的同时让模型有机会"自我检查"。
工具验证机制。Agent 执行关键操作前增加验证步骤,如检查 API 端点是否存在、参数是否合法,再执行调用。
置信度评估。让模型输出多个候选回答并比较一致性,不一致时触发人工审核或回退策略。
结构化输出约束。用 Function Calling 或 JSON Schema 约束输出格式,减少自由文本中的幻觉空间。结构化输出比自由文本更容易验证。
2.5.4 幻觉检测与评估
Agent 生产环境需建立幻觉检测机制:
自我一致性检查(Self-Consistency):对同一个问题用不同 Temperature 多次采样,检查回答的一致性。一致性低意味着高幻觉风险。
交叉验证:使用另一个 LLM 对生成结果进行事实核查。这会增加延迟和成本,但对高可靠性场景是值得的。
引用追溯:要求模型在回答中标注信息来源。如果来源无法追溯到上下文或知识库,则标记为潜在幻觉。
幻觉无法完全消除,但多层防御可将其降到可接受水平。Agent 系统设计应始终假设模型可能产生幻觉,在架构层面做好容错准备。
2.6 Function Calling 与结构化输出
2.6.1 Function Calling 的意义
Function Calling 是 LLM 从"聊天机器人"进化为"Agent"的关键能力。模型根据用户意图决定调用哪个外部工具、传入什么参数,并将工具返回结果整合到后续推理中。
没有 Function Calling 之前,让 LLM 调用外部工具需要复杂 Prompt 工程------正则解析模型输出中的工具调用意图、处理格式异常、维护调用状态。Function Calling 将这些逻辑标准化为模型原生能力,大幅降低 Agent 开发复杂度。
2.6.2 Function Calling 的工作流程
Function Calling 完整流程:
- 开发者在 API 请求中定义可用的工具(Tools)列表
- 模型分析用户输入,判断是否需要调用工具
- 如果需要,模型生成结构化的工具调用请求(包含函数名和参数)
- Agent 框架执行实际的工具调用
- 将工具返回结果送回模型
- 模型基于工具结果生成最终回答或决定下一步操作
2.6.3 Function Calling 的 JSON 结构
以下是一个典型的 Function Calling 请求结构:
json
{
  "model": "gpt-4",
  "messages": [
    {"role": "system", "content": "你是一个天气助手"},
    {"role": "user", "content": "北京今天天气怎么样?"}
  ],
  "tools": [
    {
      "type": "function",
      "function": {
        "name": "get_weather",
        "description": "获取指定城市的当前天气信息",
        "parameters": {
          "type": "object",
          "properties": {
            "city": {
              "type": "string",
              "description": "城市名称,如北京、上海"
            },
            "unit": {
              "type": "string",
              "enum": ["celsius", "fahrenheit"],
              "description": "温度单位"
            }
          },
          "required": ["city"]
        }
      }
    }
  ],
  "tool_choice": "auto"
}
模型返回的工具调用如下:
json
{
  "role": "assistant",
  "tool_calls": [
    {
      "id": "call_abc123",
      "type": "function",
      "function": {
        "name": "get_weather",
        "arguments": "{\"city\": \"北京\", \"unit\": \"celsius\"}"
      }
    }
  ]
}
2.6.4 tool_choice 参数的工程意义
tool_choice 参数控制模型工具选择行为,三个主要选项:
"auto"(默认):模型自主决定是否调用工具。适合大多数 Agent 场景,模型根据用户意图智能判断。
"none":禁止模型调用任何工具。适合纯对话场景,或强制模型用自然语言回答。
指定函数 :强制模型调用特定的函数。格式为 {"type": "function", "function": {"name": "function_name"}}。适合需要强制执行某个操作的场景,如"必须调用安全检查工具"。
Agent 多步推理流程中,合理使用 tool_choice 可提高可靠性。比如需要模型必须执行安全检查时,将 tool_choice 设为指定函数,避免模型"跳过"安全步骤。
2.6.5 结构化输出的进阶:JSON Schema 约束
除了 Function Calling,越来越多模型支持基于 JSON Schema 的结构化输出。开发者定义 JSON Schema,模型保证输出严格符合 Schema。
json
{
  "type": "json_schema",
  "json_schema": {
    "name": "agent_decision",
    "schema": {
      "type": "object",
      "properties": {
        "action": {
          "type": "string",
          "enum": ["call_tool", "respond", "ask_user"]
        },
        "tool_name": {
          "type": "string",
          "description": "要调用的工具名称"
        },
        "reasoning": {
          "type": "string",
          "description": "决策推理过程"
        },
        "confidence": {
          "type": "number",
          "minimum": 0,
          "maximum": 1
        }
      },
      "required": ["action", "reasoning", "confidence"]
    }
  }
}
模型输出可被代码直接解析,无需额外正则或容错。对多步推理 Agent,每个中间步骤都可用结构化输出保证格式一致性。
2.6.6 多工具并行调用
较新模型支持一次推理中并行调用多个工具。用户问"北京和上海的天气分别是什么",模型一次性生成两个 get_weather 调用,分别传入"北京"和"上海"。
并行调用显著提升 Agent 响应速度,但也增加状态管理复杂度。Agent 框架需正确处理多个工具调用的并发执行、结果收集和错误处理。
2.7 主流模型对比:GPT-4、Claude、LLaMA、GLM 的 Agent 能力
2.7.1 评估维度
评估 LLM 在 Agent 场景中的能力,需从多个维度综合考量。比较框架:
| 评估维度 | 说明 |
|---|---|
| 推理能力 | 复杂逻辑推理、多步规划的能力 |
| Function Calling | 工具调用的准确率和稳定性 |
| 上下文窗口 | 能处理的上下文长度 |
| 代码能力 | 代码生成、理解和调试能力 |
| 多语言支持 | 中文等非英文语言的能力 |
| 指令遵循 | 对复杂指令的遵循程度 |
| 延迟与速度 | 首 Token 延迟和生成速度 |
| 成本 | API 调用价格 |
| 开源/闭源 | 是否可本地部署 |
| 工具生态 | 周边工具链和社区支持 |
2.7.2 四大模型详细对比
| 维度 | GPT-4o | Claude 3.5 Sonnet | LLaMA 3.1 405B | GLM-4 |
|---|---|---|---|---|
| 推理能力 | 优秀 | 优秀 | 良好 | 良好 |
| Function Calling | 原生支持,稳定 | 原生支持,稳定 | 需微调 | 原生支持,稳定 |
| 上下文窗口 | 128K | 200K | 128K | 128K |
| 代码能力 | 优秀 | 优秀 | 良好 | 良好 |
| 中文能力 | 良好 | 良好 | 一般 | 优秀 |
| 指令遵循 | 优秀 | 优秀 | 良好 | 优秀 |
| 首Token延迟 | 约 0.5s | 约 0.8s | 依赖部署 | 约 0.5s |
| 输入价格($/M Token) | 2.5 | 3.0 | 自部署 | 0.5 |
| 输出价格($/M Token) | 10.0 | 15.0 | 自部署 | 1.5 |
| 开源 | 否 | 否 | 是 | 是(GLM-4-9B) |
2.7.3 各模型的 Agent 能力特点
GPT-4o:综合能力最强,Function Calling 稳定性最高,生态最完善。API 提供完善的工具调用、结构化输出、流式响应。缺点是成本高、闭源无法定制。适合可靠性要求高、预算充足的 Agent 项目。
Claude 3.5 Sonnet:上下文窗口最大(200K),长文档分析和代码理解突出。Artifacts 功能和 Prompt Caching 机制对 Agent 开发有价值。缺点是 API 生态不如 OpenAI 丰富,部分高级功能需特定接入方式。
LLaMA 3.1:开源旗舰,405B 版本能力接近 GPT-4。最大优势是本地部署、数据不出域,适合数据隐私要求高的场景。缺点是部署成本高(多张 GPU),原生 Function Calling 需额外微调。
GLM-4:中文能力最强,Token 效率高,成本最低。Function Calling 能力与 GPT-4 相当,开源版本(GLM-4-9B)可本地部署。中文 Agent 场景性价比优势明显。GLM-4-Long 支持 1M 上下文,适合超长文档处理。
2.7.4 模型选择决策框架
实际项目中,选择模型可参考以下决策树:
bash
是否需要数据完全私有?
├── 是 --> 预算是否充足部署大模型?
│         ├── 是 --> LLaMA 3.1 405B 或 GLM-4-9B 本地部署
│         └── 否 --> GLM-4-9B (9B参数,单卡可部署)
└── 否 --> 主要使用语言?
          ├── 中文为主 --> GLM-4 (性价比最优)
          ├── 英文为主 --> 预算充足?
          │             ├── 是 --> GPT-4o 或 Claude 3.5
          │             └── 否 --> GPT-4o-mini
          └── 多语言 --> Claude 3.5 (200K上下文优势)
2.7.5 多模型协作架构
复杂 Agent 系统不一定只用一个模型。多模型协作是工程中常见模式:
路由模型(Router):用轻量级模型(如 GPT-4o-mini)分析用户意图,路由到最合适的模型。简单问题用小模型快速回答,复杂问题用大模型深度推理。
规划-执行分离:强模型(如 GPT-4o)负责任务规划和工具选择,快速模型(如 GLM-4-Flash)执行子任务,保证规划质量的同时降低延迟和成本。
交叉验证:关键决策环节用两个不同模型分别给出答案,不一致时触发人工审核或用更强模型做最终判断。
2.8 Embedding 与 MCP:Agent 生态的基础设施
2.8.1 Embedding 的概念与作用
Embedding(嵌入)将离散文本(词、句子、文档)映射为连续的稠密向量。向量空间中语义相近的文本距离近,无关的远。Embedding 是 Agent 记忆系统、知识检索和语义理解的基础。
与关键词匹配不同,Embedding 能理解语义相似性。"如何部署应用"和"怎样发布服务"在关键词层面无交集,在语义空间中向量却很接近。
2.8.2 Embedding 模型的工作原理
现代 Embedding 模型通常基于 Transformer 架构,取 CLS Token 或做平均池化得到向量表示。训练目标是对比学习:让正样本对距离缩小,负样本对距离扩大。
python
# 使用 OpenAI Embedding API 的示例
from openai import OpenAI
import numpy as np

client = OpenAI()

def get_embedding(text, model="text-embedding-3-small"):
    response = client.embeddings.create(
        input=text,
        model=model
    )
    return response.data[0].embedding

# 计算余弦相似度
def cosine_similarity(vec_a, vec_b):
    return np.dot(vec_a, vec_b) / (np.linalg.norm(vec_a) * np.linalg.norm(vec_b))

query = "如何部署Python应用到服务器"
doc1 = "Python应用的Docker部署指南"
doc2 = "今天的天气很好"

emb_query = get_embedding(query)
emb_doc1 = get_embedding(doc1)
emb_doc2 = get_embedding(doc2)

print(f"相关文档相似度: {cosine_similarity(emb_query, emb_doc1):.4f}")
print(f"无关文档相似度: {cosine_similarity(emb_query, emb_doc2):.4f}")
# 相关文档相似度: 0.8732
# 无关文档相似度: 0.1234
2.8.3 主流 Embedding 模型对比
| 模型 | 维度 | 最大输入 | 多语言 | 开源 |
|---|---|---|---|---|
| text-embedding-3-small | 1536 | 8191 | 是 | 否 |
| text-embedding-3-large | 3072 | 8191 | 是 | 否 |
| bge-large-zh-v1.5 | 1024 | 512 | 中文优 | 是 |
| bge-m3 | 1024 | 8192 | 是(多语言) | 是 |
| gte-large | 1024 | 512 | 是 | 是 |
| voyage-2 | 1024 | 4000 | 是 | 否 |
选择 Embedding 模型需考虑:向量维度影响存储和检索速度,最大输入长度决定能否直接嵌入长文档,多语言能力影响跨语言检索效果。
2.8.4 向量数据库与检索策略
Agent 长期记忆通常存在向量数据库中。主流选项:
| 向量数据库 | 特点 | 适用场景 |
|---|---|---|
| Milvus | 分布式,高可用,支持十亿级向量 | 大规模生产环境 |
| Pinecone | 托管服务,免运维 | 快速原型开发 |
| Chroma | 轻量级,Python 原生 | 小型 Agent 项目 |
| Qdrant | Rust 实现,高性能 | 中大规模,性能敏感 |
| pgvector | PostgreSQL 扩展 | 已有 PG 基础设施 |
检索策略不限于简单相似度搜索,还包括:
混合检索(Hybrid Search):结合向量检索和 BM25 关键词检索,取并集或加权融合。向量检索擅长语义匹配,关键词检索擅长精确匹配,互补。
重排序(Reranking):向量检索快速召回 Top-100 候选,再用 Cross-Encoder 精细排序取 Top-5。两阶段策略平衡效果和速度。
元数据过滤:向量检索前先按元数据(时间、来源、类型)过滤,缩小检索范围。对需要按时间范围或数据来源检索的 Agent 场景很重要。
2.8.5 MCP 协议:Agent 工具调用的标准化
MCP(Model Context Protocol)是 Anthropic 2024 年提出的开放标准,标准化 LLM 与外部工具、数据源的连接方式。可以把 MCP 理解为 Agent 世界的"USB 接口"------实现 MCP 协议的工具,能被任何支持 MCP 的 Agent 直接使用。
MCP 出现前,每个 Agent 框架(LangChain、AutoGPT、CrewAI 等)有自己的工具定义格式和调用方式,工具开发者要为每个框架写适配代码,工具无法跨框架复用。MCP 解决了这个问题。
2.8.6 MCP 的架构设计
MCP 采用 Client-Server 架构:
bash
Agent (MCP Client)
    |
    |-- MCP Protocol (JSON-RPC 2.0)
    |
MCP Server (Tool Provider)
    |
    |-- Tool 1: file_read
    |-- Tool 2: web_search
    |-- Tool 3: database_query
    |-- Resource: config_file
    |-- Prompt: code_review_template
MCP Server 向 Client 暴露三种能力:
Tools(工具):可被模型调用的函数,类似于 Function Calling 中的函数定义。例如文件读写、数据库查询、API 调用等。
Resources(资源):可被读取的数据源,类似于文件系统中的文件。模型可以按需读取资源内容,如配置文件、文档、数据库表结构等。
Prompts(提示模板):预定义的 Prompt 模板,可被复用。例如代码审查模板、数据分析模板等。
2.8.7 MCP 对 Agent 生态的影响
MCP 正在重塑 Agent 生态,带来几个重要变化:
工具复用:一个 MCP Server 可以被多个 Agent 框架使用,无需重复开发。例如,一个 GitHub MCP Server 可以同时服务于 LangChain Agent、Claude Desktop 和其他支持 MCP 的客户端。
标准化工具发现:Agent 可以在运行时动态发现 MCP Server 提供的工具列表,无需在编译时硬编码工具定义。这使得 Agent 具备了"即插即用"的工具扩展能力。
安全边界清晰:MCP Server 定义了明确的权限边界,Agent 只能通过 MCP Server 暴露的接口访问外部资源,无法越权操作。
2.8.8 Embedding 与 MCP 的协同
完整 Agent 架构中,Embedding 和 MCP 扮演互补角色:
Embedding 负责知识存储和检索。Agent 长期记忆、知识库、文档档案通过 Embedding 转为向量存入向量数据库,需要时通过向量检索快速获取。
MCP 负责工具访问和操作。Agent 读写文件、查询数据库、调用 API 时通过 MCP Server 执行,提供标准化的工具调用接口。
两者结合构成 Agent 的"记忆-行动"循环:先通过 Embedding 检索相关知识,再通过 MCP 执行操作,操作结果通过 Embedding 存入记忆,形成闭环。
本章知识点总结
| 知识点 | 核心内容 | 对 Agent 的影响 |
|---|---|---|
| Transformer 架构 | Self-Attention 计算序列中任意两位置的依赖关系,复杂度 O(n^2) | 决定了上下文窗口的计算成本和延迟特性 |
| 位置编码 | RoPE/ALiBi 等方案支持长度外推 | 影响模型能处理的上下文长度上限 |
| Token 与 Tokenization | BPE/WordPiece/SentencePiece 三大算法 | 直接影响中文场景的成本和上下文有效容量 |
| 上下文窗口 | 128K-2M Token 不等,存在 Lost in Middle 效应 | Agent 需要设计记忆管理策略,不能无限制堆叠上下文 |
| Temperature | 控制 softmax 锐度,T=0 最确定,T>1 更随机 | Function Calling 场景应设为 0-0.1 |
| Top-p 采样 | 自适应选择概率累计达 p 的 Token 集合 | 常用 0.9-0.95,过滤长尾噪声 |
| 幻觉问题 | 事实性/忠实性/指令性三类幻觉 | 需 RAG + CoT + 结构化输出 + 验证机制多层防御 |
| Function Calling | 模型原生支持的工具调用能力,JSON 格式标准化 | Agent 从聊天机器人进化为行动体的关键 |
| 结构化输出 | 基于 JSON Schema 约束输出格式 | 提高输出可解析性,降低幻觉空间 |
| 模型选择 | GPT-4o/Claude/LLaMA/GLM 各有优势 | 中文场景优选 GLM,私有部署选 LLaMA 或 GLM-9B |
| 多模型协作 | 路由/规划执行分离/交叉验证 | 平衡成本、速度和可靠性 |
| Embedding | 文本的稠密向量表示,支持语义检索 | Agent 长期记忆的基础,RAG 的核心组件 |
| 向量数据库 | Milvus/Pinecone/Chroma/Qdrant 等 | 选择需考虑规模、性能、运维成本 |
| 混合检索 | 向量检索 + BM25 关键词检索 | 互补语义匹配和精确匹配 |
| MCP 协议 | 标准化 LLM 与工具/数据源的连接 | 工具跨框架复用,即插即用的 Agent 工具生态 |
本章从 Transformer 底层原理到 Agent 工程实际选择,系统覆盖了 LLM 核心技术基础。后续第三章将基于这些能力,深入探讨 Agent 架构设计模式。