目录
[一. 为什么需要 CNN------从全连接的困境说起](#一. 为什么需要 CNN——从全连接的困境说起)
[传统神经网络 vs CNN](#传统神经网络 vs CNN)
[二. CNN 的整体组成:一条流水线](#二. CNN 的整体组成:一条流水线)
[CNN 的主要组成](#CNN 的主要组成)
[三. 卷积层:核心计算在做什么](#三. 卷积层:核心计算在做什么)
[四. 输出尺寸与通道:一个公式打天下](#四. 输出尺寸与通道:一个公式打天下)
[五. 权重共享:CNN 省参数的关键一招](#五. 权重共享:CNN 省参数的关键一招)
[六. 多层卷积:特征从局部到全局](#六. 多层卷积:特征从局部到全局)
[七. 池化层:只记要点,丢掉细节](#七. 池化层:只记要点,丢掉细节)
[最大池化 vs 平均池化](#最大池化 vs 平均池化)
[八. 感受野:看得多远,懂多深](#八. 感受野:看得多远,懂多深)
[九. 小卷积核堆叠:27c² 小于 49c² 的智慧](#九. 小卷积核堆叠:27c² 小于 49c² 的智慧)
[十. 经典网络结构:VGG](#十. 经典网络结构:VGG)
[VGG 结构剖面与配置表](#VGG 结构剖面与配置表)
[十一. 经典网络结构:ResNet------给深网络一条「退路」](#十一. 经典网络结构:ResNet——给深网络一条「退路」)
一. 为什么需要 CNN------从全连接的困境说起
全连接网络把图像拉平成一维向量,既丢失空间结构、参数量又爆炸;CNN 用「局部连接 + 权值共享」的卷积核在图上滑动提取特征,天然适配图像的网格结构。
传统神经网络 vs CNN
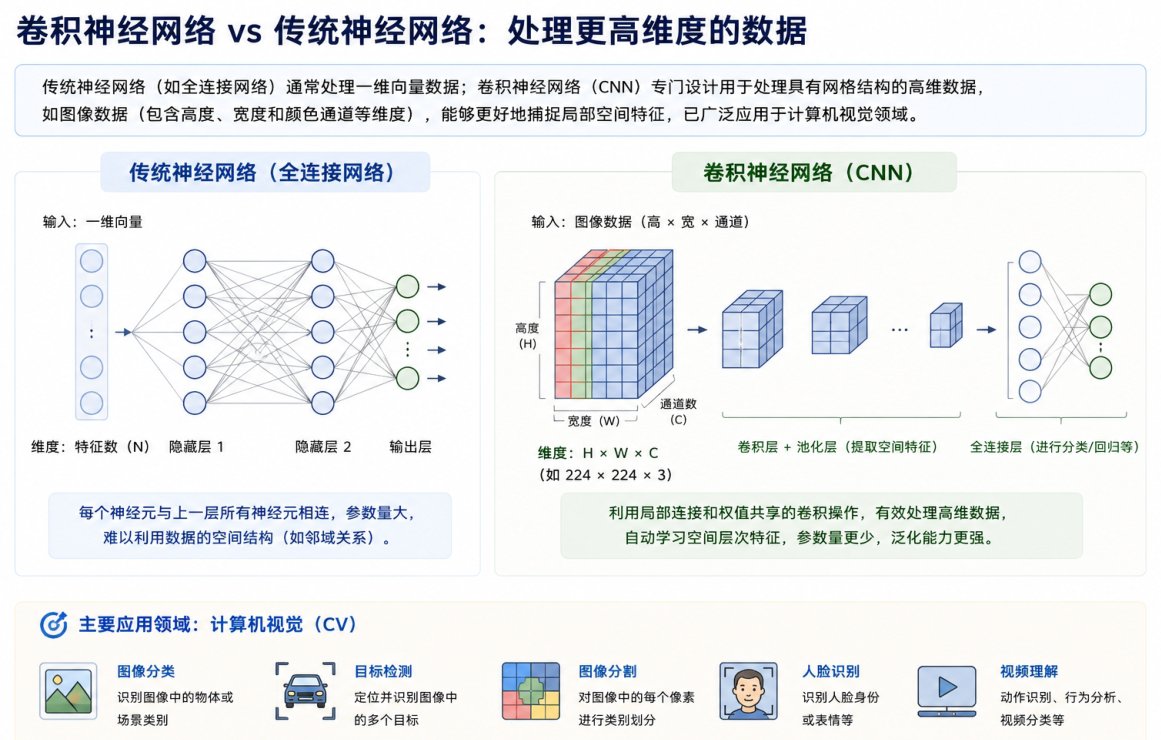
- 左半「传统神经网络(全连接网络)」:输入是一维特征向量,经隐藏层 1、隐藏层 2 到输出层;每个神经元与上一层所有神经元相连------参数量大,且难以利用图像的空间结构(如相邻像素的关联)。
- 右半「卷积神经网络(CNN)」:输入是三维图像数据 H×W×C(高度 × 宽度 × 通道数,如 224×224×3),先经「卷积层 + 池化层」提取空间特征,再接全连接层完成分类/回归。
- 图中下方两栏结论:全连接"每个神经元与上一层所有神经元相连,参数量大,难以利用数据的空间结构(如邻域关系)";CNN"利用局部连接和权值共享的卷积操作有效处理高维数据,自动学习空间层次特征,参数量更少、泛化能力更强"。
二. CNN 的整体组成:一条流水线
CNN = 输入层 → 卷积层 → 激活函数 → 池化层 × N → 全连接层 → 输出层;空间尺寸逐层缩小、通道数逐层增加,最后展平接全连接完成分类。类似一条加工流水线------先粗提特征,再压缩打包,反复几轮,最后由"决策车间"给出结论。
CNN 的主要组成
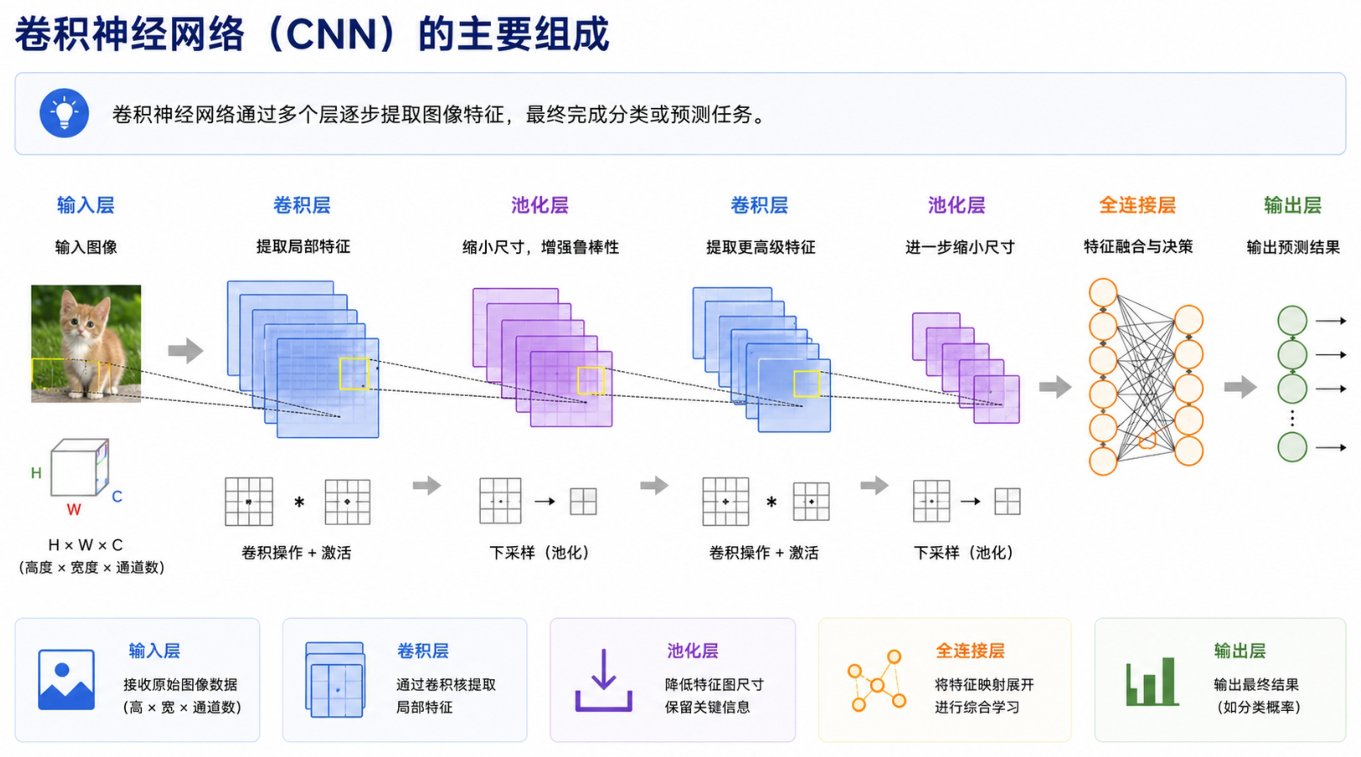
- 流水线:输入层(H×W×C)→ 卷积层(提取局部特征)→ 池化层(缩小尺寸、增强鲁棒性)→ 卷积层(提取更高级特征)→ 池化层(进一步缩小尺寸)→ 全连接层(特征融合与决策)→ 输出层(输出预测结果)。
- 层级分工口诀:浅层看纹理、中层看部件、深层看整体
- 现代 CNN 把「卷积 → 激活 → 池化」作为标准块重复堆叠;ResNet 之后池化常被步长为 2 的卷积替代,但"提特征 → 降尺寸 → 融合决策"的三段式骨架不变。
数据维度变化全程
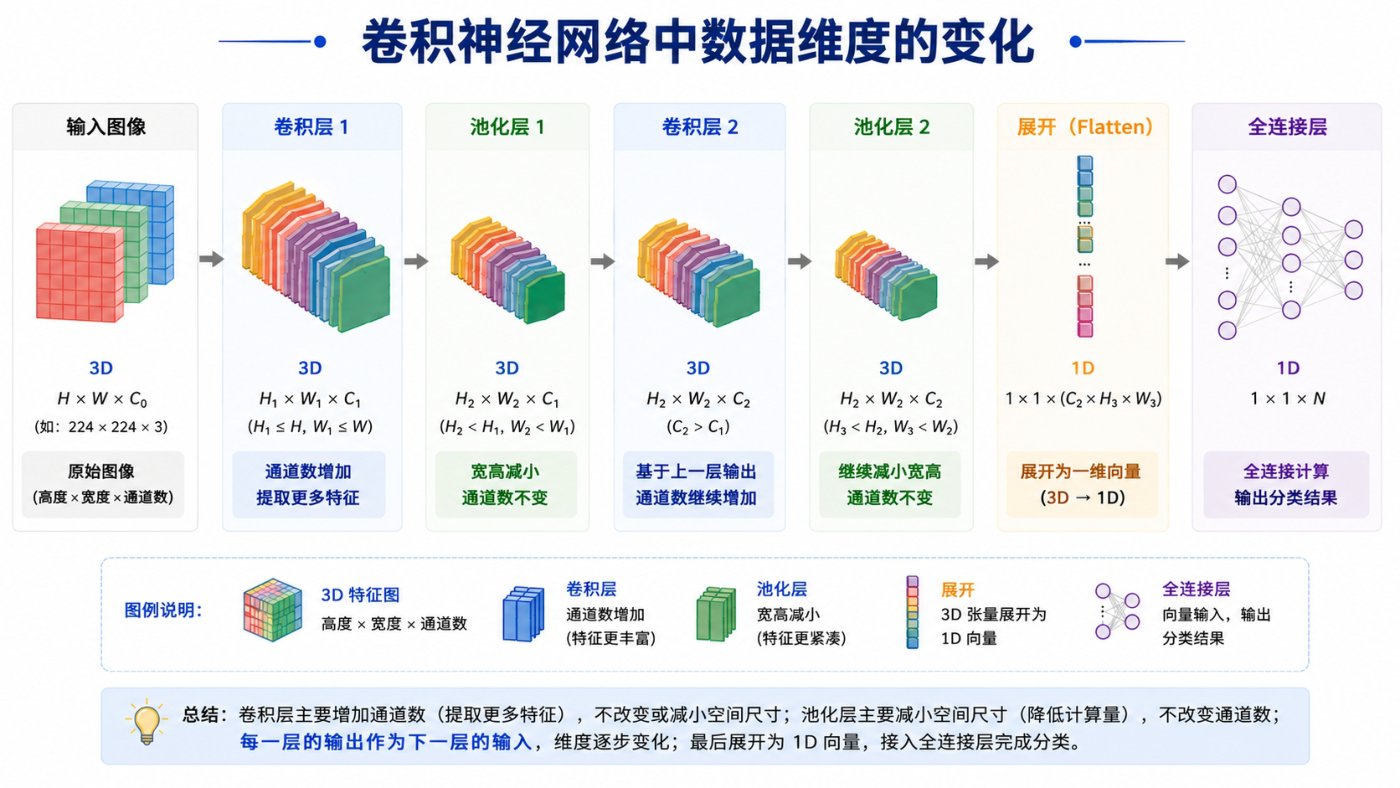
- 一张图看懂张量形状全程:输入 3D(H×W×C₀,如 224×224×3)→ 卷积层 1(3D:H₁×W₁×C₁,通道数增加"提取更多特征",宽高 ≤ 原尺寸)→ 池化层 1(H₂×W₂×C₁,宽高减小、通道不变"特征更紧凑")→ 卷积层 2(通道继续增加)→ 池化层 2(继续减小宽高)→ 展开 Flatten(3D→1D:1×1×(C₃×H₃×W₃))→ 全连接层(1×1×N,N 为类别数)。
- 图例说明五个角色:3D 特征图(高 × 宽 × 通道数)、卷积层(通道数增加,特征更丰富)、池化层(宽高变小,特征更紧凑)、展开(3D 张量展开为 1D 向量)、全连接层(向量输入输出分类结果)。
- 图底总结:卷积层主要增加通道数(提取更多特征),不改变或减小空间尺寸;池化层主要减小空间尺寸(降低计算量),不改变通道数;每一层的输出作为下一层的输入,维度逐步变化;最后展开为 1D 向量,接入全连接层完成分类。
- 金字塔规律:空间 H×W 逐层变小、通道 C 逐层变大------"空间换通道",信息表示从"哪里有什么"逐渐变成"有什么"。
- Flatten 的隐患:VGG 中 7×7×512 展平后接 FC-4096,仅一层就有约 1.03 亿参数(25088 × 4096);现代网络用全局平均池化 GAP(每张特征图取一个平均值)替代大 FC 层。
三. 卷积层:核心计算在做什么
卷积 = 卷积核在输入上按步长滑动,每个位置做点积(对应元素相乘再求和)并加偏置,得到特征图;滤波器深度必须等于输入通道数,空间上滑动、不跨深度。
多通道卷积数值计算
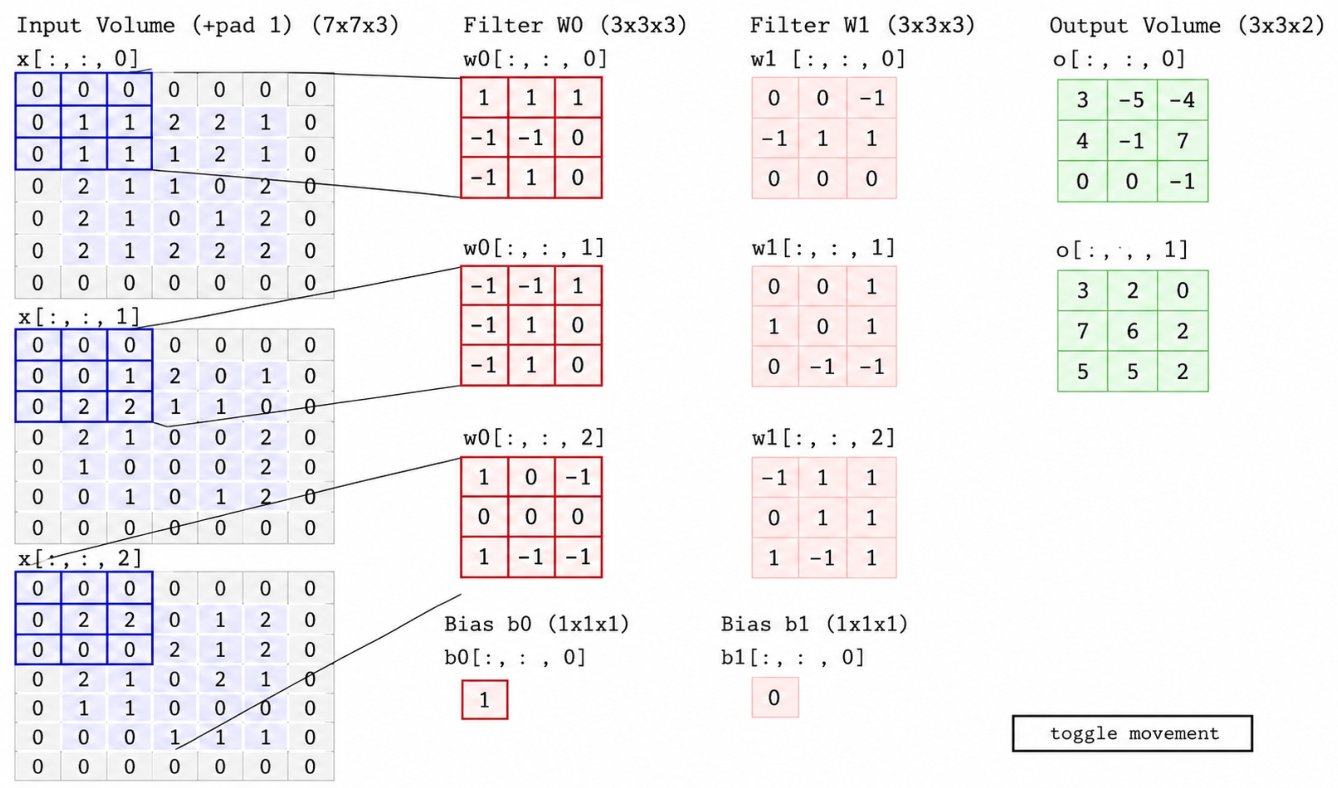
- CS231n 经典数值示例:输入体积 7×7×3(已含 padding 1),两个 3×3×3 滤波器 W0、W1,偏置 b0=1、b1=0,步长 2,输出 3×3×2。
- 图中颜色分工:蓝框 = 当前计算窗口(在 3 个输入通道上同时取 3×3 区域),红框 = 滤波器权重(w0/w1 各有 3 个通道切片),绿框 = 当前输出元素;右下角 toggle movement 按钮提示这是动画的其中一帧。
- 计算方法:窗口内 27 个数与滤波器 27 个权重对应相乘求和,再加偏置 → 写入输出一个位置;输出通道 0 由 W0 计算、通道 1 由 W1 计算。
四. 输出尺寸与通道:一个公式打天下
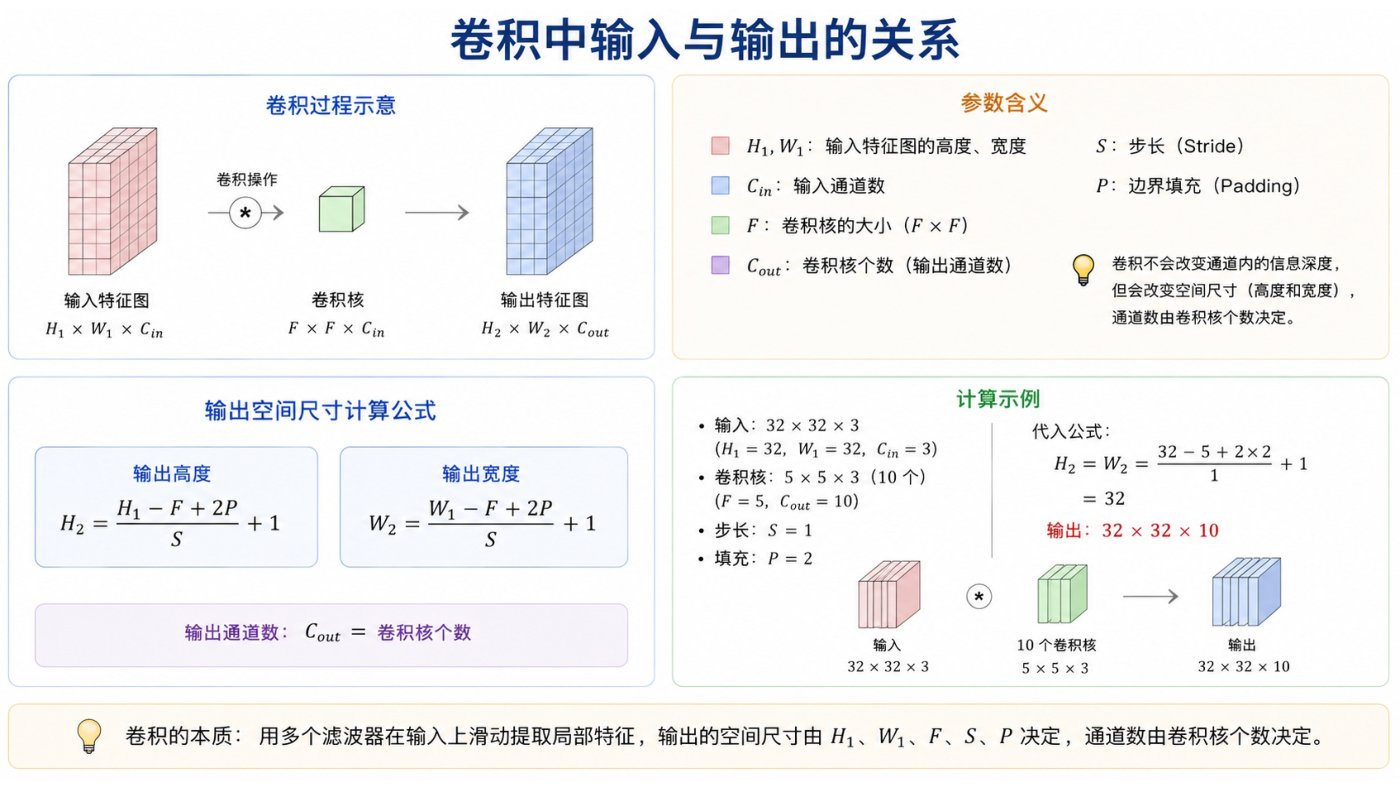
输出空间尺寸 H₂ = (H₁ − F + 2P) / S + 1(宽度同理);输出通道数 = 卷积核个数。
输入与输出的关系总图
五. 权重共享:CNN 省参数的关键一招
同一卷积核在输入所有空间位置重复使用(权值共享),参数量只与核大小和个数有关、与图像尺寸无关;对比全连接的"每个输出连所有输入",参数可差数十倍。
卷积中的权重参数共享
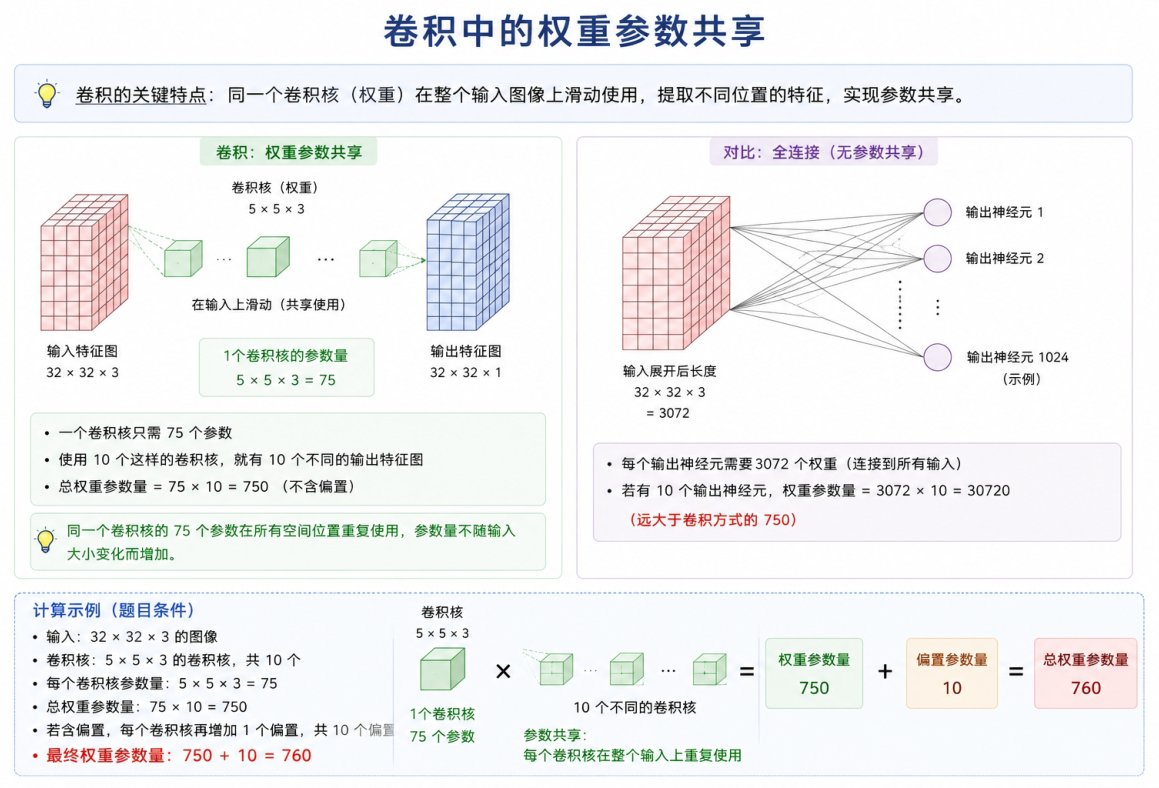
- 左半「卷积:权重参数共享」:32×32×3 输入上,一个 5×5×3 卷积核仅 75 个参数,在输入上滑动共享使用,输出 32×32×1;用 10 个这样的卷积核 → 10 张不同的输出特征图;总权重 75 × 10 = 750(不含偏置)。
- 右半「对比:全连接(无参数共享)」:输入展平后长度 32×32×3 = 3072,每个输出神经元需要 3072 个权重(连接所有输入);若有 10 个输出神经元,权重参数量 = 3072 × 10 = 30720,远大于卷积方式的 750。
- 底部计算示例(题目条件):输入 32×32×3;卷积核 5×5×3 共 10 个;每核参数 75;总权重 75×10=750;若含偏置每核再 +1 共 10 个偏置 → 最终总参数量 750 + 10 = 760。
- 绿色要点:同一卷积核的 75 个参数在所有空间位置重复使用,参数量不随输入大小变化而增加。
- 760 vs 30720 ≈ 1/40------权值共享的威力;输入升到 512×512 时全连接参数再涨 256 倍,卷积参数纹丝不动。
- 共享背后的假设:检测"猫耳朵"的模板在图像左上角和右下角同样有用(平移等变性 translation equivariance)------特征只与"模式"有关、与"位置"无关。
- 极端对照:全连接 ≈ "每个输出位置一个专属卷积核"(完全不共享);卷积 = "所有位置共用一个核"(极致共享)。
- 参数量公式速记:卷积层 (F×F×Cin + 1) × Cout;全连接层 (输入维度 + 1) × 神经元数。
六. 多层卷积:特征从局部到全局
浅层卷积提取边缘、纹理等小尺度局部特征,中层提取角点、形状,中深层提取部件与组合结构,深层提取整体结构与全局语义;感受野逐层扩大是层级化的前提。
多层卷积的层级特征
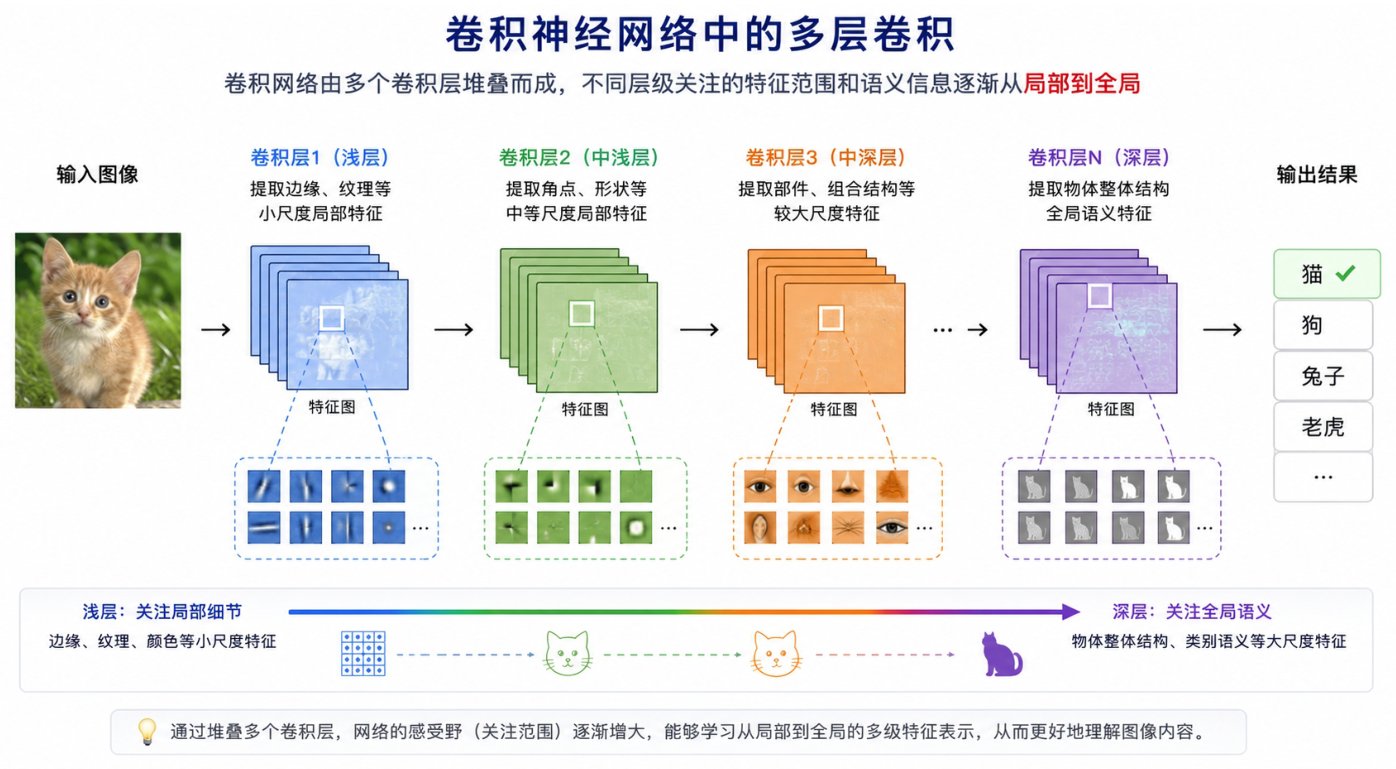
- 以猫图为例展示层级特征:卷积层 1(浅层)提取边缘、纹理等小尺度局部特征;卷积层 2(中层)提取角点、形状等中等尺度局部特征;卷积层 3(中深层)提取部件、组合结构(眼睛、耳朵)等较大尺度特征;卷积层 N(深层)提取物体整体结构、全局语义特征 → 输出结果「猫 ✓」。
- 每层下方的特征图可视化:浅层是零散的线条、色块响应,中层出现形状轮廓,深层已是完整的猫形响应图------"网络内部确实长这样"。
- 底部渐变条:浅层关注局部细节(边缘、纹理、颜色等小尺度特征)→ 深层关注全局语义(物体整体结构、类别语义等大尺度特征)。
- 图底总结:通过堆叠多个卷积层,网络的感受野(关注范围)逐渐增大,能够学习从局部到全局的多级特征表示,从而更好地理解图像内容。
- 层级成立的两个前提:感受野逐层扩大+ 层间非线性
七. 池化层:只记要点,丢掉细节
池化是无可学习参数的固定下采样------在窗口内取最大值或平均值,缩小特征图的同时扩大感受野、突出显著响应。
池化层的三大作用
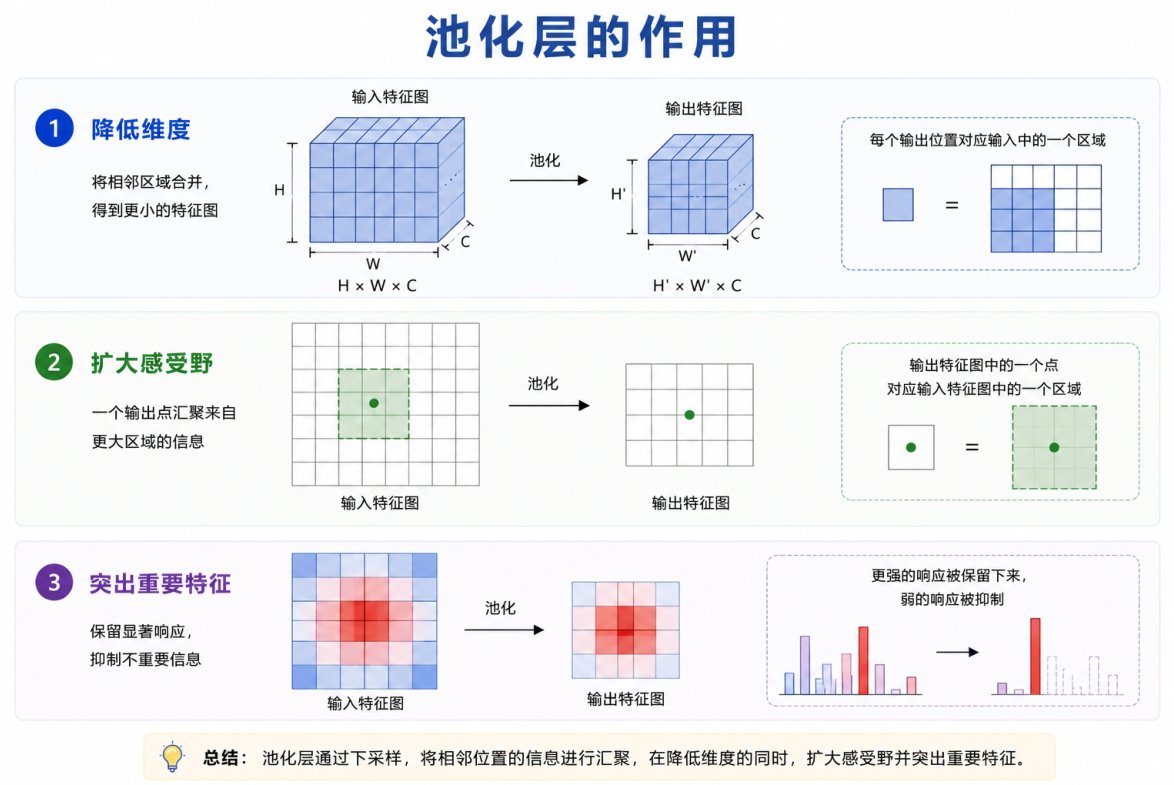
- ① 降低维度:输入特征图 H×W×C → 输出 H'×W'×C(H' 小于 H,W' 小于 W),把相邻区域合并得到更小的特征图;右侧图示"每个输出位置对应输入中的一个区域"。
- ② 扩大感受野:一个输出点汇聚来自输入中更大区域的信息;右侧图示"输出特征图中的一个点对应输入特征图中的一个区域"。
- ③ 突出重要特征:保留显著响应、抑制不重要信息;右侧柱状图显示池化后"更强的响应被保留下来,弱的响应被抑制"。
- 现代演变三连:ResNet 用 stride=2 卷积替代池化;分类网络末端用 GAP 替代大 FC 层;分割/检测任务里池化"丢位置"反而成缺点。
最大池化 vs 平均池化
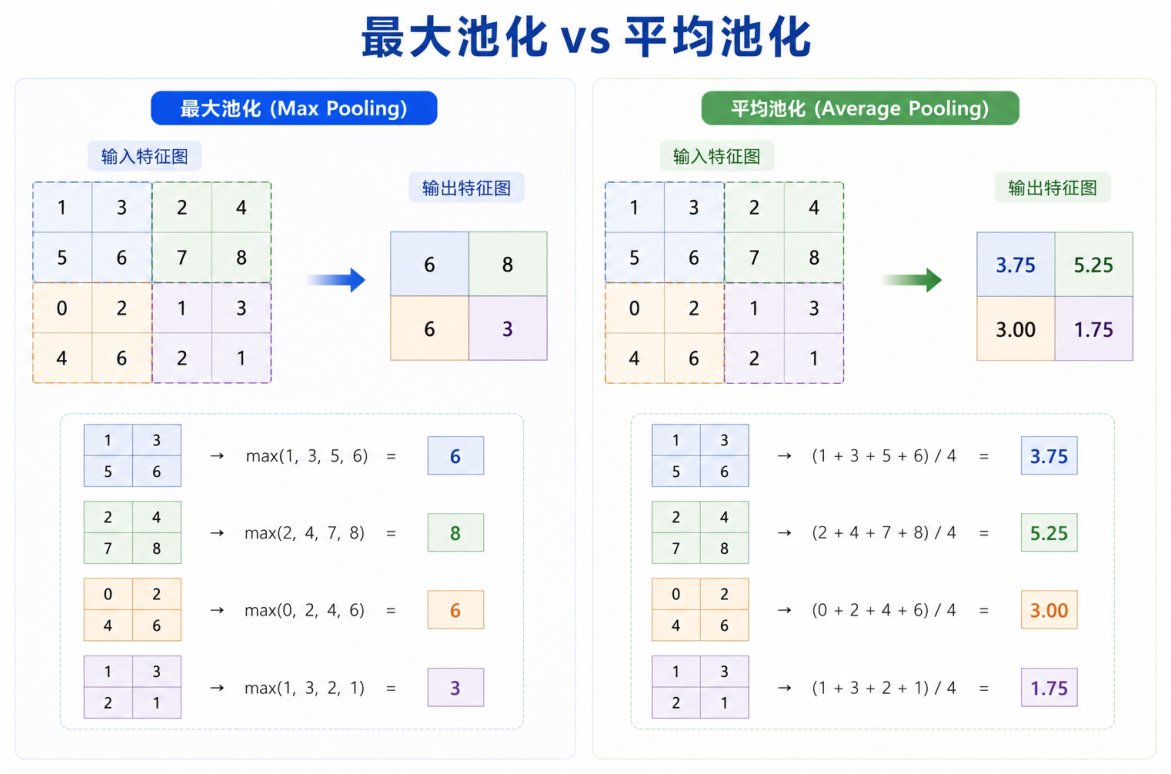
- 最大池化(Max Pooling,左侧):每个窗口取最大值 → 输出 \[6, 8, 6, 3];图下方列出四步:max(1, 3, 5, 6) = 6、max(2, 4, 7, 8) = 8、max(0, 2, 4, 6) = 6、max(1, 3, 2, 1) = 3。
- 平均池化(Average Pooling,右侧):每个窗口取平均值 → 输出 \[3.75, 5.25, 3.00, 1.75];四步:(1+3+5+6)/4 = 3.75、(2+4+7+8)/4 = 5.25、(0+2+4+6)/4 = 3.00、(1+3+2+1)/4 = 1.75。
- 选择直觉:Max 回答"有没有"(保留最强激活、突出显著特征),Avg 回答"平均怎样"(保留整体强度、画面更平滑);图像分类隐层主流用 Max,网络末端的全局池化用 Avg。
- 反向传播视角:Max 池化的梯度只流向窗口内最大值的位置,其余位置梯度为 0;Avg 把梯度平均分配给窗口内每个位置。
八. 感受野:看得多远,懂多深
感受野 = 输出特征图上一个像素所对应的输入图像区域范围;随层数加深、下采样叠加,感受野逐渐增大,网络能捕获的上下文也越丰富。
感受野的作用
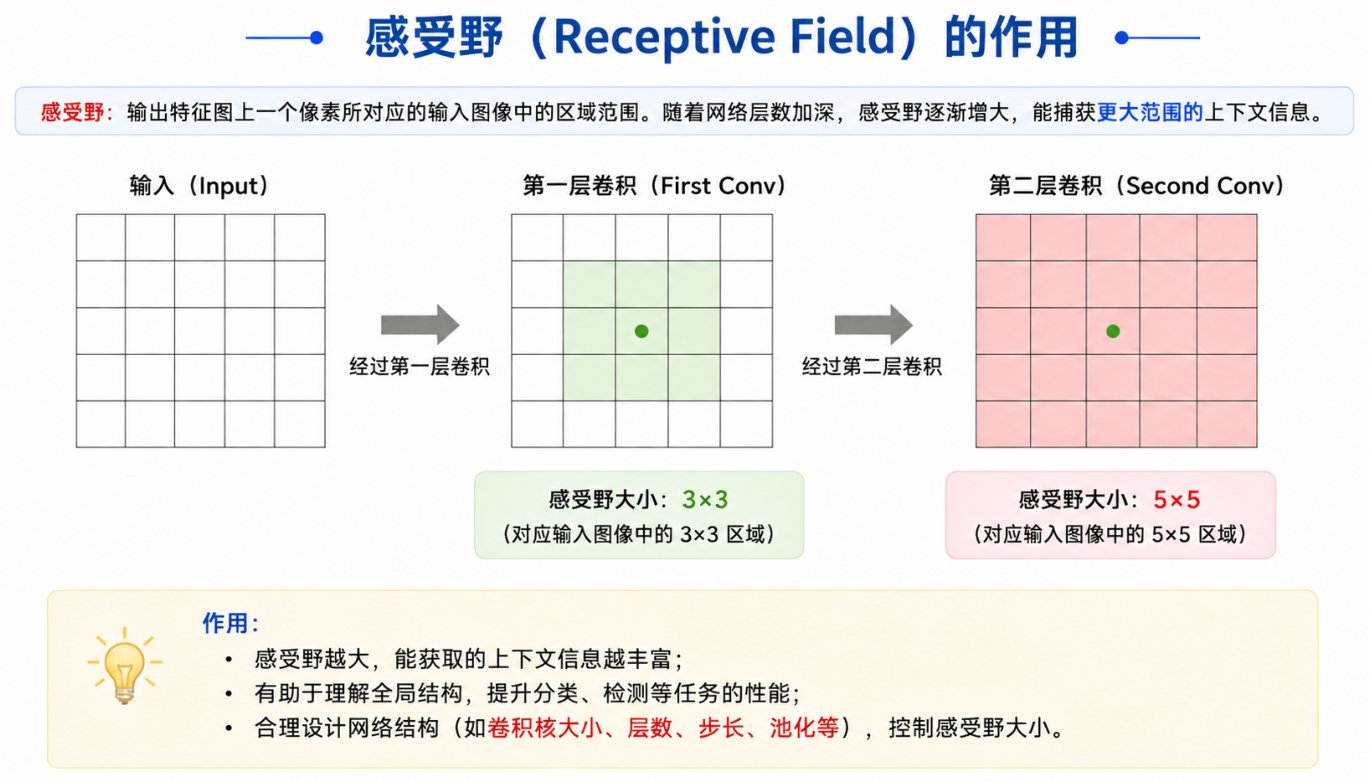
- 定义:感受野------输出特征图上一个像素所对应的输入图像中的区域范围;随着网络层数加深,感受野逐渐增大,能捕获更大范围的上下文信息。
- 三格示意:输入(Input)→ 第一层卷积(First Conv,绿色高亮区域:感受野大小 3×3,对应输入图像中的 3×3 区域)→ 第二层卷积(Second Conv,粉色高亮区域:感受野大小 5×5,对应输入图像中的 5×5 区域)。
- 图底作用总结:感受野越大,能获取的上下文信息越丰富;有助于理解全局结构,提升分类、检测等任务的性能;合理设计网络结构(如卷积核大小、层数、步长、池化等)可以控制感受野大小。
- 理论感受野不等于有效感受野:有效感受野呈高斯分布、集中在中心且明显更小。
- 工程上增大感受野的三板斧:堆层数、下采样(池化/大步长)、空洞(扩张)卷积------DeepLab 分割系列靠空洞卷积在不降分辨率的前提下扩感受野。
- 感受野是"一个输出点看得多远";平移不变性是"整体挪一下,输出基本不变"。
九. 小卷积核堆叠:27c² 小于 49c² 的智慧
在通道数不变的前提下,3 个串联 3×3 卷积的感受野等于 1 个 7×7,但参数量 27c² 远小于 49c²,且多了两次非线性变换。
小卷积核堆叠的优
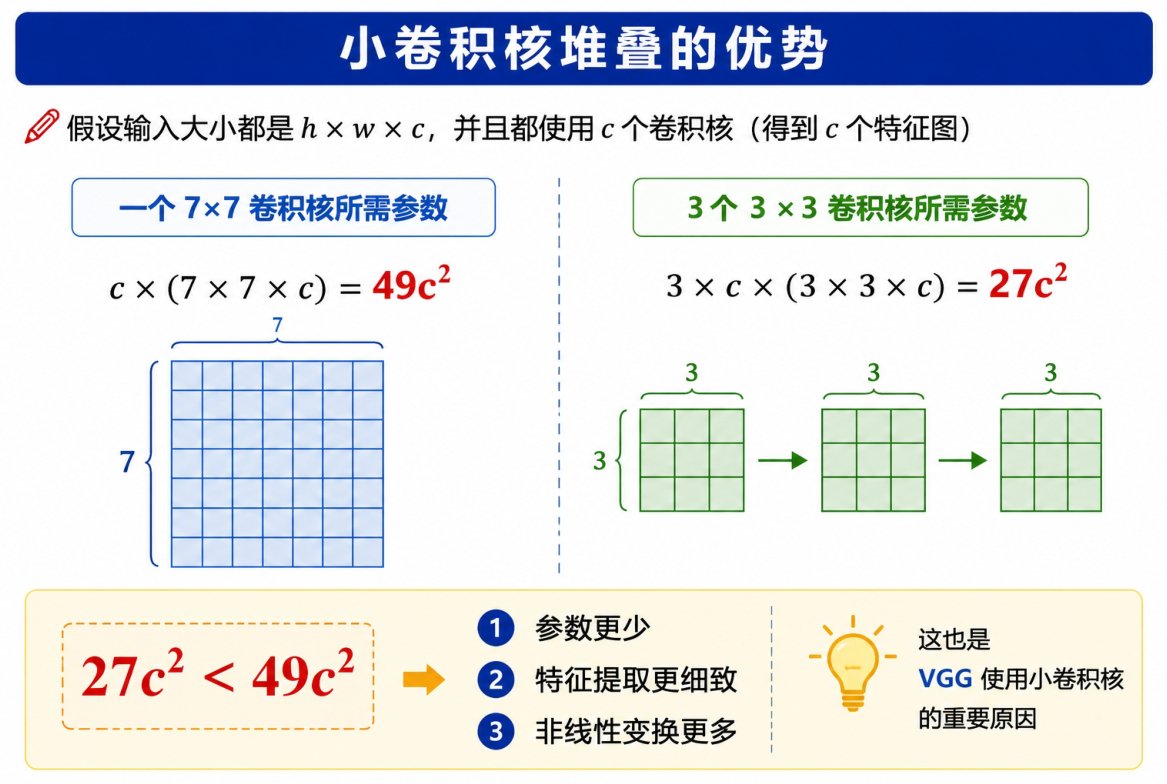
- 输入大小都是 h×w×c,并且都使用 c 个卷积核(得到 c 个特征图)。
- 左侧:一个 7×7 卷积核所需参数 = c × (7×7×c) = 49c²(配 7×7 蓝色网格示意)。
- 右侧:3 个 3×3 卷积核所需参数 = 3 × c × (3×3×c) = 27c²(三个 3×3 绿色网格依次串联,总覆盖范围同样是 7×7)。
结论框:27c² < 49c²,三大优势:① 参数更少;② 特征提取更细致(中间层多两级表达);③ 非线性变换更多(多过两次激活函数)。
两个 3×3 之间必须夹非线性(ReLU)才不等价于一层数学卷积;若没有激活函数,两层 3×3 可以合并成一层 7×7,优势 ③ 就消失了。
感受野等效链:两层 3×3(步长 1)= 5×5;三层 3×3(步长 1)= 7×7------用更少参数换同等视野。
十. 经典网络结构:VGG
VGG 用统一化的"3×3 卷积 + 2×2 最大池化"积木堆出 16/19 层网络:5 组卷积块逐级把空间尺寸减半、通道翻倍,最后 3 层全连接输出 1000 类。
VGG 结构剖面与配置表
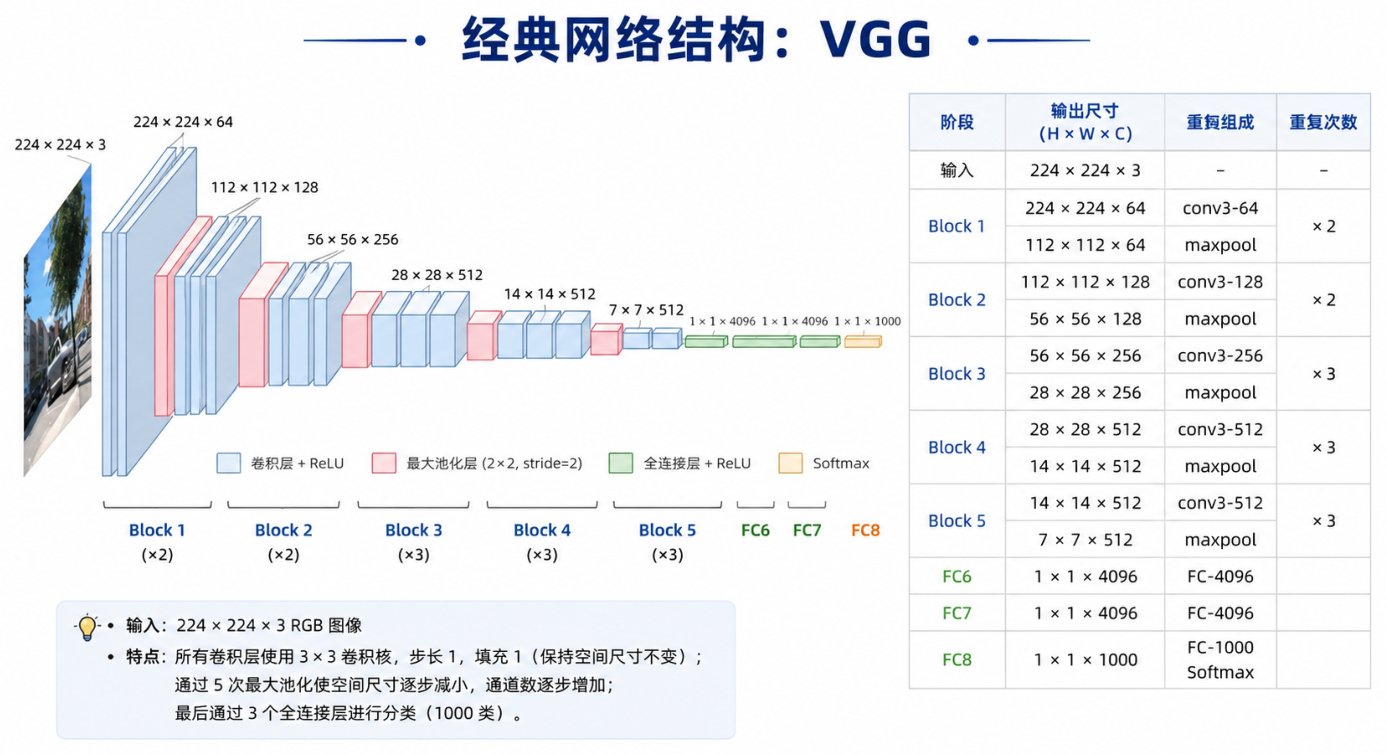
- 结构剖面(车辆图输入):224×224×3 → 各阶段特征图尺寸标注 224×224×64 → 112×112×128 → 56×56×256 → 28×28×512 → 14×14×512 → 7×7×512 → 1×1×4096 → 1×1×4096 → 1×1×1000。
- 图例四色:蓝色 = 卷积层 + ReLU;粉色 = 最大池化层(2×2,stride 2);绿色 = 全连接层 + ReLU;橙色 = Softmax。五个分组:Block1(×2)、Block2(×2)、Block3(×3)、Block4(×3)、Block5(×3)+ FC6、FC7、FC8。
- 右侧配置表逐行:输入 224×224×3;Block1 输出 112×112×64(conv3-64 + maxpool,重复 ×2);Block2 输出 56×56×128(×2);Block3 输出 28×28×256(×3);Block4 输出 14×14×512(×3);Block5 输出 7×7×512(conv3-512 + maxpool ×3);FC6 = 1×1×4096(FC-4096);FC7 = 1×1×4096;FC8 = 1×1×1000(FC-1000 + Softmax)。
十一. 经典网络结构:ResNet------给深网络一条「退路」
残差块让堆叠层学习残差 F(x) = H(x) − x,输出 H(x) = F(x) + x;恒等 shortcut 为梯度提供直通高速路,使百层、千层网络可以稳定训练。
ResNet-50:结构、退化与残差块
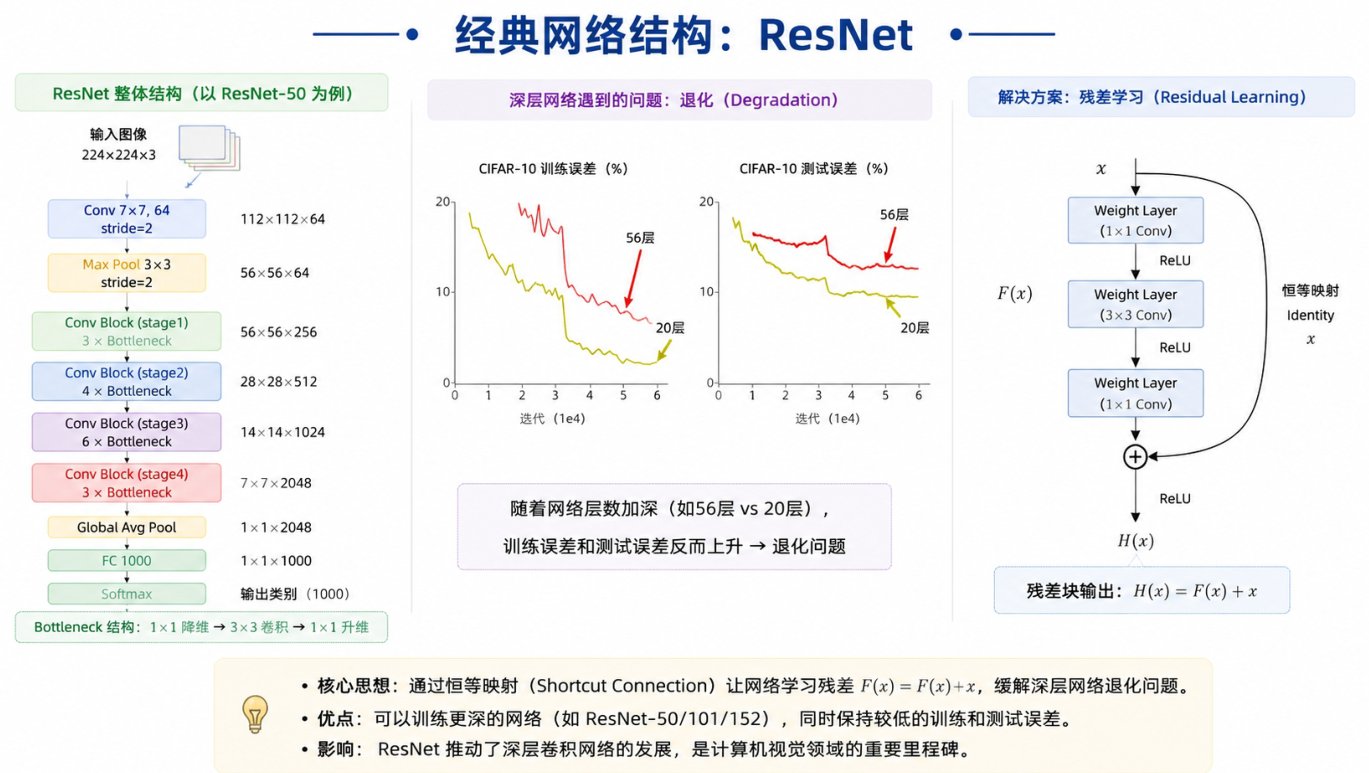
ResNet提出残差学习是为了解决深层CNN的退化问题:网络层数加深时,训练误差反而上升,并非过拟合,而是普通网络难以学习恒等映射。残差块引入shortcut短路连接,不再直接学习从输入x到输出H(x)的完整映射,而是学习残差F(x)=H(x)-x,通过残差让模型知道与正确值之间的差距,最终输出H(x)=F(x)+x;如果最优映射是恒等映射,网络只需把F(x)逼近0,优化难度大幅降低,同时梯度可通过短路支路直接回传,缓解梯度消失,让我们能够训练几十上百层的深度网络,而Bottleneck结构使用1×1卷积先降维再升维,进一步减少参数量与计算开销,ResNet也成为深度学习里程碑式的网络。