A
交互 二分/重心
二分做法
一个树上用不超过40次询问确定一个目标点。每次可以询问目标点到u的距离是否不超过d
首先考虑u=1,询问一定次数,确定目标点在1为根的树上的深度D。
然后候选点就只有所有深度D的点了,把他们拿出来。如果我们每次询问都能排除其中1/3到1/2个点的话,就能在log次内定位到目标点。
考虑从候选点内选一个大小n/3到n/2的点集,如果我们询问这个点集的LCA,那么在这个点集内的点,到这个LCA的距离是一个值,具体来说就是 D − d e p ( L C A ) D-dep(LCA) D−dep(LCA),其他候选点到LCA的距离一定都大于这个值。
那么我们询问 u = L C A , d = D − d e p ( L C A ) u=LCA,d=D-dep(LCA) u=LCA,d=D−dep(LCA),如果回答显式目标点到LCA的距离不超过d,那么说明目标点在这个点集内,缩小范围。如果回答是否定的,则说明目标点在除了这个点集外的其他点内。
这两种情况,最坏也能把问题规模缩减到2/3,可以在log次内找到目标点
在实现上,并不需要真的去找lca,可以把所有候选点标记为1,然后一次dfs求子树点权和,然后随意找到一个子树和在n/3到n/2之间的子树,这个子树的根就是一个合法的询问点u。
可以用一个布尔数组表示每个点是否还是候选点,每轮根据询问结果,以及候选点在不在这次询问点集内,更新每个候选点还是不是候选,这部分可以 O ( n ) O(n) O(n)随便组做,因为二分的次数只有 O ( log n ) O(\log n) O(logn)次
c
void solve(void) {
	int n;
	cin >> n;

	vi f(n + 1), dep(n + 1);
	int mxd = 0;
	rep(i, 2, n) {
		cin >> f[i];
		dep[i] = dep[f[i]] + 1;
		mxd = max(mxd, dep[i]);
	}

	int l = 0, r = mxd, d;
	while (l <= r) {
		int m = (l + r) / 2;
		cout << '?' << ' ' << 1 << ' ' << m << endl;
		int res;
		cin >> res;
		if (res) {
			d = m;
			r = m - 1;
		} else {
			l = m + 1;
		}
	}

	vi can(n + 1);
	rep(i, 1, n) {
		if (dep[i] == d) {
			can[i] = 1;
		}
	}

	while (1) {
		int tot = 0;
		rep(i, 1, n) {
			tot += can[i];
		}
		if (tot == 1) {
			rep(i, 1, n) {
				if (can[i]) {
					cout << '!' << ' ' << i << endl;
					return;
				}
			}
		}

		vi sz(n + 1);
		rep(i, 1, n) {
			sz[i] = can[i];
		}

		int pos;
		rep1(i, n, 1) {
			sz[f[i]] += sz[i];
			if (sz[i] * 3 > tot) {
				pos = i;
				break;
			}
		}

		vi in(n + 1);
		in[pos] = 1;
		rep(i, 1, n) {
			in[i] |= in[f[i]];
		}

		cout << '?' << ' ' << pos << ' ' << d - dep[pos] << endl;
		int res;
		cin >> res;
		rep(i, 1, n) {
			if (can[i]) {
				if (in[i] && !res) {
					can[i] = 0;
				}
				if (!in[i] && res) {
					can[i] = 0;
				}
			}
		}
	}

}
重心做法
这个有点难写,但思想比较好懂,口胡一下吧。
在树上用log次询问确定一个点,一个经典的思路是利用重心的性质:重心为根时,每一个子树大小都不超过整个树大小的一半,对于二叉树,更进一步,最大子树的大小在 n / 3 , n / 2 n/3,n/2 n/3,n/2范围内(考虑到父亲方向也有一个子树,一共三个子树,那最大子树大小肯定不会小于n/3,否则三个加起来都不到n了),因此我们对最大子树做询问,如果能确定答案在最大子树内,或者最大子树外,最坏情况下问题规模也能降低到原来的 2 / 3 2/3 2/3,基于此可以在log次下把问题规模降低到一个点,也就找到了目标点
具体来说,我们每一轮,对于当前拿到的树,先找到重心,然后检查重心为根的子树大小,找到重儿子,也就是最大的子树。询问重儿子,目标点在重儿子子树内,和在重儿子子树外,到重心的显然距离不同,利用这一点构造d
B
构造 二分图
无向图上,从s出发,走一条路径回到s,点边都可以重复用,初始每个点有点权 a u a_u au,走过路径上的点,点权+1,构造一条路径使走完之后所有点点权都是偶数,或报告无解
先考虑一些简单的性质,比如考虑一下有解的必要条件,或者说什么时候无解。把所有点权模2,那么如果最后点权都是偶数了,所有点权都是0,点权的异或和也就是0。
如果这是一个二分图,那么只存在偶环,也就是所有回路的点数都是偶数。走一条回路相当于把路径上所有点都异或1,偶环异或了偶数次1,对所有点的异或和没有贡献。也就是在二分图上走回路,不论怎么走对所有点权异或和都没影响。那么如果开始点权异或和是1,怎么操作都还是1,则一定无解。
然后这种时候,我们找到了一个必要条件(二分图上,初始异或和是1,则无解,换句话说初始异或和是0,是有解的必要条件),由于这是个CF风格的构造题,可以大胆猜测,这也是充分条件(初始异或和是0,是有解的必充分条件),也就是如果开始点权异或和是0的话,一定有解。
对于异或和已经是0了的情况,既然有解,考虑贪心构造,每次都选当前最优解,把问题规模逐渐缩小。在这里具体就是可以做一次dfs,找到一个dfs生成树,一个子树处理完毕返回时,我们目标是把这个子树的点权都变成0,那么如果子树的根为u,u的父亲为v,u点权为1,需要把u点权变为0,那么可以再uv之间多走一个来回,也就本来应该是u-v,现在改成u-v-u-v。这样u,v都异或上1,u变成0了,代价是可能会把v变成1。
但这个代价是可以接受的,我们至少把问题规模缩小了,u子树已经全都是0了,我们只要考虑u子树上面的这些点。最后问题规模逐步缩小,会缩小到整棵dfs树的根,问题是最后剩下的这个根,会不会是1?根据我们guess的结论,如果初始异或和为0,是有解的充要条件的话,最后这个根节点一定也是合法的!也就是这样贪心调整,最后剩下的根,权值也一定是0
实际上根据我们这个贪心构造方式,可以严格证明。我们划分子问题,每次解决子问题,也就是把一个子树全变成0,那么递归到最后时,肯定保证了除了根以外所有子树都是全0了,又由于我们还保证了所有点的异或和为0,那么剩下的根肯定也是0。
如果这不是个二分图,则存在奇环,如果初始异或和为1,可以多走一个奇环吧初始异或和变成0,剩下的构造和前面完全一样。
这种贪心构造是个经典范式,一直贪心,缩小子问题规模,把一部分给构造好了,把问题留到还没构造的地方,这样不断缩小问题规模,最后到了边界情况,如果没有矛盾,就是有解,否则无解。
c
void solve(void) {
	int n, m, s;
	cin >> n >> m >> s;

	vi a(n + 1);
	int sum = 0;
	rep(i, 1, n) {
		cin >> a[i];
		a[i] %= 2;
		sum ^= a[i];
	}

	vvi g(n + 1);
	rep(i, 1, m) {
		int u, v;
		cin >> u >> v;
		g[u].pb(v);
		g[v].pb(u);
	}
	{
		vi vis(n + 1);
		auto &&dfs = [&](auto &&dfs, int u, int fa)->void{
			vis[u] = 1;
			for (int v : g[u]) {
				if (v == fa || vis[v])continue;
				dfs(dfs, v, u);
			}
		};
		dfs(dfs, s, 0);
		int cnt = 0;
		rep(i, 1, n) {
			if (!vis[i] && a[i]) {
				cout << "No\n";
				return;
			}
		}
	}

	vi b(n + 1);
	vi path;
	vi odd;

	auto &&dfs = [&](auto &&dfs, int u, int fa, int c)->bool{
		b[u] = c;
		path.pb(u);
		for (int v : g[u]) {
			if (v == fa)continue;
			if (!b[v]) {
				if (!dfs(dfs, v, u, 3 - c)) {
					return 0;
				}
			} else if (b[v] == c) {
				int pos = find(all(path), v) - path.begin();

				for (int i = pos; i < path.size(); i++) {
					odd.push_back(path[i]);
				}
				return 0;
			}
		}
		path.pop_back();
		return 1;
	};

	int ok = dfs(dfs, s, 0, 1);

//	for (int x : ans) {
//		cout << x << ' ';
//	}
//	cout << '\n';


	if (ok && sum) {
		cout << "No\n";
	} else {
		vi vis(n + 1);
		vi ans;
		auto &&dfs1 = [&](auto &&dfs1, int u, int fa)->void{
			vis[u] = 1;
			if (u != s) {
				ans.pb(u);
				a[u] ^= 1;
			}
			if (sum && odd.back() == u) {
				for (int x : odd) {
					ans.pb(x);
					a[x] ^= 1;
				}
			}
			for (int v : g[u]) {
				if (v == fa || vis[v])continue;
				dfs1(dfs1, v, u);
				ans.pb(u);
				a[u] ^= 1;
				if (a[v]) {
					ans.pb(v);
					ans.pb(u);
					a[v] ^= 1;
					a[u] ^= 1;
				}
			}
		};

		dfs1(dfs1, s, 0);

		cout << "Yes\n";

		cout << ans.size() << '\n';
		for (int x : ans) {
			cout << x << ' ';
		}
		cout << '\n';
	}

}
D
三进制 sosdp 枚举
问所有长度n=16的由01?组成的字符串的权值和,每个特定串的权值,定义为把所有?的位置填0/1,形成的集合作为下标,去a数组(长度 2 n 2^n 2n)中把对应下标位置的元素求和
朴素的想法就是 3 16 3^{16} 316枚举所有串,对每个串再去确定每个?填什么,这复杂度 3 n × 2 n 3^n\times2^n 3n×2n直接爆炸
考虑把一个0/1变成问号,就可以变成另一个状态,并且新状态的权值,是0/1两种子状态的权值之和,也就是这个权值可以递推
仔细思考一下这就是SOSDP的思路,16维度的高维前缀和,把?看成2的话,一个状态的权值,就是他所有真子集的权值和,也就是每一位?可以变成0/1,则可以从这两个子状态转移过来。
SOSDP的朴素复杂度是 O ( n 3 n ) O(n3^n) O(n3n),实现如下。这里只有某一位是2,也就是是?的情况,才能从这一位是0/1的情况转移过来。
c
for (int i = 0; i < m; i++) {
    int x = 0;
    for (int j = 0; j < n; j++) {
        if ((i >> j) & 1) x += pw3[j];
    }
    sum[x] = a[i];
}
for (int i = 0; i < n; i++) {
    for (int x = 0; x < pw3[n]; x++) {
        if ((x / pw3[i]) % 3 == 2) {
            sum[x] = sum[x - 2 * pw3[i]] + sum[x - pw3[i]];
        }
    }
}
复杂度还是有点大,这里的冗余很明显,我们只需要给i位为2的状态做转移,但是还是枚举了所有 3 n 3^n 3n个状态,然后通过if判断状态是否合法,如果能直接在枚举的时候就只枚举当前位是2的状态就好了。
按照这个思路,我们可以钦定当前第i位是2,然后枚举高位和低位,这样枚举 3 n 3^n 3n个状态的这个内层循环,常数可以/3,到这一步实际上就可以通过了,qoj上400ms
c
for (int i = 0; i < n; i++) {
    int p = pw3[i];       // 3^i
    int q = pw3[i + 1];   // 3^(i+1)
    for (int high = 0; high < pw3[n - i - 1]; high++) {
        for (int low = 0; low < p; low++) {
            int x = high * q + 2 * p + low;  // 当前位为 2
            sum[x] = sum[x - 2 * p] + sum[x - p];
        }
    }
}
但这个做法还是有卡常的嫌疑,正解显然是让我们 O ( 3 n ) O(3^n) O(3n)的。考虑正解,一个状态可以找到最低的?,在这个?的左侧,都是01,可以二进制枚举
因此我们可以把外层枚举的含义,从单纯的枚举所有二进制位,改成枚举最低位?的位置,枚举范围还是一样的。然后内层可以把低位用二进制枚举,高位用三进制枚举,整体复杂度 O ( ∑ 2 i 3 n − i − 1 ) O(\sum 2^i3^{n-i-1}) O(∑2i3n−i−1)。根据二项式定理,这其实就是 ( 1 + 2 ) n (1+2)^n (1+2)n的二项式展开,因此复杂度为 O ( 3 n ) O(3^n) O(3n),这才是正解,qoj上100ms左右
c
for (int i = 0; i < n; i++) {
    for (int j = 0; j < pw3[i]; j++) {
        for (int k = 0; k < (1 << (n - i - 1)); k++) {
            int x = id[k] * pw3[i + 1] + j;
            sum[x + 2 * pw3[i]] = sum[x] + sum[x + pw3[i]];
        }
    }
}
G
线性基 思维
把一个集合划分成若干组,分别异或,然后把这些异或结果按位与,求最大值
位运算,考虑拆位。对于每一位,最终答案为1的话,需要这一位在按位与的时候,每一组都是1,也就是每一组内,这一位都出现奇数次。只要存在一组这个位置是偶数次,答案就为0了。
要分几组,很难直接看出来。考虑一个简单的性质,我们如果把多组合并,会发生什么。先考虑把奇数组合并,对于某一位,如果这几组在这一位都是奇数个1, 奇数个奇数相加,还是奇数,也就是原本都是1的位,合并后还是1,不会变差。如果各个集合,在这一位有的是偶数个1,也有奇数个1,合并后可能是偶数,也可能是奇数,也就是答案不会变差。
因此奇数组一定可以合成一组,最小的大于1的奇数是3,因此每三组就能合成一组,最终答案不会变差。因此最终答案,只可能是1组或者2组
考虑什么时候分两组。按位贪心,如果最高位有奇数个,为了让答案最高位取1,不能分成偶数组,因为奇数不能拆成两个奇数,因此只能奇数组,也就是分1组。
如果最高位有偶数个,为了让最高位取1,不能分一组,必须分两组,偶数可以拆成两个奇数相加。接下来考虑更低位。注意到分成两组的话,有奇数个1的位对答案无贡献,因为奇数不能拆成两个奇数了,只能拆成一个奇数和一个偶数,那么在这一位就没有贡献了。因此可以把所有奇数个1的位都忽略,这里实现上可以把所有偶数个1的位组成一个mask,和所有元素取交集。
接下来,每一位都是偶数个1,拆成两组,要么拆成两个偶数,要么拆成两个奇数,也就是说分出来的两组,在每一位要么都是0,要么都是1。因此分出来的两组异或和完全相等,B1=B2=B。答案是B1 B2按位与,因此答案也等于B。现在只要求出B即可。
B就是从初始元素中选一个子集得到的最大异或和。使用线性基即可。
c
void solve(void) {
	int n;
	cin >> n;

	LinearBasis lb;

	int ans = 0;
	vi a(n + 1);
	vi cnt(70);
	rep(i, 1, n) {
		cin >> a[i];
		rep(j, 0, 60) {
			if (a[i] >> j & 1) {
				cnt[j]++;
			}
		}
		ans ^= a[i];
	}

	int mask = 0;

	int mx = 0;
	rep(i, 0, 60) {
		if (cnt[i]) {
			mx = i;
		}
		if (cnt[i] % 2 == 0) {
			mask |= 1ll << i;
		}
	}

	if (cnt[mx] % 2) {
		cout << ans << '\n';
		return;
	}

	rep(i, 1, n) {
		a[i] &= mask;
		lb.insert(a[i]);
	}
	cout << lb.queryMax() << '\n';
}
J
搜索 字典序贪心
带权有向图,一条路径表示为他的边权序列。现在问前k小的路径长度,k=5e5,边权只有1-8
首先这是字典序,因此前面一个位置更小,后面都不用看了永远更小,除非这个路径能衍生出来的路径走完了,才能轮到这个位置更大的边的路径。因此考虑dfs维护,每个点按边权升序来走,先走边权小的分支。由于只有1-8的边权,可以做成类似字典树的做法。
问题是可能同时有多条不同的路径,边权序列一样,都是字典序最小的。dfs如果时刻只维护一条路径的话,会漏掉那些从其他边权序列一样的路径。
那么用BFS吗,这可以同时维护多个路径?BFS天然是层序遍历,无法达到我们字典序小的可以优先延伸的要求。考虑加个优先队列,按字典序排序。但是显然我们不能把完整路径作为排序标准,这样排序比较一次就是 O ( n ) O(n) O(n)的了,我们只能在队列状态里维护 O ( 1 ) O(1) O(1)的信息,用于排序,但是只有 O ( 1 ) O(1) O(1)信息实际上是无法区分字典序的,比如12,112,我们维护序列最后一个边权的话,这两个路径都是2,但实际上112是字典序严格更小的,应该优先推进12这个分支,直到产生的路径全走完了。
不能BFS,回到DFS,有个看着很离谱但实际上可行的思路,就是DFS同时维护多条路径,dfs参数不保存当前一条路径的结束点,而是保存当前字典序最小的多条路径的结束点集合。然后转移时枚举边权1-8,让点集所有点先一起走边权1的出边,得到一个新点集,作为下一步递归的状态,在一起走边权2的出边,以此类推。
这样跑下去复杂度当然很大,是路径数级别的,但是,由于我们只需要前k小的路径,我们严格控制只访问前k小的状态,复杂度是 O ( n + k ) O(n+k) O(n+k)的
c
vi g[N][10];
void solve(void) {
	int n, m, k;
	cin >> n >> m >> k;

	rep(i, 1, m) {
		int u, v, w;
		cin >> u >> v >> w;
		g[u][w].push_back(v);
	}

	rep(w, 1, 8) {
		vi s;
		rep(u, 1, n) {
			for (int v : g[u][w]) {
				s.push_back(v);
			}
		}

		auto &&dfs = [&](auto &&dfs, vi & s, int dep)->void{
			rep(i, 1, s.size()) {
				cout << dep << '\n';
				if (--k == 0) {
					exit(0);
				}
			}

			rep(w, 1, 8) {
				vi s1;
				for (int u : s) {
					for (int v : g[u][w]) {
						s1.push_back(v);
					}
				}
				if (s1.size()) {
					dfs(dfs, s1, dep + 1);
				}
			}
		};
		if (s.size()) {
			dfs(dfs, s, 1);
		}
	}

	while (k--) {
		cout << -1 << '\n';
	}


}
K
分块/单侧递归线段树
这三种操作
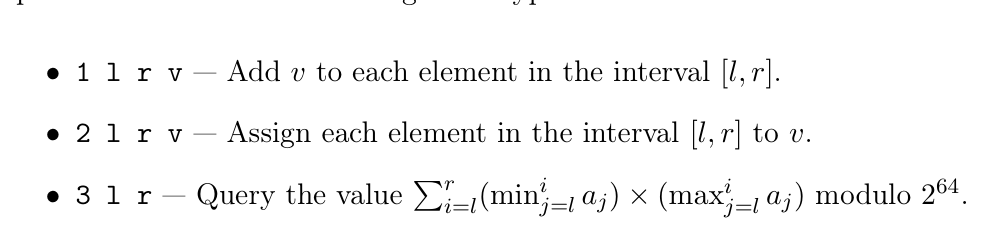
考虑分块,对于这个查询,可以从左到右维护块的前缀最值,对于块内,我们需要知前缀传递过来的最大值,最小值,能覆盖当前块内多长的前缀,设分别为p1,p2的话,
- p1,p2公共部分,mn,mx是左侧块传递过来的最小和最大,答案就是 l e n × m n × m x len\times mn\times mx len×mn×mx,
- 不妨设p1小于p2,那么在p2覆盖,p1不覆盖的部分,最小值还是前缀传过来的,最大值是当前块自己的,答案是 m n × ∑ i = p 1 + 1 p 2 m x i mn\times \sum_{i=p_1+1}^{p2}mx_i mn×∑i=p1+1p2mxi,对这个求和,可以预处理块的前缀最值的前缀和 O ( 1 ) O(1) O(1)查询。
- 对于p1,p2都不覆盖的部分,答案就是 ∑ m x i × m n i \sum mx_i\times mn_i ∑mxi×mni,这也可以预处理前缀和 O ( 1 ) O(1) O(1)查询
而p1,p2可以通过先维护一个块内前缀mx,前缀mn,然后在块内二分求得。整体复杂度 O ( n n log n ) O(n\sqrt n \log n) O(nn logn),调整块长可以做到 O ( n n log n ) O(n\sqrt{n\log n}) O(nnlogn ),当然时间6s很宽裕,不调块长也过了
对于修改,懒标记即可。赋值是好做的,如果有赋值标记,整个块都是相同元素,答案可以 O ( 1 ) O(1) O(1)求出。如果没有赋值标记,再来看加法标记,加法标记对散块可以暴力下放,对整块只能用类似标记永久化的方法,带着add来做计算,不能下放。在我们前面讨论的贡献公式里每一项都要增加add,具体看代码。
对于更新和修改时的散块,都要先下放懒标记,并且重构这一块的前缀最值,前缀和信息。
对于 2 64 2^{64} 264取模,最简单的做法是全用int128,最后输出时取模
c
void solve(void) {
	const int B = 450;
	int n, q;
	if (!(cin >> n >> q)) return;

	// 数组全部换成 long long,支持负数
	vector<ll> a(n), pos(n), st(n / B + 2), ed(n / B + 2);
	vector<ll> pmx(n), pmn(n), smx(n), smn(n);
	vector<ull> smul(n); // 唯独 smul 存自然溢出的乘积和
	vector<ll> tg1(n / B + 2, 0);
	vector<ll> tg2(n / B + 2, INF_LL);

	for (int i = 0; i < n; i++) {
		cin >> a[i];
		pos[i] = i / B;
		ed[i / B] = i;
	}

	for (int i = n - 1; i >= 0; i--) {
		st[i / B] = i;
	}

	int tot = (n + B - 1) / B;

	auto recal = [&](int p) {
		int l = st[p];
		pmx[l] = pmn[l] = a[l];
		smx[l] = smn[l] = a[l];
		smul[l] = (ull)a[l] * (ull)a[l];
		for (int j = st[p] + 1; j <= ed[p]; j++) {
			pmx[j] = max(pmx[j - 1], a[j]);
			pmn[j] = min(pmn[j - 1], a[j]);
			smx[j] = smx[j - 1] + pmx[j];
			smn[j] = smn[j - 1] + pmn[j];
			smul[j] = smul[j - 1] + (ull)pmx[j] * (ull)pmn[j];
		}
	};

	for (int i = 0; i < tot; i++) {
		recal(i);
	}

	auto pushdown = [&](int p) {
		if (tg2[p] != INF_LL) {
			for (int i = st[p]; i <= ed[p]; i++) {
				a[i] = tg2[p];
			}
			tg2[p] = INF_LL;
			tg1[p] = 0;
		}
		if (tg1[p]) {
			for (int i = st[p]; i <= ed[p]; i++) {
				a[i] += tg1[p];
			}
			tg1[p] = 0;
		}
	};

	auto upd1 = [&](int l, int r, ll v) {
		int p = pos[l], q = pos[r];

		if (p == q) {
			pushdown(p);
			for (int i = l; i <= r; i++) a[i] += v;
			recal(p);
		} else {
			pushdown(p);
			for (int i = l; i <= ed[p]; i++) a[i] += v;
			recal(p);

			pushdown(q);
			for (int i = st[q]; i <= r; i++) a[i] += v;
			recal(q);

			for (int i = p + 1; i <= q - 1; i++) {
				tg1[i] += v;
			}
		}
	};

	auto upd2 = [&](int l, int r, ll v) {
		int p = pos[l], q = pos[r];

		if (p == q) {
			pushdown(p);
			for (int i = l; i <= r; i++) a[i] = v;
			recal(p);
		} else {
			pushdown(p);
			for (int i = l; i <= ed[p]; i++) a[i] = v;
			recal(p);

			pushdown(q);
			for (int i = st[q]; i <= r; i++) a[i] = v;
			recal(q);

			for (int i = p + 1; i <= q - 1; i++) {
				tg1[i] = 0;
				tg2[i] = v;
			}
		}
	};

	auto get_ll = [](const vector<ll> & arr, int l, int r) -> ll {
		if (l > r) return 0;
		ll res = arr[r];
		if (l > 0) res -= arr[l - 1];
		return res;
	};

	auto get_ull = [](const vector<ull> & arr, int l, int r) -> ull {
		if (l > r) return 0;
		ull res = arr[r];
		if (l > 0) res -= arr[l - 1];
		return res;
	};

	auto ask = [&](int l, int r) -> ull {
		ull res = 0;
		int p = pos[l], q = pos[r];

		if (p == q) {
			pushdown(p);
			recal(p);
			ll mx = -INF_LL, mn = INF_LL;
			for (int i = l; i <= r; i++) {
				mx = max(mx, a[i]);
				mn = min(mn, a[i]);
				res += (ull)mx * (ull)mn;
			}
		} else {
			ll mx = -INF_LL, mn = INF_LL;
			pushdown(p);
			recal(p);
			for (int i = l; i <= ed[p]; i++) {
				mx = max(mx, a[i]);
				mn = min(mn, a[i]);
				res += (ull)mx * (ull)mn;
			}

			for (int i = p + 1; i <= q - 1; i++) {
				if (tg2[i] != INF_LL) {
					ull len = ed[i] - st[i] + 1;
					mx = max(mx, tg2[i]);
					mn = min(mn, tg2[i]);
					res += len * (ull)mx * (ull)mn;
				} else {
					ll add = tg1[i];
					int p1 = -1, p2 = -1;
					int bl = st[i], br = ed[i];

					while (bl <= br) {
						int m = (bl + br) / 2;
						if (pmx[m] + add <= mx) {
							p1 = m;
							bl = m + 1;
						} else {
							br = m - 1;
						}
					}

					bl = st[i];
					br = ed[i];
					while (bl <= br) {
						int m = (bl + br) / 2;
						if (pmn[m] + add >= mn) {
							p2 = m;
							bl = m + 1;
						} else {
							br = m - 1;
						}
					}

					int k1 = (p1 == -1) ? st[i] - 1 : p1;
					int k2 = (p2 == -1) ? st[i] - 1 : p2;

					int idx1 = min(k1, k2);
					int idx2 = max(k1, k2);

					ull umx = (ull)mx, umn = (ull)mn, uadd = (ull)add;

					// 第一段 [st[i], idx1]: max 被 mx 替换,min 被 mn 替换
					if (idx1 >= st[i]) {
						ull len = idx1 - st[i] + 1;
						res += len * umx * umn;
					}

					// 第二段 [idx1 + 1, idx2]: 仅有一侧被替换
					if (idx2 > idx1) {
						ull len = idx2 - idx1;
						if (k1 < k2) {
							// max 未被替换(使用 pmx + add),min 被 mn 替换
							ull sum_max = (ull)get_ll(smx, idx1 + 1, idx2) + uadd * len;
							res += umn * sum_max;
						} else {
							// min 未被替换(使用 pmn + add),max 被 mx 替换
							ull sum_min = (ull)get_ll(smn, idx1 + 1, idx2) + uadd * len;
							res += umx * sum_min;
						}
					}

					// 第三段 [idx2 + 1, ed[i]]: 两者都未被替换
					if (idx2 < ed[i]) {
						int L = idx2 + 1, R = ed[i];
						ull len = R - L + 1;
						res += get_ull(smul, L, R);
						res += uadd * (ull)get_ll(smx, L, R);
						res += uadd * (ull)get_ll(smn, L, R);
						res += uadd * uadd * len;
					}

					mx = max(mx, pmx[ed[i]] + add);
					mn = min(mn, pmn[ed[i]] + add);
				}
			}

			pushdown(q);
			recal(q);
			for (int i = st[q]; i <= r; i++) {
				mx = max(mx, a[i]);
				mn = min(mn, a[i]);
				res += (ull)mx * (ull)mn;
			}
		}

		return res;
	};

	for (int i = 1; i <= q; i++) {
		int op, l, r;
		ll v;
		cin >> op >> l >> r;
		l--,r--;
		if (op == 1) {
			cin >> v;
			upd1(l, r, v);
		} else if (op == 2) {
			cin >> v;
			upd2(l, r, v);
		} else {
			cout << ask(l, r) << '\n';
		}
	}
}还有一种单侧递归线段树做法,具体看这个博客,单侧递归线段树指的是,在pushup时允许用一个递归函数compute计算区间答案,但是这个函数必须是单侧递归的,也就是在线段树上递归,每次只走左右儿子中的一个分支,这样路径是一条链,复杂度是 O ( log n ) O(\log n) O(logn)的,线段树查询/修改时会pushup合并 O ( log n ) O(\log n) O(logn)次,因此整体复杂度 O ( n log 2 n ) O(n\log^2n) O(nlog2n)
普通的单侧递归线段树可以处理 ∑ i = l r m x i \sum_{i=l}^r mx_i ∑i=lrmxi这样的询问。但这题同时有mn,mx,需要特殊的单侧递归线段树,定义compute是求 ∑ m x i × m n i \sum mx_i\times mn_i ∑mxi×mni的,compute_mx是求 ∑ m x i \sum mx_i ∑mxi的,compute_mn是求 ∑ m n i \sum mn_i ∑mni的,那么在pushup时,每一层都调用一次compute,对于conpute,每一层都调用comput_mx/compute_mn,单个compute_mx/compute_mn复杂度是 O ( log n ) O(\log n) O(logn),那么compute复杂度 O ( log 2 n ) O(\log^2n) O(log2n),整体复杂度 O ( n log 3 n ) O(n\log^3n) O(nlog3n)