大宗商品销采运储系统・六层架构连载(基础服务篇)
报表服务上篇:为什么报表不能写在业务服务里?
很多大宗商品系统的报表,最后都会变成业务库的"隐形杀手"。
白天交易,晚上跑报表;财务一张月度进销存,可能把订单、库存、物流、结算多张大表联查。轻则慢查询,重则拖垮交易。
报表服务要解决的不是"怎么查",而是:
在哪里查、什么时候查、谁能查、查完怎么输出。
前面我们完成了调度服务(含 AI 增强方案)的完整拆解。调度服务解决了大批量异步任务、夜间批量计算的执行能力,而大量计算结果最终需要汇总、可视化、对外输出,这就是报表服务的核心价值。
一、很多报表问题,根源是"写错了地方"
很多业务系统会直接在业务服务里写报表查询,直接联表查数据库生成报表。
在简单业务场景下,这看似省事。但在大宗商品销采运储这种大数据、多数据源、多维度统计场景,会带来大量线上问题:
-
业务库压力被报表查询击穿;
-
报表查询抢占交易 SQL 资源;
-
多库关联统计逻辑散落在各个业务模块;
-
报表变更需要改动业务代码;
-
无法统一权限管控;
-
缺少报表任务调度能力。
一句话总结:
报表不是业务交易的附属功能,而是一类独立的基础能力。
| 维度 | 业务服务内嵌报表 | 独立报表服务 |
|---|---|---|
| 数据库压力 | 直接压业务库 | 多源隔离,只读库/数仓 |
| 代码耦合 | 报表逻辑散落各模块 | 元数据统一管理 |
| 权限控制 | 各模块自己控 | 统一行级/列级/导出权限 |
| 任务调度 | 难统一,临时脚本多 | 对接调度服务异步执行 |
| 导出能力 | 同步阻塞,大文件易超时 | 异步生成,文件持久化 |
| 变更影响 | 改报表可能动业务代码 | 改元数据/查询配置为主 |
所以,报表服务作为独立的基础服务,就是用来统一承接所有统计查询、报表生成、文件导出需求,和交易业务解耦,保护核心业务库稳定。
二、报表服务的职责边界
✅ 负责
-
多数据源统一接入:业务只读库、数仓/数据湖/湖仓一体、缓存、文件/对象存储;
-
报表元数据管理:报表定义、数据集、查询脚本、维度、指标、参数配置;
-
报表任务管理:定时预计算、异步生成报表文件、报表任务状态监控;
-
报表权限控制:基于用户/角色/系统的数据权限、报表访问权限、导出权限;
-
报表结果输出:在线预览、Excel/PDF 导出、报表缓存。
❌ 不负责
-
业务交易数据写入(新增、修改销采运储单据);
-
复杂数据 ETL 清洗(数据清洗交给数仓,报表服务做轻量聚合);
-
替代业务服务的实时单据查询。
核心原则只有一句:
交易与统计分离,业务库与报表查询隔离。
在线实时报表优先走预计算缓存;大批量离线报表,依托调度服务异步预生成。
三、整体分层架构
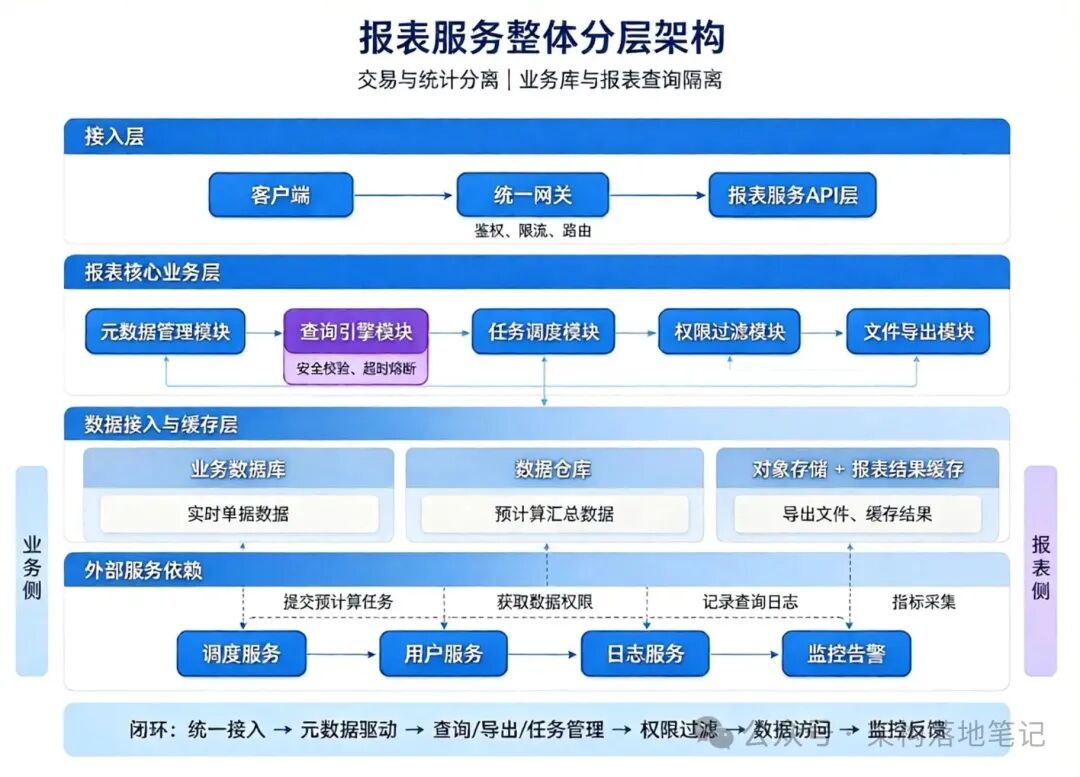
四、两大报表业务模型
1. 实时查询报表
用户前端点击查询,报表服务根据报表元数据,组装查询条件,读取预聚合数据或者轻量查询,直接返回页面展示。
适合:库存实时统计、当日成交汇总、短维度小数据量报表。
特点:响应快,查询数据量有限,优先读取缓存,禁止直接对业务大表做全表聚合。
2. 离线预计算报表
通过调度服务触发定时任务,提前跑统计逻辑,计算结果存入缓存/数据库,用户查看直接读取已经生成好的结果,支持超大批量导出。
适合:月度对账报表、季度进销存汇总、跨年度大宗交易统计。
特点:查询不占用业务高峰期资源,支持百万级行数据导出,生成 PDF/Excel 文件持久化存储。
| 维度 | 实时查询报表 | 离线预计算报表 |
|---|---|---|
| 触发方式 | 用户前端点击 | 调度定时/手动 |
| 适合场景 | 库存实时统计、当日成交汇总 | 月度对账、季度进销存、跨年度统计 |
| 数据来源 | 预聚合缓存/轻量查询 | 预计算结果/缓存/数据库/文件 |
| 响应要求 | 秒级 | 可异步,分钟级/小时级 |
| 业务高峰 | 可查,但需限流 | 避开高峰,夜间执行 |
| 导出能力 | 小数据量 | 百万级 Excel/PDF |
| 核心原则 | 禁止全表聚合业务大表 | 不占高峰期资源 |
结论很明确:
实时查询走缓存和轻量查询,离线报表走调度和预计算。
五、一个典型场景:月度进销存汇总
某大宗贸易企业,财务每月要导出"月度进销存汇总"。
这张报表需要关联采购入库、销售出库、库存流水、物流在途、结算金额等多个数据源,数据量达到百万级。
如果直接在业务库跑,交易高峰期 CPU 直接打满,订单查询和单据保存都会变慢。
接入报表服务后,流程变成:
-
业务人员在报表目录选择"月度进销存汇总";
-
报表服务读取元数据,确定数据源、维度、指标、权限规则;
-
调度服务凌晨触发预计算任务;
-
查询引擎从只读库/数仓抽取数据,做轻量聚合;
-
结果写入缓存、结果表或对象存储;
-
第二天用户直接在线预览,或下载 Excel/PDF。
带来的变化:
-
交易库稳定了;
-
报表查询快了;
-
权限统一了;
-
导出可追溯了;
-
报表变更不再牵动业务代码。
这就是独立报表服务的价值。
六、和其他服务的联动关系
-
和用户服务:获取当前用户角色、数据权限,自动过滤报表行级数据,实现同一张报表,不同用户看到不同数据范围;
-
和调度服务:报表定时预计算、大文件导出任务,提交给调度服务执行;
-
和日志服务:记录报表查询记录、导出记录、慢查询日志、异常日志,方便审计与问题排查;
-
和网关:所有报表接口统一鉴权、限流,防止大量报表查询压垮系统。
七、报表服务不是什么
报表服务不是数仓,不负责复杂 ETL 清洗。
报表服务也不是交易服务,不写业务单据。
它更像:
统计查询的统一出口,和报表能力的业务化封装。
只有边界清楚,后面元数据、查询引擎、缓存、权限模型才能落地。
八、小结
报表服务的核心目标,是把系统所有统计、报表、导出能力收拢,实现业务交易和统计查询解耦。 上篇我们重点明确了报表服务的定位、边界与整体架构。 下篇,我们会深入报表元数据模型、多数据源查询引擎设计、缓存策略、慢查询治理,以及报表权限模型落地。
下篇预告: 接下来我们将继续报表服务中篇(元数据、查询引擎、缓存与权限落地)、报表服务 AI 集成篇(AI 辅助报表生成、智能指标异常检测、自然语言转报表查询),完整完成基础服务 - 报表服务三篇连载。