前言:
在之前的学习中,我只知道如果调用API实现想要的功能,但是这对于学习FreeRTOS的完全不够的,所以这次我将使用软件仿真来彻底了解FreeRTOS的内核,我相信基于之前的学习,我很快能掌握的
1.首先我们要创建一个工程来实现软件仿真,流程如下:
先创建一个文件,按下面来创建子文件夹:
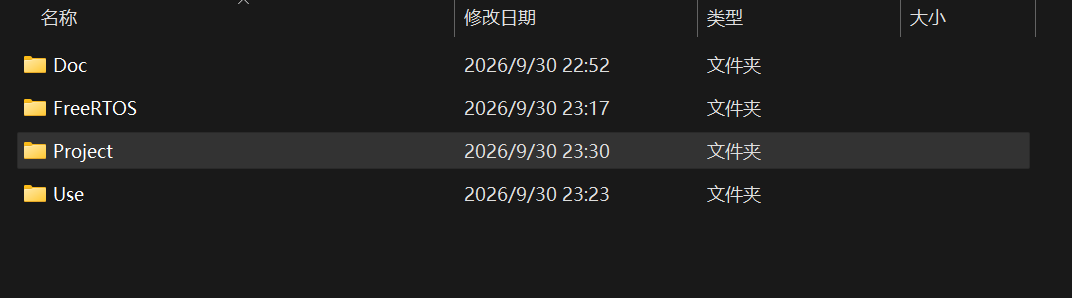
随后到Keil选择该文件创建一个keil工程,处理器我选择选择 ARMCM3
选择好处理器,点击 OK 按钮后会弹出 Manage Run-Time Environment 选项框。这里我们在 CMSIS 栏选中 CORE 和 Device 栏选中 Startup 这两个文件即可
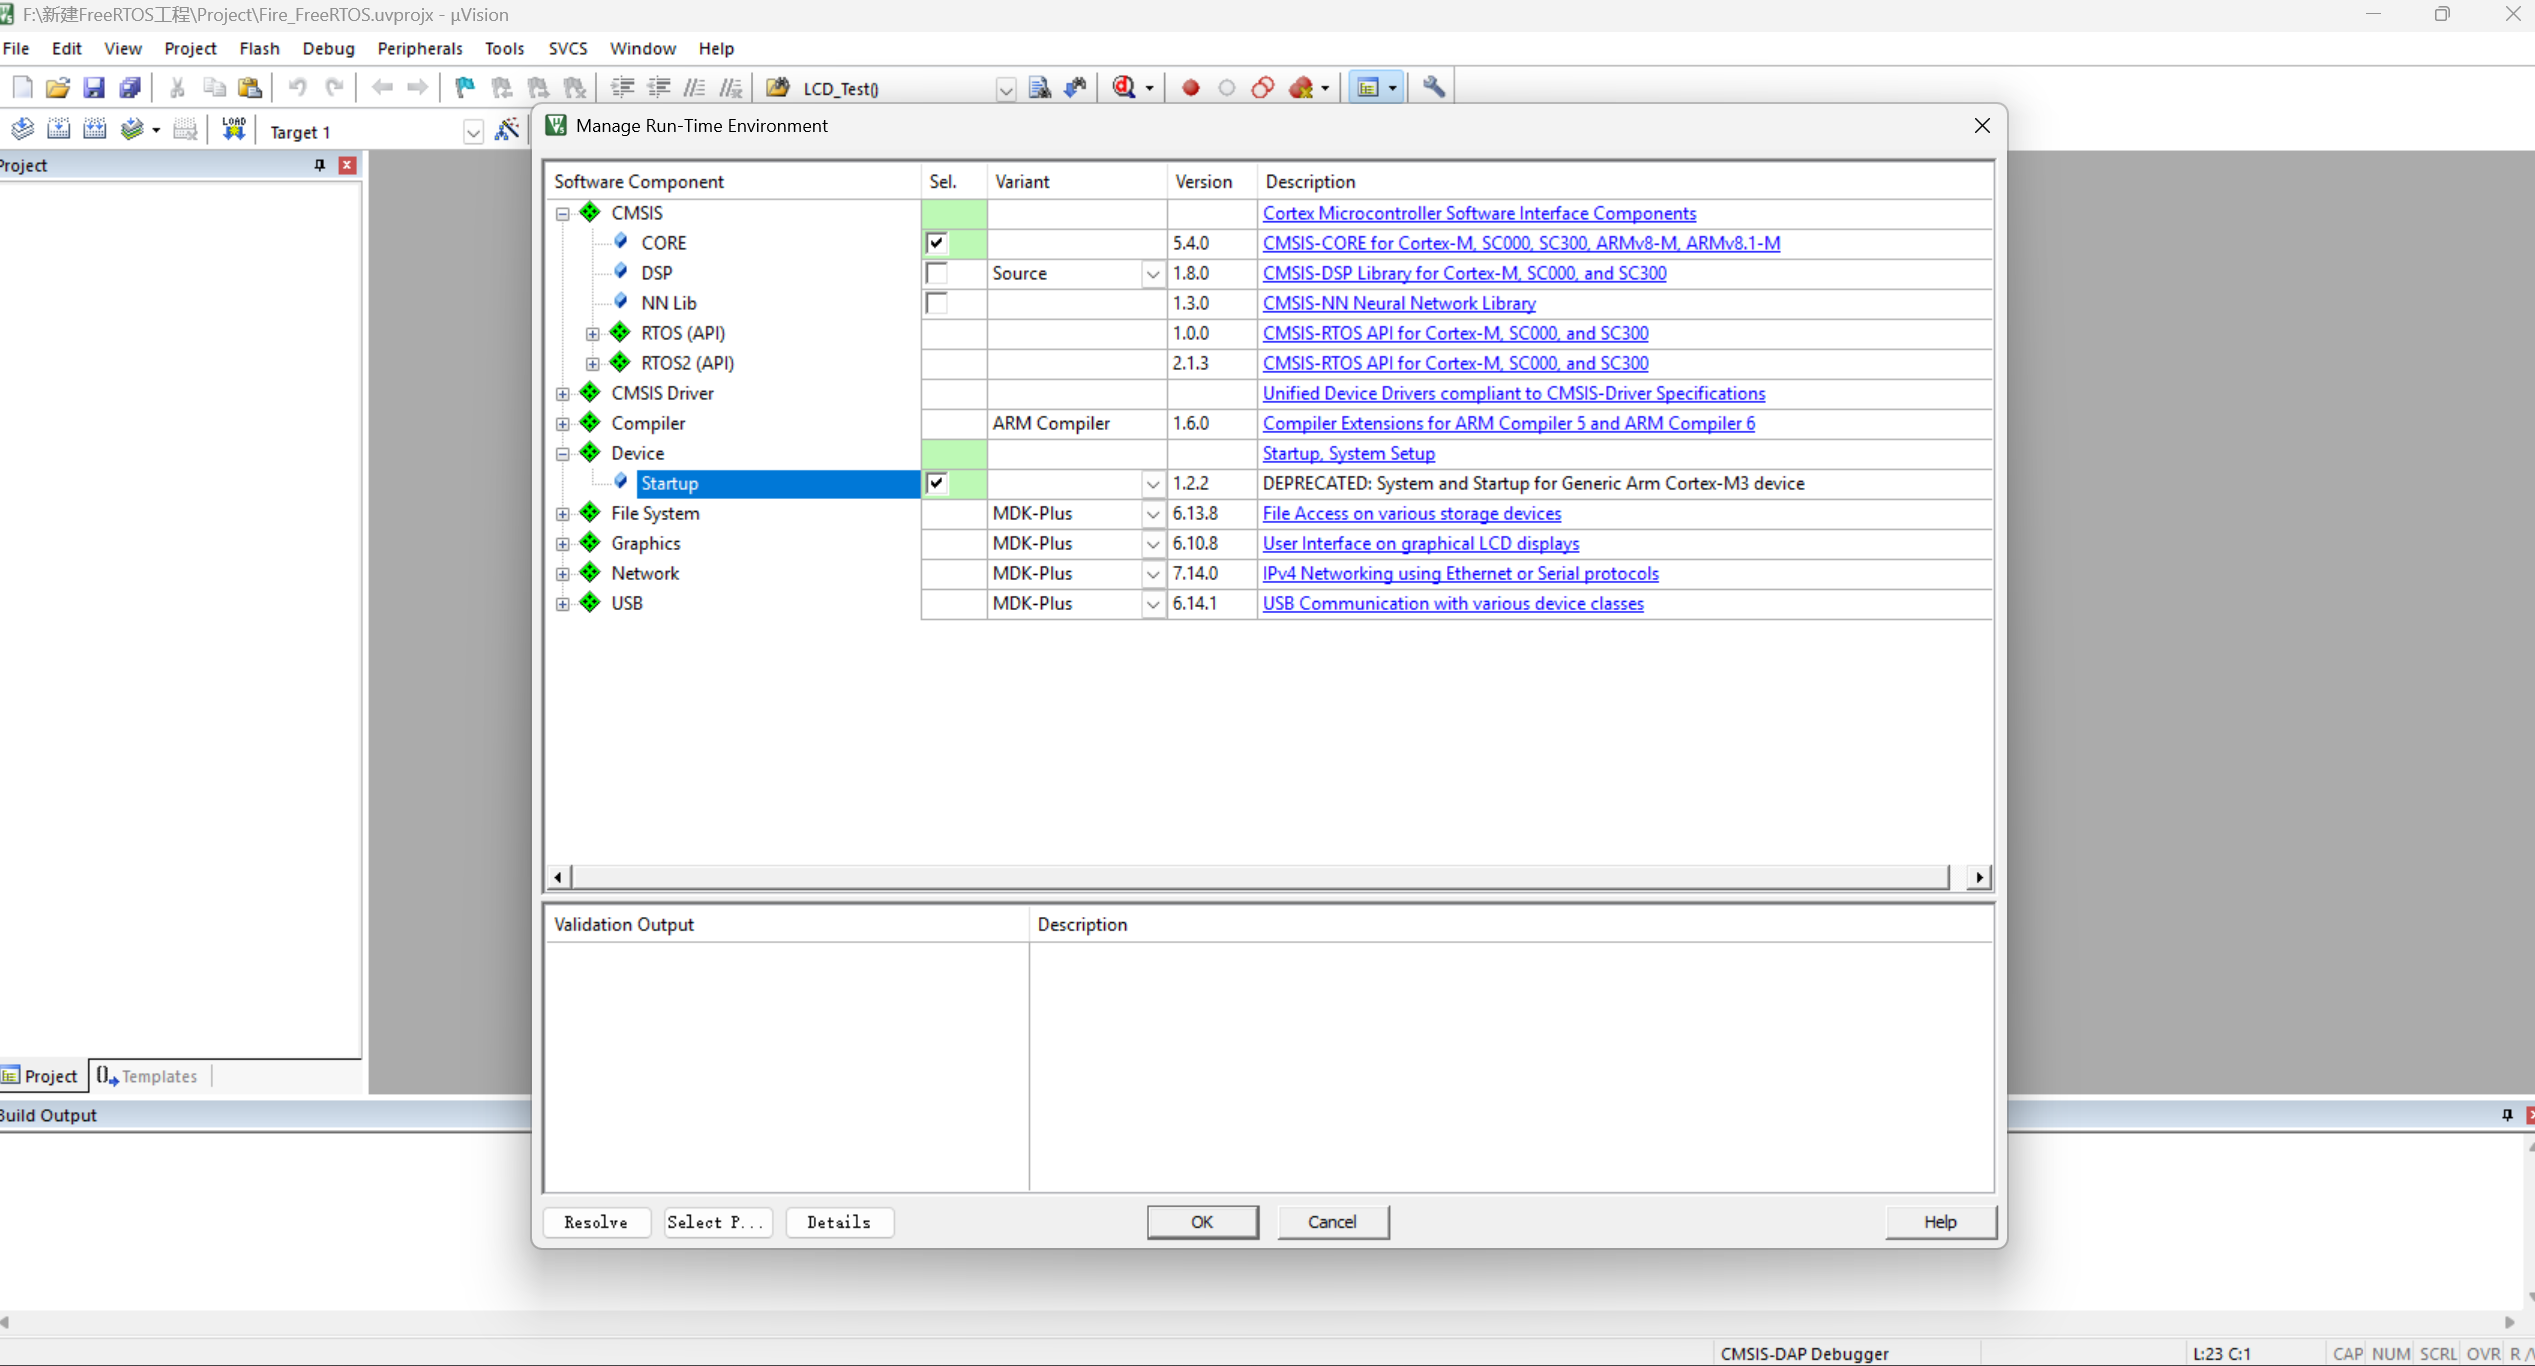
点击 OK,关闭 Manage Run-Time Environment 选项框之后,刚刚我们选择的 CORE 和Startup 这两个文件就会添加到我们的工程组里面
接着是添加文件组:
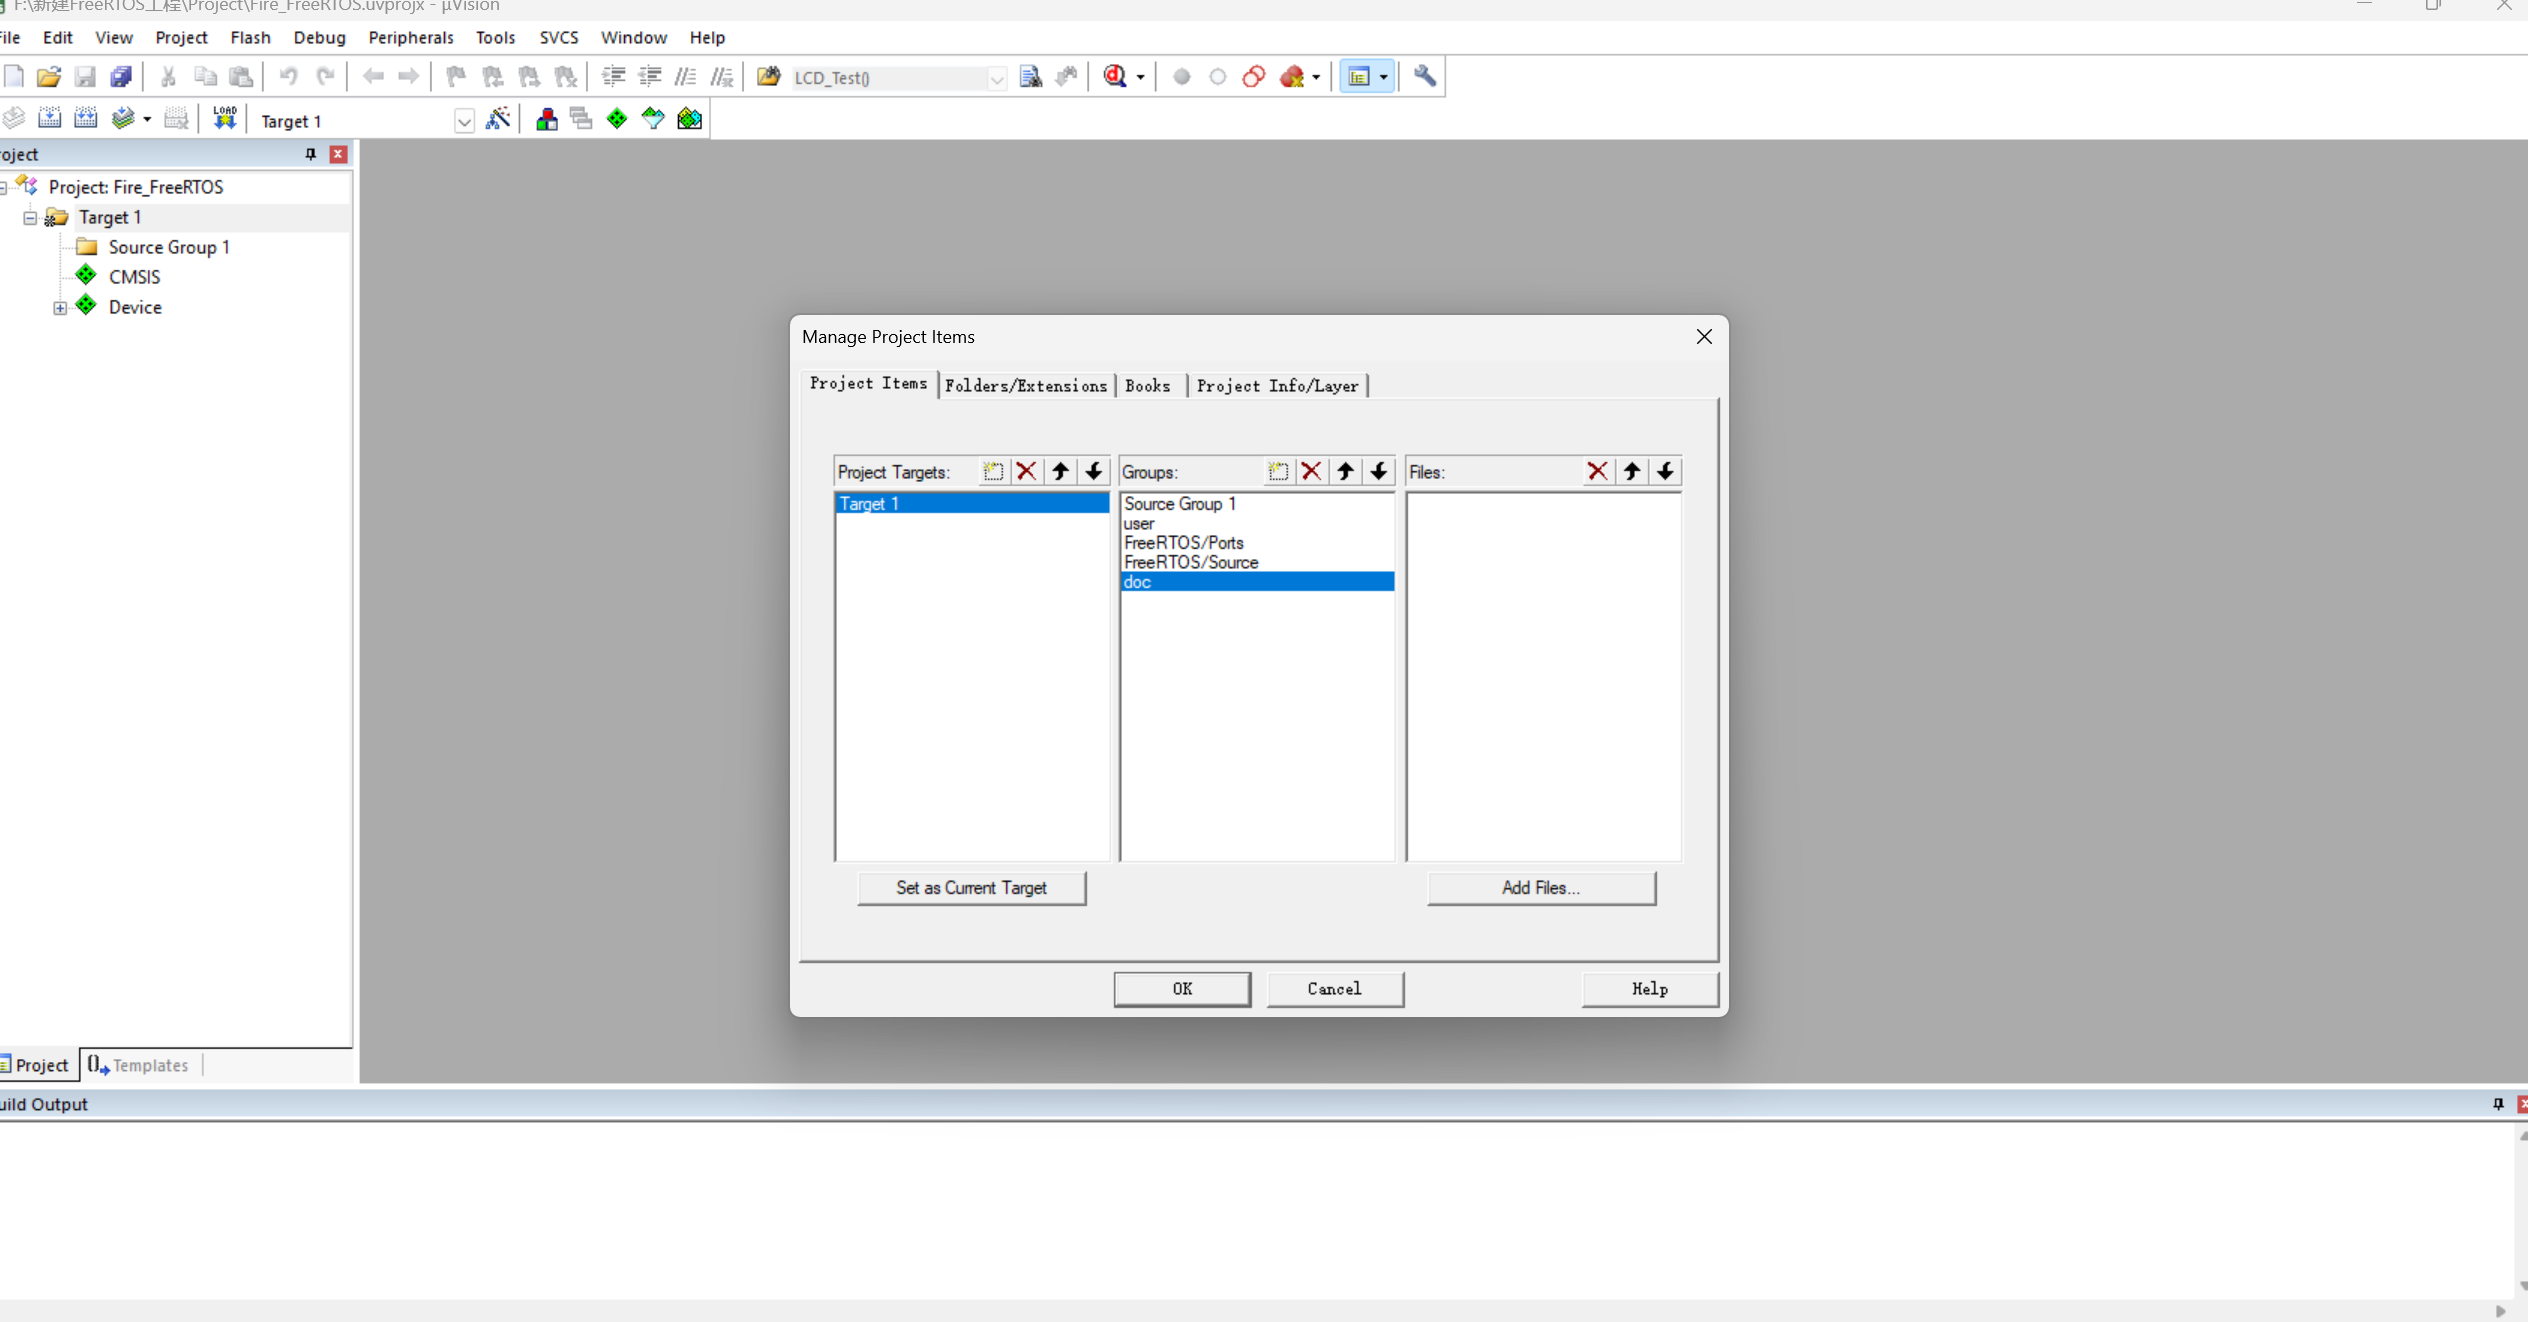
添加完文件组,我们点击编辑发现是有一个错误是,该错误是找不到我们的main文件。这是因为我们还没有创建 main.c 文件,Keil 在编译时找不到程序入口。接下来我们手动创建 main.c 文件,并把它添加到工程中。
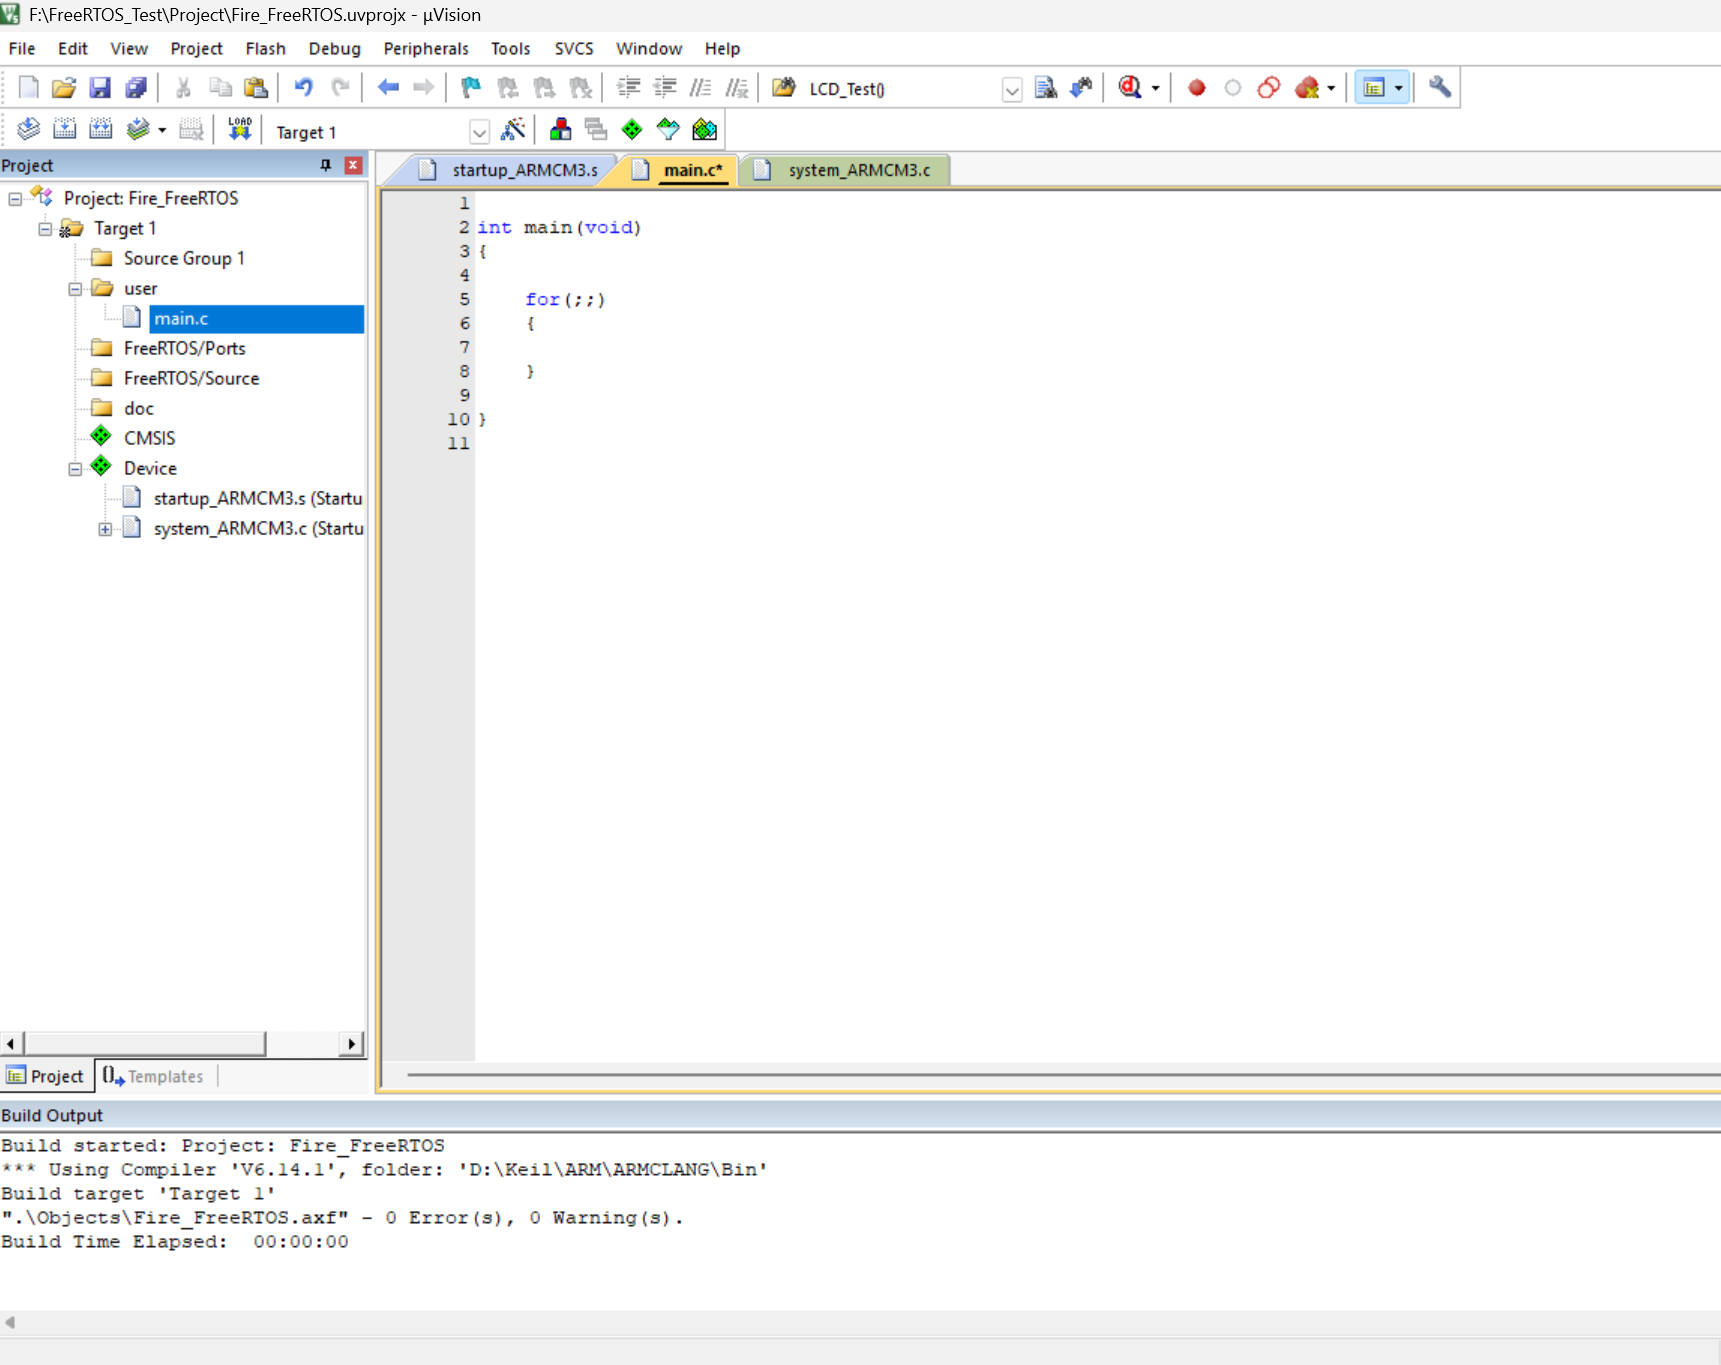
随后我们点开魔术棒,将仿真时钟频率改成25MHz
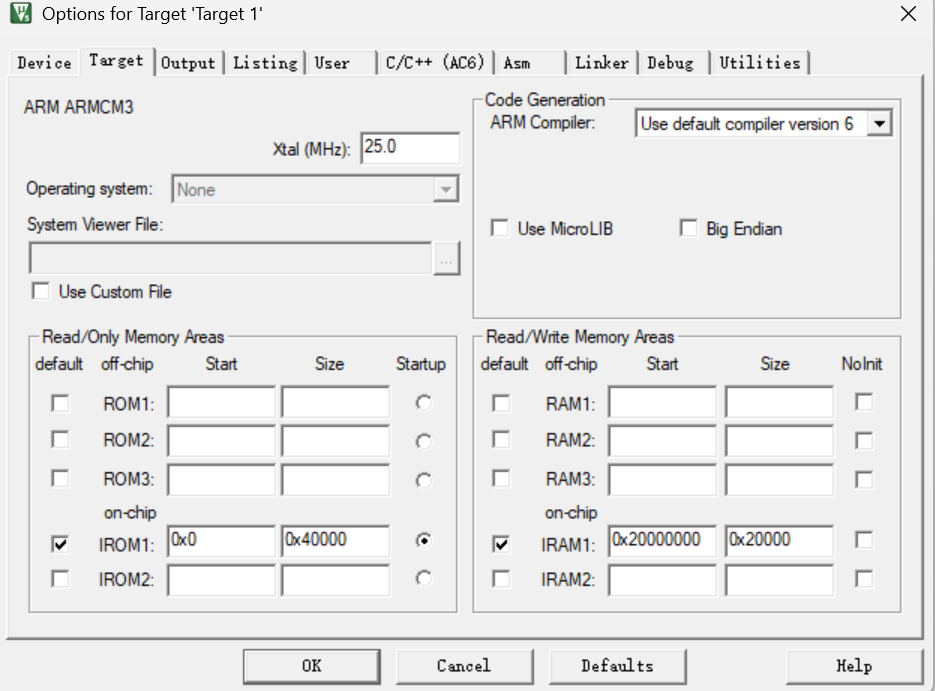
25Mhz怎么来的呢?点开该system_ARMCM3.c文件
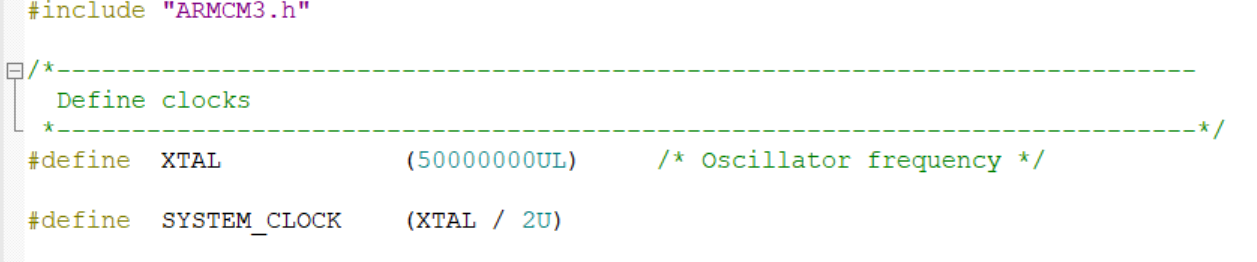
我们可以看到系统时钟是50MHz/2(即25MHz)
然后是选择软件仿真:
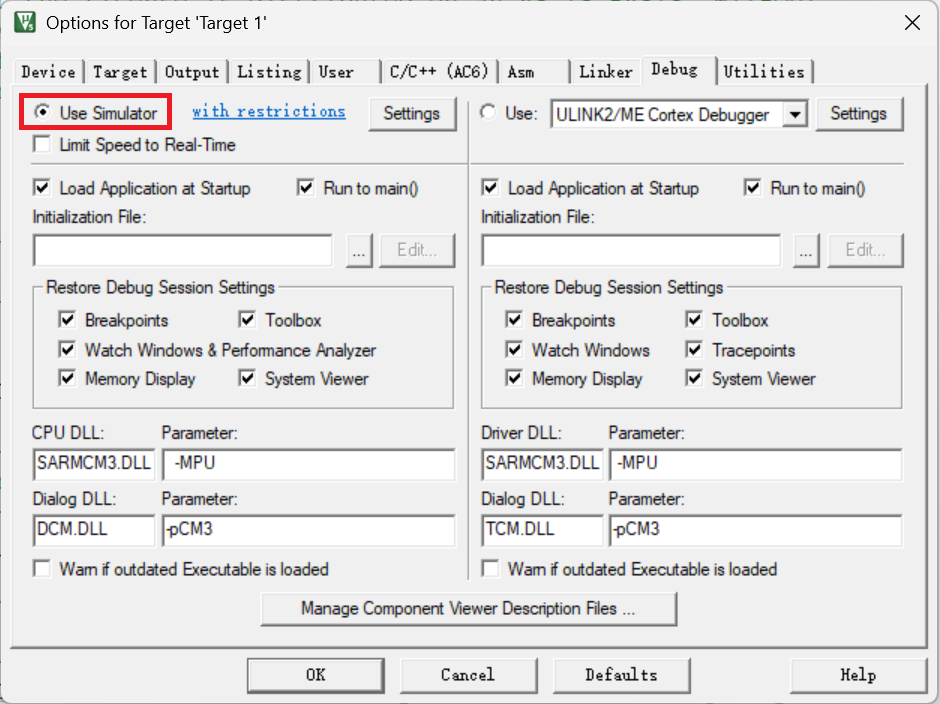
最后就是添加头文件路径:
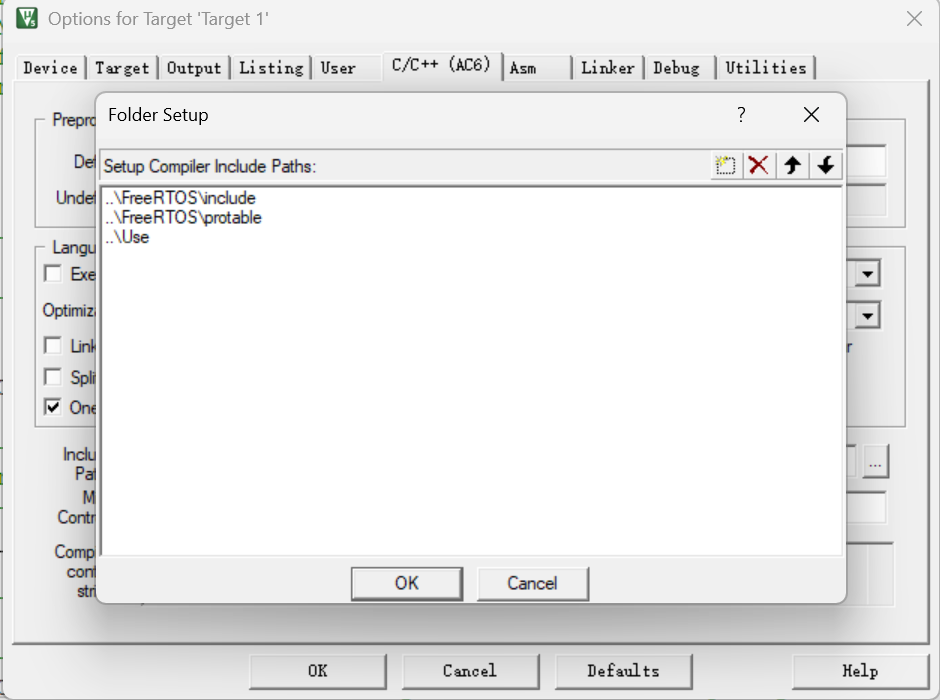
这样一个仿真软件工程就创建好了
2.数据结构--列表(链表)和列表项(节点)(重点):
(1)初识普通链表
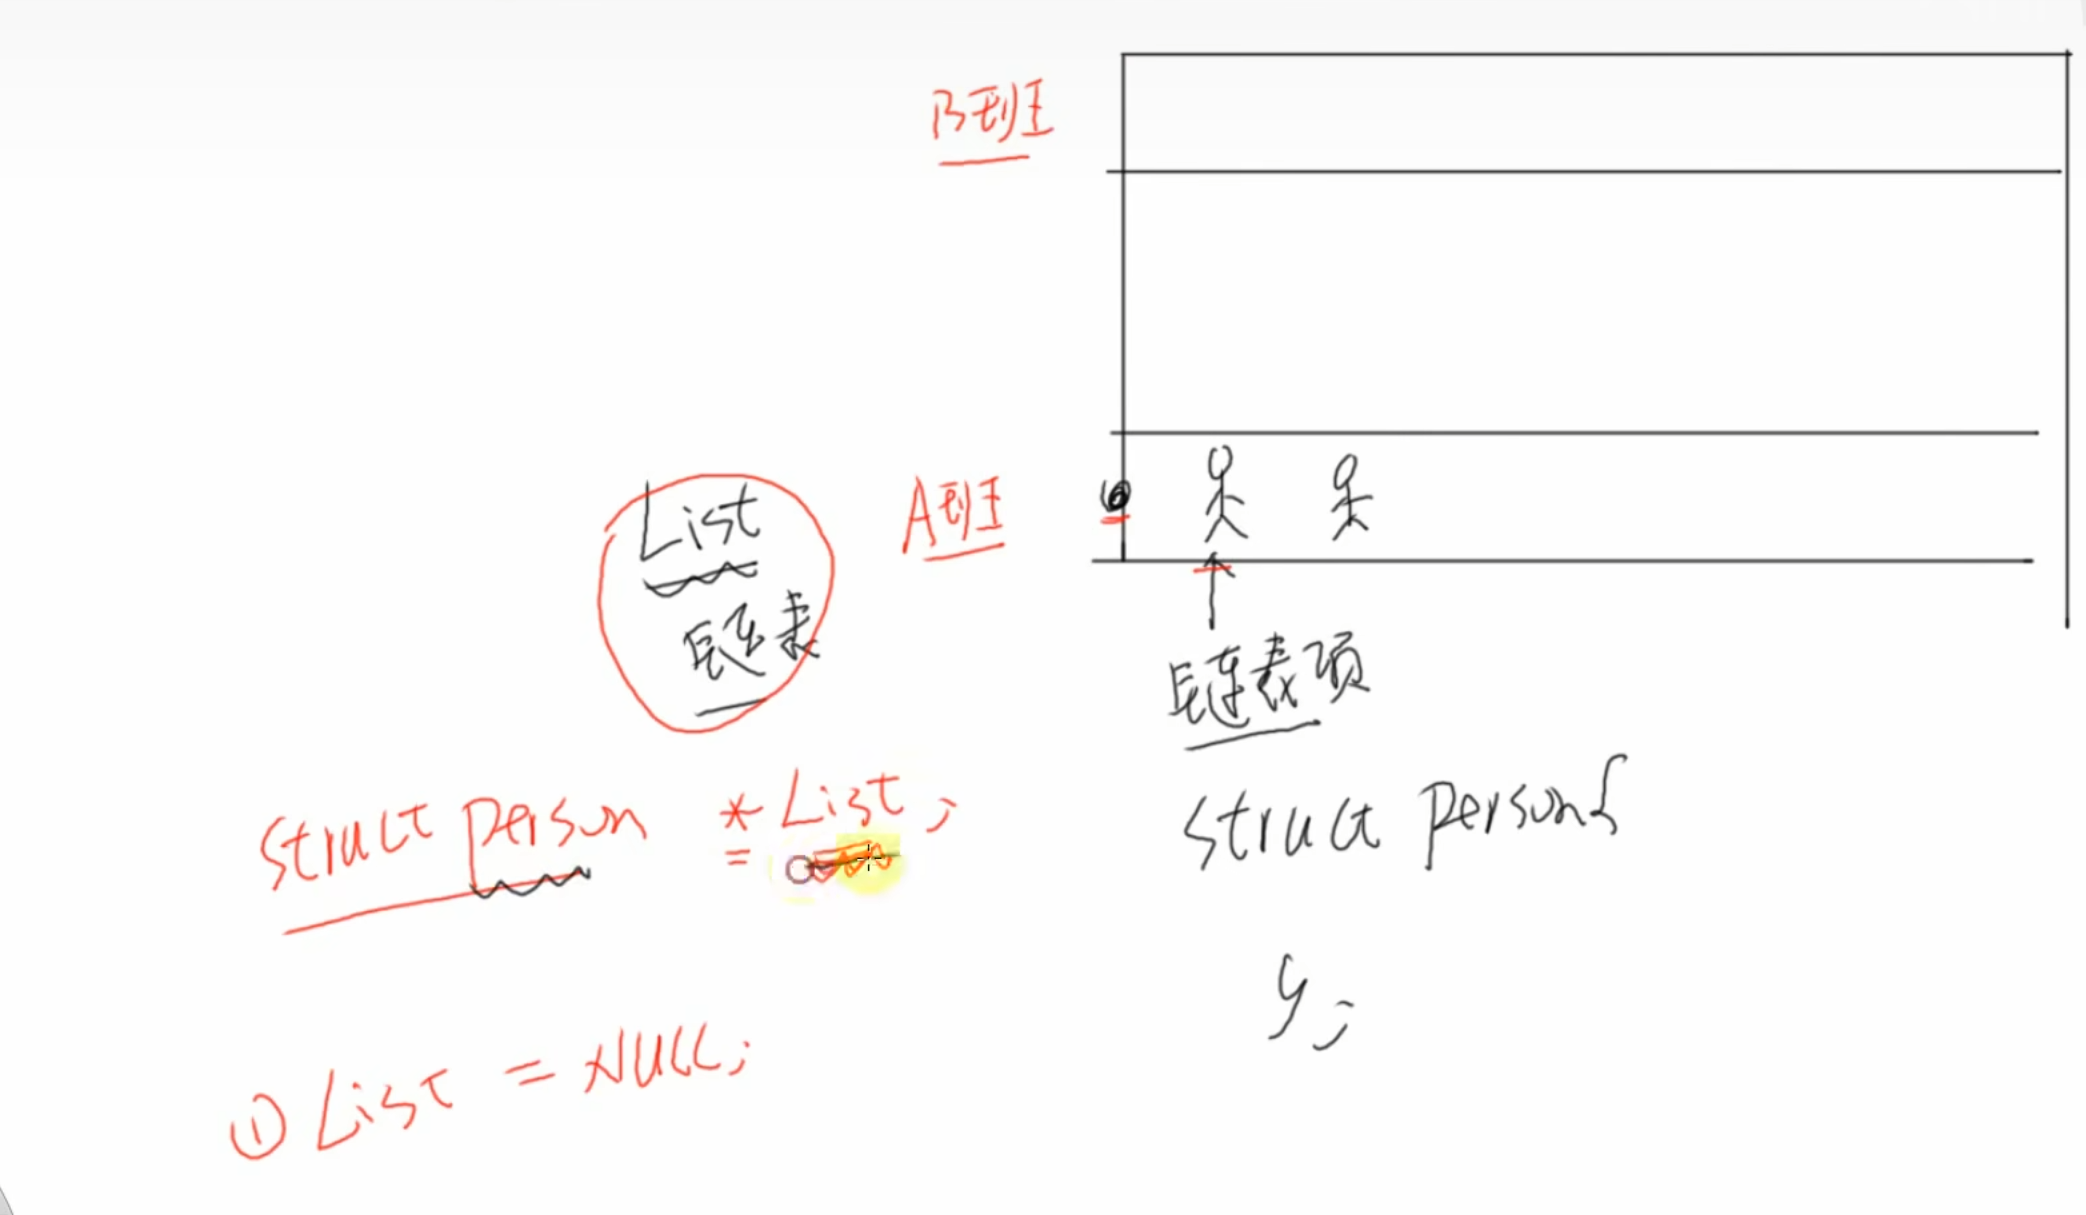
如上图,我们可以把链表想象成一个班级,把节点想象成班级里的同学。每个同学(节点)都携带自己的个人信息,同时还会记住下一个同学是谁,这样我们就能顺着这条"同学链"找到班级里的所有人。
基于这个思路,我们需要定义两个结构体:
- person 结构体(节点):相当于班级里的一个同学。它除了保存自己的信息(如姓名、年龄)外,还包含一个指向下一个同学的指针,通过这个指针我们就能顺着链表找到其他同学。
- list 结构体(链表):相当于整个班级。它保存链表的基本信息,并包含一个指向第一个同学的指针,作为整个链表的入口。
通过这两个结构体的配合,我们就能完整地描述和管理一个链表了,用代码来表示就是:
c
struct person
{
	char *name;
	uint8_t age;
	struct person* Next;
};

struct list
{
	char *class;
	struct person* Next;
};

struct list A;
struct person P1;

int main(void)
{
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");
	A.Next=NULL;

	P1.name="a1";
	P1.age = 6;
	P1.Next =NULL ;

	A.Next=&P1;

	printf("AList的第一个成员名字是:%s\r\n",A.Next->name);

	while(1)
	{

	}

}
(2)普通链表的创建和添加:
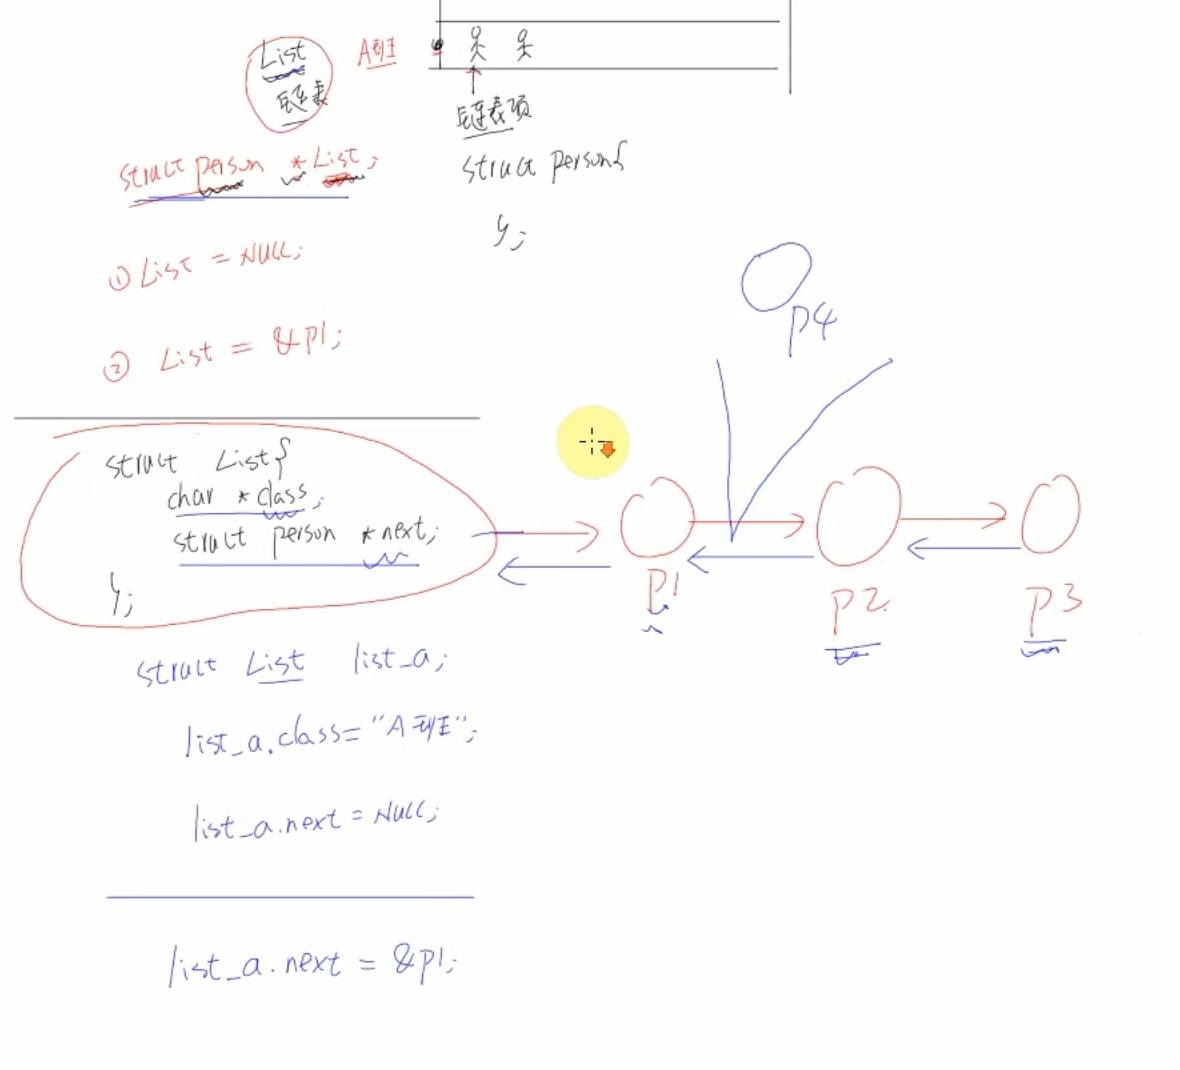
如上图,我们一开始假设班级里没有同学,也就是链表初始化时 list_a.next = NULL,表示链表为空、没有任何成员。如果我们要添加一个新同学 A,只需要把新同学 A 的地址赋给 list_a.next 即可。
这就引出了普通链表如何添加一个节点的问题:
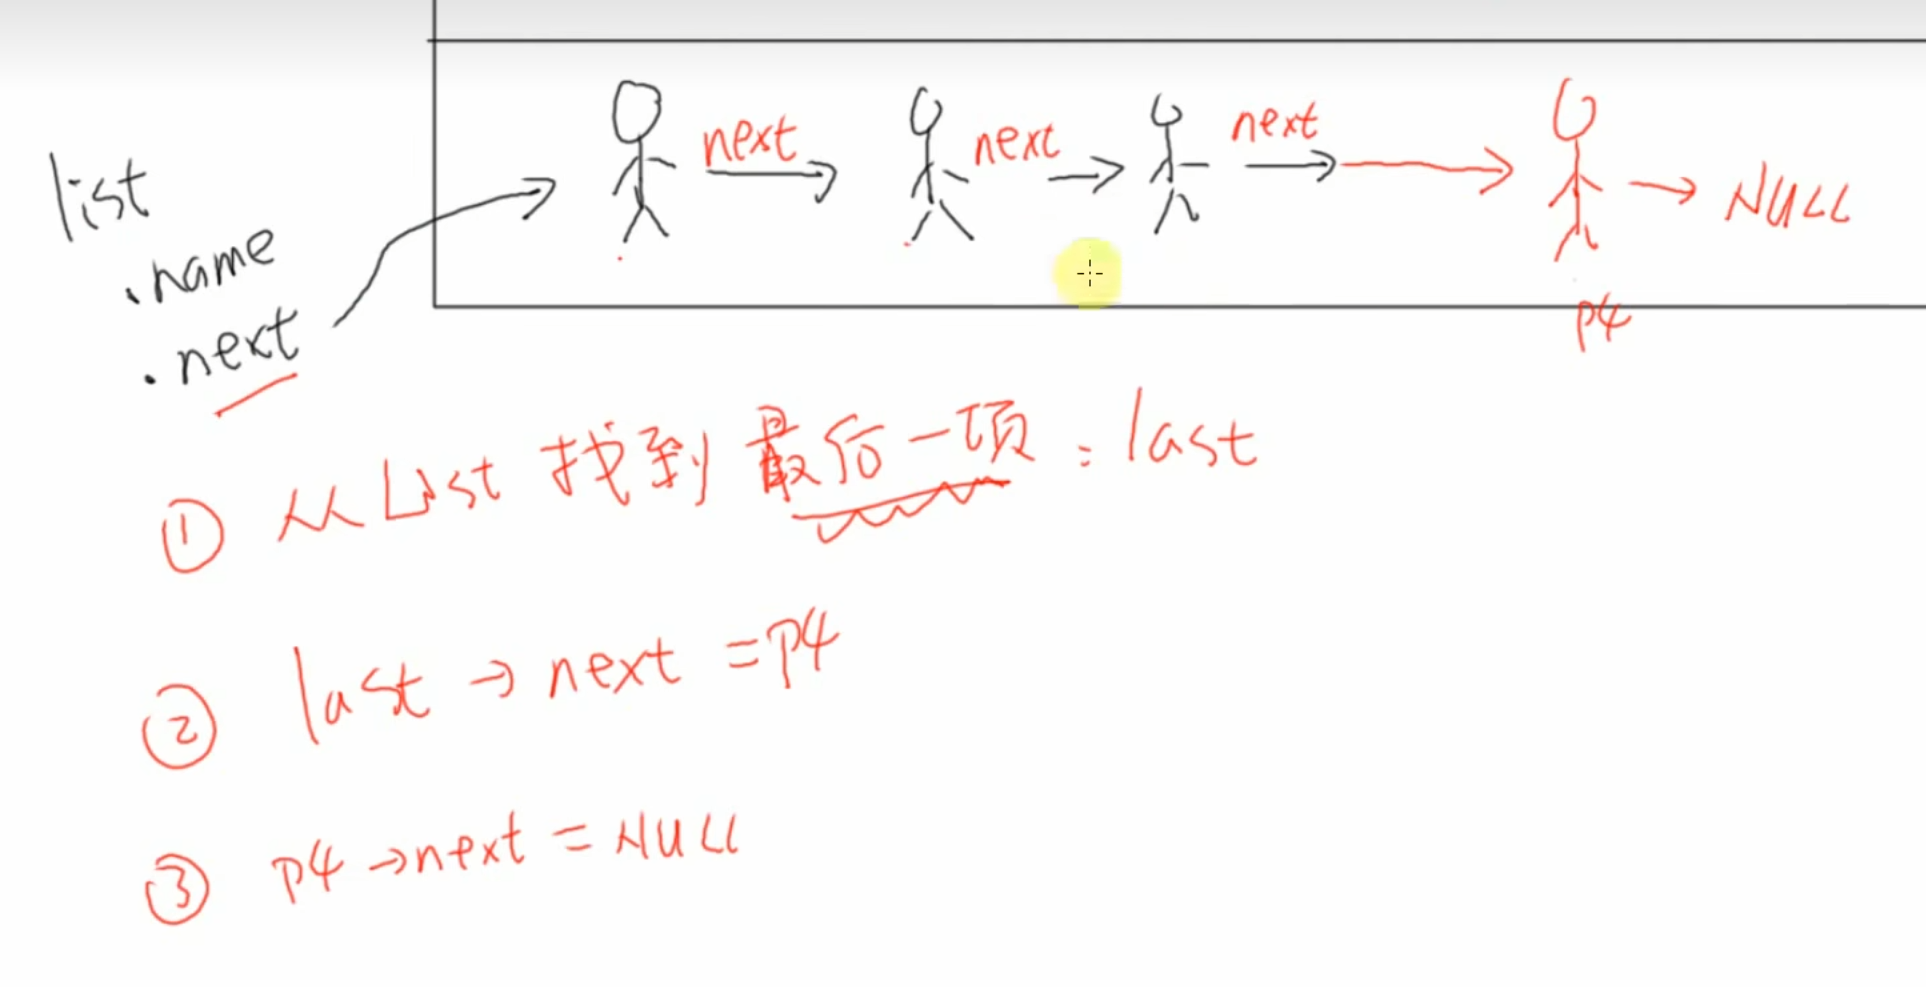
从图中可以看出,我们假设有一个 person 结构体的指针 last,只要不断访问 last.next:如果 last.next 非空,说明这个同学后面还有新同学,就继续往后找;直到 last.next == NULL,说明已经到达链表末尾,这时就可以在链表末尾添加一个新成员,并让新成员的 next 指向 NULL,链表就添加完成了。
主函数代码如下:
c
struct person
{
	char *name;
	uint8_t age;
	struct person* Next;
};

struct list
{
	char *class;
	struct person* Next;
};

struct list a_list;
struct person person[]={
	{"p1",8,NULL},
	{"p2",12,NULL},
	{"p3",38,NULL},
	{NULL,38,NULL}
};

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i]);
		i++;
	}

	printList(&a_list);
	while(1)
	{

	}

}从这段代码我们可以知道我们要定义三个函数分别是:Initlist(&a_list,"class_a");AddItemTOlist(&a_list,&personi);printList(&a_list);
Initlist(&a_list,"class_a")如下:
c
/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->Next=NULL;
}AddItemTOlist(&a_list,&personi)函数如下(重点):
c
/*list添加函数*/
void AddItemTOlist(struct list* plist,struct person* New_person)
{
	struct person* Last;
	/*判断链表一开始是不是空的*/
	if(plist->Next==NULL)
	{
		plist->Next=New_person;
		New_person->Next=NULL;
		return;
	}
	/*执行到这说明plist->Next非空*/
	Last=plist->Next;
	/*如果这同学后面没有人则跳出循环*/
	while(Last->Next)
	{
		Last=Last->Next;
	}
	Last->Next=New_person;
	New_person->Next=NULL;
}从前面我们知道,person 数组中的每个成员都没有指向下一个同学(它们的 Next 都是 NULL),而我们在初始化 plist 时也没有指向任何同学(pList->Next = NULL)。因此,第一次调用 AddItemTOlist 时,链表一定是空的,所以这段代码只会执行 if(plist->Next == NULL) 这个分支,直接把第一个同学挂到链表头部。
printList(&a_list)代码如下:
c
void printList(struct list* plist)
{
	struct person*p=plist->Next;
	while(p->Next!=NULL)
	{
		printf("成员名字:%s,成员年龄:%d\r\n",p->name,p->age);
		p=p->Next;
	}
}
所以整体程序代码如下;
c
struct person
{
	char *name;
	uint8_t age;
	struct person* Next;
};

struct list
{
	char *class;
	struct person* Next;
};

struct list a_list;
struct person person[]={
	{"p1",8,NULL},
	{"p2",12,NULL},
	{"p3",38,NULL},
	{NULL,38,NULL}
};

/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->Next=NULL;
}

/*list添加函数*/
void AddItemTOlist(struct list* plist,struct person* New_person)
{
	struct person* Last;
	/*判断链表一开始是不是空的*/
	if(plist->Next==NULL)
	{
		plist->Next=New_person;
		New_person->Next=NULL;
		return;
	}
	/*如果没有上面一步,链表一开始是空的,Last=NULL,NULL不能->Next*/
	/*执行到这说明plist->Next非空*/
	Last=plist->Next;
	/*如果这同学后面没有人则跳出循环*/
	while(Last->Next)
	{
		Last=Last->Next;
	}
	Last->Next=New_person;
	New_person->Next=NULL;
}

void printList(struct list* plist)
{
	struct person*p=plist->Next;
	while(p->Next!=NULL)
	{
		printf("成员名字:%s,成员年龄:%d\r\n",p->name,p->age);
		p=p->Next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i]);
		i++;
	}

	printList(&a_list);
	while(1)
	{

	}

}
这就是普通链表添加节点的完整代码流程:先通过 Initlist 初始化链表,再循环调用 AddItemTOlist 逐个把 person 数组中的成员挂到链表末尾,最后用 printList 遍历输出验证结果。
(3)普通链表的删除;
普通链表的删除有二种情况:
情况一:
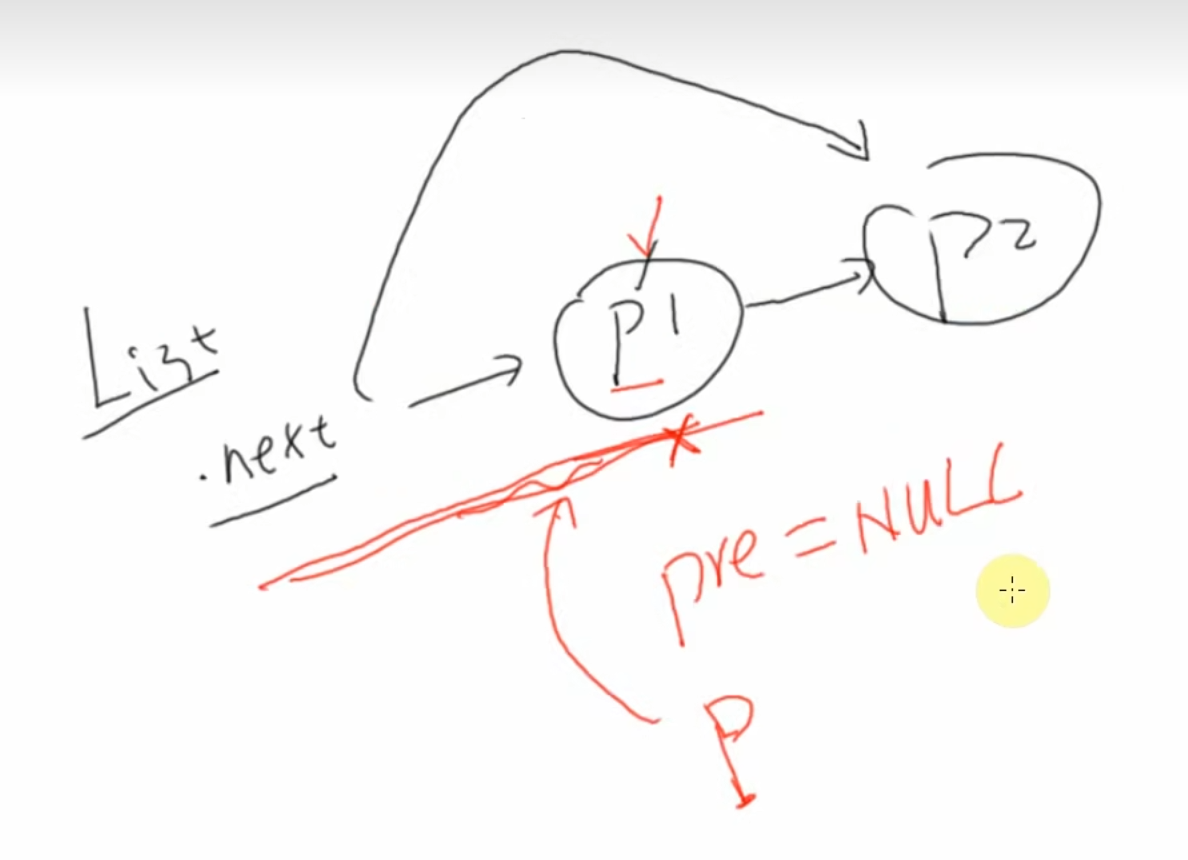
当我们要删除的节点是第一个时,那么list.next指向的就是第二个节点
情况二:
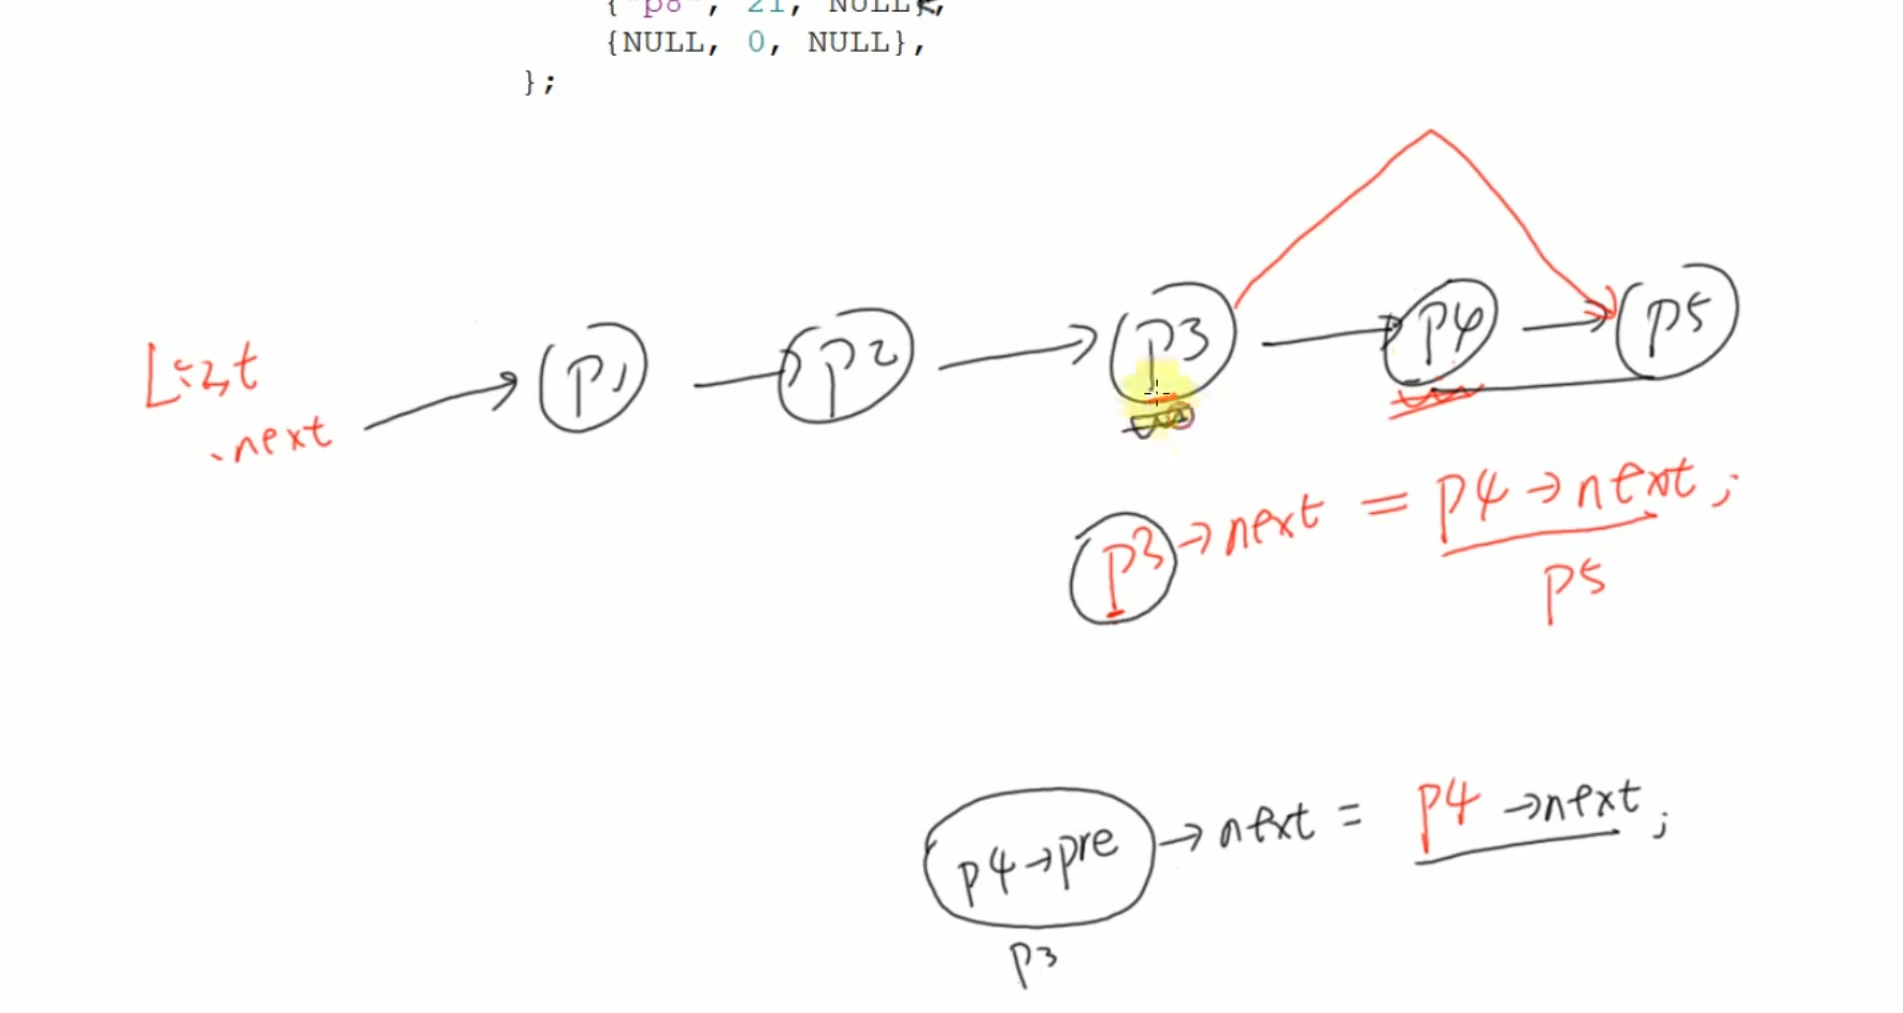
当我们要删除的节点不是第一个时,那么我们要删除的节点的前一个节点就会指向要删除的节点的下一个节点,从而跳过被删除的节点,把它从链表中"摘除"。
所以代码如下:
c
/*list删除节点函数*/
void DeleteItemTOlist(struct list* plist,struct person* Delete_person)
{
	struct person* p=plist->Next;
	struct person* pre=NULL;
	/*寻找要删除的节点*/
	while(p!=NULL && p!=Delete_person)
	{
		/*链表非空,而且要删除的节点也不是第一个节点,进入循环*/
		pre=p;
		p=p->Next;
	}
	/*跳出循环的条件,P=NULL,找到Delete_person*/
	/*(P=NULL这有两种可能,链表为空或没有找到要删除的节点,因为最后一个节点的next=NULL)*/
	if(p==NULL)
	{
		printf("链表为空或没有找到节点\r\n");
		return ;
	}
	/*如果要删除第一个节点pre=NULL*/
	if(pre==NULL)
	{
		/*链表头部指向二个节点*/
		plist->Next=p->Next;
	}
	else
	{
		pre->Next=p->Next;
	}
	return ;
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i]);
		i++;
	}

	printf("打印全部节点\r\n");
	printList(&a_list);
	printf("打印剩余节点\r\n");
	DeleteItemTOlist(&a_list,&person[2]);
	printList(&a_list);


	while(1)
	{

	}

}
(4)普通链表的排序
如果我们先按照年龄大小来排序(从低到高),可以从下面的图来操作
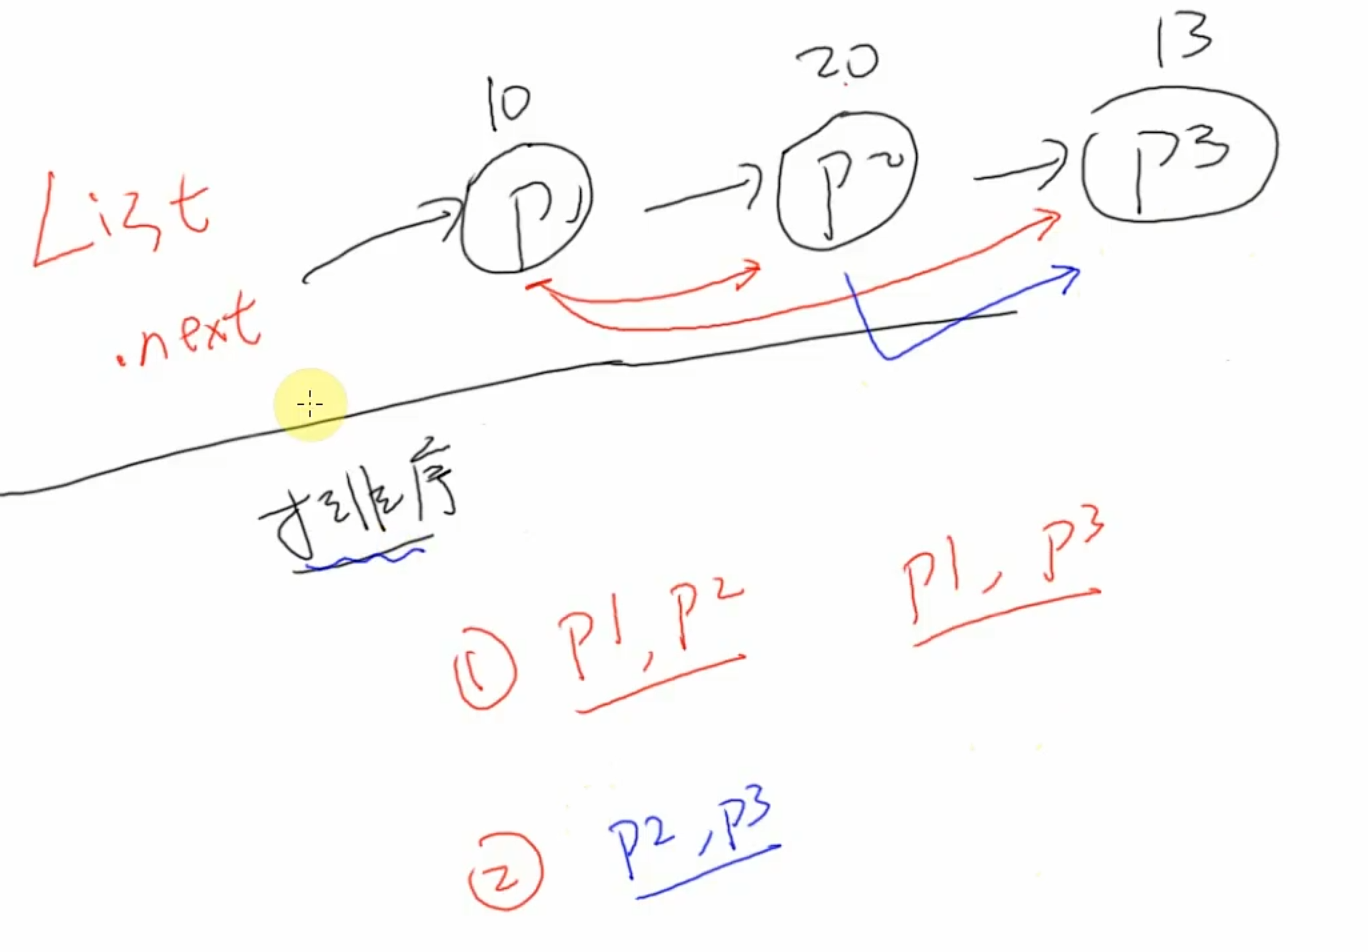
从这个图我们可以知道,我们可以先让 P1 分别与 P2、P3 对比,然后 P2 再与 P3 对比,谁的年龄小就交换到前面来。不过由于我们的程序设计存在一个问题:比如我们定义一个 struct person* pre,如果它是第二个节点的前一个节点(也就是第一个节点),那么它就是 struct list->next;但对于其他节点,它却是 struct person->next。这就导致 next 的类型不统一,直接交换节点位置会很麻烦。所以这里我们退而求其次,不交换节点本身,而是只交换它们的姓名和年龄,同样能达到排序的目的,后面我们会改进程序来达到这个目的
下面是给list排序的代码:
c
/*给list排序函数*/
void Sortlist(struct list* plist)
{
	struct person* pre;
	struct person* next;

	char *tmp_name;
	uint8_t tmp_age;

	pre=plist->Next;
	while(pre)
	{
		/*确保next是在新的pre的下一个节点*/
		next=pre->Next;
		while(next)
		{
			/*如果存在前一个节点和后一个节点就进入该循环*/
			if(pre->age>next->age)
			{
				tmp_name=pre->name;
				pre->name=next->name;
				next->name=tmp_name;

				tmp_age=pre->age;
				pre->age=next->age;
				next->age=tmp_age;
			}
			/*pre跟next的下一个比,知道next为空*/
			next=next->Next;
		}
		/*换成pre下一个节点来比*/
		pre=pre->Next;
	}

}

void printList(struct list* plist)
{
	struct person*p=plist->Next;
	while(p->Next!=NULL)
	{
		printf("成员名字:%s,成员年龄:%d\r\n",p->name,p->age);
		p=p->Next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i]);
		i++;
	}

	printf("打印全部节点\r\n");
	printList(&a_list);
	printf("打印剩余节点\r\n");
	DeleteItemTOlist(&a_list,&person[2]);
	printList(&a_list);

	printf("打印排序后的list\r\n");
	Sortlist(&a_list);
	printList(&a_list);

	while(1)
	{

	}

}
(5)改进普通链表
我们注意到上面的程序代码是有缺陷的,下面我们对程序代码进行改进:
c
struct person
{
	char *name;
	uint8_t age;
	struct person* Next;
};


struct list
{
	char *class;
	struct person Head;
};

struct list a_list;
struct person person[]={
	{"p1",8,NULL},
	{"p2",12,NULL},
	{"p3",38,NULL},
	{"p4",4,NULL},
	{"p5",7,NULL},
	{NULL,0,NULL},
};

/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->Head.Next=NULL;
}
这是改进后的代码,我把原来 struct list 结构体中的 struct person* 指针,换成了 struct person 结构体,这样的改法有啥区别呢?
打个比方:
- 原来程序 :你是班长,手里直接牵着队伍第一个人的衣服。
- 换第一个人:你得松开手,去牵新的第一个人。
- 换中间的人:让他前面的人松手牵新的。
- 两种操作不一样,需要分别处理。
- 改进程序 :队伍最前面永远站个稻草人,你牵的是稻草人,而稻草人牵着第一个真人。
- 不管换第几个真人,都只需要让他前面的那个(稻草人或真人)松手换一个,而你只需要牵稻草人就行了。
- 操作永远一模一样,不需要区分情况。
这样你就不需要判断链表是不是空的。因为在原来的程序中,你指向的第一个 struct person 结构体是在 struct list 结构体内的,而指向第二个 struct person 结构体才是在 struct person 结构体内的,导致第一个与第二个结构体不统一,所以要分别判断。而改进后,Head 这个"稻草人"永远存在,链表为空时它指向 NULL,链表非空时它指向第一个真人,操作逻辑完全统一。
所以后面的增加节点、删除节点、排序链表的代码也要改进:
c
struct person
{
	char *name;
	uint8_t age;
	struct person* Next;
};


struct list
{
	char *class;
	struct person Head;
};

struct list a_list;
struct person person[]={
	{"p1",8,NULL},
	{"p2",12,NULL},
	{"p3",38,NULL},
	{"p4",4,NULL},
	{"p5",7,NULL},
	{NULL,0,NULL},
};

/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->Head.Next=NULL;
}

/*list添加节点函数*/
void AddItemTOlist(struct list* plist,struct person* New_person)
{
	/*相当于链表里面有一个稻草人,这个稻草人牵着第一个同学*/
	struct person* Last=&plist->Head;

	/*如果这同学后面没有人则跳出循环*/
	while(Last->Next)
	{
		Last=Last->Next;
	}
	Last->Next=New_person;
	New_person->Next=NULL;
}

/*list删除节点函数*/
void DeleteItemTOlist(struct list* plist,struct person* Delete_person)
{
	struct person* pre=&plist->Head;
	/*寻找要删除的节点*/
	while(pre->Next!=NULL && pre->Next!=Delete_person)
	{
		/*链表非空,而且要删除的节点也不是第一个节点,进入循环*/
		pre=pre->Next;
	}
	if(pre->Next==NULL)
	{
		printf("链表为空或没有找到节点\r\n");
		return ;
	}
	pre->Next=Delete_person->Next;
	return ;
}

void TranteItemTOlist(struct person* pre,struct person* new_preson)
{
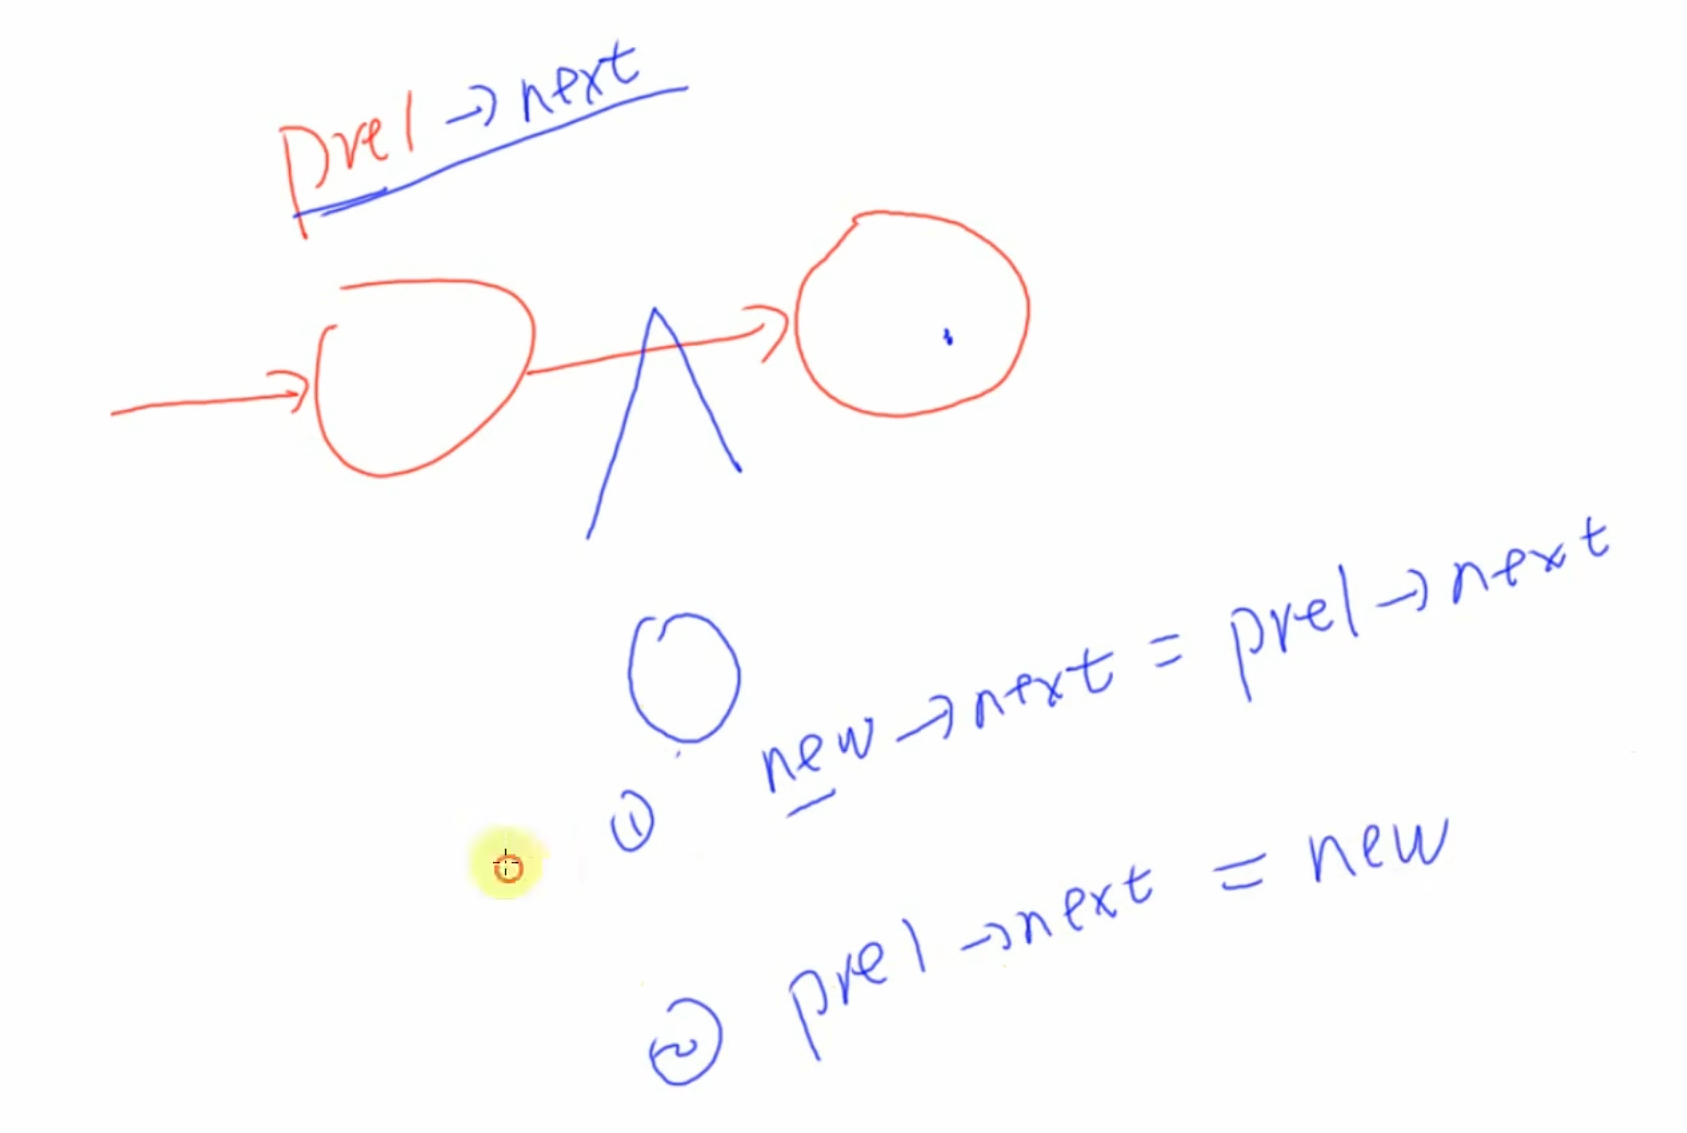
	/*新插入的节点的下一个节点是插入位置前一个节点的下一个节点*/
	new_preson->Next=pre->Next;
	/*插入位置前一个节点的下一个节点改成新插入的节点*/
	pre->Next=new_preson;
}

/*给list排序函数*/
void Sortlist(struct list* plist)
{
	/*pre是稻草人*/
	struct person* pre1=&plist->Head;
	struct person* cur=pre1->Next;
	struct person* pre2;
	struct person* next;
	struct person* tmp;


	while(cur)
	{
		pre2=cur;
		/*确保next是在新的pre的下一个节点*/
		next=cur->Next;
		while(next)
		{
			/*如果存在前一个节点和后一个节点就进入该循环*/
			if(cur->age > next->age)
			{

				/*删掉cur*/
				DeleteItemTOlist(plist,cur);
				/*删掉next*/
				DeleteItemTOlist(plist,next);
				/*将next插入cur*/
				TranteItemTOlist( pre1,next);
				if(pre2==cur)
				{
					TranteItemTOlist( next,cur);
				}
				else
				{
					/*将cur插入next*/
					TranteItemTOlist( pre2,cur);
				}
				/*因为cur和next互换位置了,为了人cur继续跟后面的对比,要把cur和next互换回来*/
				/*这里的cur和next是指名字*/
				tmp=cur;
				cur=next;
				next=tmp;
			}
			pre2=next;
			/*cut跟next的下一个比,知道next为空*/
			next=next->Next;
		}
		pre1=cur;
		/*换成cut下一个节点来比*/
		cur=cur->Next;
	}

}

void printList(struct list* plist)
{
	struct person*p=plist->Head.Next;
	while(p!=NULL)
	{
		printf("成员名字:%s,成员年龄:%d\r\n",p->name,p->age);
		p=p->Next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i]);
		i++;
	}

	printf("打印全部节点:\r\n");
	printList(&a_list);
	printf("打印剩余节点:\r\n");
	DeleteItemTOlist(&a_list,&person[2]);
	printList(&a_list);

	printf("打印排序后的list:\r\n");
	Sortlist(&a_list);
	printList(&a_list);

	while(1)
	{

	}

}
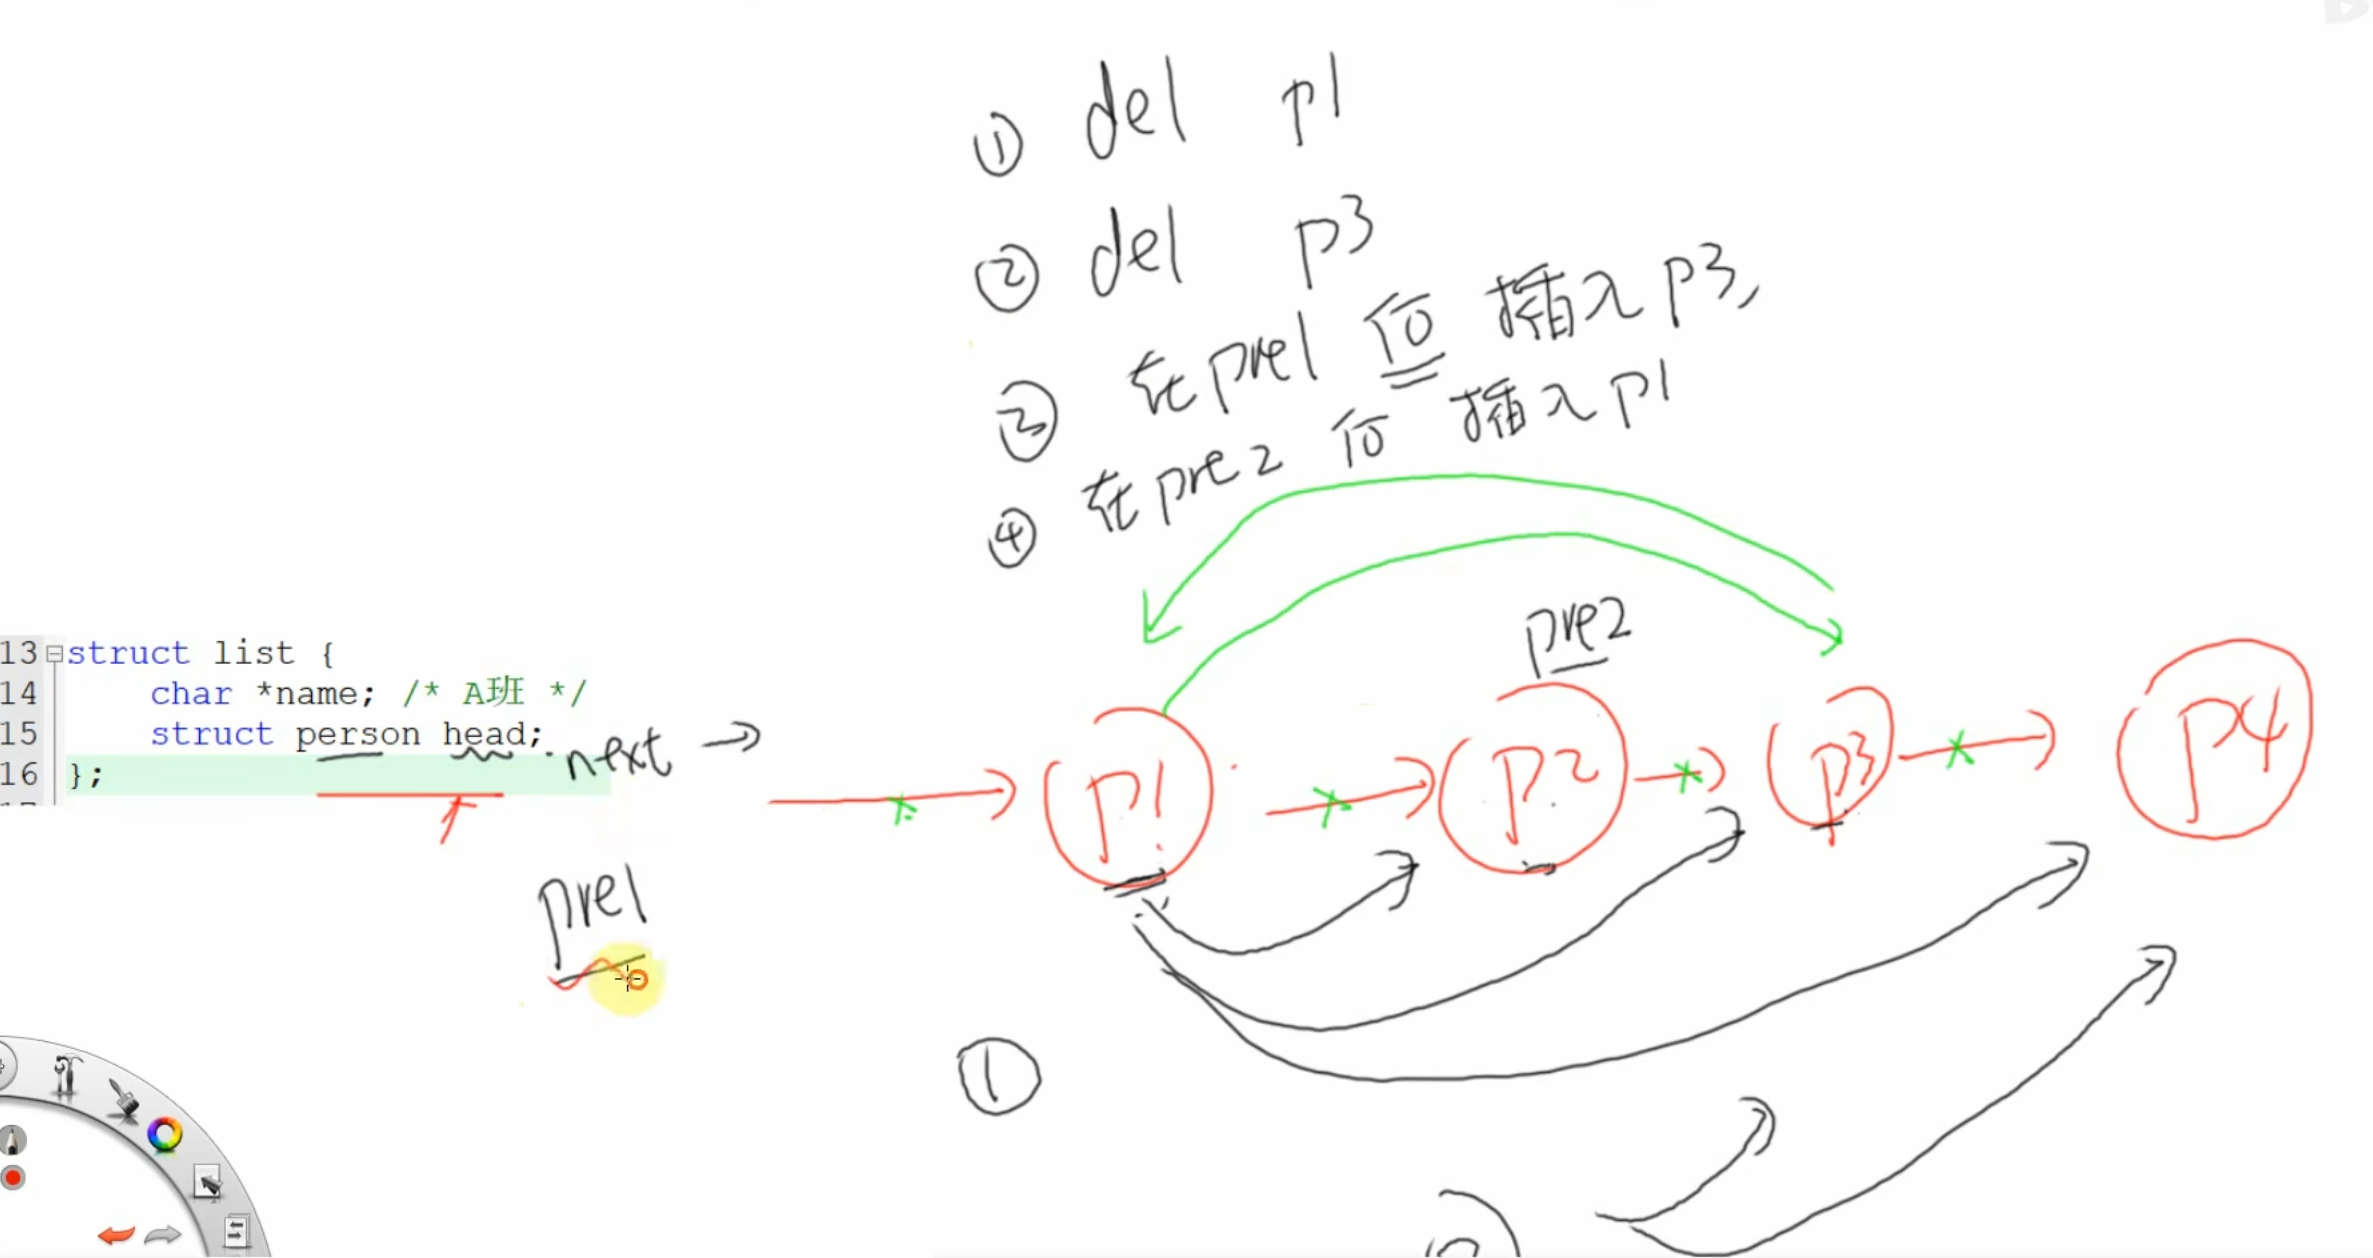
其中链表排序的代码逻辑较为复杂,流程图大致如下:
(6)通用链表
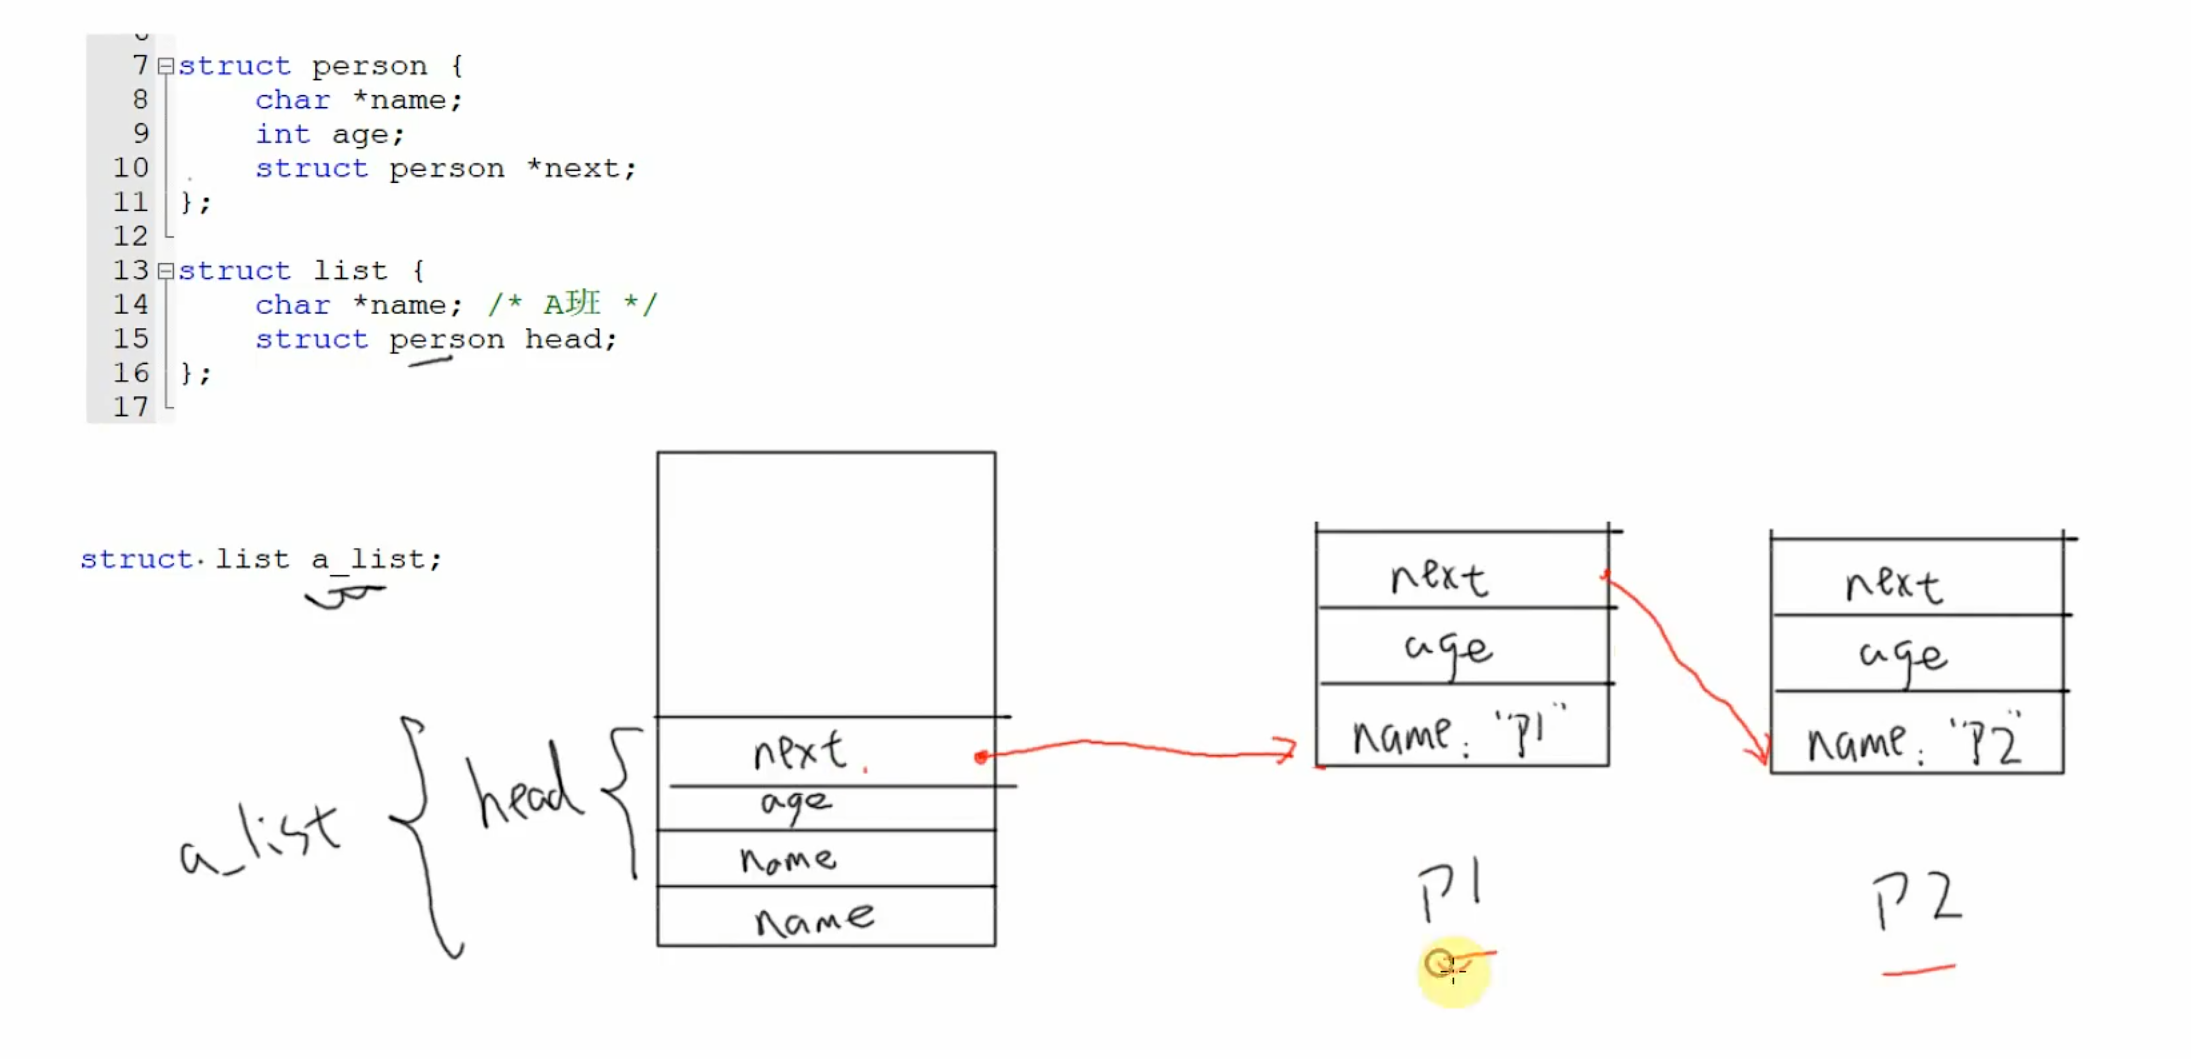
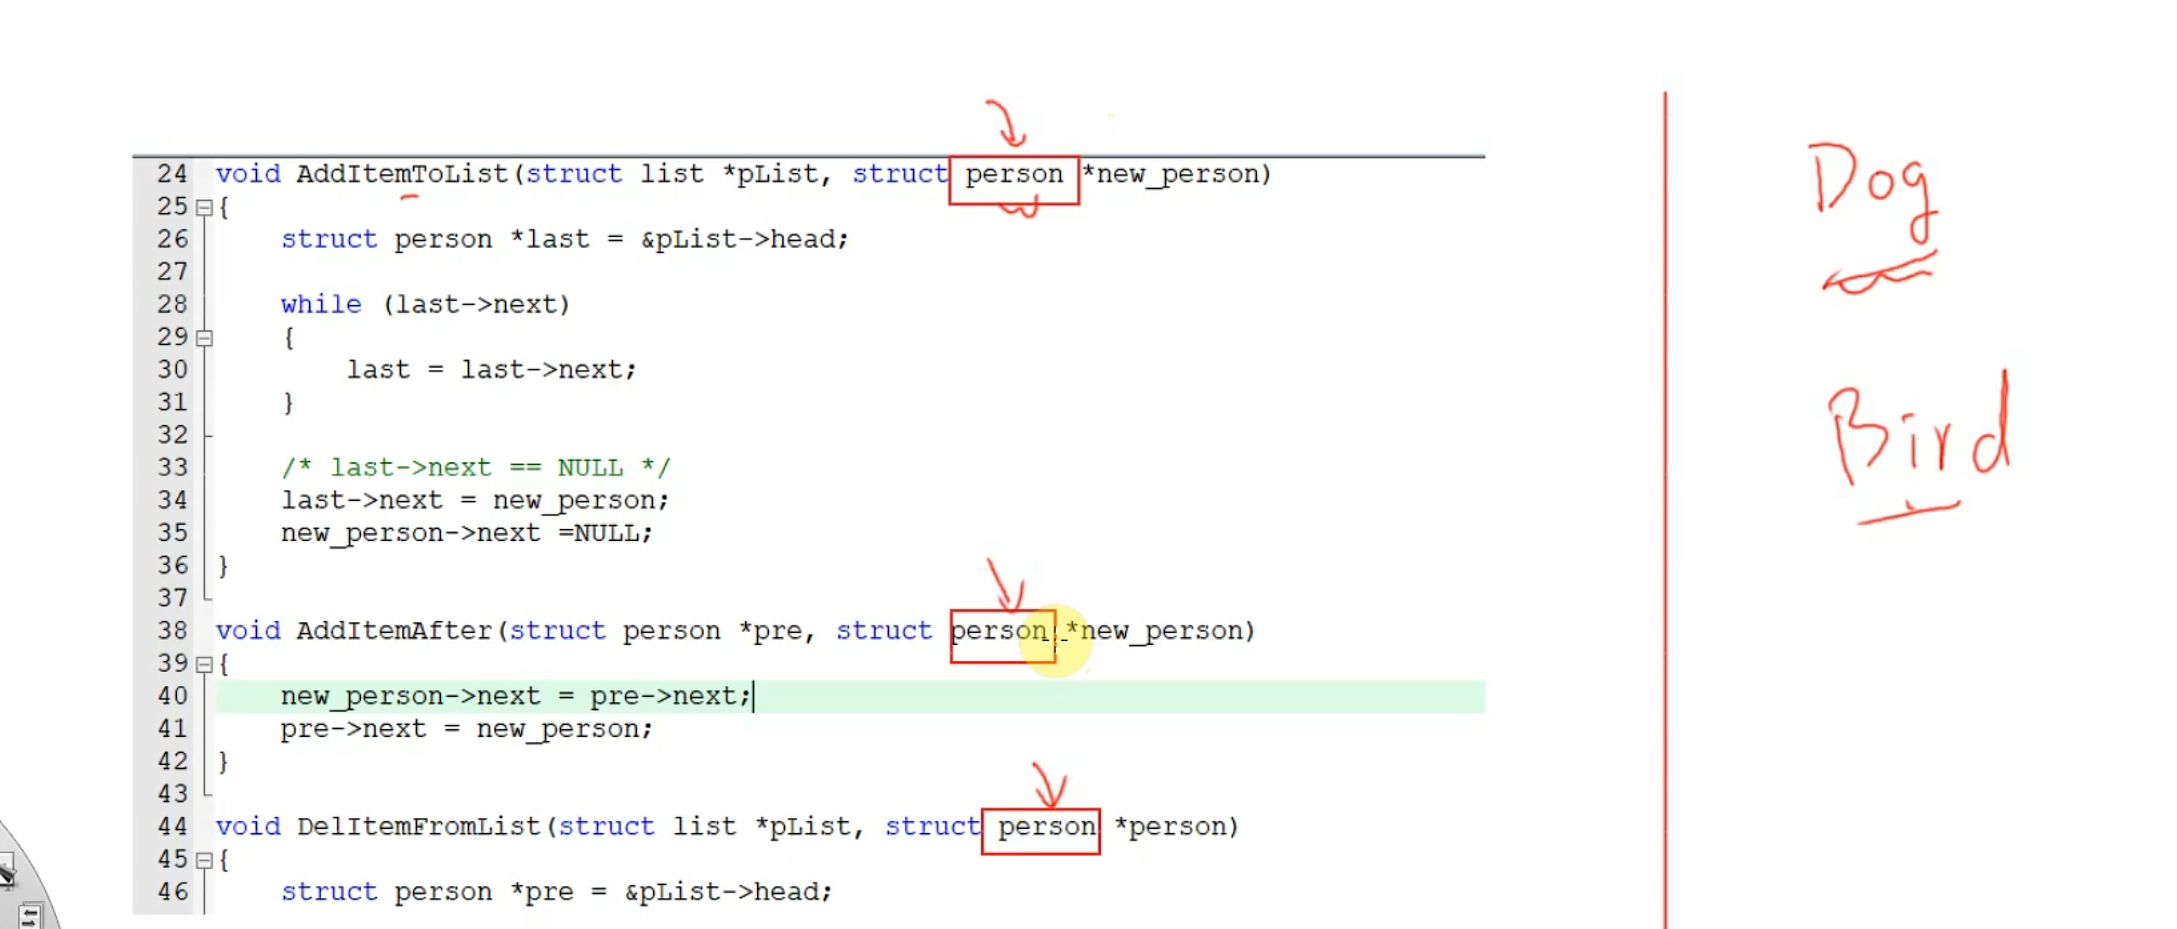
在之前的链表改进中,其实还是有缺陷的。可以发现,这种链表只能指向一种类型的结构体。那假设我换一种类型的结构体呢?例如上图,你当然可以换成指向"狗""鸟"的结构体,但是换成这种结构体后,上面那些指向"人"的结构体函数你就不能用了,你要重新创建一套"狗""鸟"的函数。
所以对于上述的普通链表,它的缺点就是只能局限一种结构体。那能不能创建一种链表,来实现能指向所有结构体呢?可以的 ,这就是我们接下来要讲的通用链表。
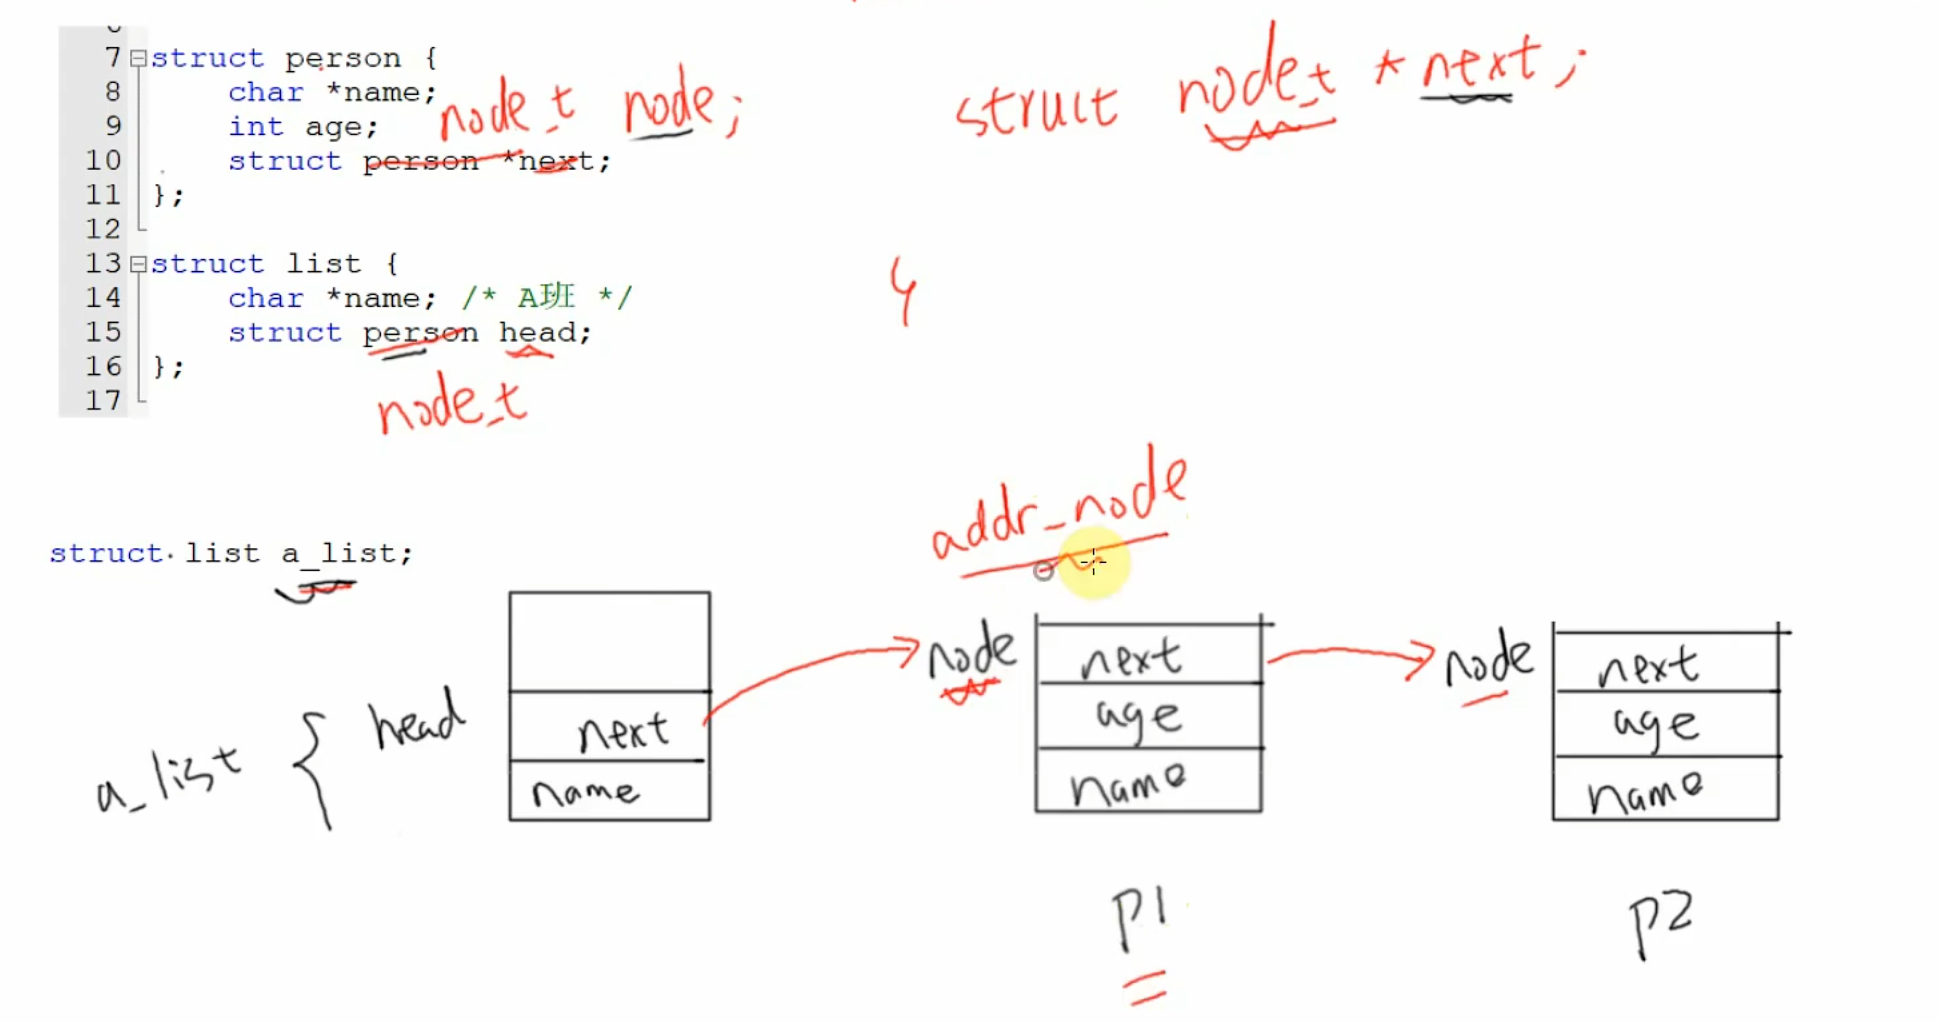
我们发现在之前的普通链表中,都是直接指向"人"这个结构体。那么我们能不能把这个结构体指针换成一个 node_t 结构体,这个结构体的成员就是指向下一个 node_t 结构体的指针呢?
打个比方:这次我们不再是一个同学牵着另外一个同学的手,而是让每个同学都拿一部手机(node_t 结构体)来联系下一个同学。我们只要通过这部手机,就能找到下一个同学的全部信息,而手机本身并不关心对方是人、是狗还是鸟。如下图:
那么就有同学疑惑了:我们怎么通过这个"手机"知道这个同学的信息呢?很简单,既然我们知道 node_t 结构体是 struct person 结构体的成员,那么我们就可以通过这个 node_t 结构体的偏移地址 反推出 struct person 结构体的首地址,如下:
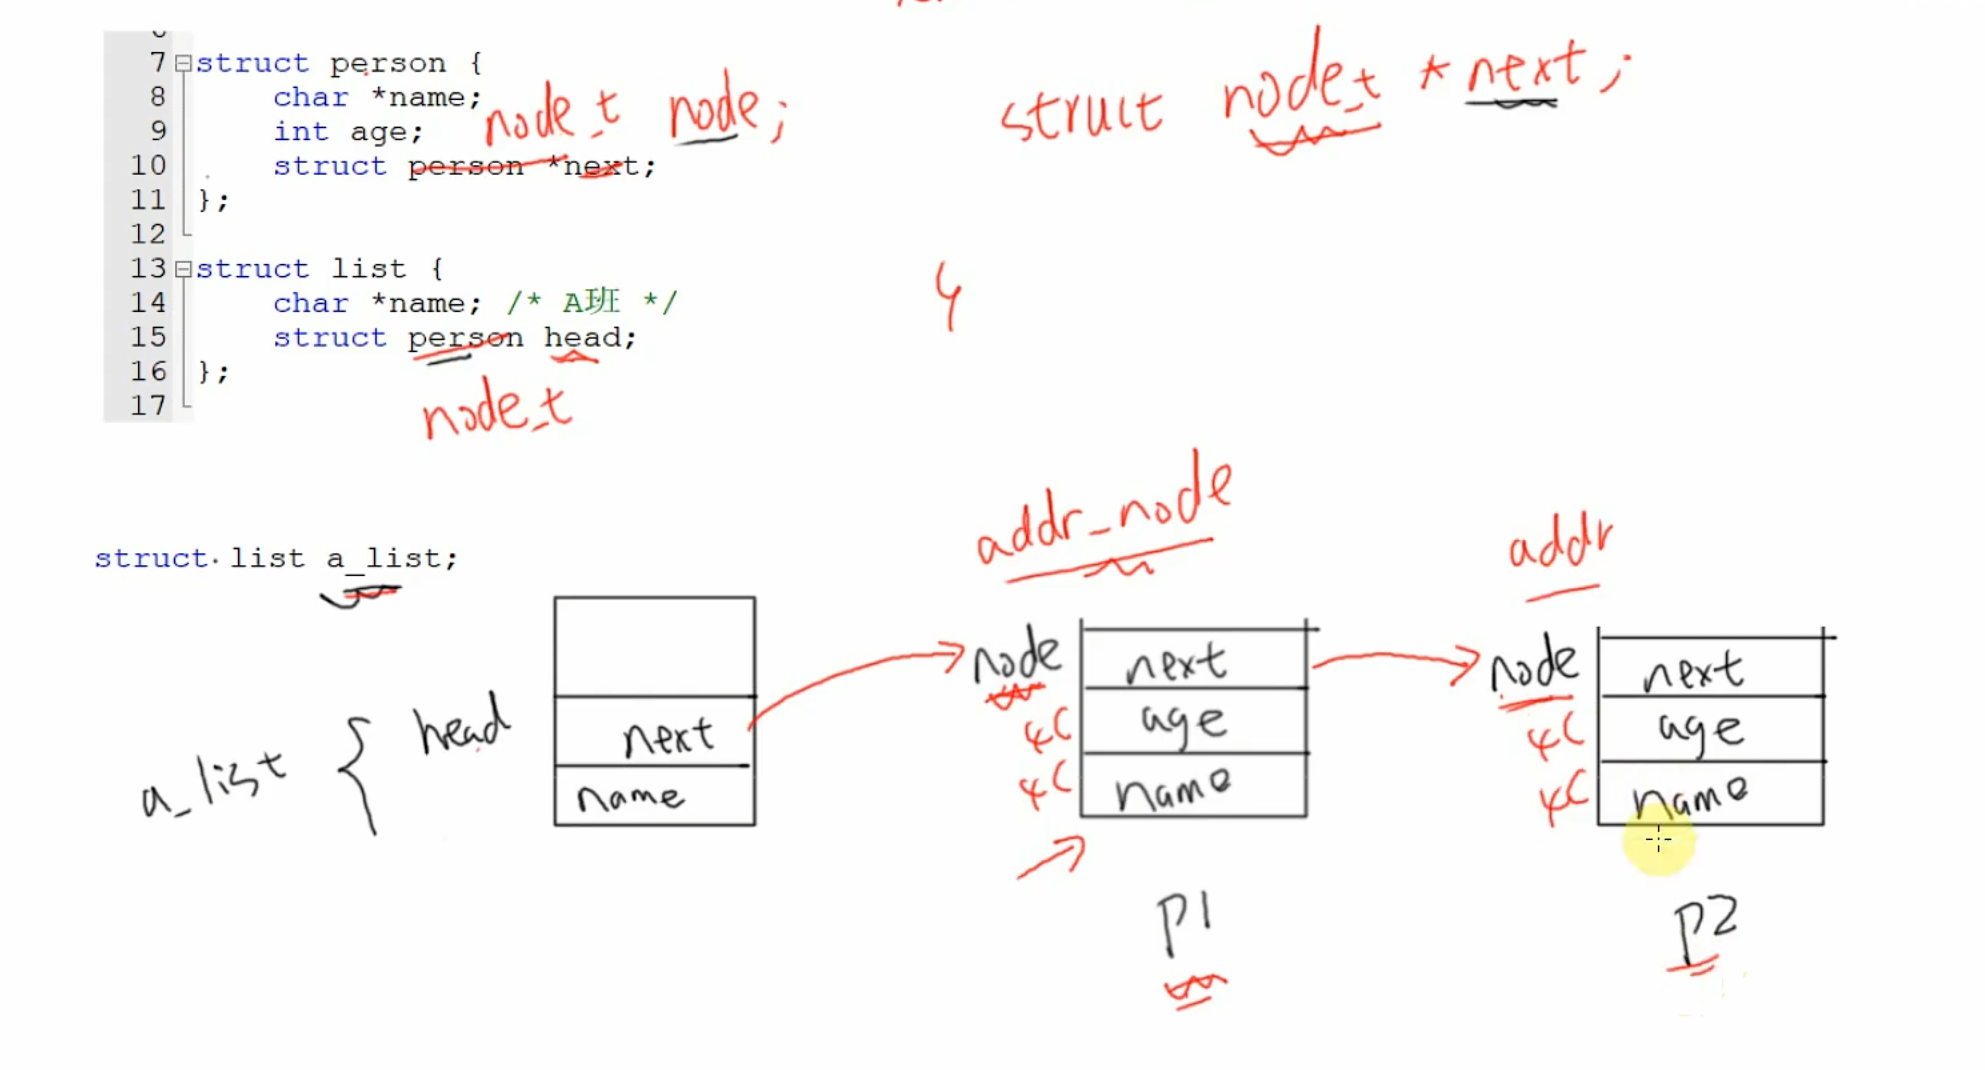
这里的关键在于:node_t 是 struct person 的成员,它在结构体中的位置是固定的(偏移量为 8 字节)。所以只要拿到 node_t 的地址,再减去这个固定的偏移量,就能反推出整个 struct person 的起始地址,从而访问到它的所有成员(如姓名、年龄等)。这正是通用链表能够"通过手机找到同学"的核心原理。
下面我们就开始改进链表:
c
struct node_t
{
	struct node_t* next;
};

struct person
{
	char *name;
	uint8_t age;
	struct node_t node;
};


struct list
{
	char *class;
	struct node_t head;
};

struct list a_list;
struct person person[]={
	{"p1",8,{NULL}},
	{"p2",12,{NULL}},
	{"p3",38,{NULL}},
	{"p4",4,{NULL}},
	{"p5",7,{NULL}},
	{NULL,0,{NULL}},
};

/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->head.next=NULL;
}

/*list添加节点函数*/
void AddItemTOlist(struct list* plist,struct node_t* New_node)
{
	/*相当于链表有一个班级手机*/
	struct node_t* Last=&plist->head;

	/*如果这手机没有加油下一个同学则跳出循环*/
	while(Last->next)
	{
		Last=Last->next;
	}
	/*给这个手机添加下一个同学*/
	Last->next=New_node;
	New_node->next=NULL;
}

/*list删除节点函数*/
void DeleteItemTOlist(struct list* plist,struct node_t* Delete_node)
{
	struct node_t* pre=&plist->head;
	/*寻找要删除的节点*/
	while(pre->next!=NULL && pre->next!=Delete_node)
	{
		/*链表非空,而且要删除的节点也不是第一个节点,进入循环*/
		pre=pre->next;
	}
	if(pre->next==NULL)
	{
		printf("链表为空或没有找到节点\r\n");
		return ;
	}
	pre->next=Delete_node->next;
	return ;
}

void TranteItemTOlist(struct node_t* pre,struct node_t* new_preson)
{
	/*新插入的节点的下一个节点是插入位置前一个节点的下一个节点*/
	new_preson->next=pre->next;
	/*插入位置前一个节点的下一个节点改成新插入的节点*/
	pre->next=new_preson;
}

/*利用struct node_t结构体算出struct person的首地址地址*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*利用node算出struct person结构体的首地址*/
	c=(struct person*)((char*)cur-(uint32_t)&(((struct person*)0)->node));
	n=(struct person*)((char*)next-(uint32_t)&(((struct person*)0)->node));
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}

/*给list排序函数*/
void Sortlist(struct list* plist)
{
	/*pre是稻草人*/
	struct node_t* pre1=&plist->head;
	struct node_t* cur=pre1->next;
	struct node_t* pre2;
	struct node_t* next;
	struct node_t* tmp;


	while(cur)
	{
		pre2=cur;
		/*确保next是在新的pre的下一个节点*/
		next=cur->next;
		while(next)
		{
			/*如果存在前一个节点和后一个节点就进入该循环*/
			if(Compare_PersonAge(cur,next)==1)
			{

				/*删掉cur*/
				DeleteItemTOlist(plist,cur);
				/*删掉next*/
				DeleteItemTOlist(plist,next);
				/*将next插入cur*/
				TranteItemTOlist( pre1,next);
				if(pre2==cur)
				{
					TranteItemTOlist( next,cur);
				}
				else
				{
					/*将cur插入next*/
					TranteItemTOlist( pre2,cur);
				}
				/*因为cur和next互换位置了,为了人cur继续跟后面的对比,要把cur和next互换回来*/
				/*这里的cur和next是指名字*/
				tmp=cur;
				cur=next;
				next=tmp;
			}
			pre2=next;
			/*cut跟next的下一个比,知道next为空*/
			next=next->next;
		}
		pre1=cur;
		/*换成cut下一个节点来比*/
		cur=cur->next;
	}

}

void printList(struct list* plist)
{
	struct node_t* p=plist->head.next;
	struct person* n;
	while(p!=NULL)
	{
		n=(struct person*)((char*)p-(uint32_t)&(((struct person*)0)->node));
		printf("成员名字:%s,成员年龄:%d\r\n",n->name,n->age);
		p=p->next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		AddItemTOlist(&a_list,&person[i].node);
		i++;
	}

	printf("打印全部节点:\r\n");
	printList(&a_list);
	printf("打印剩余节点:\r\n");
	DeleteItemTOlist(&a_list,&person[2].node);
	printList(&a_list);

	printf("打印排序后的list:\r\n");
	Sortlist(&a_list);
	printList(&a_list);

	while(1)
	{

	}

}
在这段代码中,最重要的思想是这段代码:
c
/*利用struct node_t结构体算出struct person的首地址地址*/
/*利用struct node_t结构体算出struct person的首地址地址*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*利用node算出struct person结构体的首地址*/
	c=(struct person*)((char*)cur-(uint32_t)&(((struct person*)0)->node));
	n=(struct person*)((char*)next-(uint32_t)&(((struct person*)0)->node));
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}
先分析这段代码 &(((struct person*)0)->node),这里我们定义一个 0 地址的 struct person 结构体,接着我们访问这个结构体的 node 成员,然后取出这个结构体的 node 成员的地址,而这个地址就是这个 node 对于 struct person 结构体的偏移地址。得到偏移地址,我们就可以在已有的 struct node_t 结构体成员反推出 struct person 的地址,也就是对应 c=(struct person*)((char*)cur-(uint32_t)&(((struct person*)0)->node)); 这一步。
这里的关键在于:&(((struct person*)0)->node) 这个表达式并不会真的去访问 0 地址(那会导致程序崩溃),它只是在编译期 计算 node 成员在 struct person 结构体中的偏移量。因为结构体成员的地址 = 结构体首地址 + 成员偏移量,当结构体首地址为 0 时,node 成员的地址恰好就等于它的偏移量。所以这个表达式本质上是一个编译期常量 ,等价于 offsetof(struct person, node)。
有了这个偏移量,当我们拿到一个 struct node_t* 指针 cur 时,由于 node 是 struct person 的成员,cur 实际指向的是某个 struct person 结构体内部的 node 成员。那么用 cur 的地址减去这个偏移量,就能反推出它所属的 struct person 结构体的首地址,从而访问到 name、age 等成员。这正是通用链表"通过手机找到同学"的核心原理。
(7)通用链表的三种实现方法:
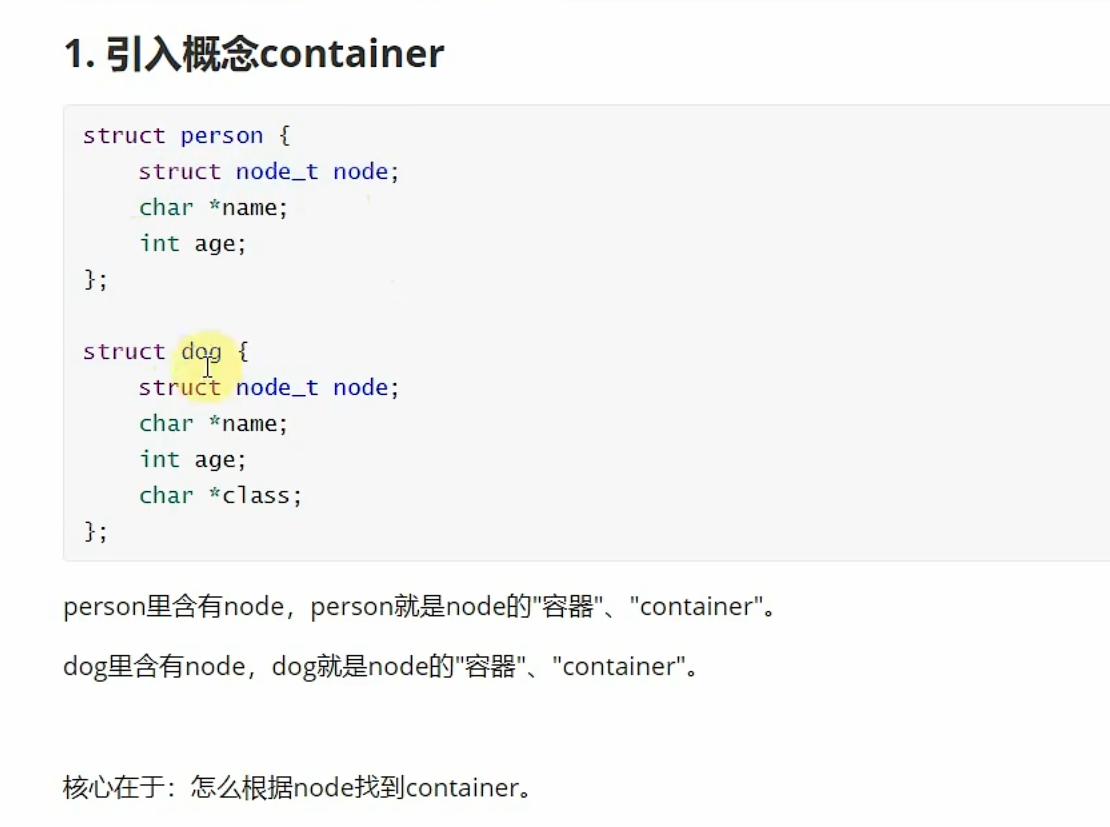
在上小节我们了解到了,利用node来找到下一个person,如上图我们将这个person改成"container",然后我们又利用node是"container"的成员,计算出这个"container"的地址,那还有没有其它方法得到这个"container"的地址呢?有的,下面我来开始介绍
方法一:
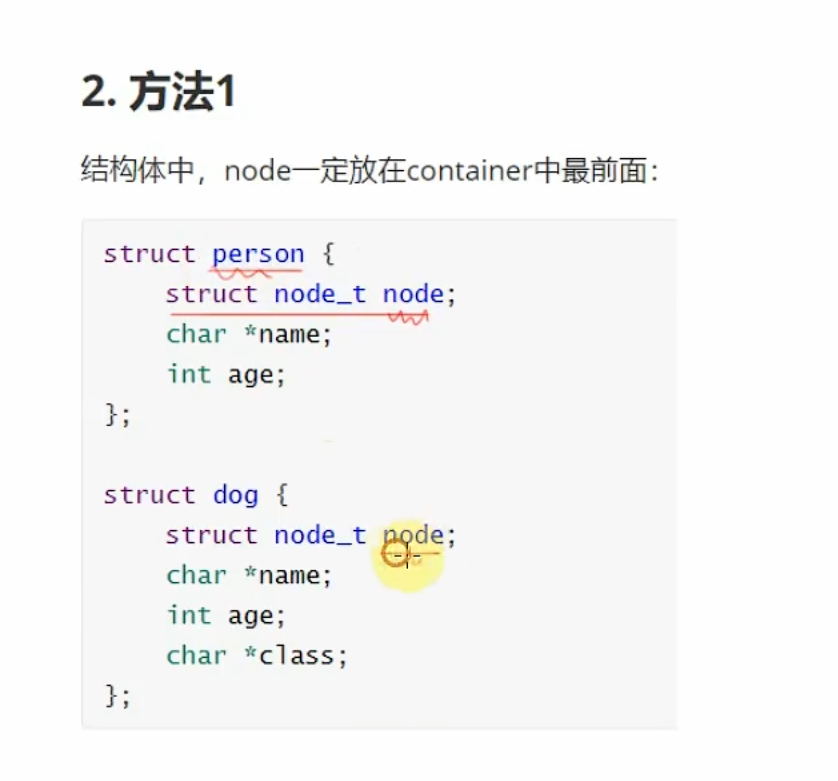
可以看到,只要我们将node放到container的最前面,那么这个node的地址不就是这个container的首地址了吗?这样不用计算,就可以得到container的地址了,因为很简单,而且这个方法几乎很少用到,所有我就不写代码了
方法二:
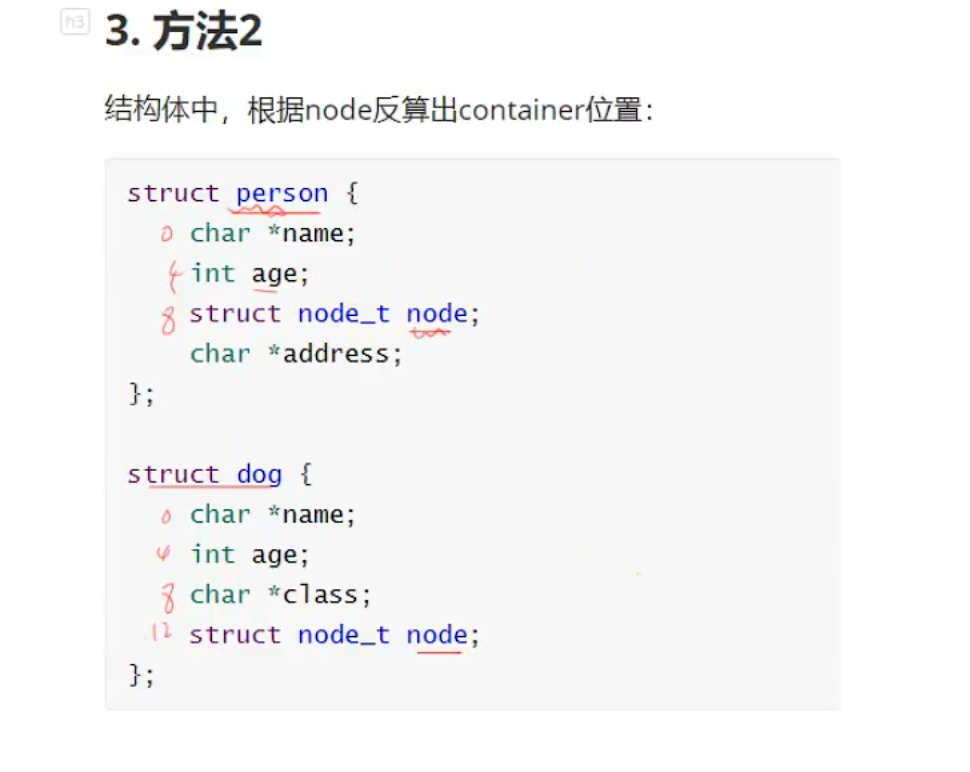
这个方法就是我们上小节用到的方法,就是计算node在container的偏移地址来反推出container的地址,我们还能再改进一下这个代码,如下:
c
/*pre是type结构体某个成员的指针("手机"),menber是type结构体pre成员的偏移地址*/
#define container_of(pre,type,menber)	(type*)((char*)pre-(uint32_t)&(((type*)0)->menber))

/*利用struct node_t结构体算出struct person的首地址地址*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*利用node算出struct person结构体的首地址*/
	c=container_of(cur,struct person,node);
	n=container_of(next,struct person,node);
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}

void printList(struct list* plist)
{
	struct node_t* p=plist->head.next;
	struct person* n;
	while(p!=NULL)
	{
		n=container_of(p,struct person,node);
		printf("成员名字:%s,成员年龄:%d\r\n",n->name,n->age);
		p=p->next;
	}
}
这种方法是Linux和RT_Thread使用的
方法三(重点):
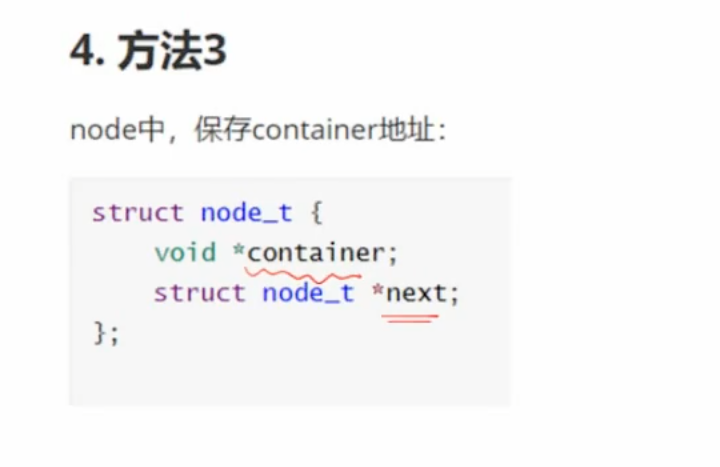
方法三比方法二更简单。如上图所示,我们只需在struct node_t中添加一个void 类型的container指针(void指针可以指向任意类型的地址),然后用这个container指针直接指向struct person结构体,这样就不需要再计算struct person结构体的地址了,代码如下:
c
struct node_t
{
	void* container;
	struct node_t* next;
};

/*利用struct node_t结构体算出struct person的首地址地址*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*利用node算出struct person结构体的首地址*/
	c=cur->container;
	n=next->container;
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}

void printList(struct list* plist)
{
	struct node_t* p=plist->head.next;
	struct person* n;
	while(p!=NULL)
	{
		n=p->container;
		printf("成员名字:%s,成员年龄:%d\r\n",n->name,n->age);
		p=p->next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		person[i].node.container=&person[i];
		AddItemTOlist(&a_list,&person[i].node);
		i++;
	}

	printf("打印全部节点:\r\n");
	printList(&a_list);
	printf("打印剩余节点:\r\n");
	DeleteItemTOlist(&a_list,&person[2].node);
	printList(&a_list);

	printf("打印排序后的list:\r\n");
	Sortlist(&a_list);
	printList(&a_list);

	while(1)
	{

	}

}personi.node.container=&personi;这段代码可以类比于:我的"手机"(node)里面保存了我的信息(指向person的container指针),这样我随时可以通过手机找到我本人。(这就是我们FreeRTOS用到的方法)
(8)双向链表:
之前我们学习的都是单向链表,下面我们来开始学习双向链表:
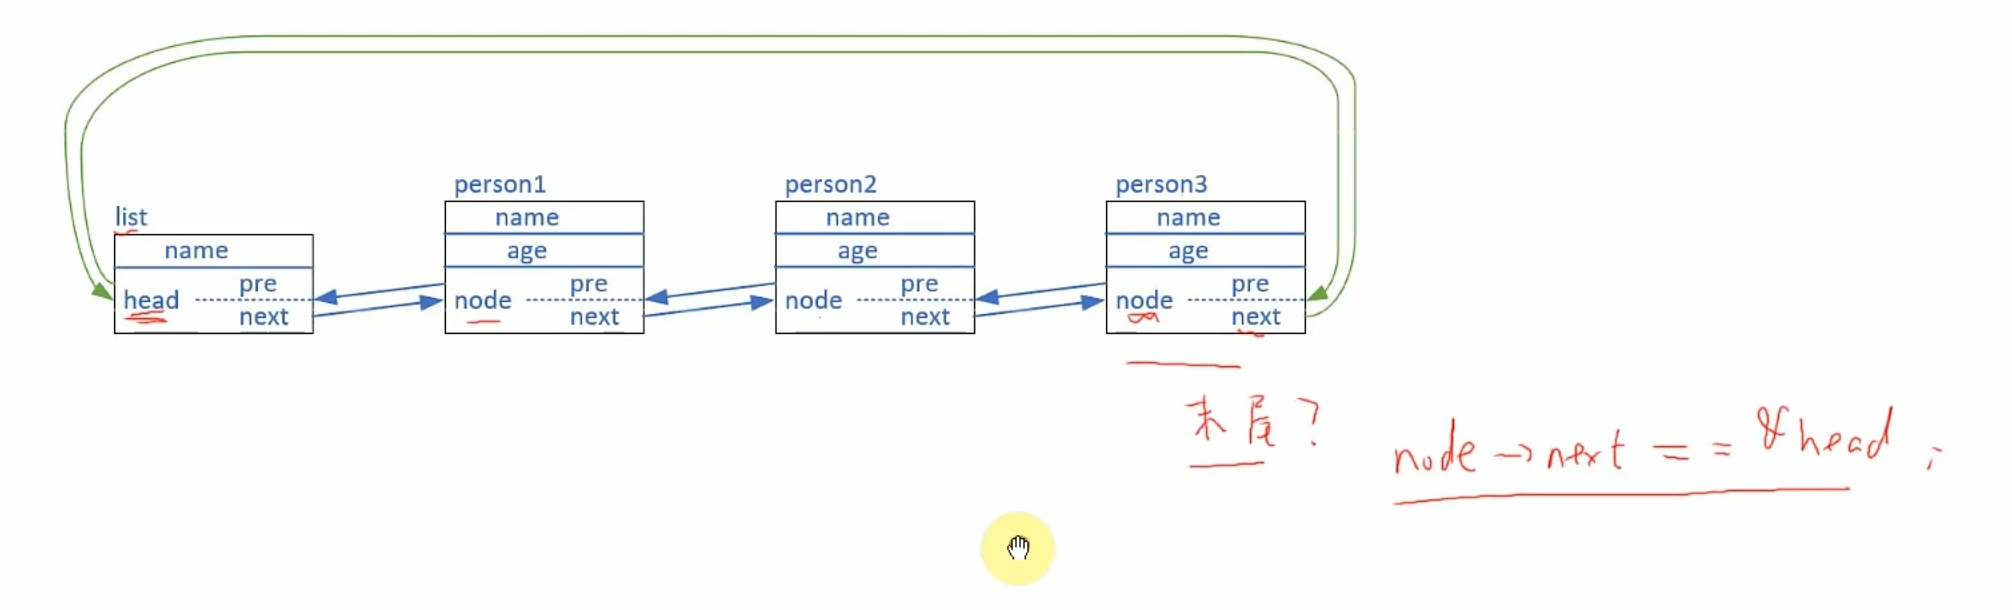
可以看到在之前的学习种,单向链表只能指向下一个同学,但是双向链表可以实现同时指向上一个同学和下一个同学,下面我们来开始改造代码:
1.初始化代码改造
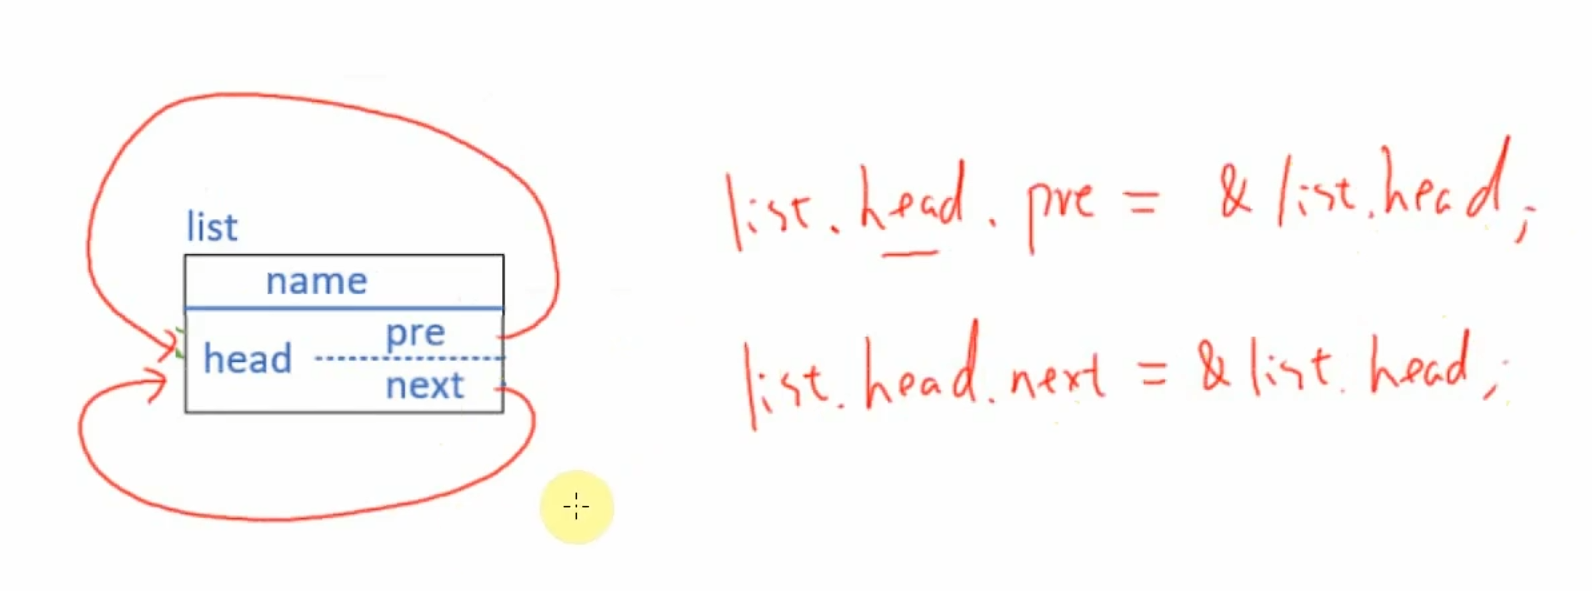
如上图,因为之前的链表是单向的(即空链表就表示后面没有节点),但是双向链表不同,最后节点的next可以指向链表头,所以在初始化双向链表时,我们可以让链表头指向自己,这样链表就形成了一个环形结构。
c
/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->head.pre=&pList->head;
	pList->head.next=&pList->head;
}
2.链表增加节点代码改造:
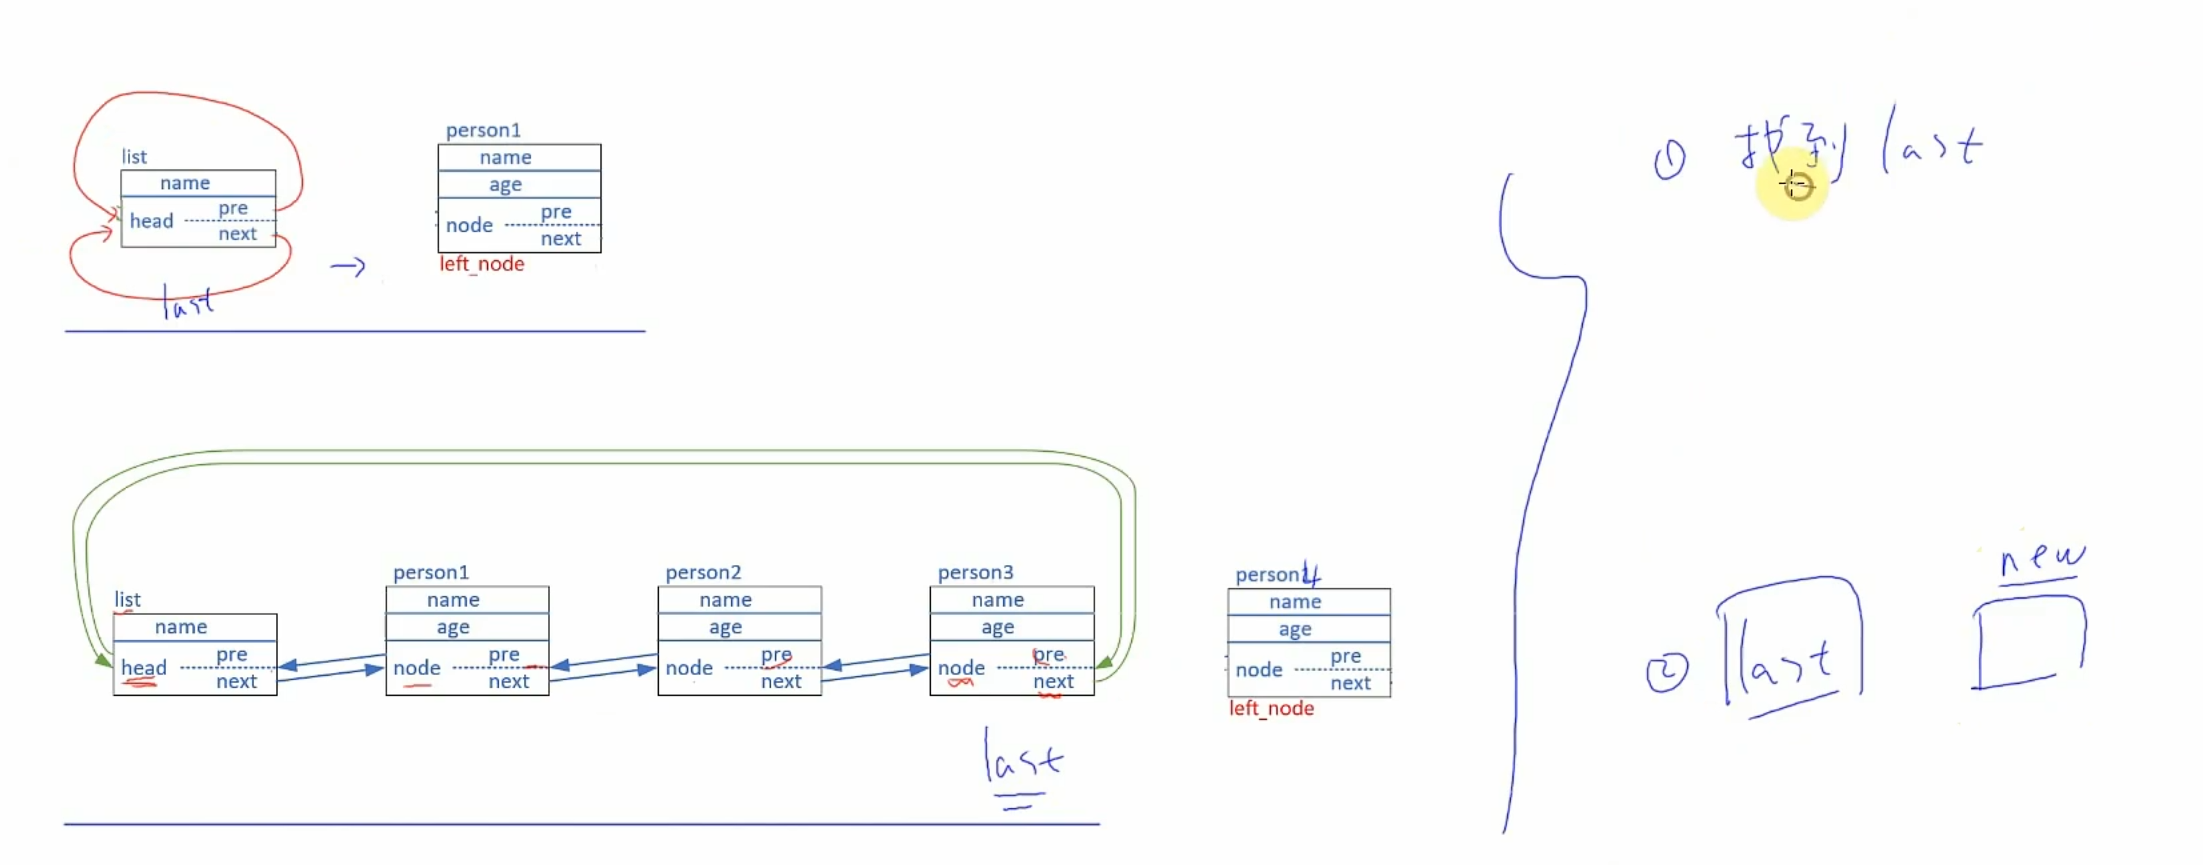
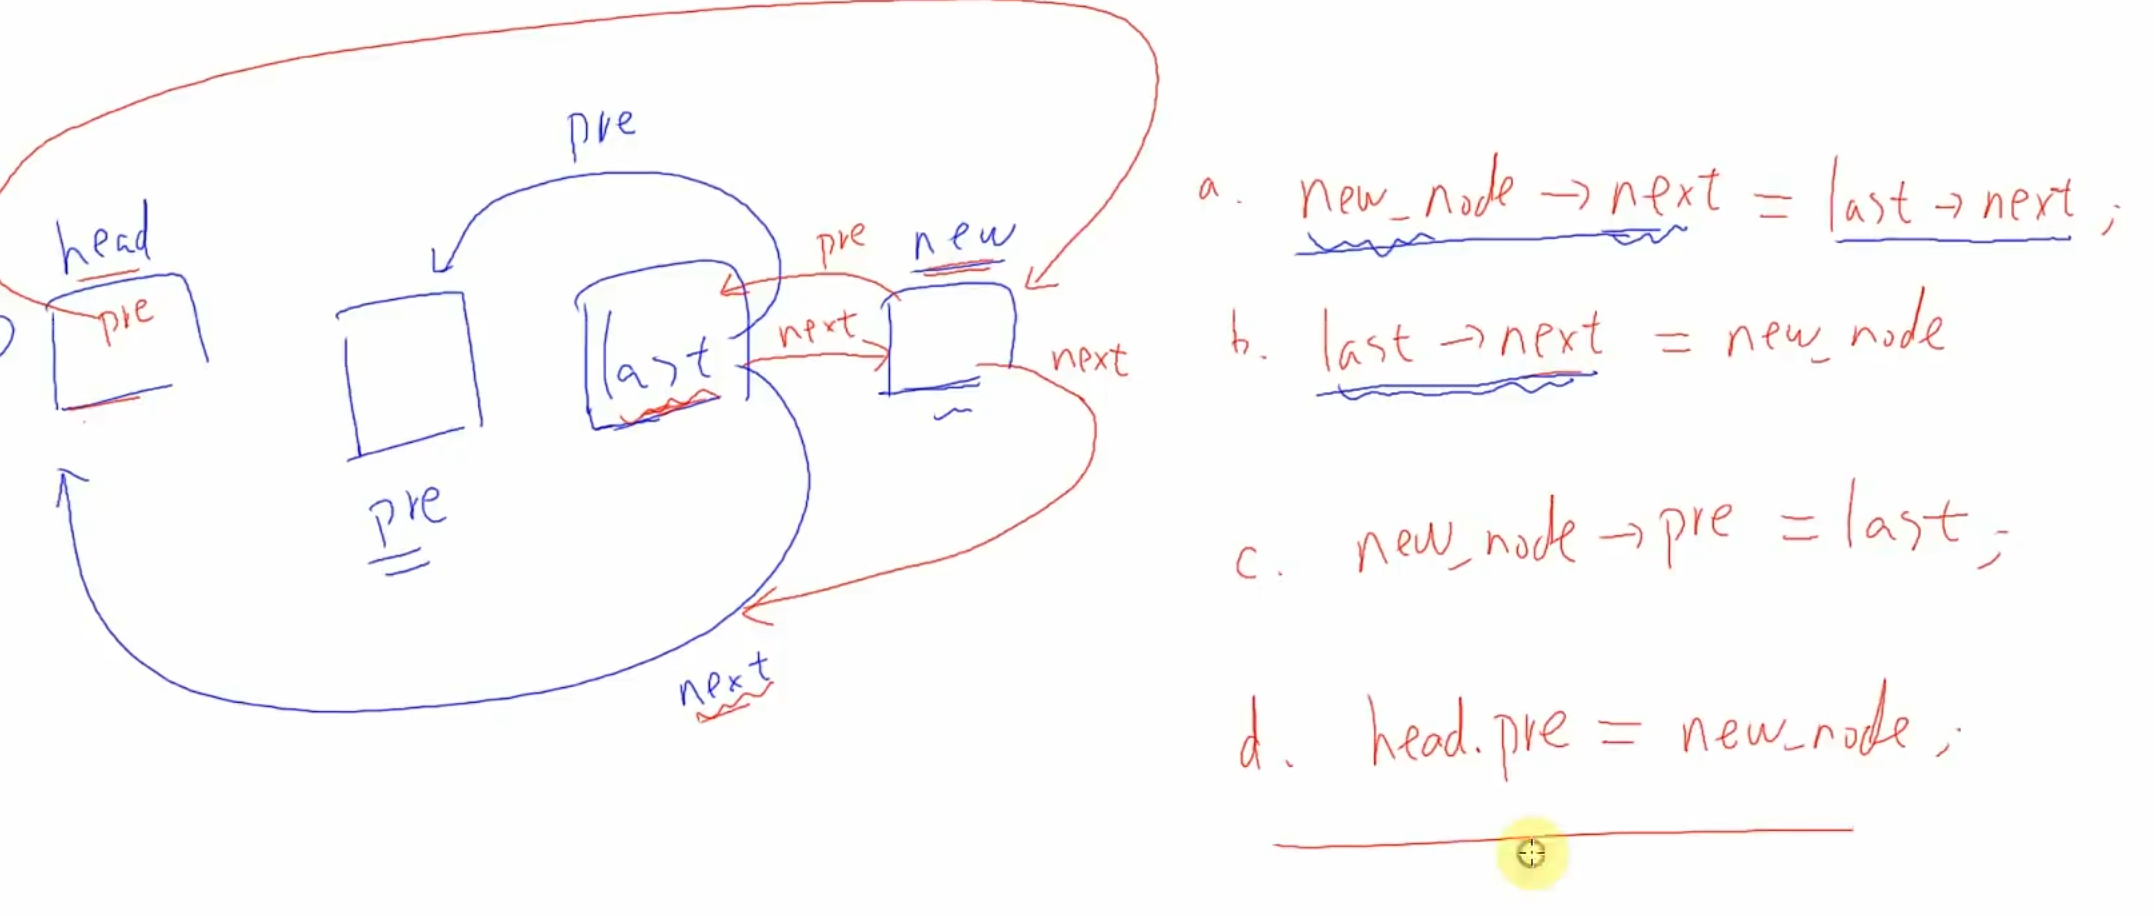
因为双向链表是一个环形结构,所以链表头的pre会指向最后一个节点,而最后一个节点的next会指向链表头。因此,当我们增加一个节点时,只需要让最后一个节点的next指向新节点,新节点的next指向链表头、pre指向最后一个节点,最后再让链表头的pre指向新节点即可。
c
/*list添加节点函数*/
void AddItemTOlist(struct list* plist,struct node_t* New_node)
{
	/*链表最后一个节点*/
	struct node_t* Last=plist->head.pre;

	/*增加新的节点*/
	New_node->next=&plist->head;
	New_node->pre=Last;
	Last->next=New_node;
	plist->head.pre=New_node;
}
3.链表删除改造:
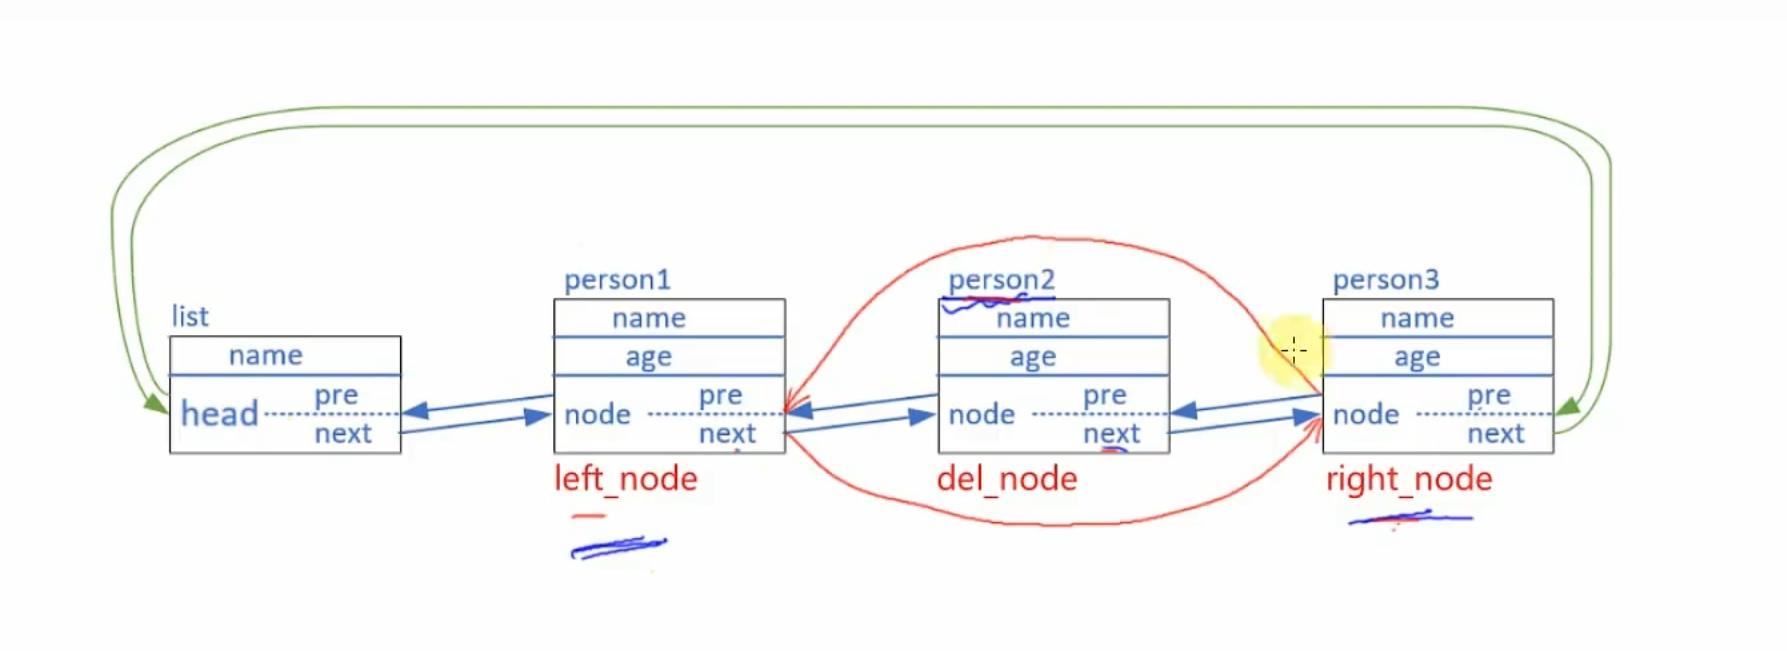
这很简单,先定义我们要删除的节点左右两边节点,然后让这两边节点都指向对方就行了
c
/*list删除节点函数*/
void DeleteItemTOlist(struct list* plist,struct node_t* Delete_node)
{
	/*定义要删除节点的左右两边节点*/
	struct node_t* left=Delete_node->pre;
	struct node_t* right=Delete_node->next;

	left->next=right;
	right->pre=left;
}
4.链表排序改造:
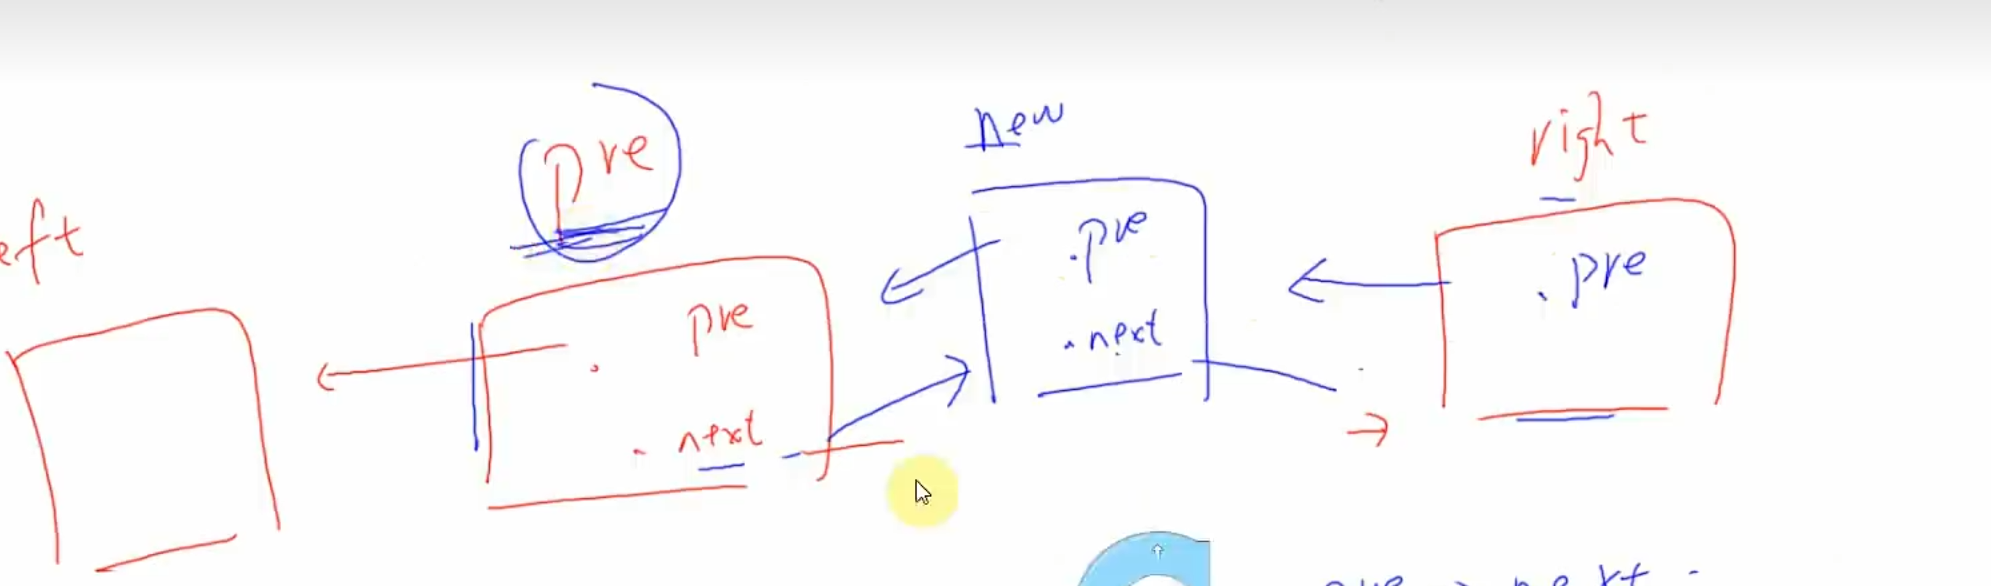
链表排序改造我们只需要改造插入新节点函数就行了,这个跟上面的删除节点相反,让插入新节点的左右两边节点指向新的节点
c
/*插入一个新节点*/
void TranteItemTOlist(struct node_t* pre,struct node_t* new_preson)
{
	/*定义要插入位置的上一个节点指向下一个的节点,即新位置的右边节点*/
	struct node_t* right=pre->next;

	pre->next=new_preson;
	new_preson->next=right;
	new_preson->pre=pre;
	right->pre=new_preson;

}

/*container会指向定义有container成员的结构体,即手机会给出持有手机者的信息*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*直接访问node的container成员就可以知道struct person结构体的地址*/
	c=cur->container;
	n=next->container;
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}

/*给list排序函数*/
void Sortlist(struct list* plist)
{

	struct node_t* pre1=&plist->head;
	struct node_t* cur=pre1->next;
	struct node_t* pre2;
	struct node_t* next;
	struct node_t* tmp;

	/*最后一个节点next会指向链表头*/
	while(cur->next!=&plist->head)
	{
		pre2=cur;
		/*确保next是在新的pre的下一个节点*/
		next=cur->next;
		/*最后一个节点next会指向链表头*/
		while(next!=&plist->head)
		{
			/*如果存在前一个节点和后一个节点就进入该循环*/
			if(Compare_PersonAge(cur,next)==1)
			{

				/*删掉cur*/
				DeleteItemTOlist(plist,cur);
				/*删掉next*/
				DeleteItemTOlist(plist,next);
				/*将next插入cur*/
				TranteItemTOlist( pre1,next);
				if(pre2==cur)
				{
					TranteItemTOlist( next,cur);
				}
				else
				{
					/*将cur插入next*/
					TranteItemTOlist( pre2,cur);
				}
				/*因为cur和next互换位置了,为了人cur继续跟后面的对比,要把cur和next互换回来*/
				/*这里的cur和next是指名字*/
				tmp=cur;
				cur=next;
				next=tmp;
			}
			pre2=next;
			/*cut跟next的下一个比,知道next为空*/
			next=next->next;
		}
		pre1=cur;
		/*换成cut下一个节点来比*/
		cur=cur->next;
	}

}
这里需要注意的是,判断是否是最后一个节点的条件变了:之前单向链表中,NULL表示后面没有新的节点了;但是在双向链表中,指向链表头才表示最后一个节点(即while(cur->next!=&plist->head))
最后就是主程序代码:
c
struct node_t
{
	void* container;
	struct node_t* next;
	struct node_t* pre;
};

struct person
{
	char *name;
	uint8_t age;
	struct node_t node;
};


struct list
{
	char *class;
	struct node_t head;
};

struct list a_list;
struct person person[]={
	{"p1",8,{NULL,NULL,NULL}},
	{"p2",12,{NULL,NULL,NULL}},
	{"p3",38,{NULL,NULL,NULL}},
	{"p4",4,{NULL,NULL,NULL}},
	{"p5",7,{NULL,NULL,NULL}},
	{NULL,0,{NULL,NULL,NULL}},
};

/*初始化list*/
void Initlist(struct list* pList,char* name)
{
	pList->class=name;
	pList->head.pre=&pList->head;
	pList->head.next=&pList->head;
}

/*list添加节点函数*/
void AddItemTOlist(struct list* plist,struct node_t* New_node)
{
	/*链表最后一个节点*/
	struct node_t* Last=plist->head.pre;

	/*增加新的节点*/
	New_node->next=&plist->head;
	New_node->pre=Last;
	Last->next=New_node;
	plist->head.pre=New_node;
}

/*list删除节点函数*/
void DeleteItemTOlist(struct list* plist,struct node_t* Delete_node)
{
	/*定义要删除节点的左右两边节点*/
	struct node_t* left=Delete_node->pre;
	struct node_t* right=Delete_node->next;

	left->next=right;
	right->pre=left;
}

/*插入一个新节点*/
void TranteItemTOlist(struct node_t* pre,struct node_t* new_preson)
{
	/*定义要插入位置的上一个节点指向下一个的节点,即新位置的右边节点*/
	struct node_t* right=pre->next;

	pre->next=new_preson;
	new_preson->next=right;
	new_preson->pre=pre;
	right->pre=new_preson;

}

/*container会指向定义有container成员的结构体,即手机会给出持有手机者的信息*/
uint8_t Compare_PersonAge(struct node_t* cur,struct node_t* next)
{
	struct person*c;
	struct person*n;
	/*直接访问node的container成员就可以知道struct person结构体的地址*/
	c=cur->container;
	n=next->container;
	if(c->age > n->age)
	{
		return 1;
	}
	else
	{
		return 0;
	}
}

/*给list排序函数*/
void Sortlist(struct list* plist)
{

	struct node_t* pre1=&plist->head;
	struct node_t* cur=pre1->next;
	struct node_t* pre2;
	struct node_t* next;
	struct node_t* tmp;

	/*最后一个节点next会指向链表头*/
	while(cur->next!=&plist->head)
	{
		pre2=cur;
		/*确保next是在新的pre的下一个节点*/
		next=cur->next;
		/*最后一个节点next会指向链表头*/
		while(next!=&plist->head)
		{
			/*如果存在前一个节点和后一个节点就进入该循环*/
			if(Compare_PersonAge(cur,next)==1)
			{

				/*删掉cur*/
				DeleteItemTOlist(plist,cur);
				/*删掉next*/
				DeleteItemTOlist(plist,next);
				/*将next插入cur*/
				TranteItemTOlist( pre1,next);
				if(pre2==cur)
				{
					TranteItemTOlist( next,cur);
				}
				else
				{
					/*将cur插入next*/
					TranteItemTOlist( pre2,cur);
				}
				/*因为cur和next互换位置了,为了人cur继续跟后面的对比,要把cur和next互换回来*/
				/*这里的cur和next是指名字*/
				tmp=cur;
				cur=next;
				next=tmp;
			}
			pre2=next;
			/*cut跟next的下一个比,知道next为空*/
			next=next->next;
		}
		pre1=cur;
		/*换成cut下一个节点来比*/
		cur=cur->next;
	}

}

void printList(struct list* plist)
{
	struct node_t* p=plist->head.next;
	struct person* n;
	/*最后一个节点next会指向链表头*/
	while(p!=&plist->head)
	{
		n=p->container;
		printf("成员名字:%s,成员年龄:%d\r\n",n->name,n->age);
		p=p->next;
	}
}

int main(void)
{
	uint8_t i=0;
	Systick_Init();
	USARTConfig_Init();

	printf("链表实验\r\n");

	Initlist(&a_list,"class_a");

	while(person[i].name!=NULL)
	{
		person[i].node.container=&person[i];
		AddItemTOlist(&a_list,&person[i].node);
		i++;
	}

	printf("打印全部节点:\r\n");
	printList(&a_list);

	printf("打印删除后剩余节点:\r\n");
	DeleteItemTOlist(&a_list,&person[2].node);
	printList(&a_list);

	printf("打印排序后的list:\r\n");
	Sortlist(&a_list);
	printList(&a_list);

	while(1)
	{

	}

}3.分析FreeRTOS链表源码(重点):
前言:有了之前学习链表的基础,我们分析这个FreeRTOS链表源码相信不会难,下面我们来开始吧
(1)分析结构体:
首先分析链表的结构体
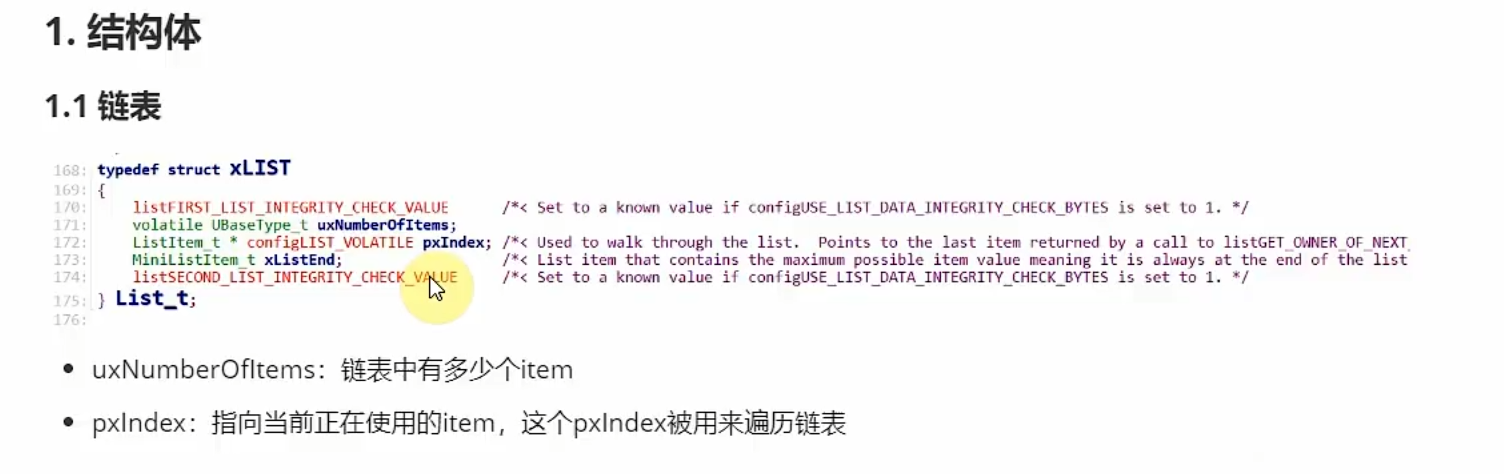
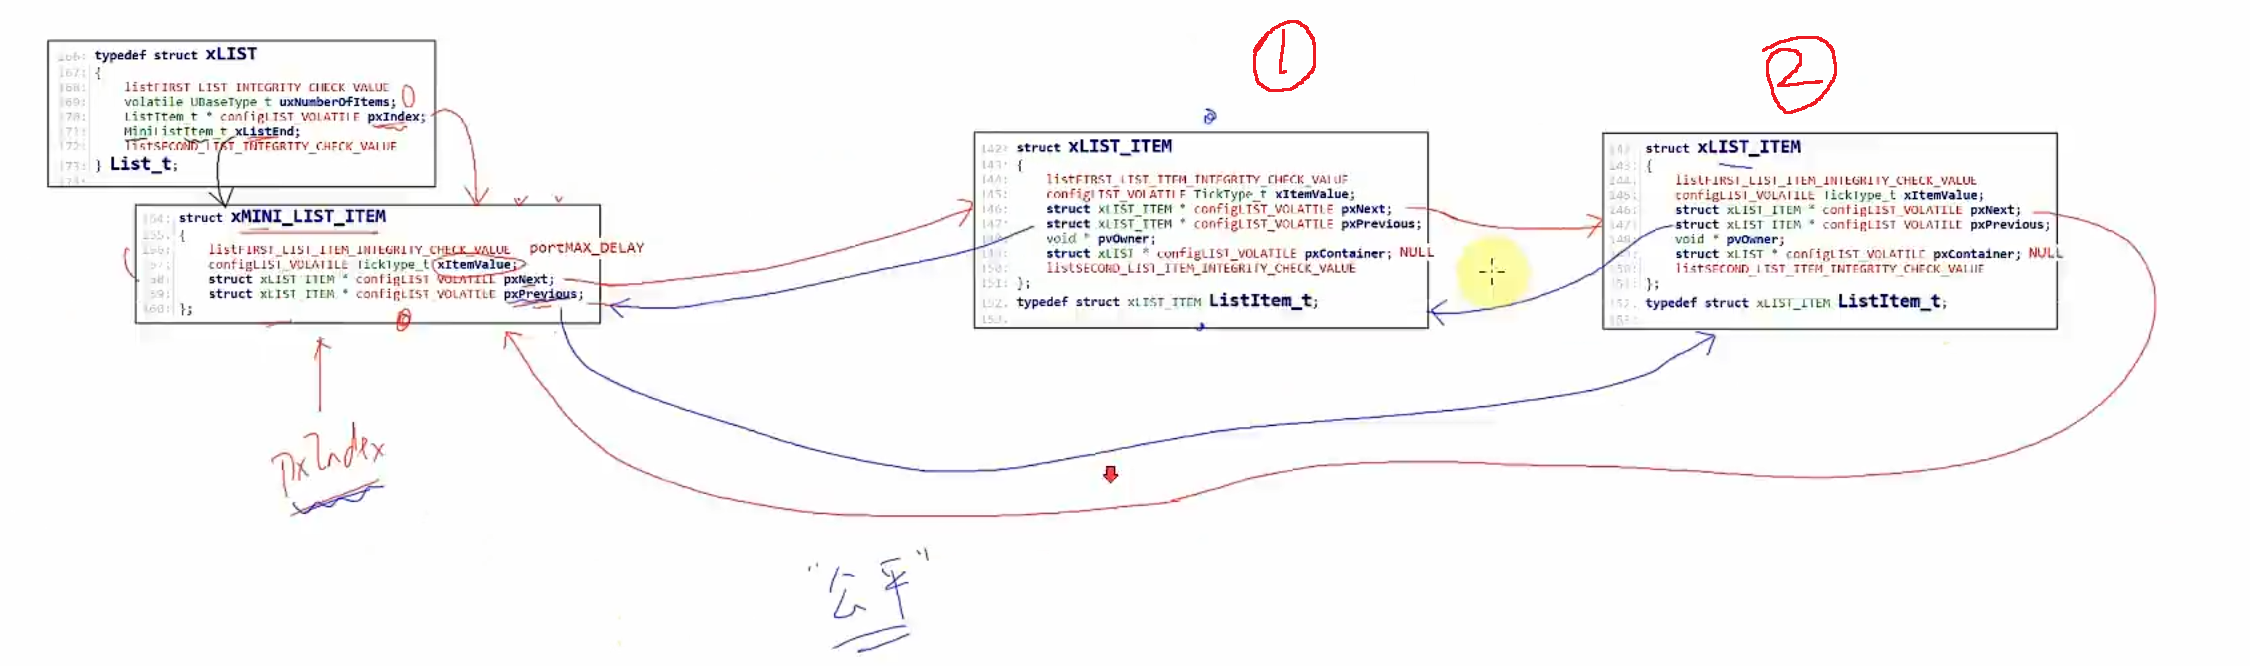
可以看到,对比之前的链表,这个链表结构体多了两个成员 uxNumberOfItems 和 ListItem_t * pxIndex
ListItem_t * pxIndex:记录轮转遍历的当前位置。它的工作方式是:每次轮转调度时从它出发沿 pxNext 走一格,取到新位置后自己也跟过去。
我来介绍一下这个成员:xListEnd,这个成员的结构体就是我们之前学的链表头 Head,其结构体如下:
c
/* mini节点结构体定义,作为双向链表的结尾
   因为双向链表是首尾相连的,头即是尾,尾即是头 */
struct xMINI_LIST_ITEM
{
	TickType_t xItemValue;                      /* 辅助值,用于帮助节点做升序排列 */
	struct xLIST_ITEM *  pxNext;                /* 指向链表下一个节点 */
	struct xLIST_ITEM *  pxPrevious;            /* 指向链表前一个节点 */
};
typedef struct xMINI_LIST_ITEM MiniListItem_t; /* 最小节点数据类型重定义 */我们可以把这个xListEnd更具象地比作环形调度队列里的「固定哨兵岗亭」:它是整个双向环形链表的 "永久锚点",本身不承载任何有效任务,就像一个立在环形跑道起点、永远不动的空岗亭,核心作用是把链表首尾 "焊" 成闭环,同时给遍历轮转提供明确的起止标记。
结合结构体和pxIndex轮转的具象解释
- 它是链表永不散架的 "锚"
哪怕链表里一个有效任务节点都没有,这个 "岗亭" 也会让自己的pxNext和pxPrevious都指向自身,维持住环形结构,不会出现空指针、链表 "解体" 的情况。当有任务节点插入 / 删除时,直接在它和相邻节点之间操作即可,不用额外判断 "链表是不是空的""是不是首尾节点" 这类特殊情况。 - 它是首尾衔接的 "环形接口"
它的pxNext永远牵着链表的第一个有效任务节点 ,pxPrevious永远牵着链表的最后一个有效任务节点。正因为有了它,普通的双向链表才真正变成 "首尾相连的环"------ 第一个节点的前驱是它,最后一个节点的后继也是它,所有有效节点围成的环,两端都拴在这个稻草人上。 - 配合
pxIndex轮转:它是每轮遍历的 "起点 + 终点裁判"
你可以把pxIndex想象成一个沿圈巡逻的调度员 :- 初始状态下,调度员就站在这个哨兵岗亭(稻草人)旁边待命;
- 每次触发轮转调度,调度员就从当前位置顺着
pxNext往前迈一步,走到下一个节点; - 如果走到有效任务节点就执行调度,同时
pxIndex自己也移动到这个节点 ------ 相当于调度员停在了这里; - 当调度员走完整整一圈,再次走回这个哨兵岗亭时,就说明这一轮所有任务都遍历过一遍了,完成了一次完整的轮询。
- 它的
xItemValue是 "免插队 buff"
这个稻草人节点的xItemValue通常会被设为系统 Tick 的最大值(比如portMAX_DELAY)。因为链表按升序排列,所以它永远会排在链表的最末尾,不会有任何有效任务节点插到它的后方,保证环形结构的秩序永远不会乱。
下面来分析ITEM(节点)结构体
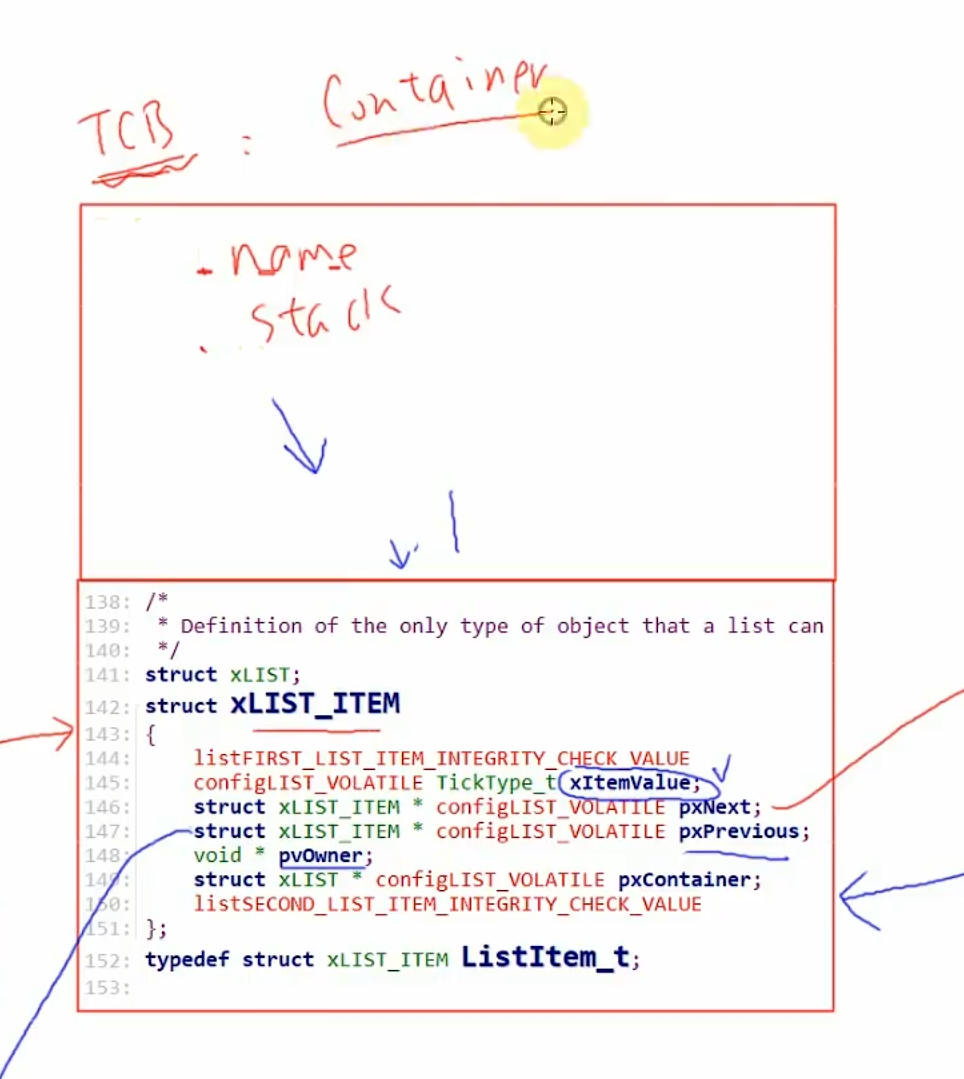
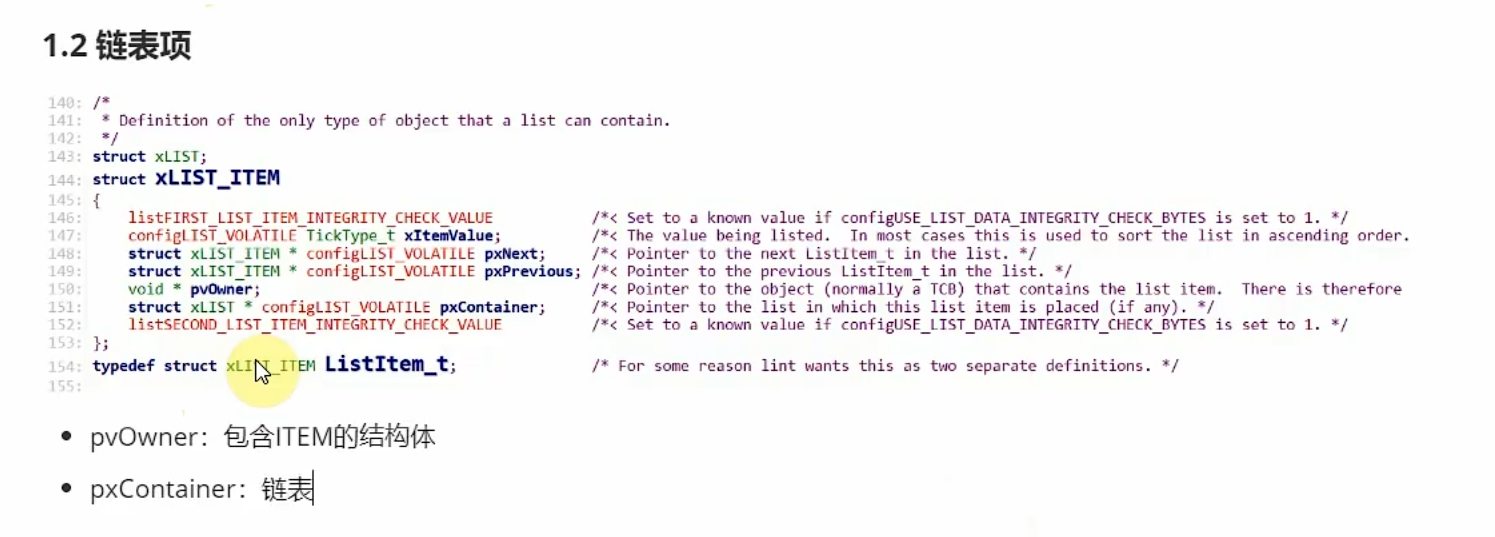
可以看到,对比 MINI_ITEM,ITEM 多了两个成员:pvOwner 和 pvContainer。这里需要注意:在之前的学习中,container 指向的是包含有 node 成员的结构体(即 struct person),但在这里 pvContainer 指向的是链表,表示这个节点属于哪个链表;而 pvOwner 才是指向 TCB 的(TCB 就是描述任务的信息)。
(2)分析链表函数内部:
1.链表的初始化:
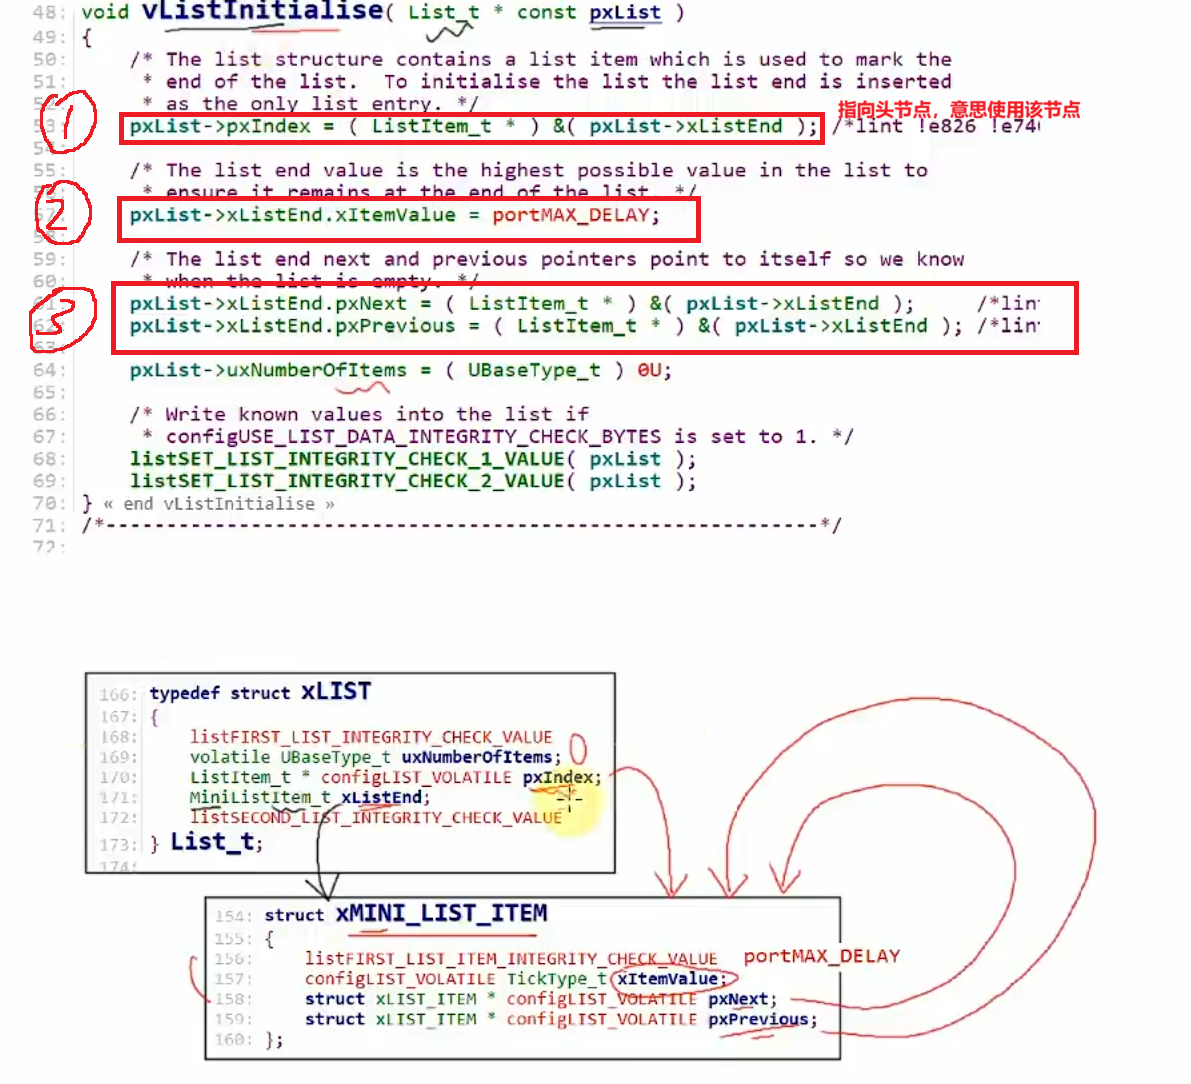
在上小节我们知道 pxIndex 表示调度员,所以:
红框 1:遍历还没开始,调度员就站在这个哨兵岗亭(稻草人)旁边待命
红框 2:跟我们之前的分析一样,在初始化的时候为了确保该节点是最后节点,所以 xItemValue(辅助值)要设置成最大值
红框 3:跟我们之前学习的初始化链表一样,链表头指向自己,所以头节点的 next 和 pre 都指向自己。
2.节点的初始化:
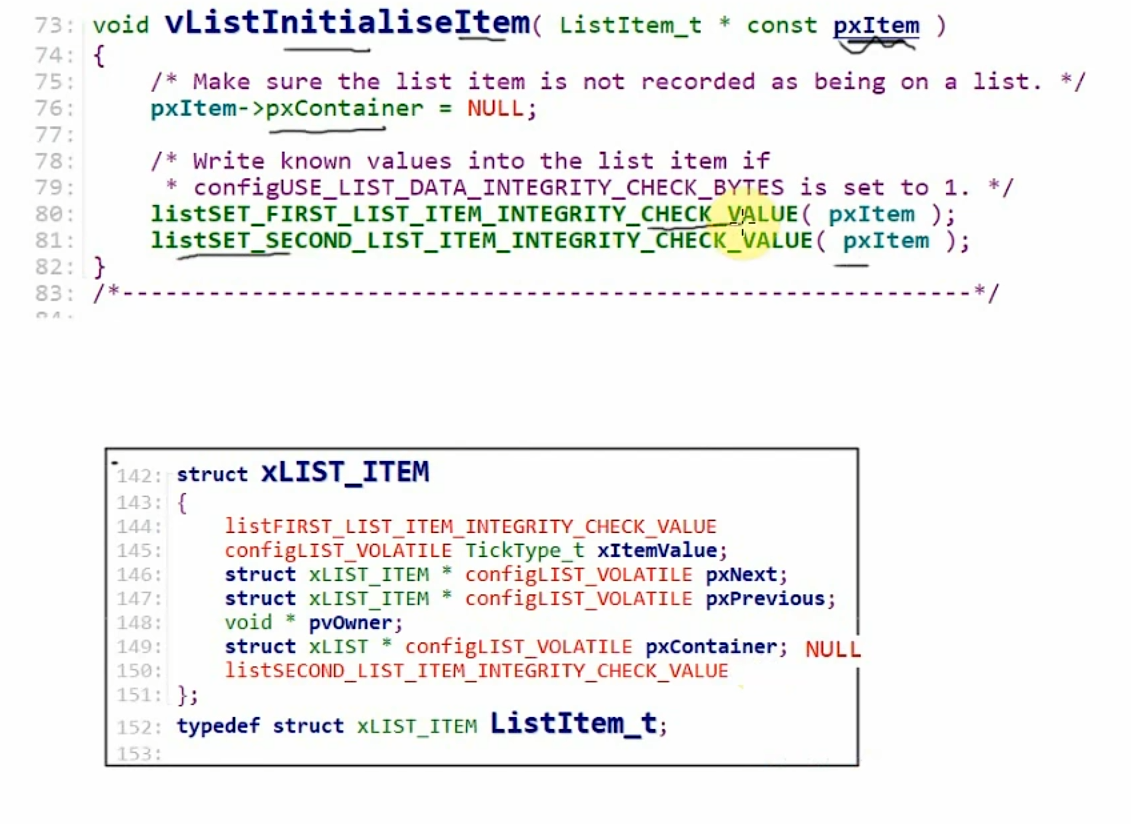
节点初始化就很简单了,直接表示该节点不属于任何链表就行了
3.链表加入新节点:
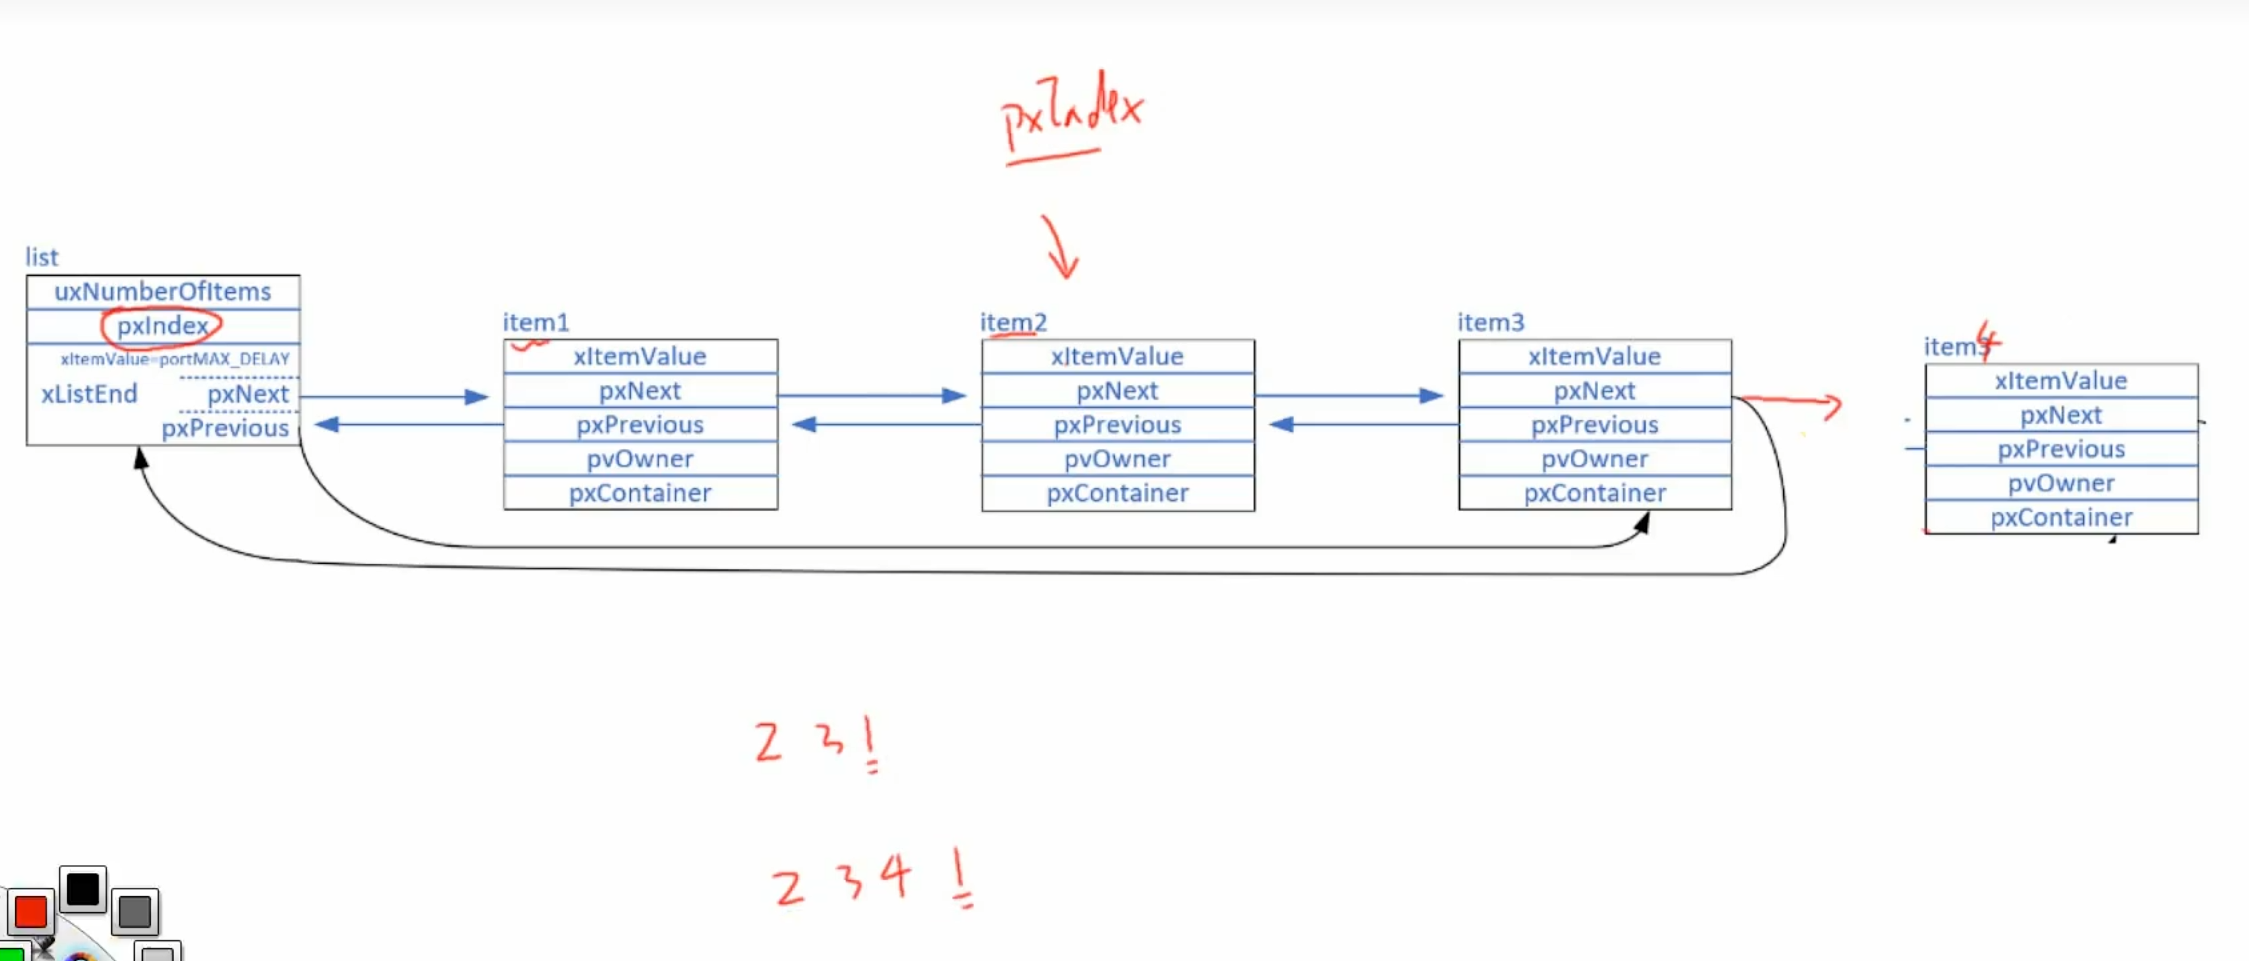
在之前的链表中,我们是在链表尾加入新的节点,如果在这实行同样的操作会怎么样呢?如上图:
可以看到,假设pxIndex现在指向节点2,如果我们也在末尾加入新的节点,那么本来pxIndex指完节点3就指向了节点1,因为新节点4的加入,只能先指向节点4再指向节点1,这对于节点1是不公平的,所以我们换在别的地方加入这个新节点:
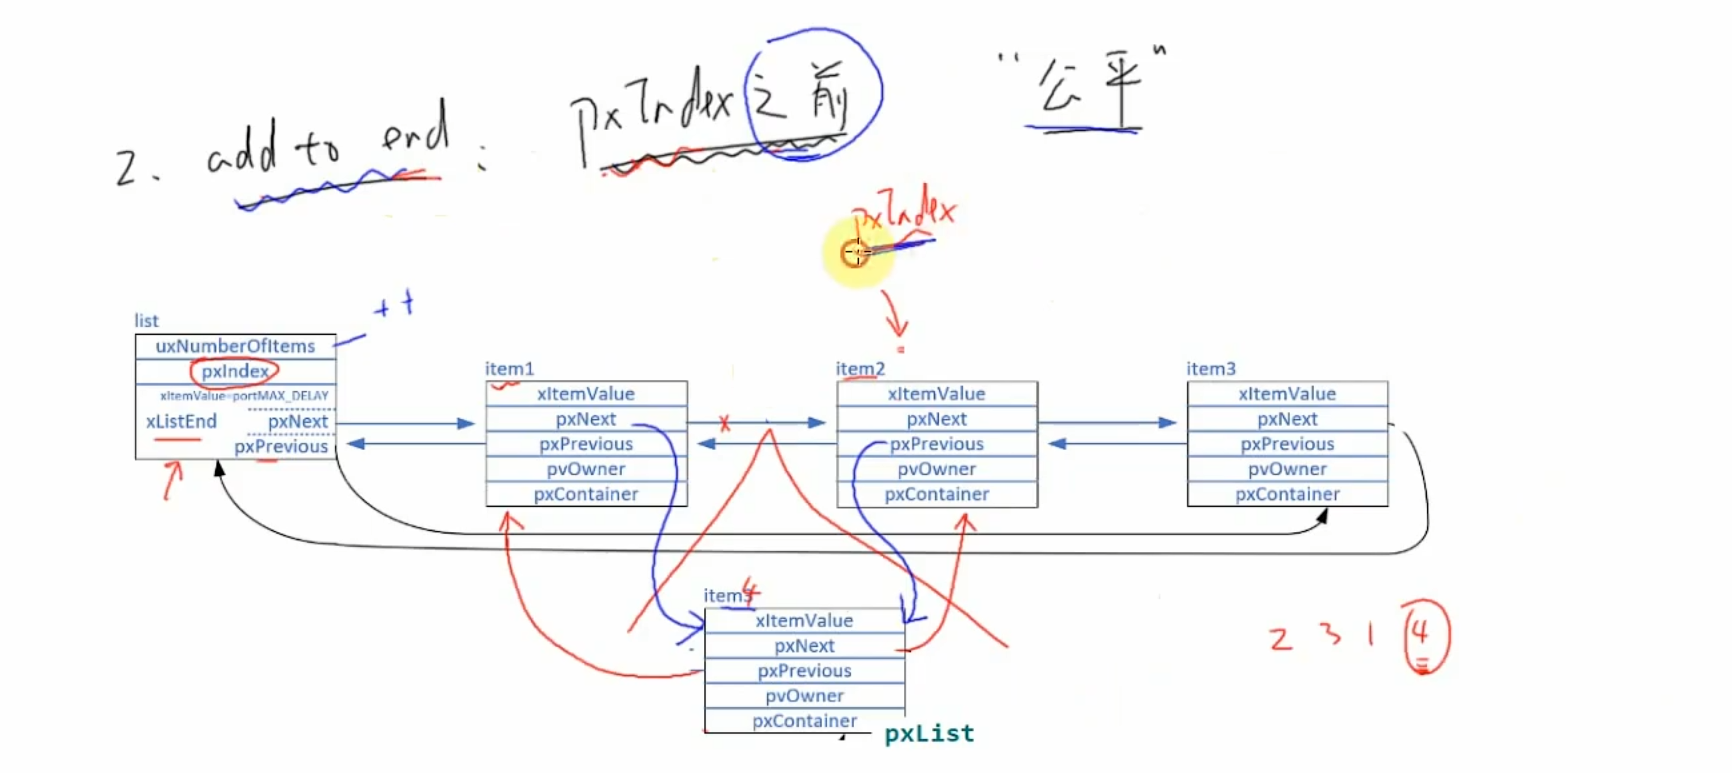
可以看到为了实行在节点1后面加入节点4,我们应该在pxIndex前面加入节点4,也就是在pxIndex所指向的节点前面加入新节点,代码内部如下:
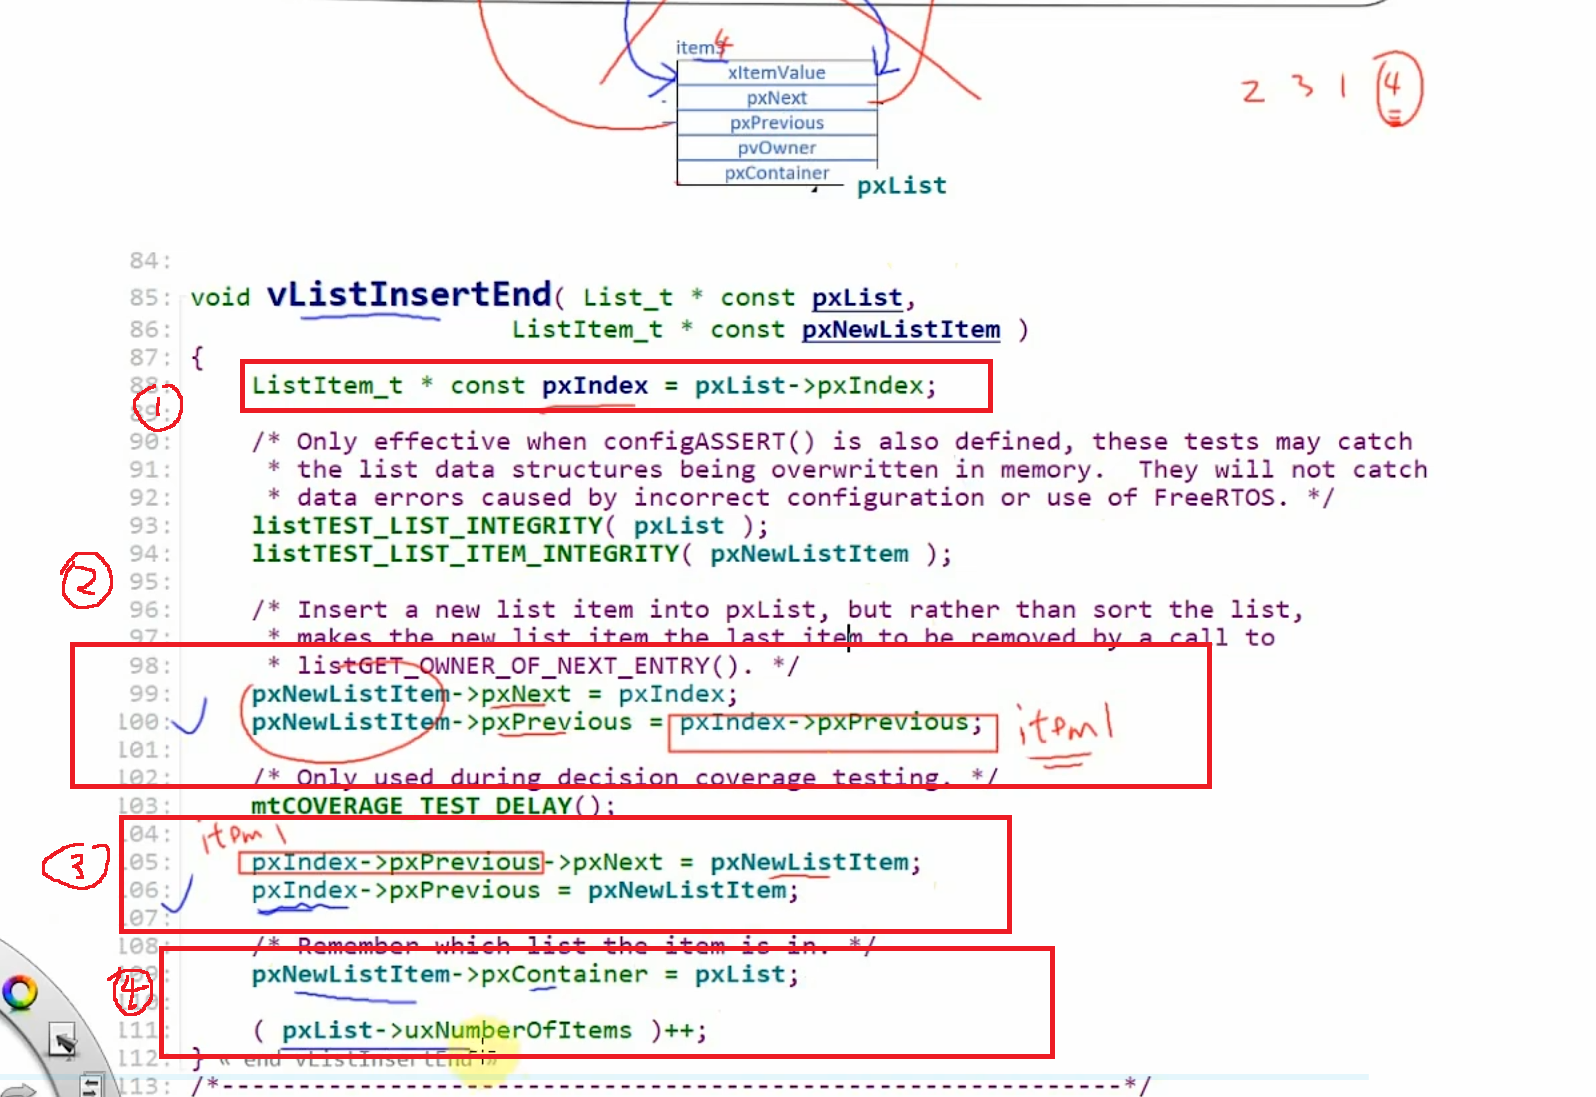
红框 1:把 pxList->pxIndex 当前指向的节点(节点 2)读到局部变量 pxIndex 里
红框 2:让新节点 pxNewListItem 的 next 指向 pxIndex,新节点 pxNewListItem 的 pre 指向 pxIndex 的 pre(即节点 1)。
红框 3:让 pxIndex 的上一个节点(节点 1)的 next 指向新节点,让 pxIndex(节点 2)的 pre 指向新节点。
红框 4:让新节点加入到该 pxList 链表,然后让链表 uxNumberOfItems++,表示节点数量多一个。
所以在pxIndex的前面加入新的节点才能保证"公平",这个公平就是指轮完全部节点才轮到你这个新节点,我们可以再分析如何在空链表加入一个新节点:
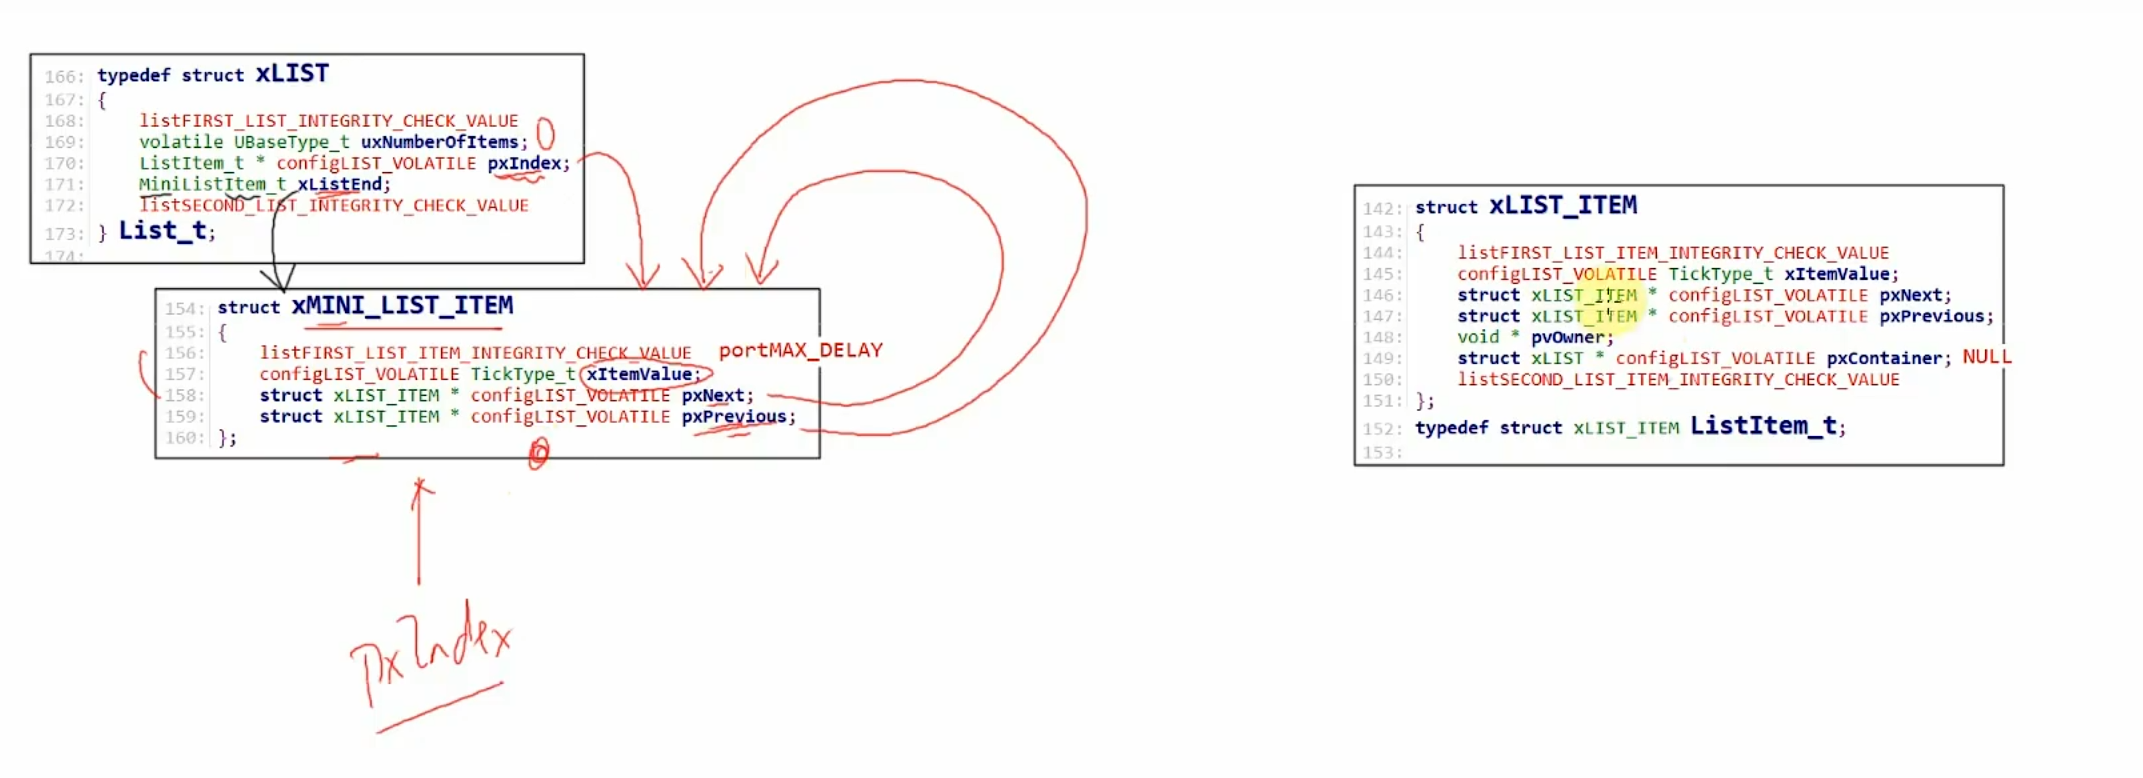
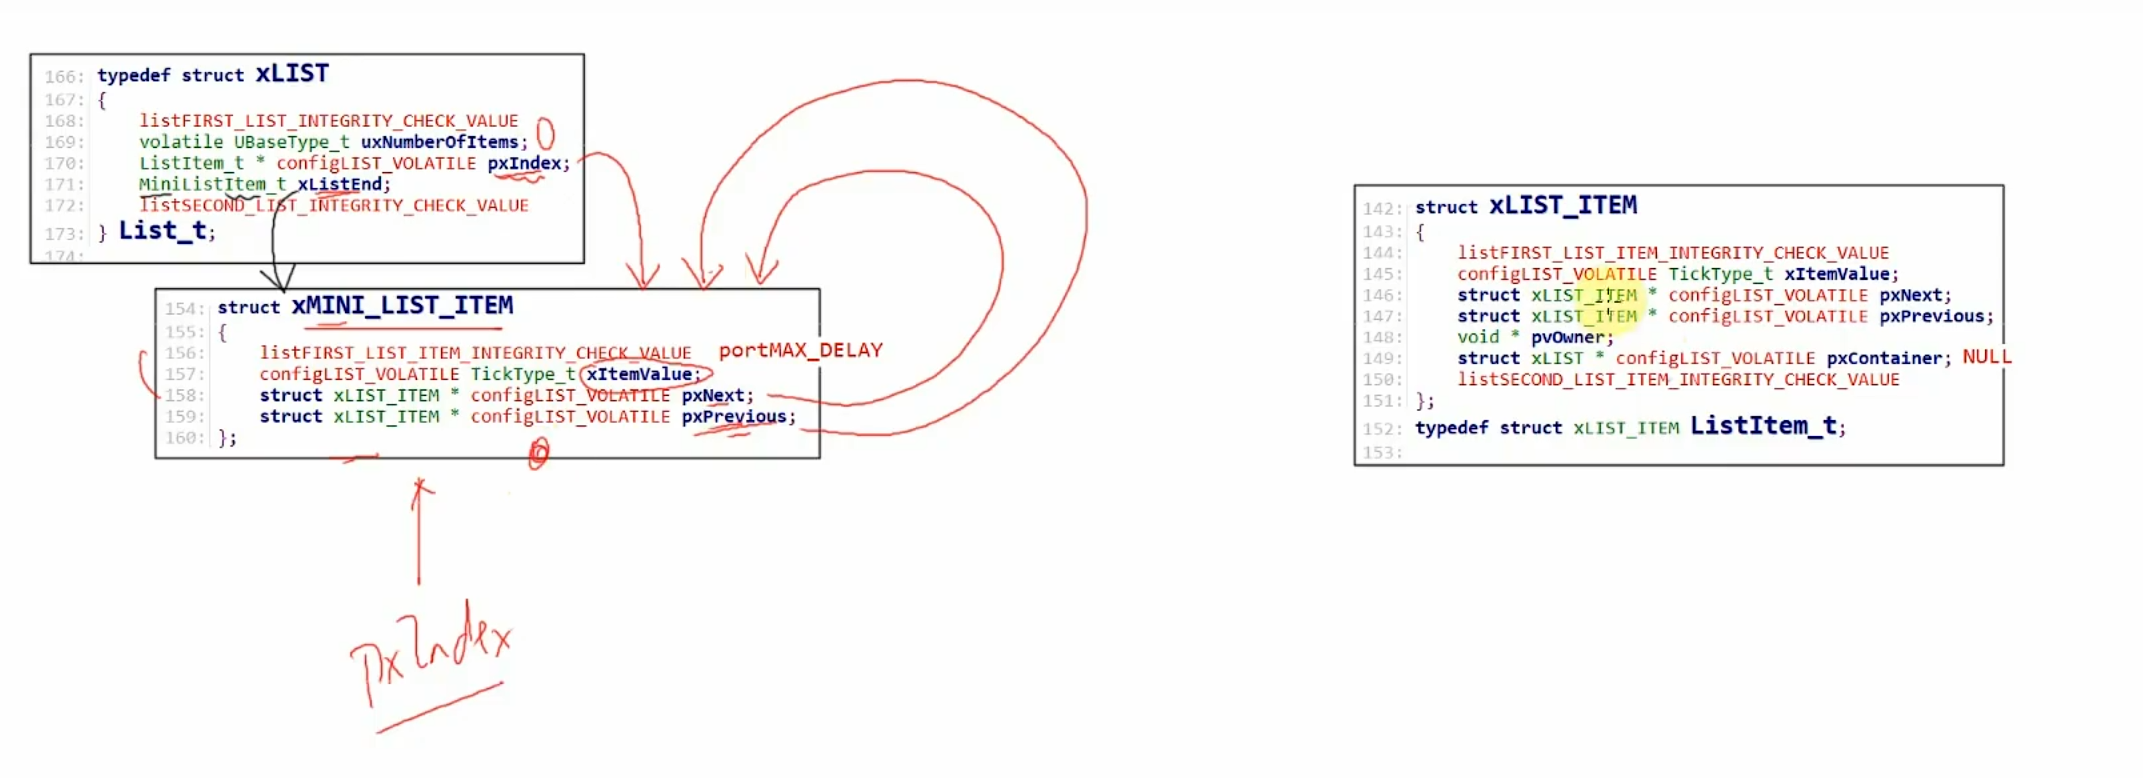
在链表为空的时候,pxIndex 指向 xListEnd 节点。此时加入一个新节点,xListEnd 的 next 和 pre 都会指向新节点(因为这个新节点既是第一个节点也是最后一个节点);同时,新节点的 next 和 pre 也会指向 xListEnd 节点(按照上面的内部代码,因为 pxIndex 指向的节点和 pxIndex 的 pre 都是 xListEnd 节点,所以新节点的 next 和 pre 也指向 xListEnd 节点)。
接着我们再加入一个节点:
可以看到还是一样的,按上面内部代码顺序来看:将新节点的 next 指向 pxIndex 指向的节点(xListEnd),新节点的 pre 指向 xListEnd 节点的 pre(节点 1),让 xListEnd 的 pre 指向新节点(节点2),又让 xListEnd 的原上一个节点(节点 1)的 next 指向新节点。
4.链表排序:
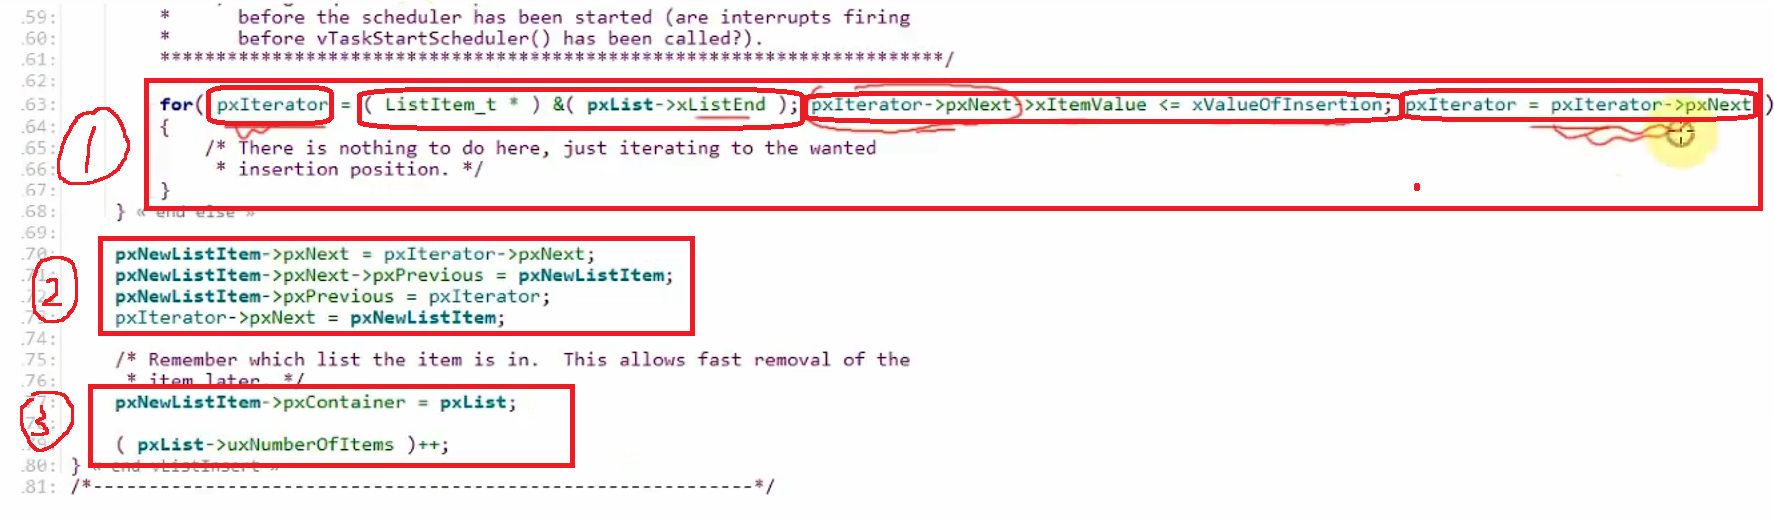
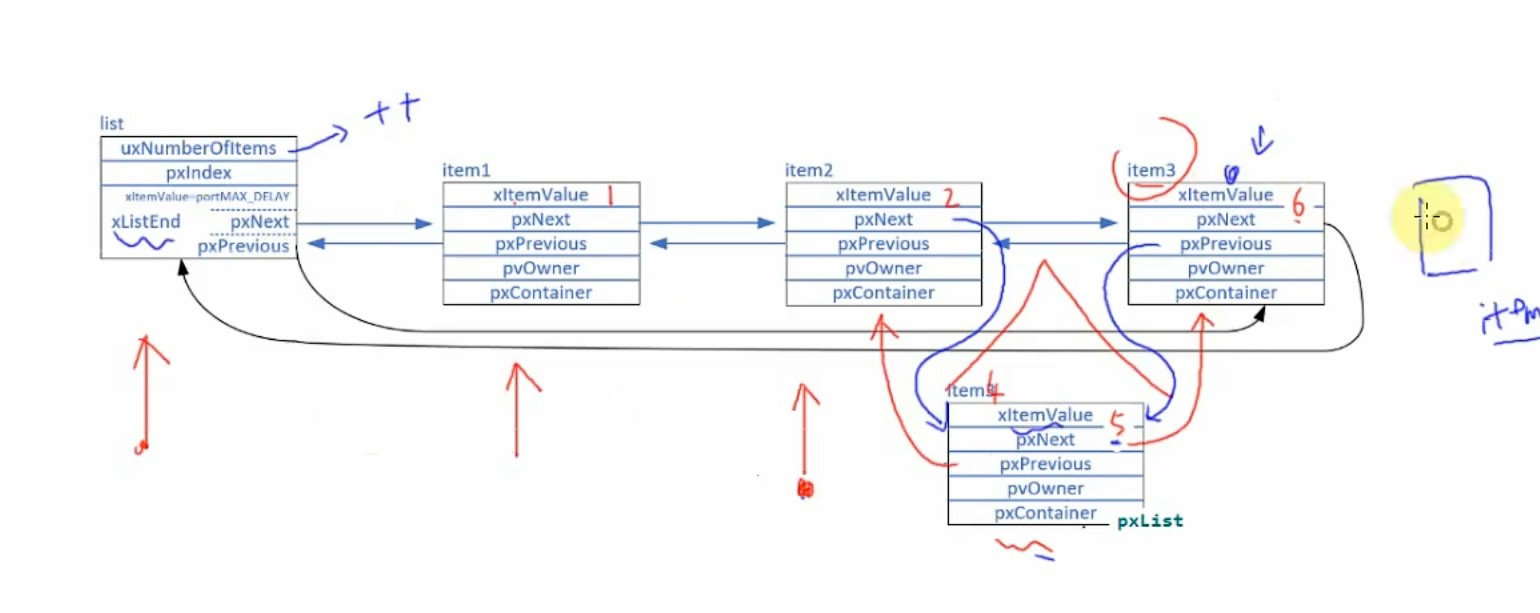
我们知道在节点中有个 xItemValue 成员,这个成员与我们之前学习的 struct person 结构体的 age 成员是一样的,我们就按照这个大小来排序。如图 2,如果我们要插入 xItemValue = 5 的新节点,这个新节点的 xItemValue 要比前一个节点的值大、比后一个小(如果是跟前一个节点的 xItemValue一样,也要排在前一个节点的后面),接下来分析图 1 的代码:
红框 1:其内第一个红框:我们要找到的位置;第二个红框:我们一开始的位置是 xListEnd;第三个红框:我们指向的位置的下一个节点的 xItemValue 小于等于新节点;第 4 个红框:pxIterator 移动到下一个节点位置(意思就是一开始我们想要的位置 pxIterator 设在 xListEnd,然后通过不断比较下一个节点的 xItemValue 是否比新节点的 xItemValue 小,如果小于或等于,pxIterator 就移动到下一个节点位置,直到找到我们要插入新节点的位置,然后跳出 for 循环)。
红框 2:我们找到要插入的位置后,pxNewListItem->pxNext = pxIterator->pxNext(让新节点的 next 指向 pxIterator 的 next),pxNewListItem->pxNext->pxPrevious = pxNewListItem(让新节点的下一个节点的 pre 指向新节点),pxNewListItem->pxPrevious = pxIterator(让新节点的 pre 指向 pxIterator),pxIterator->pxNext = pxNewListItem(让 pxIterator 的 next 指向新节点)。(用图 2 来分析就是:我们 pxIterator 指向节点 2 时,发现节点 3 的 xItemValue 大于节点 4 的 xItemValue,那么就跳出 for 循环,然后这时就让新节点的 next 指向 pxIterator 的 next,新节点的下一个节点(节点 3)的 pre 改成指向新节点(原本指向 pxIterator 节点),新节点的 pre 指向 pxIterator 节点,pxIterator 节点的 next 指向新节点)。
红框 3:就是让新节点加入到该链表中,然后链表计数器 +1。
还有一种情况:
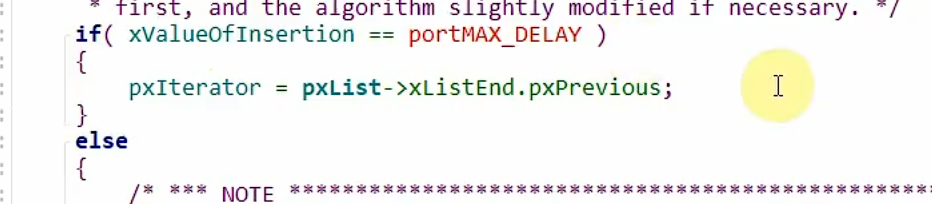
如果这个新节点的 xItemValue 等于最大值,跳过遍历直接放链表最后(哨兵前面)
5.链表的删除:
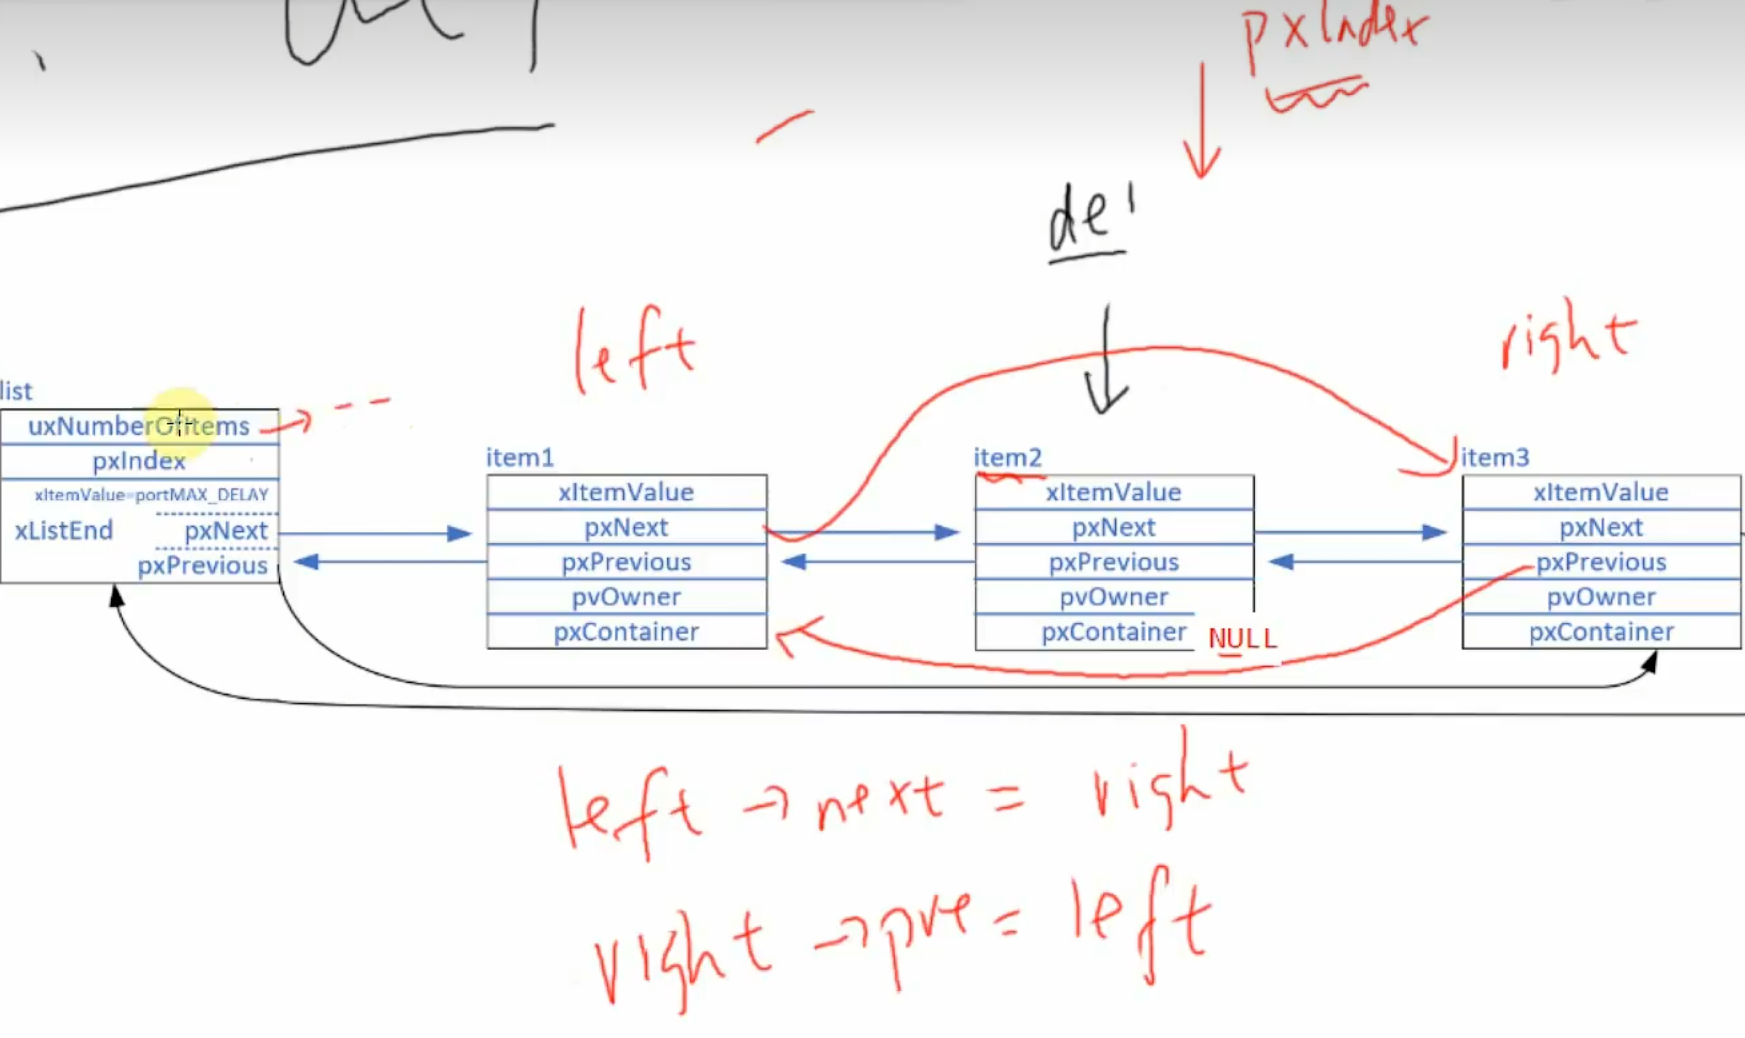
这个就比链表排序简单多了,如上图,跟我们原来链表分析是一样的,我们直接看代码:
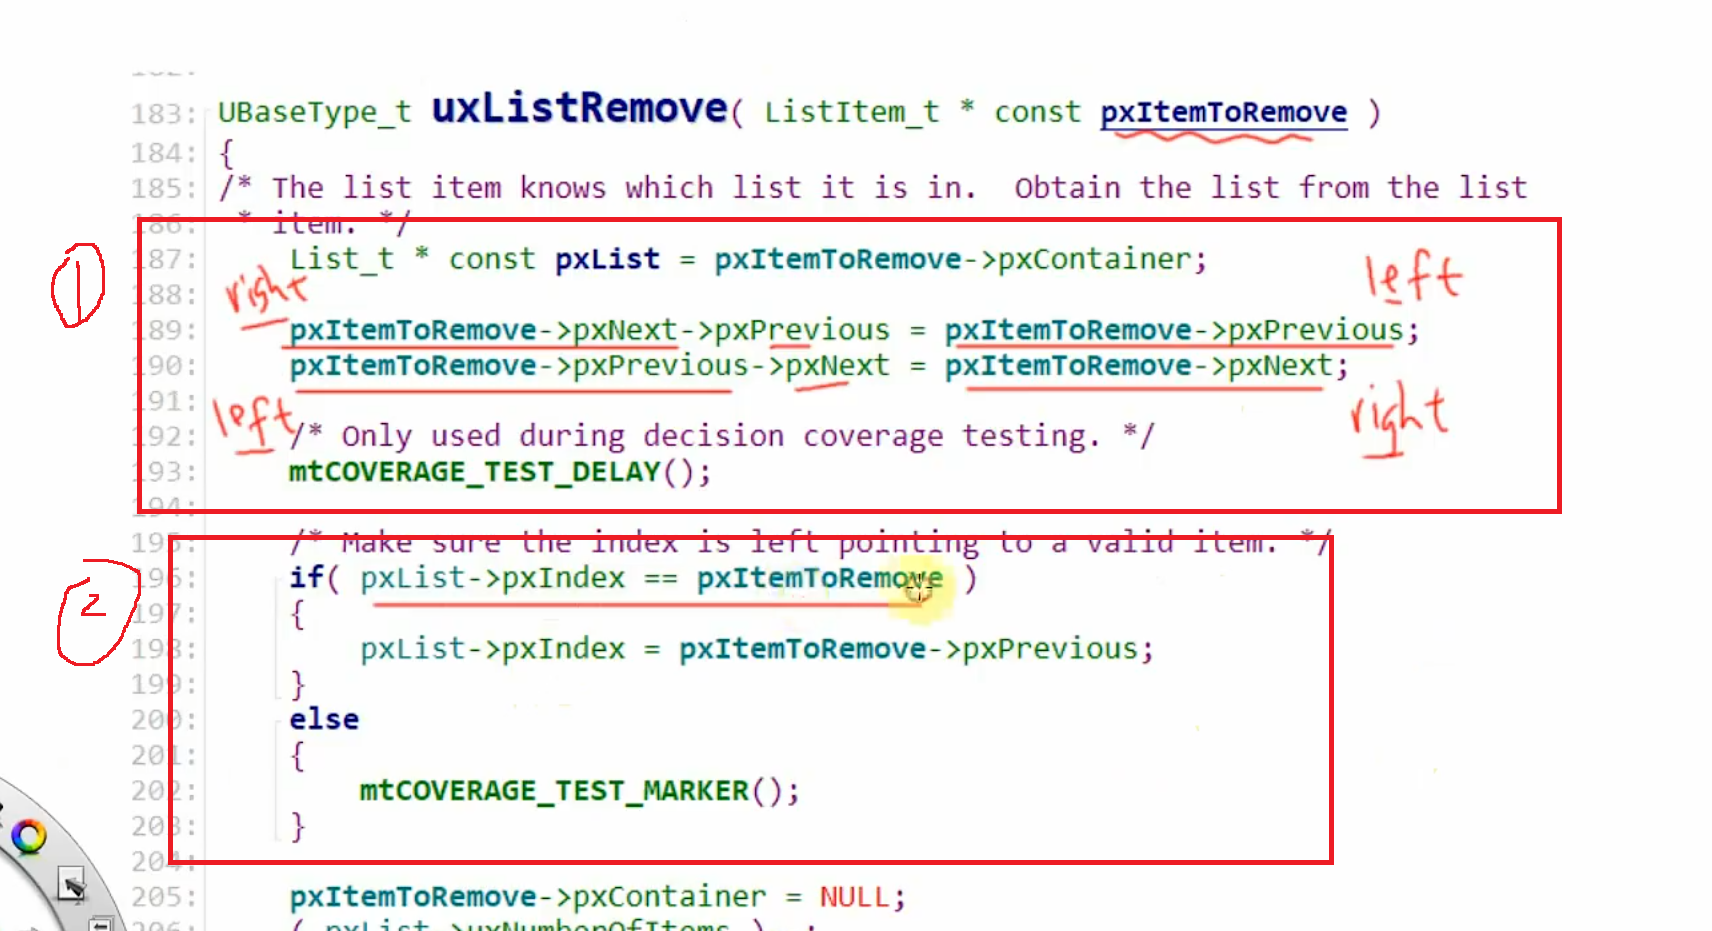
红框1:就让我们要删除的节点的左右两边节点互相指向对方就行了
红框2:如果我们这个要删除的节点刚好是我们pxIndex指向的节点,那么我们删除这个节点前就将pxIndex移动到上一个节点位置
最后:
c
	pxItemToRemove->pvContainer = NULL;

	/* 链表节点计数器-- */
	( pxList->uxNumberOfItems )--;
意思就是该节点不再属于这个链表,自然链表的计数器值也要-1
4.实验:
接下来我们来移植FreeRTOS链表源码、创建一个链表和三个节点并按序排列这三个节点:
list.c文件:
c
#include "FreeRTOS.h"
#include "list.h"

/* 节点初始化 */
void vListInitialiseItem( ListItem_t * const pxItem )
{
    /* 初始化该节点所在的链表为空,表示节点还没有插入任何链表 */
    pxItem->pvContainer=NULL;
}

/* 链表初始化 */
void vListInitialise( List_t * const pxList )
{
	/* 初始化链表节点计数器的值为0,表示链表为空 */
	pxList->uxNumberOfItems = ( UBaseType_t ) 0U;

    /* 将链表索引指针指向最后一个节点 */
    pxList->pxIndex=(ListItem_t *) & (pxList->xListEnd);

    /* 将最后一个节点的 pxNext 和 pxPrevious 指针均指向节点自身,表示链表为空 */
    pxList->xListEnd.pxNext=(ListItem_t *) & (pxList->xListEnd);
    pxList->xListEnd.pxPrevious=(ListItem_t *) & (pxList->xListEnd);

    /* 将链表最后一个节点的辅助排序的值设置为最大,确保该节点就是链表的最后节点 */
	pxList->xListEnd.xItemValue = portMAX_DELAY;

}

/* 将节点插入到链表的尾部 */
void vListInsertEnd( List_t * const pxList, ListItem_t * const pxNewListItem )
{
	ListItem_t * const pxIndex = pxList->pxIndex;

	pxNewListItem->pxNext = pxIndex;
	pxNewListItem->pxPrevious = pxIndex->pxPrevious;
	pxIndex->pxPrevious->pxNext = pxNewListItem;
	pxIndex->pxPrevious = pxNewListItem;

	/* 记住该节点所在的链表 */
	pxNewListItem->pvContainer = ( void * ) pxList;

	/* 链表节点计数器++ */
	( pxList->uxNumberOfItems )++;
}


/* 将节点按照升序排列插入到链表 */
void vListInsert( List_t * const pxList, ListItem_t * const pxNewListItem )
{
	ListItem_t *pxIterator;

	/* 获取节点的排序辅助值 */
	const TickType_t xValueOfInsertion = pxNewListItem->xItemValue;

	/* 寻找节点要插入的位置 */
	if( xValueOfInsertion == portMAX_DELAY )
	{
		pxIterator = pxList->xListEnd.pxPrevious;
	}
	else
	{
		for( pxIterator = ( ListItem_t * ) &( pxList->xListEnd );
		     pxIterator->pxNext->xItemValue <= xValueOfInsertion;
			 pxIterator = pxIterator->pxNext )
		{
			/* 没有事情可做,不断迭代只为了找到节点要插入的位置 */
		}
	}

	pxNewListItem->pxNext = pxIterator->pxNext;
	pxNewListItem->pxNext->pxPrevious = pxNewListItem;
	pxNewListItem->pxPrevious = pxIterator;
	pxIterator->pxNext = pxNewListItem;

	/* 记住该节点所在的链表 */
	pxNewListItem->pvContainer = ( void * ) pxList;

	/* 链表节点计数器++ */
	( pxList->uxNumberOfItems )++;
}


/* 将节点从链表中删除 */
UBaseType_t uxListRemove( ListItem_t * const pxItemToRemove )
{
	/* 获取节点所在的链表 */
	List_t * const pxList = ( List_t * ) pxItemToRemove->pvContainer;

	pxItemToRemove->pxNext->pxPrevious = pxItemToRemove->pxPrevious;
	pxItemToRemove->pxPrevious->pxNext = pxItemToRemove->pxNext;

	/* Make sure the index is left pointing to a valid item. */
	if( pxList->pxIndex == pxItemToRemove )
	{
		pxList->pxIndex = pxItemToRemove->pxPrevious;
	}

	/* 初始化该节点所在的链表为空,表示节点还没有插入任何链表 */
	pxItemToRemove->pvContainer = NULL;

	/* 链表节点计数器-- */
	( pxList->uxNumberOfItems )--;

	/* 返回链表中剩余节点的个数 */
	return pxList->uxNumberOfItems;
}
list.h文件:
c
#ifndef LIST_H
#define LIST_H
/*
************************************************************************
*                                头文件
************************************************************************
*/
#include "FreeRTOS.h"

/*
************************************************************************
*                                结构体定义
************************************************************************
*/
/* 节点结构体定义 */
struct xLIST_ITEM
{
	TickType_t xItemValue;             /* 辅助值,用于帮助节点做顺序排列 */
	struct xLIST_ITEM *  pxNext;       /* 指向链表下一个节点 */
	struct xLIST_ITEM *  pxPrevious;   /* 指向链表前一个节点 */
	void * pvOwner;					   /* 指向拥有该节点的内核对象,通常是TCB */
	void *  pvContainer;		       /* 指向该节点所在的链表 */
};
typedef struct xLIST_ITEM ListItem_t;  /* 节点数据类型重定义 */

/* mini节点结构体定义,作为双向链表的结尾
   因为双向链表是首尾相连的,头即是尾,尾即是头 */
struct xMINI_LIST_ITEM
{
	TickType_t xItemValue;                      /* 辅助值,用于帮助节点做升序排列 */
	struct xLIST_ITEM *  pxNext;                /* 指向链表下一个节点 */
	struct xLIST_ITEM *  pxPrevious;            /* 指向链表前一个节点 */
};
typedef struct xMINI_LIST_ITEM MiniListItem_t;  /* 最小节点数据类型重定义 */


/* 链表结构体定义 */
typedef struct xLIST
{
	UBaseType_t uxNumberOfItems;    /* 链表节点计数器 */
	ListItem_t *  pxIndex;			/* 链表节点索引指针 */
	MiniListItem_t xListEnd;		/* 链表最后一个节点 */
} List_t;

/*
************************************************************************
*                                函数声明
************************************************************************
*/
void vListInitialise( List_t * const pxList );
void vListInitialiseItem( ListItem_t * const pxItem );
void vListInsertEnd( List_t * const pxList, ListItem_t * const pxNewListItem );
void vListInsert( List_t * const pxList, ListItem_t * const pxNewListItem );
UBaseType_t uxListRemove( ListItem_t * const pxItemToRemove );


#endif /* LIST_H */
main.c文件:
c
#include "list.h"

/*定义一个链表*/
static struct xLIST List_Test;

/*定义三个节点*/
static struct xLIST_ITEM ITEM1={
	1,NULL,NULL,NULL,NULL
};
static struct xLIST_ITEM ITEM2={
	2,NULL,NULL,NULL,NULL
};
static struct xLIST_ITEM ITEM3={
	3,NULL,NULL,NULL,NULL
};

int main(void)
{
	/*链表初始化*/
	vListInitialise(&List_Test);

	/*节点初始化*/
	vListInitialiseItem(&ITEM1);
	vListInitialiseItem(&ITEM2);
	vListInitialiseItem(&ITEM3);

	vListInsert(&List_Test,&ITEM1);
	vListInsert(&List_Test,&ITEM2);
	vListInsert(&List_Test,&ITEM3);

	for(;;)
	{

	}

}
然后我们用仿真软件跑一下看看结果:
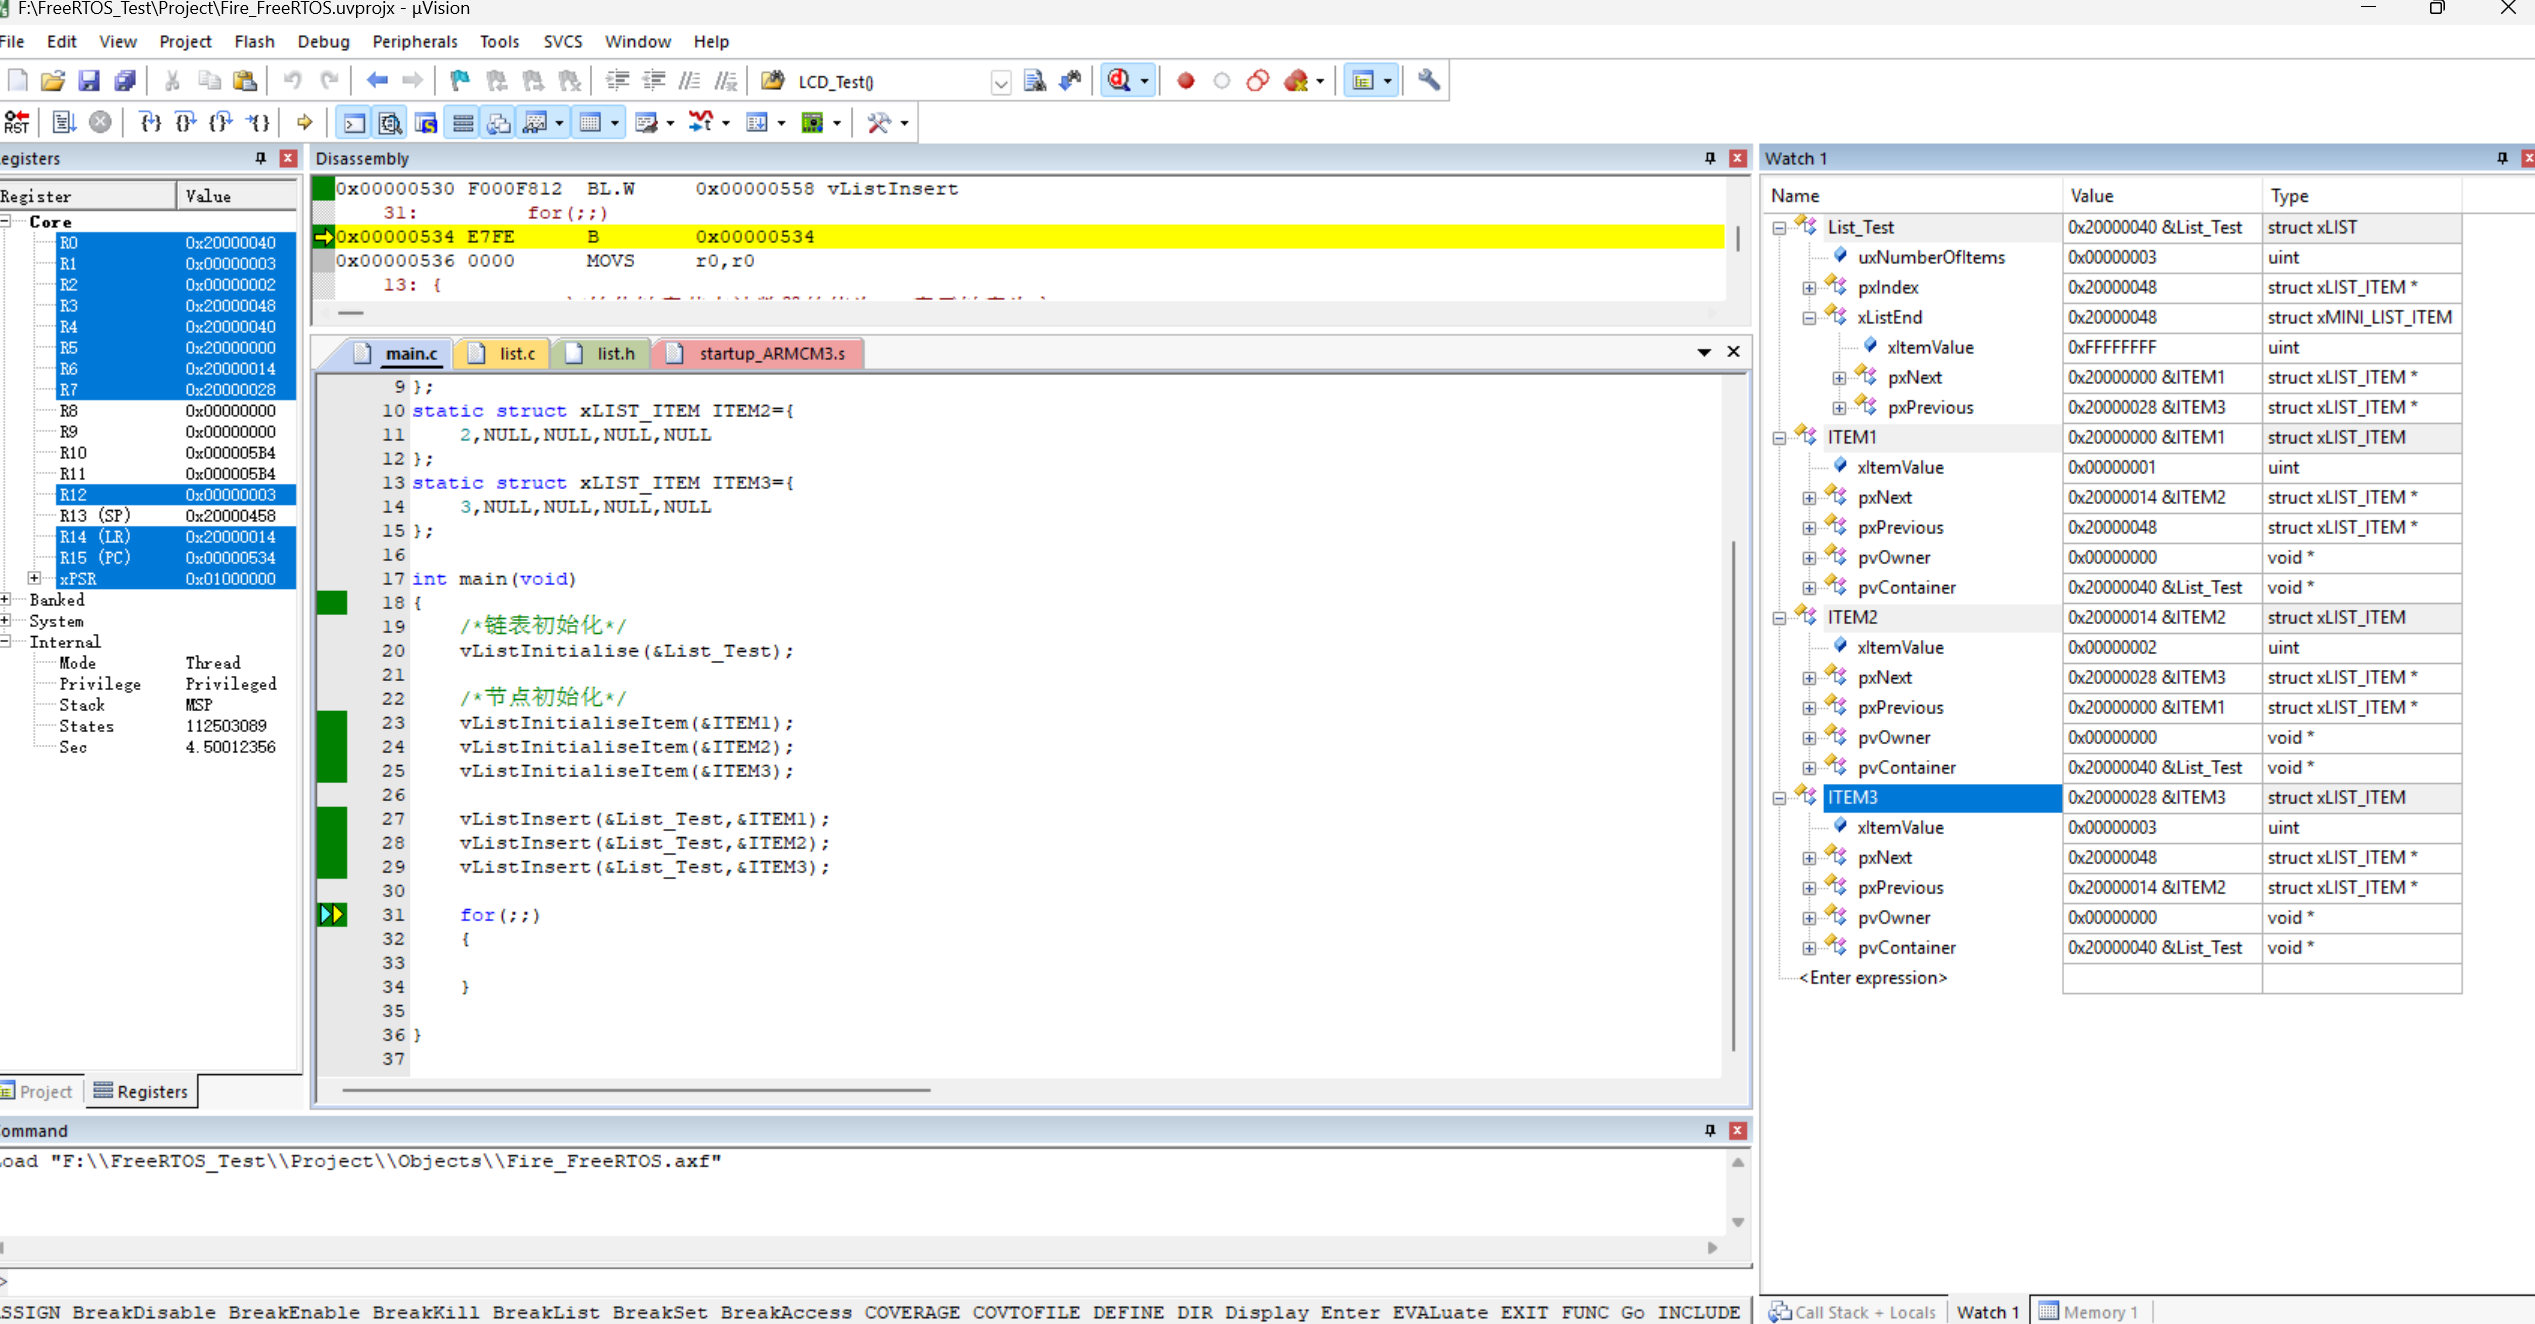
我们可以看到链表xListEnd的pre指向了节点3,next指向了节点1,其它数据结果也与我们预期结果一致,说明我们创建成功了
最后添加一些宏定义:
list.h文件:
c
/*
************************************************************************
*                                宏定义
************************************************************************
*/
/* 初始化节点的拥有者 */
#define listSET_LIST_ITEM_OWNER( pxListItem, pxOwner )		( ( pxListItem )->pvOwner = ( void * ) ( pxOwner ) )
/* 获取节点拥有者 */
#define listGET_LIST_ITEM_OWNER( pxListItem )	( ( pxListItem )->pvOwner )

/* 初始化节点排序辅助值 */
#define listSET_LIST_ITEM_VALUE( pxListItem, xValue )	( ( pxListItem )->xItemValue = ( xValue ) )

/* 获取节点排序辅助值 */
#define listGET_LIST_ITEM_VALUE( pxListItem )	( ( pxListItem )->xItemValue )

/* 获取链表根节点的节点计数器的值 */
#define listGET_ITEM_VALUE_OF_HEAD_ENTRY( pxList )	( ( ( pxList )->xListEnd ).pxNext->xItemValue )

/* 获取链表的入口节点 */
#define listGET_HEAD_ENTRY( pxList )	( ( ( pxList )->xListEnd ).pxNext )

/* 获取链表的第一个节点 */
#define listGET_NEXT( pxListItem )	( ( pxListItem )->pxNext )

/* 获取链表的最后一个节点 */
#define listGET_END_MARKER( pxList )	( ( ListItem_t const * ) ( &( ( pxList )->xListEnd ) ) )

/* 判断链表是否为空 */
#define listLIST_IS_EMPTY( pxList )	( ( BaseType_t ) ( ( pxList )->uxNumberOfItems == ( UBaseType_t ) 0 ) )

/* 获取链表的节点数 */
#define listCURRENT_LIST_LENGTH( pxList )	( ( pxList )->uxNumberOfItems )

/* 获取链表节点的OWNER,即TCB */
#define listGET_OWNER_OF_NEXT_ENTRY( pxTCB, pxList )										\
{																							\
	List_t * const pxConstList = ( pxList );											    \
	/* 节点索引指向链表第一个节点调整节点索引指针,指向下一个节点,
    如果当前链表有N个节点,当第N次调用该函数时,pxInedex则指向第N个节点 */\
	( pxConstList )->pxIndex = ( pxConstList )->pxIndex->pxNext;							\
	/* 当前链表为空 */                                                                       \
	if( ( void * ) ( pxConstList )->pxIndex == ( void * ) &( ( pxConstList )->xListEnd ) )	\
	{																						\
		( pxConstList )->pxIndex = ( pxConstList )->pxIndex->pxNext;						\
	}																						\
	/* 获取节点的OWNER,即TCB */                                                             \
	( pxTCB ) = ( pxConstList )->pxIndex->pvOwner;											 \
}

#define listGET_OWNER_OF_HEAD_ENTRY( pxList )  ( (&( ( pxList )->xListEnd ))->pxNext->pvOwner )
该宏定义有一些是我们见过的,比如listSET_LIST_ITEM_OWNER( pxListItem, pxOwner )就是我们在节点结构体的pvOwner成员,而该宏定义就是给节点的 pvOwner 成员赋值,pvOwner 指向包含该节点的 TCB(就是指向包含该节点的任务)
还有一个宏定义:
c
/* 获取链表节点的OWNER,即TCB */
#define listGET_OWNER_OF_NEXT_ENTRY( pxTCB, pxList )										\
{																							\
	List_t * const pxConstList = ( pxList );											    \
	/* 节点索引指向链表第一个节点调整节点索引指针,指向下一个节点,
    如果当前链表有N个节点,当第N次调用该函数时,pxInedex则指向第N个节点 */\
	( pxConstList )->pxIndex = ( pxConstList )->pxIndex->pxNext;							\
	/* 当前链表为空 */                                                                       \
	if( ( void * ) ( pxConstList )->pxIndex == ( void * ) &( ( pxConstList )->xListEnd ) )	\
	{																						\
		( pxConstList )->pxIndex = ( pxConstList )->pxIndex->pxNext;						\
	}																						\
	/* 获取节点的OWNER,即TCB */                                                             \
	( pxTCB ) = ( pxConstList )->pxIndex->pvOwner;											 \
}
这个宏干三件事:
- pxIndex = pxIndex->pxNext------调度员沿圈迈一步;
- 如果踩到了哨兵岗亭(xListEnd),再迈一步跳过------岗亭不是任务,没有 pvOwner,不报名字;
- pxTCB = pxIndex->pvOwner------报出当前节点的主人(TCB)。
就绪链表的轮转调度,就是循环调用这个宏:每调一次,拿出下一个任务。第 3 节的"岗亭"比喻,到这里变成了真代码。
这两个宏定义的区别:
- listGET_LIST_ITEM_OWNER = 调度员站在原地,指着某个同学问:"这个节点属于哪个任务?"
- listGET_OWNER_OF_NEXT_ENTRY = 调度员迈出一步(踩到岗亭再迈一步),然后报出脚下节点的任务------迈步这个动作本身就是它干的事。
所以关键区别就一个词:副作用。后者每次调用都会把 pxIndex 往前推一格,链表的状态被它改了。就绪链表轮转调度就是反复调用它:"下一个任务 → 运行 → 再下一个 → 运行......",pxIndex
一圈一圈地转。前者只是个安静的查询,调用一百次链表纹丝不动。