25、Python 教程 - difflib模块之文本对比
文章目录
- [25、Python 教程 - difflib模块之文本对比](#25、Python 教程 - difflib模块之文本对比)
-
- 一、痛点场景:你是否也曾在海量文本中"找不同"找到眼瞎?
- [二、痛点的解决方案:difflib 登场](#二、痛点的解决方案:difflib 登场)
- [三、difflib 是什么?](#三、difflib 是什么?)
-
- [3.1 官方定义](#3.1 官方定义)
- [3.2 核心组成](#3.2 核心组成)
- [3.3 符号理解](#3.3 符号理解)
- [四、为什么要用 difflib?](#四、为什么要用 difflib?)
-
- [4.1 零依赖,开箱即用](#4.1 零依赖,开箱即用)
- [4.2 功能全面,覆盖绝大多数文本对比场景](#4.2 功能全面,覆盖绝大多数文本对比场景)
- [4.3 算法成熟,结果可靠](#4.3 算法成熟,结果可靠)
- [4.4 输出格式丰富,便于集成](#4.4 输出格式丰富,便于集成)
- [4.5 性能足够,中小文本无压力](#4.5 性能足够,中小文本无压力)
- [五、difflib 是怎么演进过来的?](#五、difflib 是怎么演进过来的?)
-
- [5.1 1970s:Unix diff 命令诞生](#5.1 1970s:Unix diff 命令诞生)
- [5.2 1991:Python 发布](#5.2 1991:Python 发布)
- [5.3 2000s:difflib 加入 Python 标准库](#5.3 2000s:difflib 加入 Python 标准库)
- [5.4 2010s:Git 普及,diff 成为开发者标配](#5.4 2010s:Git 普及,diff 成为开发者标配)
- [5.5 2020s:AI 时代,文本对比需求爆发](#5.5 2020s:AI 时代,文本对比需求爆发)
- [六、difflib 怎么用?](#六、difflib 怎么用?)
-
- [6.1 基础文本对比:Differ 类](#6.1 基础文本对比:Differ 类)
- [6.2 生成可视化 HTML 报告:HtmlDiff 类](#6.2 生成可视化 HTML 报告:HtmlDiff 类)
- [6.3 计算文本相似度:SequenceMatcher](#6.3 计算文本相似度:SequenceMatcher)
- [6.4 智能模糊匹配:get_close_matches](#6.4 智能模糊匹配:get_close_matches)
- [6.5 生成统一差异格式:unified_diff](#6.5 生成统一差异格式:unified_diff)
- [6.6 对比两个文件](#6.6 对比两个文件)
- 七、企业项目中的实战应用
-
- [7.1 实战一:配置文件变更监控系统](#7.1 实战一:配置文件变更监控系统)
- [7.2 实战二:代码审查辅助工具](#7.2 实战二:代码审查辅助工具)
- [7.3 实战三:文档版本对比平台](#7.3 实战三:文档版本对比平台)
- [7.4 实战四:智能纠错与推荐系统](#7.4 实战四:智能纠错与推荐系统)
- [八、竞品对比:difflib vs 其他文本对比工具](#八、竞品对比:difflib vs 其他文本对比工具)
-
- [8.1 各工具的优劣势总结](#8.1 各工具的优劣势总结)
- [8.2 选型建议](#8.2 选型建议)
- [九、专业解释 + 大白话 + 生活案例](#九、专业解释 + 大白话 + 生活案例)
-
- [9.1 SequenceMatcher 的工作原理](#9.1 SequenceMatcher 的工作原理)
- [9.2 get_close_matches 的工作原理](#9.2 get_close_matches 的工作原理)
- [9.3 unified_diff 的工作原理](#9.3 unified_diff 的工作原理)
- 十、常用场景汇总
- 十一、面试官高频面试题
-
- [面试题 1:difflib 中 SequenceMatcher 的 ratio() 是怎么计算的?](#面试题 1:difflib 中 SequenceMatcher 的 ratio() 是怎么计算的?)
- [面试题 2:difflib 和 python-Levenshtein 有什么区别?什么时候用哪个?](#面试题 2:difflib 和 python-Levenshtein 有什么区别?什么时候用哪个?)
- [面试题 3:get_close_matches 的 cutoff 参数默认值是多少?如何调优?](#面试题 3:get_close_matches 的 cutoff 参数默认值是多少?如何调优?)
- [面试题 4:如何用 difflib 实现一个简单的文本去重功能?](#面试题 4:如何用 difflib 实现一个简单的文本去重功能?)
- [面试题 5:difflib 的 HtmlDiff 生成的 HTML 报告如何自定义样式?](#面试题 5:difflib 的 HtmlDiff 生成的 HTML 报告如何自定义样式?)
- [面试题 6:SequenceMatcher 的 get_opcodes() 返回哪些操作类型?分别代表什么?](#面试题 6:SequenceMatcher 的 get_opcodes() 返回哪些操作类型?分别代表什么?)
- [面试题 7:difflib 能对比二进制文件吗?为什么?](#面试题 7:difflib 能对比二进制文件吗?为什么?)
- 十二、总结
一、痛点场景:你是否也曾在海量文本中"找不同"找到眼瞎?
想象一下这些场景:
场景一:运维工程师的深夜崩溃
凌晨两点,线上服务突然告警。你怀疑是配置文件被人改动了,但服务器上有上百个配置文件,每个文件几百行。你只能一个一个打开,用肉眼逐行对比备份版本和当前版本的差异。眼睛看花了,手也抖了,十分钟过去了,你还没找到那个该死的改动点,而故障还在持续。
场景二:代码审查的"大家来找茬"
团队里的实习生提交了一个 2000 行的 PR,说"只改了一点点逻辑"。你拉下来一看,整个文件都变了颜色。你想知道他到底改了哪几行,是不是偷偷把核心算法替换了,只能靠 Git diff 一行行看。但如果没有版本控制呢?如果是两个独立的代码片段呢?你只能复制到 Beyond Compare 里手动对比。
场景三:文档审核的"像素级"核对
法务同事发来两份合同,说"第二版只改了付款日期"。你信了,直接签字盖章。结果三个月后发现,对方不仅改了付款日期,还把违约金比例从 5% 偷偷改成了 15%。你追悔莫及,但如果当时有一个工具能自动对比两份文档的每一个字,这种悲剧完全可以避免。
场景四:用户输入的"差之毫厘,谬以千里"
你做了一个命令行工具,用户输入 git statsu 想查看状态,程序直接报 CommandNotFoundError。用户体验极差。如果程序能智能识别"你是不是想输入 git status?",用户体验会好得多。
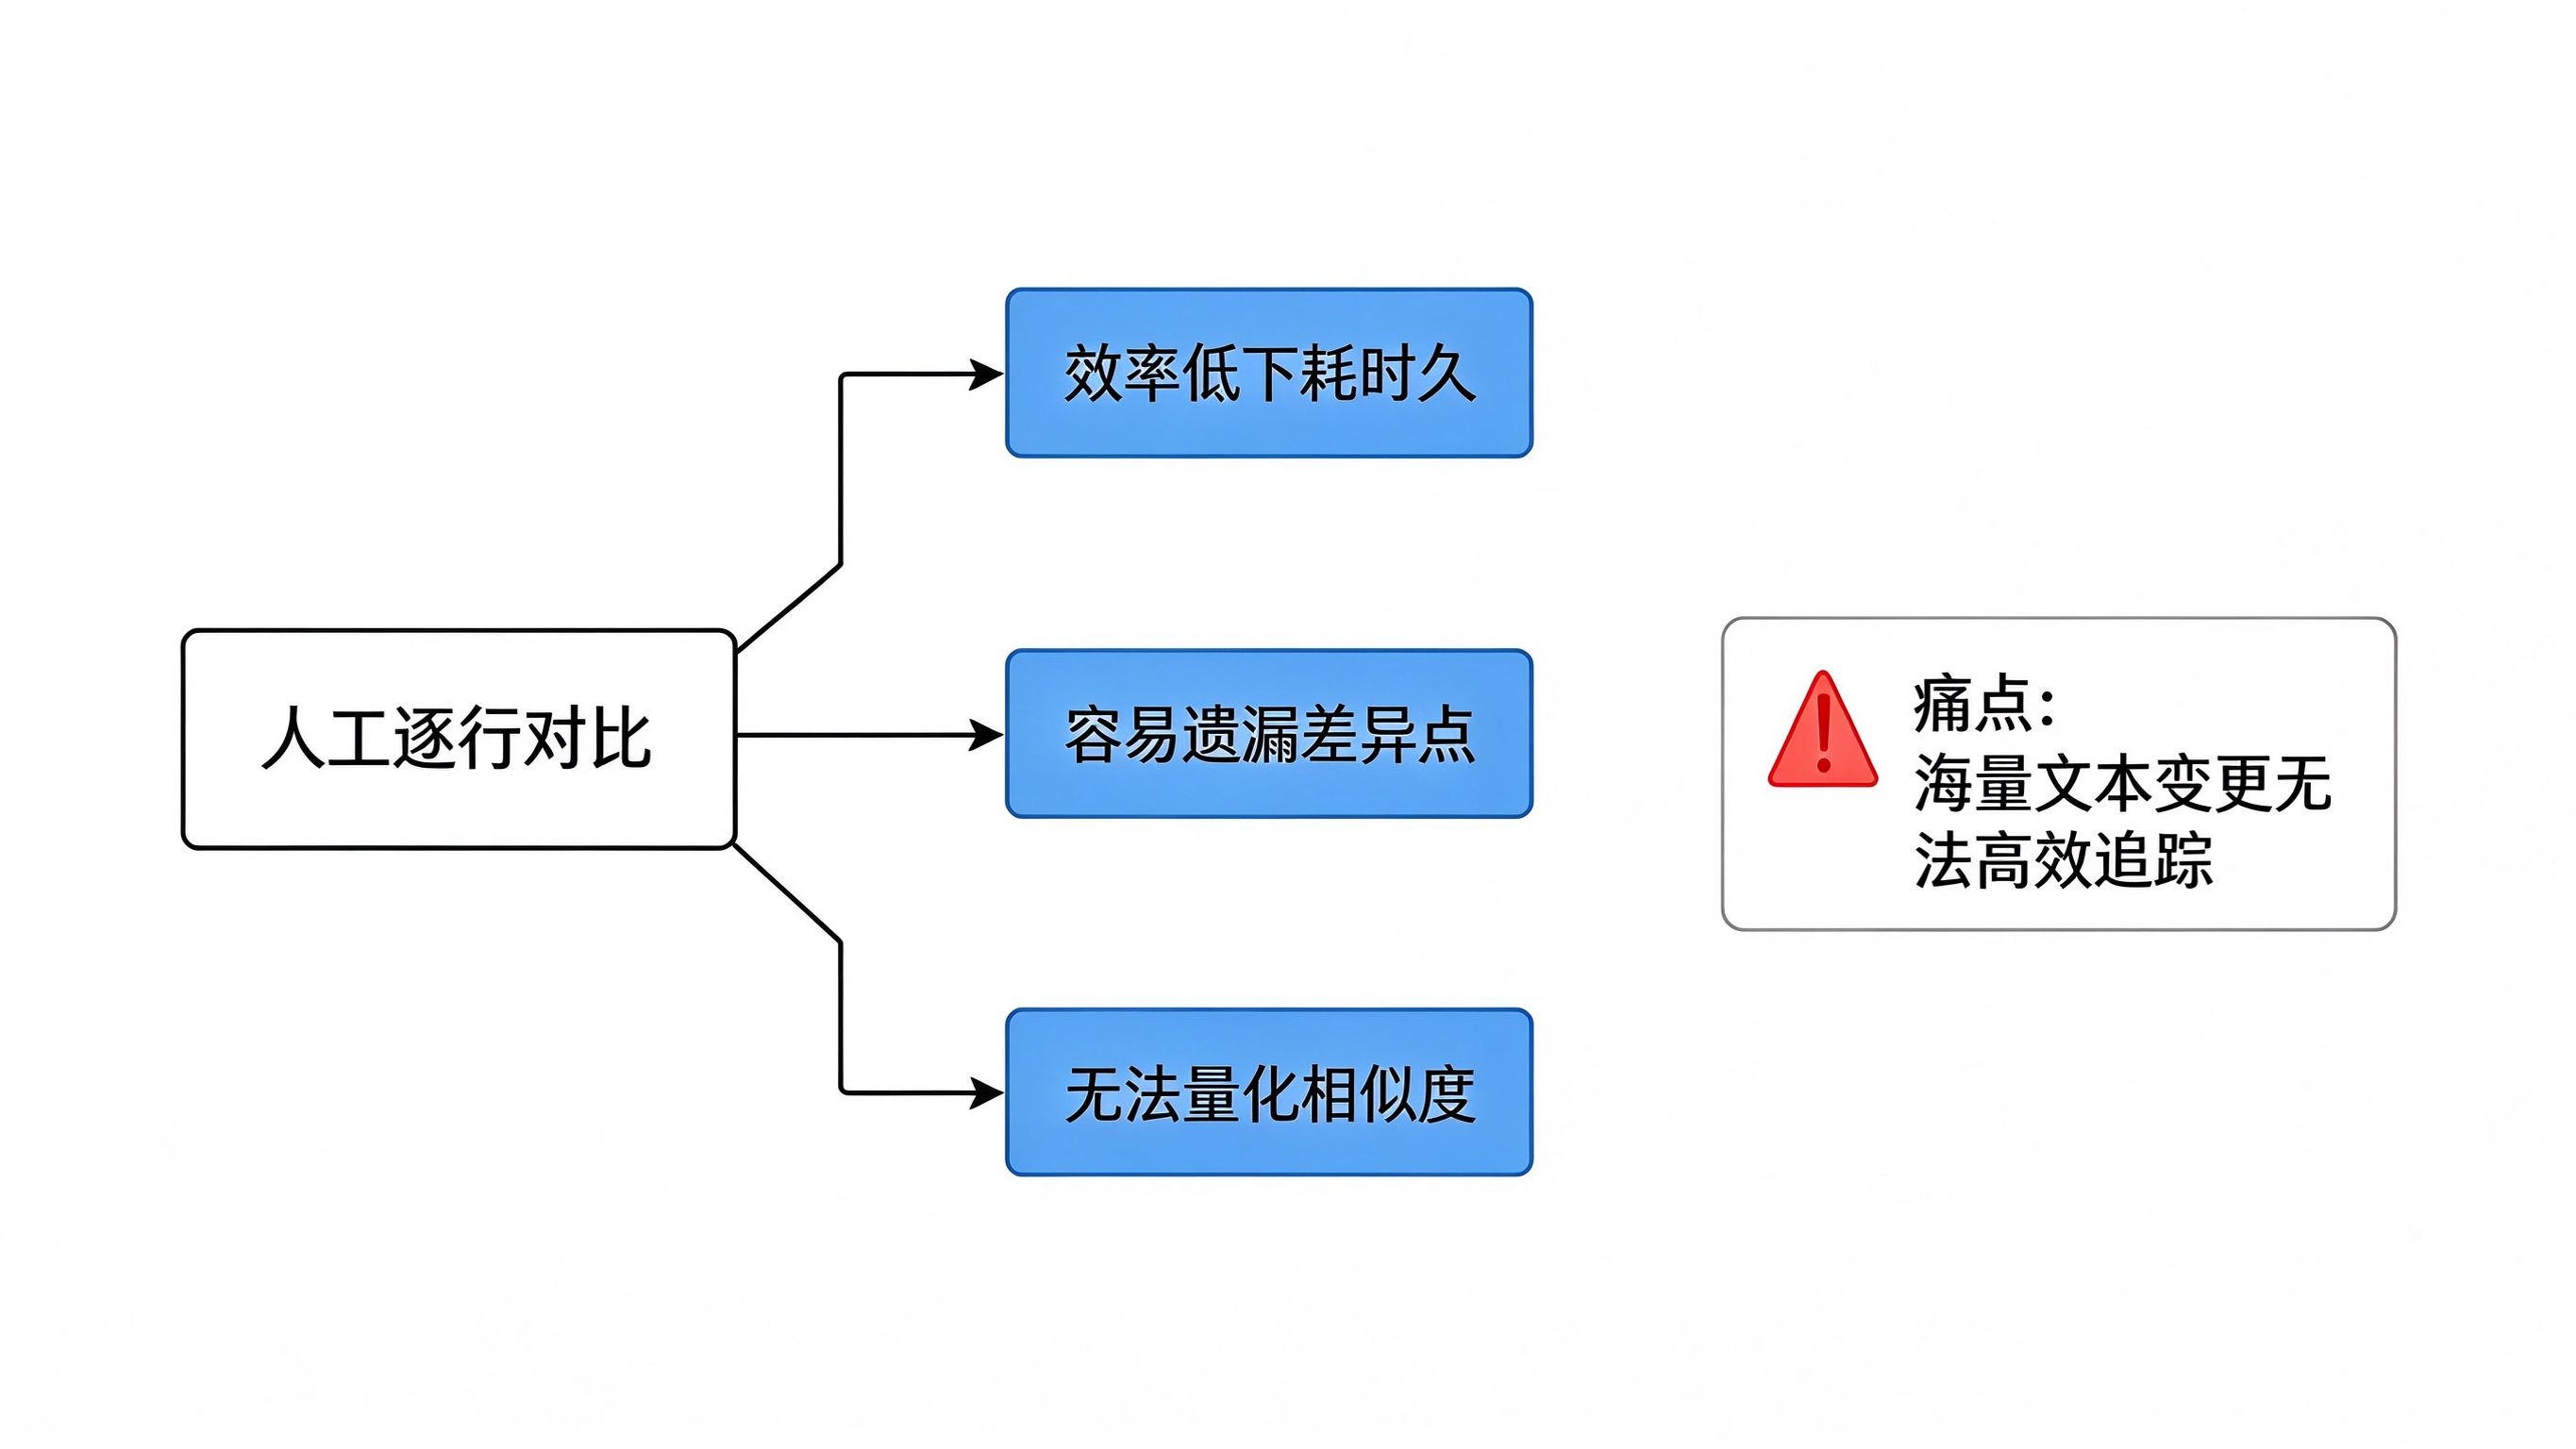
这些场景的共同痛点是什么?文本对比是刚需,但人工对比效率极低、极易出错,且无法量化相似度。
二、痛点的解决方案:difflib 登场
面对上述痛点,Python 给出的答案是标准库中的 difflib 模块。它不需要你安装任何第三方包,开箱即用,能帮你完成:
- 两段文本的逐行差异对比
- 两个文件的内容对比并生成可视化 HTML 报告
- 任意两个序列的相似度量化计算
- 从候选列表中智能模糊匹配最接近的项
- 生成符合 Git 标准的统一差异格式(unified diff)
一句话总结:difflib 就是 Python 内置的"文本对比瑞士军刀",让你从"人肉找不同"升级为"自动化精确对比"。
三、difflib 是什么?
3.1 官方定义
根据 Python 官方文档,difflib 是 Python 标准库中的一个模块,提供用于比较序列的类和函数。它可以用于比较文件,并能产生多种格式的文件差异信息,包括 HTML、上下文差异(context diff)和统一差异(unified diff)。
源码位于 Lib/difflib.py,从 Python 2.1 版本开始加入标准库,至今已有超过 20 年的历史,是 Python 生态中最稳定、最可靠的文本处理工具之一。
3.2 核心组成
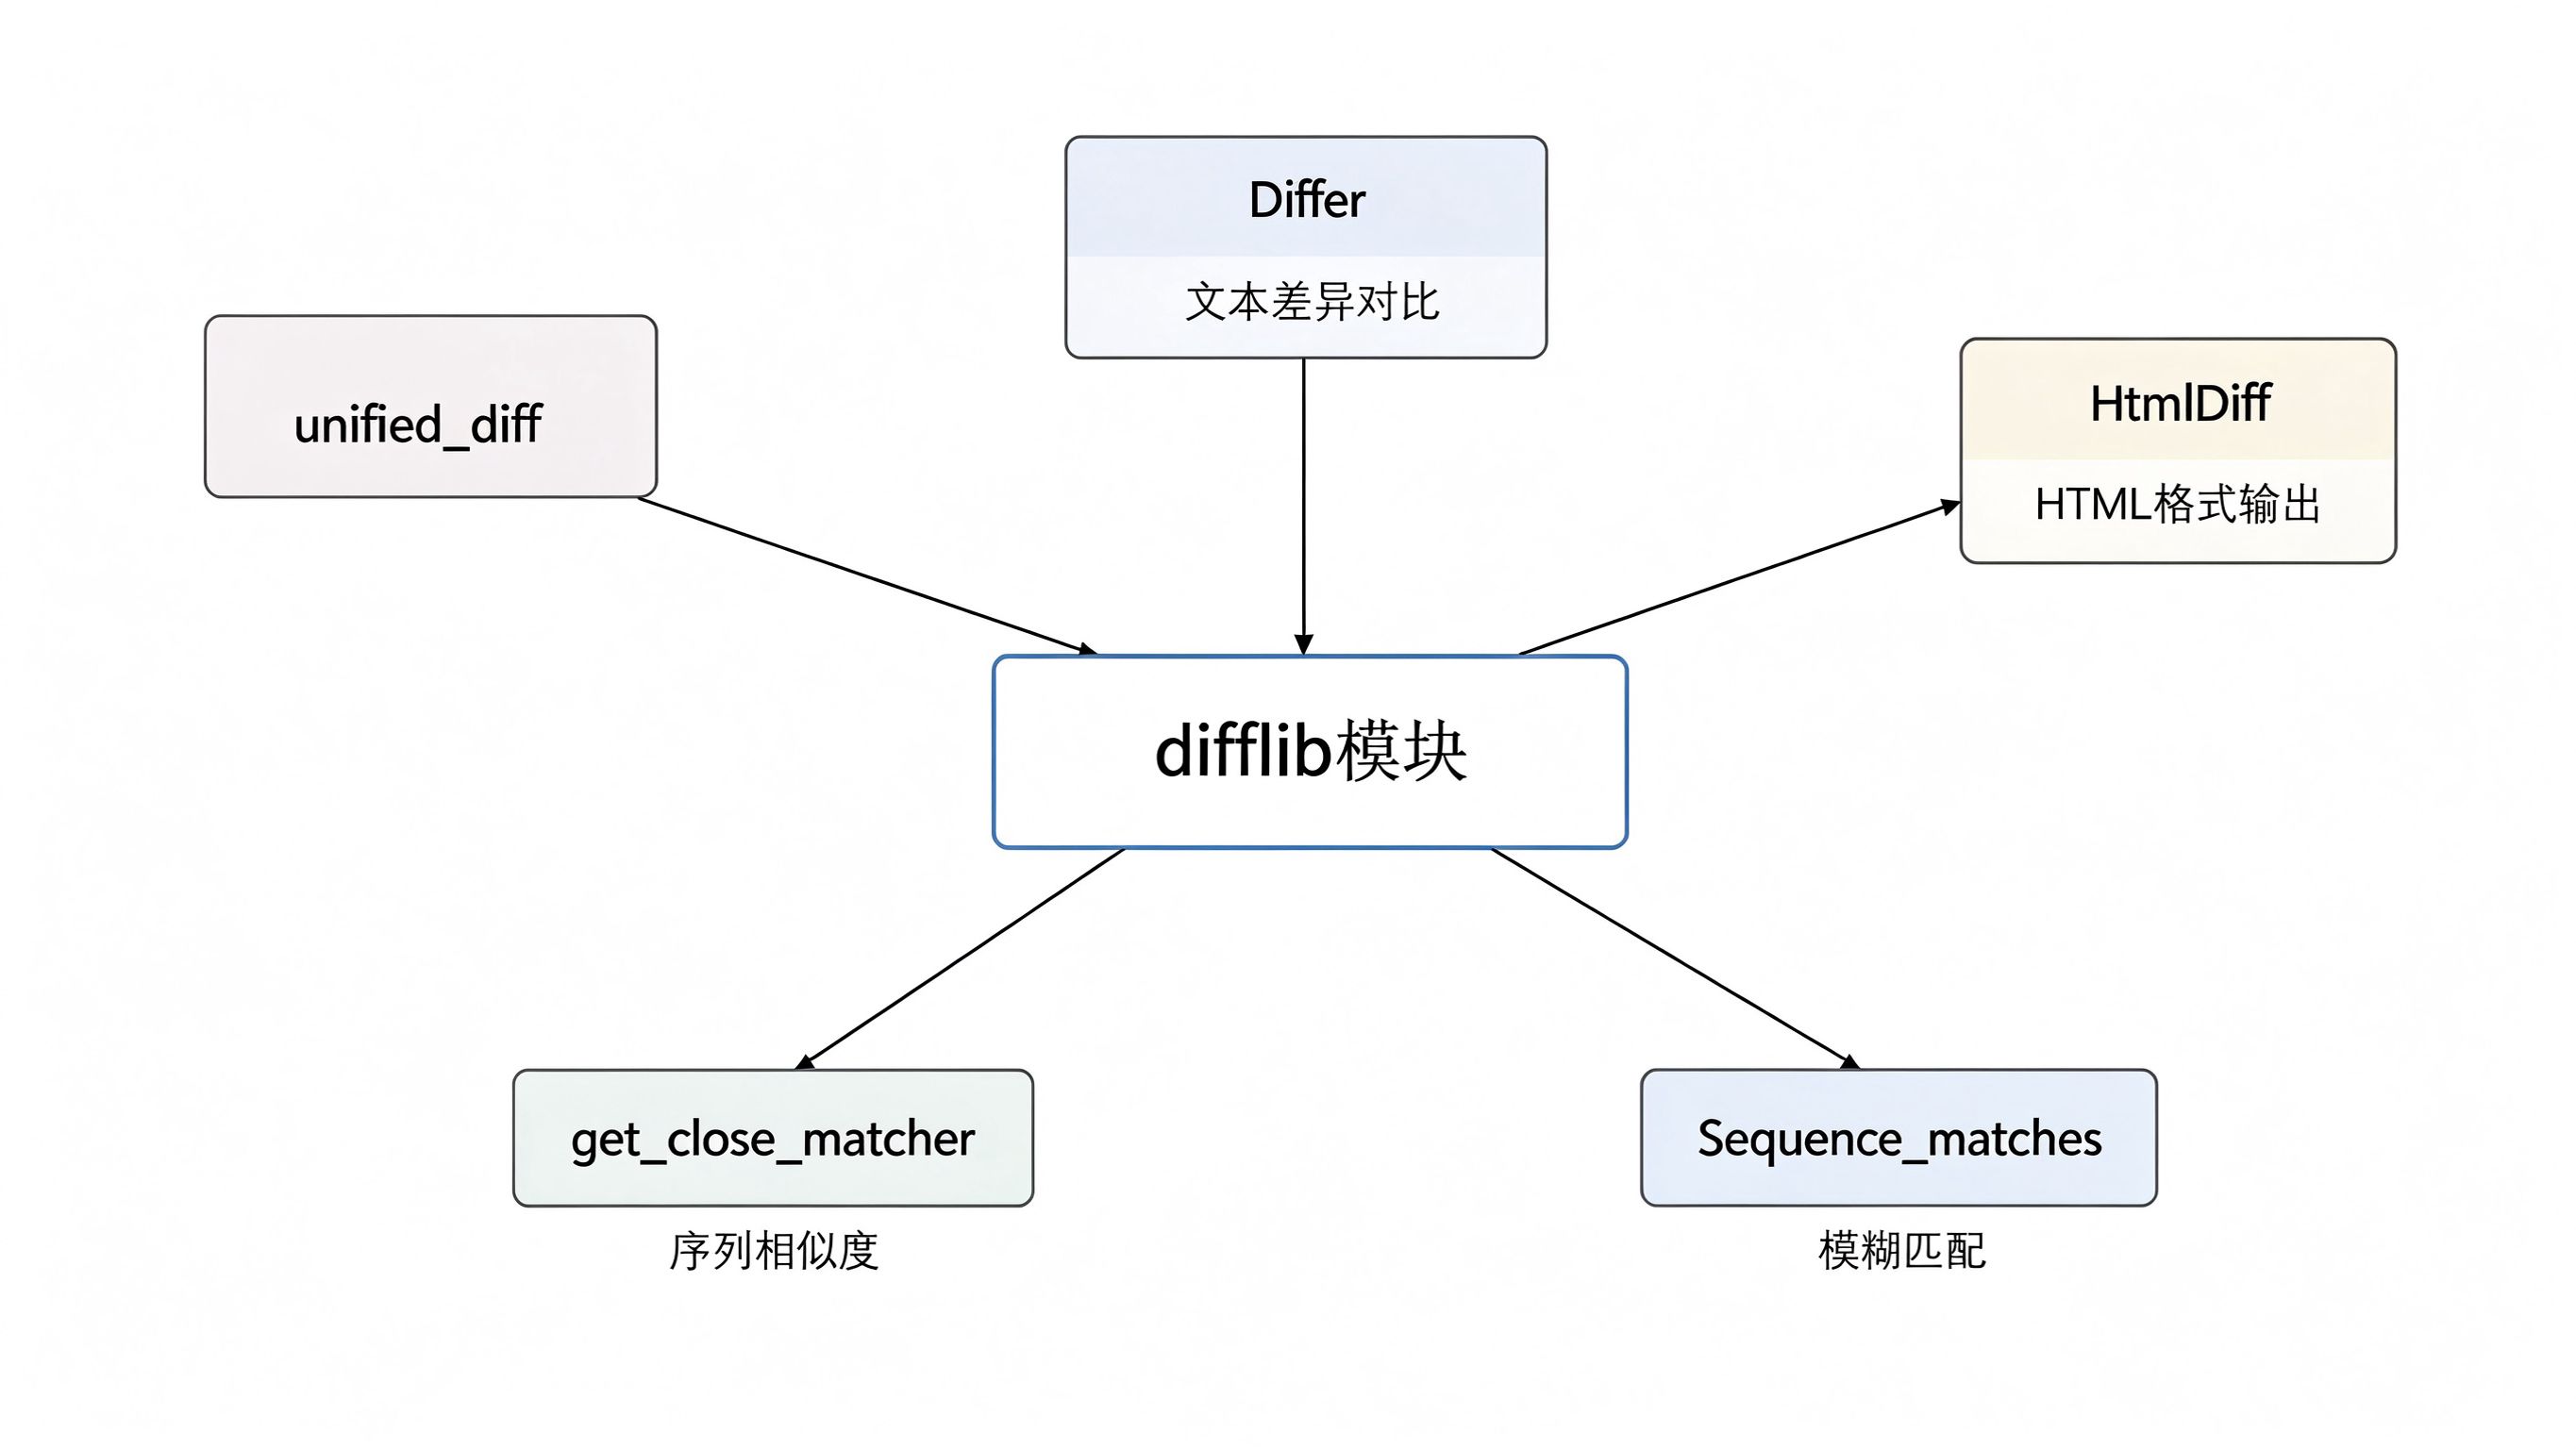
difflib 模块主要包含以下几个核心类和函数:
| 类/函数 | 作用 | 典型应用 |
|---|---|---|
Differ |
对比文本行序列,生成带符号的人类可读差异 | 控制台输出对比结果 |
HtmlDiff |
对比文本并生成 side-by-side 的 HTML 可视化报告 | 网页展示差异、邮件报告 |
SequenceMatcher |
基于 Ratcliff/Obershelp 算法计算任意序列相似度 | 模糊匹配、去重、推荐 |
get_close_matches() |
从候选列表中返回最佳近似匹配 | 命令纠错、拼写检查 |
unified_diff() |
生成统一差异格式(类似 git diff) | 补丁生成、版本控制 |
context_diff() |
生成上下文差异格式 | 传统 diff 工具兼容 |
3.3 符号理解
在使用 Differ 类输出对比结果时,会看到以下符号:
| 符号 | 含义 |
|---|---|
- |
包含在第一个序列行中,但不包含在第二个序列中(被删除) |
+ |
包含在第二个序列行中,但不包含在第一个序列中(新增) |
(空格) |
两个序列行一致 |
? |
存在增量差异,用于标记行内差异位置 |
^ |
存在差异字符的具体位置 |
四、为什么要用 difflib?
4.1 零依赖,开箱即用
difflib 是 Python 标准库的一部分,只要你安装了 Python,就可以直接 import difflib 使用,不需要 pip install 任何东西,不需要考虑版本兼容问题,不需要担心第三方库的维护状态。在企业项目中,减少一个依赖就是减少一个风险点。
4.2 功能全面,覆盖绝大多数文本对比场景
从最简单的两行文本对比,到复杂的文件差异 HTML 报告,再到模糊匹配和相似度计算,difflib 几乎覆盖了所有常见的文本对比需求。对于 90% 的业务场景,你不需要引入任何第三方库。
4.3 算法成熟,结果可靠
difflib 底层使用的是 Ratcliff/Obershelp 算法(也称为 Gestalt Pattern Matching),这是一种基于最长公共子序列的模式匹配算法,经过了 20 多年的工业级验证。它的相似度计算结果符合人类直觉,在文本去重、模糊匹配等场景中表现稳定。
4.4 输出格式丰富,便于集成
difflib 支持多种输出格式:纯文本差异、HTML 可视化报告、统一差异格式(git diff 兼容)、上下文差异格式。无论你是要在控制台打印、在网页展示、还是通过邮件发送,都能找到合适的格式。
4.5 性能足够,中小文本无压力
对于日常业务中的配置文件、代码片段、文档段落等中小文本(几千行以内),difflib 的性能完全够用。只有在处理超大规模文本(百万行级别)或需要极高吞吐量时,才需要考虑 C 扩展的第三方库。
五、difflib 是怎么演进过来的?
要理解 difflib 的设计思想,我们需要把时间线拉回到半个世纪前。
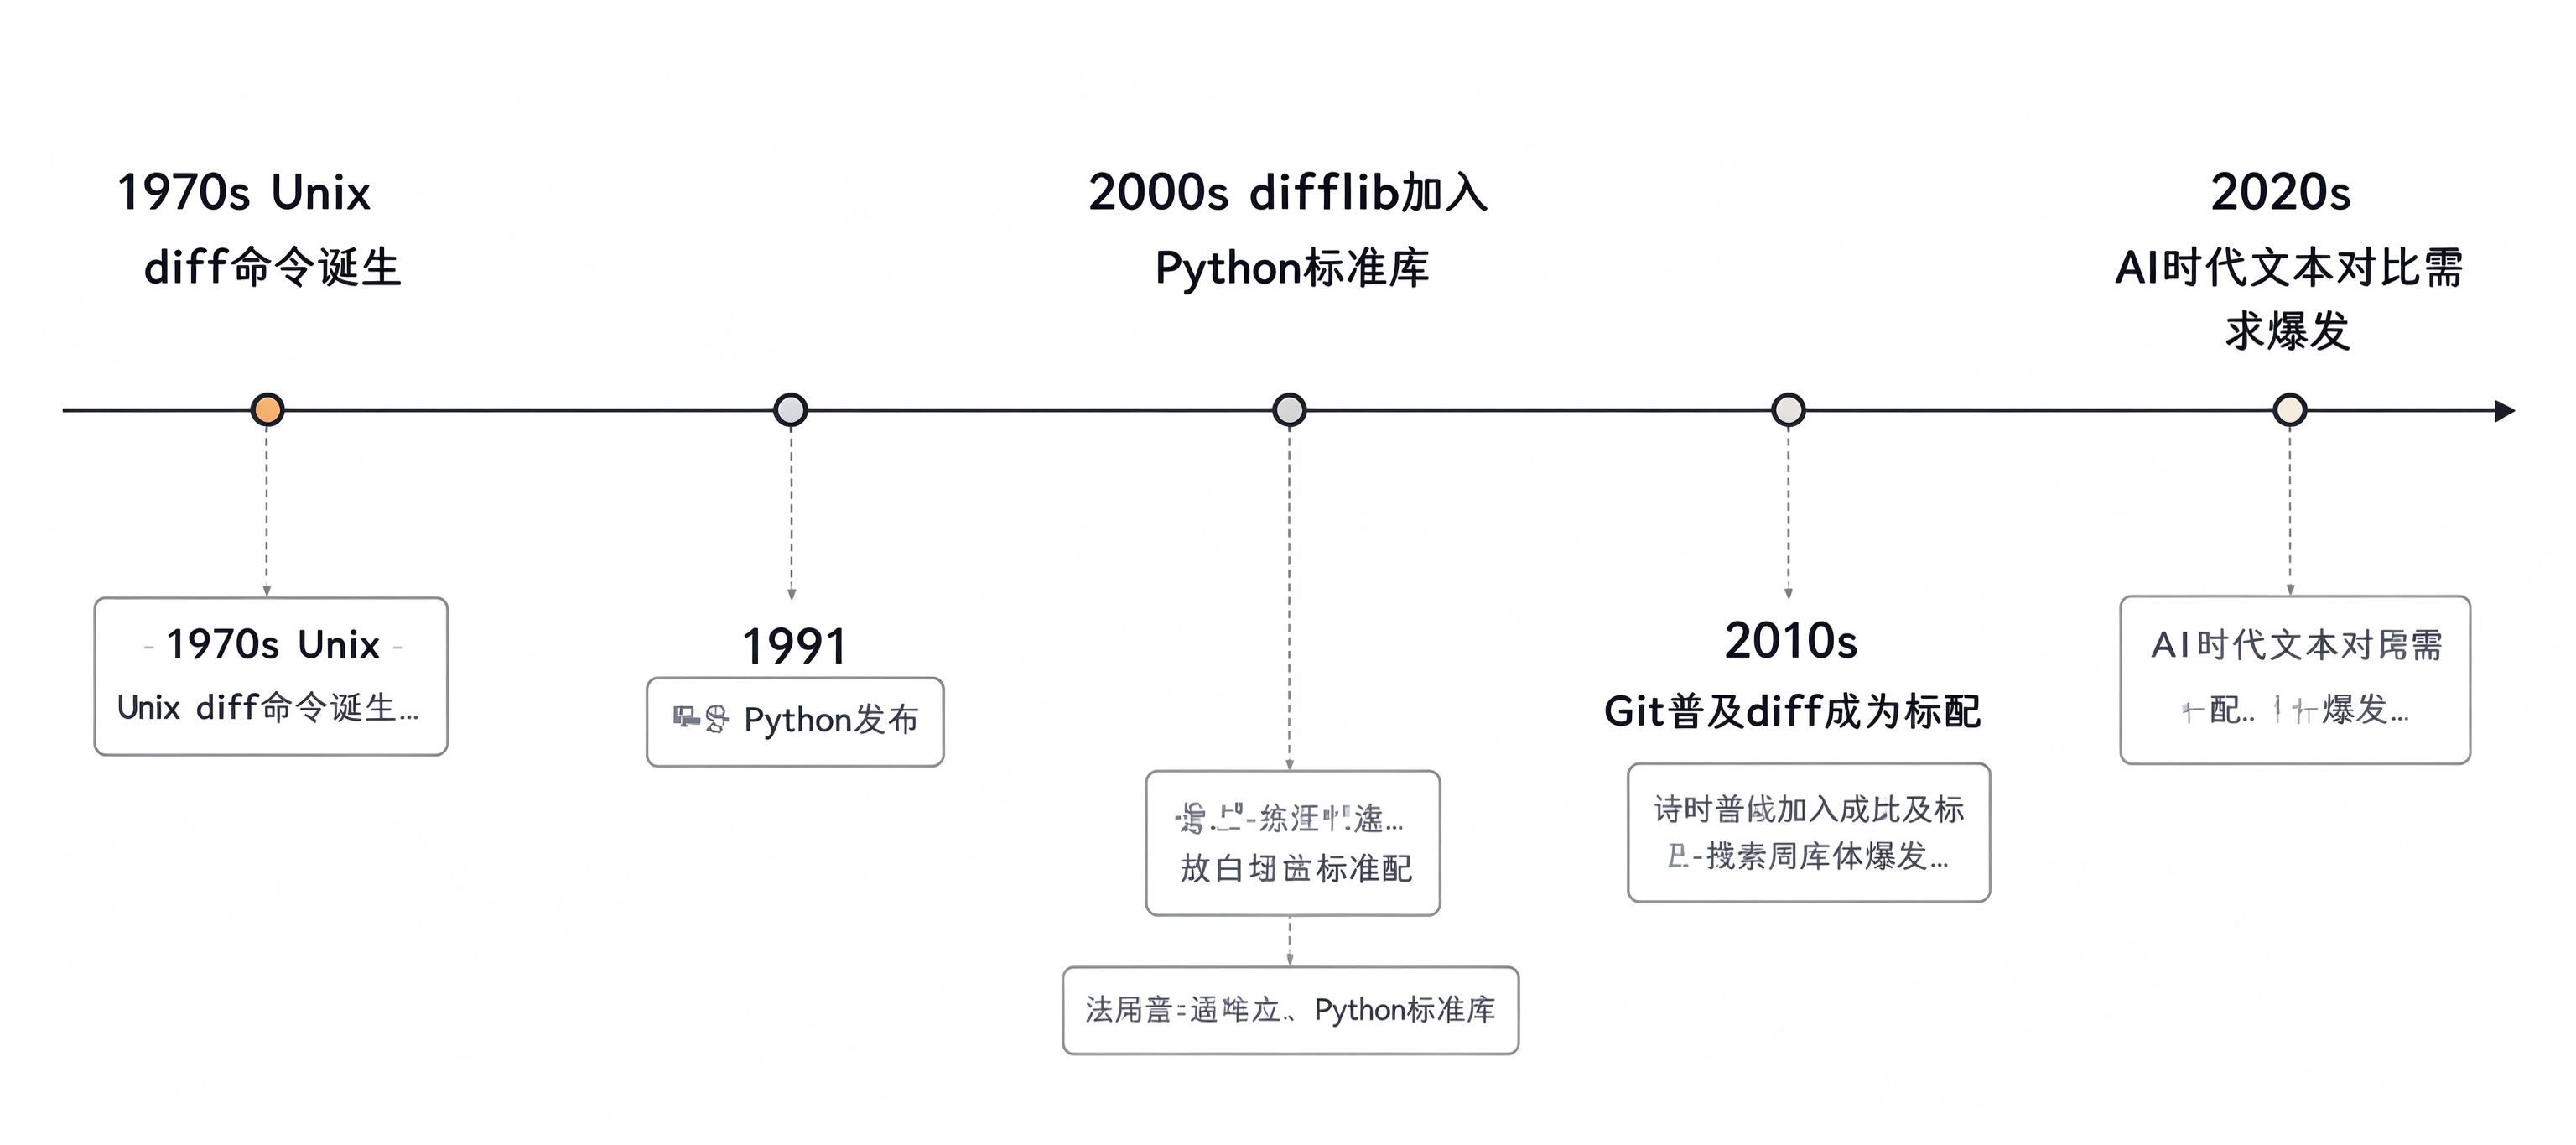
5.1 1970s:Unix diff 命令诞生
1974 年,贝尔实验室的工程师 Douglas McIlroy 在 Unix 系统上开发了 diff 命令,这是人类历史上第一个自动化文件对比工具。它基于 Hunt-Szymanski 算法,能够逐行比较两个文件的差异,并输出标准化的差异格式。在此之前,程序员们只能用肉眼对比打印在纸上的代码。
diff 命令的诞生彻底改变了软件开发的协作方式,为后来的版本控制系统(SCCS、RCS、CVS、SVN、Git)奠定了基础。
5.2 1991:Python 发布
1991 年,Guido van Rossum 发布了 Python 编程语言。Python 的设计哲学是"开箱即用"(Batteries Included),致力于提供一个功能强大的标准库,让开发者不需要到处找第三方包就能完成大多数任务。
5.3 2000s:difflib 加入 Python 标准库
Python 2.1(2001 年发布)首次将 difflib 模块纳入标准库。它的设计灵感直接来源于 Unix 的 diff 命令,但用纯 Python 实现,并增加了更多面向对象的 API 和 HTML 输出功能。
此时的 difflib 已经包含了 Differ、SequenceMatcher 和 HtmlDiff 等核心类,基本框架一直延续至今。
5.4 2010s:Git 普及,diff 成为开发者标配
2010 年代,Git 逐渐成为版本控制的事实标准,git diff 命令成为每个开发者每天必用的工具。统一差异格式(unified diff)成为代码审查、补丁提交的通用语言。difflib 的 unified_diff() 函数也因此被广泛用于生成 Git 兼容的差异补丁。
5.5 2020s:AI 时代,文本对比需求爆发
进入 2020 年代,随着大语言模型的普及,文本对比的需求迎来了爆发式增长:
- AI 输出审核:对比模型生成的文本和人工审核版本的差异
- 文档智能比对:合同、法律文书的自动化差异检测
- 代码变更分析:AI 生成代码的变更审查和安全审计
- 数据去重与清洗:大规模文本数据的相似度计算和去重
- 智能纠错推荐:用户输入错误时的智能提示和纠正
difflib 作为 Python 生态中最基础的文本对比工具,在这些新兴场景中依然发挥着重要作用。
六、difflib 怎么用?
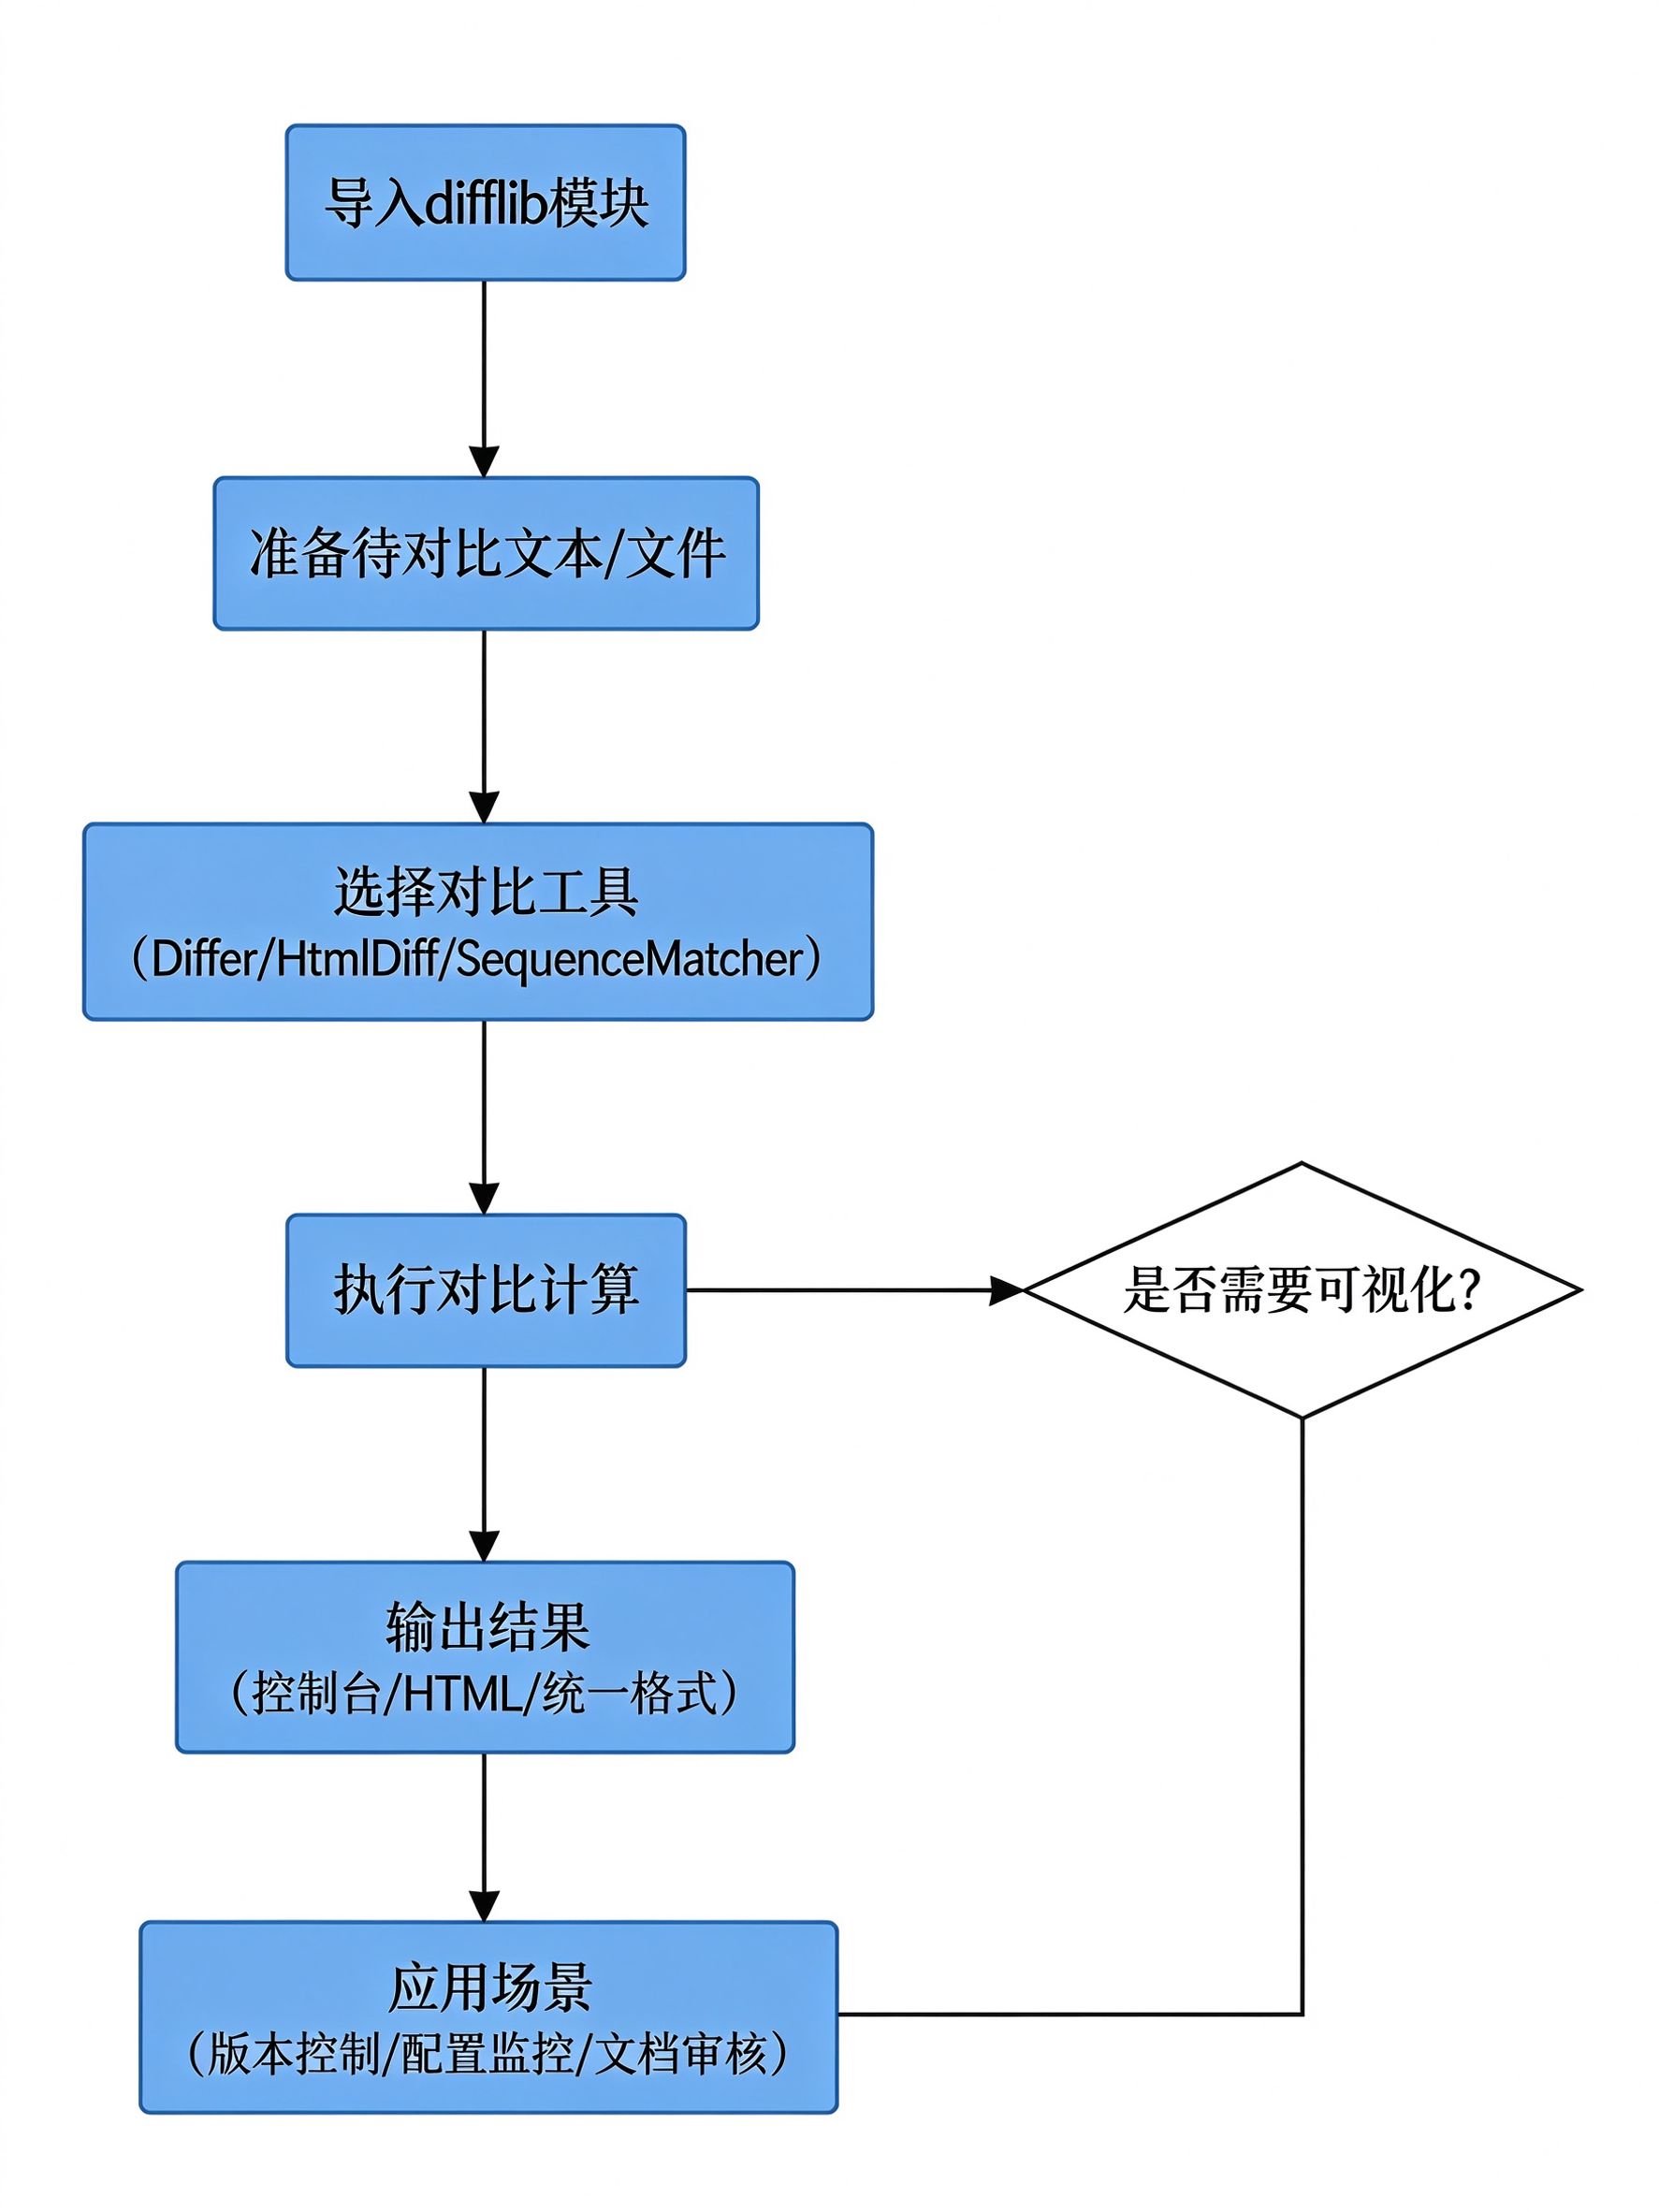
6.1 基础文本对比:Differ 类
最基础的用法是使用 Differ 类对比两段文本,输出带符号的差异结果。
python
import difflib

text1 = """Beautiful is better than ugly.
Explicit is better than implicit.
Simple is better than complex.
Complex is better than complicated.
""".splitlines(keepends=True)

text2 = """Beautiful is better than ugly.
Simple is better than complex.
Complicated is better than complex.
Flat is better than nested.
""".splitlines(keepends=True)

d = difflib.Differ()
diff_result = list(d.compare(text1, text2))
print(''.join(diff_result))
输出结果:
text
  Beautiful is better than ugly.
- Explicit is better than implicit.
  Simple is better than complex.
- Complex is better than complicated.
+ Complicated is better than complex.
+ Flat is better than nested.可以看到,- 开头的行是 text1 中有但 text2 中没有的,+ 开头的行是 text2 中新增的,空格开头的行是两者一致的。
6.2 生成可视化 HTML 报告:HtmlDiff 类
如果需要把对比结果展示给非技术人员看,或者需要通过邮件发送,HtmlDiff 类可以生成 side-by-side 的 HTML 可视化报告,用颜色高亮差异。
python
import difflib

text1 = """  1. Beautiful is better than ugly.
       2. Explicit is better than implicit.
       3. Simple is better than complex.
       4. Complex is better than complicated.
""".splitlines(keepends=True)

text2 = """  1. Beautiful is better than ugly.
       3.   Simple is better than complex.
       4. Complicated is better than complex.
       5. Flat is better than nested.
""".splitlines(keepends=True)

d = difflib.HtmlDiff()
html_content = d.make_file(text1, text2)

with open('diff.html', 'w', encoding='utf-8') as f:
    f.write(html_content)

print("HTML 报告已生成: diff.html")
用浏览器打开 diff.html,就能看到左右两栏并排对比,新增行用绿色高亮,删除行用红色高亮,一目了然。
6.3 计算文本相似度:SequenceMatcher
SequenceMatcher 是 difflib 中最强大的类,它可以计算任意两个序列的相似度,返回一个 0 到 1 之间的浮点数,1 表示完全相同,0 表示完全不同。
python
from difflib import SequenceMatcher

# 示例1:完全相同的字符串
s1 = "Hello, World!"
s2 = "Hello, World!"
ratio = SequenceMatcher(None, s1, s2).ratio()
print(f"相似度: {ratio:.4f}")  # 相似度: 1.0000

# 示例2:部分相似的字符串
s3 = "Hello, World!"
s4 = "Hello, Python!"
ratio2 = SequenceMatcher(None, s3, s4).ratio()
print(f"相似度: {ratio2:.4f}")  # 相似度: 0.6923

# 示例3:完全不同的字符串
s5 = "abcdef"
s6 = "xyz123"
ratio3 = SequenceMatcher(None, s5, s6).ratio()
print(f"相似度: {ratio3:.4f}")  # 相似度: 0.0000
SequenceMatcher 还可以获取详细的匹配块信息:
python
from difflib import SequenceMatcher

s1 = "python is great"
s2 = "python is awesome"

matcher = SequenceMatcher(None, s1, s2)

# 获取所有匹配块
for block in matcher.get_matching_blocks():
    print(f"匹配块: s1[{block.a}:{block.a+block.size}] == s2[{block.b}:{block.b+block.size}], 长度={block.size}")

# 获取操作码(替换/删除/插入/相等)
for tag, i1, i2, j1, j2 in matcher.get_opcodes():
    print(f"操作: {tag:8s} s1[{i1}:{i2}] -> s2[{j1}:{j2}]")
6.4 智能模糊匹配:get_close_matches
get_close_matches() 函数可以从一个候选列表中找出与目标词最相似的前 N 个匹配项,非常适合做命令纠错、拼写检查、智能推荐。
python
from difflib import get_close_matches

# 示例1:命令纠错
commands = ["status", "commit", "push", "pull", "clone", "checkout", "merge"]
user_input = "statsu"  # 用户拼错了
matches = get_close_matches(user_input, commands, n=3, cutoff=0.6)
print(f"你是不是想输入: {matches}")  # 你是不是想输入: ['status']

# 示例2:单词拼写检查
words = ["apple", "banana", "cherry", "date", "elderberry"]
typo = "appel"
suggestions = get_close_matches(typo, words, n=2, cutoff=0.5)
print(f"建议: {suggestions}")  # 建议: ['apple']

# 示例3:KeyError 智能提示
config = {"host": "localhost", "port": 8080, "debug": True, "timeout": 30}

def get_config(key):
    if key in config:
        return config[key]
    suggestions = get_close_matches(key, config.keys(), n=3, cutoff=0.4)
    if suggestions:
        raise KeyError(f"配置项 '{key}' 不存在,你是不是想找: {suggestions}")
    raise KeyError(f"配置项 '{key}' 不存在")

try:
    get_config("hst")
except KeyError as e:
    print(e)  # "配置项 'hst' 不存在,你是不是想找: ['host']"
6.5 生成统一差异格式:unified_diff
unified_diff() 函数生成 Git 兼容的统一差异格式,可以直接用于生成补丁文件。
python
import difflib

original = """line1
line2
line3
line4
line5
""".splitlines(keepends=True)

modified = """line1
line2 modified
line3
line4 new
line5
""".splitlines(keepends=True)

diff = difflib.unified_diff(
    original,
    modified,
    fromfile='original.txt',
    tofile='modified.txt',
    lineterm=''
)

print('\n'.join(diff))
输出结果:
diff
--- original.txt
+++ modified.txt
@@ -1,5 +1,5 @@
 line1
-line2
+line2 modified
 line3
-line4
+line4 new
 line5
这个格式和 git diff 的输出完全一致,可以直接用 patch 命令应用。
6.6 对比两个文件
实际项目中最常见的需求是对比两个文件的内容差异。
python
import difflib

def compare_files(file1_path, file2_path, output_html='file_diff.html'):
    """对比两个文件并生成 HTML 差异报告"""
    with open(file1_path, 'r', encoding='utf-8') as f1:
        content1 = f1.read().splitlines(keepends=True)

    with open(file2_path, 'r', encoding='utf-8') as f2:
        content2 = f2.read().splitlines(keepends=True)

    d = difflib.HtmlDiff()
    html_content = d.make_file(content1, content2, fromdesc=file1_path, todesc=file2_path)

    with open(output_html, 'w', encoding='utf-8') as f:
        f.write(html_content)

    print(f"差异报告已生成: {output_html}")

# 使用示例
compare_files('config_backup.yaml', 'config_current.yaml', 'config_diff.html')
七、企业项目中的实战应用
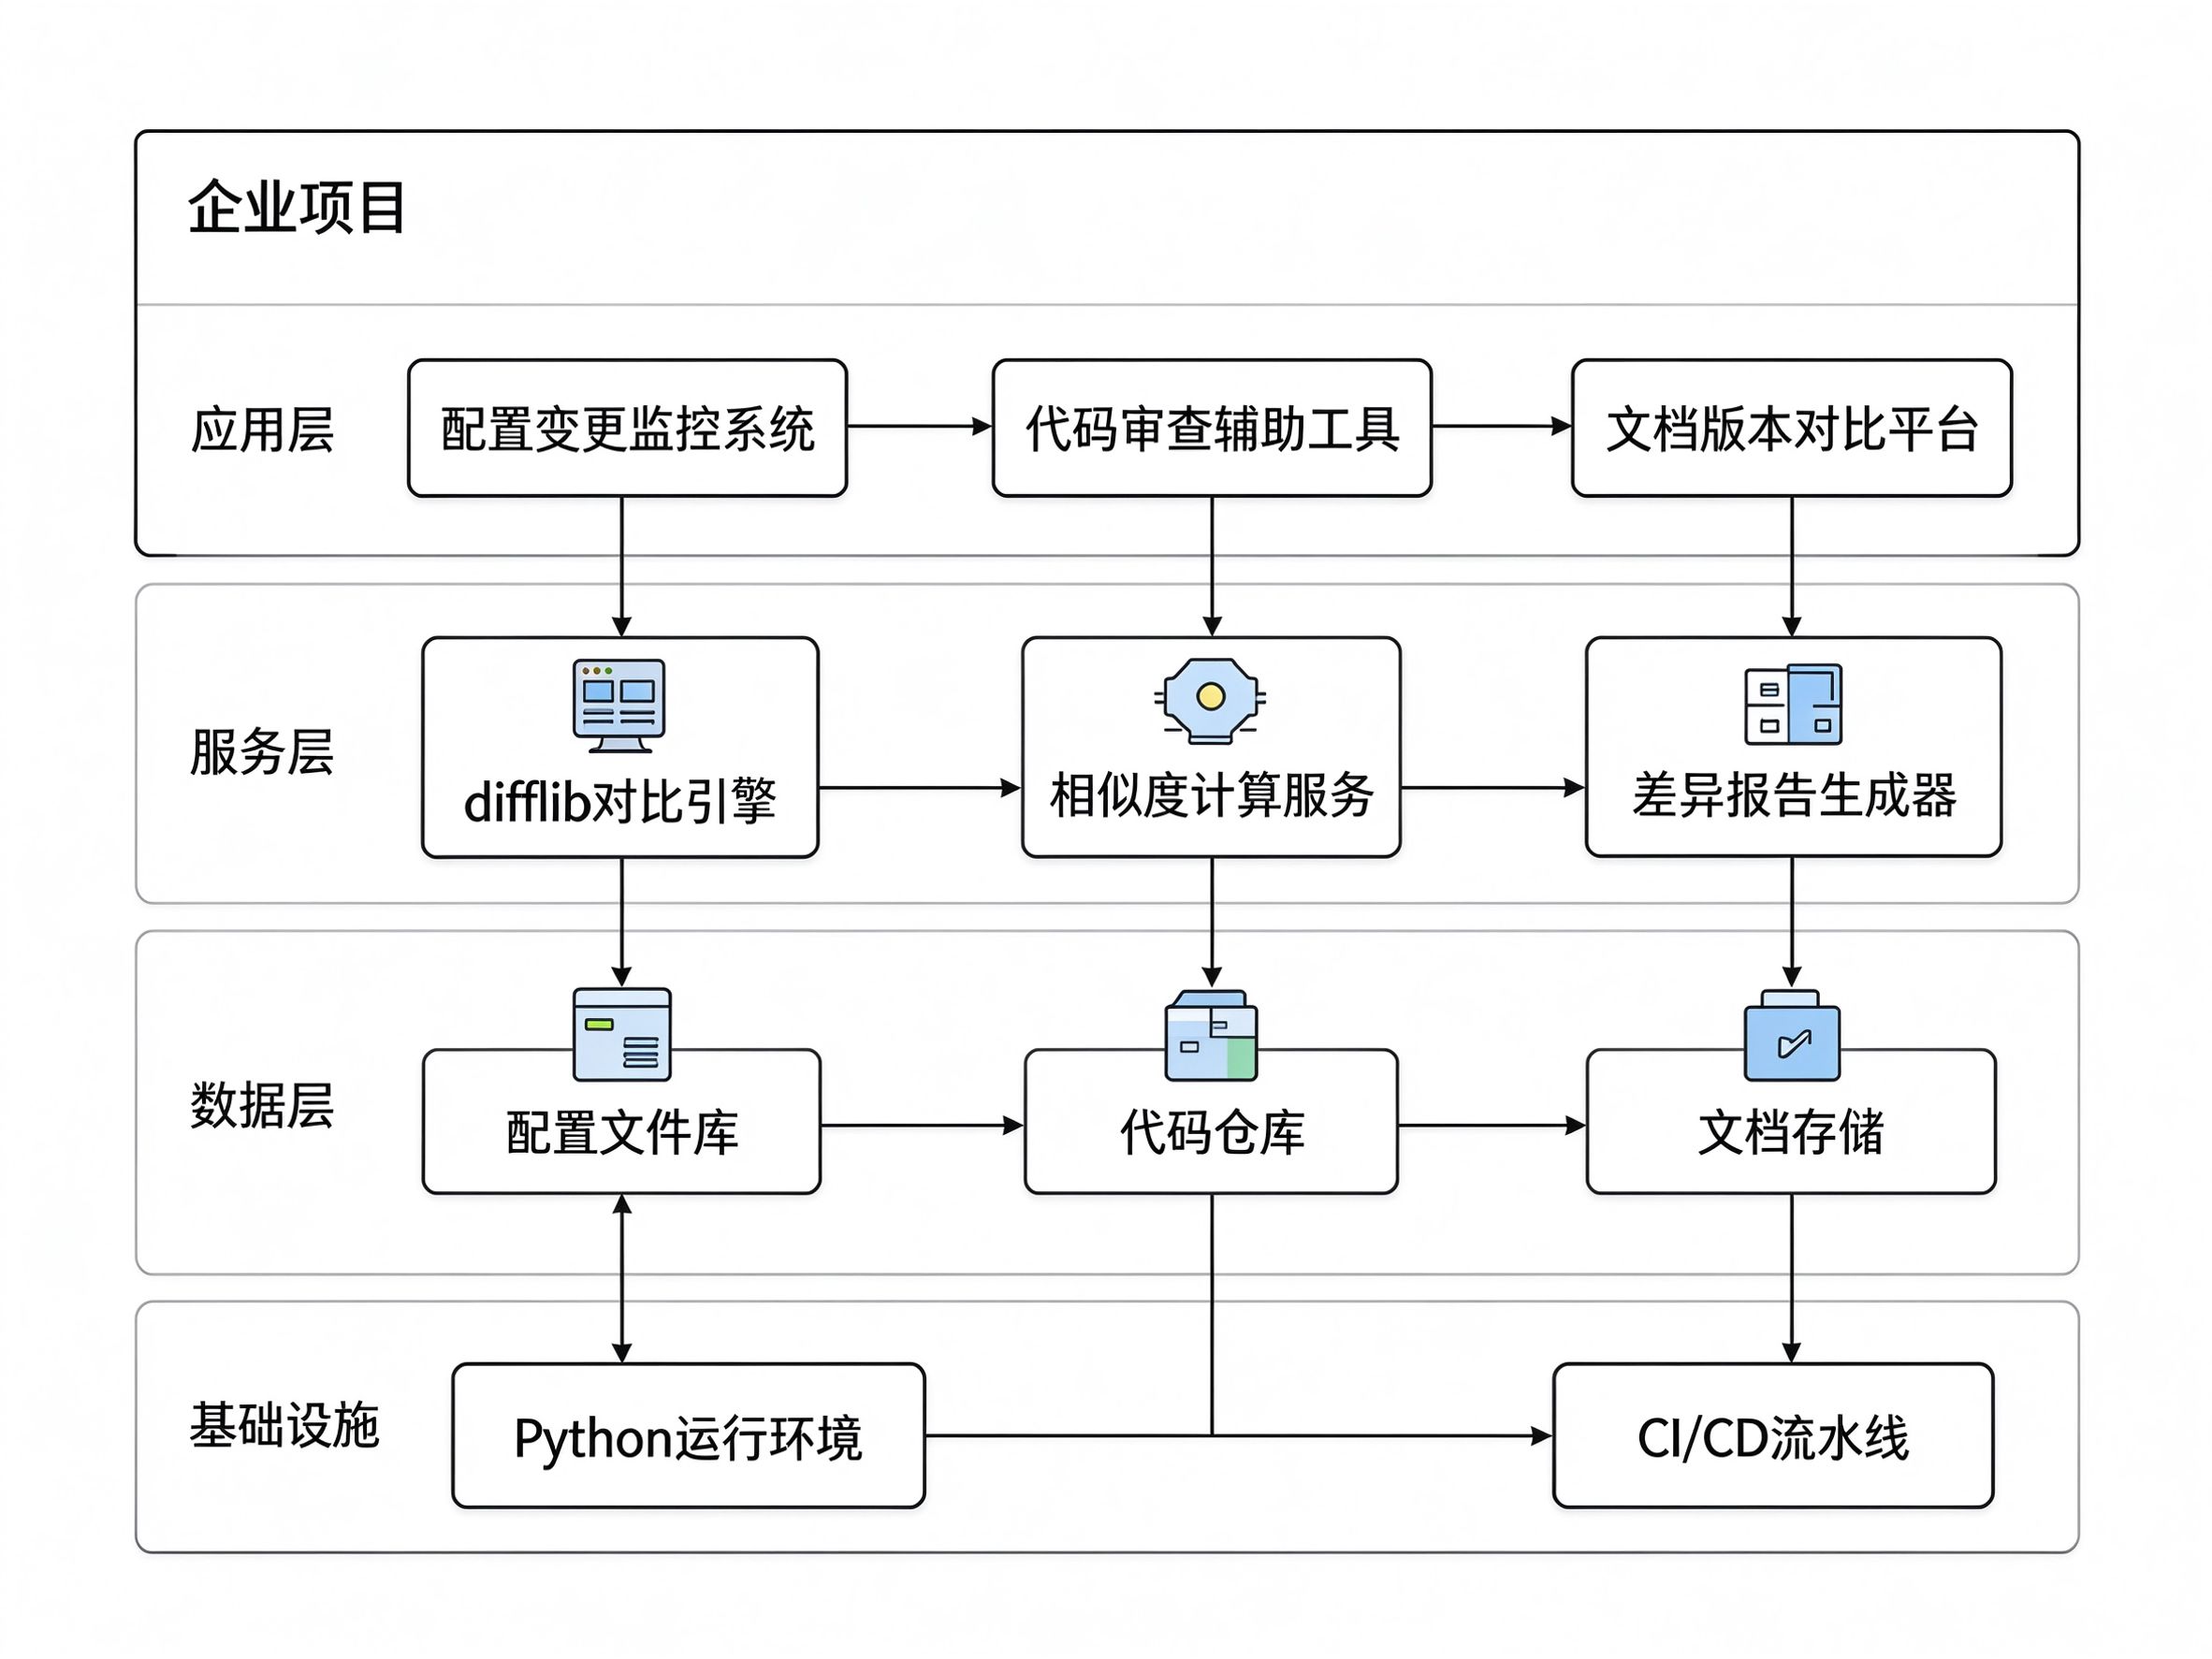
理论讲完了,下面来看 difflib 在真实企业项目中的四个实战应用场景,每个都附带可直接运行的代码。
7.1 实战一:配置文件变更监控系统
背景:某电商平台有 50 多台服务器,每台服务器上有 Nginx、Redis、MySQL 等十几个配置文件。运维团队需要每天自动检查配置文件是否被意外修改,如果有变更,自动生成差异报告并发送告警邮件。
解决方案:使用 difflib 对比每日备份的配置文件和当前配置文件,生成 HTML 差异报告,通过邮件发送给运维团队。
python
import os
import difflib
import smtplib
from email.mime.text import MIMEText
from email.mime.multipart import MIMEMultipart
from datetime import datetime

class ConfigChangeMonitor:
    """配置文件变更监控器"""

    def __init__(self, backup_dir, current_dir, config_files):
        self.backup_dir = backup_dir
        self.current_dir = current_dir
        self.config_files = config_files
        self.changes = []

    def scan_changes(self):
        """扫描所有配置文件的变更"""
        for filename in self.config_files:
            backup_path = os.path.join(self.backup_dir, filename)
            current_path = os.path.join(self.current_dir, filename)

            if not os.path.exists(backup_path) or not os.path.exists(current_path):
                continue

            with open(backup_path, 'r', encoding='utf-8') as f:
                backup_content = f.read().splitlines(keepends=True)

            with open(current_path, 'r', encoding='utf-8') as f:
                current_content = f.read().splitlines(keepends=True)

            if backup_content != current_content:
                similarity = difflib.SequenceMatcher(None, backup_content, current_content).ratio()
                self.changes.append({
                    'filename': filename,
                    'similarity': similarity,
                    'backup': backup_content,
                    'current': current_content
                })

        return self.changes

    def generate_html_report(self):
        """生成汇总 HTML 报告"""
        html_parts = [f"<h1>配置文件变更报告 - {datetime.now().strftime('%Y-%m-%d %H:%M')}</h1>"]
        html_parts.append(f"<p>共检测到 {len(self.changes)} 个配置文件发生变更</p>")

        for change in self.changes:
            html_parts.append(f"<h2>{change['filename']} (相似度: {change['similarity']:.2%})</h2>")
            d = difflib.HtmlDiff()
            html_parts.append(d.make_table(change['backup'], change['current'],
                                           fromdesc='备份版本', todesc='当前版本'))

        return '\n'.join(html_parts)

    def send_alert_email(self, smtp_server, smtp_port, sender, password, recipients):
        """发送告警邮件"""
        if not self.changes:
            print("无配置变更,无需发送告警")
            return

        msg = MIMEMultipart()
        msg['Subject'] = f"[配置变更告警] 检测到 {len(self.changes)} 个配置文件变更"
        msg['From'] = sender
        msg['To'] = ', '.join(recipients)

        html_report = self.generate_html_report()
        msg.attach(MIMEText(html_report, 'html', 'utf-8'))

        with smtplib.SMTP_SSL(smtp_server, smtp_port) as server:
            server.login(sender, password)
            server.sendmail(sender, recipients, msg.as_string())

        print(f"告警邮件已发送至: {recipients}")

# 使用示例
if __name__ == '__main__':
    monitor = ConfigChangeMonitor(
        backup_dir='/data/backup/configs',
        current_dir='/etc',
        config_files=['nginx/nginx.conf', 'redis/redis.conf', 'mysql/my.cnf']
    )

    changes = monitor.scan_changes()
    if changes:
        print(f"检测到 {len(changes)} 个配置文件变更")
        for c in changes:
            print(f"  - {c['filename']}: 相似度 {c['similarity']:.2%}")
        # monitor.send_alert_email('smtp.example.com', 465, 'ops@example.com', 'password', ['team@example.com'])
    else:
        print("所有配置文件未发生变更")
7.2 实战二:代码审查辅助工具
背景:某金融科技公司的代码审查流程中,审查者需要快速了解 PR 中到底改了哪些核心逻辑,而不是被格式化改动、注释修改等噪音干扰。团队需要一个工具,能自动提取代码变更中的"实质性修改",并计算变更比例。
解决方案 :使用 difflib 的 SequenceMatcher 计算变更比例,使用 get_opcodes() 分类变更类型,过滤掉纯空白和注释的变更。
python
import difflib
import re

class CodeChangeAnalyzer:
    """代码变更分析器"""

    def __init__(self):
        self.comment_patterns = {
            'py': r'^\s*#',
            'js': r'^\s*//',
            'java': r'^\s*//',
            'go': r'^\s*//',
            'sql': r'^\s*--',
        }

    def is_comment_line(self, line, language):
        """判断是否为注释行"""
        pattern = self.comment_patterns.get(language, r'^\s*#')
        return bool(re.match(pattern, line))

    def is_blank_line(self, line):
        """判断是否为空白行"""
        return line.strip() == ''

    def analyze_changes(self, old_code, new_code, language='py'):
        """分析代码变更,返回详细统计"""
        old_lines = old_code.splitlines(keepends=True)
        new_lines = new_code.splitlines(keepends=True)

        matcher = difflib.SequenceMatcher(None, old_lines, new_lines)

        stats = {
            'total_old_lines': len(old_lines),
            'total_new_lines': len(new_lines),
            'added_lines': 0,
            'deleted_lines': 0,
            'modified_lines': 0,
            'unchanged_lines': 0,
            'substantive_changes': 0,
            'noise_changes': 0,
            'change_ratio': 0.0,
            'details': []
        }

        for tag, i1, i2, j1, j2 in matcher.get_opcodes():
            if tag == 'equal':
                stats['unchanged_lines'] += (i2 - i1)
            elif tag == 'insert':
                added = j2 - j1
                stats['added_lines'] += added
                for idx in range(j1, j2):
                    line = new_lines[idx]
                    if self.is_blank_line(line) or self.is_comment_line(line, language):
                        stats['noise_changes'] += 1
                    else:
                        stats['substantive_changes'] += 1
            elif tag == 'delete':
                deleted = i2 - i1
                stats['deleted_lines'] += deleted
                for idx in range(i1, i2):
                    line = old_lines[idx]
                    if self.is_blank_line(line) or self.is_comment_line(line, language):
                        stats['noise_changes'] += 1
                    else:
                        stats['substantive_changes'] += 1
            elif tag == 'replace':
                modified = max(i2 - i1, j2 - j1)
                stats['modified_lines'] += modified
                for idx in range(i1, i2):
                    line = old_lines[idx]
                    if self.is_blank_line(line) or self.is_comment_line(line, language):
                        stats['noise_changes'] += 1
                    else:
                        stats['substantive_changes'] += 1

        total_changes = stats['added_lines'] + stats['deleted_lines'] + stats['modified_lines']
        if stats['total_old_lines'] > 0:
            stats['change_ratio'] = total_changes / stats['total_old_lines']

        return stats

    def generate_review_summary(self, stats):
        """生成代码审查摘要"""
        summary = []
        summary.append("=" * 50)
        summary.append("代码变更审查摘要")
        summary.append("=" * 50)
        summary.append(f"原始行数: {stats['total_old_lines']}")
        summary.append(f"新代码行数: {stats['total_new_lines']}")
        summary.append(f"新增行数: {stats['added_lines']}")
        summary.append(f"删除行数: {stats['deleted_lines']}")
        summary.append(f"修改行数: {stats['modified_lines']}")
        summary.append(f"未变更行数: {stats['unchanged_lines']}")
        summary.append(f"变更比例: {stats['change_ratio']:.2%}")
        summary.append("-" * 50)
        summary.append(f"实质性变更: {stats['substantive_changes']} 行")
        summary.append(f"噪音变更(空白/注释): {stats['noise_changes']} 行")

        if stats['change_ratio'] > 0.5:
            summary.append("[警告] 变更比例超过 50%,建议拆分 PR 以便审查")
        elif stats['change_ratio'] > 0.3:
            summary.append("[提示] 变更比例较大,请重点关注核心逻辑修改")

        if stats['substantive_changes'] == 0 and stats['noise_changes'] > 0:
            summary.append("[提示] 本次变更仅包含空白或注释修改,可快速通过")

        return '\n'.join(summary)

# 使用示例
if __name__ == '__main__':
    old_code = """def calculate_total(items):
    # 计算总价
    total = 0
    for item in items:
        total += item['price'] * item['quantity']
    return total
"""

    new_code = """def calculate_total(items, discount=0):
    # 计算总价(支持折扣)
    total = 0
    for item in items:
        total += item['price'] * item['quantity']
    if discount > 0:
        total = total * (1 - discount)
    return round(total, 2)
"""

    analyzer = CodeChangeAnalyzer()
    stats = analyzer.analyze_changes(old_code, new_code, language='py')
    print(analyzer.generate_review_summary(stats))
7.3 实战三:文档版本对比平台
背景:某律所需要一个内部工具,能自动对比两份合同文档的差异,精确到每个字,帮助律师快速定位条款修改,避免漏审风险。
解决方案 :使用 difflib 的 SequenceMatcher 进行字符级对比,生成精确到字的差异标注。
python
import difflib

class DocumentComparator:
    """文档精确对比器"""

    def compare_char_level(self, text1, text2):
        """字符级对比,返回差异片段列表"""
        matcher = difflib.SequenceMatcher(None, text1, text2)
        diff_segments = []

        for tag, i1, i2, j1, j2 in matcher.get_opcodes():
            if tag == 'equal':
                diff_segments.append({
                    'type': 'equal',
                    'content': text1[i1:i2]
                })
            elif tag == 'replace':
                diff_segments.append({
                    'type': 'delete',
                    'content': text1[i1:i2]
                })
                diff_segments.append({
                    'type': 'insert',
                    'content': text2[j1:j2]
                })
            elif tag == 'delete':
                diff_segments.append({
                    'type': 'delete',
                    'content': text1[i1:i2]
                })
            elif tag == 'insert':
                diff_segments.append({
                    'type': 'insert',
                    'content': text2[j1:j2]
                })

        return diff_segments

    def generate_html_diff(self, text1, text2, title='文档对比报告'):
        """生成带高亮的 HTML 对比报告"""
        segments = self.compare_char_level(text1, text2)

        html_parts = [f"<h1>{title}</h1>"]
        html_parts.append('<div style="font-family: monospace; font-size: 14px; line-height: 1.8; padding: 20px; background: #fff; border: 1px solid #ddd;">')

        for seg in segments:
            if seg['type'] == 'equal':
                html_parts.append(f'<span>{seg["content"]}</span>')
            elif seg['type'] == 'delete':
                html_parts.append(f'<span style="background-color: #ffebee; color: #c62828; text-decoration: line-through;">{seg["content"]}</span>')
            elif seg['type'] == 'insert':
                html_parts.append(f'<span style="background-color: #e8f5e9; color: #2e7d32;">{seg["content"]}</span>')

        html_parts.append('</div>')

        # 统计信息
        deleted_count = sum(len(s['content']) for s in segments if s['type'] == 'delete')
        inserted_count = sum(len(s['content']) for s in segments if s['type'] == 'insert')
        similarity = difflib.SequenceMatcher(None, text1, text2).ratio()

        html_parts.append(f'<p style="margin-top: 20px;">')
        html_parts.append(f'删除字符数: <strong>{deleted_count}</strong> | ')
        html_parts.append(f'新增字符数: <strong>{inserted_count}</strong> | ')
        html_parts.append(f'文本相似度: <strong>{similarity:.2%}</strong>')
        html_parts.append('</p>')

        return '\n'.join(html_parts)

    def find_clause_changes(self, text1, text2, clause_markers):
        """定位特定条款的变更"""
        changes = []
        for marker in clause_markers:
            # 在两个文本中查找条款位置
            idx1 = text1.find(marker)
            idx2 = text2.find(marker)

            if idx1 == -1 and idx2 == -1:
                continue
            elif idx1 == -1:
                changes.append({'clause': marker, 'status': '新增条款'})
            elif idx2 == -1:
                changes.append({'clause': marker, 'status': '删除条款'})
            else:
                # 提取条款内容(假设条款到下一个条款标记或文档结束)
                next_marker1 = len(text1)
                next_marker2 = len(text2)
                for m in clause_markers:
                    if m != marker:
                        ni1 = text1.find(m, idx1 + 1)
                        ni2 = text2.find(m, idx2 + 1)
                        if ni1 != -1:
                            next_marker1 = min(next_marker1, ni1)
                        if ni2 != -1:
                            next_marker2 = min(next_marker2, ni2)

                clause1 = text1[idx1:next_marker1]
                clause2 = text2[idx2:next_marker2]

                if clause1 != clause2:
                    sim = difflib.SequenceMatcher(None, clause1, clause2).ratio()
                    changes.append({
                        'clause': marker,
                        'status': '已修改',
                        'similarity': sim
                    })

        return changes

# 使用示例
if __name__ == '__main__':
    contract_v1 = """甲方:北京科技有限公司
乙方:上海贸易有限公司

第一条 合同金额
本合同总金额为人民币 100,000 元整。

第二条 付款方式
甲方应在合同签订后 30 日内支付全部款项。

第三条 违约责任
任何一方违约,应向对方支付合同总金额 5% 的违约金。
"""

    contract_v2 = """甲方:北京科技有限公司
乙方:上海贸易有限公司

第一条 合同金额
本合同总金额为人民币 120,000 元整。

第二条 付款方式
甲方应在合同签订后 15 日内支付全部款项。

第三条 违约责任
任何一方违约,应向对方支付合同总金额 15% 的违约金。

第四条 保密条款
双方应对本合同内容承担保密义务。
"""

    comparator = DocumentComparator()

    # 生成字符级 HTML 对比报告
    html = comparator.generate_html_diff(contract_v1, contract_v2, '合同版本对比报告')
    with open('contract_diff.html', 'w', encoding='utf-8') as f:
        f.write(html)
    print("合同对比报告已生成: contract_diff.html")

    # 定位特定条款变更
    clause_changes = comparator.find_clause_changes(
        contract_v1, contract_v2,
        ['第一条', '第二条', '第三条', '第四条']
    )
    print("\n条款变更明细:")
    for change in clause_changes:
        if 'similarity' in change:
            print(f"  {change['clause']}: {change['status']} (相似度: {change['similarity']:.2%})")
        else:
            print(f"  {change['clause']}: {change['status']}")
7.4 实战四:智能纠错与推荐系统
背景:某 SaaS 平台的命令行工具有上百个命令和参数,用户经常拼错命令导致报错。产品经理要求实现类似 Git 的智能纠错功能,当用户输入错误命令时,自动推荐最可能的正确命令。
解决方案 :使用 difflib 的 get_close_matches() 实现命令纠错,使用 SequenceMatcher 实现参数推荐。
python
from difflib import get_close_matches, SequenceMatcher

class SmartCLI:
    """智能命令行助手"""

    def __init__(self):
        self.commands = {
            'deploy': '部署应用到指定环境',
            'rollback': '回滚到上一个版本',
            'status': '查看应用运行状态',
            'logs': '查看应用日志',
            'restart': '重启应用',
            'stop': '停止应用',
            'scale': '扩缩容应用实例',
            'config': '管理应用配置',
            'secret': '管理应用密钥',
            'domain': '管理域名绑定',
            'cert': '管理SSL证书',
            'backup': '备份应用数据',
            'restore': '恢复应用数据',
            'migrate': '执行数据库迁移',
            'health': '健康检查',
        }
        self.aliases = {
            'dep': 'deploy',
            'rb': 'rollback',
            'st': 'status',
            'log': 'logs',
            'rs': 'restart',
        }

    def resolve_command(self, user_input):
        """解析用户输入的命令"""
        # 精确匹配
        if user_input in self.commands:
            return {'found': True, 'command': user_input, 'suggestions': []}

        # 别名匹配
        if user_input in self.aliases:
            actual = self.aliases[user_input]
            return {'found': True, 'command': actual, 'suggestions': [], 'via_alias': user_input}

        # 模糊匹配推荐
        all_commands = list(self.commands.keys()) + list(self.aliases.keys())
        suggestions = get_close_matches(user_input, all_commands, n=3, cutoff=0.5)

        # 如果相似度很高,自动纠正
        if suggestions:
            best = suggestions[0]
            best_ratio = SequenceMatcher(None, user_input, best).ratio()
            if best_ratio >= 0.8:
                actual = self.aliases.get(best, best)
                return {
                    'found': True,
                    'command': actual,
                    'suggestions': [],
                    'auto_corrected': True,
                    'original_input': user_input
                }

        return {'found': False, 'command': None, 'suggestions': suggestions}

    def execute(self, user_input):
        """执行命令"""
        result = self.resolve_command(user_input)

        if result['found']:
            cmd = result['command']
            if result.get('auto_corrected'):
                print(f"提示: '{result['original_input']}' 未找到,已自动纠正为 '{cmd}'")
            elif result.get('via_alias'):
                print(f"提示: '{result['via_alias']}' 是 '{cmd}' 的别名")

            print(f"正在执行: {cmd} - {self.commands[cmd]}")
            return True
        else:
            print(f"错误: 未知命令 '{user_input}'")
            if result['suggestions']:
                print("你是不是想输入:")
                for i, s in enumerate(result['suggestions'], 1):
                    actual = self.aliases.get(s, s)
                    print(f"  {i}. {s} -> {actual} ({self.commands.get(actual, '')})")
            else:
                print("输入 'help' 查看所有可用命令")
            return False

    def fuzzy_search_params(self, query, param_list):
        """参数模糊搜索"""
        scored = []
        for param in param_list:
            ratio = SequenceMatcher(None, query.lower(), param.lower()).ratio()
            # 额外奖励:前缀匹配
            if param.lower().startswith(query.lower()):
                ratio += 0.2
            scored.append((param, ratio))

        scored.sort(key=lambda x: x[1], reverse=True)
        return [(p, r) for p, r in scored if r >= 0.4][:5]

# 使用示例
if __name__ == '__main__':
    cli = SmartCLI()

    print("=== 测试1: 精确匹配 ===")
    cli.execute('deploy')

    print("\n=== 测试2: 别名匹配 ===")
    cli.execute('dep')

    print("\n=== 测试3: 高相似度自动纠正 ===")
    cli.execute('depliy')

    print("\n=== 测试4: 低相似度推荐 ===")
    cli.execute('stat')

    print("\n=== 测试5: 完全不相关 ===")
    cli.execute('xyz')

    print("\n=== 测试6: 参数模糊搜索 ===")
    params = ['--environment', '--env', '--region', '--replicas', '--image', '--port', '--namespace']
    results = cli.fuzzy_search_params('env', params)
    print("搜索 'env' 的参数推荐:")
    for param, score in results:
        print(f"  {param} (匹配度: {score:.2f})")
八、竞品对比:difflib vs 其他文本对比工具
虽然 difflib 功能强大,但它并不是唯一的文本对比工具。下面从多个维度对比 difflib 和几个主流竞品,帮你在不同场景下做出正确选择。
| 对比维度 | difflib(Python标准库) | python-Levenshtein | rapidfuzz | google-diff-match-patch | jsdiff(JavaScript) |
|---|---|---|---|---|---|
| 语言 | Python | Python(C扩展) | Python(C++后端) | 多语言(Python/JS/Java/C++) | JavaScript |
| 是否标准库 | 是 | 否 | 否 | 否 | 否 |
| 安装方式 | 无需安装 | pip install python-Levenshtein | pip install rapidfuzz | pip install diff-match-patch | npm install diff |
| 核心算法 | Ratcliff/Obershelp | Levenshtein编辑距离 | Levenshtein(优化版) | Myers diff算法 | 基于LCS的diff算法 |
| 对比粒度 | 行级/字符级/序列级 | 字符级 | 字符级/Token级 | 字符级 | 行级/字符级/Word级 |
| 相似度计算 | 支持(ratio方法) | 支持 | 支持(多种归一化方式) | 不直接支持 | 不直接支持 |
| 模糊匹配 | 支持(get_close_matches) | 需自行实现 | 支持(process.extract) | 不支持 | 不支持 |
| HTML可视化输出 | 支持(HtmlDiff) | 不支持 | 不支持 | 不支持 | 不支持 |
| 统一差异格式 | 支持(unified_diff) | 不支持 | 不支持 | 支持(patch格式) | 支持 |
| 大文本性能 | 中等(O(n*m)) | 优秀(C实现) | 极优(C++实现) | 优秀 | 优秀 |
| 小文本性能 | 良好 | 优秀 | 极优 | 良好 | 良好 |
| 中文支持 | 良好(字符级) | 良好 | 优秀 | 良好 | 良好 |
| 维护状态 | 活跃(Python官方维护) | 维护中 | 非常活跃 | 维护中(Google) | 维护中 |
| 学习成本 | 低(API简洁) | 低 | 中(API较多) | 中 | 低 |
| 企业级可靠性 | 极高(20年验证) | 高 | 高 | 极高(Google内部使用) | 高 |
| 典型应用场景 | 配置对比、文件差异、模糊匹配、命令纠错 | 拼写检查、去重、相似度排序 | 大规模模糊匹配、数据去重 | 在线编辑器协同、补丁生成 | 前端代码对比、富文本差异 |
8.1 各工具的优劣势总结
difflib 优势:
- 零依赖,Python 标准库自带,企业项目中引入零风险
- 功能全面,从行级对比到 HTML 可视化到模糊匹配一站式解决
- API 设计优雅,学习成本极低
- 20 年工业级验证,稳定性极高
difflib 劣势:
- 纯 Python 实现,超大规模文本(百万行级)性能不如 C 扩展库
- 相似度算法单一(只有 Ratcliff/Obershelp),不支持 Jaro-Winkler 等其他算法
- 模糊匹配功能基础,不支持批量处理和多种评分策略
python-Levenshtein 优势:
- C 扩展实现,性能极佳
- 专注编辑距离计算,API 极简
python-Levenshtein 劣势:
- 功能单一,只做编辑距离,不支持差异可视化和 HTML 输出
- 需要编译安装,部分环境可能有兼容性问题
- 模糊匹配需要自行实现
rapidfuzz 优势:
- C++ 后端,性能是所有 Python 文本对比库中最快的之一
- 支持多种相似度算法(Levenshtein、Jaro-Winkler、Hamming 等)
- 内置强大的批量模糊匹配功能(process.extract / extractOne)
- 支持 Token 级别的对比
rapidfuzz 劣势:
- 第三方库,需要安装
- API 较多,学习成本略高
- 不支持 HTML 可视化输出和统一差异格式
google-diff-match-patch 优势:
- Google 出品,可靠性极高
- 多语言支持,跨语言一致性好
- 专注字符级 diff 和 patch 生成,适合在线协同编辑场景
google-diff-match-patch 劣势:
- 不支持相似度计算和模糊匹配
- API 偏底层,需要自己封装
- Python 版本维护相对滞后
8.2 选型建议
- 如果你是 Python 开发者,需求是常规的文件对比、配置监控、简单模糊匹配:选 difflib,零依赖、够用、稳定。
- 如果你需要处理百万级文本的相似度计算,或需要多种相似度算法:选 rapidfuzz,性能最强,功能最全。
- 如果你只需要简单的编辑距离计算,且对性能有要求:选 python-Levenshtein,轻量高效。
- 如果你在做在线协同编辑器,需要字符级 diff 和 patch 应用:选 google-diff-match-patch,工业级标准。
- 如果你在前端做代码对比组件:选 jsdiff,生态成熟。
九、专业解释 + 大白话 + 生活案例
9.1 SequenceMatcher 的工作原理
专业解释:
SequenceMatcher 基于 Ratcliff/Obershelp 算法(也称为 Gestalt Pattern Matching)。该算法的核心思想是:递归地寻找两个序列之间的最长公共子序列(Longest Common Subsequence),然后分别对左右两侧的子序列递归执行相同操作,直到所有匹配块都被找到。最终的相似度比值计算公式为:
text
ratio = 2 * M / T其中 M 是所有匹配块的总长度,T 是两个序列的总长度。当两个序列完全相同时,M = T,ratio = 1.0;当完全不同时,M = 0,ratio = 0.0。
大白话:
你可以把 SequenceMatcher 想象成一个"找相同"游戏的裁判。给它两段文字,它会先找出两段文字中最长的那段完全相同的部分,然后在这段相同部分的左边和右边,再分别找最长的相同部分,如此反复,直到找不到为止。最后它算一下:所有相同部分的总长度,占两段文字总长度的百分之多少,这个百分比就是相似度。
生活案例:
假设你和朋友各自写了一篇春游作文,老师想知道你们是不是互相抄的。老师先找出两篇文章中最长的一段完全一样的话(比如"我们早上八点在学校门口集合"),然后在这段话的前面和后面,再分别找最长的相同段落。最后老师把所有相同段落的字数加起来,除以两篇文章的总字数,得到一个比例。如果比例是 95%,那基本就是抄的;如果是 30%,可能只是用了相同的素材。这就是 SequenceMatcher 在做的事情。
9.2 get_close_matches 的工作原理
专业解释:
get_close_matches(word, possibilities, n=3, cutoff=0.6) 函数内部为每个候选词创建一个 SequenceMatcher 实例,计算目标词与候选词的相似度比值,然后筛选出相似度大于等于 cutoff 的候选词,按相似度降序排列,返回前 n 个。
大白话:
你拼错了一个单词,手里有一本词典。get_close_matches 就像一个耐心的词典管理员,它把你拼错的词和词典里的每个词都比一比相似度,然后把"长得像"的词挑出来,按像的程度排个序,把最像的前几个给你。你可以设置"多像才算像"(cutoff)和"最多给几个建议"(n)。
生活案例:
你去咖啡店点单,说"给我一杯焦糖玛奇朵",但你发音不准,说成了"焦糖马奇朵"。店员没有直接说"我们没有这个",而是想了想,说"您是不是要焦糖玛奇朵?"。这个店员就是 get_close_matches,它在菜单里找到了和你说的最像的饮品名。
9.3 unified_diff 的工作原理
专业解释:
unified_diff() 生成统一差异格式(Unified Diff Format),这是 POSIX 标准定义的一种差异表示格式。它以 --- 标记原始文件,+++ 标记新文件,@@ -a,b +c,d @@ 标记差异块的位置和上下文行数,- 前缀表示删除行,+ 前缀表示新增行,无前缀表示上下文行。
大白话:
unified_diff 就像一个"修改说明书"。它告诉你:原来的文件是哪个,新文件是哪个,从第几行到第几行发生了变化,哪些行被删掉了,哪些行是新加的,周围还有哪些行没动(用来定位)。这个说明书格式非常标准,Git、patch 等工具都能看懂。
生活案例:
你交给出版社一份书稿,编辑修改后退给你,附了一张修改清单。清单上写着:"第三章第 5 段,删除了原句'他很高兴',新增了'他的嘴角微微上扬',上下文是'他推开门...'和'阳光洒进来...'"。这张修改清单就是 unified_diff,它精确地告诉你哪里改了、怎么改的,而且格式标准,任何人都能看懂。
十、常用场景汇总
| 场景 | 推荐工具 | 关键 API |
|---|---|---|
| 配置文件变更监控 | HtmlDiff | make_file() / make_table() |
| 代码变更审查 | SequenceMatcher + unified_diff | get_opcodes() / ratio() |
| 文档版本对比 | HtmlDiff / SequenceMatcher | make_file() / compare_char_level |
| 命令行智能纠错 | get_close_matches | get_close_matches() |
| 文本去重 | SequenceMatcher | ratio() |
| 拼写检查 | get_close_matches + SequenceMatcher | get_close_matches() / ratio() |
| 生成补丁文件 | unified_diff | unified_diff() |
| 日志差异分析 | Differ | compare() |
| 数据库数据对比 | SequenceMatcher | ratio() / get_matching_blocks() |
| AI 输出审核 | HtmlDiff + SequenceMatcher | make_file() / ratio() |
十一、面试官高频面试题
面试题 1:difflib 中 SequenceMatcher 的 ratio() 是怎么计算的?
参考答案:
ratio() 的计算公式是 2 * M / T,其中 M 是所有匹配块的总长度,T 是两个序列的总长度。底层基于 Ratcliff/Obershelp 算法,通过递归寻找最长公共子序列来确定匹配块。返回值范围是 0.0 到 1.0,1.0 表示完全相同。
需要注意的是,ratio() 的计算结果可能会因为 autojunk 参数的设置而不同。当序列长度超过 200 时,默认会启用自动垃圾启发式(autojunk=True),将出现超过 1% 次数的字符视为"垃圾"忽略,这可能导致相似度计算结果偏低。如果需要精确计算,可以设置 autojunk=False。
面试题 2:difflib 和 python-Levenshtein 有什么区别?什么时候用哪个?
参考答案:
主要区别有三点:
第一,算法不同。difflib 的 SequenceMatcher 使用 Ratcliff/Obershelp 算法,基于最长公共子序列;python-Levenshtein 使用 Levenshtein 编辑距离算法,计算将一个字符串变成另一个所需的最少单字符编辑(插入、删除、替换)次数。
第二,性能不同。difflib 是纯 Python 实现,python-Levenshtein 是 C 扩展,后者在大文本上性能显著优于前者。
第三,功能范围不同。difflib 是一个完整的文本对比工具集,包含差异输出、HTML 可视化、模糊匹配、统一差异格式等;python-Levenshtein 只专注于编辑距离和相似度计算。
选型建议:常规文件对比、配置监控、需要 HTML 报告的场景用 difflib;大规模字符串相似度计算、需要编辑距离具体数值的场景用 python-Levenshtein 或 rapidfuzz。
面试题 3:get_close_matches 的 cutoff 参数默认值是多少?如何调优?
参考答案:
get_close_matches(word, possibilities, n=3, cutoff=0.6) 的 cutoff 默认值是 0.6,表示只有相似度大于等于 0.6 的候选词才会被返回。
调优策略:
- 如果希望更宽松的匹配(召回率优先),可以降低 cutoff 到 0.4 或 0.5,但可能引入不相关的结果。
- 如果希望更精确的匹配(准确率优先),可以提高 cutoff 到 0.7 或 0.8,但可能漏掉一些拼写错误较大的词。
n参数控制返回结果数量,默认 3。在命令纠错场景通常设为 1 或 3,在拼写检查场景可以设为 5。- 实际项目中,应该根据业务场景的误报率和漏报率来调优,建议先用测试集评估不同 cutoff 下的准确率和召回率,再选择最优值。
面试题 4:如何用 difflib 实现一个简单的文本去重功能?
参考答案:
可以使用 SequenceMatcher 计算文本之间的两两相似度,当相似度超过阈值时判定为重复。
python
from difflib import SequenceMatcher

def deduplicate_texts(texts, threshold=0.85):
    """文本去重,保留首次出现的文本"""
    unique_texts = []
    for text in texts:
        is_duplicate = False
        for existing in unique_texts:
            similarity = SequenceMatcher(None, text, existing).ratio()
            if similarity >= threshold:
                is_duplicate = True
                break
        if not is_duplicate:
            unique_texts.append(text)
    return unique_texts

# 使用示例
texts = [
    "Python is a great programming language",
    "Python is a great programming language!",
    "Java is widely used in enterprise development",
    "Python is a great programming language for AI",
]
result = deduplicate_texts(texts, threshold=0.8)
print(f"去重前: {len(texts)} 条,去重后: {len(result)} 条")
需要注意的是,这种两两比较的方法时间复杂度是 O(n^2),在文本数量很大(超过 1000 条)时性能较差。大规模去重建议使用 MinHash、SimHash 等近似算法,或使用 rapidfuzz 的 process.cdist 批量计算。
面试题 5:difflib 的 HtmlDiff 生成的 HTML 报告如何自定义样式?
参考答案:
HtmlDiff 类有以下几个可自定义的参数和方法:
- 构造函数参数:
tabsize(Tab 字符宽度,默认 8)、wrapcolumn(换行列数,默认 None 不换行)、linejunk(行级垃圾过滤函数)、charjunk(字符级垃圾过滤函数)。 make_file(fromlines, tolines, fromdesc, todesc, context=False, numlines=5):生成完整 HTML 文件,context=True时只显示差异上下文,numlines控制上下文行数。make_table(fromlines, tolines, fromdesc, todesc, context=False, numlines=5):只生成 HTML 表格部分,可以嵌入自己的页面模板。
如果需要完全自定义样式,可以用 make_table() 获取表格 HTML,然后自己包裹外层模板和 CSS 样式。差异行的 class 名分别是 diff_add(新增)、diff_chg(修改)、diff_sub(删除),可以通过 CSS 覆盖默认样式。
面试题 6:SequenceMatcher 的 get_opcodes() 返回哪些操作类型?分别代表什么?
参考答案:
get_opcodes() 返回一个元组列表,每个元组格式为 (tag, i1, i2, j1, j2),其中 tag 有四种取值:
'replace':替换,表示 ai1:i2 应被替换为 bj1:j2'delete':删除,表示 ai1:i2 应被删除,此时 j1 == j2'insert':插入,表示 bj1:j2 应被插入到 ai1:i1 位置,此时 i1 == i2'equal':相等,表示 ai1:i2 == bj1:j2
这些操作码按顺序排列,完整描述了如何将序列 a 转换为序列 b。在代码审查、差异高亮等场景中非常有用。
面试题 7:difflib 能对比二进制文件吗?为什么?
参考答案:
difflib 本质上是用于对比文本序列的,它的 API 设计基于"行"的概念(splitlines、keepends 等),输出格式也是面向文本的。虽然 SequenceMatcher 可以对比任意可哈希元素的序列,理论上可以对比字节序列,但在实际使用中不建议用 difflib 对比二进制文件,原因有三:
第一,二进制文件没有"行"的概念,按行分割没有意义。
第二,二进制文件的差异通常是字节级的,difflib 的行级对比效率很低。
第三,HtmlDiff 和 unified_diff 的输出格式对二进制内容没有可读性。
对比二进制文件应该使用专门的工具,如 cmp 命令、xdelta、bsdiff 等,它们针对二进制数据做了优化。
十二、总结
difflib 是 Python 标准库中一个被低估的宝藏模块。它看似简单,实则功能强大,从基础的文本差异对比到高级的相似度计算和模糊匹配,几乎覆盖了所有常见的文本对比需求。
在这个 AI 大爆发的时代,文本对比的需求不仅没有减少,反而越来越多。无论是审核 AI 生成的内容、对比文档版本、监控配置变更,还是实现智能纠错,difflib 都能以零依赖、高可靠的方式帮你解决问题。
希望这篇文章能让你对 difflib 有一个全面深入的理解,在今后的工作中遇到文本对比需求时,第一时间想到这个"瑞士军刀",而不是到处找第三方库。
记住:最好的工具,往往是你已经拥有的那个。
转载声明:本文为原创文章,如需转载,请联系作者获得授权,并注明出处。