首屏不是 dist:用"加载账本"治理 Vite 的大包
dist/assets 里出现一个 800 KB 的文件,通常会立刻触发"拆包"行动:加 manualChunks、把组件改成动态导入、把所有依赖塞进 vendor。但这些动作未必改善用户体验,甚至可能把稳定的首屏加载改造成点击后的请求瀑布。
更可靠的起点不是问"哪个文件最大",而是问:用户进入某个页面、完成某次交互、再次访问时,分别为哪些 JavaScript 代码付了网络、CPU 与缓存失效的成本?
本文讨论浏览器端 JavaScript 的构建与加载治理,不展开图片、字体、WASM 的专项优化;框架层面以 Vite 通用机制为主,React、Vue、Svelte 等框架只需把各自的路由懒加载或异步组件 API 接入同一套决策模型。
**版本边界:**Vite 8 使用 Rolldown 作为统一 bundler。Vite 7 及更早版本的生产构建主要处在 Rollup 语境。使用 Vite 8 时,应优先参考
build.rolldownOptions与output.codeSplitting的当前文档;旧项目中的build.rollupOptions配置需要结合实际版本和迁移文档验证,不能机械照搬。
一、先建立"加载账本":同一个产物,有五种成本
把"包大"统一成一个数字,会让优化方向失真。至少应分别记录下面五笔账。
| 成本 | 要回答的问题 | 常见误判 |
|---|---|---|
| 总产物体积 | 本次发布一共生成了多少静态资源? | 把 dist 总大小当成首屏成本 |
| 初始加载集合 | 用户首次进入某条路由时,必须请求哪些资源? | 忽略入口、共享 chunk 与模块预加载 |
| 实际传输字节 | 冷缓存下,经过 Brotli 或 gzip 后实际传输了多少? | 只看未压缩的 .js 文件大小 |
| 解析、编译与执行 | 哪些脚本占用了主线程,推迟渲染或交互? | 认为下载变小就必然更快 |
| 缓存增量 | 老用户升级版本后,需要重新下载多少? | 忽略 hash 级联变化与共享包更新频率 |
JavaScript 的代价不止网络。浏览器还要解析、编译和执行脚本;因此,一个网络体积不算离谱、但在首屏执行大量初始化逻辑的 chunk,依然可能拉长交互等待。Lighthouse 和 Chrome Performance 面板应结合使用,分别观察脚本的解析、评估、执行以及长任务。
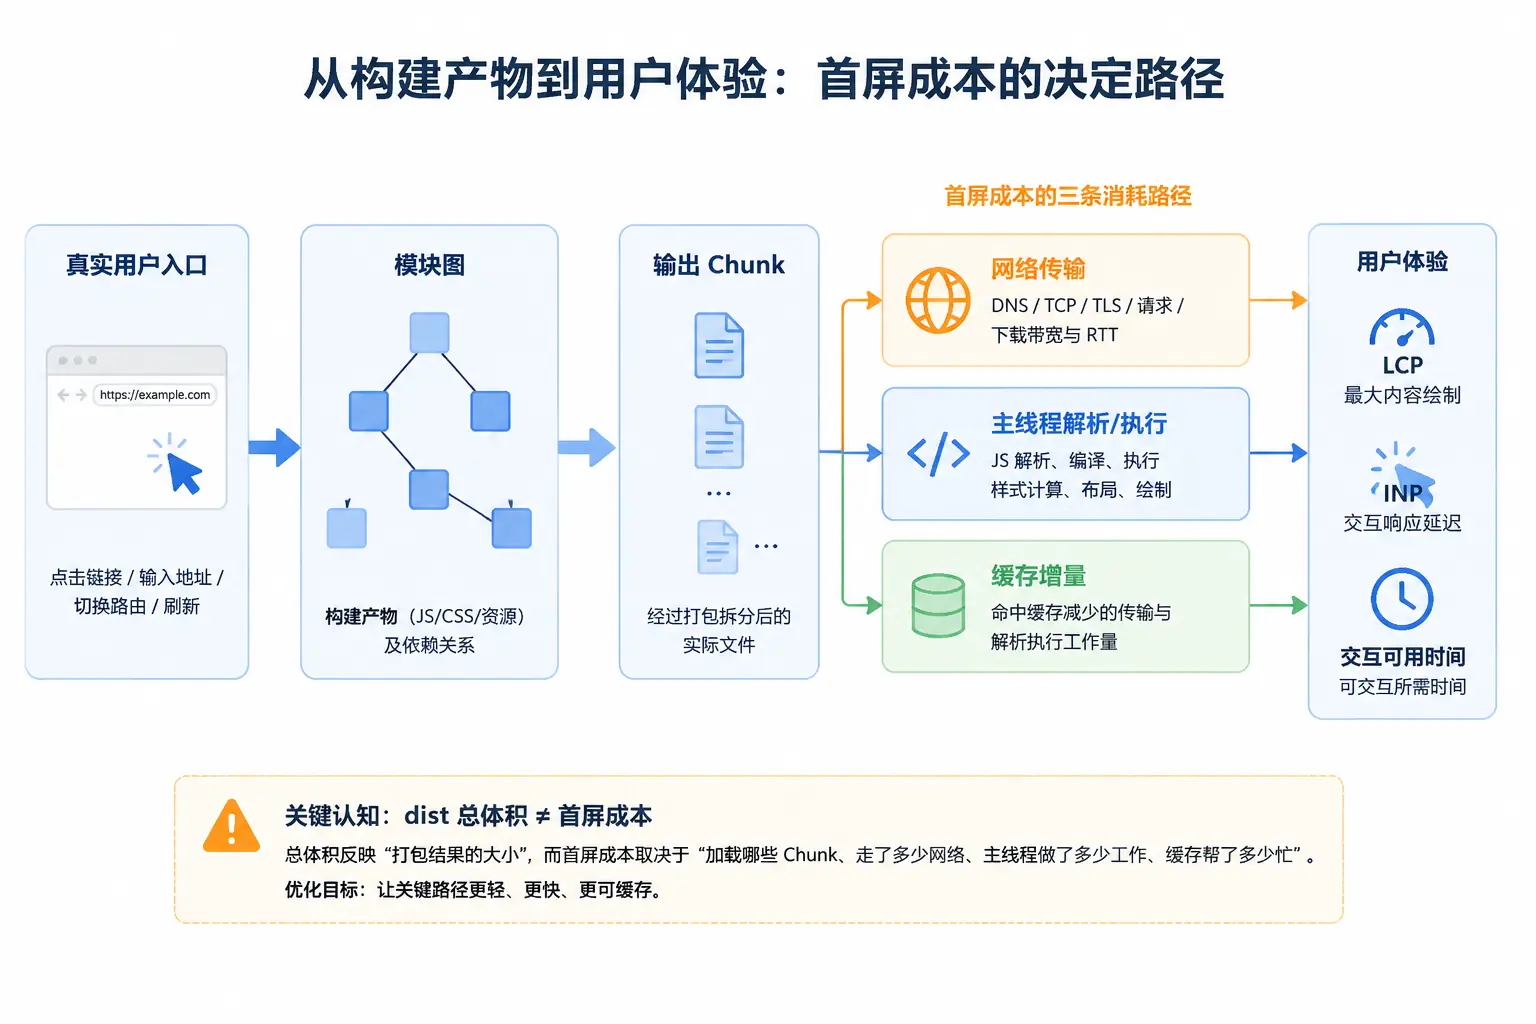
可以先做如下判断:
- 总产物大、首屏集合小 :优先看异步页面、低频功能和缓存策略,不要为了缩小
dist伤害首屏。 - 首屏传输大、执行不重:优先治理入口依赖、重复版本、重型库和不必要的预加载。
- 首屏传输不大、执行很重:优先查初始化、序列化数据处理、图表渲染、编辑器启动和运行时代码,而不是继续切碎文件。
- 冷缓存改善、热缓存变差:重点检查共享 chunk 是否过大、更新是否导致 hash 级联,以及是否把稳定依赖和高频变化的业务代码绑在了一起。
二、从用户入口回溯,而不是从 dist 正向猜测
生产构建的核心不是"把源码压缩",而是把模块关系组织为可被入口和动态边界加载的输出 chunk。静态 import 通常属于当前加载路径;import() 建立异步边界,返回 Promise,并在调用后触发模块加载与执行。预加载策略可能使资源更早开始获取,但不改变其代码边界。
因此,排查应沿着下面的路径回溯:
text
真实用户场景
  → HTML / 路由入口
    → 首屏静态 import
      → 共享依赖与副作用模块
        → 输出 chunk
          → Network 请求瀑布
            → Performance 中的解析、执行与长任务
这也解释了为什么不能拿开发环境的请求数量推断生产包大小:开发服务器中的模块请求、依赖优化和热更新路径,与生产构建后的 chunk 结构不是同一个观察对象。即使 Vite 8 统一了底层构建能力,开发时的模块访问形态和上线后的真实入口加载集合仍需分别验证。
一份最小证据链
建议每次大包排查都保留以下证据,而不是只贴一张 treemap:
- 生产构建结果:固定 lockfile、构建命令和环境变量,避免比较对象漂移。
- 模块占比图 :用可视化工具定位"大块代码是谁",例如
rollup-plugin-visualizer可接入 Vite;具体兼容性应以当前插件版本为准。 - source map 归因 :临时开启
build.sourcemap,把压缩产物映射回包、文件与导入链;生产环境可使用hiddensource map。它只是隐藏产物中的 source map 注释,不代表映射文件本身不可访问,仍需控制其发布和访问权限。 - Network 验证:在冷缓存和热缓存下,分别记录目标路由的初始请求集合、压缩后传输量、优先级与瀑布。
- Performance 验证:定位 parse、evaluate、长任务与点击后的主线程阻塞,确认代码是"晚到了",还是"晚到后仍然很重"。
**可视化图只能说明"空间由谁占据",不能证明"用户体验已改善"。**只有它与真实路由网络瀑布、主线程时间和缓存结果一致时,才构成可执行的结论。
三、依赖变大时,先判定责任类型
大依赖不等于应该被分包;分包也不等于依赖被移除。先把问题归入不同责任类型,动作才不会混乱。
1. 依赖本身就是重型能力
典型对象包括富文本编辑器、图表引擎、地图 SDK、代码编辑器、完整日期库、PDF 处理器和大型图标集。
处理顺序应是:
- 确认该能力是否为首屏必需;
- 确认是否只用到其中很小一部分;
- 比较替代库、轻量子包或服务端处理方案;
- 若能力确实低频,再将其放到明确的交互或路由边界之后。
不要先把它塞进 vendor。那只是在改变文件归属,未必改变用户何时下载和执行它。
2. 导入范围扩大了
常见信号包括从聚合入口导入、全量注册组件、全量加载图标,或通过本地 index.ts 无差别再导出。应先检查调用方能否导入更窄的模块路径或明确的命名导出。
但"按需导入"不是魔法:如果依赖发布的模块结构不利于静态分析,或者其入口在加载时就执行大量注册逻辑,导入语句变短也未必减少最终代码。
3. tree-shaking 没有按预期发生
摇树优化依赖可分析的模块结构与副作用信息。Rolldown 的 treeshake 选项控制死代码消除;CommonJS 的处理效果也取决于转换链路、代码写法和副作用。
尤其要谨慎处理副作用声明:CSS、polyfill、全局注册和"导入即初始化"的插件,可能没有被显式引用导出,却仍是运行时必需。将所有模块粗暴视为 sideEffects: false,或把 moduleSideEffects 配置为 false,可能让体积下降的同时引入样式丢失、兼容性失效或注册逻辑消失。只有确认模块不存在导出之外的副作用时,才能使用这类激进配置。
4. 同一个能力被重复打包
当可视化图中出现同类库的多个版本、多个封装副本,或同一依赖分散在多个 chunk 中时,先查依赖树和解析路径:
- lockfile 是否存在多版本;
- monorepo 内部包是否把本应作为 peer dependency 的库打进了自身产物;
- 别名、软链接或不同入口路径是否让 bundler 将同一库视为不同模块;
- 多入口页面是否各自静态引入了一个本可共享、但更新频率不同的依赖集合。
目标不是强行"只保留一个包",而是确认这些副本是否真的必须共存。
四、代码分割的单位,不是文件,而是等待意愿
一个边界是否应异步,不取决于它能不能 import(),而取决于用户是否愿意在那个时刻等待它。
| 判断维度 | 倾向同步加载 | 倾向异步加载 |
|---|---|---|
| 首屏必要性 | 页面一出现就必须可用 | 首屏不可见或非主任务 |
| 访问频率 | 大多数用户都会使用 | 少数用户或低频路径使用 |
| 模块体积与执行 | 很小,或延后收益有限 | 大且初始化、解析成本明显 |
| 交互时机 | 用户无法预知、必须即时响应 | 有明确入口、可提前感知 |
| 复用范围 | 多个首屏路径都需要 | 只属于单一路由或局部功能 |
| 更新频率 | 与业务代码同步变化 | 相对稳定,适合独立缓存 |
| 失败可恢复性 | 失败会阻断关键任务 | 可展示重试、降级或占位状态 |
路由级:最自然的第一层边界
页面路由通常对应明确的访问意图和导航时机,是最容易获得首屏收益的分割位置。对于后台管理、设置页、报表页等低频页面,路由级拆分通常比组件级碎片化更稳定。
停止继续拆路由的信号是:目标路由进入后仍立即请求多个串行 chunk,或首屏共享 chunk 已经包含了绝大部分页面代码。此时问题不在"路由没有懒加载",而在共享依赖、嵌套动态边界或加载触发顺序。
页面功能级:把重能力放在用户意图之后
编辑器、导出中心、地图、图表工作台、批量上传、代码预览等功能,更适合作为页面内异步边界。它们不应在用户只是阅读内容时就产生成本。
ts
async function openEditor() {
  showEditorLoading()

  try {
    const { mountEditor } = await import('./editor/mountEditor')
    mountEditor()
  } catch (error) {
    reportChunkLoadError(error)
    showEditorRetry()
  }
}
这段代码的关键不在语法,而在产品契约:**加载态何时出现、失败后如何重试、用户能否继续完成核心任务。**动态导入的网络、模块加载或执行失败会使 Promise 拒绝,因此异常处理不能只依赖控制台报错。
组件级:只用于真正独立且可等待的局部能力
弹窗中的富文本编辑器、展开后才出现的高级筛选、可选的 3D 预览,适合组件级拆分。反之,首屏主内容中的多个小组件不宜各自懒加载:它们会增加调度复杂度、加载态数量和请求关系,可能把一个并行请求图拆成串行瀑布。
第三方依赖级:目标是稳定边界,不是制造"万能 vendor"
将稳定、复用广且不常更新的依赖抽成独立缓存单元,有时有价值;但把所有 node_modules 强行塞进单个 vendor,常常会造成两个问题:
- 一个低频重库被所有访问者提前下载;
- 任意依赖变更都可能让巨型共享包失去缓存命中。
Vite 8 的分包策略应根据当前文档通过 build.rolldownOptions.output.codeSplitting 配置;不要把旧项目中围绕 manualChunks 的经验不加验证地迁移过来。
五、懒加载不是免费午餐:管理"晚到"的四类风险
请求瀑布:边界位置比边界数量更重要
假设点击"编辑"后,先加载编辑器 shell,shell 再加载语言包,语言包再加载 worker。即使每个 chunk 都很小,用户仍在承受连续等待。
处理方式不是简单合并所有 chunk,而是检查依赖是否能并行发现:将真正共同需要的依赖放在同一异步边界内,或在用户表现出高意图时预取下一步资源。
预加载误用:把未来成本重新塞回现在
modulepreload 适合当前页面确定需要、但存在依赖发现延迟的模块。浏览器会提前获取并准备模块图;解析、编译和执行的具体时机由浏览器实现决定,并不等于模块已经执行。prefetch 更适合可能发生的未来导航或未来资源,通常以较低优先级获取,但浏览器是否获取、何时获取以及缓存保留时间都可能受实现和网络状况影响。
两者都不是"越多越好";无差别预加载会与当前页面关键资源竞争。可采用一个保守策略:
- 当前页面必需且存在依赖发现延迟 :考虑
modulepreload; - 用户已悬停、聚焦或开始按下某个高概率入口:考虑预取相应异步 chunk;
- 低频、昂贵、不可预测的功能:保持真正按需,优先设计加载态;
- 弱网、节流或流量敏感场景:不要把猜测性加载当作默认收益。
交互延迟:下载完成不代表可以操作
异步模块到达后仍要解析、编译、执行和初始化。对于编辑器、图表或大数据表格,应在 Performance 面板确认点击后是否出现长任务;若有,可能需要减少首次挂载工作、分阶段初始化,或把计算移出主线程,而不是只继续切 chunk。
发布切换:旧 HTML 可能请求已删除的旧 chunk
动态 chunk 还涉及部署一致性。用户保留旧页面运行时代码时,新部署若删除旧 hash 资源,后续动态导入可能失败。Vite 会派发 vite:preloadError 事件;官方建议在适合的场景处理该事件,并让 HTML 使用 Cache-Control: no-cache,以免旧 HTML 长期引用过期资源。
ts
window.addEventListener('vite:preloadError', (event) => {
  event.preventDefault()
  window.location.reload()
})
这里不应机械刷新。对于有未保存表单或编辑状态的应用,应先保护本地草稿、提示用户,或设计可恢复的重试路径。
六、一次可落地的排查闭环
第 1 步:固定症状和场景
不要写"首页包大",而要写成可验证的描述:
冷缓存、移动网络模拟下,未登录用户访问
/dashboard;记录初始 JS 传输、LCP、主线程脚本时间;再记录点击"新建报表"后可操作所需时间。
这样才知道优化的对象是首屏、交互,还是缓存回访。
第 2 步:生成构建侧证据
- 构建产物清单与压缩后大小;
- 可视化图中的最大模块、最大 chunk、重复模块;
- source map 对应的源码导入链;
- 依赖树中的多版本与异常入口。
第 3 步:给每个大块标注加载责任
对每个候选模块只做四种标记:
- 必须首屏同步;
- 应保留但可异步;
- 应缩小导入范围或替换;
- 疑似重复、摇树失败或错误共享。
这一步比直接修改分包配置更重要,因为它把"文件大小"转换成了架构责任。
第 4 步:一次只改变一种边界
优先顺序通常是:
- 移除不需要的能力;
- 缩小导入范围或处理重复依赖;
- 做路由级或功能级异步边界;
- 最后才针对共享依赖调整 chunk 策略。
每次变更后都重新测量。若初始体积变小但点击延迟显著上升,说明只是把成本从"进入页面前"转移成了"用户操作后"。
第 5 步:以预算而非感觉验收
至少为关键路径设定以下预算并持续比较:
| 维度 | 建议记录 |
|---|---|
| 初始加载 | 初始 JS 请求集合、压缩传输字节、请求瀑布 |
| 主线程 | 脚本 parse / evaluate / execute 时间、长任务 |
| 用户体验 | LCP、关键交互的等待时间、INP 变化 |
| 缓存 | 冷缓存与热缓存传输量、依赖更新后的增量下载 |
| 稳定性 | 动态 chunk 加载错误率、重试成功率、发布后错误峰值 |
七、结论:优化目标是把成本放到正确时刻
Vite 大包治理的终点不是生成更多 chunk,也不是让可视化图更漂亮,而是让每段代码的下载和执行时机与用户意图匹配:
- 首屏所需的代码要少,但不能被过度异步化而制造瀑布;
- 低频重能力应等待明确意图,但必须有可接受的加载与失败体验;
- 稳定依赖可以争取缓存,但不该与高频变化的业务代码捆绑;
- tree-shaking、依赖替换和去重优先解决"不该存在的代码";
- 分包只解决"应该存在,但不该现在到达的代码"。
当团队能用加载账本同时回答"谁占空间、谁在首屏、谁阻塞主线程、谁破坏缓存、谁在点击后让用户等待",构建产物过大就不再是一个模糊的告警,而是一组可以分派、验证和持续治理的工程问题。
参考资料
- Vite 8.0 is out!(Vite)
- Building for Production(Vite)
- Build Options(Vite)
- Rolldown treeshake options(Rolldown)
- import()(MDN)
- Speculative loading(MDN)
- Reduce JavaScript execution time(Chrome for Developers)
- rollup-plugin-visualizer(btd / GitHub)