线上服务一旦拆到多台机器,日志查询就会变成一件很烦的事。我维护的几个后端服务分布在四台服务器上,平时排查问题基本靠 ssh 登上去,再 tail -f 或者 grep。单机还好,一旦某个请求跨了多个服务,或者要对比几台机器同一时间段的报错,就得开好几个终端来回切,效率低到让人怀疑人生。
之前也考虑过 ELK,但 Elasticsearch 对内存要求比较高,我的机器上还要跑业务进程,不太想为了查日志再吃掉几个 G 内存。后来选了 Loki 这套方案,它的思路和 ES 不一样:只对标签建立索引,日志正文压缩后直接存对象存储或本地磁盘,资源占用小很多。配合 Promtail 采集、Grafana 查询,整套跑起来内存占用比我预期低。
这篇文章记录一下我从零搭这套平台的过程,包括配置、标签设计、查询语法,以及跑起来之后真实遇到过的问题。
为什么是 Loki 而不是 ELK
先说选型。这不是说 Loki 比 ELK 好,而是场景不同。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| ELK(Elasticsearch + Logstash + Kibana) | 全文检索强,聚合分析能力完整,生态成熟 | 资源占用高,ES 对内存和磁盘 IO 要求大,运维成本高 | 日志量大、需要复杂全文检索和聚合分析的团队 |
| Loki + Promtail + Grafana | 资源占用低,和 Prometheus/Grafana 体系天然契合,部署简单 | 不支持全文索引,查询依赖标签过滤,聚合能力弱于 ES | 中小规模、已有 Grafana、主要靠标签定位问题的场景 |
| 直接 ssh + grep | 零部署成本 | 多机、跨服务、历史回溯场景基本不可用 | 单机、临时排查 |
我这边的情况是:服务数量不算多,日志量每天大概几个 G,查询诉求主要是"某台机器某个服务在某段时间的报错",而不是"全文搜索某个关键词出现在哪些日志里"。这种以标签定位为主的查询,正好是 Loki 的强项。
【关键结论】如果你的查询主要是按服务、主机、时间范围过滤,Loki 性价比很高;如果经常要做全文关键词检索和复杂聚合,ES 更合适。
组件分工
三个组件各管一段:
- Promtail:部署在每台被采集的机器上,负责读本地日志文件,打上标签,推送到 Loki。
- Loki:接收日志,按标签建索引,把日志内容压缩存储。
- Grafana:连到 Loki 作为数据源,提供查询界面和仪表盘。
数据流向大致是:日志文件 → Promtail(采集+打标签)→ Loki(索引+存储)→ Grafana(查询展示)。
部署方式
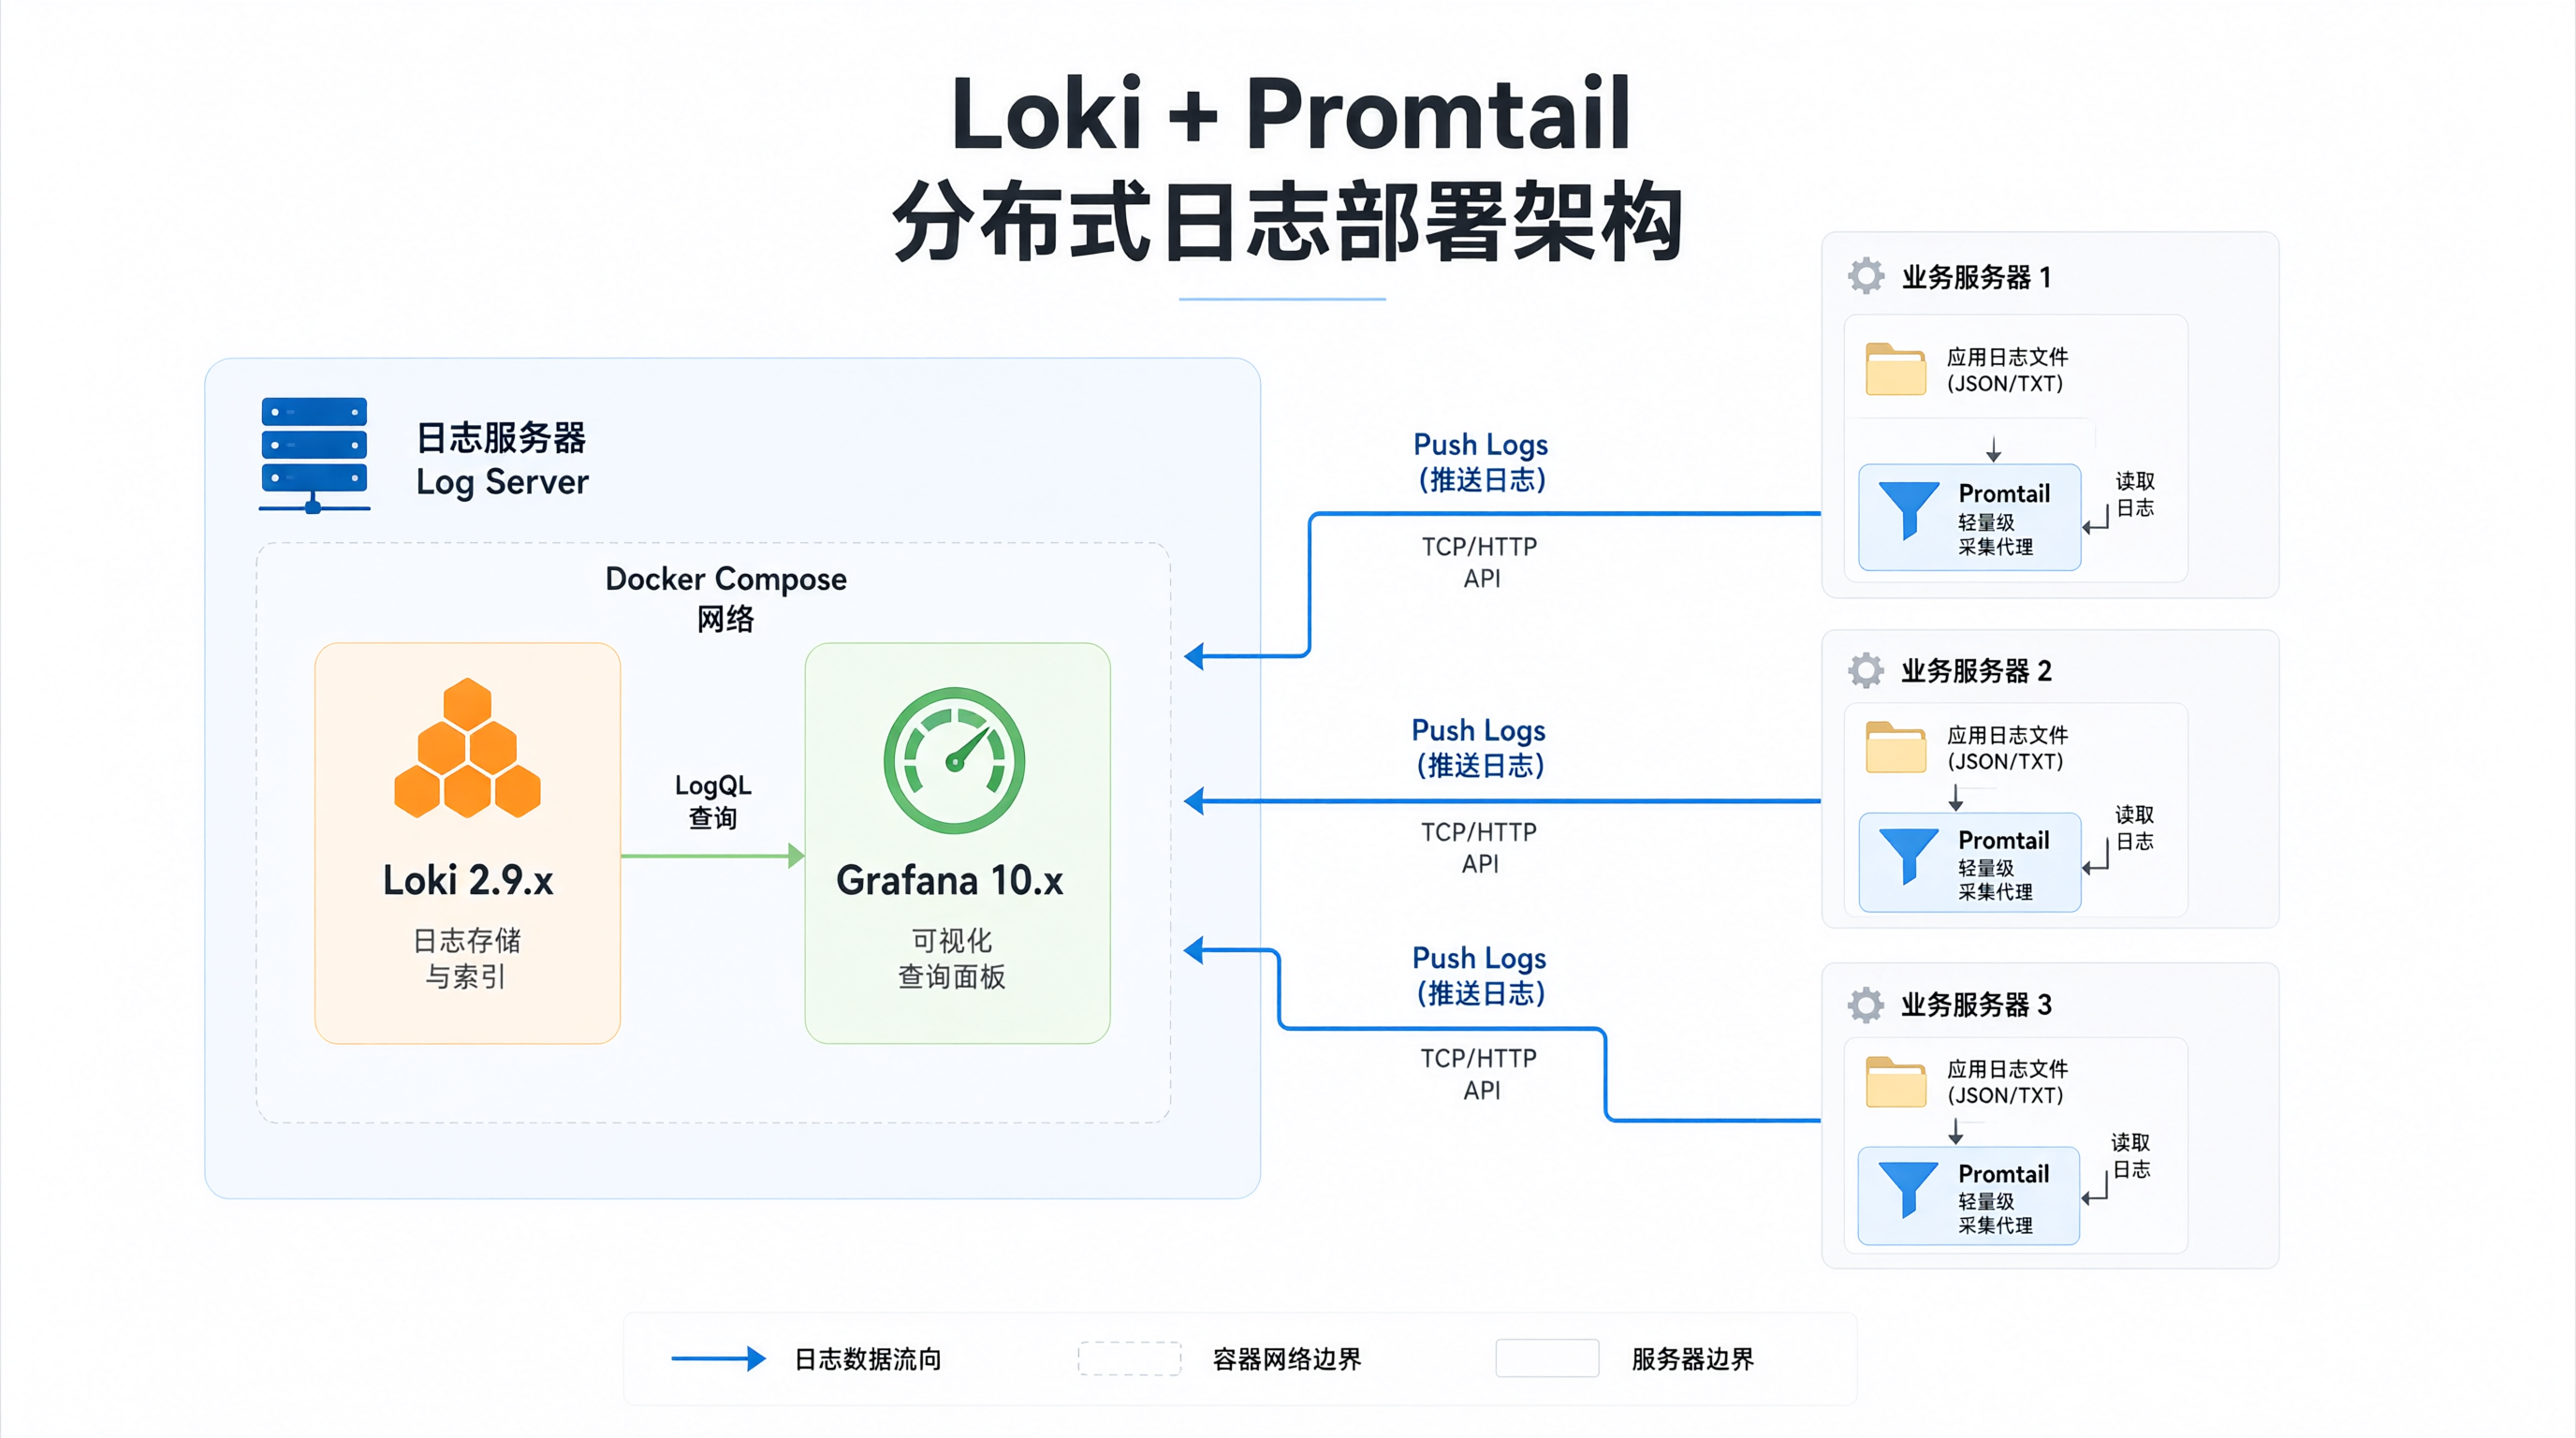
我用的是 docker-compose,把 Loki 和 Grafana 放在一台机器上(下面叫它日志服务器),Promtail 单独部署在每台业务机上。这样业务机只需要跑一个很轻的 Promtail 容器。
先看 Loki 和 Grafana 这一侧。我用的版本是 Loki 2.9.x 和 Grafana 10.x,这两个版本当前比较稳定,配置写法也是现在主流的。
yaml
# docker-compose.yml  ------ 部署在日志服务器
version: "3.8"

services:
  loki:
    image: grafana/loki:2.9.6
    container_name: loki
    ports:
      - "3100:3100"
    volumes:
      - ./loki-config.yml:/etc/loki/local-config.yaml
      - ./loki-data:/loki
    command: -config.file=/etc/loki/local-config.yaml
    restart: unless-stopped

  grafana:
    image: grafana/grafana:10.4.2
    container_name: grafana
    ports:
      - "3000:3000"
    volumes:
      - ./grafana-data:/var/lib/grafana
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=change_me
    depends_on:
      - loki
    restart: unless-stopped
Loki 的配置文件我用了接近单机默认的写法,主要确认存储路径和监听端口:
yaml
# loki-config.yml
auth_enabled: false

server:
  http_listen_port: 3100

common:
  path_prefix: /loki
  storage:
    filesystem:
      chunks_directory: /loki/chunks
      rules_directory: /loki/rules
  replication_factor: 1
  ring:
    kvstore:
      store: inmemory

schema_config:
  configs:
    - from: 2024-01-01
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: index_
        period: 24h

limits_config:
  reject_old_samples: true
reject_old_samples_max_age: 168h这里有几个点值得说一下。auth_enabled: false 是关掉多租户,单机自己用没必要开。schema: v13 是当前 Loki 推荐的 schema 版本,和 tsdb 存储配合。reject_old_samples_max_age: 168h 是拒绝超过 7 天的旧日志,防止客户端时钟不对导致乱序写入。
【注意】schema_config 里的 from 日期一旦定下来,后续如果要改 schema,需要新增一条配置项而不是改这一条,Loki 是按时间段选择 schema 的。这一点官方文档有说明,改错了会导致旧数据读不出来。
filesystem 存储适合单机或者挂载了共享存储的场景。如果日志量再大、想上对象存储(比如 S3、MinIO),把 object_store 换成对应类型即可,这个我没实际配过,就不展开了。
Promtail 采集配置
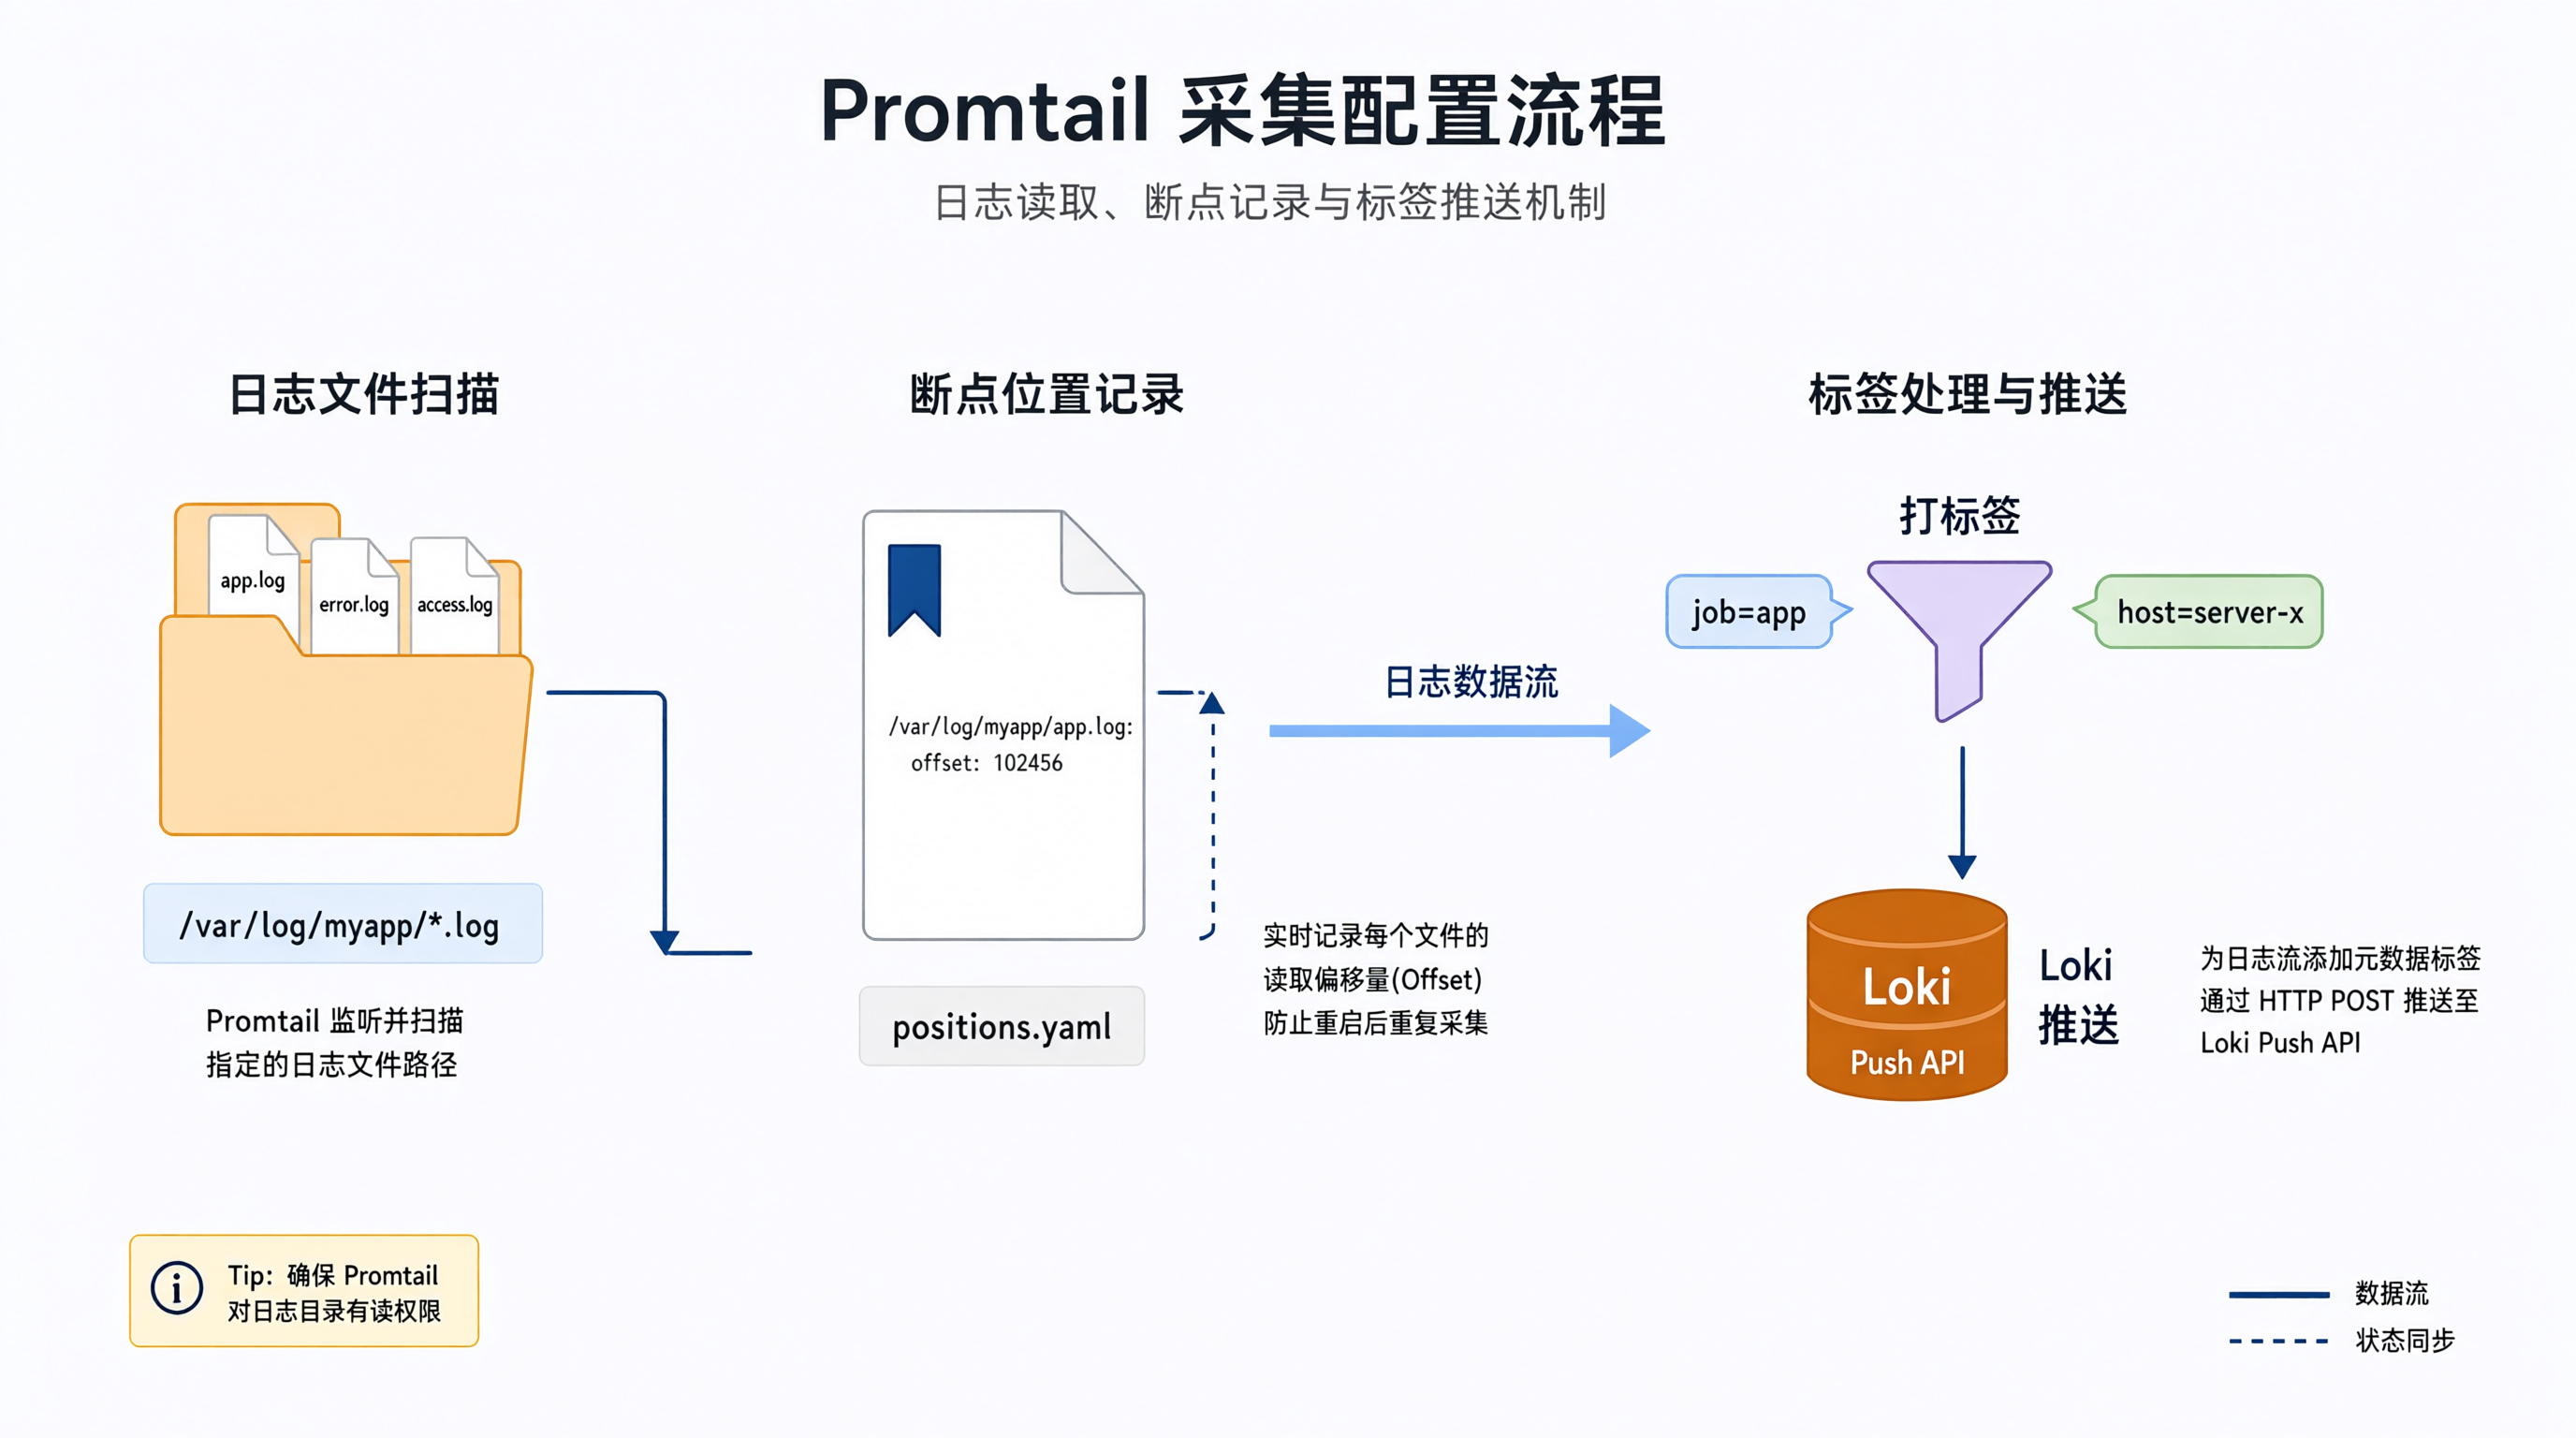
业务机上的 Promtail 配置是重点,标签怎么打直接决定了后面查询好不好用。
yaml
# promtail-config.yml ------ 部署在每台业务机
server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: /tmp/positions.yaml

clients:
  - url: http://<日志服务器IP>:3100/loki/api/v1/push

scrape_configs:
  - job_name: app-logs
    static_configs:
      - targets:
          - localhost
        labels:
          job: app
          host: server-01
          __path__: /var/log/myapp/*.log
positions.yaml 记录每个文件读到哪一行了,Promtail 重启后从断点继续,不会重复推送。这个文件要保证可写。
clients 指向 Loki 的 push 接口。
scrape_configs 里,__path__ 是匹配日志文件的路径,labels 里定义的标签会附加到这批日志上。上面这个配置的意思是:采集 /var/log/myapp/ 下所有 .log 文件,给它们打上 job=app、host=server-01 两个标签。
每台机器上的配置只有 host 不一样,其他都一样。实际部署时我用了一个模板,部署脚本里替换 host 值。
标签设计的坑
这里是我踩得比较实的一个问题。一开始我想当然地把一些动态字段也做成了标签,比如把日志里的 request_id、user_id 提取出来当标签。结果 Loki 很快就报警说标签基数太高,查询也变得很慢。
原因是 Loki 的索引是基于标签组合的。标签的唯一组合数量 (基数)一旦爆炸,索引就撑不住了。request_id 这种几乎每条都不一样的值,做成标签等于给每条日志建一个索引,完全违背了 Loki 的设计初衷。
【踩坑提醒】标签只放基数低、可枚举 的维度,比如 host、job、env、level。像 request_id、user_id、trace_id 这种高基数字段,要么放在日志正文里用查询语法过滤,要么用 Loki 的 structured metadata(需要较新版本,且行为有差异,我没有深入验证)。
调整之后,我的标签就固定在 host、job、env 这几个上:
yaml
labels:
  job: app
  host: server-01
  env: prod
这样标签组合数量就是"机器数 × 服务数 × 环境数",非常可控。
日志格式建议
Loki 查询时如果日志是结构化 JSON,过滤会方便很多。我这边后端服务用的是 Python,日志输出改成了 JSON 格式,方便后续按字段过滤。
python
# logging_config.py
import json
import logging
import sys


class JsonFormatter(logging.Formatter):
    def format(self, record: logging.LogRecord) -> str:
        payload = {
            "ts": self.formatTime(record, "%Y-%m-%dT%H:%M:%S%z"),
            "level": record.levelname,
            "logger": record.name,
            "message": record.getMessage(),
        }
        # 如果有额外字段(比如 request_id),一并带上
        if hasattr(record, "request_id"):
            payload["request_id"] = record.request_id
        if record.exc_info:
            payload["exc"] = self.formatException(record.exc_info)
        return json.dumps(payload, ensure_ascii=False)


def get_logger(name: str) -> logging.Logger:
    logger = logging.getLogger(name)
    logger.setLevel(logging.INFO)
    handler = logging.StreamHandler(sys.stdout)
    handler.setFormatter(JsonFormatter())
    logger.addHandler(handler)
    return logger
这样每条日志就是一行 JSON。注意 request_id 是放在正文里的,不是标签,查询时用 Loki 的 JSON 解析语法过滤。
在 Grafana 里查日志
Grafana 加 Loki 数据源很简单:Configuration → Data Sources → Add data source → 选 Loki,URL 填 http://loki:3100(如果 Grafana 和 Loki 在同一个 compose 网络里)或者日志服务器 IP。
配好之后,在 Explore 页面就能查了。Loki 的查询分两部分:标签选择器 和过滤器。
标签选择器必须至少有一个非空的匹配条件,比如:
logql
{host="server-01", job="app"}这会查出这台机器上 app 服务的所有日志。然后可以加过滤器:
logql
{host="server-01", job="app"} |= "ERROR"|= 是包含某个字符串,!= 是不包含,|~ 是正则匹配。这些都是对日志正文做过滤,配合标签先缩小范围,效率会好很多。
如果日志是 JSON,可以用 | json 解析后按字段过滤:
logql
{host="server-01", job="app"} | json | level="ERROR"还可以按 request_id 查一条请求的完整链路(即使它跨了多个服务):
logql
{job="app"} | json | request_id="abc-123"这比挨个 ssh 上去 grep 快太多了。
常用查询整理
几个我平时用得比较多的写法:
-
查某台机器最近的报错:
logql{host="server-01", job="app"} |= "ERROR" -
查某个服务所有机器上的 500 错误:
logql{job="app"} | json | status="500" -
统计每分钟错误日志条数(用于做告警):
logqlsum(count_over_time({job="app"} |= "ERROR" [1m])) -
排除健康检查这类噪音:
logql{job="app"} != "healthcheck"
第 3 条这种是 metric 查询,可以直接配成 Grafana 的告警规则。
实际遇到的问题
标签基数报警
前面提过,一开始把 request_id 做成标签,Loki 日志里出现 max label cardinality 类似的告警,查询也明显变慢。把高基数字段从标签里去掉之后恢复正常。这是 Loki 使用中最容易犯的错,没有之一。
时间范围查询慢
Loki 查询性能和时间范围强相关。查最近 15 分钟很快,查最近 7 天就会慢,因为它要扫过整个时间段的数据。我的做法是:日常排查控制在几小时内,需要长期回溯的场景单独处理,而不是一上来就查一周。
limits_config 里的 max_query_length 可以限制单次查询的最大时间跨度,我设了一个相对保守的值,防止有人误查超大范围把 Loki 拖垮。这个参数具体取值要结合自己的数据量和机器配置,我没有一个通用数字。
磁盘增长
日志是持续写入的,磁盘会一直涨。Loki 本身有 retention 配置,但我用的是 filesystem 存储,实际清理行为需要结合 compactor 相关配置一起看,这块我配得比较简单(靠 reject_old_samples_max_age 控制写入,定期手动清理旧 chunks)。如果对保留策略有严格要求,建议用对象存储配合 retention 配置,或者接一个定时清理脚本。这一点我没有做完整的自动化验证,属于待完善的部分。
是否值得搭
回到最开始的问题。这套方案适合什么样的场景?
- 服务分布在多台机器,ssh 逐台查已经明显影响效率;
- 查询以标签+时间范围为主,不是重度全文检索;
- 机器资源有限,不想为日志系统投入太多内存;
- 已经在用 Grafana,希望日志和指标在同一个界面看。
如果这几点都符合,Loki 这套组合的性价比很高。如果日志量特别大、或者需要 ES 那种全文检索和复杂聚合,那就老老实实上 ELK,别硬套。
我搭完之后,最直观的变化是排查一个跨服务问题的时间从"开四个终端来回切"变成了"在 Grafana 里一条查询搞定"。尤其是按 request_id 追链路,之前基本靠手动拼,现在直接查。
后续我打算再补两块:一是把错误日志的 metric 查询配上 Grafana 告警,出问题主动通知而不是等人来查;二是把 retention 策略做成自动化的,省得手动清磁盘。这两块落地之后,这套平台才算真正完整。