开篇介绍:
hello 大家,在我们系统学习完 Redis 五大基础数据类型中的 String(字符串)、List(列表)、Hash(哈希)、Set(集合) 之后,今天我们终于要迎来功能最完备、设计最精妙、实战价值最高、面试考察频率稳居第一 的数据结构 ------ZSet 有序集合(Sorted Set)。
如果说 String 是 Redis 的基础基石,List 是有序序列工具,Hash 是结构化对象载体,Set 是去重与交集工具,那么 ZSet 就是 Redis 为「排序、排名、范围查询、动态计分、多集合聚合 」这类核心业务场景量身打造的终极解决方案。在实际互联网开发中,只要你遇到排行榜、热度排序、积分排名、延时任务、优先级队列、范围筛选等需求,ZSet 几乎都是唯一且最优的选择,没有之一。
在正式进入命令、底层、实战场景之前,我们依旧先重申一个通用小技巧:如果你想在 redis-cli 中正常查看、输入中文而不出现十六进制转义字符,启动客户端时请携带 --raw 参数:
redis-cli --raw这是学习 Redis 所有数据类型都通用的细节,能让命令操作与结果查看更直观、更贴合日常开发习惯。
一、Redis ZSet 有序集合:核心基础认知
在学习任何命令、底层原理、实战用法之前,我们必须先把 ZSet 的本质定义、核心特性、铁律规则、与其他结构的区别彻底搞懂 ------ 这是理解后续所有内容的根基,也是避开使用误区、面试答对问题的关键。
1.1 什么是 ZSet(Sorted Set / 有序集合)?
Redis 官方对 ZSet(Sorted Set,有序集合) 的定义可以总结为两句话:
- 它保留了普通 Set 集合的核心特性:元素(member)唯一、不可重复;
- 它在 Set 基础上,为每一个元素绑定一个唯一关联的浮点型分数(score),Redis 会根据这个 score 自动维护元素的有序性。
简单来说:ZSet = 去重的 Set + 可排序的分数(score)
为了让大家秒懂,我们用两个最通俗的类比:
- 班级考试排名:学生姓名(元素 member)唯一不能重复,考试分数(score)可以相同(并列排名),全班按分数从高到低 / 从低到高排序;
- 三国武将武力榜 (你提供的教材示例):
user:ranking为 Key,武将名(关羽、张飞、夏侯惇...)是唯一元素,武力值(97.8、97.8、96.5...)是分数,整体按武力值有序排列。
示例:
Key:user:ranking
元素(武将)    分数(武力值)
关羽           97.8
张飞           97.8
夏侯惇         96.5
周泰           96.2
甘宁           94.2
黄祖           94.0
严颜           93.2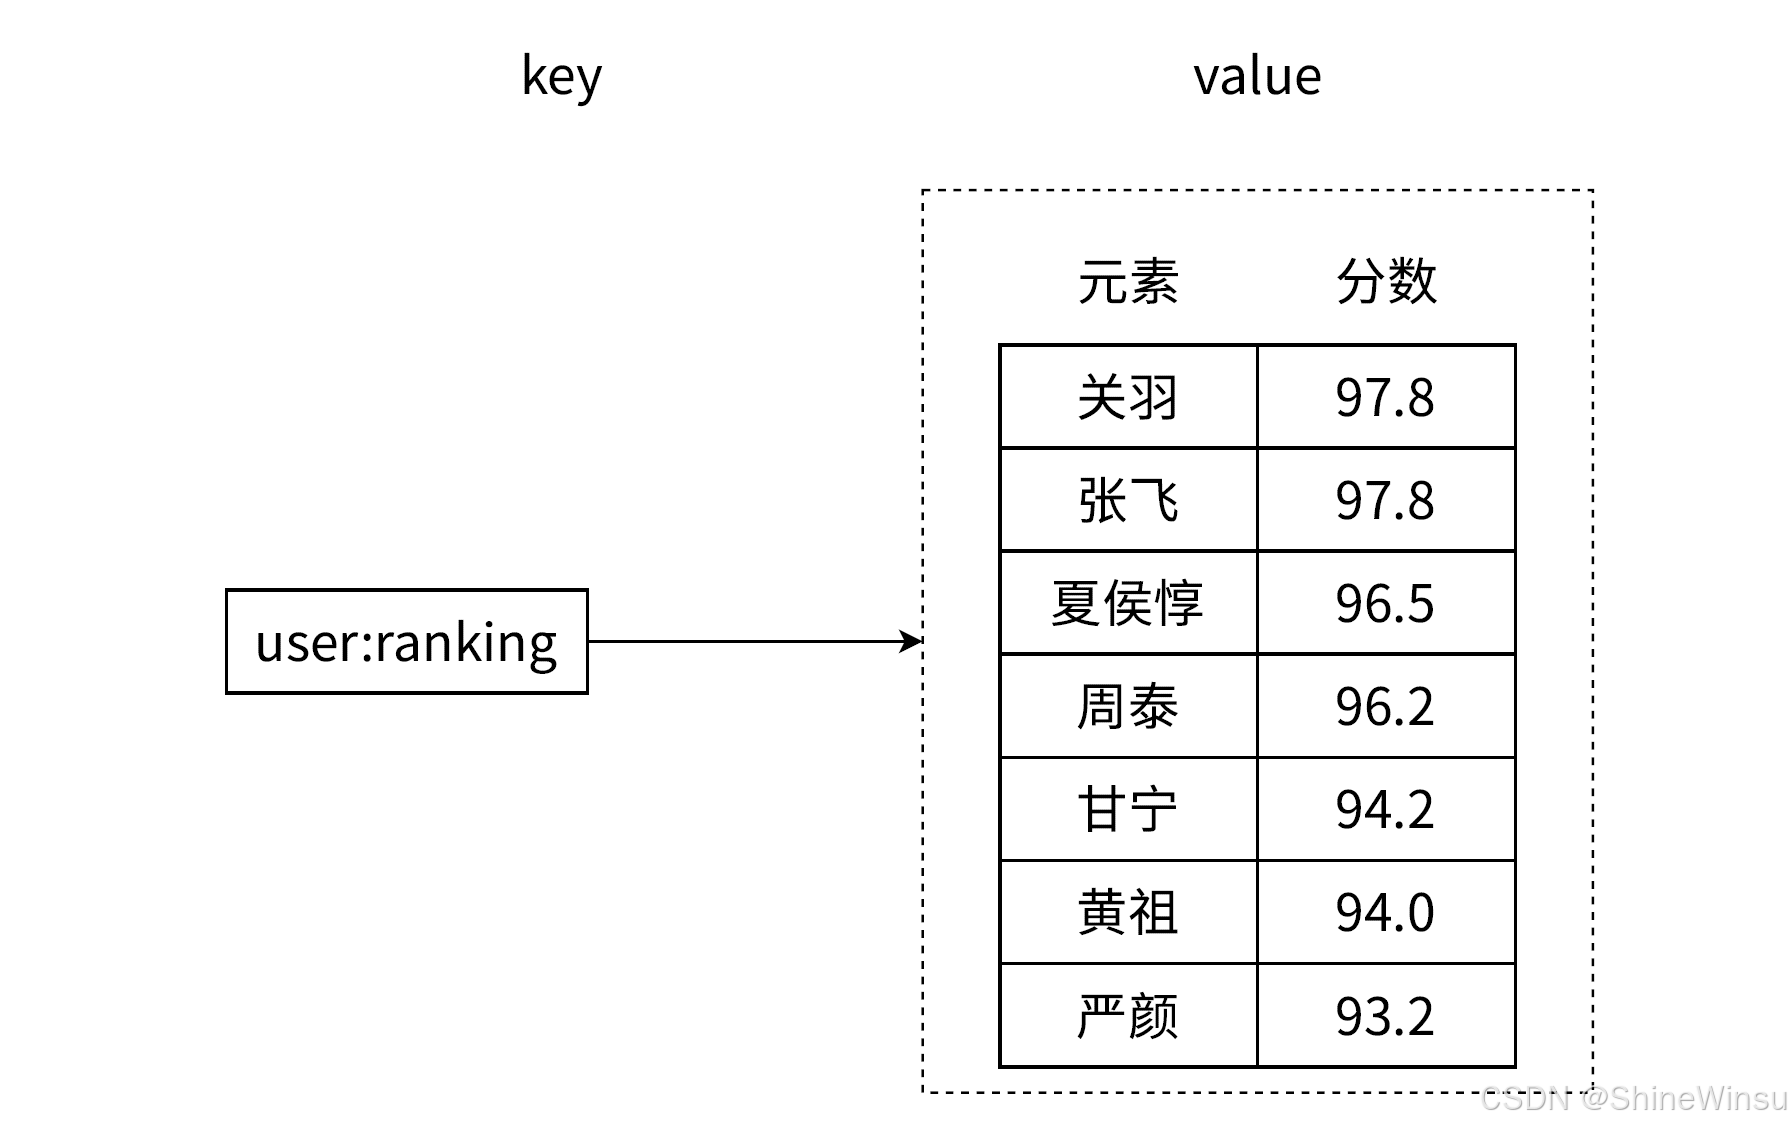
从这个例子我们能一眼看出 ZSet 的核心特征:元素不重复、分数可重复、按分数自动有序。
1.2 ZSet 两大「铁律」
ZSet 的所有命令、底层实现、业务逻辑,都围绕两条不可动摇的铁律展开:
铁律 1:元素(member)唯一,绝对不可重复
- 同一个 ZSet 中,同一个元素只能出现一次;
- 若重复添加已存在的元素,不会新增元素,只会更新该元素对应的分数,并触发重新排序;
- 这一点和普通 Set 完全一致,是 ZSet「去重能力」的核心。
铁律 2:分数(score)可重复,无任何唯一性限制
- 多个不同元素可以绑定完全相同的分数(如关羽、张飞武力值都是 97.8);
- 分数支持浮点数、整数、负数、正无穷(+inf)、负无穷(-inf);
- 分数是 ZSet「有序能力」的唯一依据。
1.3 ZSet 的有序性:排序依据是「分数(score)」,而非下标 / 插入顺序
这是 ZSet 和 List 最核心的区别:
- List 的有序 :依赖插入顺序 + 数组下标,和元素本身的值无关;
- ZSet 的有序 :完全依赖分数(score),默认按分数 ** 升序(从小到大)** 排列,也可手动指定降序(从大到小);
- 分数完全相同的元素,Redis 会按照元素的字典序(字母 / 汉字编码顺序) 做次要排序(业务开发中不建议强依赖此规则)。
1.4 分数(score)的完整规则:数据类型、合法取值、精度说明
ZSet 的 score 是 Redis 内部严格定义的类型,所有操作都必须遵循规则:
- 数据类型 :标准 64 位浮点数(double),兼容所有整数、小数;
- 合法取值 :
- 普通数值:整数(1、100、-5)、小数(97.8、3.1415、-0.5);
- 极限值:
+inf(正无穷,代表最大分数)、-inf(负无穷,代表最小分数),常用于范围查询的边界;
- 精度注意 :double 浮点数有精度限制,不建议存储超大整数(超过 2^53),否则会出现精度丢失(零基础只需记住:日常业务的分数、积分、战力值完全够用);
- 分数修改 :支持覆盖更新(ZADD)、增量更新(ZINCRBY/ZADD INCR),是实现动态排行榜、实时计分的核心。
1.5 List / Set / ZSet 三者核心异同深度对比
| 数据结构 | 是否允许重复元素 | 是否有序 | 有序依据 | 核心能力 | 典型应用场景 |
|---|---|---|---|---|---|
| List(列表) | 允许重复 | 有序 | 插入顺序 + 索引下标 | 有序序列、首尾高效操作、阻塞队列 | 时间轴、消息队列、评论流、栈 |
| Set(集合) | 不允许重复 | 无序 | 无(无序) | 去重、交集 / 并集 / 差集、随机抽取 | 标签、共同好友、UV 统计、黑名单 |
| ZSet(有序集合) | 不允许重复 | 有序 | 分数(score)+ 字典序 | 去重 + 排序、排名、范围查询、聚合 | 排行榜、热度榜、延时队列、积分系统 |
一句话总结三者差异:
- 需要有序 + 重复 → 用 List;
- 需要去重 + 无序 → 用 Set;
- 需要去重 + 有序 + 排名 + 范围查询 → 用 ZSet。
1.6 ZSet 的最大容量与存储限制
和普通 Set 一致,单个 ZSet 最多可存储 2^32 − 1(约 42 亿) 个元素,完全满足互联网业务海量数据的存储需求,日常开发几乎不会遇到容量上限问题。
1.7 ZSet 的核心能力与不可替代性
ZSet 是 Redis 唯一同时具备以下 6 大核心能力的数据结构,这也是它不可替代的原因:
- 元素去重:和 Set 一样,自动过滤重复元素;
- 自动排序:基于分数实时维护有序性,无需手动排序;
- 排名查询:快速获取任意元素的升序 / 降序排名;
- 范围查询:按分数区间、排名区间快速筛选元素;
- 动态计分:原子性增量 / 覆盖修改分数,高并发下无竞争;
- 多集合聚合:支持交集、并集、加权聚合,实现多榜单合并。
二、ZSet 普通核心命令
ZSet 的命令数量多、功能细,但逻辑高度统一 ------所有命令都围绕「元素 + 分数」的增删改查、排序、排名、范围、删除展开。
2.1 ZADD:ZSet 最核心写入命令(添加 / 更新元素 + 分数)
2.1.1 核心作用
向指定 ZSet 中添加新元素并绑定分数;若元素已存在,则覆盖更新其分数并重新排序;分数支持 double、+inf、-inf。
2.1.2 完整语法
ZADD key [NX | XX] [GT | LT] [CH] [INCR] score member [score member ...]2.1.3 有效版本
1.2.0 及以上
2.1.4 时间复杂度
O (log (N)) per member(单个元素),批量添加为 O (k・log (N)),k 为添加元素个数。
通俗解释:ZSet 底层用跳表实现,插入 / 更新的时间复杂度是对数级,性能极高,即使千万级元素也能快速操作。
2.1.5 返回值含义
- 默认:返回本次新增成功的元素个数(更新已存在元素不计入);
- 带
CH选项:返回新增 + 更新的总元素个数; - 带
INCR选项:返回增量计算后的最终分数(字符串格式)。
2.1.6 核心选项详解
ZADD 的选项是 ZSet 最核心的高级功能,覆盖「安全添加、安全更新、增量修改、计数统计」,逐一解释:
- XX :仅更新已存在的元素,绝不新增;元素不存在则直接跳过,不执行任何操作;
- NX :仅新增不存在的元素,绝不更新;元素已存在则直接跳过,不修改分数;
- GT :仅当新分数 > 旧分数时,才更新(大于才覆盖,用于只升不降的计分,如积分、战力);
- LT :仅当新分数 < 旧分数时,才更新(小于才覆盖,用于只降不升的计分);
- CH:修改返回值统计规则,默认只算新增,加 CH 后「新增 + 更新」都统计;
- INCR :增量修改分数(等价于 ZINCRBY),一次只能操作 1 个元素,返回新分数。
2.1.7 逐行实操示例
bash
# 1. 添加元素 "one",分数 1 → 新增成功,返回 1
redis> ZADD myzset 1 "one"
(integer) 1

# 2. 添加元素 "uno",分数 1 → 新增成功,返回 1
redis> ZADD myzset 1 "uno"
(integer) 1

# 3. 批量添加:two=2、three=3 → 新增 2 个,返回 2
redis> ZADD myzset 2 "two" 3 "three"
(integer) 2

# 4. 查询全量元素(升序)+ 分数(WITHSCORES)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "one"
2) "1"
3) "uno"
4) "1"
5) "two"
6) "2"
7) "three"
8) "3"

# 5. 更新已存在元素:one=10、two=20、three=30 → 无新增,返回 0
redis> ZADD myzset 10 one 20 two 30 three
(integer) 0

# 6. 再次查询,分数已更新
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "uno"
2) "1"
3) "one"
4) "10"
5) "two"
6) "20"
7) "three"
8) "30"

# 7. 加 CH 选项:更新 one=100、two=200、three=300 → 3 个更新,返回 3
redis> ZADD myzset CH 100 one 200 two 300 three
(integer) 3

# 8. 加 XX 选项:仅更新已存在元素,four/five 不存在 → 无操作,返回 0
redis> ZADD myzset XX 1 one 2 two 3 three 4 four 5 five
(integer) 0

# 9. 加 NX 选项:仅新增,one/two/three 已存在,仅新增 four、five → 返回 2
redis> ZADD myzset NX 100 one 200 two 300 three 400 four 500 five
(integer) 2

# 10. 加 INCR 选项:one 分数 +10(1+10=11),返回新分数
redis> ZADD myzset INCR 10 one
"11"

# 11. 添加负无穷、正无穷元素 → 新增 2 个,返回 2
redis> ZADD myzset -inf "negative infinity" +inf "positive infinity"
(integer) 2

# 12. 最终全量查询,包含 ±inf 元素
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "negative infinity"
2) "-inf"
3) "uno"
4) "1"
5) "two"
6) "2"
7) "three"
8) "3"
9) "one"
10) "11"
11) "four"
12) "400"
13) "five"
14) "500"
15) "positive infinity"
16) "inf"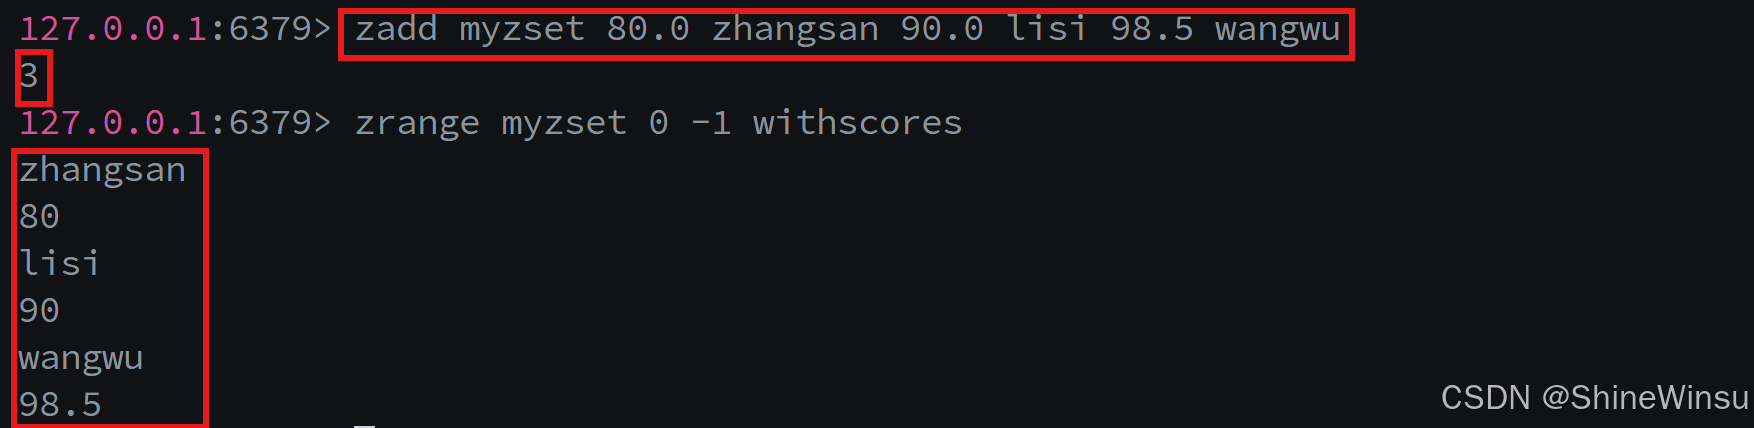
2.1.8 常见误区与注意事项
- 重复添加同一元素 = 覆盖分数,不会报错,也不会新增元素;
INCR选项一次只能操作 1 个元素,批量会报错;+inf/-inf是合法分数,常用于范围查询的「全量匹配」;- 分数为浮点数时,Redis 会自动存储,无需额外转换。
2.1.9 实战业务场景
- 初始化排行榜:
ZADD user:ranking:20260208 97.8 关羽 97.8 张飞; - 安全新增(不覆盖旧分数):
ZADD rank NX 100 user1001; - 只升不降计分(积分):
ZADD rank GT 105 user1001; - 实时更新榜单分数:
ZADD rank 88 user1001。
2.2 ZCARD:获取 ZSet 元素总个数(基数)
2.2.1 核心作用
查询指定 ZSet 中元素的总数量(和 Set 的 SCARD 完全一致),Key 不存在返回 0。
2.2.2 完整语法
ZCARD key2.2.3 有效版本
1.2.0 及以上
2.2.4 时间复杂度
O (1)(Redis 内部维护长度计数器,无需遍历,性能极致)
2.2.5 返回值含义
整数:ZSet 中的元素个数;Key 不存在返回 0。
2.2.6 逐行实操示例
bash
# 1. 添加 2 个元素
redis> ZADD myzset 1 "one"
(integer) 1
redis> ZADD myzset 2 "two"
(integer) 1

# 2. 查询总个数 → 返回 2
redis> ZCARD myzset
(integer) 2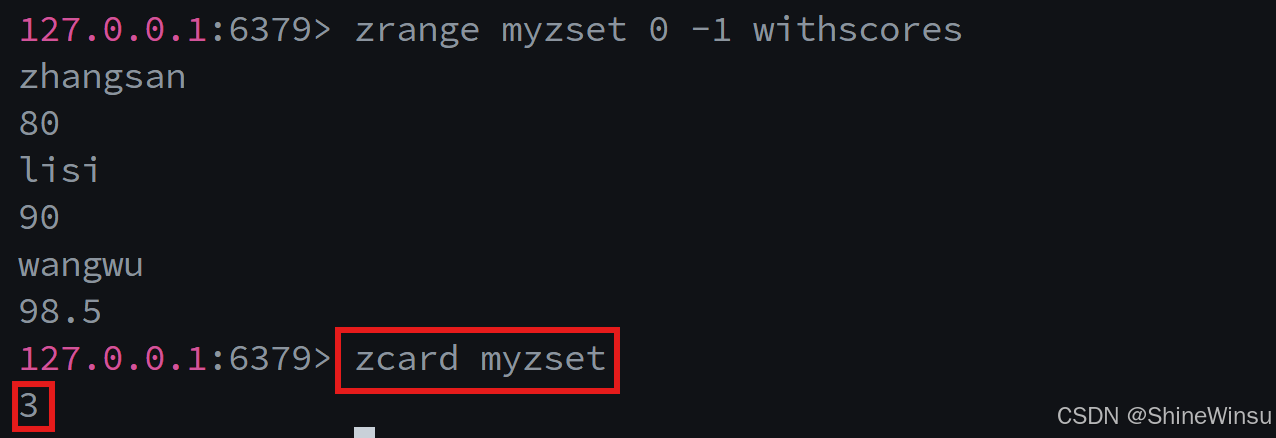
2.2.7 实战业务场景
- 统计榜单总参与人数:
ZCARD user:ranking:20260208; - 统计延时任务队列长度:
ZCARD delay:task:queue。
2.3 ZCOUNT:统计指定分数区间内的元素个数
2.3.1 核心作用
查询分数在 [min, max] 区间内的元素数量;默认包含 min 和 max,用 ( 前缀表示开区间(不包含),这里的min和max是指分数,可不是下标哦
2.3.2 完整语法
ZCOUNT key min max2.3.3 有效版本
2.0.0 及以上
2.3.4 时间复杂度
O (log (N))(先定位分数边界,再计数,性能极高)
2.3.5 返回值含义
整数:满足分数区间条件的元素个数。
2.3.6 区间规则(重点)
1 3:闭区间,包含 1 和 3;(1 3:开区间左,不包含 1,包含 3;(1 (3:全开区间,不包含 1 和 3;-inf +inf:匹配所有元素(全量计数)。
2.3.7 逐行实操示例
bash
# 1. 添加 3 个元素:one=1、two=2、three=3
redis> ZADD myzset 1 "one"
(integer) 1
redis> ZADD myzset 2 "two"
(integer) 1
redis> ZADD myzset 3 "three"
(integer) 1

# 2. 全量计数(-inf 到 +inf)→ 返回 3
redis> ZCOUNT myzset -inf +inf
(integer) 3

# 3. [1,3] → 返回 3
redis> ZCOUNT myzset 1 3
(integer) 3

# 4. (1,3] → 不包含 1,返回 2(two、three)
redis> ZCOUNT myzset (1 3
(integer) 2

# 5. (1,3) → 全开区间,返回 1(two)
redis> ZCOUNT myzset (1 (3
(integer) 1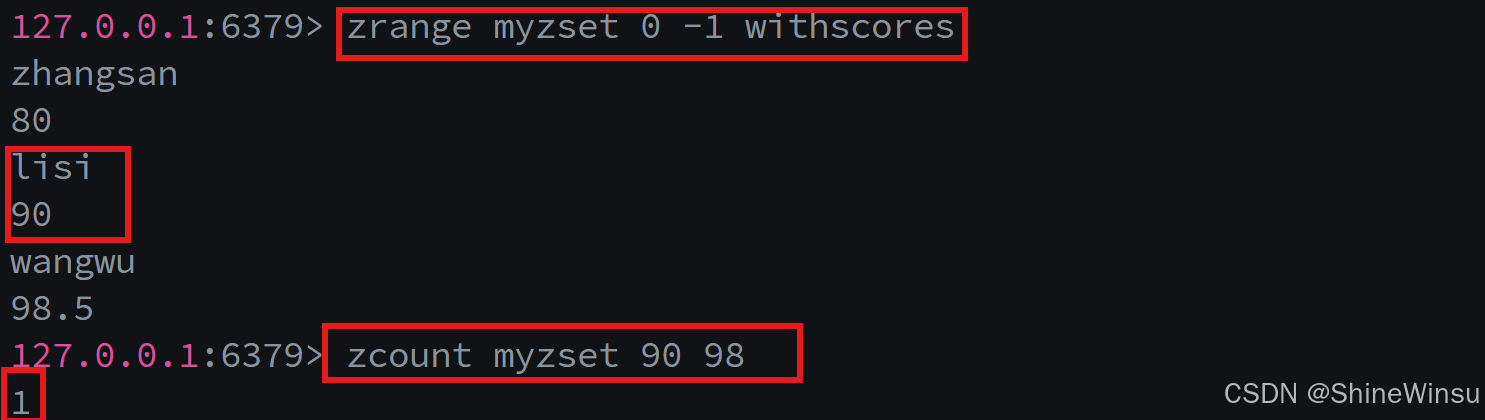
2.3.8 实战业务场景
- 统计考试 60~80 分的学生人数:
ZCOUNT exam:score 60 80; - 统计热度 1000~5000 的内容数量:
ZCOUNT content:hot 1000 5000; - 统计武力值 90~100 的武将数量:
ZCOUNT user:ranking 90 100。
2.4 ZRANGE:按下标区间查询(升序:分数从小到大)
2.4.1 核心作用
按 ** 升序(分数小 → 大)** 返回指定下标区间的元素;支持 WITHSCORES 同时返回分数;下标从 0 开始,支持负数(-1 = 最后一个元素,带有负号就是指倒数~),注意这里要填入的数字就是下标了哦,那么我们要是输入0和-1就是指将全部都显示出来
2.4.2 完整语法
bash
ZRANGE key start stop [WITHSCORES]2.4.3 有效版本
1.2.0 及以上
2.4.4 时间复杂度
O (log (N) + M),N=ZSet 总元素数,M = 返回元素数(查询性能极高)。
2.4.5 返回值含义
- 不带 WITHSCORES:元素列表;
- 带 WITHSCORES:元素 + 分数交替返回的列表。
2.4.6 逐行实操示例
bash
# 1. 添加 3 个元素
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 全量查询 + 分数
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "one"
2) "1"
3) "two"
4) "2"
5) "three"
6) "3"

# 3. 仅查询元素(无分数)
redis> ZRANGE myzset 0 -1
1) "one"
2) "two"
3) "three"

# 4. 下标 2~3 → 仅 three
redis> ZRANGE myzset 2 3
1) "three"

# 5. 倒数 2 个元素(-2~-1)→ two、three
redis> ZRANGE myzset -2 -1
1) "two"
2) "three"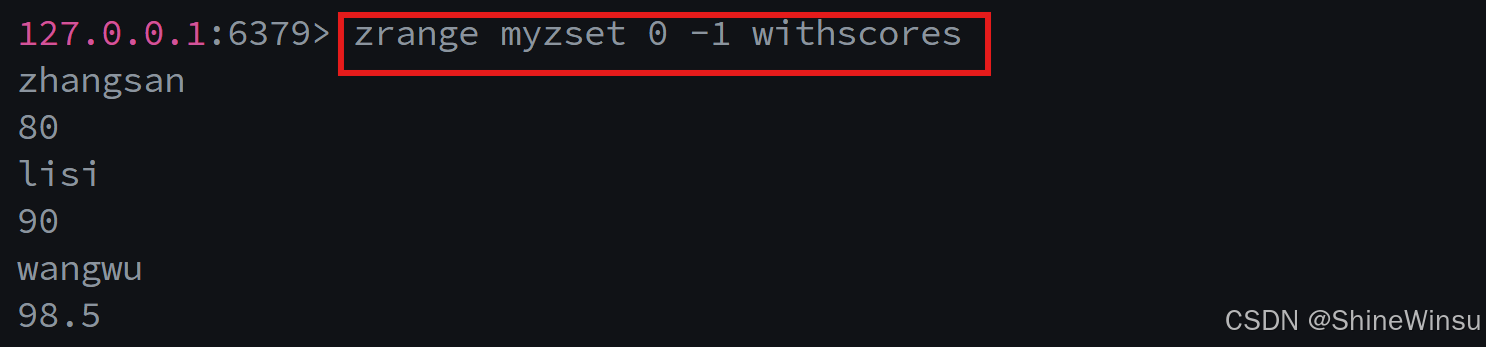
2.4.7 实战业务场景
- 查询榜单末尾 N 个元素(分数最低);
- 榜单分页查询(升序);
- 小范围遍历 ZSet 元素。
2.5 ZREVRANGE:按下标区间查询(降序:分数从大到小)
2.5.1 核心作用(详细版)
ZREVRANGE 是 ZRANGE 命令的逆序增强版本,核心作用是严格按照有序集合(ZSet)中元素的分数从大到小(降序)排序,精准返回指定下标区间内的所有元素;支持携带元素对应的分数一起返回,是实现 "排行榜 TOP N 展示、高分元素优先获取" 类业务的核心命令,也是生产环境中最常用的 ZSet 查询命令之一。
该命令的下标规则与数组下标逻辑完全一致:下标从 0 开始(0 对应降序后的第一个元素,即分数最大的元素),-1 代表最后一个元素(分数最小的元素),-2 代表倒数第二个元素,以此类推;查询区间为左闭右闭,即 start 和 stop 对应的元素都会被包含在结果中。
2.5.2 备注
Redis 6.2.0+ 版本中,官方建议使用 ZRANGE key start stop REV [WITHSCORES] 替代 ZREVRANGE(功能完全等价),但由于 Redis 5.x、4.x 等低版本仍在生产环境广泛部署,ZREVRANGE 仍是开发者必须熟练掌握的基础命令;低版本 Redis 无此替代方案,只能使用 ZREVRANGE。
2.5.3 完整语法
ZREVRANGE key start stop [WITHSCORES]key:必填,目标有序集合的键名(需确保键存在且类型为 ZSet,否则返回空数组);start:必填,起始下标(整数,支持负数,如 0 代表第一个元素,-1 代表最后一个元素);stop:必填,结束下标(整数,支持负数,如 9 代表第 10 个元素,-2 代表倒数第二个元素);WITHSCORES:可选,若添加此参数,返回结果会同时包含元素名称和对应的分数;若不添加,仅返回元素名称。
2.5.4 有效版本
1.2.0 及以上(全版本兼容,无兼容性风险)
2.5.5 逐行实操示例
# 1. 向有序集合 myzset 中添加 3 个元素(格式:分数 元素值)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3  # 返回值:成功添加的元素个数(无重复元素时等于输入数量)

# 2. 降序查询全量元素并携带分数(0 到 -1 覆盖所有元素,WITHSCORES 携带分数)
redis> ZREVRANGE myzset 0 -1 WITHSCORES
1) "three"   # 第一个元素(分数 3,降序第一)
2) "3"       # three 对应的分数(字符串格式返回)
3) "two"     # 第二个元素(分数 2)
4) "2"       # two 对应的分数
5) "one"     # 第三个元素(分数 1,降序最后)
6) "1"       # one 对应的分数

# 3. 仅查询降序全量元素(不携带分数)
redis> ZREVRANGE myzset 0 -1
1) "three"
2) "two"
3) "one"

# 补充示例:查询降序 TOP1 元素(仅第一个元素)
redis> ZREVRANGE myzset 0 0 WITHSCORES
1) "three"
2) "3"

# 补充示例:下标超出范围时(无报错,仅返回存在的元素)
redis> ZREVRANGE myzset 0 100 WITHSCORES
1) "three"
2) "3"
3) "two"
4) "2"
5) "one"
6) "1"
2.5.6 返回值解析
ZREVRANGE 的返回值为数组(列表)类型,具体格式分两种情况:
- 未添加
WITHSCORES参数:返回一维字符串数组,数组元素为符合下标区间的 ZSet 元素名称,顺序严格为分数从大到小;若目标 ZSet 为空、不存在,或无符合条件的元素,返回空数组(())。 - 添加
WITHSCORES参数:返回 "交替排列" 的一维数组(逻辑上是二维,存储为一维),格式为「元素 1、元素 1 分数、元素 2、元素 2 分数......」,所有分数均以字符串形式返回(Redis 中数值类返回值默认存储为字符串);无符合条件元素时返回空数组。
2.5.7 关键细节说明
- 下标容错:
start/stop超出 ZSet 实际下标范围时,不会抛出异常,只会返回存在的元素(如ZREVRANGE myzset 0 100仅返回所有元素); - 空键处理:若目标
key不存在(或不是 ZSet 类型),命令返回空数组,无报错; - 性能特性:时间复杂度为
O(log(N)+M),其中N是 ZSet 总元素数,M是返回的元素数;查询少量元素(如 TOP10)时性能极高,适合高并发场景;查询全量元素时需注意耗时(与元素总数正相关)。
2.5.8 实战业务场景(详细版)
- 游戏战力排行榜:查询全服战力 TOP10 玩家,命令为
ZREVRANGE game:ranking:power 0 9 WITHSCORES,返回结果可直接展示 "玩家 ID + 战力值"; - 电商销量榜单:查询 2026 年 2 月销量最高的 20 个商品,命令为
ZREVRANGE shop:ranking:sales:202602 0 19 WITHSCORES; - 内容热度榜单:查询当前平台热度最高的 50 篇文章,命令为
ZREVRANGE content:ranking:hot 0 49 WITHSCORES; - 考试成绩排名:查询班级数学成绩前 10 名的学生,命令为
ZREVRANGE class:1:math:score 0 9 WITHSCORES; - 积分排行榜:查询用户积分降序前 5 名,命令为
ZREVRANGE user:ranking:points 0 4 WITHSCORES。
2.6 ZRANGEBYSCORE:按分数区间查询(升序)
2.6.1 核心作用(详细版)
ZRANGEBYSCORE 是有序集合中按分数维度精准筛选元素的核心命令 ,核心作用是按照元素分数从小到大(升序)的顺序,返回指定分数区间内的所有元素;支持闭区间(默认)、开区间(使用 ( 标识),还支持无限区间(-inf 代表负无穷,+inf 代表正无穷),是实现 "分数范围筛选、条件过滤" 类业务的核心命令。
与 ZREVRANGE 最大的区别是:ZRANGEBYSCORE 的筛选维度是 "分数" 而非 "下标",开发者只需关注元素的分数范围,无需关心元素在 ZSet 中的下标位置。
2.6.2 备注
Redis 6.2.0+ 版本中,官方建议使用 ZRANGE key BYSCORE min max [WITHSCORES] 替代 ZRANGEBYSCORE(功能完全一致),但低版本 Redis(5.x 及以下)仍需使用 ZRANGEBYSCORE,是生产环境的主流用法;该命令支持分页(LIMIT 参数),可避免返回大量元素导致的性能问题。
2.6.3 完整语法
ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT offset count]key:必填,目标有序集合的键名;min:必填,分数区间下限,支持整数 / 浮点数、-inf(负无穷)、(数值(开区间,不包含该数值);max:必填,分数区间上限,支持整数 / 浮点数、+inf(正无穷)、(数值(开区间,不包含该数值);WITHSCORES:可选,添加后返回元素名称 + 对应分数,否则仅返回元素名称;LIMIT offset count:可选(Redis 2.0.0 + 支持),分页参数,offset为偏移量,count为每页数量,用于避免返回大量元素。
2.6.4 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3  # 返回值:成功添加的元素个数

# 2. 查询分数区间「负无穷到正无穷」的所有元素(全量),升序排列
redis> ZRANGEBYSCORE myzset -inf +inf
1) "one"   # 分数 1(最小)
2) "two"   # 分数 2
3) "three" # 分数 3(最大)

# 3. 查询分数区间 [1,2] 的元素(闭区间,包含 1 和 2)
redis> ZRANGEBYSCORE myzset 1 2
1) "one"
2) "two"

# 4. 查询分数区间 (1,2] 的元素(开区间,不包含 1,仅包含 2)
redis> ZRANGEBYSCORE myzset (1 2
1) "two"

# 补充示例:查询分数 ≥2 且 ≤3 的元素并携带分数
redis> ZRANGEBYSCORE myzset 2 3 WITHSCORES
1) "two"
2) "2"
3) "three"
4) "3"

# 补充示例:查询分数 <3 的元素(开区间上限)
redis> ZRANGEBYSCORE myzset -inf (3
1) "one"
2) "two"

# 补充示例:分页查询分数 1~3 的元素,每页 2 条,取第 2 页
redis> ZRANGEBYSCORE myzset 1 3 LIMIT 2 2
1) "three"
2.6.5 返回值解析
ZRANGEBYSCORE 的返回值为数组(列表)类型,规则与 ZREVRANGE 完全一致:
- 未添加
WITHSCORES:返回一维字符串数组,元素为符合分数区间的 ZSet 元素名称,顺序为分数从小到大;无符合条件元素时返回空数组。 - 添加
WITHSCORES:返回交替排列的一维数组(元素 1、元素 1 分数、元素 2、元素 2 分数......),分数以字符串形式返回;无符合条件元素时返回空数组。 - 添加
LIMIT:返回结果会按分页规则截取,若偏移量超出元素总数,返回空数组。
2.6.6 关键细节说明
- 区间规则:默认所有区间为闭区间(包含边界值),若需排除边界值,需在数值前加
(符号(如(1代表大于 1,(3代表小于 3); - 无限区间:
-inf和+inf无需加引号,直接使用即可,分别代表 "最小分数" 和 "最大分数"; - 分页注意:
LIMIT参数的时间复杂度会增加O(M)(M为offset+count),偏移量过大时(如LIMIT 10000 10)会有性能损耗,需谨慎使用; - 空键处理:目标
key不存在或非 ZSet 类型时,返回空数组,无报错; - 性能特性:时间复杂度为
O(log(N)+M),N为 ZSet 总元素数,M为返回的元素数;返回少量元素时性能极高,返回大量元素时需结合分页。
2.6.7 实战业务场景(详细版)
- 学生成绩筛选:查询班级数学成绩 90~100 分的学生(闭区间),命令为
ZRANGEBYSCORE class:1:math:score 90 100 WITHSCORES; - 内容热度筛选:查询平台热度 > 1000 的文章(开区间下限),命令为
ZRANGEBYSCORE content:ranking:hot (1000 +inf WITHSCORES; - 游戏武将筛选:查询武力值 95~100 的武将(闭区间),命令为
ZRANGEBYSCORE game:general:power 95 100 WITHSCORES; - 积分筛选:查询用户积分≥5000 且 < 10000 的会员(半开半闭区间),命令为
ZRANGEBYSCORE user:vip:points 5000 (10000 WITHSCORES; - 分页查询高分学生:查询 80~100 分的学生,每页 10 条,取第 2 页,命令为
ZRANGEBYSCORE class:1:math:score 80 100 LIMIT 10 10 WITHSCORES; - 低质内容清理前置筛选:查询热度 < 10 的内容(用于后续删除),命令为
ZRANGEBYSCORE content:ranking:hot -inf (10。
2.7 ZPOPMAX:删除并返回分数最高的 N 个元素
2.7.1 核心作用(详细版)
ZPOPMAX 是有序集合的 "弹出类" 核心命令,核心作用是原子性地删除有序集合中分数最高的一个或多个元素,并返回被删除的元素(及对应分数);支持指定弹出元素的个数(count),是实现 "优先级队列、任务调度、抽奖活动" 等业务的核心命令。
该命令的 "原子性" 是关键特性:删除和返回操作是一个不可分割的整体,即使高并发场景下,也不会出现 "元素被多个客户端同时获取" 的问题;若指定的 count 大于 ZSet 中的元素总数,只会删除并返回所有元素。
2.7.2 完整语法
ZPOPMAX key [count]key:必填,目标有序集合的键名;count:可选,需要弹出的元素个数(正整数),默认值为 1(仅弹出分数最高的 1 个元素)。
2.7.3 有效版本
5.0.0 及以上(低版本 Redis 无此命令,需通过 ZREVRANGE + ZREM 模拟,但无原子性保证)
2.7.4 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3  # 返回值:成功添加的元素个数

# 2. 弹出分数最高的 1 个元素(默认 count=1)
redis> ZPOPMAX myzset
1) "three"   # 被删除的元素名称
2) "3"       # 被删除元素的分数(字符串格式)

# 3. 查看弹出后的 ZSet(仅剩 one、two)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "one"
2) "1"
3) "two"
4) "2"

# 补充示例:弹出分数最高的 2 个元素
redis> ZPOPMAX myzset 2
1) "two"   # 第一个被删除的元素(分数 2)
2) "2"
3) "one"   # 第二个被删除的元素(分数 1)
4) "1"

# 补充示例:count 大于元素总数(无报错,返回所有元素)
redis> ZPOPMAX myzset 10
(empty array) # ZSet 已空,返回空数组
2.7.5 返回值解析
ZPOPMAX 的返回值为数组(列表)类型,规则如下:
- 未指定 count(默认 count=1):返回交替排列的一维数组,格式为「被删除元素、元素分数」;若 ZSet 为空,返回空数组。
- 指定 count(count≥1):返回交替排列的一维数组,格式为「元素 1、元素 1 分数、元素 2、元素 2 分数......」,元素顺序为分数从高到低;若 ZSet 为空,返回空数组;若 count 大于元素总数,仅返回所有被删除的元素。所有分数均以字符串形式返回。
2.7.6 关键细节说明
- 原子性:删除和返回操作是原子的,高并发下无竞态条件(如多个客户端同时执行 ZPOPMAX,不会获取到同一个元素);
- 空键处理:目标 key 不存在或为空 ZSet 时,返回空数组,无报错;
- 性能特性:时间复杂度为
O(log(N)+M),N为 ZSet 总元素数,M为弹出的元素数;弹出少量元素时性能极高; - 低版本兼容:5.0.0 以下版本需模拟实现(
ZREVRANGE key 0 count-1 WITHSCORES+ZREM key 元素1 元素2...),但此方式非原子性,高并发下可能出错。
2.7.7 实战业务场景(详细版)
- 优先级任务队列:高优先级任务(分数高)先执行,每次弹出 1 个最高优先级任务,命令为
ZPOPMAX task:queue:priority,获取后执行任务逻辑; - 抽奖活动:抽奖榜单中分数最高的用户中奖,中奖后移除该用户,命令为
ZPOPMAX lottery:ranking 1; - 限时秒杀资格发放:按用户预约优先级(分数)发放前 10 个秒杀资格,命令为
ZPOPMAX seckill:reserve 10; - 任务调度:按任务紧急程度(分数)处理前 5 个任务,命令为
ZPOPMAX task:queue:urgent 5; - 排行榜清零:弹出并记录排行榜所有元素(用于数据归档),命令为
ZPOPMAX game:ranking:daily 10000(count 设为足够大)。
2.8 BZPOPMAX:ZPOPMAX 的阻塞版本
2.8.1 核心作用(详细版)
BZPOPMAX 是 ZPOPMAX 的阻塞增强版本,核心作用是原子性地弹出指定有序集合中分数最高的元素;若所有指定的 ZSet 均为空,客户端会阻塞等待,直到有元素被添加到任意一个 ZSet 中,或等待时间达到超时阈值。
该命令是实现 "分布式阻塞优先级队列" 的核心:多个客户端可同时监听同一个 / 多个 ZSet,当有元素添加时,只有一个客户端能原子性地获取到该元素,完美解决分布式场景下的任务调度问题;支持监听多个 ZSet,按参数顺序优先弹出第一个非空 ZSet 的最高分数元素。
2.8.2 完整语法
BZPOPMAX key [key ...] timeoutkey [key ...]:必填,一个或多个目标有序集合的键名(按顺序优先级监听);timeout:必填,阻塞超时时间(单位:秒),支持浮点数(如 0.5 代表 500 毫秒);若设为 0,代表永久阻塞(直到有元素弹出)。
2.8.3 逐行实操示例
# 1. 清空待监听的 ZSet(确保初始为空)
redis> DEL zset1 zset2
(integer) 0  # 返回值:被删除的键个数(无键则为0)

# 2. 向 zset1 添加 3 个元素(分数 0、1、2)
redis> ZADD zset1 0 "a" 1 "b" 2 "c"
(integer) 3  # 返回值:成功添加的元素个数

# 3. 阻塞弹出最大值(监听 zset1、zset2,timeout=0 永久阻塞)
redis> BZPOPMAX zset1 zset2 0
1) "zset1"   # 弹出元素所属的 ZSet 键名
2) "c"       # 被弹出的元素名称
3) "2"       # 被弹出元素的分数(字符串格式)

# 补充示例:监听空 ZSet,设置超时时间 5 秒(5秒后返回空)
redis> BZPOPMAX zset1 zset2 5
(nil) # 超时后返回 nil,无元素弹出

# 补充示例:多 ZSet 监听(zset2 有元素时优先弹出 zset1?不,按参数顺序)
redis> ZADD zset2 10 "x"
(integer) 1
redis> BZPOPMAX zset1 zset2 0
1) "zset2"   # zset1 为空,弹出 zset2 的最高分数元素
2) "x"
3) "10"
2.8.4 返回值解析
BZPOPMAX 的返回值分两种情况:
- 成功弹出元素:返回一维数组,格式为「所属 ZSet 键名、被弹出元素名称、元素分数」,分数以字符串形式返回;
- 超时无元素:返回
nil(空),代表阻塞时间达到 timeout 阈值,且所有监听的 ZSet 仍为空。
2.8.5 关键细节说明
- 监听优先级:按参数中 key 的顺序监听,优先弹出第一个非空 ZSet 的最高分数元素(即使后续 ZSet 有更高分数的元素);
- 原子性:弹出操作是原子的,多个客户端监听同一个 ZSet 时,只有一个客户端能获取到元素;
- 阻塞特性:客户端阻塞期间,不会占用 Redis 主线程资源(Redis 采用 IO 多路复用处理阻塞客户端);
- 超时规则:timeout 设为 0 时永久阻塞,直到有元素弹出;设为正数时,超时后返回 nil,客户端解除阻塞;
- 空键处理:监听的 key 不存在时,视为空 ZSet,继续监听下一个 key。
2.8.6 实战业务场景(详细版)
- 分布式优先级任务队列:多台服务器监听同一个任务队列,高优先级任务到达时,其中一台服务器原子性获取并执行,命令为
BZPOPMAX task:queue:priority 0; - 多队列任务调度:监听 "紧急任务队列" 和 "普通任务队列",优先处理紧急任务,命令为
BZPOPMAX task:queue:urgent task:queue:normal 0; - 实时消息推送:按消息优先级(分数)推送,无消息时阻塞等待,命令为
BZPOPMAX msg:queue:priority 0; - 秒杀活动库存处理:监听秒杀资格队列,有资格用户时立即处理,无用户时阻塞等待,命令为
BZPOPMAX seckill:queue 60(超时 60 秒后退出)。
2.9 ZPOPMIN:删除并返回分数最低的元素
2.9.1 核心作用(详细版)
ZPOPMIN 是 ZPOPMAX 的反向命令,核心作用是原子性地删除有序集合中分数最低的一个或多个元素,并返回被删除的元素(及对应分数);支持指定弹出元素的个数(count),适用于 "低优先级任务清理、低分元素淘汰" 等场景。
该命令同样具备原子性:删除和返回操作不可分割,高并发下无竞态条件;若指定的 count 大于 ZSet 中的元素总数,只会删除并返回所有元素。
2.9.2 完整语法
ZPOPMIN key [count]key:必填,目标有序集合的键名;count:可选,需要弹出的元素个数(正整数),默认值为 1(仅弹出分数最低的 1 个元素)。
2.9.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3  # 返回值:成功添加的元素个数

# 2. 弹出分数最低的 1 个元素(默认 count=1)
redis> ZPOPMIN myzset
1) "one"    # 被删除的元素名称
2) "1"      # 被删除元素的分数(字符串格式)

# 3. 查看弹出后的 ZSet(仅剩 two、three)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "two"
2) "2"
3) "three"
4) "3"

# 补充示例:弹出分数最低的 2 个元素
redis> ZPOPMIN myzset 2
1) "two"    # 第一个被删除的元素(分数 2)
2) "2"
3) "three"  # 第二个被删除的元素(分数 3)
4) "3"

# 补充示例:count 大于元素总数(返回空数组)
redis> ZPOPMIN myzset 10
(empty array)
2.9.4 返回值解析
ZPOPMIN 的返回值规则与 ZPOPMAX 完全一致:
- 未指定 count:返回「被删除元素、元素分数」的一维数组;ZSet 为空时返回空数组。
- 指定 count:返回「元素 1、元素 1 分数、元素 2、元素 2 分数......」的一维数组,元素顺序为分数从低到高;ZSet 为空时返回空数组。所有分数均以字符串形式返回。
2.9.5 关键细节说明
- 原子性:删除 + 返回操作原子化,高并发下无重复获取问题;
- 低版本兼容:5.0.0 以下版本需通过
ZRANGE key 0 count-1 WITHSCORES + ZREM模拟,无原子性; - 性能特性:时间复杂度
O(log(N)+M),弹出少量元素时性能极高; - 空键处理:目标 key 不存在或为空 ZSet 时,返回空数组,无报错。
2.9.6 实战业务场景(详细版)
- 低优先级任务清理:删除并处理分数最低的 10 个低优先级任务,命令为
ZPOPMIN task:queue:low 10; - 榜单低分元素淘汰:淘汰排行榜中分数最低的 50 个元素,命令为
ZPOPMIN game:ranking:daily 50; - 库存兜底处理:弹出分数最低的用户(最后兜底的库存),命令为
ZPOPMIN seckill:reserve 1; - 低分数据清理:删除热度最低的内容(用于释放内存),命令为
ZPOPMIN content:ranking:hot 100。
2.10 BZPOPMIN:ZPOPMIN 的阻塞版本
2.10.1 核心作用(详细版)
BZPOPMIN 是 ZPOPMIN 的阻塞增强版本,核心作用是原子性地弹出指定有序集合中分数最低的元素;若所有指定的 ZSet 均为空,客户端会阻塞等待,直到有元素被添加到任意一个 ZSet 中,或等待时间达到超时阈值。
该命令是实现 "分布式阻塞低优先级队列、低分元素实时处理" 的核心,特性与 BZPOPMAX 完全一致,仅弹出的是分数最低的元素。
2.10.2 完整语法
BZPOPMIN key [key ...] timeoutkey [key ...]:必填,一个或多个目标有序集合的键名(按顺序优先级监听);timeout:必填,阻塞超时时间(单位:秒),0 代表永久阻塞。
2.10.3 逐行实操示例
# 1. 清空待监听的 ZSet
redis> DEL zset1 zset2
(integer) 0

# 2. 向 zset1 添加 3 个元素(分数 0、1、2)
redis> ZADD zset1 0 "a" 1 "b" 2 "c"
(integer) 3

# 3. 阻塞弹出分数最低的元素(timeout=0 永久阻塞)
redis> BZPOPMIN zset1 zset2 0
1) "zset1"   # 弹出元素所属的 ZSet 键名
2) "a"       # 被弹出的元素名称
3) "0"       # 被弹出元素的分数

# 补充示例:监听空 ZSet,超时 5 秒
redis> BZPOPMIN zset1 zset2 5
(nil) # 超时返回 nil
2.10.4 返回值解析
BZPOPMIN 的返回值规则与 BZPOPMAX 完全一致:
- 成功弹出:返回「所属 ZSet 键名、元素名称、元素分数」的一维数组;
- 超时无元素:返回
nil。
2.10.5 关键细节说明
- 监听优先级:按 key 参数顺序监听,优先弹出第一个非空 ZSet 的分数最低元素;
- 原子性:弹出操作原子化,多客户端无竞态条件;
- 阻塞特性:阻塞期间不占用 Redis 主线程资源;
- 空键处理:不存在的 key 视为空 ZSet。
2.10.6 实战业务场景(详细版)
- 分布式低优先级任务队列:多服务器监听低优先级任务队列,有任务时原子性获取并执行,命令为
BZPOPMIN task:queue:low 0; - 低分数据实时处理:监听低分内容队列,有新内容时立即处理,命令为
BZPOPMIN content:queue:low 0; - 兜底任务调度:监听 "兜底任务队列",无任务时阻塞等待,命令为
BZPOPMIN task:queue:backup 60。
2.11 ZRANK:查询元素升序排名(分数小 → 大)
2.11.1 核心作用(详细版)
ZRANK 是有序集合的 "排名查询" 核心命令,核心作用是查询指定元素在有序集合中的升序排名(分数从小到大),排名从 0 开始计数 ;若元素不存在于 ZSet 中,返回 nil。
该命令是实现 "元素排名查询、分数位次确认" 的基础,与 ZREVRANK 是互补关系,前者查升序排名(低分位次),后者查降序排名(高分位次)。
2.11.2 完整语法
ZRANK key memberkey:必填,目标有序集合的键名;member:必填,需要查询排名的元素名称(字符串类型)。
2.11.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 查询 "three" 的升序排名(分数 3,升序第 2 位,0 开始)
redis> ZRANK myzset "three"
(integer) 2

# 3. 查询 "two" 的升序排名(分数 2,升序第 1 位)
redis> ZRANK myzset "two"
(integer) 1

# 4. 查询不存在的元素 "four"(返回 nil)
redis> ZRANK myzset "four"
(nil)

# 5. 查询 "one" 的升序排名(分数 1,升序第 0 位)
redis> ZRANK myzset "one"
(integer) 0
2.11.4 返回值解析
ZRANK 的返回值分两种情况:
- 元素存在:返回整数类型的升序排名(从 0 开始);
- 元素不存在(或目标 key 非 ZSet 类型):返回
nil(空)。
2.11.5 关键细节说明
- 排名规则:升序排名从 0 开始,分数最小的元素排名为 0;
- 分数相同:若多个元素分数相同,排名按元素名称的字典序(lexicographical order)排序;
- 性能特性:时间复杂度
O(log(N)),查询效率极高(与 ZSet 元素总数无关); - 空键处理:目标 key 不存在时,返回
nil,无报错。
2.11.6 实战业务场景(详细版)
- 学生成绩升序排名:查询学生 "张三" 的数学成绩升序排名,命令为
ZRANK class:1:math:score "张三"; - 积分位次查询:查询用户 "user1001" 的积分升序排名(低分位次),命令为
ZRANK user:ranking:points "user1001"; - 战力位次确认:查询武将 "赵云" 的武力值升序排名,命令为
ZRANK game:general:power "赵云"; - 内容热度位次:查询文章 "art10086" 的热度升序排名,命令为
ZRANK content:ranking:hot "art10086"。
2.12 ZREVRANK:查询元素降序排名(分数大 → 小)
2.12.1 核心作用(详细版)
ZREVRANK 是 ZRANK 的逆序版本,核心作用是查询指定元素在有序集合中的降序排名(分数从大到小),排名从 0 开始计数(0 代表第一名) ;若元素不存在于 ZSet 中,返回 nil。
该命令是业务中 "展示用户排名、元素位次" 最常用的命令,因为用户更关注 "第几名"(降序),而非升序位次。
2.12.2 完整语法
ZREVRANK key memberkey:必填,目标有序集合的键名;member:必填,需要查询排名的元素名称。
2.12.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 查询 "one" 的降序排名(分数 1,降序第 2 位)
redis> ZREVRANK myzset "one"
(integer) 2

# 3. 查询 "three" 的降序排名(分数 3,降序第 0 位,第一名)
redis> ZREVRANK myzset "three"
(integer) 0

# 4. 查询 "two" 的降序排名(分数 2,降序第 1 位)
redis> ZREVRANK myzset "two"
(integer) 1

# 5. 查询不存在的元素 "four"(返回 nil)
redis> ZREVRANK myzset "four"
(nil)
2.12.4 返回值解析
ZREVRANK 的返回值规则与 ZRANK 完全一致:
- 元素存在:返回整数类型的降序排名(从 0 开始);
- 元素不存在(或目标 key 非 ZSet 类型):返回
nil。
2.12.5 关键细节说明
- 排名规则:降序排名从 0 开始,分数最大的元素排名为 0(第一名);
- 分数相同:元素分数相同时,排名按元素名称的字典序逆序排列;
- 性能特性:时间复杂度
O(log(N)),查询效率极高; - 空键处理:目标 key 不存在时,返回
nil,无报错。
2.12.6 实战业务场景(详细版)
- 全国用户排名展示:查询用户 "user8888" 的全国积分降序排名,命令为
ZREVRANK user:ranking:national "user8888",返回 0 则代表全国第一; - 班级成绩排名:查询学生 "李四" 的班级数学成绩降序排名,命令为
ZREVRANK class:1:math:score "李四"; - 游戏武将排名:查询武将 "关羽" 的全服武力值降序排名,命令为
ZREVRANK game:general:power "关羽"; - 电商商品销量排名:查询商品 "prod1001" 的月度销量降序排名,命令为
ZREVRANK shop:ranking:sales:202602 "prod1001"; - 内容热度排名:查询文章 "art9999" 的平台热度降序排名,命令为
ZREVRANK content:ranking:hot "art9999"。
2.13 ZSCORE:查询元素对应的分数
2.13.1 核心作用(详细版)
ZSCORE 是有序集合的 "分数查询" 核心命令,核心作用是精准查询指定元素在有序集合中绑定的分数值,时间复杂度为 O (1),是所有 ZSet 命令中性能最优的命令之一。
该命令的核心优势是 "极致性能":无论 ZSet 中有多少元素,查询单个元素的分数都能瞬间完成;若元素不存在于 ZSet 中,返回 nil。
2.13.2 完整语法
ZSCORE key memberkey:必填,目标有序集合的键名;member:必填,需要查询分数的元素名称。
2.13.3 逐行实操示例
# 1. 向 myzset 添加元素 "one",分数为 1
redis> ZADD myzset 1 "one"
(integer) 1  # 返回值:成功添加的元素个数

# 2. 查询 "one" 的分数(返回字符串格式的 "1")
redis> ZSCORE myzset "one"
"1"

# 3. 查询不存在的元素 "two"(返回 nil)
redis> ZSCORE myzset "two"
(nil)

# 补充示例:查询浮点数分数的元素
redis> ZADD myzset 95.5 "zhangsan"
(integer) 1
redis> ZSCORE myzset "zhangsan"
"95.5"
2.13.4 返回值解析
ZSCORE 的返回值分两种情况:
- 元素存在:返回字符串格式的分数值(整数 / 浮点数均以字符串存储);
- 元素不存在(或目标 key 非 ZSet 类型 /key 不存在):返回
nil。
2.13.5 关键细节说明
- 性能特性:时间复杂度
O(1),极致性能,适合高并发查询; - 数据类型:返回的分数为字符串类型,客户端需自行转换为数值类型(如 int/float);
- 空键处理:目标 key 不存在时,返回
nil,无报错; - 精度问题:若分数为浮点数,Redis 会保留原始精度,无精度丢失。
2.13.6 实战业务场景(详细版)
- 用户积分查询:查询用户 "user1001" 的当前积分,命令为
ZSCORE user:ranking:points "user1001"; - 内容点赞数查询:查询文章 "art10086" 的当前点赞数,命令为
ZSCORE article:like:10086 "total"; - 武将武力值查询:查询武将 "吕布" 的武力值,命令为
ZSCORE game:general:power "吕布"; - 学生成绩查询:查询学生 "王五" 的数学成绩,命令为
ZSCORE class:1:math:score "王五"; - 商品销量查询:查询商品 "prod2002" 的今日销量,命令为
ZSCORE shop:sales:today "prod2002"; - 视频播放量查询:查询视频 "vid5253" 的总播放量,命令为
ZSCORE video:play:total "vid5253"。
2.14 ZREM:删除指定元素
2.14.1 核心作用(详细版)
ZREM 是有序集合的 "元素删除" 核心命令,核心作用是从有序集合中删除一个或多个指定的元素,返回实际被删除的元素个数;若指定的元素不存在于 ZSet 中,会自动忽略,不会报错。
该命令是实现 "元素精准删除、违规内容移除、账号注销清理" 等业务的核心,支持批量删除多个元素,且操作是原子性的。
2.14.2 完整语法
ZREM key member [member ...]key:必填,目标有序集合的键名;member [member ...]:必填,一个或多个需要删除的元素名称(批量删除用空格分隔)。
2.14.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 删除元素 "two"(返回实际删除个数 1)
redis> ZREM myzset "two"
(integer) 1

# 3. 查看删除后的 ZSet(仅剩 one、three)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "one"
2) "1"
3) "three"
4) "3"

# 4. 批量删除多个元素(删除 one、three、four)
redis> ZREM myzset "one" "three" "four"
(integer) 2  # 仅删除了 one、three,four 不存在,忽略

# 5. 查看最终 ZSet(为空)
redis> ZRANGE myzset 0 -1 WITHSCORES
(empty array)
2.14.4 返回值解析
ZREM 的返回值为整数类型,代表实际被删除的元素个数(仅包含存在于 ZSet 中的元素);若目标 key 不存在,或所有指定元素均不存在,返回 0。
2.14.5 关键细节说明
- 原子性:批量删除多个元素时,操作是原子的,要么全部删除(存在的元素),要么都不删除;
- 性能特性:时间复杂度
O(M*log(N)),M为指定的元素个数,N为 ZSet 总元素数;批量删除少量元素时性能极高; - 空键处理:目标 key 不存在时,返回 0,无报错;
- 不存在元素处理:指定的元素不存在时,自动忽略,不影响其他元素的删除。
2.14.6 实战业务场景(详细版)
- 作弊用户移除:从排行榜中删除作弊用户 "user9999",命令为
ZREM game:ranking:power "user9999"; - 违规内容删除:从热度榜单中删除违规文章 "art8888",命令为
ZREM content:ranking:hot "art8888"; - 注销账号清理:删除注销用户的所有相关排名(积分、战力),命令为
ZREM user:ranking:points "user7777" ZREM game:ranking:power "user7777"; - 批量清理失效元素:删除榜单中失效的 10 个商品,命令为
ZREM shop:ranking:sales:202602 "prod1001" "prod1002" ... "prod1010"; - 抽奖资格取消:取消用户 "user5555" 的抽奖资格,命令为
ZREM lottery:queue "user5555"。
2.15 ZREMRANGEBYRANK:按升序排名区间删除元素
2.15.1 核心作用(详细版)
ZREMRANGEBYRANK 是有序集合的 "区间删除" 命令,核心作用是按照元素的升序排名区间(下标区间)删除元素,区间为左闭右闭;返回实际被删除的元素个数,是实现 "榜单末尾元素清理、保留 TOP N" 类业务的核心命令。
该命令的关键是:删除的是 "升序排名" 的下标区间(0 为分数最小的元素,-1 为分数最大的元素),而非降序,需注意与业务需求匹配。
2.15.2 完整语法
ZREMRANGEBYRANK key start stopkey:必填,目标有序集合的键名;start:必填,升序排名的起始下标(整数,支持负数,0 为分数最小的元素);stop:必填,升序排名的结束下标(整数,支持负数,-1 为分数最大的元素)。
2.15.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 删除升序排名 0~1 的元素(one、two,分数最小的两个)
redis> ZREMRANGEBYRANK myzset 0 1
(integer) 2  # 返回实际删除的元素个数

# 3. 查看剩余元素(仅 three,分数最大)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "three"
2) "3"

# 补充示例:保留 TOP100,删除排名 100 以外的所有元素
# redis> ZREMRANGEBYRANK user:ranking 100 -1
# (integer) N  # N 为被删除的元素个数
2.15.4 返回值解析
ZREMRANGEBYRANK 的返回值为整数类型,代表实际被删除的元素个数;若目标 key 不存在,或区间内无元素,返回 0。
2.15.5 关键细节说明
- 排名规则:删除的是升序排名的下标区间(0 = 分数最小,-1 = 分数最大);若需删除降序排名的末尾元素,需转换为升序下标;
- 区间容错:
start/stop超出 ZSet 实际下标范围时,仅删除存在的元素,无报错; - 性能特性:时间复杂度
O(log(N)+M),M为被删除的元素数;删除大量元素时需注意耗时; - 空键处理:目标 key 不存在时,返回 0,无报错。
2.15.6 实战业务场景(详细版)
- 榜单保留 TOP100:仅保留用户积分排行榜的前 100 名,删除排名 100 以外的所有元素,命令为
ZREMRANGEBYRANK user:ranking:points 100 -1; - 清理低分武将:删除武力值升序排名 0~99 的武将(分数最低的 100 个),命令为
ZREMRANGEBYRANK game:general:power 0 99; - 销量榜单裁剪:仅保留月度销量 TOP500 的商品,删除排名 500 以外的元素,命令为
ZREMRANGEBYRANK shop:ranking:sales:202602 500 -1; - 热度榜单瘦身:删除热度升序排名 0~499 的内容(低分内容),命令为
ZREMRANGEBYRANK content:ranking:hot 0 499。
2.16 ZREMRANGEBYSCORE:按分数区间删除元素
2.16.1 核心作用(详细版)
ZREMRANGEBYSCORE 是有序集合的 "分数区间删除" 核心命令,核心作用是按照指定的分数区间删除有序集合中的元素,支持闭区间(默认)、开区间(使用 ( 标识);返回实际被删除的元素个数,是实现 "低分元素清理、条件删除" 类业务的核心命令。
2.16.2 完整语法
ZREMRANGEBYSCORE key min maxkey:必填,目标有序集合的键名;min:必填,分数区间下限,支持-inf、(数值(开区间);max:必填,分数区间上限,支持+inf、(数值(开区间)。
2.16.3 逐行实操示例
# 1. 向 myzset 添加 3 个元素(分数 1、2、3)
redis> ZADD myzset 1 "one" 2 "two" 3 "three"
(integer) 3

# 2. 删除分数 < 2 的元素(-inf 到 (2)
redis> ZREMRANGEBYSCORE myzset -inf (2
(integer) 1  # 仅删除了 one(分数 1)

# 3. 查看剩余元素(two、three)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "two"
2) "2"
3) "three"
4) "3"

# 补充示例:删除分数 ≥3 的元素(3 到 +inf)
redis> ZREMRANGEBYSCORE myzset 3 +inf
(integer) 1  # 删除了 three

# 补充示例:删除分数 2~3 的元素(闭区间)
redis> ZREMRANGEBYSCORE myzset 2 3
(integer) 1  # 删除了 two(仅剩空)
2.16.4 返回值解析
ZREMRANGEBYSCORE 的返回值为整数类型,代表实际被删除的元素个数;若目标 key 不存在,或区间内无元素,返回 0。
2.16.5 关键细节说明
- 区间规则:默认闭区间,
(数值代表开区间(不包含该数值); - 无限区间:
-inf/+inf代表负无穷 / 正无穷,无需加引号; - 性能特性:时间复杂度
O(log(N)+M),M为被删除的元素数;删除大量元素时需注意耗时; - 空键处理:目标 key 不存在时,返回 0,无报错;
- 原子性:删除操作是原子的,批量删除区间内元素时,要么全部删除,要么都不删除。
2.16.6 实战业务场景(详细版)
- 不及格学生清理:从成绩榜单中删除分数 < 60 分的学生,命令为
ZREMRANGEBYSCORE class:1:math:score -inf (60; - 低热度内容清理:删除热度 < 10 的低质内容,命令为
ZREMRANGEBYSCORE content:ranking:hot -inf (10; - 低武力值武将删除:删除武力值 < 90 的武将,命令为
ZREMRANGEBYSCORE game:general:power -inf (90; - 低积分用户淘汰:删除积分 < 1000 的普通用户,命令为
ZREMRANGEBYSCORE user:ranking:points -inf (1000; - 高分数元素清理:删除分数 > 10000 的异常元素(作弊用户),命令为
ZREMRANGEBYSCORE game:ranking:power (10000 +inf。
2.17 ZINCRBY:元素分数增量修改(原子性)
2.17.1 核心作用(详细版)
ZINCRBY 是有序集合的 "分数增量修改" 核心命令,核心作用是原子性地对指定元素的分数进行增量调整(可加可减);若元素不存在于 ZSet 中,会自动初始化该元素的分数为 0,再执行增量操作;返回修改后的最新分数。
该命令的 "原子性" 是核心特性:即使高并发场景下(如百万级并发点赞),也不会出现分数计算错误的问题,是实现 "实时计分、增量更新" 类业务的唯一选择。
2.17.2 完整语法
ZINCRBY key increment memberkey:必填,目标有序集合的键名;increment:必填,分数增量(可正可负,支持整数 / 浮点数);正数为加分,负数为减分;member:必填,需要修改分数的元素名称。
2.17.3 有效版本
1.2.0 及以上(全版本兼容,无兼容性风险)
2.17.4 逐行实操示例
# 1. 向 myzset 添加 2 个元素(分数 1、2)
redis> ZADD myzset 1 "one" 2 "two"
(integer) 2

# 2. 给 "one" 的分数 +2(1+2=3),返回最新分数
redis> ZINCRBY myzset 2 "one"
"3"

# 3. 查看修改后的 ZSet(one=3,two=2)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "two"
2) "2"
3) "one"
4) "3"

# 4. 给不存在的元素 "three" 加分(初始化 0+5=5)
redis> ZINCRBY myzset 5 "three"
"5"

# 5. 查看新增后的 ZSet(three=5)
redis> ZRANGE myzset 0 -1 WITHSCORES
1) "two"
2) "2"
3) "one"
4) "3"
5) "three"
6) "5"

# 6. 给 "one" 的分数减 1(3-1=2)
redis> ZINCRBY myzset -1 "one"
"2"
2.17.5 返回值解析
ZINCRBY 的返回值为字符串格式的最新分数(整数 / 浮点数均以字符串存储);无论元素是否存在,都会返回修改后的分数(不存在则为增量值)。
2.17.6 关键细节说明
- 原子性:增量操作是原子的,高并发下无竞态条件(如 1000 个客户端同时给同一个元素 + 1,最终分数会准确 + 1000);
- 初始化规则:元素不存在时,自动创建并初始化分数为 0,再执行增量;
- 数据类型:返回的分数为字符串类型,客户端需自行转换为数值类型;
- 精度问题:浮点数增量(如 0.5)不会丢失精度,Redis 会保留原始值;
- 性能特性:时间复杂度
O(log(N)),极致性能,适合高并发增量更新。
2.17.7 实战业务场景
- 文章点赞 + 1:给文章 "art1001" 的点赞数 + 1,命令为
ZINCRBY article:like:1001 1 "total"; - 取消点赞 - 1:取消文章 "art1001" 的点赞,命令为
ZINCRBY article:like:1001 -1 "total"; - 视频播放量 + 1:给视频 "vid5253" 的播放量 + 1,命令为
ZINCRBY video:play:5253 1 "total"; - 用户积分增加:给用户 "user1001" 的积分 + 10,命令为
ZINCRBY user:ranking:points 10 "user1001"; - 武将武力值提升:给武将 "关羽" 的武力值 + 0.5,命令为
ZINCRBY game:general:power 0.5 "关羽";
三、ZSet 集合间高级操作(交集 ZINTERSTORE、并集 ZUNIONSTORE)
ZSet 最强大的高级功能是多集合聚合运算(交集、并集),支持权重(WEIGHTS)+ 聚合方式(AGGREGATE),完美实现「多榜单合并、综合排名、加权计分」,是电商、游戏、内容平台的核心高级用法。
3.1 集合操作核心概念
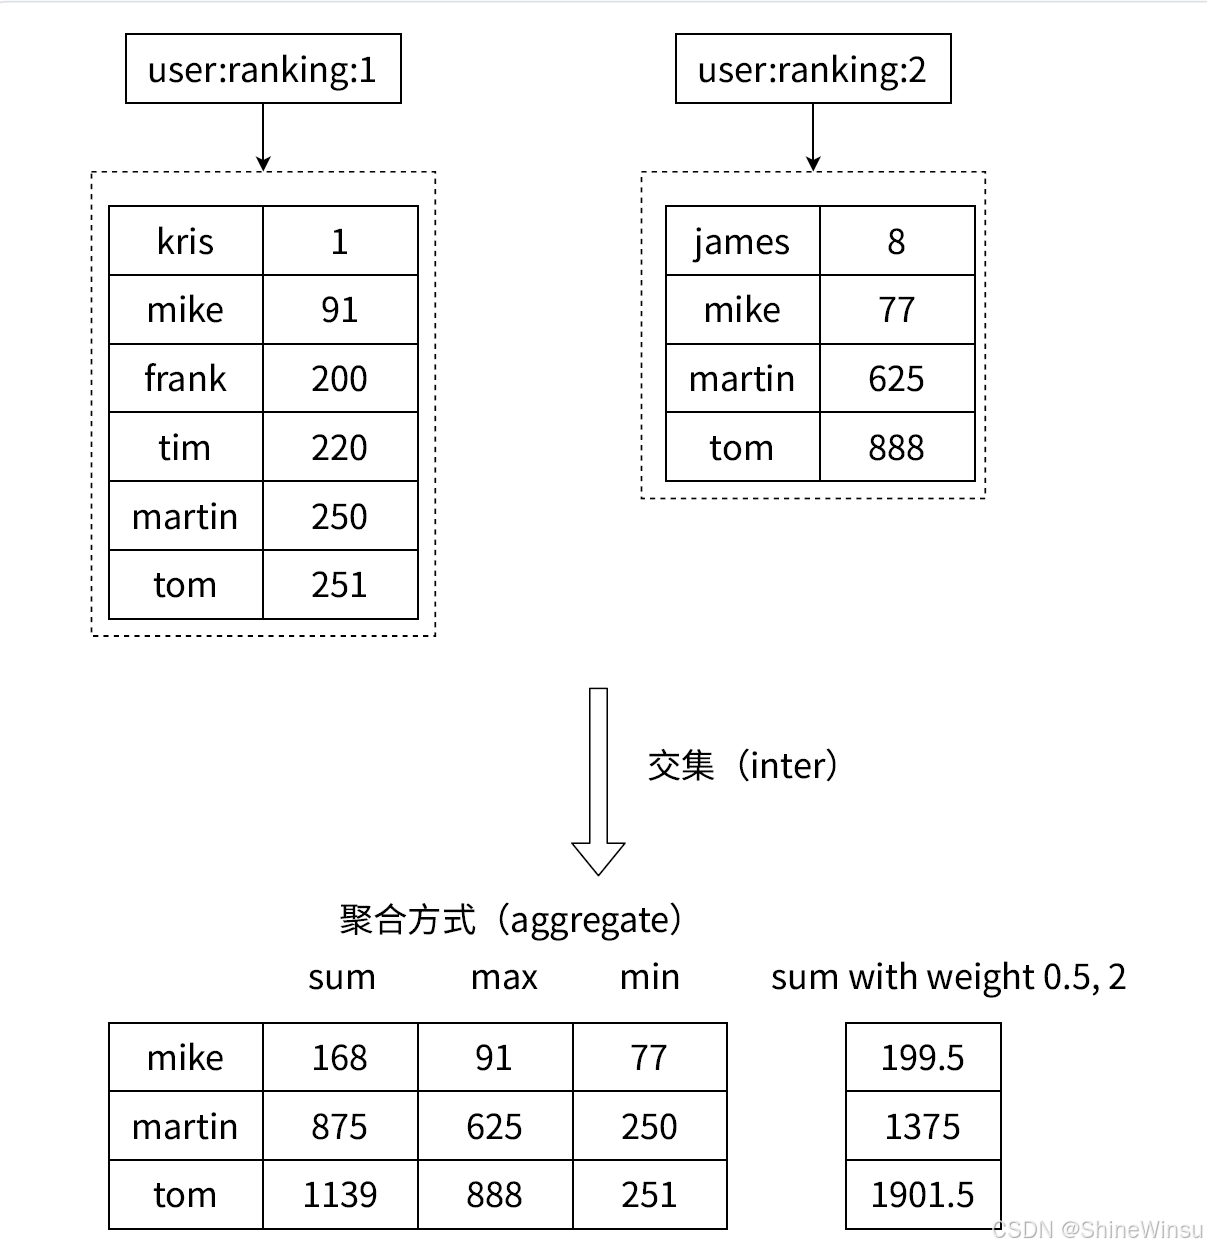
- 交集(ZINTERSTORE) :只保留所有输入 ZSet 都共同存在的元素,不同集合中同一个元素的分数按指定规则合并计算,最终存入新的 ZSet;不存在于所有集合的元素会被直接丢弃。
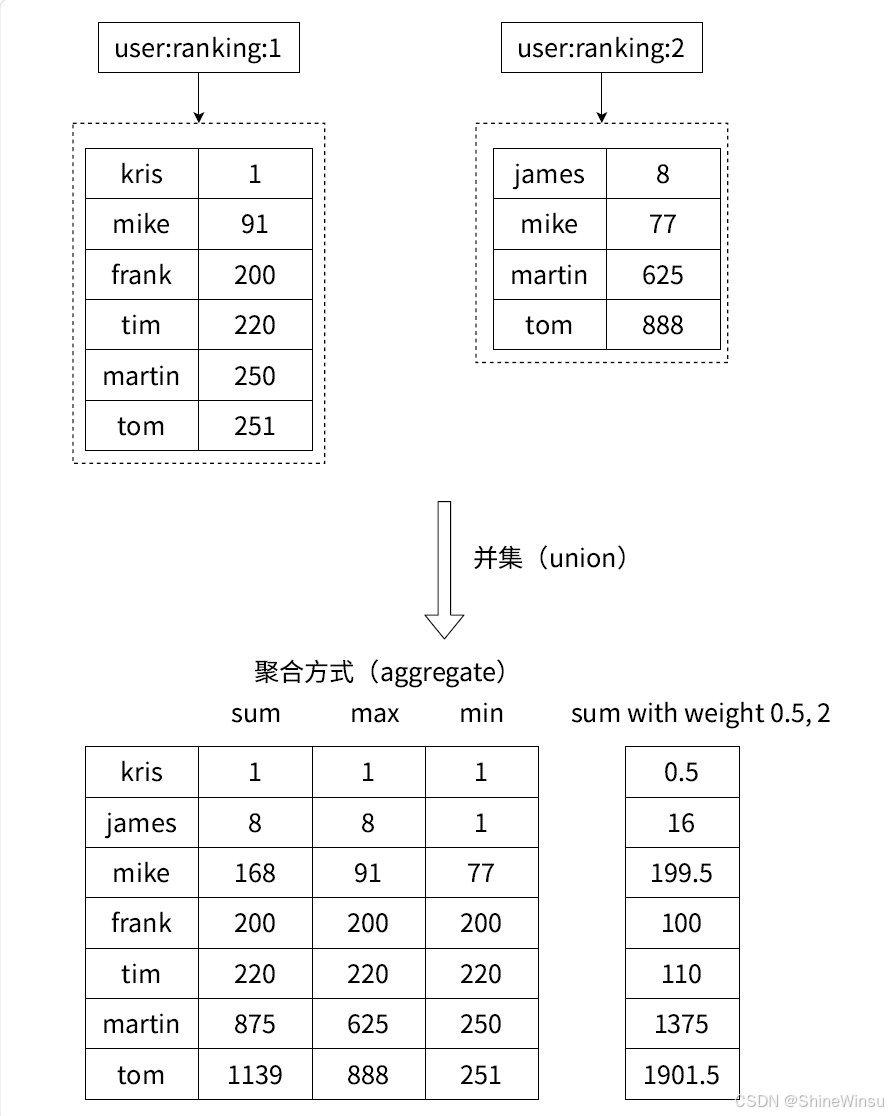
- 并集(ZUNIONSTORE):合并所有输入 ZSet 的全部元素(自动去重,相同元素只保留一份),相同元素在不同集合中的分数按规则合并,最终存入新 ZSet。
- WEIGHTS 权重 :对每个输入 ZSet 设置独立权重系数,执行聚合前,该集合内所有元素的分数会先乘以对应权重,再参与 SUM/MIN/MAX 计算,用于实现「不同榜单权重不同」的综合计分。
- AGGREGATE 聚合规则 :相同元素在多个集合中的分数合并方式:
- SUM(默认):所有集合分数(乘权重后)相加;
- MIN:取所有集合中分数(乘权重后)的最小值;
- MAX:取所有集合中分数(乘权重后)的最大值。
3.2 ZINTERSTORE:多 ZSet 交集聚合(保存到新 ZSet)
3.2.1 核心作用
ZINTERSTORE 用于计算多个有序集合的交集,只保留同时存在于所有输入 ZSet 中的共同元素;每个集合分数先按 WEIGHTS 加权,再按 AGGREGATE 规则合并为新分数;最终把结果写入目标 ZSet,并返回新集合的元素个数。
该命令是多维度榜单筛选、共同元素统计、加权综合评分的核心命令,常用于 "同时上榜多个榜单" 的优质内容 / 高价值用户筛选。
3.2.2 完整语法
ZINTERSTORE destination numkeys key [key ...] [WEIGHTS weight [weight ...]] [AGGREGATE SUM|MIN|MAX]3.2.3 关键参数解释
destination:必填,结果保存的目标新 ZSet 键名(若已存在会被覆盖);numkeys:必填且必须正确 ,代表后面跟着的输入 ZSet 个数,不能多不能少,是 Redis 语法强制要求;key [key ...]:必填,参与交集计算的原始 ZSet 键列表;WEIGHTS weight [weight ...]:可选,权重列表,个数必须与输入 ZSet 数量一致,默认所有权重 = 1;AGGREGATE SUM|MIN|MAX:可选,分数合并规则,默认 SUM。
3.2.4 逐行实操示例(完整原文 + 注释)
# 1. 创建 zset1:one=1、two=2
redis> ZADD zset1 1 "one" 2 "two"
(integer) 2

# 2. 创建 zset2:one=1、two=2、three=3
redis> ZADD zset2 1 "one" 2 "two" 3 "three"
(integer) 3

# 3. 交集聚合:2 个 ZSet,zset1 权重 2,zset2 权重 3,聚合规则 SUM
redis> ZINTERSTORE out 2 zset1 zset2 WEIGHTS 2 3
(integer) 2

# 4. 计算规则(逐元素清晰说明)
# one = 1*2 + 1*3 = 2 + 3 = 5
# two = 2*2 + 2*3 = 4 + 6 = 10
# three 只在 zset2 存在,不属于交集,被丢弃
redis> ZRANGE out 0 -1 WITHSCORES
1) "one"
2) "5"
3) "two"
4) "10"
3.2.5 返回值解析
返回整数 ,代表交集计算后,目标 ZSet destination 中最终保存的元素数量;
- 若所有集合无共同元素,返回 0;
- 若输入 key 不存在,视为空集合,交集结果也为空,返回 0。
3.2.6 关键细节说明
- 覆盖规则:目标 key 若已存在且非 ZSet 类型,会被覆盖为 ZSet;
- 权重顺序:WEIGHTS 顺序必须与 key 顺序严格一一对应;
- 空集合处理:任意一个输入 ZSet 为空,则最终交集一定为空;
- 性能:时间复杂度 O (N),N 为所有集合元素总数,集合极大时建议低峰执行。
3.2.7 实战业务场景(完整版)
- 爆款内容筛选:同时出现在日榜、周榜、月榜 的内容,取综合加权得分,命令:
ZINTERSTORE content:hot:all 3 content:hot:day content:hot:week content:hot:month WEIGHTS 1 2 3 AGGREGATE SUM - 跨服共同高分玩家:同时进入多个区服排行榜的玩家,取最低分为最终判定分:
ZINTERSTORE user:common:ranking 2 user:ranking:server1 user:ranking:server2 AGGREGATE MIN - 多维度达标筛选:同时满足 "积分≥1000、战力≥500、等级≥60" 的用户,交集筛选。
3.3 ZUNIONSTORE:多 ZSet 并集聚合(保存到新 ZSet)
3.3.1 核心作用
ZUNIONSTORE 用于计算多个有序集合的并集,合并所有集合的全部元素(相同元素自动去重);每个集合分数先按 WEIGHTS 加权,再按 AGGREGATE 合并为新分数;结果写入目标 ZSet,并返回新集合元素个数。
它是全服榜单合并、多维度积分汇总、综合热度计算的核心命令,几乎所有大型排行榜底层都会使用。
3.3.2 完整语法
ZUNIONSTORE destination numkeys key [key ...] [WEIGHTS weight [weight ...]] [AGGREGATE SUM|MIN|MAX]3.3.3 关键参数解释(与 ZINTERSTORE 完全一致)
destination:结果保存的新 ZSet;numkeys:输入 ZSet 个数(必填);key [...]:参与并集的原始 ZSet;WEIGHTS:权重列表;AGGREGATE:SUM/MIN/MAX,默认 SUM。
3.3.4 逐行实操示例(原文完整保留)
# 1. 创建 zset1:one=1、two=2
redis> ZADD zset1 1 "one" 2 "two"
(integer) 2

# 2. 创建 zset2:one=1、two=2、three=3
redis> ZADD zset2 1 "one" 2 "two" 3 "three"
(integer) 3

# 3. 并集聚合:2 个 ZSet,权重 2、3,聚合 SUM
redis> ZUNIONSTORE out 2 zset1 zset2 WEIGHTS 2 3
(integer) 3

# 4. 结果计算逻辑
# one = 1*2 + 1*3 = 5
# two = 2*2 + 2*3 = 10
# three = 0*2 + 3*3 = 9(只在 zset2 存在,zset1 视为 0)
redis> ZRANGE out 0 -1 WITHSCORES
1) "one"
2) "5"
3) "three"
4) "9"
5) "two"
6) "10"
3.3.5 返回值解析
返回整数,代表并集去重后,目标 ZSet 中最终的元素总数;
- 即使所有输入集合都为空,也返回 0;
- 元素去重只按 member 字符串匹配,与分数无关。
3.3.6 关键细节说明
- 去重规则:member 字符串完全相同才算同一个元素,大小写、空格不同视为不同元素;
- 单集合不存在:不存在的 ZSet 视为空集合,不影响并集结果(只合并存在的集合);
- 权重为 0:可通过权重 0 让某个集合只参与 "存在性判断",分数不参与计算;
- 大数据量注意:并集会加载所有集合元素,超大 ZSet 执行时可能占用较多 CPU。
3.3.7 实战业务场景
- 全服总排行榜 :合并安卓区、iOS 区、渠道区榜单,加权求和:
ZUNIONSTORE user:ranking:total 3 user:ranking:android user:ranking:ios user:ranking:channel WEIGHTS 1 1 1 AGGREGATE SUM - 内容综合热度 :热度 = 点赞 0.4 + 评论 0.3 + 收藏 0.3,用并集加权实现:
ZUNIONSTORE content:hot:total 3 content:like content:comment content:star WEIGHTS 0.4 0.3 0.3 AGGREGATE SUM - 用户总积分汇总:合并每日任务积分、成就积分、活动积分,取总和作为总排名依据
四、ZSet 全命令汇总与速查表
为方便日常开发、面试复习,我们将所有 ZSet 命令按功能、语法、时间复杂度、核心作用整理成终极速查表,覆盖 100% 场景:
| 命令分类 | 命令 | 核心语法 | 时间复杂度 | 核心作用 |
|---|---|---|---|---|
| 基础写入 | ZADD | ZADD key NX/XX/GT/LT/CH/INCR score member | O(k·log(N)) | 添加 / 更新元素 + 分数 |
| 计数查询 | ZCARD | ZCARD key | O(1) | 查询元素总个数 |
| 区间计数 | ZCOUNT | ZCOUNT key min max | O(log(N)) | 统计分数区间元素个数 |
| 下标查询(升) | ZRANGE | ZRANGE key start stop WITHSCORES | O(log(N)+M) | 按下标升序查询 |
| 下标查询(降) | ZREVRANGE | ZREVRANGE key start stop WITHSCORES | O(log(N)+M) | 按下标降序查询(TOP N 核心) |
| 分数查询(升) | ZRANGEBYSCORE | ZRANGEBYSCORE key min max WITHSCORES | O(log(N)+M) | 按分数升序查询 |
| 弹出最大分数 | ZPOPMAX | ZPOPMAX key count | O(log(N)·M) | 删除 + 返回分数最高元素 |
| 阻塞弹出最大 | BZPOPMAX | BZPOPMAX key key... timeout | O(log(N)) | 阻塞式弹出最大分数 |
| 弹出最小分数 | ZPOPMIN | ZPOPMIN key count | O(log(N)·M) | 删除 + 返回分数最低元素 |
| 阻塞弹出最小 | BZPOPMIN | BZPOPMIN key key... timeout | O(log(N)) | 阻塞式弹出最小分数 |
| 升序排名 | ZRANK | ZRANK key member | O(log(N)) | 查询元素升序排名(0 开始) |
| 降序排名 | ZREVRANK | ZREVRANK key member | O(log(N)) | 查询元素降序排名(TOP 排名) |
| 分数查询 | ZSCORE | ZSCORE key member | O(1) | 查询元素绑定分数 |
| 删除指定元素 | ZREM | ZREM key member member... | O(k·log(N)) | 删除指定元素 |
| 按排名删除 | ZREMRANGEBYRANK | ZREMRANGEBYRANK key start stop | O(log(N)+M) | 按升序排名区间删除 |
| 按分数删除 | ZREMRANGEBYSCORE | ZREMRANGEBYSCORE key min max | O(log(N)+M) | 按分数区间删除 |
| 增量计分 | ZINCRBY | ZINCRBY key increment member | O(log(N)) | 原子性增量修改分数(高并发核心) |
| 交集聚合 | ZINTERSTORE | ZINTERSTORE dest numkeys key... WEIGHTS... AGGREGATE... | O(N·K + M·log(M)) | 多 ZSet 交集聚合 |
| 并集聚合 | ZUNIONSTORE | ZUNIONSTORE dest numkeys key... WEIGHTS... AGGREGATE... | O(N + M·log(M)) | 多 ZSet 并集聚合 |
五、ZSet 内部编码(底层实现:ziplist 压缩列表、skiplist 跳表)
Redis 所有数据类型都遵循「对外统一接口,对内智能编码 」的设计思想,ZSet 也不例外 ------ 底层有两种编码,Redis 会根据元素个数、元素大小自动切换,对开发者完全透明,理解编码能帮助我们优化内存、提升性能。
5.1 ZSet 两种内部编码
ZSet 只有两种内部编码:
- ziplist(压缩列表):小数据量、小元素时使用,极致节省内存;
- skiplist(跳表):大数据量、大元素时使用,保证高性能操作。
5.2 ziplist 编码:触发条件、结构、优缺点
5.2.1 触发条件
- 元素个数 <
zset-max-ziplist-entries(默认 128 个); - 每个元素的长度 <
zset-max-ziplist-value(默认 64 字节)。
5.2.2 存储结构
连续内存块,按「元素 1 + 分数 1 + 元素 2 + 分数 2...」顺序存储,无指针、无冗余,内存占用极低。
5.2.3 优点
- 内存利用率极高,无碎片;
- 小数据量下操作速度快。
5.2.4 缺点
- 元素多 / 大后,插入 / 删除需要批量移动内存,性能急剧下降;
- 不支持高效的范围查询、排名计算。
5.2.5 实操查看编码
# 1. 添加 3 个小元素
127.0.0.1:6379> zadd zsetkey 50 e1 60 e2 30 e3
(integer) 3

# 2. 查看编码:ziplist
127.0.0.1:6379> object encoding zsetkey
"ziplist"
5.3 skiplist 编码:触发条件、结构、优缺点
5.3.1 触发条件(任意一条满足,教材原文)
- 元素个数 ≥ 128 个;
- 任意元素长度 ≥ 64 字节。
5.3.2 存储结构
跳表(skiplist)+ 哈希表(dict):
- 跳表:实现排序、范围查询、排名(O(logN));
- 哈希表:实现元素→分数的快速查找(O(1))。
5.3.3 优点
- 插入 / 删除 / 查询 / 排名均为 O (logN),海量数据下性能极致;
- 支持高效范围查询、排名计算、动态排序。
5.3.4 缺点
- 内存占用比 ziplist 高(有指针、多层索引);
- 结构更复杂。
5.3.5 实操查看编码
# 1. 添加超过 64 字节的大元素
127.0.0.1:6379> zadd zsetkey 50 "一个超长字符串超过64字节.................................."
(integer) 1

# 2. 查看编码:skiplist
127.0.0.1:6379> object encoding zsetkey
"skiplist"
5.4 编码自动转换规则(单向不可逆,重点)
Redis 编码转换是单向、不可逆的:
- 满足 ziplist 条件 → 使用 ziplist;
- 不满足 ziplist 条件 → 自动切换为 skiplist;
- skiplist 永远不会转回 ziplist(即使后续删除元素、缩短长度)。
5.5 编码设计的核心价值
- 小数据量用 ziplist:省内存;
- 大数据量用 skiplist:保性能;
- 自动切换:开发者无需手动配置,降低使用成本。
六、ZSet 核心实战场景
ZSet 的实战场景覆盖互联网 90% 的「排序、排名、计分、队列」需求,其中排行榜系统是教材指定的最核心场景,我们完整落地,同时扩展高频高级场景。
6.1 最核心场景:排行榜系统
6.1.1 需求
- 维护每日文章点赞排行榜;
- 支持点赞 + 1、取消点赞 - 1;
- 展示 TOP10;
- 查询用户排名、分数;
- 删除违规 / 注销用户。
6.1.2 键名设计(规范)
user:ranking:日期 → 如 user:ranking:20260208
6.1.3 完整命令落地(教材步骤)
步骤 1:初始化 / 添加用户赞数
# 用户 james 初始 3 个赞
ZADD user:ranking:20260208 3 james
步骤 2:点赞 +1(增量修改,原子性)
ZINCRBY user:ranking:20260208 1 james步骤 3:取消点赞 -1(负增量)
ZINCRBY user:ranking:20260208 -1 james步骤 4:删除违规用户(如 tom)
ZREM user:ranking:20260208 tom步骤 5:展示 TOP10(降序,分数从高到低)
ZREVRANGE user:ranking:20260208 0 9 WITHSCORES步骤 6:查询用户分数(点赞数)
ZSCORE user:ranking:20260208 mike步骤 7:查询用户排名(降序,TOP 名次)
ZREVRANK user:ranking:20260208 mike步骤 8:结合 Hash 存储用户详细信息(教材)
# Hash 存储用户信息
HSET user:info:tom name "Tom" age 25 sex "男"

# 查询用户信息
HGETALL user:info:tom
6.2 高频扩展实战场景
6.2.1 延时任务队列
- score = 任务执行时间戳;
- 用
ZREVRANGE查询待执行任务,ZREM标记完成; - 适用于订单超时取消、优惠券过期。
6.2.2 优先级任务队列
- score = 任务优先级(数字越大优先级越高);
- 用
ZPOPMAX弹出最高优先级任务执行。
6.2.3 多维度综合排行榜
- 日榜、周榜、月榜通过
ZUNIONSTORE加权聚合,生成总榜。
6.2.4 游戏战力 / 段位榜、短视频热度榜、商城销量排序
- 统一逻辑:score = 战力 / 热度 / 销量,ZREVRANGE 查 TOP,ZINCRBY 实时更新。
七、ZSet 生产环境避坑指南与性能优化
7.1 大 Key 危害:超大 ZSet 阻塞 Redis
- 禁止
ZRANGE 0 -1遍历千万级 ZSet(O (N),阻塞单线程); - 分页查询用
ZRANGE start stop,每次查询少量元素。
7.2 排名从 0 开始:业务展示需 +1
- ZREVRANK 返回 0 = 第一名,展示时需 +1,避免用户误解。
7.3 score 浮点数精度丢失
- 不存储超过 2^53 的超大整数,日常业务分数完全够用。
7.4 禁止 GET+SET 计分:高并发下计数错误
- 必须用
ZINCRBY/ZADD INCR原子计分,禁止客户端先读再写。
7.5 集合操作(ZINTERSTORE/ZUNIONSTORE)CPU 消耗高
- 大集合禁止频繁聚合,提前计算、缓存结果。
7.6 ZSet 无直接过期:榜单自动清理方案
- 用
ZREMRANGEBYSCORE清理低分元素; - 用定时任务删除旧日期榜单(如
user:ranking:20260201)。
7.7 键名不规范:内存浪费、维护困难
- 遵循
业务:类型:标识规范,如user:ranking:20260208。
7.8 过度依赖分数相同的字典序
- 业务不可强依赖字典序,分数相同的排序无业务意义。
7.9 阻塞命令超时设置合理
- BZPOPMAX/BZPOPMIN 不要设置永久阻塞(timeout=0),避免客户端挂起。
7.10 内存优化:尽量适配 ziplist
- 控制元素个数 < 128,元素长度 < 64 字节,节省内存。
八、ZSet 与其他数据结构选型决策
- 需要有序 + 去重 + 排名 + 范围查询 → 唯一选择:ZSet;
- 需要有序 + 重复 → List;
- 需要去重 + 无序 + 集合运算 → Set;
- 需要结构化对象 → Hash;
- 需要简单键值对 → String。
九、全文总结 + 面试高频考点
9.1 全文核心总结
- ZSet = 去重 Set + 分数排序,元素唯一、分数可重复、按 score 有序;
- 核心命令三巨头:ZADD(写入)、ZINCRBY(增量计分)、ZREVRANGE(TOP N);
- 排名命令:ZRANK(升序)、ZREVRANK(降序);
- 范围命令:ZRANGE(下标)、ZRANGEBYSCORE(分数);
- 删除命令:ZREM、ZREMRANGEBYRANK、ZREMRANGEBYSCORE;
- 高级聚合:ZINTERSTORE(交集)、ZUNIONSTORE(并集),支持权重 + 聚合;
- 底层编码:ziplist(小数据)、skiplist(大数据),单向不可逆;
- 核心场景:排行榜、延时队列、优先级队列、范围筛选;
- 高并发核心:原子性计分(ZINCRBY),无竞争、性能极致。
9.2 面试高频 10 大考点
考点 1:ZSet 和 Set、List 的核心区别(必问)
核心区别:
- List:有序(插入顺序)、可重复、基于下标访问,适合有序序列、消息队列;
- Set:无序、不可重复、支持集合运算,适合去重、标签、共同好友;
- ZSet:有序(分数排序)、不可重复、支持排名 / 范围查询,适合排行榜、实时计分。
一句话总结:需要「有序 + 去重 + 排名」选 ZSet,需要「有序 + 重复」选 List,需要「去重 + 无序」选 Set。
考点 2:ZSet 的底层实现(ziplist vs skiplist)
两种编码:
- ziplist:小数据量(<128 元素,元素 < 64 字节),连续内存、省内存,插入 / 删除慢;
- skiplist:大数据量,跳表 + 哈希表,插入 / 删除 / 查询 O (logN),性能高、耗内存。
转换规则:单向不可逆,ziplist 可转为 skiplist,反之不行。
考点 3:ZSet 的分数(score)特性
核心特性:
- 数据类型:64 位浮点数(double),支持整数、小数、±inf;
- 精度:double 有精度限制,不建议存储超大整数(>2^53);
- 作用:唯一排序依据,相同分数按字典序排序(不建议强依赖)。
考点 4:ZSet 的有序性如何保证?
有序性保证:
- 核心依据:分数(score),默认升序,可通过 ZREVRANGE 降序;
- 分数相同:按元素字典序排序(字母 / 汉字编码顺序);
- 底层实现:skiplist 结构天然支持有序遍历和范围查询。
考点 5:ZADD 命令的核心选项(NX/XX/GT/LT/CH/INCR)
选项作用:
- NX/XX:控制新增 / 更新(NX 仅新增,XX 仅更新);
- GT/LT:控制更新条件(GT 仅新分数 > 旧分数,LT 仅新分数 < 旧分数);
- CH:修改返回值统计规则(新增 + 更新都计数);
- INCR:增量计分(等价于 ZINCRBY)。
考点 6:ZINCRBY 的原子性与高并发场景
原子性 :Redis 单线程模型保证 ZINCRBY 是原子操作,高并发下无竞争、无计数错误;使用场景:点赞、播放量、积分等实时计分场景,替代「GET+SET」的非原子操作。
考点 7:ZSet 的集合间操作(ZINTERSTORE/ZUNIONSTORE)
核心作用:
- ZINTERSTORE:多 ZSet 交集聚合,保留共同元素,分数按权重 + 聚合方式合并;
- ZUNIONSTORE :多 ZSet 并集聚合,合并所有元素,分数按权重 + 聚合方式合并。使用场景:多榜单合并(日榜 + 周榜 = 总榜)、加权综合评分。
考点 8:ZSet 实现排行榜的核心命令
核心命令组合:
- 初始化 / 更新:ZADD、ZINCRBY;
- 查 TOP N:ZREVRANGE(降序);
- 查排名:ZREVRANK;
- 查分数:ZSCORE;
- 删除元素:ZREM、ZREMRANGEBYRANK。
考点 9:ZSet 实现延时任务队列的原理
实现原理:
- score = 任务执行时间戳;
- 生产者:ZADD 将任务加入队列;
- 消费者:定时用 ZRANGEBYSCORE 查询到期任务,ZREM 删除并执行。优势:简单高效,无需额外组件,适合轻量级延时任务。
考点 10:ZSet 的性能优化与常见坑
性能优化:
- 避免大 Key:拆分超大 ZSet,分页查询;
- 内存优化:控制元素大小,适配 ziplist 编码;
- 命令优化:用 ZINCRBY 替代 GET+SET,避免全量遍历。
常见坑:
- 排名从 0 开始,业务展示需 + 1;
- 分数精度丢失,避免超大整数;
- 阻塞命令(BZPOPMAX)不要永久阻塞。
结语
恭喜你,一路学完 String、Hash、List、Set 之后,终于拿下了 Redis 五大基础数据类型中功能最强、设计最精妙、实战与面试双料王者 ------ZSet 有序集合。如果说前面四种结构是 Redis 的「基础工具箱」,那 ZSet 就是真正意义上的「高级引擎」,几乎支撑了互联网中所有与排序、排名、计分、延时、优先级相关的核心业务。
回顾整篇内容,我们从 ZSet 最核心的两条铁律(元素唯一、分数可重复)出发,理清了它与 List、Set 的本质区别;系统性掌握了从 ZADD、ZINCRBY、ZREVRANGE 这类高频基础命令,到 ZINTERSTORE、ZUNIONSTORE 这种多集合加权聚合的高级能力;深入底层理解了 ziplist 与 skiplist 两种编码的自动切换逻辑与性能差异;并落地了排行榜、延时队列、优先级队列、多维度综合榜单等最真实的生产场景,同时梳理了 10 个高频生产坑点与优化方案。整套知识体系,既覆盖了命令使用,又打通了原理、场景、优化、面试全链路。
ZSet 最珍贵的价值,在于它同时拥有 Set 的去重能力、List 的有序特性、哈希表的 O (1) 查找、跳表的 O (logN) 高效排序,再加上原子增量计分、阻塞弹出、集合加权聚合,让它成为轻量级架构下实现复杂业务的「不二之选」。无论是游戏战力排行、短视频热度计算、电商销量榜单、订单超时关闭,还是分布式优先级队列,ZSet 都能用极简的结构、极高的性能轻松承接。
当然,我们也要清醒地记住它的边界:不要把 ZSet 当作超大 Key 随意遍历、不要依赖分数相同时的字典序做强业务逻辑、不要在高并发下用「先查后写」替代 ZINCRBY、不要对超大规模集合频繁做交集并集。用好 ZSet 的关键,是顺应它的设计 ------ 以分数为核心、以排名 / 范围为查询方式、以原子操作为高并发保障、以合理编码控制内存。
至此,Redis 五大基础数据类型已全部学习完毕。从最简单的 String,到结构化 Hash、有序 List、去重 Set,再到全能型 ZSet,你已经拥有了 Redis 最核心的「武器库」。真正的 Redis 高手,从来不是死记命令,而是理解每一种结构的设计初衷、性能特点、适用场景,在合适的业务里选择最合适的工具。
后续我们将进一步深入 Redis 的高级特性:如 HyperLogLog、Geo、Stream、发布订阅、事务、Lua 脚本、持久化、主从、集群、缓存设计 等,一步步从「会用 Redis」走向「精通 Redis」。愿你在实际开发中,真正把 ZSet 用活、用稳、用到极致,让它成为你系统里高性能、高可靠的核心支撑。
我们下篇 Redis 高级内容,继续深入学习~