✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!也可以在主页上或文末下与博主交流~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
温馨提示:文末有CSDN平台官方提供的博客联系方式!
多源影视数据整合质量评估与可视化分析系统-简介
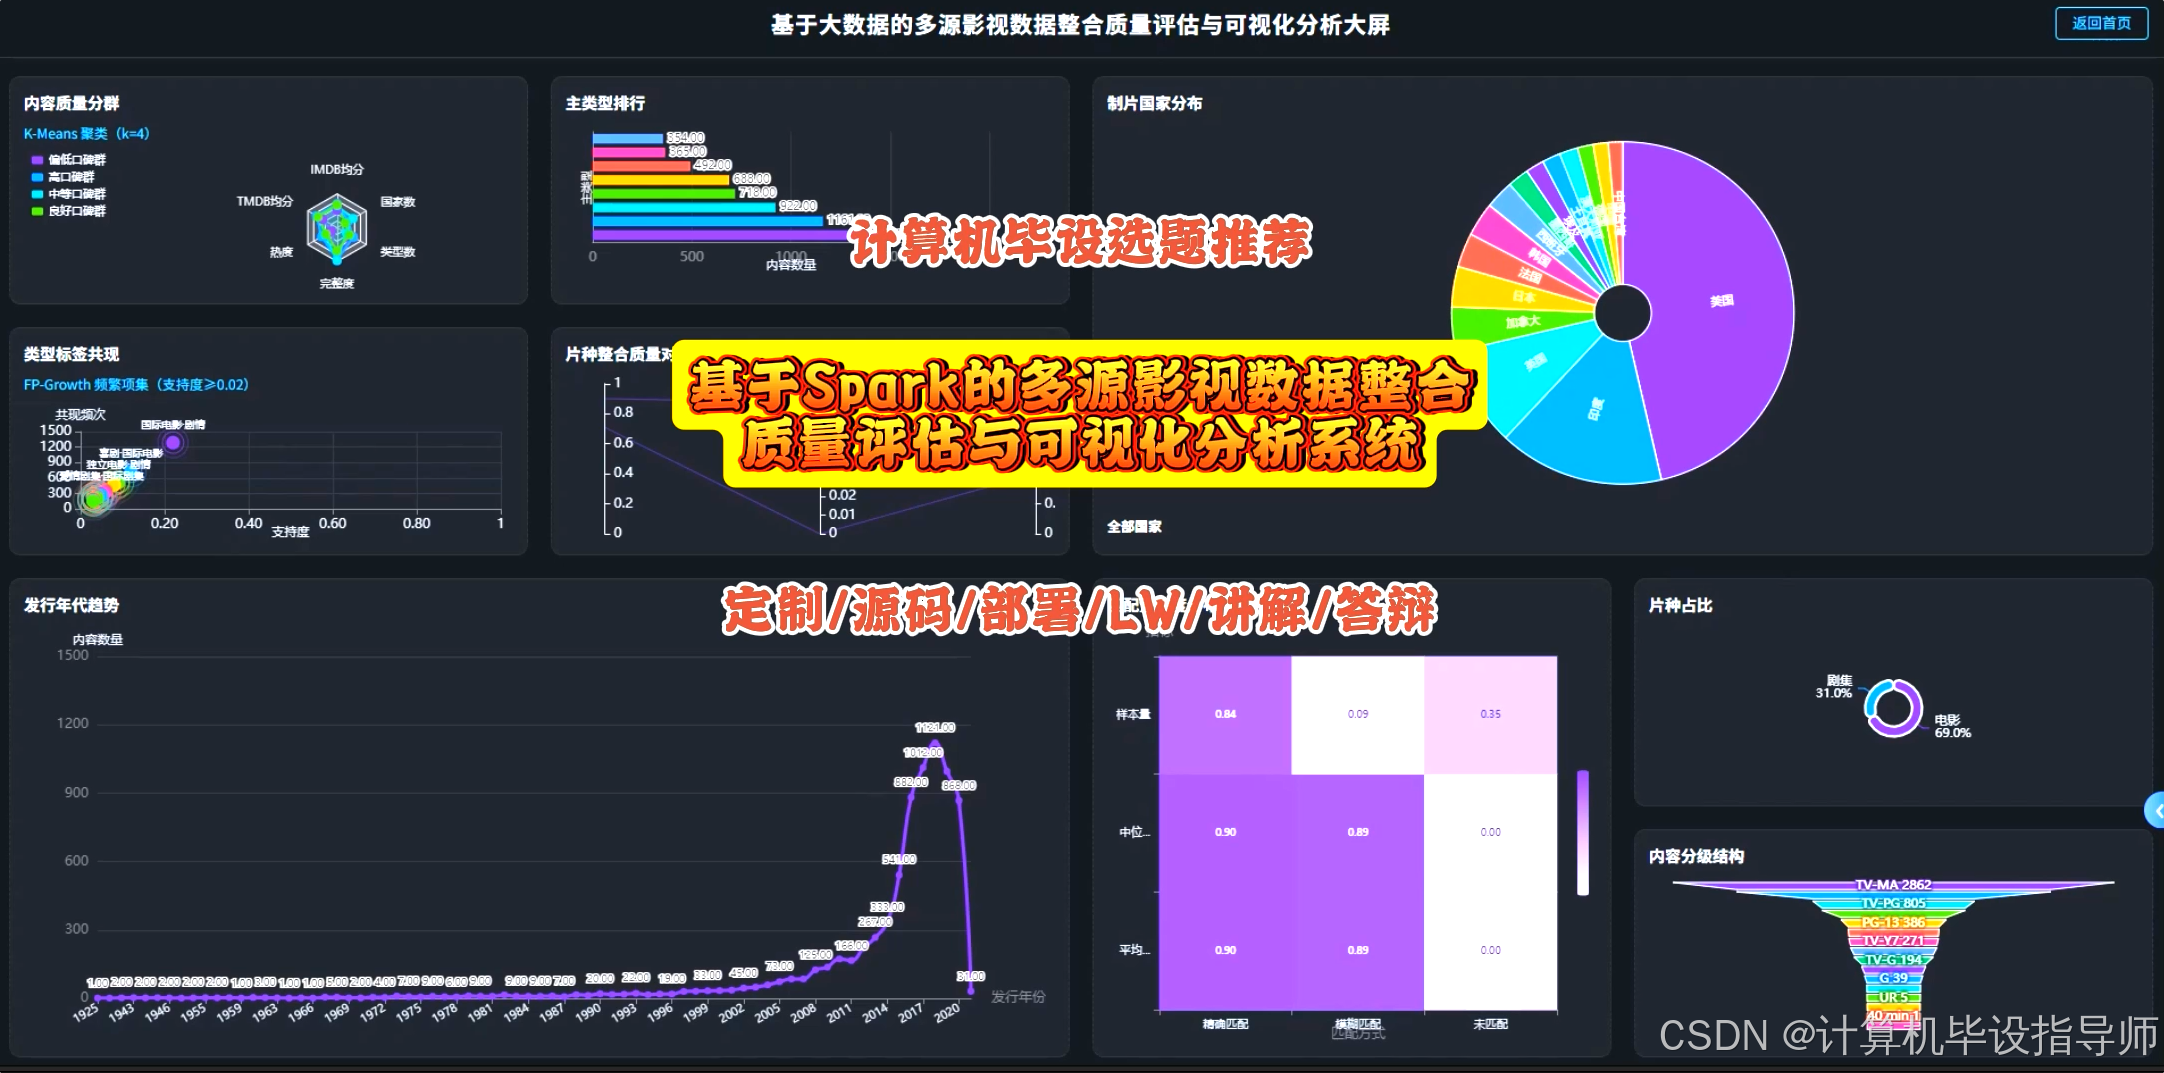
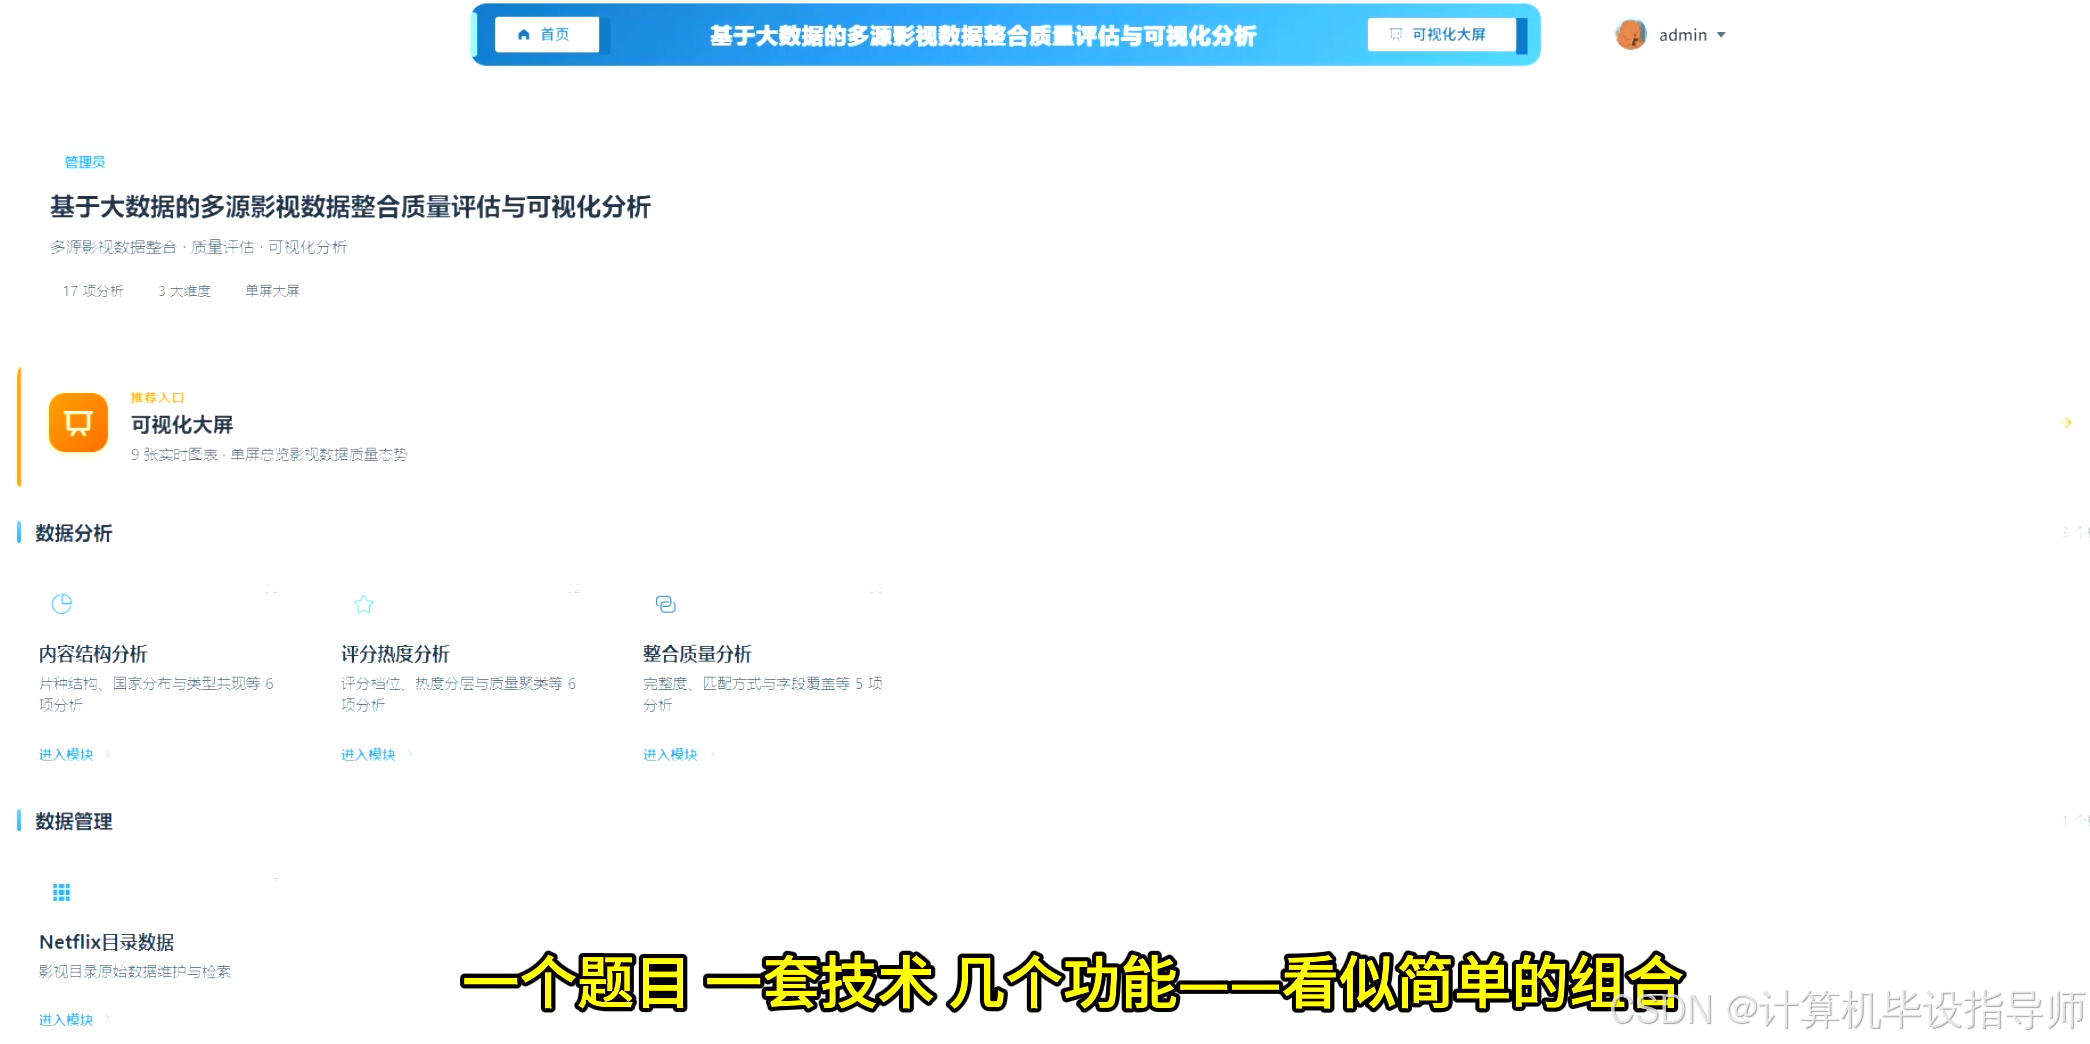
本系统基于Python生态开发,核心依托Hadoop与Spark大数据框架,后端选用Django框架提供接口服务,前端结合Vue与Echarts实现数据可视化展示,整体设计旨在解决多源影视数据整合后的质量评估与特征分析问题。系统的主要功能涵盖内容结构、评分热度以及整合质量三大分析维度。在内容结构分析方面,系统利用Spark强大的分布式计算能力,对海量的影视片库进行解析,通过对片种占比、年代发布趋势、主类型排行及制片国家分布的聚合统计,构建出片库的整体结构画像,并进一步运用FP-Growth频繁项集算法,挖掘不同影视类型标签间的共现关系,帮助识别热门题材组合。在评分热度分析模块,系统综合处理IMDB与TMDB双平台的评分与热度数据,对评分档位和热度层级进行划分,对比不同主类型影视的平均口碑,同时引入K-Means聚类算法,将影视内容依据评分、热度及数据完整度等多维特征划分为不同的质量群组,为内容分级与筛选提供参考。整合质量评估是本系统的特色功能,主要针对多源数据合并过程中的数据质量进行量化考察。系统通过统计精确匹配与模糊匹配的构成比例,分析匹配置信度在不同匹配方式下的分布情况,并对关键字段的覆盖率进行核算,最终生成数据完整度评分。这一模块能清晰地暴露出数据整合过程中的字段缺失与匹配短板,通过前端直观的可视化大屏,将繁杂的数据质量指标转化为易懂的图表,为影视数据清洗与后续的数据挖掘提供了可靠的质量诊断依据。
多源影视数据整合质量评估与可视化分析系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
多源影视数据整合质量评估与可视化分析系统-背景
现在网上的影视数据来源特别多,像IMDB、TMDB这些平台各自有各自的记录方式,字段格式也不太统一。当咱们想把这些不同来源的影视数据整合到一块儿的时候,就会发现数据存在很多残缺或者匹配不上的情况。如果直接拿这些没经过质量评估的整合数据去做分析或者推荐,得出的结果往往会偏离实际。平时大家做影视数据分析,很多时候只关注最后的数据展示,却很少去管前期数据整合的质量到底怎么样。在这个背景下,就很有必要做一个系统,专门用来评估这些多源影视数据整合后的质量,看看哪些字段缺失严重,哪些匹配得不准,顺带把这些数据的情况用图表清晰地展现出来,让看数据的人心里有个底。
这个课题的实际意义其实就是帮大家把那些杂乱的多源影视数据理清楚。从数据处理的角度看,通过评估数据完整度和匹配置信度,能直观暴露出数据整合过程中的短板,给以后清洗数据提供一个明确的参考方向。从功能应用的角度看,系统对影视内容结构和评分热度做分析,结合K-Means聚类算法划分出质量分群,能帮着快速了解片库的整体构成和口碑分布。虽然作为一个毕业设计,它不可能解决所有数据质量问题,但把Spark大数据技术跟数据质量评估结合起来,本身就是一个挺有价值的尝试。通过可视化图表把这些分析结果展示出来,也能让非技术人员看懂数据的状况,对提升数据可用性还是有实打实的帮助的。
多源影视数据整合质量评估与可视化分析系统-视频展示
基于Spark的多源影视数据整合质量评估与可视化分析系统源码
多源影视数据整合质量评估与可视化分析系统-图片展示
多源影视数据整合质量评估与可视化分析系统-代码展示
python
spark = SparkSession.builder.appName("FilmDataQualitySystem").master("local[*]").getOrCreate()
def process_genre_cooccurrence(df):
    genres_rdd = df.select("genres").rdd.flatMap(lambda row: [(row.genres, g.strip()) for g in row.genres.split(';') if g.strip()])
    transactions = genres_rdd.groupByKey().mapValues(set).map(lambda x: list(x[1]))
    fpg = FPGrowth(minSupport=0.02, numPartitions=10)
    model = fpg.fit(spark.createDataFrame(transactions.map(lambda x: (x,)), ["items"]))
    freq_items = model.freqItemsets().filter(size(col("items")) >= 2)
    result = freq_items.withColumn("support", col("freq") / df.count()).withColumn("item_count", size(col("items")))
    pandas_df = result.select(col("items").alias("items"), col("support").alias("support"), col("item_count").alias("item_count")).toPandas()
    return pandas_df
def perform_quality_clustering(df):
    features = ["imdb_rating", "tmdb_rating", "tmdb_popularity", "data_completeness_score", "genre_count", "country_count"]
    filtered_df = df.dropna(subset=features)
    assembler = VectorAssembler(inputCols=features, outputCol="features_raw")
    scaler = StandardScaler(inputCol="features_raw", outputCol="features", withMean=True, withStd=True)
    kmeans = KMeans(k=4, seed=42, featuresCol="features", predictionCol="cluster_id")
    pipeline = Pipeline(stages=[assembler, scaler, kmeans])
    model = pipeline.fit(filtered_df)
    clustered_df = model.transform(filtered_df)
    cluster_summary = clustered_df.groupBy("cluster_id").agg(count("*").alias("size"),mean("imdb_rating").alias("avg_imdb_rating"),mean("tmdb_rating").alias("avg_tmdb_rating"),mean("tmdb_popularity").alias("avg_popularity"),mean("data_completeness_score").alias("avg_completeness"))
    pandas_df = cluster_summary.orderBy("cluster_id").toPandas()
    return pandas_df
def evaluate_completeness_bins(df):
    bin_expr = F.when(col("data_completeness_score") < 0.5, "<0.5").otherwise(F.when(col("data_completeness_score") < 0.7, "0.5-0.7").otherwise(F.when(col("data_completeness_score") < 0.9, "0.7-0.9").otherwise(">=0.9")))
    df_with_bins = df.withColumn("completeness_bin", bin_expr)
    total_count = df.count()
    bin_distribution = df_with_bins.groupBy("completeness_bin").agg(count("*").alias("count"))
    pandas_df = bin_distribution.withColumn("ratio", col("count") / total_count).orderBy("completeness_bin").toPandas()
    return pandas_df
多源影视数据整合质量评估与可视化分析系统-结语
做计算机毕设卡壳了不知道从哪下手?别慌,这套系统的思路和实现过程我都在文章里掰开了讲,希望能帮你理清方向,如果内容对你有帮助,别忘了点赞、收藏、关注支持一下,你的鼓励就是我持续输出的动力。有具体的技术问题,欢迎直接在评论区提出来,看到都会回复。架构怎么搭、数据怎么跑、模块怎么调,咱们公开讨论,一起把计算机毕设顺利搞定!
实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
如果遇到具体的技术问题或其他需求,你也可以问我,我会尽力帮你分析和解决问题所在,支持我记得点赞、收藏,再点个关注,学习不迷路!~~