本文记录本地 ComfyUI + MiniMax H3 导演台做文生视频(t2v)的提示词写法,全部是本机实测。环境:Windows + RTX 4090 24G + 32G 内存,H3 导演台整合包,单模型一采直出(没开高清二采)。
我把这次用到的完整提示词、四段式空白模板、参数速查表,以及能直接导入导演台的 t2v 工作流 json 整理成了一个包(05-H3提示词模板包,就一个 Word 模板 + 一个 json,不含软件安装包和模型 ,软件本体请走 ComfyUI、MiniMax 官方渠道),免费放网盘自取:
https://pan.quark.cn/s/96d9bb6b557b
照着包里的模板填、参数抄,本文这条 5 秒片子基本能一遍跑通。
说出来你可能不信,我第一次跑的镜头简单到不能再简单:文生视频,5 秒,768P,画面里就一杯冒热气的咖啡。工作流搭得明明白白,模型、分辨率、帧数都对,点生成,两分多钟后打开视频------画面里没有咖啡,是三个穿西装的中年男女坐在豪华客厅沙发上聊天,中间那位女士还在说话,嘴型都对得上。
我盯着屏幕愣了好一会儿:我提示词里一个"人"字都没写啊。
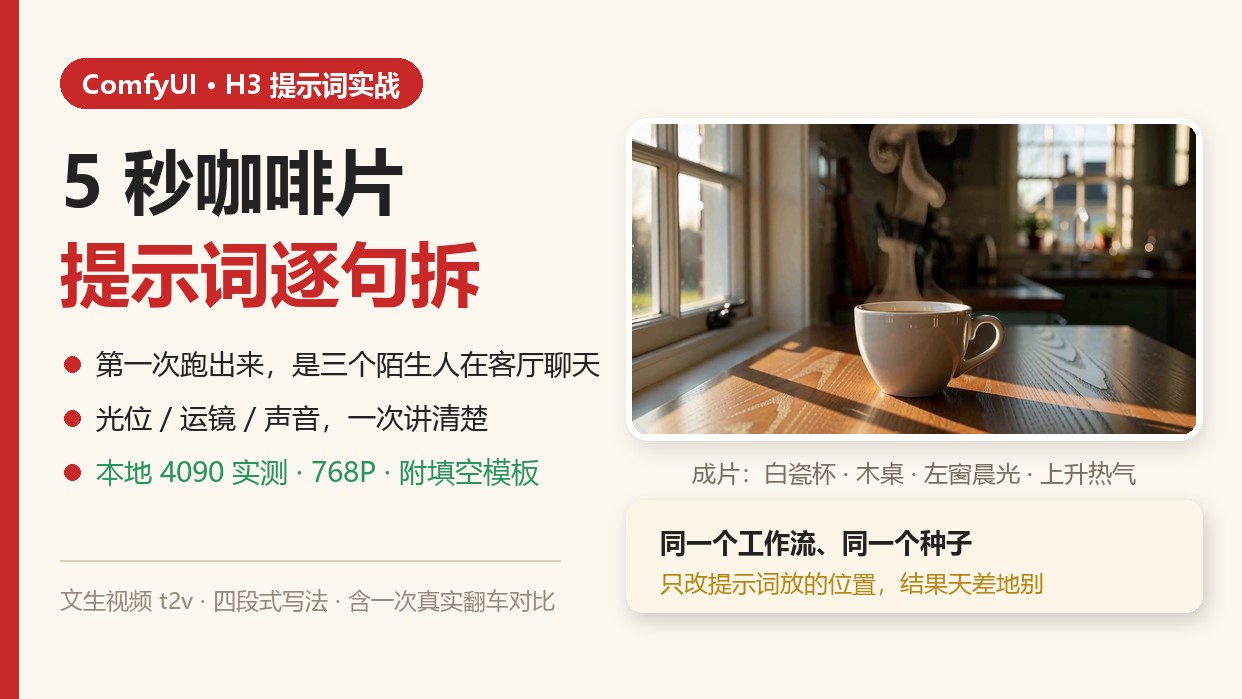
后来我用同一个工作流、同一个种子(seed 20261004),只改了一个地方重跑,白瓷杯、深色木桌、左边窗户透进来的晨光、直直往上冒的热气,全对了。
这篇就拿这条片子,把 H3 文生视频的提示词到底怎么写从头拆一遍,顺便说说那"三个陌生人"是怎么来的。
一、文生视频的提示词,其实就四块
导演台里管文生视频叫 t2v,不喂图,画面和声音全靠提示词。
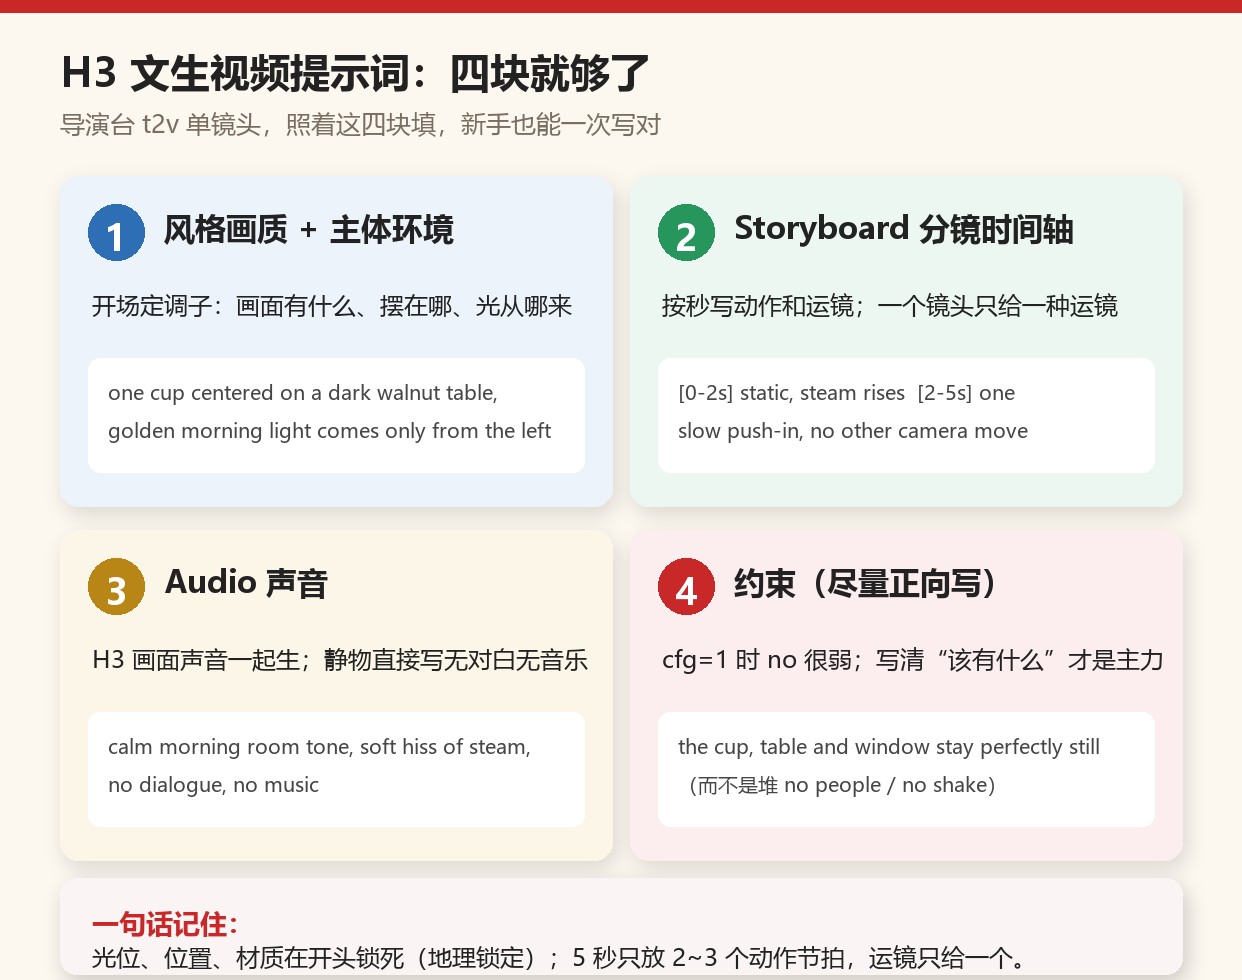
官方 MiniMax 给的 T2VA 写法是三个字段:integrated_multimodal_description(画面和动作)、overall_soundscape(环境音)、non_diegetic_music(背景音乐)。导演台把它做成了更好上手的形式,我自己用下来,一条单镜头提示词就四块:
- 风格画质 + 主体环境:开场先定调子,说清楚画面里有什么、东西摆在哪、光从哪来;
- Storyboard 分镜时间轴:第几秒到第几秒,画面怎么动、镜头怎么动;
- Audio 声音:环境音、有没有人说话、要不要音乐;
- 约束:画面里不该有什么、镜头不能怎么动。
我那条咖啡的完整提示词先贴在下面(H3 用英文最稳,新手先照英文来;中文其实也能写,但那些固定字段名别自己翻译),后面逐句拆:
Cinematic photorealistic close-up, warm and quiet morning. One white ceramic cup of black coffee sits centered on a dark walnut wooden table next to a frosted kitchen window. Soft golden morning light comes only from the left, gentle shallow depth of field, the kitchen behind softly blurred, natural film color grading. A thin column of steam rises from the hot coffee.

Storyboard:
[0s-2s] Static eye-level close-up. Delicate wisps of steam curl slowly and steadily upward from the cup; tiny dust particles drift in the sunbeam coming from the left. The cup, table and window stay perfectly still.
[2s-5s] One single very slow, perfectly smooth push-in toward the cup, with no other camera move. The steam keeps rising straight up at the same gentle speed; the warm light shimmers softly on the ceramic glaze; the shot ends on a tight close-up of the cup rim with light vapor.

Camera grammar: only one push-in for the whole shot, locked at eye level, the camera never crosses to the other side; the window and the light stay on the left in every frame. Steam only drifts upward and never swirls sideways; nothing else enters the frame.

Audio: calm morning room tone, faint soft hiss of rising steam, one distant bird chirp near the beginning. No dialogue, no narration, no music.
No people, no hands, no text, no subtitles, no logos, no watermarks, no camera shake, no fast motion, no zoom artifacts.
一个能直接套用的四段空白模板我放在文末附录,参数速查在第四章,照着填、照着跑就可以。
二、逐句拆:每一句都在解决一个翻车点
第①块,风格+主体+环境,本质是在做"地理锁定"。
One white ceramic cup ... sits centered on a dark walnut wooden table next to a frosted kitchen window,主体只有一个(一杯),位置居中,桌面是深色胡桃木,旁边是磨砂厨房窗。Soft golden morning light comes only from the left 这句最关键------光只从左边来。
为什么要写这么死?AI 视频最容易翻车的往往不是主体,而是"前后不一致":第一帧窗户在左,第三帧自己跑右边去了;光线一会儿暖一会儿白。你在开头就把光位、主体位置、材质这些地理信息锁死,后面五秒它才搬不了家。
这个写法不是我发明的。社区有个 BeatAPI 整理的 MiniMax H3 提示词库(三百多条,每条都标了原作者),里面高赞的片子基本都这么干:有的直接写"严格遵守 180 度镜头轴线,男左女右,全程站位不互换",有的写"主光恒定从右上方来",连烟雾都会标"受重力、只往上走"。链接放文末参考里,想多看例子可以去翻。
第②块,Storyboard 时间轴,记住"一个镜头只给一种运镜"。
我这条片子:0 到 2 秒是平视静态特写,蒸汽慢慢往上冒、尘埃在左边光束里飘,杯子桌子窗户都不动;2 到 5 秒只有一个非常慢、非常稳的 push in(往前推),没有别的运镜,结尾停在杯沿。
新手最常见的毛病,是一条 5 秒的片子塞四五个运镜------"先推近、再环绕、再拉升、再横移",模型根本忙不过来,结果要么乱晃要么干脆不动。5 秒你就给一个主动作(这里是推近),其余全部静态。动作节拍也一样,5 秒放 2 到 3 个就够,这条片子真正在"动"的只有两件事:热气上升、镜头推近。塞多了模型会挑着做,甚至把顺序打乱。
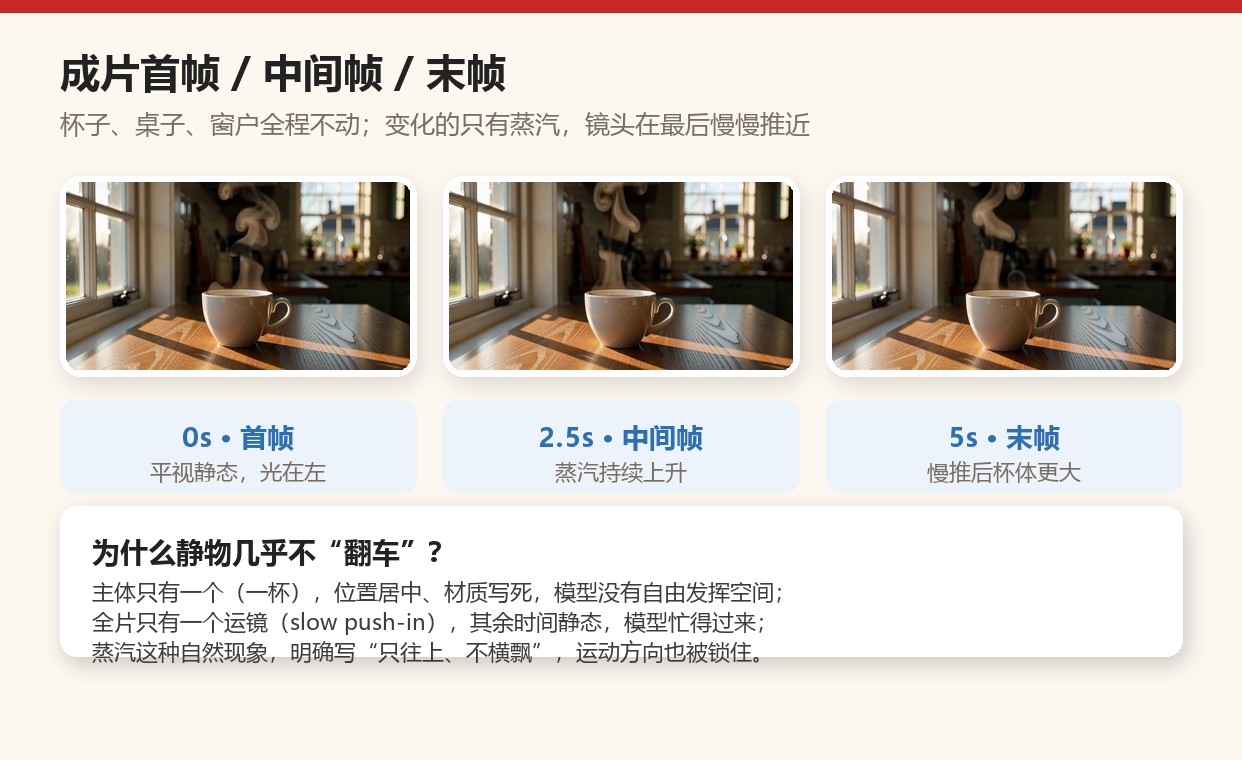
下面这三张是成片的首帧、中间帧和末帧,可以看到杯子、桌子、窗户从头到尾没动,变化的只有蒸汽的形状,镜头在最后明显推近了一点:
我还专门补了一段 Camera grammar:整条片就一个 push in、锁死在平视高度、镜头绝不绕到另一边,窗户和光每一帧都在左边;蒸汽只往上飘、绝不横着卷,画面里不许再进别的东西。这是把"地理锁定"在运动层面又锁了一遍。
第③块,声音一定要写,因为 H3 是画面声音一起生的。
它不是先出画面再配音,是音视频一起生成。你完全不写声音,它可能自作主张给你配一段音乐,甚至塞人声。
我写的是:安静的清晨室内底噪、蒸汽很轻的嘶嘶声、开头一声很远的鸟叫,然后明确 No dialogue, no music。出来的片子里确实就这些声音,很干净。新手做静物、做风景,我强烈建议直接写"无对白、无音乐",能避开一大半灵异配乐和自言自语。
第④块,约束:少用 no,尽量正向写。
我结尾还是写了一串 No people / no text / no camera shake。但说实话,H3 的 cfg 默认就是 1.0,这个强度下负面词作用很弱------你写 "no people",它有时候反而给你把人画出来。
真正托底的是前面的正向描述:one cup(就一杯)、centered(居中)、the cup, table and window stay perfectly still(杯子桌子窗户完全不动)。它清楚"该有什么",自然就不会乱加。
所以养成一个改写习惯:把"不要出现人"改成"画面里只有这一杯咖啡和桌子",把"别乱晃"改成"全程一个缓慢稳定的推近"。负面词可以写,但别指望它,正向锁定才是主力。
三、那"三个陌生人"到底是怎么来的
回到开头的翻车。我的提示词本身没毛病,问题出在我把它放哪了。
导演台的时间轴里有两层能放提示词:一层是"全局提示词(global prompt)",一层是每个"分段(segment)自己的提示词"。我图省事,只在全局里写了咖啡,把分段那一栏留空了。
旧版本这么干能跑,全局会兜底;但我手上这版导演台,实际是逐段读提示词的------分段是空的,它就真拿着一段空描述去生成了。你给视频模型一段空提示词,它不会发呆,它会从自己最熟的画面里随便挑一个,于是挑了段影视剧里最常见的三人客厅访谈给我,连说话口型都配齐了。
怎么查出来的?导演台节点每次跑完会输出一份运行报告 。第一次跑完我翻报告,分段那一行只显示一个光秃秃的 "t2v",后面什么都没有;我把提示词也填进那个唯一的分段(s0)再跑,报告里那行就变成了 t2v --- Cinematic photorealistic close-up, warm and quiet morning...,画面立刻就是咖啡了。
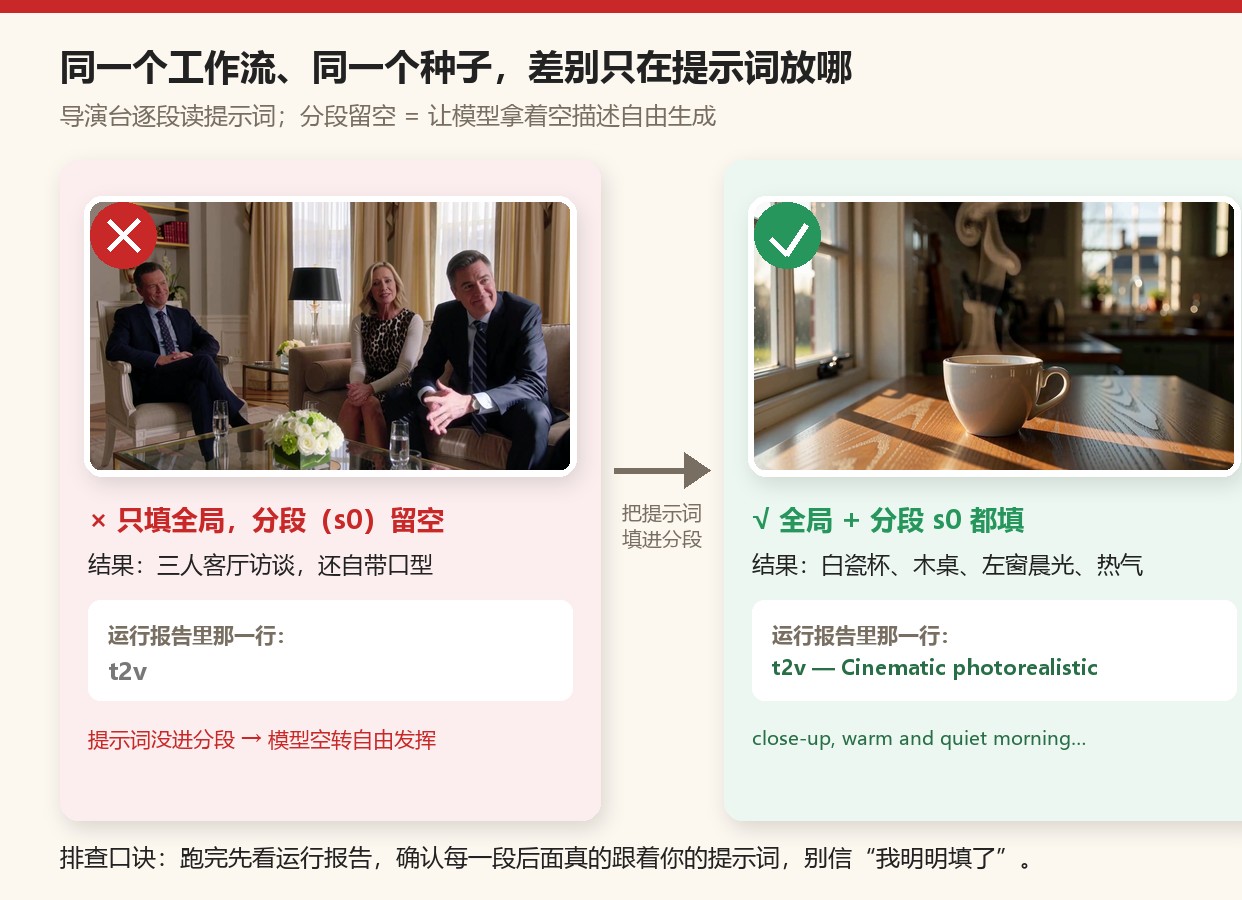
这个坑有点版本特色:导演台更新很快,网上不少教程还是旧版的,照着旧教程只填全局,就可能和我一样。判断方法特别简单------跑完瞄一眼运行报告,确认每一段后面真的跟着你的提示词,别信"我明明填了"。
如果你是在网页界面里点模板新建,一般不会遇到,界面会帮你把全局同步到分段;我是走 API、自己拼工作流批量提交才踩中。但不管哪种用法,"看报告"这招都通用。
四、参数照抄,和几个能立刻用的结论
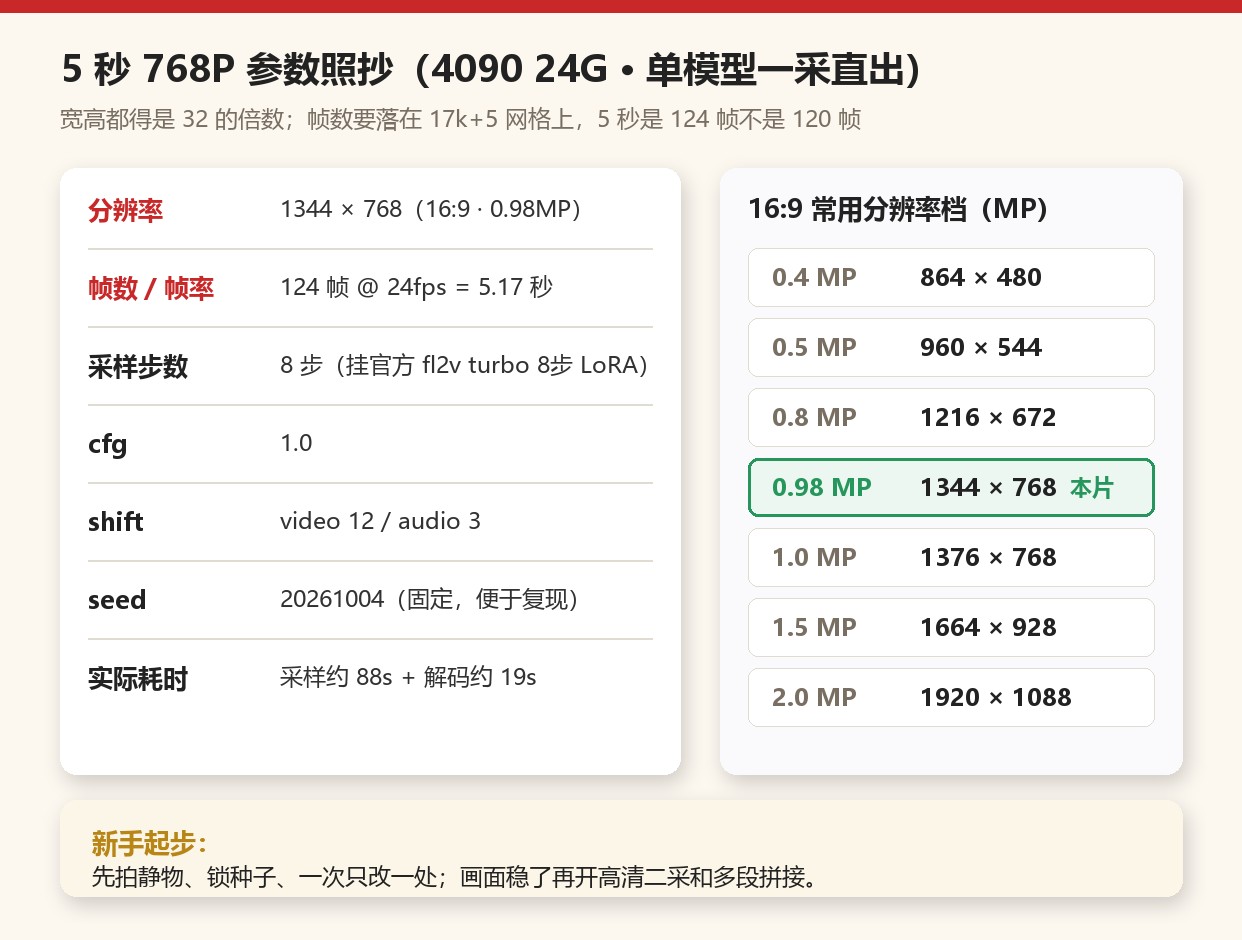
这条片子是本地 4090 24G、单模型一采直出(没开高清二采)跑的,参数都在这:
- 分辨率 1344×768,16:9 的 768P 档(导演台分辨率表里 0.98MP 那档,宽高都得是 32 的倍数,不能随手填);
- 124 帧、24fps,出来 5.17 秒(5 秒不是 120 帧,H3 的帧数要落在 17k+5 的网格上,124 才是合法档);
- 采样 8 步(挂了官方 fl2v turbo 8 步加速 LoRA;不挂默认 25 步,会慢不少);
- cfg 1.0、shift_video 12 / shift_audio 3;
- seed 固定 20261004,方便复现------调提示词时把种子锁住、一次只改一处,你才知道到底是哪一下起了作用;
- 实际耗时:采样约 88 秒 + 解码约 19 秒,两分钟出头。
给新手的最小起步路径,就四步:
- 第一条片拍静物(一杯水、一盆绿植、一盏灯),别上来就做人、做多段、做花哨运镜;
- 提示词按四块写,光位、位置、材质在开头锁死,一个镜头只给一种运镜,声音写清楚;
- 固定种子、一次只改一处,跑完看运行报告,确认提示词真的进了每一段;
- 画面稳了,再去碰高清放大、多段拼接那些高级东西(那些坑我在上一篇 《MiniMax H3 导演台多段视频避坑指南》 里专门写过)。
说句实在的,AI 视频新手和老手的差距,很多时候不在谁的词更华丽,而在你有没有把光、位置、运动、声音这些"事实"交代清楚,以及翻车之后会不会看报告定位。我第一次跑出三个陌生人也挺崩溃,但真找到原因,也就一分钟的事。
你要是也在本地跑 H3,照这条咖啡片试一次,大概率一遍成。翻车了可以把画面发评论区,我帮你看是提示词没写对,还是哪个开关没配对。后面我会继续把本地 H3、ComfyUI 的实操一条条记下来,觉得有用可以点个赞、收个藏。
附:四段式空白模板(复制后替换方括号)
Cinematic photorealistic [close-up / medium shot], [time of day, mood].
[One subject] [is / sits / stands] [position] on/at [surface / place], [next to / behind ...].
[Key light, e.g. soft warm morning light comes only from the left], [shallow depth of field], [background], [color grading].
[One natural motion of the subject, e.g. a thin column of steam rises].

Storyboard:
[0s-2s] Static [eye-level / low-angle] shot. [what moves slowly; everything else stays still].
[2s-5s] One single very slow, smooth [push-in / pan / tilt], with no other camera move.
[how the subject and light change; where the shot ends].

Camera grammar: only one camera move for the whole shot, locked at [height];
the camera never crosses to the other side; [window / light] stays [direction] in every frame;
[physics rule, e.g. steam only drifts upward and never sideways]; nothing else enters the frame.

Audio: [room tone / ambience], [one or two specific soft sounds], [one optional distant sound].
No dialogue, no narration, no music.
[Positive lock, e.g. the subject and background stay perfectly still; only one subject is visible].
No text, no subtitles, no logos, no watermarks, no camera shake, no fast motion.
新手建议:先拍静物、固定种子,一次只改一处,画面稳了再去碰高清二采和多段拼接。
参考(提示词写法思路来源,仅学习,版权归原作者):
- BeatAPI 整理的 H3 提示词库(GitHub):https://github.com/BeatAPI/awesome-minimax-h3-prompts
- 在线浏览版:https://beatapi.io/zh/minimax-h3-prompts
- MiniMax H3 官方提示词技能与模型请通过官方渠道获取。