数据在内存中的存储
进制、位置与权重
在进入计算机行业后,我们就会以各种不同的方式频繁听到一个词:"二进制"。可能最开始,我们对这些词有些好奇:"这二进制以前没碰过,怪新奇的。"但随着日复一日的重复,我们对其感到麻木:"你问我二进制是什么,二进制不就是二进制吗?这有什么好讲的。"
你可能以为我要反驳你,但是我得说,你说的没错。但是,如同在某些极少的时间下,思考那些哲学问题,比如"我是谁""我从哪来""要往哪去",二进制背后也有很多抽象的思想。当然,如果你不在意的话,也可以把它们当成故事听。
故事的开始,并不是二进制,而是我们日常所接触的数字。
text
5
50
500
尽管你可能觉得很奇怪,但我还是要问:这三个数中的 5 都是同一个符号,为什么背后表示的数值却不同?当然,这是一道主观题,有很多答案,但我想要的是这种:因为这三个数字并不是纯符号,它们背后隐含着一套名为十进制的规则。
在十进制中,我们以符号所处的相对空间位置为依据,来表示该符号背后的权重级别。"5"就一个符号,它自然落到名为"10⁰"的最低权重级别上。对于"50",其 5 落到次低"10¹"权重级别,当然 0 乘以权为 0,所以我略过了。
500 的"5"落到 10² 上。
(写这一段的时候,不知道为什么,我想到一本名为《薛定谔的猫》的书[其实我不确定是不是这个名字]。粒子先落入低能级,低能级满了,才能落更高能级。)
重要的不是位置本身,而是用位置来表示的进制级别。
不管是十进制、二进制,还是其他进制,其中的数字,比如"十""二",本质上都是常数。它们只是描述了相邻权重的递进程度而已。
表示的信息量与计算的代价
但十进制、二进制也并非是完全相同的。比如从信息量角度来说,一个二进制位只有两种可能:
log 2 2 = 1 比特 \log_2 2 = 1\ \text{比特} log22=1 比特
log 2 10 ≈ 3.22 比特 \log_2 10 \approx 3.22\ \text{比特} log210≈3.22 比特
单从这个角度来看,十进制似乎比二进制更加优秀,就像表意文字对比表音文字(你应该知道我说的是什么表意文字吧?)。
但这只是从一个方面看待事物,是不全面的。我们或许要进行某种灵魂拷问:"那么,代价是什么?"
代价就是相比二进制来说,十进制的计算规则更加复杂(因为每一位有更多的状态)。实际上,当初莱布尼茨引入二进制的一个原因,就是因为它的规则十分简单,因而适合处理某些特定的数学问题。
从逻辑规则到计算机器
在莱布尼茨于 1703 年发表它的《二进制算术说明》后的约 144 年后,乔治·布尔在 1847 年建立他的代数体系,以此来表示人的逻辑推理。
之后又过大约 80 年后,即 20 世纪 30 年代,许多研究者意识到布尔逻辑与继电器开关网络之间存在对应关系。其中的典型代表就是香农。在他的论文《继电器与开关电路的符号分析》中说:
数字可以通过继电器或步进开关的位置来表示,继电器网络能够执行数学运算;对于能够通过有限步骤和 if、or、and 等逻辑关系描述的操作,可以用继电器自动完成。
那么,我们是否可以制造出某种机器,把计算------或者说,按照一套明确规则不断进行符号操作的工作------交给它来执行呢?
好了,历史课上到这里了。从这条发展脉络中,我们可以看到,人们使用二进制当作计算机的基础,并不是因为它们有什么优越性,或者说它们在数学上更加"正确",而是出于一种实用的工程思维:二进制能够让后续操作更简单、更统一,更容易也更可靠地实现。
尽管牺牲了表示长度,但换来了两个重要东西:每一位只需要区分两种状态;运算规则也足够简单。于是抽象规则和物理器件之间非常容易建立稳定映射。
好,现在我们接受二进制了。手里只有 0 和 1 两种状态,那如果真想造一台机器替我们计算,那该如何表示数呢?最普通的加减乘除怎么做?
原码下的加法
先从非负数开始
让我们先看加法。为了方便起见,先规定一个很小的实验环境:假设机器一次处理 4 比特。最开始为了直观、简单,先不考虑正负。
这 4 bit 可以表示这些数字:
| 编码 | 数字 |
|---|---|
| 0000 | 0 |
| 0001 | 1 |
| 0010 | 2 |
| ...... | ...... |
| 1111 | 15 |
我们可以随便找几个数算一算。
3 + 4 = 7 3+4=7 3+4=7
text
  0011
+ 0100
------
  0111
这没什么特别的。
5 + 6 = 11 5+6=11 5+6=11
text
  0101
+ 0110
------
  1011
把加法拆成局部逻辑规则
如果站在机器的角度,不需要认识"5""6""11"这些完整的数,它只需要从最低位开始,一位一位处理。
先不考虑低位传来的进位,只看当前位的两个输入。每个输入都只有 0 和 1 两种状态,所有可能的组合一共只有四种:
| A | B | 本位结果 | 进位 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
本位结果实际上就是异或,进位就是与。
如果再把上一位传来的进位考虑进去,无非是三个输入:本位 A、本位 B、上一位进位;经过相同的一套规则,得到本位结果、新的进位。
无论我们算:
3 + 4 , 5 + 6 , 9 + 2 , 12 + 3 3+4,\quad 5+6,\quad 9+2,\quad 12+3 3+4,5+6,9+2,12+3
机器都不需要为了"不同的数"学习新的算法,只是在不同位置上重复同一种局部规则。
这就是我们所追求的设计原则:规则简单,而且可以靠重复同一种结构处理任意位数。
用一位区分正负
到这里,纯非负整数的加法相当漂亮。但"数"显然不只有非负数,我们迟早会碰到:
3 + ( − 2 ) 3+(-2) 3+(−2)
甚至不需要等讲到"减法",因为负数本来就可以作为加法的操作数。
现在我们手里的 0000~1111 还完全没有"正负"的概念。恰好这种符号本来就是二态的,二进制的某一位也是有两种状态,所以我们可以直接拿一个比特表示符号。
如果仍然只有 4 bit,可以规定:最高 1 bit 表示符号,剩余 3 bit 表示数值大小。0 → 正,1 → 负。
比如:
text
0 101 → +5
1 101 → -5
整个表示空间变成:
| 编码 | 数值 |
|---|---|
| 0000 | +0 |
| 0001 | +1 |
| 0010 | +2 |
| ...... | ...... |
| 0111 | +7 |
| 1000 | -0 |
| 1001 | -1 |
| 1010 | -2 |
| ...... | ...... |
| 1111 | -7 |
符号位加入计算之后
这样的话,对于 +2+(+3):
text
  0 010
  0 011
-------
  0 101
依旧可以使用之前的运算规则,毕竟 0+0 还是 0,它恰好让符号位保持相同的符号。
但对于全负数,就已经有些不对了。
− 2 + ( − 3 ) -2+(-3) −2+(−3)
text
  1 010
  1 011
-------
  0 101
如果按照之前的规则,加出来是 +5 而非 -5。
所以我们似乎要让机器做这种事:
- 符号部分:不计算,直接保留共同的符号。
- 数值部分:进行普通二进制加法。
这就已经轻微违反我们之前的设计原则。因为最早的无符号二进制加法有一个非常漂亮的性质:每一个 bit 都是对等的,不需要因为位置不同而需要分类讨论,再设计一套处理规则。
这就已经对机器造成了一定负担:它似乎需要有意区分数值位与符号位,而不能闭着眼乱加。这就不够简单,不够统一,不够通用。我们还是希望机器压根不区分符号数值位,而不是需要被单独拎出来做特殊处理。
但更严重的问题发生在符号不同的情况。对于 +5+(-3) 来说:
text
  0 101
+ 1 011
-------
  0 000
如果按照之前的规则,得到的是 0,这很明显更不对。
如果要做出正确的结果,我们需要做更重的分类讨论。对于符号不同,需要比较两数绝对值,用较大的绝对值减去较小的,结果符号取绝对值较大的那个数。
所以引入符号位,尽管解决了正负符号之间的区分问题,但也引入了新的问题。机器需要区分条件,针对不同情况进行针对性处理,严重违背了之前定下的设计原则:简单、统一、容易重复、容易用同样的物理结构实现。
编码空间的割裂
对了,说到统一性,我们还可以接着讨论一个有趣的现象:在引入符号位后,4 bit 编码完整排列如下:
text
0000  +0
0001  +1
0010  +2
0011  +3
0100  +4
0101  +5
0110  +6
0111  +7
1000  -0
1001  -1
1010  -2
1011  -3
1100  -4
1101  -5
1110  -6
1111  -7
我们发现,相比原来没符号位的编码空间来说,当前有符号的编码空间被割裂成两个部分。
非负数部分:
| 编码变化 | 0000 | → 0001 | → 0010 | → 0011 | → ...... |
|---|---|---|---|---|---|
| 数值变化 | 0 | 1 | 2 | 3 | ...... |
如果不断加 1,数值也不断变大。
但对于非正数部分:
| 编码变化 | 1000 | → 1001 | → 1010 | → 1011 |
|---|---|---|---|---|
| 数值变化 | 0 | -1 | -2 | -3 |
编码再加 1,数值却不断减小。
这隐约暴露了一个比"符号位让加法麻烦"更深的问题:我们目前这种编码虽然很好理解,但"编码空间本身的变化规则"和"数值的算术变化规律"并没有统一起来。
| 区域 | 编码变化 | 数值变化 |
|---|---|---|
| 正半区 | 编码递增 | 数值递增 |
| 负半区 | 编码递增 | 数值递减 |
0 还出现两次了。
关于加法目前的问题先按下不表,我们现在应该去看看减法。
原码下的减法
从五减三与借位开始
仍然沿用前面的四位表示:最高位表示正负,其余三位表示大小。先算 5-3。
两个数都是正数,写出来就是:
text
  0101
- 0011
------
  0010
先看数值部分,从最右边开始。最右边是 1-1,结果为 0。
向左一位,遇到了 0-1。这一位不够减,需要向更高一位借。恰好,被减数更高一位是 1,可以借给它。
这里和十进制减法很像,只是十进制向前借一单位,本位得到的是十;二进制向前借一单位,本位得到的是二。比如,刚才这一位就可以算成:
2 − 1 = 1 2-1=1 2−1=1
再向左看。被减数这一位原来是 1,但已经借出去了一单位,现在剩下 0。减数这一位也是 0,所以结果为 0。
数值部分算完,得到 010。结果为正,符号位仍是 0。而 0010 是 2,算得没错。
用逻辑操作产生结果与借位
不过,竖式是我们理解计算的方法。和前面讨论加法时一样,机器不需要认识完整的"5"和"3",也不需要理解我们口中的"不够减,向前借一个"。我们得找到一套逻辑规则,让它产生与减法相同的结果,就像在加法我们实际是用异或或者与处理那样。
好消息是,就像之前我们说的那样,二进制尽管每位信息量低,但是计算规则简单。比如我们可以对所有情况穷举,看看能不能找到计算机"懂"的操作规则。
| 被减数当前位 | 减数当前位 | 本位结果 | 是否需要向高位借 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 1 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 0 |
本位结果这一列,是不是有些熟悉?两个输入相同,输出 0;不同,输出 1。它仍然是异或,和前面加法的本位结果一样。
区别出现在另一列。加法在两个输入都是 1 时进位;这里则是在被减数当前位为 0、减数当前位为 1 时,需要借位。
这个条件也能用简单的逻辑操作表示:先把被减数当前位取反,再与减数当前位做"与"。
"取反"就是把 0 变成 1,把 1 变成 0。这样,只有原来被减数当前位是 0、减数当前位是 1 时,这个"与"的结果才是 1,正好表示需要借位。
于是,本位结果可以由异或产生,借位信号可以由取反和与产生。我们并没有要求机器理解减法,而是找到了几种简单操作,让它们的输出恰好符合减法规则。
(当然,它其实也无法理解。)
把低位传来的借位算进去
但还有一件事:当前位可能已经借给了低位一单位,这一单位也要扣掉。但其实问题也不大,我们再做一次异或就行了。
具体来说,还分两步解决。先处理当前的两个数值位,得到一个临时结果和一次借位信号;再从临时结果里扣掉低位借走的那一单位。
第二步仍然是两个二值输入,可以重复使用刚才的规则:异或产生结果,取反和与判断是否需要借位。两步中,只要有一步需要向高位借,最终就要发出借位信号,这可以用"或"合起来。
并且就目前这个例子来说,这套规则也是兼容符号位的。
拿刚才的 5-3 对照一下:最右边两个输入都是 1。异或得到 0,不需要借位,低位也没有借走东西,所以这一位输出 0。
向左一位,被减数是 0,减数是 1。异或得到 1,同时产生借位信号,交给更高一位处理。
再向左,被减数是 1,减数是 0。先异或得到 1,但低位已经借走了一单位,还得处理这个借位。临时结果 1 与借位输入 1 再做异或,得到 0,而且不需要继续向更高位借。
这样,三个数值位就产生了 010,和刚才竖式的结果一致。
所以,至少对于刚才这种较大正数减去较小正数的情况,减法没有出现什么原则性困难。
换一个顺序,再看看负数
那么如果把顺序换一下呢?
3 − 5 = − 2 3-5=-2 3−5=−2
我们已经有符号位,表示 -2 并不困难:
text
-2 → 1010问题是,刚才那套规则能直接产生它吗?显然不能。
这里就不演示全部过程了。
text
  011
- 101
-----
  110
第三位异或得 1,但是找谁借位,符号位吗?这样就会得到------
text
  0011
- 0101
------
  1110
1110 是 -6,不是 -2。
所以现在类似出现了和加法类似的问题。我们似乎还是要进行分类讨论,发现 3<5 就先算 5-3,再把结果加负号。因此违背了之前定下的设计原则。
类似的:
- 3 − ( − 2 ) = + 5 +3-(-2)=+5 +3−(−2)=+5
text
  0011
- 1010
------
  1001
− 3 − ( + 2 ) = − 5 -3-(+2)=-5 −3−(+2)=−5
text
  1011
- 0010
------
  1001
等等,也是有异常的。不过,和加法类似,我们还是先不继续说下去,而是去看看其他运算。
原码下的乘法
部分积与移位
加减法的问题先记着,我们接着看看乘法。仍然沿用前面的四位表示。先算:
2 × 3 = 6 2\times3=6 2×3=6
写成二进制:
text
    0010
  × 0011
我们仍旧可以套用十进制乘法列竖式的思路。
text
     4
  × 16
  ----
    24
+   4
  ----
    64
我故意这样写,是为了突出"移位"的那种感觉:"1"在第二权重位上,所以结果从第二权重位开始(或者你也可以在"4"后加个"0")。
对于二进制来说,仍旧是从最右边开始。最右边是 1,这一行保留被乘数,得到 0010。
向左一位,也是 1。所以得到的其实也是 0010,但它处于第二权重上,所以产生的这一行要向左错开一位,得到 00100。
再往左,两位都是 0,所对应两行也全部为零。为了方便起见,我们也可以把这两行略去,于是得到:
text
    0010
  × 0011
  ------
    0010
+  0100
  ------
    0110
得到 0110,是正确的结果,+6。
当然,现在不要拿一些别的例子,比如 4 × 6=24,会溢出。溢出不是编码格式能解决的,因此不在我们考虑范围之内。
与、移位和加法
现在回头看看,刚才每一行是怎样产生的。
乘数当前位是 0,这一行就全部为零;当前位是 1,这一行就保留被乘数。拆到单个位上,所有可能的组合只有四种:
| 被乘数当前位 | 乘数当前位 | 这一对位产生的结果 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
这正好就是"与"。
所以,机器可以让被乘数的每一位,分别与乘数当前位做"与",产生一行结果。乘数当前位每向左一位,这一行也向左错开一位,最后用前面已经讨论过的加法规则,把各行合起来。
位置上的错开也有依据:二进制相邻位置的权重相差两倍,向左移一位,正好对应权重扩大两倍。
这样,乘法也被拆成了简单、可以重复的操作:与、移位,以及加法。机器不需要认识完整的"2"和"3",只需要让这些局部操作按照固定结构执行。
换成其他数,或者换成更多位,也不需要为每个数重新设计一套算法。输入的位变了,产生的行变了,但每一处使用的规则仍然相同。
负数参与乘法会怎样
换一个带负号的例子呢?
− 2 × ( + 3 ) = − 6 -2\times(+3)=-6 −2×(+3)=−6
按照当前表示方法,写出来是:
text
    1010
  × 0011
继续使用刚才的规则。
乘数最右边是 1,产生 1010;再向左也是 1,产生向左错开一位的 10100;其余两位是 0,产生零。
text
     1010
   × 0011
   ------
    01010
+   10100
   ------
    11110
如果最终仍然只保留四位,留下的是 1110。按照当前约定,它表示 -6,这次竟然也对上了。
不过,先别急着认为这套规则已经能处理负数。把两个数稍微换一下:
− 3 × ( + 2 ) = − 6 -3\times(+2)=-6 −3×(+2)=−6
text
     1011
   × 0010
   ------
    00000
+   10110
   ------
    10110
这次保留四位,得到 0110,表示的是 +6,不是我们希望得到的 -6。
两个例子都是负数乘正数,数学上的结果甚至都是 -6,同一套逻辑规则却一次对上、一次没对上。所以,刚才 1110 的正确结果,还不能说明当前编码与这套运算规则相容。
再试试两个负数:
− 2 × ( − 3 ) = + 6 -2\times(-3)=+6 −2×(−3)=+6
text
      1010
    × 1011
  --------
  00001010
  00010100
+ 01010000
----------
  01101110
保留四位,得到 1110,按照当前约定仍然是 -6,又不对了。
这些过程中,"与"仍然按照我们规定的方式产生各行,移位和加法也没有改变规则。可是,它们最终产生的编码,并不总能对应我们想要的数值。
单独处理乘积的符号
如果继续使用当前表示方法,我们可以另外安排一套处理方式:把符号位与其余三位分开,后三位送进乘法结构,两个符号位则单独决定结果的正负。
正数乘正数、负数乘负数,结果取正;一正一负,结果取负。对应到符号位:
| 被乘数符号位 | 乘数符号位 | 结果符号位 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
这正好是异或。
这样确实可以得到正确结果,而且乘法这里的符号处理,比加减法简单一些:不需要因为正负组合不同,就切换数值部分的运算方式。
但我们还是得区分符号位与数值位,为它们安排不同的规则。之前希望各位直接参加同一套操作的想法,在这里依然没有完全实现。
原码下的除法
反复相减与商的形成
接着看看除法。仍然沿用前面的四位表示,先算:
6 ÷ 2 = 3 6\div2=3 6÷2=3
写成二进制:
text
0110 ÷ 0010我们可以先用一种直接的办法:看看被除数里能减掉多少个除数。
先减一次:
text
  0110
- 0010
------
  0100
还剩 4,已经减掉了一份 2。
再减一次:
text
  0100
- 0010
------
  0010
还剩 2,已经减掉了两份。
再减一次:
text
  0010
- 0010
------
  0000
剩下 0,一共减了三次,所以商是 3,余数是 0:
text
商:   0011
余数: 0000
如果不能恰好减完呢?比如:
7 ÷ 2 7\div2 7÷2
同样减三次,依次剩下 0101、0011、0001。最后剩下的 1 已经不够再减一份 2,所以商仍然是 3,余数是 1。
现在回头看,这个过程需要机器做什么?
减法已经有了:每一位用异或产生结果,用取反和与判断借位,再把低位传来的借位一起处理。每成功减掉一次,就让记录次数的编码加 1,这也可以使用前面的加法规则。
还差一个判断:什么时候不能继续减?
可以试着再减一次,看看最后是否还有向最高位之外发出的借位。比如刚才剩下 0001,再尝试减 0010:
text
  0001
- 0010
------
  1111
除了留下的四位,还有一次没有得到满足的借位。它告诉我们,当前剩下的量已经不够减。于是,这一次的结果不采用,保留原来的 0001,计算到这里结束。
所以,机器不需要理解"6 里面有几个 2"。我们可以安排一套固定过程:尝试减去除数,没有最终借位,就保存结果、把次数加 1,然后重复;出现最终借位,就停下,把次数作为商,把上一次留下的编码作为余数。
这种办法可能要重复很多次,未必快,但至少已经能用我们讨论过的逻辑操作复现除法。先不急着优化它。
除数为零则需要另行处理,否则每次减零都不会改变剩下的量,这个过程就停不下来了。这里先讨论除数不为零的情况。
换成负数呢?
− 6 ÷ ( + 2 ) = − 3 -6\div(+2)=-3 −6÷(+2)=−3
按照当前约定,输入是:
text
1110 ÷ 0010继续让刚才的结构处理这些位。每次减掉 0010,剩下的编码依次是:
text
1100
1010
1000
0110
0100
0010
0000
一共成功减了七次,所以记录次数的编码得到:
text
0111但按照当前表示方法,它是 +7,不是我们希望得到的 -3。
再换一个:
- 6 ÷ ( − 2 ) = − 3 +6\div(-2)=-3 +6÷(−2)=−3
负数参与除法会怎样
输入变成:
text
0110 ÷ 1010第一次尝试相减:
text
  0110
- 1010
------
  1100
同时出现了向最高位之外的借位。按刚才的规则,这一次不成功,于是直接停下,得到:
text
商:   0000
余数: 0110
又没有对上。
甚至两个负数相除也一样:
− 6 ÷ ( − 2 ) = + 3 -6\div(-2)=+3 −6÷(−2)=+3
text
1110 ÷ 1010第一次相减得到 0100,没有最终借位;再尝试减去 1010,就会出现最终借位。因此,这套过程得到商 0001、余数 0100,也不是我们想要的结果。
减法结构仍然执行同样的规则,记录次数的结构也仍然正常加 1。问题是,在当前编码约定下,这些位所表示的数值,与这套过程实际产生的结果没有对应起来。
如果继续使用这种表示方法,我们仍然可以把符号和大小分开处理:数值部分使用刚才的除法过程,商的符号另外决定。同号相除取正,异号相除取负,符号位又可以用异或产生。
这能让刚才几个整除的例子算对,但也意味着,我们仍然要辨认出符号位,为它安排不同于其他位的处理。
到这里,加减乘除都试过了。我们找到了可以重复执行的简单逻辑规则,也发现:给编码加上一个直观的正负标记,并不会自动让这些规则适用于正负数。当前这种表示容易读懂,但真正计算时,符号与大小的分工仍然需要被单独照顾。
换一种安排
前面,我们给二进制数增加了一位,用它区分正负。这样一来,负数有了自己的表示,不过在实际计算时,又出现了一些新的问题。
按照原来的规则,同一套加法电路能够正确处理两个正数,却未必能够正确处理两个负数;乘法和除法也遇到了类似的情况。为了得到正确结果,我们需要判断符号、比较大小,再决定具体怎样计算。
那么,这些问题可以怎样解决?
历史上的探索并不是沿着一条路线依次推进的。不同机器采用过不同办法,一些方案也长期并存。这里,我们按照思路之间的联系,把其中几种安排在一起,看看它们分别改变了什么。
先让机器算起来
最直接的办法,是保留目前的编码方式,再给机器增加相应的处理规则。
例如,计算正五加负三时,机器先判断两个数的符号。发现符号不同,就比较它们的大小,用五减去三,再根据大小关系确定结果的符号。乘法和除法也可以分别处理数值大小与符号。
这是一种很实际的选择:既然数已经能够表示,就先围绕这套表示,把计算过程补充完整。机器并不一定要拥有最简洁的规则,才能可靠地完成工作。
历史上的 IBM 7090 就采用了符号与大小分开的数值表示,其运算规则也包含相应的符号处理。[1](#1)
不过,这种办法把一部分复杂性留给了运算过程。符号不同,处理方式可能就不同;而前面发现的正零与负零、编码排列在正负两侧不一致等问题,也仍然存在。
因此,我们还可以从另一个方向想:能不能改变数的表示,让运算规则更自然一些?
正负一定要放在单独的一位里吗?
之前,我们选择二进制,是因为两种状态比较容易在电路中区分。不过,如果暂时放开这个条件,每一位也可以有三种状态,分别表示负一、零和正一。
为了方便书写,我们用"−""0""+"表示这三种数字,各位的权重依次是:
1 , 3 , 9 , 27 , ... 1,\ 3,\ 9,\ 27,\ldots 1, 3, 9, 27,...
例如,两位数"+−"表示:
( + 1 ) × 3 + ( − 1 ) × 1 = 2 (+1)\times3+(-1)\times1=2 (+1)×3+(−1)×1=2
而"−+"表示:
( − 1 ) × 3 + ( + 1 ) × 1 = − 2 (-1)\times3+(+1)\times1=-2 (−1)×3+(+1)×1=−2
正负已经融入各位的数值,不再需要单独留出一位,再给其余部分指定正负。
这种安排叫作平衡三进制。它的运算也有自己的进位规则。例如,一加一得到二,当前一位不能直接写二,就可以向高一位进一,当前位留下负一:
2 = 3 − 1 2=3-1 2=3−1
因此,一加一的结果写成"+−";再加一,就成为"+0",表示三。
这并不只是纸面上的设想,历史上的"塞顿"计算机就采用过平衡三进制。[2](#2)
它说明,单独设置符号位并不是唯一选择。不过,采用这种办法,也意味着存储与运算需要支持三种状态。对于已经围绕二进制建立起来的机器,我们还会希望找到一种继续使用零和一的方案。
减去一个数,能不能换成加上一个数?
我们先回到熟悉的十进制。
假设机器只保留两位十进制数,那么它一共能够表示一百种状态,从 00 到 99。超过两位的部分不保留,例如:
99 + 1 = 100 99+1=100 99+1=100
留下最后两位,就回到了 00。
在这种条件下,计算五减三,可以换一种做法。先用总状态数一百减去三,得到九十七,再把它加到五上:
05 + 97 = 102 05+97=102 05+97=102
只保留两位,结果就是 02,与五减三相同。
也就是说,对于这台只保留两位的机器,加上九十七,能够产生减去三的效果。这里的九十七,就是三相对于一百的互补数。
这种借助互补数完成减法的思路,在机械计算设备中就已经得到过应用。一些历史上的加法机,甚至在按键上标出了供减法使用的互补数字。[3](#3)
再看三减五:
03 + 95 = 98 03+95=98 03+95=98
结果是 98。如果继续给它加一,就会依次得到:
98 → 99 → 00 98\rightarrow99\rightarrow00 98→99→00
它恰好处在零的前面两步。如果我们把 98 解释为负二,把 99 解释为负一,那么这个变化就成了:
− 2 → − 1 → 0 -2\rightarrow-1\rightarrow0 −2→−1→0
这样,互补数不仅提供了一种计算减法的办法,也给出了重新表示负数的线索。
回到四位二进制
四位二进制一共有十六种状态,因此,与刚才的一百对应的数,现在是十六。
仍然计算五减三:
5 − 3 = 5 + ( − 3 ) 5-3=5+(-3) 5−3=5+(−3)
正五已经有编码 0101。现在,既然我们要把减法交给加法电路处理,就需要找到一种负三的编码,让它与 0101 相加后得到 0010。
按照刚才的办法,用十六减去三:
16 − 3 = 13 16-3=13 16−3=13
十三的四位二进制表示是 1101。把它放进加法中:
0101 + 1101 = 10010 0101+1101=10010 0101+1101=10010
只保留四位,得到 0010,正好是二。
于是,在这套新的安排中,负三的编码就从原来的 1011 变成了 1101。我们寻找十三的目的,也就在这里:用这串编码参与加法,实现加上负三的效果。
同样的 1101,按照无符号二进制解释,表示十三;按照我们正在建立的有符号编码解释,则表示负三。机器拿到的始终是这四个比特,数值含义来自我们采用的解释规则。
最高位仍然能够帮助我们辨认正负,不过,它与后面几位的关系已经改变了。不能再把最高位拿出来表示负号,然后把剩下的 101 读成五。
在这个过程中,五的编码没有改变。我们借用的就是原来的加法规则,所以零和正数可以继续沿用原来的表示;需要重新安排的,是参与同一套加法过程的负数。
这个编码怎样得到?
刚才,我们通过 16-3 找到了负三的新编码。接下来看看,这一步怎样用逻辑运算完成。
可以把它写成:
16 − 3 = ( 15 − 3 ) + 1 16-3=(15-3)+1 16−3=(15−3)+1
十五的四位二进制表示是 1111,三则是 0011。用 1111 减去 0011,每一位都不需要借位:减去零,留下的是一;减去一,留下的是零。
这恰好就是逐位取反:
0011 → 取反 1100 0011\xrightarrow{\text{取反}}1100 0011取反 1100
再加一:
1100 + 0001 = 1101 1100+0001=1101 1100+0001=1101
负三所需要的编码就得到了。整个过程是从正三的四位表示出发,全部取反,再加一,最高位也参与其中。
负二同样如此:
0010 → 取反 1101 → 加一 1110 0010\xrightarrow{\text{取反}}1101 \xrightarrow{\text{加一}}1110 0010取反 1101加一 1110
按这种方式安排,四位编码与数值的对应关系如下:
| 编码 | 数值 | 编码 | 数值 |
|---|---|---|---|
0000 |
0 | 1000 |
−8 |
0001 |
+1 | 1001 |
−7 |
0010 |
+2 | 1010 |
−6 |
0011 |
+3 | 1011 |
−5 |
0100 |
+4 | 1100 |
−4 |
0101 |
+5 | 1101 |
−3 |
0110 |
+6 | 1110 |
−2 |
0111 |
+7 | 1111 |
−1 |
其中,负八对应的 1000 来自 16-8=8;四位有符号表示里没有正八与它配对。这处边界,我们之后再仔细讨论。
这种编码方式,就是补码。
接下来还需要看什么?
我们从减法走到了补码,但它能否适用于其他计算,还需要继续考察。
先试一下负二加负三:
1110 + 1101 = 11011 1110+1101=11011 1110+1101=11011
只保留四位,得到 1011,表示负五。两个负数相加,也得到了正确结果。这让我们看到,刚才为减法找到的编码,与加法本身也能够衔接起来。
乘法也存在这样的联系。例如,负二乘正三,把完整的 1110 与 0011 按普通二进制乘法计算,得到 101010;保留最后四位是 1010,表示负六。不过,这里只考察了保留四位的结果。如果要得到更宽的完整乘积,还需要说明编码怎样扩展,以及各位怎样参与计算。
除法则还涉及判断大小、形成商与确定余数。补码提供了新的数值表示,也使其中的加减步骤能够采用统一的规则,但具体的除法过程仍然需要相应的算法。
到这里,我们已经有理由继续研究这套方案:它保留了二进制,也让正负数的加减能够接入同一套加法过程;原来正负两侧分开的编码,在零附近也连了起来:
1110 → 1111 → 0000 → 0001 1110\rightarrow1111\rightarrow0000\rightarrow0001 1110→1111→0000→0001
对应的数值是:
− 2 → − 1 → 0 → 1 -2\rightarrow-1\rightarrow0\rightarrow1 −2→−1→0→1
接下来,我们就沿着这种连接继续看:为什么取反加一能够得到这样的编码,最高位究竟承担了什么作用,以及加减乘除在这套表示下分别怎样进行。
补码中的运算
前面,我们借助互补数,把减法放进了加法过程,并由此重新安排了负数的编码。现在继续使用这套补码表示,把加减乘除重新走一遍。
仍然以四位二进制为例。正三是 0011,负三是 1101;正二是 0010,负二是 1110。
加法
先看正五加负三:
5 + ( − 3 ) = 2 5+(-3)=2 5+(−3)=2
对应的编码计算是:
0101 + 1101 = 10010 0101+1101=10010 0101+1101=10010
只保留四位,得到 0010,表示正二。
再看正三加负五:
0011 + 1011 = 1110 0011+1011=1110 0011+1011=1110
结果 1110 表示负二。
这两次计算都没有先比较五与三的大小,再决定谁减谁,也没有计算完大小之后,另外给结果确定符号。每一位仍然按照原来的加法规则处理,最终得到的整串编码就能对应结果。
两个负数相加也一样。例如,负二加负三:
1110 + 1101 = 11011 1110+1101=11011 1110+1101=11011
留下四位,得到 1011,表示负五。
因此,正数与负数能够进入同一套加法过程。不过,结果仍然需要落在当前位数能够表示的范围内。超出范围时会发生什么,我们后面再看。
减法
前面,我们已经找到了一种处理减法的办法:减去一个数,可以改成加上它相对于总状态数的互补数,再保留规定的位数。
四位二进制有十六种状态。计算五减三时,三的编码是 0011,对应的互补数是:
16 − 3 = 13 16-3=13 16−3=13
十三的编码是 1101,因此:
0101 − 0011 ⟶ 0101 + 1101 = 10010 0101-0011 \quad\longrightarrow\quad 0101+1101=10010 0101−0011⟶0101+1101=10010
保留四位,得到 0010。
那么,减数本身是负数时,这个办法还能继续使用吗?
例如,计算二减负三。负三的补码是 1101,这串编码按无符号规则解释是十三。我们仍然寻找它相对于十六的互补数:
16 − 13 = 3 16-13=3 16−13=3
得到 0011。于是,编码计算变成:
0010 + 0011 = 0101 0010+0011=0101 0010+0011=0101
结果表示正五,与二减负三的结果一致。
这里并没有更换处理办法。之前用三找到十三,现在用十三找到三,沿着的仍然是同一个互补关系。
而取反加一,就是二进制求互补数的方法:
1101 → 取反 0010 → 加一 0011 1101\xrightarrow{\text{取反}}0010 \xrightarrow{\text{加一}}0011 1101取反 0010加一 0011
负五减负三也可以这样计算:
1011 + 0011 = 1110 1011+0011=1110 1011+0011=1110
结果表示负二。
因此,在补码表示下,减法可以采用一个固定过程:对减数的完整编码取反加一,再与被减数相加,保留当前位数。减数原来是正数还是负数,都可以进入这个过程。
在实际逻辑中,加一也可以通过向加法结构的最低位送入一个进位完成。这样,加减法就能够共用主要的计算结构。
乘法
前面,我们把二进制乘法拆成了逐位的与、移位,以及部分积相加。现在继续使用这些操作,计算负二乘正三:
( − 2 ) × 3 = − 6 (-2)\times3=-6 (−2)×3=−6
输入的完整编码是 1110 与 0011。乘数的低两位都是一,因此产生两个非零部分积:
001110 + 011100 = 101010 001110+011100=101010 001110+011100=101010
保留最后四位,得到 1010,表示负六。
再看两个负数相乘:
( − 2 ) × ( − 3 ) = 6 (-2)\times(-3)=6 (−2)×(−3)=6
输入是 1110 与 1101。乘数从低位到高位,第一、第三、第四位是一,对应的非零部分积相加:
00001110 + 00111000 + 01110000 = 10110110 00001110+00111000+01110000=10110110 00001110+00111000+01110000=10110110
最后四位是 0110,表示正六。
为什么按普通二进制乘法计算,保留最后四位,就能得到正确结果?
负二的编码按无符号规则解释是十四,负三的编码则是十三:
14 = − 2 + 16 , 13 = − 3 + 16 14=-2+16,\qquad13=-3+16 14=−2+16,13=−3+16
所以:
14 × 13 = ( − 2 + 16 ) ( − 3 + 16 ) 14\times13=(-2+16)(-3+16) 14×13=(−2+16)(−3+16)
展开以后,除了 (-2)(-3),其余各项都含有十六这个因子。十六的整数倍写成二进制,最后四位都是零,不会改变结果的最后四位。
因此,这样计算得到的最后四位,与真实乘积的最后四位一致。如果真实乘积也在四位补码的表示范围内,就能直接解释成我们需要的结果。
不过,如果要用八位保存完整乘积,就需要先把输入扩展到八位,并保持数值不变。
正数可以在左边补零。例如:
0010 → 00000010 0010\rightarrow00000010 0010→00000010
负二却不能这样做,否则 1110 会变成 00001110,表示正十四。
八位一共有二百五十六种状态,负二的编码应当来自:
256 − 2 = 254 256-2=254 256−2=254
因此,负二的八位补码是 11111110。负三同样得到 11111101:
1110 → 11111110 1110\rightarrow11111110 1110→11111110
1101 → 11111101 1101\rightarrow11111101 1101→11111101
正数补零,负数补一,恰好都是重复原来的最高位。这种保持数值的扩展叫作符号扩展。这里先通过互补数核对了结果,后面讨论各位权重时,再解释为什么重复最高位能够做到这一点。
这也与编程中的整型提升有关:较小的整数进入较宽的计算类型时,需要保持原来的数值。符号扩展说明了补码有符号数可以怎样扩大表示位数,而具体什么时候发生整型提升,则由语言的类型规则决定。
把两个输入扩展成八位,再进行乘法,保留最后八位:
11111110 × 11111101 → 保留八位 00000110 11111110\times11111101 \quad\xrightarrow{\text{保留八位}}\quad 00000110 11111110×11111101保留八位 00000110
结果表示正六。
除法
除法可以先依据两个操作数是否异号,确定商的正负,再进行绝对值之间的除法。
例如:
( − 6 ) ÷ 2 = − 3 (-6)\div2=-3 (−6)÷2=−3
现在使用的都是补码,输入就是 1010 与 0010。两个最高位分别是一和零,说明操作数异号,商应该为负。这个判断可以通过两个最高位的异或完成。
接下来计算绝对值。
正二保持 0010。负六的绝对值是正六,需要求出它的相反数。刚才讨论互补关系时,我们已经看到:对一串编码取反加一,能够从互补关系的一端回到另一端。
1010 按无符号规则解释是十,十相对于十六的互补数是六。因此:
1010 → 取反 0101 → 加一 0110 1010\xrightarrow{\text{取反}}0101 \xrightarrow{\text{加一}}0110 1010取反 0101加一 0110
得到正六的编码。
对于这里的操作数,机器可以根据最高位决定是否进行变换:最高位为零,保持编码;最高位为一,取反加一。于是,绝对值之间的除法变成:
0110 ÷ 0010 0110\div0010 0110÷0010
从六中反复减去二,每成功减去一次,商就增加一:
| 成功相减的次数 | 当前剩余编码 |
|---|---|
| 0 | 0110 |
| 1 | 0100 |
| 2 | 0010 |
| 3 | 0000 |
得到商 0011,余数为零。
因为之前已经确定商为负,所以对 0011 求相反数:
0011 → 取反 1100 → 加一 1101 0011\xrightarrow{\text{取反}}1100 \xrightarrow{\text{加一}}1101 0011取反 1100加一 1101
最终商是 1101,表示负三。
再看一个有余数的例子:
( − 7 ) ÷ 2 (-7)\div2 (−7)÷2
这里约定商向零截断,因此结果应当是商负三,余数负一。
输入是 1001 与 0010。两个数异号,商为负。把负七取反加一,得到它的绝对值:
1001 → 取反 0110 → 加一 0111 1001\xrightarrow{\text{取反}}0110 \xrightarrow{\text{加一}}0111 1001取反 0110加一 0111
然后计算:
0111 ÷ 0010 0111\div0010 0111÷0010
| 成功相减的次数 | 当前剩余编码 |
|---|---|
| 0 | 0111 |
| 1 | 0101 |
| 2 | 0011 |
| 3 | 0001 |
剩余的一小于二,计算停止。得到商的大小 0011,余数的大小 0001。
商应为负,因此取反加一,得到 1101。在向零截断的约定下,非零余数与被除数同号,因此余数也要变成负一:
0001 → 取反 1110 → 加一 1111 0001\xrightarrow{\text{取反}}1110 \xrightarrow{\text{加一}}1111 0001取反 1110加一 1111
最终得到:
商: 1101 , 余数: 1111 \text{商:}1101,\qquad\text{余数:}1111 商:1101,余数:1111
检查一下:
− 7 = ( − 3 ) × 2 + ( − 1 ) -7=(-3)\times2+(-1) −7=(−3)×2+(−1)
如果换成正七除以负二,商仍然是负三,但余数是正一:
7 = ( − 3 ) × ( − 2 ) + 1 7=(-3)\times(-2)+1 7=(−3)×(−2)+1
所以,商的符号由两个输入是否异号决定;在这里采用的约定下,非零余数的符号由被除数决定。
这套除法仍然需要判断与控制,不过,求绝对值、确定结果编码,以及其中的相减,都能够使用已经得到的补码规则。
编码与数值重新接了起来
加减乘除看过以后,我们再回头看看编码本身。
之前讨论原码时,我们发现:正数一侧,编码增加,数值也增加;负数一侧,编码增加,数值却减小。
| 原码变化 | 1001 |
1010 |
1011 |
1100 |
|---|---|---|---|---|
| 数值变化 | −1 | −2 | −3 | −4 |
两侧采用了相反的变化方向。即使通过额外规则让机器正确计算,这种排列本身也没有改变。
补码的负数部分则是:
| 补码变化 | 1000 |
1001 |
1010 |
1011 |
|---|---|---|---|---|
| 数值变化 | −8 | −7 | −6 | −5 |
编码增加一,数值也增加一。继续走下去:
| 补码变化 | 1101 |
1110 |
1111 |
0000 |
0001 |
|---|---|---|---|---|---|
| 数值变化 | −3 | −2 | −1 | 0 | +1 |
1111 加一得到 10000,保留四位,就回到 0000。编码的这次回绕,恰好把负一与零接了起来。
原来正负两侧相反的变化方向,现在统一了;零附近也能够沿着同一个方向继续走。
零只剩下一种表示
原码用 0000 表示正零,用 1000 表示负零。补码中,0000 表示零,1000 已经用来表示负八。
对零取反加一:
0000 → 取反 1111 → 加一 10000 0000\xrightarrow{\text{取反}}1111 \xrightarrow{\text{加一}}10000 0000取反 1111加一 10000
保留四位,仍然是 0000。
零的相反数还是零,不会产生另一种零的编码。
四位一共有十六种状态。零只占一种,剩下十五种用于表示非零数,因此正负两侧无法拥有完全相同的数量。当前的安排能够表示:
− 8 到 + 7 -8\ \text{到}\ +7 −8 到 +7
最高位也有自己的权重
最高位仍然能够帮助我们判断正负,不过,只把它当作负号,还不足以解释补码。
例如,负三的编码是 1101。后三位 101 表示五,整个编码却表示负三,因此最高位的一应当贡献负八:
− 8 + 4 + 0 + 1 = − 3 -8+4+0+1=-3 −8+4+0+1=−3
四位补码各位的权重可以写成:
− 8 , 4 , 2 , 1 -8,\quad4,\quad2,\quad1 −8,4,2,1
负六的 1010 就是:
− 8 + 0 + 2 + 0 = − 6 -8+0+2+0=-6 −8+0+2+0=−6
正六的 0110 则是:
0 + 4 + 2 + 0 = 6 0+4+2+0=6 0+4+2+0=6
正负数都能够通过各位权重相加来解释。最高位承担负权重,其余位保持原来的正权重,而各位在加法中仍然可以使用同样的求和与进位规则。
为什么扩展位数时重复最高位?
现在可以回头解释前面的符号扩展。
先只增加一位。四位负二是 1110:
− 8 + 4 + 2 = − 2 -8+4+2=-2 −8+4+2=−2
扩展成五位的 11110 后,新最高位的权重是负十六,原来的最高位变成了权重为正八的普通位:
− 16 + 8 + 4 + 2 = − 2 -16+8+4+2=-2 −16+8+4+2=−2
其中:
− 16 + 8 = − 8 -16+8=-8 −16+8=−8
新增的一与原来的一,合起来保留了原先负八的贡献。其余位没有变化,所以整个数值保持不变。
每增加一位,都可以这样继续,因此负数能够一直在左边补一。
正数的最高位原本是零,新增的最高位也补零,两位都不贡献数值,其余部分保持不变,因此补零就能保持数值。
求相反数也有边界
四位补码中的负八有些特殊:
1000 → 取反 0111 → 加一 1000 1000\xrightarrow{\text{取反}}0111 \xrightarrow{\text{加一}}1000 1000取反 0111加一 1000
结果还是 1000。
这不是负八的相反数仍然是负八,而是正八无法用四位有符号补码表示。
如果先扩展成五位:
1000 → 11000 1000\rightarrow11000 1000→11000
再取反加一:
11000 → 取反 00111 → 加一 01000 11000\xrightarrow{\text{取反}}00111 \xrightarrow{\text{加一}}01000 11000取反 00111加一 01000
就得到正八。
因此,前面除法求绝对值时,遇到最小负数,需要扩大工作位数,或者在大小计算阶段采用无符号解释,才能容纳它的绝对值。
编码可以循环,整数仍然有边界
从负八开始,不断加一,数值逐渐增加,经过零,最后到正七。但正七再加一:
0111 + 0001 = 1000 0111+0001=1000 0111+0001=1000
结果编码表示负八。
七加一当然不等于负八。八已经超出了四位补码的表示范围,而编码仍然按照固定宽度继续变化,回到了另一端。
补码统一了正负两侧的变化方向,也把负一与零接了起来,但有限的编码仍然有边界。
这里还要区分向最高位之外进位与有符号溢出。
五加负三:
0101 + 1101 = 10010 0101+1101=10010 0101+1101=10010
产生了第五位,保留四位却仍然正确地表示二。
七加一:
0111 + 0001 = 1000 0111+0001=1000 0111+0001=1000
没有第五位,结果却超出了有符号范围。
对于补码加法,两个正数相加却得到负数,或者两个负数相加却得到非负数,说明结果越过了表示范围。只看有没有第五位,并不足以判断。
再看互补数与循环
四位计算只保留最后四位,相当于保留结果除以十六后的非负余数。相差十六整数倍的数,会留下同样的编码。
例如:
13 − ( − 3 ) = 16 13-(-3)=16 13−(−3)=16
因此,十三与负三能够对应同一串四位编码 1101。这种关系叫作模十六同余。
前面用互补数完成减法,就是利用了这件事:
5 + ( 16 − 3 ) = ( 5 − 3 ) + 16 5+(16-3)=(5-3)+16 5+(16−3)=(5−3)+16
两边相差十六,保留四位后得到相同结果。乘法中,用相差十六整数倍的数替代输入,也不会改变乘积的最后四位。
除法却不能直接照搬。例如,十四与负二对应同一串四位编码,但十四除以二得到七,负二除以二得到负一。因此,我们需要依据输入的有符号含义,选择相应的除法过程。
回头看,互补数、取反加一、负一加一回到零,以及乘法保留低位的结果,都与固定宽度下的这套关系相连。
补码保留了容易实现的二进制运算,又重新安排了编码与数值的对应关系。原码加法末尾留下的问题------编码的变化方向与数值的变化方向在正负两侧不一致------也在这里得到了回应。
这串比特放在哪里?
到这里,我们已经知道怎样用一串比特表示整数,也试过了怎样让这些编码参与计算。不过,文章的题目是"数据在内存中的存储",还有一件事没有说:这些比特到底怎样放进内存?
前面,我们一直是在"数"的层面观察这些比特。比如写下 10110010 时,我们习惯把权重更大的位写在左边,把权重更小的位写在右边。看得久了,很容易产生一种错觉:好像一个字节在内存里也真的存在某种"左边"和"右边",高位待在左边,低位待在右边。
其实,"高位"和"低位"说的是位权大小。把高权重位写在左边,只是沿用了位置记数法的书写习惯。它告诉我们怎样理解这一串比特所表示的数值,却没有告诉我们这些状态在存储介质中处于什么几何位置。
真正到了硬件内部,这些状态由什么物理结构保存、彼此是否相邻、在芯片上怎样排列,都属于更底层的实现问题。对于软件来说,这些细节通常已经被封装起来。我们能够稳定观察和操作的,是硬件和体系结构向上提供的逻辑表示,而不是某个比特在物理上位于左边还是右边。
所以,接下来讨论"怎样放进内存",我们需要换一个参照:内存地址。先把一个字节看作整体,再看看一个数占用多个字节时,各个字节怎样与地址对应起来。
一个数占用多个字节
前面为了方便,我们一直使用四位编码,把它完整地写在一行里。现在换一个稍大一些的数:
text
00010010 00110100按照二进制权重解释,它表示十进制的四千六百六十。为了方便辨认,也可以写成十六进制的 0x1234:一个十六进制数字对应四个二进制位,因此 12 对应前八位,34 对应后八位。
这串编码有十六位。如果放进一台按八位字节编址的机器,就需要占用两个字节:
| 字节内容 | 在整个数中的权重 |
|---|---|
00010010,即 0x12 |
较高 |
00110100,即 0x34 |
较低 |
这里说的高低,仍然是数值中的权重关系。0x12 所在的部分,比 0x34 所在的部分高一个字节的权重级别,因此整个数可以写成:
0 x 12 × 256 + 0 x 34 = 4660 0x12\times256+0x34=4660 0x12×256+0x34=4660
不过,这还没有涉及内存地址。我们只是确定了两个字节分别承担什么权重,并没有决定它们放在哪里。
权重的高低与地址的高低
假设为这个数安排两个相邻的内存地址:0x1000 和 0x1001。每个地址对应一个字节。
现在,需要决定哪个字节放进较低的地址。
可以先放高权重的 0x12:
| 内存地址 | 字节内容 |
|---|---|
0x1000 |
0x12 |
0x1001 |
0x34 |
也可以先放低权重的 0x34:
| 内存地址 | 字节内容 |
|---|---|
0x1000 |
0x34 |
0x1001 |
0x12 |
两种安排保存的都是这两个字节。只要读取时知道它们分别承担什么权重,都能够还原出 0x1234。
这里出现了两套高低关系:一套是数值中的权重高低,另一套是内存中的地址高低。
权重较高的字节,并不因为我们把它写在左边,就必须放在较低的地址;同样,也没有理由仅凭"高"这个字,就要求它放在较高的地址。怎样把权重顺序与地址顺序对应起来,需要另作约定。
字节序
这种多字节数值在内存中的排列约定,就是字节序。
把高权重字节放在低地址,像第一张表那样,叫作大端序;把低权重字节放在低地址,像第二张表那样,叫作小端序。
| 排列方式 | 低地址 0x1000 |
高地址 0x1001 |
|---|---|---|
| 大端序 | 高权重字节 0x12 |
低权重字节 0x34 |
| 小端序 | 低权重字节 0x34 |
高权重字节 0x12 |
这里交换的是两个字节在地址中的排列,字节内部各位所承担的权重并没有因此改变。小端序中的 0x34,仍然是 00110100,不会因为放到了低地址,就变成倒着读的一串比特。
顺便说一句,大端与小端并不是所有可能排列的穷尽。还存在混合的安排,例如先把四个字节分成两个十六位组:组与组之间,高权重组放在低地址;每组内部,却把低权重字节放在低地址。这类规则确实存在,系统源码中也能看到相应定义。[4](#4)
以 0x12345678 为例,按地址从低到高观察:
| 排列方式 | 第一个字节 | 第二个字节 | 第三个字节 | 第四个字节 |
|---|---|---|---|---|
| 大端序 | 12 |
34 |
56 |
78 |
| 小端序 | 78 |
56 |
34 |
12 |
| 上述混合排列 | 34 |
12 |
78 |
56 |
看起来有些曲折,但仍然是在规定各个字节的权重怎样与地址对应。这里只作补充,后面主要讨论大端与小端。
于是,前面一直写在一行里的数值编码,与内存中的存储排列,就有了明确的联系:编码告诉我们各位怎样组成一个数;字节序告诉我们,当这个数占用多个字节时,各个字节的权重怎样与内存地址对应起来。
从鸡蛋的哪一头敲开?
"大端"和"小端"这两个名字,听起来像是严肃的硬件术语,来历却与鸡蛋有关。
在《格列佛游记》中,人们为了应该从鸡蛋的大头还是小头敲开,分成不同阵营,甚至发生冲突。1980 年,丹尼·科恩在《论圣战与和平的呼吁》中借用了这个故事,把计算机领域关于数据排列顺序的争论,比作两派之间的争执。"大端"与"小端"也因此成了这场讨论中的名字。[5](#5)
当然,计算机工程师争论的不是早餐怎么吃。单独使用一台机器时,两种排列都能正常工作;但不同机器开始交换数据,原本各自内部的约定就会碰到一起。
假设一台机器把 0x1234 按大端序保存,依次取出两个字节,发给另一台机器:
text
12 34如果接收方按小端序把这两个字节直接组成整数,得到的就是 0x3412。两个字节都没有丢,传输也没有出错,数值却变了。
问题出在双方对权重的理解不同。这也是字节序从机器内部的安排,变成通信与数据交换问题的原因。
不同机器的选择
这些选择并不是先经过一次统一讨论,再由所有厂商共同采用的。不同的计算机体系结构各自建立规则,后续机器又需要考虑与已有程序和数据的兼容,因此形成了不同的延续路线。
例如,IBM 的 System/360、System/370,以及后来的 z/Architecture,采用大端序。摩托罗拉的 68000 也是历史上典型的大端机器。[6](#6)[5](#5)
小端序则是我们在普通个人电脑上更容易接触到的安排。常见的 Intel、AMD 的 x86 与 x86-64 电脑采用小端序。对于使用这类处理器的电脑,按地址从低到高观察 0x12345678,会看到:
text
78 56 34 12这里的选择来自目标体系结构,并不是因为我们使用了 Windows、某个编译器,或者某款开发软件。[7](#7)
不过,也不能简单地给每个厂商贴一个永久标签。某些处理器能够支持不同的字节序。例如,Arm 的 Cortex-A 处理器支持大端和小端的数据访问,具体采用哪一种,还要结合系统配置来看。[8](#8)
因此,比起问"某家公司喜欢哪种",更准确的问题是:这套体系结构、这个运行环境,对我们正在观察的数据采用了什么排列规则?
轮到自己的电脑了
知道这些背景之后,我们就可以回到自己的电脑。
如果它使用常见的 x86 或 x86-64 处理器,我们已经能够预期它采用小端序。不过,既然前面一直在讨论"软件能够观察到什么",现在也可以实际观察一次:把一个容易辨认的整数放进内存,再按照地址从低到高,逐字节查看它的内容。
我们要验证的,就是刚才那张表是否真的出现在眼前。
在自己的电脑上看一看
前面说了不同机器对字节排列的约定,现在可以拿一个具体的数,看看它在我们能够使用的环境中究竟怎样存放。
这次使用的代码稍长一些:
c
#ifdef _WIN32
#include <windows.h>
#endif

#include <stdint.h>
#include <stdio.h>

int main(void)
{
#ifdef _WIN32
    SetConsoleOutputCP(CP_UTF8);
#endif

    /* 编译期:查看编译器提供的目标信息。 */
#if defined(__BYTE_ORDER__) && \
    defined(__ORDER_LITTLE_ENDIAN__) && \
    defined(__ORDER_BIG_ENDIAN__)

    #if __BYTE_ORDER__ == __ORDER_LITTLE_ENDIAN__
        printf("编译期判断:小端\n");
    #elif __BYTE_ORDER__ == __ORDER_BIG_ENDIAN__
        printf("编译期判断:大端\n");
    #else
        printf("编译期判断:其他字节序\n");
    #endif

#elif defined(_MSC_VER) && \
      (defined(_M_IX86) || defined(_M_X64) || \
       defined(_M_ARM64) || defined(_M_ARM64EC))

    printf("编译期判断:小端(依据 Windows 目标架构)\n");

#else
    printf("编译期判断:没有可用的判断信息\n");
#endif

    /* 运行期:实际读取这个整数的各个字节。 */
    uint32_t value = 0x12345678;
    const unsigned char *p = (const unsigned char *)&value;

    printf("从低地址到高地址:\n");

    for (size_t i = 0; i < sizeof value; ++i) {
        printf("%p : %02X\n",
               (const void *)(p + i),
               (unsigned int)p[i]);
    }

    if (p[0] == 0x78 && p[1] == 0x56 &&
        p[2] == 0x34 && p[3] == 0x12) {
        printf("实际观察:小端\n");
    } else if (p[0] == 0x12 && p[1] == 0x34 &&
               p[2] == 0x56 && p[3] == 0x78) {
        printf("实际观察:大端\n");
    } else {
        printf("实际观察:其他字节排列\n");
    }

    return 0;
}
代码长了,观察的东西并没有变
先看真正用于观察的部分:
c
uint32_t value = 0x12345678;
const unsigned char *p = (const unsigned char *)&value;
uint32_t 是一个恰好占用 32 位的无符号整数类型。在这次测试的环境中,一个字节是 8 位,因此这个数占用四个字节。选用 0x12345678,是因为它的四个字节分别是 12、34、56、78,彼此不同,排列发生变化时很容易看出来。
如果直接读取 value,得到的仍然是完整的整数。我们现在想看的却是组成它的各个字节,于是把它的地址转换为 unsigned char 指针。
这一步没有移动数据,也没有改变数据的排列。整数仍然放在那里,只是接下来通过 p,可以逐字节读取它的对象表示。
随后循环里的 p + i 指向第 i 个字节,p[i] 读取这个字节的内容。随着 i 增大,我们便沿着地址递增的方向,把四个字节依次打印出来。%p 用来显示地址,%02X 用两位十六进制显示字节内容。
最后的几个条件判断,只是根据读到的排列,帮我们打印出"大端"或"小端"。
至于前面的条件编译,则是在读取之前,先看看编译器提供了什么目标信息。GCC 和 Clang 可以通过 __BYTE_ORDER__ 等宏给出目标字节序;MSVC 的这一分支依据已知的 Windows 目标架构作出判断。它们属于编译器提供的信息,所以我们仍然保留后面的实际读取,让两者相互对照。
Windows 下的 SetConsoleOutputCP(CP_UTF8) 用于显示中文,与字节序测试本身无关。在 VS 中运行这份代码时,还需要给编译选项加上 /utf-8,使字符串编码与控制台的显示设置一致。具体操作是:在解决方案资源管理器中,右键项目名称,选择"属性",再选择"C/C++"中的"命令行",在"其他选项"里加上 /utf-8,点击"确定"。
回头看旧文,当时的方法其实更直接:定义一个整数,在程序执行完这条赋值语句之后暂停,再通过 VS 的内存窗口观察它。
两种方法观察的是同一件事。旧方法由调试器把内存内容显示出来;这次则由程序自己逐字节读取,再打印出来。代码看起来多了不少,主要是增加了目标信息、输出和结果判断,核心仍然只是:放入一个整数,看看它的各个字节分别落在哪些地址上。
因此,使用 VS 的读者仍然可以在 value 初始化之后暂停程序,在内存窗口中输入 &value,按一个字节为单位查看。程序输出则提供了另一种观察方式,也方便我们把同一份代码带到其他环境中。
换几个环境再试一次
只在自己的电脑上看到小端,还不足以亲眼比较两种排列。于是这次除了 Windows 下的 VS,还在 Ubuntu 中分别使用 GCC 和 Clang 编译同一份代码。
不过,手头的这两台电脑都采用小端环境。为了看看大端下的结果,我们再借助 QEMU,分别运行面向大端 MIPS 和小端 MIPS 编译的程序。
这里用的是 QEMU 的用户模式:运行目标架构的程序,不必先安装一整套虚拟机系统。交叉编译器负责生成 MIPS 程序,QEMU 负责让这些程序在当前电脑上运行。电脑本身并没有因此变成大端,观察到的是模拟目标环境中的字节排列。
Ubuntu 中需要准备的工具是:
bash
sudo apt install --no-install-recommends \
  qemu-user \
  gcc-mips-linux-gnu \
  gcc-mipsel-linux-gnu \
  libc6-dev-mips-cross \
  libc6-dev-mipsel-cross
这次源码放在 src/main.c,编译命令在同级的 build 目录中执行。
本机 GCC:
bash
gcc ../src/main.c -o endian-gcc
./endian-gcc
本机 Clang:
bash
clang ../src/main.c -o endian-clang
./endian-clang
大端 MIPS:
bash
mips-linux-gnu-gcc -static ../src/main.c -o endian-mips
qemu-mips ./endian-mips
小端 MIPS:
bash
mipsel-linux-gnu-gcc -static ../src/main.c -o endian-mipsel
qemu-mipsel ./endian-mipsel
后两组命令中的 -static,用于把运行所需的库链接进程序,省去另外指定目标动态库位置的步骤。
实际读到了什么
先看 Ubuntu 本机 GCC 的一次输出:
text
编译期判断:小端
从低地址到高地址:
0x7fffbcbc2434 : 78
0x7fffbcbc2435 : 56
0x7fffbcbc2436 : 34
0x7fffbcbc2437 : 12
实际观察:小端
地址每次增加一,内容依次是 78、56、34、12。原数中权重最低的字节 78 放在最低地址,权重最高的字节 12 放在最高地址,符合小端排列。
换到模拟的大端 MIPS 环境,输出变成:
text
编译期判断:大端
从低地址到高地址:
0x2b2ab1f8 : 12
0x2b2ab1f9 : 34
0x2b2ab1fa : 56
0x2b2ab1fb : 78
实际观察:大端
这次仍然沿着地址递增的方向读取,但先读到的是权重最高的字节 12,最后才是 78,符合大端排列。
模拟的小端 MIPS 环境则得到:
text
编译期判断:小端
从低地址到高地址:
0x2b2ab1f8 : 78
0x2b2ab1f9 : 56
0x2b2ab1fa : 34
0x2b2ab1fb : 12
实际观察:小端
把这次测试的结果放在一起:
| 运行环境 | 编译器 | 从低地址到高地址的字节内容 | 观察结果 |
|---|---|---|---|
| Windows x64 | VS 中的 MSVC | 78 56 34 12 |
小端 |
| Ubuntu x86-64 | GCC 13.3.0 | 78 56 34 12 |
小端 |
| Ubuntu x86-64 | Clang 21.1.8 | 78 56 34 12 |
小端 |
| QEMU 模拟的大端 MIPS | MIPS 交叉 GCC | 12 34 56 78 |
大端 |
| QEMU 模拟的小端 MIPS | MIPSel 交叉 GCC | 78 56 34 12 |
小端 |
具体地址会随运行环境、编译结果和每次运行而变化,我们关心的是沿地址递增方向读到的字节顺序。
这次本机换了编译器,甚至换了操作系统,看到的仍然都是小端;而两种 MIPS 目标给出了相反的排列。这也提醒我们,不能只根据"使用了什么编译器"判断字节序,还要看它生成的程序面向什么目标环境。
无论采用哪一种排列,程序读取完整的 value 时,得到的都还是 0x12345678。差别出现在我们把这个整数拆成字节观察的时候:数值权重与地址高低,在两种约定下形成了不同的对应关系。
从存入变量到打印结果
前面观察了整数的字节排列,现在再通过一组小实验,看看类型转换怎样影响我们最终读到的数值。每个实验各自是一份完整程序,分别运行即可。
实验一:同样存入 −1,为什么输出不同?
c
#include <stdio.h>

int main(void)
{
    char a = -1;
    signed char b = -1;
    unsigned char c = -1;

    printf("a=%d,b=%d,c=%d\n", a, b, c);

    return 0;
}
这次在 Ubuntu 中运行,得到:
text
a=-1,b=-1,c=255先看右边的 -1。它是 int 类型的表达式:整数常量 1 的类型是 int,对它取负,结果仍然是 int。随后,初始化会把这个值转换成左边变量的类型。
在当前环境中,普通 char 有符号,因此 a 和 b 都能容纳 −1,存入后数值保持不变。不过,普通 char 是否有符号由实现决定,不能认为它在所有环境下都与 signed char 表现相同。
c 是八位的无符号字符型,能够表示 0~255。把 −1 转成这个类型,可以沿用前面的循环思路:共有 256 个状态,从零往回走一步,就落到 255。因此,c 保存的数值是:
256 − 1 = 255
再看打印过程。传给 printf 时,这三个字符型参数会经历整型提升。在当前环境中,int 能容纳它们各自类型的全部取值,所以都提升为 int,同时保持原来的数值。
于是,a、b 提升后仍然是 −1,c 提升后仍然是 255。三个 %d 接收到的都是 int,便得到上面的输出。
如果从补码表示来看,a、b 的扩宽对应符号扩展,高位补 1;c 的扩宽则高位补 0。它们原先虽然都是八个 1,但源类型赋予了这串比特不同的数值含义,扩宽时也就采用了不同的方式。
实验二:把 −128 转成无符号整数
接下来运行第二份程序:
c
#include <stdio.h>

int main(void)
{
    char a = -128;

    printf("%u\n", (unsigned int)a);

    return 0;
}
当前环境中,普通 char 有符号且占八位,unsigned int 占三十二位。实际输出是:
text
4294967168初始化的过程与刚才类似。-128 是 int 类型的表达式,而当前有符号 char 的范围是 −128~127,能够容纳它。因此,a 保存的数值就是 −128。
随后,(unsigned int)a 明确将这个值转换成无符号整数。%u 对应 unsigned int,负责把转换后的值按无符号十进制输出。
这里继续用互补数的思路就很方便。三十二位无符号整数共有 2³² 个状态,−128 转换后,落在这个循环中距离归零还差 128 的位置:
2³² − 128 = 4294967168
这便是实际打印出来的数值。
从比特层面看,八位补码中的 −128 是 10000000。在当前补码环境中,可以把转换后的位模式理解为高位补上符号位,再按三十二位无符号规则解释。但既然已经知道互补关系,就不必展开整串比特逐位计算。
旧代码在这里直接使用了:
c
printf("%u\n", a);这与现在的写法有一个重要区别:直接传入 a,它会先提升为 int,数值仍然是 −128;但 %u 要求的参数类型是 unsigned int。格式说明符不会替参数执行类型转换,这种不匹配属于未定义行为,不能依赖当时观察到的输出。
补上 (unsigned int) 后,过程才明确:先完成有符号数到无符号数的转换,再打印结果。
先把这两个实验放在一起,也就能看清转换发生在哪一步。实验一中,c 在初始化时就已经变成了 255,之后提升为 int,保持这个值;实验二中,a 先保存 −128,再通过显式转换得到 2³² − 128。最后的 %d 和 %u,负责输出已经准备好的参数。
实验三:当数值超出 char 的范围
c
#include <stdio.h>

int main(void) {
    char a = 128;
    printf("%u\n", (unsigned int)a);
    return 0;
}
在当前环境中,输出为:
text
4294967168前一个实验把 -128 存入了 char,这次则换成了 128。两个数显然不同,为什么最后得到的结果却一样?
我们目前使用的 char 是有符号的,占八个比特,能够表示的范围是 -128 到 127。128 本身是一个 int 类型的整数常量,放在 int 中没有问题,但赋给这个 char 时,已经超出了它能表示的范围。
在这次测试所用的实现中,转换后保留了低八位:
text
128:             00000000 00000000 00000000 10000000
存入 char 后:                              10000000
而八位补码中的 10000000,表示的就是 -128。于是,后面的过程便和实验二接上了:把 a 转换为 unsigned int,得到:
2 32 − 128 = 4294967168 2^{32}-128=4294967168 232−128=4294967168
如果联系之前的补码循环,这件事也很好理解。八位补码的 127 是 01111111,再往前增加一个刻度,就到了 10000000,按有符号补码解释,它是 -128。
不过,这里需要分清两个过程:127 + 1 在 int 中正常得到 128;这次发生变化的是随后将 128 存入 char 的转换。在我们采用的 C17 语境下,超出有符号目标类型范围的转换结果由实现规定,因此,这里展示的是当前环境的实际结果。
实验四:沿着补码的圆环走一圈
c
#include <stdio.h>
#include <string.h>

int main(void) {
    char a[1000];
    int i;

    for (i = 0; i < 1000; i++) {
        a[i] = -1 - i;
    }

    printf("%zu\n", strlen(a));
    return 0;
}
输出为:
text
255这里把原来的 %zd 改成了 %zu,因为 strlen 返回的是 size_t,应使用对应的无符号格式。
先看看循环往数组里放了什么。i 从 0 开始,所以依次计算的是 -1、-2、-3......这些表达式都在 int 中计算,然后再将结果转换为 char。
前面的数能够正常放进去,直到 a[127] 存入 -128。下一次,表达式得到 -129,超出了当前 char 的范围;按照这次实现的转换方式,存进去的值变成了 127。之后继续减一,便依次经过 126、125......最终走到 0。
数组下标 i |
表达式 -1 - i 的结果 |
存入 char 后的值 |
|---|---|---|
| 0 | -1 | -1 |
| 127 | -128 | -128 |
| 128 | -129 | 127 |
| 254 | -255 | 1 |
| 255 | -256 | 0 |
这正好可以放到我们刚才画的表盘上观察:
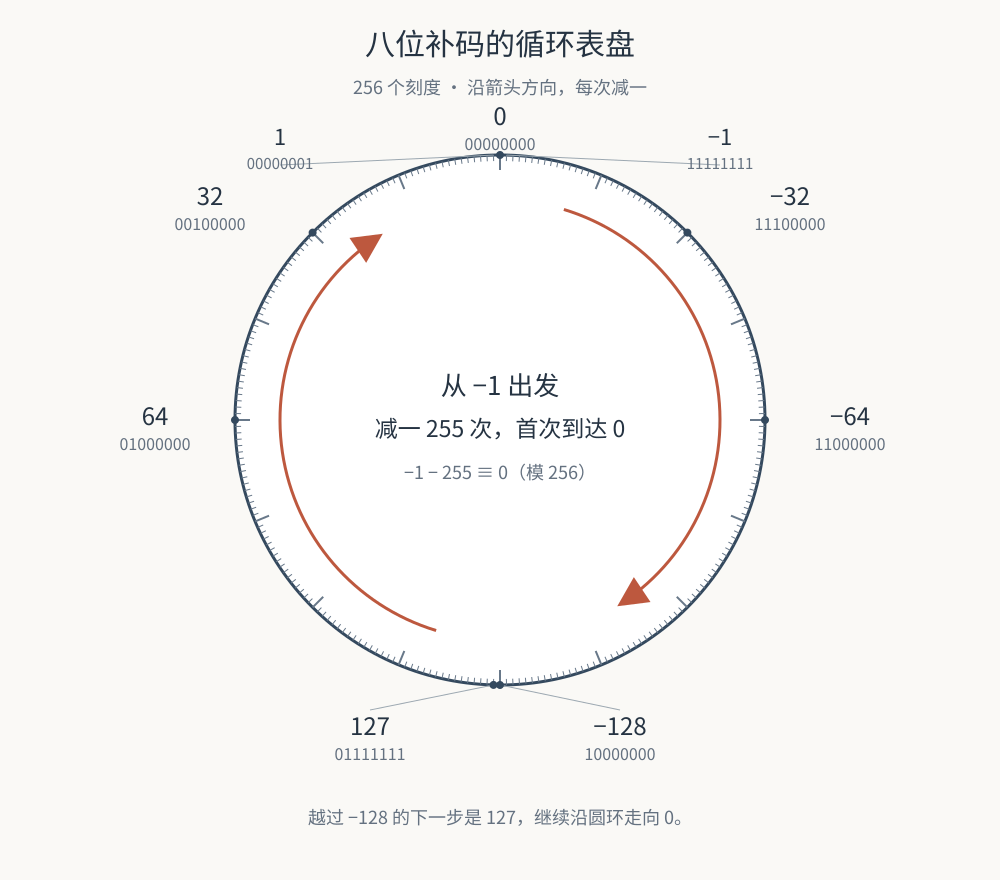
从 -1 出发,沿着每次减一的方向走,经过 -128 后,下一步就是 127;继续走过正数部分,经过 1,最终到达 0。
也可以直接用互补数的思路找出这个位置。八个比特共有 256 种状态,在当前转换方式下,表达式的结果只要是 256 的整数倍,存入后的八个比特就全是零。第一次出现这种情况时:
− 1 − i = − 256 -1-i=-256 −1−i=−256
所以:
i = 255 i=255 i=255
因此,数组中第一次出现零的位置是 a[255]。
strlen 从数组开头逐个寻找 '\0',也就是值为零的字符。在它之前,a[0] 到 a[254] 一共有 255 个非零字符,于是返回 255。这里找到的是 '\0',不是表示数字零的字符 '0'。
循环本身仍然执行了 1000 次,结束时 i 是 1000;255 是第一个零的下标,也是 strlen 得到的长度。
实验五:始终无法越过的上界
c
#include <stdio.h>

int main(void) {
    unsigned char i;

    for (i = 0; i <= 255; i++) {
        printf("hello world\n");
    }

    return 0;
}在当前环境中,unsigned char 的范围是 0~255,因此 i <= 255 始终成立。
当 i 增加到 255 后,再加一,存回 unsigned char 的值便回到 0。之后又从 0 走到 255,如此循环,条件始终无法变成假,程序便不断打印。
它与前面的补码表盘很相似,只是这里按无符号规则解释,刻度依次是 0~255,越过 255 就回到 0。
实验六:从零往回走一步
c
#include <stdio.h>

int main(void) {
    unsigned int i;

    for (i = 9; i >= 0; i--) {
        printf("%u\n", i);
    }

    return 0;
}
这次从 9 开始,每次减一,看起来似乎打印到 0 就该结束了。但 i 是无符号整数,能够等于零,却不能小于零,因此 i >= 0 始终成立。
打印完 0 后,再减一,就沿着无符号数的循环回到了最大值。在当前三十二位 unsigned int 的环境中,这个值是:
2 32 − 1 = 4294967295 2^{32}-1=4294967295 232−1=4294967295
随后,程序从 4294967295 一直递减到 0,再回到最大值,继续循环。
这两个实验都不用实际运行:一个条件要求无符号数超过它的最大值,另一个要求无符号数变成负数;循环变量都无法到达让条件失效的位置。
实验七:从整数中间开始读取字节
前面的实验主要观察类型转换,这次再回到字节序:如果从一个整数中间开始,取出连续的四个字节,会得到什么数?
c
#include <stdint.h>
#include <stdio.h>
#include <string.h>
#include <inttypes.h>

int main(void) {
    uint32_t a[4] = {1, 2, 3, 4};
    const unsigned char* p = (const unsigned char*)a;
    uint32_t value;

    memcpy(&value, p + 1, sizeof value);

    printf("%" PRIx32 ",%" PRIx32 "\n", a[3], value);
    return 0;
}
这次在 Ubuntu 中运行,得到:
text
4,2000000先说明打印语句里的 PRIx32。它是 <inttypes.h> 提供的宏,用于选择适合 uint32_t 的小写十六进制输出格式。因为 uint32_t 在不同实现中对应的底层整数类型可能不同,使用这个宏就不用自己猜应该写 %x 还是其他格式。
这里的写法看起来有些特殊:
c
"%" PRIx32 ",%" PRIx32 "\n"宏展开后,相邻的字符串字面量会自动拼接。例如,如果 PRIx32 展开为 "x",整段就相当于:
c
"%x,%x\n"再看读取过程。数组中的每个元素都是三十二位无符号整数,在当前八位一个字节的环境中,每个元素占四个字节。数组元素连续存放,而这台机器采用小端排列,所以从低地址到高地址,内容依次是:
text
01 00 00 00 | 02 00 00 00 | 03 00 00 00 | 04 00 00 00p 指向数组开头。我们把它转换成 unsigned char*,于是 p + 1 就向后移动一个字节,跳过最前面的 01。
随后:
c
memcpy(&value, p + 1, sizeof value);从这个位置开始,复制四个字节到 value 中。取出的内容是:
text
00 00 00 02它横跨了两个数组元素:前三个字节来自 a[0],最后一个字节来自 a[1]。
复制完成后,按当前机器的小端规则解释 value,最低地址的 00 权重最低,最高地址的 02 权重最高,因此得到:
0x02000000 = 2 × 256 3 = 33554432 \texttt{0x02000000}=2\times 256^3=33554432 0x02000000=2×2563=33554432
打印语句采用十六进制,并且没有要求保留前导零,所以显示为 2000000,也就是一个 2 后面六个零。另一个输出值直接来自 a[3],因此完整结果就是 4,2000000。
旧代码试图把偏移后的地址直接转换为 int*,再解引用读取。这里改用 memcpy:先按字节复制到一个真正的整数对象中,再读取它的值。这样既保留了观察字节排列的目的,也避开了地址转成 int 可能造成的截断,以及偏移一个字节后直接读取整数的对齐问题。
同样的代码放到大端环境中,数组开头的字节排列会变成:
text
00 00 00 01 | 00 00 00 02偏移一个字节后取出的四个字节是 00 00 01 00,按大端规则解释得到 0x00000100,于是输出会是:
text
4,100数组里的数仍然是 1、2、3、4,但从中间截取字节再组成整数时,字节序的差别就显露出来了。
当数值不再是整数
到这里,我们已经从一串比特怎样表示整数,走到了这些整数怎样参与运算、怎样放进内存,也通过几个实验,看到了类型转换和字节排列带来的变化。
不过,前面的例子始终都是整数。如果现在要存入的数是 3.5,这些比特又该怎样安排?
先别急着寻找一种全新的编码。回想位置记数法,十进制的小数点右边,位权依次是十分之一、百分之一、千分之一;二进制也一样,只不过换成了二分之一、四分之一、八分之一。因此:
( 11.1 ) 2 = 1 × 2 1 + 1 × 2 0 + 1 × 2 − 1 = 3.5 (11.1)_2 =1\times 2^1+1\times 2^0+1\times 2^{-1} =3.5 (11.1)2=1×21+1×20+1×2−1=3.5
所以,二进制本身并没有不能表示小数的问题。我们只需要继续向右安排更小的位权。
但落实到存储时,还缺少一个约定:小数点放在哪里?
内存中保存的仍然只有比特,并不会额外出现一个小数点。就像之前需要约定怎样解释符号位,现在也需要约定哪些位表示整数部分,哪些位表示小数部分。
例如,同样是 00111000,按之前的无符号整数规则解释,它是 56;如果约定最低四位用于小数部分,就可以把它读成:
( 0011.1000 ) 2 = 3.5 (0011.1000)_2=3.5 (0011.1000)2=3.5
比特没有变化,改变的是我们赋予它们的位权。小数点也不必真的存进去,只要读写双方遵守同一个位置约定,就能得到一致的数值。这便是一种很直接的办法:把小数点的位置固定下来,也就是定点表示。
这种办法并没有什么不妥。如果需要处理的数值范围比较明确,固定的位置反而简单。只是,在总位数不变时,整数部分和小数部分要分享同一份空间:给小数部分多分一些位,就能区分更细的变化,却会缩小能够表示的范围;给整数部分多分一些位,范围扩大了,小数部分又不够细了。
如果我们既想处理很大的数,又想处理很小的数,一个固定的小数点位置就开始显得局促。
十进制中,我们其实早已遇到过类似的问题。面对很长的一串数字,可以改用科学记数法:
3500000 = 3.5 × 10 6 3500000=3.5\times 10^6 3500000=3.5×10⁶
0.0000035 = 3.5 × 10 − 6 0.0000035=3.5\times 10^{-6} 0.0000035=3.5×10⁻⁶
这两种写法保留了同样的有效数字,只是通过不同的指数,把它们放到了不同的数量级上。我们不再要求每个数都使用同一个固定的小数点位置,而是另外说明:这些数字应该按多大的尺度去理解。
二进制也可以采用类似的思路。一部分比特保存有效数字,另一部分比特记录尺度,让同样有限的存储空间能够覆盖更宽的数值范围。
不过,范围扩大并不意味着所有小数都能精确保存。总共只有那么多比特,能够区分的状态依然有限;当表示范围和数值尺度发生变化时,相邻两个可表示数之间的距离,也会随之变化。
接下来,我们就从这种"把有效数字与尺度分开保存"的思路出发,看看浮点数究竟怎样编码,以及这种安排给计算带来了什么。
浮点数的表示
把有效数字和指数分开
前面已经想到,可以像科学记数法那样,把一个数的有效数字和尺度分别保存。现在就拿刚才的 3.5,看看这件事具体怎样完成。
它的二进制形式是:
3.5 = ( 11.1 ) 2 3.5=(11.1)_2 3.5=(11.1)2
把小数点向左移动一位,就可以写成:
( 11.1 ) 2 = ( 1.11 ) 2 × 2 1 (11.1)_2=(1.11)_2\times 2^1 (11.1)2=(1.11)2×21
这里的 1.11 保存了有效数字,指数 1 则说明这些数字应该放在哪个数量级上。二者配合,仍然表示原来的 3.5。
如果换成 0.875,也可以做同样的事:
0.875 = ( 0.111 ) 2 = ( 1.11 ) 2 × 2 − 1 0.875=(0.111)_2=(1.11)_2\times 2^{-1} 0.875=(0.111)2=(1.11)2×2−1
两个数都使用了 1.11,但指数不同,所以最终的数值不同。之前固定小数点时,每个位置的位权是固定的;现在则由指数决定整组有效数字的尺度。所谓"浮点",便与这种小数点位置可以随尺度变化的表示方式有关。
当然,存进内存后,小数点仍然不会真的移动。机器保存的是编码,我们依据其中的有效数字和指数,理解它表示的数值。
同一个数,先约定一种写法
同一个数,可以写成很多种形式。例如:
( 11.1 ) 2 = ( 1.11 ) 2 × 2 1 = ( 0.111 ) 2 × 2 3 (11.1)_2 =(1.11)_2\times 2^1 =(0.111)_2\times 2^3 (11.1)2=(1.11)2×21=(0.111)2×23
这些写法在数学上都成立,但如果随意选择,编码和计算就会多出不少麻烦。我们可以先约定:对于非零数,把小数点放在第一个非零数字之后。
十进制中,第一个非零数字可能是 1~9;二进制中,它只能是 1。因此,整理后的形式总是:
- 若干二进制数字 × 2 e 1.\text{若干二进制数字}\times 2^e 1.若干二进制数字×2e
这称为规格化表示。前面两个例子中的 1.11 × 2¹ 和 1.11 × 2⁻¹,就已经符合这个约定。
这样做还有一个直接的好处:既然开头一定是 1,就不必每次都占用一个比特去保存它。只保存小数点后面的部分,读取时再把这个 1 补回来,就能多利用一位精度。
不过,这个办法依赖"开头一定是 1"。零,以及某些非常小的数,需要另外安排,我们稍后再看。
三十二个比特怎样分配
有了这个思路,接下来就要确定具体格式:符号用几位,指数用几位,有效数字又用几位?
这里采用常见的 IEEE 754 二进制三十二位格式,也叫 binary32。在我们目前使用的环境中,float 采用这种格式。它把三十二个比特分成三部分:一位符号、八位指数、二十三位小数。
下面把每个比特单独画出来,并放入 3.5 的编码。先看字段怎样划分,具体内容接下来逐项解释:
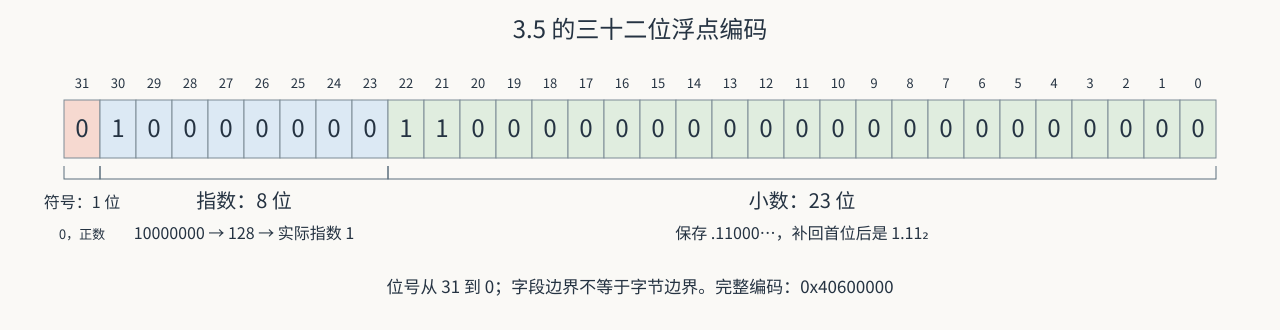
这里从第 31 位画到第 0 位,展示的是逻辑编码。最终拆成四个字节后,放到内存的哪些地址上,仍然要遵守前面讲过的字节序。
先看符号字段。0 表示正,1 表示负。它与后面的有效数字、指数共同决定数值,并不是把整个浮点编码按整数补码解释。
再看有效数字。以 3.5 为例:
3.5 = ( 1.11 ) 2 × 2 1 3.5=(1.11)_2\times 2^1 3.5=(1.11)2×21
开头的 1 按约定省略,小数字段保存的是 11,后面补零,凑足二十三位:
text
11000000000000000000000所以,虽然这个字段只占二十三位,规格化数的有效数字实际包含二十四位:一个没有显式存储的首位 1,加上二十三个小数位。
指数为什么不直接存进去
剩下的是指数。它既可能为正,也可能为负,但这八位没有直接采用之前的补码方式,而是先给实际指数加上 127,再保存得到的非负整数。这就是偏置编码。
实际指数记为 e,保存的字段值记为 E,那么:
E = e + 127 E=e+127 E=e+127
读取时再减回来:
e = E − 127 e=E-127 e=E−127
例如:
实际指数 e |
保存的字段值 E |
八位编码 |
|---|---|---|
| -1 | 126 | 01111110 |
| 0 | 127 | 01111111 |
| 1 | 128 | 10000000 |
这样,正负指数就被放进了同一段非负编码中,而且大小顺序没有改变:实际指数越大,字段值也越大。
如果直接用补码,八位的 -1 是 11111111,0 却是 00000000。把这些编码当作非负整数比较时,顺序就与实际指数不同了。加上偏置后,-1、0、1 对应 126、127、128,顺序连续,便于比较和处理。
不过,这八位的全部状态并没有都用于普通指数。字段值 0 和 255 被留作特殊用途,普通规格化数使用 1~254,对应实际指数 -126~127。这两个端点怎样使用,后面再展开。
把 3.5 真正编码出来
现在三个字段都可以确定了。
3.5 是正数,所以符号字段为 0。规格化之后,实际指数是 1,加上偏置得到 128,编码为 10000000。有效数字是 1.11,省略首位 1 后,保存 11000000000000000000000。
把它们接在一起:
text
0 | 10000000 | 11000000000000000000000竖线只是为了看清字段边界,并不占用存储空间。将这三十二个比特每四位分一组:
text
0100 0000 0110 0000 0000 0000 0000 0000对应的十六进制编码就是:
text
0x40600000我们也可以反过来检查。
符号字段是 0,指数字段值是 128,所以实际指数为:
128 − 127 = 1 128-127=1 128−127=1
小数字段以 11 开头,其余为零。补回首位 1,有效数字为:
( 1.11 ) 2 = 1 + 1 2 + 1 4 = 1.75 (1.11)_2=1+\frac12+\frac14=1.75 (1.11)2=1+21+41=1.75
最后乘上指数对应的尺度:
1.75 × 2 1 = 3.5 1.75\times 2^1=3.5 1.75×21=3.5
这就还原出了原来的数。
如果要表示 -3.5,只需要把符号字段改成 1,其他两个字段保持不变,对应编码是 0xC0600000。这里改变正负的方法,与前面整数补码的取反加一不同。
对普通规格化数,整个还原过程可以写成:
x = ( − 1 ) s × ( 1. f ) 2 × 2 E − 127 x=(-1)^s\times(1.f)_2\times 2^{E-127} x=(−1)s×(1.f)2×2E−127
其中,s 是符号字段,f 是二十三位小数字段,E 是指数字段的非负整数值。
装不下的数字,怎么办
3.5 恰好只需要很少的二进制位就能写完。但换成 0.1,事情就不一样了:
0.1 = ( 0.00011001100110011 ... ) 2 0.1=(0.00011001100110011\ldots)_2 0.1=(0.00011001100110011...)2
后面的 0011 会不断重复。十进制里只有一位小数的数,换成二进制后,却变成了无限循环小数。
小数字段只有二十三位,不可能把这串数字全部保存下来。机器只能按照舍入规则,选一个能够保存、又接近原数的值。
这与我们把三分之一写成 0.3333 很相似。并不是三分之一发生了变化,而是我们只保留了有限位数字。只是这里使用的是二进制,而且位数由格式决定。
因此,误差可能在数值刚存入变量时就已经出现。之后的运算如果产生了装不下的结果,还需要再次舍入。
这并不意味着每个浮点数都有误差:刚才的 3.5 就可以精确保存。但面对一般的数值和计算,有限精度带来的误差无法普遍避免。
实际使用时,我们通常不要求每一步都绝对精确,而是要求结果与所需的真实值之间,偏差处于允许范围内。测量本身也有精度限制,计算需要保留到哪一位,应当由具体问题决定。我们需要关心的是误差有多大、经过计算后有没有被放大,以及最终是否仍然满足要求。
数越大,能分清的差别也会变大
还有一个与定点表示不同的地方:浮点数能够区分多细的变化,会随着数值大小改变。
可以先拿一个简化的十进制例子理解。假设我们只能保留三位有效数字:
text
1.00、1.01、1.02......在这个尺度下,可以分清 0.01 的变化。但乘上 1000 后,同样的有效数字变成:
text
1000、1010、1020......这时只能分清 10 的变化。有效数字的位数没变,整个尺度扩大了,每个刻度之间的距离也跟着扩大。
二进制浮点数也是如此。三十二位浮点格式的小数字段只有二十三位,在 1 附近,最后一位的权重是 2⁻²³。所以,1 后面紧接着能够表示的数是:
1 + 2 − 23 1+2^{-23} 1+2−23
但如果把尺度扩大到 2²⁴,也就是 16777216,同一个位置的实际权重就变成了:
2 − 23 × 2 24 = 2 2^{-23}\times 2^{24}=2 2−23×224=2
也就是说,此时能够保存的最低位,代表的已经是 2,而不是 1。
看看这两个数的规格化形式:
text
16777216:1.00000000000000000000000 × 2²⁴
16777218:1.00000000000000000000001 × 2²⁴
它们的小数字段只在最后一位不同,数值却已经相差 2。
中间的 16777217 等于 2²⁴ + 1。要保留增加的这个 1,需要用到小数点后第二十四位,因为那个位置的实际权重才是:
2 − 24 × 2 24 = 1 2^{-24}\times 2^{24}=1 2−24×224=1
但小数字段只有二十三位,没有位置保存它。因此,从这里向上,能够表示的数依次是:
text
16777216、16777218、16777220......16777217 落在两个刻度之间,只能舍入到其中一个。在常用的"舍入到最近值,中间取偶"规则下,它会被舍入为 16777216。
所以,一个很大的浮点数再加上很小的数,保存下来的结果可能完全没有变化。小数并不是没有参与计算,而是它带来的变化,小于当前尺度能够保留下来的差别。
这也说明,浮点数的"精度"不能只理解成"小数点后有多少位"。同一种格式,在不同数量级上,能够分清的具体差别并不相同。
指数已经最小了,还能继续变小吗
普通规格化数使用的最小指数字段值是 1,对应实际指数:
1 − 127 = − 126 1-127=-126 1−127=−126
有效数字最小是 1.0,所以最小正规格化数为:
1.0 × 2 − 126 = 2 − 126 1.0\times 2^{-126}=2^{-126} 1.0×2−126=2−126
如果还要表示更小的数,指数已经没有继续降低的空间了。只要有效数字仍然以 1 开头,就不可能越过这个下限。
前面留下的全零指数字段,在这里派上了用场:格式规定,当指数字段全零时,有效数字开头不再补 1,而是补 0,尺度仍然固定为 2⁻¹²⁶。
注意,这是一条特殊规则,不能再用 0 − 127 算出指数 -127。
可以先暂时把小数字段缩成三位,看看这样做有什么效果:
| 类别 | 有效数字和尺度 | 数值 |
|---|---|---|
| 最小正规格化数 | 1.000₂ × 2⁻¹²⁶ |
1 × 2⁻¹²⁶ |
| 比它小一个刻度 | 0.111₂ × 2⁻¹²⁶ |
7/8 × 2⁻¹²⁶ |
| 再小一个刻度 | 0.110₂ × 2⁻¹²⁶ |
6/8 × 2⁻¹²⁶ |
| ...... | ...... | ...... |
| 最小正非零数 | 0.001₂ × 2⁻¹²⁶ |
1/8 × 2⁻¹²⁶ |
| 零 | 0.000₂ × 2⁻¹²⁶ |
0 |
尺度不变,但有效数字可以从 1 以下逐步减小,于是数值就能继续向零靠近。这样表示的非零数,称为非规格化数,也叫次正规数。
实际的小数字段有二十三位,道理相同。最大的正非规格化数是:
( 0.111 ... 111 ) 2 × 2 − 126 = ( 1 − 2 − 23 ) × 2 − 126 (0.111\ldots111)_2\times 2^{-126} =(1-2^{-23})\times 2^{-126} (0.111...111)2×2−126=(1−2−23)×2−126
它与最小正规格化数之间,只差:
2 − 23 × 2 − 126 = 2 − 149 2^{-23}\times 2^{-126}=2^{-149} 2−23×2−126=2−149
这也就是这一段每个刻度之间的距离。保持同一个尺度,让 0.111...... 与 1.000...... 在边界处自然接上,便是这里继续采用指数 -126 的用意。
当小数字段中只有最后一位为 1 时,得到最小正非零值:
2 − 23 × 2 − 126 = 2 − 149 2^{-23}\times 2^{-126}=2^{-149} 2−23×2−126=2−149
再往下,已经没有更小的正数编码了。更小的结果需要舍入,可能最终变成零。
整个解释规则可以写成:
x = ( − 1 ) s × ( 0. f ) 2 × 2 − 126 x=(-1)^s\times(0.f)_2\times 2^{-126} x=(−1)s×(0.f)2×2−126
其中,(0.f)₂ 就是"首位为 0,后面接上小数字段"的简写。机器看到指数字段全零,就按这套规则理解编码。
这一段虽然让数值继续靠近零,但前面的非零有效位会逐渐减少,能够保留的相对精度也随之下降。
当指数字段和小数字段都为零时,编码表示零。符号字段仍然存在,因此有正零和负零两种编码。通常比较时它们相等,但某些运算会利用这个符号保留方向信息。
另一端:最大值、无穷和特殊结果
再看越来越大的情况。
普通规格化数的最大指数是 127,小数字段全部为 1 时,有效数字达到最大:
( 1.111 ... 111 ) 2 = 2 − 2 − 23 (1.111\ldots111)_2=2-2^{-23} (1.111...111)2=2−2−23
因此,最大有限值是:
( 2 − 2 − 23 ) × 2 127 ≈ 3.4028235 × 10 38 (2-2^{-23})\times 2^{127} \approx 3.4028235\times 10^{38} (2−2−23)×2127≈3.4028235×1038
如果结果大到这套有限数编码也无法容纳,就需要进行溢出处理。在常用的舍入方式和默认异常处理下,足够大的结果会得到正无穷或负无穷。
这里使用的是专门的编码:
text
正无穷:0 | 11111111 | 00000000000000000000000
负无穷:1 | 11111111 | 00000000000000000000000
也就是指数字段全为 1,小数字段全为 0,再由符号字段区分正负。
如果指数全为 1,小数字段却不为零,则用来表示非数,也就是 NaN。例如,在通常的 IEEE 754 默认处理下,0.0 / 0.0 无法得到一个普通数值,就会产生 NaN。
它们都不再套用前面的规格化公式,而是根据字段组合识别其特殊含义。
| 指数字段 | 小数字段 | 表示什么 |
|---|---|---|
1~254 |
任意 | 普通规格化数 |
| 全零 | 非零 | 非规格化数 |
| 全零 | 全零 | 正零或负零 |
| 全一 | 全零 | 正无穷或负无穷 |
| 全一 | 非零 | NaN |
算法里那个"足够大的数"
不过,写算法时,我们还经常看到另一种做法:选一个很大的有限数,把它当作"无穷"。
例如,寻找最小距离时,一开始还没有找到任何可用路径,可以先把距离设为一个远大于所有合法距离的值。之后只要找到实际路径,它就会被更小的距离替换。
这里的"无穷"是程序中的约定。这个大数承担的是标记作用,表示"尚未得到有效结果",并不要求它在浮点编码中真的属于无穷。
这样的值必须结合问题范围选择:它要大于所有可能的合法结果;如果后面还会参与加法等运算,也需要考虑这些运算会不会超出范围,或者让标记失去原来的含义。
所以,算法中用大数代替无穷,和浮点格式提供无穷编码,是两种相关但不同的用法。前者依赖问题中的范围约定,后者由格式和运算规则规定。
六十四位的 double
如果希望保留更多有效数字,或者覆盖更大的数量级,可以增加存储位数。常见的六十四位 double,采用 IEEE 754 的 binary64 格式,基本思路与刚才相同:
| 格式 | 符号字段 | 指数字段 | 小数字段 | 规格化有效数字位数 | 指数偏置 |
|---|---|---|---|---|---|
三十二位 binary32 |
1 | 8 | 23 | 24 | 127 |
六十四位 binary64 |
1 | 11 | 52 | 53 | 1023 |
小数字段增加到五十二位,加上隐含的首位 1,就能保留五十三位二进制有效数字;指数字段增加到十一位,则能覆盖更大的数量级范围。
增加小数字段,主要让数值保留得更细;增加指数字段,主要让范围更宽。它们分别改善了两个方面。
但有限位数的问题依然存在。0.1 换成二进制后仍然无限延伸,double 只是能够保留更多位,得到更接近原数的结果。我们仍然要根据实际需要判断:这些误差,是否已经小到可以接受。
浮点数的运算
编码里的这些部分,怎样参与计算
到这里,我们已经知道怎样把一个浮点数拆成符号、指数和有效数字,也知道怎样从这些字段还原数值。但如果要让两个浮点数相加,机器又该怎样利用这些部分?
先看一个具体例子:
3.5 + 0.875 3.5+0.875 3.5+0.875
这两个数的二进制形式,我们前面已经见过:
3.5 = ( 1.11 ) 2 × 2 1 3.5=(1.11)_2\times2^1 3.5=(1.11)2×21
0.875 = ( 1.11 ) 2 × 2 − 1 0.875=(1.11)_2\times2^{-1} 0.875=(1.11)2×2−1
有效数字都是 1.11,但显然不能直接把它们相加。因为第一个 1.11 要乘以 2,第二个却要乘以二分之一,它们使用的尺度不同。
就像计算 3 米 + 5 厘米,需要先统一单位,这里也需要先统一指数。
加法:先让每一位的权重对上
我们先保留较大的指数 1,把第二个数改写成:
( 1.11 ) 2 × 2 − 1 = ( 0.0111 ) 2 × 2 1 (1.11)_2\times2^{-1} =(0.0111)_2\times2^1 (1.11)2×2−1=(0.0111)2×21
指数从 -1 增加到 1,尺度扩大了四倍,因此前面的有效数字要缩小到原来的四分之一,才能保持数值不变。落实到二进制,就是向右移动两位。
现在两个数都使用 2¹ 这个尺度,可以直接相加:
3.5 + 0.875 = ( ( 1.1100 ) 2 + ( 0.0111 ) 2 ) × 2 1 = ( 10.0011 ) 2 × 2 1 \begin{aligned} 3.5+0.875 &=\bigl((1.1100)_2+(0.0111)_2\bigr)\times2^1\\ &=(10.0011)_2\times2^1 \end{aligned} 3.5+0.875=((1.1100)2+(0.0111)2)×21=(10.0011)2×21
为什么这次能加了?因为对齐之后,同一个位置代表的实际位权相同。两个最低位、两个次低位,才能分别相加并产生进位。
但结果是 10.0011,还不符合前面约定的 1.xxx 形式。把它向右调整一位,同时将指数增加一:
( 10.0011 ) 2 × 2 1 = ( 1.00011 ) 2 × 2 2 (10.0011)_2\times2^1 =(1.00011)_2\times2^2 (10.0011)2×21=(1.00011)2×22
还原成十进制:
( 1 + 1 16 + 1 32 ) × 4 = 4.375 \left(1+\frac1{16}+\frac1{32}\right)\times4=4.375 (1+161+321)×4=4.375
这个例子中的有效数字都很短,结果能够完整保存。一般情况下,整理后的有效数字可能超出字段长度,还需要舍入,再将结果编码回去。
于是,加法的思路就连起来了:先统一尺度,让对应位置的位权相同;然后相加;再整理结果,并在需要时舍入。
小数加到大数上,为什么可能没有变化
前面说过,一个很大的浮点数加上一个很小的数,保存下来的结果可能不变。现在可以从对齐过程看清它。
以三十二位浮点格式中的 16777216 + 1 为例:
16777216 = ( 1.000 ... 000 ) 2 × 2 24 16777216=(1.000\ldots000)_2\times2^{24} 16777216=(1.000...000)2×224
1 = ( 1.0 ) 2 × 2 0 1=(1.0)_2\times2^0 1=(1.0)2×20
为了统一到 2²⁴ 的尺度,第二个数的有效数字需要向右移动二十四位:
1 = ( 0. 00 ... 00 ⏟ 23 个零 1 ) 2 × 2 24 1= \left( 0.\underbrace{00\ldots00}_{23\text{ 个零}}1 \right)_2 \times2^{24} 1=(0.23 个零 00...001)2×224
增加的那个 1,落在小数点后第二十四位。但结果的小数字段只有二十三位,无法完整保存它。
精确结果是 16777217,它处于两个可表示值 16777216 和 16777218 的正中间。在常用的舍入规则下,最终保存为 16777216。
所以,变化没有保留到最终结果中。
实际运算时,机器通常还会利用额外的低位信息判断怎样舍入,并不是一移动到字段之外就立刻把它忘掉。但无论中间怎样处理,最终仍然要回到规定的位数。
减法:尺度对齐之后,再看剩下什么
减法也需要先统一尺度。例如:
3.5 − 0.875 3.5-0.875 3.5−0.875
沿用刚才的对齐结果:
3.5 − 0.875 = ( ( 1.1100 ) 2 − ( 0.0111 ) 2 ) × 2 1 = ( 1.0101 ) 2 × 2 1 = 2.625 \begin{aligned} 3.5-0.875 &=\bigl((1.1100)_2-(0.0111)_2\bigr)\times2^1\\ &=(1.0101)_2\times2^1\\ &=2.625 \end{aligned} 3.5−0.875=((1.1100)2−(0.0111)2)×21=(1.0101)2×21=2.625
这次结果已经是 1.xxx 的形式,不需要再调整指数。
如果两个数很接近,相减之后却可能出现另一种情况:
1.125 − 1 1.125-1 1.125−1
它们的指数相同,可以直接相减:
1.125 − 1 = ( ( 1.001 ) 2 − ( 1.000 ) 2 ) × 2 0 = ( 0.001 ) 2 × 2 0 \begin{aligned} 1.125-1 &=\bigl((1.001)_2-(1.000)_2\bigr)\times2^0\\ &=(0.001)_2\times2^0 \end{aligned} 1.125−1=((1.001)2−(1.000)2)×20=(0.001)2×20
结果前面出现了零。为了重新写成 1.xxx,需要把有效数字向左调整三位,同时将指数降低三:
( 0.001 ) 2 × 2 0 = ( 1.0 ) 2 × 2 − 3 = 0.125 (0.001)_2\times2^0 =(1.0)_2\times2^{-3} =0.125 (0.001)2×20=(1.0)2×2−3=0.125
加法产生进位时,可能需要向右调整;减法抵消前面的数字时,则可能需要向左调整。它们都在做同一件事:保持数值不变,把结果整理回约定的表示形式。
不过,相近数相减还有一个值得留意的问题。假如参与运算的两个数原本就带有近似误差,相减时,相同的主要部分消掉了,剩下的差值很小,原先看起来不明显的误差就可能占据很大的比例。
例如,真实数值是 1000.001 和 1000.000,差值应当为 0.001。但如果保存后的第一个数偏差了 0.0001,变成 1000.0011,算出的差值就成了 0.0011。
相对于一千左右的原数,这个偏差很小;相对于 0.001 的差值,却已经达到百分之十。
因此,相减不一定产生了很大的新误差,也可能是原有误差在很小的结果中显得格外突出。
乘法:有效数字相乘,指数相加
乘法不需要先把指数对齐。因为:
( m 1 × 2 e 1 ) ( m 2 × 2 e 2 ) = ( m 1 m 2 ) × 2 e 1 + e 2 (m_1\times2^{e_1})(m_2\times2^{e_2}) =(m_1m_2)\times2^{e_1+e_2} (m1×2e1)(m2×2e2)=(m1m2)×2e1+e2
仍然使用刚才的两个数:
3.5 × 0.875 = ( ( 1.11 ) 2 × 2 1 ) ( ( 1.11 ) 2 × 2 − 1 ) = ( ( 1.11 ) 2 × ( 1.11 ) 2 ) × 2 0 = ( 11.0001 ) 2 × 2 0 \begin{aligned} 3.5\times0.875 &=\bigl((1.11)_2\times2^1\bigr) \bigl((1.11)_2\times2^{-1}\bigr)\\ &=\bigl((1.11)_2\times(1.11)_2\bigr)\times2^0\\ &=(11.0001)_2\times2^0 \end{aligned} 3.5×0.875=((1.11)2×21)((1.11)2×2−1)=((1.11)2×(1.11)2)×20=(11.0001)2×20
将结果整理成规格化形式:
( 11.0001 ) 2 × 2 0 = ( 1.10001 ) 2 × 2 1 = 3.0625 (11.0001)_2\times2^0 =(1.10001)_2\times2^1 =3.0625 (11.0001)2×20=(1.10001)2×21=3.0625
这里,有效数字相乘,实际指数相加,再根据乘积调整指数。结果如果装不下,同样需要舍入。
正负也容易确定:同号相乘为正,异号相乘为负,符号字段可以单独处理。
还要注意,参与相加的是实际指数,而不是直接把带偏置的字段值相加。若两个字段值分别为 E₁ 和 E₂,暂不考虑最后的规格化调整,那么乘积的指数字段应为:
( E 1 − 127 ) + ( E 2 − 127 ) + 127 = E 1 + E 2 − 127 (E_1-127)+(E_2-127)+127 =E_1+E_2-127 (E1−127)+(E2−127)+127=E1+E2−127
这里减掉一次偏置,是因为两个输入分别带了一次偏置,而结果只需要带一次。
除法:有效数字相除,指数相减
除法的关系也很直接:
m 1 × 2 e 1 m 2 × 2 e 2 = m 1 m 2 × 2 e 1 − e 2 \frac{m_1\times2^{e_1}}{m_2\times2^{e_2}} =\frac{m_1}{m_2}\times2^{e_1-e_2} m2×2e2m1×2e1=m2m1×2e1−e2
例如:
3.5 ÷ 0.875 = ( 1.11 ) 2 × 2 1 ( 1.11 ) 2 × 2 − 1 = ( 1.0 ) 2 × 2 1 − ( − 1 ) = ( 1.0 ) 2 × 2 2 = 4 \begin{aligned} 3.5\div0.875 &=\frac{(1.11)_2\times2^1} {(1.11)_2\times2^{-1}}\\ &=(1.0)_2\times2^{1-(-1)}\\ &=(1.0)_2\times2^2\\ &=4 \end{aligned} 3.5÷0.875=(1.11)2×2−1(1.11)2×21=(1.0)2×21−(−1)=(1.0)2×22=4
这次有效数字恰好相同,相除得到 1,只需要处理指数。
但除法得到的有效数字不一定能用有限位写完。例如,即使输入的 1 和 3 都能够精确保存,1 ÷ 3 的二进制结果仍然无限延伸,最终也需要舍入。
所以,输入没有误差,并不保证运算结果也能精确保存。
计算完,还要放得回去
走完这些例子,可以看到,符号、指数和有效数字并不是只在存储时用来解释数值,它们也提供了组织计算的方法。
加减法先统一尺度,再计算有效数字;乘除法分别计算有效数字和指数。之后还需要整理结果,判断哪些位能够保留,以及超出范围时怎样处理。
如果指数降到了普通规格化数的下限,结果还可能进入前面讲过的非规格化表示;如果结果过大,则可能发生溢出。零、无穷和 NaN 也需要遵守各自的运算规则,不能把所有编码都当作普通的 1.f × 2ᵉ 来计算。
这也让前面的误差问题有了具体来源:数值存入时可能舍入,运算结果保存时也可能舍入。我们需要的通常不是每一步都毫无偏差,而是理解偏差从哪里来,并判断最终结果是否仍在允许范围内。
参考资料与延伸阅读
以下资料对应正文中的历史背景与技术约定,供需要时查阅。配图保留在对应段落中。
二进制、逻辑与计算机器
- 计算机历史博物馆:布尔逻辑与继电器计算,介绍布尔逻辑如何应用于开关电路,以及香农和其他研究者的工作。
- 香农《继电器与开关电路的符号分析》期刊原文,用于查阅前文提到的逻辑规则与继电器网络之间的联系。
编码方案与字节序历史
类型转换与浮点表示
- C 标准草案 N1570,类型转换可查第 6.3 节,整数格式宏可查第 7.8 节。
- Oracle《数值计算指南》:三十二位浮点格式,可查阅字段分配、非规格化数及特殊编码;页面也提供双精度和误差讨论的导航。
-
高德纳《计算机程序设计艺术》:位置计数制,其中介绍了平衡三进制及塞顿计算机。 ↩︎
-
史密森尼博物馆:Dalton Model 181-4 加法机,藏品说明记录了供减法使用的互补数字按键。 ↩︎
-
NetBSD 的 endian.h 源码,其中
_PDP_ENDIAN的注释说明了组内低字节优先、组间高权重组优先的排列。 ↩︎ -
丹尼·科恩:《论圣战与和平的呼吁》,IEN 137,1980 年 4 月 1 日。原文借用《格列佛游记》的故事讨论排列顺序,并介绍了摩托罗拉 68000 等机器。 ↩︎ ↩︎
-
IBM《z/Architecture Principles of Operation》,说明 System/360、System/370、ESA/390 和 z/Architecture 采用大端字节序。 ↩︎
-
Arm:AArch64 内存模型,第 31 页介绍数据访问的字节序支持与配置。 ↩︎