Nginx负载均衡应用实战
3、负载均衡配置
3.1、负载均衡的长连接
当客户端通过浏览器访问HTTP服务器时,HTTP请求会通过TCP协议与HTTP服务器建立一条访问通道,当本次访问数据传输完毕后,该TCP连接会立即被断开,由于这个连接存在的时间很短,所以HTTP连接也被称为短连接。在HTTP/1.1版本中默认开启Connection: keep-alive,实现了HTTP协议的长连接,可以在一个TCP连接中传输多个HTTP请求和响应,减少了建立和关闭TCP连接的消耗和延迟,提高了传输效率。网络应用中,每个网络请求都会打开一个TCP连接,基于上层的软件会根据需要决定这个连接的保持或关闭。例如,FTP协议的底层也是TCP,是长连接。
默认配置下,HTTP协议的负载均衡与上游服务器组中被代理的连接都是HTTP/1.0版本的短连接。Nginx的连接管理机制如图所示。
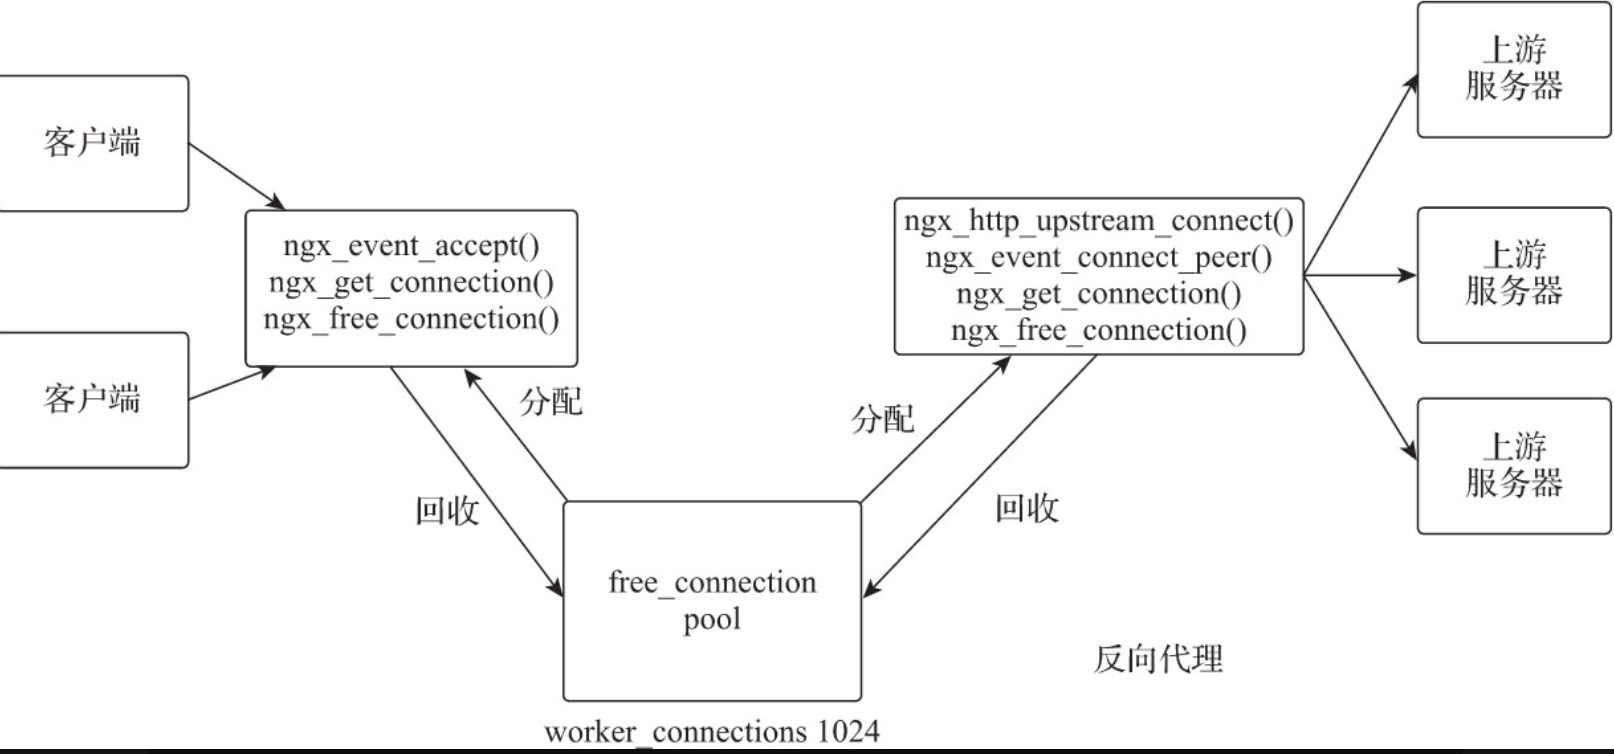
- Nginx启动初始化时,每个Nginx工作进程(WorkerProcess)会生成一个由配置指令worker_connections指定大小的可用连接池(free_connection pool)。工作进程每建立一个连接,都会从可用连接池中分配 (ngx_get_connection)到一个连接资源,而关闭连接时再通知(ngx_free_connection)可用连接池回收此连接资源。
- 客户端向Nginx发起HTTP连接时,Nginx的工作进程获得该请求的处理权并接受请求,同时从可用连接池中获得连接资源与客户端建立客户端连接资源。
- Nginx的工作进程从可用连接池获取连接资源,并与通过负载均衡策略选中的被代理服务器建立代理连接。
- 默认配置下,Nginx的工作进程与被代理服务器建立的连接都是短连接,所以获取请求响应后就会关闭连接并通知可用连接池回收此代理连接资源。
- Nginx的工作进程将请求响应返回给客户端,若该请求为长连接,则保持连接,否则关闭连接并通知可用连接池回收此客户端连接资源。
- Nginx能建立的最大连接数是worker_connections×worker_processes。而对于反向代理的连接,最大连接数是worker_connections×worker_processes/2,但是其会占用与客户端及与被代理服务器建立的两个连接。
在高并发的场景下,Nginx频繁与被代理服务器建立和关闭连接会消耗大量资源。Nginx的upstream_keepalive模块提供与被代理服务器间建立长连接的管理支持,该模块建立了一个长连接缓存,用于管理和存储与被代理服务器建立的连接。Nginx长连接管理机制如图所示。
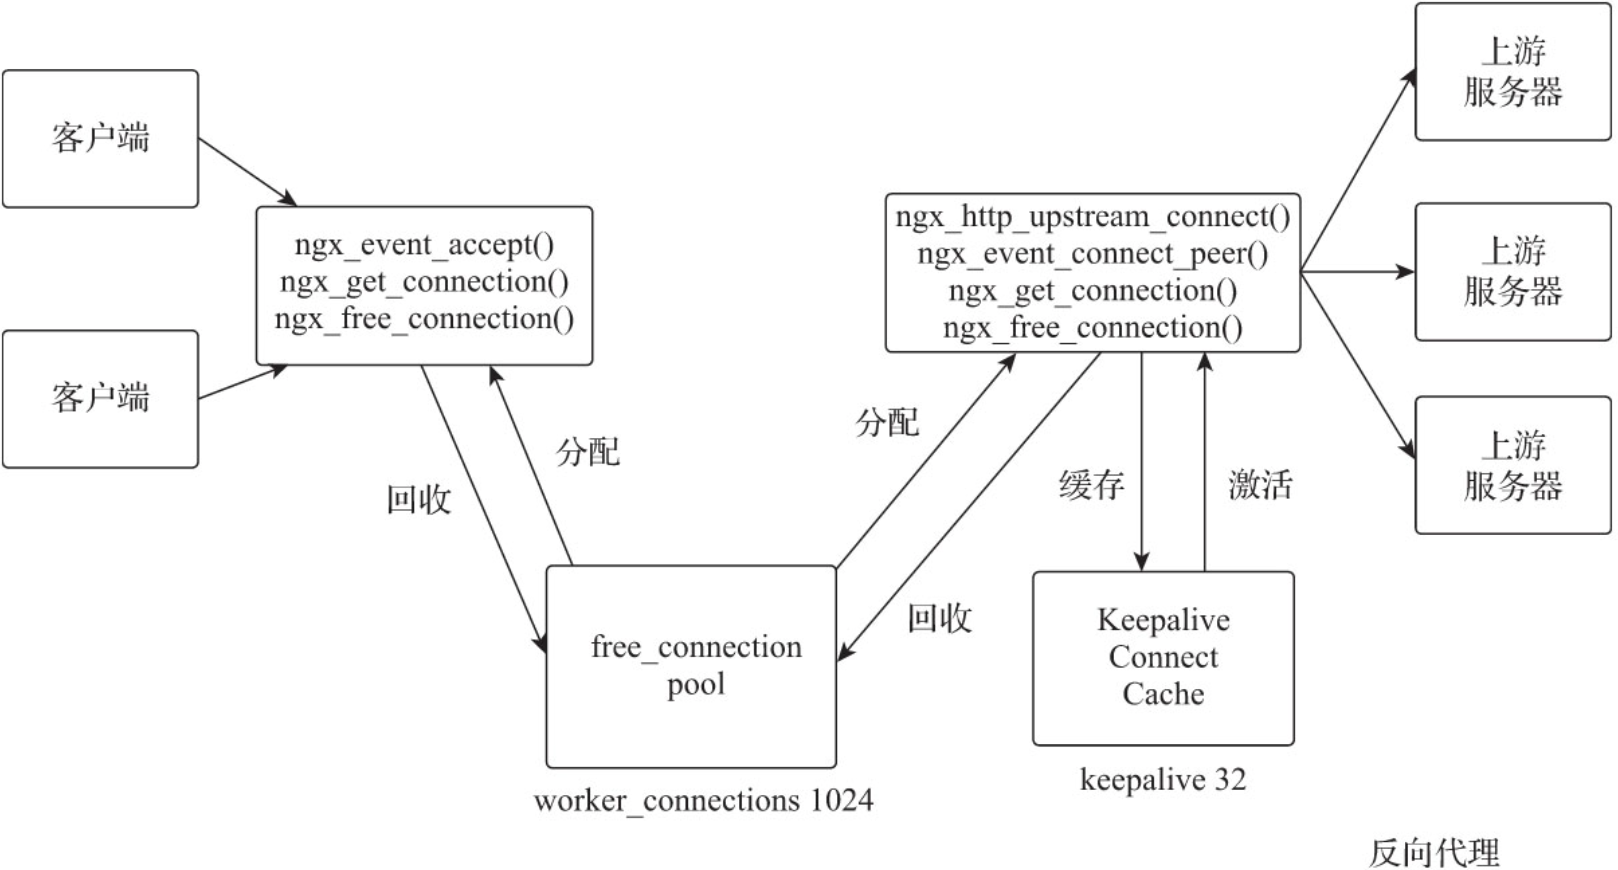
- 当upstream_keepalive模块初始化时,将建立按照upstream指令域中的keepalive指令设置大小的长连接缓存(Keepalive Connect Cache)池。
- 当Nginx的工作进程与被代理服务器新建的连接完成数据传输时,其将该连接缓存在长连接缓存池中。
- 当工作进程与被代理服务器有新的连接请求时,会先在长连接缓存池中查找符合需求的连接,如果存在则使用该连接,否则创建新连接。
- 对于超过长连接缓存池数量的连接,将使用最近最少使用(LRU)算法进行关闭或缓存。
- 长连接缓存池中每个连接最大未被激活的超时时间由upstream指令域中keepalive_timeout指令设置,超过该指令值时间未被激活的连接将被关闭。
- 长连接缓存池中每个连接可复用传输的请求数由upstream指令域中keepalive_requests指令设置,超过该指令值复用请求数的连接将被关闭。
- Nginx与被代理服务器间建立的长连接是通过启用HTTP/1.1版本协议实现的。由于HTTP代理模块默认会将发往被代理服务器的请求头属性字段Connection的值设置为Close,因此需要通过配置指令清除请求头属性字段Connection的内容。
配置样例如下:
bash
upstream http_backend {
    server 192.168.2.154:8080;
    server 192.168.2.109:8080;
    keepalive 32;                           # 长连接缓存池大小为32
    keepalive_requests 2000;                # 每条长连接最大复用请求数为2000
}

server {
    location /http/ {
        proxy_pass http://http_backend;
        proxy_http_version 1.1;             # 启用HTTP/1.1版本与被代理服务器建立连接
        proxy_set_header Connection "";     # 清空发送被代理服务器请求头属性字段Connection
                                                # 的内容
    }
}
对于FastCGI协议服务器,需要设置fastcgi_keep_conn指令启用长连接支持。
bash
upstream fastcgi_backend {
    server 192.168.2.154:9000;
    server 192.168.2.109:9000;
    keepalive 8;                            # 长连接缓存池大小为8
}

server {
    ...

    location /fastcgi/ {
        fastcgi_pass fastcgi_backend;
        fastcgi_keep_conn on;               # 启用长连接支持
        ...
    }
}- SCGI和uWSGI协议没有长连接的概念。
- Memcached协议(由ngx_http_memcached_module模块提供)的长连接配置,只需在upstream指令域中设置keepalive指令即可。
bash
upstream memcached_backend {
    server 127.0.0.1:11211;
    server 10.0.0.2:11211;

    keepalive 32;                           # 长连接缓存池大小为32
}

server {
    ...

    location /memcached/ {
        set $memcached_key $uri;            # 设置$memcached_key为$uri
        memcached_pass memcached_backend;
    }
}
3.2、upstream的容错机制
Nginx在upstream模块中默认的检测机制是通过用户的真实请求去检查被代理服务器的可用性,这是一种被动的检测机制,通过upstream模块中server指令的指令值参数max_fails及fail_timeout实现对被代理服务器的检测和熔断。
配置样例如下:
bash
upstream http_backend {
    # 10s内出现3次错误,该服务器将被熔断10s
    server 192.168.2.154:8080 max_fails=3 fail_timeout=10s;
    server 192.168.2.109:8080 max_fails=3 fail_timeout=10s;
    server 192.168.2.108:8080 max_fails=3 fail_timeout=10s;
    server 192.168.2.107:8080 max_fails=3 fail_timeout=10s;
}

server {
    proxy_connect_timeout 5s;               # 与被代理服务器建立连接的超时时间为5s
    proxy_read_timeout 10s;                 # 获取被代理服务器的响应最大超时时间为10s

    # 当与被代理服务器通信出现指令值指定的情况时,认为被代理出错,并将请求转发给上游服务器组中
    # 的下一个可用服务器
    proxy_next_upstream http_502 http_504 http_404 error timeout invalid_header;
    proxy_next_upstream_tries 3;            # 转发请求最多3次
    proxy_next_upstream_timeout 10s;        # 总尝试超时时间为10s

    location /http/ {
        proxy_pass http://http_backend;
    }
}
其中的参数和指令说明如下。
- 指令值参数max_fails是指10s内Nginx分配给当前服务器的请求失败次数累加值,每10s会重置为0。
- 指令值参数fail_timeout既是失败计数的最大时间,又是服务器被置为失败状态的熔断时间,超过这个时间将再次被分配请求。
- 指令proxy_connect_timeout或proxy_read_timeout为超时状态时,都会触发proxy_next_upstream的timeout条件。
- proxy_next_upstream是Nginx下提高请求成功率的机制,当被代理服务器返回错误并符合proxy_next_upstream指令值设置的条件时,将尝试转发给下一个可用的被代理服务器。
- 指令proxy_next_upstream_tries的指令值次数包括第一次转发请求的次数。
Nginx被动检测机制的优点是不需要增加额外进程进行健康检测,但用该方法检测是不准确的。如当响应超时时,有可能是被代理服务器故障,也可能是业务响应慢引起的。如果是被代理服务器故障,那么Nginx仍会在一定时间内将客户端的请求转发给该服务器,用以判断其是否恢复。
Nginx官方的主动健康检测模块仅集成在商业版本中,对于开源版本,推荐使用Nginx扩展版OpenResty中的健康检测模块lua-resty-upstream-healthcheck。该模块的检测参数如表所示。
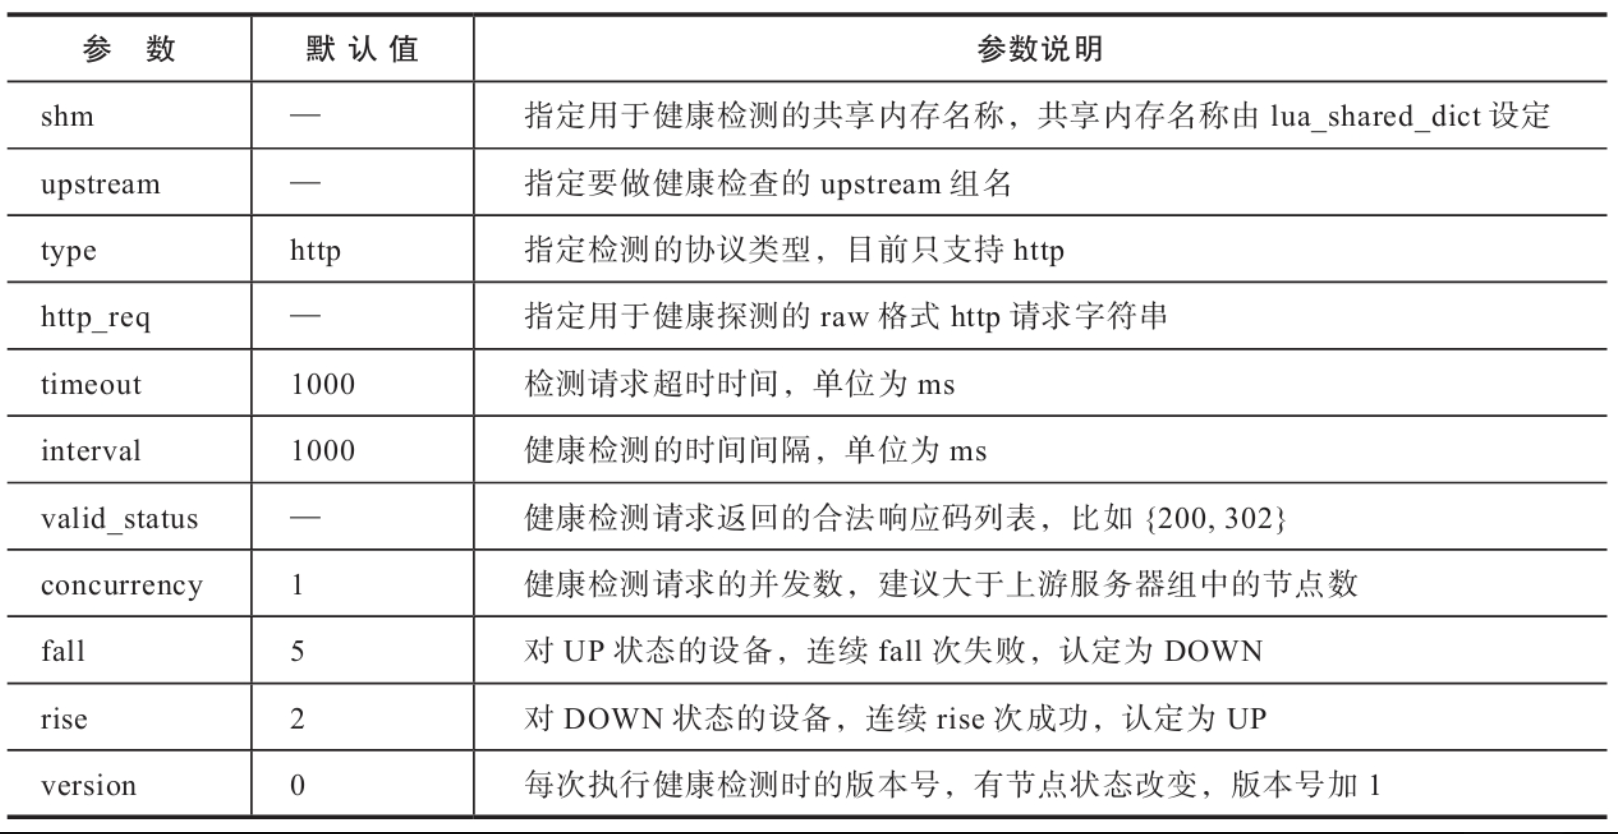
模块lua-resty-upstream-healthcheck的原理是每到(interval)设定的时间,就会对被代理服务器的HTTP端口主动发起GET请求(http_req),当请求的响应状态码在确定为合法的列表(valid_status)中出现时,则认为被代理服务器是健康的,如果请求的连续(fall)设定次数返回响应状态码都未在列表(valid_status)中出现,则认为是故障状态。对处于故障状态的设备,该模块会将其置为DOWN状态,直到请求的连续(rise)次返回的状态码都在确定为合法的列表中出现,被代理服务器才会被置为UP状态,并获得Nginx分配的请求,Nginx在整个运行过程中不会将请求分配给DOWN状态的被代理服务器。lua-resty-upstream-healthcheck模块只会使用Nginx中的一个工作进程对被代理服务器进行检测,不会对被代理服务器产生大量的重复检测。
配置样例如下:
bash
http {
    # 关闭socket错误日志
    lua_socket_log_errors off;

    # 上游服务器组样例
    upstream foo.com {
        server 127.0.0.1:12354;
        server 127.0.0.1:12355;
        server 127.0.0.1:12356 backup;
    }

    # 设置共享内存名称及大小
    lua_shared_dict _foo_zone 1m;

    init_worker_by_lua_block {
        # 引用resty.upstream.health-check模块
        local hc = require "resty.upstream.healthcheck"

        local ok, err = hc.spawn_checker{
            shm = "_foo_zone",              # 绑定lua_shared_dict定义的共享内存
            upstream = "foo.com",           # 绑定upstream指令域
            type = "http",

            http_req = "GET /status HTTP/1.0\r\nHost: foo.com\r\n\r\n",
                                                # 用以检测的raw格式http请求

            interval = 2000,                # 每2s检测一次
            timeout = 1000,                 # 检测请求超时时间为1s
            fall = 3,                       # 连续失败3次,被检测节点被置为DOWN状态
            rise = 2,                       # 连续成功2次,被检测节点被置为UP状态
            valid_statuses = {200, 302},    # 当健康检测请求返回的响应码为200或302时,被认
                                                # 为检测通过
            concurrency = 10,               # 健康检测请求的并发数为10
        }
        if not ok then
            ngx.log(ngx.ERR, "failed to spawn health checker: ", err)
            return
        end
    }

    server {
        listen 10080;
        access_log  off;                    # 关闭access日志输出
        error_log  off;                     # 关闭error日志输出

        # 健康检测状态页
        location = /healthcheck {
            allow 127.0.0.1;
            deny all;

            default_type text/plain;
            content_by_lua_block {
                # 引用resty.upstream.healthcheck模块
                local hc = require "resty.upstream.healthcheck"
                ngx.say("Nginx Worker PID: ", ngx.worker.pid())
                ngx.print(hc.status_page())
            }
        }
    }
}
以下是对该配置样例的几点说明。
- 该配置样例参照OpenResty官方样例简单修改。
- 对不同的upstream需要通过参数upstream进行绑定。
- 建议为每个上游服务器组指定独享的共享内存,并用参数shm进行绑定。
3.3、动态更新upstream
Nginx的配置是启动时一次性加载到内存中的,在实际的使用中,对Nginx服务器上游服务器组中节点的添加或移除仍需要重启或热加载Nginx进程。在Nginx的商业版本中,提供了ngx_http_api_module模块,可以通过API动态添加或移除上游服务器组中的节点。对于Nginx开源版本,通过Nginx的扩展版OpenResty及Lua脚本也可以实现上游服务器组中节点的动态操作,这里只使用OpenResty的lua-upstream-nginx-module模块简单演示节点的上下线状态动态修改的操作。该模块提供了set_peer_down指令,该指令可以对upstream的节点实现上下线的控制。由于该指令只支持worker级别的操作,为使得Nginx的所有worker都生效,此处通过编写Lua脚本与lua-resty-upstream-healthcheck模块做了简单的集成,利用lua-resty-upstream-healthcheck模块的共享内存机制将节点状态同步给其他工作进程,实现对upstream的节点状态的控制。
首先在OpenResty的lualib目录下创建公用函数文件api_func.lua, lualib/api_func.lua内容如下:
bash
local _M = { _VERSION = '1.0' }
local cjson = require "cjson"
local upstream = require "ngx.upstream"
local get_servers = upstream.get_servers
local get_primary_peers = upstream.get_primary_peers
local set_peer_down = upstream.set_peer_down

# 分割字符串为table
local function split( str,reps )
    local resultStrList = {}
    string.gsub(str,"[^"..reps.."]+",function ( w )
        table.insert(resultStrList,w)
    end)
    return resultStrList
end

# 获取server列表
local function get_args_srv( args )
    if not args["server"] then
        ngx.say("failed to get post args: ", err)
        return nil
    else
        if type(args["server"]) ~= "table" then
            server_list=split(args["server"],",")
        else
            server_list=args["server"]
        end
    end
    return server_list
end

# 获取节点在upstream中的顺序
local function get_peer_id(ups,server_name)
    local srvs = get_servers(ups)
    for i, srv in ipairs(srvs) do
        -- ngx.print(srv["name"])
        if srv["name"] == server_name then
            target_srv = srv
            target_srv["id"] = i-1
            break
        end
    end
    return target_srv["id"]
end

# 获取节点共享内存key
local function gen_peer_key(prefix, u, is_backup, id)
    if is_backup then
        return prefix .. u .. ":b" .. id
    end
    return prefix .. u .. ":p" .. id
end

# 设置节点状态
local function set_peer_down_globally(ups, is_backup, id, value,zone_define)
    local u = ups
    local dict = zone_define
    local ok, err = set_peer_down(u, is_backup, id, value)
    if not ok then
        ngx.say(cjson.encode({code = "E002", msg = "failed to set peer down", data = err}))
    end

    local key = gen_peer_key("d:", u, is_backup, id)
    local ok, err = dict:set(key, value)
    if not ok then
        ngx.say(cjson.encode({code = "E003", msg = "failed to set peer down state", data = err}))
    end
end

# 获取指定upstream的节点列表
function  _M.list_server(ups)
    local srvs, err = get_servers(ups)
    ngx.say(cjson.encode(srvs))
end

# 设置节点状态
function  _M.set_server(ups,args,status,backup,zone_define)
    local server_list = get_args_srv(args)
    if server_list == nil then
        ngx.say(cjson.encode({code = "E001", msg = "no args",data = server_list}))
        return nil
    end

    for _, s in pairs(server_list) do
        local peer_id = get_peer_id(ups,s)
        if status then
            local key = gen_peer_key("nok:", ups, backup, peer_id)
            local ok, err = zone_define:set(key, 1)
            set_peer_down_globally(ups, backup, peer_id, true,zone_define)
        else
            local key = gen_peer_key("ok:", ups, backup, peer_id)
            local ok, err = zone_define:set(key, 0)
            set_peer_down_globally(ups, backup, peer_id, nil,zone_define)
        end
    end
    ngx.say(cjson.encode({code = "D002", msg = "set peer is success",data = server_list}))
end

return _M
Nginx配置文件status.conf的内容如下:
bash
# 关闭socket错误日志
lua_socket_log_errors off;

# 设置共享内存名称及大小
lua_shared_dict _healthcheck_zone 10m;

init_worker_by_lua_block {
    local hc = require "resty.upstream.healthcheck"

    # 设置需要健康监测的upstream
    local ups = {"foo.com","sslback"}

    # 遍历ups,绑定健康监测策略
    for k, v in pairs(ups) do
        local ok, err = hc.spawn_checker{
            shm = "_healthcheck_zone",      # 绑定lua_shared_dict定义的共享内存
            upstream = v,                   # 绑定upstream指令域
            type = "http",
            http_req = "GET / HTTP/1.0\r\nHost: foo.com\r\n\r\n",
                                            # 用以检测的raw格式http请求

            interval = 2000,                # 每2s检测一次
            timeout = 1000,                 # 检测请求超时时间为1s
            fall = 3,                       # 连续失败3次,被检测节点被置为DOWN状态
            rise = 2,                       # 连续成功2次,被检测节点被置为UP状态
                                                # 当健康检测请求返回的响应码为200或302时,被认
                                                # 为检测通过
            valid_statuses = {200, 302},
            concurrency = 10,               # 健康检测请求的并发数为10
        }
        if not ok then
            ngx.log(ngx.ERR, "failed to spawn health checker: ", err)
            return
        end
    end
}

upstream foo.com {
    server 192.168.2.145:8080;
    server 192.168.2.109:8080;
    server 127.0.0.1:12356 backup;
}

upstream sslback {
    server 192.168.2.145:443;
    server 192.168.2.159:443;
}

server {
    listen 18080;
    access_log  off;
    error_log off;

    # 健康检测状态页
    location = /healthcheck {
        access_log off;
        allow 127.0.0.1;
        allow 192.168.2.0/24;
        allow 192.168.101.0/24;
        deny all;

        default_type text/plain;
        content_by_lua_block {
            local hc = require "resty.upstream.healthcheck"
            ngx.say("Nginx Worker PID: ", ngx.worker.pid())
            ngx.print(hc.status_page())
        }
    }

    location = /ups_api {
        default_type  application/json;
        content_by_lua '
            # 获取URL参数
            local ups = ngx.req.get_uri_args()["ups"]
            local act = ngx.req.get_uri_args()["act"]
            if act == nil or ups == nil then
                ngx.say("usage: /ups_api?ups={name}&act=[down,up,list]")
                return
            end

            # 引用api_func.lua脚本
            local api_fun = require "api_func"
            # 绑定共享内存_healthcheck_zone
            local zone_define=ngx.shared["_healthcheck_zone"]

            if act == "list" then
                # 获取指定upstream的节点列表
                api_fun.list_server(ups)
            else
                ngx.req.read_body()
                local args, err = ngx.req.get_post_args()
                if act == "up" then
                    # 节点状态将设置为UP
                    api_fun.set_server(ups,args,false,false,zone_define)
                end
                if act == "down" then
                    # 节点状态将设置为DOWN
                    api_fun.set_server(ups,args,true,false,zone_define)
                end
            end
        ';
    }
}
操作命令如下:
bash
# 查看upstream foo.com的服务器列表
curl "http://127.0.0.1:18080/ups_api?act=list&ups=foo.com"

# 将192.168.2.145:8080这个节点设置为DOWN状态
curl -X POST -d "server=192.168.2.145:8080" "http://127.0.0.1:18080/ups_api?act= down&ups=foo.com"

# 将192.168.2.145:8080这个节点设置为UP状态
curl -X POST -d "server=192.168.2.145:8080" "http://127.0.0.1:18080/ups_api?act= up&ups=foo.com"
3.4、HTTP负载均衡配置
基于HTTP协议的负载均衡是通过HTTP代理模块(ngx_http_proxy_module)及上游模块(ngx_http_upstream_module)实现的,配置样例如下:
bash
upstream http_backend {
    server 192.168.2.154:8080;
    server 192.168.2.109:8080;
    keepalive 32;                                   # 长连接缓存池大小为32
    keepalive_requests 2000;                                # 长连接复用请求的最大数为2000
}

server {
    location /http/ {
        proxy_pass http://http_backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
3.5、FastCGI负载均衡配置
基于FastCGI协议的负载均衡是通过FastCGI模块(ngx_http_fastcgi_module)及上游模块(ngx_http_upstream_module)实现的,配置样例如下:
bash
upstream php_backend {
    server 192.168.2.154:8080;
    server 192.168.2.109:8080;
    keepalive 32;
    keepalive_requests 2000;
}

server {
    listen 8080;
    root /opt/nginx-web/phpweb;
    index index.php;                                        # 默认首页index.php
    include fscgi.conf;                                     # 引入FastCGI配置

    location ~ \.php(.*)$ {
        fastcgi_pass   php_backend;                         # FastCGI服务器地址及端口
        fastcgi_keep_conn on;                               # 启用长连接
        fastcgi_index  index.php;

        fastcgi_split_path_info    ^(.+\.php)(.*)$; # 获取$fastcgi_path_info变量值
        fastcgi_param PATH_INFO    $fastcgi_path_info;      # 赋值给参数PATH_INFO
        include  fastcgi.conf;      # 引入默认参数文件
    }

    error_page 404 /404.html;
    error_page 500 502 503 504 /50x.html;
}
3.6、uWSGI负载均衡配置
基于uWSGI协议的负载均衡是通过uWSGI模块(ngx_http_uwsgi_module)及上游模块(ngx_http_upstream_module)实现的,配置样例如下:
bash
upstream uwsgi_backend {
    server 192.168.2.154:8080;
    server 192.168.2.109:8080;
}

server {
    listen         8083;
    server_name    localhost
    charset UTF-8;

    client_max_body_size 75M;

    location / {
        include uwsgi_params;               # 引入uWSGI默认参数配置
        uwsgi_pass uwsgi://uwsgi_backend;   # 代理到上游服务器组uwsgi_backend
        uwsgi_read_timeout 2;
    }
}
3.7、gRPC负载均衡配置
基于gRPC协议的负载均衡是通过gRPC模块(ngx_http_grpc_module)及上游模块(ngx_http_upstream_module)实现的,配置样例如下:
bash
upstream grpc_backend {
    server 192.168.2.154:8080;
    server 192.168.2.109:8080;
}

server {
    listen  80 http2;                       # 设置监听端口为80并启用HTTP/2协议支持
    access_log /var/log/nginx/grpcs_access.log main;
    location / {
        grpc_pass grpc://grpc_backend;      # 代理到gRPC上游服务器组grpc_backend
    }
}
3.8、Memcached负载均衡配置
Memcached协议的负载均衡是通过Memcached模块(ngx_http_memcached_module)及上游模块(ngx_http_upstream_module)实现的,配置样例如下:
bash
upstream memcached_backend {
    server 127.0.0.1:11211;
    server 10.0.0.2:11211;

    keepalive 32;
}

server {
    ...

    location /memcached/ {
        set $memcached_key $uri;
        memcached_pass memcached_backend;
    }
}
4、TCP/UDP负载均衡
Nginx的TCP/UDP负载均衡是应用Stream代理模块(ngx_stream_proxy_module)和Stream上游模块(ngx_stream_upstream_module)实现的。Nginx的TCP负载均衡与LVS都是四层负载均衡的应用,所不同的是,LVS是被置于Linux内核中的,而Nginx是运行于用户层的,基于Nginx的TCP负载可以实现更灵活的用户访问管理和控制。
4.1、TCP/UDP负载均衡
Nginx的Stream上游模块支持与Nginx HTTP上游模块一致的轮询(Round Robin)、哈希(Hash)及最少连接数(least_conn)负载均衡策略。Nginx默认使用轮询负载均衡策略,配置样例如下:
bash
stream {
    upstream backend {
        server 192.168.2.145:389 weight=5;
        server 192.168.2.159:389 weight=1;
        server 192.168.2.109:389 weight=1;
    }

    server {
        listen 389;
        proxy_pass backend;
    }
}
哈希负载均衡策略可以通过客户端IP($remote_addr)实现简单的会话保持,其可将同一IP客户端始终转发给同一台后端服务器。
配置样例如下:
bash
stream {
    upstream backend {
        hash $remote_addr;
        server 192.168.2.145:389 weight=5;
        server 192.168.2.159:389 weight=1;
        server 192.168.2.109:389 weight=1;
    }

    server {
        listen 389;
        proxy_pass backend;
    }
}
哈希负载均衡策略通过指令参数consistent设定是否开启一致性哈希负载均衡策略。Nginx的一致性哈希负载均衡策略是采用Ketama一致性哈希算法,当后端服务器组中的服务器数量变化时,只会影响少部分客户端的请求。
配置样例如下:
bash
stream {
    upstream backend {
        hash $remote_addr consistent;
        server 192.168.2.145:389 weight=5;
        server 192.168.2.159:389 weight=1;
        server 192.168.2.109:389 weight=1;
    }

    server {
        listen 389;
        proxy_pass backend;
    }
}
最少连接负载均衡策略,可以在后端被代理服务器性能不均时,在考虑上游服务器组中各服务器权重的前提下,将客户端连接分配给活跃连接最少的被代理服务器,从而有效提高处理性能高的被代理服务器的使用率。
配置样例如下:
bash
stream {
    upstream backend {
        least_conn;
        server 192.168.2.145:389 weight=5;
        server 192.168.2.159:389 weight=1;
        server 192.168.2.109:389 weight=1;
    }

    server {
        listen 389;
        proxy_pass backend;
    }
}
4.2、TCP/UDP负载均衡的容错机制
Nginx的TCP/UDP负载均衡在连接分配时也支持被动健康检测模式,如果与后端服务器建立连接失败,并在fail_timeout参数的时间内连续超过max_fails参数设置的次数,Nginx就会将该服务器置为不可用状态,并且在fail_timeout参数的时间内不再给该服务器分配连接。当fail_timeout参数的时间结束时将尝试分配连接检测该服务器是否恢复,如果可以建立连接,则判定为恢复。
配置样例如下:
bash
stream {
    upstream backend {
        # 10s内出现3次错误,该服务器将被熔断10s
        server 192.168.2.154:8080 max_fails=3 fail_timeout=10s;
        server 192.168.2.109:8080 max_fails=3 fail_timeout=10s;
        server 192.168.2.108:8080 max_fails=3 fail_timeout=10s;
        server 192.168.2.107:8080 max_fails=3 fail_timeout=10s;
    }

    server {
        proxy_connect_timeout 5s;           # 与被代理服务器建立连接的超时时间为5s
        proxy_timeout 10s;          # 获取被代理服务器的响应最大超时时间为10s

        # 当被代理的服务器返回错误或超时时,将未返回响应的客户端连接请求传递给upstream中的下
        # 一个服务器
        proxy_next_upstream on;
        proxy_next_upstream_tries 3;        # 转发尝试请求最多3次
        proxy_next_upstream_timeout 10s;    # 总尝试超时时间为10s
        proxy_socket_keepalive on;  # 开启SO_KEEPALIVE选项进行心跳检测
        proxy_pass backend;
    }
}
其中的参数及指令说明如下。
- 指令值参数max_fails是指10s内Nginx分配给当前服务器的连接失败次数累加值,每10s会重置为0。
- 指令值参数fail_timeout既是失败计数的最大时间,又是服务器被置为失败状态的熔断时间,超过这个时间将再次被分配连接。
- 指令proxy_connect_timeout或proxy_timeout为超时状态时,都会触发proxy_next_upstream机制。
- proxy_next_upstream是Nginx下提高连接成功率的机制,当被代理服务器返回错误或超时时,将尝试转发给下一个可用的被代理服务器。
- 指令proxy_next_upstream_tries的指令值次数包括第一次转发请求的次数。
TCP连接在接收到关闭连接通知前将一直保持连接,当Nginx与被代理服务器的两个连续成功的读或写操作的最大间隔时间超过proxy_timeout指令配置的时间时,连接将会被关闭。在TCP长连接的场景中,应适当调整proxy_timeout的设置,同时关注系统内核SO_KEEPALIVE选项的配置,可以防止过早地断开连接。