LangGraph Multi-Agent CASE
1.前言
本文基于案例代码进行学习,源码在这:AI_agent项目: Agent项目片段代码。这篇文章可能看着乱乱的,主要是在不连续时间段上作者补了好几次了(作者的上下文有点遭不住了)
1.1autogen简介
关于采用langgraph做多智能体协作而不是采用autogen/crewai,考量之处在于这两个学习曲线较陡(前提是作者本身就已经学习了langchain了,//我觉得核心思想还是差不多的)这是官方文档链接:AgentChat --- 自动生成
当然这些区别也是很大的,比如:
AgentChat supports many message types for agent-to-agent communication. They belong to subclasses of the base class
BaseChatMessage. Concrete subclasses covers basic text and multimodal communication, such asTextMessageandMultiModalMessage.
尤其MultiModalMessage有这样一个独立类,而langgraph只有几个简单的humanmessage,AImessage,toolmessage等等,但是用state中的content来承载多模态的信息,有点偏了
本文重点探讨多智能体协作模式,在autogen中为teams(这只是最简单的例子,后面高级篇中也包含swarm这种消息协作模式):
ini
# Create the primary agent.
primary_agent = AssistantAgent(
"primary",
model_client=model_client,
system_message="You are a helpful AI assistant.",
)
# Create the critic agent.
critic_agent = AssistantAgent(
"critic",
model_client=model_client,
system_message="Provide constructive feedback. Respond with 'APPROVE' to when your feedbacks are addressed.",
)We will begin by creating a team with two
AssistantAgentand aTextMentionTerminationcondition that stops the team when a specific word is detected in the agent's response.The two-agent team implements the reflection pattern, a multi-agent design pattern where a critic agent evaluates the responses of a primary agent.
现在autogen的功能也越来越丰富了,比如引入了graphflow。但总感觉了差了点意思,翻阅资料发现它更像是一个群聊以对话的模式进行各个子agent协作,靠消息驱动而不是状态。
就拿它的graphflow来说:
它所有的子agent之间交流都需要靠messagefilter裁剪
ini
# Apply message filtering
filtered_analyst = MessageFilterAgent(
name="analyst",
wrapped_agent=analyst,
filter=MessageFilterConfig(per_source=[PerSourceFilter(source="researcher", position="last", count=1)]),
)
filtered_presenter = MessageFilterAgent(
name="presenter",
wrapped_agent=presenter,
filter=MessageFilterConfig(per_source=[PerSourceFilter(source="analyst", position="last", count=1)]),
)
#通过 MessageFilter 让 analyst 只看到 researcher 的最后一条消息,presenter 只看到 analyst 的最后一条消息这点与langgrapg的state按需分发消息/接受完全不同(关于langgraph这点知识会先下文提及),因为autogen是all messages are sent to all agents in the graph需要纯靠message裁剪。autogen我感觉它更像是万物agent化,如上例来说用MessageFilterAgent继续抽象那两个agent,而不是像langgraph那样本身就是用图知识完成。如果autogen需要做到像langgraph那样需要 把"上下文感知"从"框架结构问题"降维成了"又一个 agent 的职责问题" (专门做一个管理上线文的agent摘要精简消息或者把特定的message结构化写入message metadata传入下游)
当然了autogen也有很多内置的agent类,按功能分区实现不同子agent的,比如还有UserProxyAgent(这个看似作用不大,其实在agent中都是很重要的,但凡需要有人工介入的流程用户input绝对不能是简单第一次输入中途流程无法打断,比如代码确定执行hhh,或者多角色群聊等等),CodeExecutorAgent(代码执行agent,+E2B)
1.2选择langgraph
文档参考:langgraph.com.cn/index.html#...
langgraph在langchain生态中的优势:
LangGraph 基于状态机和 DAG 思想,完美解决了基础 Agent 的局限性,核心优势如下:
- 流程精准可控:开发者可手动定义执行节点、节点间的流转关系,实现"固定流程+条件分支"的结构化管控,彻底摆脱对 LLM 推理的依赖。
- 内置状态管理:通过"状态(State)"统一管理中间数据(如调研结果、草稿、校对意见),所有节点可共享、修改状态,避免中间数据丢失。
- 原生支持多 Agent 协作:可将不同功能的 Agent 作为独立节点,定义节点间的协作规则,实现多角色协同完成复杂任务。
- 灵活的循环与分支 :通过"条件边(Conditional Edges)"实现分支决策,通过循环节点实现"反复执行直到满足条件",支持复杂业务逻辑。
- 可视化执行路径:可通过 LangSmith 或内置工具可视化 DAG 图和执行过程,便于调试和流程优化。
- 持久执行:构建能够抵御故障并长时间运行的智能体,可从上次中断的地方自动恢复。
- 人机协作:在执行的任何时间点检查和修改智能体状态,无缝地融入人工监督。
- 全面记忆:创建真正有状态的智能体,既具备用于持续推理的短期工作记忆,也具备跨会话的长期持久记忆。
- 使用 LangSmith 进行调试:利用可视化工具深入了解复杂的智能体行为,这些工具可以追踪执行路径、捕获状态转换并提供详细的运行时指标。
- 生产就绪部署:利用可扩展的基础设施,自信地部署复杂的智能体系统,该基础设施旨在处理有状态、长时间运行工作流的独特挑战。
上面这五点在本案例中不涉及扩展。
当然本文所涉及的langgraph知识点只是冰山一角,只能够管中窥豹看一看,如果想要完整学习还是需要学习专业文档,本文只是一个快速开发的例子讲解,更多的可以把这一篇文章当成一个内容较多的readme
2.架构设计
langgraph基础本文就不多提了,直接走案例分析。
回过来看了一下一些必要的还是要提一下,比如langgraph的记忆设计,在以前我或者其他文章早期可能会是查库动态凭借上下文到prompt中,但在langgraph中就不必如此,内部设置memorysaver检擦点:
ini
from langgraph.checkpoint.memory import MemorySaver
memory = MemorySaver()
graph = graph_builder.compile(checkpointer=memory)
#编译图时加载检查点但要注意一下这个checkpointer是恢复当前所有state,包含里面的message,比如某些属性是归并器(add_messages),则会自动追加,内部类似一个map存了一个snapshot,根据key来查得,像文中所述"在生产应用程序中,您可能会将其更改为使用 SqliteSaver 或 PostgresSaver 并连接数据库"。
还有工具类管理
与现在手写一套工具注册中心如示例代码../tools/registry.py中的那一套,包含所有工具注册和resolve限权每个子agent拥有的工具,用的时候绑定即可:
scss
 registry = get_registry()
 tool_instances = registry.resolve(registry.list_tools())   #全量解析,也可换成tool_names=["search", "book_flight"],registry.resolve(tool_names)
 llm_with_tools = llm.bind_tools(tool_instances)
但是无论是自己写的一套工具注册中心加载进去,还是用langchain的tool装饰器,核心都离不开传给llm一套name + description + parameters 的 JSON Schema。@tool就是省去了手写shcema。当然载入llm之后,分析出需要调用的工具,然后执行相关工具拿到返回的消息对象,这一套可以放到一个node节点中例如官方文档中的BasicToolNode,或者类似langchainAgentExecutor 高级封装,把所有的执行解析都做好了。
注意: 本项目中把这个节点差分开了,在孙子图中设置了执行相关工具函数并解析,机制思想仍是一样的也是路由到执行节点,解析返回toolmessage
2.1几种架构模式
文档参考:概述 - LangChain 框架
先来谈谈主流的主管模式:
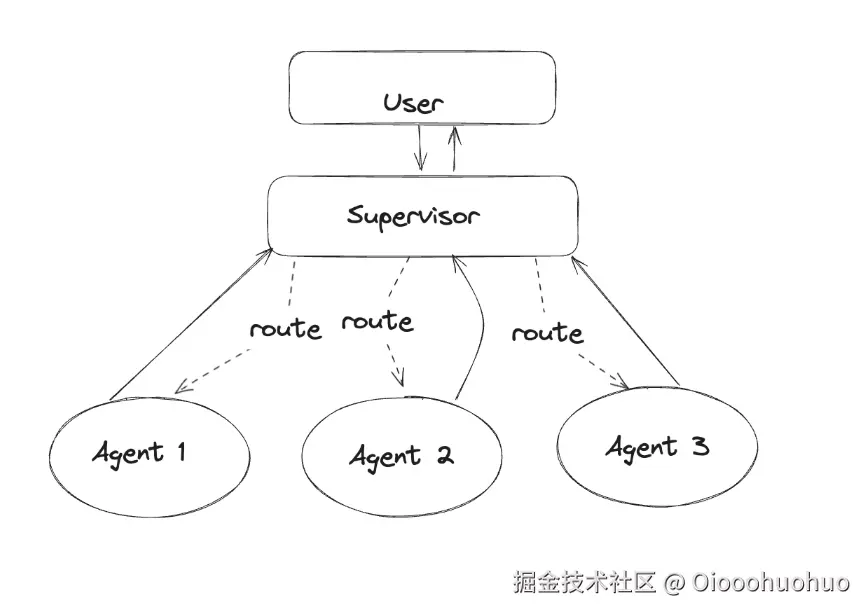
主管是一种多智能体架构,其中专业 智能体由中央主管智能体协调。主管智能体控制所有通信流和任务委托,根据当前上下文和任务要求决定调用哪个智能体。
主管架构示例图:
还有群蜂架构,示例图如下:
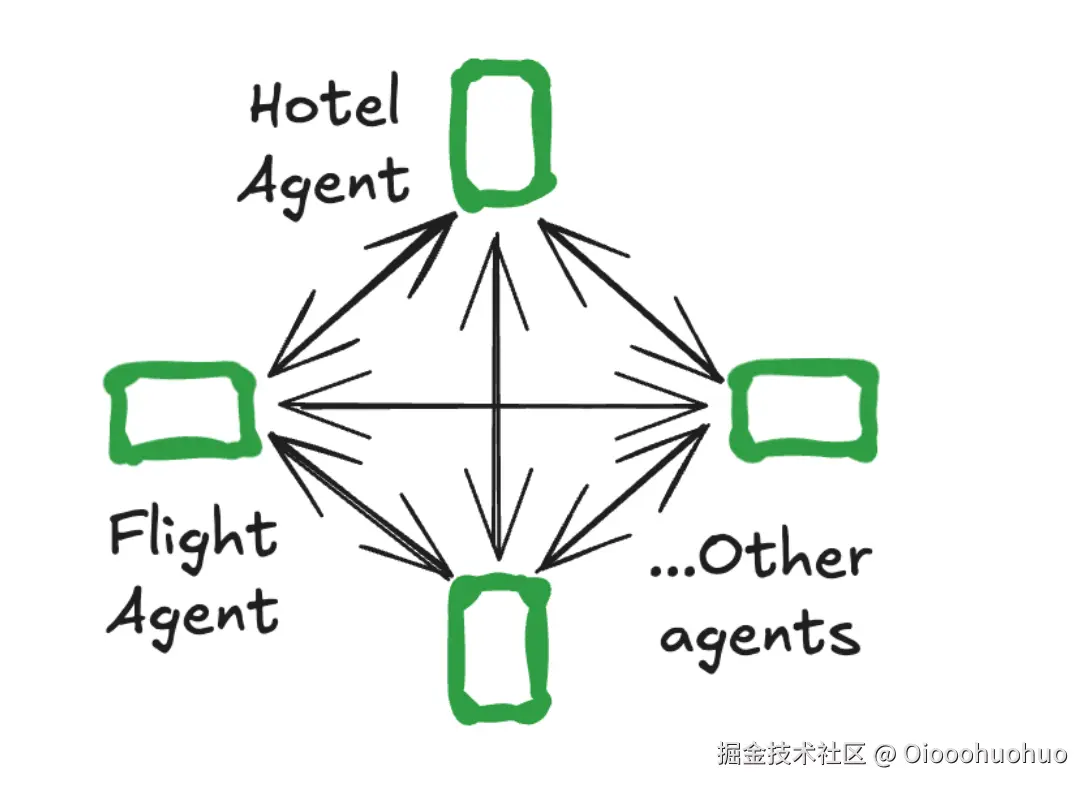
但是参考官方文档也有很省力的方式,这两种架构都有对应的三方库:langgraph-supervisor和langgraph-swarm,以及对应的类方法直接实例化想要的子agent,这点又与autogen类似了,但是也又局限性(社区上案例更多可能还是使用supervisor)正比如本案例是采取supervisor+swarm的混合架构设计(注意仅仅是设计并没有用到这两个三方库)
下面是这个架构的优劣对比:
| 维度 | Supervisor(主管/集中调度) | Swarm(去中心化/交接) |
|---|---|---|
| 控制方式 | 集中式,中央主管统一调度 | 分散式,Agent 直接点对点交接 |
| 协调器 | 有(Supervisor 节点) | 无 |
| 下一个谁执行 | 主管的决策 | 模型每跳的判断(不可预先审计) |
| 路由可控性 | 高,路由逻辑清晰 | 低,行为难预测、难调试 |
| 可调试性 | 好,集中日志易定位 | 差,无中心日志,需 Tracing |
| 扩展性 | 有限,worker 多则主管成瓶颈 | 强,新增 Agent 不必改全局逻辑 |
| 灵活性 | 较低,流程偏固定 | 高,协作关系可动态变化 |
| 鲁棒性/弹性 | 较低,中心节点故障则全瘫 | 较高,无单点瓶颈 |
| 成本 | 高(每轮带全量历史,约单 agent 3 倍) | 随交接次数叠加,每次 handoff 一次调用 |
| 死循环风险 | 有(主管自言自语) | 高,必须设递归上限 |
| 配置难度 | 低 | 高,每个 Agent 的 system message 都要精确定义 |
| 权限/状态边界 | 主管统一掌控,较清晰 | 必须自行设计,易混乱 |
| 责任/审计归属 | 清晰,可映射治理框架 | 模糊,弥散的责任 |
| 轻量请求 | 被全流程拖累、延迟高 | 较灵活,无强制流水线 |
| 适用场景 | 任务边界明确、需统一调度、重审计 | 探索型任务、开放域对话、边界模糊需多轮协商 |
除了这这两种还有更多的multi-agent架构
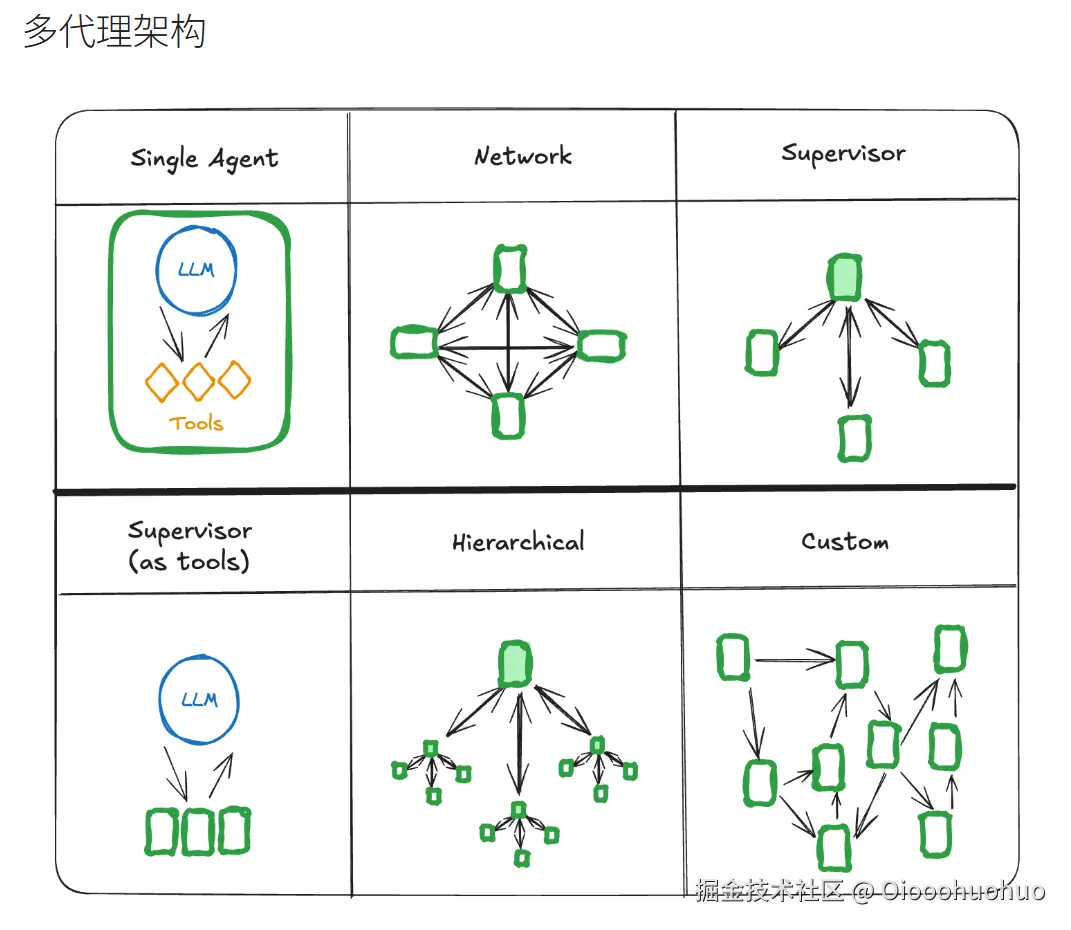
除了这个主管模式还有两种讨论度比较大这里扩展一下:层次化架构(Hierarchical Architecture)和网络模式(Network Pattern)
层次化架构(Hierarchical Architecture)------大规模系统首选 //感觉之前很火的三省六部就是这个 核心逻辑:通过"嵌套主管"模拟企业组织架构,形成多层级管控------顶层主管(父图)管理多个部门主管(一级子图),部门主管管理具体执行智能体(二级子图),层层递进,相当于"总公司→分公司→部门→员工"的层级结构。
架构特点:分层清晰、可扩展性强,适合大规模、复杂业务场景,每个层级的主管只负责自己层级的调度,便于多团队协同开发。
适用场景:大型企业流程自动化、多部门协同系统(如企业 ERP、供应链管理、大型客服平台),任务复杂、子图数量多、需要多层级审批和管控。
网络模式(Network Pattern)------灵活但需谨慎使用 核心逻辑:子图之间可以点对点通信,无需通过父图或主管智能体中转,灵活性极高;但在生产环境中,通常需要引入 Command 模式进行显式的"交接协议(Handoffs)",避免子图之间通信混乱、数据交互失控。
架构特点:灵活性高、协作效率高,适合子图之间需要频繁交互的场景;但复杂度高、可维护性差,调试难度大,容易出现通信冲突、状态混乱。
适用场景:创新型项目、子图之间交互频繁的场景(如多智能体科研协作、创意生成、复杂逻辑推理),不建议用于核心业务系统(如金融、支付相关)。
生产级选型建议:优先选择"主管模式",易落地、易调试,能满足80%的业务需求;如果业务规模较大、需要多层级管控,再选择"层次化架构";"网络模式"仅用于非核心业务的创新场景,务必引入 Command 模式规范通信,同时做好日志记录,便于后期调试。
2.2子图以及孙子图设计
中间层为agents里所有的文件,在此case中主要包含三个:TravelAgentState / CodingAgentState / RagAgentState
Domain Agent 作为第二层 Worker,被父图调用后,在其内部再作为局部调度器,将任务分发给第三层的 Pattern 子图(如 travel_agent)
详细的wrapper包装以及mapper用法见下面
底层子图如下:
ReactState / PlanActState / RagAgentState
Pattern 子图私有,上层不可见。这一层的主要作用就是搭建了或者说套用我之前项目的范式设计,无论是react+reflection+局部重试熔断还是with_rag的工具函数。把他们封装成子graph可完全供上层子agent随意调用,从而减少冗余设计导致的效果不佳以及token损耗过大。依次我甚至预留了plan and act范式的预留
2.3混合架构设计
本案例是"中心化 Supervisor 调度 + Swarm 式共享协作"的混合体------控制流的"决策权"集中在父图(supervisor 特征),信息流的"协作方式"是各 Agent 通过共享黑板接力传递产出(swarm 特征),且每个 Domain Agent 整体被包装成一个节点挂进父图
2.3.1Supervisor 侧
| 节点名称 | 核心职责 | 代码位置 | 关键说明 |
|---|---|---|---|
| orchestrator_node总调度节点 | 理解任务、意图识别、生成执行计划,写入active_subgraph,所有决策在这里完成 |
L52-165 | 中心化大脑,决定该调用哪个子图,只负责做决策 |
| intent_router意图路由(条件边) | 执行路由分发,根据 orchestrator 的决策,跳转到对应子图包装节点 | case_production.py L278-314 | 纯路由表,决策和执行解耦;orchestrator 负责判断,router 负责跳转 |
| travel_wrapper / coding_wrapper / rag_wrapper / react_wrapper / planact_wrapper各子图包装节点 | 执行对应领域子任务(旅游、代码、RAG、ReAct、PlanAct) | - | 子图只能产出结果,无权决定下一步流向,执行完统一进入 post_process |
| post_process_node后处理节点 | 推进计划下标plan_step_index,更新计划状态,收集子图输出结果 |
L172-210 | 维护多步任务计划,把子图结果做标准化整理 |
| review_node审查节点 | 消费子图回传信号,生成审查决策:reroute重新调度 / clarify澄清 / continue继续 |
L217-279 | 二次校验结果,可触发流程回退,增加流程可控性 |
| route_completion审查路由(条件边) | 根据 review 的决策做分支跳转:回到 orchestrator 重调度 / 进入 finalize | - | 审查层的路由分发 |
| error_fallback_node异常兜底节点 | 全局异常捕获、降级处理 | - | 出现异常时直接进入 finalize,跳过后处理与审查 |
| finalize_node结果汇总收口 | 整合全链路所有子图输出,生成最终回复 | L286-303 | 任务收尾,输出最终答案,之后走向 END |
2.3.2Swarm侧
| Swarm 核心特征 | 本项目对应实现 | 代码位置 |
|---|---|---|
| Agent 控制权移交(handoff)时携带共享会话状态,所有 Agent 可互相读取彼此产出 | context 充当共享黑板,所有 Agent 读写同一块上下文存储 |
各子图 mapper:merged_ctx.update({"last_answer": ...}) |
| Agent 执行完成 → 将自身输出写入共享黑板 | travel/coding/rag/react/planact 的 mapper 统一写入 context["last_answer"] |
case_production.pyL104 / L128 / L151 / L195 / L226 |
| 下一个接管任务的 Agent,读取黑板中历史产出作为输入 | 1. planact:读取last_answer拼入查询2. react/travel:把完整context注入 system prompt3. orchestrator 重调度时读取reroute_reason + last_answer |
planact_input_mapper L208-209_react_input_mapper L163-179nodes.py L88-97 |
| Handoff 控制权移交闭环(Agent 之间转交任务) | reroute 闭环:子图执行 → post_process → review 判定需要重调度 → 回到 orchestrator,携带上一轮last_answer交给新 Agent |
case_production L333-336nodes.py L228:子图可主动请求重新分发(跨领域场景) |
| 子图具备一定主动权,可主动 "踢皮球" 请求重分发(区别于传统纯 Supervisor 架构:子图无权请求回退) | review 产生reroute决策,由子图输出信号驱动重调度;也支持clarify分支,携带问题直接交给用户 |
review_node 输出review_decision: reroute / clarify / continue |
| 人机协作出口 | clarify分支:直接把澄清问题汇总交给用户 |
review 决策为 clarify 时进入 finalize,向用户提问 |
3.数据管道的搭建以及流转
数据管道是一条逐层降维流入、逐层汇总回写的受控流水线:
3.1数据传递
跨 Agent 的间接数据传递 • 父图的 context 字段是唯一的受控共享区(数据管道的中转站)。 • 上一个 Domain Agent 可以把结果写入 context.last_answer,下一个子图通过 input_mapper 读取 context 作为增强输入,实现跨子agent的间接、异步数据传递。
整个数据管道遵循 "分层路由 + 状态封装 + 映射转换 + 受控共享" 的设计原则:
- 三层嵌套结构 :
父图Orchestrator→Domain Agent(领域Agent,如travel_agent)→Pattern子图(如plan_and_act子图),每层都有独立的状态类、节点与映射器,实现职责分离。 - 单向数据流:下行链路负责 "用户意图→领域意图→执行计划" 的逐层降维与分发;上行链路负责 "执行结果→领域结果→最终答案" 的逐层汇总与回写。
- 受控数据共享 :
context字段是唯一的跨层 / 跨子图共享区,所有中间结果、历史交互、上下文信息都通过它传递,避免了直接的状态耦合。 - 映射器解耦 :
input_mapper/output_mapper作为各层状态之间的 "适配器",实现不同状态类之间的数据格式转换,保证上层状态与下层状态的解耦。
context的角色与设计
- 唯一受控共享区 :
context是整个数据管道中唯一的跨层共享数据结构,存储历史交互、上一轮结果、用户上下文等信息,所有节点都只能通过它传递数据。 context.last_answer约定 :上一个 Domain Agent 或 Pattern 子图执行完成后,会通过output_mapper将结果写入context.last_answer;下一个子图 / Agent 通过input_mapper读取context(包括last_answer),作为增强输入,实现异步、间接的数据传递。- 解耦优势 :子图 / Agent 之间不需要知道彼此的状态结构,只需要约定
context的字段规范即可,新增子图时无需修改上层逻辑。
input_mapper/output_mapper的核心作用
-
input_mapper(下行):- 从上层状态 /
context中提取当前子图 / Agent 需要的字段; - 转换为当前层状态类的格式,完成状态初始化;
- 示例:
travel_wrapper_node.input_mapper从OrchestratorState中提取信息,生成TravelAgentState。
- 从上层状态 /
-
output_mapper(上行):- 从当前层状态中提取结果与关键信息;
- 转换为上层状态 /
context的格式,完成结果回写; - 示例:
planact_wrapper_node.output_mapper将PlanActState.final_answer写入TravelAgentState与context。
3.2workflow case
注意: 这两个上下链路并不完全,每个node应该都有state这个本身就是基于langgraph是一个有限状态机决定的,包括路由也是,其实这一套链路中隐藏了一个循环,就是通过路由条件判断的,但在图编译中不能出现node1->edge1->node1这种,原因就在于langgraph的DAG(有向无循环图,这个主要是保证图本身没有死环,编译器就可做校验)
3.1.1下行链路详解
下行链路(父图 → Domain Agent → Pattern 子图) 以travel_agent为例
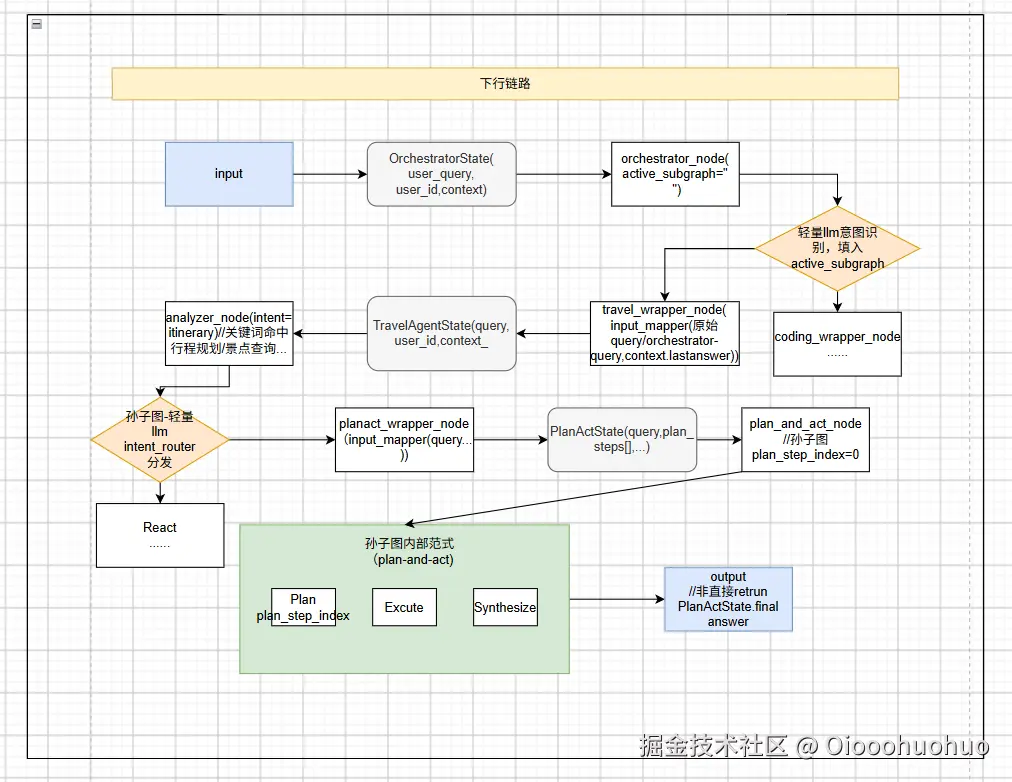
文字说明:
- 初始阶段(orchestratorState中刚接受来自用户的input)
python
  input_state_1 = {
       "session_id": "demo_session_001",
       "user_query": "帮我制定一个计划:先搜索航班从 BOS 到 JFK,再预订 McKittrick Hotel",
       "user_id": 12345,
       "plan": [],
       "plan_step_index": 0,
       "active_subgraph": "",
       "context": {},               # ← 空的受控共享区
       "is_complete": False, "error": None,
       "final_answer": "",
       "review_decision": "",
   }
//父图状态上下文context与final_answer均为空- 第二阶段动态分发(orchestrator_node)
- 本节点不借助硬性语法规则进行active_subgraph分发,结主轻量llm,加载所有subgraphy以及description进行动态意图识别分发
- 本节点还采用了上下文感知增强,将上下文对话载入(这个memory模块本文暂不涉及,在brain_case.py略有提到)
python
 //当然一个轻量的llm不可能全盘接受所有的上下文,这也是极度浪费资源的,既然用了,langgraph的状态机就可以好好利用,只传入必要字段即可
 enhanced_user_input = f"用户请求:{query}"
     if context.get("reroute_reason"):
         enhanced_user_input += f"\n\n【历史执行反馈】前次执行被退回,原因:{context['reroute_reason']}"
     #注意一下这个是context中last_answer,不是state中的final_answer
     if context.get("last_answer"):
         truncated_answer = str(context["last_answer"])[:300]
         enhanced_user_input += f"\n\n【已产生的中间结果】{truncated_answer}"
     if context.get("needs_clarification"):
         enhanced_user_input += (
             f"\n\n【待澄清信息】{context.get('clarification_text', '用户请求存在歧义,需要进一步澄清')}"
         )
• 输入读取:取 user_query,并从 context 里提取历史信号拼成增强输入(本轮是首轮,context 为空,所以增强输入就是原始 query 本身)。 • 输出写入:plan = {"subgraph": "travel_agent", ...}、active_subgraph = "travel_agent"、context = {"intent_reason": "用户请求预订航班和酒店"}。 此时状态关键字段:plan=travel_agent 计划项,active_subgraph="travel_agent",context={"intent_reason": ...}。
兜底:空 query 直接置 is_complete=True, error="用户查询为空";LLM 调用或 JSON 解析失败 → intent="default",走通用 ReAct;intent 不在映射表 → 也回退 default。
- 第三阶段父图传子图(intent_router->travel_wrapper_node)
intent_router路由(conditonal_edge),读 active_subgraph == "travel_agent",路由到 travel_wrapper。若此时 error 非空,直接去 error_fallback。
进入 wrapper 后,_travel_input_mapper函数把OrchestratorState 翻译成 TravelAgentState:
bash
TravelAgentState = {
"query": "帮我制定一个计划:...", # ← user_query 重命名
"user_id": 12345, # ← 原样映射
"context": {"intent_reason": ...}, # ← 父图 context 整个传入
"intent": "", # ← 待 analyzer 填充
"final_answer": "",
}
- 第四阶段子图意图识别分发
travel_agent内部analyzer_node节点,原本也是想要启动一个轻量llm进行意图识别的,正如流程图所画,但考虑到成本以及时间损耗,但判断只有基础范式如planandact与react范式,硬编码的语法规则即可
关键词规则分类:query 中含"计划/航班/酒店/book"等词 → 返回 {"intent": "itinerary"}。intent_router 据此路由到 planact_wrapper(而不是 react_wrapper)
- 第五阶段子图传孙子图
调用节点内部_planact_input_mapper方法(其实是通过工厂函数,为react和planact都创建了),把TravelAgentState 翻译入PlanActState
csharp
  PlanActState = {
       "query": "帮我制定一个计划:...\n[上下文信息] ...",  # 若有 last_answer 会拼接增强
       "plan_steps": [],            # ← 待 PlanNode 生成
       "current_step_index": 0,
       "step_results": [],          # ← Annotated[list, operator_add],每步结果"追加"
       "final_answer": "",
   }
//注意step_results 用了 Annotated[list[str], operator_add]------LangGraph 合并状态时对列表做追加而不是覆盖,这是 Plan-Act 循环能逐步累积结果的关键- 第六阶段planact孙子图每步信息存入
注意: planact外面应该也是也有一个循环的,这点与react有共同的地方,说到底这两个范式更多的还是提示词不同导致的思考方式不一样而已(react再与不断自省给出自认为最完美的答案,planact则侧重于给出一套完成的计划书然后一步步完成),在这里理应实在孙子图内部循环的,但上面的流程图我画成了外部的循环
- 用采取LLM + PLAN_SYSTEM_PROMPT 要求输出 JSON 步骤数组。例如: "搜索从 BOS 到 JFK 的航班", "预订 McKittrick Hotel"
- 返回 {"plan_steps": ..., "current_step_index": 0} → 合并进 PlanActState。
- 内部循环ExecuteNode ⇄ route_execute:逐步执行并追加结果:
取当前步骤 stepsidx,把之前所有步骤的结果格式化成 prev_results 文本(这就是步骤间依赖的数据通道------第二步预订酒店时能看到第一步搜到的航班信息)
用 EXECUTE_STEP_PROMPT 调 LLM(绑定了 ToolRegistry 里的全部工具);LLM 可决定直接回答或发起 tool_calls
工具执行兜底:每个 tool_call 单独 try/except------工具抛异常 → 结果记为 工具名 => 错误: xxx;工具不存在 → 记为 工具未找到。这些错误文本照样追加进结果,流程不中断
返回 {"step_results": 本步结果, "current_step_index": idx + 1}。由于 operator_add,step_results 变成 结果1, 结果2, ...,索引与 plan_steps 一一对应。
- route_execute 判断 idx < len(plan_steps):还有步骤 → 回到 ExecuteNode;否则 → SynthesizeNode。
最终得到的 PlanActState示例应该如下:
bash
  {
       "query": "...",
       "plan_steps": ["搜索从 BOS 到 JFK 的航班", "预订 McKittrick Hotel"],
       "current_step_index": 2,          # 已执行完
       "step_results": ["[search] => 找到 3 个航班...", "[book] => 预订成功..."],
       "final_answer": "针对您的请求...(完整行程答案)",
   }
3.1.2上行链路详解
上行链路(Pattern 子图 → Domain Agent → 父图)
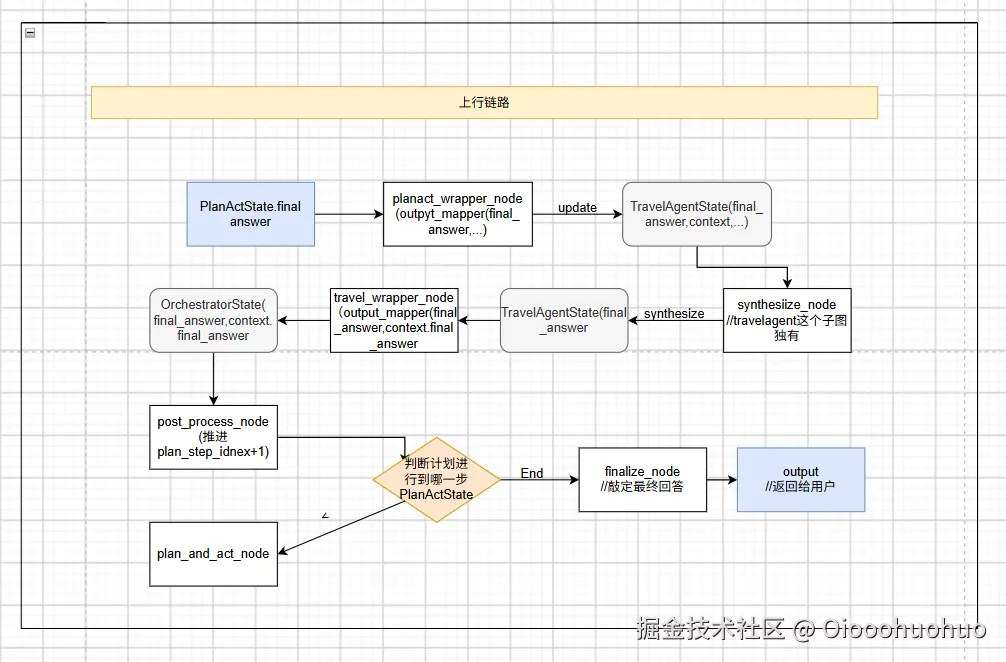
文字详解:
- 第七阶段孙子图向子图更新状态(PlanActState->TravelAgentState)
子图中_planact_output_mapper方法函数,sub_result"final_answer" 非空 → updates"final_answer" = 答案(透传)(sub_result也是一个公共的state)
python
     def _planact_output_mapper(sub_result: dict, agent_state: dict) -> dict:
         updates: dict = {}
         if sub_result.get("final_answer"):
             updates["final_answer"] = sub_result["final_answer"]
         merged_ctx = dict(agent_state.get("context", {}))
         merged_ctx.update({
             "last_answer": sub_result.get("final_answer", ""),
             "planact_steps": sub_result.get("plan_steps", []),
             "planact_results": sub_result.get("step_results", []),
         })
         updates["context"] = merged_ctx
         return updates
注意合并技巧:merged_ctx = dict(agent_state.get("context", {})) 先拷贝旧的,再 update------增量合并,不丢历史键(比如之前的 intent_reason 还在)
TravelAgentState 更新后:final_answer 有值,context 里多了 last_answer / planact_steps / planact_results
- 第八阶段子图(domainagent)出口兜底
final = state.get("final_answer", "") if not final: final = state.get("context", {}).get("last_answer", "旅游助手已处理您的请求,但未产生明确输出。") 三层兜底链:final_answer → context"last_answer" → 固定友好文案。即使孙子图什么也没产出,travel_agent 也能带着一个非空答案正常 END,不会把异常抛给父图
- 第九阶段子图向父图更新状态(TravelAgentState -> OrchestratorState)
_travel_output_mapper方法函数处理final_answer 非空 → 写入父图 updates"final_answer",合并父图 context:{"last_answer": ..., "domain": "travel"}, wrapper 注入 active_subgraph = "travel_agent"
- 第十阶段总结review并finalize
- review_node 按优先级检查 context 信号: • needs_reroute → review_decision="reroute"(把 reroute_reason 写回 context); • error 非空 → reroute(同时清空 error,给重调度一次机会); • quality_score < 5 → reroute; • needs_clarification → review_decision="clarify",直接把澄清文案写入 final_answer 并 is_complete=True; • 都没有 → continue。
- route_completion 消费决策:clarify 或 is_complete → finalize;reroute 或还有 plan 步骤 → 回到 intent_router(重新进 orchestrator,此时 orchestrator 会读到 context 里的 reroute_reason/last_answer 精准的二次分发------这就是"扩展点B"的反馈闭环)。
- finalize_node:final_answer 有值就透传,没有就从 context"last_answer" 兜底,再不行给 "处理完成,但未产生输出。",置 is_complete=True。 最终 main 打印 result"final_answer" 给用户
4.动态路由以及query分发
动态分发的实现 //我以为啥呢,就是调用chatopenai调用了一次llm结构化输出 • orchestrator_node 不再使用硬编码关键词规则,而是调用 ChatOpenAI(qwen3-max,temperature=0.0)进行语义理解。 • LLM 根据 user_query 内容输出 JSON 格式的意图分类: {"intent": "travel_agent", "reason": "用户请求预订航班和酒店", "plan_summary": "..."} • 父图解析该 JSON,将 intent 映射为 active_subgraph,并生成对应的 plan。
动态性的优势:
arduino
1. 语义理解:能处理模糊、多义或跨领域请求(如"帮我写个爬虫抓机票价格"会被 LLM 识别为 coding_agent,而关键词规则可能误判)
2. 扩展友好:新增 Domain Agent 时,只需修改 _INTENT_SYSTEM_PROMPT 中的可选列表和 intent_router 的路由表,无需改动复杂的规
引擎。
3. 兜底降级:若 LLM 调用失败或返回格式异常,orchestrator_node 自动捕获异常,回退到 default(通用 ReAct),保证系统可用性
静态部分
intent_router 本身仍是基于 active_subgraph 字符串的静态路由表,但决策权已交给 LLM,因此整体分发流程是动态的。5.通信
通信无论在哪个地方都不可不论不重要,单agent考虑的不多,撑死就是记忆的上下文和工具指令
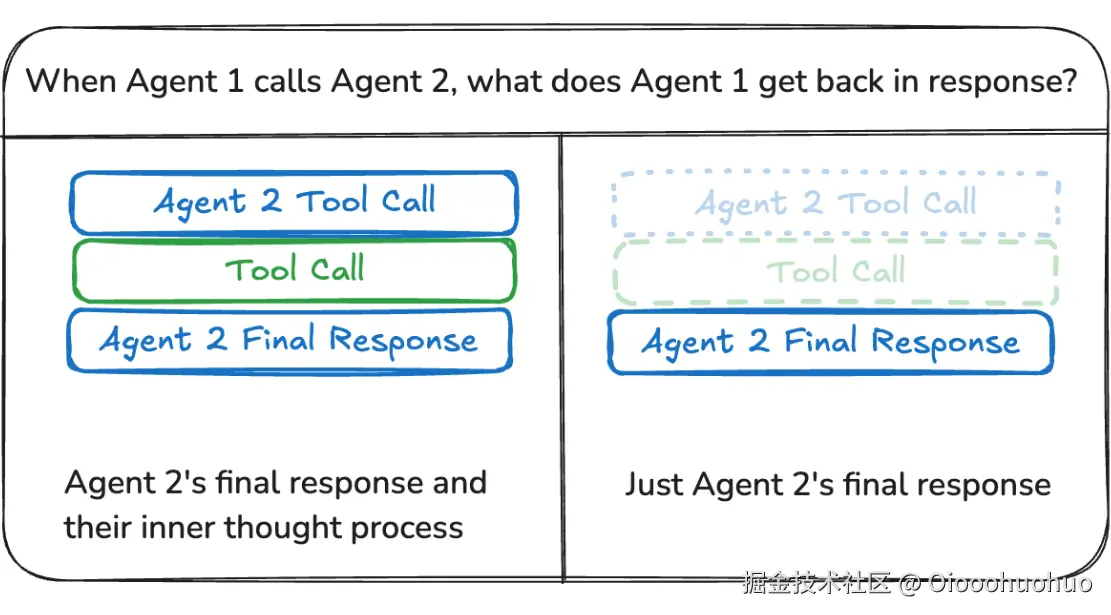
在multi-agent中通信更是重中之重,在官方文档中大概能总结出两套通信架构的选择:
共享完整思维过程
代理可以与所有其他代理共享其思维过程的完整历史 (即,"草稿本")。这个"草稿本"通常看起来像一个消息列表。共享完整思维过程的好处是,它可能帮助其他代理做出更好的决策,并提高整个系统的推理能力。缺点是,随着代理数量和复杂性的增长,"草稿本"将迅速增长,可能需要额外的内存管理策略。
只共享最终结果
代理可以拥有自己的私有"草稿本",并且只与其余代理共享最终结果 。这种方法可能更适用于具有许多代理或更复杂的代理的系统。在这种情况下,你需要定义具有不同状态模式的代理。
对于作为工具调用的代理,主管根据工具模式确定输入。此外,LangGraph 允许在运行时将状态传递给单个工具,因此下属代理可以在需要时访问父状态。
在消息中指示代理名称
在消息中指示特定 AI 消息来自哪个代理会很有帮助,特别是对于冗长的消息历史。一些 LLM 提供商(如 OpenAI)支持向消息添加
name参数------你可以使用它将代理名称附加到消息中。如果不支持,你可以考虑手动将代理名称注入到消息内容中,例如,<agent>alice</agent><message>来自 alice 的消息</message>。
官方图解:
5.1共享转态(黑板架构的引入)
Blackboard Architecture
黑板架构 = 共享状态(context 就是黑板)
所有 Agent 都不互相说话,只往黑板上写 / 读。
-_-电脑意外关机重启了没招了(幸好typora能找回吓死我了),不知道我的thinkbook最近怎么回事,之前还意外触发电源保护都开不了机
原文章地址:黑板架构模式详解:原理、应用与C++实现-CSDN博客(如介意请联系我删除)
黑板架构图案例如下:
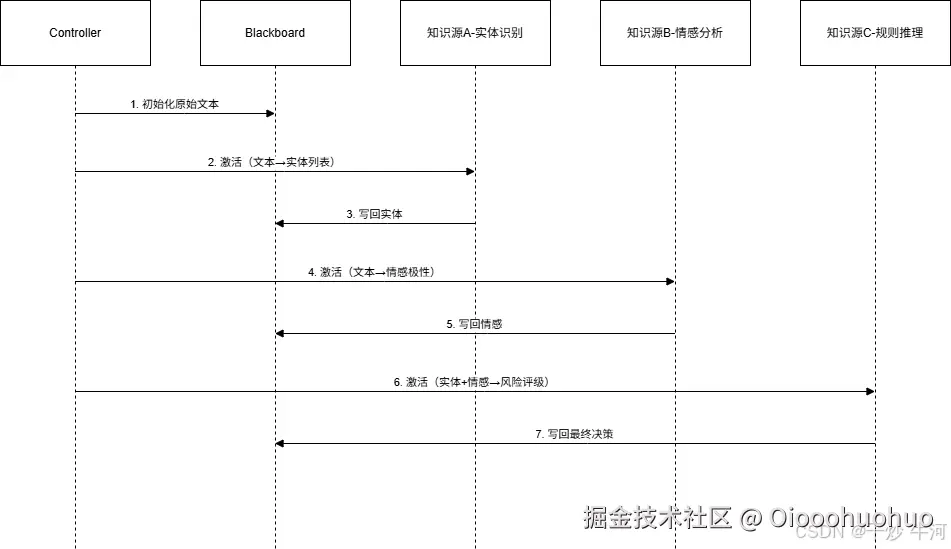
利用数据库:利用数据库充当黑板,不同的应用共享数据库信息,并且可以更新数据信息。这也是最常见的实现方式。
利用发布-订阅模式:这种实现方式通常采用消息队列作为黑板,队列工作在主题模式,专家作为队列的订阅者,同事可以向队列发送消息,消息会被发送至所有订阅者。以上过程实现了专家间的信息交流。
//这个架构思想同样可以运用到agent开发上,最早是在哪出处的我已经找不到原文了
这种感觉就像是定义一个"全局变量"(这是相对于所有的agent来说的),然后大家都可以看到这个全局变量中所有的内容,然后在插入信息加入自己的role比如可以是这样的dict contexts:dictagent_role,dict={},value值完全就子agent的所有message
5.2转态转换
每一层都有完全独立的私有 Schema,父图对子图 Schema 不可见。
| 层级 | Schema 状态类 | 定义文件路径 |
|---|---|---|
| 父图 | OrchestratorState | subgraphs/base/types.py |
| Travel Agent | TravelAgentState | subgraphs/agents/travel_agent.py |
| Coding Agent | CodingAgentState | subgraphs/agents/coding_agent.py |
| RAG Agent | RagAgentState | subgraphs/agents/rag_agent.py |
| ReAct Pattern | ReactState | subgraphs/patterns/react.py |
| PlanAct Pattern | PlanActState | subgraphs/patterns/plan_act.py |
wrappers.py 中的注释(第 7-11 行)明确解释了为什么不用 LangGraph 原生子图挂载:
"原生挂载会强制共享父图 State Schema,子图必须与父图状态字段兼容。生产环境中子图需要独立演化,不能因父图新增字段而被污染。" 因此每个 Domain Agent 和 Pattern 子图都有自己的 TypedDict,字段完全不同。例如: • ReactState 有 messages, tools, retries, is_passed • PlanActState 有 plan_steps, current_step_index, step_results • 这些字段在父图 OrchestratorState 中根本不存在。
5.3小总结
通信方式:不是纯粹黑板架构,而是"显式状态流转 + 受控共享区"(这点跟swarm架构并不完全一致) 这个系统核心用的是 显式状态转换管道,而不是黑板式的全共享状态。 关键在 subgraphs/base/wrappers.py(第 17-81 行):
python
   def subgraph_invoker_factory(subgraph, input_mapper, output_mapper, ...):
       def _invoke_node(parent_state):
           # Step 1: 父图状态 → 子图私有输入(显式裁剪)
           subgraph_input = input_mapper(parent_state)
           # Step 2: 子图在完全隔离的状态空间中运行
           subgraph_result = subgraph.invoke(subgraph_input)
           # Step 3: 子图结果 → 父图状态更新(显式映射)
           return output_mapper(subgraph_result, parent_state)
三层状态严格隔离: • 父图:OrchestratorState(session_id, user_query, active_subgraph, context...) • 中间层 Domain Agent:TravelAgentState / CodingAgentState / RagAgentState • 底层 Pattern:ReactState / PlanActState 每层之间不共享状态对象,全靠 input_mapper / output_mapper 做显式数据搬运。这是生产级架构中典型的 "状态隔离 + 契约转换模式,目的是让子图可以独立演化而不污染父图。但确实有一个受控共享区:OrchestratorState 中的 context 字段(见 types.py 第 35 行注释)。子图可以通过 output_mapper 把结果写入 context,后续子图通过 input_mapper 从 context 读取。这是一种间接的、受父图中介的数据传递,有黑板的味道,但读写都经过显式映射控制,不是任意节点直接读写同一块黑板。
6.详细代码说明
顺序按从孙子图->子图(子agent)->父图
项目结构如下
dart
   一、项目整体结构
   multi_agent/
   ├── subgraphs/                    ← 核心子图模块(三层架构的实现层)
   │   ├── base/                     ← 基础设施层:状态契约、包装工厂、父图节点
   │   │   ├── types.py              OrchestratorState + SubgraphResult
   │   │   ├── wrappers.py           subgraph_invoker_factory(跨层状态隔离器)
   │   │   └── nodes.py              父图编排节点(orchestrator / post_process / review / finalize)
   │   ├── agents/                   ← 中间层:领域 Agent 子图(Domain Agent)
   │   │   ├── travel_agent.py       旅游领域 Agent(内部再嵌套 Pattern)
   │   │   ├── coding_agent.py       编程领域 Agent(内部再嵌套 Pattern)
   │   │   └── rag_agent.py          RAG 专门 Agent(独立两阶段流程)
   │   ├── patterns/                 ← 最底层:通用范式子图(孙子图 / Pattern)
   │   │   ├── react.py              ReAct 五节点循环(Reason-Action-Observe-Generate-Reflect)
   │   │   └── plan_act.py           Plan-and-Act(先规划再顺序执行)
   │   └── tools/                    ← 工具注册中心(解耦工具定义与 Agent 范式)
   │       └── registry.py           ToolRegistry + 预置 Mock 工具
   │
   └── case_production.py            ← 父图编排入口:三层子图的组装与注册
   //另外三个文件都是测试用例
6.1工具注册中心
工具注册中心(tools/registry.py) 这是最先就绪的基础设施,被所有 Pattern 子图依赖。
registry.py 在模块加载时就完成了初始化
_registry = get_registry()
@_registry.register("search") def mock_search(query: str) -> str: ... 作用:子图(如 ReAct)不直接依赖工具实现,而是通过 tool_names="search", "book_flight" 声明依赖,运行时由 registry.re solve(tool_names) 解析为真实可调用对象。这样工具可以 Mock ↔ 真实 API 热替换。
//等我去沉淀一下
写在最前面总结一下,此套注册函数还是对langchain_core的tool方法的二次包装,通过tool方法注册(在此文件中名字改为langchain_tool)
类实例的定义及创建:
python
     def __new__(cls):
         if cls._instance is None:
             cls._instance = super().__new__(cls)
             #此处用法是调用super()方法调用父类方法创建一个实例对象
             cls._instance._tools: dict[str, Callable] = {}
             #callable提示tools应该是可调用对象(函数,方法,工具类)
         return cls._instance
python
def register(self, name: str, fn: Callable, description: str | None = None) -> Callable:
"""注册一个工具
Args:
name: 工具唯一标识名(子图通过此名称引用工具)
fn: 工具函数
description: 工具描述(用于 LLM 理解何时调用此工具)
Returns:
传入的 fn(支持装饰器写法)
"""
# 如果是普通函数,用 langchain_tool 包装为标准 Tool 对象
if not hasattr(fn, "name"):
#hasattr是检测fn是否有name属性,因为在用langchain_tool构建了工具之后是会有一个name的属性的,没有则创建注册一个避免重复注册
fn = langchain_tool(name, description=description or fn.__doc__ or "")(fn)
#这个就很有意思,跟之前的用装饰器@tool def fn:xxxx一模一样的用法,等价吧
self._tools[name] = fn
#没啥好说的,把该单实例的注册进去,这咋不用append(dict的增加方法不是这个嘛),/没啥好说的key:name value:fn
return fn一些可用的自定义方法:
python
def get(self, name: str) -> Callable:
"""根据名称获取工具实例
Args:
name: 工具名
Returns:
工具实例
Raises:
KeyError: 工具未注册
"""
if name not in self._tools:
raise KeyError(f"工具 '{name}' 未注册。已注册工具: {list(self._tools.keys())}")
return self._tools[name]
def resolve(self, names: list[str]) -> list[Callable]:
"""批量解析工具名列表为工具实例列表
这是子图在构建时调用的核心方法:
tools = registry.resolve(["search", "book_flight"])
"""
return [self.get(n) for n in names]
def list_tools(self) -> list[str]:
"""列出所有已注册的工具名"""
return list(self._tools.keys())定义方法获取单实例:
python
def get_registry() -> ToolRegistry:
"""获取工具注册中心单例"""
return ToolRegistry()
#没啥好说的之前定义的class类名字叫ToolRegistry
#有一点很重要的装饰器用法,对于@_registry.register(假设_registry是执行def_registry()方法后的实例)这个register方法就是实例中的方法,具体你会看到原来的方法中是要求显示传参为fn的对象,但这里没有,其实此装饰器的用法完全等价于mock_search = _registry.register("search", "联网搜索", mock_search)//是不是写的太详细了
funtion_calling/tool_calls结构:
ruby
{
"id": "call_12345", # tool_call_id:这次工具调用的唯一标识
"name": "search_docs", # 工具名字,用来匹配我们注册的 @tool
"args": {"keyword": "LangGraph", "limit": 5} # tool_args:工具函数的入参
}
6.2孙子图(pattern子图)
孙子图也是这三层架构中最低层的,在此案例中目前只展现react,plan and act范式的子图,对于真实项目中,子agent可调用切换,复用的都可以解耦成子图,比如上个项目中with_rag我把它注册成了一个工具函数,但完全可以当成孙子图,在缓解工具调用压力的同时,一些子agent完全用不到rag,就可以不用改sub_graph,然后某个专职调用知识库的可以直接用这套子图,流程高内聚吧。
6.2.1React
这个react孙子图就是上个项目的单agent的核心思考架构
ai的流程图,将就着看吧,一些细节不对
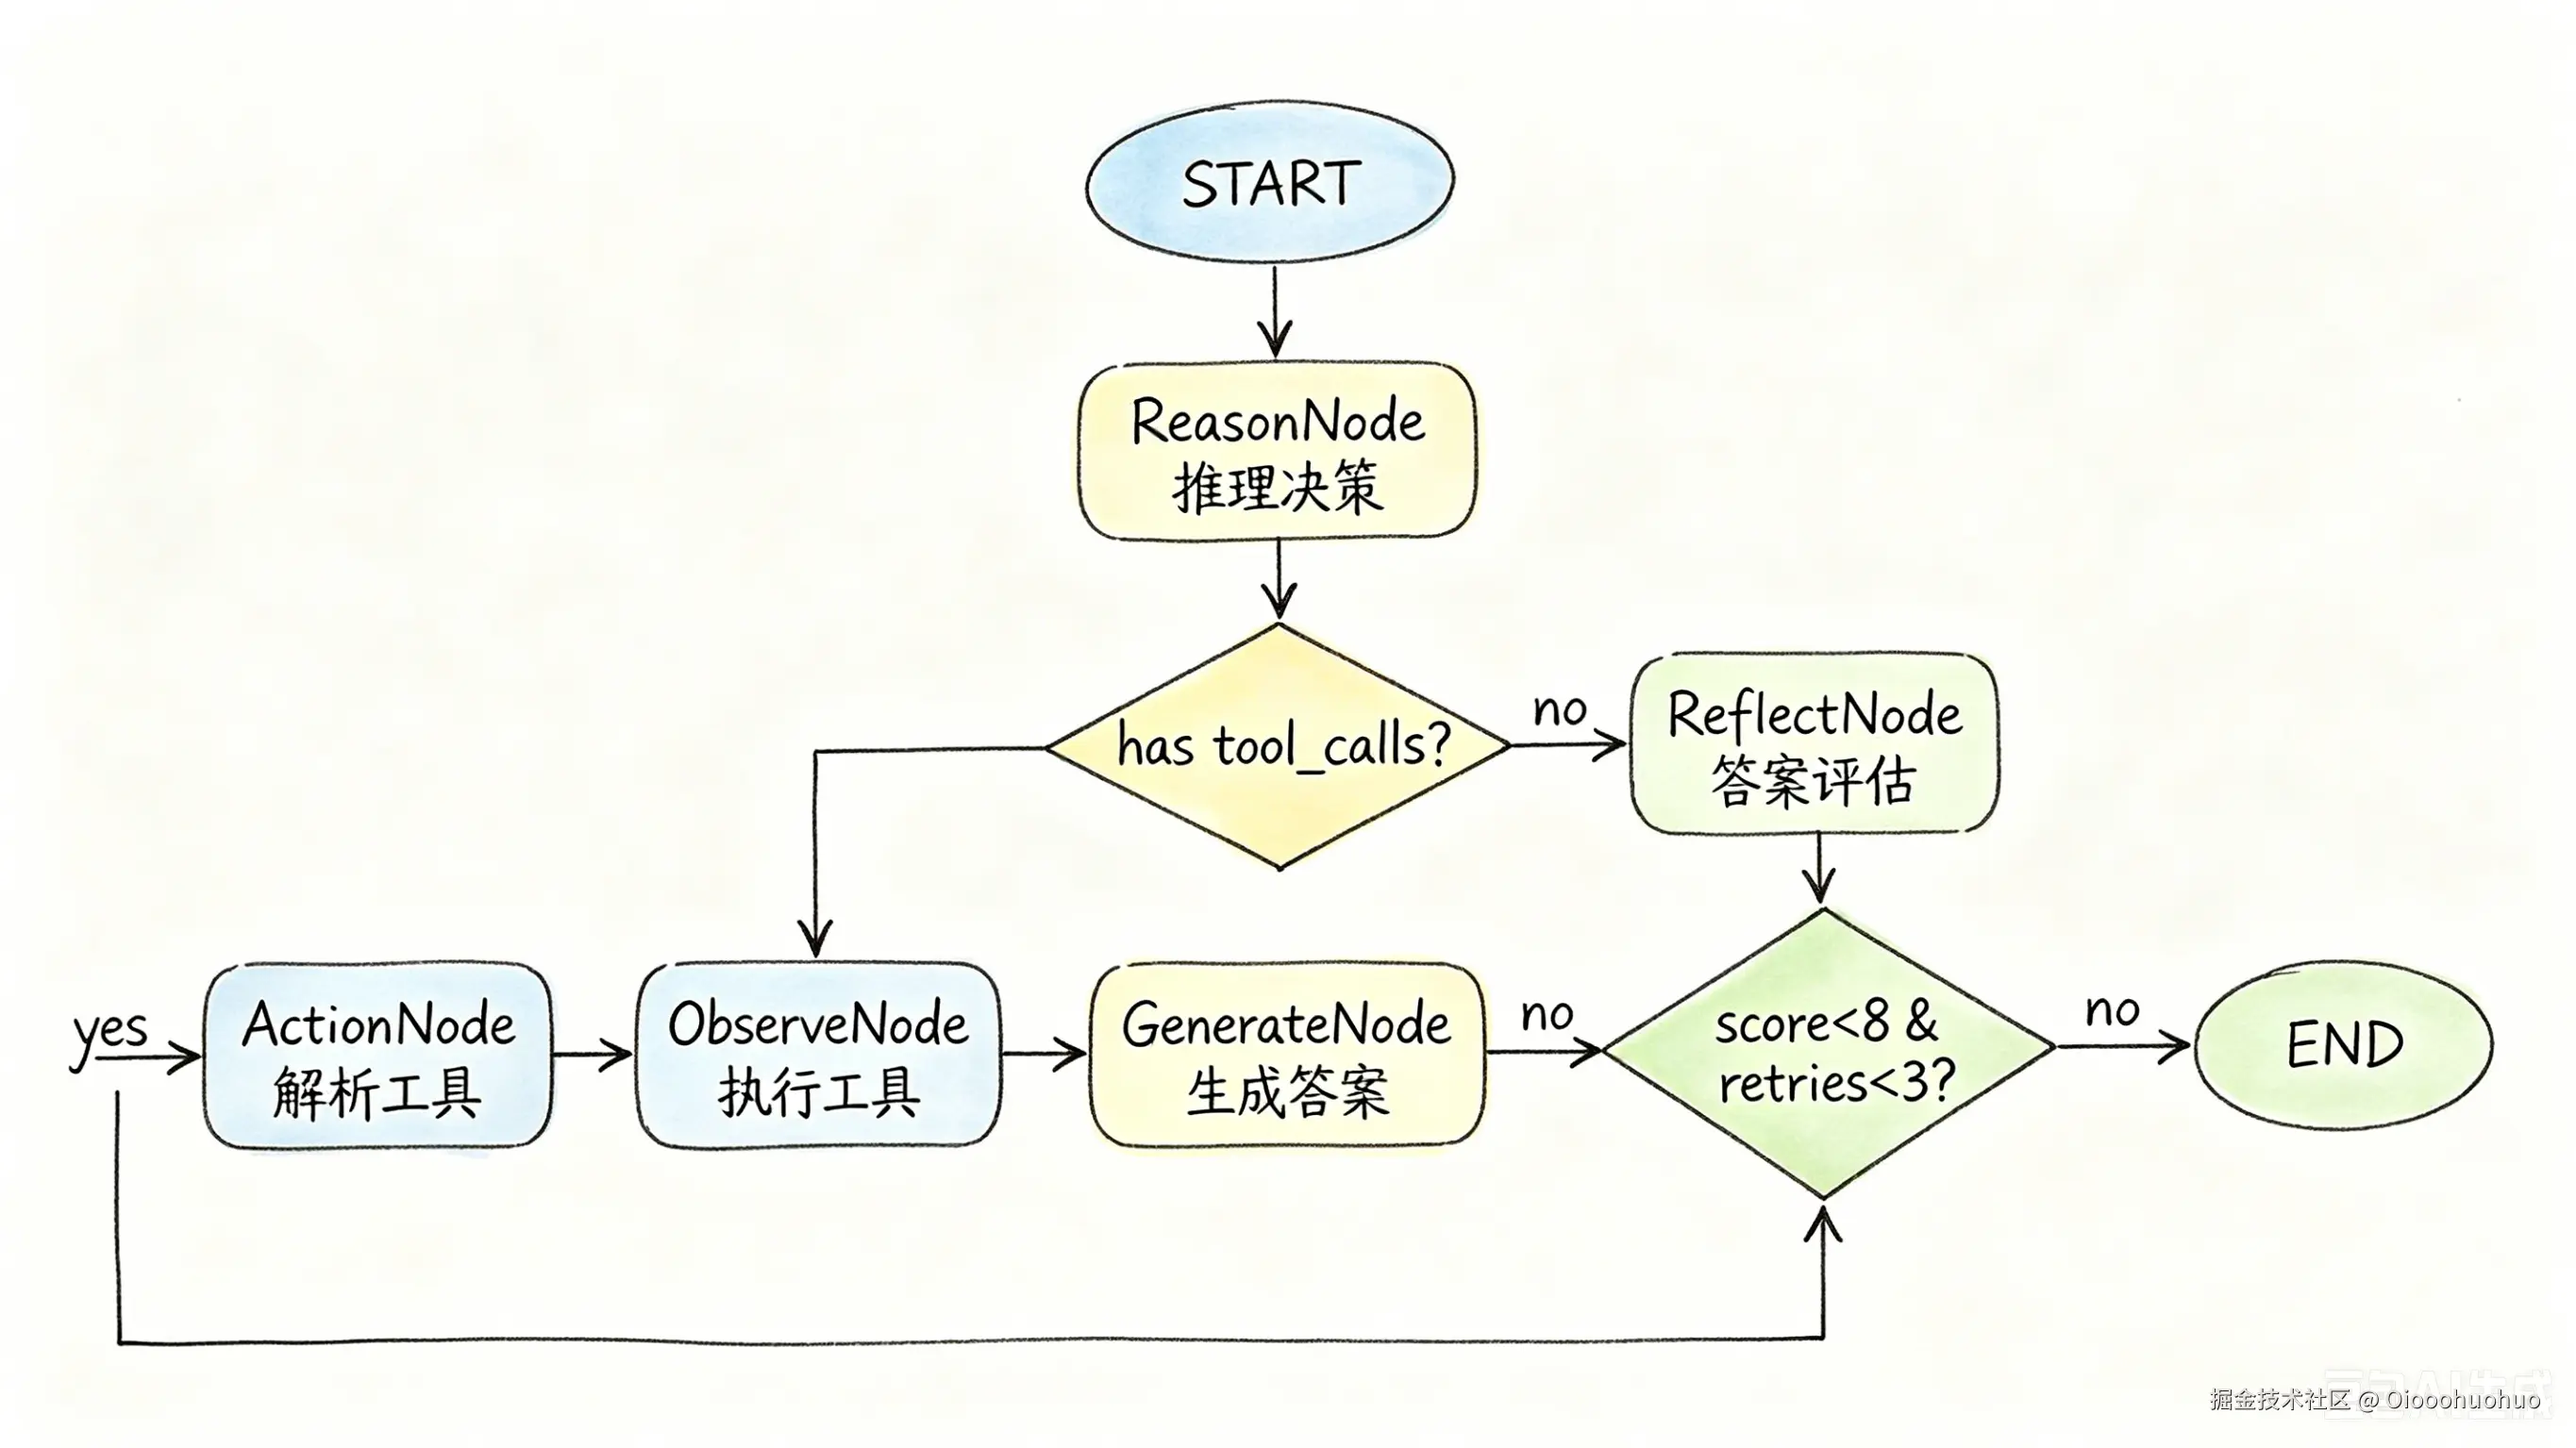
孙子图私有schema,所以子agent也无需管这套react+reflect里面是咋跑的
python
class ReactState(TypedDict):
"""ReAct 子图私有状态 --- 父图不可直接访问
字段说明:
- query: 用户查询(从父图 user_query 映射而来)//真的假的,为毛要从父图的query映射过来
- messages: 子图内部消息历史(含系统提示、用户输入、LLM 推理、工具结果、反思反馈)
- tools: 本次执行需要的工具名列表(由父图通过 input_mapper 传入)
- retries: 当前重试次数(Reflect 触发重试时递增)
- final_answer: 经过 Generate 节点生成的最终答案
- is_passed: Reflect 评分是否通过(>= 8 分)
"""
query: str
messages: Annotated[list[BaseMessage], add_messages]
#自定义 TypedDict 作为状态模式,用 Annotated 显式声明每个字段的归约策略
#这个是langgraph提供的消息合并reducer归并器下面会再详细介绍,当节点返回{"message":[AIMessage(...)]}时不会覆盖旧列表,而是追加到state["message"]中,详细用法见下
tools: list[str]
retries: int
final_answer: str
is_passed: boolLanggraph add_messages归并器用法:(关于这个的用法可以参考这一系列文章:【LangGraph新手村系列】(2)自定义状态与归约器:让 LangGraph 记住更多东西从 MessagesSta - 掘金)不过它的开篇出把它的数据管道叫状态流转,虽然他后面补充了黑板state的改变
python
#官方定义
from langgraph.graph import add_messages
from typing import Union, List, Optional
from langchain_core.messages import BaseMessage
from langchain_core.runnables import RunnableConfig
def add_messages(
left: Union[List[BaseMessage], BaseMessage, str, None],
right: Union[List[BaseMessage], BaseMessage, str, None],
config: Optional[RunnableConfig] = None
) -> List[BaseMessage]:
...
left:
类型:UnionList\[BaseMessage, BaseMessage, str, None] 描述:当前状态中的消息,通常是状态中的消息列表(ListBaseMessage)或单个消息。 用途:表示现有的消息历史或初始状态。 示例:HumanMessage(content="Hello") 或 None(空状态)。 right:
类型:UnionList\[BaseMessage, BaseMessage, str, None] 描述:新传入的消息,通常是节点函数的输出或用户输入。 用途:表示需要追加或合并到 left 的消息。 示例:AIMessage(content="Hi!") 或 "New message"(自动转换为 HumanMessage)。 config:
类型:OptionalRunnableConfig 描述:运行时配置,包含 configurable 字段(如 thread_id、user_id),通常由 LangGraph 自动传递。 用途:支持上下文相关的消息处理(目前主要用于扩展,未广泛使用)。 示例:{"configurable": {"user_id": "user123"}}。
参考文章【LangGraph】langgraph.graph.add_messages() 函数:处理和更新消息列表_langgraph messages-CSDN博客
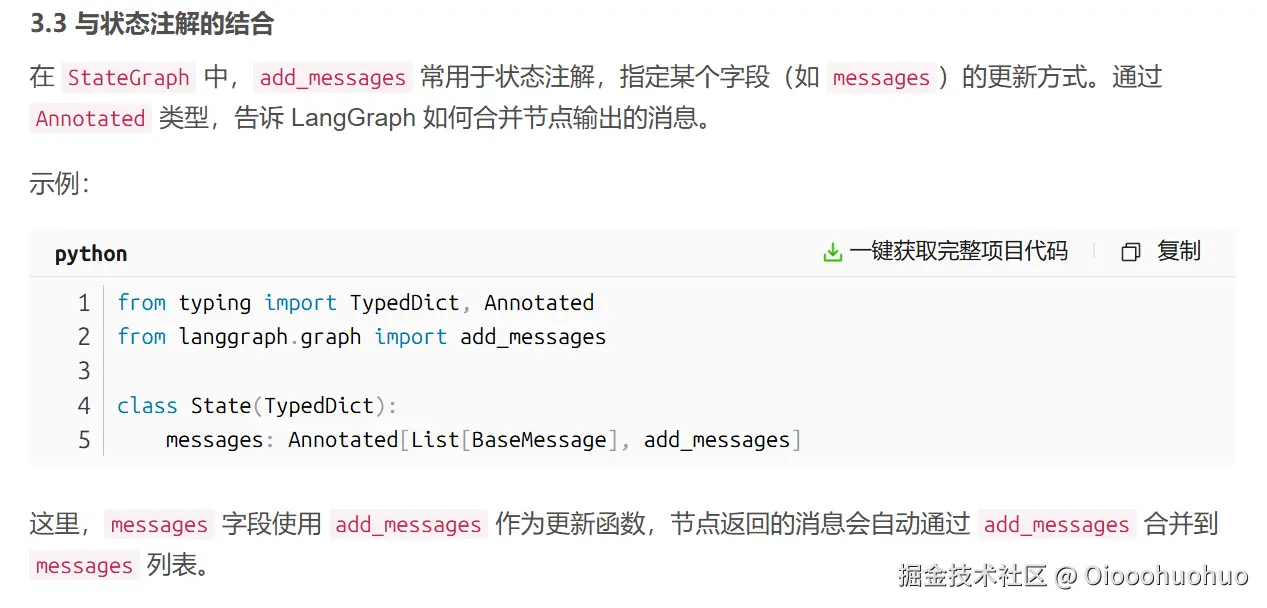
在这就挑最核心的节点讲:
python
async def observe_node(state: ReactState):
"""观察节点:执行工具调用,获取返回结果
遍历最后一条 AI 消息中的 tool_calls,逐一调用对应工具,
生成 ToolMessage 追加到 messages 中。
"""
last_msg = state["messages"][-1]
#在reason_node中处理最开始的humanmassage追加之后//?这个有吗,这个好像不是原始query。的aimessage里面自动包含了tool_calls原生返回的字段,是模型自带的,function_calling
if not hasattr(last_msg, "tool_calls") or not last_msg.tool_calls:
return {}
tool_messages = []
for tool_call in last_msg.tool_calls:
tool_name = tool_call["name"]
#框架的确是做了结构化扁平化的处理,单独把function输出去掉了
tool_args = tool_call.get("args", {})
tool_id = tool_call["id"]
tool = next((t for t in tool_instances if getattr(t, "name", None) == tool_name), None)
#从注册的所有工具数组中找到llm的function_call的工具名字
if tool:
try:
result = await tool.ainvoke(tool_args)
tool_messages.append(
ToolMessage(content=str(result), tool_call_id=tool_id, name=tool_name)
#直接结构化langchain的标准工具消息类型如下:
#content=str(result), # 工具返回结果
#tool_call_id=tool_id, # 必须对应 AI 生成的 tool_call id
#name=tool_name # 工具名
)
except Exception as e:
tool_messages.append(
ToolMessage(content=f"执行工具出错: {str(e)}", tool_call_id=tool_id, name=tool_name)
)
else:
tool_messages.append(
ToolMessage(content=f"工具 {tool_name} 不存在", tool_call_id=tool_id, name=tool_name)
)
return {"messages": tool_messages}
#这个return相当重要,因为在langgraph中图的state是不能改变的,所以append,push是不行的,但由于用来add_messages可以自动追加这些信息而不会覆盖,然后不显示写的默认是right,意思就是追加到最后
#一些文档中可能会这么写
#return {**state,"message":tool_messages}.这是因为再没有reducer情况下不会自动将旧值合并到当前state中,等于覆盖吧。当然如果有Annotated[dict[],add_messages]这样的reducer(add_messadges/opeerator_add(operator库中的add方法)),反而使用**state后会把旧值再次追加一遍AImessage实例返回的json数据:
json
 {
   "role": "assistant",
   "content": null,
   "tool_calls": [
     {
       "id": "call_123",
       "type": "function",
       "function": {
         "name": "get_weather",
         "arguments": "{"city":"北京"}"
       }
     }
   ]
 }
python
class ToolRegistry:
"""工具注册中心:单例模式管理所有可用工具"""
_instance = None
_tools:dict[str,Callable]={} #类变量全局共享
def __new__(cls):
if cls._instance is None:
cls._instance = super().__new__(cls)
# cls._instance._tools: dict[str, Callable] = {}
return cls._instance
#这是之前按的注册中心的一个错误,我看了一下react的工厂函数代码发现它完全就是假单实例,工厂函数里注册的工具,其他实例化get_registry()不得要在工厂函数里重新写工具函数用来注册吗,现在把类变量变成全局共享,所以在register.py文件中注册的所有工具函数,其他的实例化之后都能看到了。工厂函数分析:
python
def build_react_subgraph(
model: str = "qwen3-max",
base_url: str = "https://dashscope.aliyuncs.com/compatible-mode/v1",
api_key: str | None = None,
tool_names: list[str] | None = None,
):
"""构建并编译 ReAct 五节点子图
Args:
model: LLM 模型标识
base_url: API 基础地址
api_key: API 密钥(默认从环境变量 OPENAI_API_KEY 读取)
tool_names: 子图可调用的工具名列表(从 ToolRegistry 解析)
Returns:
编译后的 CompiledStateGraph,可通过 subgraph.invoke(ReactState) 独立运行
"""
# 初始化 LLM
_api_key = api_key or os.environ.get("OPENAI_API_KEY", "sk-dummy")
llm = ChatOpenAI(
model=model,
api_key=_api_key,
base_url=base_url,
streaming=True,
)
# 从注册中心解析工具实例
registry = get_registry()
tool_names = tool_names or ["search", "rag_query"]
tool_instances = registry.resolve(tool_names)
#这个就是我说的重新实例化后并不能用resolve实现查找大模型所需要的工具
#还有一个问题就是子agent为啥要传tool_name进来,思考用什么工具本来就是孙子图干的活。我理解ai的想法是觉得把全部tool丢给孙子图会降低tool调用的正确率,但工程上解决这种方法多了
# 构建节点函数
nodes = _build_nodes(llm, tool_instances)
# 组装 StateGraph
builder = StateGraph(ReactState)
builder.add_node("ReasonNode", nodes["reason"])
builder.add_node("ActionNode", nodes["action"])
builder.add_node("ObserveNode", nodes["observe"])
builder.add_node("GenerateNode", nodes["generate"])
builder.add_node("ReflectNode", nodes["reflect"])
# 定义边与条件路由
builder.add_edge(START, "ReasonNode")
builder.add_conditional_edges("ReasonNode", nodes["route_reason"], {
"ActionNode": "ActionNode",
"ReflectNode": "ReflectNode",
})
builder.add_edge("ActionNode", "ObserveNode")
builder.add_edge("ObserveNode", "GenerateNode")
builder.add_edge("GenerateNode", "ReflectNode")
builder.add_conditional_edges("ReflectNode", nodes["route_reflect"], {
"ReasonNode": "ReasonNode",
END: END,
})
return builder.compile()6.2.2Plan-and-Act
这个跟React也大差不差
下图是简单的plan act流程图:
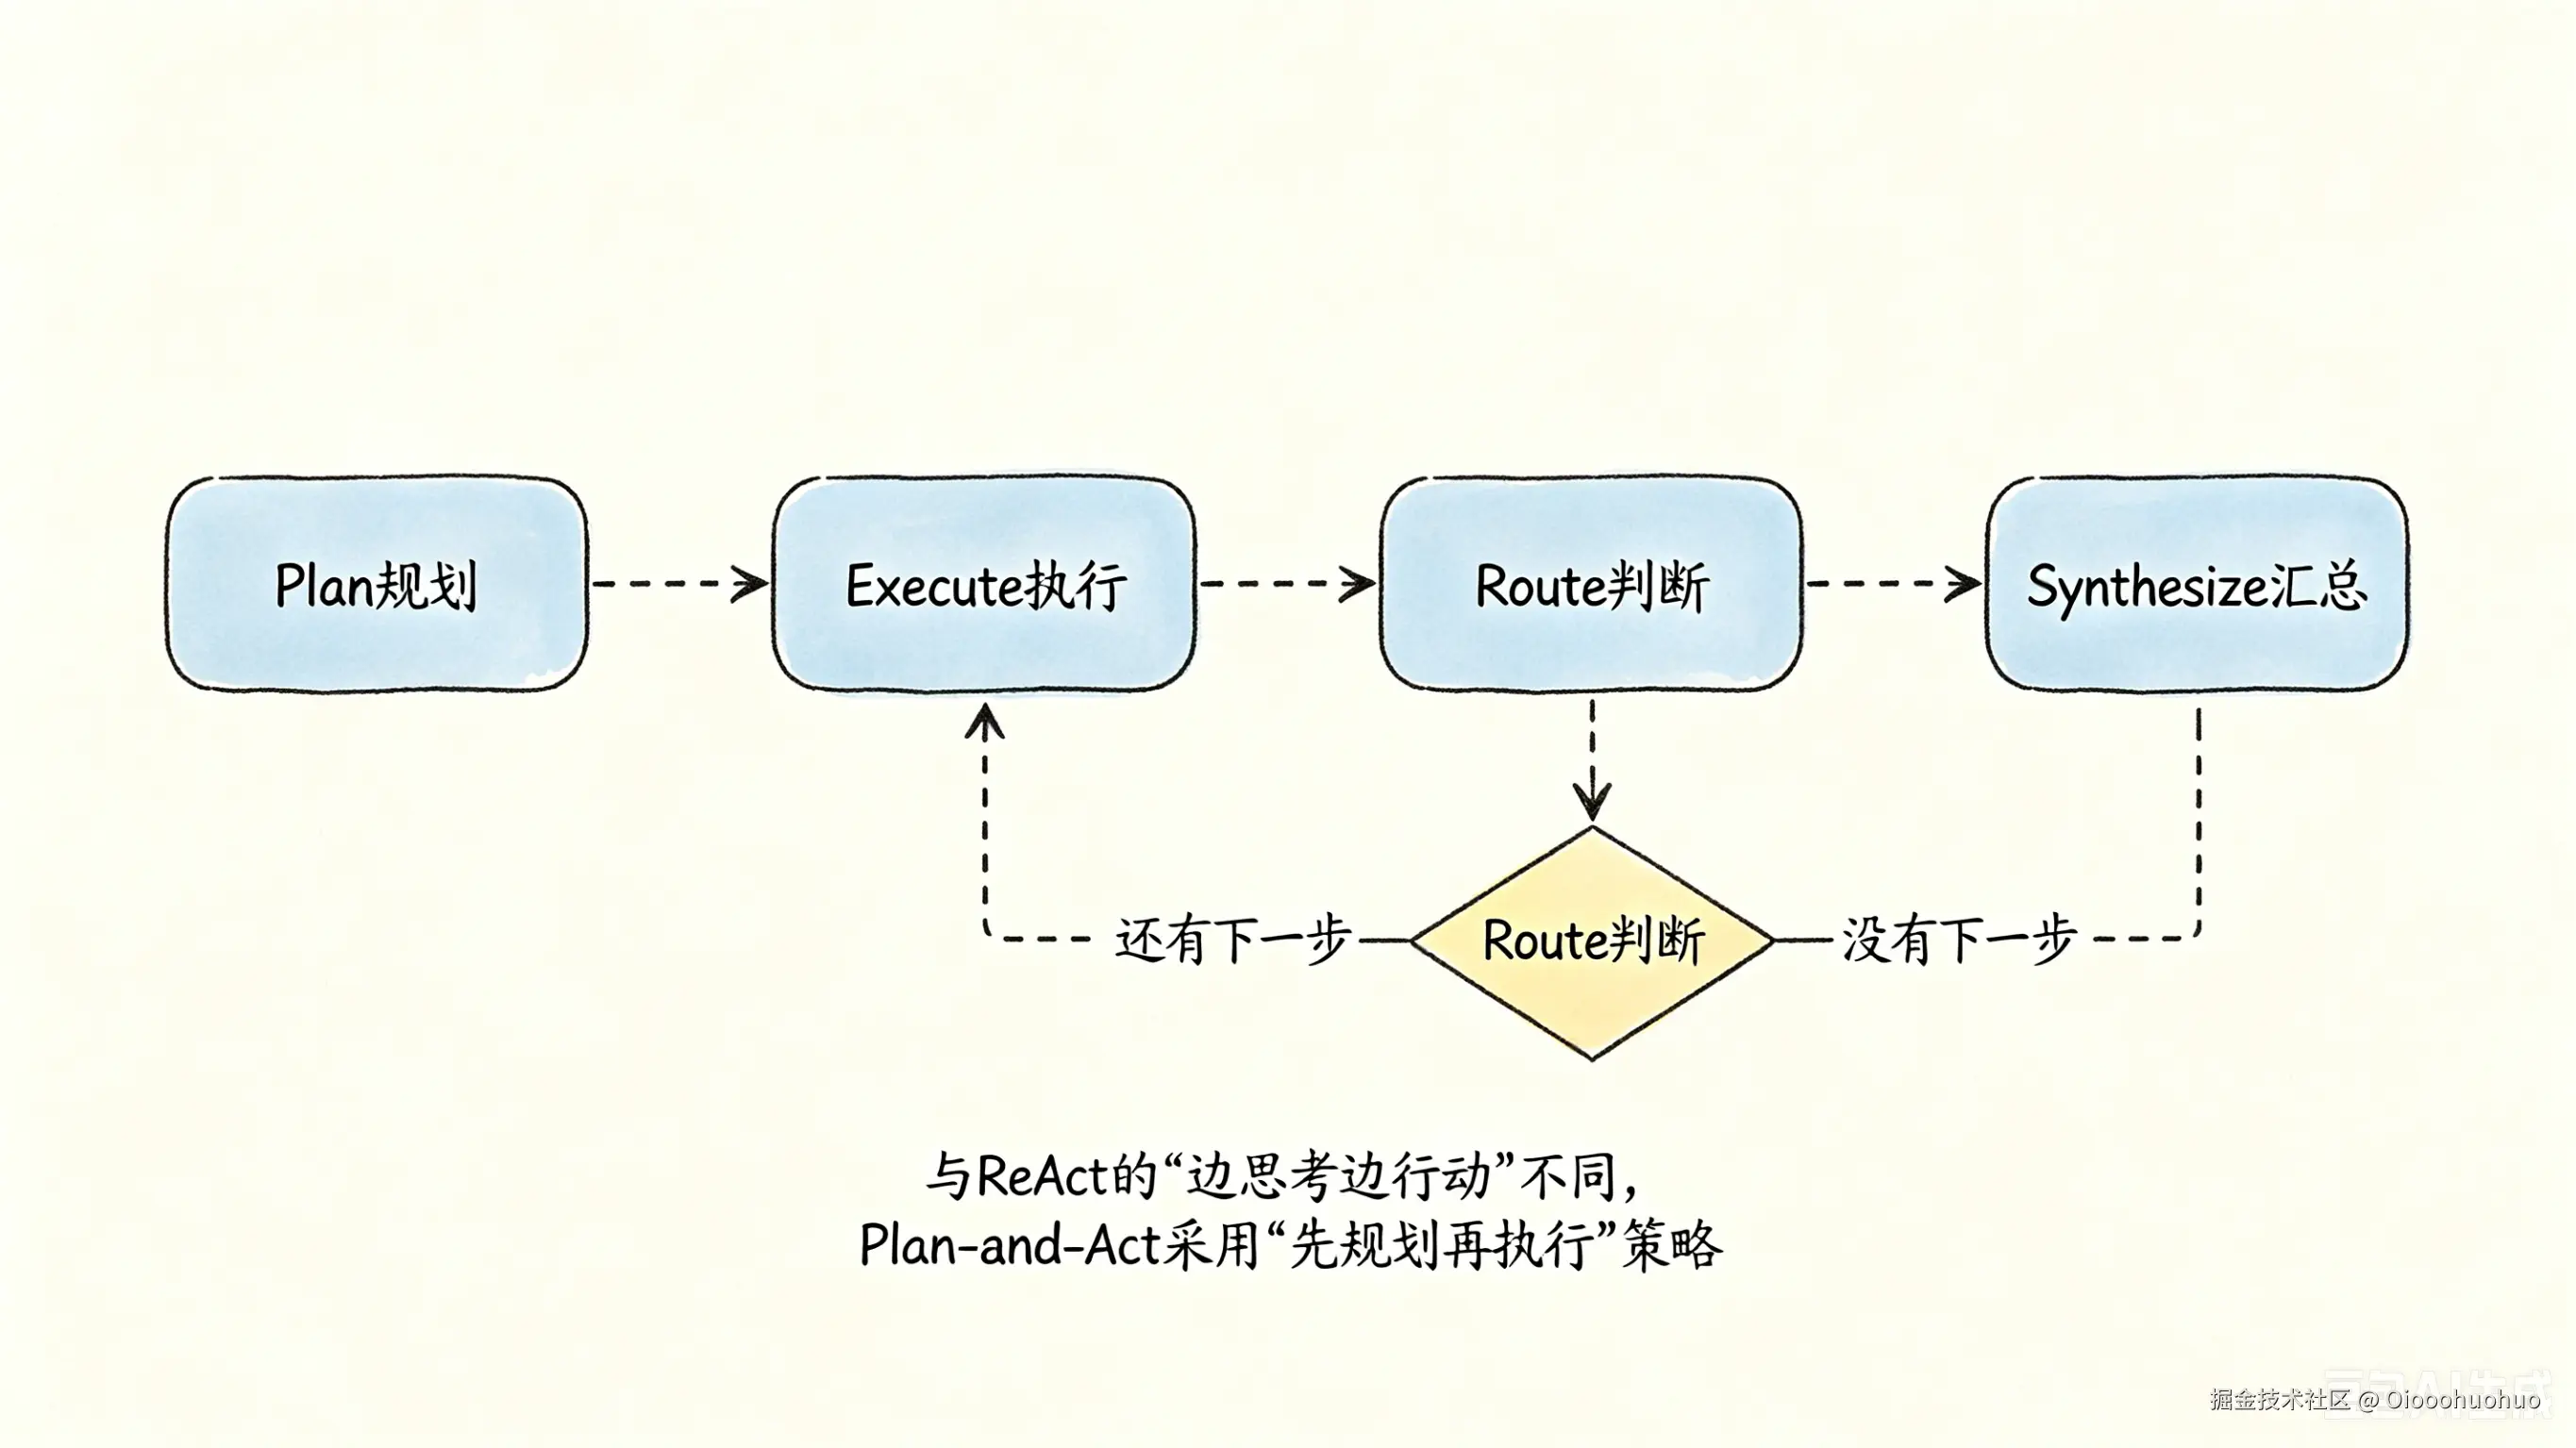
这个范式的主要差距就在一个plan规划和sumup总结
plan_act节点的主要状态类
python
class PlanActState(TypedDict):
"""Plan-and-Act 子图私有状态 --- 父图不可直接访问
字段说明:
- query: 用户查询
- plan_steps: Plan 节点生成的执行步骤列表(如 ["搜索航班", "预订酒店"])
- current_step_index: 当前执行到第几步(从 0 开始)
- step_results: 每一步的执行结果列表(与 plan_steps 一一对应)
- final_answer: Synthesize 节点生成的最终汇总答案
"""
query: str
plan_steps: list[str]
current_step_index: int
step_results: Annotated[list[str], operator_add]
#operator的add方法是python原生自带的列表追加信息,但不覆盖,注意一下这个是step_results,这个state里面根本就没存message
final_answer: str下面是langgraoh的add_messages方法的优势:
识别消息类型:HumanMessage / AIMessage / SystemMessage
自动去重:不会重复添加同一条消息
自动合并连续消息:(比如连续 AI 回复)
保持角色顺序:严格遵循人类 ↔ AI 对话流
兼容消息对象:不是字符串,是带角色、内容、元数据的结构化对象
React 框架强制依赖:React 内部就是靠这个消息列表做推理、反思、调用工具
核心节点详解:
python
async def plan_node(state: PlanActState):
"""规划节点:LLM 分析用户请求,生成执行步骤列表
使用结构化 prompt 要求 LLM 输出 JSON 格式的步骤数组。
"""
messages = [
SystemMessage(content=PLAN_SYSTEM_PROMPT),
HumanMessage(content=f"请为以下请求制定执行计划:{state['query']}")
]
response = await llm.ainvoke(messages)
# 尝试解析 JSON 步骤列表
content = getattr(response, "content", "")
plan_steps = []
#这个希望的content是直接结构化的数据类如:["步骤1", "步骤2"]。但我觉得这如果像校验的话可以拿pydantic先看数据结构是否争取
try:
# 先尝试直接解析
plan_steps = json.loads(content)
except json.JSONDecodeError:
# 尝试从文本中提取 JSON 数组
import re
match = re.search(r'[.*]', content, re.DOTALL)
#虽然没必要,但是这个地方的可取之处还是在于取[]内容,兼容llm返回的数据结构不对,比如如下:
#好的,计划如下:
#["步骤1","步骤2"]
#有问题再问我!
if match:
try:
plan_steps = json.loads(match.group())
except json.JSONDecodeError:
plan_steps = []
#这个意思是如果json的[]解析还有问题返回空列表
# 兜底:按行拆分
if not plan_steps:
plan_steps = [line.strip("- *0123456789. ") for line in content.split("\n") if line.strip()]
# 确保是字符串列表
#对,说的就是这,咋这么检查字符串列表的啊
if not isinstance(plan_steps, list):
plan_steps = [str(plan_steps)]
plan_steps = [str(s) for s in plan_steps if s]
return {"plan_steps": plan_steps, "current_step_index": 0}
#利用operator_add存到state中//虽然模型的结构化输出仅仅依赖prompt注入提示可能输出错误,可以改用llm_structured = llm.with_structured_output(xxx)结构化输出,但面对超长上下文依然还是要做兜底和异常捕获
改用funtion_call伪装工具调用,让llm输出想要的shcema/pydantic 模型:
ini
llm_structured = llm.with_structured_output(
schema=XXX,
method="function_calling",
include_raw=True # 保留原始消息,解析失败不会直接炸掉
)
#输出:
{
"raw": AIMessage(...), # LangChain原生BaseMessage子类
"parsed": XXX | None # 解析成功=Pydantic实例;解析失败=None
}
推荐写法:
python
from pydantic import BaseModel, Field
from langchain_core.output_parsers import PydanticOutputParser, PydanticValidationError
from typing import List
class PlanSteps(BaseModel):
plan_steps: List[str] = Field(description="步骤数组,不能为空")
parser = PydanticOutputParser(pydantic_object=PlanSteps)
async def plan_node(state: PlanActState):
messages = [
SystemMessage(content=PLAN_SYSTEM_PROMPT + "\n" + parser.get_format_instructions()),
#看清楚,再借用PydanticOutputParser库前提下只是再系统提示词中加入了显示提醒,其实主要还是借用它的parse方法,这个才是想要的
#顺带说一说为什么不在用chatopenai实例化llm时用response_format。这样的化所有的输出就是很纯正的你想要的orm数据,工具指令肯定无法发出了,可以参考上面的方法改用with_structured_output方法
#还有这个plan_node肯定是要会用工具的,所以不单单是下面的简单的llm.invoke了
HumanMessage(content=f"请求:{state['query']}")
]
try:
#一般是llm_tools.invoke。写了不用,这是为何,这样让excute_node自己取判断用哪个工具吗? YES
response = await llm.ainvoke(messages)
#parse 自带强校验,不需要再写 model_validate
result = parser.parse(response.content)
if not result.plan_steps:
raise ValueError("生成的步骤不能为空,请重新生成")
except PydanticValidationError as e:
raise ValueError(f"解析步骤格式失败:{str(e)}") from e
except Exception as e:
raise ValueError(f"规划生成失败:{str(e)}") from e
return {
"plan_steps": result.plan_steps,
"current_step_index": 0
}6.3wrapper
启用这个的原因在于舍弃了黑板架构的状态共享的前提下,并且在每个子agent和上下层级无法直接通信的情况下,必须要给他们一个传话的工具。这就是我们用wrapper包装了input_mapper和output_mapper的原因
LangGraph 原生子图有一个致命问题:
原生子图会和父图共用同一个 State!
后果(前文也已提到过了):
- 父图加一个字段 → 子图报错
- 子图改一个字段 → 父图被污染
- 子图和父图强耦合,无法独立升级
它解决就是:
✅ 状态隔离
✅ 显式输入输出
✅ 父子图解耦
✅ 子图变成黑盒节点
最重要的文件,把子图包装成父图能用的一个节点(详细就是用到了langgraph的CompiledStateGraph方法,就是嵌套子图那套)
python
 def subgraph_invoker_factory(
     subgraph: CompiledStateGraph,
     #直接用已编译后的图,通常用来嵌套用的,把子图当作一个节点给上层图用
     input_mapper: Callable[[dict], dict],#父图给子图的
     output_mapper: Callable[[dict, dict], dict],#子图返回给父
     subgraph_name: str = "unnamed_subgraph",
     #虽然我之前说啥孙子图,pattern,啥子agent,子图他们实际上都是子图sub_graph
 ) -> Callable[[dict], dict]:
对上面的工厂函数改写使得其可自动配备签名,主要是可以手动传参parentstate这样子图到子图的通信也是能复用这个子图构建工厂
python
 #上面的工厂函数是简写了,补充一下
 ParentState = TypeVar("ParentState")
 def subgraph_invoker_factory(
     subgraph: CompiledStateGraph,
     input_mapper: Callable[[ParentState], dict],
     output_mapper: Callable[[dict, ParentState], dict],
     #比如第一个input_mapper,传的参数就是父图接受状态state,把他打包成一个字典返回给子图(具体返回什么完全可控了)
     #但output_mapper中第一个字典中两个参数的含义是第一个子图返回值,一个是父图状态最后返回的是一个合并后的最终字典
     subgraph_name: str = "unnamed_subgraph",
 ) -> Callable[[ParentState], dict]:
最近又发现了一偏知识点很全的文章 没想到langsimth还有apikey可以用来实时追踪链路。原文地址如下:(80 封私信 / 80 条消息) 第14章 高级 Agent:LangGraph 与状态机 - 知乎
为了更加解耦,使得该wrapper能够处理单父图到子图能用,子图到孙子图也能够用,特地改为TypeVar类型的parentstate
python
def _invoke_node(parent_state: ParentState) -> dict:
"""包装节点:在父图执行流中被调用
关键设计点:
1. 子图在包装器内部被独立调用,拥有完全私有的状态空间
2. 子图无权访问 parent_state 的全部字段(只能看到 input_mapper 提取的内容)
3. 子图输出无权直接修改父图状态(必须经过 output_mapper 显式映射)
"""
# ── Step 1: 从父图状态提取子图输入 ──
# 这是显式契约:子图能看到的父图信息完全由 input_mapper 决定
subgraph_input = input_mapper(parent_state)
# ── Step 2: 独立运行子图(状态隔离) ──
# 子图在此被作为独立的 compiled graph 运行,与父图状态完全隔离
# 即使子图内部也使用 StateGraph,其状态 Schema 也与父图无关
try:
subgraph_result = subgraph.invoke(subgraph_input)
except Exception as e:
# 子图执行异常时,包装层统一捕获并转换为父图可理解的错误格式
return {
"error": f"[{subgraph_name}] 子图执行失败: {str(e)}",
"active_subgraph": subgraph_name,
}
# ── Step 3: 将子图结果映射回父图状态更新 ──
# 这是另一个显式契约:子图输出中只有 output_mapper 选择映射的字段才会影响父图
parent_updates = output_mapper(subgraph_result, parent_state)
# 注入追踪信息,便于后续调试
parent_updates["active_subgraph"] = subgraph_name
return parent_updates
# 给包装函数打上元信息,便于调试
_invoke_node.__name__ = f"{subgraph_name}_wrapper"
_invoke_node.__doc__ = f"包装节点:调用 {subgraph_name} 子图,实现状态隔离与转换"
#说的已经很详细了,subgraph_invoker_factory函数中传的参数是整个parentstate也没有进行schema隔离啊,还有如果父图分发的query不属于任何state呢,甚至只是简单的str,连字段都不是下面是两个默认的input_mapper和output_mapper
python
def default_input_mapper(fields: list[str]) -> Callable[[ParentState], dict]:
"""默认输入映射器工厂:从父图状态中提取指定字段传递给子图
适用于简单场景:子图只需要父图中的几个字段即可运行。
复杂场景建议手写 input_mapper,做字段重命名、类型转换、提示词注入等。
Args:
fields: 需要从父图提取的字段名列表
Returns:
input_mapper 函数,签名随 ParentState 类型变化
"""
def _mapper(state: ParentState) -> dict:
result = {}
for field in fields:
if field in state: # type: ignore[literal-required]
result[field] = state[field] # type: ignore[literal-required]
return result
return _mapper
def default_output_mapper(
result_field: str = "final_answer",
context_fields: list[str] | None = None,
) -> Callable[[dict, ParentState], dict]:
"""默认输出映射器工厂:将子图结果的标准字段映射回父图
默认行为:
- 子图的 `final_answer` → 父图的 `subgraph_output.answer`
- 子图指定的上下文字段 → 父图的 `context` 合并更新
Args:
result_field: 子图中存放最终答案的字段名
context_fields: 子图中需要合并到父图 context 的字段名列表
Returns:
output_mapper 函数,签名随 ParentState 类型变化
"""
def _mapper(subgraph_result: dict, parent_state: ParentState) -> dict:
updates: dict = {}
# 提取最终答案
if result_field in subgraph_result:
updates["final_answer"] = subgraph_result[result_field]
# 提取上下文更新并合并到父图 context
ctx_updates = {}
if context_fields:
for cf in context_fields:
if cf in subgraph_result:
ctx_updates[cf] = subgraph_result[cf]
if ctx_updates:
# 深拷贝父图现有 context,避免副作用
merged_context = dict(parent_state.get("context", {}))
merged_context.update(ctx_updates)
updates["context"] = merged_context
return updates
return _mapper//这一块确实复杂。
//其实更好跟子agent或者父图联系起来才能真正理解用上这个wrapper,这就先填几个坑吧,下面的子agent和父图在详细介绍
优先解释一下subgrpah_invoker_factory工厂函数的三步隔离机制
关键:虽然 input_mapper 能"看到"整个 parent_state,但它传给子图的只是一个 dict。子图运行时,它的状态空间与父图是物理隔离的。
ini
def _invoke_node(parent_state: ParentState) -> dict:
# Step 1: 【显式提取】input_mapper 从父图状态中选择性地拷贝字段
subgraph_input = input_mapper(parent_state) # ← 生成一个全新的 dict,这点非常重要,如果不生成一个新的dict,由于是同一个类变量造成全局共享,信息将会一直保存,之前所有不同来源混在一起,上下文污染会非常恐怖
# Step 2: 【物理隔离】独立运行子图,与父图状态完全断开
subgraph_result = subgraph.invoke(subgraph_input) # ← 子图内部创建自己的状态空间
# Step 3: 【显式回写】output_mapper 决定哪些子图结果写回父图
parent_updates = output_mapper(subgraph_result, parent_state)
return parent_updates此处稍微跳一下,已travel_agent为例,解决谁到底有权看到parent_state,而是不是一个公共的state,大家可以随意追加,这就是纯黑板架构了
注意一下这个mapper是在最终产出组装文件中的即,case_production.py
csharp
  def _travel_input_mapper(parent_state: OrchestratorState) -> dict:
       return {
           "query": parent_state.get("user_query", ""),   # 重命名:user_query -> query
           "user_id": parent_state.get("user_id", 0),     # 透传
           "context": parent_state.get("context", {}),    # 透传
           "intent": "",                                   # 初始化私有字段
           "final_answer": "",                             # 初始化私有字段
       }
     #这样就避免暴露了父图state的plan,session_id...等一堆的无用字段信息
这跟包装工厂函数关系见下:
在最终的组装中,父图的组装不把单子agent当作一个节点,而是用wrapper包装一层,从而实现状态流转,然后再当作一个可用节点,后面的孙子图也是如此,也是把它外包一层当作节点。虽然啊,本demo的case文件说是三层架构的langgraph的多agent协作,但是逻辑上的,实际上看还是一大串drg架构的图。所以实际上最外层的父图加上那么一个planact的孙子图(真要加放到orchestrator节点前面)都没问题
ini
travel_wrapper_node = subgraph_invoker_factory(
subgraph=travel_agent_subgraph,
#甚至连这个子图也是travel_agent也是调用自生工厂函数生成的
#这个视角是父图到子agent
input_mapper=_travel_input_mapper,
output_mapper=_travel_output_mapper,
subgraph_name="travel_agent",
)
//后面子agent调用孙子图也都是用自己的mapeer入上文的_travel_input_mapper
接下就是比较难的output_mapper,这个核心在于怎么解决子图完成任务后怎么正确把信息返回给父图的对应字段,虽然也是用langgraph的增量更新机制:
1.首先要知道最底层孙子图最终返回的数据格式是什么:
json
  {
       "query": "...",
       "plan_steps": ["搜索航班", "预订酒店"],
       "current_step_index": 2,
       "step_results": ["...", "..."],
       "final_answer": "已为您规划好行程..."
   }
2.然后是关键的子agent的 _planact_output_mapper的调用:
python
  def _planact_output_mapper(sub_result: dict, agent_state: dict) -> dict:
       updates = {}
       if sub_result.get("final_answer"):
           updates["final_answer"] = sub_result["final_answer"]   # ← 写入 TravelAgentState
       merged_ctx = dict(agent_state.get("context", {}))
       merged_ctx.update({
           "last_answer": sub_result.get("final_answer", ""),
           "planact_steps": sub_result.get("plan_steps", []),
       })
       updates["context"] = merged_ctx
     #我觉得就这里的嵌套字典需要注意一下,哦对了这里还得关注本案例的travelagentstate(它就没存分发来的query直接拿到就invoke,这点注意一下,到时候的记忆系统就难受了,肯定不能把memory和原始query放到一起啊,那样多割裂啊,要不,记忆系统也干脆编译成工具算了,只需要invoke之前加一个拦截器)。
       return updates
这个 updates dict 被 subgraph_invoker_factory(这个是复用的) 返回给 Travel Agent 的 LangGraph 框架,LangGraph 将其增量合并到 TravelAgentState。 此时 TravelAgentState 的 final_answer 被更新。
3.然后还有最外层的子agent返回给父图的orchestrator节点
python
  def _travel_output_mapper(sub_result: dict, parent_state: OrchestratorState) -> dict:
       updates = {}
       if sub_result.get("final_answer"):
           updates["final_answer"] = sub_result["final_answer"]   # ← 写入 OrchestratorState
       merged_ctx = dict(parent_state.get("context", {}))
       merged_ctx.update({
           "last_answer": sub_result.get("final_answer", ""),
           "domain": "travel",
       })
       updates["context"] = merged_ctx
       return updates
这个 updates 被返回给父图的 LangGraph 框架,增量合并到 OrchestratorState。
最后来一个完整的案例数据流:
arduino
  OrchestratorState (父图)
       │
       │ _travel_input_mapper 提取 {"query", "user_id", "context", ...}
       ▼
   TravelAgentState (Domain Agent)
       │
       │ _planact_input_mapper 提取 {"query", "plan_steps", ...}
       ▼
   PlanActState (孙子图)
       │
       │ synthesize_node 返回 {"final_answer": "..."}
       │
       │ subgraph.invoke() 结束,返回完整 PlanActState
       ▼
   _planact_output_mapper 挑选 {"final_answer", "context": {...}}
       │
       │ 增量合并到 TravelAgentState
       ▼
   TravelAgentState.final_answer = "..."
       │
       │ Travel Agent 子图 invoke() 结束,返回完整 TravelAgentState
       ▼
   _travel_output_mapper 挑选 {"final_answer", "context": {...}}
       │
       │ 增量合并到 OrchestratorState
       ▼
   OrchestratorState.final_answer = "..."
6.4子图(Domain子agent)
6.4.1travel_agent
子图state:
python
class TravelAgentState(TypedDict):
"""旅游 Agent 子图私有状态
字段说明:
- query: 用户查询(从父图 user_query 映射)
- user_id: 用户标识(从父图映射)
- context: 父图传入的上下文(可选,如已知偏好、历史行程)
- intent: 内部分析结果,"itinerary"(行程规划)或 "inquiry"(实时查询)
- final_answer: 汇总后的最终答案
"""
query: str
user_id: int
context: dict
intent: str
final_answer: str
#这个没话说,应该是孙子图的ouput_mapper传上来的下面是子agent内部与孙子图的通信所用的input/output_mapper
python
def _react_input_mapper(agent_state: dict) -> dict:
"""TravelAgentState -> ReactState"""
query = agent_state.get("query", "")
context = agent_state.get("context", {})
system_text = (
"你是一个专业的旅游顾问助手,擅长实时回答用户的旅游相关问题。\n"
f"当前用户ID: {agent_state.get('user_id', 'unknown')}\n"
)
if context:
system_text += f"已知上下文: {context}\n"
return {
"query": query,
"messages": [SystemMessage(content=system_text), HumanMessage(content=query)],
"tools": ["search", "get_user_info", "rag_query"],
"retries": 0,
"final_answer": "",
"is_passed": False,
}
def _react_output_mapper(sub_result: dict, agent_state: dict) -> dict:
"""ReactState -> TravelAgentState 更新"""
updates: dict = {}
if sub_result.get("final_answer"):
updates["final_answer"] = sub_result["final_answer"]
merged_ctx = dict(agent_state.get("context", {}))
merged_ctx.update({
"last_answer": sub_result.get("final_answer", ""),
"react_is_passed": sub_result.get("is_passed", False),
"react_retries": sub_result.get("retries", 0),
})
updates["context"] = merged_ctx
return updates//这里一个很重要的地方,关于为什么参数输入是agent_state而包装wrappers.py中的工厂函数构造却是需要显示传父图状态参
_react_input_mapper 的 agent_state 参数就是当前运行中的 TravelAgentState 实例------它是 LangGraph 在执行 react_wrapper 节点时自动传入的当前子图状态。不需要显式传类型,因为 LangGraph 的 StateGraph 在 add_node 注册节点函数时,会在运行时把当前状态 dict 作为参数传入。
//真的假的
还有我上面说的创建新的dict实例防止上下文污染(还不如状态共享这样)的解释:
- TravelAgentState 是 TypedDict,不是实例化的类。TypedDict 只是类型标注,它不持有任何数据。实际的状态数据是 LangGraph 在每次 graph.invoke() 时创建的一个普通 dict 实例。
- 每次 invoke() 调用都会创建全新的状态 dict。LangGraph 内部在启动一次图运行时,会把你传入的初始值复制到一个新的 dict 中,后续所有节点都在这个独立的 dict 上操作。
- input_mapper 和 output_mapper 都创建了新 dict,不修改原状态:
python- _react_input_mapper 的 return {...} 返回全新 dict - _react_output_mapper 的 merged_ctx = dict(agent_state.get("context", {})) 做了浅拷贝,然后 updates = {} 也是新dict
- 子图的 subgraph.invoke() 更是完全独立的执行------ReactState 有自己的 Schema,子图内部的 messages、retries 等字段与 TravelAgentState 毫无引用关系。
最总包装成wrapper节点(孙子)
ini
     react_wrapper = subgraph_invoker_factory(
         subgraph=react_sub,
         input_mapper=_react_input_mapper,
         output_mapper=_react_output_mapper,
         subgraph_name="travel_react",
     )
     planact_wrapper = subgraph_invoker_factory(
         subgraph=plan_act_sub,
         input_mapper=_planact_input_mapper,
         output_mapper=_planact_output_mapper,
         subgraph_name="travel_plan_act",
     )
之前说intent的作用是内部做一次关键词匹配的简易需求分析,决定是否用react范式还是plan and excute范式,虽然不准吧,反正也有react范式的保底策略(实际上就是if else,让我想到了某个"高级算法设计":
kotlin
     def intent_router(state: TravelAgentState) -> str:
         intent = state.get("intent", "inquiry")
         #忘记补充了,在TypedDict中如果没有做默认值填写,无论是invoke还是get都要做兜底策略,否则直接返回None。值得说一下,之前讲解那个reducer的那篇文章稀土的讲的是真不错
         if intent == "itinerary":
             return "planact_wrapper"
         return "react_wrapper"
6.4.2coding_agent
这个基本上就是travle_agent的拷贝了,这个就没做需求分析了,直接上react范式。
当然无论是子图,孙子图,甚至父图既然要解耦,没比方编译图,仅对外暴露生成该图的工厂函数就行。详细见case_production.py中各图最终的组装。
6.5父图( Orchestrator)
父图的全貌是在case_production文件中的组装的,但一些节点在base文件中。
下面就是最基础核心的orchestratorstate(也就是:
python
 class OrchestratorState(TypedDict):
     """父图编排层状态 --- 全局唯一状态契约

     字段说明:
     - session_id: 会话追踪标识
     - user_query: 用户原始查询(只读入口)
     - user_id: 用户标识
     - plan: 父图生成的执行计划(按步骤调用不同子图)
     - plan_step_index: 当前执行到计划的第几步
     - active_subgraph: 当前激活的子图名称(用于调试和追踪)
     - context: 跨子图受控共享上下文(由 PostProcessor 决定写入内容)
     - is_complete: 是否完成全部计划
     - error: 错误信息
     - final_answer: 最终输出给用户的答案
     """
     session_id: str
     user_query: str
     user_id: int
     plan: Annotated[list[dict], operator_add]       # 使用 operator.add 支持追加
     plan_step_index: int
     active_subgraph: str
     context: dict                                   # 受控共享区:子图间不直接通信,经父图中转。此处其实就是状态共享了
     #这个context作为横向字段,所有的横向数据都流向这个dict中,也能通过input_mapper读取
     is_complete: bool
     error: Optional[str]
     final_answer: str
     review_decision: str                            # 【扩展点B】审查节点决策:continue / reroute / clarify / finalize
在这补充一点context的作用:
子图没有直接访问父图的能力,但它可以通过 output_mapper 往 context 里写入语义信号,父图的 review_node 读取这些信号做流程干预。这是子图对父图的"反向通知"机
本来是没必要放agentprompt的,但父图的这个prompt engnieering确实做的不错:
arduino
_INTENT_SYSTEM_PROMPT = """你是一个顶级意图识别与任务调度专家。
你的职责是分析用户的原始请求,将其精确分发到最合适的领域 Agent。
可选的 Agent 列表:
1. travel_agent: 处理旅游、航班、酒店、行程规划、景点攻略、交通安排等请求。
2. coding_agent: 处理编程、代码调试、技术概念解释、算法、软件开发等请求。
3. rag_agent: 处理基于知识库、文档、内部资料、专业文献的问答。
4. default: 其他通用问答(如闲聊、简单计算、无法归类的请求),使用通用 ReAct 范式处理。
输出要求:
- 请以 JSON 格式输出,不要包含任何解释性文字。
- 格式: {"intent": "travel_agent", "reason": "用户请求预订航班和酒店", "plan_summary": "调用旅游Agent处理行程规划"}
- intent 字段必须是以上四个选项之一。
【上下文感知指令】
如果提供了"历史执行反馈"或"已产生的中间结果",请将它们纳入考虑:
- 若前次执行因质量不达标被退回(reroute_reason),请尝试更精确地拆解用户意图或更换 Agent。
- 若已存在中间结果(last_answer),请判断当前请求是否需要延续之前的话题,还是开启新的独立任务。
- 若用户请求本身存在歧义,且历史反馈中已指出需要澄清,请输出 intent="default" 并在 reason 中注明"需澄清"。
"""后面这四个节点更是重中之重:
orchestrator节点:
python
def orchestrator_node(state: OrchestratorState) -> dict:
"""编排器入口节点:使用 LLM 做动态意图识别并生成执行计划
【动态分发标注】
──────────────────────────────────────────────────────────────
本节点不再使用硬编码的关键词规则(如 "plan" -> plan_and_act),
而是通过 LLM 对 user_query 进行语义理解,动态决定调用哪个 Domain Agent。
动态分发的优势:
1. 可处理模糊、多义或跨领域的自然语言请求(如"帮我写一段 Python 爬虫代码来抓取酒店价格",
LLM 可以判断这偏向 coding_agent,而关键词规则可能误判)。
2. 新增 Agent 时只需更新 _INTENT_SYSTEM_PROMPT 中的可选列表,无需修改路由代码。
3. 通过 LLM 的推理能力,可以实现更细粒度的任务拆解(未来可扩展为多步骤 plan)。
降级策略:
- 若 LLM 调用失败或返回格式异常,自动回退到 default(通用 ReAct),保证系统可用性。
──────────────────────────────────────────────────────────────
"""
query = state.get("user_query", "")
context = state.get("context", {})
# 空查询保护
if not query or not query.strip():
return {
"plan": [],
"plan_step_index": 0,
"active_subgraph": "",
"is_complete": True,
"error": "用户查询为空",
"context": context,
}
# 【扩展点B】构建上下文感知增强的用户输入
# 从 context 中提取历史信号,注入到意图识别的用户输入中,
# 使 orchestrator 能基于前次执行反馈做更精准的分发,而非仅看原始 query。
enhanced_user_input = f"用户请求:{query}"
if context.get("reroute_reason"):
enhanced_user_input += f"\n\n【历史执行反馈】前次执行被退回,原因:{context['reroute_reason']}"
if context.get("last_answer"):
# 截断避免 prompt 过长,只保留前 300 字符作为信号
truncated_answer = str(context["last_answer"])[:300]
enhanced_user_input += f"\n\n【已产生的中间结果】{truncated_answer}"
if context.get("needs_clarification"):
enhanced_user_input += (
f"\n\n【待澄清信息】{context.get('clarification_text', '用户请求存在歧义,需要进一步澄清')}"
)
# 初始化 LLM(使用低温保证输出确定性)
api_key = os.environ.get("OPENAI_API_KEY", "sk-dummy")
llm = ChatOpenAI(
model="qwen3-max",
api_key=api_key,
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
temperature=0.0, # 低温度,降低分类随机性
)
messages = [
SystemMessage(content=_INTENT_SYSTEM_PROMPT),
HumanMessage(content=enhanced_user_input)
]
intent = "default"
#说是分发query,那也不是真"并发"/多线程去执行子agent的啊,还是一条一条去执行的,哪怕意图识别出了需要调用多个agent。但应该会用解决方法的吧?没错,采用Fan+out+Join模式可以用到并发,需要注意的是需修改state的active_subgraph为list。不对,准确来说这也不是常见用asyncio,此处是用langgraph.types.Send
reason = "兜底默认"
try:
response = llm.invoke(messages)
content = getattr(response, "content", "")
# 尝试从 LLM 输出中提取 JSON 对象
match = re.search(r'{.*}', content, re.DOTALL)
if match:
parsed = json.loads(match.group())
intent = parsed.get("intent", "default")
reason = parsed.get("reason", "")
except Exception:
# LLM 调用失败或解析失败时,回退到 default,不阻断主流程
intent = "default"
reason = "LLM 意图识别失败,回退到默认处理"
# 根据 LLM 识别的意图映射到对应的子图节点
# 此处可灵活扩展:未来若 LLM 返回多个 intent,可生成多步骤 plan 实现链式调用
agent_plan_map = {
"travel_agent": {
"subgraph": "travel_agent",
"goal": "处理旅游相关请求",
"input_fields": ["user_query", "user_id", "context"],
},
"coding_agent": {
"subgraph": "coding_agent",
"goal": "处理编程相关请求",
"input_fields": ["user_query", "user_id", "context"],
},
"rag_agent": {
"subgraph": "rag_agent",
"goal": "基于知识库回答",
"input_fields": ["user_query", "context"],
},
}
# 若意图不在映射表中,回退到通用 ReAct
plan_item = agent_plan_map.get(intent, {
"subgraph": "react",
"goal": "通用实时推理回答",
"input_fields": ["user_query", "context"],
})
# 【扩展点B】每次重新进入 orchestrator 时,清空上一次的审查决策,
# 防止旧的 review_decision 干扰新的路由轮次。
return {
"plan": [plan_item],
"plan_step_index": 0,
"active_subgraph": plan_item["subgraph"],
"is_complete": False,
"context": {**state.get("context", {}), "intent_reason": reason},
"review_decision": "", # 清空旧决策
}既然写到这了,就提一下真实项目中很重要的一点:memory。
一定要区分开context和meomory
context 是子图间的"对话",memory 是系统对用户的"记忆",两者数据来源和生命周期完全不同,不应该混在同一个dict 里。
所以在父图中应该把memory注册成一个节点( memory_loader_node),同样的相关路由需要判断是否需要memory然后调用你的节点随你怎么加载怎样加载,加载什么memory。还需在orchestrator节点中判断是否需要加载memory。
这样orchestratorstate增加如下字段:
yaml
  OrchestratorState 新增字段:
       session_id: str           ← 已有,作为记忆查询的 key
       user_id: int              ← 已有,作为记忆查询的 key
       memory: dict              ← 新增,记忆系统专用字段
           long_term: list       ← 长期记忆(用户偏好、历史摘要)
           short_term: list      ← 短期记忆(近 N 轮对话)
           working: dict         ← 工作记忆(当前会话的中间状态)
needs_memory: bool ← 新增,orchestrator 决定是否需要加载关于上面的动态并发,如果是调用多个agent将串行执行的agent改为并行(好像流式也是用到langgraph的types库吧),文章借阅:LangGraph设计与实现-第12章-Send 与动态并行第12章 Send 与动态并行 12.1 引言 在前面的章节 - 掘金:
动态并行 的核心需求:在运行时根据数据决定要派生多少个并行任务,每个任务可以携带不同的输入,最终所有任务的输出通过 reducer 汇聚回主图状态。LangGraph 通过
Send对象和TopicChannel 精巧地解决了这个问题,实现了经典的 map-reduce 模式。
这就是我上面说为什么多agent看起来像是一张拓扑图(确实,让人很误以为是会同时调用多个agent,但实际上是可以调用的agent并且只串行执行一个把final_ansewer通过output_mapper传到上层state中或公共context),但实际上运行起来就是if else加一条单线的图运行,不过还有就是如果agent之间协作起来也只能等其他的兄弟子图完成后再拿到answer后才能回答,边界值处理一定要做好,否则并行时其他的agent拿到错误信息/无信息并不会等待,依旧输出最后的reduce汇聚会很混乱(比如某用户"请帮我生成一份去杭州的旅游方案,并根据这各方案给我生成一个可执行的前端界面代码来演示这份方案"大概率会调用两个agent并发执行,orchestrator分发query之后,coding_agent并不知到那份旅游方案(会通过input_mapper从context中拿取,但此时也没生成好啊),要么硬输出一份,要么疯狂走重试策略,要么直接抛异常给父图,然后父图再重试,然后....直到第一份旅游方案生成好了。//真的会很消耗token
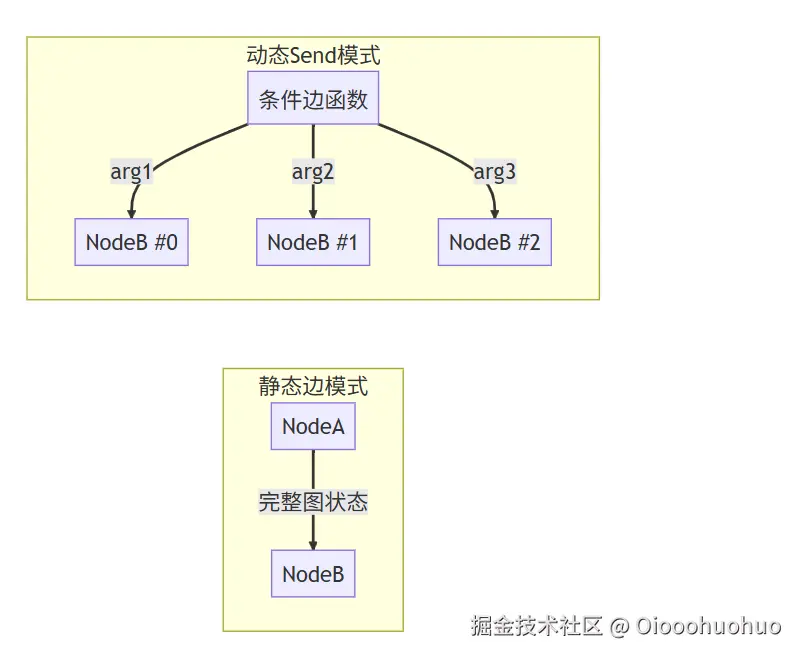
回到原来的nodes.py中四节点的实现:
更新节点:
python
def post_process_node(state: OrchestratorState) -> dict:
"""后处理节点:子图执行完成后,更新父图状态并决定下一步
职责:
1. 将当前子图的输出整合进 context(受控共享)
2. 推进 plan_step_index
3. 判断是否还有后续子图需要执行
4. 若出错,触发降级策略(如重试、跳过、返回错误)
"""
updates: dict = {}
current_index = state.get("plan_step_index", 0)
plan = state.get("plan", [])
error = state.get("error")
# 如果子图报告了错误
if error:
# 生产级降级策略:记录错误,尝试继续下一步(或结束)
# 这里选择:如果当前是最后一步,直接结束;否则跳过当前步继续
if current_index >= len(plan) - 1:
updates["is_complete"] = True
else:
updates["plan_step_index"] = current_index + 1
updates["active_subgraph"] = plan[current_index + 1].get("subgraph", "")
# 清空错误,让下一步有机会成功
updates["error"] = None
return updates
# 推进到下一步
next_index = current_index + 1
if next_index >= len(plan):
# 所有步骤执行完毕
updates["is_complete"] = True
updates["plan_step_index"] = next_index
else:
# 还有后续子图
updates["plan_step_index"] = next_index
updates["active_subgraph"] = plan[next_index].get("subgraph", "")
return updates
#哦对了,这个updates随便叫什么,这是langgraph更新state的一个特性:只返回要修改的字段(当然是字典啊),无论最后返回的是什么,都会对state进行更新,有则覆盖,无则增加评估审查节点:
python
def review_node(state: OrchestratorState) -> dict:
"""审查节点:对子图输出与 context 做轻量规则审查,产出流程控制信号
设计原则(解耦 & 非 Agent 化):
- 本节点不做 LLM 推理,只做规则化的策略审查,保持轻量与可预测性。
- 不替代子图自身的质检(如 ReAct 的 Reflect),而是对"跨子图流程"进行优化。
- 输出标准信号 review_decision,由 route_completion 消费做最终路由,
实现"审查决策"与"路由执行"的解耦。
- 子图可通过 output_mapper 向 context 写入特定信号,即可触发本节点的流程干预。
支持的审查信号(均来自 context,由子图 output_mapper 写入):
- needs_reroute: 子图主动请求重新分发(如发现用户 query 跨领域)
- reroute_reason: 重新分发的原因文本
- quality_score: 子图自评质量分(0-10),低于阈值则退回
- needs_clarification: 需要用户补充信息
- clarification_text: 具体的澄清文案
"""
context = state.get("context", {})
error = state.get("error")
# 信号1:子图显式请求重新分发(最高优先级)
if context.get("needs_reroute"):
return {
"review_decision": "reroute",
"context": {
**context,
"reroute_reason": context.get("reroute_reason", "子图主动请求重新分发"),
},
}
# 信号2:子图报告错误且未恢复 ------ 触发 reroute,让 orchestrator 尝试其他策略
if error:
return {
"review_decision": "reroute",
"context": {
**context,
"reroute_reason": f"子图执行报错: {error}",
},
"error": None, # 清空错误,给重新分发一次容错机会
}
# 信号3:答案质量不达标(子图可输出 quality_score)
#说是审查,但为了不调用llm,简化版的话更多的是相当于一个路由了,全是if else的判断,再加一个反馈提醒
score = context.get("quality_score")
if isinstance(score, (int, float)) and score < 5:
return {
"review_decision": "reroute",
"context": {
**context,
"reroute_reason": f"子图质量评分过低({score}),需 orchestrator 重新调度",
},
}
# 信号4:需要用户澄清 ------ 直接 finalize,向用户返回澄清提示
if context.get("needs_clarification"):
clarification = context.get("clarification_text", "您的请求存在歧义,请补充更多信息。")
return {
"review_decision": "clarify",
"final_answer": clarification,
"is_complete": True,
}
# 默认:流程正常继续
return {"review_decision": "continue"}
#确实解耦了,详细看该审查节点,应为它最终还是对state(context)进行修改了,所以还是归为节点。至于为什么会偏向说是路由,应为它的分析硬编码判断(也不能这么说,毕竟那些,error,score本身就是子图通过output_mapper上传来的后面的那几个节点就不一一介绍了
6.6 超级拼装(case_production)
最后的三层架构图(依旧某包生成:
rust
case_production.py --- 工程化三层多 Agent 编排入口
核心架构(三层嵌套):
┌─────────────────────────────────────────────────────────────────────────────┐
│ 父图 (Orchestrator) │
│ START ──► orchestrator ──► intent_router ──┬──► travel_agent_wrapper │
│ (LLM动态识别) ├──► coding_agent_wrapper │
│ ├──► rag_agent_wrapper │
│ ├──► react_wrapper (default) │
│ └──► error_fallback │
│ │
│ Domain Agent 执行完成 ──► post_process ──► route_done ──► finalize ──► END │
└─────────────────────────────────────────────────────────────────────────────┘
│
▼
┌─────────────────────────────────────────────────────────────────────────────┐
│ 子图 (Domain Agent) │
│ 示例:travel_agent │
│ START ──► analyzer ──► intent_router ──┬──► planact_wrapper (行程规划) │
│ └──► react_wrapper (实时查询) │
│ │
│ Pattern 执行完成 ──► synthesize ──► END │
└─────────────────────────────────────────────────────────────────────────────┘
│
▼
┌─────────────────────────────────────────────────────────────────────────────┐
│ 孙子图 (Pattern / 专门范式) │
│ ReAct: Reason -> Action -> Observe -> Generate -> Reflect │
│ PlanAct: Plan -> Execute(loop) -> Synthesize │
│ RAG: Retrieve -> Generate │
└─────────────────────────────────────────────────────────────────────────────┘
数据管道与通信范式(三层保持一致):
- 每层之间均通过 subgraph_invoker_factory + input_mapper / output_mapper 通信
- 状态严格隔离:父图 OrchestratorState → DomainAgentState → PatternState
- 跨层信息通过显式映射传递,不共享状态对象
- 父图 context 字段作为受控共享区,实现跨子图的间接数据传递ai的一般,上方解释的也不行,有几处问题(比如父图的intent_router(根据意图识别后的active_subgraph来决定调用哪一个子agent)之后不应该是所有的子agent罗列。还有就是review_node,但代码已经实现了,还有一个却待加强地方,应该归属于子图那一章的,rag流程还属于native rag
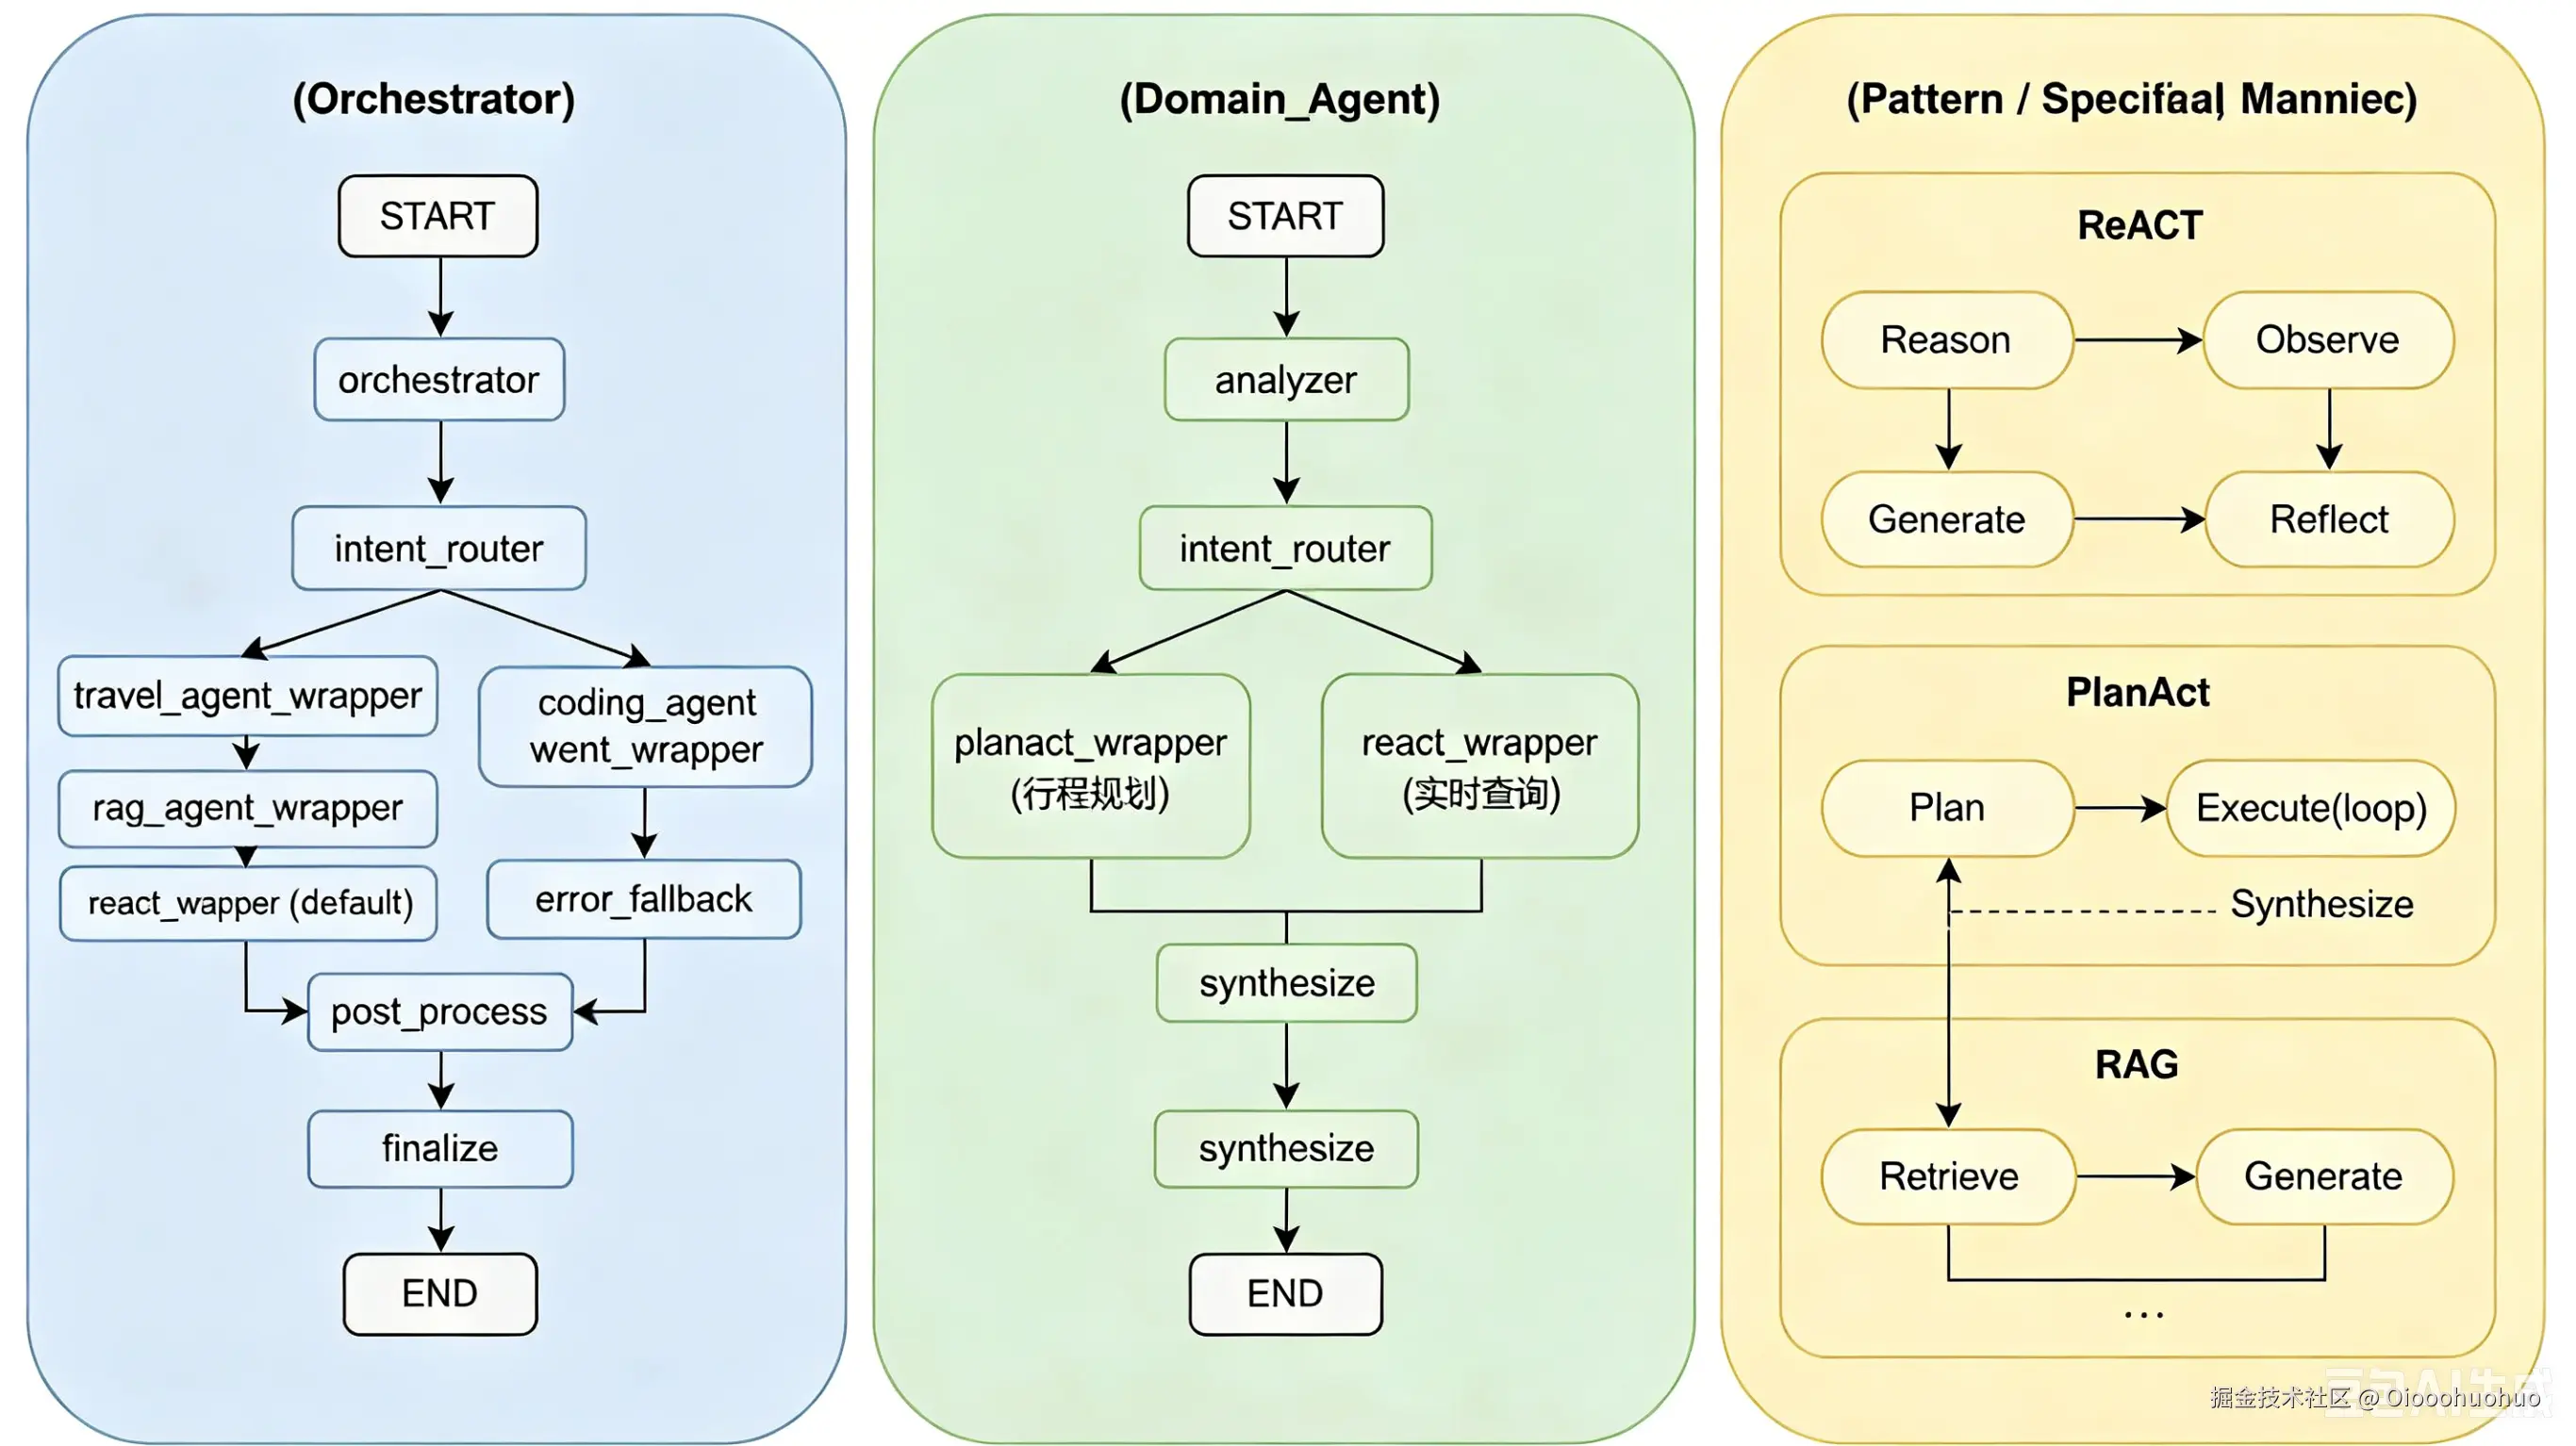
总体搭建流程(最后更多是调用工厂函数生成graph):
ini
 # 1.1 构建 Domain Agent 子图(中间层)
 travel_agent_subgraph = build_travel_agent_subgraph(
     model="qwen3-max",
 )
 coding_agent_subgraph = build_coding_agent_subgraph(
     model="qwen3-max",
 )
 rag_agent_subgraph = build_rag_agent_subgraph(
     model="qwen3-max",
 )
 #孙子图
 react_subgraph = build_react_subgraph(
     model="qwen3-max"
 )
 plan_act_subgraph = build_plan_act_subgraph(
     model="qwen3-max"
 )
接下来就是包装各个子图/孙子图的input/output_mapper了(基本无法复用,每个子图需要拿到的字段信息和传输的都不同),比如_travel_input_mapper。。。等等每个子图孙子图都需要配备一个"交流工具"
接下来就是调用subgraph_invoker_factory包装工厂函数注册将图变为节点
ini
travel_wrapper_node = subgraph_invoker_factory(
subgraph=travel_agent_subgraph,
input_mapper=_travel_input_mapper,
output_mapper=_travel_output_mapper,
subgraph_name="travel_agent",
)
coding_wrapper_node = subgraph_invoker_factory(
subgraph=coding_agent_subgraph,
input_mapper=_coding_input_mapper,
output_mapper=_coding_output_mapper,
subgraph_name="coding_agent",
)
rag_wrapper_node = subgraph_invoker_factory(
subgraph=rag_agent_subgraph,
input_mapper=_rag_input_mapper,
output_mapper=_rag_output_mapper,
subgraph_name="rag_agent",
)
react_wrapper_node = subgraph_invoker_factory(
subgraph=react_subgraph,
input_mapper=_react_input_mapper,
output_mapper=_react_output_mapper,
subgraph_name="react",
)
planact_wrapper_node = subgraph_invoker_factory(
subgraph=plan_act_subgraph,
input_mapper=_planact_input_mapper,
output_mapper=_planact_output_mapper,
subgraph_name="plan_and_act",
)
#subgraph_invoker_factory包装函数用法详细在wrapper章节