30、Python 教程 - Python中的装饰器
你是否曾经在项目中遇到这样的困境:几十个函数都需要加日志、计时、权限校验,复制粘贴到手软,改一个逻辑要翻遍整个代码库?你是否在阅读Flask、Django、FastAPI源码时,被满屏的
@app.route、@login_required搞得晕头转向?这篇文章将从痛点出发,带你彻底搞懂Python装饰器的前世今生,从零基础到企业级实战,让你看完就能上手,面试再也不慌。
文章目录
- [30、Python 教程 - Python中的装饰器](#30、Python 教程 - Python中的装饰器)
-
- 一、痛点场景:没有装饰器的日子有多惨
-
- [1.1 真实项目中的噩梦](#1.1 真实项目中的噩梦)
- [1.2 痛点分析](#1.2 痛点分析)
- 二、痛点的解决方案:装饰器登场
- 三、装饰器是什么
-
- [3.1 专业解释](#3.1 专业解释)
- [3.2 大白话解释](#3.2 大白话解释)
- [3.3 生活案例](#3.3 生活案例)
- [3.4 装饰器的两个核心基石](#3.4 装饰器的两个核心基石)
- 四、为什么要用装饰器
-
- [4.1 遵循开闭原则](#4.1 遵循开闭原则)
- [4.2 代码复用,消除冗余](#4.2 代码复用,消除冗余)
- [4.3 关注点分离](#4.3 关注点分离)
- [4.4 声明式编程,语义清晰](#4.4 声明式编程,语义清晰)
- 五、装饰器是怎么演进过来的
-
- [5.1 史前时代:手动包装](#5.1 史前时代:手动包装)
- [5.2 PEP 318:装饰器语法的诞生](#5.2 PEP 318:装饰器语法的诞生)
- [5.3 PEP 3129:类装饰器的加入](#5.3 PEP 3129:类装饰器的加入)
- [5.4 现代Python:装饰器的全面繁荣](#5.4 现代Python:装饰器的全面繁荣)
- 六、装饰器怎么用
-
- [6.1 最基础的装饰器](#6.1 最基础的装饰器)
- [6.2 装饰带参数的函数](#6.2 装饰带参数的函数)
- [6.3 装饰有返回值的函数](#6.3 装饰有返回值的函数)
- [6.4 functools.wraps:保留原函数元信息](#6.4 functools.wraps:保留原函数元信息)
- [6.5 带参数的装饰器](#6.5 带参数的装饰器)
- [6.6 多个装饰器的叠加](#6.6 多个装饰器的叠加)
- [6.7 类装饰器](#6.7 类装饰器)
- 七、企业项目中如何使用装饰器
-
- [7.1 场景一:接口权限校验](#7.1 场景一:接口权限校验)
- [7.2 场景二:性能监控与计时](#7.2 场景二:性能监控与计时)
- [7.3 场景三:结果缓存](#7.3 场景三:结果缓存)
- [7.4 场景四:数据库事务管理](#7.4 场景四:数据库事务管理)
- [7.5 场景五:接口限流](#7.5 场景五:接口限流)
- [7.6 场景六:参数校验](#7.6 场景六:参数校验)
- 八、装饰器与相关方案的对比
-
- [8.1 详细对比表](#8.1 详细对比表)
- [8.2 各自的优势与劣势](#8.2 各自的优势与劣势)
- [8.3 选型建议](#8.3 选型建议)
- 九、装饰器的常用场景总结
- 十、面试官高频面试题
- 十一、总结
一、痛点场景:没有装饰器的日子有多惨
1.1 真实项目中的噩梦
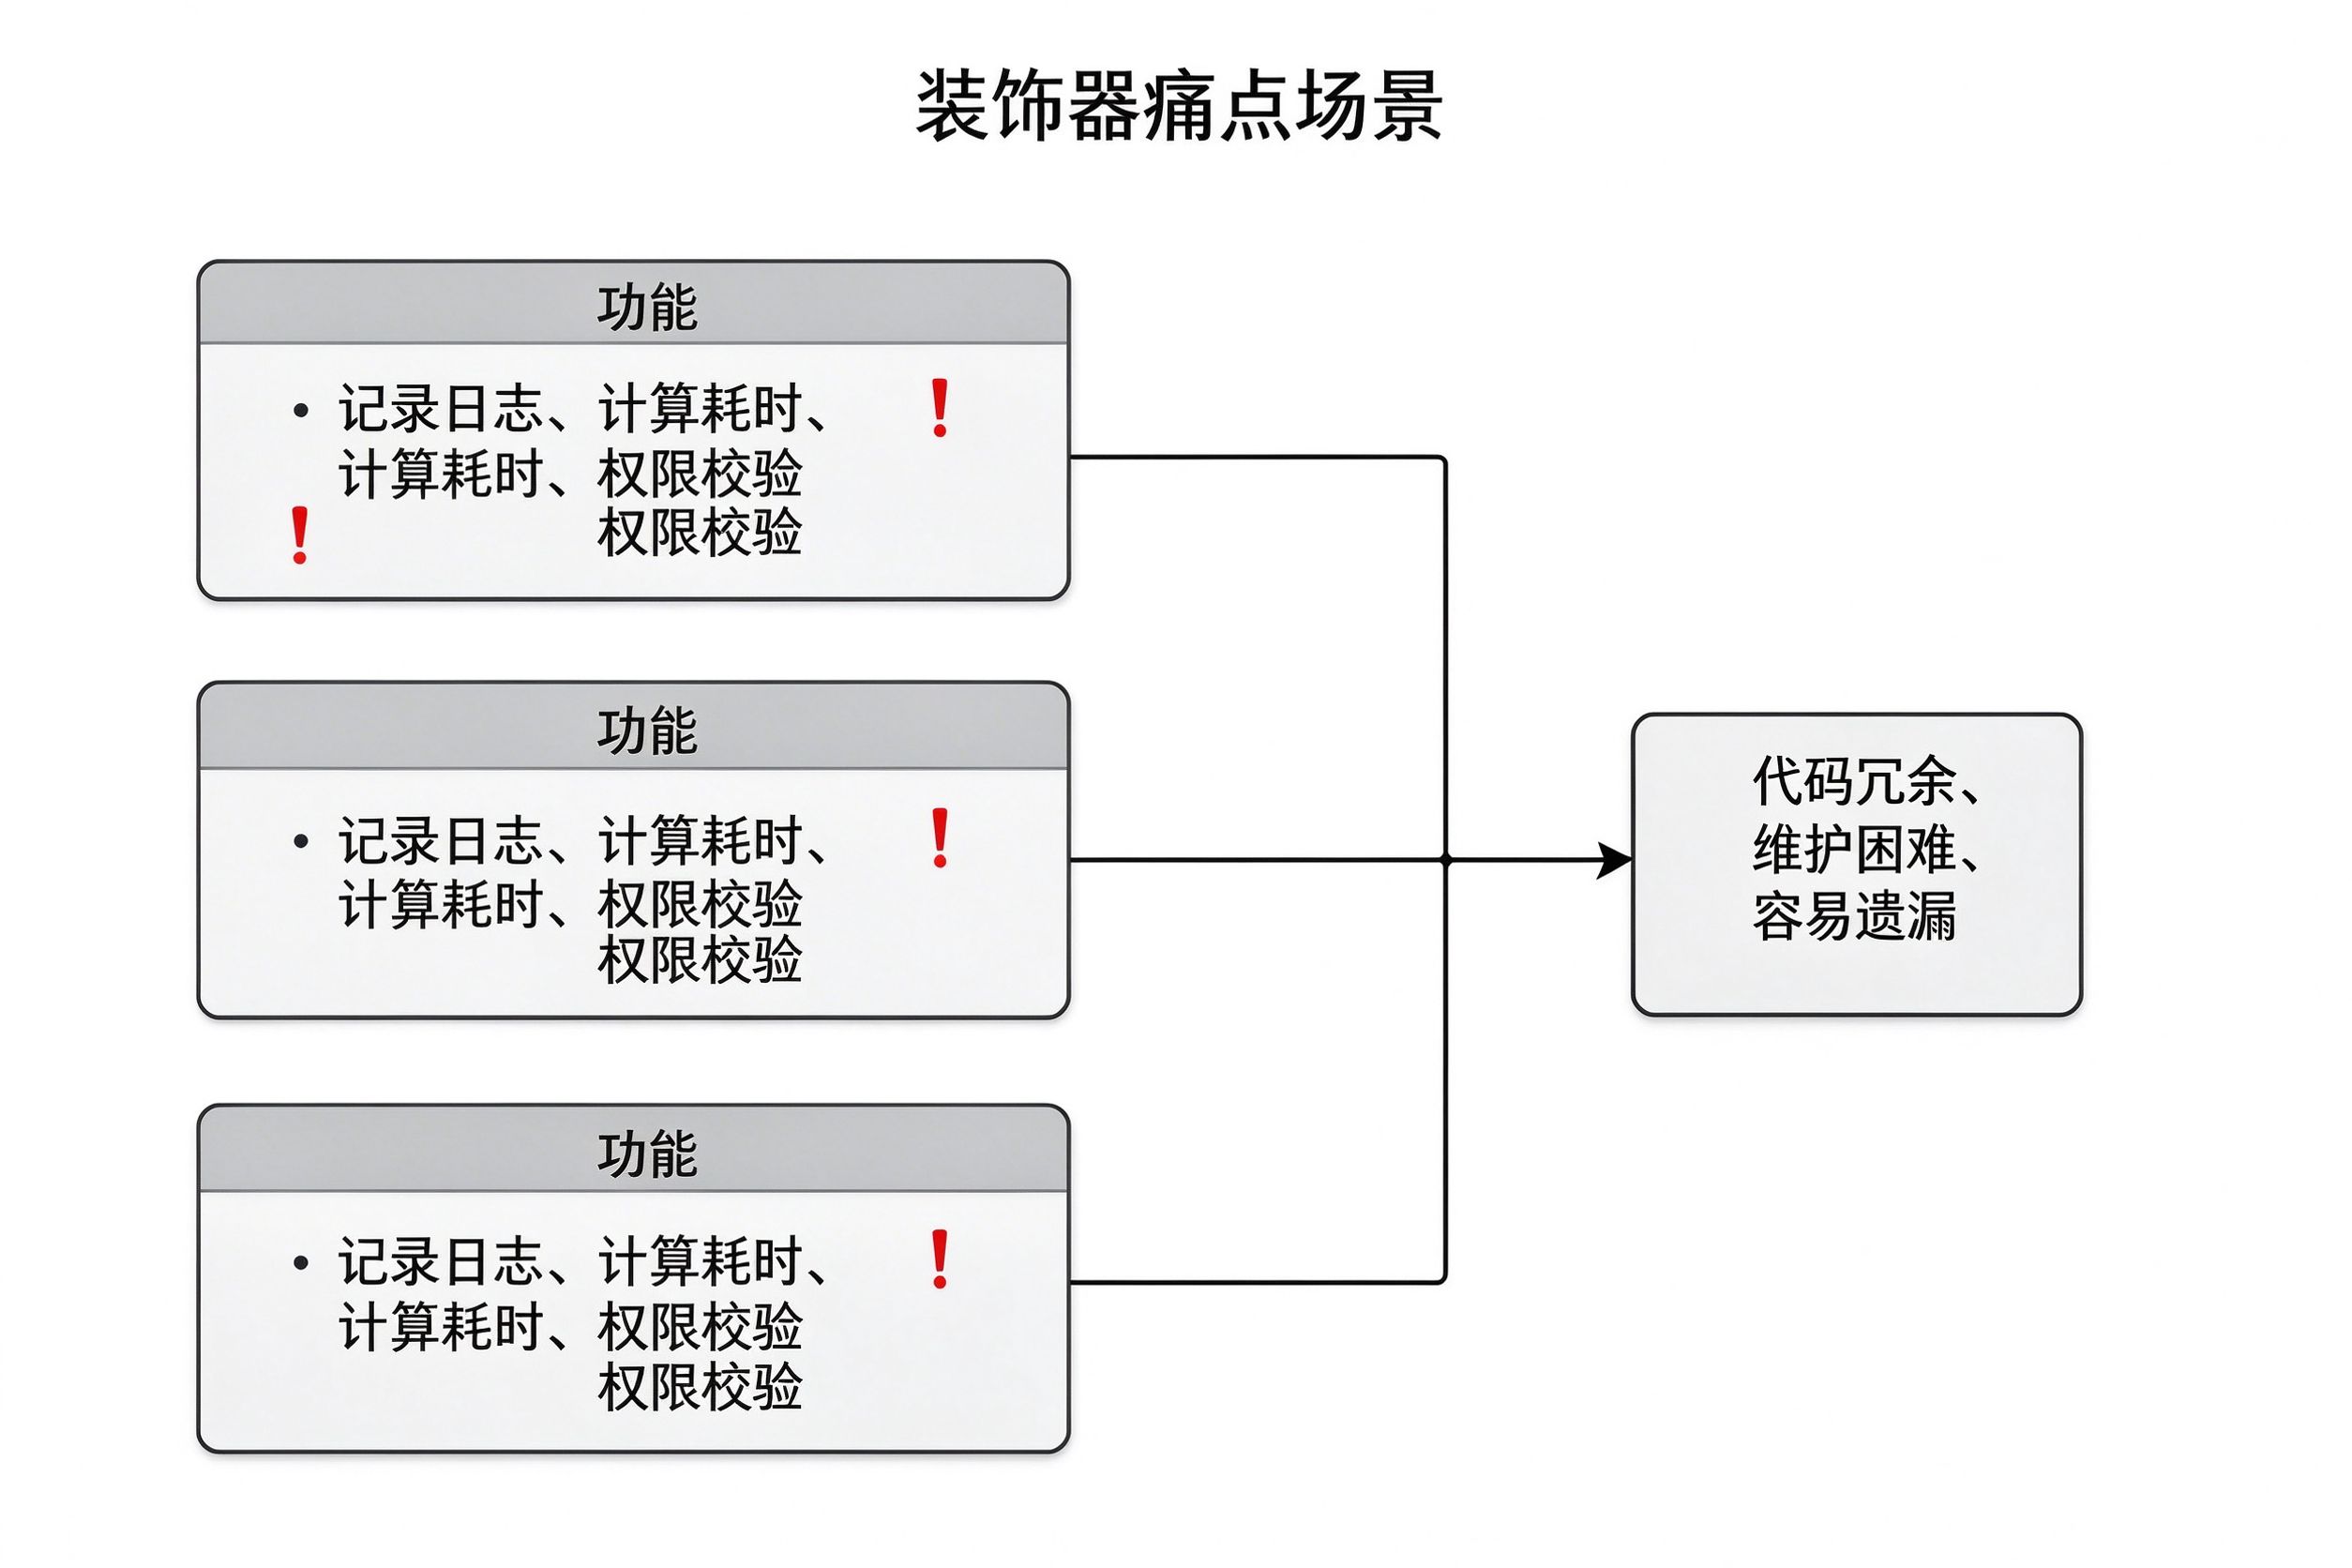
假设你在一家电商公司负责后端开发,项目里有上百个接口函数。产品经理提了一个需求:所有接口都要记录执行日志、计算响应时间、校验用户登录状态。
没有装饰器的时候,你可能会这样写:
python
def get_user_info(user_id):
    # 记录日志
    print(f"[INFO] 调用 get_user_info,参数: user_id={user_id}")
    # 计时开始
    start_time = time.time()
    # 权限校验
    if not check_login(user_id):
        return {"error": "未登录"}
    # 业务逻辑
    user = db.query("SELECT * FROM users WHERE id = ?", user_id)
    # 计时结束
    end_time = time.time()
    print(f"[INFO] get_user_info 执行耗时: {end_time - start_time:.4f}秒")
    return user

def create_order(user_id, product_id):
    # 记录日志
    print(f"[INFO] 调用 create_order,参数: user_id={user_id}, product_id={product_id}")
    # 计时开始
    start_time = time.time()
    # 权限校验
    if not check_login(user_id):
        return {"error": "未登录"}
    # 业务逻辑
    order = db.insert("INSERT INTO orders ...")
    # 计时结束
    end_time = time.time()
    print(f"[INFO] create_order 执行耗时: {end_time - start_time:.4f}秒")
    return order

def update_product(product_id, data):
    # 同样的日志、计时、权限校验代码...
    pass
1.2 痛点分析
上面的代码存在三个致命问题:
第一,代码严重冗余。 每个函数开头和结尾都重复着几乎一模一样的日志、计时、校验代码,上百个函数就是上百份重复。
第二,维护成本极高。 某天产品经理说"日志格式要改一下,加上请求ID",你就得打开上百个函数一个个改,改到怀疑人生。
第三,业务逻辑被淹没。 真正的核心业务代码只有两三行,却被大量的辅助代码包围,可读性极差。新人接手项目,看半天都找不到业务逻辑在哪。
这就是装饰器要解决的核心痛点:在不修改原函数代码、不改变原函数调用方式的前提下,动态地为函数增加额外功能。
二、痛点的解决方案:装饰器登场
用装饰器重构上面的代码,效果立竿见影:
python
import time
import functools

def log_and_time(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        # 记录日志
        print(f"[INFO] 调用 {func.__name__},参数: args={args}, kwargs={kwargs}")
        # 计时开始
        start_time = time.time()
        # 执行原函数
        result = func(*args, **kwargs)
        # 计时结束
        end_time = time.time()
        print(f"[INFO] {func.__name__} 执行耗时: {end_time - start_time:.4f}秒")
        return result
    return wrapper

def login_required(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        user_id = args[0] if args else kwargs.get("user_id")
        if not check_login(user_id):
            return {"error": "未登录"}
        return func(*args, **kwargs)
    return wrapper

# 使用装饰器,业务代码干干净净
@log_and_time
@login_required
def get_user_info(user_id):
    return db.query("SELECT * FROM users WHERE id = ?", user_id)

@log_and_time
@login_required
def create_order(user_id, product_id):
    return db.insert("INSERT INTO orders ...")
看到了吗?业务函数里只剩下纯粹的业务逻辑,日志、计时、权限校验全部被装饰器抽离出去了。想改日志格式?改一个装饰器就行,所有函数自动生效。
三、装饰器是什么
3.1 专业解释
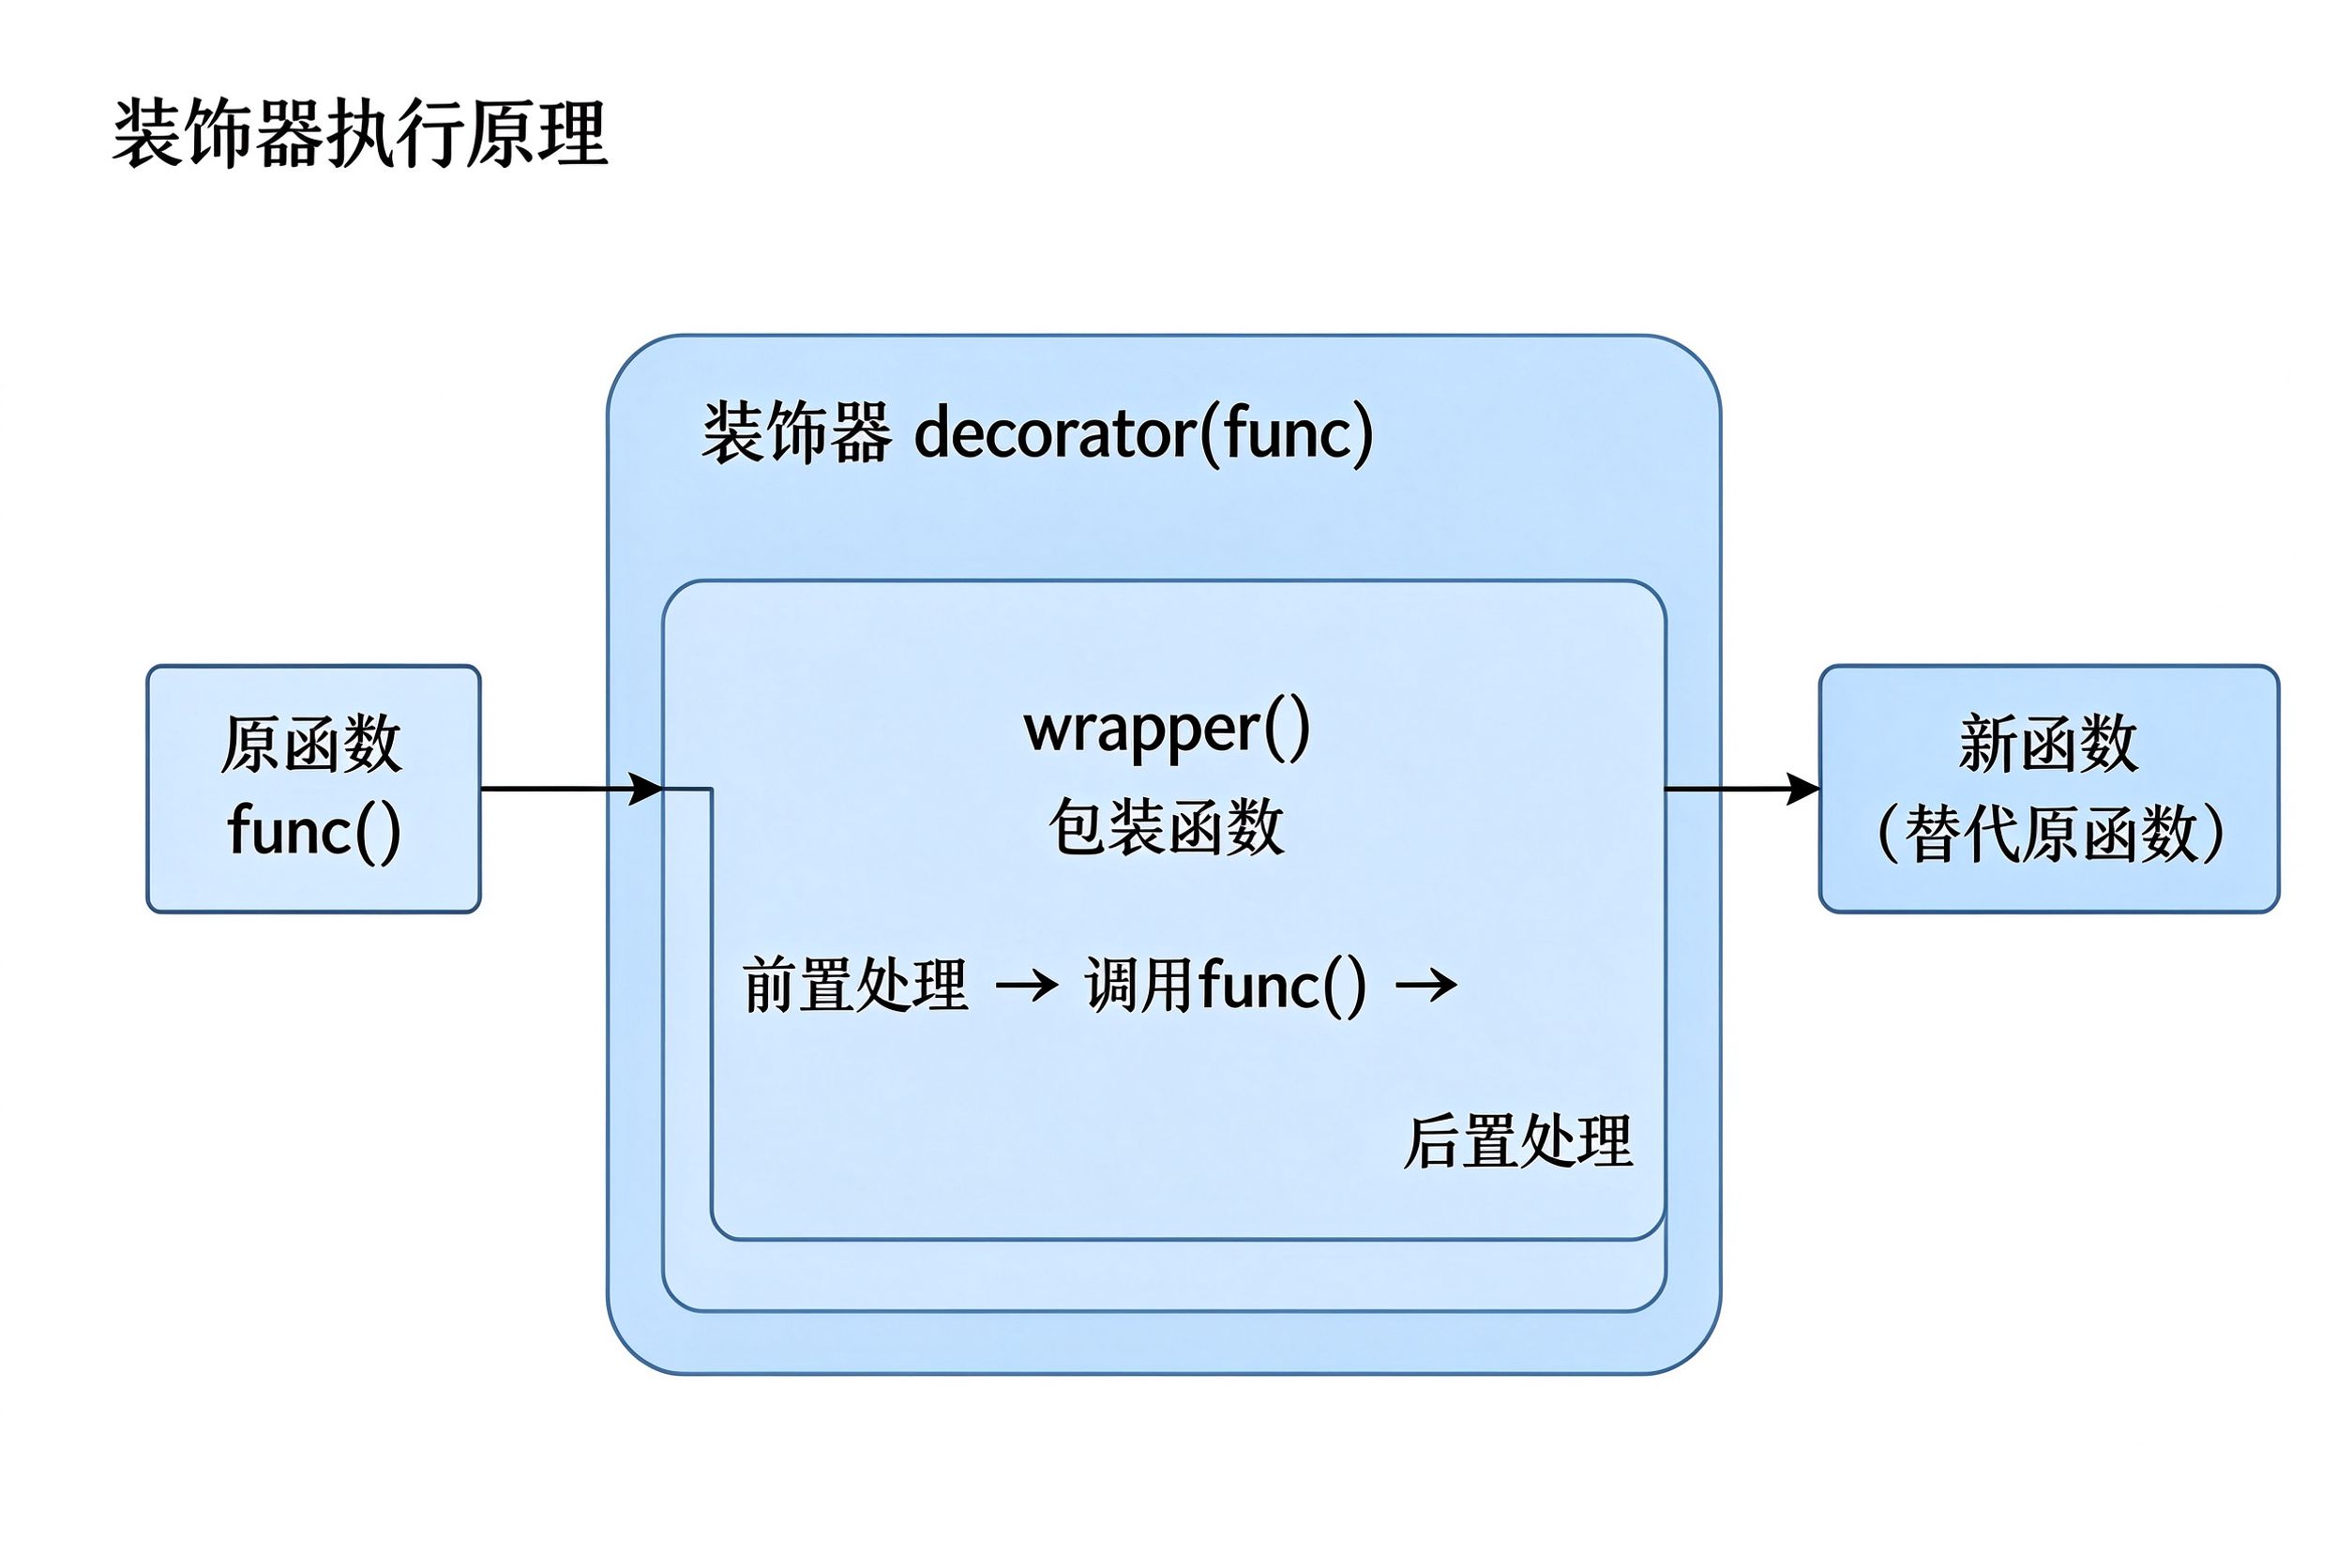
装饰器(Decorator)是Python中一种用于修改函数或类行为的语法结构。本质上,装饰器是一个接收函数作为参数、返回一个新函数的高阶函数。它利用了Python中"函数是一等公民"的特性,配合闭包(Closure)实现对原函数的包装和增强。
用公式表达就是:
@decorator
def func():
    pass

# 等价于
func = decorator(func)
3.2 大白话解释
说人话,装饰器就像手机壳。你的手机(原函数)本身能打电话、发短信,这是核心功能。手机壳(装饰器)套上去之后,手机还是那个手机,打电话发短信的功能一点没变,但多了防摔、好看、挂绳孔这些额外功能。
你不需要拆开手机改造内部结构,只需要套个壳就行。装饰器也是一样,你不需要修改原函数的代码,只需要在函数上面加一行@装饰器名,就能给它增加新功能。
3.3 生活案例
案例一:奶茶加料。 你点一杯原味奶茶(原函数),可以选择加珍珠、加椰果、加奶盖(装饰器)。加了料的奶茶本质还是奶茶,但口感更丰富。而且你可以自由组合,加珍珠加椰果再加奶盖,这就对应多个装饰器叠加使用。
案例二:快递包装。 商品(原函数)本身是完好的,快递公司会给它套气泡膜、装纸箱、贴快递单(装饰器)。商品本身没有被修改,但多了保护措施和物流信息。拆开包装(去掉装饰器),商品还是原来的商品。
3.4 装饰器的两个核心基石
装饰器能实现,依赖两个Python核心特性:
第一,函数是一等公民。 在Python中,函数可以像普通变量一样被赋值、作为参数传递、作为返回值返回。
python
def say_hello(name):
    return f"Hello {name}"

# 函数可以赋值给变量
greet = say_hello
print(greet("Bob"))  # 输出: Hello Bob

# 函数可以作为参数传递
def greet_bob(func):
    return func("Bob")

print(greet_bob(say_hello))  # 输出: Hello Bob
第二,闭包。 闭包是指一个内部函数能够访问并"记住"其外部函数作用域中的变量,即使外部函数已经执行完毕返回。
python
def outer(x):
    def inner(y):
        return x + y  # inner引用了outer的变量x
    return inner

add_five = outer(5)
print(add_five(3))  # 输出: 8,outer已经执行完,但inner还记得x=5
装饰器就是这两个特性的完美结合:把函数作为参数传进去,在内部定义一个包装函数(闭包,记住了原函数),然后把这个包装函数返回出来替代原函数。
四、为什么要用装饰器
4.1 遵循开闭原则
开闭原则(Open/Closed Principle)是面向对象设计的五大原则之一,它要求:对扩展开放,对修改关闭。 意思是,给一个函数增加新功能时,应该通过扩展的方式,而不是修改原有代码。
装饰器正是开闭原则的最佳实践。你想给函数加日志?加个@log就行,原函数一行代码都不用动。原函数经过了充分测试,修改它可能引入新bug,而装饰器是独立的、可测试的、可复用的。
4.2 代码复用,消除冗余
同一个功能(日志、计时、权限、缓存)可能在几十个甚至上百个函数中用到。用装饰器封装一次,到处可以用,彻底消除复制粘贴带来的代码冗余。
4.3 关注点分离
业务逻辑和辅助逻辑混在一起,是代码可读性差的主要原因。装饰器把日志、计时、权限这些横切关注点(Cross-Cutting Concerns)从业务逻辑中抽离出来,让业务函数只关心业务本身,代码结构清晰,维护成本大幅降低。
4.4 声明式编程,语义清晰
用@login_required、@cache、@retry这样的装饰器,一眼就能看出这个函数有哪些附加行为,比在函数内部写一堆if判断要清晰得多。这是一种声明式的编程风格,告诉计算机"这个函数需要什么",而不是"怎么做"。
五、装饰器是怎么演进过来的
5.1 史前时代:手动包装
在装饰器语法出现之前,Python开发者想给函数增加功能,只能手动包装:
python
def my_decorator(func):
    def wrapper():
        print("函数执行前")
        func()
        print("函数执行后")
    return wrapper

def say_hello():
    print("Hello!")

# 手动包装,重新赋值
say_hello = my_decorator(say_hello)
say_hello()这种方式虽然能用,但有两个问题:一是每次都要手动写一遍函数名 = 装饰器(函数名),容易写错;二是装饰逻辑和函数定义分开了,可读性差,看函数定义的时候不知道它被装饰了。
5.2 PEP 318:装饰器语法的诞生
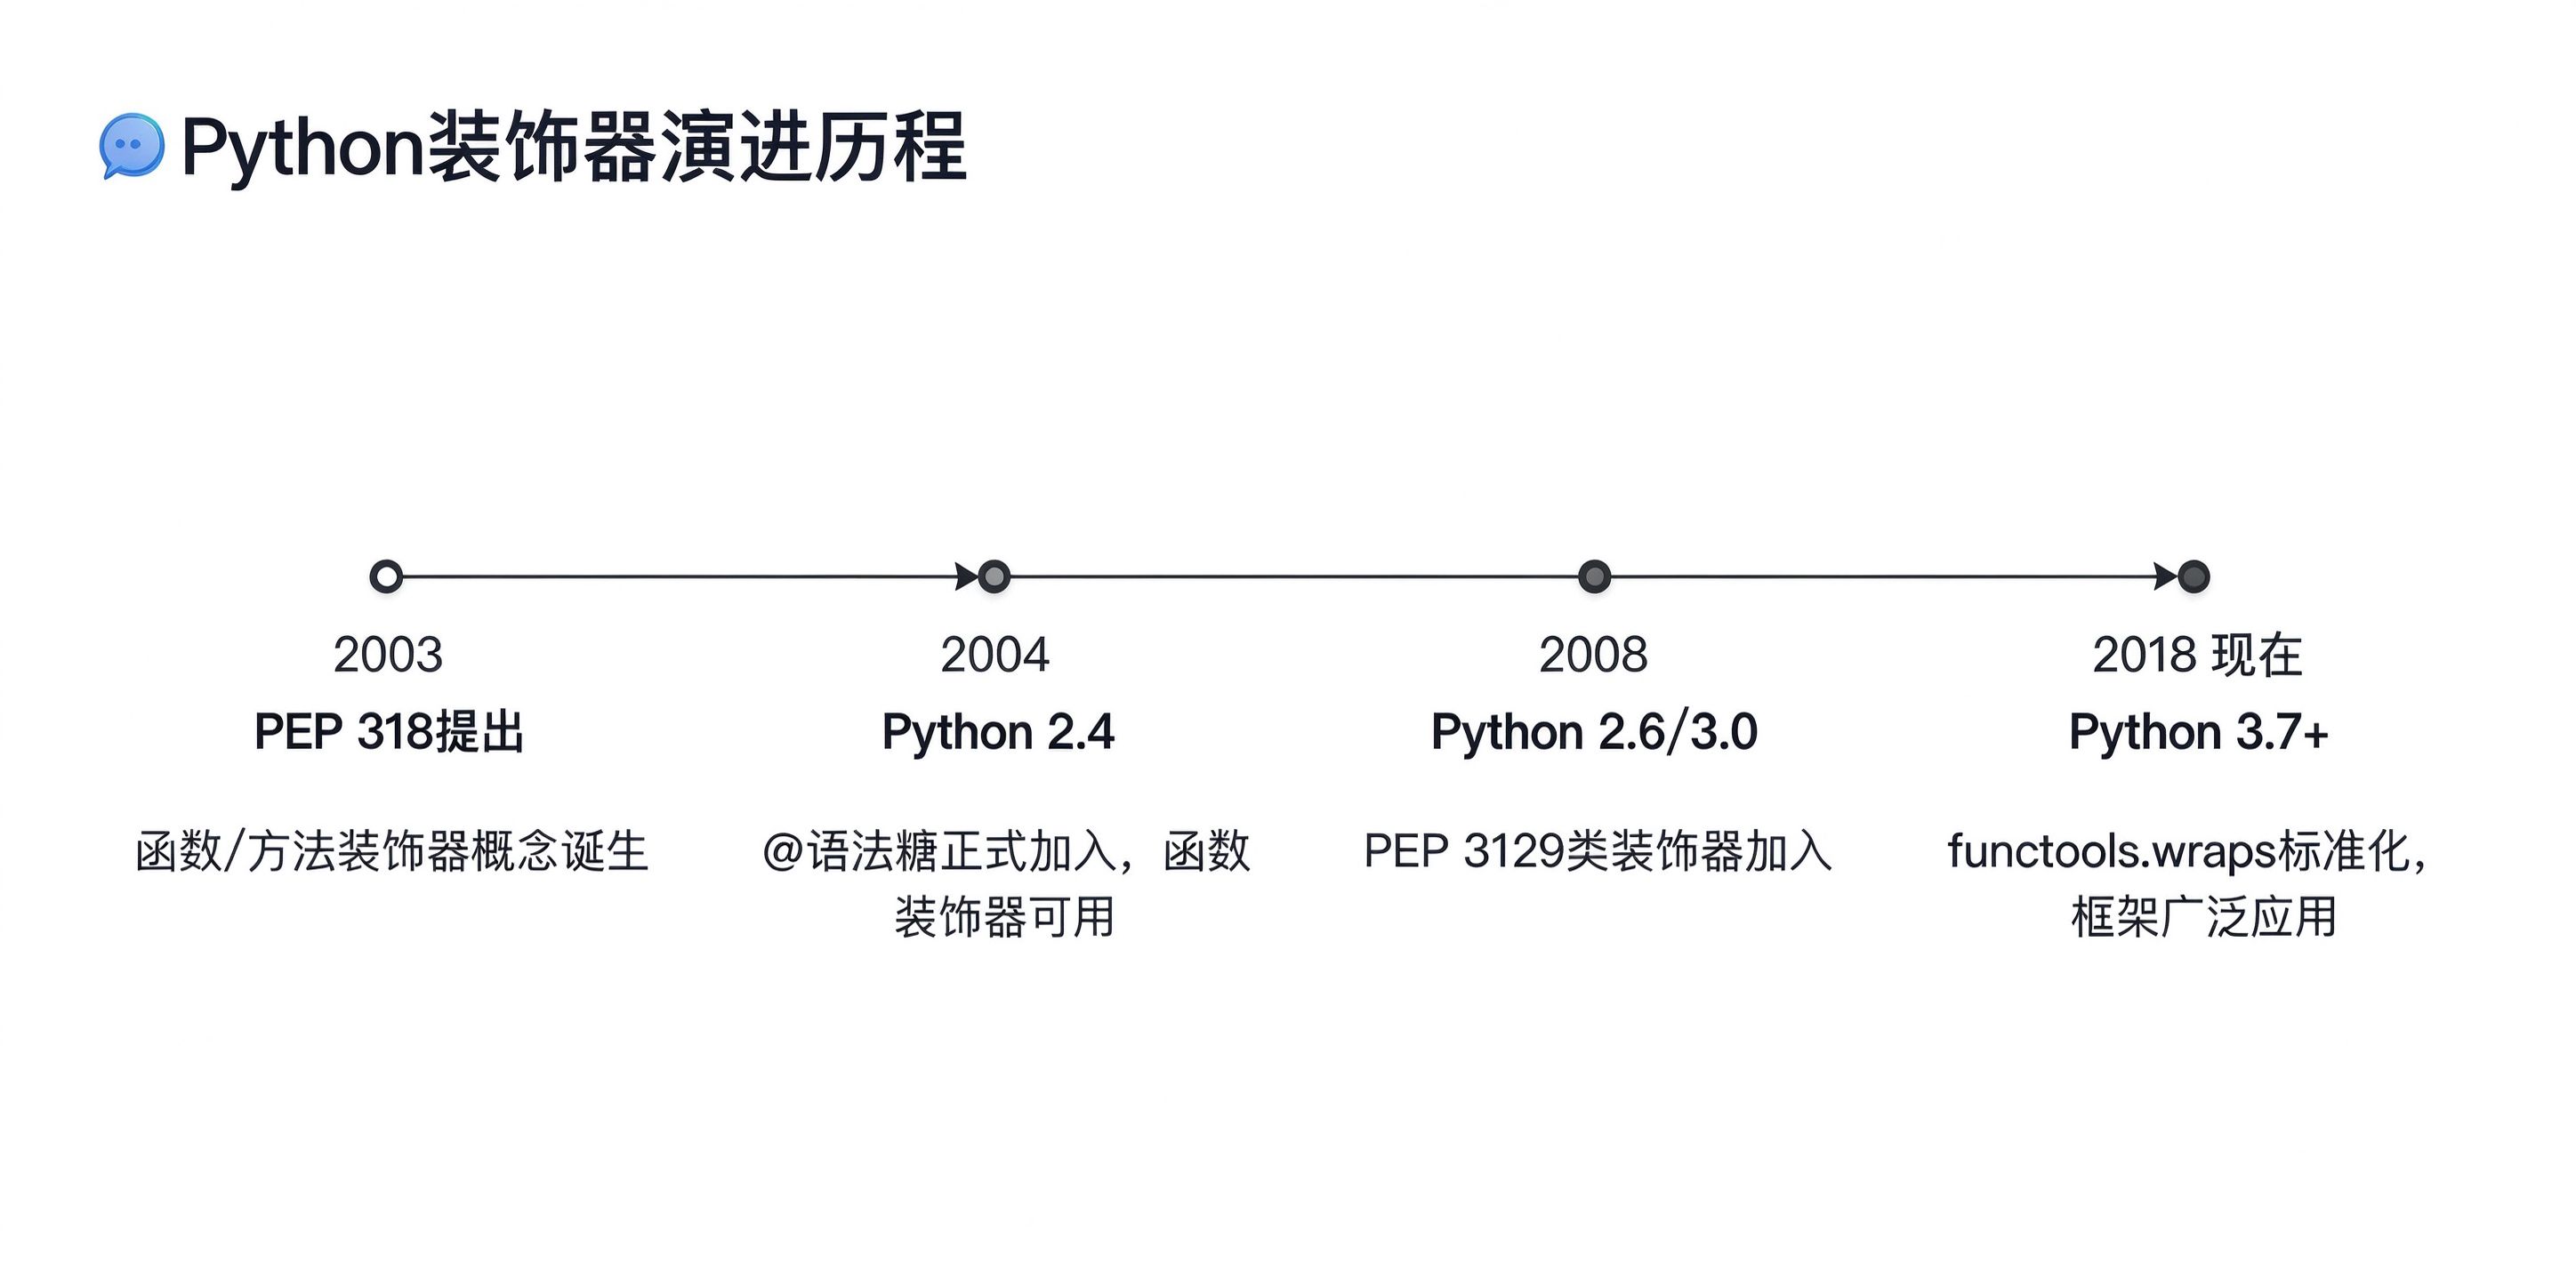
2003年,Python社区提出了PEP 318 (Decorators for Functions and Methods),正式提议为函数和方法增加装饰器语法。经过激烈讨论,最终选择了@符号作为装饰器的语法标记。
2004年,Python 2.4正式发布,装饰器语法成为官方特性。从此,你可以这样写:
python
@my_decorator
def say_hello():
print("Hello!")这行代码等价于say_hello = my_decorator(say_hello),但语义更清晰,写法更简洁。
5.3 PEP 3129:类装饰器的加入
最初,装饰器只能用于函数和方法。社区很快发现,给类也加装饰器会很有用,比如给类自动注册到某个工厂、给类添加属性、实现单例模式等。
2008年,PEP 3129 (Class Decorators)被接受,在Python 2.6和Python 3.0中正式加入了类装饰器支持:
python
def singleton(cls):
    instances = {}
    def wrapper(*args, **kwargs):
        if cls not in instances:
            instances[cls] = cls(*args, **kwargs)
        return instances[cls]
    return wrapper

@singleton
class Database:
    pass
5.4 现代Python:装饰器的全面繁荣
从Python 3.x开始,装饰器已经成为Python生态中不可或缺的一部分。functools.wraps成为标准实践,各大框架(Flask、Django、FastAPI、Celery等)大量使用装饰器,装饰器已经从一个高级特性变成了Python开发者的必备技能。
六、装饰器怎么用
6.1 最基础的装饰器
从最简单的例子开始,写一个给函数加问候语的装饰器:
python
def greet_decorator(func):
    def wrapper():
        print("==========")
        func()
        print("==========")
    return wrapper

@greet_decorator
def say_hello():
    print("Hello, World!")

say_hello()
输出结果:
==========
Hello, World!
==========
执行流程解析:
- Python解释器读到
@greet_decorator时,立即执行greet_decorator(say_hello),把say_hello函数传进去 greet_decorator内部定义了wrapper函数,然后返回它- 返回的
wrapper函数被赋值给say_hello这个名字,从此say_hello指向的不再是原来的函数,而是wrapper - 调用
say_hello()时,实际执行的是wrapper(),wrapper内部再调用原来的函数
6.2 装饰带参数的函数
上面的例子中,原函数没有参数。如果原函数有参数怎么办?用*args和**kwargs接收任意参数:
python
def outer(f):
    def inner(age):
        if age <= 0:
            age = 0
        f(age)
    return inner

@outer
def say(age):
    print('year old:', age)

say(-1)  # 输出: year old: 0
say(1)   # 输出: year old: 1
更通用的写法,支持任意参数:
python
import functools

def log_decorator(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print(f"调用 {func.__name__},位置参数: {args},关键字参数: {kwargs}")
        result = func(*args, **kwargs)
        print(f"{func.__name__} 执行完成,返回值: {result}")
        return result
    return wrapper

@log_decorator
def add(a, b, c=0):
    return a + b + c

add(1, 2, c=3)
6.3 装饰有返回值的函数
如果原函数有返回值,装饰器必须把返回值传递出去,否则调用方会拿到None:
python
import time
import functools

def timeit(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)  # 接收返回值
        end_time = time.time()
        print(f"运行时间为: {end_time - start_time:.6f}秒")
        return result  # 必须返回,否则调用方拿不到结果
    return wrapper

@timeit
def calculate_sum(n):
    return sum(range(n))

result = calculate_sum(1000000)
print(f"计算结果: {result}")
6.4 functools.wraps:保留原函数元信息
这里有一个容易踩的坑:被装饰后的函数,它的__name__和__doc__会变成装饰器内部函数的信息:
python
def my_decorator(func):
    def wrapper(*args, **kwargs):
        """这是wrapper的文档"""
        return func(*args, **kwargs)
    return wrapper

@my_decorator
def add(a, b):
    """这是add函数的文档,用于计算两个数之和"""
    return a + b

print(add.__name__)  # 输出: wrapper,而不是add
print(add.__doc__) # 输出: 这是wrapper的文档,而不是add的文档这在调试、自动生成文档、序列化时会出问题。解决方案是使用functools.wraps,它会把原函数的元信息拷贝到包装函数上:
python
import functools

def my_decorator(func):
    @functools.wraps(func)  # 加上这一行
    def wrapper(*args, **kwargs):
        """这是wrapper的文档"""
        return func(*args, **kwargs)
    return wrapper

@my_decorator
def add(a, b):
    """这是add函数的文档,用于计算两个数之和"""
    return a + b

print(add.__name__)  # 输出: add
print(add.__doc__) # 输出: 这是add函数的文档,用于计算两个数之和最佳实践:写任何装饰器都应该加上@functools.wraps(func),这是行业标准。
6.5 带参数的装饰器
有时候装饰器本身也需要接收参数,比如@retry(max_attempts=3, delay=1)。带参数的装饰器需要多嵌套一层函数:
python
import time
import functools

def log(level):
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            print(f"[{level}] 函数 {func.__name__} 开始执行")
            result = func(*args, **kwargs)
            print(f"[{level}] 函数 {func.__name__} 执行结束")
            return result
        return wrapper
    return decorator

@log("DEBUG")  # 先执行log("DEBUG"),返回decorator,再执行decorator(add)
def add(a, b):
    return a + b

add(1, 2)
执行流程:
@log("DEBUG")先执行log("DEBUG"),返回内部的decorator函数- 然后用返回的
decorator去装饰add,即add = decorator(add) - 最终
add被替换为wrapper
再看一个更实用的例子,带参数的重试装饰器:
python
import time
import functools

def retry(max_attempts=3, delay=1):
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            for attempt in range(1, max_attempts + 1):
                try:
                    return func(*args, **kwargs)
                except Exception as e:
                    print(f"第 {attempt}/{max_attempts} 次尝试失败: {e}")
                    if attempt < max_attempts:
                        time.sleep(delay)
            raise Exception(f"函数 {func.__name__} 在 {max_attempts} 次尝试后仍然失败")
        return wrapper
    return decorator

@retry(max_attempts=3, delay=2)
def call_external_api():
    # 模拟调用外部接口,可能失败
    import random
    if random.random() < 0.7:
        raise ConnectionError("网络超时")
    return {"status": "success"}

result = call_external_api()
print(result)
6.6 多个装饰器的叠加
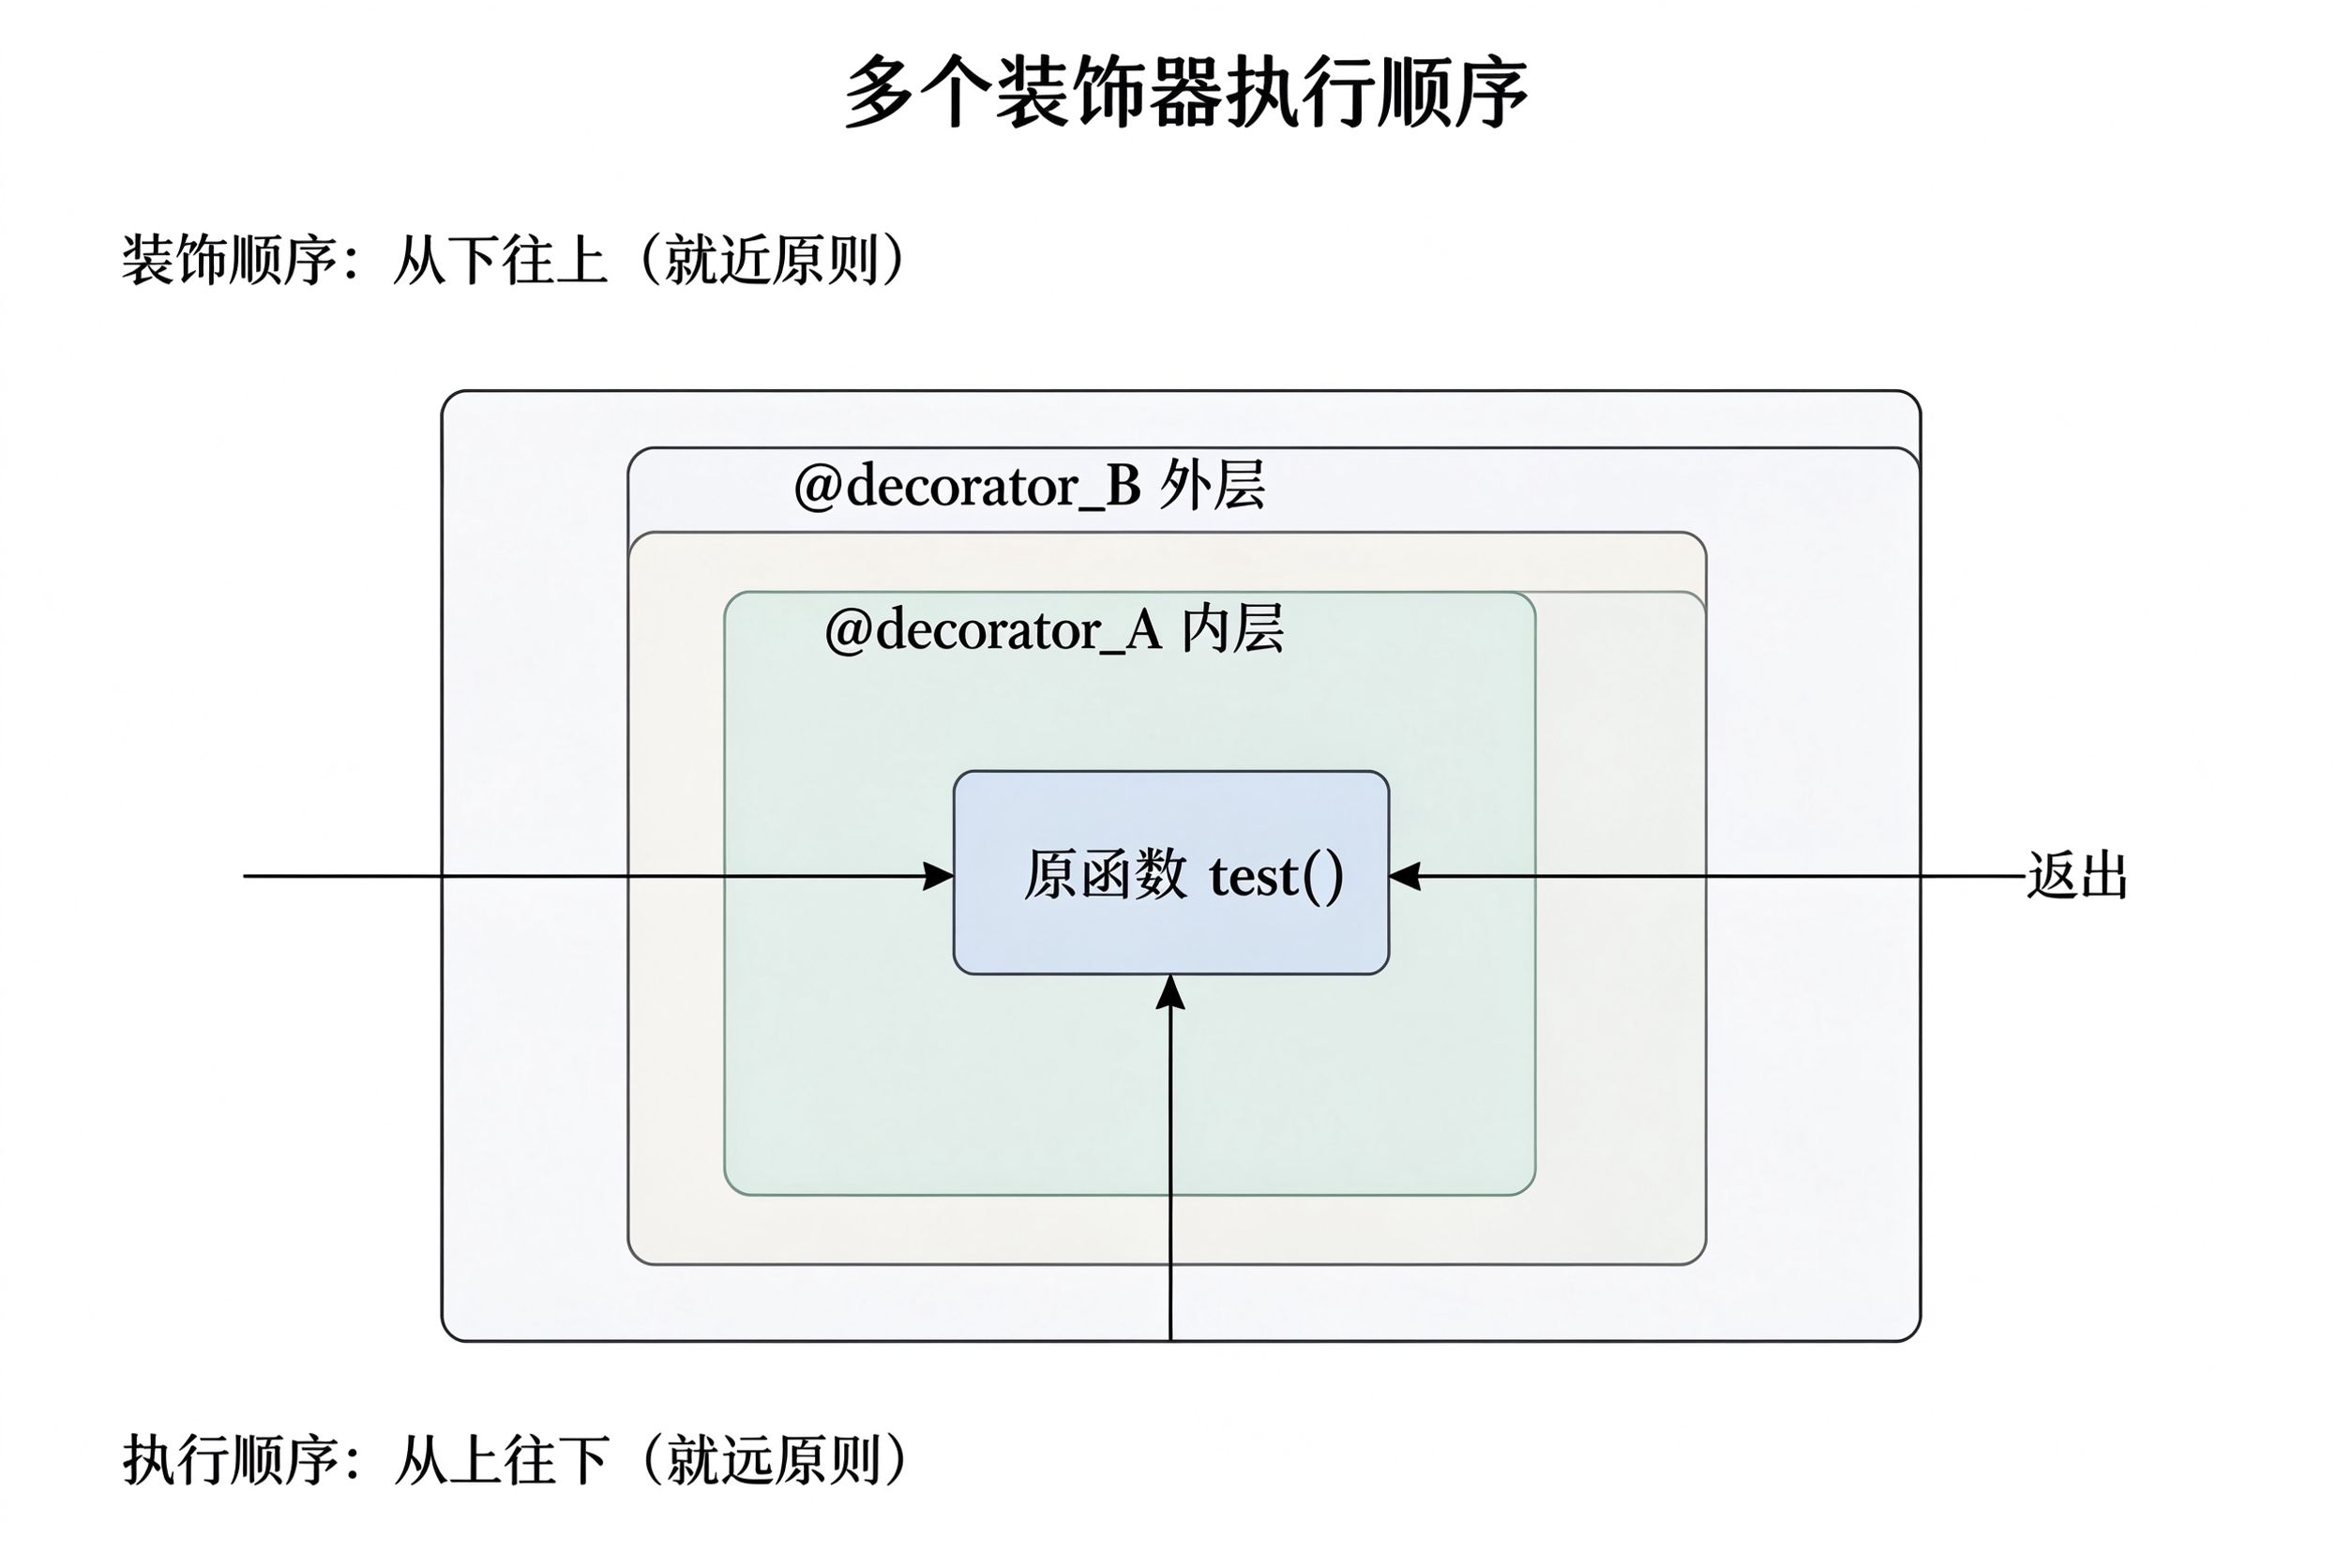
一个函数可以被多个装饰器同时装饰,这时候需要注意执行顺序:
python
def decorator_a(func):
    print("装饰器A被加载")
    def wrapper(*args, **kwargs):
        print("进入装饰器A")
        result = func(*args, **kwargs)
        print("退出装饰器A")
        return result
    return wrapper

def decorator_b(func):
    print("装饰器B被加载")
    def wrapper(*args, **kwargs):
        print("进入装饰器B")
        result = func(*args, **kwargs)
        print("退出装饰器B")
        return result
    return wrapper

@decorator_b
@decorator_a
def test():
    print("执行test函数")
    return "done"

test()
输出结果:
装饰器A被加载
装饰器B被加载
进入装饰器B
进入装饰器A
执行test函数
退出装饰器A
退出装饰器B
核心规则:
- 装饰顺序(加载顺序):从下往上,就近原则。 离函数最近的装饰器先被应用。上面的例子等价于
test = decorator_b(decorator_a(test)),所以先执行decorator_a(test),再执行decorator_b(...)。 - 执行顺序(调用顺序):从上往下,就远原则。 调用时,离函数最远的(最上面的)装饰器先进入。上面的例子中,先进入B,再进入A,执行完原函数后,先退出A,再退出B,就像洋葱一样,一层一层往里进,再一层一层往外出。
6.7 类装饰器
除了函数装饰器,Python还支持类装饰器,用于修改或增强类的行为:
python
import functools

def add_repr(cls):
    """给类自动添加__repr__方法"""
    def __repr__(self):
        attrs = ', '.join(f'{k}={v!r}' for k, v in vars(self).items())
        return f'{cls.__name__}({attrs})'
    cls.__repr__ = __repr__
    return cls

@add_repr
class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

p = Point(3, 4)
print(p)  # 输出: Point(x=3, y=4)
类装饰器的典型应用场景包括:单例模式、自动注册、属性校验、混入(Mixin)功能等。
七、企业项目中如何使用装饰器
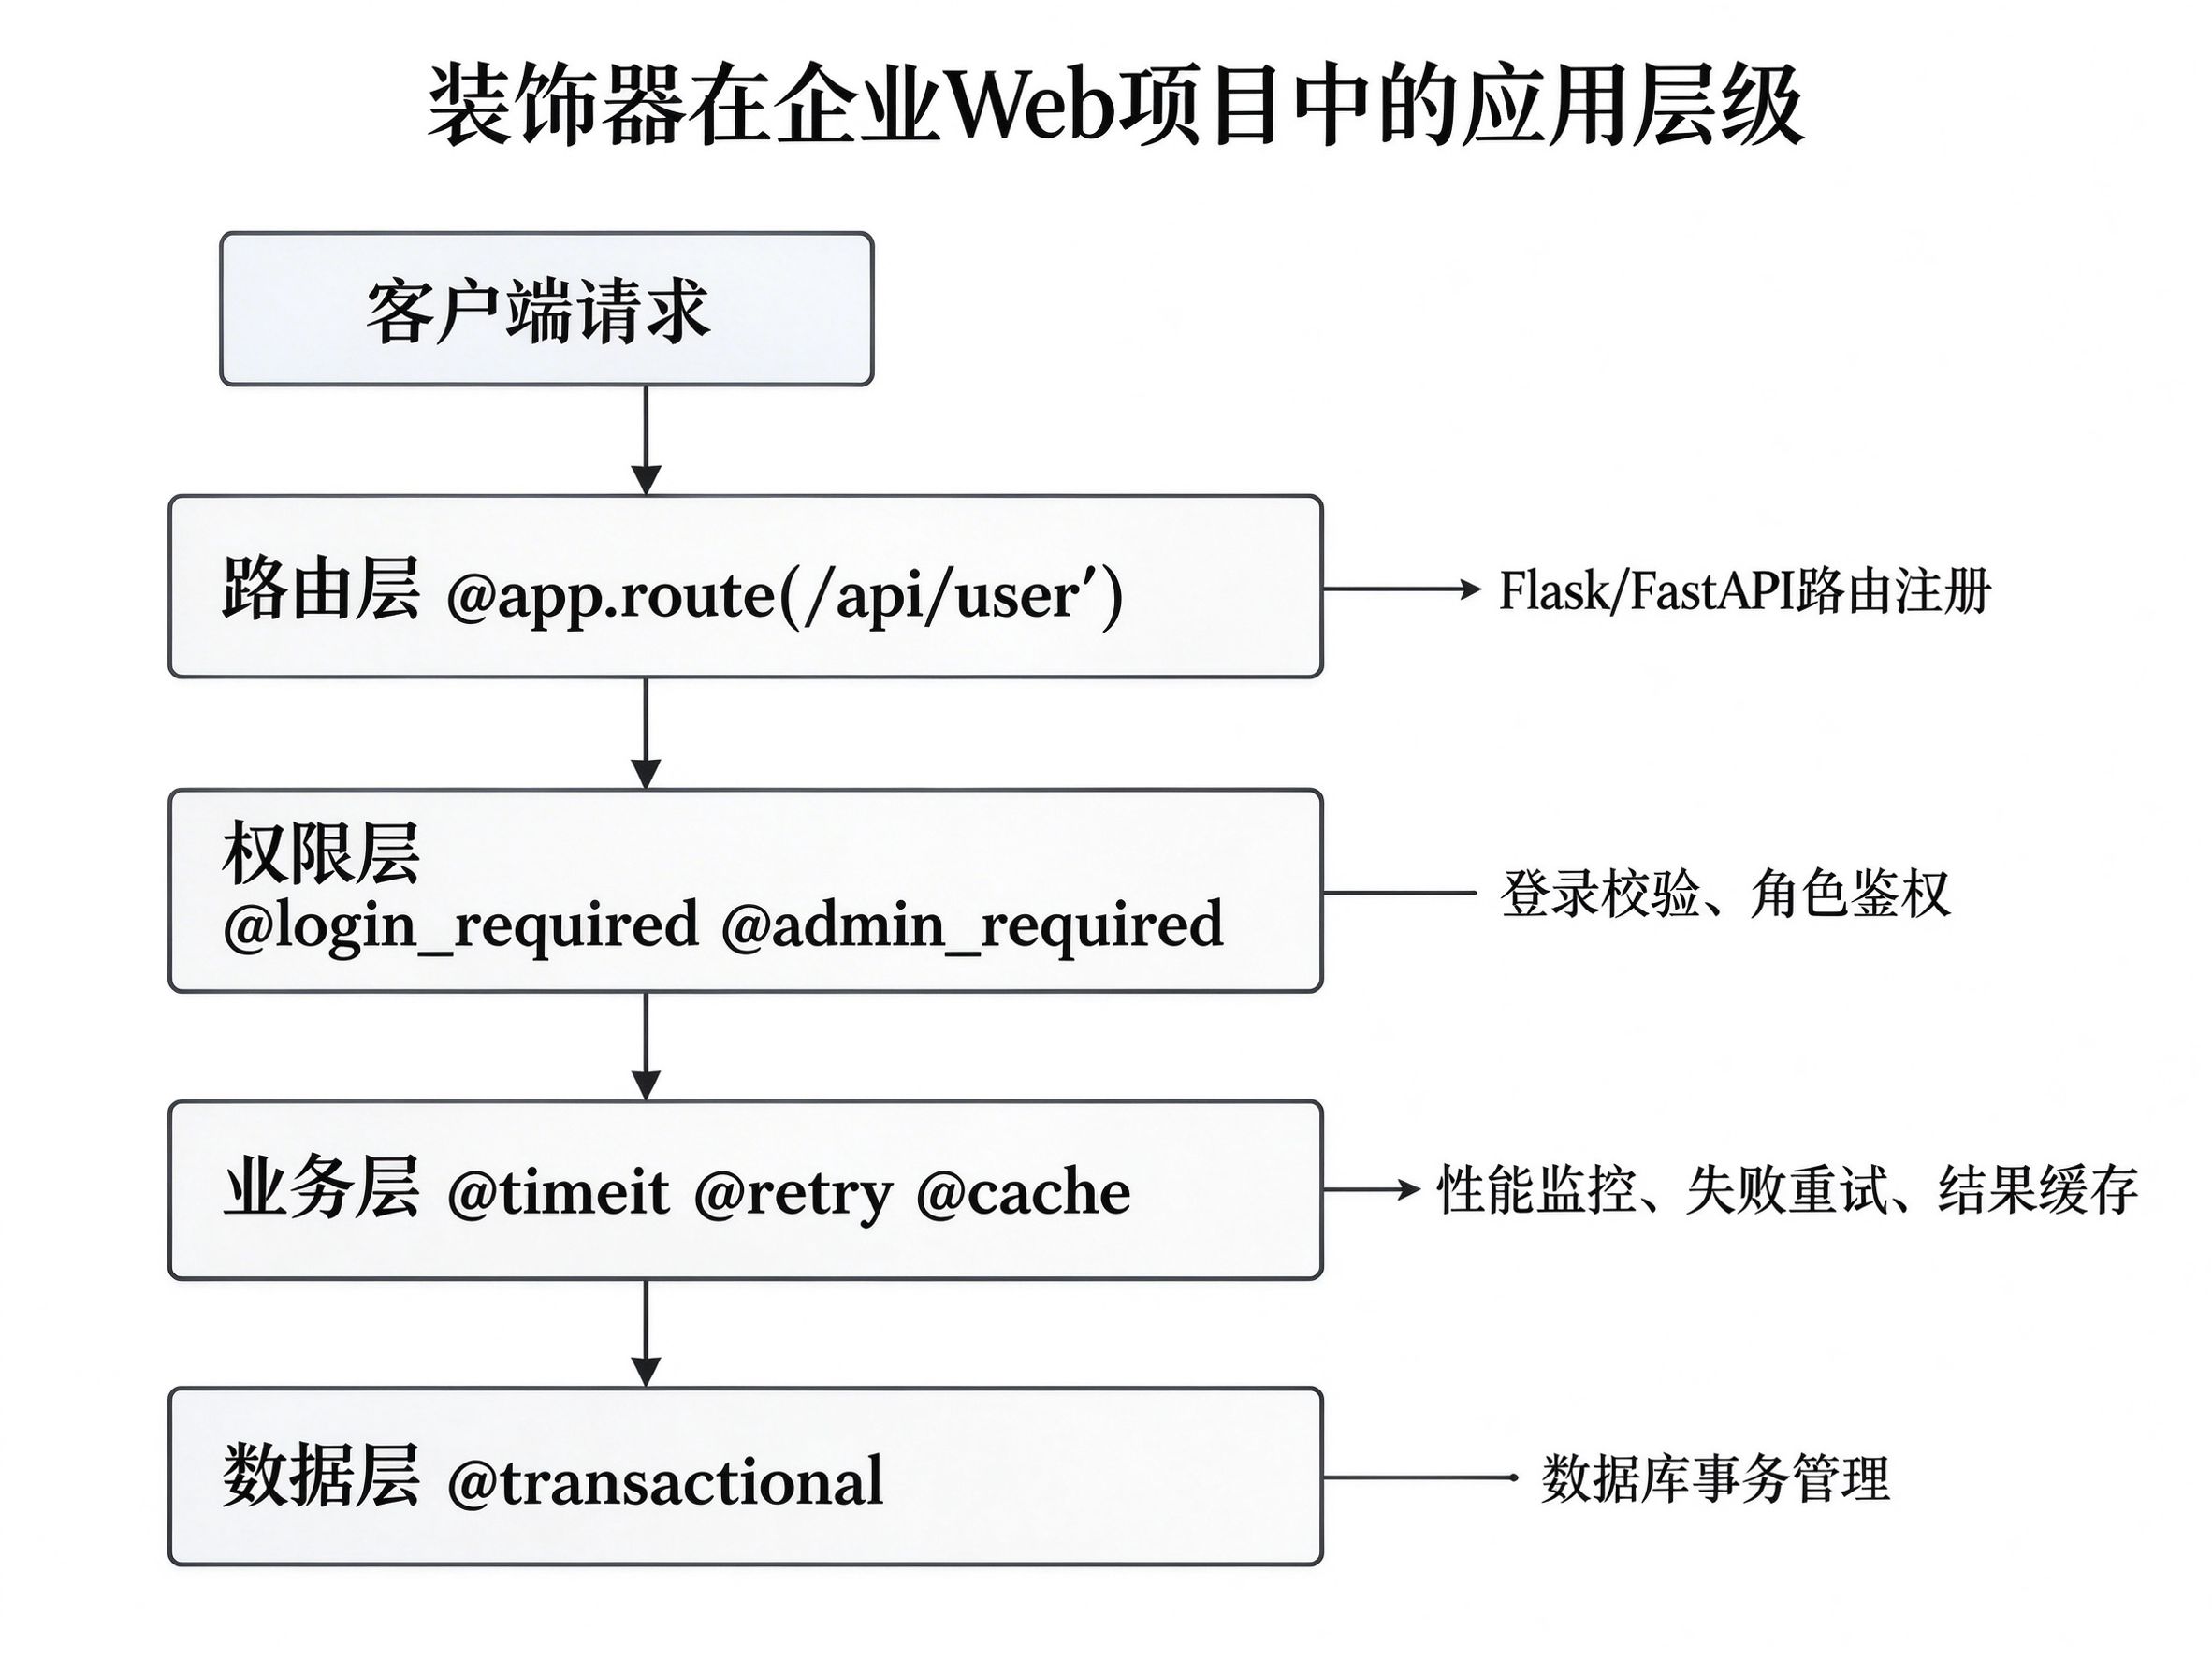
在真实的企业项目中,装饰器无处不在。下面介绍几个最常用的企业级场景,每个都附带可直接运行的代码。
7.1 场景一:接口权限校验
在Web项目中,几乎所有接口都需要校验用户是否登录、是否有权限访问。用装饰器封装后,代码非常优雅:
python
import functools
from flask import request, jsonify, session

def login_required(func):
    """校验用户是否已登录"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        user_id = session.get('user_id')
        if not user_id:
            return jsonify({"code": 401, "msg": "请先登录"}), 401
        return func(*args, **kwargs)
    return wrapper

def admin_required(func):
    """校验用户是否为管理员"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        user_role = session.get('user_role')
        if user_role != 'admin':
            return jsonify({"code": 403, "msg": "权限不足,需要管理员权限"}), 403
        return func(*args, **kwargs)
    return wrapper

# 使用示例
@app.route('/api/user/info')
@login_required
def get_user_info():
    user_id = session['user_id']
    user = user_service.get_by_id(user_id)
    return jsonify({"code": 0, "data": user})

@app.route('/api/admin/users')
@login_required
@admin_required
def get_all_users():
    users = user_service.get_all()
    return jsonify({"code": 0, "data": users})
7.2 场景二:性能监控与计时
在微服务架构中,监控每个接口的响应时间是基本操作。装饰器可以一行代码接入:
python
import time
import functools
import logging

logger = logging.getLogger(__name__)

def monitor(func):
    """性能监控装饰器:记录执行时间、异常信息"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        try:
            result = func(*args, **kwargs)
            elapsed = time.perf_counter() - start_time
            logger.info(f"[Monitor] {func.__name__} 执行成功,耗时: {elapsed:.4f}秒")
            # 实际项目中可以把耗时上报到Prometheus、Grafana等监控系统
            return result
        except Exception as e:
            elapsed = time.perf_counter() - start_time
            logger.error(f"[Monitor] {func.__name__} 执行失败,耗时: {elapsed:.4f}秒,异常: {e}")
            raise
    return wrapper

@monitor
def query_order_report(start_date, end_date):
    """查询订单报表,可能耗时较长"""
    return report_service.query_by_date_range(start_date, end_date)
7.3 场景三:结果缓存
对于计算密集型或查询密集型函数,缓存结果可以大幅提升性能。装饰器可以透明地添加缓存能力:
python
import functools
import time

def cache(func):
    """简单的内存缓存装饰器"""
    cache_data = {}

    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        # 用参数作为缓存key,注意kwargs需要排序以保证一致性
        key = (args, tuple(sorted(kwargs.items())))
        if key in cache_data:
            print(f"[Cache] 命中缓存: {func.__name__}{args}")
            return cache_data[key]
        result = func(*args, **kwargs)
        cache_data[key] = result
        return result
    return wrapper

@cache
def fibonacci(n):
    """计算斐波那契数列,递归计算非常慢"""
    if n <= 1:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

# 有了缓存,计算第100项也很快
print(fibonacci(100))实际项目中,更推荐使用Python标准库的functools.lru_cache,它支持最大缓存数量、缓存统计等功能:
python
from functools import lru_cache

@lru_cache(maxsize=128)
def fibonacci(n):
    if n <= 1:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)
如果需要分布式缓存(Redis),可以自己写一个装饰器:
python
import json
import functools
import redis

redis_client = redis.Redis(host='localhost', port=6379, db=0)

def redis_cache(expire_seconds=300):
    """Redis分布式缓存装饰器"""
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            key = f"cache:{func.__name__}:{args}:{sorted(kwargs.items())}"
            cached = redis_client.get(key)
            if cached:
                return json.loads(cached)
            result = func(*args, **kwargs)
            redis_client.setex(key, expire_seconds, json.dumps(result))
            return result
        return wrapper
    return decorator

@redis_cache(expire_seconds=600)
def get_product_detail(product_id):
    return product_service.query(product_id)
7.4 场景四:数据库事务管理
在业务代码中,确保一系列数据库操作的原子性非常重要。装饰器可以自动处理事务的开启、提交和回滚:
python
import functools
from sqlalchemy.orm import sessionmaker
from sqlalchemy import create_engine

engine = create_engine('mysql+pymysql://user:password@localhost/dbname')
Session = sessionmaker(bind=engine)

def transactional(func):
    """数据库事务装饰器:自动开启、提交、回滚事务"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        session = Session()
        try:
            # 把session注入到函数参数中
            kwargs['db_session'] = session
            result = func(*args, **kwargs)
            session.commit()
            return result
        except Exception as e:
            session.rollback()
            print(f"事务回滚: {e}")
            raise
        finally:
            session.close()
    return wrapper

@transactional
def create_order_and_deduct_stock(user_id, product_id, quantity, db_session=None):
    """创建订单并扣减库存,两个操作必须在同一个事务中"""
    # 扣减库存
    product = db_session.query(Product).filter_by(id=product_id).with_for_update().first()
    if product.stock < quantity:
        raise ValueError("库存不足")
    product.stock -= quantity

    # 创建订单
    order = Order(user_id=user_id, product_id=product_id, quantity=quantity)
    db_session.add(order)

    return order.id
7.5 场景五:接口限流
在高并发场景下,防止接口被恶意刷请求,限流是必备功能:
python
import time
import functools
from collections import defaultdict

def rate_limit(max_calls=100, period=60):
    """
    接口限流装饰器:固定时间窗口内最多允许max_calls次调用
    实际项目中建议使用Redis实现分布式限流
    """
    call_records = defaultdict(list)

    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            # 用用户ID或IP作为限流key,这里简化用函数名
            key = func.__name__
            now = time.time()
            # 清理过期的调用记录
            call_records[key] = [t for t in call_records[key] if now - t < period]
            if len(call_records[key]) >= max_calls:
                raise Exception(f"请求过于频繁,请在{period}秒后重试")
            call_records[key].append(now)
            return func(*args, **kwargs)
        return wrapper
    return decorator

@rate_limit(max_calls=5, period=10)
def send_sms(phone, code):
    """发送短信验证码,限制调用频率防止被刷"""
    print(f"向 {phone} 发送验证码: {code}")
    return True
7.6 场景六:参数校验
在接口开发中,校验入参的合法性是必不可少的环节。装饰器可以统一处理:
python
import functools

def validate_params(required_fields=None, field_types=None):
    """
    参数校验装饰器
    required_fields: 必填字段列表
    field_types: 字段类型映射字典
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            data = args[0] if args else {}
            # 校验必填字段
            if required_fields:
                for field in required_fields:
                    if field not in data or data[field] is None:
                        raise ValueError(f"缺少必填字段: {field}")
            # 校验字段类型
            if field_types:
                for field, expected_type in field_types.items():
                    if field in data and not isinstance(data[field], expected_type):
                        raise TypeError(
                            f"字段 {field} 类型错误,期望 {expected_type.__name__},"
                            f"实际 {type(data[field]).__name__}"
                        )
            return func(*args, **kwargs)
        return wrapper
    return decorator

@validate_params(
    required_fields=['username', 'password', 'email'],
    field_types={'username': str, 'age': int}
)
def register_user(data):
    """用户注册接口"""
    print(f"注册用户: {data['username']}")
    return {"code": 0, "msg": "注册成功"}
八、装饰器与相关方案的对比
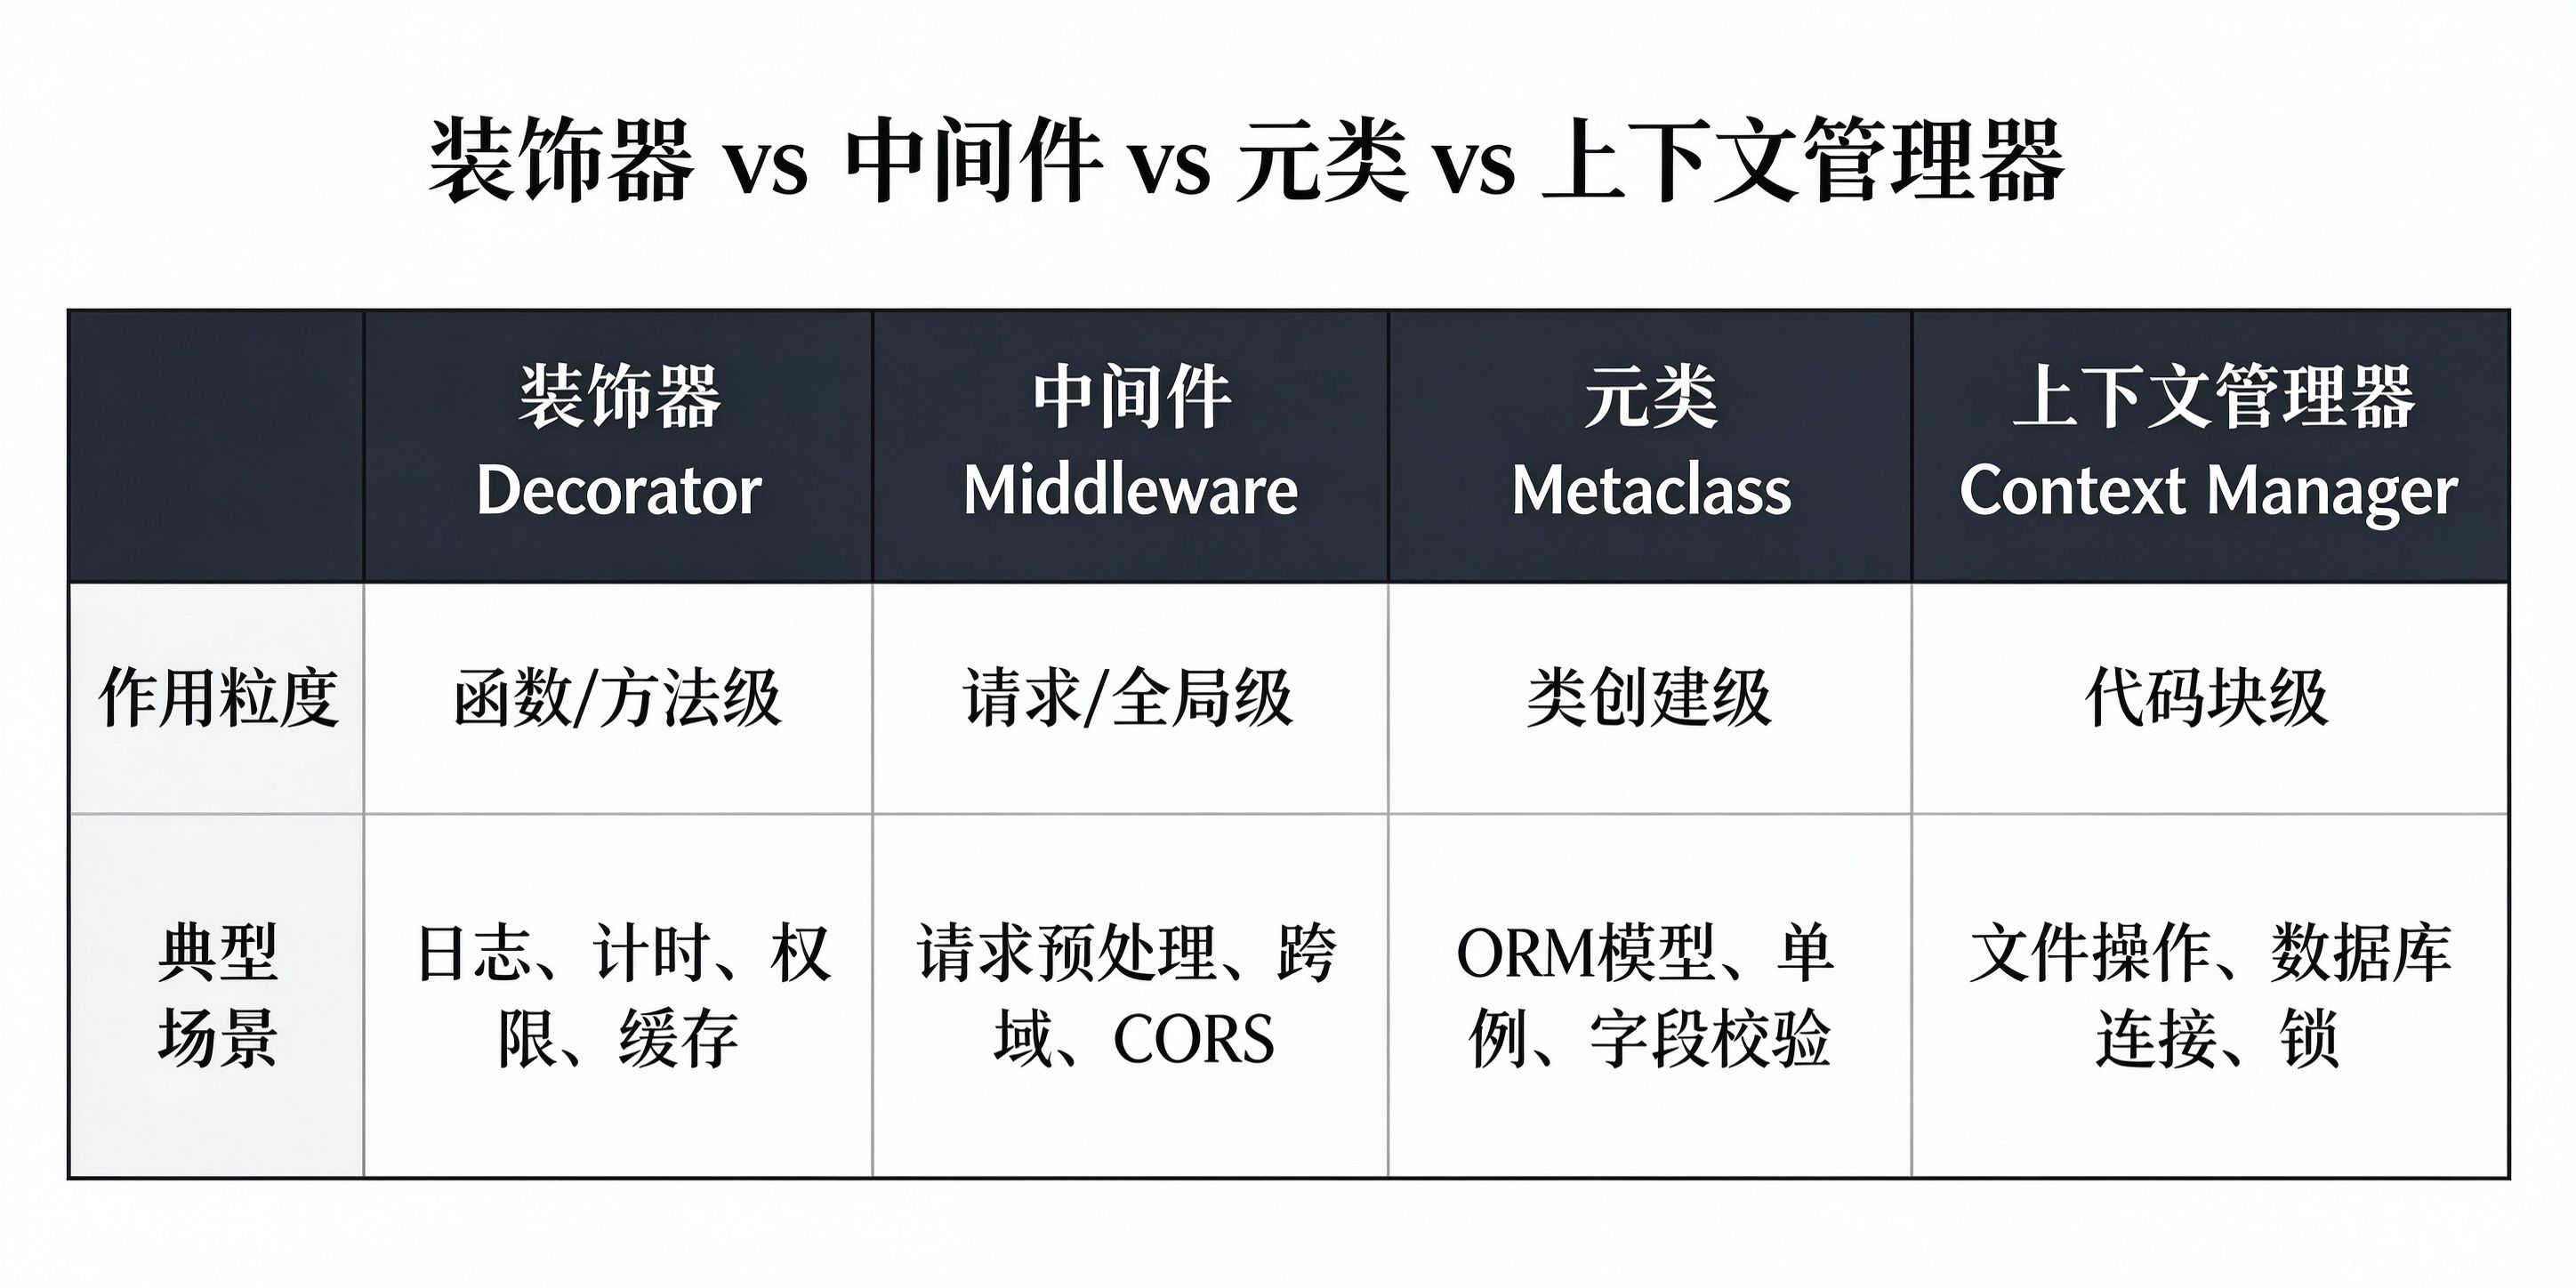
在Python中,实现"给代码增加额外功能"的方式不止装饰器一种。下面对比四种最常见的方案,帮你在实际项目中做出正确选择。
8.1 详细对比表
| 对比维度 | 装饰器 Decorator | 中间件 Middleware | 元类 Metaclass | 上下文管理器 Context Manager |
|---|---|---|---|---|
| 作用粒度 | 函数/方法级 | 请求/全局级 | 类创建级 | 代码块级 |
| 核心原理 | 高阶函数+闭包 | 请求处理管道 | 类的创建钩子 | __enter__/__exit__ |
| 语法形式 | @decorator |
注册到框架 | class Meta(type) |
with ... as ... |
| 典型场景 | 日志、计时、权限、缓存、重试、限流 | 请求预处理、跨域CORS、全局异常处理 | ORM模型定义、单例模式、字段自动校验 | 文件操作、数据库连接、锁、资源清理 |
| 侵入性 | 低,只需加一行注解 | 中,需要框架支持 | 高,改变类创建逻辑 | 低,包裹代码块 |
| 灵活度 | 高,可叠加、可传参 | 中,按固定顺序执行 | 极高,可完全控制类 | 中,仅控制进入和退出 |
| 学习曲线 | 中等 | 中等 | 陡峭 | 简单 |
| 代表框架 | Flask、FastAPI、Django | Django、Flask、FastAPI | Django ORM、SQLAlchemy | Python标准库 |
8.2 各自的优势与劣势
装饰器的优势:
- 粒度最细,可以精确控制到单个函数
- 灵活度高,支持叠加、传参、条件应用
- 语法简洁,声明式风格,可读性好
- 不依赖特定框架,纯Python特性
装饰器的劣势:
- 多个装饰器叠加时,执行顺序容易搞混
- 调试时堆栈跟踪会变长,定位问题稍复杂
- 不适合处理全局的、跨函数的横切逻辑
中间件的优势:
- 适合处理全局请求逻辑,一次配置全局生效
- 执行顺序明确,按注册顺序依次执行
- 可以在请求到达业务逻辑之前和响应返回之后做处理
中间件的劣势:
- 粒度粗,无法针对单个函数定制
- 依赖Web框架,不是纯Python特性
- 所有请求都会经过,无法灵活跳过
元类的优势:
- 可以在类创建阶段做深度定制,能力最强
- 适合框架级别的魔法,比如ORM的字段映射
- 一次定义,所有子类自动继承
元类的劣势:
- 学习曲线最陡峭,理解成本高
- 过度使用会让代码变得晦涩难懂
- 调试困难,元类相关的bug很难定位
上下文管理器的优势:
- 最适合资源管理,确保资源一定被释放
- 语法简洁,
with语句可读性好 - 即使发生异常也能保证清理逻辑执行
上下文管理器的劣势:
- 只能包裹代码块,不能透明地增强函数
- 不适合给函数增加行为,适合管理资源生命周期
- 无法像装饰器那样叠加使用
8.3 选型建议
- 给单个函数加日志、计时、权限、缓存:用装饰器
- 给所有请求统一处理跨域、鉴权、日志:用中间件
- 写ORM框架、需要自动处理类属性:用元类
- 管理文件、连接、锁等资源的打开和关闭:用上下文管理器
实际项目中,这四种方式经常配合使用,比如Django框架同时使用了中间件(请求处理)、装饰器(@login_required)、元类(ORM模型)和上下文管理器(transaction.atomic())。
九、装饰器的常用场景总结
根据企业项目的实践经验,装饰器的常用场景可以归纳为以下几类:
| 场景分类 | 具体用途 | 典型装饰器 |
|---|---|---|
| 日志监控 | 函数调用日志、执行时间、异常捕获 | @log、@timeit、@monitor |
| 权限安全 | 登录校验、角色鉴权、接口签名验证 | @login_required、@admin_required |
| 性能优化 | 结果缓存、延迟计算、内存优化 | @cache、@lru_cache、@lazy_property |
| 可靠性 | 自动重试、熔断降级、限流 | @retry、@circuit_breaker、@rate_limit |
| 数据管理 | 事务管理、数据校验、类型转换 | @transactional、@validate |
| 框架功能 | 路由注册、信号处理、任务调度 | @app.route、@celery.task、@app.on_event |
| 设计模式 | 单例模式、观察者模式、代理模式 | @singleton、@observer |
十、面试官高频面试题
面试题1:什么是装饰器?它的原理是什么?
参考答案:
装饰器是Python中一种用于修改函数或类行为的语法结构,本质上是一个接收函数作为参数、返回一个新函数的高阶函数。它的原理基于两个Python核心特性:
- 函数是一等公民:函数可以作为参数传递、作为返回值返回
- 闭包:内部函数可以记住外部函数作用域的变量
@decorator语法糖等价于func = decorator(func),装饰器在不修改原函数代码、不改变调用方式的前提下,为函数增加额外功能。
面试题2:装饰器装饰后的函数,函数名和文档字符串会变成什么?怎么解决?
参考答案:
被装饰后的函数,它的__name__和__doc__会变成装饰器内部包装函数(通常叫wrapper)的名字和文档,而不是原函数的。这会导致调试、自动生成文档时出现问题。
解决方案是使用functools.wraps装饰器,它会把原函数的元信息(__name__、__doc__、__module__等)拷贝到包装函数上:
python
import functools

def my_decorator(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper
面试题3:多个装饰器装饰同一个函数时,执行顺序是怎样的?
参考答案:
多个装饰器的执行遵循两个原则:
- 装饰顺序(加载顺序):从下往上,就近原则。 离函数最近的装饰器先被应用。
@A@Bdef f()等价于f = A(B(f)),所以B先装饰,A后装饰。 - 执行顺序(调用顺序):从上往下,就远原则。 调用时,最上面的装饰器先进入,像洋葱一样一层一层往里进,执行完原函数后再一层一层往外出。
面试题4:带参数的装饰器怎么实现?为什么要多嵌套一层?
参考答案:
带参数的装饰器需要三层嵌套:最外层接收装饰器的参数,中间层接收被装饰的函数,最内层是实际的包装逻辑。
python
def retry(max_attempts=3):
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            # 可以使用max_attempts和func
            pass
        return wrapper
return decorator多嵌套一层的原因是:@retry(max_attempts=3)会先执行retry(max_attempts=3),这个调用必须返回一个真正的装饰器(接收函数的函数)。所以最外层负责接收参数并返回装饰器,中间层才是真正的装饰器。
面试题5:装饰器和闭包是什么关系?
参考答案:
装饰器是闭包的一种典型应用。闭包是指一个内部函数引用了外部函数的变量,并且外部函数返回了这个内部函数。装饰器中的wrapper函数就是一个闭包,它引用了外部函数decorator的参数func(原函数),即使decorator执行完毕,wrapper仍然记得func。
可以说,没有闭包就没有装饰器。闭包是底层机制,装饰器是基于闭包的语法糖和设计模式。
面试题6:写一个记录函数执行时间的装饰器
参考答案:
python
import time
import functools

def timeit(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        result = func(*args, **kwargs)
        end = time.perf_counter()
        print(f"函数 {func.__name__} 执行耗时: {end - start:.6f}秒")
        return result
return wrapper这是最经典的装饰器面试题,必须熟练掌握。注意三个要点:用*args, **kwargs支持任意参数、用result接收并返回原函数的返回值、用functools.wraps保留元信息。
面试题7:类装饰器和函数装饰器有什么区别?
参考答案:
函数装饰器接收一个函数,返回一个新函数,用于增强函数的行为。类装饰器接收一个类,返回一个新类(或修改后的类),用于增强类的行为。
类装饰器的典型应用包括:给类自动添加方法、实现单例模式、自动注册类到工厂、给类的属性添加校验等。类装饰器的实现原理和函数装饰器一样,都是高阶函数+闭包,只是操作对象从函数变成了类。
面试题8:装饰器有什么缺点?使用时需要注意什么?
参考答案:
装饰器的主要缺点和注意事项:
- 元信息丢失 :被装饰后函数名和文档会变,必须用
functools.wraps解决 - 调试困难:多层装饰器叠加后,调用栈变深,异常堆栈跟踪不够直观
- 性能开销:每次调用都会多一层函数调用,虽然开销很小,但对性能极致要求的场景需要注意
- 执行顺序易错:多个装饰器叠加时,装饰顺序和执行顺序容易搞混
- 类型提示问题 :装饰器可能破坏静态类型检查,需要用
typing模块的Callable等正确标注 - 不要滥用:装饰器虽好,但不要什么都用装饰器,过度使用会让代码逻辑变得不透明,增加理解成本
十一、总结
Python装饰器是Python语言中最优雅、最实用的特性之一。它本质上是高阶函数与闭包的结合,通过@语法糖实现了在不修改原函数代码的前提下动态增强函数行为的能力。
从最基础的函数装饰器,到带参数的装饰器、多个装饰器叠加、类装饰器,装饰器的用法灵活多变。在企业项目中,装饰器广泛应用于日志监控、权限校验、性能缓存、事务管理、限流重试等场景,是每个Python开发者必须掌握的核心技能。
学习装饰器的关键在于理解它的本质:函数是一等公民、闭包记住状态、语法糖简化写法。掌握了这三点,装饰器就不再是黑魔法,而是你手中的利器。
希望这篇文章能帮你彻底搞懂Python装饰器,从入门到企业级实战,面试再也不慌。如果觉得有帮助,欢迎点赞收藏关注。
转载声明:本文为原创文章,如需转载,请联系作者获得授权,并注明出处。