C语言核心语法:
基础1:
- 1.程序结构
- (1)导入库(头文件)
- stdio.h 标准输入输出库 (在代码中使用的scanf printf等函数都是这个库中的)
- (1)导入库(头文件)
c
#include <stdio.h>
int main(){
	printf("Hello World!\n");

	int num=0;
	scanf("%d",&num);
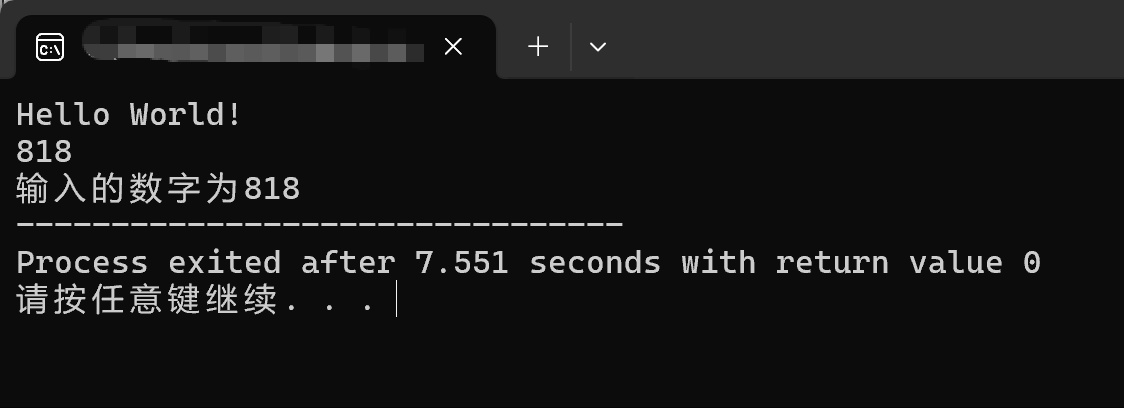
	printf("输入的数字为%d",num);

}
结果:
    - stdlib.h 动态内存分配 malloc 数值类型转换
        - malloc 用于在堆区动态分配内存,返回 void* 指针,需要强转为目标类型
        - 数值类型转换:使用 (类型名) 进行强制类型转换,如 (int*)、(double*) 等
c
            #include <stdio.h>
            #include <stdlib.h>   // malloc 所在库

            int main() {
                // 1. 动态分配 3 个 int 大小的内存,并强转为 int*
                int *p = (int*)malloc(3 * sizeof(int));
                if (p == NULL) {
                    printf("内存分配失败\n");
                    return 1;
                }

                // 2. 通过指针赋值
                p[0] = 10;
                p[1] = 20;
                p[2] = 30;

                // 3. 打印结果
                for (int i = 0; i < 3; i++) {
                    printf("p[%d] = %d\n", i, p[i]);
                }

                // 4. 释放内存
                free(p);
                return 0;
} - 运行结果:
p[0] = 10
p[1] = 20
p[2] = 30
- 数值类型转换示例:
c
                int *ip = (int*)malloc(sizeof(int));       // 分配 int 大小
                double *dp = (double*)malloc(sizeof(double)); // 分配 double 大小
char *cp = (char*)malloc(sizeof(char)); // 分配 char 大小 - 要点:
- malloc 返回 void*,必须强转为目标指针类型
- 分配后要检查是否为 NULL,防止分配失败
- 使用完必须 free 释放,避免内存泄漏
- math.h 数学函数库 (提供 sqrt 开方、pow 幂运算、abs 绝对值等数学函数)
c
            #include <stdio.h>
            #include <math.h>   // 数学函数所在库

            int main() {
                double x = 9.0;
                double y = 2.0;

                // 1. sqrt 开平方
                printf("sqrt(%.1f) = %.2f\n", x, sqrt(x));

                // 2. pow 幂运算:2 的 3 次方
                printf("pow(%.1f, %.1f) = %.2f\n", y, 3.0, pow(y, 3.0));

                // 3. fabs 浮点数绝对值
                printf("fabs(-5.5) = %.2f\n", fabs(-5.5));

                // 4. ceil 向上取整、floor 向下取整
                printf("ceil(3.2) = %.0f, floor(3.2) = %.0f\n", ceil(3.2), floor(3.2));

                return 0;
            }
运行结果:
                sqrt(9.0) = 3.00
                pow(2.0, 3.0) = 8.00
                fabs(-5.5) = 5.50
ceil(3.2) = 4, floor(3.2) = 3-
要点:
-
使用 math.h 中的函数时,编译需要链接数学库,Linux 下加
-lm参数 -
sqrt 返回 double 类型,接收时用 double 变量
-
常用函数:sqrt 开方、pow 幂、fabs 绝对值、ceil 向上取整、floor 向下取整
- string.h 字符串处理库 (提供 strlen 求长度、strcpy 复制、strcat 拼接、strcmp 比较等函数)
-
c
            #include <stdio.h>
            #include <string.h>   // 字符串函数所在库

            int main() {
                char s1[20] = "Hello";
                char s2[20] = "World";

                // 1. strlen 求字符串长度(不含结尾的 \0)
                printf("strlen(s1) = %d\n", (int)strlen(s1));

                // 2. strcpy 复制:把 s2 复制到 s1
                strcpy(s1, s2);
                printf("strcpy 后 s1 = %s\n", s1);

                // 3. strcat 拼接:把 s2 追加到 s1 末尾
                strcat(s1, "!");
                printf("strcat 后 s1 = %s\n", s1);

                // 4. strcmp 比较:相等返回 0,s1<s2 返回负数,s1>s2 返回正数
                char a[] = "abc";
                char b[] = "abd";
                int cmp = strcmp(a, b);
                printf("strcmp(a, b) = %d\n", cmp);

                return 0;
}-
运行结果:
strlen(s1) = 5 strcpy 后 s1 = World strcat 后 s1 = World! strcmp(a, b) = -1 -
要点:
-
strlen 返回的是 size_t 类型,打印时建议强转为 int
-
strcpy 目标数组要足够大,否则会越界
-
strcat 拼接时目标数组要预留足够空间,且以 \0 结尾
-
strcmp 按字典序比较,常用于字符串排序和查找
- (2)主函数: int main(){ } 程序的入口,在其中可以调用主函数之前定义的常量 函数等
-2. 输出语句:printf 格式化输出语句 - 格式: ("输出的内容与对应的占位符",数据参数,...)
-
-
3.数据类型与变量
-(1) 基本类型: 占用空间 与 取值范围
-
整数型:int long long
-
浮点型:float double
-
字符型:char
- (2)字符串: char 类型的数组,经过了特殊的处理,值可以使用双引号括起来 char xx字符数+1="值";
- (3)数组: 可以存储多个同类型元素的数据结构 ,在内存中是一整块空间,可以使用下标操作
- (4)指针: 指针变量用来存储其他变量的内存地址
- (5)结构体:是自己定义的一个数据类型,可以将多个数据放在一起。比如:学生(姓名 年龄 学号 班级)
-
结构体:
-
结构体与面向对象中的类非常相似,它允许我们自定义一种数据类型,将多个不同类型的数据变量组合在一起
-
创建结构体变量之后,可以通过结构体变量访问并对其中的成员进行赋值等操作
-
结构体实战示例:定义一个学生结构体,包含姓名、年龄、学号、班级等字段,演示如何创建结构体变量并赋值、打印,以及结构体数组和结构体指针的用法
c#include <stdio.h> #include <string.h> // 1. 定义结构体类型 Student struct Student { char name[20]; // 姓名 int age; // 年龄 int id; // 学号 char class[20]; // 班级 }; int main() { // 2. 创建结构体变量并赋值 struct Student stu1; strcpy(stu1.name, "张三"); stu1.age = 18; stu1.id = 1001; strcpy(stu1.class, "计算机1班"); // 3. 通过结构体变量访问成员并打印 printf("姓名:%s\n", stu1.name); printf("年龄:%d\n", stu1.age); printf("学号:%d\n", stu1.id); printf("班级:%s\n", stu1.class); // 4. 结构体数组:存储多个学生 struct Student stuArr[3] = { {"李四", 19, 1002, "计算机1班"}, {"王五", 20, 1003, "计算机2班"}, {"赵六", 18, 1004, "计算机2班"} }; // 5. 遍历结构体数组 printf("\n--- 结构体数组遍历 ---\n"); for (int i = 0; i < 3; i++) { printf("第%d个学生:%s,%d岁,学号%d,%s\n", i + 1, stuArr[i].name, stuArr[i].age, stuArr[i].id, stuArr[i].class); } // 6. 结构体指针:通过指针访问成员 struct Student *p = &stu1; printf("\n--- 结构体指针访问 ---\n"); printf("通过指针访问姓名:%s\n", p->name); printf("通过指针访问年龄:%d\n", p->age); // 7. 通过指针修改成员 p->age = 19; printf("修改后年龄:%d\n", stu1.age); return 0; }-
运行结果:
姓名:张三 年龄:18 学号:1001 班级:计算机1班 --- 结构体数组遍历 --- 第1个学生:李四,19岁,学号1002,计算机1班 第2个学生:王五,20岁,学号1003,计算机2班 第3个学生:赵六,18岁,学号1004,计算机2班 --- 结构体指针访问 --- 通过指针访问姓名:张三 通过指针访问年龄:18 修改后年龄:19 -
要点总结:
- 结构体用
struct 结构体名 { 成员列表 };定义,末尾分号不能省略 - 访问成员用
.(点运算符),结构体指针访问成员用->(箭头运算符) - 结构体数组可以批量管理多个同类型对象,常用于学生、商品等场景
- 结构体指针常用于函数传参,避免复制整个结构体,提高效率
- 结构体用
-
--- 0-12的二进制码
0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100
-
二进制码解读:
- 每一组 4 位二进制数对应一个十六进制数字,方便阅读和记忆
- 例如:
0000对应 0,0001对应 1,0010对应 2,0011对应 3,以此类推 - 从右往左每一位的权重依次是 1、2、4、8、16、32、64、128......(即 2 的 0 次方、1 次方、2 次方......)
- 例如
0111从右往左:1×1 + 1×2 + 1×4 + 0×8 = 7,所以0111表示十进制 7
-
位移运算与二进制的关系:
- 右移一位(
>> 1)相当于把所有位向右移动一位,最右边的一位被丢弃,最左边补 0,效果等价于整除 2- 例如:
7 >> 1,7 的二进制是0111,右移一位变成0011,即十进制 3
- 例如:
- 左移一位(
<< 1)相当于把所有位向左移动一位,最左边的一位被丢弃,最右边补 0,效果等价于乘以 2- 例如:
3 << 1,3 的二进制是0011,左移一位变成0110,即十进制 6
- 例如:
- 位移运算在底层硬件中执行速度极快,常用于性能敏感的场景,如乘除 2 的幂、位掩码操作等
- 右移一位(
-
逻辑语句:控制程序的执行流程,让代码能够根据条件做出不同选择,或重复执行某段代码
-
条件判断语句:根据条件的真假,决定执行哪一段代码
- if-else:最常用的条件判断语句
-
格式:
if (条件) { 条件为真时执行的代码 } else { 条件为假时执行的代码 } -
条件可以是比较表达式(如
a > b)、逻辑表达式(如a > 0 && b > 0)或任意非零值 -
示例:
cint score = 85; if (score >= 60) { printf("及格\n"); } else { printf("不及格\n"); } -
支持
else if进行多分支判断,例如根据分数划分优秀、良好、及格、不及格
-
- switch case:匹配语句,根据表达式的值精确匹配到对应的分支
-
格式:
switch (表达式) { case 常量: 语句; break; default: 语句; } -
表达式的结果必须是整数类型(int、char 等),不能是浮点数或字符串
-
每个 case 末尾通常要加
break;,否则会继续向下执行(称为「穿透」) -
default分支在所有 case 都不匹配时执行,可省略 -
示例:
cint day = 3; switch (day) { case 1: printf("星期一\n"); break; case 2: printf("星期二\n"); break; case 3: printf("星期三\n"); break; default: printf("无效输入\n"); } -
适用场景:当判断的分支较多且都是等值比较时,switch 比 if-else 更清晰高效
-
- if-else:最常用的条件判断语句
-
循环语句:让同一段代码重复执行多次,直到满足退出条件
-
for:适合已知循环次数的场景
-
格式:
for (初始化; 条件; 更新) { 循环体 } -
三个部分都可以省略,但分号不能省;全部省略时是死循环
-
示例:计算 1 到 100 的和
cint sum = 0; for (int i = 1; i <= 100; i++) { sum += i; } printf("1到100的和 = %d\n", sum);
-
-
while:适合循环次数未知、只根据条件判断的场景
-
格式:
while (条件) { 循环体 } -
先判断条件,条件为真才进入循环体;条件一开始为假,循环体一次都不执行
-
示例:不断读取输入直到输入 0 为止
cint num; scanf("%d", &num); while (num != 0) { printf("你输入了 %d\n", num); scanf("%d", &num); }
-
-
do-while:先执行一次循环体,再判断条件
-
格式:
do { 循环体 } while (条件); -
与 while 的区别:do-while 至少执行一次循环体,适合「先做再判断」的场景
-
示例:菜单选择,至少显示一次菜单
cint choice; do { printf("1. 查询 2. 退出\n"); scanf("%d", &choice); } while (choice != 2);
-
-
循环控制关键字:
break:立即跳出当前循环(或 switch)continue:跳过本次循环剩余部分,直接进入下一次循环- 示例:打印 1 到 10 中所有奇数
-
c
            for (int i = 1; i <= 10; i++) {
                if (i % 2 == 0) {
                    continue;   // 偶数跳过
                }
                printf("%d ", i);
}- 要点总结:
- if-else 适合范围判断和多分支逻辑,switch 适合等值匹配
- for 适合已知次数,while 适合条件控制,do-while 保证至少执行一次
- 循环中注意更新条件,避免死循环;break 跳出循环,continue 跳过本次
数组:
-
数组的定义:数组是一种可以存储多个同类型元素的数据结构,在内存中是一整块连续的空间,可以通过下标(索引)快速访问其中的任意元素
-
数组的类型设定:数组中的元素必须是同一种数据类型,可以是 int、float、double、char 等基本类型,也可以是结构体等自定义类型
- 定义格式:
类型名 数组名[长度];,例如int scores[5];表示定义一个能存放 5 个 int 类型元素的数组 - 数组的长度必须是常量,不能是变量(C99 之前);定义后长度不可改变
- 定义格式:
-
数组的初始化:
- 定义时直接赋值:
int arr[5] = {10, 20, 30, 40, 50}; - 部分初始化:
int arr[5] = {1, 2};未指定的元素自动补 0 - 省略长度初始化:
int arr[] = {1, 2, 3, 4, 5};编译器根据元素个数自动确定长度 - 全部初始化为 0:
int arr[5] = {0};
- 定义时直接赋值:
-
数组的长度是固定的:一旦定义,数组能存储的元素个数就固定了,不能像链表那样动态增删
- 数组名本质是一个常量指针,指向数组首元素的地址,定义之后不能修改
- 如果需要动态改变存储空间大小,可以使用 malloc 动态分配内存(见指针一节)
-
数组的下标不要超过范围:
- 数组下标从 0 开始,到
长度 - 1结束,例如长度为 5 的数组,下标范围是 0 到 4 - 访问越界下标(如
arr[5])属于未定义行为,可能读取到脏数据,甚至导致程序崩溃 - 遍历数组时,循环条件通常写成
i < 长度,避免越界
- 数组下标从 0 开始,到
-
数组的遍历:使用 for 循环配合下标,可以依次访问数组中的每一个元素
c#include <stdio.h> int main() { int arr[5] = {10, 20, 30, 40, 50}; // 遍历并打印每个元素 for (int i = 0; i < 5; i++) { printf("arr[%d] = %d\n", i, arr[i]); } return 0; }-
运行结果:
arr[0] = 10
arr[1] = 20
arr[2] = 30
arr[3] = 40
arr[4] = 50
-
-
数组的求和与平均值:
c#include <stdio.h> int main() { int scores[5] = {85, 90, 78, 92, 88}; int sum = 0; // 遍历求和 for (int i = 0; i < 5; i++) { sum += scores[i]; } double avg = (double)sum / 5; // 强转为 double,避免整数除法丢失小数 printf("总分 = %d\n", sum); printf("平均分 = %.2f\n", avg); return 0; }-
运行结果:
总分 = 433
平均分 = 86.60
-
-
数组的查找:遍历数组,逐个比较元素是否等于目标值,找到后记录下标
c#include <stdio.h> int main() { int arr[5] = {10, 20, 30, 40, 50}; int target = 30; int found = -1; // 初始化为 -1,表示未找到 for (int i = 0; i < 5; i++) { if (arr[i] == target) { found = i; // 记录找到的下标 break; } } if (found != -1) { printf("找到 %d,下标为 %d\n", target, found); } else { printf("未找到 %d\n", target); } return 0; }-
运行结果:
找到 30,下标为 2
-
-
数组的排序:以冒泡排序为例,通过相邻元素两两比较并交换,把最大(或最小)的元素逐步「冒泡」到末尾
c#include <stdio.h> int main() { int arr[5] = {50, 10, 40, 20, 30}; // 冒泡排序(升序) for (int i = 0; i < 5 - 1; i++) { for (int j = 0; j < 5 - 1 - i; j++) { if (arr[j] > arr[j + 1]) { int temp = arr[j]; arr[j] = arr[j + 1]; arr[j + 1] = temp; } } } // 打印排序结果 printf("排序后:"); for (int i = 0; i < 5; i++) { printf("%d ", arr[i]); } printf("\n"); return 0; }-
运行结果:
排序后:10 20 30 40 50
-
-
要点总结:
- 数组元素类型必须一致,长度固定,下标从 0 开始,访问时注意不要越界
- 遍历数组常用 for 循环,配合
i < 长度作为循环条件 - 求和、平均值、查找、排序等操作都建立在遍历的基础上,先掌握遍历再学这些操作
- 数组名是常量指针,不能重新赋值;需要动态大小请使用 malloc
函数:
- 格式: 返回值类型 函数名(参数类型 参数名){ 函数体 }
- 返回值:
- 定义函数时,设定在函数执行完成之后需要返回什么数据,返回值类型就设定为该数据的类型,在函数执行结束的地方,使用return
返回一个匹配类型的数据、带数据的变量 - 调用带返回值的函数时,在函数的前面定义一个与返回值类型一样的变量 等于 这个函数式调用
int a = abs(-100);
- 定义函数时,设定在函数执行完成之后需要返回什么数据,返回值类型就设定为该数据的类型,在函数执行结束的地方,使用return
- 参数:
- 定义函数时,预设一组变量,知道类型,不知道具体的值,只用于完成函数中逻辑代码编写
- 调用函数时,一定要根据参数设定来传入对应匹配的数据、带数据的变量 按照匹配的类型 顺序 数量传入
- 返回值:
- 定义函数的优点,缺点:
- 优点:
- 将程序中一些重复执行的代码定义出来,然后通过调用函数的形式复用代码
- 提高代码的简洁性,可重用性,可维护性
- 缺点:
- 函数中属于一个局部空间,将数据作为参数传入时,要考虑作用域的问题
- 优点:
指针:
-
使用一个指针变量存储其他的变量的地址编码,在变量传递的时候比较方便
-
将数据变量,作为参数传入函数时,如果需要在函数中修改该数据变量的值,通常需要使用指针类型作为参数,传入该变量的地址进去
-
指针是地址操作,与数组下标通用 ,在我们实现动态数组中比较需要
- 通过使用内存分配空间来替代数据,做到存储数据空间替换 ,因为普通的数组名本质是一个常量,定义之后不能改
-
指针实战示例:使用 malloc 动态创建数组,通过指针遍历并修改元素,最后 free 释放内存
c#include <stdio.h> #include <stdlib.h> // malloc / free 所在库 int main() { int n = 5; // 1. 动态分配 n 个 int 大小的连续内存 int *arr = (int*)malloc(n * sizeof(int)); if (arr == NULL) { // 分配失败时返回 NULL printf("内存分配失败\n"); return 1; } // 2. 通过指针遍历数组并赋值 for (int i = 0; i < n; i++) { *(arr + i) = i * 10; // 等价于 arr[i] = i * 10 } // 3. 通过指针遍历并修改元素(把每个元素加 1) for (int i = 0; i < n; i++) { arr[i] += 1; // 下标写法,与 *(arr+i) 等价 } // 4. 打印结果 for (int i = 0; i < n; i++) { printf("arr[%d] = %d\n", i, arr[i]); } // 5. 释放内存,避免内存泄漏 free(arr); return 0; }-
运行结果:
arr[0] = 1 arr[1] = 11 arr[2] = 21 arr[3] = 31 arr[4] = 41 -
要点总结:
- malloc 返回 void* 指针,需要强转为目标类型(如 int*)
- 分配后必须检查返回值是否为 NULL,防止内存分配失败
- 指针算术
*(arr + i)与下标arr[i]完全等价 - 使用完 malloc 分配的内存后,必须调用 free 释放,否则会造成内存泄漏
-
结构体:
-
与类与对象的类非常像, 可以通过设定一个结构类型,其中自定义多个不同类型的数据变量
-
结构体变量创建之后,可以使用结构体变量调用其中的数据变量进行赋值 等使用场景
-
结构体实战示例:定义一个学生结构体,包含姓名、年龄、学号、班级,创建结构体变量并赋值、打印,再演示结构体数组和结构体指针
c#include <stdio.h> #include <string.h> // 1. 定义结构体类型 Student struct Student { char name[20]; // 姓名 int age; // 年龄 int id; // 学号 char class[20]; // 班级 }; int main() { // 2. 创建结构体变量并赋值 struct Student stu1; strcpy(stu1.name, "张三"); stu1.age = 18; stu1.id = 1001; strcpy(stu1.class, "计算机1班"); // 3. 通过结构体变量访问成员并打印 printf("姓名:%s\n", stu1.name); printf("年龄:%d\n", stu1.age); printf("学号:%d\n", stu1.id); printf("班级:%s\n", stu1.class); // 4. 结构体数组:存储多个学生 struct Student stuArr[3] = { {"李四", 19, 1002, "计算机1班"}, {"王五", 20, 1003, "计算机2班"}, {"赵六", 18, 1004, "计算机2班"} }; // 5. 遍历结构体数组 printf("\n--- 结构体数组遍历 ---\n"); for (int i = 0; i < 3; i++) { printf("第%d个学生:%s,%d岁,学号%d,%s\n", i + 1, stuArr[i].name, stuArr[i].age, stuArr[i].id, stuArr[i].class); } // 6. 结构体指针:通过指针访问成员 struct Student *p = &stu1; printf("\n--- 结构体指针访问 ---\n"); printf("通过指针访问姓名:%s\n", p->name); printf("通过指针访问年龄:%d\n", p->age); // 7. 通过指针修改成员 p->age = 19; printf("修改后年龄:%d\n", stu1.age); return 0; }-
运行结果:
姓名:张三 年龄:18 学号:1001 班级:计算机1班 --- 结构体数组遍历 --- 第1个学生:李四,19岁,学号1002,计算机1班 第2个学生:王五,20岁,学号1003,计算机2班 第3个学生:赵六,18岁,学号1004,计算机2班 --- 结构体指针访问 --- 通过指针访问姓名:张三 通过指针访问年龄:18 修改后年龄:19 -
要点总结:
- 结构体用
struct 结构体名 { 成员列表 };定义,末尾分号不能省略 - 访问成员用
.(点运算符),结构体指针访问成员用->(箭头运算符) - 结构体数组可以批量管理多个同类型对象,常用于学生、商品等场景
- 结构体指针常用于函数传参,避免复制整个结构体,提高效率
- 结构体用
-
链表:
-
链表的定义:链表是一种动态的数据结构,由一系列节点(Node)通过指针连接而成,每个节点在内存中不一定连续,而是通过指针字段指向下一个节点,从而形成一条「链」
-
组成结构:节点结构体变量,每个节点都包含了一个数据变量和下一个节点指针变量
-
数据域:存放该节点要保存的数据,可以是 int、char 等基本类型,也可以是结构体等自定义类型
-
指针域:存放下一个节点的地址,通过它把各个节点串联起来;最后一个节点的指针指向 NULL,表示链表结束
-
节点结构体定义示例:
cstruct Node { int data; // 数据域:存放数据 struct Node *next; // 指针域:指向下一个节点 };
-
-
链表与数组的区别:
- 数组长度固定,链表长度可以动态增长或缩减
- 数组在内存中连续,链表节点在内存中分散,靠指针连接
- 数组按下标随机访问很快,链表只能从头开始逐个遍历
- 数组插入/删除元素需要移动大量数据,链表只需修改指针指向,效率更高
-
创建链表:通过 malloc 动态分配节点内存,再用指针把节点逐个连接起来
c#include <stdio.h> #include <stdlib.h> struct Node { int data; struct Node *next; }; int main() { // 1. 创建三个节点并分配内存 struct Node *n1 = (struct Node*)malloc(sizeof(struct Node)); struct Node *n2 = (struct Node*)malloc(sizeof(struct Node)); struct Node *n3 = (struct Node*)malloc(sizeof(struct Node)); // 2. 给节点赋值 n1->data = 10; n2->data = 20; n3->data = 30; // 3. 通过指针把节点连接成链表 n1->next = n2; n2->next = n3; n3->next = NULL; // 最后一个节点指向 NULL // 4. 从头节点开始遍历链表 struct Node *p = n1; while (p != NULL) { printf("%d ", p->data); p = p->next; // 移动到下一个节点 } printf("\n"); // 5. 释放内存 free(n1); free(n2); free(n3); return 0; }-
运行结果:
10 20 30
-
-
链表的遍历:通过节点中下一个节点的指针可以进行从头到尾的循环遍历操作
- 从「头节点」开始,用一个临时指针 p 指向当前节点
- 每访问完一个节点,就让 p 指向 p->next,即下一个节点
- 当 p 为 NULL 时,说明已经走到链表末尾,遍历结束
- 遍历是链表最基础的操作,查找、统计长度、打印等都要基于遍历实现
-
链表的插入:在指定位置插入一个新节点,核心是修改相邻节点的指针指向
c#include <stdio.h> #include <stdlib.h> struct Node { int data; struct Node *next; }; int main() { // 创建初始链表:10 -> 20 -> 30 struct Node *head = (struct Node*)malloc(sizeof(struct Node)); struct Node *n2 = (struct Node*)malloc(sizeof(struct Node)); struct Node *n3 = (struct Node*)malloc(sizeof(struct Node)); head->data = 10; head->next = n2; n2->data = 20; n2->next = n3; n3->data = 30; n3->next = NULL; // 在 20 之后插入一个新节点 25 struct Node *newNode = (struct Node*)malloc(sizeof(struct Node)); newNode->data = 25; newNode->next = n2->next; // 新节点指向 30 n2->next = newNode; // 20 指向新节点 // 遍历打印 struct Node *p = head; while (p != NULL) { printf("%d ", p->data); p = p->next; } printf("\n"); // 释放内存 while (head != NULL) { struct Node *temp = head; head = head->next; free(temp); } return 0; }-
运行结果:
10 20 25 30
-
-
链表的删除:删除指定节点,核心是让前一个节点的指针跳过被删除的节点
c#include <stdio.h> #include <stdlib.h> struct Node { int data; struct Node *next; }; int main() { // 创建链表:10 -> 20 -> 30 struct Node *head = (struct Node*)malloc(sizeof(struct Node)); struct Node *n2 = (struct Node*)malloc(sizeof(struct Node)); struct Node *n3 = (struct Node*)malloc(sizeof(struct Node)); head->data = 10; head->next = n2; n2->data = 20; n2->next = n3; n3->data = 30; n3->next = NULL; // 删除节点 20:让 10 直接指向 30 struct Node *toDelete = n2; head->next = n2->next; // 10 跳过 20,指向 30 free(toDelete); // 释放被删除节点的内存 // 遍历打印 struct Node *p = head; while (p != NULL) { printf("%d ", p->data); p = p->next; } printf("\n"); // 释放内存 while (head != NULL) { struct Node *temp = head; head = head->next; free(temp); } return 0; }-
运行结果:
10 30
-
-
要点总结:
- 链表节点由数据域和指针域组成,指针域存放下一个节点的地址
- 链表通过 malloc 动态分配节点,长度可以灵活变化,不受固定大小限制
- 遍历链表必须从头节点开始,借助 p = p->next 逐个移动
- 插入和删除只需修改指针指向,不需要移动大量数据,效率高
- 使用完链表后要逐个 free 释放每个节点,避免内存泄漏
总结:
本文系统梳理了 C 语言的核心语法,从最基础的程序结构出发,逐步深入到数据类型、数组、函数、指针、结构体与链表等进阶内容,帮助读者建立起完整的 C 语言知识框架。
- 程序结构 :C 程序由头文件导入、主函数入口和各类语句组成。头文件提供了标准库函数(stdio.h 输入输出、stdlib.h 动态内存分配、math.h 数学运算、string.h 字符串处理),主函数
int main()是程序执行的起点。 - 数据类型与变量:基本类型包括整数型(int、long、long long)、浮点型(float、double)和字符型(char);字符串本质是 char 数组;数组、指针、结构体则是在基本类型之上构建的复合数据形式。
- 数组:在内存中连续存储同类型元素,通过下标快速访问。遍历、求和、查找、排序等操作都建立在 for 循环遍历的基础上;数组长度固定,需要动态大小时应改用 malloc。
- 函数:通过「返回值类型 + 函数名 + 参数 + 函数体」的格式定义,实现代码复用,提高可维护性;注意参数传递时的作用域问题。
- 指针:存储其他变量的内存地址,与数组下标通用,是实现动态数组和函数内修改外部变量的关键;使用 malloc 分配的内存必须用 free 释放。
- 结构体 :自定义数据类型,将多个不同类型成员组合在一起,类似面向对象中的类;用
.访问成员、->通过指针访问,结构体数组可批量管理对象。 - 链表:由节点通过指针连接而成的动态数据结构,节点包含数据域和指针域。与数组相比,链表长度可动态变化,插入删除只需修改指针指向,效率更高;遍历、插入、删除是链表最核心的操作。
学习建议:先掌握程序结构与基本数据类型,再依次攻克数组、函数、指针,最后学习结构体与链表。指针和动态内存分配是 C 语言的难点,务必亲手敲代码验证 malloc/free 的配对使用,避免内存泄漏。链表作为指针与结构体的综合应用,是理解后续数据结构(栈、队列、树)的重要基石。