一、核心研究问题与动机
核心观点:验证(Verification)应被视为继预训练、后训练、测试时计算之后的第四个扩展轴。
-
当前LLM生成能力已从扩展范式中显著受益,但验证------即判断解决方案正确性或质量的能力------尚未经历同等程度的扩展。
-
现有验证方法存在根本局限:
-
标准LM评判器(LLM-as-a-Judge):将评分分布坍缩为单一离散分数,导致高平局率(如Terminal-Bench上达27%)、区分度差。
-
学习型奖励模型:受限于训练数据,难以跨领域泛化。
-
-
关键洞察:多数模型已具备解决任务的能力------重复采样时往往至少产生一次正确解。在Terminal-Bench V2上,若有预言验证器,成功率可达98.9% (接近解决整个基准)。但捕获这一余量需要一个能可靠区分正确与错误轨迹的验证器。
二、提出的方法:LLM-as-a-Verifier
1. 核心机制:细粒度概率验证
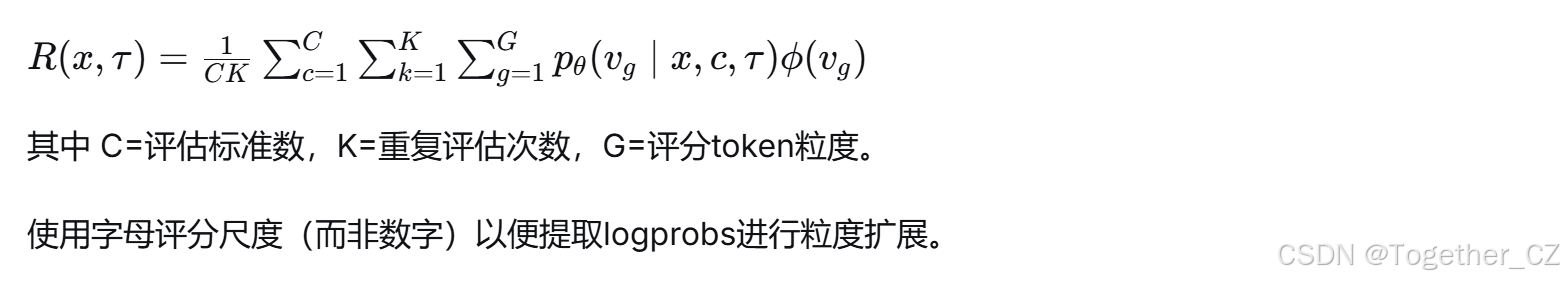
区别于标准LM评判器 :不是取最高概率token作为离散分数,而是对评分token logits的完整分布取期望,生成连续奖励:
2. 验证扩展的三个维度
| 维度 | 作用 | 效果 |
|---|---|---|
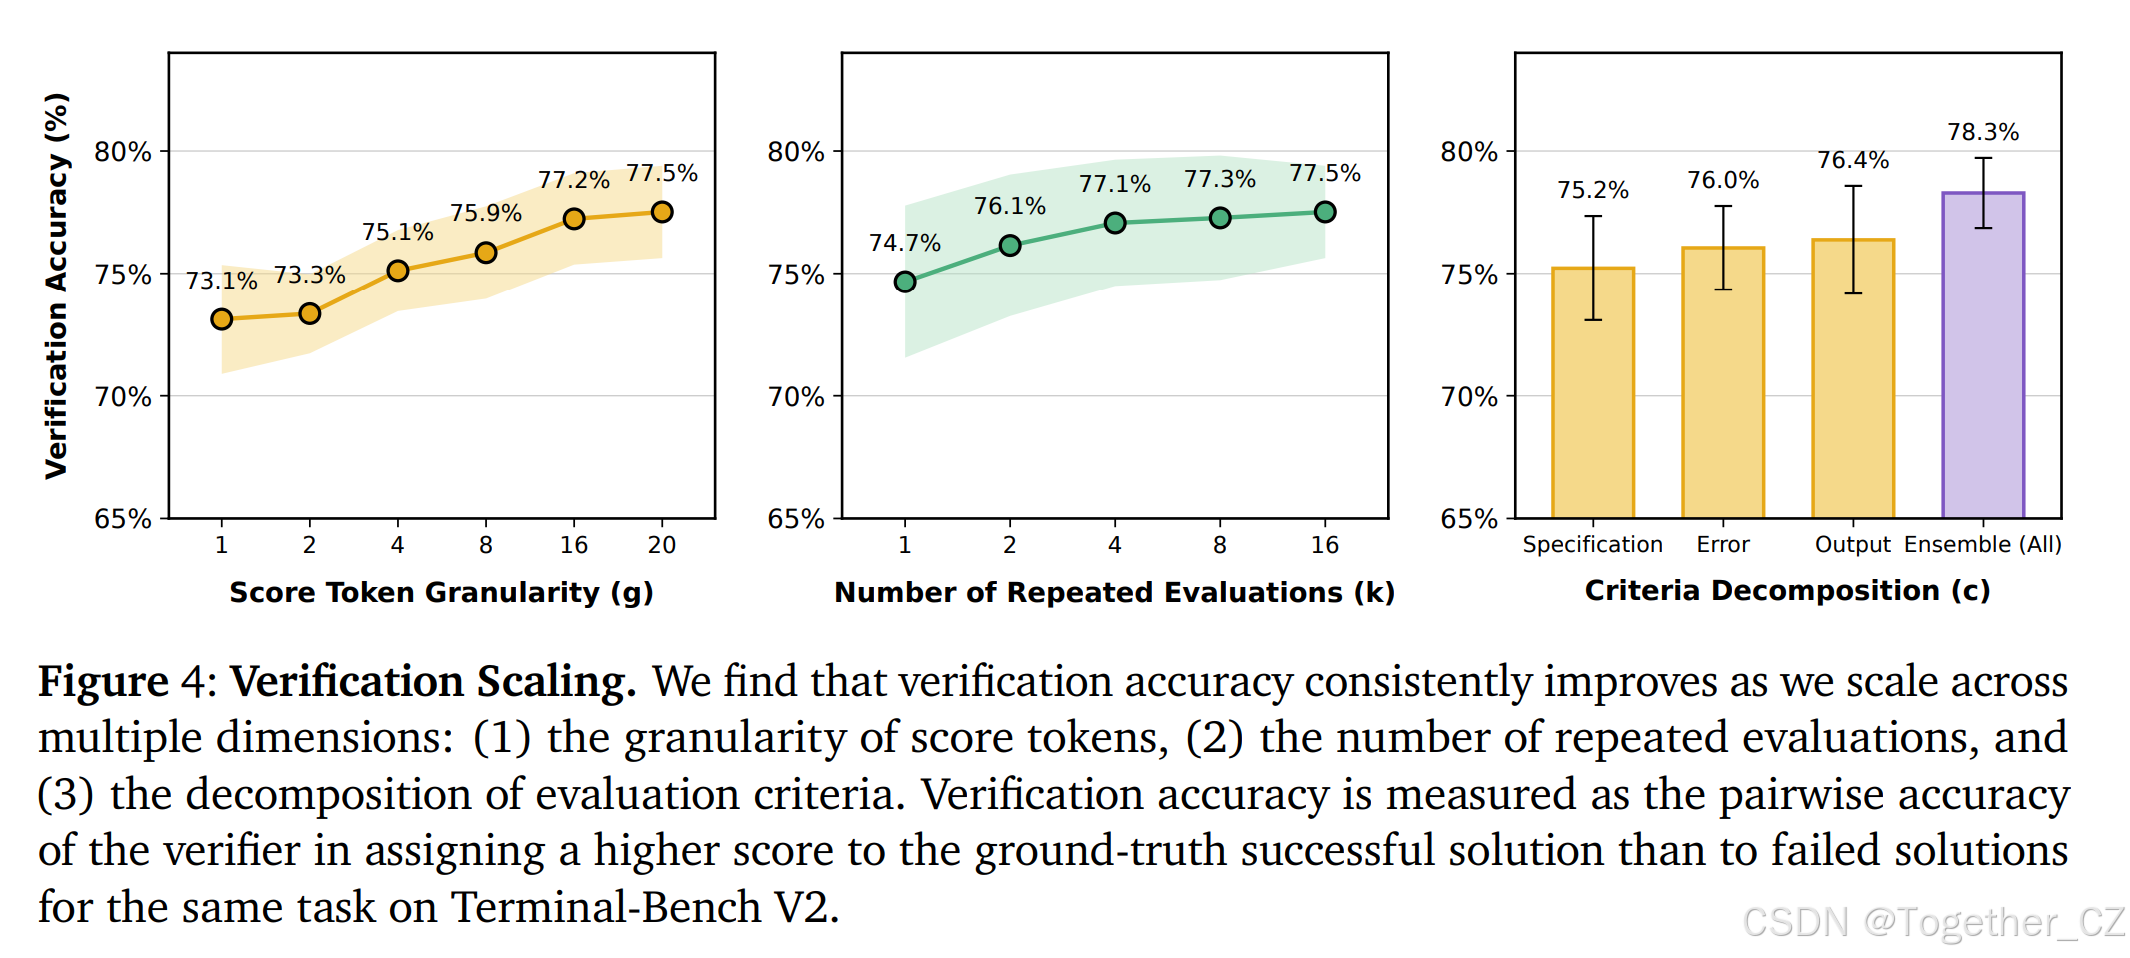
| 分数粒度 G | 锐化单次评估,改善正负解分离 | G从1→20,准确率73.1%→77.5% |
| 重复评估 K | 蒙特卡洛平均,减少方差 | K从1→16,准确率74.7%→77.4% |
| 标准分解 C | 减少提示偏差,捕捉互补方面 | 单标准75.2%-76.4%→集成78.3% |
信噪比分析:粒度增大使SNR从0.775(G=1)升至0.799(G=20),产生更校准的分数分离。
3. 概率枢轴锦标赛(PPT)------成本高效排序算法
-
传统循环赛需 O(N²) 次成对验证,成本随候选数急剧增长。
-
PPT将预算降至 O(Nk)(k≪N):
-
环传递:随机哈密顿环评分相邻对,消除位置偏差(每个候选在"A"和"B"槽各出现一次)
-
枢轴选择:按环传递平均偏好选前k个作为枢轴
-
枢轴轮次:非枢轴vs枢轴、枢轴vs枢轴比较,按 w_i/c_i 归一化选最优
-
三、实验结果
1. 测试时扩展(轨迹奖励模型)
| 基准 | 领域 | 基线最佳 | Oracle上限 | LLM-as-a-Verifier |
|---|---|---|---|---|
| Terminal-Bench V2 | 编码 | 84.7% | 92.1% | 86.5% |
| SWE-Bench Verified | 编码 | 76.8% | 84.4% | 78.2% |
| RoboRewardBench | 机器人 | 81.4% | --- | 87.4% |
| MedAgentBench | 医学 | 70.2% | 75.0% | 73.3% |
-
无需训练、即插即用,同一框架跨领域应用,无领域特定微调。
-
在SWE-Bench上从不同模型家族(Claude、Gemini、MiniMax)的异质候选池中选择最强轨迹。
-
RoboRewardBench上零样本超越专门训练的奖励模型(RoboReward-8B、Robometer-4B、TOPReward)。
2. 作为任务进度代理
-
验证器分数与步骤时间顺序强相关(VOC)。
-
代码生成:成功轨迹VOC 0.848,失败轨迹0.769(差距+0.079)。
-
机器人学:VOC达0.966,远超RoboReward-8B(0.877)、Robometer-4B(0.780)、TOPReward(0.565)。
-
构建了 Claude Code 和 Codex 扩展(TurboAgent),实时监控智能体进度,支持暂停/回滚。
3. 作为RL密集奖励
| 设定 | 算法 | 样本效率提升 | 最终成功率 |
|---|---|---|---|
| LIBERO(离策略) | DSRL-SAC | ≈1.8× | 0.76 vs 0.69 |
| MATH(在策略) | GRPO | ≈1.1× | --- |
-
离策略:用验证器进度曲线 ρ_t 塑形奖励 r_t = r^env_t + λρ_t,离线重标注,零额外算法成本。
-
在策略:GRPO早期所有响应答案错误时组相对优势坍缩为零;验证器为推理轨迹分配偏好分数,即使最终答案相同也能提供梯度。
四、关键创新点
-
概率验证框架:利用评分token完整分布而非单一最高概率token,产生连续、校准的奖励。
-
验证扩展三轴:系统刻画粒度、重复评估、标准分解对验证质量的提升。
-
成本高效排序:PPT将预算从O(N²)降至O(Nk),环传递消除位置偏差。
-
多功能性:同一框架兼作轨迹奖励模型、进度估计器和RL密集奖励,跨编码/机器人/医学领域。
-
无需训练:完全免训练、即插即用,适用于可访问logprobs的模型;附录还提供针对logit受限前沿模型的两阶段变通方法。
五、局限与未来方向
-
假设可访问评分token logits,排除部分仅提供受限API的前沿模型(已提出两阶段变通)。
-
扩展轴非穷尽:标准分解可学习/动态生成,重复评估可替换为自适应计算分配。
-
RL实验限于单轮设定;扩展到多轮RL(验证器为长时域轨迹提供每步奖励)是有前景的方向。
文章提出 LLM-as-a-Verifier ,将验证确立为独立的扩展轴。通过概率化地利用评分token分布、沿粒度/重复/标准分解三维扩展,并配合成本高效的PPT排序算法,该框架在编码、机器人、医学四大基准上达到SOTA,同时可作为任务进度监控器和RL密集奖励信号,为自主智能体的安全部署和高效训练提供了通用、可扩展的验证机制。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
官方项目主页地址在这里,如下所示:
项目地址在这里,如下所示:
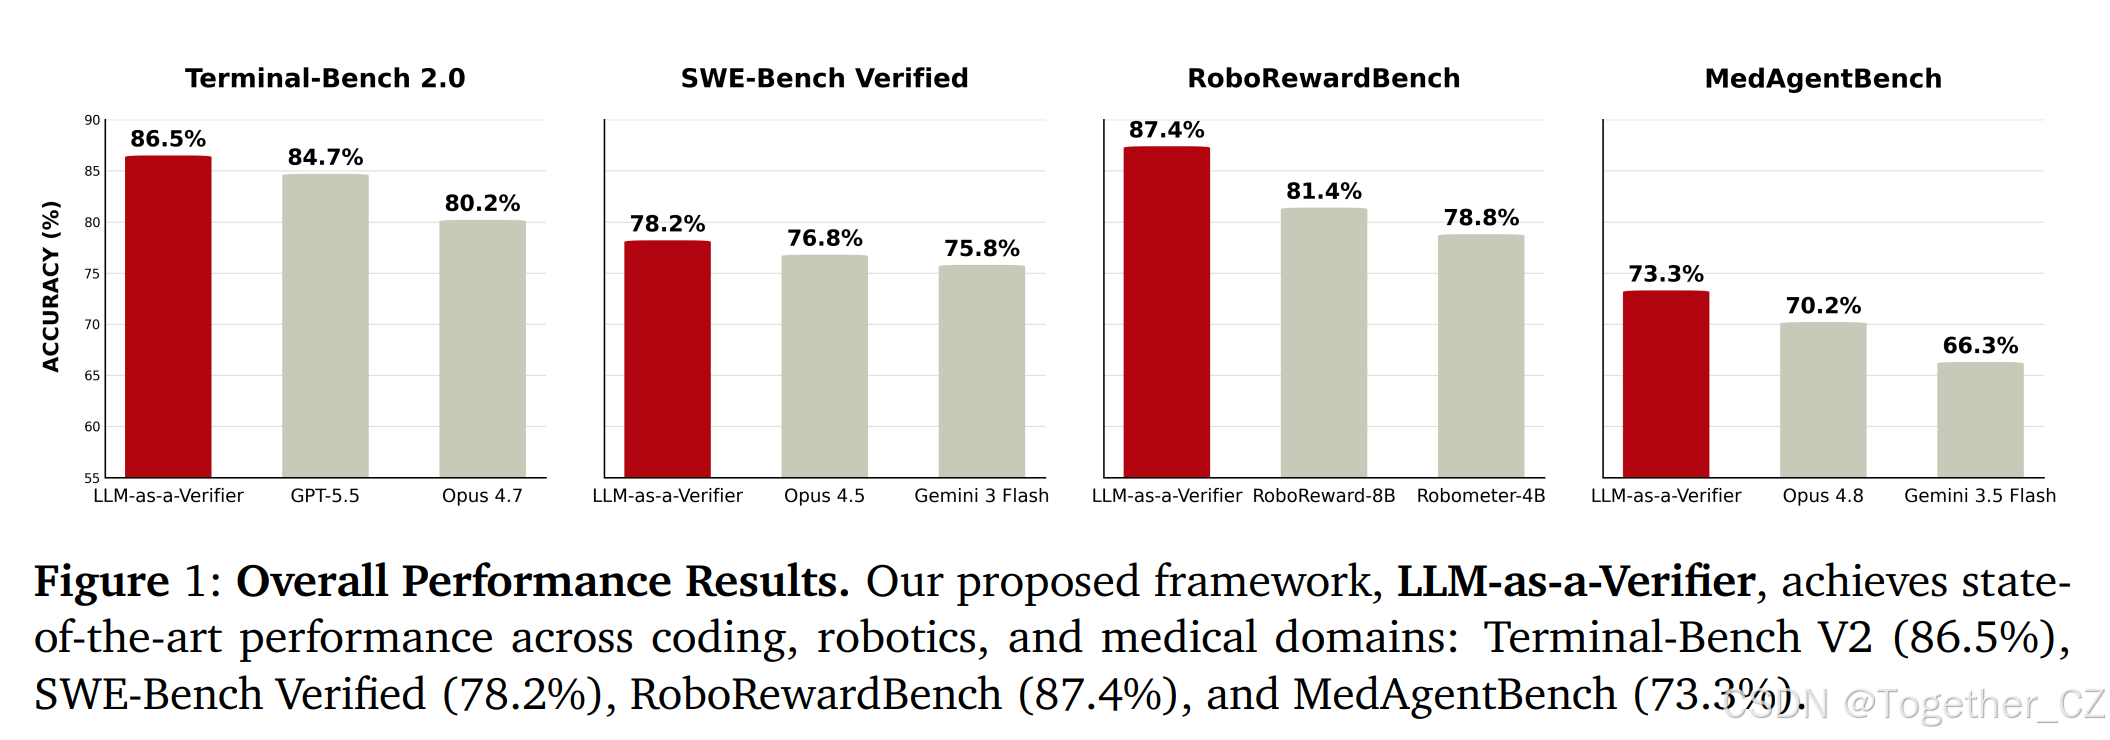
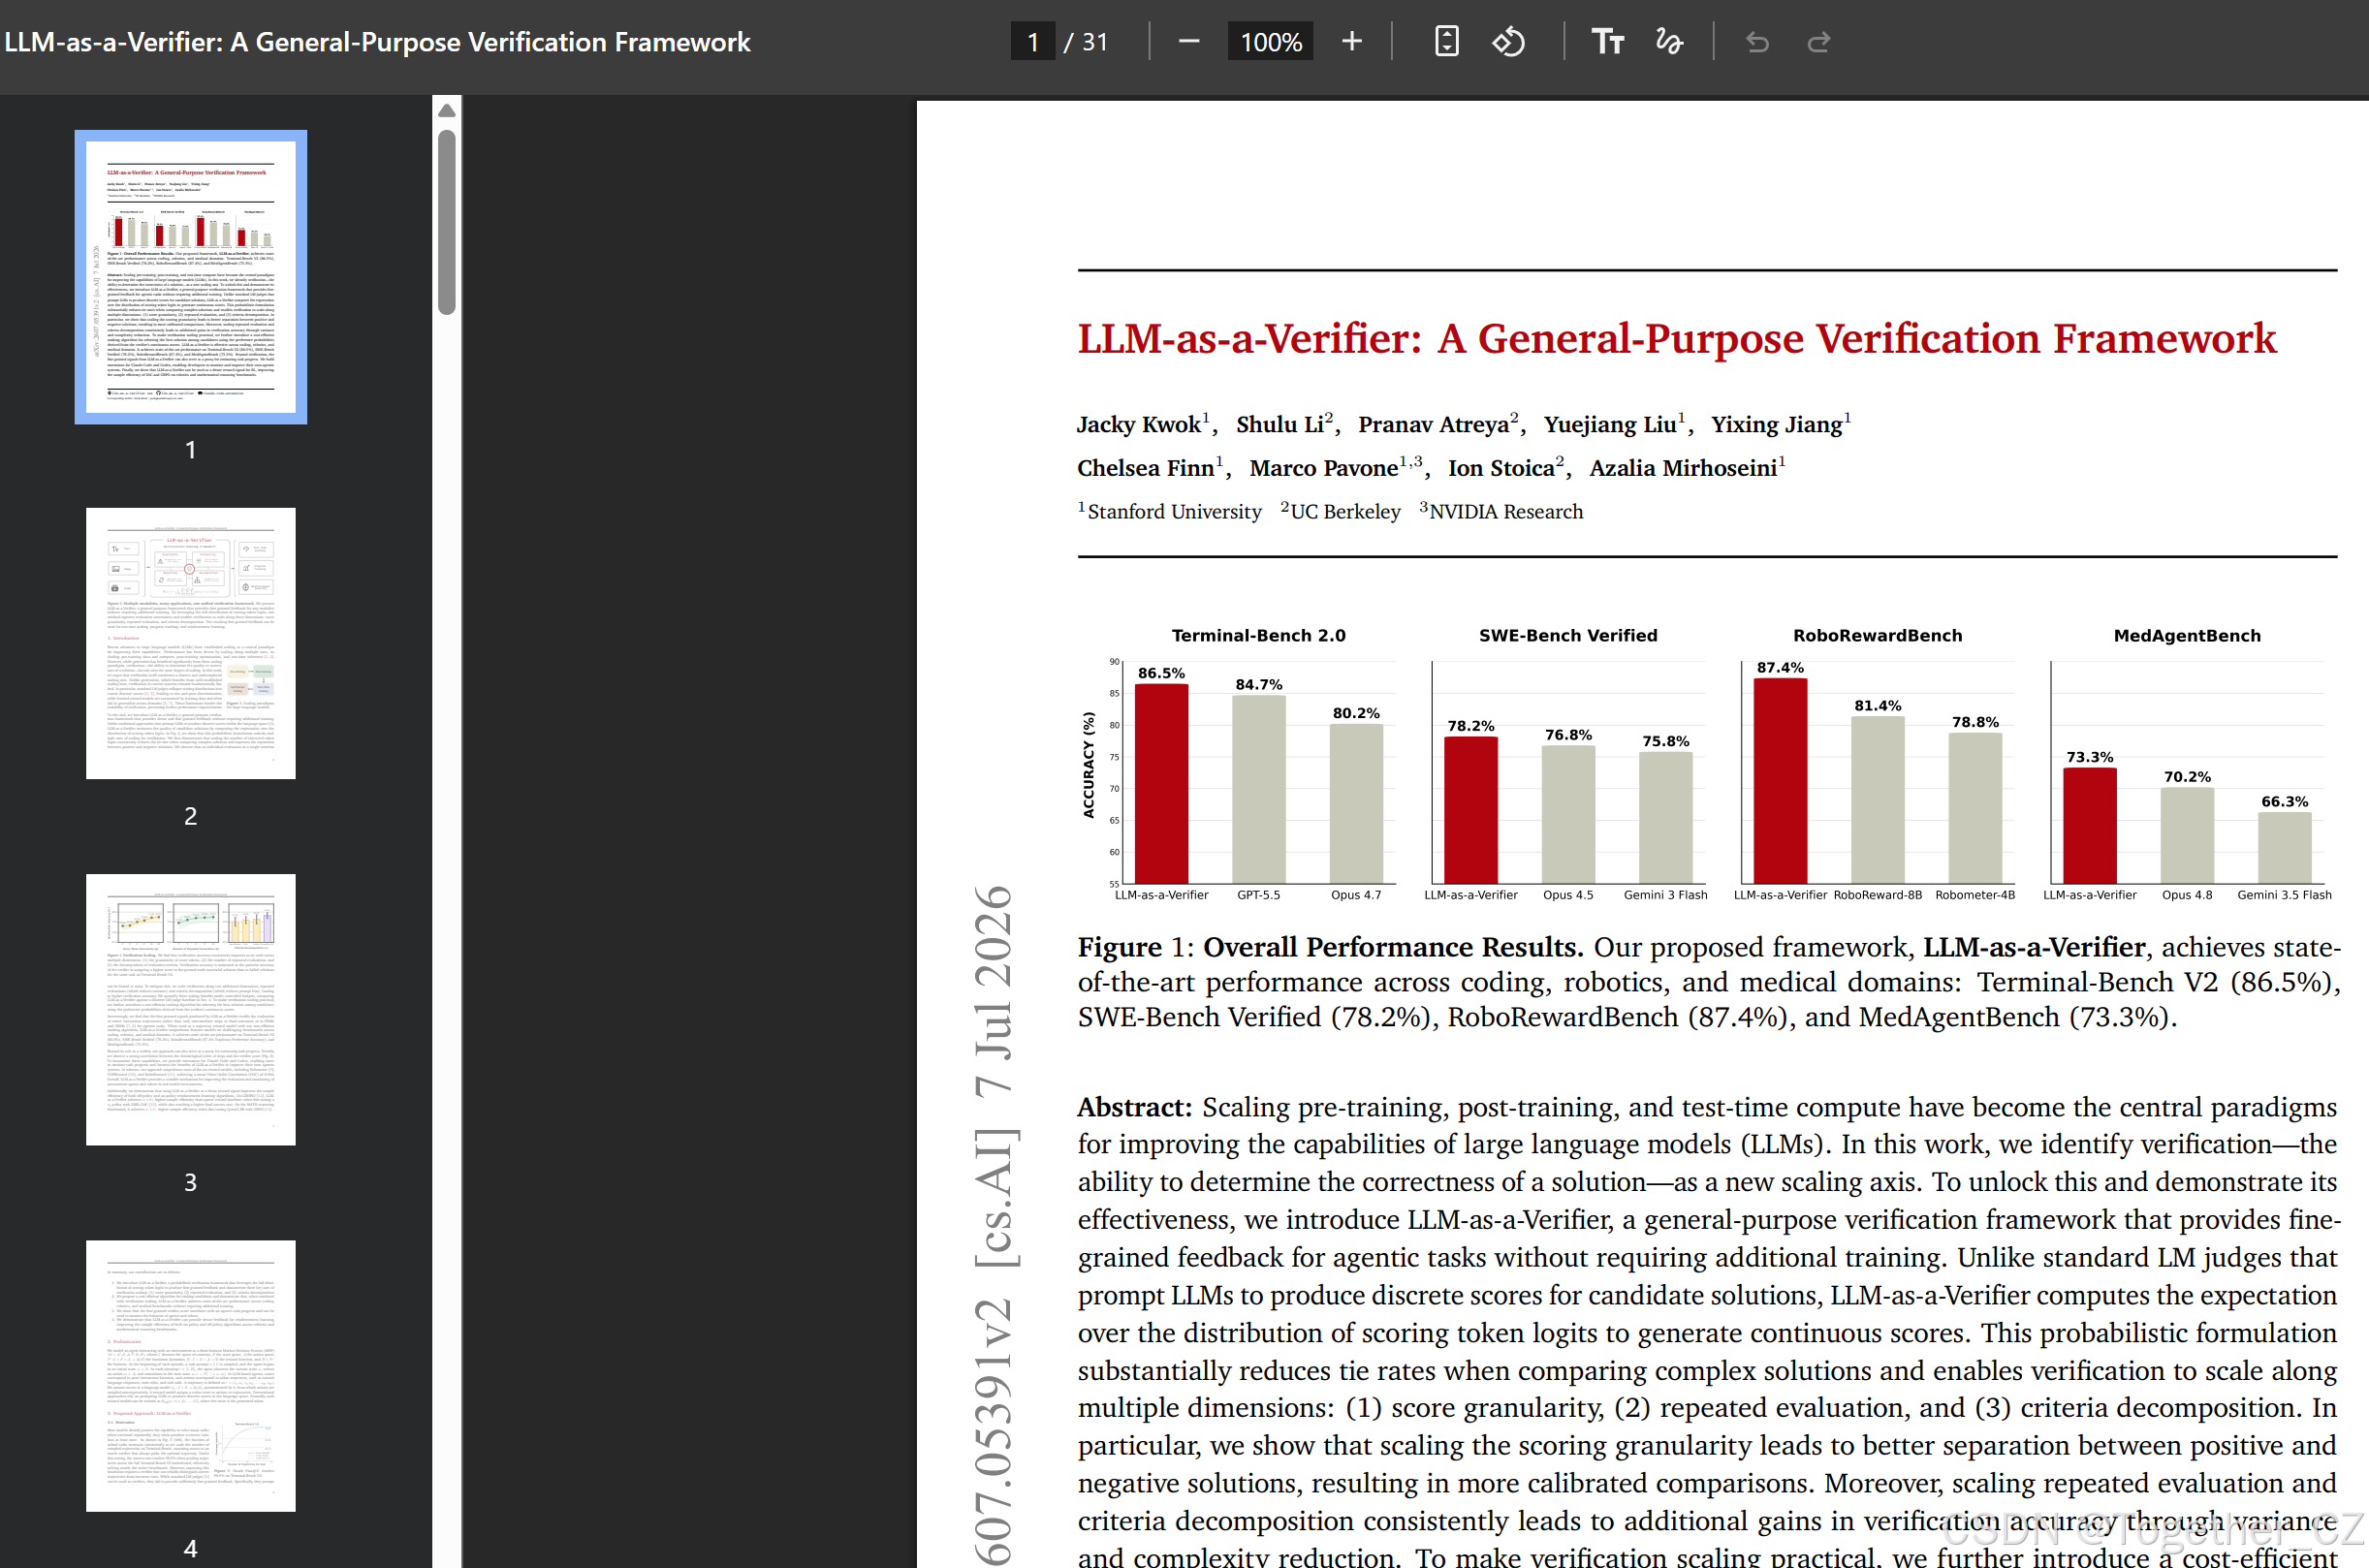
图1:总体性能结果。 我们提出的框架 LLM-as-a-Verifier 在编码、机器人和医学领域均达到了最先进的性能:Terminal-Bench V2(86.5%)、SWE-Bench Verified(78.2%)、RoboRewardBench(87.4%)和 MedAgentBench(73.3%)。
摘要: 扩展预训练、后训练和测试时计算已成为提升大型语言模型(LLM)能力的核心范式。在这项工作中,我们将验证------即判断解决方案正确性的能力------确定为一个新的扩展轴。为了解锁这一能力并证明其有效性,我们引入了 LLM-as-a-Verifier,这是一个通用的验证框架,无需额外训练即可为智能体任务提供细粒度反馈。与提示 LLM 为候选解决方案产生离散分数的标准 LM 评判器不同,LLM-as-a-Verifier 计算评分 token logits 分布上的期望,以生成连续分数。这种概率公式在比较复杂解决方案时大幅降低了平局率,并使验证能够在多个维度上扩展:(1)分数粒度,(2)重复评估,(3)标准分解。特别地,我们表明扩展评分粒度可以更好地分离正负解决方案,从而实现更校准的比较。此外,扩展重复评估和标准分解通过减少方差和复杂性,持续带来验证准确率的额外增益。为了使验证扩展具有实用性,我们进一步引入了一种成本高效的排序算法,利用验证器连续分数导出的偏好概率在候选者中选择最佳解决方案。LLM-as-a-Verifier 在编码、机器人和医学领域均有效。它在 Terminal-Bench V2(86.5%)、SWE-Bench Verified(78.2%)、RoboRewardBench(87.4%)和 MedAgentBench(73.3%)上达到了最先进的性能。除了验证之外,LLM-as-a-Verifier 产生的细粒度信号还可以作为估计任务进度的代理。我们为 Claude Code 和 Codex 构建了扩展,使开发者能够监控和改进自己的智能体系统。最后,我们表明 LLM-as-a-Verifier 可以作为 RL 的密集奖励信号,提高 SAC 和 GRPO 在机器人学和数学推理基准上的样本效率。
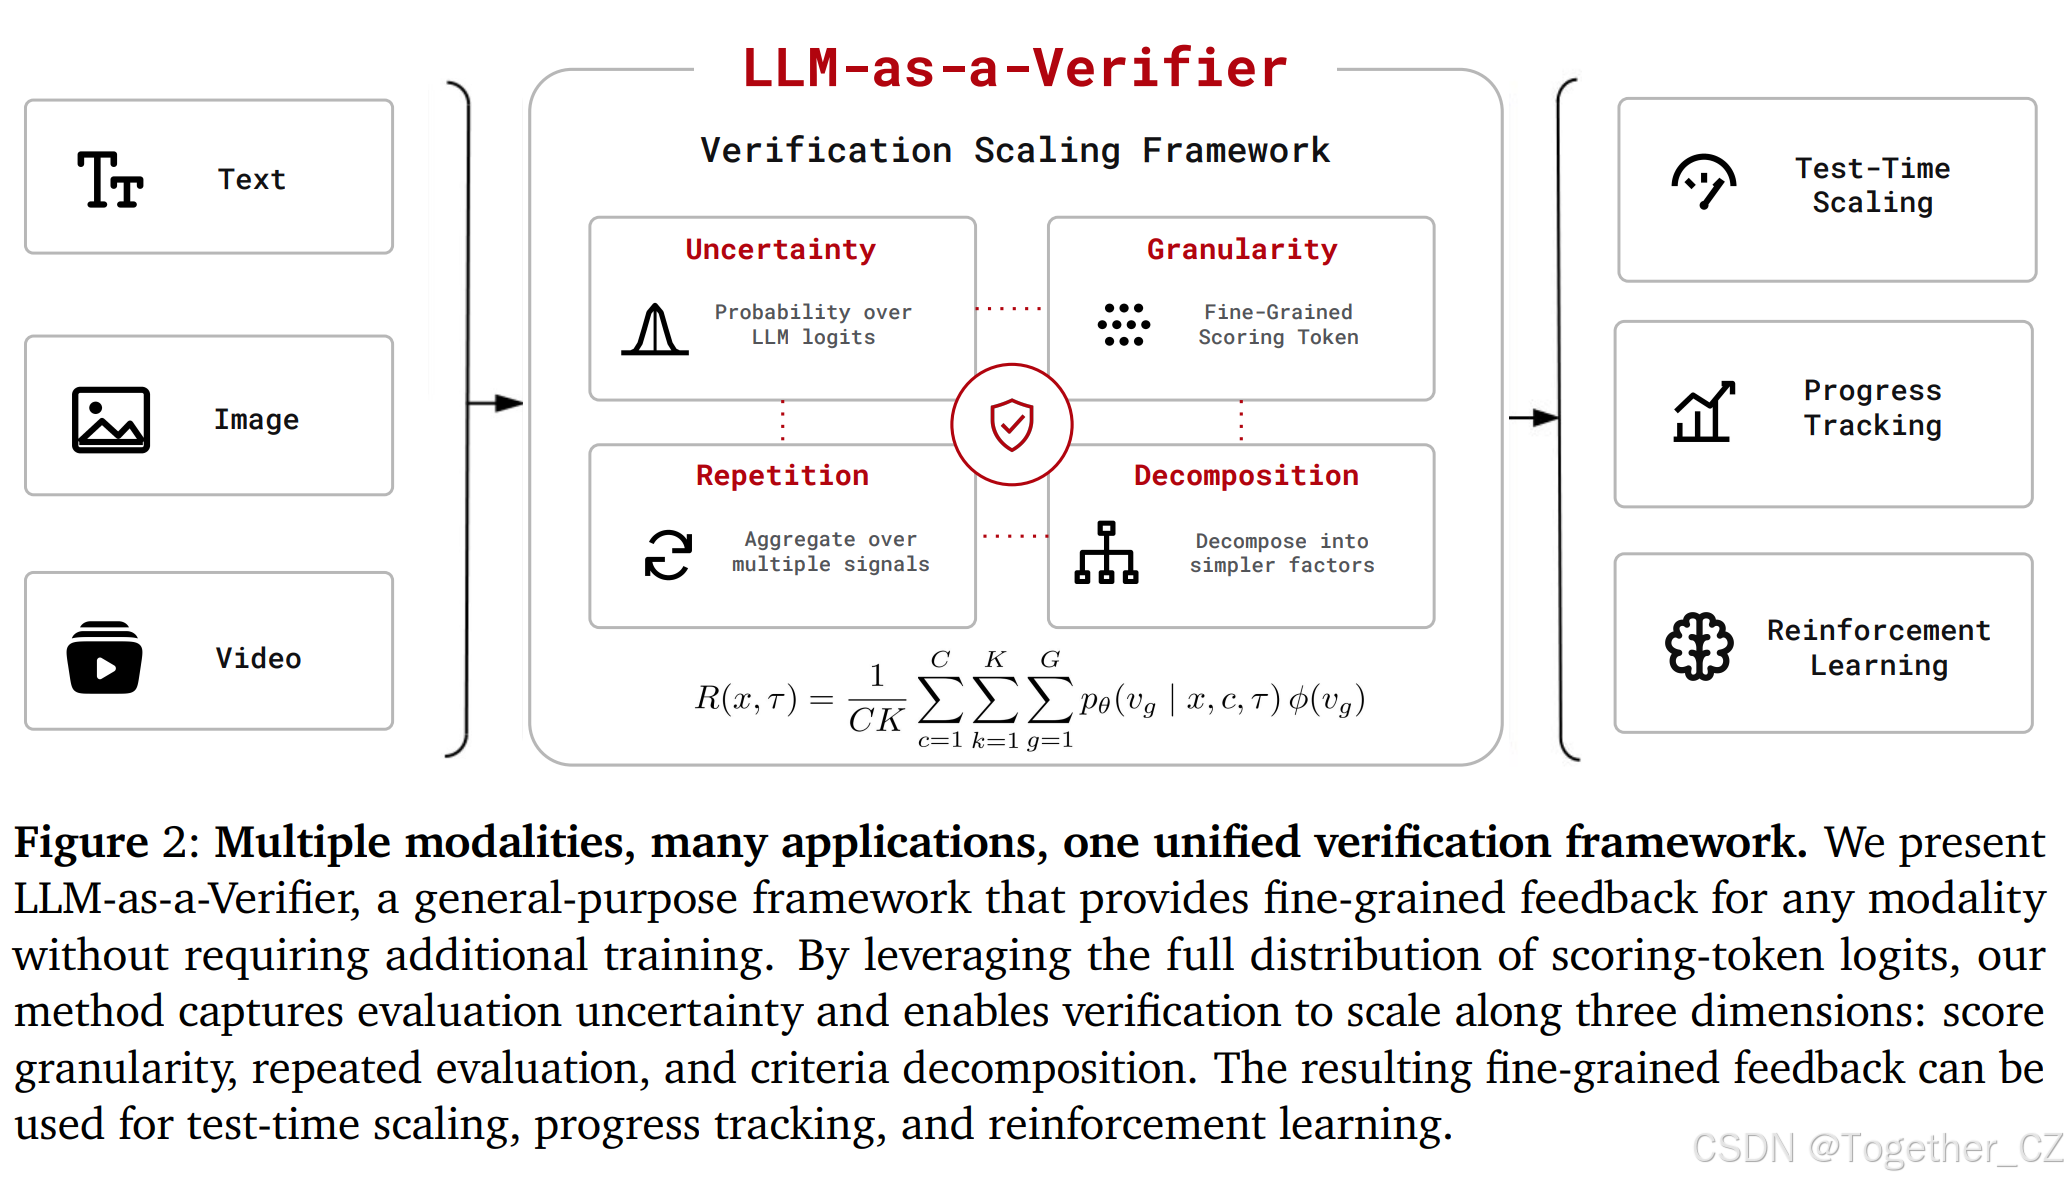
图2:多模态、多应用、统一验证框架。 我们提出了 LLM-as-a-Verifier,这是一个通用框架,无需额外训练即可为任何模态提供细粒度反馈。通过利用评分 token logits 的完整分布,我们的方法捕捉了评估不确定性,并使验证能够沿三个维度扩展:分数粒度、重复评估和标准分解。由此产生的细粒度反馈可用于测试时扩展、进度跟踪和强化学习。
1. 引言
大型语言模型(LLM)的最新进展已将扩展确立为提升其能力的核心范式。性能的提升由多个轴的扩展驱动,包括预训练数据和计算、后训练优化以及测试时推理 1-3。然而,尽管生成已从这些扩展范式中显著受益,但验证------即判断解决方案质量或正确性的能力------尚未经历同等程度的扩展。在这项工作中,我们认为验证本身构成了一个独特且尚未充分探索的扩展轴。与受益于成熟扩展定律的生成不同,当前系统中的验证仍然受到根本性限制。特别是,标准 LM 评判器将评分分布坍缩为粗略的离散分数 4, 5,导致平局和区分度差,而学习到的奖励模型受限于训练数据,往往无法跨领域泛化 6, 7。这些限制阻碍了验证的可扩展性,阻止了进一步的性能提升。
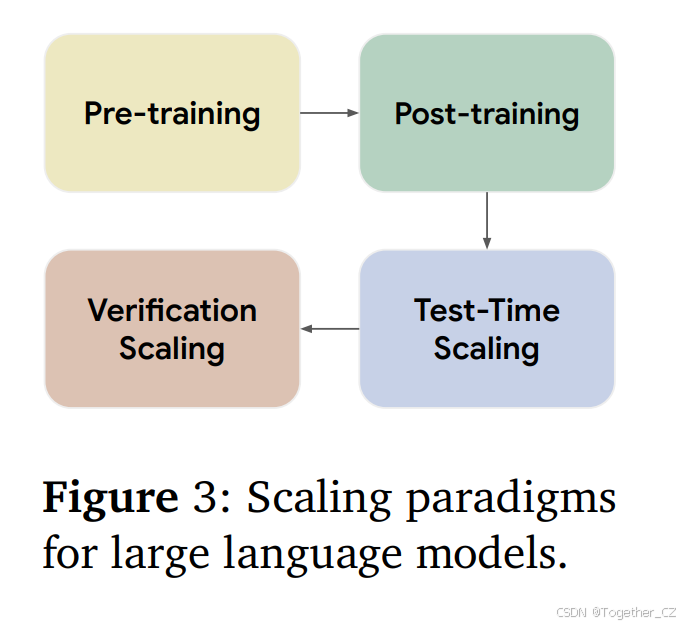
图3:大型语言模型的扩展范式。
为此,我们引入了 LLM-as-a-Verifier,这是一个通用的验证框架,无需额外训练即可提供密集且细粒度的反馈。与在语言空间内提示 LLM 产生离散分数的传统方法 4 不同,LLM-as-a-Verifier 通过计算评分 token logits 分布上的期望来估计候选解决方案的质量。在图4中,我们展示了这种概率公式为验证解锁了多个扩展轴。我们首先证明,扩展提取的 token logits 数量持续降低了比较复杂解决方案时的平局率,并改善了正负解决方案之间的分离。我们观察到,单个评估或单一标准可能存在偏差或噪声。为了缓解这一问题,我们沿另外两个维度扩展验证:重复评估(减少方差)和标准分解(减少提示偏差),从而提高验证准确率。我们在受控预算下量化了这些扩展收益,将 LLM-as-a-Verifier 与离散 LM 评判器基线进行比较(见第4节)。为了使验证扩展具有实用性,我们进一步引入了一种成本高效的排序算法,利用验证器连续分数导出的偏好概率在候选者中选择最佳解决方案。
有趣的是,我们发现 LLM-as-a-Verifier 产生的细粒度信号能够评估整个交互轨迹,而不仅仅是智能体任务中 PRM 和 ORM 7, 8 所关注的中间步骤或最终结果。当作为轨迹奖励模型与我们的成本高效排序算法结合使用时,LLM-as-a-Verifier 在编码、机器人和医学领域的挑战性基准上超越了前沿模型。它在 Terminal-Bench V2(86.5%)、SWE-Bench Verified(78.2%)、RoboRewardBench(87.4% 轨迹偏好准确率)和 MedAgentBench(73.3%)上达到了最先进的性能。
除了作为验证器的作用外,我们的方法还可以作为估计任务进度的代理。值得注意的是,我们观察到步骤的时间顺序与验证器分数之间存在强相关性(图8)。为了实现这些能力,我们为 Claude Code 和 Codex 提供了扩展,使用户能够监控任务进度并利用 LLM-as-a-Verifier 的优势来改进自己的智能体系统。在机器人学中,我们的方法超越了最先进的奖励模型,包括 Robometer 9、TOPReward 10 和 RoboReward 11,达到了 0.966 的平均值-顺序相关性(VOC)。总体而言,LLM-as-a-Verifier 提供了一种可扩展的机制,用于改善真实环境中自主智能体和机器人的评估与监控。
此外,我们证明使用 LLM-as-a-Verifier 作为密集奖励信号可以提高离策略和在策略强化学习算法的样本效率。在 LIBERO 12 上,当使用 DSRL-SAC 13 微调 π₀ 策略时,LLM-as-a-Verifier 实现了比稀疏奖励基线高约 1.8 倍的样本效率,同时达到了更高的最终成功率。在 MATH 推理基准上,当使用 GRPO 14 微调 Qwen3-8B 时,它实现了约 1.1 倍的样本效率提升。
-
我们引入了 LLM-as-a-Verifier,这是一个概率验证框架,利用评分 token logits 的完整分布产生细粒度反馈,并刻画了验证扩展的三个关键轴:(1)分数粒度,(2)重复评估,(3)标准分解。
-
我们提出了一种成本高效的候选者排序算法,并证明当与验证扩展结合时,LLM-as-a-Verifier 在编码、机器人和医学基准上达到了最先进的性能,且无需额外训练。
-
我们表明细粒度验证器分数与智能体的任务进度相关,可用于监控智能体和机器人的行为。
-
我们证明 LLM-as-a-Verifier 可以为强化学习提供密集反馈,提高在策略和离策略算法在机器人学和数学推理基准上的样本效率。
2. 预备知识
我们将智能体与环境交互建模为有限时域马尔可夫决策过程(MDP)𝓜 = (𝓒, 𝓢, 𝓐, P, R, H),其中 𝓒 表示上下文空间,𝓢 表示状态空间,𝓐 表示动作空间,P: 𝓒 × 𝓢 × 𝓐 → Δ(𝓢) 表示转移动力学,R: 𝓒 × 𝓢 × 𝓐 → ℝ 表示奖励函数,H ∈ ℕ⁺ 表示时域。在每个回合开始时,采样一个任务提示 x ∈ 𝓒,智能体从初始状态 s₁ ∈ 𝓢 开始。在每个时间步 t ∈ 1, H,智能体观察当前状态 sₜ,选择动作 aₜ ∈ 𝓐,并转移到下一个状态 sₜ₊₁ ~ P(· | x, sₜ, aₜ)。在基于 LLM 的智能体中,状态对应于先前的交互历史,动作对应于 token 序列,例如自然语言响应、代码编辑和工具调用。轨迹定义为 τ = (s₁, a₁, s₂, a₂, ..., s_H, a_H)。我们假设可以访问一个语言模型 π_θ: 𝓒 × 𝓢 → Δ(𝓐),由 θ 参数化,从中自回归地采样动作。奖励模型为动作或轨迹分配标量分数。传统方法依赖于提示 LLM 在语言空间中产生离散分数。形式上,此类奖励模型可写为 R_LM(x, τ) ∈ {1, ..., G},其中分数是生成的 token。
3. 提出的方法:LLM-as-a-Verifier
3.1. 动机
大多数模型已经具备解决许多任务的能力:当重复执行时,它们通常至少产生一次正确的解决方案。如图5(左)所示,假设有一个总是选择最优轨迹的预言验证器,随着我们在 Terminal-Bench 上扩展采样的轨迹数量,已解决任务的比例持续增加。在此设定下,当汇集整个 Terminal-Bench V2 排行榜的轨迹时,成功率达到了 98.9%,实际上几乎解决了整个基准。然而,要捕获这一余量,需要一个能够可靠区分正确轨迹和错误轨迹的验证器。虽然标准 LM 评判器 4 可以用作验证器,但它们无法提供足够细粒度的反馈。具体来说,它们提示模型输出一个离散的分数 token,并选择概率最高的 token 作为最终分数,将完整的评分分布坍缩为单一值。这导致评估本质上很粗糙。在比较复杂解决方案时,标准 LM 评判器经常给出相同的分数,导致平局,无法区分它们。结果,粗略评分在 Terminal-Bench 上导致了高平局率(27%),不同的轨迹经常坍缩到相同的分数,如图7所示。人们可以改为训练奖励模型 15,但此类方法受限于其训练数据,往往无法跨领域泛化。这些限制促使我们需要一个能够提供细粒度验证信号的通用框架。
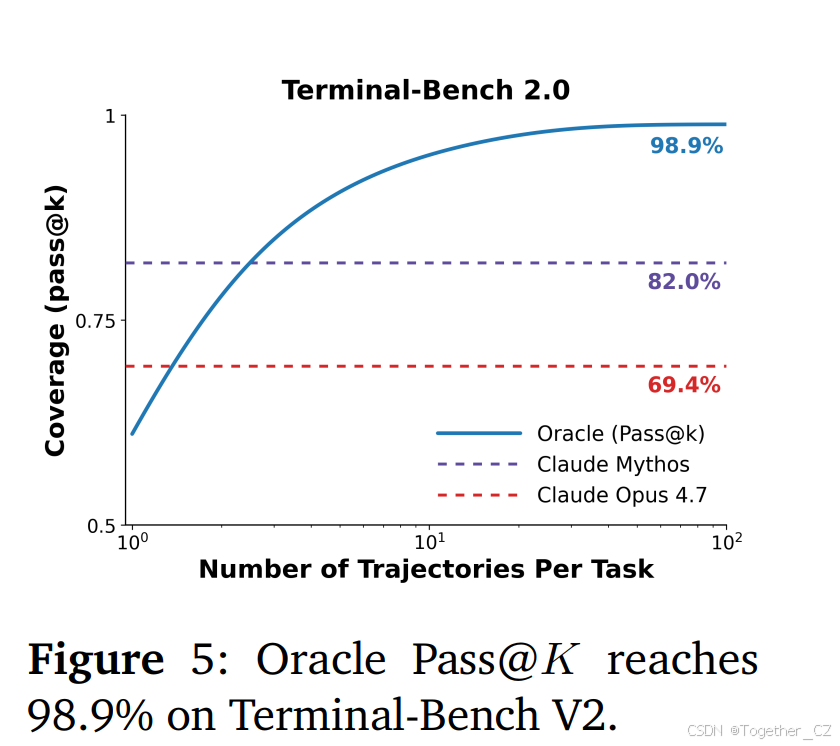
图5:Oracle Pass@K 在 Terminal-Bench V2 上达到 98.9%。
3.2. 方法论
细粒度奖励估计。 从定义上讲,评判者是形成总体意见并做出决定的人,而验证者是确认某事物真实性或正确性的人,需要更详细的评估。为此,我们引入了 LLM-as-a-Verifier,这是一个概率验证框架,通过扩展评分粒度、重复评估和标准分解来提供细粒度反馈。
令 V_score = {v₁, ..., v_G} 表示代表离散分数水平的有序 token 集合。给定任务提示 x、语言模型 p_θ、标准 c 和两个候选轨迹 τ_i 和 τ_j,我们构造评分提示并获得它们的条件分布 p_θ(v | x, c, τ_i) 和 p_θ(v | x, c, τ_j),通过使用以下提示从 <score_A> 和 <score_B> 标签中提取 logprobs:
你是一位专家 领域 评审员。你将看到任务描述和两条轨迹。评估标准:领域特定标准 任务:{task prompt} 轨迹 A:{A} 轨迹 B:{B} 仔细分析每条轨迹,然后给出你的最终分数:<score_A> INTEGER_1_TO_20 </score_A> <score_B> INTEGER_1_TO_20 </score_B> 评分规则:根据评估标准在 1-20 分范围内对正确性进行评分(1 = 不正确,10 = 临界,20 = 正确)注意:我们使用基于字母的评分标准而非数字,以便能够提取 logprob 进行粒度扩展。
我们没有将每个分布坍缩为单个离散分数,而是将轨迹的奖励近似为:
R(x, τ) = (1/CK) Σ_{c=1}^{C} Σ_{k=1}^{K} Σ_{g=1}^{G} p_θ(v_g | x, c, τ) φ(v_g) (3.1)
其中 C 是评估标准的数量,K 是重复验证的次数,G 是评分 token 的数量(粒度级别),p_θ(v_g | x, c, τ) 是模型 θ 分配给评分 token v_g 的概率,φ(v_g) 将每个评分 token 映射为标量值。
我们首先通过线性映射 R ↦ (R - φ_min) / (φ_max - φ_min) 将 R(x, τ) ∈ 0, 1 归一化。然后,我们使用 Bradley-Terry 模型将这些连续奖励转换为成对偏好,将 R(x, τ) 视为轨迹 τ 的潜在强度:
P(τ_i ≻ τ_j | x) = 1 / (1 + exp(-(R(x, τ_i) - R(x, τ_j)))) (3.2)
概率枢轴锦标赛。 为了在 N 个候选者中选出最佳轨迹,我们可以运行循环赛,对所有 C(N,2) 对进行评分并累积胜场
w_i += P(τ_i ≻ τ_j | x), w_j += 1 - P(τ_i ≻ τ_j | x),
使用公式 3.2 的偏好概率。然而,这种调度按 O(N²) 成对验证扩展,随着 N 的增长很快主导验证器成本。我们提出了一种预算高效的替代方案------概率枢轴锦标赛(PPT),如图6所示,其中每个候选者仅与一小组 k ≪ N 个枢轴进行比较,将预算从 O(N²) 降至 O(Nk)。关键的是,枢轴的选择决定了节省的预算是否花得值:任意的锚点会将验证浪费在明显较弱的候选者上。因此,我们引入了一个基于环的枢轴选择步骤,既消除了验证器的位置偏差,又将剩余预算集中在不确定的顶级候选者上。PPT 分为三个步骤:
-
环传递。 我们在 {1, ..., N} 上采样一个均匀随机的哈密顿环 γ,并对 N 个相邻对 {(γ_t, γ_{t+1 mod N})}_{t=1}^{N} 进行评分。由于循环结构,每个候选者在验证器提示的"A"位置和"B"位置各出现一次,因此语言模型对某一槽位的任何系统性偏好在整个环上期望抵消。
-
枢轴选择。 我们根据环传递平均偏好 w_i / c_i 对候选者进行排序,并选择前 k 个作为枢轴集 𝓟。从经验领先者中选择枢轴将剩余的验证预算分配给最有可能正确的候选者。
-
枢轴轮次。 固定枢轴集后,我们对 (i) 每个非枢轴 vs. 枢轴对 (i, p)(其中 i ∉ 𝓟,p ∈ 𝓟)以及 (ii) 枢轴之间的每一对 C(P,2) 进行评分。所有环和枢轴轮次比较都聚合到相同的 w_i、c_i 中,我们选择 i* ∈ arg max_i w_i / c_i。按 c_i 归一化消除了枢轴参与比非枢轴更多比较的偏差。成对验证的总数为 N + k(N-k) + C(k,2),按 O(Nk) 扩展,其中 k ≪ N。完整的生成和验证流程见算法1(附录B.2)。
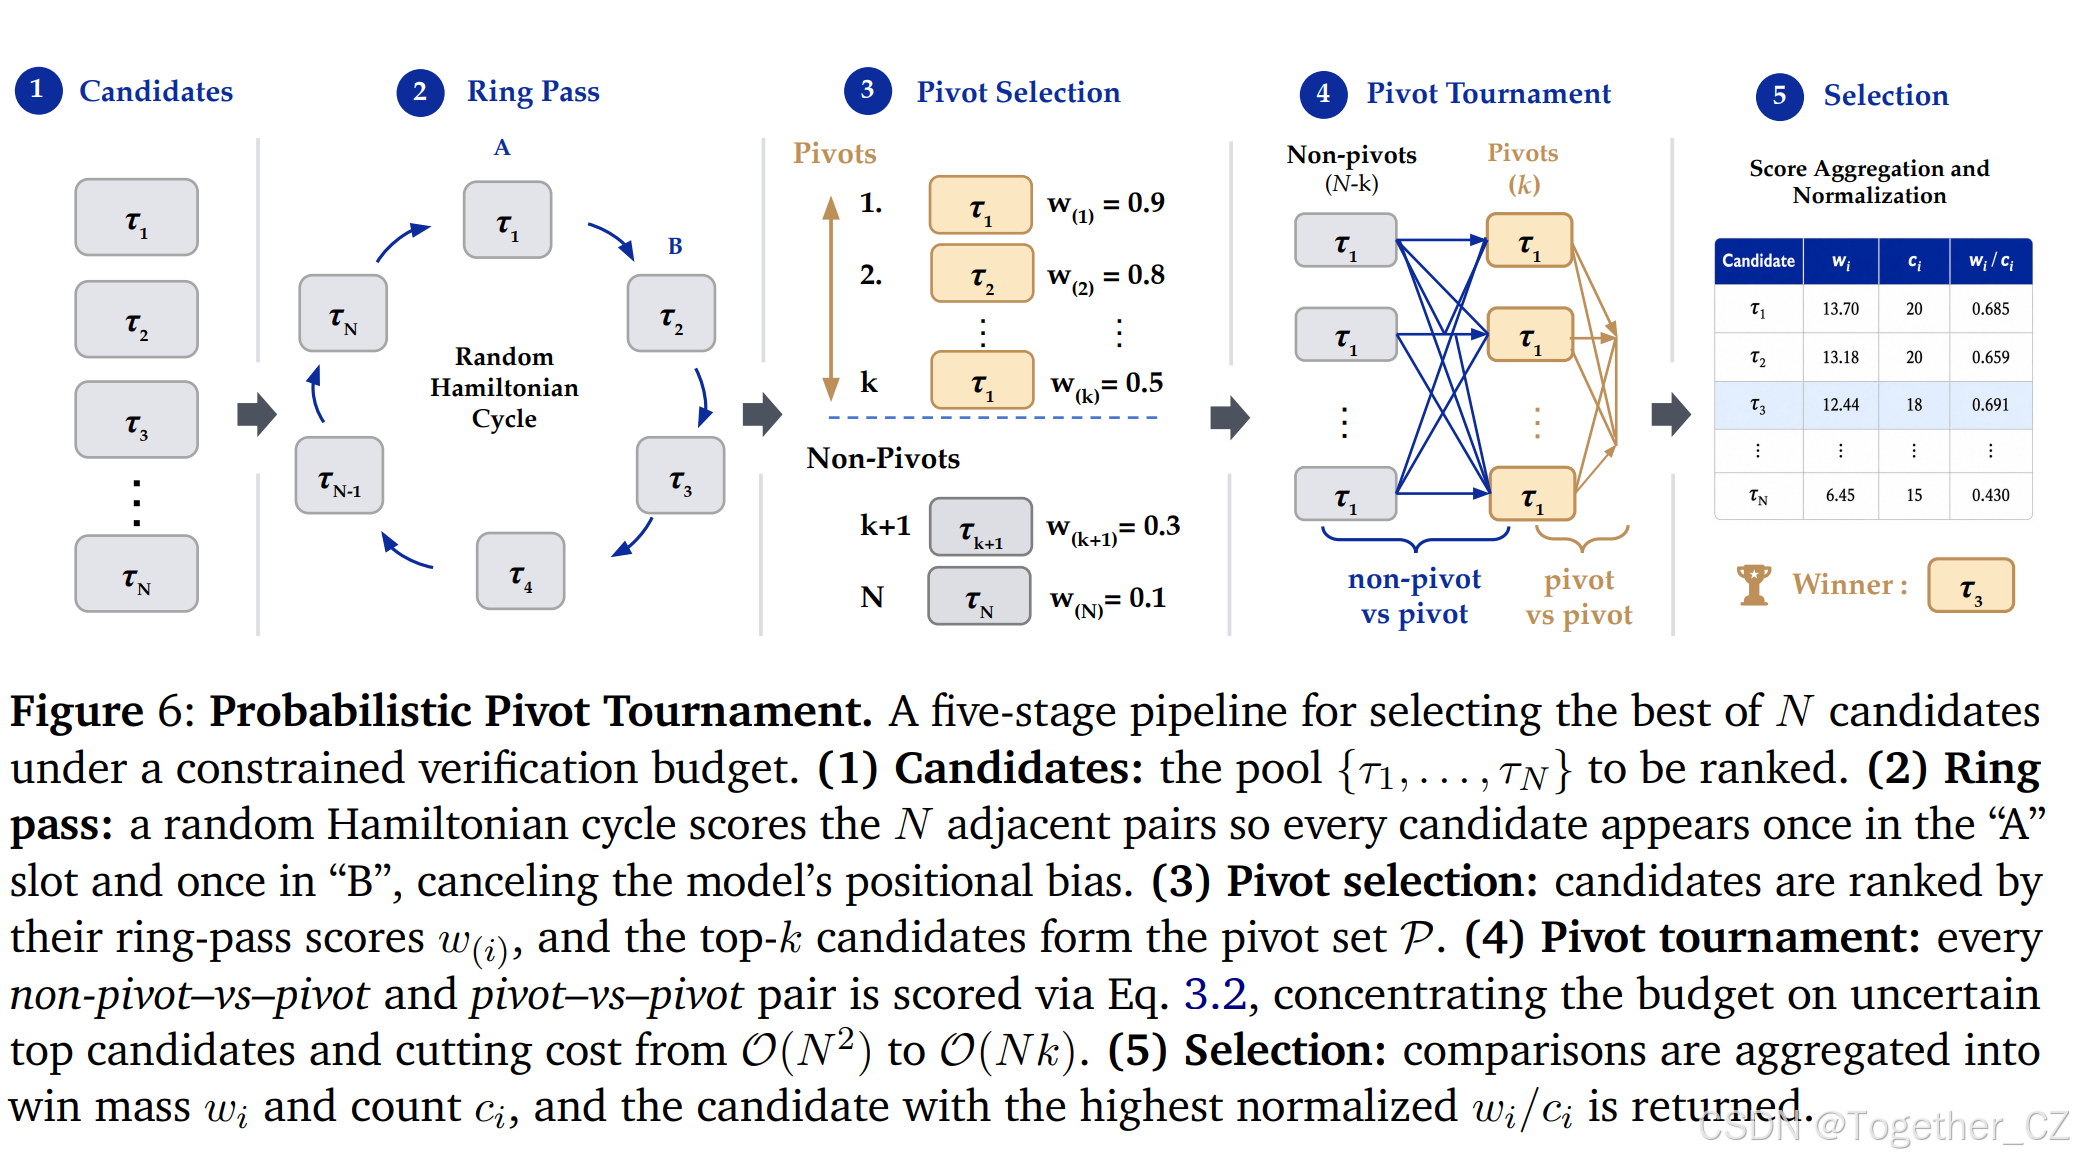
图6:概率枢轴锦标赛。 在受限验证预算下从 N 个候选者中选择最佳的五个阶段流程。(1) 候选者:待排序的池 {τ₁, ..., τ_N}。(2) 环传递:随机哈密顿环对 N 个相邻对进行评分,使每个候选者在"A"槽和"B"槽各出现一次,消除模型的位置偏差。(3) 枢轴选择:候选者按环传递分数 w_(i) 排序,前 k 个候选者组成枢轴集 𝓟。(4) 枢轴锦标赛:每个非枢轴 vs. 枢轴和枢轴 vs. 枢轴对通过公式 3.2 评分,将预算集中在不确定的顶级候选者上,将成本从 O(N²) 降至 O(Nk)。(5) 选择:比较聚合为胜场质量 w_i 和计数 c_i,返回归一化 w_i / c_i 最高的候选者。
为了严格评估排序算法并评估大型候选池上的性能,我们使用 Terminus-2 工具为每个任务构建了 20 条轨迹,并在此设定下对所有方法进行基准测试。表9刻画了 PPT 的预算-准确率权衡,表明我们的方法在需要较少比较的情况下优于先前方法(例如 V1 5)。值得注意的是,随着枢轴数量的增加,性能持续改善。更多消融实验见附录 B.2。
4. 验证扩展
公式 3.1 展示了验证可以沿三个独立轴扩展:评分 token 的粒度 G、重复评估的次数 K 和评估标准的数量 C。每个轴针对奖励估计中不同的误差来源,我们发现这三个轴作为互补杠杆发挥作用:增加粒度改善了候选解决方案之间的分数分离,重复评估平均了单次验证的偏差,标准分解捕捉了轨迹质量的互补方面。对于所有扩展实验,我们使用 Gemini 2.5 Flash 16 作为验证器,它允许我们为每个评分 token 提取最多 20 个 top logprobs。在图4中,我们展示了 Terminal-Bench 2.0 上的验证准确率沿所有三个维度均有改善,从 G = 1 时的 73.1% 上升到 G = 20 时的 77.5%,从 K = 1 时的 74.7% 上升到 K = 16 时的 77.4%,从任何单一标准的 75.2%-76.4% 上升到三个标准集成时的 78.3%。我们在 Terminal-Bench 的 200 条随机采样轨迹上测量成对验证准确率,涵盖多个智能体工具。每个轴都是实践者可以根据下游应用的延迟预算进行调整的旋钮。虽然我们的主要实验使用可访问 logprob 的模型,但附录 B.6 表明我们的框架也通过简单的两阶段变通方法与不暴露 token 级 logprobs 的前沿模型兼容。
4.1. 评分 Token 粒度
标准 LM 评判器将评分分布坍缩为单个最高概率 token,产生分辨率为 1/G 的离散奖励 R_LM(t, τ) ∈ {1, ..., G}。直观上,扩大有序 token 集 V_score 并不会给验证器提供关于轨迹的任何新信息。然而,它为解码器提供了一个更精细的空间来投影模型的内部信念,使得原本会被舍入到同一整数的邻近信念现在被映射到连续奖励。
信噪比。 为了分离出为什么更细粒度能改善验证,我们将正确轨迹(s_c)和错误轨迹(s_i)之间的成对分数差距 Δ = s_c - s_i 分解为信号和噪声分量。我们定义信噪比如公式 4.1(表1,左),其中 E(s_c - s_i) 捕捉验证器对正确轨迹相对于错误轨迹的偏好强度(信号强度),分母 Var(s_c - s_i) 捕捉该偏好在各对之间的一致性(噪声)。成对验证准确率是 SNR(G) 的单调函数:在样本量固定的情况下,标准化差距越大,意味着 s_c > s_i 的概率越高。经验上,我们发现 Terminal-Bench 上的 SNR(G) 从 G = 1 时的 0.775 增加到 G = 20 时的 0.799(表1)。因此,更细粒度的 token 产生更校准的分数,更可靠地区分正确和错误轨迹,进而将成对准确率从 73.1% 提高到 77.5%。
表1:信噪比(SNR)。(左)SNR 衡量验证器区分正确(s_c)和错误(s_i)轨迹的可靠性(公式 4.1)。(右)随着评分 token 数量 G 的增加,SNR 增长,表明分数分离更加校准。
| 粒度 G | 1 | 4 | 16 | 20 |
|---|---|---|---|---|
| SNR (k=16) | 0.775 | 0.786 | 0.797 | 0.799 |
案例研究:query-optimize。 为了具体说明将粒度扩展到 G = 20 以及我们的概率公式如何锐化验证器的信号,我们分析了 Terminal-Bench V2 上 query-optimize 任务的一个代表性轨迹对,由 Claude Opus 4.5 在 OpenHands 工具下生成,由 Gemini 2.5 Flash 评分。在这里,智能体被给定一个在数据库上运行的慢 SQL 查询,并被要求生成一个等价的优化版本。两条候选轨迹都生成了执行更快的查询,但它们在验证程序上存在关键差异。正确的轨迹等待完整 5 分钟让原始查询在规范数据库上完成,并与优化输出进行直接 diff。相比之下,失败的轨迹从未在数据库上验证等价性,而是创建了一个新数据库。如附录 B.4 中的推理轨迹所示,Gemini 2.5 Flash 可靠地识别出这一失败模式,但用分级的、含糊的语言表达(例如"稍微更干净"、"略微更直接"),仿佛差异很小。当在 100 次重复上评估时,标准 LM 评判器在 1-5 分制上将这种细致评估坍缩为离散分数(表2),在 100 次运行中有 88 次产生平局(例如 5 vs. 5),从而无法有意义地区分候选者。对相同 5 点分布取期望完全消除了平局------在 69 次运行中将正确轨迹排名更高------将粒度扩展到 G = 20 进一步锐化了信号,使 LLM-as-a-Verifier 在 100 次运行中有 77 次严格将正确轨迹排名更高。
表2:评判器 vs. 验证器在 query-optimize 上。 在 100 次重复评估中,我们统计正确轨迹被评分高于(s_c > s_i)、等于(s_c = s_i)或低于(s_c < s_i)错误轨迹的次数。离散 1-5 评判器在 88/100 次评估中产生平局。对相同 1-5 分制取期望消除了平局,并在 69/100 次评估中正确排名轨迹。将评分粒度增加到 G = 20 进一步改善了区分度,在 77/100 次评估中正确排名轨迹。
| 方法 | 奖励 R(x,τ) | #(s_c > s_i) | #(s_c = s_i)(平局) | #(s_c < s_i) |
|---|---|---|---|---|
| 评判器(离散,G=5) | φ(arg max_g p_θ(v_g)) | 12/100 | 88/100 | 0/100 |
| 验证器(连续,G=5) | Σ_g p_θ(v_g) φ(v_g) | 69/100 | 0/100 | 31/100 |
| 验证器(连续,G=20) | Σ_g p_θ(v_g) φ(v_g) | 77/100 | 0/100 | 23/100 |
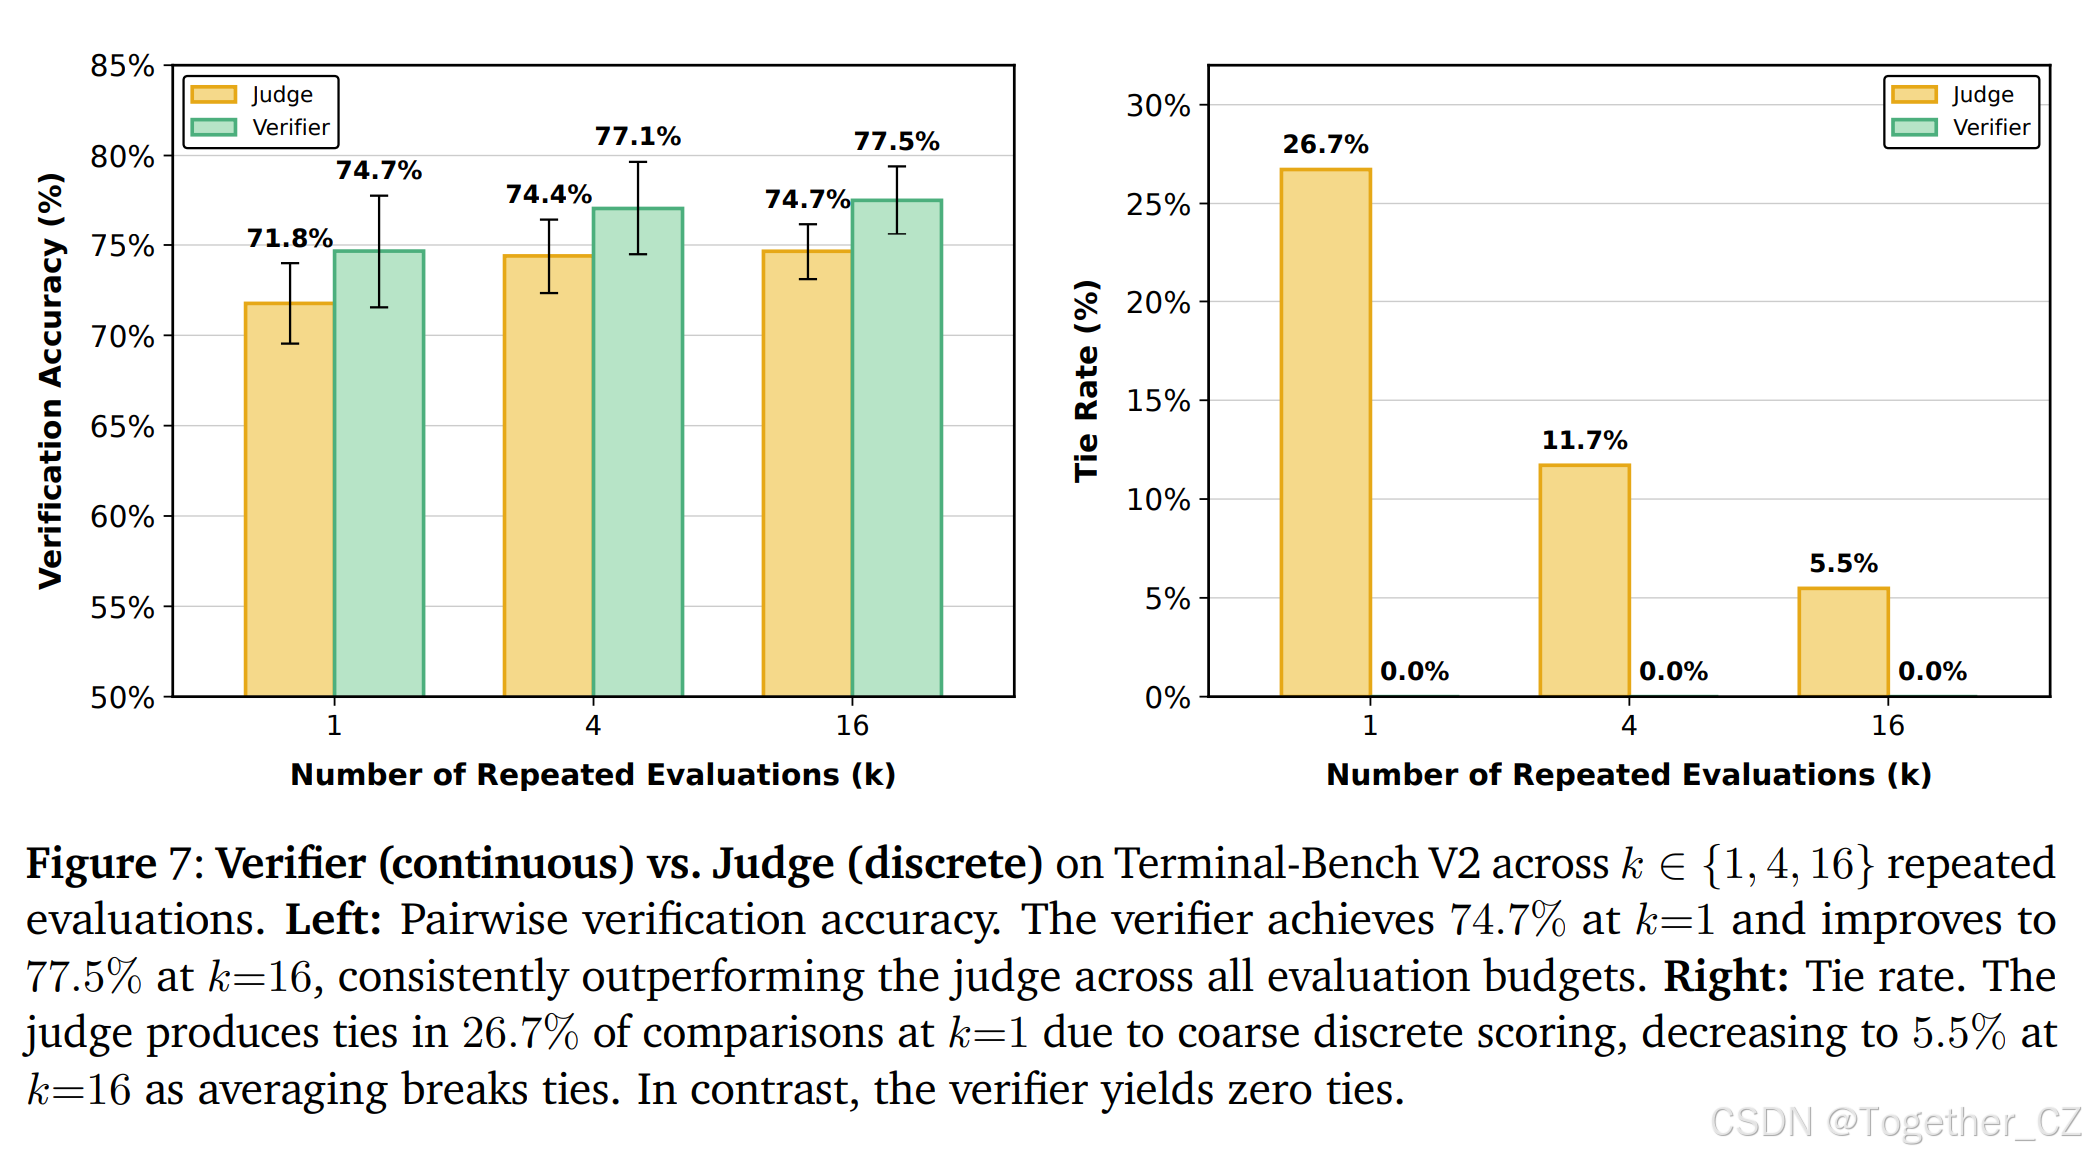
图7:验证器(连续)vs. 评判器(离散)在 Terminal-Bench V2 上,k ∈ {1, 4, 16} 次重复评估。 左:成对验证准确率。验证器在 k = 1 时达到 74.7%,在 k = 16 时提高到 77.5%,在所有评估预算下始终优于评判器。右:平局率。由于粗略离散评分,评判器在 k = 1 时在 26.7% 的比较中产生平局,随着平均打破平局,在 k = 16 时降至 5.5%。相比之下,验证器产生零平局。
4.2. 重复评估
虽然粒度改善了单次前向传播中的分数校准,但它并未解决第二个误差来源:验证器在单次评估中的方差。即使在高 G 下,单次评估 R^(k)(x, τ) 也可能被提示的虚假特征或验证器在特定轨迹上的失败模式所偏斜。平均 K 次独立评估 (1/K) Σ_{k=1}^{K} R^(k)(x, τ) 是底层期望奖励的蒙特卡洛估计器;其方差以 O(1/K) 缩小,而偏差不变。这补充了粒度而非重复它:粒度锐化每个单独的估计器,而重复评估平均掉粒度无法消除的噪声。图4(中)显示准确率从 K = 1 时的 74.7% 增加到 K = 16 时的 77.5%。然而,增益随着 K 增大而递减:早期改进来自方差减少,而额外的评估由于在更难示例上的相关偏差而贡献递减。重要的是,重复评估有利于离散评判器,其粗略评分在低 K 时导致高平局率。虽然增加 K 通过平均有助于打破这些平局,但这种机制对离散评判器而言从根本上受到限制。我们表明,单次验证器(K = 1)已经匹配了重度集成的评判器(K = 16),突出了细粒度概率评分提供了更强的信号。
4.3. 标准分解
粒度和重复评估都假设评分标准本身是充分的;如果单一整体标准不能很好地代表轨迹质量,两者都无济于事。在长时域智能体任务中,诸如"这条轨迹是否正确?"的判断混合了几个逻辑上不同的因素,而被问及复合问题的验证器往往会抓住提示中最显著的因素。因此,我们用 C 个更简单的子标准的集成来替代单一整体评分标准。具体而言,对于代码智能体轨迹,我们将正确性分解为三个单独更容易验证的因素:规范 (轨迹是否满足所有任务要求)、输出 (最终输出格式是否匹配预期结果)和错误(轨迹是否没有日志和工具输出中的失败信号)。最终奖励是各标准期望分数的平均值,如公式1的外层求和所示。在图4(右)中,任何单一标准单独达到 75.2%-76.4% 的准确率,它们的集成达到 78.3%。
5. 实验
我们评估 LLM-as-a-Verifier 作为轨迹奖励模型(TRM)在四个基准上进行测试时扩展,涵盖三个领域:编码(Terminal-Bench V2 17、SWE-Bench Verified 18)、机器人学(RoboRewardBench 11)和医学(MedAgentBench 19)。在所有四个基准上,我们使用相同的协议:生成策略 π_θ 为每个任务产生 N 条候选轨迹,验证器使用算法1中描述的概率枢轴锦标赛对每一对进行评分,提交归一化分数最高的轨迹。除非另有说明,验证器运行时粒度 G = 20,重复评估 K = 8,以及第4.3节描述的三标准分解。我们的方法是无需训练且即插即用的:相同的验证框架应用于所有四个基准,无需任何领域特定微调。总体结果总结在图1中,每个基准的主要数字(包括基线准确率、Pass@1 和 oracle Pass@N)报告在表3中。
表3:每个基准的性能和验证带来的增益。 基线准确率(左)在固定智能体工具下获得。在相同的候选池上,我们报告 Pass@1、oracle Pass@N 上限,以及 LLM-as-a-Verifier 达到的准确率(右)。我们的方法持续优于 Pass@1,并恢复了大部分 oracle 余量,在每个基准上都达到了最先进的性能。
| 基准 | 基线模型#1 | 基线模型#2 | 基线模型#3 | Pass@1 | Oracle | 我们的方法 |
|---|---|---|---|---|---|---|
| Terminal-Bench V2 | GPT-5.5 (84.7%) | Opus 4.7 (80.2%) | G3.1 Pro (80.2%) | 83.1% | 92.1% | 86.5% |
| SWE-Bench Verified | Opus 4.5 (76.8%) | G3 Flash (75.8%) | M2.5 (75.8%) | 76.1% | 84.4% | 78.2% |
| MedAgentBench | Opus 4.8 (70.2%) | G3.5 Flash (66.3%) | GPT-5.5 (65.1%) | 70.2% | 75.0% | 73.3% |
5.1. Terminal-Bench V2
Terminal-Bench V2 17 衡量智能体在基于 shell 的环境中的熟练程度,涉及需要多步推理、文件操作和从失败工具调用中恢复的长时域任务。该基准对验证器特别困难,因为许多轨迹产生语法上合理但错误的终端状态。我们使用 Capy 20 作为脚手架,从 GPT-5.5 为每个任务采样 N = 5 条轨迹;Gemini 2.5 Flash 作为验证器。GPT-5.5 在 Capy 下的 Pass@1 为 83.1%,该候选池上的 oracle Pass@5 上限为 92.1%。LLM-as-a-Verifier 将准确率从 83.1% 提高到 86.5%,超越了 Claude Mythos + Terminus-2 21(82.0%)、GPT-5.5 + NexAU-AHE(84.7%)、Claude Opus 4.7 + WOZCODE(80.2%)和 Gemini 3.1 Pro + TongAgents(80.2%),在 Terminal-Bench V2 上创造了新的最先进水平。我们进一步表明这些增益不依赖于特定工具。关于 Terminus-2 和 Terminus-Kira 的额外泛化结果,请参阅附录 B.1。
5.2. SWE-Bench Verified
SWE-Bench Verified 18 是 500 个真实世界 GitHub 问题的人工精选子集,每个任务要求智能体生成一个补丁来解决该问题并通过维护者的隐藏测试套件。它强调长上下文推理、跨文件编辑和与现有代码库的兼容性。我们使用 mini-swe-agent 作为脚手架,与 Terminal-Bench 上使用的同质提案池不同,我们从 Claude Opus 4.5、Gemini 3 Flash 和 MiniMax M2.5 各采样一条轨迹,为每个任务构建 N = 3 的异质候选池。Gemini 2.5 Flash 再次作为验证器。该候选池的平均 Pass@1 为 76.1%,oracle Pass@3 上限为 84.4%。LLM-as-a-Verifier 在 SWE-Bench Verified 上达到 78.2%,优于 Claude Opus 4.5(76.8%)、Gemini 3 Flash(75.8%)和 MiniMax M2.5(75.8%)。这些结果突出了验证器从不同模型家族产生的多样化候选者中选出最强轨迹的能力。
5.3. RoboRewardBench
RoboRewardBench 11 评估机器人操作轨迹上的奖励模型。遵循 Liang 等人 9 的方法,我们构建了遵循相同自然语言指令但取得不同进展的 rollout 视频对;奖励模型必须输出偏好,指示哪个 rollout 取得更多进展。与编码和临床基准不同,这里的输入是多帧视频,因此验证器必须整合跨帧的视觉上下文,以推理朝向目标的物理进展。我们使用 Qwen 3.6 35B 作为基础 VLM 验证器,并应用相同的概率公式(公式1)对从 VLM logits 中提取的评分 token 进行计算,粒度 G = 20,重复验证 K = 8。我们在 RoboRewardBench 的 500 个随机采样轨迹对上评估,并与 (i) 使用相同 VLM 的离散 LLM-as-a-Judge 基线、(ii) 专门在机器人数据上训练的奖励模型------RoboReward-8B(在约 45k 回合上训练)和 Robometer-4B(在约 1M 比较上训练),以及 (iii) TOPReward 10(Qwen 3.6)进行比较。如表4和附录 B.5 所示,LLM-as-a-Verifier 达到了 87.4% 的偏好准确率,优于离散 LLM-as-a-Judge 基线(70.8%)、RoboReward-8B(81.4%)、Robometer-4B 9(78.8%)和 TOPReward(74.7%),尽管是零样本应用且没有任何微调。我们还通过测量预测奖励与人工标注之间的平均绝对误差(MAE)在 RoboRewardBench 上评估。如表5所示,使用公式 3.1 中的连续奖励公式以及 K = 8 次重复评估,显著改善了与人类判断的对齐,将 MAE 从 1.11 降至 0.72。
表4:RoboRewardBench 上的偏好准确率。 LLM-as-a-Verifier 优于训练有素的机器人奖励模型。
| 方法 | 准确率 (%) |
|---|---|
| TOPReward | 74.7 |
| Robometer-4B | 78.8 |
| RoboReward-8B | 81.4 |
| LLM-as-a-Judge(离散) | 70.8 |
| LLM-as-a-Verifier(我们的) | 87.4 |
表5:RoboRewardBench 上与人工标注的评估。 我们报告人类标签与预测奖励之间的平均绝对误差(MAE;越低越好)。LLM-as-a-Verifier 使用连续奖励(K = 8),而基线从模型提取离散分数。
| 模型 | RoboRewardBench MAE (↓) |
|---|---|
| RoboReward 8B | 1.11 |
| RoboReward 8B + LLM-as-a-Verifier | 0.72 |
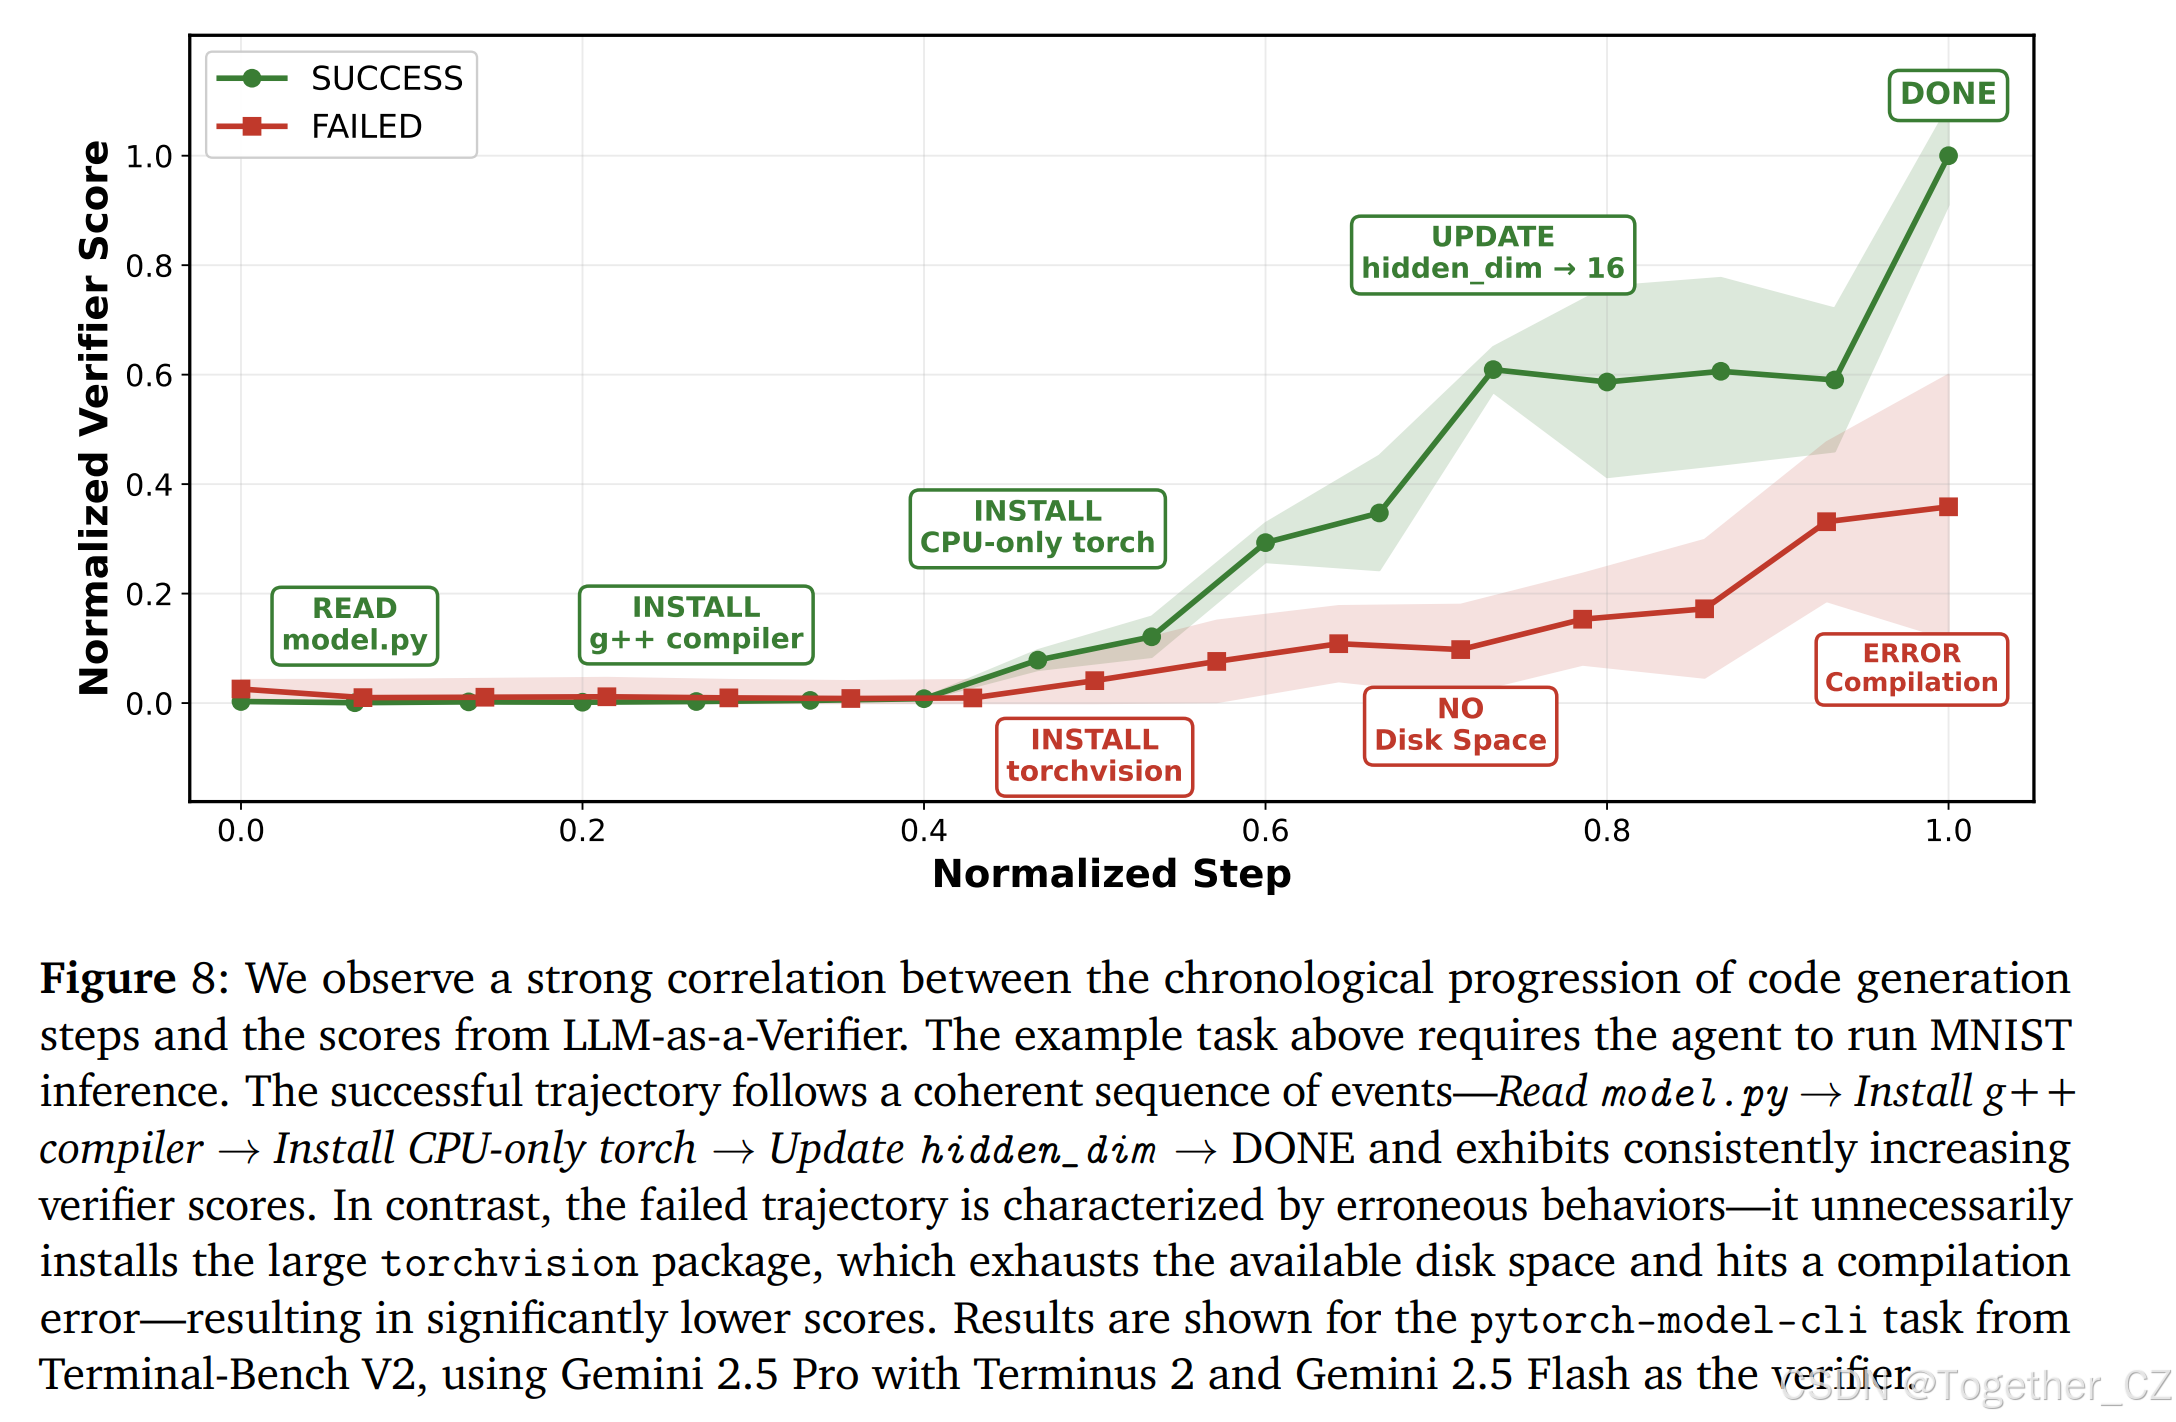
图8: 我们观察到代码生成步骤的时间顺序进展与 LLM-as-a-Verifier 的分数之间存在强相关性。上面的示例任务要求智能体运行 MNIST 推理。成功的轨迹遵循连贯的事件序列------Read model.py → Install g++ compiler → Install CPU-only torch → Update hidden_dim → DONE,并表现出持续增加的验证器分数。相比之下,失败的轨迹以错误行为为特征------它不必要地安装了大型 torchvision 包,耗尽了可用磁盘空间并遇到编译错误------导致分数显著降低。结果显示为 Terminal-Bench V2 的 pytorch-model-cli 任务,使用 Gemini 2.5 Pro 与 Terminus 2 以及 Gemini 2.5 Flash 作为验证器。
5.4. MedAgentBench
MedAgentBench 19 评估 LLM 智能体在涉及患者信息检索、指南查找和在模拟电子健康记录(EHR)环境中多步工具使用的医学任务上的表现。它涵盖了一个真实轨迹检查器构建成本高昂且验证错误带来真实安全后果的场景,使其成为通用验证器的自然压力测试。我们使用 AgentBench 工具,从 Claude Opus 4.8 为每个任务采样 N = 5 条轨迹,然后应用相同的验证程序。Claude Opus 4.8 在该池上的 Pass@1 为 70.2%,LLM-as-a-Verifier 达到 73.3%,优于 Opus 4.8(70.2%)、Gemini 3.5 Flash(66.3%)和 GPT-5.5(65.1%)。
6. 细粒度验证器信号作为任务进度的代理
除了选择最佳轨迹外,LLM-as-a-Verifier 产生的细粒度信号还可以作为智能体在任务中进展程度的标量代理。我们使用值-顺序相关性(VOC)来量化这一点,即步骤的时间索引与验证器对截止该步骤的前缀预测值之间的 Spearman 秩相关,遵循 Ma 等人 22 的方法。直观上,跟踪任务进度的验证器应该为成功 rollout 的较晚前缀分配单调更高的分数,产生 VOC → 1,并且应该对卡住或回退等失败模式保持稳健。
VOC = rank-correlation(argsort(s_{t_1}, s_{t_2}, ..., s_{t_K}), (t_1, t_2, ..., t_K)) (6.1)
代码生成上的 VOC。 在 Terminal-Bench V2 上,我们测量每个智能体动作的时间步骤与验证器对相应轨迹前缀的分数之间的 VOC。LLM-as-a-Verifier 在成功 rollout 上产生持续增加的分数,而在停滞或漂向失败的轨迹上基本持平,允许同一标量同时作为进度度量和早期预警信号。图8在 pytorch-model-cli 任务上说明了这一点,成功运行的分数单调上升,而失败运行的分数保持低位。这种双重用途激发了我们的 Claude Code 和 Codex 扩展,它们向用户展示实时验证器分数,以便长时间运行的智能体作业可以在将损坏状态提交到磁盘之前被监控、暂停或回滚。在从 Terminal-Bench V2 运行中抽取的 500 个(成功,失败)对中,验证器(Gemini 2.5 Flash,G = 20)在成功轨迹上达到 Spearman VOC 0.848,在失败轨迹上达到 0.769(完整数字见表6)。代码生成 VOC 数字表明,LLM-as-a-Verifier 产生的细粒度信号不仅仅是一个更好的排序器,而是一个校准的任务进度估计器,为自主智能体更安全的真实世界部署开辟了道路。
表6:Terminal-Bench V2 上按轨迹结果的值-顺序相关性。 步骤索引与验证器进度分数之间的平均 Spearman 秩相关,在从 Terminal-Bench V2 随机采样的 500 条轨迹上计算。验证器(Gemini 2.5 Flash,G = 20)对成功轨迹表现出接近单调的进展,而失败 rollout 显示较弱的相关性,表明进展有限或不一致。我们观察到同一任务上相同智能体骨干生成的成功和失败轨迹之间有 0.08 的 Spearman 差距。
| 轨迹结果 | Spearman VOC(秩相关) |
|---|---|
| 成功 | 0.848 ± 0.012 |
| 失败 | 0.769 ± 0.016 |
| 成功 -- 失败(差距) | +0.079 |
机器人学上的 VOC。 我们在保留的 RoboReward 数据集的 500 条轨迹上计算 VOC。如表7所示,LLM-as-a-Verifier(Qwen 3.6,K = 5,G = 20)达到 0.966,大幅超过 RoboReward-8B(0.877)、Robometer-4B(0.780)和 TOPReward(0.565)。定性上,TOPReward 倾向于几乎立即饱和在 P(True) = 1.0,因此当 rollout 最终失败时失去了区分中期轨迹进展的能力,而我们对完整评分分布的期望在整个回合中保留了平滑的、按时间对齐的信号。
表7:RoboRewardBench 上 500 条轨迹的值-顺序相关性。 LLM-as-a-Verifier 使用 K = 5 次重复评估和 G = 20 评分粒度,在时间步骤索引与验证器预测进度分数之间达到最高的秩相关。
| 方法 | Spearman VOC(秩相关) |
|---|---|
| LLM-as-a-Verifier(Qwen 3.6 35B,5 次重复,20 粒度) | 0.966 |
| RoboReward-8B | 0.877 |
| Robometer-4B | 0.780 |
| TOPReward(Qwen 3.6,P(true)) | 0.565 |
编码智能体扩展。 为了展示 LLM-as-a-Verifier 对真实世界编码智能体的适用性,我们开发了 TurboAgent,这是一个用于 Claude Code 和其他 OpenAI-API 兼容客户端的即插即用扩展。TurboAgent 作为一个推理时代理,透明地位于客户端和 LLM 提供商之间,无需修改底层智能体工具或后端模型。代理设计还允许 TurboAgent 透明地插入现有基准,如 Terminal-Bench 17。对于每个请求,它并行地向后端模型分派 N 条候选轨迹,并使用所提出的概率枢轴锦标赛(PPT)选择最佳响应。除了验证之外,TurboAgent 还提供了一个基于 Web 的界面,用于可视化验证器输出并实时监控智能体进度。
7. 强化学习的密集奖励
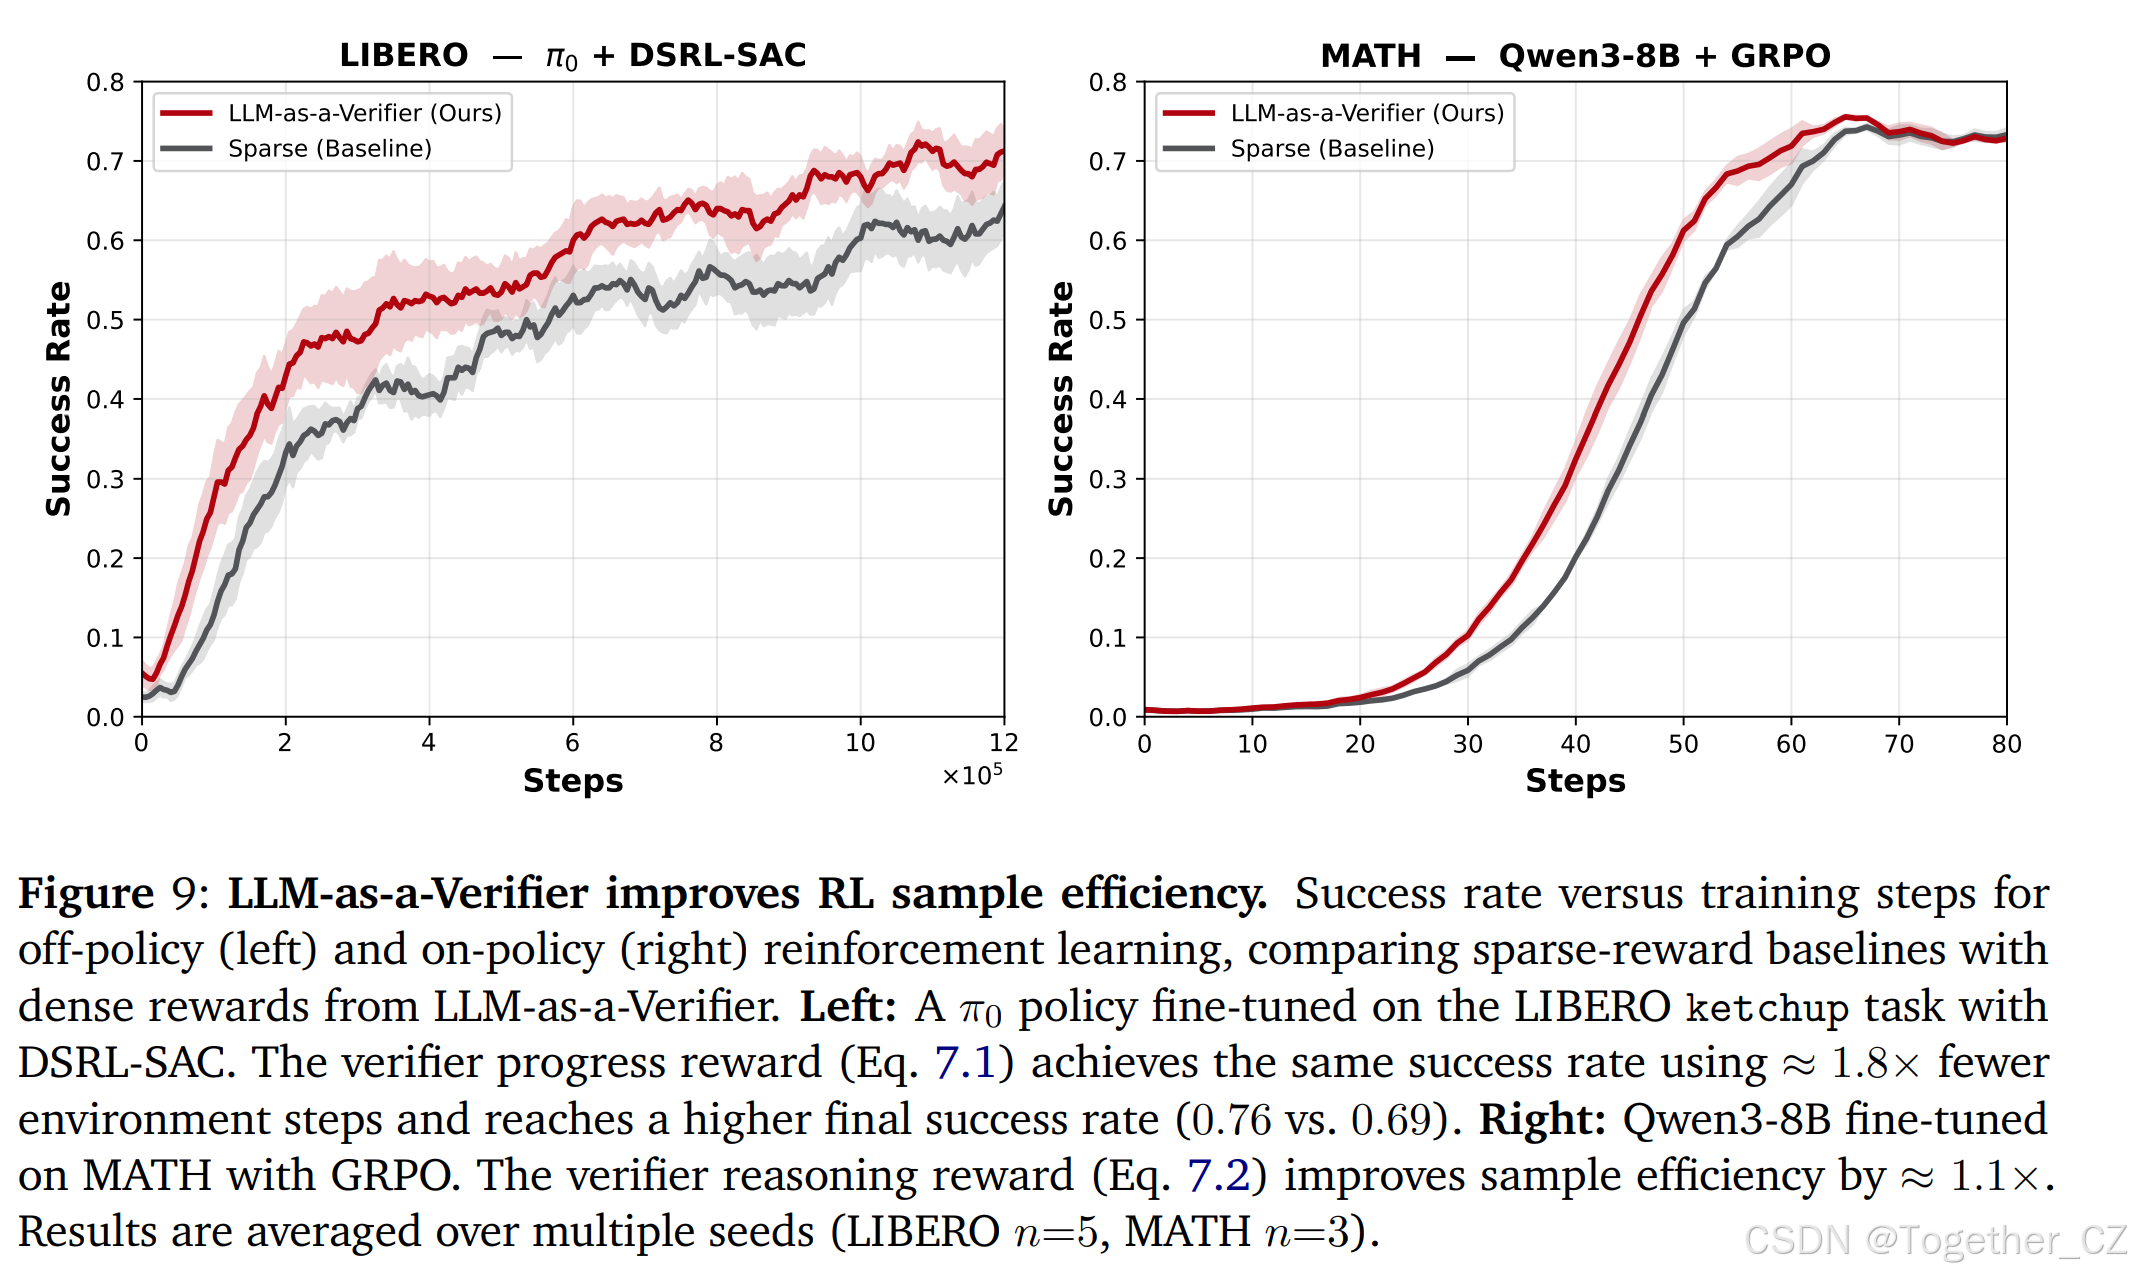
图9:LLM-as-a-Verifier 提高了 RL 样本效率。 离策略(左)和在策略(右)强化学习的成功率与训练步骤的关系,比较稀疏奖励基线与来自 LLM-as-a-Verifier 的密集奖励。左:在 LIBERO ketchup 任务上用 DSRL-SAC 微调的 π₀ 策略。验证器进度奖励(公式 7.1)使用约 1.8 倍更少的环境步骤达到相同的成功率,并达到更高的最终成功率(0.76 vs. 0.69)。右:在 MATH 上用 GRPO 微调的 Qwen3-8B。验证器推理奖励(公式 7.2)将样本效率提高约 1.1 倍。结果在多个种子上平均(LIBERO n = 5,MATH n = 3)。
上一节的进度信号还有助于缓解强化学习(RL)中长期存在的困难:信用分配问题。我们表明,LLM-as-a-Verifier 的细粒度分数(公式 3.1)是离策略和在策略 RL 的即插即用密集奖励,无需任何奖励模型训练或环境特定塑形即可提高样本效率。
离策略 RL:DSRL-SAC 的密集进度奖励。 我们在 LIBERO 上使用 DSRL 和 Soft Actor--Critic(SAC)微调 π₀ 23 视觉--语言--动作模型。在每个 rollout 结束时,我们用任务指令 x 和均匀子采样的渲染帧序列查询 VLM 验证器,获得逐步进度曲线 ρ_t = R(x, τ_{1:t}) ∈ 0, 1。然后我们用塑形奖励重新标注该 rollout:
r_t = r^env_t + λ ρ_t, (7.1)
将重新标注的转移 (s_t, a_t, r_t, s_{t+1}) 存入回放缓冲区 𝓓,并基于从 𝓓 中采样的重新标注回报训练 SAC 评论家。系数 λ 权衡环境奖励和验证器奖励。由于塑形是离线应用于已存储的轨迹,且不改变 SAC 目标,因此它以零额外算法成本添加了密集的中间信号。
在策略 RL:GRPO 的密集推理奖励。 我们在 MATH 上使用组相对策略优化(GRPO)14 微调 Qwen3-8B 24,该方法为每个提示 x 采样一组 G 个响应 {y_i}_{i=1}^{G},并估计每个响应相对于该组的优势。在训练的早期阶段,所有采样的响应通常都产生错误的最终答案,导致组相对优势坍缩为零,从而不产生梯度。LLM-as-a-Verifier 通过使用概率枢轴锦标赛(公式 3.2)评估每个补全的推理轨迹来缓解这一问题,为每个响应分配一个归一化偏好分数 R̄_i ∈ 0, 1,即使最终答案相同,也能捕捉推理质量上的细粒度差异。我们将这个由验证器导出的分数以权重 β 纳入标准的正确性和格式奖励中:
r_i = r_correct,i + r_format,i + β r_reasoning,i. (7.2)
实证发现。 在两种设定下,密集验证器奖励都比稀疏基线提高了样本效率(图9)。我们将样本效率量化为稀疏基线达到目标成功率所需的训练步数与我们密集奖励所需步数的比值。在 LIBERO 上,对使用 DSRL-SAC 训练的 π₀ 策略进行塑形,在显著更少的环境步骤中达到了匹配的成功率------在 0.2 到 0.6 的成功率目标范围内,样本效率提高了 1.8 倍------同时达到了更高的最终成功率(0.76 vs. 0.69)。在 MATH 上,用推理奖励增强 GRPO 带来了较小但一致的增益,约为 1.1 倍(达到匹配准确率所需的优化器步数减少了约 10%)。我们在附录 B.7 中报告了奖励塑形超参数和额外的消融实验。
8. 讨论
在这项工作中,我们认为验证构成了一个尚未充分探索的扩展轴。为了实现这一点,我们提出了 LLM-as-a-Verifier,这是一个通用框架,为智能体任务提供细粒度反馈。与输出单一离散分数的标准 LM 评判器不同,我们的方法通过对评分 token logits 分布取期望来计算连续奖励,并使验证能够沿多个维度扩展,包括:(1)分数粒度,(2)重复评估,(3)标准分解。当作为测试时扩展的轨迹奖励模型使用时,它在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上达到了最先进的性能。除了排序之外,细粒度验证器信号还可以用作进度估计器,为自主智能体更安全的真实世界部署开辟了道路。最后,我们证明 LLM-as-a-Verifier 可以作为 RL 的密集奖励信号,提高 SAC 和 GRPO 在机器人学和数学推理基准上的样本效率。
9. 相关工作
测试时扩展。 测试时扩展通过在 deliberation、搜索或候选生成上花费额外的推理计算来提高模型性能。一条工作线通过链式思维 25, 26 引出中间推理、将问题分解为更简单的子问题 27 或对采样的推理路径进行边缘化 28 来改进单个响应。另一条线基于测试时反馈 34-39 在中间思维 29, 30、动作 31, 32 或潜在世界状态 33 上进行搜索。重复采样和 best-of-N 选择进一步为代码生成 40、一般推理 3, 41、并行自验证 5 和推理感知训练 42 扩展候选池。这些方法可以暴露大量 oracle 余量,但实现这一余量需要可靠的 selector。我们的 LLM-as-a-Verifier 反而表明,验证器质量可以通过扩展分数粒度、重复评估和标准分解来改善,而更好的验证直接改善了长时域决策的 best-of-N 选择。
LLM-as-a-Judge。 LLM-as-a-judge 方法通过提示大型模型对生成的输出进行评分或比较,为人类评估提供了可扩展的替代方案。基于概率和填表式的评估器从 LLM 中提取更丰富的评分信号 43, 44,而基准式评估器使用 LLM 偏好来评估指令遵循系统 45-47。一个互补的工作线通过技能分解 48、定制评分标准和专门的开源评判器 49-52 以及分层标准 53 使评估更加细粒度。其他工作训练可扩展的评判模型 54, 55 或通过辩论和弱验证器集成结合多个评判器 56, 57。最近的研究还分析了评判器的可靠性,包括公平性和位置偏差 58, 59、认知和自我增强偏差 60, 61、通用评判器基准 62, 63 以及领域特定的评判器评估 64。多模态评判模型将此范式扩展到图像和视觉-语言评估 65-67。我们的工作建立在这些工作之上,但在设定、目标和扩展表征方面有所不同。LLM-as-a-Verifier 不是评估孤立的自然语言响应,而是验证涉及工具使用、代码执行、机器人学和医学决策的长时域智能体轨迹。此外,我们系统地研究了验证质量如何随分数粒度、重复评估和标准分解而扩展。
可验证奖励。 奖励模型将候选解决方案、动作或轨迹转换为标量反馈,用于选择、监控或策略优化。在语言推理中,学习到的验证器已被训练为用于最终答案选择的结果奖励模型 7、用于步骤级监督的过程奖励模型 8, 68 以及将奖励建模作为下一 token 预测的生成式验证器 6。在机器人学中,奖励信号已从价值隐式视觉表示 69、语言-图像奖励表示 70、预训练视觉-语言模型 22, 71, 72、VLM 反馈或偏好 73、LLM 生成的奖励代码 74-76、token 概率进度 10 以及基于大规模轨迹或偏好数据训练的通用的机器人奖励模型 9, 11, 77, 78 中导出。最近的工作还开发了用于引导采样 79-81、运行时监控 82 和多模态对齐 83 的动作级验证器。一个互补的工作线通过将整体判断分解为更小的检查 53, 84-88 使验证更可靠。与这些方法正交,我们的工作研究了验证器质量如何在通用框架中跨多个领域随分数粒度、重复评估和标准分解而扩展。