摘要 :给智能体写工具,难点不在接口能否被调用,而在于让模型知道何时调用、怎样传参、哪些返回值得相信、下一步能做什么。本文解读 Anthropic 的工程经验文章,围绕「选择契约、输入契约、输出契约」展开:先从工作流出发决定暴露哪些能力,用命名空间和消歧字段避免模型在名称处走偏,让返回值支持下一步而非展示后端一切,省 token 时保住判断所需信息,并用真实任务评测工具而非固定路线。核心方法是一套用任务评测反复改进工具的迭代流程,最终让正确的信息更容易获得、业务对象更容易辨认、下一步动作更容易选对。
"客户说同一笔订单被扣了三次,帮我查清楚。"
你给智能体接上了用户查询、订单查询、支付流水、日志读取四个 API。每个接口单独测试都正常。模型却拿着错误的标识符反复查询,读了一大段无关日志,最后把三次支付重试当成了三笔真实扣款。
接口没有报错,任务仍然失败了。
给智能体做工具,难点就在这里:工具不仅要能被执行,还要让模型知道何时调用、怎样传参、哪些返回内容值得相信,以及下一步能做什么。
本文解读 Anthropic 于 2025 年 9 月 11 日发表的 Writing effective tools for agents --- with agents。原文是工程经验文章,核心是一套用任务评测反复改进工具的方法。下文的账单与日志接口是本文构造的教学例子,未进行真实 LLM 性能实验。1
工具契约里,多了一个会理解错的调用者
传统 API 的调用程序通常已经写好了字段映射和调用顺序。模型面对的却是一段自然语言需求,它需要自行决定:调用哪个工具、先查什么、是否继续、怎样解释结果。
同一份工具定义,对不同模型、不同任务上下文,可能产生不同调用行为。这里的"不确定"主要发生在智能体的选择与生成环节,并不意味着工具后端可以随意改变业务语义。
因此,一份可用的工具契约至少需要说明三件事:
- 选择契约:什么情况下用它,与相近工具的边界是什么。
- 输入契约:参数代表什么对象,单位、格式、约束和默认值是什么。
- 输出契约:返回值支持什么判断,是否完整,有没有可继续调用的资源标识。
例如,status="success" 究竟表示 API 请求成功,还是已经成功扣款?如果工具定义不区分,模型可能把一次请求成功当成业务完成。这个错误不能靠 JSON 语法检查发现。
你仍然需要普通软件测试,检查查询是否正确、分页是否稳定、业务操作是否符合约束;还要增加智能体层面的任务评测,检查模型能否借助这些接口完成真实目标。两种测试回答不同的问题。
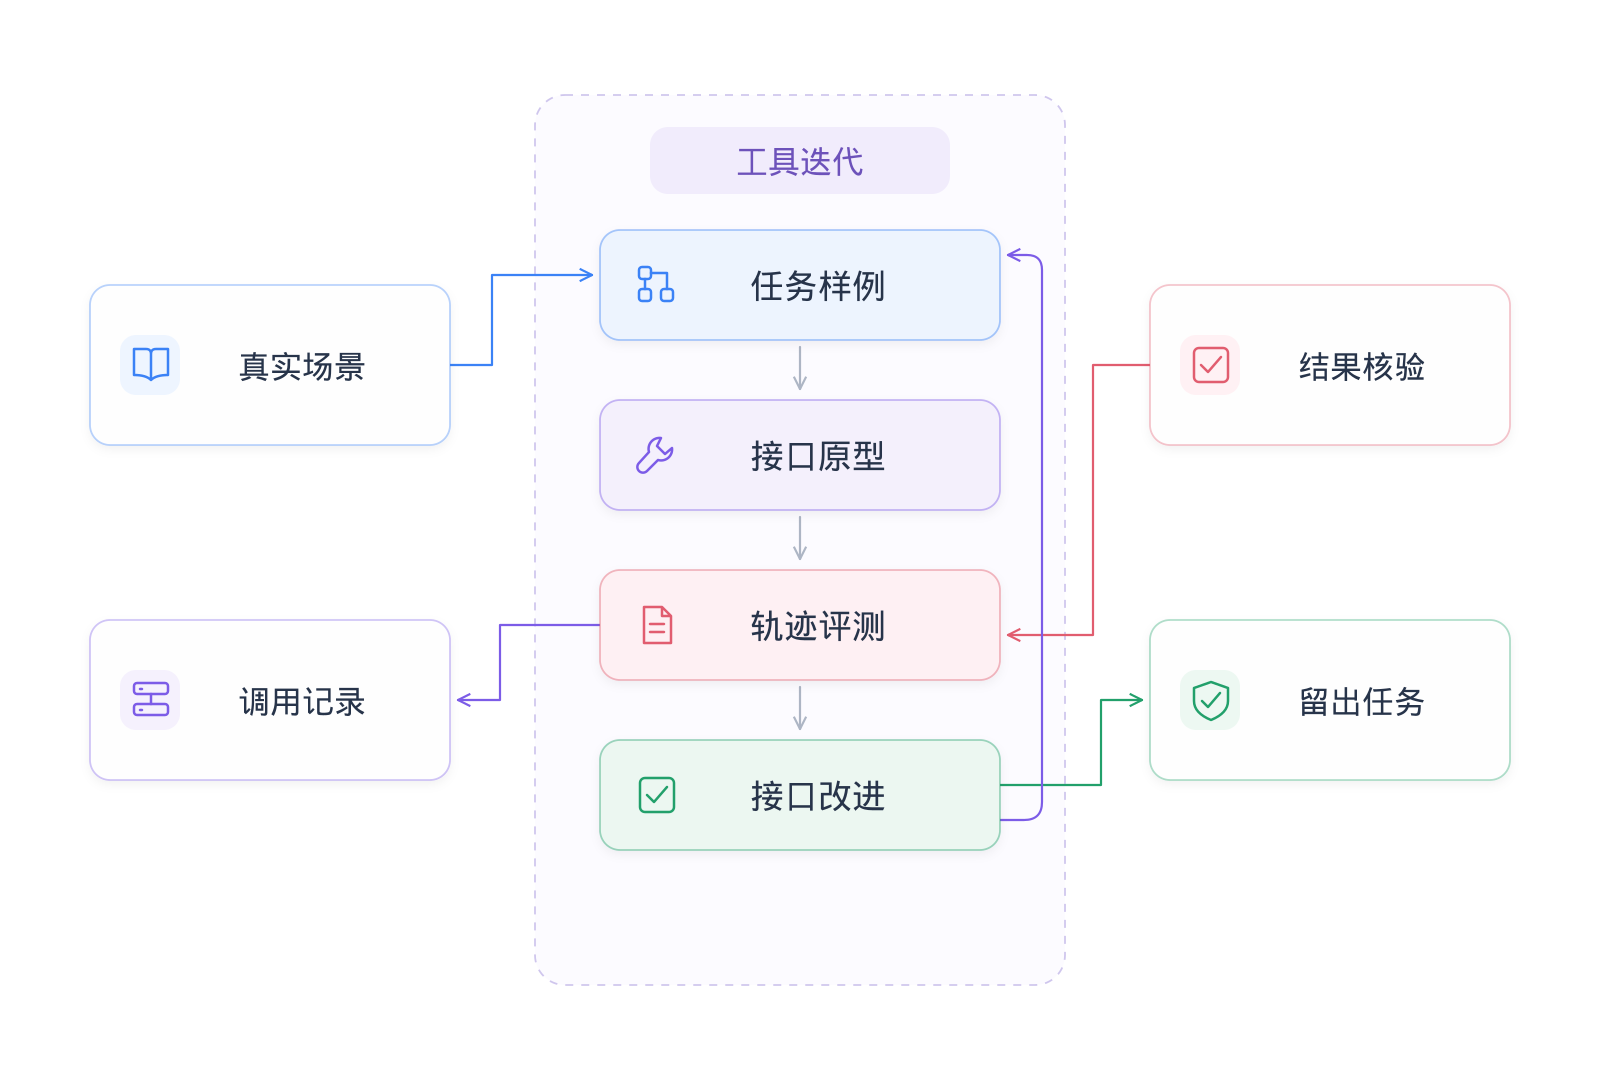
图 1|原文的评测驱动迭代思路。中央流程从任务到原型,再到评测与改进;回路表示修改后重新测试,右侧留出任务用于检查改进是否超出开发样例。这里优化的是工具与接口设计,图中没有模型训练步骤。依据原文整理,布局原创。1
先从工作流出发,决定暴露哪些能力
把每一个后端 API 都包装成工具,容易把数据库内部结构直接交给模型理解。模型要在许多相似名称之间选择,还要完成大量低层关联。
对开头的扣款问题,一种接口设计可能要求模型先查客户,再查订单,再查支付尝试,最后关联日志。另一种设计可以提供一个只读工具,按支付尝试返回关联的请求记录、账务记录和必要日志。
第二种设计把一部分确定性的关联工作放回程序。它的收益不只在于减少调用次数:模型不必自己猜测哪个字段是关联键,也少了一次把请求事件当作实际入账的机会。
这并不要求所有操作都合成一个万能工具。查询范围过大、参数含糊、返回内容膨胀的"大工具",也会增加理解负担。适合合并的通常是边界稳定、经常连续出现、程序能确定执行的子流程。
| 任务需要 | 较难使用的接口形态 | 更值得评测的候选设计 |
|---|---|---|
| 找到与事故相关的日志 | 返回一整天全部日志 | 按时间、业务对象和事件类型搜索,并提供少量上下文 |
| 理解一位客户的近期情况 | 分别列出全部订单、留言和流水 | 汇总与当前问题相关的信息,保留可追溯标识 |
| 找到一个联系人 | 一次返回完整通讯录 | 先按姓名等条件搜索,再返回明确候选与唯一标识 |
| 完成多资源关联任务 | 把所有关联键交给模型拼接 | 在工具内部完成确定性关联,暴露有业务意义的结果 |
这是设计候选,不是预先成立的优劣排名。是否合并,要在同一批任务、同一调用预算上比较。对于需要灵活探索的场景,较细的工具仍可能更合适。1, §Choosing the right tools for agents
一个实用判断是:这个参数要求模型做业务判断,还是要求它重复一段可以确定编程的机械操作?前者可以由模型处理;后者往往适合留在工具内部。
工具名称和描述,决定了模型最早的分岔
模型调用错误工具,可能还没轮到复杂推理,就已经在名称处走偏。
search 放在一个工具很少的应用里并不奇怪;当系统同时有文档、人员、日志和工单搜索,它就失去了区分力。原文建议按服务或资源进行命名空间划分,同时提醒前缀和后缀的效果会随模型变化,需要实测。1, §Namespacing your tools
例如,本文的日志接口可以叫 billing_search_events。billing 提示服务边界,search_events 说明操作对象。相近的 billing_get_incident_context 则用于读取一个明确事故对象的关联信息。两者的描述应该解释何时检索,何时根据已有标识读取详情。
参数同样需要消歧。user 是姓名、用户名还是数据库 ID?time 是北京时间、UTC,还是服务器本地时间?与其在描述末尾补一句"请正确使用",不如让字段名和结构本身消除歧义。
json
{
  "customer_id": "cus_184",
  "start_time_utc": "2026-09-28T00:00:00Z",
  "end_time_utc": "2026-09-29T00:00:00Z",
  "event_types": ["payment_attempt", "ledger_charge"],
  "limit": 20,
  "response_format": "concise"
}
这是一份示意参数,不是实际调用记录。真正的工具规范还应写清时间区间是否包含边界、事件类型枚举、分页方法以及结果排序。
工具描述可以像一份给新同事的简短使用说明:解释目标、输入要求、返回内容,以及重要的邻近工具差别。别让模型自行补齐人类工程师默认知道的背景。
原文给出过一个很具体的案例:模型在网页搜索查询中不必要地追加年份,导致结果偏向特定时间。团队通过改写工具描述引导它改变行为。这个例子提醒我们,描述里的几句话可能改变数据来源,进而改变最终答案;不能把它当成接口旁边的装饰文字。1, §Analyzing results
返回值要支持下一步,而不是展示后端的一切
工具返回了 200 个字段,不等于给了模型 200 份有效信息。
对于扣款问题,有用的内容是:哪些事件属于同一支付尝试,哪个是请求重试,哪个形成了真实账务记录,证据来自哪里。图片缩略图尺寸、内部 MIME 类型和无关调试字段,通常无法帮助当前判断。
但"优先返回语义信息"也不能写成"删除所有 ID"。如果下一步需要读取某笔交易的明细,模型必须拿到可用的唯一标识。显示名帮助理解,稳定 ID 支持操作,两者承担不同职责。
可以为工具提供 concise 与 detailed 两种返回模式:简洁模式先给任务相关内容,详细模式再补充下游操作和审计所需的字段。原文的 Slack 示例分别为 72 与 206 tokens,说明的是一次示例响应的体积差异,不是所有任务都会节省同样比例,也不是准确率提升幅度。1, §Returning meaningful context from your tools
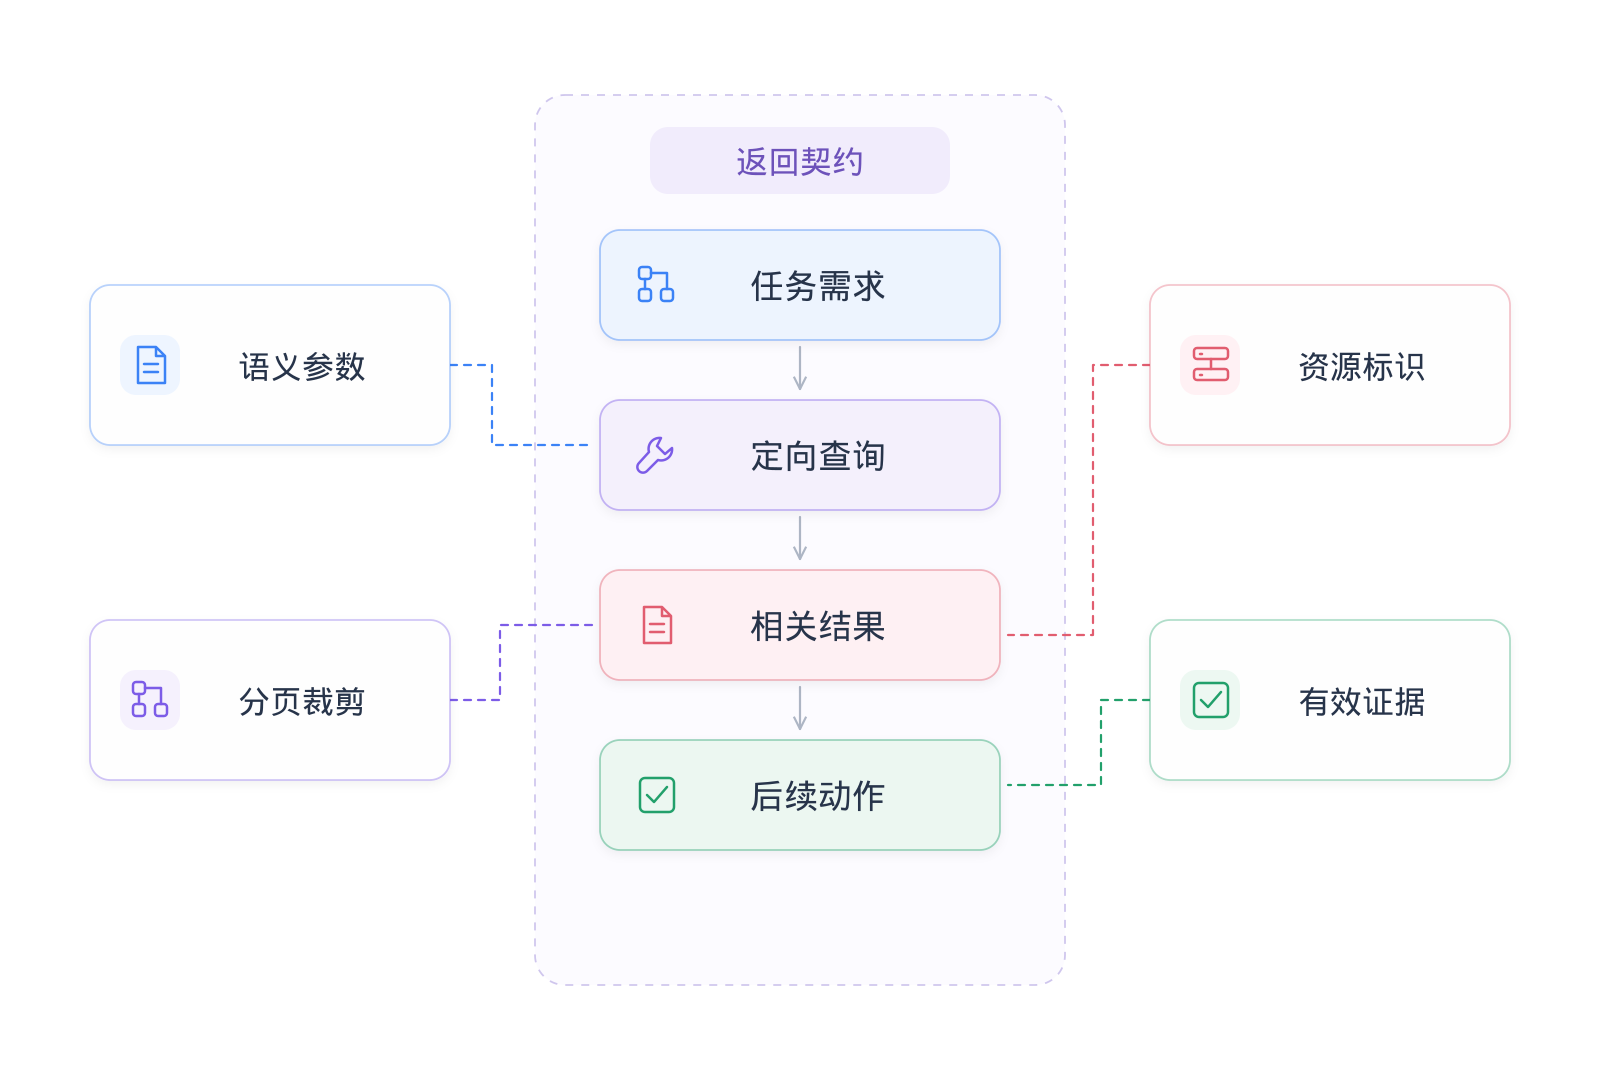
图 2|返回设计的关键关系。语义参数帮助限定查询,分页裁剪控制结果范围,资源标识允许继续读取对象,证据支撑后续判断。图中"相关结果"不能只剩总结:必要的原始依据和可调用标识仍须保留。机制示意原创。
一份面向任务的返回值,可以有这样的结构:
json
{
  "events": [
    {
      "event_id": "evt_701",
      "payment_attempt_id": "pa_82",
      "event_type": "payment_attempt",
      "summary": "同一支付尝试的一次请求重试"
    }
  ],
  "returned_count": 1,
  "has_more": true,
  "next_cursor": "cursor_2"
}
这个例子刻意保留 has_more。如果只显示"找到一条记录",却不告诉模型还有下一页,它可能把局部结果当成全集。裁剪与摘要需要一份清楚的完整性说明。
原文还指出,JSON、XML 或 Markdown 的最佳选择依赖具体模型和任务。结构正确并不保证模型理解正确。应比较实际调用和结果解释,而不是仅凭格式偏好决定。
省 token 时,要保住判断所需的信息
长响应会占用上下文,增加读取成本。原文建议使用分页、范围选择、过滤和截断,并给出合理默认值。1, §Optimizing tool responses for token efficiency
这里更值得优化的是无关信息,而非一味压短。若一个错误日志同时写明失败位置、参数和重试条件,压成"调用失败"虽然节省了 token,却删掉了恢复需要的信息。
同样,工具报错应指向可执行的修正。假设查询超出允许时间范围,可以返回明确错误代码、允许的最大跨度,以及如何分段查询。直接暴露长堆栈,或只说"无效参数",都可能让模型继续盲试。
原文提到 Claude Code 当时默认限制工具响应为 25,000 tokens。这是文章发布时的一项产品设置,不是推荐所有工具都接近这个长度,也不是本文声称当前各版本仍采用同一上限。
对日志任务,一个可以实际检查的约束是:返回信息中有多少条与事故有关?分页有没有遗漏?相关事件是否还能追溯到同一支付尝试?这些检查比单独记录"响应更短了"更有解释力。
用真实任务评测工具,不把标准答案写成固定路线
"搜索包含某字符串的日志"可以测试检索参数,却很难测试模型能否查清事故。较强的任务会保留真实目标,让模型自己选择步骤,再用可核验结果判定是否完成。
例如,本文的扣款任务可以要求输出:真实入账次数、对应交易标识、重试事件数量,以及受影响对象。验证器检查这些结果,不必强制它严格按照某一条工具序列执行。
有些任务存在多条有效路线。如果验证器只接受特定措辞、标点或调用顺序,就会把成功的方法判成失败。反过来,如果只检查回答中有没有"重复扣款"这几个字,也会放过没有证据的结论。
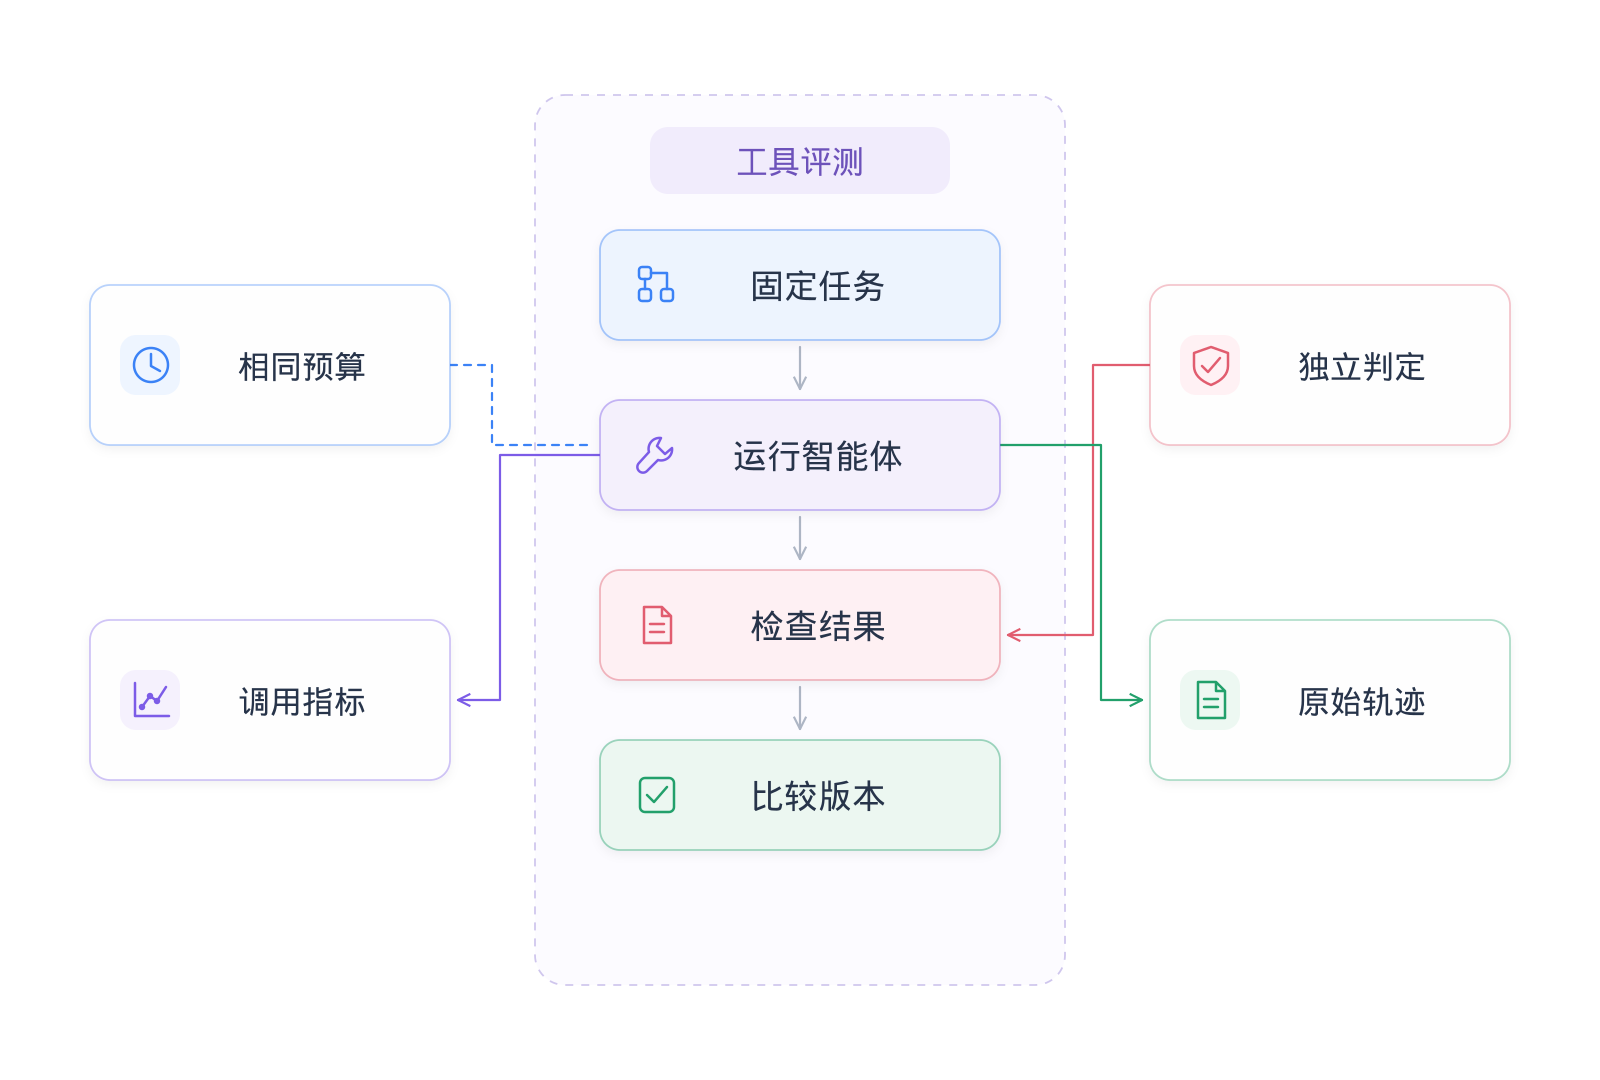
图 3|结果、成本和轨迹需要一起看。先对齐任务与预算,记录实际调用,再用独立判定检查结果;最后比较工具版本。独立判定指评测标准与被测工具的自我描述分开,并不要求每个任务都用另一位 LLM 裁判。依据原文整理。
| 观察项 | 能帮助定位的失败 | 需要避免的误读 |
|---|---|---|
| 可核验的任务完成率 | 工具能否支撑目标 | API 成功返回不等于任务完成 |
| 调用次数与重复调用 | 是否有无效绕路、分页不当 | 调用少也可能是提前放弃 |
| 参数错误与工具错误 | 定义、例子和约束是否清楚 | 不把外部服务故障都归给模型 |
| 输入输出 token | 返回信息是否挤占上下文 | 短响应也可能删掉关键证据 |
| 任务总时间与调用时间 | 等待、串行依赖、慢查询 | 单次调用快不等于任务完成快 |
| 原始调用与返回记录 | 模型忽略了什么,误读了什么 | 模型自己的总结可能漏掉关键错误 |
最后一项尤其有用。模型会给出"工具设计得很好"的反馈,却在真实调用里反复用错一个字段。你应先看它执行了什么,再看它如何解释执行过程。原文也强调,模型遗漏的行为有时比主动报告的意见更能暴露问题。
官方工具评测 Cookbook 提供了按任务运行智能体、记录调用时间并汇总结果的示例。它适合帮助搭建评测骨架;具体的结果验证仍需要根据业务目标设计。2
让智能体改工具,也要给它开发集之外的题目
模型可以阅读失败轨迹,提出更清楚的描述、调整参数名、合并常用查询,并检查不同工具之间的定义是否一致。Anthropic 把这种合作用于内部 Slack、Asana 等工具的迭代,并用留出任务检查效果。1, §Collaborating with agents
真正值得复制的是这个实验顺序:用开发任务发现问题,修改工具,重新运行;再在未参与修改的任务上确认是否仍有收益。若每一轮都把测试答案交给优化工具的模型,后面的分数就失去了留出验证的意义。
对于开头的支付事故,先修复一个可观察的问题就足够具体:把支付重试与账务入账在工具返回中明确分开,然后检查模型还会不会混淆。接着再判断,是否需要聚合关联信息、调整分页或重写说明。
一套好工具应该让正确的信息更容易获得,让业务对象更容易辨认,让下一步动作更容易选对。检查这三件事时,最有说服力的材料是一条真实完成任务的调用轨迹。
参考资料
- Ken Aizawa. Writing effective tools for agents --- with agents. Anthropic,2025-09-11。原文。已核对工作流、五项设计原则、示例与评测建议。原文内部评测图没有提供完整公开样本、代码与误差分析,本文未补造图上的精确收益数字。
- Anthropic. Tool evaluation. 官方 Cookbook。核对任务运行、调用计时与结果汇总部分;网页代码可能更新,资料核对日期为 2026-10-03。本文没有运行其 API 示例。