项目描述:一人多宠的全生命周期管理(出生 → 饲养投喂 → 疫苗 → 就医 → 繁殖 → 死亡),图片/信息/数据实时存储与展示
前端:Vue 3后端:Spring Cloud Alibaba + MySQL + Redis + Kafka
AI工具链:Memory / SubAgents / Skills / Commands / Hooks / MCP / Headless / Rules / Agent SDK / Plugins
一、总体架构
1、系统架构图
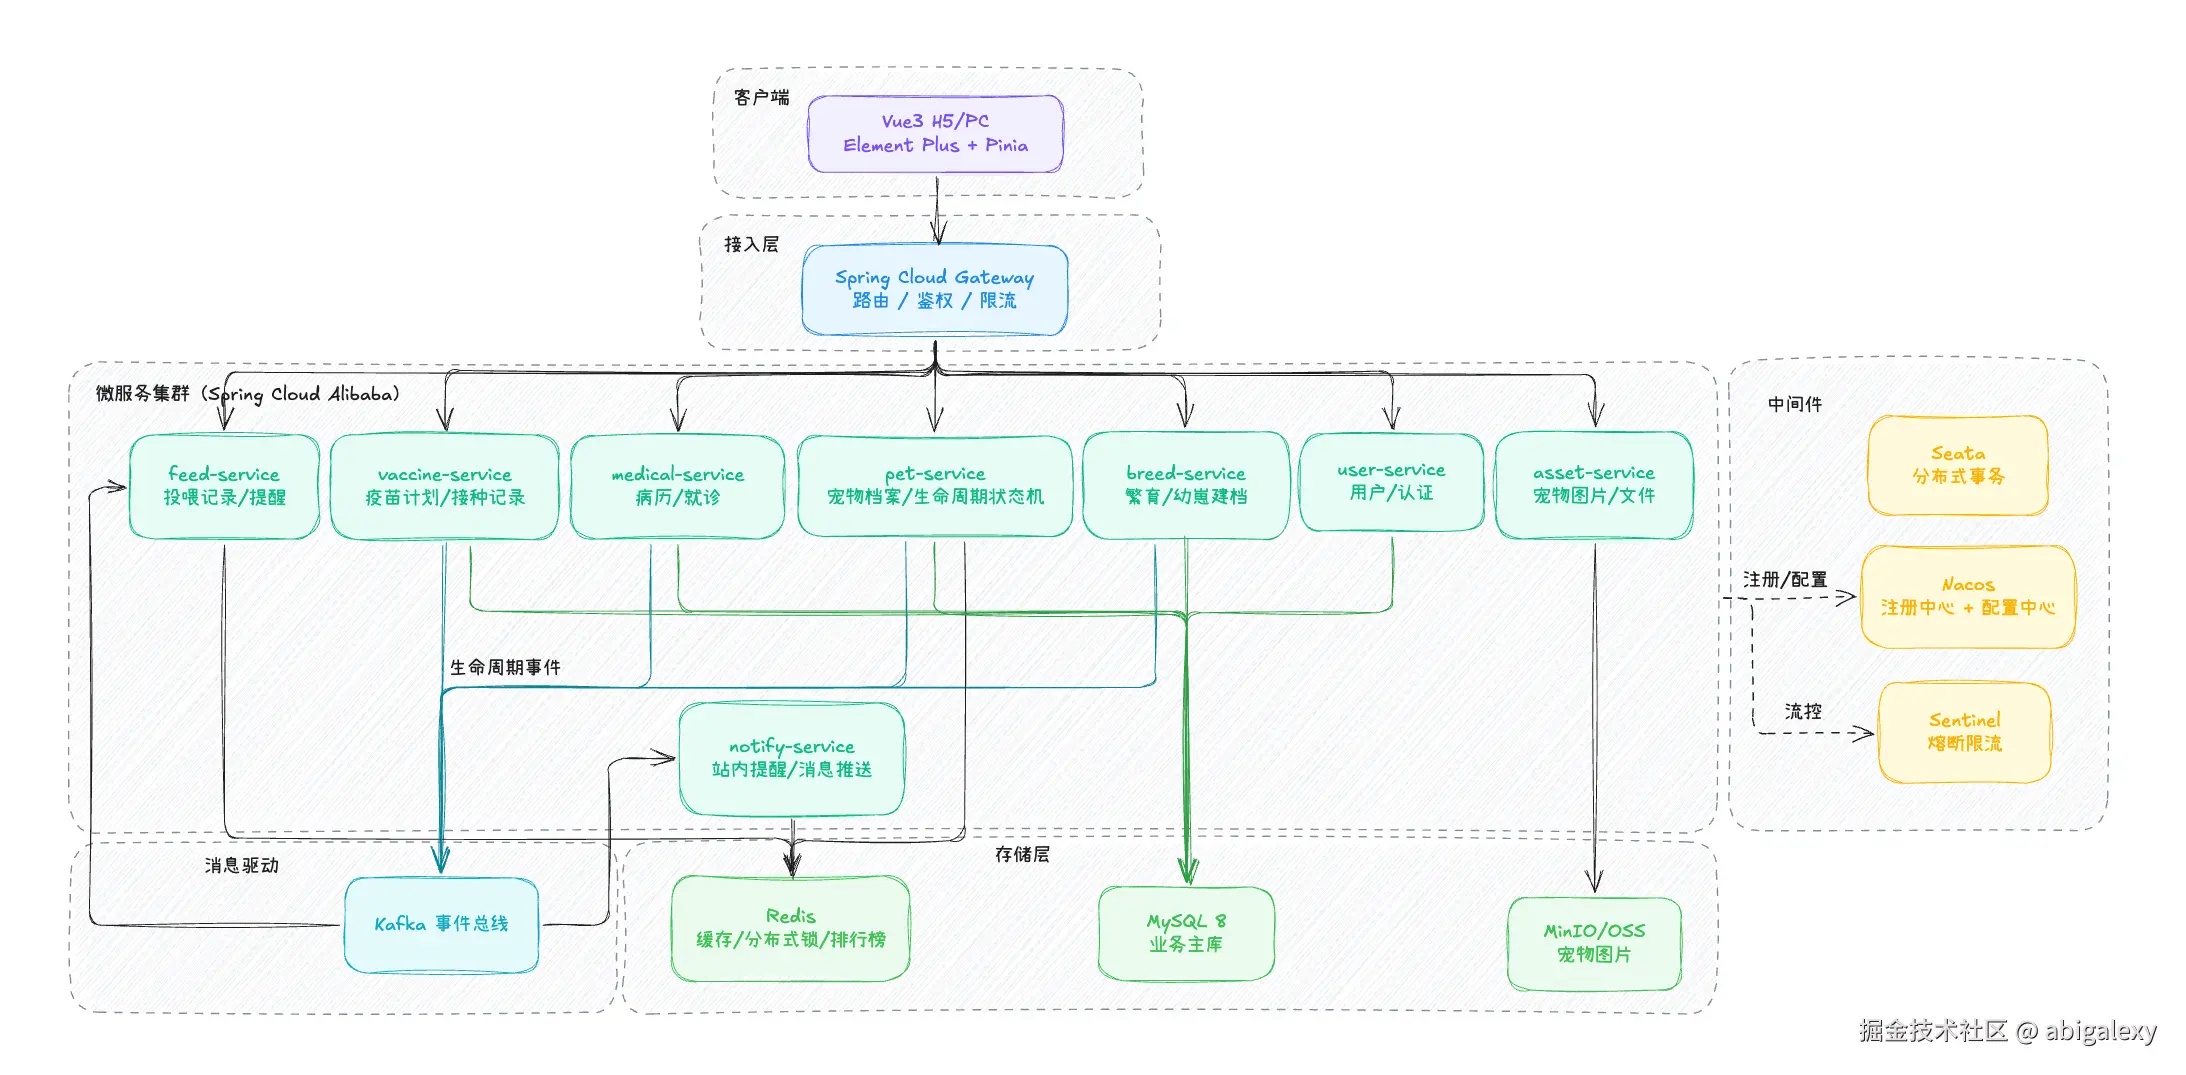
2、核心领域模型:宠物生命周期状态机
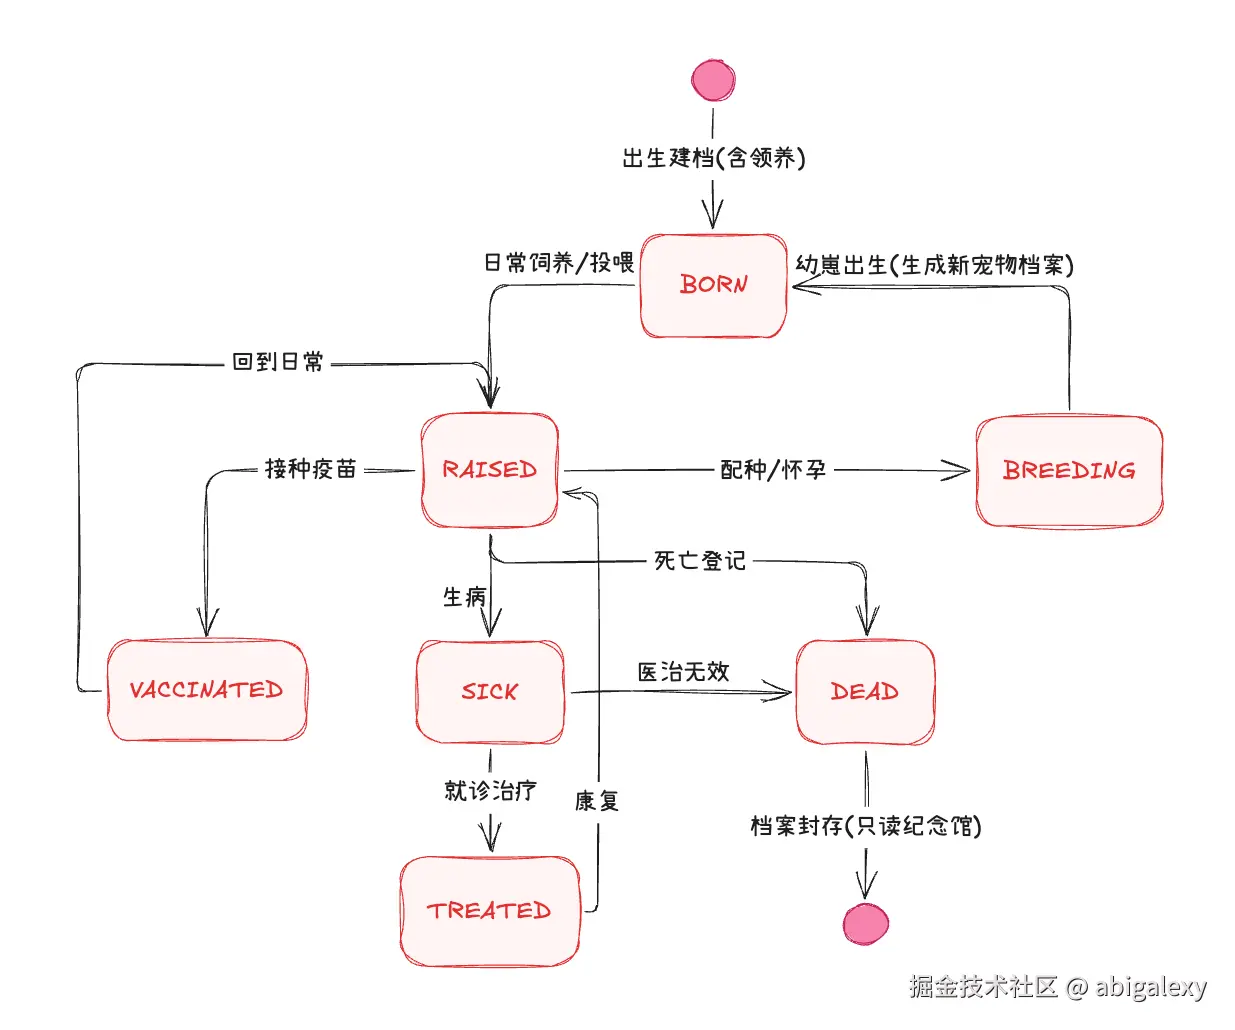
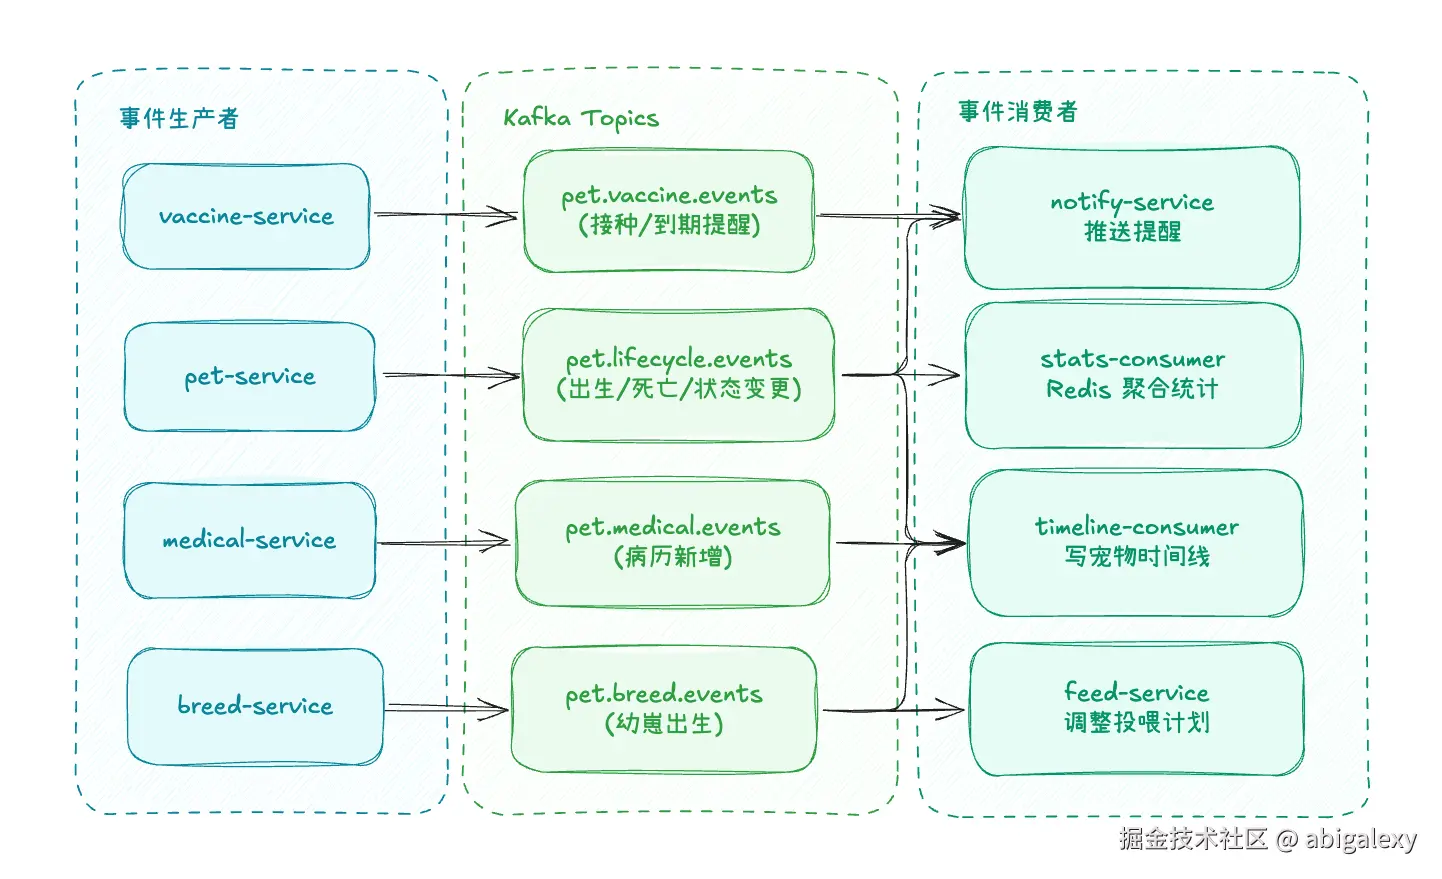
pet-service 持有状态机,每次状态跃迁都向Kafka投递一条领域事件,其他服务(提醒、时间线、统计)全部事件驱动,杜绝服务间网状RPC。
3、Kafka事件流设计
二、Claude Code十大能力 → 项目落地映射
| 能力 | 本质 | 在本项目中的具体用途 |
|---|---|---|
| Memory | CLAUDE.md项目记忆 |
固化架构约定、命名规范、状态机定义,让AI每次开工"秒懂项目" |
| Rules | 权限与规则 | 限制AI只能改自己负责的模块;禁止直连生产库;危险命令需确认 |
| Skills | 领域知识包 | 沉淀Vue3开发规范、SCA 微服务模板、宠物领域术语表 |
| Commands | 团队标准命令 | /new-service、/gen-api、/review、/changelog 等一键标准化操作 |
| MCP | 连接外部系统 | 直连MySQL看表结构、连Kafka看消息、连Git/CI触发流水线 |
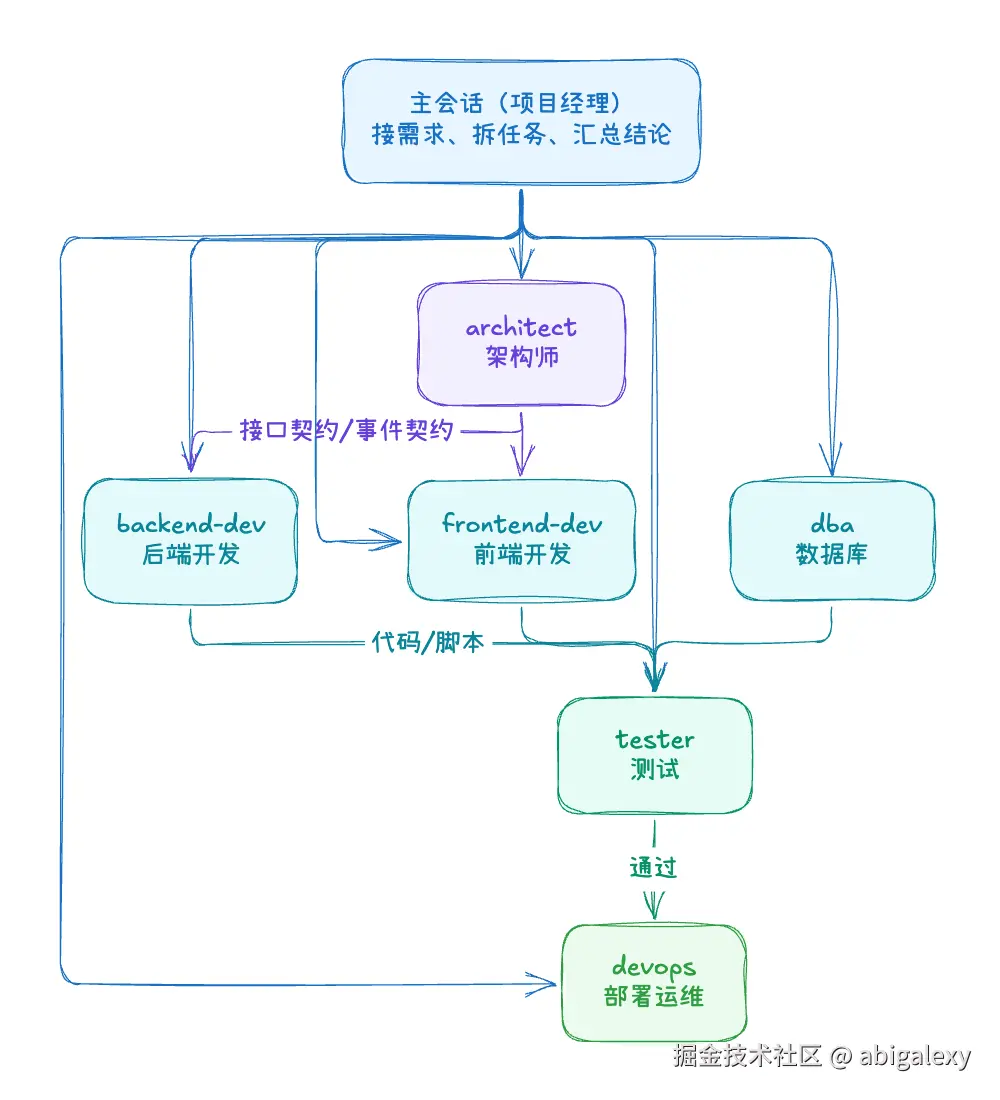
| SubAgents | 分而治之 | 架构师/后端/前端/DBA/测试/DevOps六个子代理并行协作 |
| Hooks | 自动化行为 | 保存文件自动lint/format;提交前自动跑单测;改SQL自动备份 |
| Headless | 无人值守运行 | CI中claude -p自动Code Review、自动生成接口文档 |
| Agent SDK | 代码驱动AI | 写Python/TS脚本批量生成CRUD、批量补单测、自动迁移老代码 |
| Plugins | 打包分发 | 把上面全部产物打成团队插件,新人plugin install即配好全部环境 |
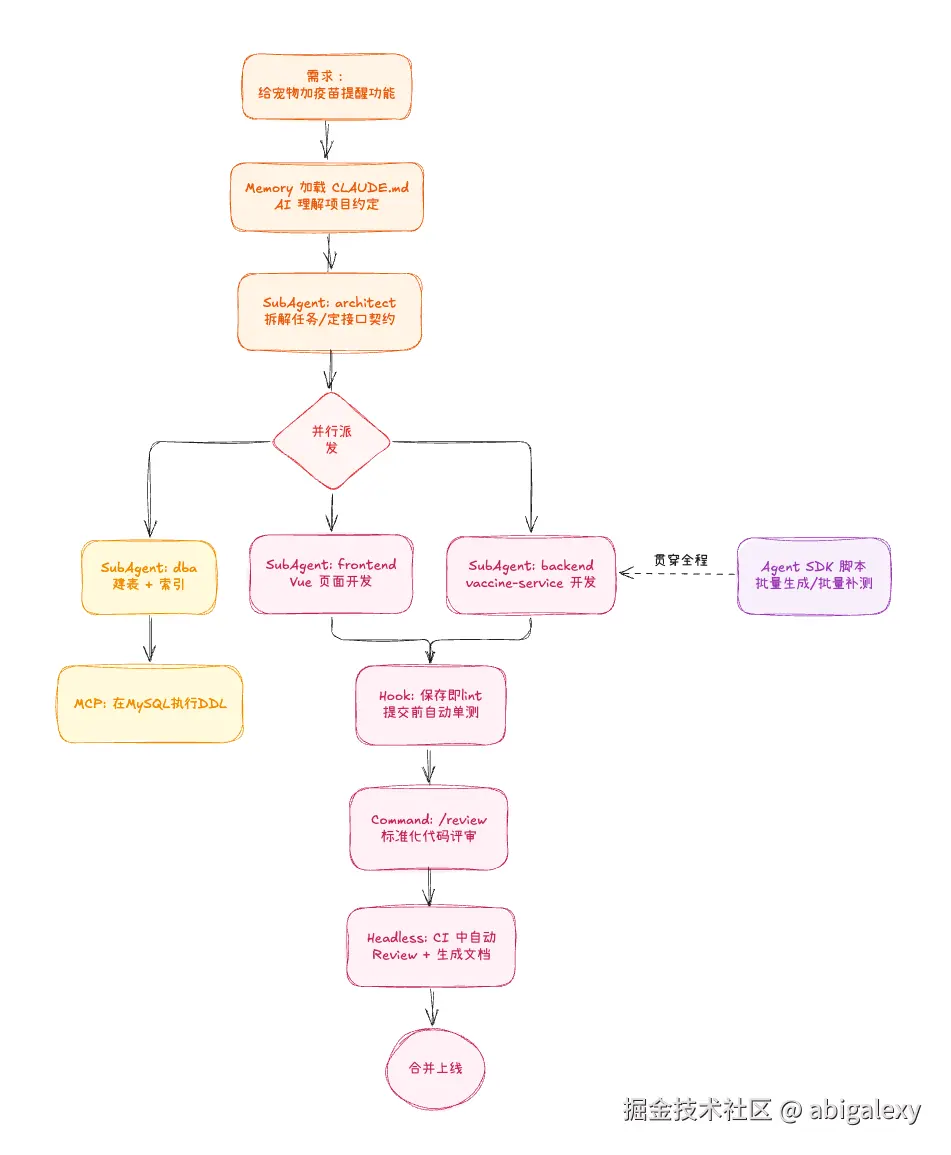
1、AI协作总流程图
2、第0步:项目骨架与环境准备
2.1 Monorepo目录结构
javascript
pet-life-platform/
├── CLAUDE.md                    # ★ Memory:项目记忆(第1步详解)
├── .claude/
│   ├── settings.json            # ★ Rules:权限规则
│   ├── agents/                  # ★ SubAgents 定义
│   │   ├── architect.md
│   │   ├── backend-dev.md
│   │   ├── frontend-dev.md
│   │   ├── dba.md
│   │   ├── tester.md
│   │   └── devops.md
│   ├── commands/                # ★ Commands 团队命令
│   │   ├── new-service.md
│   │   ├── gen-api.md
│   │   ├── review.md
│   │   └── changelog.md
│   ├── skills/                  # ★ Skills 领域知识
│   │   ├── vue3-standard/SKILL.md
│   │   ├── sca-microservice/SKILL.md
│   │   └── pet-domain/SKILL.md
│   └── hooks/                   # ★ Hooks 钩子脚本
│       ├── on-save-lint.sh
│       └── pre-commit-test.sh
├── pet-server/                  # 后端
│   ├── pet-gateway/
│   ├── pet-common/              # 通用:结果封装/异常/状态机枚举
│   ├── user-service/
│   ├── pet-service/
│   ├── feed-service/
│   ├── vaccine-service/
│   ├── medical-service/
│   ├── breed-service/
│   ├── asset-service/
│   └── notify-service/
├── pet-web/                     # Vue3 前端
│   ├── src/api/  src/stores/  src/views/  src/components/
└── deploy/                      # docker-compose / k8s / CI 配置
2.2 本地中间件一键起(docker-compose)
yaml
# deploy/docker-compose.yml(节选)
services:
  mysql:    { image: mysql:8.0, ports: ["3306:3306"], environment: { MYSQL_ROOT_PASSWORD: root } }
  redis:    { image: redis:7, ports: ["6379:6379"] }
  kafka:    { image: bitnami/kafka:3.7, ports: ["9092:9092"] }
  nacos:    { image: nacos/nacos-server:v2.3.2, ports: ["8848:8848"], environment: { MODE: standalone } }
  minio:    { image: minio/minio, ports: ["9000:9000"], command: server /data }
这一步也可以交给AI:描述需求 → Claude Code生成全部compose配置与初始化SQL
3、第1步:Memory-让AI永久"理解项目"
CLAUDE.md放在仓库根目录,Claude Code每次会话自动加载。这是所有AI协作的地基-没有它,AI每次都要重新猜你的约定。
markdown
# CLAUDE.md(节选示例)

## 项目概述
宠物全生命周期管理平台。一个用户可养多只宠物,覆盖:
出生→投喂→疫苗→就医→繁育→死亡 全链路,事件驱动架构。

## 技术栈硬性约定
- 后端:JDK 17 + Spring Boot 3.2 + Spring Cloud Alibaba 2023.x
- 注册/配置中心:Nacos;流控:Sentinel;分布式事务:Seata
- 存储:MySQL 8(InnoDB, utf8mb4)、Redis 7、Kafka 3.7、MinIO
- 前端:Vue 3 + Vite + TypeScript + Pinia + Element Plus + Axios
- ORM:MyBatis-Plus,禁止手写XML单表CRUD

## 分层与命名规范
- 每个微服务固定分层:controller / service / mapper / entity / dto / event
- 表名:`pl_` 前缀(pet-life),如 pl_pet、pl_vaccine_record
- 接口路径:`/api/{服务名}/v1/...`,统一返回Result<T>
- Kafka topic:`pet.{域}.events`,消息体为CloudEvent JSON
- 生命周期状态枚举:BORN/RAISED/VACCINATED/SICK/TREATED/BREEDING/DEAD
  (定义在pet-common的PetLifecycleEnum,任何状态变更必须走状态机服务)

## 核心领域规则(AI不可违背)
1. 宠物状态变更只能由pet-service的状态机完成,其他服务发事件申请
2. 死亡后档案转只读(纪念馆),所有写接口必须校验状态
3. 幼崽出生 = breed-service 发事件 → pet-service 自动建新档案并绑定parentId
4. 图片统一走asset-service上传MinIO,业务表只存fileKey
5. 所有跨服务一致性用Kafka最终一致,禁止跨库事务

## 常用命令
- 后端启动:cd pet-server && mvn spring-boot:run -pl pet-service
- 前端启动:cd pet-web && pnpm dev
- 单测:mvn test -pl {module} / pnpm test:unit
Memory维护策略:架构决策(ADR)、踩坑记录、接口契约变更,全部让AI在完成任务后自动追加进 CLAUDE.md-记忆随项目一起生长。
4、第2步:Rules-规则与权限边界
.claude/settings.json 控制AI能做什么、不能做什么:
json
{
  "permissions": {
    "allow": [
      "Bash(mvn *)", "Bash(pnpm *)", "Bash(docker compose *)",
      "Bash(git add *)", "Bash(git commit *)",
      "Edit(pet-server/**)", "Edit(pet-web/**)", "Edit(deploy/**)"
    ],
    "deny": [
      "Bash(rm -rf *)",
      "Bash(git push --force *)",
      "Bash(mysql -h prod*)",
      "Edit(**/application-prod.yml)",
      "Edit(pet-server/pet-common/**)"
    ],
    "ask": [
      "Bash(git push *)",
      "Bash(kubectl *)"
    ]
  }
}
要点:
pet-common(状态机枚举所在)禁止AI直接改-领域核心必须人工评审;
生产配置、生产数据库连接一律deny;
推送远端、操作k8s需人工确认(ask)。
5、第3步:Skills-注入领域知识
Skills是可复用的知识包,AI进入对应任务时自动加载。本项目建3个:
5.1 pet-domain(宠物领域知识)
markdown
# SKILL.md要点
- 术语表:绝育/免疫程序/驱虫周期/妊娠期(猫63天/犬58-68天)...
- 业务规则:
  · 幼宠首次免疫6-8周龄,之后每3-4周一针至16周龄
  · 狂犬疫苗每年加强
  · 投喂量按体重系数计算:成猫每日热量 ≈ 体重kg^0.75 × 70
- 数据字典:物种/品种枚举、常见病枚举、疫苗种类枚举
AI写疫苗计划算法、投喂推荐逻辑时,不用你反复解释业务。
5.2 sca-microservice(Spring Cloud Alibaba模板)
markdown
# SKILL.md要点
- 新服务标准骨架(pom依赖清单:nacos-discovery/nacos-config/sentinel/openfeign)
- Feign调用规范:fallback必写、超时3s、统一TraceId透传
- Kafka生产者/消费者模板:acks=all、幂等生产者、消费端手动提交+重试3次进死信
- Redis缓存规范:cache-aside,key = pet:{biz}:{id},空值缓存60s防穿透
- 统一异常码:10000用户域 / 20000宠物域 / 30000医疗域...
5.3 vue3-standard(前端规范)
markdown
# SKILL.md要点
- 组件:组合式API + <script setup lang="ts">,单文件 ≤ 300 行
- 状态:Pinia store按域划分(usePetStore / useVaccineStore...)
- API层:src/api/*.ts,每个文件对应一个微服务,Axios拦截器统一处理Result<T>
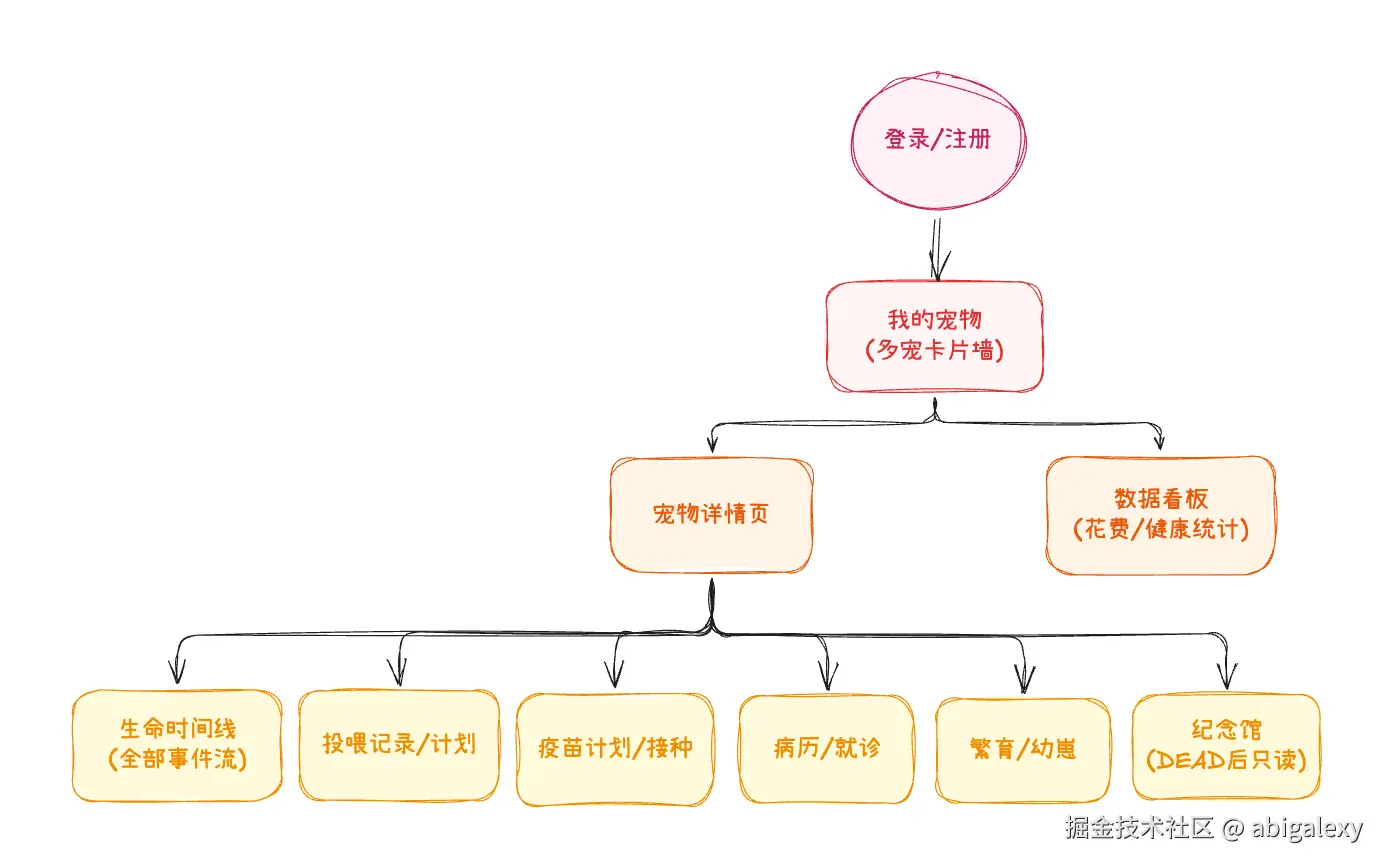
- 页面规范:列表页 = 查询表单 + Table + 分页;详情页 = 时间线组件
- 图片上传:先调asset-service拿预签名URL,直传MinIO
6、第4步:Commands-把团队标准做成斜杠命令
放在.claude/commands/,团队所有人输入同样的命令得到同样标准的产出:
| 命令 | 文件 | 作用 |
|---|---|---|
/new-service 服务名域 |
new-service.md |
按sca-microservice技能脚手架生成新微服务(pom/启动类/Nacos配置/健康检查) |
/gen-api 实体名 |
gen-api.md |
生成Entity→Mapper→Service→Controller→Vue API文件→列表页的全链路CRUD |
/review |
review.md |
按团队checklist评审当前改动:规范/安全/事务边界/Kafka幂等 |
/changelog |
changelog.md |
读取git log,生成按服务分组的变更日志 |
/add-event 事件名 |
add-event.md |
标准化新增Kafka领域事件:事件类→生产者→消费者→文档 |
gen-api.md 示例(命令本质是一段带参数的提示词模板):
markdown
---
description: 生成全链路CRUD
argument-hint: <实体名> <所属服务>
---

请按以下步骤为实体 $ARGUMENTS 生成全链路代码:
1. 阅读 CLAUDE.md 的命名规范与 sca-microservice 技能
2. 生成 pl_$1 表的建表 SQL(含逻辑删除、create_time/update_time)
3. 生成 Entity / Mapper / Service(+Impl) / Controller,统一 Result<T> 返回
4. 在 pet-web/src/api/ 生成对应 TS API 文件
5. 生成 Vue 列表页 + 新增/编辑对话框
6. 为 Service 生成 JUnit5 + Mockito 单测,覆盖率 ≥ 70%
7. 完成后把新接口追加到 CLAUDE.md 的接口清单
7、第5步:MCP-连接万物
通过MCP Server让AI直接操作项目依赖的外部系统:
json
// .mcp.json
{
  "mcpServers": {
    "mysql": {
      "command": "npx", "args": ["-y", "@modelcontextprotocol/server-mysql"],
      "env": { "MYSQL_HOST": "localhost", "MYSQL_DB": "pet_life" }
    },
    "kafka": {
      "command": "npx", "args": ["-y", "mcp-server-kafka"],
      "env": { "KAFKA_BROKERS": "localhost:9092" }
    },
    "redis": {
      "command": "npx", "args": ["-y", "mcp-server-redis"],
      "env": { "REDIS_URL": "redis://localhost:6379" }
    },
    "github": {
      "command": "npx", "args": ["-y", "@modelcontextprotocol/server-github"],
      "env": { "GITHUB_TOKEN": "${GH_TOKEN}" }
    }
  }
}
MCP打通后AI获得的真实能力:
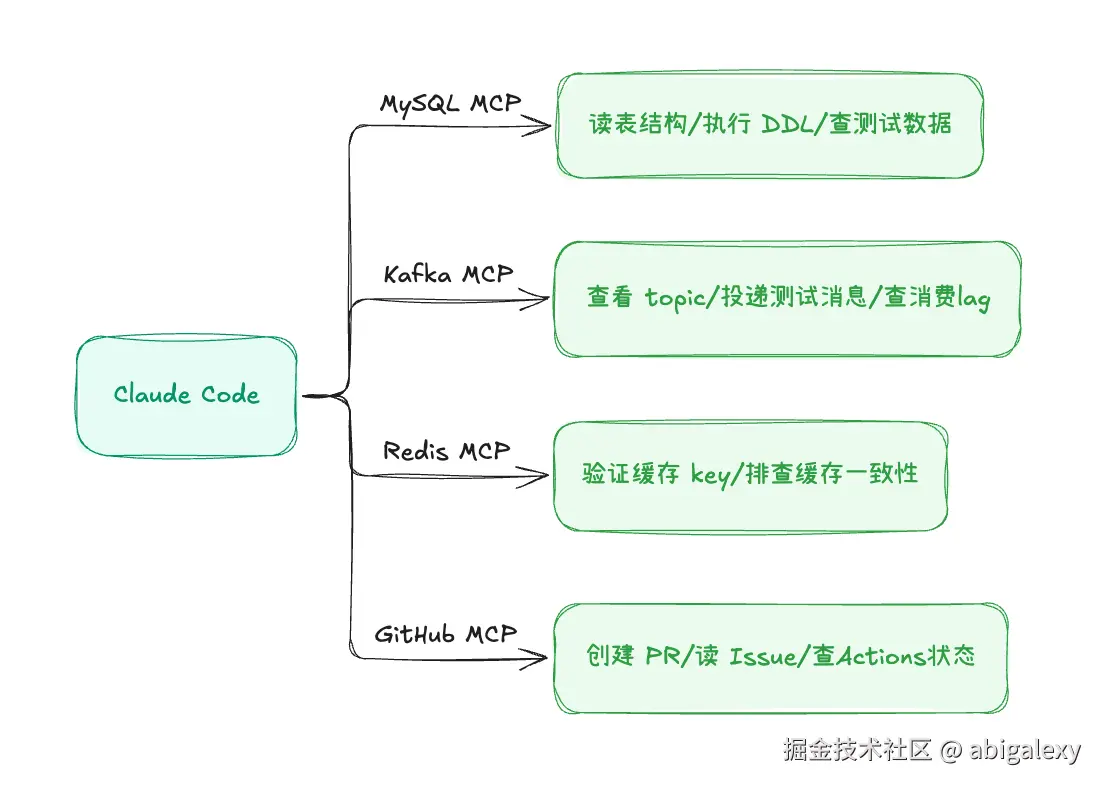
典型场景:
联调疫苗提醒:让AI向 pet.vaccine.events 投一条「7天后到期」的测试消息,再查notify-service是否正确消费、Redis提醒队列是否写入------全程无需你手动开 kafka-console-producer;
排查线上疑似问题(测试环境):AI直接查MySQL慢查询、查Redis key分布、查Kafka积压,给出定位报告。
8、第6步:SubAgents-分而治之的团队
在.claude/agents/ 定义子代理,主对话作为"项目经理"派发任务。每个子代理有独立上下文窗口 + 限定工具 + 专属系统提示。
8.1 子代理分工图
8.2 子代理定义示例
markdown
# .claude/agents/backend-dev.md
---
name: backend-dev
description: 后端微服务开发专家,处理Spring Cloud Alibaba相关编码任务
tools: Read, Write, Edit, Bash, Grep
---

你是宠物生命周期平台的后端开发专家。规则:
1. 开工前必读CLAUDE.md与sca-microservice技能
2. 只修改你被指派的服务目录
3. 状态变更一律走pet-service状态机,你只发Kafka事件
4. 每个Service方法必须有单测
5. 完成后输出:改动文件清单 + 自测结果 + 遗留风险
markdown
# .claude/agents/dba.md
---
name: dba
description: 数据库设计与变更,负责DDL、索引优化、慢查询分析
tools: Read, Bash, mcp__mysql__*
---

1. 所有DDL必须是幂等的(IF NOT EXISTS)并写入 deploy/migrations/
2. 建表规范:pl_ 前缀、逻辑删除字段、乐观锁version字段
3. 给出每个新表的索引设计与预估数据量说明
8.3 并行实战示例
javascript
你:实现"宠物生病就医"完整功能
主会话自动编排:
 ├─ Task(architect): 设计病历模型 + pet.medical.events 事件契约
 ├─ Task(dba):       并行 → 建pl_medical_record / pl_prescription表
 ├─ Task(backend-dev): 契约确定后 → medical-service全部接口
 ├─ Task(frontend-dev): 契约确定后 → 就诊记录页 + 时间线组件
 └─ Task(tester):    代码就绪后 → 集成测试 + Kafka事件验证
关键收益:每个子代理上下文独立,互不污染,前端代理不用读后端代码,主会话只接收各代理的精炼总结,长项目不"失忆"。
9、第7步:Hooks-自动化行为
Hooks在AI工作流的特定时机自动触发,把"每次都要提醒AI做的事"变成"必然发生的事":
json
// .claude/settings.json(hooks部分)
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": ".claude/hooks/on-save-lint.sh $FILE" }
        ]
      }
    ],
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          { "type": "command", "command": ".claude/hooks/block-dangerous.sh" }
        ]
      }
    ],
    "Stop": [
      {
        "hooks": [
          { "type": "command", "command": ".claude/hooks/session-summary.sh" }
        ]
      }
    ]
  }
}
bash
# .claude/hooks/on-save-lint.sh  AI每改一个文件,立即校验
case "$1" in
  *.java) mvn -q spotless:check -pl $(dirname $1 | cut -d/ -f1-2) ;;
  *.vue|*.ts) pnpm --dir pet-web eslint --fix "$1" ;;
  *.sql)  sqlfluff lint "$1" ;;
esac
项目里推荐的5个Hook:
1)保存即格式化:Java走Spotless,前端走ESLint+Prettier,AI产出永远是规范代码;
2)提交前单测:git commit前自动 mvn test -pl 改动模块,红了就拦住;
3)SQL变更备份:AI写 .sql 文件时自动复制到 deploy/migrations/日期/并编号;
4)危险命令拦截:PreToolUse扫描Bash命令,命中 drop/truncate/flushall直接拒绝;
5)会话结束摘要:Stop钩子自动生成"本次会话改了什么"并追加到开发日志。
10、第8步:Headless-CI中无人值守运行
claude -p(非交互模式)让AI成为流水线的一环:
yaml
# .github/workflows/ai-review.yml

name: AI Code Review & Docs
on: [pull_request]
jobs:
  ai-review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: AI评审PR
        run: |
          claude -p "评审本次PR改动:
            1) 是否符合CLAUDE.md规范
            2) 状态机/事件使用是否正确
            3) 有无SQL注入/越权风险
            4) Kafka消费是否幂等
            按 /review 标准输出结论:APPROVE 或 REQUEST_CHANGES + 明细" \
            --output-format json > review.json
      - name: 回写评审意见到PR
        uses: actions/github-script@v7
        with:
          script: |
            const r = require('./review.json');
            github.rest.pulls.createReview({ ...context.repo,
              pull_number: context.issue.number,
              body: r.result, event: 'COMMENT' });
      - name: AI自动生成接口文档
        run: claude -p "扫描 pet-server 所有 @RestController,更新 docs/api.md"
其他Headless用法:
每晚定时:claude -p "分析今天的Kafka死信队列内容并生成日报";
发布前:claude -p "对比main与release分支,生成发布说明与回滚预案";
依赖升级后:claude -p "运行全部测试,逐个修复失败用例"。
11、第9步:Agent SDK-代码驱动批量AI任务
交互式对话适合"一个功能",批量、循环、编排型任务用Agent SDK写脚本驱动:
python
# scripts/batch_gen_tests.py    批量为存量Service补单测
from claude_agent_sdk import ClaudeSDKClient, ClaudeAgentOptions
import asyncio, pathlib

options = ClaudeAgentOptions(
    system_prompt="你是后端测试专家,遵循CLAUDE.md与sca-microservice技能。",
    allowed_tools=["Read", "Write", "Bash"],
    permission_mode="acceptEdits",
)

async def gen_test(service_file: str):
    async with ClaudeSDKClient(options=options) as client:
        await client.query(
            f"为 {service_file} 生成JUnit5单测,覆盖率≥70%,"
            f"运行mvn test验证,失败自行修复,最多重试3轮。"
        )
        async for msg in client.receive_response():
            print(msg)

async def main():
    services = list(pathlib.Path("pet-server").rglob("*ServiceImpl.java"))
    for s in services:                      # 也可 asyncio.gather 并发
        await gen_test(str(s))

asyncio.run(main())
典型场景:
批量生成:9个微服务×CRUD,循环调用,每个服务一个独立agent会话;
批量迁移:JDK8→17、javax→jakarta改造,逐模块跑编译-修复循环;
质量门禁:遍历所有Kafka消费者,检查幂等处理,输出合规报告;
数据脚本:生成十万条宠物/投喂测试数据的SQL,按表依赖顺序执行。
12、第10步:Plugins-打包分发给整个团队
把前9步沉淀的一切(agents/commands/skills/hooks/MCP 配置)打成一个插件,新人一行命令获得全套装配:
javascript
pet-life-plugin/
├── .claude-plugin/plugin.json     #插件清单
├── agents/      # 6 个子代理
├── commands/    # /new-service /gen-api /review ...
├── skills/      # pet-domain / sca-microservice / vue3-standard
├── hooks/       # lint / 单测 / SQL备份
├── .mcp.json    # MySQL/Kafka/Redis MCP配置模板
└── CLAUDE.md    # 项目记忆模板
json
// plugin.json
{
  "name": "pet-life-devkit",
  "version": "1.0.0",
  "description": "宠物生命周期平台AI开发套件",
  "author": "平台架构组"
}
发布到团队插件市场(私有git仓库即可)后:
bash
# 新人入职第一天
claude plugin marketplace add git@gitlab.team:devkits.git
claude plugin install pet-life-devkit
# → 规范、子代理、命令、钩子、MCP 连接 全部就位
三、业务实现关键设计(AI按此施工)
1、数据库核心表
sql
CREATE TABLE pl_pet (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  user_id BIGINT NOT NULL COMMENT '主人',
  name VARCHAR(64) NOT NULL,
  species VARCHAR(32) NOT NULL COMMENT '物种: cat/dog/...',
  breed VARCHAR(64),
  gender TINYINT,
  birthday DATE,
  avatar_key VARCHAR(128) COMMENT '头像 fileKey → MinIO',
  status VARCHAR(16) NOT NULL DEFAULT 'BORN' COMMENT '生命周期状态机',
  parent_id BIGINT COMMENT '繁育场景: 父亲/母亲档案',
  death_time DATETIME, death_reason VARCHAR(255),
  version INT NOT NULL DEFAULT 0,
  deleted TINYINT NOT NULL DEFAULT 0,
  create_time DATETIME DEFAULT CURRENT_TIMESTAMP,
  update_time DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
  KEY idx_user (user_id, status)
);

-- 配套:pl_feed_record / pl_vaccine_plan / pl_vaccine_record /
--      pl_medical_record / pl_breed_record / pl_pet_timeline(事件流水)
2、Redis设计
| Key模式 | 类型 | 用途 |
|---|---|---|
pet:detail:{id} |
String(JSON) | 宠物档案缓存,状态变更时主动失效 |
pet:list:{userId} |
ZSet | 用户宠物列表,score=更新时间 |
vaccine:due:{date} |
ZSet | 疫苗到期提醒队列(Kafka事件写入) |
feed:remind:{petId} |
String+TTL | 投喂提醒防抖 |
lock:pet:status:{id} |
String | 状态机变更分布式锁 |
3、前端页面地图(Vue3)
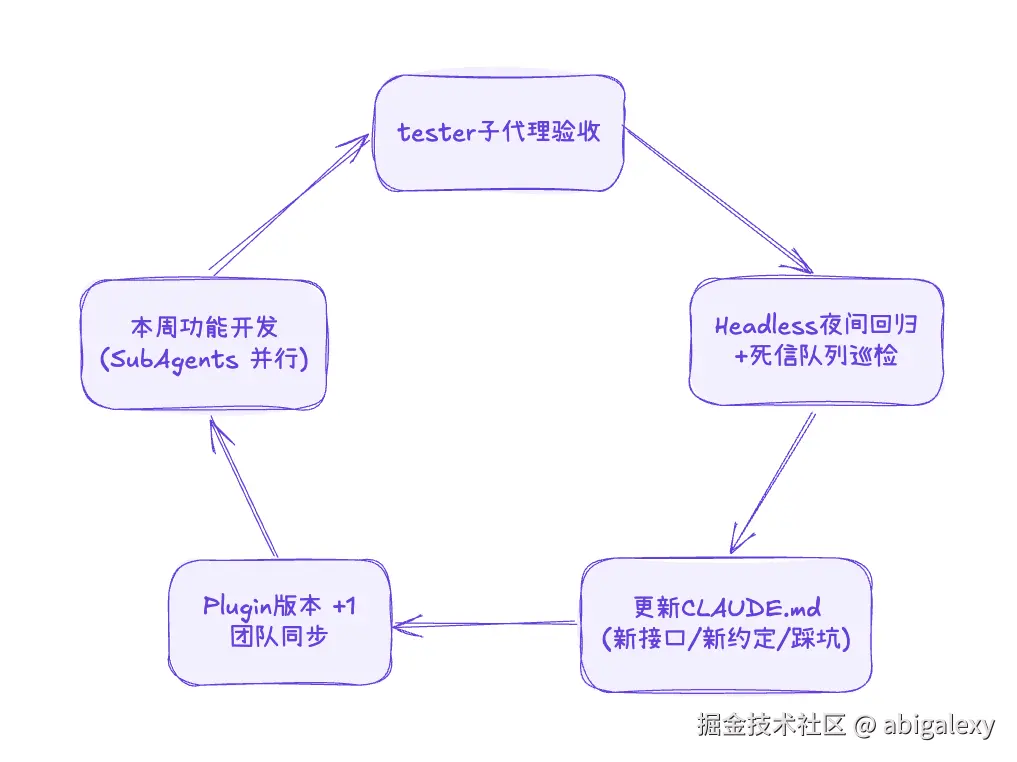
四、全步骤路线图(8周参考节奏)
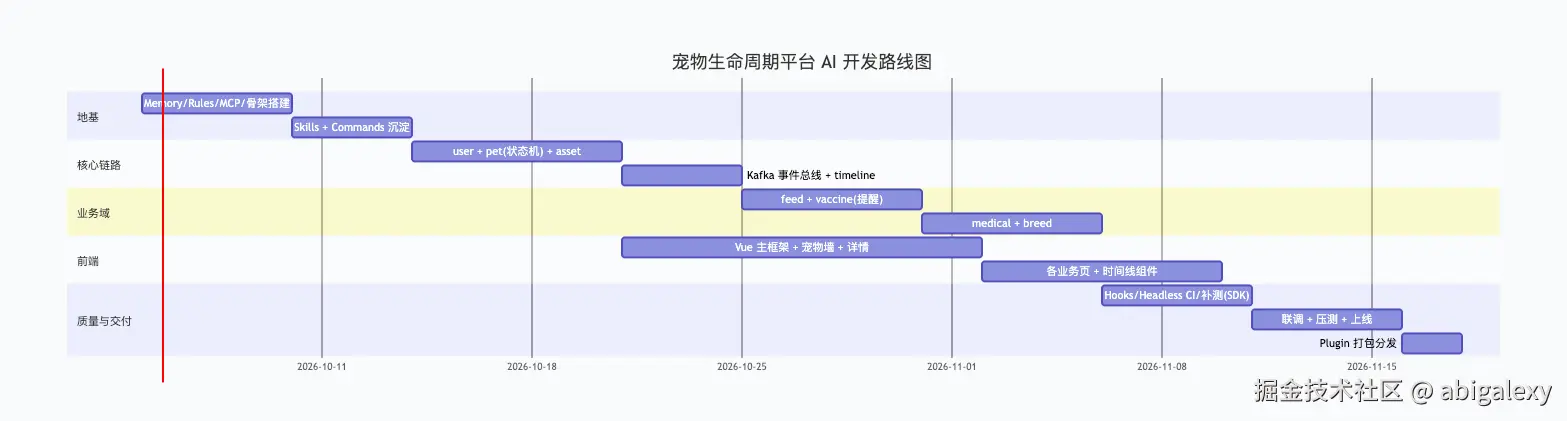
每周末的固定闭环:
五、一张图总结:一个需求的完整AI闭环
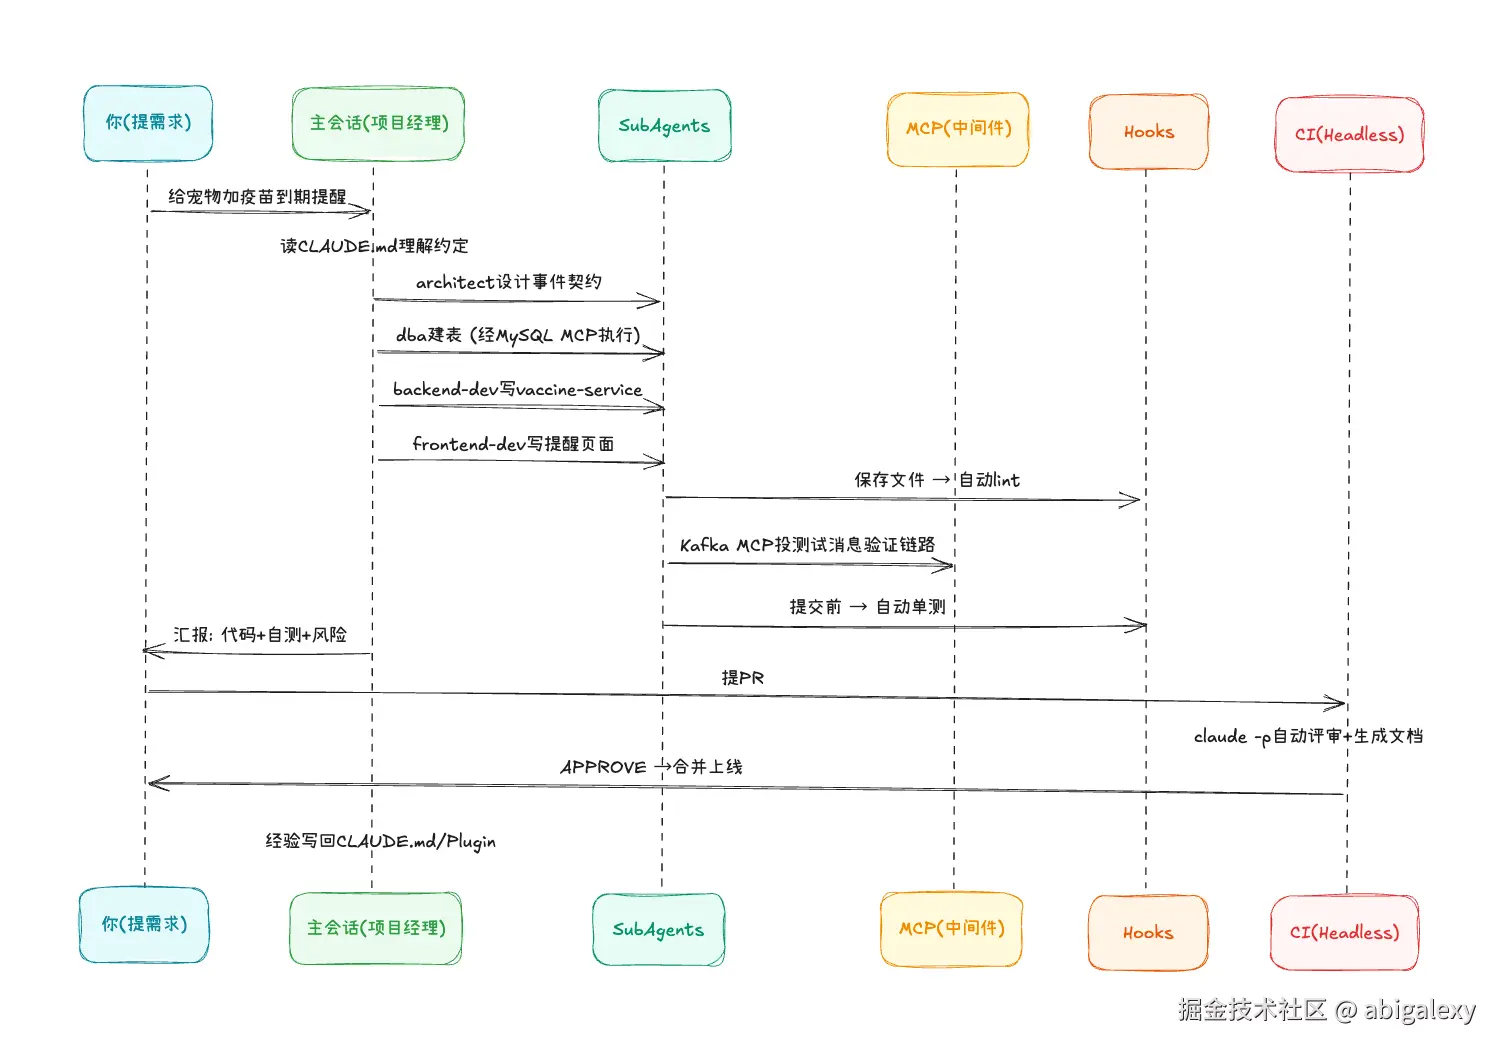
实施要点:
1、先Memory后一切:CLAUDE.md写不好,后面所有环节质量都打折;
2、状态机是项目的"宪法":放进pet-common并在Rules里禁止AI擅改;
3、事件驱动先行:先把Kafka topic契约定死,各服务才能放心并行开发;
4、子代理宁多勿滥:按"上下文需要隔离"来拆,不是按职位拆;
5、Hook管必然,Command管标准,Skill管知识-三者别混用;
6、SDK只干批量的活,单功能用对话更快;
7、每周升级Plugin版本,让团队所有人的AI同步进化
六、团队人员配置方案(AI×人工协作最大化)
1、核心原则:AI放大器模型
传统同类项目需要10~14人;引入Claude Code全家桶后,推荐6人核心团队即可在同等周期内交付。原则:
1)人做决策,AI做执行:架构、契约、验收标准由人定,编码、单测、文档由AI做;
2)1人驾驶N个Agent:每个工程师同时带2~4个SubAgent并行作业;
3)质量闸门全在人手:状态机、事件契约、上线决策必须人工评审;
4)团队越小越好:AI放大产能后,沟通成本成为唯一瓶颈,6人是甜点区间。
2、人机分工全景图
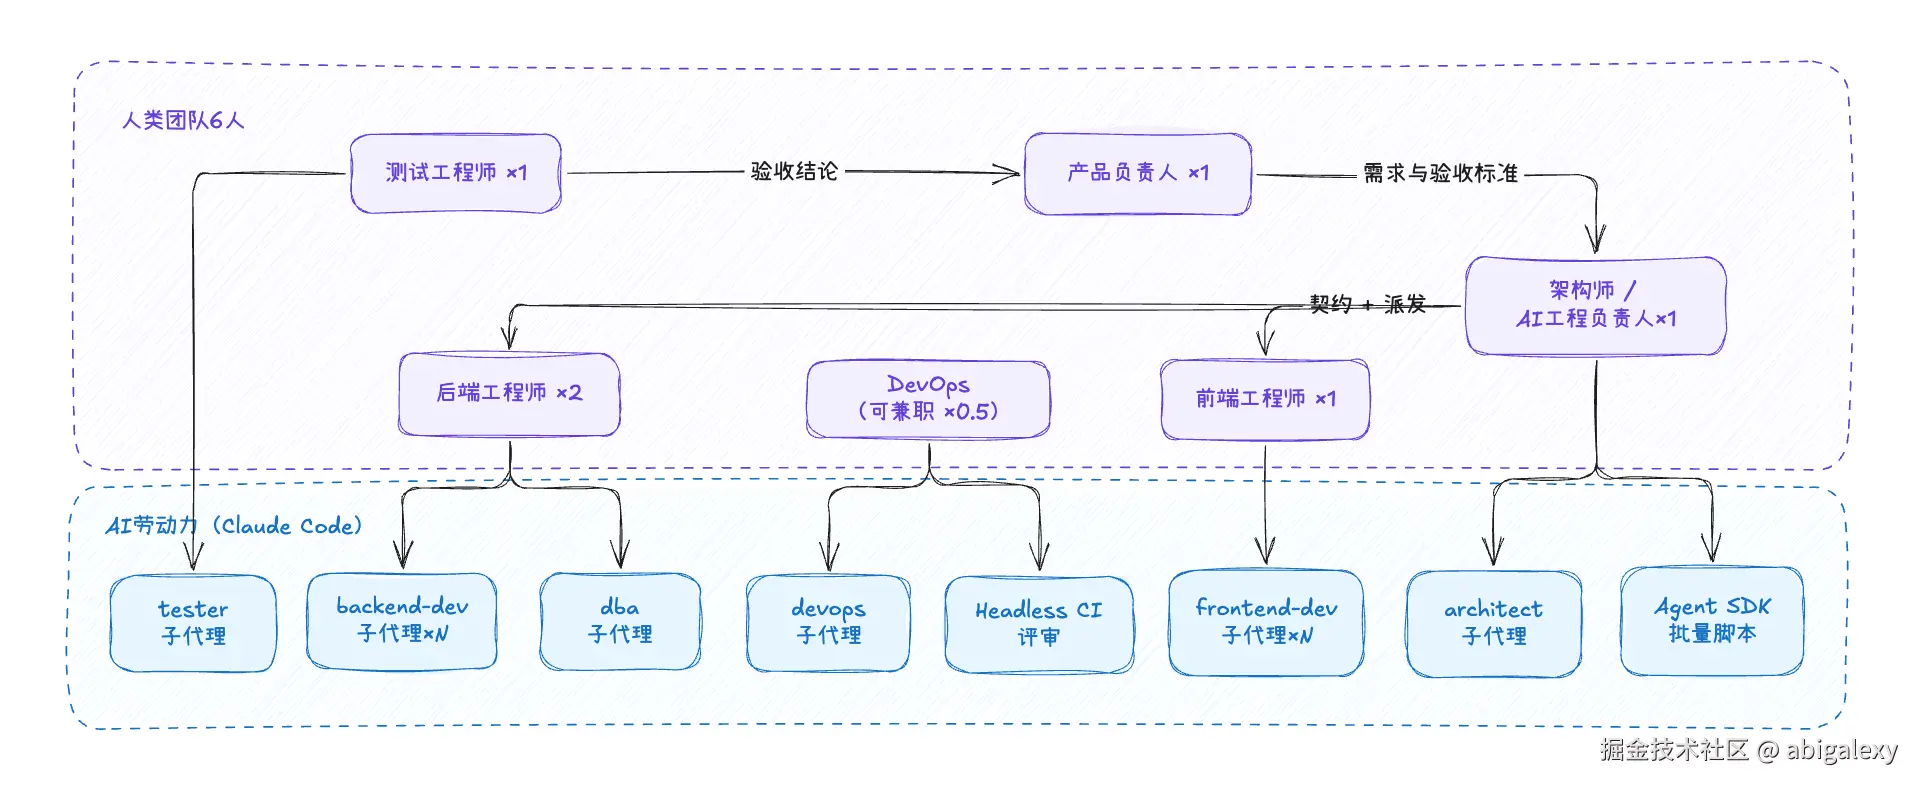
3、岗位明细(推荐配置:5.5~6人)
| 岗位 | 人数 | 核心职责 | 驾驭的AI能力 |
|---|---|---|---|
| 产品负责人(PO/PM) | 1 | 需求拆解与优先级;宠物业务规则把关(疫苗周期、繁殖逻辑等);验收每个功能;管理backlog | 用 /changelog、Headless日报了解进度 |
| 架构师/AI工程负责人 | 1 | 系统架构与状态机设计;Kafka事件契约;维护CLAUDE.md、Rules、Skills、Commands、Plugin;评审所有跨服务改动;写Agent SDK批量脚本 | Memory/Rules/Skills/Commands/Plugins/Agent SDK/architect子代理 |
| 后端工程师 | 2 | 各自认领3~4个微服务;评审并修正AI生成的代码;处理复杂业务(状态机、分布式事务);联调 | backend-dev / dba子代理、MySQL·Kafka·Redis MCP、Hooks |
| 前端工程师 | 1 | Vue3全部页面;组件库建设;交互细节与体验把关;评审AI生成页面的可维护性 | frontend-dev子代理、vue3-standard技能、Hooks |
| 测试工程师(QA) | 1 | 编写验收标准(先于开发);E2E测试设计;验证AI生成单测的有效性(防止"为了过测而写测");性能/并发测试 | tester子代理、Headless夜间回归、Agent SDK批量补测 |
| DevOps | 0.5~1 | docker-compose/k8s环境;CI/CD流水线;监控告警;MCP连接维护;Headless流水线建设 | Headless/Hooks/GitHub MCP/devops子代理 |
兼职补充:UI设计师0.5人(可外包,出设计稿后前端+AI还原);宠物领域顾问(非全职,评审pet-domain技能的业务规则正确性)。
4、三种规模配置对比
| 维度 | 精简版3人 | 推荐版6人 | 完整版9人 |
|---|---|---|---|
| 人员构成 | 全栈×1 + 后端×1 + 产品兼QA×1 | 见 17.3 | +后端×1、+前端×1、+专职DevOps×1 |
| 适用场景 | MVP/验证期 | 正式商业化交付 | 多产品线并行/有合规要求 |
| 交付周期(本文档范围) | 12~14周 | 8周 | 6~7周 |
| 风险 | 单点故障高,评审深度不足 | 平衡最佳 | 沟通成本上升,AI利用率反而下降 |
5、人机协作责任(RACI)
| 工作项 | 人负责(A/R) | AI负责 | 质量闸门 |
|---|---|---|---|
| 需求与业务规则 | PO | 整理成文档/技能 | PO验收 |
| 架构/状态机/事件契约 | 架构师 | 出方案草稿、画架构图 | 架构评审会 |
| 微服务CRUD代码 | 后端工程师(评审) | 生成~80% | /review + Hooks单测 |
| 前端页面 | 前端工程师(评审) | 生成~70% | ESLint Hook+人工走查 |
| 建表DDL/索引 | 后端工程师(确认) | dba子代理生成并执行 | 架构师复核索引 |
| 单元测试 | QA(抽查有效性) | 生成+自修复 | 覆盖率≥70%+QA抽查 |
| E2E/性能测试 | QA | 生成脚本初稿 | QA全权负责结论 |
| CI/CD/环境 | DevOps | 生成配置、Headless评审 | 人工确认上线 |
| 文档/变更日志 | 架构师(审) | Headless自动生成 | 随PR评审 |
| CLAUDE.md/Skills/Plugin | 架构师(唯一owner) | 按指令更新内容 | 周会同步 |
6、产出配比估算
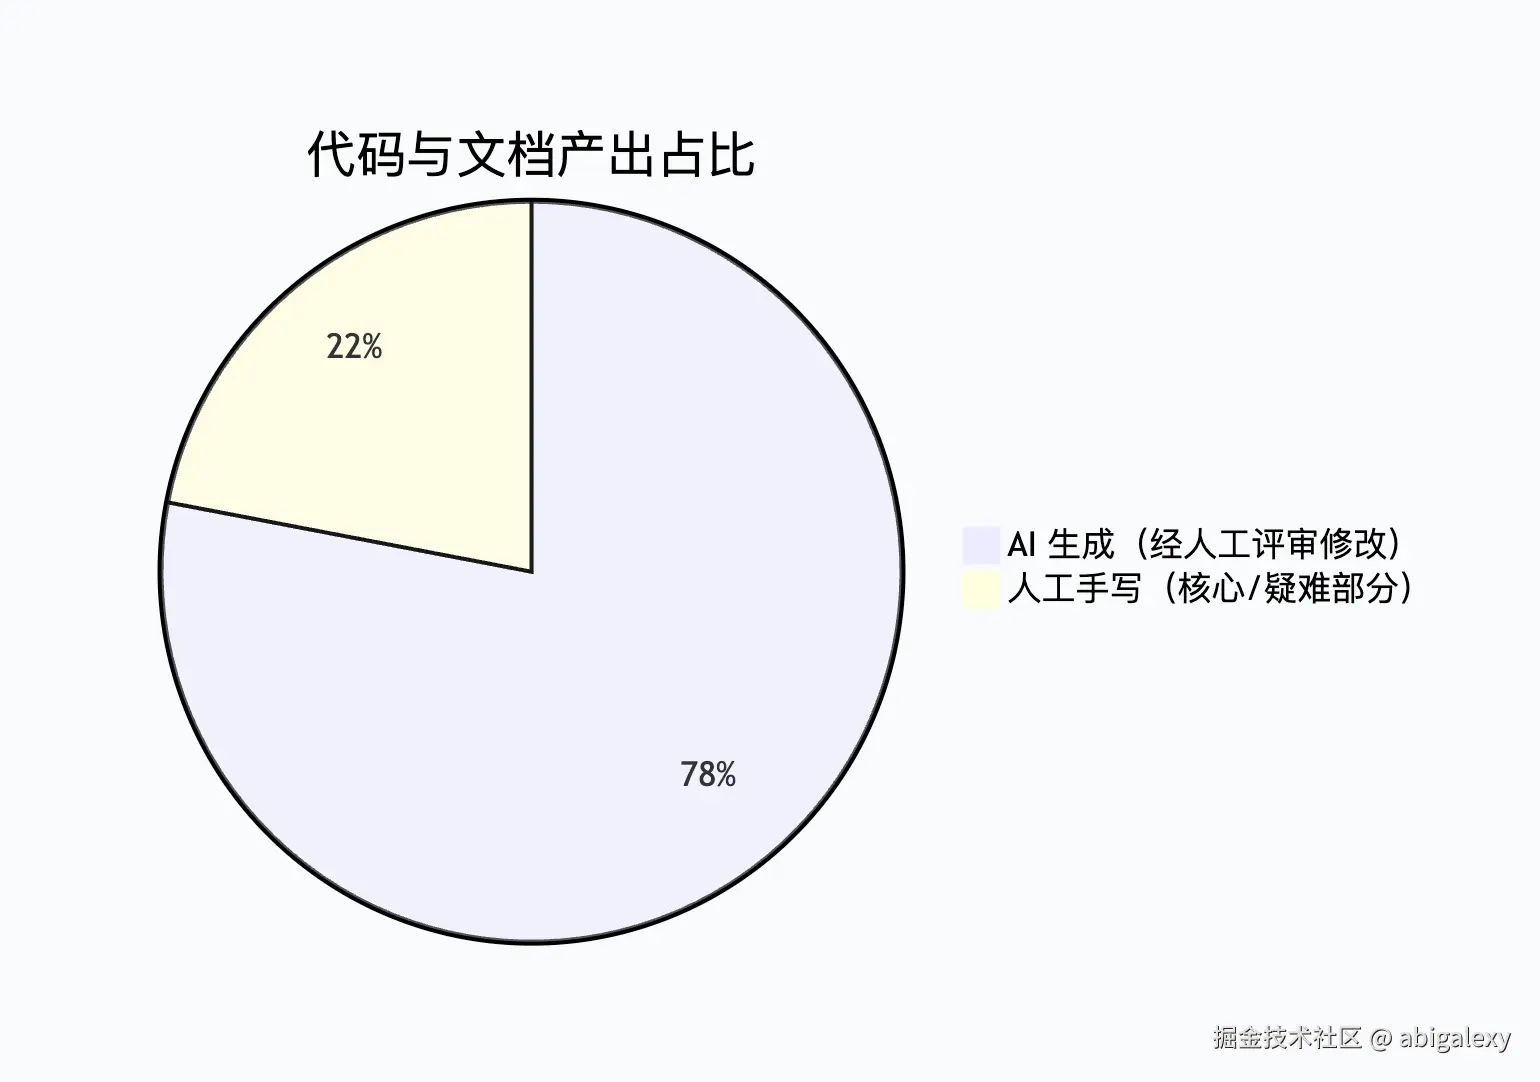
AI主产:CRUD全链路、单测、DTO/Entity、前端标准页面、SQL、文档-约75~80%;
人工主产:状态机核心逻辑、事件契约、复杂查询与事务、性能调优、线上排障-约20~25%,但这部分是项目的命脉。
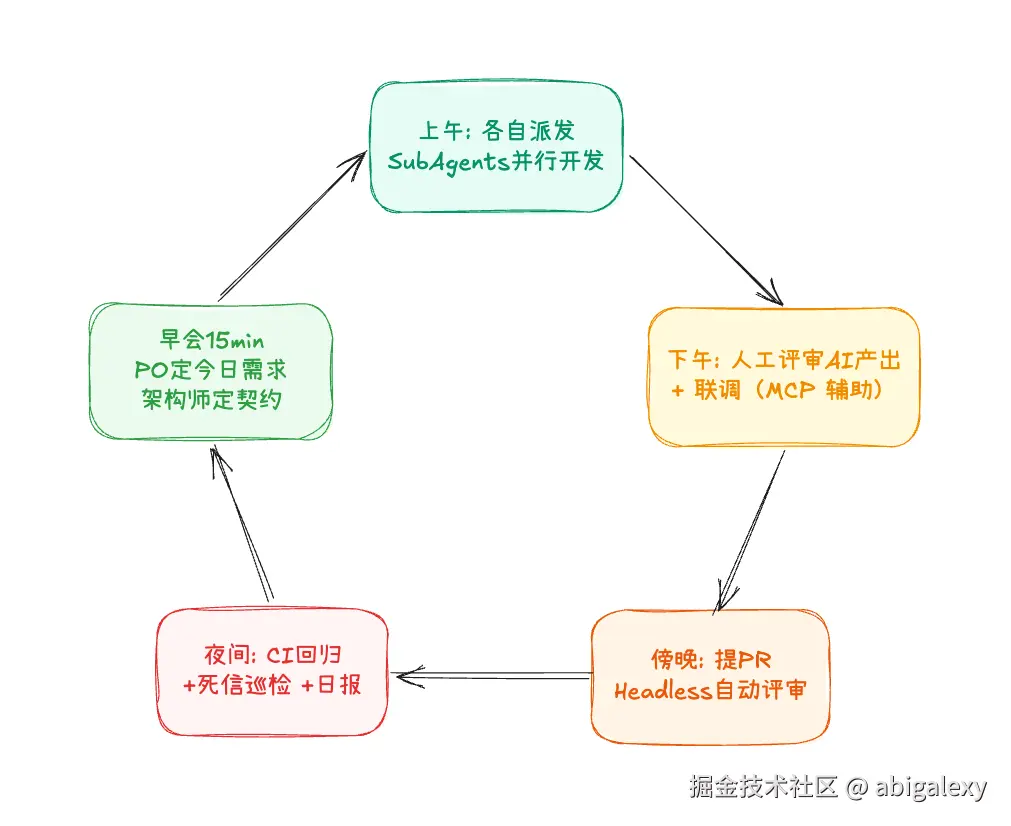
7、每日协作
8、关键因素
1)架构师是最关键岗位-他维护的CLAUDE.md/Skills/Plugin质量,直接决定6个人+N个Agent的整体产出质量,宁可用最贵的人;
2)QA必须独立且前置-AI时代的测试风险是"AI写的代码由AI写的测试来验证",验收标准必须由QA独立编写、先于开发;
3)每人驾驶Agent数≤4-超过则评审深度不够,AI产出质量塌方;
4)所有AI产出必须过人工评审-Rules里 git push 设为ask,从机制上保证没有未评审代码进主干;
5)每周Plugin版本升级-团队6人的AI配置保持同步,避免"你的AI和我的AI规范不一致"。