《Agentic Design Patterns》第 1 章导读:提示词链(Prompt Chaining)
本文是对开源书籍《Agentic Design Patterns》第 1 章的解读与导读,内容忠实呈现原文,后续引入个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
大型语言模型(LLM)非常强大,但当它需要在一个"整体化"的提示词里同时解决多个问题时,往往会力不从心。标注过高、指令被忽略、上下文丢失、错误放大------这些都是单体提示词的常见毛病。提示词链(Prompt Chaining) ,又叫管道模式(Pipeline pattern),正是用来解决这类问题的思路:把复杂任务拆成一系列更小、更聚焦、顺序执行的子步骤,前一步的输出作为后一步的输入,环环相扣,逐步逼近最终答案。
这是《Agentic Design Patterns》开篇介绍的第一个模式,也是构建复杂 AI 智能体体系的地基。本文将带你理解它到底解决了什么、怎么用、以及它的边界。
一、为什么要用提示词链:单体提示词的困境
面对多维度的复杂任务,单独用一个复杂提示词通常效率很低。LLM 会表现出典型的"过载"症状:
- 指令忽略:部分提示内容被无视;
- 上下文偏离:模型逐渐丢失对初始目标的追踪;
- 错误传播:前期的错误在后期的推理中被放大;
- 上下文窗口不足:模型拿到的信息不足以生成可靠响应;
- 幻觉:认知负荷过高,导致编造不实信息。
书中举了个很形象的例子:要求模型"分析一份市场研究报告、总结发现、识别趋势、并起草一封邮件"。这个请求包含太多环节,模型可能总结做得不错,但提取数据或起草邮件就出差错了。
提示词链的核心思想是"分而治之",把这样的复杂问题拆成独立、聚焦、顺序推进的小步骤。以上面的例子为例,可以拆成三步:
- 总结:"总结以下市场研究报告的主要发现:文本"------模型的唯一焦点就是总结;
- 趋势识别:"基于这份摘要,识别前三个新兴趋势并给出支撑数据:上一步输出"------这一步建立在已验证的基础上,约束更强;
- 写邮件:"给营销团队起草一封简明邮件,概述这些趋势及其数据:上一步输出"。
环节拆细之后,每一步的认知负荷都下降了,也就更容易得到准确、可靠的结果。这种模块化有点像计算流水线------每个函数只干一件事,然后把结果往下传。
二、链的可靠性:关键在"结构化输出"
提示词链的可靠性高度依赖步骤间传递的数据是否"干净"。如果前一步的输出含糊不清、格式混乱,后一步很可能因为它拿到的是坏输入而失败。
书中的建议是:在步骤之间指定结构化输出格式(如 JSON、XML)。比如趋势识别这一步的输出可以定义成 JSON 对象:
json
{
  "trends": [
    {
      "trend_name": "AI-Powered Personalization",
      "supporting_data": "73% of consumers prefer to do business with brands that use personal information to make their shopping experiences more relevant."
    },
    {
      "trend_name": "Sustainable and Ethical Brands",
      "supporting_data": "Sales of products with ESG-related claims grew 28% over the last five years, compared to 20% for products without."
    }
  ]
}
结构化格式保证数据是机器可读、可精确解析的,能无歧义地拼进下一个提示词,最大程度避免自然语言解释带来的误差。这是构建健壮多步 LLM 系统的关键组件。
三、提示词链的典型应用场景
书中枚举了 7 个实际用例,我整理成一张速览表:
| 应用场景 | 大致步骤 | 典型价值 |
|---|---|---|
| 信息处理工作流 | 提取文本 → 总结 → 抽取实体 → 查知识库 → 生成报告 | 自动化内容分析、研究助手 |
| 复杂查询问答 | 拆解子问题 → 分项检索 → 综合答案 | 多步推理、跨来源信息集成 |
| 数据提取与转换 | 抽取字段 → 校验 → 条件性补全 → 规范化 | 处理发票、表单、OCR 结果 |
| 内容生成工作流 | 构思 → 大纲 → 分段起草 → 修订 | 创意写作、技术文档自动生成 |
| 带状态的对话智能体 | 识别意图与实体 → 更新状态 → 生成响应 | 多轮对话上下文维护 |
| 代码生成与完善 | 伪代码 → 草稿 → 审查 → 重写 → 加文档/测试 | AI 辅助软件开发 |
| 多模态多步推理 | 提取图内文本 → 链接标签 → 结合表格推断 | 图片+表格+文本的联合分析 |
其中一个值得注意的洞见是:复杂操作常把"并行 + 链式"混着用。比如一个自动化研究智能体,初期从多篇文章里提取关键信息时适合用并行处理;但一旦进入整合、综合成草稿、审查完善的阶段,就必须是链条式的------每一步都依赖前一步的结果,这正是提示词链大显身手的地方。
另外,提示词链还允许在两次 LLM 调用之间插入确定性逻辑,比如中间数据处理、输出校验、条件分支,甚至把精确的算术运算委托给外部计算器工具(LLM 做精确数学计算很吃力)。这种"文本处理 + 外部工具"的链式组合,能拿到单靠一次 LLM 查询很难可靠得到的精确结果。
四、实操示例:用 LangChain 搭一个两步链
书中用 LangChain / LangGraph 演示了线性序列的实现。先是安装依赖:
bash
pip install langchain langchain-community langchain-openai langgraph然后是一段"先提取技术规格、再转成 JSON"的两步链:
python
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

## 为了更好的安全性,从 .env 文件加载环境变量
## from dotenv import load_dotenv
## load_dotenv()
## 确保你的 OPENAI_API_KEY 在 .env 文件中设置

llm = ChatOpenAI(temperature=0)

## --- 提示词 1:提取信息 ---
prompt_extract = ChatPromptTemplate.from_template(
    "从以下文本中提取技术规格:\n\n{text_input}"
)

## --- 提示词 2:转换为 JSON ---
prompt_transform = ChatPromptTemplate.from_template(
    "将以下规格转换为 JSON 对象,使用 'cpu'、'memory' 和 'storage' 作为键:\n\n{specifications}"
)

## --- 利用 LCEL 构建处理链 ---
## StrOutputParser() 将 LLM 的消息输出转换为简单字符串。
extraction_chain = prompt_extract | llm | StrOutputParser()

## 完整的链将提取链的输出传递到转换提示词的 'specifications' 变量中。
full_chain = (
    {"specifications": extraction_chain}
    | prompt_transform
    | llm
    | StrOutputParser()
)

input_text = "新款笔记本电脑型号配备 3.5 GHz 八核处理器、16GB 内存和 1TB NVMe 固态硬盘。"

final_result = full_chain.invoke({"text_input": input_text})

print("\n--- 最终 JSON 输出 ---")
print(final_result)思路很清晰:extraction_chain 先从原文里抽出规格文字,full_chain 再把这份规格交给第二个提示词转成 JSON。LangChain 的表达式语言(LCEL)用 | 把"提示词→模型→输出解析器"优雅地串成一条流水线。
五、配套概念:从提示工程到上下文工程
第 1 章不止讲了链本身,还引入了**上下文工程(Context Engineering)**这一重要概念。
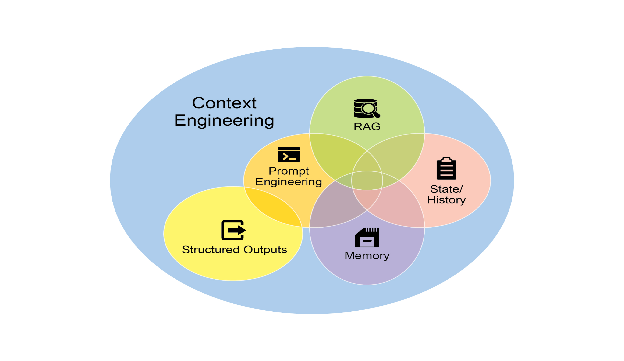
图 1:上下文工程是为 AI 构建丰富、全面的信息环境的学科------上下文质量是实现高级智能体性能的主要因素。
书中强调:模型输出的质量,更取决于"所提供的上下文的丰富度",而非模型架构本身。上下文工程就是在生成 token 之前,系统地设计、构建并喂给模型一整套信息环境,比传统只优化提示词措辞的"提示工程"走得更远。它涵盖多层信息:
- 系统提示词:定义 AI 操作参数的基础指令,例如"你是一名技术作家,语气必须正式且精确";
- 检索文档:AI 主动从知识库拉取信息来指导回答;
- 工具输出:AI 调用外部 API 获取实时数据(比如查日历判断用户是否有空);
- 隐性数据:用户身份、交互历史、环境状态等并不显式出现的背景信息。
为此还可借助 Google Vertex AI 提示优化器 这类工具,用样本输入 + 评估指标来系统化地自动化改进上下文,形成反馈闭环。可以说,上下文工程是把"无状态聊天机器人"升级为"情境感知、高度能干系统"的关键方法论。
六、速览
- 问题背景:复杂任务塞进单个提示词会让 LLM 不堪重负,出现指令忽略、上下文偏离、错误放大、幻觉等问题,输出不可靠。
- 解决方案:把复杂问题分解成一系列较小的子任务,每个子任务用聚焦提示词处理,一步输出作为下一步输入,形成逻辑工作流;步骤间还能插入外部工具与结构化数据格式。
- 实践建议:当任务对单个提示词来说过于复杂、涉及多个不同的处理阶段、需要在步骤间与外部工具交互,或要构建需多步推理并维护状态的智能体系统时,就应使用此模式。
七、可视化总结
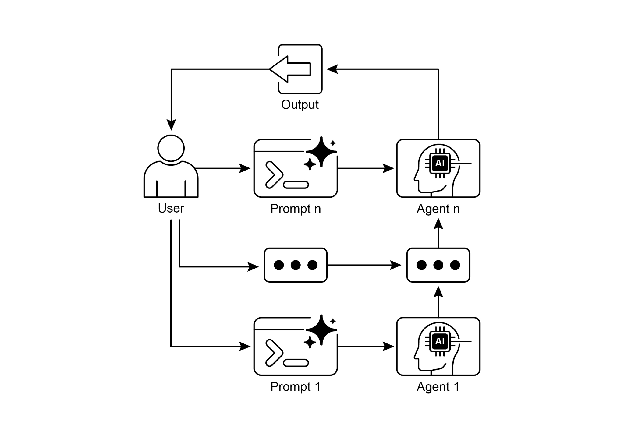
图 2:提示词链模式 ------ 智能体从用户接收一系列提示词,每个智能体的输出作为链中下一个智能体的输入。
关键要点
- 提示词链把复杂任务拆成一系列更小、更聚焦的步骤,有时也叫管道模式;
- 链中每一步都包含一次 LLM 调用或处理逻辑,以前一步输出为输入;
- 它显著提升了复杂交互的可靠性与可管理性;
- LangChain / LangGraph、Google ADK 等框架为定义、管理和执行这些多步序列提供了健壮工具。
结语与个人思考
提示词链是《Agentic Design Patterns》开篇的第一个模式,也是全书构建复杂 AI 智能体的"地基工程"。它的价值不在于炫技,而在于把"分而治之"这一朴素思想用在了 LLM 场景上:一次只让模型干好一件事。
值得延伸思考的是,提示词链并非银弹。它的强项是"线性、有依赖"的任务流,这也意味着:如果各子任务之间没有强依赖、可以并行,那链条反而会拖慢进度(此时应考虑第 3 章的"并行化"模式);如果步骤太多,链的调试和审计成本也会上升。书中建议在多步模式下为每一步分配不同角色(如"市场分析师""文档撰写者")来提升稳定性,这也是个很实用的调参思路。
下一步,建议阅读第 2 章 路由(Routing)------看看如何根据输入自动选择合适的处理路径,和提示词链形成互补。
本文基于开源书籍《Agentic Design Patterns》(https://github.com/xindoo/agentic-design-patterns ,在线阅读 https://adp.xindoo.xyz/ )整理,供学习交流,版权归原作者所有。